


La memoria associativa di Hopfield#
La memoria di un computer funziona per indirizzo: ogni dato abita in una casella numerata, e per recuperarlo bisogna conoscere il numero esatto, sbagli una cifra e ottieni un dato qualsiasi. La memoria umana funziona per contenuto: bastano tre note stonate fischiettate da un passante per farti riaffiorare l’intera canzone, un profumo per restituirti una cucina di trent’anni fa, mezza faccia intravista da un autobus per completare nome e cognome. Non forniamo indirizzi: forniamo frammenti, e il ricordo si completa da solo. I tecnici la chiamano memoria associativa.
Nel 1982 John Hopfield mostra come costruirne una con neuroni artificiali [Hop82]. Era un fisico della materia condensata, cioè di come si comportano solidi e liquidi, passato poi a studiare i sistemi biologici, e dal 1980 insegnava al California Institute of Technology.
Non parte da un foglio bianco, ed è giusto dirlo. Memorie che si interrogano per contenuto circolavano già da un decennio, costruite legando fra loro i pezzi che nei ricordi vanno d’accordo: le propongono nel 1972, ognuno per conto suo, Teuvo Kohonen [Koh72], Kaoru Nakano [Nak72], James Anderson [And72] e Shun-ichi Amari [Ama72].[1] Quello che Hopfield aggiunge, e che fa ripartire il campo da lui, è l’energia: un solo numero associato a ogni configurazione della rete, più la dimostrazione che la regola con cui i neuroni cambiano stato, uno alla volta, non lo fa mai salire. Da quel momento i ricordi sono minimi, e ricordare è una discesa.
La sua mossa è quella di un fisico. Si prendono \(N\) neuroni che possono stare solo «accesi» o «spenti» (in gergo si dicono binari, come una fila di interruttori), e lo stato del neurone \(i\) si scrive \(s_i = +1\) se è acceso e \(s_i = -1\) se è spento. I neuroni sono collegati a due a due da pesi \(w_{ij}\), numeri che dicono quanto due neuroni tendono a stare d’accordo: positivi se preferiscono trovarsi nella stessa posizione, negativi se preferiscono l’opposta. E i pesi sono simmetrici, \(w_{ij} = w_{ji}\): il legame fra due neuroni vale lo stesso nei due versi. Un sistema così ha la stessa struttura matematica di un modello di materiale magnetico, quello di Ising con legami di segno qualunque, dove ogni atomo si comporta come una freccina che punta in su o in giù e sente l’influenza delle altre.
Quella freccina introduce un’altra parola in prestito dalla fisica: lo spin, ed è la parola che si incontra in tutti i lavori di fisica su queste reti. Qui non serve sapere che cos’è uno spin davvero: basta l’immagine della freccina con due sole posizioni, che è la stessa cosa di un neurone acceso o spento. Da qui in avanti «stato» e «configurazione» vogliono dire la stessa cosa: l’elenco \(\mathbf{s}\) dei valori di tutti i neuroni in un dato momento.
La fisica statistica studia da decenni sistemi di questo tipo, e parte da due domande: qual è l’energia di ogni configurazione, e verso dove scende?

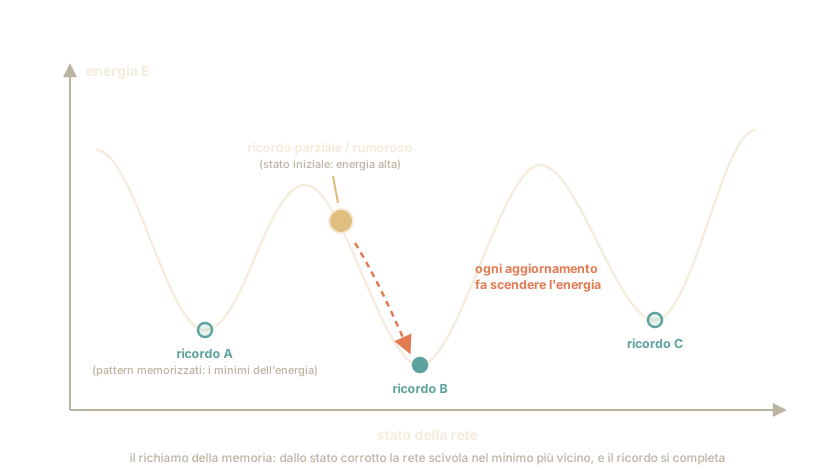
Fig. 29.2 Il paesaggio di energia di una rete di Hopfield. Le parole tecniche del disegno, sciolte: i «pattern memorizzati» sono i ricordi (nel disegno sono tre, e si chiamano A, B e C), i «minimi» sono i fondovalle in cui stanno, sull’asse orizzontale («stato della rete») ci sono tutte le configurazioni possibili messe in fila, lo stato «rumoroso» da cui parte la pallina è l’indizio rovinato che diamo alla rete, e un «aggiornamento» è una casella che guarda i suoi vicini e decide se cambiare.#
La Fig. 29.2 contiene, in un solo disegno, tutta l’idea: i ricordi sono valli, e a fare il lavoro di richiamo al posto nostro è la regola con cui la rete si aggiorna, che non fa mai salire l’energia.
A questo punto la rete e la pallina rischiano di sembrare due oggetti distinti. La pallina non è un oggetto in più che si muove sopra il paesaggio: la pallina è la rete, cioè l’elenco di quali neuroni sono accesi in quel momento, disegnato come un puntino su una carta.
Ogni ricordo che la rete ha memorizzato scava una valle nel paesaggio della figura. Lo stato della rete in un dato momento è una pallina appoggiata da qualche parte su quel profilo. Dare alla rete un indizio (un ricordo parziale, o rovinato) significa posare la pallina in un punto alto del pendio, vicino a una valle ma non sul fondo. Poi non c’è altro da fare: la pallina rotola, e può soltanto scendere, finché si ferma nel punto più basso nei paraggi. Se l’indizio somigliava al ricordo B più che agli altri, il fondo più vicino è proprio la valle di B: arrivarci è ricordare, con tutti i dettagli che l’indizio non conteneva. La melodia stonata del passante ti deposita sul fianco della valle della canzone giusta, e la discesa fa il resto: il ricordo non lo cerchi, ci cadi dentro.
Due avvertenze oneste, sulla valle sbagliata e sulla capienza. La pallina scende nella valle più vicina, non necessariamente in quella giusta, e «vicina» qui vuol dire somigliante: due configurazioni sono vicine quando differiscono in poche caselle. Se l’indizio è troppo rovinato somiglia più al ricordo sbagliato che a quello giusto, e da lì si finisce nel ricordo sbagliato con la stessa naturalezza.
E il paesaggio ha una capienza. Scavando troppe valli in poco spazio i fianchi si fondono, e compaiono conche che nessuno ha mai memorizzato, miscele di più ricordi insieme: «ricordi fantasma». A fondersi per prime sono le valli dei ricordi che si somigliano, perché due ricordi somiglianti scavano vicini. Una rete di venticinque neuroni si può mettere alla prova diecimila volte: con tre ricordi presi a caso il richiamo riesce l’88% delle volte, con quattro il 72%, con cinque il 54%, con sei il 36%. Il peggioramento, qui, è dolce.
In una rete grande il passaggio è netto, e la soglia si sa dov’è, almeno per ricordi presi a caso: sta intorno al 14% del numero di neuroni, cioè un ricordo ogni sette. Sotto quella quota la rete funziona quasi sempre, al più con qualche casella su cento sbagliata; appena sopra smette di funzionare quasi del tutto. A rompersi di colpo è la rete grande, il contrario di quel che verrebbe da pensare, e la ragione è la stessa delle monete. Dieci lanci possono dare sette teste, diecimila lanci danno quasi esattamente metà teste. In una rete piccola ogni gruppo di ricordi pescato a caso è un caso a sé: alcuni si disturbano poco, altri molto, e la rete cede ogni volta a una quota diversa, così che a guardarle tutte insieme si vede una discesa dolce. In una rete grande i disturbi di migliaia di caselle si compensano fra loro, ogni gruppo di ricordi si comporta come gli altri, e la rete cede sempre alla stessa quota: uno scalino.
La rete è un vettore di \(N\) neuroni binari \(s_i \in \{-1, +1\}\), collegati da pesi simmetrici (\(w_{ij} = w_{ji}\)) e senza auto-connessioni (\(w_{ii} = 0\)). A ogni stato \(\mathbf{s}\) è associata l’energia
dove \(\mathbf{W}\) è la matrice dei pesi e la somma percorre le coppie ordinate (ogni coppia di neuroni compare due volte, una per verso: è da lì che viene il \(\tfrac12\) davanti). Una coppia collegata da peso positivo abbassa l’energia quando i due neuroni concordano, e la alza quando discordano (per pesi negativi vale l’opposto). Manca il termine di soglia \(+\sum_i b_i s_i\) del modello generale: qui le soglie sono nulle, com’è nel codice. La dinamica è l’aggiornamento asincrono: si sceglie un neurone \(i\), si calcola il suo campo locale \(h_i = \sum_j w_{ij} s_j\) e si pone \(s_i \leftarrow \operatorname{sign}(h_i)\) (con la convenzione \(\operatorname{sign}(0) = s_i\), cioè in caso di parità il neurone resta com’è: è quello che fa il codice, e senza quella convenzione lo stato uscirebbe da \(\{-1,+1\}\)), lasciando tutto il resto fermo.
Che l’energia non possa salire si mostra in tre passaggi, e ciascuno usa un’ipotesi diversa. Primo: si isolano i termini che contengono \(s_i\). Sono due somme, \(-\tfrac12\sum_{l \neq i} w_{il}s_i s_l\) e \(-\tfrac12\sum_{k \neq i} w_{ki} s_k s_i\), che grazie alla simmetria sono uguali e si raccolgono in \(-s_i h_i\); e \(h_i\) non dipende da \(s_i\) grazie a \(w_{ii} = 0\). Dunque \(E = -s_i h_i + \text{cost}\), dove la costante non coinvolge \(s_i\). Secondo: se il neurone si capovolge, \(s_i \to -s_i\), l’energia varia di \(\Delta E = 2\, s_i h_i\). Terzo: il capovolgimento avviene solo quando \(\operatorname{sign}(h_i) \neq s_i\), cioè quando \(s_i h_i = -|h_i|\), da cui
Ogni aggiornamento fa scendere l’energia o la lascia invariata, mai salire: invariata quando il neurone resta com’è (anche in caso di parità, \(h_i = 0\)), più bassa di \(2|h_i|\) quando si capovolge. Tolta la simmetria il conto non torna: le due somme non si raccolgono più in \(-s_i h_i\), un capovolgimento può alzare \(E\), e la rete può girare in tondo senza fermarsi mai (con due neuroni, \(w_{12} = 1\) e \(w_{21} = -1\), il primo vuole copiare il secondo e il secondo vuole fare il contrario del primo: gli stati sono quattro, e la rete li visita in cerchio).
Che la discesa termini segue da un conto. L’energia è limitata, \(|E| \le \tfrac12 \sum_{i \neq j} |w_{ij}|\), e ogni capovolgimento la abbassa di almeno \(2 \min\{|h_i| : h_i \neq 0\}\), un minimo preso su un numero finito di stati e quindi positivo: i capovolgimenti sono in numero finito, e una passata completa senza capovolgimenti, in qualunque ordine, certifica un punto fisso. Basta che ogni neurone venga visitato, e il codice lo garantisce ripescando ogni volta una permutazione di tutti i neuroni. La condizione \(w_{ii} = 0\) si può allentare in \(w_{ii} \ge 0\): con un termine diagonale positivo il neurone si capovolge solo se \(s_i \sum_{j \neq i} w_{ij} s_j < -w_{ii}\), e la discesa resta; con \(w_{ii} < 0\) cade. L’asincronia invece non si può allentare: con l’aggiornamento sincrono e \(\mathbf{W}\) simmetrica la dinamica finisce in un punto fisso oppure in un ciclo di due stati che si alternano per sempre [GO80].
Le valli si scolpiscono con la regola di Hebb [Heb49]. Per memorizzare i pattern \(\boldsymbol{\xi}^1, \dots, \boldsymbol{\xi}^M\), ciascuno un vettore di \(\pm 1\):
dove \(\xi_i^{\mu}\) è l’\(i\)-esimo bit del pattern \(\mu\): ogni pattern rafforza i legami tra i propri bit concordi. Sostituendo questi pesi nell’energia si ottiene la forma da cui partirà, molto più avanti, la versione moderna di queste reti:
cioè ogni ricordo abbassa l’energia in proporzione al quadrato della sua sovrapposizione con lo stato (il \(M/2\) è la diagonale che \(w_{ii} = 0\) toglie, ed è una costante). Che la regola renda \(\boldsymbol{\xi}^\mu\) un minimo locale di \(E\) si vede in un conto solo, ed è il conto da cui discende tutto il resto della sezione. Mettendo la rete nello stato \(\boldsymbol{\xi}^\mu\), il campo locale sul neurone \(i\) vale
perché \((\xi_j^\mu)^2 = 1\) per ogni \(j\). Il primo termine tira il neurone esattamente dove il pattern lo vuole; il secondo è la somma delle sovrapposizioni con tutti gli altri ricordi, e il bit resta al suo posto finché quel disturbo, moltiplicato per \(\xi_i^\mu\), non scende sotto \(-(N-1)/N\). Da qui vengono, in un colpo solo, tre cose: che i pattern quasi ortogonali (interferenza piccola) siano stabili; che aggiungerne troppi faccia crescere il disturbo finché non prevale; e che a pesare non sia solo il loro numero, ma anche quanto si somigliano, come si vedrà con la T, la L e la X. Per pattern casuali il conto si chiude. L’interferenza è una somma di \((M-1)(N-1)\) termini \(\pm 1/N\) indipendenti, con media nulla e varianza \(\approx M/N\), quindi per il limite centrale un bit è instabile al primo passo con probabilità \(\approx \Phi\big(-\sqrt{N/M}\big)\), dove \(\Phi\) è la ripartizione della normale standard: a \(M/N = 0{,}138\) vale \(0{,}0036\). Se invece si pretende che tutti i bit di tutti i pattern restino fermi con probabilità che tende a uno, serve \(M < N/(4 \ln N)\) [MPRV87]: \(1{,}9\) ricordi a \(N = 25\), \(271\) a \(N = 10\,000\), dove \(0{,}138\,N\) ne darebbe \(1380\). La differenza fra le due capienze è la tolleranza su una piccola frazione di bit. La capienza è dunque limitata: l’analisi di meccanica statistica di Daniel Amit, Hanoch Gutfreund e Haim Sompolinsky [AGS85], con i metodi dei vetri di spin, mostra che la memoria associativa esiste solo per \(M < \alpha_c N\) con \(\alpha_c = 0{,}138\), e che oltre quella soglia il recupero non degrada dolcemente: crolla tutto insieme (la transizione è del primo ordine). Il valore \(0{,}14\) che si trova citato dappertutto non è frutto di scoperte successive: è un arrotondamento, e sta nello stesso articolo del 1985, che scrive \(0{,}138\) sotto la formula e nei due grafici, e circa \(0{,}14\) nel sommario e nella conclusione. Il valore \(0{,}138\) è quello della soluzione a simmetria di replica: rompendo la simmetria a un passo, gli stati di richiamo sopravvivono fino a \(\alpha \approx 0{,}144\) [CAG86]. E sotto soglia il richiamo non è perfetto: vicino ad \(\alpha_c\) il ricordo richiamato ha ancora una frazione di bit sbagliati dell’ordine dell’uno o due per cento, ed è per questo che i teoremi parlano di ricordi «quasi» perfetti.
Le ipotesi contano, perché sono ciò che rende quel numero un teorema e non un’osservazione: pattern casuali e non correlati, rete completamente connessa, limite termodinamico \(N \to \infty\) a carico \(M/N\) fisso, temperatura nulla, simmetria di replica, e una tolleranza per una piccola frazione di bit errati nel richiamo. Al di fuori di queste assunzioni il numero va maneggiato con cura, e la rete di venticinque neuroni mostra quanto: a \(N = 25\) non c’è nessun limite termodinamico e la transizione è del tutto sfumata. Con pattern casuali (diecimila prove per punto, gli \(M\) pattern ridisegnati a ogni prova, sei bit invertiti su venticinque) il richiamo perfetto riesce con frequenza \(0{,}88\) a \(M = 3\), \(0{,}72\) a \(M = 4\), \(0{,}54\) a \(M = 5\) e ancora \(0{,}36\) a \(M = 6\), quasi il doppio del valore \(M \approx 3{,}5\) in cui la formula asintotica metterebbe il crollo (\(0{,}138 \times 25\)): nessun crollo, una discesa regolare. Quel prodotto dà un ordine di grandezza e nient’altro: il crollo è un fenomeno di reti grandi, e prenderlo per una soglia su venticinque neuroni è un modo elegante di sbagliare.
Il limite è della regola di Hebb, e la rete da sola non lo impone. Con la regola della pseudo-inversa, \(\mathbf{W} = \boldsymbol{\Xi}^{+}\boldsymbol{\Xi}\) con i ricordi nelle righe di \(\boldsymbol{\Xi} \in \mathbb{R}^{M \times N}\) (la proiezione sul sottospazio che generano), ogni insieme di ricordi linearmente indipendenti, anche correlati fra loro, è stabile e senza errori per ogni \(M < N\) [KS87, PGD85]; il prezzo è che il peso \(w_{ij}\) non dipende più soltanto dai neuroni \(i\) e \(j\), e la regola smette di essere locale. Quanto al costo, un aggiornamento costa \(O(N)\) e una passata \(O(N^2)\), e la regola di Hebb tiene circa \(0{,}138\,N\) ricordi da \(N\) bit in \(N(N-1)/2\) pesi: poco più di un quarto di bit per peso.
E anche sotto soglia il paesaggio contiene minimi non richiesti: gli opposti \(-\boldsymbol{\xi}^{\mu}\) di ogni pattern, profondi quanto i pattern perché \(E(-\mathbf{s}) = E(\mathbf{s})\), e le miscele spurie. Con tre pattern le miscele sono le \(2^3\) combinazioni \(\operatorname{sign}(\pm\boldsymbol{\xi}^{1} \pm \boldsymbol{\xi}^{2} \pm \boldsymbol{\xi}^{3})\), voti a maggioranza fra i pattern presi con il segno scelto; per pattern casuali la maggioranza di tre concorda con ciascuno con probabilità \(3/4\), quindi ogni miscela ha sovrapposizione \(1/2\) con ciascuno dei tre pattern da cui nasce, preso con il suo segno. Con la T, la L e la X tutte e otto sono punti fissi, e sono le sole conche spurie in cui la rete va a finire.
Una memoria che si ripara da sola, in poche righe#
Tutto questo si può toccare con mano, e in poche righe. Il codice che segue costruisce una rete di venticinque neuroni disposti in una griglia di cinque per cinque caselle, e le fa memorizzare tre lettere stilizzate: una T, una L e una X. Memorizzare, qui, vuol dire una cosa sola, e la fa una riga sola: legare fra loro le caselle che nelle tre lettere vanno d’accordo, tanto più forte quanto più spesso ci vanno. È la regola che scava le valli, e porta il nome del neuropsicologo Donald Hebb, che nel 1949 propose per le sinapsi del cervello proprio questo: due cellule che si accendono insieme rafforzano il legame che le unisce [Heb49]. Poi il codice rovina una lettera invertendo sei caselle a caso (sei su venticinque, il 24%) e lascia che la rete si aggiusti da sé, una casella alla volta, finché nessuna vuole più cambiare.
Conviene vedere che numero esce da quel «legare», perché è il conto che regge tutto il resto della sezione. Prendiamo la seconda e la terza casella della prima riga: nella T sono accese tutte e due, nella L sono spente tutte e due, nella X sono spente tutte e due. Vanno d’accordo tre volte su tre, e il loro legame vale \(3/25 = 0{,}12\), il massimo che si possa avere con tre ricordi. Prendiamo invece la prima casella e la seconda della stessa riga: vanno d’accordo solo nella T (accese entrambe) e discordano nella L e nella X. Un accordo e due disaccordi fanno \(1 - 1 - 1 = -1\); si divide per il numero di caselle, venticinque, perché così i legami restano della stessa taglia anche se la griglia cresce, e viene \(-0{,}04\): un legame debole e di segno contrario, che quelle due caselle tenderà a tenerle diverse. Tutti i legami della rete sono numeri così, e sono tutto ciò che la rete «sa».
Il codice costruisce i legami con quella regola, e poi mette la rete alla prova.
import numpy as np

rng = np.random.default_rng(42)

# Tre lettere stilizzate 5x5: '#' = pixel acceso (+1), '.' = spento (-1)
LETTERE = {
    "T": ["#####",
          "..#..",
          "..#..",
          "..#..",
          "..#.."],
    "L": ["#....",
          "#....",
          "#....",
          "#....",
          "#####"],
    "X": ["#...#",
          ".#.#.",
          "..#..",
          ".#.#.",
          "#...#"],
}

def a_vettore(disegno):
    """Da lista di stringhe a vettore di +1/-1."""
    return np.array([1 if c == "#" else -1
                     for riga in disegno for c in riga])

def a_righe(s):
    """Da vettore di +1/-1 a cinque stringhe stampabili."""
    griglia = np.where(s == 1, "#", ".").reshape(5, 5)
    return ["".join(riga) for riga in griglia]

pattern = np.array([a_vettore(d) for d in LETTERE.values()])   # forma (3, 25)
N = pattern.shape[1]

# Regola di Hebb: somma dei prodotti esterni, diagonale a zero
W = (pattern.T @ pattern) / N
np.fill_diagonal(W, 0.0)

def energia(s):
    """E(s) = -1/2 s^T W s (soglie nulle)."""
    return -0.5 * s @ W @ s

def richiama(s, W, max_passate=10):
    """Aggiornamento asincrono fino a un punto fisso (minimo locale)."""
    s = s.copy()
    for _ in range(max_passate):
        cambiato = False
        for i in rng.permutation(N):        # un neurone alla volta
            campo = W[i] @ s                # campo locale sul neurone i
            # in caso di parita' il neurone resta com'e'. Il confronto vuole una
            # tolleranza: i legami sono multipli di 1/25, che in virgola mobile
            # non sono esatti, e un campo nullo esce come 1e-17 invece che come 0
            nuovo = np.sign(campo) if abs(campo) > 1e-9 else s[i]
            if nuovo != s[i]:
                s[i] = nuovo
                cambiato = True
        if not cambiato:                    # nessun cambiamento: stato stabile
            break
    return s

def corrompi(s, quanti=6):
    """Inverte 'quanti' bit scelti a caso (6 su 25 = 24%)."""
    s = s.copy()
    indici = rng.choice(N, size=quanti, replace=False)
    s[indici] = -s[indici]
    return s

for nome, disegno in LETTERE.items():
    originale = a_vettore(disegno)
    rumoroso = corrompi(originale)          # 24% dei pixel invertiti
    recuperato = richiama(rumoroso, W)
    esito = ("recuperato" if np.array_equal(recuperato, originale)
             else "NON recuperato")
    print(f"{nome}:  E = {energia(rumoroso):+.2f} "
          f"-> {energia(recuperato):+.2f}  ({esito})")
    print("   corrotto   richiamato")
    for r1, r2 in zip(a_righe(rumoroso), a_righe(recuperato)):
        print(f"   {r1}      {r2}")
    print()
T:  E = -2.08 -> -11.20  (recuperato)
   corrotto   richiamato
   #.###      #####
   ..#..      ..#..
   #.#.#      ..#..
   .##..      ..#..
   .###.      ..#..

L:  E = -3.68 -> -11.20  (recuperato)
   corrotto   richiamato
   #...#      #....
   ##..#      #....
   #.#..      #....
   ##...      #....
   ###.#      #####

X:  E = -3.04 -> -11.04  (recuperato)
   corrotto   richiamato
   #.#.#      #...#
   ##.##      .#.#.
   ...##      ..#..
   .#.#.      .#.#.
   #...#      #...#
Tutte e tre le lettere riemergono intatte dalle loro versioni sfigurate. Per la T, ad esempio, l’energia scende da \(-2{,}08\) dello stato corrotto a \(-11{,}20\) della lettera richiamata.
Quei due numeri li ha calcolati la rete, sommando un contributo per ogni coppia di caselle: chi va d’accordo con il legame che lo unisce abbassa il totale, chi lo contraddice lo alza. Che vengano negativi non vuol dire niente di speciale. Sulla carta geografica c’è uno zero, il livello del mare; qui non c’è, e l’energia non è un’altitudine. Da sola non dice nulla; dice tutto se confrontata con un’altra energia dello stesso paesaggio. \(-11{,}20\) sta più in basso di \(-2{,}08\), e qui è l’unico fatto che conta.
Quella stampa mostra il prima e il dopo, e nasconde la parte interessante: i passi in mezzo. In Fig. 29.3 ci sono tutti, e la figura mette per la prima volta accanto le due immagini che finora sono andate separate. A sinistra c’è la griglia di venticinque caselle, dove a ogni aggiornamento (una casella guarda lo stato delle altre e decide se cambiare) una sola casella cambia colore. A destra c’è la pallina, cioè l’energia. Sono la stessa cosa vista da due parti: ogni casella che cambia colore è uno scalino che la pallina scende. E si vede la proprietà che rende la rete una memoria e non un pasticcio: l’energia non risale mai. Scende quando una casella cambia, e resta ferma quando la casella si guarda intorno e decide di stare com’è; nel disegno si contano solo i sei cambi, perché sono i soli passi in cui succede qualcosa. Che i cambi siano sei come le caselle rovinate è il caso migliore e non una regola: vuol dire che ogni casella sbagliata si è raddrizzata una volta sola e che nessuna casella giusta si è mossa per sbaglio. Alla fine nessuna casella vuole più cambiare, e quello è ciò che i tecnici chiamano un punto fisso.

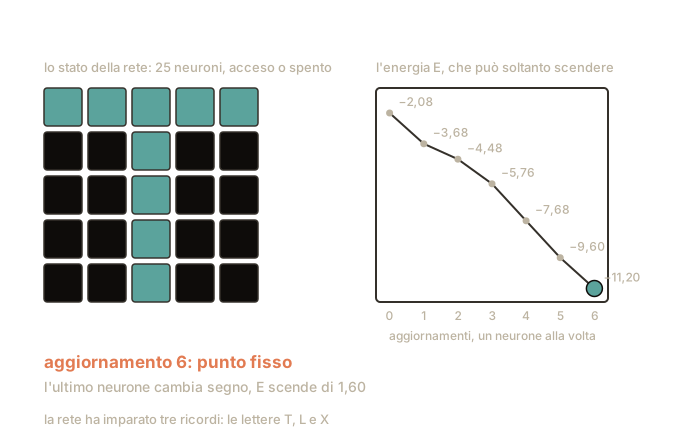
Fig. 29.3 Sei aggiornamenti, un neurone alla volta: la T corrotta si ricompone e l’energia scende a ogni passo, senza mai risalire, finché nessun neurone vuole più cambiare.#
Il codice rispetta le tre ipotesi della dimostrazione di discesa. La diagonale
di \(\mathbf{W}\) è nulla (np.fill_diagonal), quindi nessuna casella è
collegata a se stessa, e la spinta che sente mentre decide non dipende dalla
sua stessa posizione. \(\mathbf{W}\) è simmetrica, perché è una somma di
prodotti esterni: il legame fra due caselle vale lo stesso nei due versi, e la
casella che decide vede lo stesso costo che il totale conta. E le caselle si
aggiornano una alla volta, in un ordine che rng.permutation rimescola a ogni
passata. Il ciclo si ferma quando una passata intera non cambia niente, cioè in
un punto fisso.
L’ipotesi che si dimentica più facilmente è la terza. Una casella cambia solo quando è in disaccordo con la spinta che riceve dalle altre, e se le altre intanto stanno ferme l’energia può soltanto scendere. Se invece si aggiornassero tutte insieme, ciascuna deciderebbe credendo ferme le altre, e la rete potrebbe oscillare per sempre fra due stati, come due persone che per lasciarsi passare si scansano dallo stesso lato, poi tutte e due dall’altro, e così via.
Poi c’è l’onestà statistica, che qui è più istruttiva della riuscita. Quella stampa viene da un unico sorteggio. Il \(42\) è il seme del generatore di numeri pseudocasuali: fissa la sequenza dei sorteggi (le sei caselle rovinate e l’ordine in cui le caselle vengono visitate), così che chi esegue il codice veda la stessa stampa, e cambiandolo cambia tutto il resto. Per sapere quanto vale la rete bisogna ripetere la prova molte volte, e in tre modi: con ricordi presi a caso, da tre a sei, ridisegnati a ogni prova; con la T, la L e la X, rovinate diecimila volte ciascuna, contando dove la rete si ferma; e misurando quanto le tre lettere si somigliano. Per misurarlo, per ogni coppia di lettere si contano le caselle su cui concordano, si sottraggono quelle su cui discordano, e del saldo si tiene il numero senza il segno, perché un ricordo e il suo esatto opposto danno lo stesso disturbo. Più il saldo è piccolo, meno le due lettere si somigliano (su venticinque caselle, che sono in numero dispari, il minimo è 1).
from itertools import combinations, product
from math import comb

def prova(P, W, mu):
    """Rovina il ricordo mu in sei caselle e lo fa richiamare alla rete W."""
    return richiama(corrompi(P[mu]), W)

def fra(r, stati):
    """Lo stato r e' uno di quelli dell'elenco?"""
    return any(np.array_equal(r, x) for x in stati)

# ricordi presi a caso, ridisegnati a ogni prova: quante volte il richiamo
# restituisce il ricordo giusto, casella per casella
PROVE = 10_000
for M in (3, 4, 5, 6):
    riusciti = 0
    for _ in range(PROVE):
        P = rng.choice([-1, 1], size=(M, N))
        W_M = (P.T @ P) / N
        np.fill_diagonal(W_M, 0.0)
        mu = rng.integers(M)
        riusciti += np.array_equal(prova(P, W_M, mu), P[mu])
    print(f"{M} ricordi a caso: richiamo perfetto {riusciti / PROVE:.2f}")

# T, L e X rovinate diecimila volte ciascuna: dove si ferma la rete.
# Una miscela vota a maggioranza fra le tre lettere, ciascuna presa
# diritta o capovolta: le combinazioni di segno sono otto.
miscele = [np.sign(a * pattern[0] + b * pattern[1] + c * pattern[2])
           for a, b, c in product((1, -1), repeat=3)]
esiti = dict.fromkeys(["la lettera di partenza", "una miscela delle tre",
                       "un'altra lettera, capovolta", "un'altra lettera",
                       "la lettera di partenza, capovolta",
                       "nessuna di queste"], 0)
for mu in range(3):
    altre = [pattern[nu] for nu in range(3) if nu != mu]
    for _ in range(10_000):
        r = prova(pattern, W, mu)
        if np.array_equal(r, pattern[mu]):
            esiti["la lettera di partenza"] += 1
        elif fra(r, miscele):
            esiti["una miscela delle tre"] += 1
        elif fra(r, [-x for x in altre]):
            esiti["un'altra lettera, capovolta"] += 1
        elif fra(r, altre):
            esiti["un'altra lettera"] += 1
        elif np.array_equal(r, -pattern[mu]):
            esiti["la lettera di partenza, capovolta"] += 1
        else:
            esiti["nessuna di queste"] += 1
print()
for dove, quante in esiti.items():
    print(f"{dove:34s} {quante:6d} su 30000")
falliti = 30000 - esiti["la lettera di partenza"]
print(f"fallimenti {falliti}, finiti in una miscela "
      f"{esiti['una miscela delle tre'] / falliti:.0%}")
ferme = sum(np.array_equal(richiama(m, W), m) for m in miscele)
print(f"miscele da cui la rete non si muove: {ferme} su {len(miscele)}")

# quanto si somigliano: caselle concordi meno discordi, senza segno
print()
saldi = [abs(int(pattern[a] @ pattern[b]))
         for a, b in combinations(range(3), 2)]
print(f"saldo T-L {saldi[0]}, T-X {saldi[1]}, L-X {saldi[2]}: "
      f"in media {np.mean(saldi):.1f}")
# fra due disegni a caso il saldo vale |N - 2k| con probabilita' C(N,k)/2^N
atteso = sum(abs(N - 2 * k) * comb(N, k) for k in range(N + 1)) / 2**N
print(f"saldo atteso fra due disegni a caso: {atteso:.1f}")
3 ricordi a caso: richiamo perfetto 0.88
4 ricordi a caso: richiamo perfetto 0.72
5 ricordi a caso: richiamo perfetto 0.54
6 ricordi a caso: richiamo perfetto 0.36

la lettera di partenza              27839 su 30000
una miscela delle tre                1882 su 30000
un'altra lettera, capovolta           167 su 30000
un'altra lettera                      112 su 30000
la lettera di partenza, capovolta       0 su 30000
nessuna di queste                       0 su 30000
fallimenti 2161, finiti in una miscela 87%
miscele da cui la rete non si muove: 8 su 8

saldo T-L 3, T-X 1, L-X 1: in media 1.7
saldo atteso fra due disegni a caso: 4.0
Con ricordi presi a caso il richiamo perfetto cala dolcemente, da 88 prove su cento con tre ricordi a 36 con sei. Con la T, la L e la X va meglio: 27839 volte su 30000, quasi il 93%, più dell’88% dei tre ricordi presi a caso.
Nelle altre la rete si ferma altrove, e non sempre dove ci si aspetterebbe. Su dieci fallimenti quasi nove (l’87%) finiscono in una conca che nessuno ha memorizzato: una miscela delle tre lettere, in cui ogni casella prende il colore della maggioranza fra le tre, alcune delle quali prese col colore rovesciato. Le combinazioni di questo tipo sono otto, e sono tutte conche vere: messa in una qualunque di loro, la rete non si muove più. Il decimo fallimento si divide in due, e la parte più grossa è l’immagine capovolta di un’altra lettera; il resto è un’altra lettera.
Che le lettere capovolte compaiano è inevitabile, e capire perché aiuta: scambiando acceso e spento dappertutto, le caselle che andavano d’accordo continuano ad andarci, quindi ogni ricordo si porta dietro un gemello capovolto, profondo esattamente uguale. Quello che non compare mai è il gemello della lettera da cui si è partiti: in trentamila prove non capita neanche una volta, ed è troppo lontano perché succeda. Lo stato di partenza differisce dalla lettera in sei caselle su venticinque, e quindi dalla sua immagine capovolta in diciannove. Il gemello è profondo uguale, ma sta dall’altra parte, e una discesa che si muove una casella per volta non ci arriva mai.
E c’è un punto in cui questa rete è più fortunata di quanto la teoria le concederebbe. Le tre lettere sono state scelte in modo da somigliarsi il meno possibile, non pescate a caso, e il saldo lo mostra: vale 3 fra T e L e 1 nelle altre due coppie, in media 1,7, mentre fra due disegni presi a caso ci si aspetta 4,0.
E questo conta, perché è proprio la somiglianza fra i ricordi a far fondere i fianchi delle valli: la capienza di cui si diceva è calcolata su ricordi presi a caso e su reti grandi, e in questo caso i ricordi non sono casuali e la rete non è grande. Quel 93% la rete lo deve alla forma di questo paesaggio più che al codice, e la forma l’abbiamo scelta noi scegliendo le lettere.
Da ricordare
Una memoria associativa si interroga con un frammento, non con un indirizzo: tre note fischiettate da un passante e la canzone riaffiora intera.
Nella rete di Hopfield ogni ricordo memorizzato è una valle scavata nel paesaggio. L’indizio dice dove posare la pallina, la pallina rotola (può soltanto scendere) e il fondo in cui si ferma è il ricordo completo: la regola che scava le valli si limita a legare fra loro le caselle che nei ricordi vanno d’accordo.
La capienza è limitata, e per le reti grandi si sa di quanto: circa il 14% del numero di neuroni. Superata quella quota il richiamo non peggiora un poco alla volta, crolla tutto insieme.
Su una rete piccola come la nostra quel 14% non si applica, e non c’è nessuna soglia netta: ripetendo la prova diecimila volte si trova un peggioramento dolce (con tre ricordi presi a caso il richiamo riesce l’88% delle volte, con quattro il 72%, con cinque il 54%, con sei il 36%). Nel paesaggio compaiono anche conche che nessuno ha mai memorizzato, miscele di più ricordi, e il gemello capovolto di ogni ricordo.
La pallina finisce nella valle più vicina, non necessariamente in quella giusta. E la rete ricorda soltanto: non inventa, e può solo scendere. Sono i due limiti che la prossima sezione affronta con la temperatura e i neuroni nascosti.
Da ricordare
Una memoria associativa si interroga con un frammento, non con un indirizzo: il ricordo si completa da solo.
Nella rete di Hopfield [Hop82] i ricordi sono minimi dell’energia \(E(\mathbf{s}) = -\tfrac{1}{2}\, \mathbf{s}^\top \mathbf{W} \mathbf{s}\); la regola di Hebb scava le valli e l’aggiornamento asincrono (che non fa mai salire \(E\)) completa i ricordi corrotti scendendo nel minimo più vicino.
La capienza è di circa il 14% del numero di neuroni (\(\alpha_c = 0{,}138\)) [AGS85], e oltre soglia il richiamo non degrada: crolla. È però un risultato asintotico, per pattern casuali e non correlati: su reti piccole la transizione è sfumata e la degradazione dolce. Il limite è della regola di Hebb: con la pseudo-inversa si arriva a \(N\) ricordi linearmente indipendenti, a prezzo di una regola non locale. Il paesaggio ospita anche minimi spuri: i gemelli capovolti \(-\boldsymbol{\xi}^\mu\) e le miscele dei ricordi.
La rete ricorda ma non inventa, e può solo scendere: due limiti che la prossima sezione affronta con la temperatura e i neuroni nascosti.