


Aprire la scatola nera#
Nel 2016 tre ricercatori dell’Università di Washington (Marco Tulio Ribeiro, Sameer Singh e Carlos Guestrin) costruirono di proposito un programma truccato. Doveva guardare una fotografia e dire se ritraeva un husky o un lupo, e nessuno gliel’aveva insegnato a parole: l’aveva imparato da solo, guardando delle foto su cui qualcuno aveva già scritto la risposta giusta. Era un classificatore semplice, di quelli del capitolo sul machine learning, appoggiato sopra una rete per immagini già addestrata da altri e lasciata com’era: la parte che imparava dalle foto era solo il classificatore in cima.
Il trucco stava nelle foto. Erano venti soltanto, poche apposta, e scelte a mano in modo che tutti i lupi comparissero su sfondo innevato, al contrario degli husky. Come previsto, il modello imparò una scorciatoia («c’è neve → lupo») che con l’animale non c’entrava nulla: un rilevatore di neve travestito da riconoscitore di canidi.
Poi venne la parte interessante. I tre mostrarono dieci risposte del modello, errori compresi, a ventisette studenti di dottorato e di magistrale che avevano già seguito un corso di machine learning, e chiesero loro se si fidassero e su quali basi pensassero che il programma decidesse. Con le sole risposte sotto gli occhi, dieci studenti su ventisette dissero di fidarsi, e meno della metà sospettò della neve. Allora i ricercatori diedero loro le spiegazioni: sopra ogni foto, evidenziate a colori, le porzioni di immagine su cui quella risposta si era basata. L’inganno crollò. I fiduciosi scesero a tre, e venticinque studenti su ventisette indicarono la neve [RSG16]. Era una messinscena costruita apposta per dimostrare una cosa sola: senza una spiegazione, nemmeno gli addetti ai lavori si accorgono di un modello che funziona per la ragione sbagliata. Il metodo che disegna quelle macchie, LIME, lo proposero gli stessi autori insieme all’esperimento, e lo racconta la sezione sulle spiegazioni locali.
La storia ha un antenato illustre. All’inizio del Novecento, a Berlino, un cavallo di nome Hans il Sapiente sembrava saper contare: gli si chiedeva «quanto fa sette più cinque?» e lui batteva lo zoccolo dodici volte. Nel settembre del 1904 una commissione di tredici persone lo esaminò e concluse due cose: che imbroglio non ce n’era, e che il caso meritava un’indagine seria. L’indagine cominciò a metà ottobre, condotta dall’Istituto di psicologia dell’università di Berlino, e gli esperimenti li fece lo psicologo Oskar Pfungst: a fine novembre era finita, e a dicembre si sapeva come stavano le cose. Hans non faceva aritmetica, leggeva i movimenti involontari di chi gli poneva la domanda. L’esaminatore, chino appena in avanti a guardare lo zoccolo, alzava di un nonnulla la testa quando i colpi arrivavano al numero giusto, senza accorgersene, e il cavallo si fermava lì. Bastava che l’esaminatore non conoscesse la risposta, e Hans sbagliava. Pfungst ne pubblicò il resoconto per esteso in un libro nel 1907, ed è quello che si cita ancora. Da allora si chiama effetto Clever Hans ogni sistema che sembra risolvere un problema mentre in realtà ne risolve un altro, più facile e nascosto. Il rilevatore di lupi è un Clever Hans in silicio: azzeccava quasi sempre, e per la ragione sbagliata.
Il problema è che un modello non ci dice, di suo, perché decide come decide. È una scatola nera: si vedono la fotografia che entra e la risposta che esce, e i numeri che stanno in mezzo si possono anche stampare tutti, ma nessuno di essi dice qualcosa che una persona sappia leggere.
Le regole di questo programma, del resto, non le ha scritte nessuno: il modello se le è ricavate dagli esempi, e sono i parametri della rete a strati che il capitolo sulle reti neurali ha montato pezzo per pezzo, una tabella di numeri senza nome (milioni, nei modelli di oggi).
Nessuno di quei numeri, preso da solo, significa qualcosa. Il modello non risponde «lupo» e basta: risponde con un punteggio, per esempio una probabilità di 0,87 che nella foto ci sia un lupo. Quel valore non sta scritto in nessun punto del modello: è l’effetto combinato di tutti i parametri, ognuno dei quali spinge un poco verso il lupo o contro, e i loro contributi in gran parte si compensano fra loro. Stampare il programma non serve a niente, perché il programma è quella tabella, e lì dentro la parola «neve» non è scritta da nessuna parte. Chiamiamo interpretabilità la capacità di capire su che cosa si appoggia la risposta di un modello, anche quando il modello non la offre da sé.
Se il modello suggerisce un film, un errore costa poco. Se decide se concedere un mutuo, se un tumore è maligno o se rilasciare un imputato, la domanda «perché?» diventa una questione di fiducia e di giustizia. E lì gli esempi non sono fotografie ma righe di una tabella, una per persona, con le feature in colonna (il reddito, l’età, i debiti in corso): è alle colonne che i metodi di spiegazione chiedono conto delle risposte.
La domanda «perché?», dicevamo, è anche una questione di legge. Il Regolamento generale sulla protezione dei dati europeo (GDPR, applicabile dal 2018) detta delle regole sulle decisioni prese da un programma senza che un essere umano ci metta mano, e obbliga chi le usa a dare all’interessato, cioè alla persona su cui la decisione cade, «informazioni significative sulla logica utilizzata». Per anni i giuristi hanno discusso se da lì nascesse un vero e proprio «diritto alla spiegazione», e il punto della lite era proprio questo: quelle informazioni riguardano il funzionamento del sistema in generale, o si può pretendere il motivo della propria decisione, quella e non un’altra? Nel febbraio del 2025 la Corte di giustizia dell’Unione europea (causa C-203/22) ha preso la seconda strada: chi decide deve descrivere la procedura e i principi che ha applicato davvero, in modo che l’interessato capisca quali dei suoi dati sono stati usati e come, e consegnargli l’algoritmo non basta. L’AI Act, il regolamento europeo sull’intelligenza artificiale, aggiunge per le decisioni prese sulla base di un sistema ad alto rischio il diritto a spiegazioni chiare e significative sul ruolo che il sistema ha avuto e sugli elementi principali della decisione (art. 86) [EuropeanPaCouncil24]. Che cosa debba contenere, in concreto, una spiegazione così resta aperto, e la differenza fra le due letture è una delle domande con cui fra poco metteremo ordine fra i metodi: spiegare il modello in generale non è la stessa cosa che spiegare una sua singola risposta, e non si fa con gli stessi attrezzi.
Ti fidi di un professore che dà sempre voti giusti e non spiega mai come li assegna? Finché i voti sono corretti sì; ma il giorno che ne prendi uno che ti sembra ingiusto, senza una spiegazione non puoi né capire dove hai sbagliato né difenderti. E il colpo di scena arriva qui: i compiti quel professore non li legge, guarda la calligrafia. Correggerne trenta a sera sono tre ore, la calligrafia si vede in un secondo, e nella sua classe, per caso, i più bravi scrivono anche più ordinato. La regola gli è costata pochissimo e funziona: nessuno gli ha mai dato un motivo per cercarne una migliore.
E funziona anche sui compiti che non aveva mai visto: puoi metterlo alla prova quanto vuoi, finché quelli che gli porti vengono da quella classe i voti tornano. Nessuno se ne accorge finché non arriva uno bravo con una brutta calligrafia, o un somaro ordinatissimo. Lì il voto è sbagliato, e nel registro non c’è niente che lo faccia sospettare.
Per scoprirlo non serve contare i voti giusti, che sono tanti: bisogna sorprenderlo mentre corregge, e vedere che gli occhi vanno alla calligrafia e non al compito. Aprire la scatola nera vuol dire questo: chiedere al modello non solo cosa ha deciso, ma su cosa si è basato.
Il fenomeno degli husky ha un nome tecnico: correlazione spuria, e l’apprendimento che se ne serve si chiama shortcut learning: la scorciatoia è una regola di decisione che funziona sui dati di prova estratti come quelli di addestramento e fallisce fuori da quella distribuzione [GJM+20]. Il modello minimizza la sua loss sui dati disponibili, e se una feature accessoria (la neve) è statisticamente associata all’etichetta nel training e nel test, l’ottimizzazione la sfrutta senza scrupoli: è la strategia più economica per abbassare l’errore. La metrica di generalizzazione non lo cattura perché la correlazione è presente in entrambe le partizioni, indistinguibili sotto l’ipotesi che siano campionate dalla stessa distribuzione. È l’illusione dell’accuratezza: un modello «giusto per la ragione sbagliata» collassa appena la distribuzione cambia (un lupo su erba, un husky sulla neve), perché la scorciatoia appresa non è la relazione causale che ci interessava. L’interpretabilità è uno degli strumenti diagnostici che espongono la discrepanza tra ciò che il modello dovrebbe usare e ciò che usa davvero, che l’accuratezza aggregata, per costruzione, non può vedere; gli altri sono le prove mirate, su dati raccolti altrove o divisi per sottogruppi.
Perché aprire la scatola#
Le ragioni per volere una spiegazione non sono una sola, e non hanno tutte lo stesso peso. Hanno però una radice comune [DVK17]. Un modello si addestra facendo scendere un solo numero, la perdita, che misura quanto le sue risposte sono sbagliate e nient’altro; e si vuole una spiegazione quando quel numero non riesce a contenere tutto quello che gli chiediamo davvero: «indovina l’animale» si scrive in una formula, «guarda l’animale e non lo sfondo» o «non discriminare» no. Elencarle conviene lo stesso, perché guidano che tipo di spiegazione cerchiamo.
Fiducia. Un medico non delega una diagnosi a un sistema di cui non capisce il ragionamento. E senza una spiegazione non può nemmeno fare il contrario, cioè scartarlo con cognizione di causa: gli mancano gli elementi tanto per fidarsi quanto per rifiutare.
Trovare i difetti. Il caso husky è il manifesto. La scorciatoia non è un errore di programmazione: il programma faceva esattamente quello che doveva. È un difetto che si vede solo guardando su che cosa il modello si appoggia, perché dai risultati non emerge affatto: il modello indovina tanto, e chi guarda i risultati lo promuove. (Cercare e togliere i difetti da un programma si chiama fare debug.) Aprire la scatola è, prima di tutto, uno strumento di ingegneria.
Equità. Un modello può discriminare per genere o provenienza anche senza che quelle informazioni gli siano state date: gli basta una colonna che ne faccia le veci, cioè che ne sia una spia. Il quartiere di residenza, in molte città, dice qualcosa sull’origine di chi ci abita, e un modello che rifiuta un prestito «per il quartiere» può di fatto rifiutarlo per la provenienza, che è proprio la cosa che non gli era stata data. Il modello non ha bisogno di sapere che sta discriminando: gli basta trovare la spia nei dati. Solo esaminando su cosa si basa una decisione si può scoprirlo, ed è un tema che riprenderemo nel capitolo sull’AI responsabile.
Scoperta scientifica. Ci sono modelli che indovinano cose che nessuno sapeva prevedere: come si ripiega una proteina, se una molecola nuova sarà un farmaco. Lì la domanda cambia segno. Non si chiede una spiegazione per controllare il modello, la si chiede per imparare qualcosa dal modello: se ha capito qualcosa che noi non sappiamo, quel qualcosa è un’ipotesi da andare a verificare in laboratorio. Il modello come microscopio, non solo come macchina che dà responsi.
Obblighi normativi. Dal credito all’assicurazione, sempre più leggi chiedono che una decisione presa da un programma su una persona sia, in qualche misura, spiegabile e contestabile.
C’è un punto sottile che lega tutto: la stessa decisione richiede spiegazioni diverse a seconda di chi la riceve.
Chiedi «perché questo prestito è stato rifiutato?» a tre persone diverse e ti aspetti tre risposte diverse. Al cliente serve sapere che cosa può fare: «il reddito dichiarato è troppo basso rispetto alla rata; con una rata inferiore la domanda passerebbe». All’ingegnere che ha costruito il modello serve sapere quali colonne pesano e se ce n’è una sospetta, cioè se in questa tabella esiste l’equivalente della neve. All’ufficio pubblico che vigila sulle banche, il regolatore, serve la garanzia che il sistema non discrimini e che chi si vede dire di no possa protestare con qualche argomento in mano. Una sola frase non può accontentarli tutti: la spiegazione «buona» dipende da a chi parli e a cosa gli serve.
E come si fa a sapere se una spiegazione ha funzionato? Il modo più solido costa caro: la si dà all’impiegata allo sportello, sulle pratiche vere che ha sul tavolo, e si guarda se decide meglio di prima. Quando quell’impiegata non ce l’hai, scendi di un gradino e la stessa spiegazione la fai leggere a persone qualunque, su un caso inventato più semplice, almeno per vedere se si capisce. E quando non hai nemmeno loro, resta un ripiego: misurare una proprietà della spiegazione stessa, per esempio quanto è corta, sperando che corta voglia dire chiara. Quel gradino è il più debole di tutti, perché non c’è più nessuno da convincere.
Doshi-Velez e Kim [DVK17] insistono su questo: l’interpretabilità non è una proprietà monolitica del modello, ma è relativa a un compito a valle e a un destinatario. Ne deriva la loro tassonomia della valutazione delle spiegazioni, su tre livelli di rigore decrescente: application-grounded (esperti reali sul compito reale; un medico che usa la spiegazione in corsia), human-grounded (persone non esperte su compiti semplificati, per esperimenti controllati), functionally-grounded (nessun umano, ma una definizione formale di interpretabilità come proxy, per esempio la profondità di un albero). La lezione è che «spiegabile» senza specificare per chi e per fare cosa è un aggettivo vuoto: la stessa uscita del modello va tradotta in linguaggi diversi per lo sviluppatore, l’utente finale e il regolatore.
Che forma debba avere una spiegazione per chi la riceve lo dicono anche le scienze sociali. Tim Miller [Mil19] ha passato in rassegna quello che la filosofia, la psicologia e le scienze cognitive sanno su come le persone chiedono e danno spiegazioni, e ne ha tratto quattro fatti che chi costruisce spiegazioni automatiche tende a ignorare.
Chi chiede «perché mi hanno rifiutato il prestito?» di solito intende un’altra domanda: perché a me no, quando al mio collega, che guadagna come me, sì? Anzitutto, quindi, una spiegazione è un confronto fra quello che è successo e quello che ci si aspettava, e un elenco di tutte le colonne con il loro peso non risponde a nessun confronto. Poi è una scelta: delle mille cause di una decisione le persone ne vogliono una o due, e le scelgono con preferenze prevedibili, per esempio per le cause insolite rispetto a quelle ordinarie. Le probabilità, poi, contano, ma convincono meno di una causa: «nove clienti su dieci come te non restituiscono il prestito» spiega meno di «la rata supera metà del tuo reddito». E infine una spiegazione è un pezzo di conversazione: si adatta a quello che chi ascolta sa già, e se non basta si fa un’altra domanda.
Tutto questo dice che cosa le persone trovano soddisfacente, non che cosa sia vero del modello: una spiegazione può avere tutte e quattro le qualità ed essere falsa.
Miller [Mil19] riassume la letteratura in quattro risultati. Le spiegazioni sono contrastive, nel senso della filosofia della spiegazione e non dell’apprendimento contrastivo: la domanda non è «perché \(P\)?» ma «perché \(P\) invece di \(Q\)?», dove \(Q\), il foil nella terminologia di Lipton, è spesso implicito, e la risposta cita una differenza causale fra la storia di \(P\) e quella di non-\(Q\). Sono selezionate: le persone scelgono una o due cause fra molte, con distorsioni documentate (per esempio a favore delle cause anomale). Le probabilità contano, ma riferirsi a probabilità o a regolarità statistiche spiega meno che riferirsi a cause, e una generalizzazione statistica senza un meccanismo causale che la sostenga soddisfa poco. E sono sociali: un trasferimento di conoscenza dentro una conversazione, calibrato su quello che chi spiega crede che l’altro sappia. Ne discendono requisiti per i metodi: rispondere a domande contrastive, come fanno le spiegazioni controfattuali delle spiegazioni locali, scegliere poche cause invece di distribuire il merito su tutte, e permettere domande di seguito. Il limite dell’argomento è che descrive che cosa soddisfa chi riceve la spiegazione, non che cosa è fedele al modello: le due proprietà sono indipendenti, ed è il tema della sezione «Una spiegazione può convincere ed essere falsa».
Una mappa delle spiegazioni#
I metodi per spiegare un modello sono decine, e presi in blocco sembrano un elenco senza capo né coda. Tre domande li mettono in ordine, e ci accompagneranno per tutto il capitolo. Sono quasi indipendenti l’una dall’altra: l’unico legame è che un modello che si legge da sé si legge, per costruzione, con un attrezzo fatto per quel tipo di modello.
A ogni metodo di spiegazione si fanno tre domande.
Il modello si legge da sé, o va spiegato dopo? Alcuni modelli decidono con una catena di domande sì/no («il reddito supera i 30 000? se sì, l’età supera i 40? se no, rifiuta»). Disegnato, un modello così si biforca a ogni domanda, ed è l’albero di decisione già incontrato: leggerlo è come leggere una ricetta, e diciamo che è trasparente. Un modello con milioni di numeri dentro no: lì serve uno strumento esterno che lo interroghi dopo che ha finito di imparare, e una spiegazione ottenuta così si chiama post-hoc, che in latino vuol dire «dopo il fatto».
Vuoi capire tutto il modello, o una singola decisione? «In generale questo modello dà molto peso al reddito» riguarda il modello nel suo insieme (spiegazione globale). «Questo prestito è stato rifiutato per via della rata troppo alta» riguarda una risposta sola (spiegazione locale). Del modello intero si può non venire a capo, e riuscire benissimo a spiegare la pratica di un cliente solo.
Lo strumento funziona solo per un tipo di modello, o per qualunque modello? Alcuni metodi hanno bisogno di sapere com’è fatto il modello dentro, e valgono solo per quel tipo lì. Altri non lo aprono nemmeno: gli passano un caso, si prendono la risposta, e ricominciano con un altro caso, cento o mille volte, finché dalle risposte si intravede una regola. Questi ultimi funzionano con qualunque cosa, e si chiamano agnostici: la parola, presa a prestito dalla filosofia, qui vuol dire soltanto «che non si pronuncia su com’è fatto il modello». Il prezzo lo pagano in tentativi, perché quello che gli altri leggono dentro al modello loro lo devono ricavare a furia di domande.
Ogni tecnica del capitolo si colloca rispondendo a tutte e tre.
Seguendo l’organizzazione di Molnar [Mol22], distinguiamo lungo tre assi.
Intrinseca vs post-hoc. L’interpretabilità intrinseca è una proprietà strutturale del modello, vincolato a priori a essere leggibile: regressione lineare/logistica, alberi poco profondi, sistemi a regole. L’interpretabilità post-hoc si applica dopo l’addestramento a un modello già dato, senza alterarne l’architettura (per esempio calcolando importanze delle feature o surrogati locali).
Globale vs locale. Una spiegazione globale descrive il comportamento del modello sull’intero dominio: quali feature contano in media, che forma ha la dipendenza. Una spiegazione locale riguarda una singola predizione \(f(\mathbf{x}_0)\): perché questo input ha prodotto questa uscita. I due livelli richiedono metodi diversi; un modello con superficie decisionale complessa può essere globalmente incomprensibile ma localmente approssimabile.
Model-specific vs model-agnostic. Un metodo specifico sfrutta la struttura interna di una classe di modelli (i coefficienti di un GLM, i gradienti di una rete). Un metodo agnostico accede solo alla funzione input→output \(f\) e resta valido per qualunque modello, al costo di stimare il comportamento per campionamento anziché leggerlo dai parametri.
I tre assi sono largamente indipendenti (fa eccezione l’interpretabilità intrinseca, che per definizione è sempre specifica del modello [Mol22]). A mostrarlo serve un esempio che li separi, perché i primi due che vengono in mente non lo fanno: LIME, che vedremo, è post-hoc, locale e agnostico, mentre i coefficienti di una regressione lineare sono intrinseci, globali e specifici, cioè ai due capi di tutti e tre gli assi. L’esempio che separa è la permutation importance della sezione su alberi e metodi ensemble, che mescola a caso una colonna e guarda di quanto il modello peggiora: post-hoc come LIME, agnostica come LIME, e però globale, perché quel che restituisce vale su tutti gli esempi insieme e non su una risposta sola.
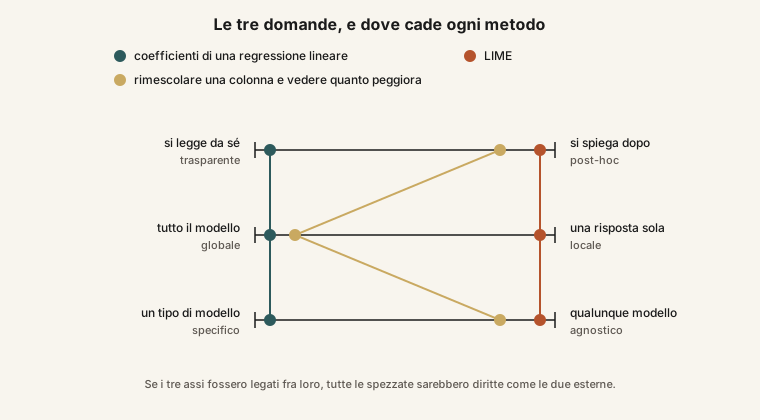
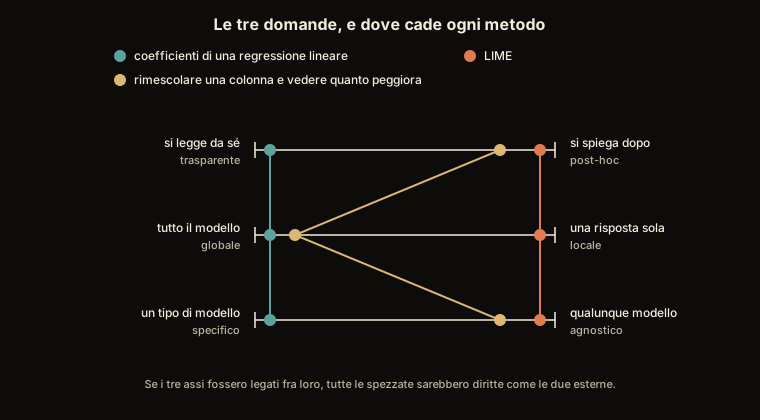
Fig. 37.1 Le tre domande in fila, con tre metodi appoggiati sopra: ogni metodo ha il suo colore, e una linea a segmenti unisce le sue tre risposte. Che le tre scelte si facciano davvero una per una lo dice la linea di mezzo, la sola che cambia lato. È quella dell’importanza per rimescolamento, che mescola a caso i valori di una colonna e guarda quanto il modello peggiora: si fa a modello già addestrato e va bene su qualunque modello, ma quello che ne esce riguarda il modello intero e non una risposta sola.#
Le tre domande, e la Fig. 37.1 con loro, dicono come lavora un metodo, non che cosa restituisce. E qui c’è una trappola, perché sotto la parola «spiegazione» stanno oggetti di forma diversissima:
una classifica delle colonne, valida per tutti gli esempi insieme: «in questo modello il reddito conta più dell’età, e il colore preferito non conta niente» (è l’importanza delle feature);
un conto per un caso solo, che è un’altra cosa: non l’ordine delle colonne, ma di quanto ciascuna ha spinto questa risposta rispetto a una risposta di riferimento, per esempio quella che il modello dà in media. In alcuni metodi le quote sommano esattamente alla distanza fra le due risposte, senza avanzi (è il caso dei valori di Shapley); in altri il conto torna solo in parte;
una regola scritta: «finché il reddito supera 30 000 e non ci sono ritardi di pagamento, la risposta è sì» (un anchor);
un altro caso, quasi identico, in cui la risposta cambia: «con 6 000 euro di reddito in più sarebbe stato un sì» (un controfattuale);
una macchia colorata sopra una fotografia, come quella che ha smascherato la neve (una mappa di salienza, o di attribuzione);
un pezzo del modello indicato col dito: la soglia su cui un albero si biforca, il gruppetto di neuroni che insieme fanno una cosa riconoscibile. È la sola delle sei che si legge dentro il modello invece di ricavarla dalle sue risposte, e per questo vale soltanto per il tipo di modello che si sta aprendo, mai per uno qualsiasi [Mol22]. È la forma dei modelli trasparenti e, dentro le reti, dell’interpretabilità meccanicistica della sezione su attribuzione e meccanicistica.
Sei cose che non si assomigliano per niente, e la prima e la seconda si somigliano solo in apparenza: una classifica non ti dice niente sul tuo caso, e un conto sul tuo caso non è una classifica valida per tutti. Quando una sezione dice «spiegazione», la prima domanda utile è quale delle sei.
C’è poi una quarta domanda, che non riguarda il funzionamento di un metodo ma decide quale risposta sia quella giusta: si vuole spiegare il modello, o il mondo? Sembra la stessa cosa e non lo è, e su un caso si vede.
Mettiamo che nella tabella ci siano due colonne che dicono quasi la stessa cosa, due colonne gemelle: lo stipendio del mese e il reddito dichiarato in un anno. Chi ha l’uno alto ha alto anche l’altro, quindi al modello ne basta una, e mettiamo che abbia scelto lo stipendio e ignorato il reddito annuo. Adesso chiediamoci quanto vale ciascuna delle due colonne, e notiamo che ci sono due domande diverse, non una.
«Su che cosa si appoggia questo programma?» Risposta: tutto sullo stipendio, zero sul reddito annuo. È la verità sul programma: se cancelli la colonna del reddito annuo, non cambia niente.
«Che cosa ci dice il dato?» Risposta: metà e metà. Le due colonne portano la stessa informazione, il modello ne ha scelta una per caso, e se lo si riaddestrasse domani potrebbe scegliere l’altra. Non c’è nessuna ragione per dare più credito a una che all’altra, quindi si divide in parti uguali.
Nessuna delle due risposte è sbagliata: rispondono a domande diverse, e chi usa un metodo senza sapere a quale delle due sta rispondendo si prende il numero per quello che non è. Chi cerca un difetto nel modello vuole la prima. Chi cerca una causa nel mondo vorrebbe la seconda, e nemmeno quella gliela darà: un modello ha visto solo cose che vanno insieme (si dice che sono correlate), non ha mai fatto un esperimento, e due cose che vanno insieme non sono per forza l’una la causa dell’altra. Questo bivio tornerà più volte, ogni volta che due metodi entrambi ragionevoli daranno due numeri diversi per lo stesso caso.
Un modello che si spiega da sé#
Un modello che si legge da sé si capisce meglio in un caso concreto. Della prima delle tre domande abbiamo detto che alcuni modelli si leggono da sé e altri no; ecco che aspetto ha un modello del primo tipo. Ricordiamo il nome che gli diamo: trasparente, e nel resto del capitolo si dirà anche che è interpretabile in modo intrinseco, che è la stessa cosa detta col termine di mestiere.
L’esempio più pulito è l’albero di decisione già incontrato, tenuto basso, con poche domande, e costruito davvero con qualche riga di codice.
I dati sono un classico, l’iris: 150 fiori di iris di tre specie diverse,
ciascuno descritto da quattro misure in centimetri (lunghezza e larghezza del
petalo, e le stesse due del sepalo, che è la fogliolina verde che sta sotto al
fiore). Il compito è indovinare la specie a partire dalle quattro misure.
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier, export_text

# Un modello intrinsecamente interpretabile: un albero volutamente basso
iris = load_iris()
X, y = iris.data, iris.target
albero = DecisionTreeClassifier(max_depth=2, random_state=0)
albero.fit(X, y)

# Tutta la "logica" del modello è leggibile come una ricetta di if-then
print(export_text(albero, feature_names=list(iris.feature_names)))
|--- petal width (cm) <= 0.80
|   |--- class: 0
|--- petal width (cm) >  0.80
|   |--- petal width (cm) <= 1.75
|   |   |--- class: 1
|   |--- petal width (cm) >  1.75
|   |   |--- class: 2
Le tre righe che cominciano con class sono le tre specie, numerate da zero
come si usa in programmazione. Il resto sono tre regole annidate su una misura
sola, la larghezza del petalo: fino a 0,80 cm, prima specie; fra 0,80 e 1,75,
seconda; oltre 1,75, terza. Nessuno strumento esterno, nessuna spiegazione
aggiunta dopo: il modello è la propria spiegazione, e sta in sette righe.
Adesso il confronto. Al posto di un albero solo se ne possono far crescere centinaia, tutti un po’ diversi fra loro, e far votare le loro risposte: si chiama foresta casuale, ed è il metodo visto nella sezione su alberi e metodi ensemble. Per misurare chi indovina di più si fa come sempre: si dividono i 150 fiori in dieci gruppi, si addestra il modello su nove e lo si interroga sul decimo, e si ripete dieci volte cambiando ogni volta il gruppo tenuto da parte, così che ogni fiore prima o poi faccia da esame.
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

# dieci gruppi: nove per imparare, uno per l'esame, e si gira dieci volte
albero_alto = DecisionTreeClassifier(max_depth=3, random_state=0)
foresta = RandomForestClassifier(n_estimators=300, random_state=0)
for nome, m in [("alberello", albero), ("alberello più alto", albero_alto),
                ("foresta casuale", foresta)]:
    giusti = cross_val_score(m, X, y, cv=10).mean()
    print(f"{nome:18} {giusti:.1%}, "
          f"cioè {round(giusti * len(y))} fiori su {len(y)}")
alberello          94.7%, cioè 142 fiori su 150
alberello più alto 96.0%, cioè 144 fiori su 150
foresta casuale    96.0%, cioè 144 fiori su 150
Una foresta mette ai voti molti alberi cresciuti su campioni diversi, e il voto sbaglia meno del singolo albero quando gli errori dei singoli non vanno tutti nella stessa direzione. Qui la foresta indovina il 96,0% contro il 94,7% dell’alberello, ma su 150 fiori sono due fiori di differenza, troppo pochi per dire che sia davvero più brava. In cambio, la logica della foresta non si stampa più, perché sono centinaia di ricette che votano invece di una sola. I metodi del capitolo servono quando questo scambio c’è davvero, cioè quando il modello che non si legge indovina parecchio di più di quello che si legge.
E i due fiori, poi, misurano il tetto che all’albero abbiamo messo noi per farlo stare in sette righe, non il prezzo della leggibilità. Concedendogli una domanda in più, un albero di profondità tre, che si stampa ancora tutto in una schermata, indovina gli stessi 144 fiori della foresta. Su questi fiori lo scambio non c’è.
Una spiegazione può convincere ed essere falsa#
C’è una trappola, e i ricercatori ci sono caduti più di una volta. Una spiegazione ricavata dopo, a decisione presa, descrive dall’esterno il calcolo che il modello ha fatto, e una descrizione può essere convincente e sbagliata insieme.
Un telecronista spiega perché un calciatore ha tirato in quel modo: «ha visto il portiere spostarsi». Suona sensato, sta guardando la stessa partita che guardi tu, ma non è stato nella testa del calciatore, che magari è solo scivolato. La spiegazione è credibile e falsa insieme, e il telecronista non sta mentendo: sta indovinando dall’esterno, ed è tutto quello che può fare.
E anche quando ci prende, ci prende su quel tiro lì. Per raccontarlo si è fatto in testa un calciatore semplificato, che in quei tre secondi si muove come quello vero; sul rigore all’ottantesimo lo stesso calciatore immaginario dirà una sciocchezza. Aver spiegato bene un’azione non vuol dire aver capito il giocatore.
Uno strumento che spiega un modello dall’esterno è nella stessa posizione, che si costruisca una copia semplificata o che si limiti a interrogarlo caso per caso. Può produrre una motivazione che a noi sembra ragionevole e che non corrisponde a come il modello ha davvero deciso. Chiamiamo fedeltà quanto la spiegazione aderisce al vero funzionamento del modello, e plausibilità quanto ci convince. Sono due cose diverse, e la seconda è pericolosa proprio quando non c’è la prima: una spiegazione bella e infedele ci fa fidare di un modello che non lo merita.
E il guaio è che a occhio non si distinguono, perché una spiegazione che convince e una spiegazione vera si presentano allo stesso identico modo. Come si smaschera una spiegazione infedele? Provando a farla fallire: si cambia qualcosa nel modello e si guarda se la spiegazione cambia di conseguenza. Se non cambia, non stava parlando del modello. È esattamente l’esperimento che faremo nell’ultima sezione del capitolo, quella dentro le reti profonde, e che boccerà parecchi metodi in uso.
Una famiglia importante di spiegazioni post-hoc costruisce un modello surrogato \(g\), interpretabile, che approssima la scatola nera \(f\) in un intorno del punto di interesse. La sua qualità si misura con la fedeltà locale, cioè quanto \(g\) e \(f\) concordano sui punti \(\mathbf{z}\) vicini a \(\mathbf{x}_0\). La si quantifica per il suo rovescio, misurando quanto i due discordano:
dove \(\pi_{\mathbf{x}_0}\) è un peso di prossimità, grande sui punti \(\mathbf{z}\) vicini a \(\mathbf{x}_0\) e quasi nullo su quelli lontani; le \(\mathbf{z}\) sono perturbazioni estratte da una distribuzione di campionamento che sceglie chi usa il metodo (in LIME, sui dati in tabella, quella dei dati di addestramento, sicché la località la porta soltanto \(\pi_{\mathbf{x}_0}\)); e \(\ell\) è una loss adatta al tipo di uscita: l’indicatrice di disaccordo per etichette discrete, uno scarto quadratico per probabilità o punteggi continui. La quantità cresce quando la fedeltà cala: tanto più è piccola, tanto più \(g\) è fedele a \(f\) in quell’intorno (all’estremo, vale zero se il surrogato riproduce esattamente la scatola nera sui punti campionati). Una fedeltà alta sull’intorno non garantisce nulla globalmente, ed è del tutto scorrelata dalla plausibilità: quanto la spiegazione appare sensata a un umano. Nulla vieta a un surrogato di essere plausibile e infedele, o fedele e controintuitivo. È il difetto costitutivo dei metodi a surrogato: approssimano, e un’approssimazione può ingannare. Non tutto il post-hoc è fatto così (l’importanza per permutazione, i controfattuali e le attribuzioni che vedremo interrogano \(f\) direttamente, senza copie di mezzo), ma la distinzione tra plausibilità e fedeltà vale per ogni spiegazione, comunque prodotta.
Su questo punto la letteratura è divisa, e per capire perché serve prima la convinzione che il dibattito mette in discussione: che chiarezza e bravura si paghino l’una con l’altra, cioè che un modello leggibile sia per forza più scarso di uno oscuro, e che quindi l’oscurità sia un prezzo che si paga volentieri per avere ragione più spesso. La bravura qui si misura con l’accuratezza, la quota di risposte giuste, e chiamiamo quella convinzione il presunto scambio fra accuratezza e chiarezza; sui fiori di poco fa non lo abbiamo trovato.
Cynthia Rudin [Rud19] sostiene una tesi tagliente: per le decisioni che pesano davvero (giustizia, sanità, credito) si dovrebbe smettere di spiegare le scatole nere e usare direttamente modelli leggibili. L’argomento è duplice. Primo: una spiegazione infedele è peggio di niente, perché dà una falsa sensazione di controllo. Secondo, e più radicale: quello scambio, su molti problemi veri, semplicemente non esiste. Quando i dati stanno in una tabella e ogni colonna significa qualcosa di preciso (il reddito, l’età, la pressione arteriosa), un modello trasparente ben costruito arriva spesso dove arriva la scatola nera, e allora l’oscurità è un costo senza contropartita: si paga e non si compra niente.
Non tutti concordano, e la ragione è che non tutti i dati stanno in una tabella. Su fotografie, testi e suoni, dove le colonne di partenza sono i pixel o le lettere e presi uno per uno non significano nulla, le reti profonde restano di gran lunga le più accurate. Lì le strade sono due: spiegare la rete dopo, con i metodi dell’ultima sezione del capitolo, oppure costruirla leggibile per progetto. Rudin stessa porta l’esempio delle reti che finiscono con uno strato di prototipi, e decidono confrontando parti dell’immagine da classificare con parti di immagini viste in addestramento (la testa di questo uccello somiglia alla testa tipica di quella specie), così che la spiegazione coincida con il calcolo [Rud19]. È una strada più giovane, e la spiegazione dopo resta la più battuta.
Su una cosa, però, le due fazioni concordano, e l’hanno scritta nel 2017 due ricercatrici, Finale Doshi-Velez e Been Kim [DVK17]: una spiegazione è una cosa da misurare, non da esibire. Chi la produce deve dichiarare che cosa ha misurato e con quale esperimento, esattamente come si fa per l’accuratezza di un modello, che nessuno si sognerebbe di dichiarare senza dire su quali casi l’ha contata. Non esistono spiegazioni «gratis»: esistono spiegazioni verificate e spiegazioni che ci raccontiamo.
Resta da dire perché, sui dati in tabella, lo scambio fra accuratezza e chiarezza manchi così spesso. La ragione ha un nome preso dal cinema, effetto Rashomon, e Leo Breiman lo mise al centro di un saggio del 2001 [Bre01b].
Nel film Rashomon di Akira Kurosawa quattro testimoni raccontano lo stesso delitto, riferiscono gli stessi fatti, e ne danno quattro storie diverse. Con i dati succede qualcosa di simile: modelli diversi spiegano gli stessi esempi quasi con la stessa bravura (per dire, il 79,7% di risposte giuste l’uno e il 79,65% l’altro), e raccontano storie diverse su che cosa conta. Se il reddito dell’anno e lo stipendio del mese vanno quasi sempre insieme, un modello può appoggiarsi al reddito e un altro allo stipendio, e sbagliare quasi lo stesso numero di volte: chiedere a ciascuno quale colonna conta dà due risposte opposte, tutte e due vere per quel modello.
Da qui due conseguenze. La prima è un’avvertenza: la spiegazione di un modello dice come ragiona quel modello, non come sono fatti i dati. Per dire quanto una colonna conta davvero bisogna guardare tutto il gruppo dei modelli quasi migliori, e allora la risposta è un intervallo: per il reddito, da niente a molto. La seconda è l’argomento di Cynthia Rudin: se i modelli quasi migliori sono tanti, è probabile che fra loro ce ne sia uno semplice da leggere, e conviene cercare quello invece di spiegare il più complicato. Probabile, non garantito: quando i modelli buoni sono pochi, quello semplice può mancare.
Breiman chiama effetto Rashomon la molteplicità dei buoni modelli: nel suo esempio, fra i circa \(140\,000\) sottoinsiemi di cinque variabili su trenta di una regressione lineare, ce ne sono di solito parecchi con la somma dei quadrati dei residui entro l’uno per cento della minima, e ciascuno racconta una storia diversa su quali variabili contano [Bre01b]. In forma generale, dati uno spazio di ipotesi \(\mathcal{F}\), una perdita empirica \(\hat{\mathcal{L}}\) e il suo minimizzatore \(\hat{f}\), il Rashomon set con una soglia \(\theta\) è
La definizione, in questa forma, è di Semenova, Rudin e Parr [SRP22], che ne misurano anche la taglia con il Rashomon ratio, la frazione dello spazio (in volume, sotto un prior uniforme) che cade nel set, e sostengono che quando il rapporto è grande è probabile che il set contenga modelli quasi ottimi di una classe più semplice: è la ragione tecnica della tesi di Rudin [Rud19], e resta un argomento probabilistico, non una garanzia. L’altra faccia riguarda l’importanza: Fisher, Rudin e Dominici [FRD19] definiscono la model class reliance come l’intervallo fra il minimo e il massimo della model reliance di una variabile sui modelli del Rashomon set (che definiscono rispetto a un modello di riferimento), e mostrano come stimarlo. L’importanza calcolata su un solo modello è un punto di quell’intervallo, e con variabili correlate l’intervallo può andare da zero a valori elevati. Rapporto e intervallo dipendono entrambi dalla classe \(\mathcal{F}\) e dalla soglia scelte.
Il blocco costruisce dati in cui la risposta dipende dal reddito e dall’età, con uno stipendio mensile che è quasi una copia del reddito annuo, e confronta tre modelli: due regressioni logistiche (il modello che somma punti per colonna e ne fa una probabilità), una sul reddito e una sullo stipendio, e un boosting (una somma di molti alberi piccoli) su tutte e tre le colonne. Per ciascuno stampa l’accuratezza su dati nuovi e l’importanza di reddito e stipendio, misurata come calo di accuratezza rimescolando la colonna, in media su venti rimescolamenti. In fondo regola il boosting, scegliendo fra sei combinazioni di profondità degli alberi e passo di apprendimento quella che va meglio con la validazione incrociata sui soli dati di addestramento, e conta su quanti casi di prova il boosting regolato e la prima logistica non sono d’accordo.
import numpy as np
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score

rng = np.random.default_rng(0)
n = 4000
reddito = rng.normal(size=n)
stipendio = reddito + 0.1 * rng.normal(size=n)  # quasi una copia del reddito
eta = rng.normal(size=n)
y = (reddito + eta + rng.normal(size=n) > 0).astype(int)
X = np.column_stack([reddito, stipendio, eta])
X_tr, X_te, y_tr, y_te = X[:2000], X[2000:], y[:2000], y[2000:]
nomi = ["reddito", "stipendio", "età"]

def importanza(modello, colonne, j, ripetizioni=20):
    """Quanto cala l'accuratezza rimescolando la colonna j, in media su più rimescolamenti
    (zero se il modello non la usa)."""
    if j not in colonne:
        return 0.0
    base, cali = modello.score(X_te[:, colonne], y_te), []
    for r in range(ripetizioni):
        A = X_te.copy()
        A[:, j] = np.random.default_rng(r).permutation(A[:, j])
        cali.append(base - modello.score(A[:, colonne], y_te))
    return float(np.mean(cali))

modelli = {"logistica su reddito ed età": (LogisticRegression(), [0, 2]),
           "logistica su stipendio ed età": (LogisticRegression(), [1, 2]),
           "boosting su tutte e tre": (GradientBoostingClassifier(random_state=0), [0, 1, 2])}
for nome, (m, colonne) in modelli.items():
    m.fit(X_tr[:, colonne], y_tr)
    imp = ", ".join(f"{nomi[j]} {importanza(m, colonne, j):.3f}" for j in (0, 1))
    print(f"{nome:30}: accuratezza {m.score(X_te[:, colonne], y_te):.4f}; "
          f"importanza {imp}")

# il boosting regolato: profondità e passo scelti con la validazione incrociata
# sui soli dati di addestramento, perché i dati di prova servono a giudicare
griglia = [(d, lr) for d in (1, 2, 3) for lr in (0.03, 0.1)]
def boosting(d, lr):
    return GradientBoostingClassifier(max_depth=d, learning_rate=lr,
                                      random_state=0)
voti = [cross_val_score(boosting(d, lr), X_tr, y_tr, cv=5).mean()
        for d, lr in griglia]
d, lr = griglia[int(np.argmax(voti))]
regolato = boosting(d, lr).fit(X_tr, y_tr)
print(f"boosting regolato (profondità {d}, passo {lr}): "
      f"accuratezza {regolato.score(X_te, y_te):.4f}")

# quanto è netta la differenza: i casi di prova su cui i due non sono d'accordo
logistica = modelli["logistica su reddito ed età"][0]
giusta_l = logistica.predict(X_te[:, [0, 2]]) == y_te
giusta_b = regolato.predict(X_te) == y_te
print(f"casi indovinati solo dalla logistica: {np.sum(giusta_l & ~giusta_b)}, "
      f"solo dal boosting regolato: {np.sum(~giusta_l & giusta_b)}")
logistica su reddito ed età   : accuratezza 0.7970; importanza reddito 0.158, stipendio 0.000
logistica su stipendio ed età : accuratezza 0.7965; importanza reddito 0.000, stipendio 0.157
boosting su tutte e tre       : accuratezza 0.7825; importanza reddito 0.126, stipendio 0.004
boosting regolato (profondità 2, passo 0.03): accuratezza 0.7855
casi indovinati solo dalla logistica: 65, solo dal boosting regolato: 42
Le due regressioni logistiche sono buone uguali (\(0{,}7970\) e \(0{,}7965\)) e raccontano storie opposte: per la prima conta il reddito e la spesa niente, per la seconda il contrario, con quasi la stessa importanza passata da una colonna all’altra (\(0{,}158\) e \(0{,}157\)). Se ci si fermasse a una sola, si direbbe che una delle due colonne è inutile; sull’insieme dei modelli buoni, l’importanza del reddito va da zero a \(0{,}158\). E il modello più complicato non fa meglio dei due semplici: \(0{,}7825\) così com’è e \(0{,}7855\) regolato, contro \(0{,}7970\) e \(0{,}7965\). Quanto sia netta la differenza lo dicono i casi in cui i modelli non sono d’accordo, perché su tutti gli altri sbagliano o indovinano insieme: su 2000 casi di prova, 65 li indovina solo la logistica e 42 solo il boosting. Basta per dire che il boosting non fa meglio; per dire di quanto faccia peggio, poco più di cento disaccordi non bastano. Su dati come questi lo scambio fra accuratezza e chiarezza non c’è.
Dai modelli trasparenti ai circuiti#
Il percorso ha tre tappe. Prima i modelli che si leggono da sé, e le misure che valgono per un modello qualsiasi preso nel suo insieme; poi le spiegazioni di una risposta sola; infine le reti profonde, guardate prima dall’esterno, pixel per pixel, e poi dall’interno.
La prima tappa riparte dai modelli trasparenti: l’albero di poco fa, e i modelli che rispondono facendo una somma, tanti punti per il reddito, tanti per l’età. Li abbiamo già incontrati nel capitolo sul Machine Learning, e qui li rileggiamo con un’altra domanda in testa, quanto sono leggibili. Vengono poi i modi di misurare su che cosa un modello qualsiasi si appoggia in media, su tutti gli esempi insieme: la classifica delle colonne, che si chiama importanza delle feature, e le curve che mostrano come agisce una colonna, oltre a quanto. Chiude un modo di spiegare un’intera raccolta di dati con pochi esempi scelti bene, i prototipi, accompagnati dai casi che quegli esempi rappresentano male.
La seconda tappa riguarda una risposta sola, ed è quella delle spiegazioni locali. Il primo metodo costruisce, attorno al caso da spiegare e solo lì, un modellino semplice che imita quello vero, un surrogato locale: si chiama LIME, ed è quello che disegnò le macchie sulla neve. Il secondo spartisce fra le colonne il merito di una risposta, con una regola che viene da un problema del 1953: come dividere in modo equo il guadagno di un’impresa fra i soci che ci hanno lavorato. Quelle quote sono i valori di Shapley, e il modo di calcolarle in fretta si chiama SHAP. Il terzo risponde alla domanda più pratica di tutte, «che cosa sarebbe dovuto essere diverso perché la risposta cambiasse?», e sono le spiegazioni controfattuali. La stessa domanda locale ammette poi altre due risposte: una regola che dice fin dove la risposta resta quella, e ciò che manca e che, se ci fosse, la cambierebbe.
La terza tappa entra nelle reti profonde. Lì la domanda diventa quanto ogni pezzo dell’ingresso, ogni singolo pixel, ha contribuito a una risposta: quella quota di merito si chiama attribuzione, e la cartina che la disegna sopra la foto si chiama mappa di salienza. I metodi che la disegnano sono di tre famiglie (chi misura una pendenza, chi divide il risultato all’indietro, chi toglie un pezzo e guarda che cosa cambia), e non tutti superano le prove con cui si controlla se una mappa descrive davvero il modello. La stessa domanda vale per i pesi di attenzione della sezione sul meccanismo di attenzione: sembrano una spiegazione già pronta, e sono un indizio. Poi si guarda dentro la rete: a che cosa risponde ciascun filtro, quale informazione è scritta a ciascun piano, e infine il tentativo più ambizioso e più giovane, quello di smontare una rete pezzo per pezzo come un ingegnere apre un chip per capire che cosa fa ciascun componente. Si chiama interpretabilità meccanicistica, e i pezzi che prova a isolare, piccoli gruppi di neuroni che insieme svolgono un compito riconoscibile, si chiamano circuiti.
Un filo, sopra a tutto, tiene insieme il capitolo con quello sull’AI responsabile: aprire la scatola nera non è un vezzo accademico, ma il primo passo per costruire sistemi di cui potersi fidare, e da poter contestare quando sbagliano. Il rilevatore di lupi era stato truccato apposta, per dimostrare quanto è facile non accorgersene. I modelli addestrati su dati veri imparano scorciatoie dello stesso tipo senza che nessuno le costruisca, e un’accuratezza alta sui dati di prova non le rivela: le scoprono le prove mirate, su dati raccolti altrove o divisi per gruppi di persone, e lo sguardo su che cosa il modello si appoggia.
Da ricordare
Un modello può indovinare tantissimo e farlo per la ragione sbagliata: il cavallo Hans leggeva i movimenti di chi chiedeva, il riconoscitore di lupi guardava la neve. Contare quante volte ha ragione non lo smaschera; guardare su che cosa si appoggia sì. Questa è l’interpretabilità.
Dentro un modello non c’è un programma da leggere: ci sono milioni di numeri che nessuno ha scritto a mano e che il modello si è ricavato dagli esempi.
Si chiede una spiegazione per fidarsi, per trovare i difetti, per equità, per scoprire cose nuove e perché la legge lo chiede. E la spiegazione buona dipende da chi la riceve: al cliente serve sapere cosa cambiare, all’ingegnere quali colonne pesano, all’ufficio che vigila che il sistema non discrimini. Chi chiede «perché?» vuole un confronto («perché a me no e a lui sì?»), una o due cause e non tutte, e la possibilità di chiedere ancora.
Tre domande ordinano tutti i metodi del capitolo: il modello si legge da sé o va interrogato dopo? vuoi capire il modello intero o una risposta sola? lo strumento serve un solo tipo di modello o va bene per qualunque modello? E una quarta, che decide chi ha ragione quando due metodi discordano: vuoi spiegare il modello o il mondo? Se due colonne dicono quasi la stessa cosa e il modello ne usa una sola, la prima domanda dà tutto a quella e zero all’altra, la seconda divide a metà. Nessuna delle due sbaglia: sono domande diverse.
Una spiegazione può essere convincente e falsa insieme (il telecronista che spiega il tiro e non è mai stato nella testa del calciatore). «Mi convince» e «è vera» sono due cose diverse, e la prima senza la seconda è pericolosa: ci fa fidare di un modello che non lo merita. Per distinguerle non basta guardare: bisogna provare a far fallire la spiegazione.
Il dibattito: si crede che un modello chiaro sia per forza più scarso di uno oscuro, ma sui dati a righe e colonne quello scambio spesso non c’è (sui fiori dell’esempio un albero con una domanda in più arriva dove arriva la foresta, e resta leggibile). Per le decisioni che pesano davvero (giustizia, sanità, credito) Cynthia Rudin dice quindi che è meglio usare un modello trasparente invece di appiccicare una spiegazione a una scatola nera. Su foto, testo e suoni le reti profonde restano le più brave, e si possono spiegare dopo oppure costruire leggibili per progetto; la spiegazione dopo è oggi la strada più battuta.
L’effetto Rashomon: modelli quasi ugualmente bravi possono appoggiarsi a colonne diverse, quindi la spiegazione di un modello racconta quel modello, e l’importanza vera di una colonna è un intervallo sui modelli buoni. Se i modelli buoni sono tanti, è probabile che uno sia semplice da leggere.
Da ricordare
Un modello accurato può esserlo per la ragione sbagliata (effetto Clever Hans, la neve al posto del lupo): l’accuratezza aggregata non smaschera le correlazioni spurie (shortcut learning); le smascherano le prove fuori distribuzione e l’interpretabilità.
Si spiega per fiducia, debug, equità, scoperta scientifica e obblighi normativi (GDPR, letto dalla Corte di giustizia nel 2025 come diritto a conoscere procedura e principi applicati al proprio caso; art. 86 dell’AI Act per i sistemi ad alto rischio); la spiegazione «buona» dipende da a chi serve: sviluppatore, utente finale, regolatore vogliono cose diverse. Le spiegazioni umane (Miller) sono contrastive, selezionate, causali più che probabilistiche, e sociali.
Tre assi ordinano il campo: intrinseca vs post-hoc, globale vs locale, model-specific vs model-agnostic. Sono largamente indipendenti, salvo che l’intrinseca è sempre specifica del modello. A essi si affianca una domanda che non è un asse ma decide quale risposta sia corretta: si sta spiegando il modello o il fenomeno? (Due colonne quasi ridondanti di cui il modello ne usa una: la prima domanda attribuisce tutto a quella usata, la seconda ripartisce.)
Plausibilità ≠ fedeltà: una spiegazione post-hoc può convincere senza aderire a come il modello decide davvero. È il rischio di ogni racconto costruito dopo, a decisione presa, e cresce quando a essere letto non è il modello vero ma una sua copia semplificata.
Il dibattito: Rudin invita a usare modelli interpretabili per le decisioni ad alto rischio invece di spiegare scatole nere; sui dati non strutturati il post-hoc è la via più usata, accanto alle reti interpretabili per costruzione (lo strato di prototipi). In ogni caso, spiegazioni valutate con rigore (Doshi-Velez & Kim), non rassicurazioni qualitative.
Effetto Rashomon (Breiman): il Rashomon set dei modelli entro una soglia dall’ottimo è spesso grande, e allora contiene probabilmente modelli semplici (Semenova, Rudin, Parr); l’importanza di una variabile va letta come model class reliance, l’intervallo sul set (Fisher, Rudin, Dominici).