


Introduzione#
Joseph Weizenbaum era un informatico tedesco emigrato negli Stati Uniti e professore al MIT. Nel 1966 presentò al mondo ELIZA, il capostipite dei chatbot: un programma con cui si poteva conversare per iscritto, digitando una frase e leggendo la risposta. L’articolo che lo descrive si apre così [Wei66]:
Si dice che spiegare sia dissolvere l’incanto.[1]
Nei programmi che sembrano intelligenti, osservava, questa massima si compie alla perfezione: finché il meccanismo resta nascosto la macchina appare prodigiosa; appena qualcuno lo spiega, l’incanto si sgretola. E il meccanismo di ELIZA sta in poche righe. Il programma vero e proprio non imitava nessuno: era un motore che riconosceva schemi, cioè pezzi di frase fatti a stampo, del tipo «mi sento ___» o «mia madre ___». La parte da recitare gliela assegnava un copione, un foglio di regole scritto a parte che si poteva cambiare senza toccare il programma. Il copione più celebre si chiamava DOCTOR e gli faceva sostenere la conversazione di uno psicoterapeuta: riconosceva nella frase dell’utente uno schema noto e gliela rigirava addosso. «Mi sento infelice» diventava «pensa che venire qui la aiuterà a non sentirsi infelice?», e alla parola «madre» rispondeva «mi parli della sua famiglia». Nessuna comprensione, e come memoria soltanto qualche frase detta prima dall’utente, tenuta da parte e ripescata quando nella frase nuova non c’era nessuno schema a cui agganciarsi.
Quella separazione fra il motore e il foglio delle regole è il primo passo della strada che percorreremo. Nel 1966 le regole le scriveva ancora una persona, a mano, una per una; ma stavano già fuori dal programma, come un testo che il programma legge. I capitoli che seguono raccontano che cosa succede quando quel foglio non lo scrive più nessuno.
Eppure Weizenbaum voleva dimostrare esattamente il contrario di quello che ottenne: voleva far vedere quanto fosse superficiale la comunicazione fra uomo e macchina. Rimase sgomento davanti al numero di persone che al suo programma attribuivano sentimenti umani. La sua stessa segretaria, che l’aveva visto lavorare al programma per mesi e sapeva benissimo che era soltanto un programma, gli chiese di uscire dalla stanza per poterci parlare in privato [Wei76]. Ma siamo sicuri che quella da lui creata sia soltanto una lista di istruzioni? O c’è qualcosa di più? Se è un semplice programma, perché attribuirgli una parola così ricca di significato come l’intelligenza?
E poi: che cos’è, esattamente, questa intelligenza artificiale? In inglese si dice Artificial Intelligence, e la sigla AI è quella che si legge dappertutto. Ogni anno la si perfeziona, e ogni anno sembra sfuggire un po’ di più a una definizione precisa.
Su ELIZA la risposta è breve e deludente: no, niente di più, era davvero soltanto una lista di istruzioni. Per certi altri programmi non basta, e che cosa sia l’intelligenza artificiale ha bisogno di più spazio: ci arriveremo dopo aver visto che cosa distingue un programma scritto riga per riga da uno che le sue regole se le trova da solo.
Le origini dell’intelligenza artificiale#
L’idea di costruire qualcosa che somigli a noi è vecchia quanto il pensiero. La scienza che ci prova davvero, invece, è giovane: nasce nel decennio successivo alla Seconda Guerra Mondiale, quando per la prima volta ci sono delle macchine su cui provare.
Nella vita di tutti i giorni è entrata due volte. Negli anni Dieci (il decennio 2010–2019) ci è entrata senza farsi notare, dentro il traduttore automatico, i suggerimenti di un negozio online, il riconoscimento dei volti nelle fotografie: la usavano tutti e quasi nessuno la chiamava per nome. Dal novembre 2022, con ChatGPT, è diventata invece qualcosa con cui si parla apposta, e in pochi mesi il nome lo conosceva chiunque. I due momenti vanno tenuti separati. Il salto che il pubblico ha percepito alla fine del 2022 era cominciato cinque anni prima, in un articolo del 2017 intitolato Attention Is All You Need, «l’attenzione è tutto ciò che serve» [VSP+17]. Da lì è nata la famiglia di programmi con cui oggi si conversa, e la descrive il capitolo sui Transformer. Nel 2022 l’architettura aveva già cinque anni; di nuovo c’erano l’ultimo tratto dell’addestramento, fatto con istruzioni e giudizi di persone [OWJ+22], e soprattutto il posto in cui la tecnologia si incontrava. Prima stava nascosta dentro servizi che facevano altro (traduci questa pagina, suggerisci un film), e nessuno ci parlava; da allora è diventata una casella bianca in cui si scrive, e che risponde.
Ma torniamo all’inizio, che è più indietro di quanto sembri: prima dei calcolatori c’erano stati duemila anni di filosofi e matematici che si ponevano le stesse domande [RN20].
Aristotele, nel IV secolo a.C., è il primo di cui ci sia rimasto un sistema scritto delle regole del ragionamento corretto. Si regge sui sillogismi: catene di tre frasi in cui la terza discende dalle prime due per la sola forma in cui sono scritte. L’esempio che sanno tutti (probabilmente di Sesto Empirico, non di Aristotele) è «tutti gli uomini sono mortali; Socrate è un uomo; quindi Socrate è mortale». Per tirare la conclusione non serve sapere chi fosse Socrate: basta la struttura delle prime due frasi. È questo che vuol dire ottenere le conclusioni «meccanicamente», ed è il più antico tentativo giunto fino a noi di scrivere le regole del pensiero come si scriverebbero quelle di un gioco.
Poi bisogna aspettare quasi due millenni, e arrivare al Seicento, quando compaiono le prime macchine che fanno di conto. Hobbes ipotizzò che ragionare fosse una specie di calcolo, come se dentro la testa eseguissimo addizioni e sottrazioni. Pascal costruì una di quelle macchine, la Pascalina,[2] e ne scrisse una frase che va letta per intero: la macchina aritmetica produce effetti che sembrano più vicini al pensiero di quanto lo sia tutto ciò che fanno gli animali, ma non fa niente che permetta di dire che abbia una volontà, come invece ce l’hanno gli animali. Metà elogio e metà rifiuto, nella stessa riga. Cartesio, infine, tracciò una distinzione netta fra mente e materia, sostenendo che il pensiero è fatto di una sostanza diversa dal corpo e non obbedisce alle stesse leggi. Una macchina, invece, è materia e nient’altro: se Cartesio avesse ragione, nessuna macchina potrebbe mai avere una mente. È l’obiezione con cui l’intelligenza artificiale fa i conti da quando esiste.
I filosofi hanno posto quasi tutte le domande dell’AI, ma il passaggio a una scienza vera e propria richiedeva qualcosa che i filosofi non davano. Una macchina opera su numeri e simboli, non su significati: perché un’idea le arrivi, bisogna prima ridurla a un calcolo, e Aristotele aveva scritto quali passaggi fossero leciti, non come farli fare a una macchina. Servivano strumenti che a metà del Novecento la matematica aveva già [RN20]. La logica era diventata un calcolo, con simboli e regole come l’algebra (Boole nel 1847, Frege nel 1879). La probabilità permetteva di ragionare anche quando l’informazione è incerta. E una branca nuova, la teoria del calcolo, stabiliva che cosa un procedimento meccanico sa calcolare e che cosa no: ha una sezione tutta sua, perché quei limiti riguardano anche i programmi che imparano.
Accanto a questi c’erano le discipline nate per far prendere decisioni. La ricerca operativa studia come scegliere il piano migliore quando le risorse sono poche (quali camion mandare su quali strade); la teoria del controllo come tenere un sistema sulla rotta voluta, correggendolo di continuo, ed è la matematica del termostato e del pilota automatico; la teoria dei giochi come decidere quando dall’altra parte c’è qualcuno che decide a sua volta.
Viste da vicino, queste discipline facevano in fondo la stessa cosa. Ognuna inventava un punteggio che dice come sta andando (quanto costa il giro dei camion, di quanto la temperatura si scosta da quella voluta, quanto si guadagna in una partita). Il costo e lo scarto si vogliono piccoli, il guadagno grande, ma il mestiere è lo stesso, cercare le mosse che spingono il punteggio dalla parte giusta. Quel punteggio ha un nome, ed è uno dei pochi da imparare adesso: si chiama funzione obiettivo. È a grandi linee anche lo scopo dell’AI, costruire sistemi che agiscono «nel modo migliore possibile».
L’AI, però, non è una costola della teoria del controllo: nacque anzi proprio per superarne i limiti [RN20]. Quella matematica sapeva tenere in rotta un sistema descritto da pochi numeri che cambiano nel tempo (la velocità, la temperatura, l’angolo del timone), e si fermava lì. Capire una frase, riconoscere che cosa c’è in una fotografia, decidere in che ordine fare le cose per arrivare a un obiettivo: erano problemi che si ponevano completamente fuori dal suo campo d’azione, ed è per affrontarli che nasce un campo nuovo.
Nel 1950 Alan Turing propose di sostituire la domanda «le macchine possono pensare?» con un esperimento concreto, il gioco dell’imitazione, oggi noto come test di Turing: se conversando a distanza non riesci a capire se dall’altra parte c’è una persona o un programma, la domanda di partenza si può mettere da parte [Tur50].[3]
Quel gioco misura una cosa sola: se la conversazione regge, non se dall’altra parte qualcuno ha capito. ELIZA lo mostra bene. Non comprendeva nulla, eppure bastava a far credere il contrario a chi ci parlava, ed è quello che oggi si chiama effetto ELIZA; ne riparla Dialogo e chatbot.
Il termine intelligenza artificiale compare per la prima volta nel 1955, nella proposta con cui John McCarthy, Marvin Minsky, Nathaniel Rochester e Claude Shannon chiedevano i fondi per un seminario estivo al Dartmouth College; è quel seminario, nell’estate del 1956, a essere ricordato come l’atto di nascita ufficiale della disciplina. Il mestiere della nuova disciplina è rendere automatiche attività che fino a quel momento sapeva fare soltanto una persona: riconoscere immagini, giocare a scacchi, dimostrare teoremi, guidare un’automobile. Tocca quindi, almeno in potenza, ogni attività della mente, ed è insieme uno dei campi più giovani: quando nasce, la fisica moderna ha quasi tre secoli di storia, dai Principia di Newton (1687), e i calcolatori elettronici sono in circolazione da una decina d’anni.
Fra il seminario di Dartmouth e i risultati che oggi diamo per scontati, però, non c’è una linea che sale. Ci sono due lunghi inverni (AI winters), periodi in cui le promesse non mantenute fecero tagliare i finanziamenti, e conoscerli aiuta a giudicare con calma sia l’entusiasmo sia la paura di oggi.
Il primo arriva negli anni Settanta. Le promesse del decennio precedente (una macchina che traduce, che dimostra teoremi, che vede) erano andate a scadenza senza essere mantenute, e nel 1973 un rapporto commissionato al matematico James Lighthill dallo Science Research Council britannico stroncò il campo, aprendo la strada ai primi tagli veri ai finanziamenti nel Regno Unito. Il secondo arriva a fine anni Ottanta, quando si sgonfia il mercato dei sistemi esperti: programmi che racchiudevano in migliaia di regole scritte a mano il sapere di uno specialista. Dentro il loro campo ristretto funzionavano; appena fuori si rompevano, perché ogni caso non previsto chiedeva una regola nuova. Chi ci lavorava lo chiamava il collo di bottiglia dell’acquisizione della conoscenza: il sapere c’era, nella testa degli specialisti, ma travasarlo in regole e tenerle aggiornate costava più di quanto rendesse.
Il modo di lavorare che è succeduto a questo secondo inverno ne è il rovescio esatto, e fra poco, quando parleremo di regole che nessuno scrive, si vedrà quale. Oltre ai due inverni di tutto il campo, uno tutto loro lo hanno avuto le reti neurali, che il capitolo che porta il loro nome racconta per esteso. Quell’inverno comincia nel 1969, con Perceptrons di Minsky e Papert, che dimostrava i limiti del percettrone, la versione più semplice di quelle reti [MP69], e si intreccia con l’inverno degli anni Settanta, perché i tagli seguiti al rapporto Lighthill colpirono tutto il campo. Si scioglie nel 1986, quando un articolo su Nature di David Rumelhart, Geoffrey Hinton e Ronald Williams mostra come addestrare una rete a più strati. Il metodo si chiama retropropagazione dell’errore (backpropagation): calcola, per ciascuno dei numeri regolabili della rete, di quanto cambierebbe l’errore ritoccandolo di poco, e quindi in che verso correggerlo. Paul Werbos lo aveva formulato dodici anni prima, nella sua tesi di dottorato [RHW86, Wer74].
Le regole scritte a mano, intanto, facevano cose notevoli, e non solo in laboratorio. Una delle auto che si guidavano da sole negli anni Novanta girava sulle strade italiane, su una Lancia Thema. A partire dal 1996, all’Università di Parma, un gruppo di ricercatori e ingegneri guidato da Alberto Broggi costruì ARGO. Vedeva con due telecamere in bianco e nero montate in coppia, come i nostri due occhi, e le sue decisioni le prendeva un computer di bordo del tutto ordinario per l’epoca, un Pentium 200 MMX: un processore incomparabilmente più lento di quello del telefono che oggi tieni in tasca. Sapeva sterzare da sola, restare al centro della corsia e accorgersi degli ostacoli davanti. Nel giugno 1998, nella prova «MilleMiglia in Automatico», percorse circa 2.000 km sulle autostrade italiane con lo sterzo governato dal programma per oltre il 90% del tragitto; acceleratore e freno restavano al guidatore.
ARGO non fu la prima: negli stessi anni la VaMP di Ernst Dickmanns girava sulle autostrade europee e la Navlab 5 della Carnegie Mellon University, in Pennsylvania, attraversava gli Stati Uniti. Colpisce per l’economia dei mezzi: dove la VaMP portava armadi di elettronica costruita apposta, ARGO lavorava con due telecamere in bianco e nero e un personal computer da negozio.
Dentro ARGO, però, non c’era niente che avesse imparato qualcosa. Le regole con cui riconosceva la corsia e gli ostacoli le aveva scritte a mano qualcuno che sapeva già che aspetto ha una striscia bianca su un asfalto grigio, una regola per volta.
Nel 2010 il gruppo di Broggi è riuscito a far guidare da soli dei furgoni elettrici dall’Italia alla Cina. La sfida si chiamava VIAC (VisLab Intercontinental Autonomous Challenge): quasi sedicimila chilometri da Parma a Shanghai, con due veicoli in marcia (più due di riserva) e una regola d’ingaggio che è la parte più interessante dell’impresa. I due procedevano in fila: quello di testa apriva la strada e ogni tanto un umano interveniva, per scegliere il percorso o per risolvere le situazioni che il sistema non sapeva gestire; quello dietro seguiva il primo in completa autonomia. Non sedicimila chilometri senza nessuno al volante, dunque, ma qualcosa che nel 2010 era comunque senza precedenti.
Che cos’è un algoritmo#
Fin qui abbiamo parlato di programmi e di regole scritte a mano, senza mai chiamarli con il loro nome. Un algoritmo, prima di tutto, è una ricetta: una lista finita di passi precisi, che non lasciano dubbi su che cosa fare e che, eseguiti nell’ordine giusto, portano a un risultato in un numero finito di mosse. La parola viene dal nome di al-Khwarizmi, un matematico persiano del IX secolo, ma la cosa è più antica. Uno dei primi della storia si può far risalire a Euclide, che oltre due millenni fa trovò il modo di calcolare il massimo comune divisore di due numeri: applicato a \(12\) e \(8\), per dire, restituisce \(4\). È esattamente il procedimento che proveremo a scrivere nel linguaggio Python, appena avremo finito di guardarlo da vicino.
Il massimo comune divisore (MCD) di \(12\) e \(8\) è il numero più grande che li divide entrambi senza resto. Puoi immaginarlo così: hai un pavimento rettangolare di \(12 \times 8\) mattonelle e vuoi ricoprirlo con piastrelle quadrate, tutte uguali e senza tagliarne nessuna; la piastrella più grande che funziona è quella da \(4 \times 4\). Il trucco di Euclide per trovarlo è elegante: dividi il numero grande per il piccolo e guarda il resto. \(12\) diviso \(8\) dà resto \(4\); ora ripeti con \(8\) e \(4\): resto \(0\). Appena compare il resto zero, l’ultimo numero per cui hai diviso (qui \(4\)) è il MCD. Niente elenchi di divisori, niente tentativi: due divisioni e hai finito. E se il resto viene zero già alla prima, va bene lo stesso, hai solo finito prima: \(12\) diviso \(6\) dà resto \(0\), e il MCD è \(6\).
Perché il trucco funziona lo racconta il pavimento. Dal rettangolo di \(12 \times 8\) ritaglia il quadrato più grande che ci sta, \(8 \times 8\): avanza una striscia di \(8 \times 4\), e la larghezza della striscia è proprio il resto della divisione. Una piastrella che copre senza tagli il pavimento intero copre senza tagli anche la striscia, e viceversa: quindi cercare la piastrella più grande per \(12\) e \(8\), o cercarla per \(8\) e \(4\), è lo stesso problema, solo più piccolo. Dalla striscia ritaglia poi due quadrati di \(4 \times 4\): non avanza niente, e quando non avanza niente il lato del quadrato è la piastrella cercata.
Il bello è che le divisioni restano poche anche quando i numeri crescono: per due numeri lunghi cento cifre ne bastano al massimo cinquecento, cinque per cifra, mentre provare i divisori uno per uno ne chiederebbe fino a un \(1\) seguito da cento zeri. Per darti la misura di quanto sia grande quel numero: gli atomi dell’intero universo osservabile si stimano intorno a un \(1\) seguito da ottanta zeri, cioè cento miliardi di miliardi di volte di meno.
Poche, però, non vuol dire poco tempo. Le divisioni crescono con la lunghezza dei numeri, al più cinque per ogni cifra in più (in media meno di due), e ciascuna, su numeri da cento cifre, costa molto più che su numeri da una cifra.
Per interi \(a \ge 0\) e \(b > 0\) l’algoritmo sfrutta l’identità
\(\mathrm{MCD}(a, b) = \mathrm{MCD}(b,\, a \bmod b)\), dove \(a \bmod b\) è il
resto della divisione intera, \(0 \le a \bmod b < b\); il caso base è
\(\mathrm{MCD}(a, 0) = a\) per \(a > 0\), e \(\mathrm{MCD}(0, 0)\) si pone uguale a
\(0\) per convenzione. Poiché il secondo argomento scende strettamente a ogni
passo restando non negativo, il ciclo termina.
La correttezza segue dal fatto che ogni divisore comune di \(a\) e \(b\) divide
anche \(a \bmod b = a - \lfloor a/b \rfloor\, b\) e che, viceversa, ogni
divisore comune di \(b\) e \(a \bmod b\) divide
\(a = \lfloor a/b \rfloor\, b + (a \bmod b)\): i due insiemi di divisori comuni
coincidono, quindi il massimo è invariante a ogni passo. Per \(a=12\), \(b=8\):
\((12, 8) \to (8, 4) \to (4, 0) \Rightarrow 4\). Il numero di passi \(N\) è
\(O(\log \min(a, b))\). Più precisamente, se \(a > b \ge 1\) vale
\(b \ge F_{N+1} \ge \varphi^{N-1}\), con \(F_k\) i numeri di Fibonacci e
\(\varphi = (1+\sqrt{5})/2\) (teorema di Lamé, 1844): ne segue
\(N \le 1 + \log_\varphi b\), cioè al più cinque passi per cifra decimale di \(b\),
e il caso peggiore è quello di due numeri di Fibonacci consecutivi, con
\(\log_\varphi 10 \approx 4{,}79\) passi per cifra. In media i passi sono circa
\(\tfrac{12\ln 2}{\pi^2}\ln b\), poco meno di due per cifra
[Knu97]. È per questa efficienza (non solo per
l’età) che l’idea di Euclide è ancora oggi nelle librerie standard di quasi
tutti i linguaggi (math.gcd in Python, std::gcd in C++ dal 2017; la
libreria standard del C non ne ha una). Attenzione però a leggere bene la stima:
quelli sono passi, e il
logaritmo è preso sul valore di \(\min(a, b)\), quindi su due numeri di \(n\)
cifre i passi sono \(O(n)\), non \(O(\log n)\). Su interi lunghi ogni passo costa
una divisione, il cui prezzo è proporzionale alle cifre del quoziente
moltiplicate per quelle del divisore; la somma delle cifre di tutti i
quozienti resta però \(O(n)\), perché il prodotto dei quozienti non supera il
numero di partenza. Da lì il tempo totale
\(O(n^2)\), e non l’\(n^3\) che il prodotto ingenuo dei due fattori farebbe
temere. Le librerie, però, non eseguono questo ciclo tale e quale. CPython
usa una sua raffinatura, l’algoritmo di Lehmer, che lavora sulle cifre di testa
in precisione singola e risparmia molte divisioni su interi lunghi (stessa
classe \(O(n^2)\), costante molto migliore); librerie come GMP, per numeri
enormi, passano ad algoritmi subquadratici di tipo half-GCD (Knuth, 1970;
Schönhage, 1971), con costo \(O(M(n)\log n)\), dove \(M(n)\) è il costo di una
moltiplicazione fra numeri di \(n\) cifre.
La Fig. 1.1 mostra la stessa discesa su un’altra coppia di numeri, \(60\) e \(48\): sono quelli su cui lavoreremo in Python.

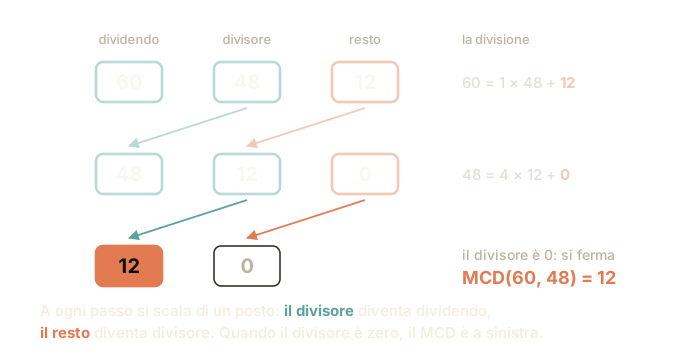
Fig. 1.1 La discesa di Euclide su 60 e 48: a ogni passo il divisore prende il posto del dividendo e il resto quello del divisore, e i numeri si accorciano. Quando il divisore arriva a zero ci si ferma, e quello rimasto a sinistra è il massimo comune divisore. Due divisioni in tutto, senza provare nemmeno un candidato.#
Quando le regole non si scrivono#
L’algoritmo di Euclide è una ricetta, e le ricette hanno un autore: qualcuno ha capito come si fa e ne ha scritto i passi. Per duemila anni ogni algoritmo è stato così, e così è ancora la maggior parte dei programmi che usi ogni giorno: chi li ha scritti sapeva già che cosa dovevano fare, riga per riga.
Il salto si vede bene su una fotografia. Per un computer è un rettangolo di puntini, e ogni puntino (si chiama pixel) è una terna di numeri che dicono quanto rosso, quanto verde e quanto blu ci sono lì. Una foto da telefono ne ha qualche milione.
Adesso prova a scrivere la ricetta per riconoscere un gatto in una fotografia. Non può parlare di orecchie a punta: deve dire che cosa fare con quei milioni di numeri, e deve funzionare anche col gatto di spalle, in controluce, mezzo nascosto dietro una sedia. Nessuno è mai riuscito a scriverne una che regga in tutti i casi, e non per pigrizia: quella ricetta non la sappiamo, per quanto siamo capacissimi di eseguirla con gli occhi in un decimo di secondo.
E allora si cambia strada. Invece di scrivere le regole, si raccolgono gli esempi (migliaia di fotografie con scritto accanto «gatto» oppure «non gatto») e si lascia che sia il programma a trovare da solo che cosa distingue le une dalle altre. Le regole non le scrive nessuno: emergono dai dati. È questo che significa dire che un programma impara, e spiega perché, in questo modo di lavorare, i dati contano quanto il codice.
C’è una vecchia obiezione a questa idea, cioè un argomento per dire che non può funzionare, ed è stata scritta quasi due secoli fa; un pezzo della sua storia si è svolto in Italia, a Torino. Nel 1840 il matematico inglese Charles Babbage vi presentò il progetto della sua macchina analitica, un calcolatore fatto di ingranaggi che avrebbe dovuto eseguire in fila le istruzioni scritte su schede di cartone perforate, un po’ come oggi un computer esegue un programma. Non fu mai costruita. A descriverla, in un articolo in francese, fu Luigi Federico Menabrea, un ufficiale del genio che insegnava all’Accademia militare di Torino e che quasi trent’anni dopo sarebbe diventato capo del governo italiano. La matematica inglese Ada Lovelace tradusse l’articolo e lo accompagnò con note lunghe più del doppio, in cui mostrava fra l’altro come istruire la macchina, passo per passo, a eseguire un calcolo lungo. In una di quelle note scrisse che la macchina «non pretende affatto di creare qualcosa da sé: può fare qualunque cosa noi sappiamo ordinarle di eseguire» [Men43].
Nello stesso articolo del 1950 in cui proponeva il suo test, Turing mise quella frase fra le obiezioni alle macchine pensanti e la chiamò «obiezione di Lady Lovelace» (Lady è il titolo nobiliare: è la stessa Ada Lovelace). Qualche pagina più avanti ci tornò sopra, e la sua proposta è l’idea degli esempi detta con un’altra immagine: invece di costruire una mente adulta, con tutte le regole già scritte dentro, costruirne una da bambino, «qualcosa come un quaderno appena comprato in cartoleria», poco meccanismo e molti fogli bianchi, e poi educarla [Tur50]. Il quaderno bianco è il programma prima di vedere le fotografie; l’educazione sono le migliaia di fotografie con scritto accanto «gatto» oppure «non gatto».
Qui nascono tre parole che torneranno in quasi tutti i capitoli. La fase in cui il programma guarda gli esempi e aggiusta se stesso si chiama addestramento; quello che ne esce, cioè il programma già aggiustato e pronto a rispondere su fotografie che non ha mai visto, si chiama modello. Il «gatto» scritto accanto a ciascuna foto si chiama etichetta.
Le fotografie etichettate a mano sono il caso più facile da raccontare, non l’unico né il più diffuso. La risposta giusta può essere già dentro il materiale che si ha: si nasconde la parola che viene dopo e si chiede al programma di indovinarla, e a quel punto le etichette sono tante quante le parole del testo e non costano niente, perché le fornisce il testo stesso. È così che si fa la prima fase dell’addestramento dei modelli di cui oggi si parla di più, e fin d’ora vale la distinzione: «imparare dagli esempi» non vuol dire per forza che qualcuno abbia etichettato qualcosa.
Da qui i tre nomi che si incontrano più spesso, e che a questo punto si dicono in una riga ciascuno:
il machine learning (apprendimento automatico) è l’idea appena detta: ricavare le regole dagli esempi invece di scriverle a mano;
il deep learning (apprendimento profondo) è il machine learning fatto con le reti neurali (il nome viene dal cervello, che le ha ispirate alla lontana): programmi composti da molti passaggi elementari disposti in fila per strati. Ogni strato trasforma i numeri dello strato precedente in una descrizione un po’ più astratta: in una rete che guarda fotografie, dai pixel ai bordi, dai bordi alle forme, dalle forme al gatto. «Profondo» vuol dire soltanto che gli strati sono tanti, uno sopra l’altro, e nessuno scrive a mano che cosa ciascuno debba cercare;
il reinforcement learning (apprendimento per rinforzo) è il caso in cui gli esempi giusti non esistono e il programma impara dalle conseguenze delle proprie azioni: prova, riceve un punteggio, riprova. È il caso che incontreremo nella sezione sulla robotica, con il robot che impara a camminare.
Il disegno più diffuso mette l’intelligenza artificiale, il machine learning e il deep learning come tre cerchi uno dentro l’altro, e per questi tre è giusto: il deep learning è un modo di fare machine learning, e il machine learning un modo di fare intelligenza artificiale. Il reinforcement learning è un altro tipo di machine learning, diverso dall’imparare da esempi con la risposta scritta accanto: l’unico giudizio è un punteggio. Può usare le reti profonde (e allora si parla di deep reinforcement learning) o farne a meno. E l’intelligenza artificiale è più larga di tutto il machine learning: comprende anche i programmi che ragionano su regole scritte a mano o che cercano fra le mosse possibili, cioè la sua parte classica, quella dei sistemi esperti del secondo inverno.
Da qui una definizione pratica, provvisoria come tutte quelle buone: l’intelligenza artificiale si occupa dei compiti per cui nessuno sa scrivere a mano una ricetta che regga nel mondo reale. È la riga che tiene fuori la lavatrice. Anche una lavatrice decide da sola quando fermare il risciacquo, ma per quella decisione la ricetta c’è, sta in poche righe e funziona: un tecnico ha stabilito quale sensore leggere e sopra quale soglia fermarsi. Riconoscere un gatto, tradurre una frase, far camminare un robot su un terreno qualunque: lì la ricetta non esiste, e va fatta emergere. Ed è anche la riga che tiene dentro i sistemi esperti, che provavano lo stesso a scriverla, a mano, una regola alla volta. Il loro fallimento è una delle ragioni per cui oggi le regole si ricavano dagli esempi.
Torna così la domanda dell’inizio. ELIZA non aveva niente di più di una lista di istruzioni, ed è proprio per questo che il suo incanto si sgretola appena lo si spiega. I programmi che imparano dagli esempi qualcosa di più ce l’hanno, ma è meno misterioso e più scomodo di quanto si immagini: nessuno ha scritto le regole che seguono e, nei modelli grandi, nessuno sa elencarle tutte, nemmeno chi li ha costruiti. Da lì vengono sia i risultati sia i guai: dei modi per sbirciare comunque là dentro parla Interpretabilità, dei danni che quei programmi possono fare AI responsabile.
Il punteggio da far salire#
Le regole emergono dai dati, ma qualcosa deve pur dire al programma se sta andando meglio o peggio. È di nuovo la funzione obiettivo, quella con cui la ricerca operativa e il termostato sapevano se il piano stava funzionando; solo che questa volta il punteggio si vuole alto, e a cercare le mosse che lo fanno salire non è un ingegnere, è l’addestramento.
Quello che l’addestramento tocca, però, è una cosa sola. Dentro un programma che impara c’è un elenco di numeri, spesso lunghissimo, e si chiamano parametri; tutti insieme si indicano con la lettera greca \(\theta\) (theta), e la funzione obiettivo, che da loro dipende, si scrive \(J(\theta)\). L’addestramento cambia soltanto \(\theta\); il comportamento viene dietro.
A un robot aspirapolvere assegni un punteggio: \(+1\) per ogni briciola raccolta, \(-1\) per ogni urto contro un mobile. Se in un giro di salotto raccoglie \(30\) briciole e sbatte \(5\) volte, totalizza \(30 - 5 = 25\) punti. Quel modo di dare i punti è la sua funzione obiettivo: non gli spieghiamo come pulire, gli diciamo solo che punteggio vogliamo veder salire.
Dentro, il robot ha una manciata di manopole, i suoi parametri: quanto sterzare quando il sensore davanti si accende, quanto rallentare vicino a un mobile, quanto insistere dove il tappeto è sporco. Si girano quelle, si guarda il punteggio, si girano ancora. Qualunque giro di manopola che porti il totale medio sopra \(25\) è un miglioramento; «agire nel modo migliore possibile» significa, alla fine, scegliere le mosse che rendono quel punteggio il più alto possibile. Buona parte dell’intelligenza artificiale moderna, sotto sotto, funziona così: si sceglie un numero da massimizzare (o un errore da rendere minimo) e si lascia che sia la macchina a scoprire come.
Un giro solo, però, dice poco. Il robot vale per come pulirà le stanze che deve ancora vedere: il salotto coi mobili spostati, la casa di un amico. Quei giri futuri non si possono misurare oggi: si misurano i giri già fatti, si allena il robot su quelli e si spera che le stanze che verranno somiglino a quelle già viste. Quanta fiducia meriti quella speranza è la domanda al centro del capitolo sul machine learning.
C’è poi una crepa, e ci accompagnerà per tutto il libro: quel punteggio lo scriviamo noi, e non è mai esattamente la cosa che vogliamo. Un aspirapolvere pagato a briciole raccolte, se è abbastanza bravo, può scoprire che gli conviene rovesciare il cestino e raccoglierle una seconda volta. Ha fatto il punteggio più alto e ha sporcato il salotto: ha obbedito alla lettera tradendo l’intenzione. Il fenomeno ha un nome, reward hacking, e lo racconta Esplorazione e ricompensa, nelle pagine sull’imparare per tentativi ed errori con le reti neurali.
Formalmente, si descrive il comportamento del sistema con dei parametri \(\theta\) e se ne misura la qualità con un’utilità attesa
dove \(\xi\) è una situazione (un esempio, un episodio), \(U(\theta, \xi)\) il punteggio che il sistema vi ottiene e \(p_\theta\) la distribuzione delle situazioni che incontrerà: i dati che vedrà, o l’ambiente in cui agirà. Nell’apprendimento supervisionato \(p_\theta = p\) non dipende dai parametri, e \(\theta\) agisce solo attraverso \(U\); nel reinforcement learning le azioni decidono quali stati si visitano, \(p_\theta\) dipende da \(\theta\), ed è questa dipendenza a rendere il gradiente di \(J\) più difficile da stimare. Massimizzare \(J\) equivale a minimizzare la perdita attesa (loss) \(\mathcal{L}(\theta) = -J(\theta)\) e, assumendo che un ottimo esista, si cerca
dove \(\theta^\star\) è una configurazione ottima dei parametri.
Un avvertimento che vale per tutto il seguito, ed è la differenza fra ottimizzare e imparare: quell’attesa non si sa calcolare, perché la distribuzione su cui è presa è quella dei casi futuri, l’unica a cui in fase di addestramento non si ha accesso. In pratica si massimizza la media su \(n\) situazioni già raccolte, \(\hat{J}_n(\theta) = \frac{1}{n}\sum_{i=1}^{n} U(\theta, \xi_i)\), con le \(\xi_i\) estratte in modo indipendente dalla stessa \(p\) (il caso supervisionato), e si spera che il \(\hat{\theta}\) che la massimizza valga molto anche per \(J\). Per un \(\theta\) fissato, se \(\mathbb{E}\,|U(\theta,\xi)| < \infty\), la legge dei grandi numeri garantisce \(\hat{J}_n(\theta) \to J(\theta)\); per \(\hat{\theta}\) no, perché è stato scelto guardando proprio quei dati, e in media \(\hat{J}_n(\hat{\theta})\) sovrastima \(J(\hat{\theta})\): infatti \(\mathbb{E}\,\hat{J}_n(\hat{\theta}) \ge \mathbb{E}\,\hat{J}_n(\theta^\star) = J(\theta^\star) \ge \mathbb{E}\,J(\hat{\theta})\). Tutto questo presuppone che i dati futuri vengano dalla stessa \(p\) di quelli raccolti; quando non è così si parla di dataset shift, il tema della sezione sui dati che cambiano.
Massimizzare \(\hat{J}_n\) è la minimizzazione del rischio empirico (Vapnik): \(-\hat{J}_n\) è il rischio empirico, \(-J\) il rischio, e la loro distanza è il divario di generalizzazione, di cui si occupa la teoria dell’apprendimento. Nei modelli differenziabili il massimo si cerca salendo lungo il gradiente, \(\theta \leftarrow \theta + \eta\,\nabla_\theta \hat{J}_n(\theta)\), con \(\eta\) il tasso di apprendimento; \(\hat{J}_n\) in generale non è concava, e la salita si ferma su un massimo locale, non per forza su quello globale. Misurare la distanza fra \(\hat{J}_n\) e \(J\), e sapere quando fidarsene, è il mestiere del capitolo sul machine learning.
È la cornice dell’agente razionale [RN20]: un sistema che sceglie le azioni che massimizzano l’utilità attesa, date le informazioni disponibili. Qui l’ottimizzazione agisce sui parametri, non direttamente sulle azioni: \(\theta\) determina il comportamento del sistema, e la configurazione ottima dei parametri induce le scelte migliori che la famiglia di modelli \(\{f_\theta\}\) permette, sempre che l’ottimizzazione trovi un ottimo globale. Gran parte dei metodi che seguono sono variazioni su questo tema: la regressione minimizza un errore quadratico medio, la classificazione una cross-entropy, il reinforcement learning massimizza una ricompensa cumulata attesa. Cambiano \(\mathcal{L}\) e il modo di calcolare il minimo, non lo schema.
Le eccezioni sono poche e istruttive, e mostrano due modi di uscire dal quadro. Le GAN sostituiscono la minimizzazione di una funzione con l’equilibrio di un gioco fra due reti in competizione, e allora la loss smette di dire se le cose stanno andando bene; i metodi non parametrici come il k-NN non hanno parametri da stimare con l’addestramento: conservano i dati stessi. «Non parametrico» significa questo, e non che non ci siano numeri da scegliere: significa che ciò che il modello si porta dietro cresce con i dati, invece di essere fissato in partenza. Va aggiunta una crepa che non è un’eccezione ma un limite della cornice, dichiarato dagli stessi autori che l’hanno resa canonica: \(J\) è il punteggio che scriviamo noi, non quello che vogliamo davvero, e un sistema abbastanza bravo massimizza il primo anche a spese del secondo. Il fenomeno si chiama reward hacking, e lo tratta Esplorazione e ricompensa.
Perché proprio adesso#
Se le regole si ricavano dagli esempi, servono molti esempi e macchine capaci di elaborarli. È la risposta alla domanda che tutti fanno, cioè perché un campo nato negli anni Cinquanta abbia dato i risultati di oggi solo dopo il 2012: servivano insieme i dati, la potenza di calcolo e gli algoritmi capaci di sfruttarli, e per decenni ne mancava almeno uno.
L’AI deve molto all’informatica e all’elettronica. Le hanno dato i linguaggi con cui si scrivono i programmi, Python fra questi. Le hanno dato le librerie, cioè raccolte di codice già scritto e collaudato che si usano invece di rifarlo da capo (PyTorch, con cui addestreremo le reti neurali, e TensorFlow, che fa lo stesso mestiere ed è nato in Google). E le hanno dato macchine sempre più veloci: prima i processori normali, le CPU; poi le schede grafiche, le GPU, che erano nate per far girare i videogiochi e si sono rivelate adatte ad addestrare le reti neurali, perché sanno fare moltissimi conti semplici tutti insieme; infine i chip costruiti apposta per questo mestiere, come le TPU di Google.
Ed è in debito con Internet, che ha reso raccoglibili i dati su cui i modelli si addestrano, dalle grandi collezioni di immagini già etichettate, come ImageNet, al testo del web. Dati, potenza di calcolo e algoritmi: sono questi a essere arrivati insieme, e il capitolo sul deep learning li riprende uno per uno. Di quanto pesino i dati e il calcolo, insieme alla taglia del modello, si può anche fare una misura: sono le leggi di scala, che racconta la sezione sui grandi modelli linguistici.
Su che cosa siano quei dati bisogna fermarsi, perché è la cosa che si fraintende più spesso. Il modo di dire corrente li chiama «il petrolio del nostro secolo», cioè un giacimento che qualcuno è andato a scavare. I dati sono piuttosto uno scarto. Non che nessuno li produca apposta: le fotografie con scritto accanto «gatto» le ha etichettate una persona, a mano, ed è un mestiere pagato. Ma quella è la fetta piccola, e costa cara proprio perché è l’eccezione. Il grosso non lo produce nessuno di proposito: lo lasciamo dietro di noi mentre facciamo altro, cercando un indirizzo, comprando un libro, scrivendo a un amico, guardando un video fino in fondo o smettendo al secondo minuto. È la traccia di un passaggio, non il prodotto di un’intenzione.
C’è un precedente, ed è successo su scala planetaria. Certi batteri, i cianobatteri, impararono a spezzare l’acqua con la luce del sole per prendersi la parte che serviva loro a costruirsi il cibo: è la fotosintesi, quella che si studia a scuola. Quel che restava lo buttarono via, ed era ossigeno [LRP14]. Per loro era un sottoprodotto; per la vita di allora, cresciuta in un mondo che non ne aveva mai avuto, era un veleno.
E per moltissimo tempo non successe niente. I cianobatteri cominciarono forse tre miliardi di anni fa, e l’aria restò come prima: l’ossigeno finiva subito, mangiato dalle rocce e dai gas che incontrava. Solo intorno a due miliardi e trecento milioni di anni fa l’atmosfera cominciò a tenerselo, e ai livelli di oggi ci arrivò molto più tardi ancora [LRP14]: quasi ieri, su quella scala. Lungo quella strada comparve una forma di vita che di quello scarto faceva il proprio respiro, e da quel respiro ricavava molta più energia di qualunque modo di vivere venuto prima. Quella strada è la nostra: respiriamo, alla lettera, il rifiuto di qualcun altro.
I dati stanno alle macchine come l’ossigeno sta a noi. Sono l’avanzo del nostro passaggio nel mondo digitale, prodotto senza volerlo e in quantità che nessuno ha deciso; e sopra quell’avanzo è cresciuta una cosa che di lì trae il proprio respiro. E torna la domanda «perché proprio adesso»: come l’ossigeno, i dati sono rimasti lì un pezzo prima che qualcosa imparasse a respirarli.
C’è però una parte scomoda, e vale quanto l’altra. Quello scarto, prima di diventare respiro, fu un veleno, e chi non seppe conviverci non sparì del tutto: si ritirò. Gli organismi che l’ossigeno avvelena esistono ancora, ma solo dove l’aria non arriva, nel fango dei fondali e dentro il nostro intestino. Nel nostro caso quella parte si chiama privacy: ciò che lasciamo per strada senza pensarci è esattamente ciò di cui vive qualcuno che non abbiamo scelto (di solito un’azienda di cui non abbiamo mai sentito il nome), e i posti dove non si lascia niente si fanno più stretti. La prende sul serio Privacy e robustezza.
Il debito con l’informatica, peraltro, è stato ripagato con gli interessi [RN20]: parecchie idee nate nei laboratori di intelligenza artificiale hanno poi fatto il giro dell’informatica intera e oggi si usano ovunque senza ricordarne la provenienza. La più diffusa è la gestione automatica della memoria. Un programma, mentre gira, chiede continuamente al computer un po’ di spazio in cui mettere quello che sta maneggiando, e quello spazio prima o poi va restituito, altrimenti si esaurisce e tutto si ferma. Per anni tenerne il conto è stato un lavoro di chi programmava, e una fonte inesauribile di errori. L’idea che a restituirlo possa pensarci il linguaggio da solo, la garbage collection («raccolta dei rifiuti»), la introdusse intorno al 1959 John McCarthy, uno dei quattro della proposta di Dartmouth, per il Lisp, il linguaggio che aveva creato per scrivere programmi di intelligenza artificiale; oggi è quello che Python fa per te senza che tu debba accorgertene. Ed è con Python che scriveremo il primo algoritmo.