


Funzioni di attivazione#
Prendi una rete profonda: dieci strati, migliaia di neuroni, milioni di parametri. Ora togli le funzioni di attivazione. Tutta quella profondità si sgonfia in un istante: quello che resta, per quanto grande sia, equivale a un solo strato affine, una moltiplicazione per una matrice più un vettore, cioè a un modello che sa tracciare soltanto confini dritti. Le funzioni di attivazione sono il gesto non lineare che, ripetuto strato dopo strato, impedisce quel collasso e trasforma una pila di moltiplicazioni in un modello capace di riconoscere un volto o tradurre una frase.
Perché serve una non linearità#
Tolta l’attivazione, uno strato fa una cosa sola: ciascun suo neurone moltiplica ogni numero che riceve per un peso (l’importanza che gli assegna), somma i risultati e aggiunge un numero fisso suo, il bias; tutto lo strato insieme, con i pesi in una matrice e i bias in un vettore, calcola \(\mathbf{W}\mathbf{x} + \mathbf{b}\). È un’operazione affine, cioè una moltiplicazione seguita da uno spostamento fisso (nell’uso si dice lineare anche così), e il problema è che comporre due operazioni affini ne dà ancora una affine: mille strati così valgono quanto uno.
Una catena di macchinette, ognuna delle quali moltiplica per un numero e poi aggiunge un numero fisso. La prima moltiplica per \(2\) e aggiunge \(1\), la seconda moltiplica per \(3\) e aggiunge \(1\). Metterle in fila non crea niente di nuovo: equivale a una sola macchinetta che moltiplica per \(6\) e aggiunge \(4\), perché l’\(1\) della prima passa per la seconda e diventa \(3\), più l’\(1\) suo. Se ne impilano quante se ne vuole, e alla fine resta sempre una regola dello stesso tipo, moltiplica e aggiungi, che sul grafico è una retta. In uno strato vero le macchinette sono tante, una per ogni coppia fra un numero che entra e uno che esce, e i loro numeri messi in tabella sono la matrice dei pesi; il conto non cambia.
Una rete fatta solo di strati così, per quanto profonda, non è più potente di un neurone solo: per dividere i casi in due gruppi sa tracciare una riga dritta e nient’altro. Non imparerà mai una spirale, una lettera scritta a mano, il tono di una frase. Serve, tra uno strato e l’altro, una «piega»: una funzione che storce i numeri, cioè che non si riduce a moltiplicare e aggiungere. È lei che dà alla rete la libertà di disegnare curve.
Non una piega qualunque, però. Uno strato è fatto di macchinette affiancate invece che in fila: lavorano tutte sullo stesso numero, e quello che hanno prodotto si somma, ciascuno con il suo peso. Allargare lo strato vuol dire affiancarne di più. Prendiamo come piega «eleva al quadrato», che è una piega vera ma è pur sempre una parabola, e chiediamo allo strato di ricalcare la curva di \(x^3\) fra \(-1\) e \(1\), quella che sale ripida agli estremi e si appiattisce attorno allo zero. Le macchinette si prendono a caso, e si sceglie soltanto quanto pesa ciascuna nella somma, nel modo che sbaglia meno. Dieci macchinette sbagliano in media di quindici centesimi, su una curva i cui valori stanno fra \(-1\) e \(1\). Ottocento sbagliano di quindici centesimi, gli stessi. Sommare parabole non porta oltre la parabola, e di quanto la miglior parabola resti lontana da quella curva si sa fare il conto prima ancora di provare: quei quindici centesimi sono il muro contro cui la larghezza si ferma. Con una piega che nessuna somma di parabole sa rifare, invece, come la ReLU, che lascia passare i numeri positivi e azzera i negativi, allargare rende davvero: dieci macchinette scendono a poco più di tre centesimi di scarto, più di quattro volte sotto il muro, e ottocento a meno di quattro centomillesimi, quasi quattromila volte sotto.
Con una piega di quelle buone, e abbastanza macchinette affiancate, ci si avvicina quanto si vuole a qualunque curva tracciata senza staccare la matita. La garanzia è dimostrata, e dice una cosa sola: uno strato che ci riesce esiste. Quanto largo debba essere non lo dice, e per una curva che dipende da molte grandezze insieme il numero di macchinette può esplodere.
In simboli, ogni strato calcola \(\mathbf{W}\mathbf{x}+\mathbf{b}\): una moltiplicazione per una matrice di pesi, più un vettore di bias. Consideriamo due strati lineari in cascata, senza attivazione:
Sostituendo il primo nel secondo:
La composizione collassa in un unico strato lineare con pesi \(\mathbf{W}'\) e bias \(\mathbf{b}'\): la profondità è illusoria. Introducendo una non linearità \(g\) tra gli strati, \(\hat{\mathbf{y}} = \mathbf{W}^{[2]}\,g(\mathbf{W}^{[1]}\mathbf{x}+\mathbf{b}^{[1]})+\mathbf{b}^{[2]}\), la fattorizzazione salta.
Non basta però che \(g\) sia non lineare, ed è un punto su cui si scivola spesso. Se \(g\) fosse un polinomio, per esempio \(g(x)=x^2\), uno strato nascosto calcolerebbe \(\sum_i c_i\,(w_i x + b_i)^2 + d\), dove \(w_i\) e \(b_i\) sono peso e bias dell’\(i\)-esimo neurone nascosto, \(c_i\) il peso con cui l’uscita lo raccoglie e \(d\) il bias d’uscita: comunque si scelgano quei parametri resta un polinomio di grado al più \(2\), e aggiungere neuroni non servirebbe a niente. Il conto si fa senza addestrare niente: su duemila punti equispaziati di \([-1,1]\) si estraggono a caso pesi e bias dello strato nascosto, e lo strato d’uscita, che è lineare, si calcola esatto ai minimi quadrati. Con \(g(x)=x^2\), sulla curva \(x^3\), dieci neuroni e ottocento danno lo stesso scarto quadratico medio, \(0{,}151\), e quello scarto si sa già quanto vale prima di calcolare. La miglior approssimazione di \(x^3\) con un polinomio di grado al più \(2\), in media quadratica su \([-1,1]\), è \(\tfrac{3}{5}x\) (è la proiezione ortogonale, e si legge nella scrittura di \(x^3\) come combinazione di polinomi di Legendre); lo scarto che resta ha radice
ed è il muro contro cui la larghezza si ferma (sui duemila punti l’ottimo sta appena sopra, a \(0{,}151\)). Con la ReLU, invece, la larghezza compra davvero qualcosa: dieci neuroni scendono a \(3{,}32\cdot 10^{-2}\) e ottocento a \(3{,}85\cdot 10^{-5}\), quasi quattromila volte sotto quel muro. Estrarre a caso lo strato nascosto rende il confronto più severo: lasciandolo libero di muoversi l’ottimo potrebbe solo scendere, e con il quadrato resterebbe comunque al muro.
La condizione esatta è che \(g\) non sia un polinomio (per la classe di funzioni in cui il risultato è enunciato: attivazioni continue a tratti e localmente limitate), e sotto quella condizione la rete è un approssimatore universale: con abbastanza neuroni avvicina, con errore arbitrariamente piccolo, qualunque funzione continua su un insieme compatto ([Cyb89] per le sigmoidali; [LLPS93] nella forma generale, ReLU compresa). Resta un teorema di esistenza, e per giunta muto sulla larghezza necessaria, che nel caso peggiore cresce esponenzialmente con la dimensione \(n\) dell’ingresso.
L’esperimento delle due pieghe sta in poche righe: lo strato nascosto si estrae a caso, e quello d’uscita si calcola esatto ai minimi quadrati.
import numpy as np

rng = np.random.default_rng(0)
x = np.linspace(-1, 1, 2000)                       # duemila punti in [-1, 1]
y = x**3

def scarto(neuroni, piega):
    """Uno strato nascosto con pesi e bias estratti a caso; lo strato
    d'uscita, che è lineare, si calcola esatto ai minimi quadrati."""
    w = rng.normal(size=neuroni)
    b = rng.uniform(-1, 1, size=neuroni)
    H = np.column_stack([piega(np.outer(x, w) + b), np.ones_like(x)])
    c, *_ = np.linalg.lstsq(H, y, rcond=None)
    return np.sqrt(np.mean((H @ c - y) ** 2))      # scarto quadratico medio

print(f"il muro dei polinomi di grado 2: {np.sqrt(4 / 175):.4f}")
pieghe = (("quadrato", np.square), ("ReLU", lambda z: np.maximum(0, z)))
for nome, piega in pieghe:
    for neuroni in (10, 800):
        s = scarto(neuroni, piega)
        print(f"{nome:>8}, {neuroni:>3} neuroni: scarto {s:.3g}")
il muro dei polinomi di grado 2: 0.1512
quadrato,  10 neuroni: scarto 0.151
quadrato, 800 neuroni: scarto 0.151
    ReLU,  10 neuroni: scarto 0.0332
    ReLU, 800 neuroni: scarto 3.85e-05
Prima di guardarle una per una serve il metro con cui si giudicano, e viene da come una rete impara. Ogni peso \(w\) si corregge in base alla derivata della loss rispetto a quel peso, \(\partial\mathcal{L}/\partial w\): la pendenza vista nella sezione su analisi e ottimizzazione, cioè di quanto cambierebbe l’errore muovendo quel peso di pochissimo. Quelle derivate le calcola la backpropagation, partendo dall’uscita, dove l’errore si vede, e risalendo gli strati all’indietro. Il gradiente che risale, ogni volta che attraversa una funzione di attivazione, viene moltiplicato per la sua derivata \(g'(z)\), presa nel punto \(z\) in cui il neurone stava lavorando; e ogni volta che attraversa uno strato, per la matrice dei pesi trasposta, \(\mathbf{W}^\top\), perché ogni neurone raccoglie i gradienti di tutti i neuroni a cui mandava il proprio numero, ciascuno pesato con il peso del collegamento. Dove la funzione è ripida il gradiente passa; dove è piatta la sua derivata vale quasi zero, e moltiplicare per quasi zero lo spegne.
Una buona funzione di attivazione, allora, è una che ha derivata lontana da zero là dove i neuroni lavorano davvero.
Le protagoniste degli strati nascosti sono tre, ognuna con un carattere diverso (Fig. 6.10); a queste si aggiunge poi una quarta, la softmax, che fa un altro mestiere e lavora solo sull’ultimo strato.

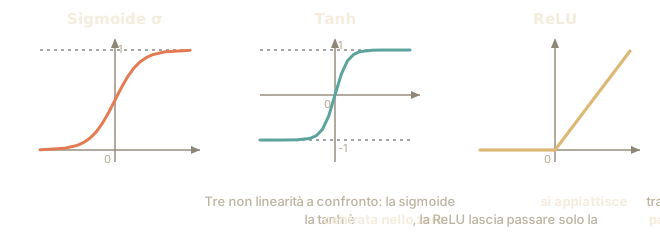
Fig. 6.10 Le tre funzioni di attivazione classiche, in tre grafici affiancati. In orizzontale il numero che entra nella funzione, in verticale quello che ne esce; l’incrocio degli assi è lo zero in entrambe le direzioni. Da guardare soprattutto dove ciascuna curva è piatta: è lì che il gradiente che risale la rete si spegne.#
La sigmoide: il primo interruttore morbido#
La prima scelta derivabile, ed è quella con cui la backpropagation del 1986 addestrava le reti: schiaccia qualunque numero in un valore fra \(0\) e \(1\). Comoda, perché un numero fra zero e uno si legge come un interruttore acceso a metà, o come «quanto sono convinto». È la stessa funzione della regressione logistica, il classificatore dell’apprendimento supervisionato.
La sigmoide prende un numero qualsiasi e lo comprime in un valore tra \(0\) e \(1\). Numeri molto negativi diventano quasi \(0\), numeri molto positivi quasi \(1\), e lo zero finisce esattamente a metà, \(0{,}5\). È un interruttore che invece di scattare di colpo scivola dolcemente da spento ad acceso. Ecco qualche valore (sono da calcolatrice: la formula ha dentro il numero \(e\), lo stesso della S della regressione logistica):
entra |
\(-6\) |
\(-5\) |
\(-2\) |
\(0\) |
\(1\) |
\(2\) |
\(5\) |
|---|---|---|---|---|---|---|---|
esce |
\(0{,}0025\) |
\(0{,}0067\) |
\(0{,}12\) |
\(0{,}50\) |
\(0{,}73\) |
\(0{,}88\) |
\(0{,}993\) |
Il difetto salta all’occhio guardando la curva: agli estremi diventa piattissima. E «piattissima» si può misurare, con i numeri della tabella. Vicino allo zero, spostandosi di uno (da \(0\) a \(1\)), l’uscita sale da \(0{,}50\) a \(0{,}73\): si è mossa di ventitré centesimi. In fondo alla coda, spostandosi sempre di uno (da \(-6\) a \(-5\)), sale da \(0{,}0025\) a \(0{,}0067\): si è mossa di quattro millesimi, cioè più di cinquanta volte meno, per uno spostamento identico.
E quei due numeri sono, in pratica, la pendenza: la pendenza vera è quanto si muove l’uscita per un passo piccolissimo, e su un passo lungo uno viene fuori un po’ meno (vicino allo zero la pendenza vera è \(0{,}25\), non \(0{,}23\)). Nelle code il divario resta, ma i numeri in gioco sono tutti di pochi millesimi: la pendenza vera vale meno di tre millesimi in \(-6\) e quasi sette millesimi in \(-5\), e i quattro millesimi letti sulla tabella stanno in mezzo. Il messaggio di correzione che risale la rete dall’errore verso i primi strati (è il gradiente) viene moltiplicato per un numero così, e si spegne.
Le code sono la parte peggiore, ma non sono tutto il problema. Un quarto è il massimo che la sigmoide concede: nel suo punto migliore, lo zero, il messaggio che la attraversa esce ridotto a un quarto, e ovunque altro esce ridotto di più. Dieci strati uno dietro l’altro, ciascuno con il suo quarto, e di quello che era partito resta un milionesimo.
Il rimedio che viene in mente per primo, alzare i pesi per compensare, non funziona. Pesi più grandi ingrandiscono i numeri che entrano nella funzione, e ingrandirli li spinge proprio verso le code, dove la curva è ancora più piatta. Su una rete di venti strati, moltiplicando per quattro tutti i pesi, la parte di messaggio che sopravvive a ogni strato sale da \(0{,}24\) a poco più di \(0{,}6\). Si guadagna qualcosa, e non basta: un fattore così, moltiplicato venti volte per sé stesso, vale circa un decimillesimo. Il messaggio si spegne comunque, solo un po’ più in là. Alzandoli di dodici volte smette di spegnersi, ma solo perché più di metà dei neuroni si è bloccata su uno dei due estremi, dove la curva è piatta, e il messaggio passa per i pochi rimasti nel mezzo: si è cambiato guasto, non lo si è riparato.
La sigmoide logistica è
La derivata è massima nell’origine, dove vale solo \(0{,}25\), e tende a \(0\) per \(|x|\to\infty\) (le code sature). Nella backpropagation il gradiente che attraversa uno strato viene moltiplicato per \(\sigma'\) e per la matrice dei pesi: con pesi di norma moderata, quella delle inizializzazioni standard, il fattore complessivo per strato resta sotto \(1\) e il prodotto collassa esponenzialmente con la profondità. È il celebre problema del gradiente che svanisce (vanishing gradient), studiato da Hochreiter [Hoc91] e Bengio [BSF94]: nelle reti profonde gli strati vicini all’ingresso smettono di ricevere segnale e non apprendono. A ciò si aggiunge che l’uscita non è centrata nello zero (sempre positiva), il che rallenta la convergenza della discesa del gradiente.
La via d’uscita che viene in mente per prima non funziona, e la porta va chiusa subito: non si rimedia alzando i pesi per compensare il fattore \(1/4\). Pesi più grandi spingono \(z\) nelle code, dove \(\sigma'\) è ancora più piccola, e a scale moderate i due effetti si mangiano a vicenda. Si prende una rete di venti strati da \(128\) unità, pesi estratti con l’inizializzazione di Glorot e ingressi normali standard, e si chiama «fattore» il rapporto fra la norma del gradiente che esce da uno strato verso l’ingresso e quella del gradiente che vi è entrato dall’uscita, mediato sugli strati. Il fattore medio per strato viene \(0{,}24\), in linea con il tetto di \(1/4\); quadruplicando la scala dei pesi sale soltanto a \(0{,}63\), perché nel frattempo \(\mathbb{E}[\sigma'(z)]\) scende da \(0{,}23\) a \(0{,}13\). Il blocco prova anche una scala dodici volte più grande, e conta le unità sature, quelle con \(\sigma'(z) < 0{,}01\).
import numpy as np

def sigmoide(z):
    return 1 / (1 + np.exp(-z))

def fattore_medio(scala, strati=20, n=128, esempi=256, seme=0):
    rng = np.random.default_rng(seme)
    limite = np.sqrt(6 / (n + n)) * scala          # Glorot uniforme, riscalata
    W = [rng.uniform(-limite, limite, (n, n)) for _ in range(strati)]
    a, zeta = rng.normal(size=(esempi, n)), []
    for Wl in W:                                    # andata: si tengono le z
        z = a @ Wl.T
        zeta.append(z)
        a = sigmoide(z)
    g, fattori, pendenze, sature = rng.normal(size=(esempi, n)), [], [], []
    for Wl, z in zip(reversed(W), reversed(zeta)):  # ritorno: W^T (g * sigma')
        d = sigmoide(z) * (1 - sigmoide(z))
        nuovo = (g * d) @ Wl
        fattori.append(np.linalg.norm(nuovo) / np.linalg.norm(g))
        pendenze.append(d.mean())
        sature.append((d < 0.01).mean())            # unità quasi piatte
        g = nuovo
    return np.mean(fattori), np.mean(pendenze), np.mean(sature)

for scala in (1, 4, 12):
    f, p, s = fattore_medio(scala)
    print(f"pesi x{scala}: fattore per strato {f:.2f}, E[sigma'(z)] {p:.2f},",
          f"sature {s:.0%}")
pesi x1: fattore per strato 0.24, E[sigma'(z)] 0.23, sature 0%
pesi x4: fattore per strato 0.63, E[sigma'(z)] 0.13, sature 7%
pesi x12: fattore per strato 1.08, E[sigma'(z)] 0.05, sature 57%
Si guadagna sul modulo di \(\mathbf{W}\) e si perde sulla saturazione, ma non in pari misura: a dodici volte la scala il fattore per strato supera già \(1\). Non è un rimedio, però. A quella scala più di metà delle unità ha \(\sigma'(z)\) sotto un centesimo, la rete lavora quasi a gradini, e il gradiente che sopravvive passa per la minoranza di unità rimaste a metà della curva. Si è barattato lo svanire con la saturazione, e oltre quella scala con l’esplosione.
La tanh: la stessa S, ma centrata nello zero#
La tanh (tangente iperbolica) è la stessa S della sigmoide, alta il doppio e
centrata nello zero: va da \(-1\) a \(1\) invece che da \(0\) a \(1\), e corregge così
uno dei suoi difetti, lo stare tutta sopra lo zero.
Un numero molto negativo esce quasi \(-1\), uno molto positivo quasi \(+1\), e lo zero resta zero. La differenza con la sigmoide è che ora l’uscita può essere anche negativa: in media i valori si bilanciano attorno allo zero, e questo aiuta la rete a imparare un po’ più in fretta. Il motivo, in breve: i numeri che entrano in un neurone sono le uscite dello strato precedente, e con la sigmoide sono tutti positivi; la correzione che tocca a ciascun peso di quel neurone è quel numero moltiplicato per il messaggio che arriva dall’alto, che per tutto il neurone è uno solo. Quindi o salgono tutti i pesi insieme o scendono tutti insieme. Se la direzione buona chiedeva un peso su e un altro giù, in linea retta non ci si arriva, e la discesa del gradiente ci arriva a zig-zag, un passo per verso. Con lo zero al centro le uscite si bilanciano, i segni si mescolano, e la strada si raddrizza.
C’è un secondo guadagno, e si misura come prima. Spostandosi di uno, da \(0\) a \(1\), l’uscita sale da \(0\) a \(0{,}76\): settantasei centesimi, contro i ventitré della sigmoide. Nel punto migliore la pendenza vera vale \(1\) tondo, quattro volte quella della sigmoide, e un messaggio moltiplicato per uno arriva dall’altra parte intero. Resta però lo stesso tallone d’Achille: agli estremi la curva si appiattisce, da \(2\) a \(3\) l’uscita si muove di tre centesimi appena, e lì il messaggio che risale la rete svanisce di nuovo.
L’uscita è centrata nello zero, quindi i gradienti dei pesi non hanno un
segno sistematico: la convergenza è più regolare che con la sigmoide
[LBOMuller98]. La derivata arriva fino a \(1\) nell’origine, contro
il \(0{,}25\) della sigmoide, ma satura comunque agli estremi. Per anni la tanh
è stata lo standard negli strati nascosti e sopravvive tuttora nelle celle
ricorrenti LSTM e GRU, che la sezione sui modelli di sequenza costruisce cancello per
cancello.
ReLU: la scelta di partenza delle reti profonde#
Fra il 2010 e il 2012 diventa la scelta standard una funzione elementare, che Fukushima usava già nel 1969 [Fuk69]: se il numero è positivo lo lascia passare, altrimenti lo mette a zero. Nessun conto complicato e, dal lato positivo, nessuna zona piatta.
La ReLU (Rectified Linear Unit) fa una cosa sola: se l’ingresso è positivo lo restituisce identico, se è negativo o zero restituisce zero. È uno sportello che lascia passare i versamenti e blocca i prelievi: entra \(10\), esce \(10\); entra \(-3\), esce \(0\).
Perché è diventata la scelta di partenza delle reti profonde? Perché dal lato positivo la curva è una riga inclinata: la sua pendenza è sempre \(1\), non si appiattisce mai. Si misura come prima: da \(2\) a \(3\) l’uscita passa da \(2\) a \(3\), si è mossa di uno intero; da \(20\) a \(21\) passa da \(20\) a \(21\), ancora uno intero. Lontano dallo zero quanto vicino, la pendenza vale sempre \(1\). Il messaggio che risale la rete, moltiplicato per \(1\), resta quello di prima; non si smorza a ogni passaggio come faceva con la sigmoide, e arriva quindi fino ai primi strati anche in una rete che ne ha decine, lungo gli sportelli aperti: dove lo sportello è chiuso non passa niente. Ed è velocissima da calcolare: un confronto con lo zero.
Che anche la ReLU spenga dei messaggi sembra rimetterla nei guai della sigmoide, e la differenza sta tutta in dove e in quando. La sigmoide smorzava ogni messaggio, sempre e dappertutto, un quarto per strato nel caso migliore. Lo sportello invece o lascia passare tutto o non lascia passare niente, e quali sportelli siano chiusi cambia da un esempio all’altro: il messaggio che si ferma qui passa da un’altra parte, e ai primi strati ci arriva. Lo sportello chiuso si fa sentire più in là nella rete: in qualunque momento buona parte dei numeri esce a zero, e lo strato successivo riceve poche voci accese invece di tutte.
Un punto solo fa eccezione, lo zero esatto: lì la curva fa un angolo, piatta da una parte e inclinata dall’altra, e non esiste una pendenza sola che valga per tutte e due. Chi la misura prendendo un pezzetto a sinistra e uno a destra ottiene \(0{,}5\), la media dei due lati; il calcolatore, che una risposta deve pur darla, risponde zero per convenzione. Nessuno dei due sbaglia, e la faccenda non ha conseguenze, perché un numero esattamente zero, con tutti i decimali in gioco, non capita quasi mai.
C’è un rischio. Se un neurone finisce nella zona negativa per tutti gli esempi (cioè per tutti i dati con cui la rete viene addestrata), la sua uscita è sempre zero, e allora anche la pendenza che sente è sempre zero: nessuna indicazione, nessuna correzione, i suoi pesi restano fermi. È il neurone «morto», e il nome è più drammatico di quello che gli capita davvero. Da solo non si tira fuori, ma i neuroni che lo precedono continuano a cambiare, e possono cominciare a mandargli numeri diversi e risvegliarlo senza che un suo peso si sia mosso di un millimetro. Senza ritorno è di sicuro il neurone del primo strato, che prima di sé ha solo i dati, e i dati non cambiano mai. E lo è anche un neurone più interno che pesa in negativo tutto quello che riceve e parte già sotto lo zero: i neuroni che lo precedono sono sportelli che lasciano passare solo numeri positivi o zero, e per quanto cambino non gli riporteranno mai il totale sopra lo zero. La Leaky ReLU previene il problema lasciando filtrare una pendenza piccola (un centesimo) anche per i valori negativi, così un po’ di indicazione arriva sempre.
I due casi non coprono tutta la retta, e l’omissione è voluta: in \(x=0\) la
derivata non esiste, perché il rapporto incrementale vale \(0\) arrivando da
sinistra e \(1\) arrivando da destra. Le librerie ne scelgono una per convenzione
(PyTorch restituisce \(0\); per leaky_relu restituisce \(\alpha\)), ed è una
scelta innocua: i punti in cui la pre-attivazione è esattamente zero sono un
insieme trascurabile, e qualunque valore fra \(0\) e \(1\) è un sotto-gradiente
legittimo. C’è però una conseguenza pratica che costa un pomeriggio a chi
controlla i conti a mano: verificando il gradiente con le differenze finite
proprio in zero si trova \(0{,}5\), cioè la media dei due lati, e non lo \(0\) che
la libreria restituisce. I due numeri non coincidono e nessuno dei due è
sbagliato: è il punto in cui la derivata non c’è, non un errore nel codice.
Per \(x>0\) il gradiente è esattamente \(1\): niente saturazione, niente vanishing lungo i cammini attivi. Ciò ha contribuito, con l’inizializzazione e più tardi con le connessioni residue, a rendere addestrabili reti profonde senza pre-addestramento ([NH10]; [GBB11]; AlexNet, [KSH12]), e induce attivazioni sparse (molti neuroni esattamente a zero). Il rovescio è il dying ReLU: un neurone la cui pre-attivazione \(z\) resta negativa su tutti i dati ha gradiente esattamente nullo sui propri pesi e smette di aggiornarsi. Attenzione a leggerlo bene: la condizione è su \(z\), non sull’ingresso \(\mathbf{x}\) (a valle di uno strato ReLU gli ingressi sono \(\ge 0\) per costruzione). E «non si aggiorna più» vale per i suoi parametri, non per il suo destino: in uno strato nascosto \(z\) continua a muoversi perché cambiano gli strati a monte, e il neurone può risvegliarsi senza che nessuno dei suoi pesi si sia mosso. Nel primo strato, dove l’ingresso è il dato e non cambia, la morte è definitiva; e lo è anche più in alto quando il neurone ha tutti i pesi in ingresso non positivi e il bias negativo, perché a valle di uno strato ReLU gli ingressi non sono mai negativi e allora \(z=\mathbf{w}^\top\mathbf{a}+b\le b<0\) qualunque cosa facciano gli strati a monte. La Leaky ReLU introduce una pendenza \(\alpha\) piccola (tipicamente \(0{,}01\)) sul ramo negativo:
Sulla stessa idea nascono PReLU (con \(\alpha\) appreso), ELU e, nei Transformer moderni, la GELU [HG16], cioè \(x\,\Phi(x)\): una ReLU ammorbidita in cui il gradino secco è sostituito da \(\Phi\), la funzione di ripartizione della normale standard. La sua derivata, \(\Phi(x) + x\,\Phi'(x)\), non somiglia a nessuna delle precedenti: vale \(1/2\) nell’origine, supera \(1\) (fino a circa \(1{,}13\) in \(x=\sqrt{2}\)), diventa negativa a sinistra del minimo della funzione (\(x \approx -0{,}75\), dove la GELU vale circa \(-0{,}17\)) e tende a \(0\) per \(x \to -\infty\): il lato negativo satura come quello della ReLU, soltanto senza lo spigolo. Da non confondere con la densità, che qui chiamiamo \(\Phi'\) per non tirare in ballo la \(\varphi\) (nel resto del capitolo \(\varphi\) è l’attivazione dello strato d’uscita, e un simbolo con due mestieri è un errore in agguato): \(x\,\Phi'(x)\) è tutt’altra funzione, dispari e non monotona, e chi prova a rifarsi il grafico partendo dalla campana ottiene un disegno diverso.
Softmax: dalle uscite alle probabilità#
Le funzioni viste finora lavorano su un numero alla volta, negli strati nascosti. Sull’ultimo strato serve un’altra cosa, quando la rete deve scegliere fra più risposte possibili: qualcosa che guardi tutte le uscite insieme e le trasformi in percentuali che sommano a \(100\). È la softmax.
La rete deve decidere tra «gatto», «cane» e «volpe», e produce tre punteggi grezzi, per esempio \(2{,}0\), \(1{,}0\), \(0{,}1\). La softmax li converte in tre percentuali che sommano a \(100\%\) (qui \(66\%\), \(24\%\), \(10\%\)) esaltando il punteggio più alto ma senza mai azzerare del tutto gli altri. Il risultato si legge come «quanto la rete è convinta di ciascuna classe».
È il conto già fatto con le cartelle della posta, nella regressione logistica a più risposte: ogni punteggio fa da esponente al numero \(e\), che vale \(2{,}718\ldots\), e poi si divide per il totale. Qui \(2{,}0\) diventa \(7{,}39\), \(1{,}0\) diventa \(2{,}72\) (cioè \(e\) stesso) e \(0{,}1\) diventa \(1{,}11\); sommano \(11{,}22\), e \(7{,}39 / 11{,}22\) fa il \(66\%\). È l’esponente, che ingrandisce di più i punteggi più alti, a esaltare il primo (senza, \(2\) diviso \(3{,}1\) farebbe il \(64{,}5\%\)), ed è anche il motivo per cui nessuna percentuale arriva mai a zero tondo.
Perché proprio \(e\) e non, che so, \(10\)? Con \(10\) funzionerebbe lo stesso, verrebbero solo percentuali più sbilanciate verso il punteggio più alto. La ragione della scelta è che con \(e\) le pendenze, quelle con cui la rete si corregge, vengono semplicissime.
Dato il vettore dei punteggi grezzi dell’ultimo strato, che si chiamano logit e qui indichiamo con \(\mathbf{z}\in\mathbb{R}^K\) (dove \(K\) è il numero di classi), la softmax è
È la generalizzazione multiclasse della sigmoide e si accompagna alla loss di cross-entropia. Attenzione: l’esponenziale di logit grandi va facilmente in overflow. La soluzione standard è sottrarre il massimo, \(z_i \leftarrow z_i - \max_j z_j\), che non cambia il risultato ma lo rende numericamente stabile: il trucco del log-sum-exp, discusso nella sezione di analisi numerica.
Quale usare, in pratica#
Una guida ragionevole per la maggior parte dei casi:
Dove |
Scelta consigliata |
Perché |
|---|---|---|
Strati nascosti (scelta di partenza) |
ReLU |
veloce, il gradiente non si spegne, ottimo punto di partenza |
Strati nascosti, neuroni «morti» |
Leaky ReLU |
un po’ di pendenza anche sui negativi |
Celle ricorrenti (le LSTM e le GRU della sezione sui modelli di sequenza, nel capitolo sul linguaggio naturale) |
tanh + sigmoide |
uscita centrata; la sigmoide fa da rubinetto, perché moltiplicare per un numero fra \(0\) e \(1\) è decidere quanta informazione lasciar passare |
Uscita, scelta fra due risposte (classificazione binaria) |
sigmoide |
una probabilità, mai esattamente \(0\) né \(1\) |
Uscita, scelta fra più risposte (classificazione multiclasse) |
softmax |
una percentuale per ciascuna delle classi in gioco |
Uscita, previsione di un numero (regressione) |
nessuna (lineare) |
il valore può essere qualunque numero |
La regola pratica di oggi: negli strati nascosti parti da ReLU, cambia solo se i risultati non convincono. Sull’uscita, invece, la funzione la detta il problema, non il gusto.
In pratica, con NumPy#
Ogni funzione è una o due righe. La softmax ne chiede due in più, e sono due precauzioni da conoscere. La prima: si sottrae il punteggio più alto prima di fare gli ingrandimenti, così i numeri restano piccoli e il computer non va fuori scala (il risultato non cambia). La seconda: si dichiara su quali numeri fare la somma. Senza, dando alla funzione un gruppo di esempi tutti insieme, le percentuali sommerebbero a \(100\) sull’intero gruppo invece che su ciascun esempio, e sarebbe un risultato sbagliato che non dà nessun errore.
import numpy as np

def sigmoide(x):
    return 1 / (1 + np.exp(-x))

def tanh(x):
    return np.tanh(x)                      # già in NumPy

def relu(x):
    return np.maximum(0, x)

def leaky_relu(x, alpha=0.01):
    return np.where(x > 0, x, alpha * x)   # pendenza alpha sui negativi

def softmax(z):
    z = z - np.max(z, axis=-1, keepdims=True)   # stabilità numerica
    e = np.exp(z)
    return e / e.sum(axis=-1, keepdims=True)    # una riga per esempio

print(softmax(np.array([2.0, 1.0, 0.1])))
[0.65900114 0.24243297 0.09856589]
Sono le tre percentuali del conto fra gatto, cane e volpe, \(66\), \(24\) e \(10\), con i decimali che a mano, fermandosi a due cifre, si erano persi per strada.
In PyTorch (la libreria per costruire e addestrare reti, un framework, che
presenta il capitolo che porta il suo nome) non serve
implementarle a mano: esistono come funzioni (torch.relu, torch.tanh,
torch.sigmoid, torch.softmax) o come moduli da impilare tra gli strati
(nn.ReLU(), nn.Sigmoid()), e sono già scritte nella forma numericamente
stabile.
Da ricordare
Fra uno strato e l’altro ci vuole una piega: senza, mettere in fila dieci strati equivale a metterne uno, e tutta la profondità non serve a niente. E non una piega qualunque: con una parabola, allargare lo strato smette di servire, perché sommare parabole non porta oltre la parabola.
Sigmoide e tanh schiacciano i numeri fra due estremi, e proprio agli estremi diventano piatte: lì la rete non trova più nessuna pendenza da seguire e smette di imparare. La tanh è un po’ meglio perché è centrata sullo zero. E alzare i pesi per compensare non aiuta: li spinge proprio verso le code, dove la curva è ancora più piatta.
La ReLU («se è positivo lascialo passare, altrimenti zero») dal lato positivo non si appiattisce mai, e costa un confronto: è la scelta di partenza, ed è uno dei pezzi che hanno reso possibili le reti profonde. La Leaky ReLU cura i neuroni che restano bloccati a zero.
Sull’ultimo strato di un classificatore c’è la softmax, che trasforma i punteggi grezzi in percentuali che sommano a \(100\).
Da ricordare
Senza una non linearità tra gli strati, una rete profonda collassa in un singolo strato lineare: la profondità sarebbe inutile. E non basta che sia non lineare: deve essere non polinomiale, altrimenti la larghezza non compra niente.
Sigmoide e tanh saturano agli estremi e soffrono il vanishing gradient; la tanh almeno è centrata nello zero. Alzare i pesi per compensare non aiuta: sposta il problema dal modulo di \(\mathbf{W}\) alla saturazione.
La ReLU (\(\max(0,x)\)) non satura dal lato positivo ed è velocissima: è la scelta di partenza negli strati nascosti, e uno dei pezzi che hanno reso addestrabili le reti profonde. La Leaky ReLU cura i neuroni «morti», cioè quelli con pre-attivazione negativa su tutto il dataset.
La softmax trasforma i logit dell’ultimo strato in probabilità che sommano a \(1\); va calcolata nella forma numericamente stabile.