


La voce sintetica: dal testo al parlato#
New York, estate del 1939. Nel padiglione della Bell all’Esposizione universale, una giovane donna siede a una console che ricorda un piccolo organo: una quindicina di tasti sotto le dita, una barra sotto il polso, un pedale sotto il piede. Il presentatore fa una domanda, la donna muove le dita, e dagli altoparlanti esce una voce che risponde: gommosa, un po’ subacquea, ma si capisce. Non è una registrazione. Il Voder di Homer Dudley, ingegnere dei Bell Labs, la voce la genera sul momento. I tasti dosano l’energia alle varie altezze sonore, dalle più gravi alle più acute. La barra sceglie fra le due sorgenti di suono che la macchina ha in pancia: il ronzio, che sta sotto le vocali, e il soffio, che sta sotto le consonanti come la «s» (mettiti una mano in gola e prova a dire aaa e poi sss: la prima ti fa vibrare sotto le dita, la seconda no). Il pedale disegna l’intonazione. La voce, letteralmente, si suona, e a suonarla bene, scrivono gli ingegneri della Bell, ci vuole «circa un anno»: sei mesi per imparare a fare tutti i suoni, altri sei per farli suonare naturali. A tenere la console, qui e poi a San Francisco, servivano ventiquattro operatrici, e per trovarle ne provarono oltre trecento, tutte centraliniste.
Quasi novant’anni dopo, la sintesi vocale (TTS, Text-to-Speech) legge ad alta voce le indicazioni stradali, gli audiolibri, i messaggi mentre guidiamo. Il problema è ancora quello del Voder, tolte le dita: fabbricare da zero un’onda di pressione, cioè un’aria che vibra, che un orecchio accetti come voce umana. Solo che al Voder la voce gliela dettava una persona, tasto per tasto, mentre oggi si parte da del testo scritto e a fabbricare l’onda sono le reti neurali.
Il viaggio inverso#
Fin qui la strada è andata in una sola direzione: dall’onda al testo. Abbiamo trasformato il suono in numeri, i numeri in spettrogramma, lo spettrogramma in parole. La sintesi vocale percorre la stessa mappa al contrario, e il punto d’incontro dei due viaggi è proprio il mel-spettrogramma costruito in Dal suono alle feature: quell’immagine a bande che dice, istante per istante, quanta energia c’è a ciascuna altezza sonora, misurata come la sente l’orecchio e non come la misurerebbe uno strumento (è questo che significa il «mel» davanti a «spettrogramma»). L’ASR parte da lì per salire verso le parole; il TTS ci arriva scendendo dalle parole, e da lì ricostruisce l’onda (Fig. 24.5). I due viaggi si incontrano sullo stesso tipo di immagine, ma non si scambiano i pezzi: riconoscimento e sintesi la calcolano con finestre e passi diversi, e quella che esce da un sintetizzatore non si passa a un riconoscitore.[1]

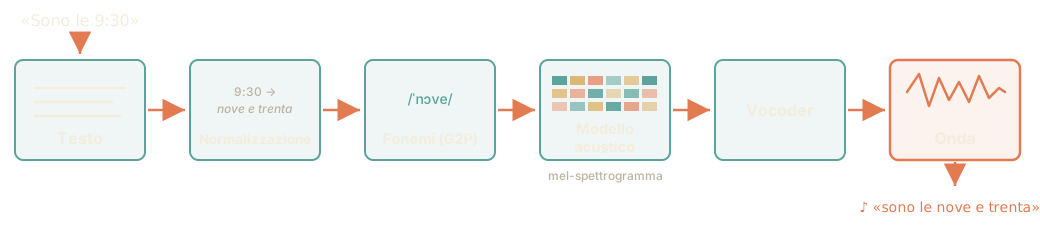
Fig. 24.5 Dal testo alla voce, tappa per tappa. Prima si riscrive il testo come va pronunciato («9:30» diventa «nove e trenta»), poi lo si traduce nei suoni veri della lingua, poi da quei suoni si disegna l’immagine a bande del parlato, e in fondo l’immagine ridiventa un’onda che si può ascoltare. Ogni tappa ha un nome, e le prossime pagine le prendono una per una.#
Un nome torna e cambia mestiere. Nel riconoscimento il modello acustico era il pezzo che, ascoltando il suono, diceva quali suoni ci fossero dentro; qui è il pezzo che, letto il testo, decide quali suoni produrre. Stesso nome, freccia rovesciata: è il punto in cui la specularità della figura si vede meglio.
Perché tante tappe, invece di andare dritti dal testo all’onda? Perché l’onda è lunghissima. Dentro un computer è la fila di campioni da cui partiva I modelli di riconoscimento: la pressione dell’aria misurata a intervalli regolari, migliaia di volte al secondo. In Tacotron 2, il modello che vedremo fra poco, un secondo di parlato sono \(24\,000\) campioni in fila. Lo stesso secondo, come mel-spettrogramma, sta in \(80\) colonne, una ogni \(12{,}5\) millesimi di secondo. Il rapporto fra i due, \(300\), non misura quanti numeri si risparmiano: ogni colonna ha a sua volta \(80\) bande, quindi i numeri sono \(6400\) contro \(24\,000\), un fattore \(3{,}75\). Misura i passi da fare uno dopo l’altro, e quando ogni decisione aspetta la precedente è quello il numero che conta. (Che bande e colonne siano tutte e due ottanta è una coincidenza dei parametri di Tacotron 2.)
Ecco perché il lavoro si divide in due. Prima si decide che suoni produrre e con che ritmo, e sono ottanta colonne al secondo: poche, e si possono guardare tutte insieme. Poi uno specialista (il vocoder) ci mette sopra il dettaglio fine dell’onda. Prima ancora dei suoni, però, va preparato il testo.
Mettere ordine nel testo: la normalizzazione#
Il testo scritto è pieno di simboli che nessuno pronuncia così come sono: numeri, date, sigle, abbreviazioni. Prima di qualunque rete neurale, un sistema TTS deve decidere quali parole corrispondono a ciò che è scritto.
Al telefono, «1901» non lo puoi mostrare: lo devi sciogliere a voce («millenovecentouno»). La normalizzazione è esattamente questo lavoro, fatto da un programma. «Il dott. Rossi arriva l’1/3 alle 9:30» deve diventare «il dottor Rossi arriva il primo marzo alle nove e trenta»: «dott.» si scioglie in «dottore» (anzi, «dottor» davanti al nome), «1/3» è una data e non una frazione, «9:30» è un orario. Sembra banale finché non arrivano le ambiguità: «1901» si legge «millenovecentouno» se è un anno, ma «uno nove zero uno» se è un interno telefonico. E c’è di peggio: «ancora» si pronuncia àncora se è l’attrezzo della nave e ancóra se vuol dire «di nuovo»; sulla pagina sono identiche, e per scegliere bisogna capire che mestiere fa la parola nella frase. È lo stesso problema di analisi grammaticale di POS tagging ed entità.
E sbagliare qui non fa rumore. Se il programma legge «1901» come «millenovecentodieci», chi ascolta sente un anno plausibile, detto bene, e non ha il foglio davanti per accorgersi che era un altro. Un errore che nessuno può correggere pesa più di uno che si sente subito: per questo il lavoro si fa ancora a mano, regola per regola, invece di darlo a una rete.
Formalmente la normalizzazione è una trasduzione testo→testo: mappare le classi semiotiche (cardinali, ordinali, date, orari, valute, unità di misura, sigle) nella loro forma pronunciabile. Storicamente si fa con regole e trasduttori a stati finiti pesati (WFST), che restano lo standard nei sistemi di produzione; gli approcci seq2seq neurali sbagliano poco in media e male nei casi che contano. Sproat e Jaitly lo misurano su un grande corpus allineato: l’accuratezza complessiva è alta, ma gli errori residui sono quelli che loro stessi chiamano «sciocchi», concentrati nelle classi semiotiche, come una cifra cambiata in una data o un orario letto come un altro, cioè un testo scorrevole che dice un’altra cosa e che chi ascolta non ha modo di accorgersi di aver sentito male [SJ16]. Il rimedio che propongono è ibrido: la rete propone, e un filtro a stati finiti scritto a mano, che elenca le letture ammissibili di una classe (loro lo scrivono per misure e valute), scarta le proposte impossibili; esteso agli anni, farebbe sì che «1901» possa diventare un anno o un numero di interno ma mai millenovecentodieci. Il secondo fronte sono gli omografi eterofoni: àncora/ancóra, sùbito/subìto, lèggere/leggère. La grafia non basta: serve la categoria grammaticale, cioè il POS tagging visto nel capitolo NLP, o un contesto più ampio. La normalizzazione è la parte meno glamour della pipeline e una delle più costose da fare bene: è qui, non nella rete, che un sistema commerciale si gioca le figuracce.
Dal grafema al fonema#
I fonemi della panoramica tornano qui al centro, perché per la sintesi bisogna passare dalle lettere scritte (i grafemi) ai suoni, e le due cose non si corrispondono una a una.
«Pane» e «cane» differiscono per un solo suono iniziale, e infatti sono due parole diverse: quel suono minimo che, cambiando, cambia il significato è il fonema.
Il contrario si sente con la bocca, ed è la prova della coarticolazione nella panoramica: pronuncia «un cane», poi «un pane». La «n» non è la stessa (nel secondo caso le labbra si chiudono già per la «p» che arriva), eppure la parola non cambia. Sono due modi di dire lo stesso fonema, e a sceglierli non sei tu: è il suono che viene dopo.
Le lettere, poi, non bastano a rappresentare i fonemi: la «c» di casa e la «c» di ciao sono la stessa lettera ma due suoni completamente diversi. Per scriverli senza ambiguità i linguisti usano l’alfabeto fonetico internazionale (IPA), dove ogni simbolo è un suono e uno solo, e si scrive fra due barrette: /k/ per la c di casa, /tʃ/ per la c di ciao. Il passaggio automatico dalle lettere ai suoni ha una sigla, G2P, dall’inglese grapheme-to-phoneme, cioè «dal grafema al fonema».
L’italiano è quasi «trasparente» (quasi sempre si legge come si scrive, con poche regole) ma l’inglese no: though, tough e through finiscono tutte in -ough e si pronunciano in tre modi che non si somigliano affatto.
E i fonemi giusti non bastano ancora: prova a leggere ad alta voce l’elenco della spesa e poi una battuta di teatro. Le parole sono chiare in entrambi i casi, ma cambiano la melodia della frase, le pause, la durata delle sillabe. Questa musica si chiama prosodia, ed è la differenza tra leggere e recitare: la parte più difficile da insegnare a una macchina.
Il fonema è l’unità sonora minima con valore distintivo: due suoni sono fonemi diversi se esiste una coppia minima che li oppone (/p/ e /k/ in pane/cane). Le varianti che non cambiano mai il significato sono allofoni dello stesso fonema: la nasale di «un cane» e quella di «un pane» (l’esempio di coarticolazione della panoramica del capitolo) suonano diverse, e non sono nemmeno intercambiabili (le sceglie il contesto: velare davanti a velare, bilabiale davanti a bilabiale), ma scambiarle non cambierebbe la parola, solo la pronuncia. La conversione grafema→fonema (G2P, grapheme-to-phoneme) è quasi deterministica per le ortografie trasparenti come l’italiano (poche regole contestuali: ⟨c⟩ → /tʃ/ davanti a ⟨e, i⟩, /k/ altrove; restano imprevedibili l’apertura delle vocali medie e la posizione dell’accento, che l’ortografia non marca), mentre per l’inglese è un problema di apprendimento a tutti gli effetti, spesso risolto con un dizionario di pronuncia più un modello seq2seq per le parole fuori lista. Sopra i fonemi c’è la prosodia: il contorno della frequenza fondamentale \(F_0\) (l’intonazione), le durate dei foni, le pause. Nei sistemi end-to-end moderni la prosodia non è annotata: il modello la assorbe implicitamente dai dati, ed è lì che si gioca la naturalezza.
Da robot a persona: le generazioni della sintesi#
La prima generazione automatizza proprio il Voder: al posto delle dita dell’operatrice ci sono regole scritte a mano, una per ogni suono da produrre. Si chiama sintesi per formanti, dal nome della cosa che imita: quando parliamo, la gola e la bocca cambiano forma e fanno risuonare più forte certe frequenze e non altre, ed è da quelle poche frequenze esaltate (le formanti) che l’orecchio distingue una «a» da una «i». La macchina non registra nessuna voce: fabbrica quelle risonanze da zero, con generatori di suono e filtri, e la ricetta gliela scrive una persona. Si capisce benissimo, non si stanca mai, e non somiglia a nessuno: è la voce robotica per definizione.
Le ricette migliori le scrisse Dennis Klatt, al MIT, e per scriverle prese a modello la propria voce: la misurò, e mise nelle regole le frequenze che ci aveva trovato. Non è una registrazione (nessun pezzo di Klatt finisce nella macchina) ma il risultato gli somiglia, ed è la voce che tutti conoscono come Perfect Paul. Quelle regole, prese in licenza, finirono nel DECtalk (1984), il sintetizzatore più famoso di quella generazione; e dallo stesso suo lavoro derivava anche un apparecchio di un’altra ditta, il CallText 5010 di Speech Plus, che ha una voce della stessa famiglia. Fu quest’ultimo a entrare nella storia, perché era quello di Stephen Hawking.
Hawking era il fisico più famoso del mondo, e una malattia degenerativa dei nervi gli aveva tolto prima l’uso delle gambe, poi delle mani, infine la voce. Dalla metà degli anni Ottanta parlò attraverso quella macchina: sceglieva le parole una a una su uno schermo, comandando un interruttore con i muscoli che poteva ancora muovere, e il sintetizzatore le leggeva ad alta voce. Quando negli anni arrivarono voci molto migliori rifiutò sempre di cambiarla: «La tengo perché non ho ancora sentito una voce che mi piaccia di più, e perché ormai mi ci identifico». Quel timbro metallico era diventato la sua voce. Un gruppo di tecnici lavorò per anni a emularne l’elettronica ormai introvabile, e il 26 gennaio 2018, sette settimane scarse prima che morisse, gli portarono a casa l’emulatore su un Raspberry Pi, un computer grande come un mazzo di carte, e glielo montarono sulla carrozzina. Hawking scrisse: «I love it». Klatt, l’uomo che gli aveva prestato la voce, era morto trent’anni prima, dopo che un tumore alla tiroide gli aveva tolto la propria.
La seconda generazione, dominante dagli anni Novanta, è la sintesi concatenativa: si registrano ore di parlato di uno speaker professionista, si tagliano in frammenti e si ricuciono i pezzi giusti per comporre la frase richiesta (unit selection: tra i tanti ritagli disponibili si sceglie la sequenza che si incolla meglio). Sulle frasi facili suona naturale (è vera voce umana) ma le giunture si sentono, e il sistema è rigido: per cambiare stile, o anche solo correggere un’intonazione, bisogna tornare in studio di registrazione.
Fra la seconda e la terza c’è una generazione spesso dimenticata, che per quindici anni ha tenuto il campo accanto alla concatenativa: la sintesi parametrica statistica. Un modello impara dalle registrazioni la distribuzione dei parametri acustici di ciascun fonema nel suo contesto (la forma dello spettro, che decide timbro e vocale; l’altezza della voce, \(F_0\); le durate), e un vocoder a regole li rende udibili: prima con i modelli di Markov nascosti della panoramica [ZTB09], dal 2013 con reti neurali profonde [ZSS13]. Suonava più liscia e più ovattata della concatenativa, ma si ritoccava cambiando un numero invece che tornando in studio. Nei test d’ascolto con cui la confrontano gli autori di Tacotron 2 (voti medi da 1 a 5 che più avanti prenderanno il nome di MOS) prende \(3{,}49\) contro il \(4{,}17\) della concatenativa. Le reti neurali entrano nella sintesi da lì; la generazione che le mette al centro comincia nel 2016 con WaveNet [vdODZ+16], che fabbrica l’onda sonora un campione alla volta, sedicimila al secondo, con una rete sola e una qualità fino ad allora irraggiungibile. Era però lentissima, e per aggirare la lentezza nel giro di due anni la ricetta si assesta nella forma a due stadi che è ancora quella di oggi.
Il TTS neurale, in due stadi#
Delle quattro tappe di Fig. 24.5, le prime due (sciogliere il testo e tradurlo in suoni) sono preparazione; le ultime due sono le due reti neurali vere e proprie, ed è a loro che si dà il nome di stadi. Il primo stadio prende il testo, ormai sciolto e tradotto in suoni, e ne disegna il mel-spettrogramma. Il secondo prende quell’immagine e ne fabbrica l’onda che esce dall’altoparlante. Sono due mestieri talmente diversi che quasi sempre li fanno due reti separate, addestrate una indipendentemente dall’altra.
Primo stadio: dal testo al mel-spettrogramma#
Il modello di riferimento è Tacotron 2 [SPW+18], di Google, e la macchina che c’è dentro l’abbiamo già vista due volte: è la stessa del traduttore automatico del capitolo sul linguaggio naturale e dei riconoscitori con attenzione, quella in cui una parte della rete legge e un’altra scrive, con l’attenzione che si sposta sul punto giusto (in gergo, un encoder-decoder con attenzione). Cambia solo cosa scrive in uscita.
Tacotron 2 è l’interprete dei riconoscitori con attenzione, girato dall’altra parte: legge tutta la frase scritta, poi la ridice, e a ogni passo la sua attenzione torna sul punto giusto del testo di partenza. Solo che non scrive parole: scrive colonne di mel-spettrogramma, un fotogramma sonoro alla volta, e l’attenzione scorre sul testo come il dito di chi impara a leggere segue il rigo. Se una vocale va tenuta a lungo, l’attenzione resta ferma lì per più colonne. Il risultato si avvicina molto a una registrazione, ma messo a confronto diretto con lei perde ancora: chi ascolta le due versioni della stessa frase preferisce quella vera, perché ogni tanto il modello sbaglia una pronuncia. E il metodo ha il difetto di chi scrive una lettera alla volta: ogni tanto il dito scivola, e il modello salta una parola o balbetta una sillaba due volte. È lo stesso difetto dei riconoscitori con attenzione, con la freccia girata dall’altra parte.
FastSpeech 2 [RHT+21] rovescia il metodo: prima decide quanto dura ogni suono, poi riempie tutte le colonne in un colpo solo, in parallelo. Come faccia a sapere quanto dura un suono è una domanda giusta, e la risposta è che gliel’hanno insegnato: prima di addestrarlo, un altro programma passa su tutte le registrazioni e segna dove comincia e dove finisce ogni suono, così il modello ha degli esempi da cui imparare. Quel programma, per inciso, è un sistema della generazione precedente, uno di quelli che hanno retto il riconoscimento vocale per trent’anni: il metodo nuovo si appoggia al vecchio per la parte che non sa fare da sé (finché, con la famiglia VITS, il modello non ha imparato a segnare da sé dove comincia ogni suono). Il risultato è una sintesi decine di volte più veloce, quasi cinquanta nelle misure degli autori, e senza balbuzie. In cambio, la melodia della frase va decisa in anticipo invece di venir fuori strada facendo: è per questo che FastSpeech 2 si porta dietro anche un pezzo che stima l’intonazione e uno che stima il volume, colonna per colonna. È la scelta tipica quando la voce deve rispondere all’istante.
Tacotron 2 è un seq2seq autoregressivo: un encoder (convoluzioni + BiLSTM) trasforma la sequenza di caratteri o fonemi \(c = (c_1, \dots, c_n)\) negli stati \(\mathbf{h}_1, \dots, \mathbf{h}_n\); un decoder genera il mel-spettrogramma \(\mathbf{M} = (\mathbf{m}_1, \dots, \mathbf{m}_T)\), con \(\mathbf{m}_t \in \mathbb{R}^{80}\) (80 bande mel), una colonna alla volta:
dove il testo in ingresso si chiama \(c\) e non \(\mathbf{x}\) perché in questo capitolo \(\mathbf{x}\) è già il vettore acustico di un frame: qui la freccia va nell’altro verso, e all’ingresso c’è il testo. Come regressore la rete è autoregressiva ma non probabilistica: nessuna densità da massimizzare, la loss è la somma degli errori quadratici sui frame mel prima e dopo la post-net (cinque convoluzioni che aggiungono un residuo alla predizione), più un predittore di stop, una sigmoide che chiude la frase al primo frame in cui supera \(0{,}5\). Deterministica però non è: il dropout con probabilità \(0{,}5\) sugli strati della pre-net resta acceso anche in inferenza, ed è la sorgente della variazione fra due letture della stessa frase [SPW+18]. Ogni passo è condizionato da un vettore di contesto calcolato con l’attenzione di Bahdanau vista nella traduzione (in variante location-sensitive, che tiene traccia di dove ha già guardato per favorire un avanzamento monotono sul testo). Nei test d’ascolto degli autori il sistema completo raggiunge un voto medio che l’intervallo di confidenza non separa da quello del parlato registrato da professionisti; nel confronto diretto sulla stessa frase, però, gli ascoltatori preferiscono ancora la registrazione vera, in modo statisticamente significativo. Le due misure non si contraddicono: dicono che la media dei voti è uno strumento più grossolano del confronto appaiato.
FastSpeech 2 elimina l’autoregressione con un variance adaptor a tre rami (durate, pitch, energia): il predittore di durate stima quanti frame occupa ciascun fonema e il length regulator replica gli stati dell’encoder di conseguenza (\(T = \sum_i d_i\), dove \(d_i\) è il numero di frame assegnati al fonema \(i\)-esimo), mentre gli altri due rami stimano pitch ed energia per frame; il mel si genera poi in parallelo. Niente attenzione da far convergere: spariscono salti e ripetizioni, e la sintesi dell’onda, vocoder compreso, diventa \(47{,}8\) volte più veloce di quella del Transformer TTS autoregressivo con cui gli autori la confrontano (fattore di tempo reale, cioè secondi di calcolo per secondo di audio, \(1{,}95 \cdot 10^{-2}\) contro \(9{,}32 \cdot 10^{-1}\), sulla stessa GPU e con lo stesso vocoder [RHT+21]).
La frase «niente attenzione da far convergere» nasconde però un passaggio. Il predittore di durate è addestrato in modo supervisionato, quindi gli servono le durate vere di ogni fonema; ma un corpus TTS è fatto di coppie testo-audio, non di segmentazioni fonema per fonema, ed è la stessa impraticabilità che si è vista dal lato del riconoscimento. Le etichette gliele fornisce un allineatore forzato esterno (nel paper il Montreal Forced Aligner, costruito sopra un sistema HMM della generazione precedente), applicato ai dati prima dell’addestramento. L’allineamento, insomma, non sparisce: esce dal modello e diventa un passo di preparazione dei dati, comprato da un impianto che il modello dichiara superato. La scelta è deliberata (gli autori adottano l’allineatore esterno al posto del maestro autoregressivo di FastSpeech 1, per avere allineamenti più accurati) ma sanno bene che resta un debito: in nota, nella stessa pagina, scrivono che lavoreranno a una sintesi non autoregressiva senza modelli di allineamento esterni.
Il debito lo salda VITS [KKS21], che fonde i due stadi in un modello generativo solo: un autoencoder variazionale condizionato dal testo (la famiglia del capitolo sui modelli latenti), con un normalizing flow a dare forma alla distribuzione a priori e un generatore del tipo di HiFi-GAN come decoder, addestrato sull’ELBO più le perdite avversarie. L’allineamento fra fonemi e frame si stima dentro l’addestramento, con una ricerca dell’allineamento monotono più probabile (Monotonic Alignment Search), e un predittore di durate stocastico dà a ogni lettura un ritmo un po” diverso. Nella prova degli autori, su LJSpeech, prende \(4{,}43\) di MOS contro \(4{,}46\) del parlato registrato.
Secondo stadio: il vocoder#
Il vocoder è il modello che prende l’immagine a bande e ne fabbrica l’onda vera e propria, quella che si può ascoltare. Il nome chiude un cerchio: vocoder sta per voice coder, e ai Bell Labs indicava la macchina con cui Homer Dudley faceva due cose opposte. Prima smontava una voce nelle sue poche misure essenziali, perché quelle poche misure occupano sul cavo del telefono molto meno spazio della voce intera e quindi costano meno da spedire; poi, all’altro capo, dalle misure rimontava una voce. Il Voder era la metà «rimonta» di quel lavoro, messa in vetrina all’Esposizione universale con una tastiera al posto del cavo.
Il mel-spettrogramma è il progetto della casa; il vocoder è l’impresa che la costruisce mattone su mattone. WaveNet (l’abbiamo già incontrata in Generare suono e musica, quando generava musica) lavora come un amanuense: scrive l’onda un campione alla volta, sedicimila al secondo, decidendo ognuno sulla base di quelli che ha già scritto. Qualità altissima, ma una lentezza proverbiale: nella versione a ventiquattromila campioni al secondo, sulla scheda grafica di allora, un secondo di parlato chiedeva più di due minuti di calcolo. HiFi-GAN risolve il problema con una gara fra falsario ed esperti d’arte. È l’idea delle GAN, le reti avversarie generative, a cui più avanti è dedicato un capitolo intero: qui basta il gioco. Una rete-falsario impara a produrre l’onda intera in un colpo solo, e delle reti-esperto provano a distinguere l’audio vero da quello fabbricato. Gli esperti sono parecchi, perché uno solo si farebbe fregare: qualcuno ascolta l’onda in tutto il suo dettaglio, qualcuno sfocata, a grana più grossa, e qualcuno la ascolta a intervalli regolari, per cogliere le ripetizioni che stanno sotto una vocale. Un difetto che sfugge all’uno salta all’orecchio dell’altro, e il falsario deve ingannarli tutti. C’è poi un controllo in più: dall’onda appena fabbricata si ridisegna l’immagine a bande e la si confronta con quella di partenza, così il falsario non può cavarsela con una voce bellissima che dice un’altra frase. Falsario ed esperti si allenano a vicenda finché il falso non si distingue più.
Risultato: qualità paragonabile a WaveNet, ma molto più veloce del tempo reale, che vuol dire questo: per fabbricare un secondo di parlato ci mette molto meno di un secondo, tanto che in un secondo di calcolo ne produce minuti. Il conto gira su una scheda grafica, che qui non disegna niente: fa migliaia di moltiplicazioni insieme.
WaveNet [vdODZ+16] è la stessa rete di Generare suono e musica; qui compare condizionata sul mel e con i campioni chiamati \(a\), perché in questo capitolo \(\mathbf{x}\) è già il vettore acustico di un frame. Modella l’onda in modo autoregressivo:
dove \(\mathbf{a}\) è l’onda intera, \(a_t\) il campione audio al passo \(t\) (quantizzato su 256 livelli con compansione \(\mu\)-law nella versione originale; il vocoder di Tacotron 2 sostituisce la softmax sui 256 livelli con una mistura di dieci distribuzioni logistiche su campioni a 16 bit, come Parallel WaveNet [SPW+18]), \(T'\) è il numero di campioni dell’onda (da non confondere con il \(T\) delle colonne di mel: qui i campioni sono centinaia di volte più numerosi) e \(\mathbf{M}\) è il mel-spettrogramma che condiziona la generazione. L’architettura usa convoluzioni causali dilatate, con dilatazione che raddoppia a ogni strato fino a un tetto e poi riparte da uno: dentro un ciclo il campo recettivo cresce esponenzialmente, e i cicli impilati lo portano a un paio di centinaia di millisecondi. Il limite è strutturale: \(T'\) passi sequenziali, cioè ventiquattromila per ogni secondo di audio alla frequenza di campionamento del paper di Tacotron 2 (24 kHz; il corpus pubblico LJSpeech è a 22.050 Hz). Su una GPU P100 la WaveNet autoregressiva ne genera \(172\) al secondo, cioè circa centoquaranta secondi di calcolo per un secondo di voce [vdOLB+18]. HiFi-GAN [KKB20] sostituisce l’autoregressione con il gioco avversario del capitolo sulle GAN, con una differenza nella perdita: al posto dell’entropia incrociata binaria del GAN originale usa i minimi quadrati (LSGAN), che non lasciano spegnere i gradienti. Il generatore è una pila di convoluzioni trasposte che sovracampiona il mel fino alla frequenza dell’onda; i discriminatori sono due famiglie: multi-period, che riorganizzano l’onda per periodi diversi per coglierne le periodicità, e multi-scale, che la ascoltano a risoluzioni diverse. Alla loss avversaria si sommano una feature matching loss e una loss L1 tra i mel-spettrogrammi dell’audio vero e di quello generato, che stabilizzano l’addestramento. La differenza di costo non è quantitativa ma strutturale: WaveNet paga \(T'\) passi sequenziali, HiFi-GAN uno solo, e la velocità misurata dagli autori sta due ordini di grandezza sopra il tempo reale su una singola GPU, con naturalezza percepita alla pari dei vocoder autoregressivi.
Quanto è naturale? L’orecchio come giudice#
Per il riconoscimento avevamo il WER, il tasso di errore sulle parole: si confronta la trascrizione con quella giusta e si contano le correzioni che servono. Per la sintesi una «trascrizione giusta» non esiste: la stessa frase si può pronunciare bene in mille modi diversi, e nessuno di quei modi è più vero degli altri.
Come si giudica un doppiatore? Lo si ascolta. Il MOS (mean opinion score, punteggio medio di opinione) è esattamente questo: si fa ascoltare la stessa frase a un gruppo di persone e si chiede un voto da 1 («pessima») a 5 («eccellente»); il MOS è la media. Il voto da solo, però, non dice niente: per leggerlo serve il termine di paragone, cioè quanto hanno preso, nella stessa prova, delle registrazioni di voce umana vera, infilate fra le altre senza dirlo a nessuno. Se il sistema prende 4,2 e le registrazioni, nella stessa prova, 4,5, la voce sintetica sta tre decimi sotto quella vera. Se invece le registrazioni prendono 3,9, lo stesso 4,2 vuol dire che la voce sintetica è piaciuta più di quella vera.
C’è una ragione precisa per cui quel paragone deve stare dentro la stessa prova. Trenta persone in una stanza con le cuffie giudicano in un modo, trenta persone a casa propria in un altro, e lo stesso sistema può prendere 4,5 in uno studio e 3,7 in un altro senza essere cambiato di una virgola. Confrontare il MOS di un articolo con quello di un altro, quindi, non dice niente: è come confrontare i voti di due professori diversi. Lo stesso tremolio, in piccolo, c’è anche dentro una prova sola: cambia il gruppo di ascoltatori e i voti si spostano di qualche centesimo. Tre decimi sono un divario; tre centesimi sono rumore. L’alternativa più affidabile è il test A/B: due versioni della stessa frase, «quale preferisci?». Chiedere quale delle due si preferisce è una domanda più facile, e più fine, che chiedere un voto in assoluto. Un’altra prova costa poco: si fa trascrivere la voce sintetica a un riconoscitore e si guarda se torna il testo di partenza. Non dice se la voce è bella, ma scopre subito chi salta o ripete le parole. Non esiste comunque una formula che sostituisca le orecchie: la naturalezza è un giudizio umano, e due onde matematicamente diversissime possono suonare entrambe perfette.
Il MOS è la media dei giudizi su scala 1–5, \(\mathrm{MOS} = \frac{1}{N}\sum_{i=1}^{N} s_i\), dove \(s_i\) è il voto dell’ascoltatore \(i\)-esimo e \(N\) il numero di ascoltatori (non le parole del riferimento, che è il mestiere che \(N\) faceva nel WER); si riporta con l’intervallo di confidenza al 95% e richiede un protocollo rigoroso (frasi fuori dal training, ascoltatori madrelingua, cuffie, campioni mescolati con parlato reale come ancoraggio). Le alternative sono i test di preferenza A/B e ABX. Due debolezze strutturali: il MOS è relativo al gruppo di ascoltatori e alle condizioni della prova, quindi i numeri di studi diversi non sono confrontabili. Nel paper di Tacotron 2 il parlato umano registrato prende \(4{,}58\), in quello di FastSpeech 2 tre anni dopo prende \(4{,}30\): ventotto centesimi fra due righe che portano la stessa etichetta, e dietro le quali c’è tutto un altro esperimento, una professionista registrata in studio contro il corpus pubblico LJSpeech, altri ascoltatori, un altro protocollo. Lo stesso corpus non aiuta: il parlato registrato di LJSpeech, \(4{,}30\) in FastSpeech 2, prende \(4{,}46\) nel paper di VITS [KKS21]. E nemmeno due numeri della stessa tabella si leggono per differenza se i loro intervalli di confidenza si sovrappongono, come succede fra Tacotron 2 e il parlato registrato; e le metriche oggettive (come la distorsione mel-cepstrale dal riferimento) correlano male con la qualità percepita, perché il TTS è un problema uno-a-molti e penalizzano pronunce legittime solo perché diverse. Per separare due sistemi vicini si usa il confronto appaiato: il CMOS (comparative MOS) chiede, per la stessa frase resa dai due, un voto da \(-3\) a \(+3\), ed è la misura con cui FastSpeech 2 valuta le proprie scelte di progetto e VALL-E si confronta con gli altri. Un riconoscitore, poi, torna utile anche qui: si trascrive il parlato sintetico e si calcola il WER rispetto al testo di partenza, che misura l’intelligibilità e non la naturalezza, e scopre i sistemi che saltano o ripetono parole. VALL-E lo riporta con un HuBERT-Large rifinito con una testa CTC, senza modello di linguaggio, accanto a una somiglianza del parlante calcolata da un modello di verifica [WCW+23]. La naturalezza, però, passa ancora dall’orecchio umano.
La voce di chi? Cloni, truffe e consenso#
C’è un rovescio della medaglia, ed è bene guardarlo senza allarmismi ma senza sconti. Gli stessi modelli, addestrati sulla voce di una persona specifica, producono un clone vocale. La quantità di registrazione che serve è crollata da ore a secondi da quando la voce non si riaddestra più ma si condiziona: un secondo modello, addestrato a riconoscere chi parla, ricava da un campione di pochi secondi un vettore che descrive quel timbro, e il sintetizzatore lo riceve come riceve il testo [JZW+18]. Il passo successivo viene dalla strada dei token di Generare suono e musica. VALL-E [WCW+23] tratta la sintesi come un modello di linguaggio che, invece di parole, scrive i token di un codec neurale, EnCodec, quello di Codec neurali. Riceve i fonemi del testo e tre secondi di una voce mai sentita, già tradotti in token, e continua la fila nella stessa voce, con lo stesso ambiente acustico e la stessa emozione: è la continuazione di AudioLM, guidata da un testo. (Ogni istante, nel codec, è una pila di otto token: il primo livello lo scrive un Transformer autoregressivo, un istante dopo l’altro; gli altri sette li scrive un secondo Transformer, un livello alla volta ma su tutti gli istanti in parallelo.) Addestrato su sessantamila ore di audiolibri inglesi, si porta dietro due difetti già incontrati. I fonemi di quelle ore non li ha scritti nessuno: li ha ricavati dall’audio un riconoscitore della vecchia catena, un DNN-HMM, con i suoi errori. E come ogni modello che scrive rileggendosi, a volte salta o ripete una parola, come dichiarano gli stessi autori.
Le truffe sono già successe. Nel 2019 il Wall Street Journal raccontò questa: l’amministratore delegato di un’azienda energetica britannica riceve una telefonata, e dall’altra parte c’è la voce del capo della casa madre tedesca, che gli chiede di pagare con urgenza un fornitore ungherese. Riconosce la voce e trasferisce 220.000 euro. La voce era fabbricata. Da allora lo schema si è ripetuto in tutte le taglie, fino alle telefonate che imitano la voce di un familiare in difficoltà.
La questione di fondo è il consenso. La voce identifica una persona, e quando la si tratta proprio per riconoscere chi parla la legge europea sulla protezione dei dati la conta fra i dati biometrici, come un volto o un’impronta digitale; ed è anche un pezzo della sua identità: Hawking, che rifiutò per trent’anni voci «migliori» della sua, lo sapeva bene. Clonarla senza permesso vuol dire far parlare qualcuno senza che l’abbia deciso.
Una contromisura tecnica è il watermarking, una filigrana inudibile incorporata nell’onda sintetica per riconoscerla dopo, come il filo di sicurezza in una banconota. Funziona però soltanto sulle voci fabbricate da chi la applica, e chi vuole può provare a toglierla. Per questo la difesa che funziona meglio non è tecnica, ed è vecchia come il telefono: se una voce chiede soldi o dati con urgenza, si riattacca e si richiama il numero che si conosce. E una parola d’ordine concordata in famiglia costa niente e non si clona.
Vale anche il rovescio del rovescio: la stessa tecnologia restituisce la voce a chi la sta perdendo per una malattia neurodegenerativa, registrandola prima che scompaia. Come sempre, lo strumento non sceglie l’uso.
In pratica: sintetizzare una frase#
Tutto questo si può anche, semplicemente, ascoltare. torchaudio tiene pronti
i due stadi già addestrati, e bastano una decina di righe per metterli in fila:
qui Tacotron 2 disegna l’immagine a bande, e un vocoder di nome WaveRNN (un
parente alleggerito di WaveNet, che scrive anche lui un campione alla volta) la
trasforma in onda. La frase da pronunciare è la traduzione inglese di «il gatto
nero salta sul
muro», che ci accompagna dal capitolo sul linguaggio naturale.
import torch
import torchaudio
import soundfile as sf

# bundle preaddestrato: Tacotron 2 (da caratteri) + vocoder WaveRNN,
# voce inglese femminile (registrazioni LJSpeech)
bundle = torchaudio.pipelines.TACOTRON2_WAVERNN_CHAR_LJSPEECH

processor = bundle.get_text_processor()   # testo -> ID dei caratteri
tacotron2 = bundle.get_tacotron2()        # caratteri -> mel-spettrogramma
vocoder = bundle.get_vocoder()            # mel-spettrogramma -> onda

testo = "The black cat jumps on the wall."

# inference_mode: stiamo solo usando i modelli, non addestrandoli,
# quindi PyTorch può risparmiare memoria e tempo
with torch.inference_mode():
    token, lunghezze = processor(testo)
    mel, mel_len, _ = tacotron2.infer(token, lunghezze)   # il primo stadio
    onda, onda_len = vocoder(mel, mel_len)                # il secondo

# onda contiene un gruppo di frasi: qui ce n'è una sola, ed è la prima
sf.write("gatto.wav", onda[0].cpu().numpy(), vocoder.sample_rate)
print(onda.shape, vocoder.sample_rate)  # es. torch.Size([1, ...]) e 22050
In gatto.wav ci sono un paio di secondi di voce sintetica, e vanno
ascoltati: nessuna descrizione scritta dice quello che dicono.
Qualche parola sul codice. Un bundle è la confezione già pronta: i due modelli e i numeri che hanno imparato (i pesi), scaricati insieme. Quei pesi sono addestrati su una voce inglese, quindi una frase italiana la leggerà con un buffo accento anglofono.
Il numero stampato in fondo, 22.050, è la frequenza di campionamento della voce su cui il modello è addestrato, e di frequenze se ne sono incontrate tre: 16.000 Hz per il riconoscimento (e per Whisper), 24.000 Hz per Tacotron 2 nell’articolo che lo presenta, e 22.050 Hz per le registrazioni LJSpeech di questo modello. Sono scelte, non incoerenze: più campioni al secondo danno più acuti e più dati da trattare. Quello che conta è non mescolarle: un modello addestrato a una frequenza va usato a quella.
Per l’italiano esistono modelli aperti (cioè scaricabili e usabili da chiunque, pesi compresi) addestrati su registrazioni nostrane, in particolare della famiglia VITS [KKS21], che fonde i due stadi in un modello solo, addestrato tutto insieme dal testo all’onda, e si segna da sé dove comincia e dove finisce ogni suono.
Il cerchio si chiude qui: sappiamo trasformare la voce in testo e il testo in voce. Messe in fila (ASR, un modello che decide cosa rispondere, TTS) sono lo scheletro di un assistente vocale: la catena che si mette in moto quando chiedi «che ore sono?» al telefono, e una voce sintetica ti risponde.
Da ricordare
La sintesi vocale rifà la strada del riconoscimento al contrario: testo → si sciolgono numeri e sigle → si scrivono i suoni → si disegna l’immagine a bande del suono → si costruisce l’onda. Quell’immagine a bande (il mel-spettrogramma) è il punto in cui i due viaggi si toccano, ma calcolata con finestre diverse dalle due parti: quella che esce da un sintetizzatore non si passa a un riconoscitore.
Attenzione al modello acustico, che nei due viaggi fa mestieri opposti: all’andata ascolta i suoni e dice quali sono, al ritorno legge il testo e decide quali suoni produrre. Stesso nome, freccia rovesciata.
Sciogliere il testo (la normalizzazione) è il lavoro meno appariscente e quello dove si sbaglia di più: «1901» è «millenovecentouno» o «uno nove zero uno» a seconda di cosa sia. Poi si passa dalle lettere ai suoni veri, i fonemi, e il passaggio si chiama G2P: la c di casa e la c di ciao sono la stessa lettera e due fonemi diversi. E sopra tutto c’è la prosodia, la musica della frase: pause, durate, intonazione.
Le generazioni delle macchine parlanti: quella per formanti (fabbrica i suoni da zero seguendo regole, ed è la voce robotica di Hawking), quella concatenativa (ritagli di voce vera ricuciti insieme), quella neurale, di oggi; in mezzo, per quindici anni, quella parametrica, che impara dalle registrazioni i numeri di ogni suono.
Oggi il lavoro è diviso in due: un modello scrive l’immagine del suono (Tacotron 2 una colonna alla volta, FastSpeech 2 tutte insieme e senza balbettare) e un secondo modello, il vocoder, la trasforma in onda (WaveNet un campione alla volta e lentissimo, HiFi-GAN tutto in un colpo e velocissimo).
Se la qualità è buona lo decide l’orecchio: si fa votare la gente (MOS) o le si chiede quale delle due versioni preferisce (test A/B). Un voto da solo non dice niente: si legge accanto a quanto hanno preso, nella stessa prova, delle registrazioni di voce vera. E nessun conto automatico basta, perché la stessa frase si può dire bene in mille modi diversi.
Clonare una voce è facile e serve già alle truffe. La voce è un pezzo di identità: il permesso di chi parla è il minimo, e al telefono la difesa che funziona è riattaccare e richiamare il numero vero.
Da ricordare
Il TTS percorre la pipeline dell’ASR al contrario: testo → normalizzazione → fonemi → mel-spettrogramma → onda. Il mel-spettrogramma è il punto d’incontro dei due viaggi, ma non è lo stesso tensore: finestre e passi sono diversi dalle due parti (10 ms nell’ASR, 12,5 ms in Tacotron 2).
La normalizzazione scioglie numeri, date e sigle («1901» → «millenovecentouno») e disambigua gli omografi (àncora/ancóra) col contesto; il G2P converte i grafemi in fonemi (la c di casa è /k/, quella di ciao è /tʃ/): facile in italiano, difficile in inglese. Sopra tutto c’è la prosodia: intonazione, durate, pause.
Le generazioni: sintesi per formanti (robotica: le regole di Klatt, il DECtalk, e il CallText 5010 che dava la voce a Hawking), concatenativa (ritagli di voce vera ricuciti), neurale; in mezzo la parametrica statistica, con HMM e poi reti profonde a stimare i parametri acustici.
Il TTS neurale lavora in due stadi: un modello acustico testo→mel (Tacotron 2, seq2seq con attenzione; FastSpeech 2, parallelo e più stabile, ma con le durate fornite da un allineatore forzato esterno, un debito che VITS salda stimando l’allineamento dentro un modello unico) e un vocoder mel→onda (WaveNet, autoregressivo e lento; HiFi-GAN, avversario e di ordini di grandezza più veloce).
La naturalezza si misura con l’orecchio: MOS, test A/B, CMOS; nessuna metrica automatica è pienamente affidabile, perché la sintesi è un problema uno-a-molti. Il MOS non si confronta fra prove diverse, nemmeno sullo stesso corpus, e dentro la stessa prova due numeri con intervalli di confidenza sovrapposti non si leggono per differenza. Il WER del parlato sintetico, trascritto da un riconoscitore, ne misura l’intelligibilità.
La clonazione vocale è già usata nelle truffe. La voce identifica chi parla, e trattata per riconoscerlo è un dato biometrico per la legge europea; il consenso è il minimo, e il watermarking riconosce soltanto le voci di chi lo applica.
A decidere se una voce sintetica è buona resta l’orecchio, e non è una particolarità della sintesi: quando le risposte accettabili sono molte, nessun conto automatico dice quale valga, e da qui in avanti è la regola. È la condizione di chi fabbrica dati nuovi invece di riconoscerli, ed è il terreno dei capitoli che seguono. Il primo, il capitolo sui modelli latenti, parte da un problema più vecchio, i fattori nascosti dietro dati che si somigliano, e ritrova fra le sue macchine la clessidra dei codec neurali, l’autoencoder che stringe il suono in un pugno di numeri: se le risposte accettabili sono molte, basta imparare a pescare a caso un pugno di numeri nuovo e lasciare che il decoder lo trasformi in un dato mai visto. Quello dopo, il capitolo sulle GAN, sceglie la strada opposta e mette un giudice; ci si arriva con un pezzo già in mano, la gara fra falsario ed esperti che rende HiFi-GAN capace di scrivere l’onda in un colpo solo, e quel capitolo la smonta per mostrare a quali condizioni un duello del genere si tiene in piedi.