


Privacy e robustezza: dati protetti e attacchi avversari#
Il nome completo di una persona reale, il suo indirizzo, un numero di telefono, un’email: GPT-2, il modello linguistico di OpenAI addestrato su un’enorme raccolta di testi del web, li restituiva parola per parola, e nei dati di addestramento comparivano in un documento solo, da cui il modello li aveva memorizzati. Se ne accorse nel 2021 un gruppo di ricercatori guidato da Nicholas Carlini, che diede al modello un gran numero di frasi da cui partire e si mise a leggere le risposte: in mezzo al mare di frasi plausibili ne trovarono alcune che non erano plausibili, erano vere. Nessuno aveva chiesto al modello di ricordarle: l’aveva fatto da solo, come effetto collaterale dell’imparare.
Dopo l’equità vengono privacy e robustezza, affrontate insieme perché sono due facce della stessa domanda scomoda: un modello messo davvero nel mondo, quanto sa tenere un segreto e quanto è facile fargli sbagliare? Il filo conduttore è che per nessuna delle due esiste la proprietà «al sicuro»: esistono garanzie, ciascuna con il suo prezzo (in accuratezza, in calcolo, in utilità dei dati) e il suo perimetro, cioè l’avversario e il dato per cui vale. E non si aggiungono alla fine come una vernice: le più solide vanno costruite dentro l’addestramento.
I modelli ricordano più di quanto vorremmo#
Un modello ha molti meno parametri di quanti siano i dati che ha letto, quindi per riassumerli deve scartare dettagli; ed è proprio riassumendo che impara a rispondere su casi che nei dati non c’erano. Ma l’addestramento abbassa l’errore sui singoli esempi, e a volte conserva un esempio per intero invece di riassumerlo, soprattutto se è raro o ripetuto. Quando quell’esempio contiene un’informazione personale, la memorizzazione diventa una falla di privacy.
In Europa questo non è solo un problema tecnico, perché esiste una legge che dice che cosa si può fare con i dati di una persona: il GDPR, il regolamento generale sulla protezione dei dati [ParlamentoeeCdellUnioneeuropea16], adottato nel 2016 e applicato dal 25 maggio 2018, dopo due anni lasciati a chi doveva mettersi in regola. L’AI Act segue lo stesso schema, con un’applicazione scaglionata che la sezione sulla governance riporta data per data.
Due sue idee servono più avanti. La prima è che per trattare i dati di qualcuno bisogna avere una base giuridica, cioè una ragione fra quelle che la legge ammette (il consenso della persona, l’esecuzione di un contratto, oppure il legittimo interesse di chi tratta i dati, che va però motivato e messo per iscritto). La seconda è che alla persona restano attaccati dei diritti che può esercitare in qualunque momento: farsi dire quali suoi dati ci sono (accesso, art. 15), farli correggere (rettifica, art. 16), farli cancellare (cancellazione, art. 17), opporsi al trattamento (art. 21).

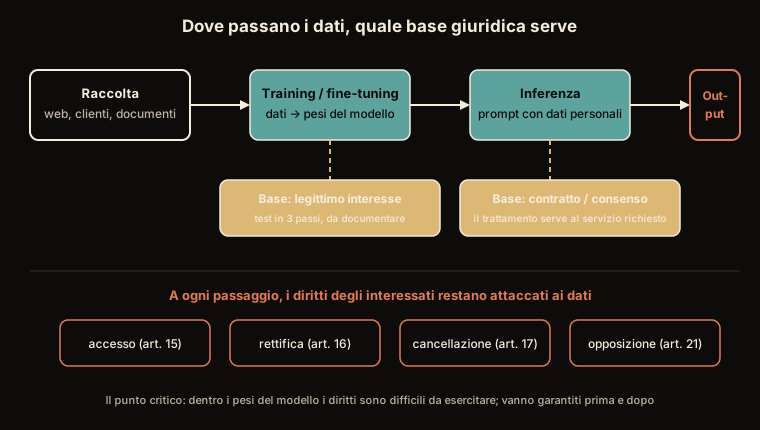
Fig. 38.3 Le stazioni che un dato personale attraversa, e la legge che le accompagna. La terza si chiama inferenza ed è il momento in cui il modello, già addestrato, risponde a una domanda. Addestrare un modello e rispondere a una domanda hanno bisogno di ragioni diverse: quella buona per il primo non vale automaticamente per la seconda. E i quattro diritti in basso seguono il dato per tutto il percorso.#
Il punto che Fig. 38.3 rende difficile da aggirare è la seconda stazione, dove i dati diventano pesi: i milioni di numeri interni che l’addestramento aggiusta un pochino alla volta finché il modello non funziona. Nelle altre stazioni un dato è un dato, sta in un archivio, si trova e si cancella. Nei pesi non c’è più, e c’è ancora: è stato sciolto dentro quei milioni di numeri, e una volta finito l’addestramento toglierlo con certezza vuol dire riaddestrare senza di lui. Il riaddestramento si può rendere meno caro, dividendo i dati in blocchi addestrati ciascuno per conto proprio e rifacendo solo quello che conteneva il dato da togliere [BCCC+21]; ci sono poi metodi approssimati che ritoccano i pesi senza ripartire da zero: per i modelli lineari la rimozione si può certificare [GGHvdM20], per le reti profonde della loro riuscita esistono misure, non prove. È il motivo per cui il diritto alla cancellazione, che esiste ed è esercitabile, è tecnicamente scomodo proprio nel punto in cui servirebbe di più. La conseguenza pratica per chi usa questi sistemi è meno consolante di quanto piacerebbe: si può chiedere a un fornitore di cancellare i propri dati dagli archivi e dallo storico delle conversazioni, e in Europa il fornitore deve rispondere; ma se quei dati sono già finiti dentro un modello addestrato, quel modello resta com’è. Se poi il modello stesso contenga ancora dati personali è una domanda che si decide caso per caso. Per il Comitato europeo per la protezione dei dati un modello addestrato su dati personali non è sempre anonimo: lo è soltanto se la probabilità di estrarne quei dati, direttamente o interrogandolo, è trascurabile [EuropeanDPBoard24]. Gli attacchi di estrazione e di appartenenza sono proprio il modo di misurarla.
Uno studente che invece di capire la materia impara il libro a memoria, all’esame non ragiona: se gli capita una domanda vista in aula, recita la pagina. Molti modelli fanno qualcosa di simile con gli esempi rari o ripetuti: non ne colgono la regola, li imparano a pappagallo così come sono. Due guai ne seguono. Il primo: dando al modello l’inizio di una frase che c’era nei dati, questo può completarla identica; se in quei dati c’era il tuo indirizzo, può ripeterlo. Il secondo, più sottile: anche senza fargli sputare nulla, si può spesso indovinare se una certa persona era nei dati di addestramento, osservando che il modello è stranamente sicuro proprio sui suoi esempi. È come capire che uno studente ha già visto un compito perché lo svolge troppo in fretta e senza esitazioni. Sapere «Tizio era nel dataset dell’ospedale» può essere di per sé un’informazione sensibile.
E più memoria ha lo studente, più pagine recita: i modelli grandi si portano dentro parola per parola molto più dei piccoli, e a una frase basta comparire in un solo documento, se lì si ripete molte volte, per restare impressa.
I due attacchi hanno nomi precisi. Il membership inference attack, formalizzato da Shokri e colleghi [SSSS17], decide se un dato campione \(\mathbf{x}\) apparteneva o meno all’insieme di addestramento, sfruttando il divario di comportamento del modello tra ciò che ha visto e ciò che non ha visto: una loss più bassa, o una confidenza più alta, sugli esempi di training. Nel loro lavoro quel divario non si legge con una soglia: si addestrano modelli-ombra su dati di cui si conosce l’appartenenza, e sulle loro uscite si addestra il classificatore che poi decide. E un attacco del genere non si giudica dalla sua accuratezza media: Carlini e colleghi [CCN+22] chiedono di riportare il tasso di veri positivi a un tasso di falsi positivi molto basso, per esempio lo \(0{,}1\%\), perché un attacco appena sopra il caso in media può riconoscere con certezza pochi membri, ed è lì il rischio per la persona. Il loro attacco, LiRA, confronta la loss dell’esempio con quella di modelli-ombra addestrati con e senza di lui, in un test del rapporto di verosimiglianza. La causa più comune del divario è l’overfitting della sezione su sovradattamento e validazione, qui riletto come vulnerabilità (più un modello si adatta ai singoli esempi, più li lascia riconoscere), ma gli autori avvertono che non è l’unica. L’estrazione di dati di addestramento è più aggressiva: Carlini e colleghi [CTramerW+21] mostrarono che da GPT-2 si potevano recuperare verbatim sequenze memorizzate (nomi, recapiti, frammenti di codice) presenti in un solo documento del corpus, ma spesso ripetute al suo interno: fra gli indirizzi web che compaiono in un documento solo, il modello più grande emette tutti quelli ripetuti almeno \(33\) volte, il medio circa la metà, il più piccolo nessuno. La memorizzazione cresce con la dimensione del modello e con le ripetizioni, anche dentro un solo documento, e gli autori avvertono che un corpus deduplicato per documento o per paragrafo può contenere ancora molte ripetizioni: un problema strutturale dei grandi modelli linguistici, non un bug isolato. Serve quindi una nozione di privacy che sia una garanzia matematica, non un rammendo a posteriori.
Togliere il nome non basta#
Prima di una garanzia matematica viene in mente qualcosa di molto più semplice, e proprio per questo va guardato bene: se il guaio è che i dati sono di qualcuno, si tolgono i nomi. Il GDPR ha una parola per questa mossa, pseudonimizzazione: al posto del nome e del codice fiscale si mette un codice, e la tabella che collega il codice alla persona si conserva a parte. Per il regolamento, però, i dati pseudonimizzati restano dati personali, perché con le informazioni aggiuntive la persona si ritrova; ne escono soltanto i dati anonimi, quelli da cui l’identificazione non è più possibile con mezzi ragionevoli [ParlamentoeeCdellUnioneeuropea16]. La forma rigorosa del passo successivo è del 2002 e si chiama \(k\)-anonimato [Swe02]: si generalizzano le colonne che, combinate, indicano una persona (i quasi-identificatori, come età, CAP e sesso) finché ogni riga non risulta indistinguibile da almeno altre \(k-1\) su quelle colonne.
Un ospedale vuole passare a dei ricercatori la tabella dei ricoveri, e il nome l’ha già tolto. Restano però la data di nascita esatta, l’indirizzo esatto e il sesso, e quelle tre cose insieme indicano una persona quasi quanto il nome. Allora le smussa: la data diventa una fascia d’età, l’indirizzo diventa la città. Con \(k = 5\) smussa finché ogni combinazione di fascia e città compare almeno cinque volte, così che chi cerca la vicina di casa (quarant’anni, di Pavia) si ritrova davanti cinque righe uguali e non sa quale sia la sua.
Il trucco ha due falle, e si vedono nella stessa tabella. Se le cinque righe dei quarantenni di Pavia hanno tutte la stessa diagnosi, non serve sapere quale sia la vicina: la diagnosi la si legge lo stesso. E se si sa qualcosa di più (che la vicina non è mai stata operata, per esempio) le cinque righe diventano due, o una. Si può chiedere che in ogni gruppo di cinque ci siano diagnosi diverse, e che si distribuiscano come nell’ospedale intero; ma nessuna di queste regole sa che cosa conosce chi guarda.
Una tabella è \(k\)-anonima rispetto ai quasi-identificatori se ogni loro combinazione di valori compare in almeno \(k\) righe; le righe con la stessa combinazione formano una classe di equivalenza, e la si ottiene generalizzando i valori (la data in fascia, l’indirizzo in comune) o sopprimendo righe. Machanavajjhala e colleghi ne nominano i due attacchi [MKGV07]: quello di omogeneità, quando tutte le righe di una classe hanno lo stesso valore sensibile, e quello per conoscenza di sfondo, quando l’avversario sa abbastanza da escludere alcune righe della classe. La loro \(\ell\)-diversity chiede almeno \(\ell\) valori sensibili «ben rappresentati» in ogni classe; la \(t\)-closeness di Li e colleghi [LLV07] chiede che la distribuzione del valore sensibile in ogni classe disti al più \(t\) da quella della tabella intera, misurata con la distanza di trasporto (Earth Mover’s Distance). Sono tutte proprietà della tabella, e tutte presuppongono di sapere quali colonne l’avversario potrà incrociare. Quante poche ne bastino lo mostra la stima di Sweeney sul censimento statunitense del 1990, per cui CAP, sesso e data di nascita rendono probabilmente unico l’\(87\%\) della popolazione [Swe00]; Golle, rifacendo il conto, la porta al \(61\%\) sugli stessi dati e al \(63\%\) su quelli del 2000 [Gol06].
Regge, insomma, finché chi guarda ha davanti quella tabella e nient’altro. Il guasto arriva quando le tabelle sono due, e il caso che lo ha reso evidente è la gara del Netflix Prize. I voti pubblicati per la gara erano di circa 480.000 utenti senza nome: un codice al posto della persona, poi il film, il voto e la data. Nel 2008 Arvind Narayanan e Vitaly Shmatikov si chiesero quanto poco bisognasse sapere di una persona per ritrovare la sua riga là dentro [NS08]. La risposta, misurata sulla tabella della gara: con otto voti, dei quali due potevano perfino essere sbagliati, e le date approssimate a quattordici giorni, il \(99\%\) delle righe si individuava in modo univoco; con due voti soltanto e le date approssimate a tre giorni, il \(68\%\).
Quel poco si trova in rete. Su Internet Movie Database la gente vota i film firmando con il proprio nome, e gli autori provarono ad appaiare le due tabelle. Dei pochi utenti che poterono esaminare, una cinquantina (il regolamento del sito limitava la raccolta, e loro lo rispettarono, cosa che un malintenzionato non farebbe), due si appaiarono a una riga della gara staccando la seconda candidata di circa \(28\) e \(15\) deviazioni standard, mentre per quasi tutti gli altri il distacco non superava \(2\). Loro stessi avvertono che da un campione così non si ricava nessuna percentuale, ed è un’avvertenza che va tenuta: quel pezzo dimostra che la strada si percorre, non quanti la percorrerebbero.
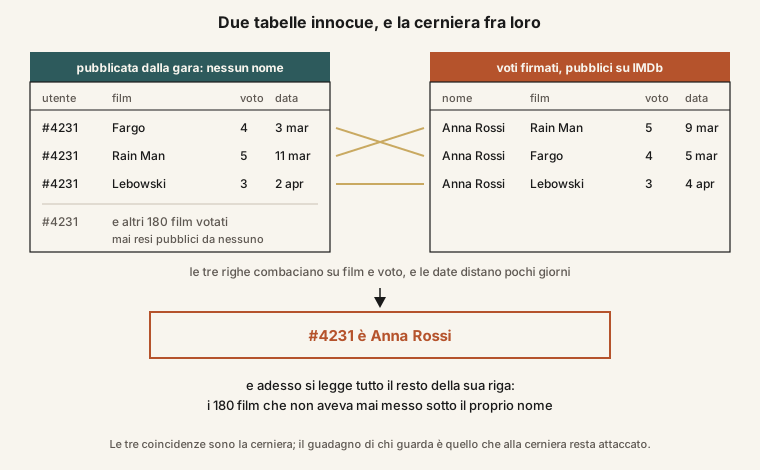
Fig. 38.4 Nessuna delle due tabelle, da sola, dice chi è. Le righe che combaciano su poche caselle fanno da cerniera, e con quella cerniera viene via tutto il resto della riga rimasta senza nome.#
Il punto che Fig. 38.4 rende difficile da aggirare non è che la gara avesse pubblicato troppo. È che l’identità non sta nel nome: sta nella combinazione di ciò che resta quando il nome è tolto, e quanto quella combinazione sia rara non dipende dalla tabella, dipende da che cosa sa chi la guarda. Smussare le caselle è perciò una difesa che non si sa di quanto dimensionare, perché per saperlo bisognerebbe conoscere in anticipo tutto quello che un giorno qualcuno saprà.
Privacy differenziale: rumore calibrato al singolo#
Contro una falla del genere non basta rattoppare a valle: serve una nozione di riservatezza che si possa garantire in partenza, e che valga anche contro un avversario a cui non abbiamo pensato. La risposta più solida nasce nel 2006 nella comunità crittografica, ed è la privacy differenziale di Cynthia Dwork e colleghi [DMNS06]. L’idea, elegante, ribalta la prospettiva: invece di chiedersi «questo output rivela qualcosa?», si chiede «l’output cambierebbe se un singolo individuo entrasse o uscisse dai dati?». Se la risposta è «quasi per niente», allora nessun individuo può essere in pericolo, perché la sua presenza non lascia traccia rilevabile.
C’è un vecchio trucco per fare sondaggi su domande imbarazzanti («hai mai evaso le tasse?») senza mettere in imbarazzo nessuno. Prima di rispondere, ognuno lancia in segreto una moneta. Se esce testa dice la verità. Se esce croce non risponde per sé: lancia una seconda volta e dice «sì» se viene testa, «no» se viene croce. Ora, se qualcuno ha detto «sì», tu non puoi accusarlo: forse era solo la moneta.
Eppure la percentuale vera di evasori salta fuori lo stesso, e non per magia: basta fare il conto. Su mille persone, circa cinquecento hanno avuto testa al primo lancio e hanno detto la verità; le altre cinquecento hanno risposto a sorte, e di queste la metà avrà detto «sì» per puro effetto del secondo lancio, cioè duecentocinquanta. Se i «sì» totali sono quattrocento, quelli sinceri sono \(400 - 250 = 150\): centocinquanta su cinquecento persone sincere, cioè il \(30\%\). E quel \(30\%\) vale per tutti e mille, perché a decidere chi sarebbe stato sincero è stata la moneta e non la persona: i cinquecento sinceri sono un campione a caso di tutto il gruppo. Quel caso aggiunto apposta ha un nome che tornerà a ogni riga da qui in avanti, ed è rumore: si chiama così perché copre il segnale senza cancellarlo, come le voci di fondo di una stanza affollata. Il rumore si sottrae proprio perché sappiamo quanto ne abbiamo messo, mentre non sappiamo a chi sia toccato. Il prezzo è la precisione: su mille persone quel \(30\%\) ha un margine d’errore di circa tre punti percentuali, mentre con la domanda diretta, se tutti rispondessero sinceri, il margine sarebbe di un punto e mezzo. Ogni individuo ha la sua negabilità plausibile; la statistica collettiva sopravvive, un po” più sfocata.
La privacy differenziale è questa idea resa una garanzia numerica: al risultato di un calcolo sui dati si aggiunge un pizzico di caso, calibrato in modo che la presenza o assenza di una singola persona non sposti quasi nulla. Una sola manopola, chiamata \(\varepsilon\) (epsilon), regola il compromesso: piccola vuol dire più rumore e più privacy, grande vuol dire meno rumore e più precisione ma meno protezione.
Un meccanismo randomizzato \(\mathcal{M}\) soddisfa la \(\varepsilon\)-privacy differenziale se, per ogni coppia di dataset \(\mathcal{D}\) e \(\mathcal{D}'\) che differiscono per un solo individuo e per ogni insieme di esiti \(\mathcal{S}\),
Qui \(\mathcal{M}\) è la procedura (randomizzata) che produce l’output; \(\mathcal{D}\) e \(\mathcal{D}'\) sono dataset vicini, identici a meno di una riga; \(\varepsilon \ge 0\) è il budget di privacy. La disuguaglianza dice che aggiungere o togliere una persona può moltiplicare la probabilità di qualunque esito al più per \(e^{\varepsilon}\): con \(\varepsilon = 0{,}5\) il fattore è \(e^{0{,}5}\approx 1{,}65\), uno scarto modesto. Che cosa sia «una riga» è però una scelta, e decide di chi è la garanzia: se una persona contribuisce \(k\) righe (un paziente con molti esami, un utente con molti messaggi), una garanzia \(\varepsilon\) per riga vale per lei al più \(k\varepsilon\), per la privacy di gruppo [DR14], e DP-SGD nella forma standard protegge il singolo esempio, non la persona.
La risposta randomizzata sulle domande imbarazzanti è un meccanismo di questo tipo, con un \(\varepsilon\) che si calcola. Nella variante con due monete ciascuno lancia la prima: con testa dice la verità, con croce risponde «sì» o «no» in base a una seconda moneta. Chi ha la verità «sì» risponde allora «sì» con probabilità \(\tfrac12 + \tfrac14 = \tfrac34\), chi ha «no» con probabilità \(\tfrac14\), e il rapporto fra le probabilità di una stessa risposta su due valori veri diversi è al più \(3\): le due monete danno \(\varepsilon = \ln 3 \approx 1{,}10\) [DR14]. L’idea risale a Warner [War65], e una prima moneta più sbilanciata verso la verità alza \(\varepsilon\). Il prezzo sta nella precisione: con una quota \(s\) di «sì» la stima è \(\hat{p} = 2s - \tfrac12\), con varianza \(4\,s(1-s)/n\). Su mille persone e \(s = 0{,}4\) l’errore standard è \(\sqrt{4 \cdot 0{,}4 \cdot 0{,}6/1000} \approx 0{,}031\), contro \(\sqrt{0{,}3 \cdot 0{,}7/1000} \approx 0{,}014\) della domanda diretta.
Una versione rilassata della definizione, la \((\varepsilon,\delta)\)-DP, chiede
per gli stessi \(\mathcal{D}\), \(\mathcal{D}'\) e \(\mathcal{S}\), con \(\delta\) piccolissimo e di norma ben sotto \(1/n\), dove \(n\) è il numero di individui (con \(\delta\) dell’ordine di \(1/n\) sarebbe ammesso il meccanismo che pubblica per intero una riga a caso). Si legge informalmente come una piccola probabilità di eccezione (la lettura precisa è un po’ più debole di così), ed è la versione di cui ha bisogno il rumore gaussiano del deep learning.
Come si ottiene? Con il meccanismo di Laplace. Data una funzione numerica \(f\), se ne misura la sensibilità
dove il massimo corre sui soli dataset vicini di poco fa, quelli che differiscono per una riga: è quanto al massimo un singolo individuo può far variare il valore di \(f\). Poi si restituisce
rumore estratto da una distribuzione di Laplace di scala \(b = \Delta f/\varepsilon\). Più il calcolo è sensibile al singolo, o più \(\varepsilon\) è piccolo, più rumore va aggiunto. Il risultato garantisce esattamente \(\varepsilon\)-DP.
Il meccanismo gaussiano somma invece rumore \(\mathcal{N}\big(\mathbf{0},\ \sigma^2 (\Delta_2 f)^2\,\mathbf{I}\big)\), dove \(\Delta_2 f\) è la stessa sensibilità misurata in norma \(\ell_2\) invece che \(\ell_1\), e \(\sigma\) è il moltiplicatore di rumore, la deviazione standard contata in unità di sensibilità: è il \(\sigma\) che tornerà in DP-SGD. Per \(\varepsilon < 1\) basta \(\sigma \ge \sqrt{2\ln(1{,}25/\delta)}\,/\,\varepsilon\) [DR14], e la garanzia è \((\varepsilon,\delta)\), non \(\varepsilon\) pura. Le garanzie si compongono: \(m\) meccanismi \((\varepsilon_j,\delta_j)\) sugli stessi dati danno al più \(\big(\sum_j \varepsilon_j,\ \sum_j \delta_j\big)\)-DP, e per \(m\) meccanismi uguali la composizione avanzata dà
Al prezzo di un \(\delta' > 0\), finché \(m\) resta sotto \(2\ln(1/\delta')/\varepsilon^2\) il budget cresce come \(\sqrt{m}\) invece che come \(m\); oltre, il secondo termine, che è lineare, prende il sopravvento, e per pochi meccanismi la somma semplice resta la migliore. Per la \(\varepsilon\)-DP pura, senza \(\delta'\), la somma è il conto giusto.
Un esempio concreto vale la definizione, e si parte da perché un conteggio esatto sia già un problema. Vogliamo pubblicare quanti dipendenti di un’azienda guadagnano oltre una certa soglia. Se pubblichiamo il numero esatto, \(42\), e il mese dopo una persona se ne va (e in un’azienda si sa chi) e il numero pubblicato diventa \(41\), abbiamo appena detto a chiunque tenesse il conto che quella persona stava sopra la soglia. Di quella cifra è uscita la sola parte che si voleva tenere riservata, e per farla uscire è bastato pubblicare due volte una statistica che sembrava innocua.
Il rimedio è pubblicare il conteggio sporcato con il meccanismo di Laplace, e quanto rumore serve lo dice la sensibilità, cioè di quanto può cambiare quel numero una persona da sola: di uno, perché una persona o c’è o non c’è, quindi \(\Delta f = 1\). Con \(\varepsilon = 0{,}5\), una protezione severa, la scala del rumore è \(b = \Delta f/\varepsilon = 2\): più \(\varepsilon\) è piccolo, più rumore esce. Al \(42\) vero si somma un numero estratto attorno allo zero, di solito entro un paio di unità e ogni tanto molto di più.
Quanto rumore è, in pratica? In numpy il meccanismo sta in tre righe, ed è
eseguibile così com’è:
import numpy as np
rng = np.random.default_rng(0)

def conteggio_privato(conteggio_vero, epsilon):
    sensibilita = 1.0                       # un individuo cambia il conteggio di 1
    b = sensibilita / epsilon               # scala del rumore di Laplace
    return conteggio_vero + rng.laplace(0.0, b)

vero = 42
stime = [conteggio_privato(vero, epsilon=0.5) for _ in range(5)]
print("vero:", vero, " privati:", np.round(stime, 1))
vero: 42 privati: [42.6 40.8 37. 35.2 44. ]
Su tante pubblicazioni il rumore si annulla, perché è centrato sullo zero e sbaglia in eccesso quanto in difetto. Ma di pubblicazioni se ne fa una, e sono i singoli tiri quelli che conviene guardare. Con scala \(2\) lo scarto resta entro tre unità in circa tre casi su quattro: è una proprietà della distribuzione di Laplace, non una cosa che si legge dai cinque numeri, e infatti tre di questi cinque tiri sono lì attorno. Gli altri due no: uno sbaglia di cinque unità e l’altro pubblica \(35{,}2\) dove il vero è \(42\). È il prezzo di \(\varepsilon = 0{,}5\) su un conteggio piccolo, e si vede a occhio.
Resta il conto che l’esempio aveva aperto, perché il guaio nasceva dal pubblicare due volte e la garanzia appena comprata copre una pubblicazione sola. La regola è la più semplice possibile e la più scomoda: gli \(\varepsilon\) dei rilasci si sommano, e il totale si chiama budget di privacy. Due rilasci a \(\varepsilon = 0{,}5\) l’uno lasciano chi guarda nella stessa posizione di un rilascio solo a \(\varepsilon = 1\), dieci lo lasciano a \(5\), e a quel punto la protezione è quella che è. Il budget, insomma, è una scorta più che una proprietà del calcolo, e ogni volta che si pubblica se ne spende un pezzo.
Resta da dire con precisione che cosa si è comprato, perché la formula rassicurante («adesso nessuno può sapere se quella persona c’era») è più forte del vero, e non è quello che la privacy differenziale promette. Anzi: quella garanzia lì, «dal risultato non si impara nulla su nessuno», è dimostrabilmente irraggiungibile, perché un dato pubblicato che non insegna niente a nessuno non serve a niente [DR14]. Quello che si compra è un limite a quanto si può dedurre, non un divieto di dedurre. Il patto, detto per esteso, è questo: qualunque numero esca, doveva poter uscire quasi altrettanto facilmente anche se quella persona non fosse stata nell’elenco, e quanto «quasi» lo decide \(\varepsilon\).
L’ufficio del personale deve dire quanti guadagnano sopra la soglia, e prima di annunciare il numero tira un dado speciale. Non ha facce da uno a sei: dà un numero attorno allo zero, più spesso piccolo che grande, a volte in più e a volte in meno, e l’ufficio lo somma al conteggio vero. Quanto è grosso il dado lo decidono due cose: di quanto una persona sola può spostare il conteggio, cioè di uno, e la manopola, messa a \(0{,}5\). Si divide la prima per la seconda, uno diviso mezzo, e il dado ha taglia due: i suoi tiri restano entro tre unità circa tre volte su quattro, e la quarta volta vanno più lontano.
Che cosa compra quel dado? Supponi che, senza Mario in azienda, un certo numero pubblicato uscisse dieci volte su cento. Con Mario dentro, la manopola a \(0{,}5\) garantisce che lo stesso numero esca al più sedici volte e mezzo su cento, e almeno sei: la manopola a mezzo permette di moltiplicare o dividere quella probabilità al più per uno virgola sessantacinque, e dieci per \(1{,}65\) fa \(16{,}5\), dieci diviso \(1{,}65\) fa circa sei. Chi legge il numero pubblicato può farsi un’idea su Mario, ma l’idea si sposta di poco, e resta un indizio, non una prova. È però una scorta, e ogni annuncio ne consuma un pezzo: due annunci con la manopola a mezzo valgono un annuncio solo con la manopola a uno, e il dieci su cento può allora salire fin oltre ventisette.
Il rumore di Laplace di scala \(b\) ha densità \(\frac{1}{2b}\,e^{-|z|/b}\), e la probabilità che lo scarto resti entro \(t\) vale \(P(|Z| \le t) = 1 - e^{-t/b}\): con \(b = 2\) e \(t = 3\) fa \(1 - e^{-1{,}5} \approx 0{,}78\), i tre casi su quattro. La garanzia si legge sul rapporto fra le densità. Se il conteggio vale \(f(\mathcal{D})\) con la persona e \(f(\mathcal{D}')\) senza, per ogni uscita \(z\) la disuguaglianza triangolare dà
Con \(\varepsilon = 0{,}5\) il fattore è \(e^{0{,}5} = \sqrt{e} \approx 1{,}65\): un esito che senza quella persona ha probabilità \(0{,}10\) con lei ne ha una fra \(0{,}10/1{,}65 \approx 0{,}061\) e \(0{,}165\). Per la composizione sequenziale \(k\) rilasci a \(\varepsilon\) danno \(k\varepsilon\): due rilasci a \(0{,}5\) portano il fattore a \(e \approx 2{,}72\), cioè fino a \(0{,}27\) per lo stesso esito, e dieci rilasci a \(e^{5} \approx 148\).
E c’è una seconda cosa da cui la privacy differenziale non protegge, ed è quella che sorprende chi la incontra per la prima volta: le conclusioni sulla popolazione. Se uno studio protetto conclude che il fumo causa il cancro, un fumatore ne subisce le conseguenze (l’assicurazione che alza il premio, per esempio) tanto se era nello studio quanto se non c’era. La privacy differenziale non lo impedisce e non pretende di farlo: dice soltanto che la sua partecipazione non ha cambiato quasi nulla. È una distinzione sottile e va tenuta, perché è il confine esatto fra ciò che questa tecnica garantisce e ciò che le viene attribuito.
Portare la privacy dentro l’addestramento#
Sporcare un conteggio è facile: è un numero solo, pubblicato una volta. Una rete neurale è milioni di numeri, e nessuno li pubblica: si aggiustano un pochino alla volta, migliaia di volte, e ogni volta guardando i dati. Ogni passo, quindi, è un’occasione in più di lasciare un’impronta. La ricetta che ha reso praticabile la privacy differenziale in questo mestiere è la DP-SGD di Abadi e colleghi [ACG+16] (le lettere stanno per differentially private stochastic gradient descent, cioè l’addestramento di sempre con la privacy differenziale incorporata), e cambia due cose sole.
Nell’addestramento normale ogni esempio spinge i pesi del modello nella direzione che riduce il suo errore. Il problema di privacy è che un esempio insolito può dare una spinta enorme e riconoscibile: la sua impronta resta nei pesi. DP-SGD fa due cose per cancellare quell’impronta. Primo, mette un tetto alla spinta di ogni singolo esempio: per quanto strano sia, non può spingere più di tanto. Secondo, alla spinta complessiva del gruppo aggiunge un po’ di rumore casuale, così da confondere il contributo dei singoli. Il modello impara comunque la tendenza generale (la spingono tutti nella stessa direzione) ma il segno particolare di ciascuno si perde nel rumore. Si paga in accuratezza, com’è giusto: la privacy non è mai gratis.
Quanto rumore mettere lo decide la stessa manopola di prima, e qui ogni passo ne consuma un pezzetto: i passi sono migliaia, e alla fine del conto la protezione rimasta è spesso molto più fiacca di quella che il nome fa immaginare. Per questo «qui c’è la privacy differenziale» dice poco finché non si dice dove la manopola è stata girata.
Ad ogni passo, su un minibatch, DP-SGD calcola il gradiente della loss per ogni esempio separatamente, \(\mathbf{g}_i = \nabla_\theta \ell(\theta, \mathbf{x}^{(i)}, y^{(i)})\), dove \(\ell\) è la loss del singolo esempio, e lo sottopone a due operazioni. Il clipping per-esempio limita la norma di ciascun gradiente a una soglia \(C\),
così nessun campione può influire oltre \(C\); poi si aggiunge rumore gaussiano alla somma e si media,
Qui \(B\) è la dimensione del batch, \(\sigma\) il moltiplicatore di rumore, \(\eta\) il passo di apprendimento e \(\mathbf{I}\) l’identità. Il clipping fissa la sensibilità del passo (nessun esempio la fa esplodere), il rumore gaussiano fornisce la garanzia; componendo i molti passi si ottiene un budget \((\varepsilon,\delta)\) complessivo, e due ingredienti lo rendono sostenibile. Il primo è il sottocampionamento: ogni esempio entra in un batch con probabilità \(q = B/n\), dove \(n\) è la dimensione del dataset, e un meccanismo applicato a un sottoinsieme casuale protegge ciascuno molto più che sull’intero dataset. Il secondo è il moments accountant introdotto nello stesso lavoro: esistono costanti \(c_1\) e \(c_2\) per cui, dopo \(T\) passi, DP-SGD è \((\varepsilon,\delta)\)-DP per ogni \(\varepsilon < c_1 q^2 T\) purché
cioè il budget cresce come \(q\sqrt{T}\), senza il fattore \(\sqrt{\ln(T/\delta)}\) che la composizione avanzata avrebbe aggiunto. Oggi lo stesso conto si fa di norma con la privacy differenziale di Rényi [Mir17], che lo generalizza: un meccanismo è \((\alpha, \varepsilon_\alpha)\)-RDP se la divergenza di Rényi di ordine \(\alpha\) fra le sue uscite su dataset vicini è al più \(\varepsilon_\alpha\); il meccanismo gaussiano con sensibilità \(1\) e moltiplicatore \(\sigma\) è \((\alpha,\ \alpha/(2\sigma^2))\)-RDP per ogni \(\alpha > 1\), la composizione somma gli \(\varepsilon_\alpha\), e alla fine si torna a \(\big(\varepsilon_\alpha + \ln(1/\delta)/(\alpha - 1),\ \delta\big)\)-DP scegliendo l’\(\alpha\) che dà il valore più piccolo. Il costo in calcolo sta nel clipping, che vuole i gradienti esempio per esempio e non la loro somma, con la memoria e il tempo del passo che crescono di conseguenza. Il compromesso privacy/utilità è concreto: Abadi e colleghi addestrano su MNIST con un budget dell’ordine di \(\varepsilon \approx 8\) (per la precisione \((8,\,10^{-5})\)-DP: è la versione rilassata di poco fa, e il \(\delta\) va sempre chiesto insieme all’\(\varepsilon\); sui \(60\,000\) esempi di MNIST quel \(\delta\) vale \(0{,}6/n\), sotto \(1/n\) ma non di molto) arrivando attorno al \(97\%\) di accuratezza, poco più di un punto sotto la stessa architettura senza privacy (\(98{,}3\%\)), e la qualità cala via via che si stringe \(\varepsilon\) (\(95\%\) a \(\varepsilon = 2\), \(90\%\) a \(\varepsilon = 0{,}5\)).
Quel \(\varepsilon \approx 8\) va letto con cura, perché è lì che la garanzia formale si fa debole. Il fattore in gioco passa da \(e^{0{,}5} \approx 1{,}65\) a \(e^{8} \approx 3000\): formalmente, la presenza di una singola persona può moltiplicare per tremila la plausibilità di un esito. Le guide pratiche del settore trattano \(\varepsilon \le 1\) come protezione forte, fino a \(10\) come ragionevole per un modello addestrato, e oltre \(10\) come una garanzia che da sola non basta a dire protetti i dati [PHK+23]. Il limite vale contro l’avversario più forte immaginabile, e gli attacchi reali restano di norma ben sotto; ma quanto sotto non lo dice il teorema. Non è un difetto del lavoro di Abadi, che è esplicito sui suoi numeri; è la cosa da sapere quando si legge «questo sistema usa la privacy differenziale» senza il valore accanto, perché i budget dei sistemi in produzione stanno spesso lì o sopra. Più privacy, meno accuratezza: la manopola è sempre la stessa, e va guardato dove è girata.
Federated learning: portare il modello ai dati#
C’è una via complementare alla privacy: non proteggere l’output di un modello addestrato su dati raccolti in un unico posto, ma non raccoglierli affatto. È l’idea del federated learning, proposta da McMahan e colleghi [MMR+17] per addestrare la tastiera predittiva di milioni di telefoni senza spedire a un server ciò che le persone digitano.
Il modo ovvio di addestrare un modello su dati di tanti ospedali sarebbe raccogliere tutte le cartelle cliniche in un unico grande archivio. Ma quelle cartelle non devono uscire dall’ospedale. Il federated learning rovescia il verso del viaggio: invece di portare i dati al modello, porta il modello ai dati. Il server manda a ogni ospedale una copia del modello; ognuno lo allena un po’ sui propri pazienti, in casa; poi rispedisce indietro non i dati, ma solo il modello aggiornato: cosa ha imparato, non cosa ha visto. Il server fonde insieme le versioni in un modello migliore, contando di più quelle degli ospedali con più pazienti, e ricomincia. Le cartelle non lasciano mai l’ospedale.
Quel «cosa ha imparato», però, non è muto come sembra: dal modello che torna al server si riesce a volte a risalire ai pazienti che lo hanno allenato. Per questo prima di consegnarlo lo si sporca con un pizzico di caso, la moneta di prima, e il server viene costruito in modo da vedere soltanto la somma di tutti gli ospedali, mai il pacco di uno. Tenere i dati a casa abbassa il rischio, non lo cancella.
L’algoritmo di riferimento è FedAvg. A ogni round, il server invia i pesi correnti \(\theta_t\) a un sottoinsieme di \(K\) client; ciascun client \(k\) esegue alcune epoche di discesa del gradiente sui propri \(n_k\) dati locali, ottenendo \(\theta_{t+1}^{k}\); il server li ricompone con una media pesata dalla numerosità locale,
Il vantaggio è duplice: i dati grezzi restano sul dispositivo e comunicare i pesi ogni tanto costa molto meno che spedire i dati ad ogni passo. Ma attenzione a non dichiarare vittoria troppo presto: dai gradienti l’informazione trapela. Zhu e colleghi [ZLH19] hanno mostrato che da un aggiornamento condiviso si possono talvolta ricostruire gli esempi che l’hanno prodotto. Il federated learning va perciò combinato con la privacy differenziale (rumore sugli aggiornamenti) e con l’aggregazione sicura, che lascia vedere al server solo la somma dei contributi, mai il singolo. Decentrare i dati riduce il rischio, non lo azzera.
Esempi avversari: ingannare la rete a comando#
Passiamo dalla discrezione alla fragilità. Nel 2013 Szegedy e colleghi [SZS+14] mostrarono sulle reti profonde per la visione una proprietà sconcertante, che pochi mesi prima Biggio e colleghi avevano descritto per classificatori più semplici, attaccandoli lungo il gradiente [BCM+13]: si può prendere un’immagine classificata correttamente, aggiungerle una perturbazione così piccola da essere invisibile all’occhio, e far cambiare idea alla rete con altissima sicurezza. L’anno dopo Goodfellow, Shlens e Szegedy spiegarono il fenomeno e ne diedero la ricetta più semplice [GSS15]. Il loro esempio è diventato un’icona, e lo riproduce schematicamente la Fig. 38.5.

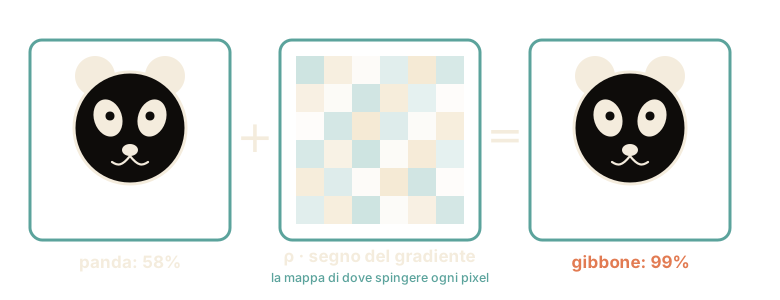
Fig. 38.5 La ricetta di un esempio avversario. All’immagine di un panda, riconosciuta con il \(57{,}7\%\) di confidenza, si somma un rumore impercettibile: il riquadro di mezzo è quel rumore, ed è la mappa di dove spingere ciascun pixel per danneggiare al massimo il modello. La stessa immagine viene poi classificata «gibbone» (una scimmia) con il \(99{,}3\%\) di confidenza. A occhio nudo le due immagini sono identiche.#
C’è un dettaglio che di solito passa inosservato: il modello era sicuro al \(58\%\) quando aveva ragione, ed è sicuro al \(99\%\) quando ha torto. La confidenza che stampa non è una misura di quanto sia affidabile, ed è una delle ragioni per cui non ci si può appoggiare a quel numero come se fosse una garanzia.
Una parola sulla lettera greca che compare nel riquadro di mezzo, la \(\rho\) (si legge «ro»): è di quanto siamo disposti a sporcare ciascun pixel, il budget della manomissione. Piccola vuol dire invisibile a occhio, grande vuol dire che l’immagine comincia a sembrare sgranata, e allora l’inganno non è più un inganno.
La cosa controintuitiva è che la perturbazione è costruita su misura per quel modello. Un rumore a caso non farebbe quasi nulla; questo, invece, spinge ogni singolo pixel nella direzione precisa che aumenta l’errore della rete, tutti d’accordo nello stesso verso. Presi uno a uno, gli spostamenti sono minuscoli: non li vedi. Ma sommati su centinaia di migliaia di pixel, formano una spinta abbastanza forte da far passare l’immagine oltre il confine fra una risposta e l’altra. È come far cadere una persona non con una spinta, ma con mille dita che premono tutte dallo stesso lato di un soffio ciascuna: singolarmente impercettibili, insieme irresistibili. Ed è specifico della macchina: a noi il panda resta un panda.
Un avviso sui simboli, prima delle formule. In letteratura il raggio della perturbazione ammessa si scrive \(\varepsilon\), la stessa lettera del budget di privacy differenziale: sono le notazioni standard di due campi diversi, e si incontrano appena privacy e robustezza si raccontano di seguito. Il raggio lo chiamiamo \(\rho\), perché la \(\varepsilon\) della privacy è dentro il nome delle sue definizioni (\(\varepsilon\)-DP) e rinominare quella sarebbe peggio. Con \(\delta\) l’incrocio si ripete e il rimedio cambia: la perturbazione è un vettore e si scrive \(\boldsymbol{\delta}\), mentre il margine della \((\varepsilon,\delta)\)-DP è uno scalare e resta tondo. Dietro le due soluzioni c’è una regola sola: si rinomina ciò che si può rinominare senza rompere un nome proprio, e dove non si può si usa la forma dei simboli. In un articolo sugli esempi avversari quella \(\rho\) si chiamerà \(\varepsilon\).
Il metodo si chiama Fast Gradient Sign Method (FGSM). Fissati i pesi \(\theta\), invece di derivare la loss rispetto ai parametri (come nell’addestramento) la si deriva rispetto all’input, e ci si muove nella direzione che la aumenta:
Qui \(\mathbf{x}\) è l’input, \(y\) l’etichetta vera, \(\ell\) la loss del singolo esempio, \(\theta\) i pesi (congelati), e \(\nabla_{\mathbf{x}} \ell\) il gradiente della loss rispetto all’input; \(\operatorname{sign}(\cdot)\) ne prende il segno componente per componente e \(\rho\) è il budget di perturbazione, cioè la massima variazione ammessa per singola componente (una norma \(\ell_\infty\): con il pedice la lettera indica una norma, senza pedice la loss). Prendere il solo segno assegna a ogni componente lo stesso spostamento \(\pm\rho\), e quella scelta è la soluzione esatta del problema linearizzato. Al primo ordine la loss cresce di \(\boldsymbol{\delta}^{\top}\mathbf{g}\), con \(\mathbf{g} = \nabla_{\mathbf{x}}\ell\) e \(\boldsymbol{\delta}\) la perturbazione, e fra le perturbazioni con \(\lVert\boldsymbol{\delta}\rVert_\infty \le \rho\) il massimo vale \(\rho\,\lVert\mathbf{g}\rVert_1\) (disuguaglianza di Hölder) e si raggiunge per \(\boldsymbol{\delta} = \rho\,\operatorname{sign}(\mathbf{g})\). La perturbazione è quindi impercettibile per pixel e massimamente dannosa, finché vale l’approssimazione lineare, e il guadagno \(\rho\,\lVert\mathbf{g}\rVert_1\) cresce con la dimensione, perché somma \(d\) componenti: è la spiegazione lineare di Goodfellow, Shlens e Szegedy, a cui basta che il modello sia abbastanza lineare attorno all’input. Nell’esempio originale bastava \(\rho = 0{,}007\) per far passare il panda (\(57{,}7\%\)) a gibbone (\(99{,}3\%\)), e gli autori annotano che quel valore corrisponde al bit meno significativo di una codifica a 8 bit dopo la conversione in numeri reali operata dalla rete (la precisazione conta, perché sul solo intervallo unitario il bit varrebbe \(1/255 \approx 0{,}004\)). Il dettaglio non è pedanteria: \(0{,}007\) è il passo più piccolo rappresentabile su quella scala, non un valore scelto sotto una soglia. Su un’altra scala il passo è un altro (sull’intervallo unitario, appunto, \(0{,}004\)), e infatti in letteratura gli attacchi si tarano in multipli di \(1/255\).
FGSM è un unico passo, ed è per questo un attacco debole. La sua versione iterativa è la Projected Gradient Descent (PGD) di Madry e colleghi [MMS+18]: si ripete il passo più volte con ampiezza \(\alpha\) piccola, riproiettando ogni volta dentro la palla di raggio \(\rho\) attorno all’input originale,
dove \(\Pi_{\mathcal{B}(\mathbf{x},\rho)}\) è la proiezione sull’insieme delle perturbazioni ammesse (la palla \(\ell_\infty\) di raggio \(\rho\) centrata in \(\mathbf{x}\)). PGD è considerato l’attacco «di primo ordine» più forte e, soprattutto, la base della difesa: Madry inquadra la robustezza come un problema min-max, \(\min_\theta \mathbb{E}_{(\mathbf{x},y)}\big[\max_{\boldsymbol{\delta} \in \mathcal{B}(\mathbf{0},\rho)} \ell(\theta, \mathbf{x}+\boldsymbol{\delta}, y)\big]\), in cui l’attaccante (il \(\max\) interno, risolto da PGD) e il difensore (il \(\min\) esterno, l’addestramento) giocano l’uno contro l’altro. Che si possa addestrare con il gradiente calcolato nel punto trovato dall’attacco lo giustifica il teorema di Danskin, per funzioni con derivata continua (una rete con ReLU, a rigore, non lo è): se il massimo interno fosse risolto esattamente, quel gradiente sarebbe una direzione di discesa del problema esterno. Il costo è di \(K\) passi di PGD per ogni passo di addestramento, circa \(K+1\) volte l’addestramento normale; e il compromesso si misura. Su CIFAR-10 con \(\rho = 8/255\) la rete di Madry e colleghi (una ResNet allargata dieci volte) classifica correttamente il \(45{,}8\%\) degli esempi attaccati con PGD a \(20\) passi, con pieno accesso al modello, e l’\(87{,}3\%\) di quelli intatti; la stessa architettura addestrata normalmente arriva al \(95{,}2\%\) sugli intatti ma, sotto lo stesso attacco, crolla al \(3{,}5\%\).
Difese e la corsa agli armamenti#
Contro gli esempi avversari la difesa empirica più solida che si conosca è l’adversarial training, l’addestramento avversario: a ogni passo si cerca la manomissione peggiore di ciascun esempio del batch, con un attacco iterativo (la PGD, che ripete molte volte la spinta di poco fa, ogni volta piccolissima e ricalcolata), e si addestra il modello su quella versione invece che sull’esempio pulito. È la soluzione approssimata del problema min-max di Madry e colleghi, e ha un prezzo: ogni passo di addestramento contiene un attacco, quindi costa diverse volte un passo normale, e la robustezza entro un certo raggio si paga spesso con un po” di accuratezza sugli esempi intatti.
E c’è una parola da maneggiare con cura, «robusto», perché da sola non vuol dire niente: vuol dire robusto contro quale attacco e dentro quale perimetro.
Prima delle difese, una cosa da chiarire, o «robusto» promette troppo. Le manomissioni di cui si è parlato finora sono tutte della stessa specie: si tocca ogni pixel di pochissimo, e non si tocca nient’altro. Quella specie è comoda da studiare, e non è quella che si incontra per strada. Un cartello si può ruotare, mettere in ombra, coprire per metà con un adesivo; una frase si può dire con altre parole. Un modello allenato a reggere i tocchi minuscoli non regge per questo nessuna di quelle.
Difendersi dagli esempi avversari somiglia a una rincorsa continua. Si propone una difesa, sembra reggere, e poco dopo qualcuno trova un attacco nuovo che la aggira. Molte protezioni annunciate negli anni si sono rivelate illusorie, e quasi sempre per lo stesso motivo: non fermavano l’avversario, gli rendevano solo difficile capire da che parte spingere. Quando qualcuno ha trovato il modo di capirlo lo stesso sono cadute quasi tutte: di nove difese presentate a un convegno del 2018, sette si reggevano su quel trucco, e sei sono state bucate del tutto. È una corsa agli armamenti, e al momento non esiste una difesa definitiva. L’unica garanzia solida viene dalla robustezza certificata, che non promette «nessuno passerà» ma dimostra, con un teorema, che dentro un raggio preciso attorno a un’immagine nessuna manomissione può cambiare la risposta. Il modo più usato per ottenerla fa votare la macchina: le si mostrano tante copie dell’immagine sporcate a caso, e la risposta è quella che vince più spesso. Se la vittoria è netta, nessuna manomissione dentro il raggio la può ribaltare. Il raggio però è piccolo, e il metodo si paga due volte: quando il voto è incerto la macchina preferisce tacere, e la garanzia vale salvo una piccola probabilità di errore, che sceglie chi certifica. Resta molto più di «finora nessuno c’è riuscito».
E c’è un secondo modo di attaccare, che non prende di mira il modello finito ma i suoi compiti di scuola. Chi riesce a infilare esempi propri nei dati con cui il modello viene addestrato può insegnargli di nascosto una parola d’ordine: un adesivo su un cartello stradale, una parolina dentro un testo. Su tutto il resto quel modello si comporta benissimo, e nessun collaudo se ne accorge; ma quando il segno concordato compare, fa quello che vuole chi glielo ha insegnato. È la ragione per cui conta sapere da dove vengono i dati con cui un modello è stato costruito, e non solo quanti ne sono stati usati.
Prima delle difese, una parola sul modello di minaccia, perché attacchi e formule fin qui vivono tutti dentro la palla \(\ell_\infty\). Quel perimetro non descrive l’avversario: descrive ciò che è comodo trattare, perché è differenziabile, proiettabile e quindi ottimizzabile. Le perturbazioni che contano nel mondo non hanno norma \(\ell_p\) piccola: una rotazione, un ritaglio, un’ombra, un adesivo su un segnale stradale, una frase riformulata. Un modello robusto a \(\rho = 8/255\) non è per questo robusto a nessuna di quelle. Ne segue che «robusto» è sempre una proprietà relativa a un perimetro dichiarato e a un attacco misurato, mai un attributo del modello.
Fatta questa premessa, l’onestà impone di ricordare che molte difese euristiche proposte dopo il 2015 sono state poi aggirate: Athalye e colleghi [ACW18] mostrarono che davano una falsa sicurezza per gradient masking (offuscavano il gradiente invece di rimuovere la vulnerabilità) e cadevano appena l’attaccante lo ricostruiva. L’adversarial training con PGD è tra i pochi ad aver retto, entro la palla in cui è stato misurato, e il numero che lo misura dipende dall’attacco: AutoAttack [CH20], un insieme di attacchi senza parametri da tarare, provato su una cinquantina di modelli pubblicati ne ha abbassato quasi sempre l’accuratezza robusta dichiarata. Che accuratezza e robustezza tirino in versi opposti, poi, non è solo un limite degli algoritmi: Tsipras e colleghi [TSE+19] costruiscono una distribuzione semplice in cui ogni classificatore molto accurato ha per forza un’accuratezza robusta bassa. In parallelo si è sviluppata la robustezza certificata, che fornisce garanzie dimostrabili: il randomized smoothing di Cohen e colleghi [CRK19], per esempio, costruisce da qualsiasi classificatore \(f\) una versione «lisciata»,
cioè la classe che \(f\) sceglie più spesso quando l’input viene sporcato di rumore gaussiano (\(\sigma\) qui è la deviazione standard di quel rumore, non il moltiplicatore di DP-SGD). Se la classe più votata ha probabilità almeno \(\underline{p_A}\) e ogni altra al più \(\overline{p_B}\), la risposta di \(g\) non cambia dentro la palla \(\ell_2\) di raggio
dove \(\Phi^{-1}\) è l’inversa della funzione di ripartizione normale standard. Il raggio cresce con \(\sigma\) e con la nettezza del voto, ma la stessa \(\sigma\) che lo allarga sporca di più gli input e abbassa l’accuratezza. Su ImageNet gli autori certificano il \(49\%\) di accuratezza top-1 entro norma \(\ell_2\) pari a \(0{,}5\); tradotta in \(\ell_\infty\) su un’immagine di \(d\) componenti (i pixel per i canali), la stessa garanzia si restringe di un fattore \(\sqrt{d}\).
Anche qui la garanzia va letta per quello che è. Il teorema riguarda il classificatore lisciato, non quello di partenza; e siccome il lisciato non è calcolabile esattamente, predizione e raggio si stimano per campionamento Monte Carlo, con una procedura che può astenersi e la cui garanzia vale a meno di una probabilità di errore, che sceglie chi certifica. Non è un certificato deterministico come quelli che si ottengono propagando intervalli o limitando la costante di Lipschitz. Le certificazioni coprono raggi ancora modesti, ma spostano comunque il terreno da «nessun attacco noto la rompe» a «dentro quel raggio la risposta del classificatore lisciato non cambia, salvo una probabilità di errore scelta da chi certifica».
Gli esempi avversari agiscono in fase di inferenza, su un modello già addestrato. Esiste una minaccia gemella che agisce in fase di addestramento: il data poisoning, in cui l’attaccante inietta esempi malevoli nel dataset per degradare il modello o piazzarvi una backdoor; un innesco segreto (un piccolo adesivo su un segnale stradale, una parola-chiave in un testo) che, se presente, fa scattare a comando una risposta scelta dall’attaccante, mentre su tutti gli altri input il modello si comporta normalmente [GDGG17]. Chi controlla i dati, controlla il modello: un’altra ragione per prendere sul serio la provenienza dei dati di addestramento. Con i modelli di linguaggio, che si addestrano su testo raccolto dal web, la minaccia si fa concreta. Carlini e colleghi mostrano che avvelenare una raccolta di quel tipo è alla portata di chiunque: basta ricomprare i domini scaduti a cui un elenco di indirizzi ancora rimanda, o modificare una pagina poco prima che venga fotografata, e con una sessantina di dollari si sarebbe controllato lo \(0{,}01\%\) di una grande raccolta di immagini con didascalia [CJCC+24]. E Souly e colleghi trovano che per impiantare una backdoor semplice (testo senza senso dopo una parola d’innesco) servono circa 250 documenti avvelenati da 600 milioni a 13 miliardi di parametri, benché il modello più grande veda più di venti volte i dati puliti del più piccolo [SRC+25]. A decidere è il numero assoluto dei campioni avvelenati, e la loro frazione conta poco.
Come funziona il voto del randomized smoothing si vede nel caso più semplice, un confine diritto fra due classi (Fig. 38.6): le copie dell’input sporcate di rumore gaussiano (a campana, centrato sull’input) votano, e il raggio garantito dipende da quanto netta è la maggioranza.
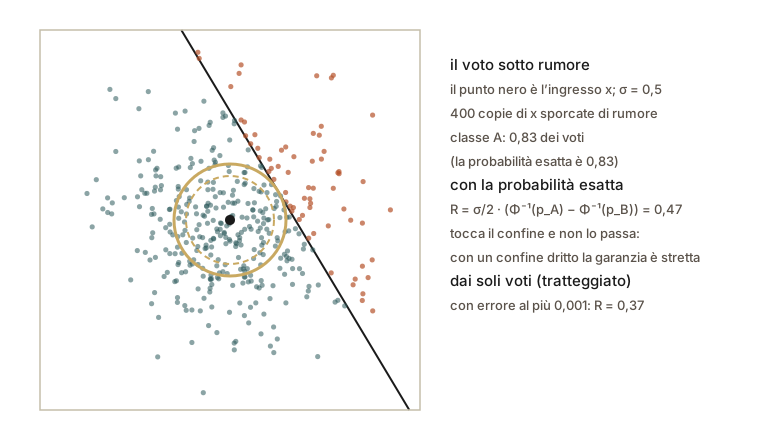
Fig. 38.6 Il randomized smoothing su un confine diritto. Le copie di x sporcate di rumore votano, e la classe di x prende la maggioranza. Il cerchio è il raggio che dà la probabilità esatta del voto, e con un confine diritto coincide con la distanza dal confine: la palla lo tocca senza superarlo. Dai soli 400 voti, con il margine d’errore che la certificazione pretende, il raggio garantito esce più piccolo.#
Marchiare il sintetico: watermarking e provenienza#
Fin qui il problema era che cosa entra in un modello; adesso guardiamo che cosa ne esce. Se un modello genera testo, immagini o voce indistinguibili dal vero, come si riconosce a posteriori che sono stati fabbricati?

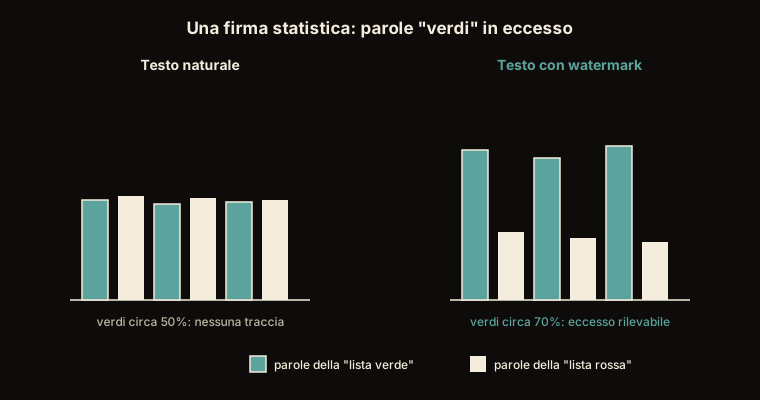
Fig. 38.7 La filigrana su un testo è uno sbilanciamento. Nessuna parola, presa da sola, è sospetta: è la proporzione sull’intero brano a non essere quella del caso.#
La regola del gioco è più semplice di quanto la Fig. 38.7 faccia sospettare. Prima di scrivere ogni parola, il modello tira a sorte: divide in due metà tutte le parole che potrebbe usare, chiama «verdi» quelle di una metà e «rosse» quelle dell’altra, e poi sceglie un po’ più spesso del normale fra le verdi. Il sorteggio sembra casuale ma non lo è: come i dadi di un videogioco, esce da un calcolo che parte da un numero segreto, e chi conosce quel numero rifà la stessa identica sequenza di sorteggi tutte le volte che vuole. Così chi vuole controllare un testo rifà tutti i sorteggi, riconta le parole verdi e vede se sono troppe. In un testo scritto da una persona sarebbero circa la metà, perché quel sorteggio la persona non lo conosceva.
E il limite si legge nella figura stessa, in filigrana: quello che si misura è una proporzione, quindi serve abbastanza testo perché lo sbilanciamento si distingua dal caso. Su una frase corta non c’è niente da misurare, e riscrivere il brano con parole proprie diluisce l’eccesso, e su un brano corto lo cancella.
C’è un limite più profondo del testo corto e della riscrittura, e non dipende da chi attacca ma dal testo stesso: il trucco delle due liste funziona solo dove il modello aveva davvero una scelta. Se sta scrivendo qualcosa di quasi obbligato (il seguito di «Barack» è «Obama», e non c’è alternativa) allora o rispetta il sorteggio e scrive una sciocchezza, o scrive la parola giusta e non lascia traccia. Sul testo pieno di scelte, come un racconto, la marca si nasconde benissimo; su codice sorgente, citazioni, elenchi di numeri, quasi per niente.
Sulle immagini l’idea è la stessa e cambiano i mezzi: la filigrana nascosta sposta di pochissimo migliaia di pixel secondo uno schema segreto, così che l’occhio non veda niente e un rilevatore che conosce lo schema ritrovi il segno anche dopo una compressione moderata. SynthID di Google DeepMind fa questo su immagini, audio e video.
La provenienza dichiarata fa l’opposto: invece di nascondere, allega. Lo standard C2PA (dalle iniziali della coalizione di aziende che lo ha scritto, Coalition for Content Provenance and Authenticity) attacca al file un cartellino con scritto chi l’ha creato, con quale strumento e come è stato modificato. E chi impedisce di scriverselo da sé, un cartellino così, e appiccicarlo a un video falso dicendo che l’ha girato una televisione? Un sigillo digitale, che funziona come la ceralacca col timbro di famiglia: solo chi ha il timbro lo sa imprimere, ma chiunque può confrontare l’impronta con il disegno del timbro, che è pubblico. Il timbro è una chiave segreta, il disegno una chiave che il produttore distribuisce a tutti, e il confronto lo fa un programma. Se il sigillo non torna, il cartellino è falso e si vede subito.
La differenza si vede tutta con una foto dello schermo, che copia i pixel e butta il resto: cancella il cartellino e lascia la filigrana, un po’ consumata. In compenso il cartellino racconta una storia, la filigrana dice soltanto «sono artificiale».
Né la filigrana né il cartellino chiudono la porta, e non è questione di farli meglio. Il cartellino si stacca in un secondo; e per la filigrana si dimostra che chi sa giudicare quando un contenuto è venuto bene, e sa riscriverlo lasciandolo equivalente, trova sempre una strada per cancellarla, se deve restare invisibile. Chi ha tempo riscrive il testo con altre parole, ritaglia e ricomprime l’immagine finché il segno non si legge più. Quello che si compra è il prezzo: far passare per autentico un contenuto fabbricato smette di essere gratis.
Sul testo il meccanismo è diverso e istruttivo. A ogni passo di generazione si partiziona pseudo-casualmente il vocabolario in una lista «verde» e una «rossa», con un seme derivato dal token precedente, e si aggiunge un piccolo bias ai logit dei verdi. Il testo resta fluido dove le alternative plausibili sono molte; e su una sequenza lunga la frazione di token verdi si scosta dalla frazione attesa \(\gamma\) (che è un parametro, non una costante: il lavoro originale la fa scorrere da \(0{,}1\) a \(0{,}9\)) in modo statisticamente rilevabile. Il rilevatore non deve conoscere il testo originale né avere accesso al modello: gli basta ricalcolare le liste e fare un test d’ipotesi (Kirchenbauer e colleghi [KGW+23]).
Che il seme dipenda dal solo token precedente serve alla robustezza: una parola sostituita altera al più due assegnazioni, la propria e quella della parola dopo. Il test si fa sulla statistica
dove \(T\) è il numero di token esaminati e \(|s|_G\) quanti di essi cadono nella lista verde, e si dichiara marcato un testo con \(z > 4\): un testo non marcato supera la soglia con probabilità di circa \(3 \cdot 10^{-5}\), nell’approssimazione normale. Nell’esempio del lavoro originale (mille token tutti verdi, \(\gamma = 0{,}5\), e un attaccante che conosce le liste e sceglie ogni sostituzione nel modo peggiore, così che ciascuna costi due verdi) la soglia cade a \(500 + 4\sqrt{250} \approx 563\) verdi: per scendere sotto bisogna togliere almeno \(437\) verdi, cioè fare almeno \(219\) sostituzioni, più di un token su cinque, e gli autori, con un conto più grossolano, parlano di circa un quarto dei token. Con una marca morbida i verdi di partenza sono meno, e ne bastano meno; chi le liste non le conosce, invece, ne deve toccare di più, perché ogni sostituzione gli rende in media un rosso solo. Una finestra di contesto più larga rende le liste più difficili da ricostruire per chi attacca e, in cambio, più fragili alle modifiche.
E c’è un limite più strutturale, perché non dipende dall’attaccante ma dal testo: la marca si può nascondere soltanto dove il modello aveva davvero una scelta, cioè dove l’entropia della distribuzione sul token successivo è alta. Su testo a bassa entropia (codice, citazioni, completamenti quasi deterministici) o non si riesce a marcare, o si marca rompendo il testo, ed è il caso limite in cui «Barack» è seguito da «Obama» mentre «Obama» è finito nella lista rossa. Lo stesso lavoro lega esplicitamente il numero atteso di token verdi all’entropia media della sequenza: le sequenze ad alta entropia si rilevano con pochi token, quelle a bassa entropia ne richiedono molti di più. I due parametri del metodo (la quota verde \(\gamma\) e l’entità del bias sui logit) comprano forza di rilevazione in cambio di qualità del testo, e il tetto che possono raggiungere lo fissa l’entropia, non la sola lunghezza.
Ed è anche il punto debole: una parafrasi erode la marca. Far riscrivere il testo a un altro modello riporta la frazione di verdi verso \(\gamma\), e sui brani corti la porta sotto la soglia del test; sui brani lunghi ne resta spesso abbastanza da rilevarla ancora, a patto di esaminare più token. Il prezzo per chi attacca è un parafrasatore abbastanza bravo da non guastare il testo. Sulle immagini, ridimensionamento, ritaglio, ricompressione o una foto dello schermo erodono il segnale; i metadati C2PA li cancella uno screenshot.
C’è poi un limite di natura teorica, non di implementazione. Zhang e colleghi [ZEF+23] dimostrano che, sotto ipotesi plausibili sull’avversario (sa giudicare la qualità di un contenuto e sa perturbarlo restando fra le versioni equivalenti), nessun watermark può essere insieme impercettibile e robusto: si può sempre costruire una sequenza di trasformazioni che preserva il significato e cancella la marca.
La conclusione onesta è la stessa della crittografia applicata: il watermarking non stabilisce cosa è vero, alza il costo di far passare il sintetico per autentico. Non esiste il lucchetto inviolabile, esiste il lucchetto che costa più della refurtiva.
Le trenta dita, in pratica#
Per toccare con mano il fenomeno non serve una rete profonda: basta il più semplice dei classificatori, una regressione logistica giocattolo (un modellino che, dato un esempio con trenta caratteristiche numeriche, stima una probabilità). Le trenta caratteristiche non rappresentano niente in particolare, sono numeri estratti a caso, e le due risposte possibili si chiamano \(0\) e \(1\): fai conto che \(1\) voglia dire «pratica da approvare». L’esperimento: scegliamo un caso che il modello azzecca, poi spostiamo ogni caratteristica di un soffio, tutte nel verso che danneggia di più il modello (trenta piccole spinte concordi, invisibili una per una: sono le dita del titolo), e guardiamo la predizione ribaltarsi.
L’esempio non è scelto a mano: il programma prende il primo caso che il modello classifica correttamente con una fiducia fra l’\(85\) e il \(95\) per cento. Su un caso in cui fosse sicuro oltre il \(97\%\) questa spinta non basterebbe a ribaltarlo, e la soglia esatta la stampa il programma stesso.
import numpy as np
rng = np.random.default_rng(0)

# --- dataset giocattolo in dimensione d, da un vero modello logistico ---
d, n = 30, 500
w_true = rng.normal(size=d)
X = rng.normal(size=(n, d))
prob = 1.0 / (1.0 + np.exp(-(X @ w_true)))
y = (rng.random(n) < prob).astype(float)

def sigmoid(z):
    return 1.0 / (1.0 + np.exp(-z))

# --- regressione logistica addestrata con la discesa del gradiente ---
w, b = np.zeros(d), 0.0
for _ in range(3000):
    p = sigmoid(X @ w + b)
    w -= 0.2 * (X.T @ (p - y) / n)
    b -= 0.2 * np.mean(p - y)

# --- scelta dell'esempio per criterio, non per indice: azzeccato e con
#     fiducia alta ma non troppo (sopra la soglia stampata non basta) ---
p_tutti = sigmoid(X @ w + b)
azzeccati = (p_tutti > 0.5) == (y == 1)
fiducia = np.maximum(p_tutti, 1 - p_tutti)
i = np.flatnonzero(azzeccati & (fiducia > 0.85) & (fiducia < 0.95))[0]

x, yt = X[i].copy(), y[i]
p0 = sigmoid(x @ w + b)

# --- FGSM: un passo lungo il segno del gradiente della loss rispetto a x ---
grad_x = (p0 - yt) * w                      # dL/dx per la cross-entropy logistica
rho = 0.15
x_adv = x + rho * np.sign(grad_x)
p1 = sigmoid(x_adv @ w + b)

def verdetto(p):                            # calcolato, non scritto a mano
    return "corretto" if int(p > 0.5) == int(yt) else "SBAGLIATO"

print(f"esempio scelto: i = {i},  vera etichetta y = {int(yt)}")
print(f"originale:  p(classe 1) = {p0:.3f}  ->  predice {int(p0 > 0.5)}  ({verdetto(p0)})")
print(f"avversario: p(classe 1) = {p1:.3f}  ->  predice {int(p1 > 0.5)}  ({verdetto(p1)})")
print(f"spinta: {rho} per caratteristica; lunghezza complessiva"
      f" {np.linalg.norm(x_adv - x):.2f} contro {np.linalg.norm(x):.2f} dell'input")

# --- lo stesso attacco su esempi nuovi, mai visti in addestramento ---
X_nuovi = rng.normal(size=(n, d))
y_nuovi = (rng.random(n) < sigmoid(X_nuovi @ w_true)).astype(float)
p_nuovi = sigmoid(X_nuovi @ w + b)
bene = (p_nuovi > 0.5) == (y_nuovi == 1)
segni = np.sign((p_nuovi - y_nuovi)[:, None] * w)
p_adv = sigmoid((X_nuovi + rho * segni) @ w + b)
ribaltati = bene & ((p_adv > 0.5) != (y_nuovi == 1))
soglia = sigmoid(rho * np.abs(w).sum())   # sopra questa fiducia non si ribalta
print(f"soglia di fiducia: {soglia:.4f}")
print(f"su {n} esempi nuovi, ribaltati {ribaltati.sum()} dei {bene.sum()}"
      f" classificati bene ({100 * ribaltati.sum() / bene.sum():.0f}%)")
esempio scelto: i = 1,  vera etichetta y = 1
originale:  p(classe 1) = 0.890  ->  predice 1  (corretto)
avversario: p(classe 1) = 0.190  ->  predice 0  (SBAGLIATO)
spinta: 0.15 per caratteristica; lunghezza complessiva 0.82 contro 6.00 dell'input
soglia di fiducia: 0.9717
su 500 esempi nuovi, ribaltati 174 dei 434 classificati bene (40%)
Il modello passa da una fiducia dell’\(89\%\) nella risposta giusta a una risposta sbagliata. E la quarta riga dice quanto è costato: la spinta complessiva vale \(0{,}82\) contro il \(6{,}00\) dell’esempio di partenza, cioè meno di un settimo. Attenzione però a come si sommano quelle spinte, perché \(0{,}82\) non è trenta volte \(0{,}15\), che farebbe \(4{,}5\). Le trenta spinte sono concordi nel verso, perché ciascuna fa salire l’errore, ma ciascuna muove una caratteristica diversa, cioè agisce lungo un asse diverso, e spostamenti lungo assi diversi si compongono come nel teorema di Pitagora: elevando al quadrato, sommando e poi facendo la radice. Il conto si rifà a mano: \(0{,}15\) al quadrato fa \(0{,}0225\), moltiplicato per trenta fa \(0{,}675\), e la radice di \(0{,}675\) è \(0{,}82\).
L’ultima riga è quella che tiene onesto l’esempio, e va letta. Su cinquecento esempi nuovi, mai visti in addestramento, una spinta di questa taglia ribalta il \(40\%\) di quelli che il modello classificava bene: è una frazione, non una certezza. Gli altri resistono tutti per la stessa ragione, e la soglia è netta: la spinta sposta il punteggio di ogni esempio della stessa quantità, quindi si ribaltano tutti e soli quelli che il modello classificava con una fiducia sotto il \(97{,}17\%\) (la soglia della penultima riga), e nessuno di quelli sopra. Il fenomeno è reale e non ha bisogno di essere gonfiato: che quattro casi su dieci si ribaltino con una spinta invisibile è già una notizia.
Il codice prova un valore solo di \(\rho\), quello scelto in partenza. La Fig. 38.8 rifà lo stesso esperimento su tutta la scala, e mostra la cosa che il prima e il dopo non possono mostrare: il punto preciso in cui la risposta si ribalta.

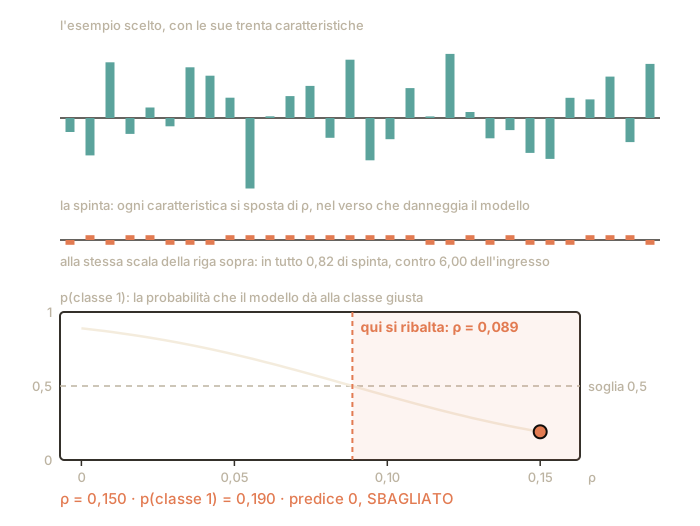
Fig. 38.8 Quanto poco basta. Ognuna delle trenta caratteristiche dell’esempio (in alto) riceve una spinta della stessa ampiezza \(\rho\) (in mezzo, disegnata alla stessa scala: è minuscola), e la probabilità della risposta giusta scende finché passa sotto la metà. Succede a \(\rho = 0{,}089\): da lì in poi il modello dà la risposta sbagliata.#
Perché spostamenti così piccoli bastano? Perché sono tanti e tutti d’accordo. Ogni caratteristica si muove appena, ma tutte e trenta si muovono nel verso che fa salire l’errore del modello, e trenta soffi concordi sono una spinta vera. Con le immagini va anche peggio: le caratteristiche sono i pixel, cioè centinaia di migliaia, e più dita premono, meno forte deve premere ciascuna. È il motivo per cui al panda dell’esempio famoso è bastato un rumore invisibile.
Il gradiente della cross-entropia rispetto all’input, per la regressione
logistica, è semplicemente \((\hat{y}-y)\,\mathbf{w}\): è la riga grad_x del
codice. E il risultato mostra la spiegazione lineare di Goodfellow: il passo
si muove lungo \(\operatorname{sign}\!\big((\hat{y}-y)\,\mathbf{w}\big)\) e sposta
il punteggio (il logit) di \(\rho\,\lVert \mathbf{w}\rVert_1\) in modulo,
sempre nel verso che fa crescere la loss. Nell’esempio \(y=1\) e \(\hat{y}<y\),
quindi la direzione è \(-\operatorname{sign}(\mathbf{w})\) e il logit cala di
\(\rho\,\lVert \mathbf{w}\rVert_1 = 3{,}54\) (il codice non lo stampa, ma
np.linalg.norm(w, 1) vale \(23{,}58\), e \(0{,}15 \times 23{,}58 = 3{,}54\)):
quanto basta a far scendere la probabilità da \(0{,}890\) a \(0{,}190\), perché il
logit di partenza era \(2{,}09\). È una quantità che cresce con il numero
di dimensioni. In alta dimensione (dove vivono immagini e testi) bastano tante
piccole spinte concordi per scavallare il confine. La stessa formula in PyTorch
si scriverebbe con x.requires_grad_(True), un passaggio loss.backward() e
x + rho * x.grad.sign(): identica idea, gradiente rispetto all’input calcolato
in automatico.
Privacy e robustezza si somigliano più di quanto la distanza fra i due argomenti faccia pensare: in nessuna delle due esiste la proprietà «al sicuro», esiste una garanzia con accanto il suo prezzo e il suo perimetro. È il criterio con cui leggere anche la sezione seguente, che porta la stessa domanda ai modelli di linguaggio. Lì l’attacco non sarà più un rumore invisibile, sarà una frase scritta in italiano che chiunque può leggere; e il perimetro da difendere non si riuscirà nemmeno a disegnare dentro il modello.
Da ricordare
I modelli imparano a memoria le cose rare o ripetute, come lo studente che recita la pagina invece di ragionare. Due conseguenze: dandogli l’inizio di una frase che c’era nei dati può completarla identica, e si può spesso indovinare se una certa persona era nei dati osservando che il modello è stranamente sicuro proprio sui suoi esempi.
In Europa una legge dice cosa si può fare con i dati di una persona, e le dà il diritto di sapere quali dati ci sono, farli correggere e farli cancellare. Il punto scomodo è che dai pesi di un modello già addestrato si tolgono con certezza solo riaddestrando, tutto o almeno la parte che li aveva visti: dagli archivi si cancellano con un clic, da lì no.
Il trucco della moneta lanciata prima di rispondere protegge la singola persona e lascia leggere il totale: si aggiunge un po’ di caso, in quantità nota. Una manopola decide quanto: più caso, più protezione e meno precisione. Ma non promette che di te non si sappia più nulla, promette che la tua presenza cambi poco le idee di chi guarda; e non ti protegge dalle conclusioni sulla popolazione a cui appartieni. Per questo «qui c’è la privacy differenziale» dice poco finché non si dice dove la manopola è stata girata.
Togliere i nomi non basta: bastano pochi dettagli presi altrove (una manciata di voti a dei film, con la data) per ritrovare una persona in una tabella «anonima», come è successo con i dati del Netflix Prize. E smussare le caselle finché ogni riga ha delle gemelle non basta nemmeno, se le gemelle hanno tutte la stessa diagnosi.
Un’altra strada è non raccogliere i dati affatto: si manda il modello a casa di chi li ha, ognuno lo allena un po’ sui propri e rimanda indietro solo quello che ha imparato. Riduce il rischio, non lo azzera.
Si può far sbagliare una rete a comando con tante piccole spinte concordi, invisibili una per una. Difendersi è una rincorsa: al momento non esiste una difesa definitiva, e «robusto» vuol sempre dire robusto contro un attacco preciso e dentro un limite dichiarato.
Quello che un modello produce si può marchiare in due modi opposti: un segno nascosto dentro il testo o l’immagine, che l’occhio non vede e un rilevatore ritrova; oppure un cartellino allegato che dice chi l’ha fatto, con un sigillo che solo lui sa produrre. Chi ha tempo riscrive il testo, ricomprime l’immagine e il cartellino lo stacca in un secondo: quello che si compra è il prezzo, non una porta chiusa.
Chi controlla i dati di addestramento può anche piazzarci dentro una parola d’ordine segreta che, quando compare, fa fare al modello quel che vuole lui.
Da ricordare
I modelli memorizzano i dati rari o ripetuti: da qui gli attacchi di membership inference (capire se un individuo era nel training) e l’estrazione verbatim di dati sensibili dagli LLM. La memorizzazione è overfitting visto come falla di privacy.
La privacy differenziale [DMNS06] garantisce che l’output cambi al più di un fattore \(e^{\varepsilon}\) se un individuo entra o esce dai dati, aggiungendo rumore (meccanismo di Laplace) calibrato alla sensibilità. È un limite all’inferenza, non un’impossibilità di dedurre ([DR14]: nothing is learned è irraggiungibile), e non copre le inferenze sulla popolazione. Il valore di \(\varepsilon\) va sempre guardato: \(e^{0{,}5}\approx 1{,}65\), ma \(e^{8}\approx 3000\). DP-SGD [ACG+16] la porta nel deep learning con clipping per-esempio + rumore gaussiano; su MNIST costa poco più di un punto di accuratezza a \(\varepsilon \approx 8\), cioè con una garanzia debole, e già tre a \(\varepsilon = 2\).
La de-identificazione non protegge: pochi attributi incrociati con una fonte esterna reidentificano (Netflix Prize: otto voti con le date approssimate individuano il \(99\%\) delle righe); il \(k\)-anonimato cade già per omogeneità e per conoscenza di sfondo, e regge solo contro chi non ha altre tabelle da incrociare. Per il GDPR i dati pseudonimizzati restano dati personali.
Il federated learning [MMR+17] porta il modello ai dati invece del contrario (FedAvg); ma dai gradienti condivisi l’informazione trapela, e vanno protetti con DP e aggregazione sicura.
Gli esempi avversari [GSS15] ingannano una rete con perturbazioni impercettibili: FGSM somma \(\rho\) per il segno del gradiente della loss rispetto all’input; PGD [MMS+18] ne è la versione iterativa e la base dell’adversarial training. Attenzione al simbolo: il raggio della perturbazione qui è \(\rho\), mentre negli articoli si scrive \(\varepsilon\), che in questo capitolo è già il budget di privacy.
La palla \(\ell_p\) è una comodità matematica, non il modello di minaccia: la robustezza si dichiara sempre con accanto perimetro e attacco.
Sul lato dell’output, il watermarking del testo sbilancia la scelta dei token verso una lista pseudo-casuale e si rileva con un test d’ipotesi [KGW+23]: regge dove l’entropia è alta, non sul testo quasi obbligato, e una parafrasi lo erode fino a cancellarlo sui brani corti; il C2PA allega invece una provenienza firmata, che uno screenshot toglie. Nessun watermark può essere insieme impercettibile e robusto [ZEF+23]: alza il costo del falso, non stabilisce che cosa è vero.
Non esiste difesa definitiva: è una corsa agli armamenti. La robustezza certificata offre garanzie provate ma su raggi piccoli, e nel caso del randomized smoothing [CRK19] sono garanzie probabilistiche sul classificatore lisciato; data poisoning e backdoor attaccano invece in fase di addestramento.