


Il pezzo più piccolo che si può addestrare#
Chi innesta una vite non pianta un albero nuovo. Prende un ceppo già radicato, scelto perché regge quel terreno e resiste ai suoi parassiti, e ci salda sopra un rametto di un’altra pianta, quello che dà l’uva che gli interessa. Le due parti hanno storie separate e restano quello che sono: il mestiere sta tutto nella saldatura, che è la più piccola delle tre cose e l’unica che il vivaista fabbrica davvero.
L’architettura che segue funziona come un innesto: il ceppo è il modello di linguaggio, già radicato e capace di parlare; il rametto è l’encoder visivo, che porta l’occhio; la saldatura è il pezzo in mezzo, il connettore. Fra le giunzioni provate si è diffusa soprattutto la più semplice, non la più ingegnosa.
La domanda che genera l’architettura#
Esistono già due componenti che funzionano bene, ciascuno per conto proprio. Gli encoder visivi, come il Vision Transformer [DBK+21] o la torre di immagini di un modello contrastivo come CLIP [RKH+21], trasformano una fotografia in una griglia di vettori, uno per patch, che ne codifica il contenuto (ai connettori servono queste feature delle patch, in genere del penultimo strato, e non il solo vettore finale con cui CLIP confronta le didascalie). I modelli di linguaggio scrivono, seguono un’istruzione, argomentano. Nessuno dei due fa il mestiere dell’altro, e nessuno dei due è economico: dietro ciascuno ci sono mesi di calcolo su cluster di GPU.
Addestrare da zero un unico modello che veda e parli sarebbe la soluzione pulita, ed è fuori portata per quasi tutti. La domanda diventa allora un’altra:
qual è il pezzo più piccolo che si può addestrare perché quei due modelli comincino a parlarsi?
Non è solo una questione di soldi. C’è una seconda ragione per lasciare fermi i pesi che esistono già. Un modello di linguaggio riaddestrato su qualche milione di didascalie perde per strada una parte di quello che sapeva fare con il testo puro: impara una cosa nuova cancellandone una vecchia. È la dimenticanza catastrofica, già incontrata nella sezione sui modelli multilingua. Congelare dà anche una garanzia sul comportamento che si vuole conservare, oltre al risparmio.
Che cosa deve fare, di preciso, il connettore#
Il pezzo in mezzo si chiama connettore e deve fare due cose insieme. La prima è cambiare spazio: il modello di linguaggio lavora su vettori di \(\mathbb{R}^{d_t}\), le righe della sua matrice di embedding, mentre l’encoder visivo produce vettori di \(\mathbb{R}^{d_v}\), con \(d_v\) in genere diverso da \(d_t\); e i due spazi si sono formati separatamente, quindi nessuna coordinata dell’uno corrisponde a una dell’altra. La seconda è decidere quanti vettori consegnare: ognuno occupa nella sequenza una posizione, come una parola, e quella posizione si paga in calcolo e in memoria.
Il connettore è l’interprete di cui si parlava all’inizio del capitolo. Un modello di linguaggio, dentro, non riceve parole: riceve liste di numeri tutte della stessa lunghezza, che va a pescare in una tabella dove a ogni parola corrisponde la sua lista. Anche l’encoder visivo produce liste di numeri, ma sono lunghe diversamente e scritte in un’altra convenzione, come un menu in una lingua straniera, dove i piatti ci sono tutti e nessuna parola combacia: tradurre è il primo mestiere. Il secondo è decidere quante liste consegnare, e qui servono numeri veri.
Un encoder molto usato lavora su immagini da \(336 \times 336\) puntini e le taglia in tessere da \(14 \times 14\): siccome \(336 : 14 = 24\), ne stanno 24 per riga e 24 per colonna, cioè \(24 \times 24 = 576\) tessere, e quindi 576 liste di numeri. Allega quell’immagine a una domanda di venti parole. La sequenza che entra nel modello di linguaggio è fatta di 596 pezzi, e 576 su 596 sono immagine: il 97%. La tua domanda è una briciola dentro un contesto quasi interamente occupato dalla foto.
Il costo dell’attenzione, il meccanismo con cui ogni pezzo guarda tutti gli altri, cresce come il quadrato della lunghezza della sequenza (è il conto fatto nella sezione sul meccanismo di attenzione: se i pezzi raddoppiano, le coppie da confrontare quadruplicano). Se al posto di 576 tessere ne passassimo 32 (un numero che qualcuno ha scelto davvero), la sequenza scenderebbe da 596 a 52 pezzi, cioè undici volte e mezzo più corta; e siccome i confronti vanno col quadrato, undici e mezzo per undici e mezzo fa circa centotrenta volte meno confronti.
Vale però la regola vista all’inizio del capitolo: i confronti sono solo una parte del lavoro. Dopo aver guardato gli altri, ogni pezzo passa da solo per una lunga catena di calcoli tutta sua, che cresce quanto i pezzi, e in un modello di linguaggio grande, a seicento pezzi, pesa una quarantina di volte più dei confronti. Il conto vero cala quindi di undici volte e mezzo, non di centotrenta, e il quadrato comincerebbe a comandare solo quando i pezzi si contano a decine di migliaia.
Ecco perché «quanti» pesa lo stesso: ogni tessera occupa un posto, i posti sono contati, e mentre scrive la risposta, parola dopo parola, il modello tiene il taccuino già visto fra i Transformer, con due righe per ogni pezzo che ha letto: 576 tessere sono 576 coppie di righe in più. Il risparmio, quando si comprime, si paga in quello che dell’immagine viene buttato via.
L’encoder produce \(\mathbf{Z} \in \mathbb{R}^{N \times d_v}\), con \(N\) il numero di patch e \(d_v\) la dimensione delle sue feature; il modello di linguaggio consuma sequenze di vettori in \(\mathbb{R}^{d_t}\), dove \(d_t\) è la dimensione dei suoi embedding. Un connettore è una funzione appresa
dove \(\theta\) sono i suoi parametri (gli unici che si aggiornano, nella configurazione base) e \(M\) il numero di vettori consegnati al modello di linguaggio. Sono quindi due i gradi di libertà: la mappa, che riallinea la geometria, e il fattore di compressione \(N/M\).
Il secondo grado di libertà ha un prezzo esplicito. Se il prompt testuale ha \(T\) token, il costo dell’attenzione per strato è \(O\big((M+T)^2 d_t\big)\), e la memoria della KV cache cresce linearmente in \(M+T\) per ogni strato e ogni testa. Con i valori dell’esempio numerico, \(N = 576\) e \(T = 20\): passare da \(M = 32\) a \(M = N\) moltiplica il termine quadratico per \((596/52)^2 \approx 131\). Quel \(131\) però non è il rapporto fra i due costi: a \(M + T \approx 600\) e \(d_t = 4096\) il termine quadratico vale il \(2{,}4\%\) del blocco (è il conto \(4(M+T)^2 d_t\) contro \(24 (M+T) d_t^2\) che la sezione sulla risoluzione fa per esteso), e i FLOP totali per strato scendono di \(11{,}7\) volte, cioè quanto la sequenza. Quello che si paga davvero, a queste lunghezze, è il contesto occupato e la KV cache, che crescono linearmente: per un modello da sette miliardi di parametri con attenzione multi-testa (32 strati, \(d_t = 4096\), mezza precisione) un token costa \(2 \cdot 32 \cdot 4096 \cdot 2\) byte, cioè \(0{,}5\) MiB, e quindi 596 token pesano circa 300 MiB per richiesta contro i 26 MiB di 52 (con l’attenzione a gruppi di query i numeri scendono del rapporto fra le teste). È per questo che la compressione, quando si può fare, rende praticabile allegare un’immagine a ogni richiesta.
Tre risposte, dalla più elaborata alla più povera#
Tre soluzioni hanno lasciato il segno, e si presentano in ordine di complessità decrescente, che per questi sistemi coincide con l’ordine di uscita: Flamingo nel 2022, BLIP-2 e LLaVA nel 2023. L’idea della proiezione semplice però è più vecchia di tutti e tre: un prefisso visivo, cioè dei vettori d’immagine messi davanti al testo, ottenuto con una proiezione lineare verso un modello di linguaggio congelato, esisteva già nel 2021 [TMC+21], e a imporla è stata la dimostrazione, con LLaVA, che bastava.

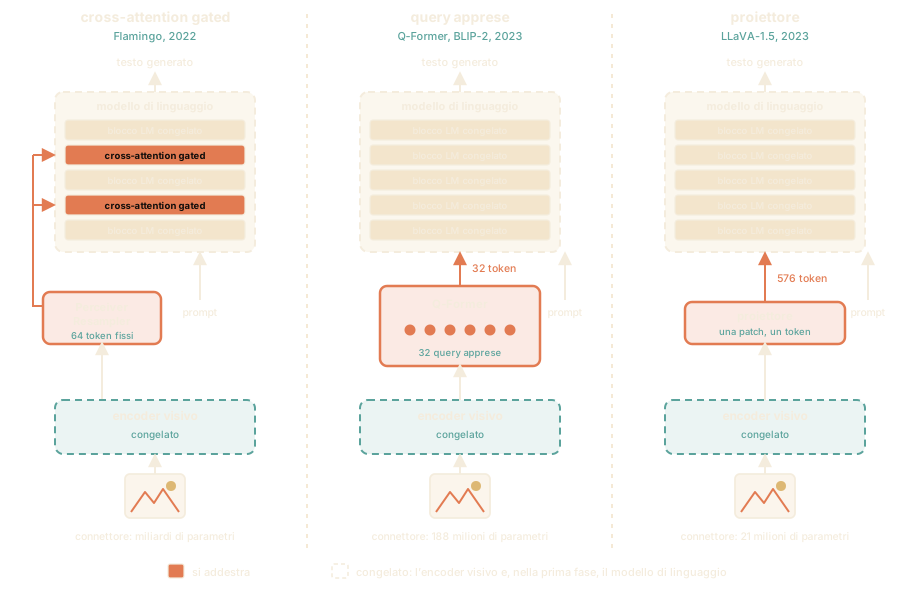
Fig. 19.4 Gli stessi due modelli, tre connettori diversi (a destra quello di LLaVA-1.5). Il conto del connettore scende da sinistra a destra (miliardi di parametri, poi 188 milioni, poi 21), e i primi due comprimono a un numero fisso di vettori (64 e 32, qualunque immagine arrivi) mentre il terzo non comprime affatto: consegna un token per ogni tessera, ed è il più leggero dei tre. Il modello di linguaggio è disegnato come nella prima fase: in LLaVA, nella seconda, si riaddestra anche lui.#
Come mostra Fig. 19.4, i blocchi alle estremità non cambiano mai. Cambia il pezzo in mezzo, e cambiano con lui due grandezze: quanti parametri si addestrano, che calano da sinistra a destra di quasi tre ordini di grandezza, e se ci sia o no una compressione. Le prime due colonne comprimono e la terza no, ed è quest’ultima distinzione, non il conto dei parametri, a decidere quale delle tre si è diffusa.
Aggiungere strati nuovi dentro il modello congelato#
La prima risposta, quella di Flamingo [ADL+22] nel 2022, non mette il connettore prima del modello di linguaggio: lo mette dentro. Fra i blocchi congelati si inseriscono strati nuovi di cross-attention, dove le query vengono dal testo e le chiavi e i valori dall’immagine (il testo chiede, l’immagine risponde), e sono questi strati (più il pezzo che prepara i vettori visivi) l’unica cosa che si addestra. Encoder visivo e modello di linguaggio restano entrambi fermi; gli strati nuovi entrano ogni quarto blocco nella versione di Flamingo da nove miliardi di parametri, e ogni settimo in quella da ottanta.
Inserire in un modello addestrato strati inizializzati a caso è però pericoloso: al primo passo quegli strati emettono rumore, il rumore si somma alle attivazioni costruite in mesi di addestramento, e il comportamento che si voleva conservare si degrada prima ancora che l’addestramento cominci. Flamingo lo evita con uno scalare per sotto-strato.
Un secondo microfono va aggiunto a un impianto audio già tarato bene. Acceso al volume che capita, rovina il concerto. Si collega allora con il volume a zero: l’impianto suona esattamente come prima, come se il microfono non ci fosse. Poi il volume si alza, se e quanto serve, e ha un fondo scala: al massimo il microfono nuovo entra a volume pieno, e più di così non lo si può amplificare.
Ogni strato nuovo è collegato così, anzi due volte, perché è fatto di due pezzi, uno che va a guardare l’immagine e uno che rielabora quello che ha raccolto: ciascuno ha il suo volume, un unico numero che moltiplica tutto quello che il pezzo produce prima di sommarlo al resto, e che parte da zero. Al primo istante l’immagine non influenza nulla e il modello si comporta identico a com’era; poi l’addestramento scopre che alzare il volume conviene, perché aiuta a indovinare le parole giuste, e lo alza da sé.
Resta il problema di quante liste di numeri consegnare. Un’immagine ne dà centinaia, un video ne dà centinaia per ogni fotogramma, e gli strati nuovi dovrebbero confrontarsi con tutte a ogni piano del modello, a un costo che cresce con la durata del video. Il pezzo che se ne occupa, il Perceiver Resampler, ne fa uscire sempre 64, qualunque sia il materiale che entra, e da lì in poi il costo non dipende più dal formato. Le 64 liste in uscita corrispondono a 64 domande fisse che il Resampler ha imparato a fare in addestramento. Per ciascuna domanda guarda tutto il materiale che è entrato, prende soprattutto dai pezzi che rispondono meglio, e scrive la risposta nella sua lista: la lista numero uno è sempre la risposta alla domanda numero uno, per una foto come per un’ora di video. È un modulo prestampato con 64 righe, una per domanda, non un imbuto tarato su una quantità: che il materiale sia poco o tanto, cambia solo dove ciascuna riga va a pescare.
Tutto questo, gli strati nuovi più il Resampler, pesa miliardi di parametri, cioè di numeri da imparare: è un modello dentro il modello.
Il meccanismo si chiama tanh gating. Ogni sotto-strato aggiunto entra nel flusso residuale non come \(\mathbf{x} \leftarrow \mathbf{x} + \mathrm{XAttn}(\mathbf{x}, \mathbf{R})\), ma come
dove \(\mathbf{x}\) sono le attivazioni del testo che attraversano il modello congelato, \(\mathbf{R}\) i vettori visivi già preparati dal modulo a monte, \(\mathrm{XAttn}\) la cross-attention (query da \(\mathbf{x}\), chiavi e valori da \(\mathbf{R}\)) e \(\alpha\) uno scalare appreso, inizializzato a zero (ogni blocco ne ha due, uno per la cross-attention e uno per il feed-forward che la segue). Poiché \(\tanh(0) = 0\), alla prima iterazione ogni blocco aggiunto è esattamente l’identità: la funzione calcolata dalla rete è, token per token, quella del modello di partenza. L’inizializzazione è quindi esatta e non soltanto «piccola», e si parte da un punto di cui si conoscono le prestazioni; \(\tanh\) dà inoltre un gate limitato in \((-1, 1)\), che non fa esplodere il ramo nuovo quando \(\alpha\) cresce. Lo stesso schema avvolge il blocco feed-forward che accompagna la cross-attention, da cui il nome gated cross-attention dense.
A monte, il Perceiver Resampler risolve il problema del formato variabile. È un modulo di attenzione con \(K\) latenti appresi \(\mathbf{L} \in \mathbb{R}^{K \times d}\) (nel lavoro, \(K = 64\)) che fanno da query; chiavi e valori vengono dalla concatenazione \([\mathbf{Z}; \mathbf{L}]\) delle feature visive, appiattite in un’unica sequenza e già proiettate in \(\mathbb{R}^{N \times d}\) (la concatenazione avviene lungo l’asse della sequenza, quindi la dimensione di feature dev’essere la stessa dei latenti), con i latenti stessi, che quindi calcolano l’attenzione anche su di sé: \(\mathbf{R} = \mathrm{XAttn}(\mathbf{L}, [\mathbf{Z}; \mathbf{L}]) \in \mathbb{R}^{K \times d}\), ripetuta per qualche strato con un feed-forward dopo ciascuno. Qualunque sia \(N\) (una sola immagine, oppure le feature spazio-temporali di un video) l’uscita ha sempre \(K\) righe, e il costo a valle diventa indipendente dalla risoluzione e dalla durata: è questa, nel lavoro, la ragione del Resampler, perché le cross-attention accetterebbero un numero qualunque di chiavi e valori, ma a un costo che cresce con \(N\) a ogni strato in cui compaiono. Il Resampler stesso costa \(O\big(K(N+K)d\big)\) per strato, lineare in \(N\).
Il conto dei parametri, però, è severo: gli strati aggiunti sono blocchi di attenzione a dimensione piena distribuiti lungo tutta la pila, e nella variante più grande la differenza fra il totale dichiarato (ottanta miliardi di parametri) e il modello di linguaggio congelato su cui poggia (settanta) è dell’ordine dei dieci miliardi. Il connettore, qui, è letteralmente un modello dentro il modello.
Il Q-Former di BLIP-2#
La seconda risposta, il Q-Former di BLIP-2 [LLSH23] nel 2023, tiene l’idea della compressione e abbandona quella degli strati inseriti nel modello di linguaggio. Il connettore torna a essere un pezzo esterno, messo in fila fra i due modelli congelati, e il suo compito è ridurre la griglia di feature visive a un pugno di vettori che il modello di linguaggio riceve come un normale prefisso di token.
È la stessa idea del modulo prestampato, con due differenze: le righe sono 32, e il riassunto non entra dentro il modello di linguaggio ma gli viene messo davanti, come le prime parole della domanda. Un assistente, davanti a qualunque fotografia, compila sempre lo stesso questionario di 32 domande. Le domande non gliele detta nessuno: se le è scritte da solo in addestramento, tenendo quelle le cui risposte servivano di più a chi poi doveva parlare dell’immagine, e guardandole tutte insieme perché non finissero a chiedere due volte la stessa cosa. Potrebbero essere «che oggetti ci sono» o «dove stanno l’uno rispetto all’altro», e cose senza nome che a noi non verrebbero in mente.
Le ha scritte in due tempi. Prima con le foto e le loro didascalie, correggendo le domande finché dalle risposte si riusciva a risalire alla didascalia giusta, o a scriverla: è il gioco del «chi va con chi» della sezione sull’allineamento, più un dettato. Solo dopo le risposte sono andate a chi doveva scriverci sopra. Saltando la prima lezione, le domande imparerebbero soltanto da quello che il modello di linguaggio riesce a farne, e nelle prove degli autori il risultato peggiora molto: con uno dei due modelli di linguaggio provati, anzi, peggiora via via che lo studio va avanti.
Davanti a ogni nuova foto pone le 32 domande, la guarda per rispondere e consegna 32 risposte: da lì in poi il modello di linguaggio ha in mano solo quelle, la foto non la vede più.
Il guadagno si legge nei numeri. L’encoder qui produce 257 liste per ogni foto: l’immagine è da 224 puntini di lato, le tessere da 14, quindi 16 per riga e 16 per colonna fanno 256 tessere, più una lista che riassume l’intera fotografia. (Su un’immagine da 336 puntini, e senza contare la lista di riassunto, le tessere erano 576: il numero cambia con la foto e con la tessera, non è mai fisso.) Da 257 si scende a 32, otto volte meno, e ciascuna risposta è anche più corta, 768 numeri invece dei 1024 con cui l’encoder descrive una tessera: in tutto passano \(32 \times 768\) numeri contro \(257 \times 1024\), circa undici volte meno.
Il questionario lo compila una macchina sua, che pesa 188 milioni di parametri, cioè di numeri da imparare: poca cosa accanto ai due modelli che collega.
Il Q-Former è un piccolo Transformer (inizializzato dai pesi di BERT-base, per un totale di 188 milioni di parametri) che riceve un insieme di query apprese \(\mathbf{Q} \in \mathbb{R}^{M \times d_q}\), con \(M = 32\) e \(d_q = 768\). Le query non dipendono dall’immagine: sono parametri del modello, come una matrice di pesi. Dentro il blocco si alternano due interazioni: una self-attention fra le query (che permette loro di specializzarsi e non chiedere tutte la stessa cosa) e una cross-attention verso le feature congelate dell’immagine, inserita ogni due blocchi, in cui l’immagine fornisce chiavi e valori.
dove \(\mathbf{Z}\) sono le feature dell’encoder visivo, \(\theta\) i parametri del Q-Former e \(\mathbf{W}_{\text{proj}} \in \mathbb{R}^{768 \times d_t}\) una proiezione lineare che porta le uscite nella dimensione degli embedding del modello di linguaggio. Il collo di bottiglia è dimensionato apposta: con un ViT-L/14 le feature visive sono \(257 \times 1024\), l’uscita è \(32 \times 768\), cioè un fattore \(10{,}7\) in meno di numeri. Le query non possono portarsi dietro tutto, e sono costrette a selezionare.
L’addestramento avviene in due fasi, e la prima serve a decidere che cosa selezionare: il Q-Former è collegato al solo encoder visivo e ottimizza tre obiettivi congiunti (contrastivo fra immagine e testo, generazione di testo condizionata all’immagine, classificazione binaria di appaiamento). In questa fase il Q-Former ha anche una metà testuale, che condivide con le query gli strati di self-attention, e i tre obiettivi differiscono soltanto per la maschera: nel contrastivo query e testo non si vedono, e la somiglianza è il massimo sulle 32 query; nella generazione il testo vede le query e sé stesso in modo causale, le query non vedono il testo; nell’appaiamento si vedono tutti. Le query sono così costrette a raccogliere dall’immagine ciò che serve a scrivere il testo, perché il testo può arrivare all’immagine soltanto attraverso di loro. Solo nella seconda fase l’uscita viene proiettata e data al modello di linguaggio congelato, con la sola loss di modellazione del linguaggio. Senza la prima fase il Q-Former si addestra soltanto attraverso il modello di linguaggio congelato, come il Perceiver Resampler di Flamingo, e nelle prove degli autori le prestazioni sulle domande visive a zero esempi scendono molto; con OPT come modello di linguaggio peggiorano anzi via via che l’addestramento procede, per dimenticanza catastrofica.
Una matrice, e basta#
La terza risposta, LLaVA [LLWL23] nello stesso 2023, è la più semplice: niente compressione, niente query apprese, niente strati nuovi. Il connettore è una matrice, detta proiettore: il vettore di ogni tessera viene moltiplicato per quella matrice e diventa un token, e i token si mettono in fila davanti al prompt come fossero parole.
Una matrice è una tabella di conversione, e non fa niente di più misterioso di una ricetta a dosi fisse: ogni numero che esce è una miscela sempre uguale dei numeri che entrano, con le dosi decise una volta per tutte durante l’addestramento. Qui la lista che entra è la descrizione di una tessera come l’ha prodotta l’encoder (1024 numeri), quella che esce è un token nel formato che il modello di linguaggio si aspetta (4096 numeri). Una tessera entra, un token esce: nessuna selezione, nessun riassunto, nessuna domanda decisa in anticipo.
Quanto costa una tabella del genere? Ha una casella per ogni coppia «numero in ingresso, numero in uscita»: \(1024 \times 4096\), cioè poco più di quattro milioni di caselle, e ogni casella è un parametro, un numero che l’addestramento regola. Il modello di linguaggio a cui si salda ha sette miliardi di parametri, quindi la saldatura pesa lo \(0{,}06\%\) del pezzo che collega, sei centesimi di punto percentuale. Una versione successiva, LLaVA-1.5 [LLLL24], mette due tabelle in fila invece di una, e guarda le immagini da \(336\) puntini invece che da \(224\): è quella da 576 tessere. La prima tabella resta quella di prima, da \(1024 \times 4096\); la seconda parte da un token già tradotto, quindi è da \(4096 \times 4096\), quattro volte più grande, e in tutto fanno ventuno milioni di parametri, lo \(0{,}3\%\). Sempre un’inezia, ma cinque volte l’inezia di prima.
dove \(\mathbf{Z}_v \in \mathbb{R}^{N \times d_v}\) sono le feature dell’encoder visivo congelato, \(\mathbf{W}\) è l’unico parametro addestrato nella prima fase e \(\mathbf{H}_v \in \mathbb{R}^{N \times d_t}\) sono i token visivi, che vivono nello stesso spazio degli embedding di parola. La mappa è lineare e applicata patch per patch: nessuna interazione fra le righe, nessuna riduzione di \(N\).
Con \(d_v = 1024\) (un ViT-L/14) e \(d_t = 4096\) (un modello di linguaggio da sette
miliardi di parametri), \(\mathbf{W}\) ha \(1024 \times 4096 \approx 4{,}2\) milioni
di parametri, cioè lo 0,06% del modello che serve. Una versione successiva,
LLaVA-1.5 [LLLL24], sostituisce la mappa lineare con un
percettrone a due strati (Linear \(\to\) GELU \(\to\) Linear), che porta il
connettore a circa 21 milioni di parametri, cioè lo \(0{,}3\%\) del totale, e
alza la risoluzione da \(224\) a \(336\) pixel, cioè da 256 a 576 token.
Contro i miliardi della prima risposta e i 188 milioni della seconda siamo a un altro ordine di grandezza, ed è questa terza la strada presa dalla famiglia di LLaVA e da molti dei modelli aperti che l’hanno seguita.
Perché si è diffuso il più semplice#
Il Q-Former è più sofisticato, e la cross-attention con il gate di Flamingo è più rispettosa del modello congelato: perché, nei modelli aperti della famiglia di LLaVA, la strada che si è imposta è quella della matrice? La ragione di principio è che gli altri due connettori fanno una cosa che sembrava un pregio ed è un difetto: comprimono, cioè scelgono che cosa dell’immagine conta prima di conoscere la domanda. È una ragione, non una legge, e ha i suoi confini: in sistemi più grandi la cross-attention è ancora in uso.
Un collega ti prepara le carte per una riunione. Nella versione efficiente ti legge un fascicolo di quaranta pagine e ti consegna dieci righe di riassunto: veloce, comodo, quasi sempre sufficiente. Nella versione inefficiente ti mette il fascicolo intero sulla scrivania e ti lascia sfogliarlo.
Finché in riunione ti chiedono quello che il collega si aspettava, il riassunto vince a mani basse. Il giorno in cui qualcuno chiede il numero scritto in una nota a piè di pagina, a pagina dodici, il riassunto non solo non lo contiene: non c’è modo di andarlo a prendere, perché il fascicolo il collega se l’è portato via.
I connettori che comprimono sono il collega efficiente, e nella versione di base il riassunto lo scrivono sempre uguale, prima di sentire la domanda. Il proiettore è il fascicolo lasciato sulla scrivania: costa contesto (576 tessere occupano posto e tempo di calcolo) ma non butta via niente, e la selezione la fa l’attenzione del modello di linguaggio, quando la domanda è già arrivata.
Il fascicolo sulla scrivania, però, regge finché sono quaranta pagine. Se ne fossero quattromila (una fotografia enorme, oppure un’ora di video, un fotogramma dopo l’altro), sfogliarle tutte a ogni domanda non si potrebbe, e il collega che riassume tornerebbe ad avere ragione. E a parità di pagine consegnate, chi le abbia scelte, e come, conta poco: conta quante sono.
Ne esce una regola generale, con i suoi confini: quando il collo di bottiglia è l’informazione, e non il calcolo, conviene rimandare la selezione al momento in cui si conosce la domanda.
Il punto si formula bene in termini di condizionamento, cioè di che cosa si sa del compito nel momento in cui si sceglie che cosa tenere. Un connettore con \(M \ll N\) è un canale a capacità fissa, e la funzione \(g_\theta\) che decide che cosa passa viene appresa marginalizzando sulla distribuzione dei compiti visti in addestramento: produce il riassunto ottimo in media. All’inferenza però il compito è la domanda che l’utente ha scritto, e non più una variabile aleatoria, e il connettore non la vede: i token visivi si calcolano prima di leggere il prompt (nel Q-Former per costruzione, dato che le query sono parametri). L’informazione scartata è irrecuperabile, e lo è prima che il condizionamento su cui conterebbe sia disponibile.
Con \(M = N\) e una mappa iniettiva, invece, nessuna informazione viene scartata a monte: la selezione è delegata all’attenzione del modello di linguaggio, che opera con query derivate dal testo (quindi condizionate alla domanda) e agisce a ogni strato e in ogni testa, non una volta sola. La compressione non sparisce, cambia posto: da preprocessing fisso diventa attenzione dinamica. Il principio generale è che quando il collo di bottiglia è informativo e non computazionale, la selezione va rimandata al punto del sistema in cui è disponibile il massimo condizionamento; è la stessa logica per cui il collo di bottiglia del seq2seq classico è stato sciolto dall’attenzione di Bahdanau invece che da un vettore di contesto più grande.
Quattro precisazioni, per non trasformare un’osservazione in un dogma. La prima: la cecità alla domanda non è inevitabile, e InstructBLIP [DLL+23] la toglie passando l’istruzione dentro il Q-Former insieme alle query. La seconda: a parità di numero di token, le ablazioni sistematiche [MGF+24] trovano che il tipo di connettore conta poco, mentre contano l’encoder, la risoluzione e quanti token visivi arrivano; la ragione di principio vale quindi soprattutto come argomento contro la compressione, più che a favore della matrice. E la cross-attention non è sparita: Llama 3 la inserisce dopo ogni quarto strato del modello di linguaggio, circa cento miliardi di parametri nella versione da 405 [GDJ+24], e NVLM, confrontando le due architetture a parità di condizioni, la trova più efficiente sulle immagini ad alta risoluzione, mentre la versione a soli token è più accurata sull’OCR [DLW+24]. La terza: il prezzo è pesante: su immagini ad alta risoluzione, su documenti e sui video il contesto e la cache si riempiono per primi, e più in là, oltre i \(6 d_t\) token, il termine quadratico calcolato sopra prende il sopravvento. Lì il collo di bottiglia torna a essere computazionale e la compressione torna sensata (è il tema della sezione sulla risoluzione, che quella soglia la ricava). E la quarta: le query apprese sono un’idea con un dominio di validità, e riappaiono proprio dove i token visivi sarebbero troppi.
Due tempi, in quest’ordine#
Resta da dire come si addestra il connettore: in due tempi, con la stessa loss, due insiemi di dati e due insiemi di parametri addestrati. È la ricetta del primo LLaVA, dove saltare la prima fase costava qualche punto.
Primo tempo, allineamento delle feature. Si congela tutto e si addestra il solo connettore su coppie immagine-didascalia, con l’obiettivo di sempre di un modello di linguaggio: data l’immagine, scrivi la sua didascalia, una parola dopo l’altra. Nel primo lavoro su LLaVA questa fase usa 595 000 coppie filtrate da un grande corpus di immagini e testi del web. Non si insegna niente di nuovo ai due modelli: si insegna al connettore dove scrivere, cioè si allineano le feature visive alla regione dello spazio che il modello di linguaggio sa già leggere, nello stesso senso geometrico della sezione sull’allineamento.
Secondo tempo, visual instruction tuning. Si scongela anche il modello di linguaggio (l’encoder visivo di norma resta fermo) e si continua su dialoghi che riguardano immagini. È l’instruction tuning descritto nella sezione sul post-training, applicato a un modello che adesso ha un occhio, e vale anche qui che serve poco materiale rispetto al pre-addestramento del modello di linguaggio: 158 000 esempi nel primo LLaVA, 665 000 in LLaVA-1.5 [LLLL24].
Perché due fasi e non una sola? Perché sono due lezioni diverse, e la prima toglie un rischio alla seconda.
La prima è di traduzione pura: il connettore deve capire dove mettere le cose. Se qui lasciassi libero anche il modello di linguaggio, potrebbe adattarsi ai vettori sgangherati che il connettore gli manda all’inizio, e il connettore non avrebbe più motivo di mandarli fatti bene, come un’orchestra che si aggiusta sugli errori del principiante invece di aspettare che impari.
La seconda è di comportamento: rispondere alla domanda, e non limitarsi a descrivere la foto. Qui il modello di linguaggio deve poter cambiare, perché il compito non è più quello su cui era stato addestrato.
Il rischio dell’orchestra c’è, ma non è inevitabile: quando uno studio successivo ha provato con cura a fare le due lezioni insieme, con una buona ricetta, il risultato è stato lo stesso e il costo un quinto in meno. L’ordine in due tempi resta una cautela, da verificare caso per caso.
Le due fasi ottimizzano la stessa forma di loss, la cross-entropia autoregressiva sui token della risposta,
dove \(y_t\) è il token al passo \(t\), \(\mathbf{H}_v\) sono i token visivi e \(\mathbf{x}\) il prompt testuale, e cambiano soltanto per (a) quali parametri stanno dentro \(\theta\) e (b) come sono fatti i dati.
Nella prima fase \(\theta\) contiene i soli parametri del connettore e i dati sono coppie immagine-didascalia; il compito è quasi geometrico, portare le feature visive nella regione dello spazio di embedding che il modello di linguaggio sa già leggere. Nella seconda \(\theta\) include i pesi del modello di linguaggio e i dati sono conversazioni multi-turno; la loss è mascherata sui token dell’istruzione e su quelli visivi, cioè il modello li legge ma non viene penalizzato per non saperli generare. Fondere le due fasi espone il modello di linguaggio a un connettore non ancora allineato, che è il rischio classico dell’ottimizzazione congiunta di due componenti mal condizionate; uno studio sistematico successivo [KNB+24] trova però che, con una buona ricetta, un tempo solo rende altrettanto o meglio e risparmia fra il 20 e il 25% del calcolo.
Questa seconda fase ha un dettaglio di metodo, e un limite che si vede a occhio nudo. I dati di istruzione visiva del primo LLaVA sono stati generati da un modello di solo testo, e non scritti da persone davanti a delle fotografie; a quel modello delle immagini si davano soltanto due sostituti scritti: le didascalie già disponibili e le coordinate dei riquadri degli oggetti annotati. Da quel materiale uscivano conversazioni, descrizioni dettagliate e domande di ragionamento, per un totale di 158 000 esempi (58 000 dialoghi, 23 000 descrizioni, 77 000 ragionamenti).
È un caso di dati sintetici che ha funzionato, e per una ragione precisa: il compito non era procurarsi conoscenza nuova (quella stava già nelle annotazioni) ma un formato, insegnare che a una domanda si risponde. Il limite sta in una frase: il generatore l’immagine non l’ha mai vista. Quello che didascalie e riquadri non dicono non finisce nei dati, e quello che il generatore inventa dentro un ragionamento plausibile ci finisce come se fosse vero. Chi studia quel materiale ne eredita lo stile, e con lo stile anche la sicurezza con cui il generatore afferma cose che non poteva sapere: un modello rifinito su quei 158 000 esempi, nelle prove di HalluciDoctor, nomina un oggetto che non c’è in più di un terzo delle sue descrizioni lunghe, e in meno di un quinto se i dati sono prima ripuliti delle affermazioni che le immagini non confermano [YLW+24]. La sezione sull’allucinazione visiva ci tornerà sopra; qui basti annotare che una parte del difetto nasce in addestramento, e non nel momento in cui il modello risponde.
Il connettore in dieci righe#
Tradotto in PyTorch, il proiettore è quello che promette di essere: due strati lineari con una non linearità in mezzo.
import torch
from torch import nn


class Proiettore(nn.Module):
    """Porta le feature dell'encoder visivo nello spazio dei token del testo."""

    def __init__(self, d_visione: int, d_testo: int):
        super().__init__()
        self.rete = nn.Sequential(
            nn.Linear(d_visione, d_testo),
            nn.GELU(),
            nn.Linear(d_testo, d_testo),
        )

    def forward(self, patch: torch.Tensor) -> torch.Tensor:
        # patch: (B, N, d_visione) -> (B, N, d_testo). Una patch, un token.
        return self.rete(patch)


proiettore = Proiettore(d_visione=1024, d_testo=4096)
print(sum(p.numel() for p in proiettore.parameters()))
20979712
Il pezzo che conta davvero, però, è come i token visivi raggiungono il decoder. Non passano da una porta di servizio, entrano dalla stessa porta delle parole.
# primo tempo: encoder e llm sono pre-addestrati e congelati, si addestra solo
# il proiettore (nel secondo tempo si toglie llm da questo ciclo)
for modulo in (encoder, llm):
    for p in modulo.parameters():
        p.requires_grad = False

with torch.no_grad():
    patch = encoder(immagine)          # (B, 576, 1024): la griglia di feature

token_visivi = proiettore(patch)       # (B, 576, 4096): ora sono "parole"

# llm è un modello causale della libreria transformers: espone la tabella
# degli embedding e accetta gli embedding già calcolati al posto degli id
tabella = llm.get_input_embeddings()
prefisso = tabella(id_prima)           # (B, T1, 4096) il testo che precede
suffisso = tabella(id_dopo)            # (B, T2, 4096) la domanda vera e propria

# la sequenza che entra nel decoder: testo, immagine, testo. Tutto insieme.
ingresso = torch.cat([prefisso, token_visivi, suffisso], dim=1)

uscita = llm(inputs_embeds=ingresso, attention_mask=maschera, labels=etichette)
Due osservazioni. La prima è che i pesi del modello di linguaggio non vengono
modificati: gli si passa inputs_embeds invece degli identificativi dei token,
e da lì in poi non sa che 576 delle sue posizioni vengono da una fotografia.
Questo ha un prezzo: i 576 token ricevono le posizioni unidimensionali della
sequenza, in ordine raster (riga dopo riga), e la griglia \(24 \times 24\) arriva
al modello solo perché le feature dell’encoder portano già la posizione di ogni
patch. Qwen2-VL [WBT+24] estende per questo la RoPE a tre
componenti, tempo, altezza e larghezza. La seconda
riguarda etichette: nelle posizioni visive e in quelle dell’istruzione va
messo il valore che segnala «ignora» (in PyTorch, -100), perché quei token il
modello deve leggerli senza essere penalizzato per non saperli generare.
Dove porta questa strada, e dove si ferma#
Il connettore risponde in parte al limite che aveva chiuso la sezione sull’allineamento: un modello che legge l’immagine token per token, invece di comprimerla in un vettore solo, ha almeno i mezzi per parlare delle relazioni fra le cose e non solo del loro elenco, e lo fa partendo da due modelli già addestrati (il secondo tempo riaddestra il modello di linguaggio, ma con poco materiale). Che li usi davvero è un’altra questione, e la sezione sull’allucinazione visiva mostra quanto spesso non lo faccia.
Restano due domande, e le affrontano le due sezioni che seguono. Se l’immagine entra dalla stessa porta delle parole, perché non farne davvero delle parole, simboli di un vocabolario, così che il modello possa anche scriverne? È la sezione sulla fusione. E poi: 576 token bastano per riconoscere una scena e non per leggere una tabella stampata dentro la fotografia, ma moltiplicarli significa pagare in contesto e in KV cache, linearmente, e oltre qualche decina di migliaia di token anche il fattore quadratico. Il conto del dettaglio, nella sezione che porta quel nome, è il vero limite pratico di tutto quello che si è visto fin qui.
Da ricordare
Il connettore nasce da un problema di soldi: i modelli che sanno guardare una foto e quelli che sanno scrivere esistono già, e dietro ciascuno ci sono mesi di calcolo, quindi si cerca il pezzo più piccolo da addestrare perché comincino a parlarsi. Tenere fermi i due modelli è anche una garanzia: riaddestrarli farebbe loro dimenticare per strada una parte di quello che sapevano fare.
Al pezzo in mezzo si chiedono due cose insieme: tradurre la descrizione di una tessera d’immagine nel formato che il modello di linguaggio si aspetta, e decidere quante tessere consegnargli. La seconda pesa quanto la prima: ogni tessera occupa posto come una parola e resta in memoria per tutta la risposta, mentre i confronti, a qualche centinaio di pezzi, sono ancora una briciola del conto.
Strati nuovi dentro il modello congelato [ADL+22]: si inseriscono strati in cui il testo chiede e l’immagine risponde, collegati con un volume che parte da zero, così al primo istante il modello suona esattamente come prima; davanti a loro il Perceiver Resampler riduce a 64 vettori qualunque cosa entri, una foto o un video intero, perché il costo degli strati nuovi non cresca con la durata del video.
Questionario fisso [LLSH23]: 32 domande scritte una volta per tutte in addestramento vengono poste a ogni foto, e ne escono 32 risposte: dai 257 vettori con cui la foto era stata descritta si scende a 32, e siccome ogni risposta è anche un po’ più corta, nel punto più stretto passano circa undici volte meno numeri.
Tabella di conversione [LLWL23]: una tessera entra, un token esce, nessun riassunto (circa quattro milioni di parametri, poi una ventina di milioni con due tabelle in fila in LLaVA-1.5).
Fra i modelli aperti ha prevalso il più semplice, e la ragione più solida è contro il riassunto: riassumere vuol dire scegliere prima di sapere qual è la domanda. Meglio il fascicolo intero lasciato sulla scrivania, finché lo si può sfogliare: si paga in posto occupato, ma a scegliere è il modello di linguaggio, quando la domanda è già arrivata. Non è una legge: a parità di pagine consegnate, come le si sceglie conta poco.
L’addestramento è in due tempi: prima il solo connettore su coppie immagine-didascalia (imparare dove scrivere), poi dialoghi sulle immagini, con il modello di linguaggio libero di cambiare; fatto tutto insieme, con cura, rende lo stesso. I dialoghi del primo LLaVA li ha scritti un modello di solo testo, che le foto non le aveva mai viste: materiale inventato che ha funzionato, ma che passa anche i difetti di chi l’ha scritto.
Da ricordare
Il connettore nasce da una domanda economica: encoder visivi e modelli di linguaggio esistono già e costano milioni, quindi si cerca il pezzo più piccolo addestrabile che li faccia parlare. Congelare protegge anche dalla dimenticanza catastrofica.
Deve fare due cose insieme: cambiare spazio (da \(d_v\) a \(d_t\)) e decidere quanti token visivi entrano nel contesto. Il secondo pesa quanto il primo: ogni token occupa contesto e KV cache, che crescono linearmente (mezzo MiB per token in un modello da sette miliardi con attenzione multi-testa), e il termine quadratico dell’attenzione a qualche centinaio di token pesa pochi punti percentuali.
Cross-attention gated [ADL+22]: strati nuovi inseriti fra i blocchi congelati, con due gate \(\tanh(\alpha)\) per blocco e gli \(\alpha\) inizializzati a zero, così all’inizio il modello è esattamente quello di prima; un Perceiver Resampler porta un numero variabile di feature a 64 token fissi, e rende il costo a valle indipendente da \(N\). Sono gli strati aggiunti a costare miliardi di parametri, non il resampler.
Q-Former [LLSH23]: 32 query apprese interrogano l’immagine in cross-attention e ne estraggono 32 vettori (188 milioni di parametri, due fasi di addestramento, e senza la prima le prestazioni scendono molto). Proiettore [LLWL23]: una matrice, poi in LLaVA-1.5 [LLLL24] un MLP a due strati, e una patch resta un token (4 milioni di parametri la sola matrice, 21 con l’MLP).
Nei modelli aperti della famiglia di LLaVA ha prevalso il più semplice. La ragione di principio vale contro la compressione (comprimere significa scegliere prima di conoscere la domanda), e a parità di token il tipo di connettore conta poco [MGF+24]; la cross-attention resta in sistemi come Llama 3. Quando il collo di bottiglia è l’informazione e non il calcolo, conviene rimandare la selezione al punto in cui il condizionamento è massimo, cioè all’attenzione del modello di linguaggio. Il prezzo è il contesto occupato, e su immagini ad alta risoluzione, documenti e video quel collo di bottiglia torna a essere computazionale: lì la compressione ha di nuovo senso.
L’addestramento è in due tempi con la stessa loss: prima il solo connettore su coppie immagine-didascalia, poi visual instruction tuning con il modello di linguaggio scongelato. Con una buona ricetta un tempo solo rende altrettanto e costa un quinto in meno [KNB+24]. I dati di istruzione del primo LLaVA furono generati da un modello di solo testo a partire da didascalie e riquadri: dati sintetici che funzionano, ma che trasmettono anche i difetti del generatore.