


NumPy: calcolo numerico vettorizzato#
Una griglia di numeri che può essere una fila, una tabella, o una pila di
tabelle. Si chiama array N-dimensionale, in breve ndarray, ed è
l’oggetto su cui poggiano Pandas, Matplotlib e scikit-learn, e il formato in
cui anche PyTorch e TensorFlow, che hanno un motore di calcolo proprio, si
scambiano i dati con il resto dell’ecosistema scientifico di Python. È il
ponte fra la matematica dei vettori e delle matrici (elenchi e tabelle di
numeri, che la sezione di algebra lineare
tratta per esteso) e il codice che addestra i modelli.
NumPy nasce nel 2005, quando Travis Oliphant riunisce in un solo progetto due
librerie concorrenti, Numeric e Numarray; il progetto esce come NumPy 1.0
l’anno seguente. Da allora gli strumenti scientifici di Python si scambiano i
dati nello stesso formato, l’ndarray. Quanto a vettorizzato, che sta nel
titolo, per ora vuol dire fare un conto su un blocco intero di numeri in una
volta sola invece che su un numero per volta.
L’ndarray: perché non basta una lista#
Python ha già le liste. Perché inventare un altro contenitore di numeri?

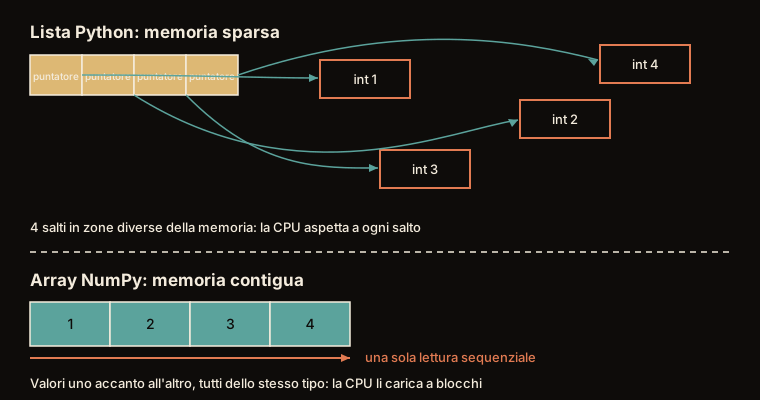
Fig. 2.11 Dove stanno davvero i numeri. Nella lista ogni numero è un pacchetto a sé, sparso nella memoria, e per raggiungerlo si segue un riferimento per volta; nell’array i valori stanno di fila, e il processore può leggerli a blocchi.#
La Fig. 2.11 mostra il motivo per cui l’array esiste: un processore è costruito per scorrere valori messi di fila, e se la cava peggio quando deve seguire un riferimento alla volta (un riferimento, o puntatore, porta scritto l’indirizzo in cui si trova il numero, invece del numero). La compattezza, però, serve al motore interno di NumPy, scritto in C (un linguaggio molto più vicino all’hardware rispetto a Python, veloce da eseguire e scomodo da scrivere), che attraversa l’array tutto insieme; non serve a un ciclo scritto in Python.
In Python il +
fra due liste non somma i numeri, ma attacca la seconda in coda alla prima
([1, 2] + [3] fa [1, 2, 3]). Per sommarle davvero, valore per valore,
servirebbe un ciclo scritto a mano, ed è una delle ragioni per cui NumPy
esiste.
Una lista Python è un contenitore generico: può tenere insieme un numero, una stringa e perfino un’altra lista. Questa flessibilità si paga. Per il computer ogni elemento è una scatola separata sparsa nella memoria, e per raddoppiare un milione di numeri deve visitarle una a una, chiedendosi ogni volta «che cos’è questo?».
L’ndarray fa il patto opposto: tutti gli elementi sono dello stesso tipo e
stanno uno accanto all’altro in un blocco compatto di memoria. Perde la
libertà di mescolare tipi diversi, ma in cambio le operazioni sui numeri
diventano corte da scrivere e molto più veloci da eseguire.
Insieme al blocco viene il passo con cui percorrerlo. In memoria i numeri di una tabella stanno scritti in fila, una riga dopo l’altra: per leggere una riga si va avanti di uno in uno, per leggere una colonna di una tabella larga cinque si salta di cinque in cinque, e nessun numero va spostato. Così prendere una colonna o una fetta non costruisce niente di nuovo: cambia solo il percorso sul blocco che c’è già.
Un ndarray è una vista tipizzata su un blocco di memoria: un dtype omogeneo
(per esempio float64 o int32), una forma (shape) e un insieme di
stride che dicono di quanti byte spostarsi per passare all’elemento
successivo lungo ogni asse. Quando gli stride sono esattamente quelli che si
ricavano dalla forma, l’array è contiguo (in ordine C per righe, in ordine
Fortran per colonne) e un ciclo in C può scorrerlo di fila; la contiguità è
quindi una proprietà del modo in cui l’array guarda il buffer, non una sua
definizione, ed è verificabile con .flags (C_CONTIGUOUS, F_CONTIGUOUS).
La distinzione conta: una colonna estratta da una matrice, M[:, 0], è un
ndarray perfettamente legittimo e non contiguo, e la trasposta M.T è
F-contigua ma non C-contigua. Questa struttura permette due cose. Primo: slice
e trasposizione sono sempre viste, ricalcoli di stride a costo zero senza
copia dei dati (ed è proprio perché la contiguità non è garantita che gli
stride esistono); reshape è una vista quando gli stride della forma nuova si
possono ricavare da quelli vecchi, e altrimenti copia. Secondo: le operazioni
elemento-per-elemento sono delegate a cicli in C compilati e vettorizzati
(istruzioni SIMD), che saltano l’overhead dell’interprete su ogni iterazione;
l’algebra lineare vera e propria (i prodotti tra matrici di decimali o
complessi) passa invece per librerie BLAS ottimizzate; sugli interi NumPy usa
un ciclo C semplice, molto più lento. È la differenza fra un milione di numeri
ciascuno impacchettato nel proprio oggetto, sparsi dove capita, e un array C
nudo.
Il dtype fisso ha però conseguenze che una lista non ha. Gli interi hanno
larghezza finita e traboccano in silenzio, in aritmetica modulare:
import numpy as np
a = np.array([100, 100, 100], dtype=np.int8)
a * 2        # -> array([-56, -56, -56], dtype=int8)
I decimali nascono float64, mentre PyTorch lavora di norma in float32: un
tensore ricavato con torch.from_numpy conserva il float64, e dato a uno
strato in float32 si ferma con mat1 and mat2 must have the same dtype. E
quando due dtype si incontrano valgono le regole di NumPy 2 (NEP 50): un
numero Python è «debole» e adotta il dtype dell’array se è dello stesso
genere, intero con intero o decimale con decimale (np.float32(1) + 1.0 resta
float32); se il genere cambia, vince il dtype predefinito del nuovo genere
(un array int8 più 1.0 dà float64), e un intero Python che non sta nel
dtype dell’array solleva OverflowError invece di allargarlo (a + 200, con
a di int8). Uno scalare o un array NumPy è invece «forte»: float32 più
float64 dà float64.
Creare un array#
I modi per far nascere un array sono pochi, e tornano di continuo.
import numpy as np

np.array([1, 2, 3])          # da una lista Python
np.zeros((2, 3))             # tabella di zeri con 2 righe e 3 colonne
np.ones(4)                   # vettore di 1 -> array([1., 1., 1., 1.])
np.arange(0, 10, 2)          # come range, ma array -> array([0, 2, 4, 6, 8])
np.linspace(0, 1, 5)         # 5 punti equispaziati tra 0 e 1 inclusi

rng = np.random.default_rng(0)   # generatore con seme, per risultati riproducibili
rng.normal(size=(2, 2))          # tabella 2×2 di numeri casuali "a campana"
Nell’ultima riga size=(2, 2) è un argomento passato con il suo nome, la
scrittura vista nella sezione sulle funzioni: dice quanto dev’essere grande il
risultato. E «a campana» è la forma che si vede disegnando quanti numeri escono
vicino a ciascun valore: quasi tutti vicino allo zero, sempre meno man mano che
ci si allontana, in modo simmetrico. È la distribuzione che torna più spesso in
statistica, perché descrive bene le grandezze che nascono sommando tanti
piccoli effetti che non dipendono l’uno dall’altro, come il totale di molti
lanci di dado: si chiama distribuzione normale, o gaussiana, e la
sezione di probabilità e statistica
le dedica la formula e il grafico.
La prima riga contiene una parolina da guardare: as. import numpy as np
vuol dire «importa numpy e, qui dentro, chiamalo np»: è un soprannome, e da
quel momento ogni strumento della libreria si scrive np.qualcosa. Il
soprannome lo sceglie chi scrive (funzionerebbe anche numpy.array(...), o
as npy), ma np per NumPy, pd per Pandas e plt per Matplotlib sono
convenzioni così universali che cambiarle rende il codice illeggibile agli
altri.
Attenzione alle parentesi di np.zeros((2, 3)), che sono due: la funzione
vuole una sola cosa, la forma dell’array, e la forma è una coppia
(righe, colonne), che si scrive fra le sue parentesi. Con un array a una
dimensione la forma è un numero solo e le parentesi doppie non servono, da cui
np.ones(4). L’ordine è sempre quello: prima le righe, poi le colonne. A un
array già fatto la forma si può anche chiedere, e si scrive M.shape.
La funzione arange è pensata per interi e passi (con un passo decimale la
lunghezza dipende dagli arrotondamenti: np.arange(0.1, 0.4, 0.1) contiene
anche 0.4, l’estremo che dovrebbe restare fuori), mentre linspace serve a
dividere un intervallo in un numero esatto di punti (è quello giusto per
disegnare curve). E il generatore casuale moderno si costruisce con
default_rng(seme): fissare il seme rende l’esperimento ripetibile, requisito
minimo di ogni lavoro scientifico serio. Non è una contraddizione: un programma
deterministico non produce numeri casuali, li calcola con una formula che li fa
sembrare casuali (si dicono infatti pseudo-casuali). Il seme è il numero da
cui la formula parte: stesso seme, stessa sequenza, oggi e sulla macchina di un
altro; seme diverso, sequenza diversa. Senza seme, NumPy parte da un valore
preso dal sistema operativo, e ogni esecuzione è diversa. La promessa vale a
parità di versione di NumPy, che si riserva di cambiare la formula quando ne
trova una migliore, e lo dichiara. Chi deve ritrovare gli stessi numeri fra
dieci anni scrive nel lavoro anche la versione. Il valore 0 è una scelta
qualunque: un altro seme darebbe un’altra sequenza, ugualmente valida.
Indicizzazione e slicing#
Un array si indicizza con le stesse parentesi quadre delle liste (numeri[0]
è il primo elemento), ma si possono indicizzare più assi insieme, separati
da virgola: gli assi sono le direzioni lungo cui l’array si estende (in una
tabella, le righe e le colonne).

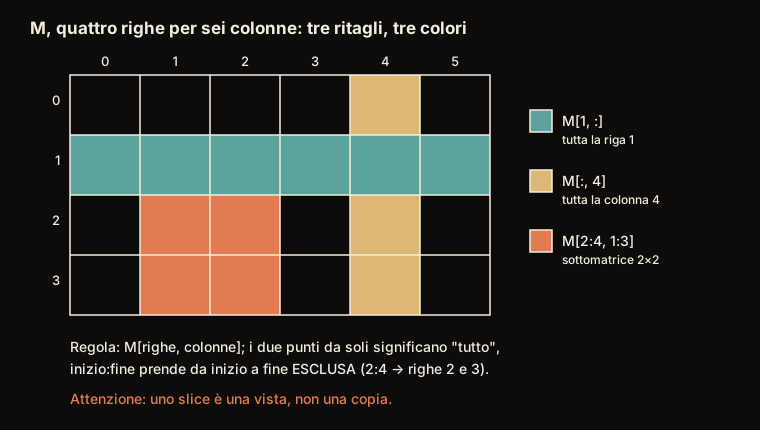
Fig. 2.12 Lo slicing visto sulla griglia. Il primo indice sceglie fra le righe, il secondo fra le colonne, e i due tagli si incrociano: quel che resta è la selezione.#
Nessuna delle tre selezioni di Fig. 2.12 copia i dati. Sono viste sullo stesso array in memoria, e scriverci dentro modifica l’originale: è la differenza più insidiosa rispetto alla fetta di una lista, che invece è una copia.
lista = [10, 20, 30, 40]
fetta = lista[1:3]          # una copia
fetta[0] = 999
lista                       # -> [10, 20, 30, 40]   la lista è intatta

vettore = np.array([10, 20, 30, 40])
vista = vettore[1:3]        # NON una copia: una finestra sugli stessi numeri
vista[0] = 999
vettore                     # -> array([ 10, 999,  30,  40])   l'array è cambiato
Non è un difetto: una fetta di un array da un milione di elementi non costa
niente, perché non copia niente, e questo tiene bassi tempo e memoria. Se
invece serve una copia vera va chiesta, con .copy().
x = np.array([10, 20, 30, 40, 50])
x[0]        # np.int64(10)  il primo (si conta da zero)
x[-1]       # np.int64(50)  l'ultimo: gli indici negativi contano dalla fine
x[1:4]      # array([20, 30, 40])  slice: da 1 incluso a 4 escluso

M = np.arange(12).reshape(3, 4)   # i numeri 0..11 ridisposti in 3 righe e 4 colonne
                                  # con un argomento solo, arange parte da zero;
                                  # reshape attaccato col punto lavora su ciò che
                                  # arange ha appena prodotto, senza dargli un nome
M[1, 2]     # np.int64(6)  seconda riga, terza colonna: gli indici sono 1 e 2
M[:, 0]     # tutte le righe, colonna 0 -> array([0, 4, 8])
M[0]        # prima riga intera -> array([0, 1, 2, 3])
Si conta sempre da zero, quindi l’indice 1 è il
secondo elemento e M[1, 2] sta nella seconda riga, terza colonna. Un indice
negativo conta dalla fine, e x[-1] è l’ultimo qualunque sia la lunghezza. E
in una slice il secondo estremo è escluso (x[1:4] dà tre elementi): vale la
stessa regola delle liste, e per la stessa ragione.
Sulla forma di ciò che viene stampato: np.int64(10) non è un numero strano, è
il modo in cui NumPy 2 mostra un suo numero intero quando lo si scrive
all’interprete, per dire di che tipo è (x[0] è un intero a 64 bit che nei
conti si comporta come il numero 10, ma non è un int di Python: dove serve un
int, per esempio per json, si scrive int(x[0]); print(x[0]) stampa
proprio 10). Chi arriva da un tutorial scritto per NumPy 1, dove usciva 10
e basta, si trova la differenza qui e in tutti i punti in cui da un array si
estrae un valore singolo.
C’è poi un’indicizzazione che in Python puro richiederebbe un ciclo con if.
L’indicizzazione booleana seleziona gli elementi in base a una condizione. Scrivi la domanda («quali sono maggiori di 25?») e NumPy ti restituisce solo quelli:
x = np.array([10, 20, 30, 40, 50])
x > 25            # array([False, False,  True,  True,  True])
x[x > 25]         # array([30, 40, 50])  tieni solo i "True"
Quello che torna è un array nuovo, con dentro ricopiati i valori scelti:
qui la regola delle fette non vale, e scriverci sopra non tocca x. Se invece
la condizione la metti a sinistra dell’uguale, allora sì che stai scrivendo
sull’originale, ed è il modo di correggere un mucchio di valori in un colpo:
x[x > 25] = 0 # array([10, 20, 0, 0, 0])
Le condizioni si possono anche combinare, e ciascuna vuole le sue parentesi
attorno: & vuol dire «e», | vuol dire «oppure».
y = np.array([10, 20, 30, 40, 50])
y[(y > 15) & (y < 45)]    # array([20, 30, 40])
È il modo naturale per filtrare dati: «prendi solo i clienti sopra i 25 anni», «azzera i valori negativi».
Una condizione come x > 25 produce una maschera booleana, un array di
bool della stessa forma. Usata come indice, x[mask] estrae gli elementi
dove la maschera è True restituendo un array 1-D, ed è sempre una copia:
gli elementi scelti in generale non stanno a passo costante, quindi non esiste
nessuno stride che li descriva, e senza stride non c’è vista. Copia anche
quando il passo per caso ci sarebbe, perché la regola guarda la forma
dell’indicizzazione e non i valori della maschera. La stessa maschera funziona
in assegnazione, x[mask] = 0, che invece scrive sul buffer originale.
Gli operatori con cui le maschere si compongono sono quelli bitwise &, |,
~, e non and/or, che su un array solleverebbero
ValueError: The truth value of an array ... is ambiguous, perché pretendono
un solo True o False da un oggetto che ne contiene molti. Le parentesi
attorno a ciascun confronto non sono uno scrupolo di stile: & lega più
stretto di >, quindi x > 15 & x < 45 verrebbe letto come
x > (15 & x) < 45. È un confronto a catena, che Python scioglie in
(x > (15 & x)) and ((15 & x) < 45): quell’and chiede di nuovo un solo
valore di verità a un array intero, e l’espressione si ferma sullo stesso
ValueError.
Questa indicizzazione booleana è il pane quotidiano della pulizia dati e sostituisce interi cicli con un’unica espressione dichiarativa.
Broadcasting: sommare forme diverse senza cicli#
Cosa succede se si sommano una riga e una colonna di dimensioni diverse? Per le regole dell’algebra lineare l’operazione non è definita, e molti linguaggi la rifiutano. NumPy la definisce con una regola, il broadcasting: le forme più piccole vengono espanse virtualmente finché combaciano (Fig. 2.13).

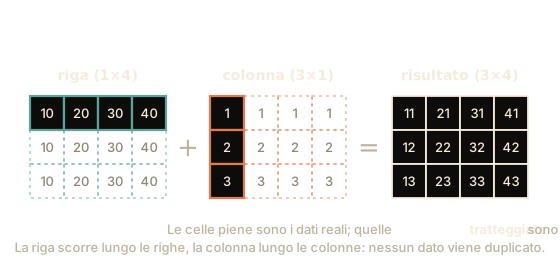
Fig. 2.13 Broadcasting: una riga \((1\times 4)\), cioè una riga per quattro colonne, e una colonna \((3\times 1)\) si espandono virtualmente ciascuna lungo la dimensione mancante e si sommano in una matrice \((3\times 4)\). Nessun dato viene davvero copiato in memoria.#
Una tabella da riempire: i prezzi base di 4 prodotti (una riga), i sovrapprezzi di 3 regioni (una colonna), e servono tutte le combinazioni. Invece di un doppio ciclo, allinei riga e colonna e NumPy ripete l’una lungo le righe e l’altra lungo le colonne, calcolando la griglia intera:
a = np.array([10, 20, 30, 40])    # riga: 4 prezzi base
b = np.array([[1], [2], [3]])     # colonna: 3 sovrapprezzi
a + b                             # tabella 3x4, senza un solo for
# array([[11, 21, 31, 41],
#        [12, 22, 32, 42],
#        [13, 23, 33, 43]])
Guarda le quadre di b, che sono doppie: [1, 2, 3] sarebbe una riga di
tre numeri, mentre [[1], [2], [3]] è fatto di tre righe da un numero
ciascuna, cioè una colonna. Le parentesi esterne racchiudono la
tabella, quelle interne una riga per volta.
La regola pratica: se una delle due forme ha \(1\) dove l’altra ha \(n\), quel lato viene «steso» a \(n\). Il ripetersi è solo apparente: serve a far tornare i conti, non consuma memoria.
E se scrivessi anche i sovrapprezzi in riga, tre numeri di fila contro quattro? NumPy si fermerebbe con un errore, e ha ragione lui: nessuno dei due lati vale \(1\), quindi non c’è niente da stendere, e nessuno ha deciso quale sovrapprezzo vada con quale prezzo.
Il broadcasting allinea le forme da destra. Due assi sono compatibili se
sono uguali oppure se uno dei due vale \(1\): quel lato viene esteso senza copia.
Con a di forma \((4,)\) e b di forma \((3,1)\) (nomi del codice, quindi in
tondo: il grassetto matematico è per vettori e matrici, non per gli
identificatori di un programma):
L’asse mancante di \(a\) viene inserito a sinistra come \(1\), poi ogni asse-\(1\) è
trasmesso lungo l’altra dimensione. Il risultato è equivalente a
\(S_{ij}=a_j+b_i\), dove \(S\) è il risultato di forma \((3,4)\), ma è calcolato in
C, senza materializzare le copie: gli stride
del lato «trasmesso» sono posti a \(0\), così lo stesso dato viene riletto più
volte. Con stride nullo più celle guardano lo stesso byte, e da qui la vista
che np.broadcast_to restituisce è in sola lettura: assegnarci dentro
solleva ValueError: assignment destination is read-only, perché
un’assegnazione non saprebbe quale delle celle sovrapposte debba vincere. È il
meccanismo che permette, per esempio, di sottrarre la media di colonna da
un’intera matrice di dati con X - X.mean(axis=0). L’argomento axis dice
lungo quale asse ridurre, e quell’asse sparisce dalla forma: su X di forma
\((n, d)\), X.mean(axis=0) ha forma \((d,)\) e si allinea da destra con
\((n, d)\). La media di riga, X.mean(axis=1), ha forma \((n,)\), e per
sottrarla serve keepdims=True, che lascia l’asse con lunghezza \(1\) e dà
\((n, 1)\); senza, le forme non combaciano e NumPy si ferma, tranne in due
casi: con \(n = d\) si allinea in silenzio sull’asse sbagliato, e con \(d = 1\)
allarga tutte e due le forme e restituisce una matrice \((n, n)\). È il secondo a
rendere cara la regola: una previsione di forma \((n, 1)\) meno un bersaglio di
forma \((n,)\) dà una matrice \((n, n)\), e l’errore quadratico medio calcolato
sopra restituisce un numero sbagliato senza nessun avviso.
Il movimento è più facile da vedere che da descrivere (Fig. 2.14).

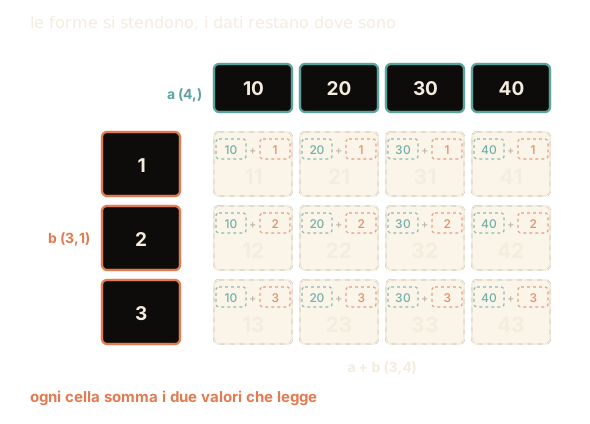
Fig. 2.14 Il durante del broadcasting: la riga scende di riga in riga, la colonna attraversa le colonne, e dove sono passate resta una coppia di caselle tratteggiate. Quelle caselle sono letture dello stesso dato, non copie: dodici celle si riempiono a partire da sette numeri soltanto, perché il lato che si stende viene riletto invece che ricopiato.#
Vettorizzazione: quanto conta davvero#
Il motivo per cui tutto questo esiste è la velocità. «Vettorizzare» significa
sostituire un ciclo Python con un’operazione sull’intero array. Il guadagno di
tempo si misura con %timeit, un comando dei notebook che cronometra
l’istruzione alla sua destra (qui il % non è il resto della divisione).
import numpy as np

x = np.random.default_rng(0).random(1_000_000)

def raddoppia_loop(v):          # la versione "a mano"
    out = np.empty_like(v)      # empty non azzera: dentro c'è spazzatura,
                                # e tocca al ciclo riempirla tutta
    for i in range(len(v)):
        out[i] = 2 * v[i]
    return out

%timeit raddoppia_loop(x)       # ~100 millisecondi
%timeit 2 * x                   # ~0,2 millisecondi

# e adesso il rovescio, che serve a capire da dove venga il guadagno:
lista = x.tolist()              # gli stessi numeri, in una lista Python
%timeit [2 * v for v in lista]  # ~40 millisecondi
%timeit [2 * v for v in x]      # ~85 millisecondi: stesso ciclo, altro contenitore
%timeit appartiene a IPython, il motore che sta sotto le celle dei
notebook, e non al linguaggio (in gergo è una magic): ripete l’istruzione
molte volte e riporta il tempo medio, di quanto le singole ripetizioni se ne
scostano (mean ± std. dev.) e il numero di ripetizioni. In un normale file
.py non funziona: lì si usa il modulo timeit della libreria standard.
Le due misure riguardano la stessa cosa (raddoppiare un milione di numeri) ma
la seconda strada è di solito centinaia di volte più veloce, e la ragione
sta tutta nel ciclo che sparisce. È il pedaggio già incontrato: il ciclo
Python lo paga un milione di volte, 2 * x una volta sola, perché a scorrere
il blocco è il motore in C. Che i numeri stiano in
fila serve a lui, che li prende a manciate, e non a un ciclo scritto in Python.
Vale anche il rovescio: se il ciclo lo scrivi comunque, farlo passare su un
array invece che su una lista lo rallenta, perché a ogni giro l’array deve
chiudere il numero in una scatola che nella lista esisteva già.
Un prezzo però c’è, e si vede solo sui dati grandi: il conto fatto sul blocco
intero fabbrica per strada altri blocchi grandi come quello, e quella memoria
va trovata. La regola d’oro con NumPy: se stai scrivendo un for su un
array, quasi sempre esiste un modo per non scriverlo.
Il divario fra le prime due misure è di due o tre ordini di grandezza (circa \(100\) ms il ciclo, circa \(0{,}2\) ms la forma vettorizzata) e nasce dall’overhead dell’interprete: ogni iterazione in Python comporta controllo di tipo, allocazione di oggetti e dispatch dinamico. La forma vettorizzata sposta il ciclo dentro codice C compilato che opera su memoria contigua, con buona località di cache e, dove disponibile, vettorizzazione SIMD.
La località di cache è la ragione per cui la contiguità conta anche dentro il
C. La memoria centrale consegna i dati a blocchi, le righe di cache, di
solito da 64 byte, cioè otto float64 consecutivi, e li consegna a una
gerarchia di memorie piccole e veloci vicine al processore. La L1 tiene
qualche decina di kilobyte e risponde in un nanosecondo circa, la L2 qualche
centinaio di kilobyte o pochi megabyte, la L3 (condivisa fra i core) decine di
megabyte, con latenze che salgono fino alla decina di nanosecondi, mentre la
DRAM ne chiede un centinaio. Chi scorre un blocco contiguo usa tutti gli otto
numeri di ogni riga caricata, e il prefetcher dell’hardware, che riconosce
l’accesso sequenziale, porta le righe successive prima che servano, così la
latenza della DRAM si nasconde. Chi salta con passo di otto elementi usa un
numero su otto di ogni riga e muove otto volte i byte; una lista Python, con
gli oggetti sparsi nella memoria, paga in più un salto imprevedibile per ogni
elemento. È la stessa piramide che la sezione sulla memoria della GPU percorre con altri numeri, e con lo stesso principio:
il costo sta nello spostare i dati più che nel calcolarci sopra.
Le ultime due misure servono a isolare quale dei due fattori pesi, ed è la
domanda su cui la conclusione sbagliata è a portata di mano. Lo stesso
ciclo Python, che legge un elemento per volta, impiega dal doppio al triplo del
tempo (a seconda della macchina) quando legge da un ndarray invece che da una
lista, e fra le due righe l’unica cosa che cambia è il contenitore letto. La
ragione è che ogni lettura deve incartare il numero grezzo in un oggetto
np.float64, mentre nella lista quell’oggetto esiste già. La contiguità serve
al ciclo in C e non a quello in Python: un ndarray è veloce quando lo si
tocca tutto in una volta, e chi «ottimizza» un ciclo Python convertendo la
lista in array lo rallenta.
Il meccanismo che sta sotto si chiama ufunc (universal function):
np.add, np.multiply, np.sqrt e gli operatori che le richiamano applicano
una funzione compilata a tutti gli elementi, con broadcasting, e accettano
out= per scrivere il risultato in un array già allocato invece di crearne
uno nuovo. Vettorizzare ha due costi: gli array intermedi (un’espressione come
a * b + c può crearne, e out= serve a evitarli) e gli algoritmi
intrinsecamente sequenziali, in cui ogni passo dipende dal precedente e non
c’è un’operazione sull’intero array da scrivere. Attenzione a np.vectorize:
non vettorizza niente, è un ciclo Python che chiama la funzione su ogni
elemento (la documentazione dice che serve per comodità, non per velocità), e
su un milione di elementi impiega quanto il ciclo scritto a mano, centinaia di
volte più di 2 * x.
Algebra lineare, in una riga#
Un vettore è una fila di numeri, una matrice è una tabella di numeri: qui
basta questo, e che cosa siano davvero, insieme ai conti che ci si fanno
sopra, lo spiegherà la sezione di algebra lineare. Quello che conta adesso è una cosa sola: ogni
operazione è una riga. Prodotto scalare, prodotto matrice-vettore e prodotto
fra matrici sono tutti l’operatore @, e np.linalg raccoglie il resto. Il
prodotto con * è un’altra cosa: moltiplica elemento per elemento (\(\odot\)),
come la somma, e A * A non è A @ A.
A = np.array([[1., 2.],
              [3., 4.]])
v = np.array([1., 1.])

A @ v                  # prodotto matrice-vettore -> array([3., 7.])
A @ A                  # prodotto matrice-matrice
v @ v                  # prodotto scalare -> np.float64(2.0)

np.linalg.norm(v)      # norma euclidea
np.linalg.inv(A)       # inversa
np.linalg.solve(A, v)  # risolve A z = v  (più stabile dell'inversa)
I due numeri di A @ v si leggono a occhio, e conviene farlo: \(3\) è
\(1 + 2\), \(7\) è \(3 + 4\), cioè ogni riga di A moltiplicata voce per voce per
v e poi sommata.
Per risolvere un sistema di equazioni
\(\mathbf{A}\mathbf{z} = \mathbf{v}\), cioè trovare lo \(\mathbf{z}\) che
moltiplicato per \(\mathbf{A}\) dà \(\mathbf{v}\), si usa np.linalg.solve, non
inv(A) @ v. Il primo è più preciso e più veloce; calcolare l’inversa
esplicita è quasi sempre uno spreco, e la
sezione sui sistemi lineari dice quanto
costa. Con questi mattoni (array, broadcasting, vettorizzazione, algebra
lineare), abbiamo il vocabolario per esprimere in poche righe ciò che un
modello, sotto, fa milioni di volte.
Da ricordare
In un
ndarrayi valori sono tutti dello stesso tipo e stanno uno accanto all’altro, ed è la condizione che permette di scrivere il conto sul blocco intero in una volta. Il guadagno però nasce dalforche sparisce, non dal contenitore: unforscritto a mano su unndarrayè più lento dello stessoforsu una lista.array,zeros,ones,arange,linspace,default_rngcreano array; le parentesi quadre ne scelgono un pezzo, e una condizione fra le quadre (x[x > 25]) fa da colino, tenendo solo gli elementi che la soddisfano.Prendere una fetta di un array non fabbrica niente: è una finestra sugli stessi numeri, e scriverci dentro cambia l’originale (con una lista era il contrario). Il colino invece una copia la fa, e di una fetta la copia si chiede con
.copy().Il broadcasting permette di sommare forme diverse: dove una delle due misura 1 e l’altra misura n, quel lato viene steso fino a n, senza copiare niente.
Vettorizzare vuol dire sostituire un
forcon un’operazione su tutto l’array: il codice è più corto e da cento a mille volte più veloce, perché il ciclo sparisce.Il segno
@fa i prodotti fra vettori e matrici enp.linalgraccoglie il resto dell’algebra lineare: qui basta sapere che esistono e che ognuno di quei conti è una riga sola; il significato arriva con la sezione di algebra lineare.
Da ricordare
L’
ndarrayè una vista tipizzata su un blocco di memoria, contigua quando gli stride sono quelli della forma: da qui il fatto che una slice resti una vista, e la possibilità di far scendere il ciclo nel codice compilato, che è dove nasce il guadagno.array,zeros,ones,arange,linspace,default_rngcreano array; slicing e indicizzazione booleana li selezionano senza cicli (lo slicing dà una vista, la maschera booleana una copia).Il broadcasting allinea le forme da destra ed espande gli assi di dimensione \(1\): somma forme diverse senza copiare dati.
Vettorizzare (sostituire un
forcon un’operazione sull’array) rende il codice più corto e da cento a mille volte più veloce (due o tre ordini di grandezza). Il guadagno sta nel ciclo che sparisce, non nel contenitore: unforsu unndarrayè più lento dello stessoforsu una lista.Prodotti e algebra lineare vivono in
@enp.linalg: per i sistemi usasolve, non l’inversa.
Un array però è una griglia di numeri e basta: non sa che la terza colonna è
l’età e la quinta la spesa, non sa che a una riga manca un dato (per i decimali
c’è NaN, per gli interi niente) e ha un solo dtype per tutti i valori:
mettere testo e numeri nella stessa tabella li riduce a stringhe, e
np.array([["Ada", 34]]) contiene la stringa "34" al posto del numero. Sui
dati veri, che arrivano con nomi, buchi e tipi misti, serve qualcosa che poggi
sull’array e ci metta sopra le etichette.