


Cercare per rispondere: retrieval e RAG#
C’è una differenza che ogni studente conosce bene: l’esame a libro chiuso e l’esame a libro aperto. A libro chiuso conta solo ciò che hai in testa, e quando la memoria vacilla, la tentazione di improvvisare con disinvoltura è fortissima. A libro aperto cambia tutto: non serve ricordare ogni data, serve saper trovare la pagina giusta in fretta e usarla bene.
Un modello di linguaggio, così come è stato costruito fin qui, dà sempre l’esame a libro chiuso. Tutto quello che «sa» è compresso nei pesi durante il pre-addestramento; e quando gli chiedi qualcosa che non c’è (un fatto raro, un documento privato, una notizia successiva ai suoi dati) non tace: completa nel modo più plausibile, con la sicurezza fluente delle allucinazioni che abbiamo già messo tra i limiti strutturali di questi modelli. C’è anche un secondo difetto, più prosaico: il libro interno si ferma al giorno in cui è finito l’addestramento, e riscriverlo (riaddestrare il modello) costa settimane di calcolo su migliaia di acceleratori.
L’idea del retrieval è dare al modello il libro aperto, e insegnargli a consultarlo. Servono due mestieri diversi: cercare (ed è il territorio dell’information retrieval, una disciplina che precede di decenni i modelli di linguaggio neurali) e rispondere usando ciò che si è trovato. La combinazione dei due si chiama RAG, Retrieval-Augmented Generation, e per capirla si parte dal primo mestiere, il più antico.
Trovare l’ago: l’information retrieval#
Il problema è presto detto: data una richiesta, trovare in una collezione che può contenere milioni di documenti i pochi che servono. È il problema dei motori di ricerca, ma è nato ben prima del web. Il termine information retrieval compare nel 1950, in una relazione di Calvin Mooers a un convegno, e negli anni Sessanta il gruppo di Gerard Salton confrontava già documenti e domande come vettori, misurandone la somiglianza con il coseno [SC12].
Chi lo studia chiama quella richiesta una query, ed è la stessa parola che nel meccanismo di attenzione indica la domanda che una parola pone alle altre. Il gesto è analogo: si confronta la domanda con tutto quello che potrebbe rispondere, e si tengono i migliori. Cambia il modo: l’attenzione dà a tutte le parole un peso, grande o piccolo, mentre il retrieval sceglie in modo netto i primi \(k\) fra milioni di voci e scarta il resto. La prima domanda è di ingegneria: come si cerca in milioni di documenti senza leggerli tutti a ogni richiesta?
In fondo al manuale di biologia, dopo seicento pagine, c’è l’indice analitico. Cerchi «fotosintesi» e non sfogli niente: leggi fotosintesi → pp. 91, 214, 380 e salti dritto lì. Qualcuno ha letto tutto una volta sola e ha annotato dove compare ogni parola, perché tu non debba rifarlo a ogni ricerca.
Lo stesso schedario per un’intera biblioteca è l’indice invertito dei motori di ricerca: una scheda per ogni parola, e sotto la lista di tutti i libri che la contengono. Alla domanda «gatto muro» tiri fuori due schede, confronti le due liste e tieni i titoli che compaiono in tutte e due. Non hai aperto un libro.
Restano mille titoli. Quale apri per primo? Le schede lo dicono già in parte: quella di «muro» è sottile, quella di «il» è spessa un dito e ci sta dentro mezza biblioteca. Una parola che sta dappertutto non distingue niente: le parole rare contano di più.
Poi apri un titolo e conti. «Gatto» ci compare dieci volte, ma il libro non è dieci volte più pertinente di uno che lo nomina una volta sola: dopo un po’ il tema è chiaro e le menzioni in più aggiungono briciole. Con la regolazione più usata, e su un libro di lunghezza normale, una menzione vale un punto e dieci ne valgono meno di due; per quanto si insista non si supera un tetto, che con quella regolazione sta a due punti e due decimi, e si tocca presto.
Sullo scaffale accanto c’è l’enciclopedia in dodici volumi, che contiene «gatto» e «muro» per forza di cose, come contiene quasi ogni parola. Se la lunghezza non si sconta, in cima ai risultati ci finisce sempre lei. Chi compila lo schedario ha allora due manopole, quanto scontare le ripetizioni e quanto pesare la lunghezza, e le gira finché i risultati non lo convincono.
Sullo scaffale dei ricettari il conto della rarità si rompe. Il peso di una parola, nel conto più diretto, nasce dal rapporto fra i libri che non la contengono e quelli che la contengono: «muro» in cinque libri su cento dà novantacinque contro cinque, e pesa molto. «Cucchiaio» in ottanta ricettari su cento dà venti contro ottanta, un rapporto sotto uno, e il conto lo trasforma in un peso negativo: contenere «cucchiaio» fa scendere il punteggio invece di lasciarlo dov’è. Chi cerca «cucchiaio di burro» si vedrebbe passare davanti proprio le ricette in cui il cucchiaio non compare. Nei sistemi veri il conto si ferma prima dello zero: una parola diffusissima vale pochissimo, mai meno di niente.
E come si sa se lo schedario funziona? Si prepara un elenco di domande di cui si conosce già la pagina giusta, e si guardano due numeri: quante delle prime dieci risposte sono davvero utili (più sono, meglio è) e a che posto arriva la prima buona (più è in alto, meglio è).
Un indice invertito associa a ogni termine \(t\) del vocabolario la lista dei documenti (e delle posizioni) in cui compare: l’elaborazione di una query si riduce a operazioni su liste ordinate, con costo legato ai documenti che contengono i termini della query, non all’intera collezione.
Per l’ordinamento, il punto di riferimento da trent’anni è la funzione di punteggio BM25, nata negli anni Novanta per il sistema Okapi e sistematizzata da Robertson e Zaragoza [RZ09]. Discende dal modello probabilistico della rilevanza degli anni Settanta e Ottanta, e ha la forma del TF-IDF con due differenze che pesano: la frequenza del termine satura invece di crescere senza fine, e il punteggio è normalizzato per la lunghezza del documento:
dove \(q\) è la query e \(d\) il documento; \(\mathrm{tf}(t,d)\) è il numero di occorrenze del termine \(t\) in \(d\) e \(\mathrm{idf}(t)\) la sua rarità nella collezione, in versione levigata, \(\mathrm{idf}(t) = \log\frac{N - \mathrm{df}(t) + 0{,}5}{\mathrm{df}(t) + 0{,}5}\), con \(N\) documenti totali e \(\mathrm{df}(t)\) quelli contenenti \(t\); \(|d|\) è la lunghezza del documento e \(\bar{\ell}\) la lunghezza media nella collezione; \(k_1\) e \(b\) sono due manopole. Un avviso a chi la implementa: così scritta, l’idf diventa negativa per ogni termine presente in più di metà della collezione (basta che \(\mathrm{df}(t) > N/2\)), e un contributo negativo significa che contenere il termine peggiora il punteggio. È un’anomalia nota, che le implementazioni correnti (Lucene, e quindi quasi tutti i BM25 in produzione) evitano usando \(\log\!\big(1 + \frac{N - \mathrm{df}(t) + 0{,}5}{\mathrm{df}(t) + 0{,}5}\big)\), sempre positiva e con lo stesso ordinamento nei casi utili.
La frazione è il cuore della formula, e codifica la saturazione della term frequency: cresce con \(\mathrm{tf}\) ma tende al tetto \(k_1 + 1\). Con il valore tipico \(k_1 = 1{,}2\) e un documento di lunghezza media (la parentesi vale 1): un’occorrenza dà punteggio \(1\); dieci occorrenze danno \(\frac{10 \cdot 2{,}2}{10 + 1{,}2} \approx 1{,}96\) (non dieci volte tanto, nemmeno il doppio, e sempre sotto il tetto). Il termine \(b \in [0, 1]\) (tipicamente \(b = 0{,}75\)) dosa invece la normalizzazione per lunghezza: penalizza i documenti più lunghi della media, che accumulano occorrenze per pura mole.
Due parole sulla valutazione, perché torneranno. Detti \(\mathrm{Ril}(q)\) i documenti rilevanti per la query e \(\mathrm{Top}_k(q)\) i primi \(k\) restituiti, la precision@k è \(|\mathrm{Ril}\cap\mathrm{Top}_k|/k\) e la recall@k è \(|\mathrm{Ril}\cap\mathrm{Top}_k|/|\mathrm{Ril}|\): la prima misura quanto è pulita la lista, la seconda quanto del necessario è stato recuperato, ed è quella che conta per un sistema che poi legge i passaggi. L’MRR (Mean Reciprocal Rank) è la media, sulle query, di \(1/\mathrm{rank}\), dove \(\mathrm{rank}\) è la posizione del primo risultato corretto (vale \(1\) se il sistema azzecca sempre il primo posto). Quando la rilevanza ha dei gradi si usa l’nDCG@k, \(\sum_{i=1}^{k}(2^{g_i}-1)/\log_2(i+1)\) diviso per lo stesso valore dell’ordinamento ideale, dove \(g_i\) è il grado di rilevanza del documento in posizione \(i\). Tutte e quattro crescono verso il meglio.
Quando le parole non bastano: cercare per significato#
L’indice invertito ha un difetto congenito: cerca parole, non significati. Fra le insidie della lingua l’overview del capitolo sul NLP elencava i sinonimi: «auto», «macchina» e «vettura» indicano lo stesso oggetto, ma per un indice invertito sono tre chiavi diverse, e la query «manutenzione della vettura» non troverà mai il documento che parla solo di «tagliando dell’auto», perché non condividono una parola. Il rimedio sono gli embedding della sezione su come si rappresenta il testo, la stessa mappa del significato della sezione sui modelli multilingua: ogni passaggio, e anche la domanda, diventa un vettore di \(\mathbb{R}^d\), e testi dal significato simile hanno vettori vicini. Cercare, allora, diventa misurare distanze invece che confrontare parole. Il modo di cercare che ne esce si chiama retrieval denso, dove «denso» dice come è fatto il vettore: non una coordinata per ogni parola della lingua, quasi tutte nulle, come nell’indice invertito, ma qualche centinaio o qualche migliaio di coordinate quasi tutte diverse da zero, nessuna delle quali ha da sola un significato. Contano le distanze e le direzioni.
Su una mappa del genere alcune relazioni diventano direzioni, e si possono perfino fare dei conti.

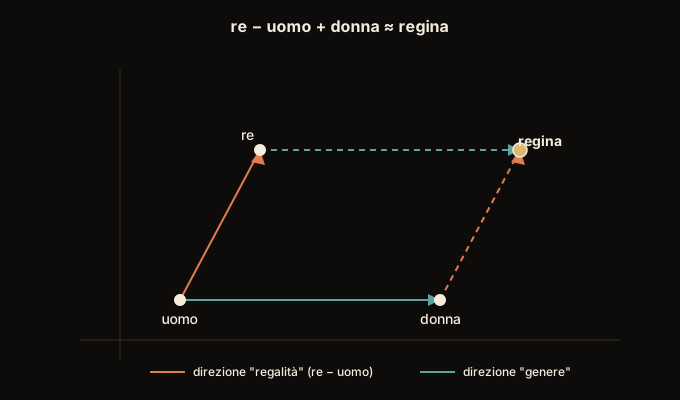
Fig. 16.24 Il significato come geometria, in un disegno idealizzato. Sulla mappa, andare da «uomo» a «re» è all’incirca lo stesso spostamento che porta da «donna» a «regina»: la relazione «la versione regale di» diventa una direzione. Nello spazio vero le due frecce non coincidono, e il parallelogramma si chiude solo per approssimazione.#
Il disegno di Fig. 16.24 è la versione ideale della proprietà. Sui vettori veri, come mostra la sezione sull’aritmetica del significato, la parola più vicina al punto d’arrivo resta re, e regina esce prima solo se si tolgono dalla gara le tre parole della domanda. Per cercare basta la proprietà più semplice, la vicinanza.
Con la mappa cambia anche l’unità di misura. Un documento intero non si lascia ridurre a un punto solo, perché un manuale di quattrocento pagine, dovendo riassumersi in un indirizzo, finirebbe per parlare di tutto e quindi di niente. L’archivio si taglia prima in pezzi lunghi una frase o un paragrafo, e sono quelli a diventare punti sulla mappa. Si chiamano passaggi, e nei programmi portano il nome inglese chunk; ognuno porta poche idee, spesso una sola, ed è per questo che si fa trovare quando quell’idea viene chiesta. Il taglio è una scelta, e si paga nei due versi: troppo fine, e al pezzo manca il contesto che lo rende comprensibile; troppo grosso, e si torna al manuale che parla di tutto.
Il catalogo di una biblioteca e un libraio esperto non trovano le stesse cose. Il catalogo trova solo ciò che combacia con le parole della tua richiesta. Il libraio ha letto tutto: gli chiedi «qualcosa sull’educazione del cucciolo» e ti mette in mano Come allenare il tuo cane (nessuna parola in comune, tema identico).
Il retrieval denso costruisce un libraio artificiale. Ogni passaggio dell’archivio viene trasformato in un punto sulla mappa del significato: la stessa idea degli embedding di parole, ma per frasi intere. La domanda, quando arriva, diventa anch’essa un punto sulla stessa mappa: i passaggi pertinenti sono semplicemente i punti più vicini, parole in comune o no.
Attenzione però a non pensionare il catalogo. Se cerchi «errore E-52 della lavatrice», vuoi esattamente E-52, non «un errore simile»: sui codici, sui nomi propri, sulle sigle, il confronto letterale resta imbattibile, perché lì il significato è la parola esatta. Per questo i sistemi seri fanno cercare tutti e due, il catalogo e il libraio, e poi fondono le due liste di risultati in una sola, tenendo in cima quello che compare in alto in entrambe.
L’architettura standard è il bi-encoder, cioè la struttura siamese della
sezione su come si rappresenta il testo applicata a due tipi di
ingresso diversi: due encoder Transformer (o uno condiviso), \(E_q\) per le query
ed \(E_z\) per i passaggi, producono vettori in \(\mathbb{R}^d\), dove \(d\) è la
dimensione dell’embedding e non il documento che la stessa lettera indicava in
BM25; la rilevanza fra una query \(q\) e un passaggio \(z\) è il prodotto scalare
\(\mathrm{sim}(q, z) = E_q(q)^\top E_z(z)\), che coincide con la similarità del
coseno, già incontrata nella sezione sull’algebra lineare, quando i vettori sono normalizzati. Il
vantaggio computazionale è decisivo: gli embedding dei passaggi si calcolano
una volta sola, offline; al momento della ricerca restano solo una codifica e
il calcolo dei vicini più prossimi. Esatta, quella ricerca costa \(O(Nd)\) per
domanda, con \(N\) passaggi di dimensione \(d\): per i 21 milioni di passaggi di
Wikipedia dell’articolo di Lewis e colleghi e \(d = 768\), la dimensione di DPR,
sono circa \(1{,}6 \times 10^{10}\) moltiplicazioni a domanda, e i soli vettori,
in float32, occupano circa 65 GB. Su milioni di vettori si usano allora
indici approssimati dei vicini più prossimi (in sigla ANN, approximate
nearest neighbor, da non confondere con la sigla delle reti neurali): grafi
navigabili a più livelli come HNSW [MY20], liste invertite con
quantizzazione del prodotto, librerie come FAISS [JDJegou21]. Il
compromesso è fra recall, latenza e memoria: si accetta di perdere qualche
vicino vero in cambio di una ricerca sublineare, ed è la funzione dei database
vettoriali.
Il risultato che ha mostrato come bastino coppie supervisionate è DPR (Dense Passage Retrieval) [KOuguzM+20]. Prima di lui i retriever densi battevano BM25 solo grazie a un costoso pre-addestramento ausiliario, come ORQA [LCT19]; DPR sono invece due BERT addestrati in modo contrastivo, ad avvicinare le coppie domanda–passaggio corrette e ad allontanare i negativi, riciclando come negativi gli altri esempi del batch (in-batch negatives) e aggiungendo a ogni domanda un negativo pescato da BM25: è la configurazione con cui sono ottenuti i numeri che seguono. Il salto sopra un BM25 ben tarato è ampio su quattro delle cinque raccolte di question answering a dominio aperto dell’epoca, dagli \(8{,}9\) ai \(19{,}3\) punti di accuratezza top-20, cioè della quota di domande per cui la risposta compare in almeno uno dei primi venti passaggi. Sulla quinta, SQuAD, DPR resta sotto di \(5{,}6\) punti, e gli autori lo attribuiscono, come congettura, al modo in cui quella raccolta è nata: le domande sono state scritte avendo il passaggio sotto gli occhi, quindi ne ricalcano le parole, e vengono tutte da poco più di cinquecento articoli. Quel che resta valido oltre i numeri è il perché: il denso recupera ciò che è detto con altre parole, il lessicale ciò che è scritto con quelle esatte. La misura fuori dal dominio di addestramento è BEIR [TRRuckle+21], diciotto raccolte eterogenee: lì BM25 si rivela una base robusta, il reranking e i modelli a interazione tardiva come ColBERT [KZ20] fanno meglio in media ma a un costo alto, e i retriever densi, più efficienti, spesso fanno peggio. I sistemi ibridi interrogano tutti e due e fondono le liste con la reciprocal rank fusion, \(\mathrm{RRF}(d) = \sum_{m} 1/(c + \mathrm{rank}_m(d))\) con \(c\) intorno a 60 [CCButtcher09]: conta la posizione in ciascuna lista e non il punteggio, che fra un BM25 e un prodotto scalare non è confrontabile. La fusione e il reranking hanno una sezione propria, RAG avanzato.
Un raffinamento chiude il quadro. Il bi-encoder codifica query e passaggio separatamente, mentre un cross-encoder li concatena in un unico Transformer, in cui l’attenzione confronta i token dei due testi uno a uno. È un approccio più accurato ma troppo costoso per scandagliare l’archivio; per questo si usa come reranker, per riordinare i migliori \(k\) candidati proposti dal retriever.
Rispondere: il question answering#
Cercare non basta: la parte che cerca, il retriever, restituisce passaggi, non risposte. Trasformare un testo trovato in una risposta alla domanda è il compito che nell’overview del capitolo sul NLP avevamo chiamato question answering, uno dei compiti classici della disciplina. Ha avuto persino il suo momento televisivo: nel febbraio 2011 Watson di IBM, un sistema costruito proprio su ricerca più analisi della domanda, batté i campioni umani del quiz Jeopardy!.
Ci sono due modi di rispondere avendo il testo sotto gli occhi. Il primo è l’evidenziatore: la risposta è già scritta nel brano, basta sottolinearla. «Su cosa salta il gatto nero?»: il brano dice «il gatto nero salta sul muro», evidenzi «sul muro», fine. È il QA estrattivo. Il secondo è la penna: la risposta va composta con parole tue, magari cucendo insieme più punti del testo. È il QA generativo, più flessibile, ma con la libertà arriva il rischio: chi scrive di suo può anche scrivere cose che nel testo non ci sono.
C’è poi il caso in cui il brano non lo dà nessuno: la domanda arriva nuda, e la prima mossa è andarsi a cercare le pagine giuste. Trovate quelle, si torna a scegliere fra evidenziatore e penna.
Il QA estrattivo è stato standardizzato da SQuAD [RZLL16]: oltre centomila domande scritte da crowdworker su articoli di Wikipedia, dove la risposta è per costruzione uno span del paragrafo dato. Il modello predice le posizioni di inizio e fine dello span (con BERT bastano due teste softmax sulle rappresentazioni dei token) e si valuta con exact match e F1 sui token. Nel giro di un paio d’anni i modelli della famiglia BERT [DCLT19] hanno superato su questo benchmark le prestazioni degli annotatori umani: un risultato vero, da leggere però per quello che misura (trovare uno span in un paragrafo già dato, non rispondere a domande nel mondo). Il QA generativo rimuove il vincolo dello span: un modello seq2seq (o un decoder autoregressivo) scrive la risposta, condizionata su domanda e contesto. E il QA a dominio aperto rimuove anche il paragrafo dato: prima si recuperano i passaggi da una collezione, poi si legge quel che si è trovato, ed è la catena su cui poggia la RAG.
Il libro aperto: la RAG#
Tutti i pezzi sono sul tavolo: un retriever che trova i passaggi giusti e un modello di linguaggio che sa scrivere. La Retrieval-Augmented Generation, «generazione aumentata dal recupero», li mette semplicemente in fila, ed è la catena di Fig. 16.25. La domanda va al retriever, che consulta l’archivio e restituisce i passaggi più pertinenti. Domanda e passaggi vengono poi incollati insieme in un unico testo, che si passa al modello come contesto: è questo che si chiama prompt aumentato, cioè la richiesta con attaccati i documenti che servono a rispondere. E il modello scrive la risposta appoggiandosi a quei passaggi, citandoli. Il nome viene dal lavoro di Patrick Lewis e colleghi [LPP+20], che nel 2020 hanno mostrato come saldare le due metà in un unico modello addestrabile.

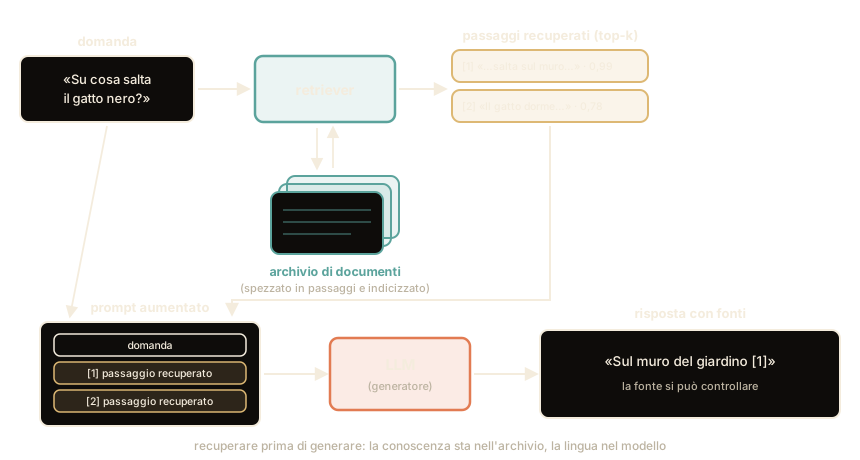
Fig. 16.25 La pipeline RAG: recuperare prima di generare. La conoscenza vive nell’archivio (aggiornabile), la competenza linguistica nel modello.#
È lo studente all’esame a libro aperto, addestrato a usarlo bene. Arriva la domanda; lo studente non si fida della memoria: apre l’indice, trova le tre pagine giuste, le tiene sotto gli occhi e scrive la risposta da lì, annotando a margine «pag. 214». Le altre seicento pagine non le apre nemmeno, perché l’indice dice che non c’entrano. Le tre pagine stanno tutte sullo stesso banco, e a decidere quale conta, mentre scrive, è lo studente. Ogni pagina in più è altro da leggere, e quando la pila è alta lo studente legge meglio quelle in cima e in fondo che quelle in mezzo.
I vantaggi sono concreti. La risposta è controllabile: chi corregge può andare a pagina 214 e verificare, cosa impossibile con una risposta recitata a memoria. E il sapere è aggiornabile: se esce l’edizione nuova del libro basta sostituirla sullo scaffale, e nessuno deve rimandare lo studente a scuola. Nei sistemi reali è la differenza tra aggiornare un archivio stanotte e riaddestrare un modello per settimane.
Ma il libro aperto non rende infallibili, e le cose vanno storte in tre punti diversi. Lo studente può aprire la pagina sbagliata, perché l’indice l’ha ingannato o perché la domanda era ambigua: allora scrive una risposta sbagliata con tanto di citazione in bella vista, più convincente proprio perché ha la fonte a margine. Può non trovare affatto la pagina che serviva: quello che non ha davanti non entrerà nella risposta presa dal libro, e se lo scrive lo scrive a memoria senza dichiararlo, cioè è tornato di nascosto all’esame a libro chiuso. E può avere la pagina giusta sotto gli occhi e scrivere altro, o piegarne il senso: «pag. 214» resta una citazione esatta, e la frase sopra non è quello che a pagina 214 c’è scritto. Spostare il problema dalla memoria alla ricerca resta un ottimo affare, perché una ricerca si può ispezionare e migliorare; ma il problema non sparisce, e un pezzo resta dov’era, nella penna di chi scrive.
Nel modello originale [LPP+20] le due metà sono esplicite: un retriever DPR fornisce \(p_\eta(z \mid x)\), la probabilità di recuperare il passaggio \(z\) data la domanda \(x\), e un generatore seq2seq (BART) fornisce \(p_\theta(y \mid x, z)\). Il prodotto scalare del bi-encoder diventa quella probabilità nel modo consueto, passando per l’esponenziale e normalizzando su tutto l’archivio: \(p_\eta(z \mid x) \propto \exp\!\big(E_z(z)^\top E_q(x)\big)\). (Due avvisi sulle lettere, presi tutti e due dal paper: \(\eta\) sono i parametri del retriever e non il tasso di apprendimento che \(\eta\) indica nel resto del libro; e la domanda qui è \(x\), la stessa che il bi-encoder chiamava \(q\).) La risposta marginalizza sui passaggi recuperati, ed è la variante che il paper chiama RAG-Sequence, quella che usa lo stesso passaggio per tutta la risposta (nell’altra, RAG-Token, la somma viene ricalcolata per ogni token, e parole diverse possono venire da passaggi diversi):
dove \(x\) è la domanda, \(y\) la risposta generata, \(z\) uno dei \(k\) passaggi recuperati, \(\eta\) i parametri del retriever e \(\theta\) quelli del generatore. Il segno di «circa» dice una cosa precisa: la somma esatta si estenderebbe a tutti i passaggi dell’archivio, mentre qui si ferma ai primi \(k\). Il paper la chiama approssimazione top-\(k\) e non la giustifica: quanto pesi la coda che resta fuori dipende dalla scala dei prodotti scalari del retriever, e non è detto sia poco. La somma troncata viene poi rinormalizzata sui soli \(k\) passaggi tenuti (nel codice di riferimento una softmax sui loro punteggi), quindi quello che ne esce è di nuovo una distribuzione: quella esatta, però, solo se la coda scartata pesava davvero poco.
Il tutto si addestra end-to-end sulle sole coppie domanda–risposta: il gradiente attraversa il generatore e l’encoder delle query (l’indice dei passaggi, che nell’articolo sono circa 21 milioni da cento parole di Wikipedia, resta congelato). La lettura concettuale è la più duratura: il modello ha una memoria parametrica (i pesi) e una memoria non parametrica (l’indice), e la seconda si può ispezionare, correggere e aggiornare senza toccare la prima.
Il testo recuperato può entrare nel sistema in punti diversi, ciascuno col suo costo. In Fusion-in-Decoder [IG21] ogni passaggio è codificato insieme alla domanda, separatamente dagli altri, e il decoder attende alla concatenazione delle codifiche: l’encoder costa una quantità lineare nel numero di passaggi, e la qualità continua a crescere con quel numero. RETRO [BMH+22] porta il recupero dentro il modello, con un’attenzione incrociata su blocchi presi da una base di due trilioni di token; kNN-LM [KLJ+20] lo porta all’uscita, interpolando la distribuzione del modello con quella dei vicini più prossimi nello spazio degli embedding, senza riaddestrare. A parte sta l’addestramento del retriever: REALM [GLT+20], uscito due mesi prima di DPR, lo pre-addestra con il linguaggio mascherato, propagando il gradiente attraverso la ricerca.
Oggi il termine RAG indica più spesso la variante leggera, leggera perché non addestra insieme il retriever e il generatore: recupero, poi prompt augmentation verso un modello già istruito col post-training; è proprio l’instruction tuning a rendergli eseguibile una consegna come «rispondi usando solo i passaggi e cita le fonti». In quella variante sparisce anche la marginalizzazione: i passaggi finiscono tutti nello stesso prompt, il generatore li vede insieme, e a pesarne la pertinenza è lui, dal contenuto e non dal punteggio del recupero, che però decide ancora quali entrano e in che ordine. L’ordine conta: con molti passaggi nel contesto le prestazioni sono spesso migliori quando l’informazione rilevante sta all’inizio o alla fine, e calano quando sta in mezzo [LLH+24]. E ogni passaggio in più costa contesto: con \(k\) passaggi di \(n_p\) token ciascuno la domanda si allunga di \(k\,n_p\) token, e \(k\) diventa la manopola che mette in tensione la recall con il costo e il rumore. I limiti però non cambiano. Il tetto di ciò che il sistema può dire in modo fondato e citabile è la recall del retriever, cioè la quota dei passaggi pertinenti che la ricerca riesce a ripescare: è la stessa domanda della recall di un classificatore, quanti dei casi buoni si riescono a prendere, con i passaggi pertinenti dell’archivio al posto dei positivi da trovare (la sezione sulle metriche la definisce per esteso). Quel che non viene recuperato non può entrare nella risposta a partire dai documenti, e il modello può sempre rispondere attingendo ai propri pesi, ma allora è tornato all’esame a libro chiuso, e senza dirlo. Il generatore, poi, può ignorare i passaggi o contraddirli, tanto che la fedeltà alla fonte (groundedness) è oggi una metrica di valutazione a sé; e una citazione formalmente corretta non rende vera una risposta che ne travisa il contenuto.
Il modello originale di Lewis e colleghi tiene insieme le due metà con una somma: ogni passaggio recuperato produce la sua risposta per conto proprio, e le risposte si sommano contando ciascuna per il peso che il recupero le ha dato (Fig. 16.26). I passaggi non si vedono fra loro, e il peso di ciascuno è deciso prima che il generatore scriva una parola. La variante di oggi fa diversamente: mette tutti i passaggi nello stesso prompt, e lascia al modello il compito di distinguere quello che serve da quello che somiglia soltanto.
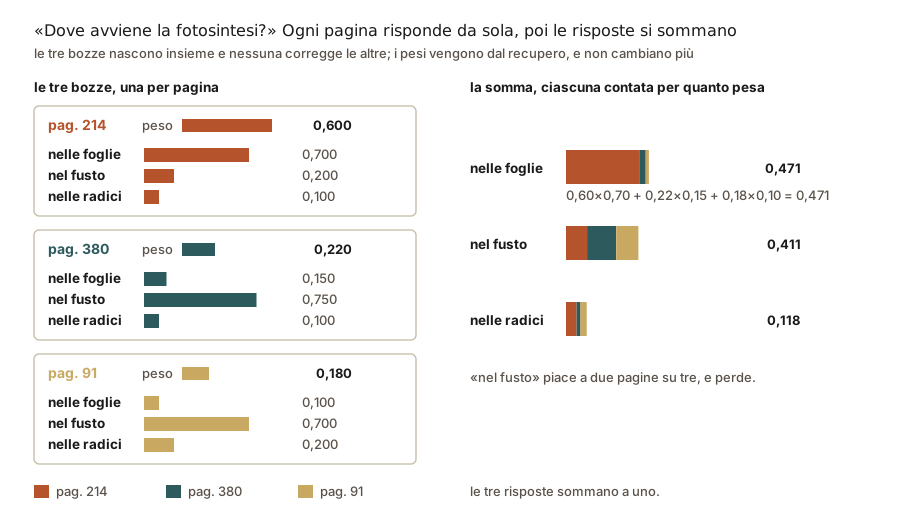
Fig. 16.26 Tre passaggi recuperati (le tre pagine), tre risposte parziali che nascono insieme e non si correggono a vicenda, e una risposta sola che le somma pesandole. Un voto a maggioranza direbbe «nel fusto», che due passaggi su tre preferiscono; la somma pesata dà «nelle foglie»: il primo passaggio pesa più degli altri due messi insieme, e la sua preferenza prevale, 0,471 contro 0,411. La risposta che perde si porta via lo stesso quattro decimi: pesare non è filtrare. I numeri sono inventati apposta, per far vedere il meccanismo.#
Il bilancio è questo. La RAG mitiga le allucinazioni: su ciò che sta nell’archivio il modello non deve più inventare, e nel dialogo fondato su conoscenze i modelli con recupero allucinano meno [SPC+21]. Non le elimina: un recupero sbagliato produce una risposta sbagliata con le fonti in bella vista. In cambio offre due cose che i soli pesi non danno in modo affidabile: la citabilità, perché una risposta con la fonte si può verificare e una senza fonte no, e l’aggiornabilità, perché quando i documenti cambiano si ricostruisce l’indice dell’archivio, non si riaddestra il modello.
Un retriever denso in miniatura#
Chiudiamo con il codice. Costruiamo un retriever denso completo su un archivio di sei passaggi: si calcolano gli embedding, si misura quanto ciascuno è vicino alla domanda, si tengono i due migliori, si monta il prompt aumentato. Gli embedding qui sono scritti a mano e hanno quattro sole coordinate, ognuna con un significato leggibile (quanto il passaggio parla di gatti, di muri e casa, di automobili, di cucina), al posto delle centinaia di coordinate opache che produrrebbe un modello vero. Tutto il resto è identico a un sistema in funzione.
La vicinanza si misura con la similarità del coseno, \(\cos\theta = \mathbf{a}^\top\mathbf{b} / (\lVert\mathbf{a}\rVert\,\lVert\mathbf{b}\rVert)\), che dice quanto due vettori puntano nella stessa direzione: vale \(1\) per due vettori allineati, \(0\) per due perpendicolari e \(-1\) per due opposti, e con i vettori normalizzati coincide con il prodotto scalare. Qui le coordinate sono tutte positive, quindi il coseno sta fra \(0\) e \(1\); con un modello vero scende fino a \(-1\), e i valori negativi vanno letti come direzioni opposte, non come un guasto. Si legge come una misura di direzione, e non come una percentuale di somiglianza.
Il programma segue la variante leggera. L’uscita mostra prima i due passaggi trovati con il loro coseno, poi il prompt aumentato per intero, cioè quello che il modello si troverà davanti.
import torch

# mini-archivio: sei passaggi e i loro embedding "didattici"
# dimensioni: [gatti, muri/casa, automobili, cucina]
passaggi = [
    "Il gatto nero salta sul muro del giardino.",
    "Il muro portante sostiene il solaio.",
    "La vettura elettrica si ricarica in garage.",
    "L'auto storica sfila per il centro.",
    "Il gatto dorme accanto ai fornelli.",
    "La ricetta prevede burro e salvia.",
]
E = torch.tensor([
    [0.9, 0.6, 0.0, 0.1],
    [0.1, 0.9, 0.1, 0.0],
    [0.0, 0.1, 0.9, 0.0],
    [0.1, 0.0, 0.8, 0.1],
    [0.8, 0.2, 0.0, 0.5],
    [0.0, 0.1, 0.1, 0.9],
])

# normalizza le righe: il prodotto scalare diventa similarita' del coseno
E = E / E.norm(dim=1, keepdim=True)

# la domanda, codificata dallo stesso "encoder": parla di gatti e muri
domanda = "Su cosa salta il gatto nero?"
q = torch.tensor([0.9, 0.7, 0.0, 0.0])
q = q / q.norm()

sim = E @ q                       # coseno con tutti i passaggi in un colpo
val, idx = torch.topk(sim, k=2)   # i due passaggi piu' vicini

for v, i in zip(val, idx):
    print(f"{v:.2f}  {passaggi[i]}")

# assemblaggio del prompt aumentato
contesto = "\n".join(f"[{n + 1}] {passaggi[i]}" for n, i in enumerate(idx))
prompt = (
    "Rispondi usando solo i passaggi seguenti e cita le fonti.\n\n"
    f"{contesto}\n\nDomanda: {domanda}\nRisposta:"
)
print(prompt)
0.99  Il gatto nero salta sul muro del giardino.
0.78  Il gatto dorme accanto ai fornelli.
Rispondi usando solo i passaggi seguenti e cita le fonti.

[1] Il gatto nero salta sul muro del giardino.
[2] Il gatto dorme accanto ai fornelli.

Domanda: Su cosa salta il gatto nero?
Risposta:
Il primo passaggio è quello giusto, con una somiglianza di \(0{,}99\), cioè quasi perfetta. Ma guarda il secondo, che sta a \(0{,}78\): parla di gatti, ed è per questo vicino alla domanda sulla mappa, eppure non risponde. È il quasi-pertinente, l’insidia tipica della ricerca per significato: la vicinanza di tema non è pertinenza alla domanda. Nei sistemi reali è qui che interviene un secondo lettore, più lento e più accurato, che riesamina uno per uno i pochi candidati e li rimette in ordine (si chiama reranker). Senza di lui a distinguerli resta il generatore: la consegna «usando solo i passaggi» gli vieta di uscire dall’archivio, ma fra il [1] e il [2] deve scegliere lui, dal contenuto, e un generatore distratto può citare quello sbagliato.
Da questo giocattolo a un sistema vero, di quelli che stanno dietro a un
servizio in funzione, i passi sono pochi. Al posto degli embedding scritti a
mano ci va un modello addestrato apposta a produrli: quello che ha fatto scuola
si chiama DPR, Dense Passage Retrieval, e sono due encoder addestrati
insieme a mettere vicine le domande e i passaggi che le soddisfano. Al posto
delle sei righe ci vanno milioni di passaggi, tagliati da un archivio vero e
serviti da un indice che sa trovare i punti vicini fra milioni di punti senza
confrontarli tutti: si accontenta dei quasi-vicini in cambio della velocità, e
per questo si chiama approssimato. Al posto del print finale ci va la
chiamata a un modello istruito. La struttura (si codifica, si misura il coseno,
si tengono i primi \(k\), si monta il prompt) è esattamente quella del
programma.
Da ricordare
Un modello da solo risponde a libro chiuso: quello che non ha in testa se lo inventa in modo plausibile, e rifargli studiare il libro costa settimane. Il recupero gli apre il libro.
Cercare per parole è il mestiere antico: l’indice analitico dice subito in quali pagine compare una parola, senza doverle sfogliare tutte; poi si ordinano i risultati dando più peso alle parole rare, contando le ripetizioni sempre meno man mano che aumentano, e penalizzando i documenti-fiume.
Cercare per significato è il mestiere nuovo: ogni passaggio diventa un punto su una mappa dove le cose che vogliono dire cose simili stanno vicine, e la domanda diventa un punto sulla stessa mappa. Vince sui sinonimi («auto» trova «vettura»), perde sui codici e sui nomi esatti, dove serve la parola precisa: per questo i sistemi seri usano tutti e due.
Rispondere avendo il testo sotto gli occhi si fa in due modi: l’evidenziatore (la risposta è già scritta, basta sottolinearla) o la penna (la risposta si compone con parole proprie, più libera e più rischiosa).
La RAG mette in fila le due cose: prima si cerca, poi si risponde con i passaggi sotto gli occhi, citando. I modi sono due: quello di oggi mette tutti i passaggi nello stesso testo e lascia scegliere al modello; quello originale scriveva una risposta per passaggio e poi le sommava, contando ciascuna per quanto la ricerca l’aveva messa in cima. Attenua le risposte inventate ma non le elimina (se si apre la pagina sbagliata, la risposta è sbagliata con tanto di fonte in bella vista); in cambio si può verificare, e si aggiorna cambiando l’archivio invece del modello.
Da ricordare
Un LLM da solo risponde a libro chiuso: ciò che non è nei pesi viene completato in modo plausibile (allucinazioni), e aggiornare i pesi costa un riaddestramento. Il retrieval gli apre il libro.
L’information retrieval classico cerca per parole: indice invertito per non leggere tutto, BM25 [RZ09] per ordinare (il peso del modello probabilistico della rilevanza, con la forma di un TF-IDF, saturazione della term frequency e normalizzazione per lunghezza). Qualità misurata con precision@\(k\), recall@\(k\) (il tetto per un sistema che poi legge i passaggi), MRR e nDCG@\(k\).
Il retrieval denso [KOuguzM+20] cerca per significato: bi-encoder, embedding di passaggi, similarità del coseno, indici approssimati per non confrontare tutto. Vince sui sinonimi («auto»/«vettura»), perde su sigle, nomi esatti e domini lontani da quello di addestramento [TRRuckle+21]: gli ibridi e il reranking con cross-encoder correggono il tiro.
Il question answering (già tra i compiti del capitolo NLP) è estrattivo (evidenziare lo span: SQuAD [RZLL16]) o generativo (scrivere la risposta).
La RAG [LPP+20] incatena recupero e generazione, e nella forma originale marginalizza sui passaggi, cioè somma le risposte pesandole con la probabilità di recupero; la variante leggera di oggi salta la somma e monta invece il prompt aumentato. Mitiga le allucinazioni ma non le elimina (la recall del retriever è il tetto), e offre citabilità e aggiornabilità; l’archivio si cambia, il modello no.
Fra i problemi che i Transformer lasciano aperti, la sezione sulle tendenze e sui limiti ritrova il recupero di fonti esterne fra le mitigazioni delle allucinazioni: una mitigazione, appunto, e non una cura.