


La struttura nascosta della frase: sintassi e parsing#
«Ho visto un uomo con il binocolo». La frase con cui il capitolo ha presentato l’ambiguità merita di essere ripresa adesso, con gli attrezzi giusti in mano. Chi ha il binocolo? Se ce l’ho io, «con il binocolo» accompagna il verbo: dice come ho visto. Se ce l’ha lui, accompagna il nome: dice quale uomo ho visto. E c’è un dettaglio che rende la faccenda istruttiva: le etichette del POS tagging, da sole, qui non bastano. Ausiliare, verbo, articolo, nome, preposizione, articolo, nome: il POS tagging produce la stessa identica sequenza per entrambe le letture. In «La vecchia porta la sbarra» l’ambiguità viveva al piano delle categorie grammaticali; qui vive un piano più su. Le due letture sono due strutture diverse costruite con gli stessi mattoni, e non due sfumature dello stesso significato.
La disciplina che studia queste strutture è la sintassi; costruirle automaticamente si chiama parsing, o analisi sintattica, e un programma che lo fa si chiama parser. Se il POS tagging era l’analisi grammaticale di scuola, il parsing è l’analisi logica: chi fa che cosa, a chi, con che cosa.
Per descrivere la struttura di una frase la linguistica usa due formalismi. La struttura a costituenti raggruppa le parole in blocchi annidati uno dentro l’altro; la struttura a dipendenze collega ogni parola alla parola da cui dipende, con una freccia che porta il nome della relazione. Dicono cose diverse: i costituenti dicono quali parole formano un blocco, le dipendenze quale parola regge quale. Dai primi si passa alle seconde con regole che indicano, in ogni blocco, la parola principale; il passaggio inverso non è univoco. Il NLP li usa tutti e due.
Scatole dentro scatole: i costituenti#
L’osservazione di partenza è che certe sequenze di parole si comportano come un blocco unico. Nell’esempio ricorrente del libro, «Il gatto nero salta sul muro», il gruppo «il gatto nero» si sposta e si sostituisce come un pezzo solo. Questi blocchi si chiamano sintagmi, o costituenti, e li si riconosce con due prove, la sostituzione (il gruppo si rimpiazza con una parola sola) e lo spostamento (il gruppo si muove tutto intero). Per non perdersi conviene fissare adesso i tre nomi che tornano più spesso: si dice sintagma nominale il blocco che ha un nome per protagonista («il gatto nero»), sintagma verbale quello che ha un verbo («salta sul muro»), e sintagma preposizionale quello che comincia con una preposizione («sul muro»).
Le forchette, in un trasloco, non si portano in strada una per una: si chiudono in una scatola, ed è la scatola che viaggia. La frase funziona uguale, e si riconosce quali parole viaggiano insieme con due prove da fare a orecchio.
Prova di sostituzione: se un gruppo di parole si può rimpiazzare con una parola sola, è una scatola. «Il gatto nero salta sul muro» diventa «Lui salta sul muro», e regge.
Prova di spostamento: una scatola si sposta tutta intera. «Sul muro salta il gatto nero» suona benissimo, mentre «Muro il gatto nero salta sul» non è italiano: abbiamo strappato il cartone e le forchette sono per terra.
E dentro la scatola «sul muro» c’è una scatolina, «il muro»: scatole dentro scatole, fino alle parole. Verso l’alto, invece, non c’è un tetto. Una scatola può stare dentro una scatola dello stesso tipo, e quella dentro un’altra ancora: «il gatto del vicino del piano di sopra» ne infila tre una dentro l’altra, e si potrebbe continuare per un pezzo. Sono sempre gli stessi pochi modi di inscatolare, riusati; bastano quelli a costruire frasi lunghe quanto si vuole, comprese quelle che nessuno ha mai pronunciato.
Ora il binocolo. Le due letture sono due modi diversi di inscatolare le stesse parole. Se l’uomo ha il binocolo, c’è una scatola grande: «Ho visto [un uomo con il binocolo]», e infatti puoi sostituirla tutta con «l’ho visto», dove «lo» è l’uomo col binocolo. Se il binocolo è mio, le scatole sono due: «Ho visto [un uomo] [con il binocolo]», e infatti la seconda si sposta da sola: «Con il binocolo, ho visto un uomo» funziona solo in questa lettura. Stesse sette parole, due disegni di scatole: l’ambiguità è tutta lì.
Lo strumento formale è la grammatica context-free (CFG), e nasce in due tempi. Nel 1956 Noam Chomsky [Cho56] confronta tre modelli matematici del linguaggio (i processi a stati finiti, parenti stretti degli \(n\)-gram; le grammatiche a struttura sintagmatica; le grammatiche trasformazionali) e ne trae la tesi che fece scuola: gli stati finiti non bastano, perché la sintassi annida dipendenze a distanza arbitraria. Il nome context-free e la scala a quattro livelli che oggi si chiama gerarchia di Chomsky arrivano tre anni dopo [Cho59], ed è da quella scala che l’informatica ha attinto anche i linguaggi di programmazione.
Una CFG è una quadrupla \(G = (\mathcal{N}, \Sigma, R, S)\), dove \(\mathcal{N}\) è l’insieme dei simboli non terminali (le categorie sintattiche, che nelle regole si scrivono in tondo: N il nome, V il verbo), \(\Sigma\) il vocabolario dei terminali (le parole), \(R\) un insieme di regole di riscrittura della forma \(A \to \alpha\) con \(A \in \mathcal{N}\) e \(\alpha\) sequenza di simboli, e \(S\) il simbolo iniziale. Una grammatica giocattolo per il nostro frammento d’italiano:
dove \(F\) fa da simbolo iniziale \(S\) ed è la frase, SN, SV e SP i sintagmi nominale, verbale e preposizionale, e le categorie lessicali (DET, N, V, AUX, P) riscrivono le parole. Una derivazione parte da \(F\) e riscrive un simbolo alla volta finché restano solo parole; la sua storia è l’albero di derivazione. Si noti la ricorsione di \(\text{SN} \to \text{SN}\ \text{SP}\): sei regole generano infinite frasi, ed è proprio questa regola, in concorrenza con \(\text{SV} \to \text{SV}\ \text{SP}\), a produrre l’ambiguità del binocolo (l’attacco del sintagma preposizionale, al nome oppure al verbo).
Frecce tra le parole: le dipendenze#
C’è un secondo modo di descrivere la struttura, che risale alla tradizione europea di Lucien Tesnière (il suo Éléments de syntaxe structurale uscì postumo nel 1959 [Tesniere59]): niente scatole, ma frecce che collegano ogni parola alla parola da cui dipende, con un’etichetta che ne dichiara il ruolo.
In un organigramma aziendale ogni impiegato ha un capo, e uno solo non ce l’ha. Una frase, disegnata così, ha la stessa forma: ogni parola dipende da un’altra parola, tranne il verbo principale, che è l’amministratore delegato. In «Il gatto nero salta sul muro» comanda «salta»: per lui lavorano «gatto», con la qualifica di soggetto (chi compie l’azione), e «muro», con la qualifica di complemento del verbo (a scuola, complemento di luogo). A loro volta «il» e «nero» lavorano per «gatto», e «sul» per «muro»: a scuola la preposizione introduce il complemento, qui invece dipende dal nome che accompagna. Sei parole, cinque frecce fra una parola e l’altra. Sopra l’amministratore delegato c’è ancora una casella, fuori dalla frase, il punto da cui il disegno parte: serve perché anche il capo di tutti abbia una freccia che lo indica, e così ogni parola, nessuna esclusa, ne riceve esattamente una.
E l’ambiguità del binocolo? Diventa una sola domanda da ufficio del personale: per chi lavora «binocolo»? Se lavora per «visto», è lo strumento con cui ho guardato; se lavora per «uomo», è un accessorio dell’uomo. Una freccia che cambia datore di lavoro, e il significato della frase si capovolge.
C’è un motivo pratico per cui questo disegno è quello che si usa quando si lavora su molte lingue insieme. In italiano si può dire «il gatto nero salta sul muro», ma anche «sul muro salta il gatto nero», e in altre lingue le parole girano ancora di più. Con le scatole ogni riordino richiede una regola di montaggio nuova (una regola dice come due pezzi ne fanno uno più grande: un articolo seguito da un nome fa un sintagma nominale), perché le scatole stanno in fila e la fila cambia. Con le frecce no: chi comanda chi resta identico, cambia solo dove le parole sono scritte sulla riga. È una delle ragioni per cui il progetto che annota con gli stessi criteri più di centocinquanta lingue, quell’Universal Dependencies già incontrato per le etichette, ha scelto le frecce, e infatti si chiama «delle dipendenze»: da una lingua all’altra cambiano l’ordine, le desinenze e le parole piccole, ma chi comanda chi si riconosce lo stesso.
C’è un effetto collaterale, e conta. Quando le parole si mescolano parecchio, due frecce disegnate sopra la riga possono accavallarsi, perché ciascuna deve raggiungere il proprio capo che nel frattempo è finito lontano. Dove l’ordine delle parole è rigido succede di rado; dove è libero è ordinaria amministrazione. E conta perché uno dei metodi che costruiscono il disegno, quello della pila che si incontra fra poco, sa fare soltanto frecce che non si incrociano.
Un’analisi a dipendenze di una frase di \(n\) parole è un albero diretto ed
etichettato: ogni parola ha esattamente una testa (un solo arco entrante); la
radice, tipicamente il verbo principale, dipende da un nodo fittizio root; e
ogni arco porta una relazione grammaticale. Nello schema di Universal
Dependencies [NdMG+16], già incontrato per il POS tagging, le
relazioni principali sono nsubj (soggetto), obj (oggetto diretto), det
(determinante), amod (aggettivo modificatore), case (preposizione), obl
(complemento obliquo), nmod (modificatore nominale). Le sigle sono quelle
della seconda versione dello schema [dMMNZ21], ed è lì
che nasce la distinzione su cui gira l’esempio del binocolo: prima l’oggetto
diretto si chiamava dobj, e obl non esisteva perché nmod copriva tutti e
due i mestieri.
Perché due formalismi? Le dipendenze pagano meglio nelle lingue a ordine flessibile. L’italiano ammette «Il binocolo l’ho visto io» o «Sul muro salta, il gatto nero»: una grammatica a costituenti deve prevedere regole per ogni permutazione, mentre l’albero a dipendenze resta lo stesso; a cambiare è solo l’ordine lineare in cui le parole compaiono, non la struttura. È uno dei motivi per cui il progetto UD ha scelto le dipendenze come base comune per annotare con gli stessi criteri più di centocinquanta lingue, dall’italiano al finlandese al giapponese: il suo obiettivo dichiarato è una rappresentazione in cui costruzioni simili restino parallele da una lingua all’altra, nonostante le differenze di ordine, di morfologia e di parole funzionali [dMMNZ21]. Un arco dalla testa \(h\) al dipendente \(d\) è proiettivo se da \(h\) si arriva, seguendo gli archi, a ogni parola compresa fra \(h\) e \(d\) nella frase; un albero è proiettivo se lo sono tutti i suoi archi, il che equivale a dire che gli archi, disegnati sopra la frase con la radice compresa, non si incrociano. Un albero non proiettivo è raro in inglese, assai più comune nelle lingue a ordine libero.
Fig. 15.23 mette i due disegni fianco a fianco sulla frase del binocolo, con una malizia: ciascuno mostra una lettura diversa. A sinistra, nelle scatole, «con il binocolo» sta dentro la scatola di «un uomo», ed è la lettura in cui il binocolo è dell’uomo. A destra, nelle frecce, «binocolo» dipende da «visto» e non da «uomo», ed è la lettura opposta, quella in cui il binocolo è di chi guarda.
Per scambiarle basta uno spostamento per parte: a sinistra tirare fuori la
scatola del binocolo da quella dell’uomo e agganciarla a quella del verbo, a
destra spostare la coda della freccia da «visto» a «uomo». Chi lavora in questo
campo lo dice in due gerghi diversi, ed è utile riconoscerli quando si
incontrano. Con le scatole si dice che il sintagma preposizionale passa dal
sintagma nominale a quello verbale, cioè che «con il binocolo» smette di stare
dentro «un uomo» e va a stare dentro «ho visto». Con le frecce si dice che la
relazione cambia sigla, da obl a nmod: obl sta per «complemento del
verbo» e nmod per «modificatore del nome», che sono esattamente le due
relazioni di dipendenza che il binocolo può avere, dal verbo principale o
dal nome.

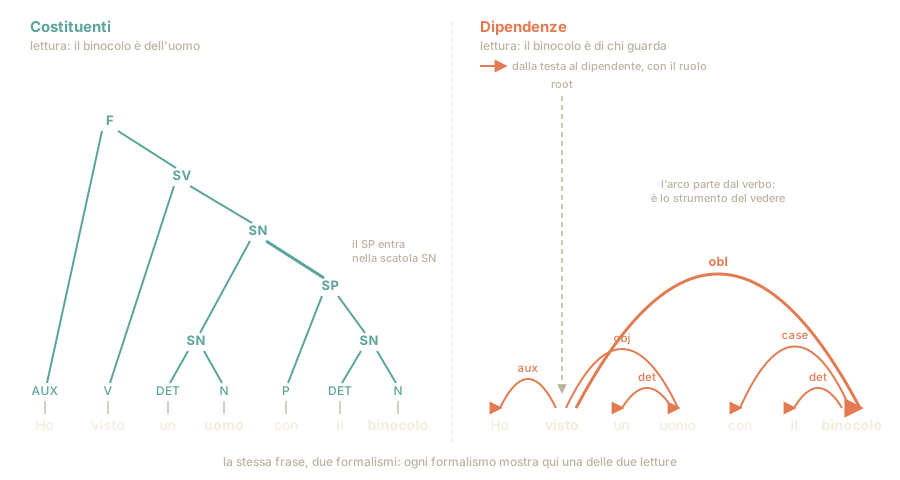
Fig. 15.23 La stessa frase ambigua nei due modi di disegnarla: a sinistra i costituenti di una lettura, a destra le dipendenze dell’altra. La differenza tra le due letture è un solo aggancio: al nome oppure al verbo. Le sigle del disegno di sinistra sono le scatole (SN nominale, SV verbale, SP preposizionale, F la frase intera) e le categorie delle singole parole (DET l’articolo, N il nome, V il verbo, AUX l’ausiliare, P la preposizione); a destra ogni freccia va dalla testa al dipendente e porta la sigla della relazione (aux l’ausiliare, obj l’oggetto, det l’articolo, case la preposizione, obl il complemento del verbo), e root è la casella da cui il disegno parte.#
In tutti e due i formalismi la struttura disegnata è un albero, rovesciato, con la radice in cima. Nell’albero a costituenti la radice è la frase intera, ogni sintagma è un nodo da cui partono i rami verso i pezzi che contiene, e le foglie, dove non c’è più niente da aprire, sono le singole parole. Nell’albero a dipendenze i nodi sono le parole stesse, la radice è il verbo principale, e ogni parola ha sopra di sé un solo nodo, la sua testa. «Albero sintattico» e «analisi sintattica» indicano l’uno o l’altro, secondo il formalismo.
L’esplosione degli alberi#
Con un solo complemento le letture sono due: pazienza. Ma allunghiamo la frase, e mettiamoci «Ho visto un uomo con il binocolo nel parco». Adesso i complementi da sistemare sono due, e ciascuno si può agganciare a qualcosa che lo precede: al vedere, all’uomo, o al binocolo.
Il vincolo è uno solo: due costituenti, cioè due scatole, o sono uno dentro l’altro o sono separati, mai sovrapposti a metà. In termini formali, un’analisi a costituenti è una parentesizzazione ben formata. Per questo non si può dire che «nel parco» si aggancia all’uomo mentre «con il binocolo», che sta in mezzo, si aggancia al vedere: le due scatole si incrocerebbero.
Contiamo, allora, tenendo fermo il primo complemento e provando tutti gli agganci del secondo.
Caso A: il binocolo è dell’uomo, cioè «con il binocolo» sta dentro la scatola di «un uomo». Dove può andare «nel parco»? Al vedere (ho visto nel parco), all’uomo con il binocolo (l’uomo col binocolo che stava nel parco), oppure al binocolo (il binocolo del parco, quello lì in dotazione). Tre. Attenzione: agganciarlo al solo «uomo» senza il binocolo ricade nella stessa scatola e non in una quarta possibilità: dal momento che il binocolo è già dentro l’uomo, non c’è modo di infilare il parco fra i due senza rompere il costituente.
Caso B: il binocolo è mio, cioè «con il binocolo» è già agganciato al vedere. Dove può andare «nel parco»? Al vedere, oppure al binocolo. Non all’uomo: per farlo dovrebbe scavalcare «con il binocolo», che sta più a sinistra ma è agganciato più in alto, e le scatole si incrocerebbero. Due.
Tre più due fa cinque, tutte grammaticalmente ineccepibili. La Fig. 15.24 le mette in fila, e mette anche la sesta, quella che il cartone non permette.
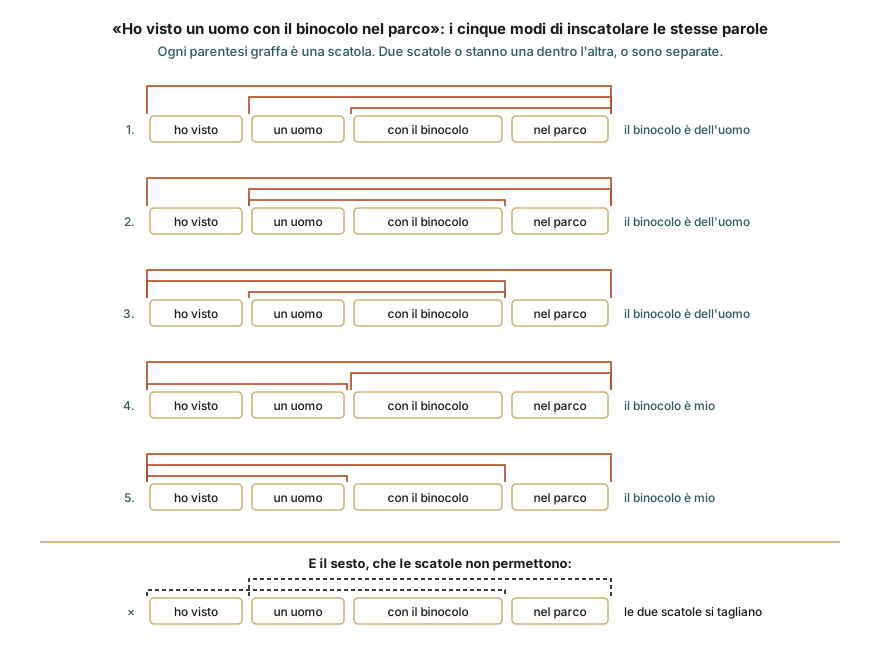
Fig. 15.24 I cinque modi di inscatolare le stesse nove parole, con la frase spezzata nei suoi quattro pezzi. Nelle prime tre «con il binocolo» finisce in una scatola insieme a «un uomo», e il binocolo è dell’uomo; nelle altre due la scatola parte da «ho visto», e il binocolo è di chi guarda. In tutte e cinque le scatole o si contengono o restano separate: l’ultima riga fa vedere la combinazione che questo vieta, due scatole che si tagliano a vicenda.#
Aggiungi «dalla finestra» e salgono a 14, poi 42, 132, 429… Sono i numeri di Catalan, dal matematico belga Eugène Catalan che li studiò nell’Ottocento, e sono la risposta a una domanda che torna dappertutto: in quanti modi si può mettere fra parentesi una fila di cose. Il che è esattamente il nostro problema, perché inscatolare le parole e metterle fra parentesi sono la stessa operazione.
Crescono in fretta: a ogni complemento in più gli alberi si moltiplicano per un fattore che sale (due e mezzo, quasi tre, tre, poco più di tre) e si avvicina a quattro. Continuando: 429 con sei complementi, poi 1.430, 4.862, e con nove si arriva a 16.796. Nove complementi in una frase sono tanti ma non impossibili, e le analisi grammaticalmente lecite sono già sedicimila. Il fenomeno ha un articolo di riferimento dal titolo emblematico, perché il titolo stesso è ambiguo: Coping with syntactic ambiguity or how to put the block in the box on the table [CP82]. Come mettere il blocco nella scatola sul tavolo: ma il tavolo sostiene la scatola, o è lì che va messo il blocco?
La morale è doppia. Una frase di giornale può avere migliaia di alberi grammaticalmente leciti, quasi tutti assurdi per un lettore umano ma impeccabili per la grammatica, che non giudica la plausibilità. E nessun parser può permettersi di elencarli uno per uno. Servono allora due cose. La prima è condividere i pezzi comuni a molte analisi, ed è la programmazione dinamica, già incontrata con la griglia della distanza di edit e con l’algoritmo di Viterbi: risolvere una volta sola ogni pezzo che servirà più volte, e conservarne il risultato. La seconda è scegliere fra le analisi, e nella forma più semplice si fa contando. In un insieme di frasi già analizzate a mano si guarda quante volte è stata usata ciascuna regola di montaggio, rispetto alle altre regole che costruiscono lo stesso tipo di blocco, e quella frequenza diventa la probabilità della regola; un albero vale il prodotto delle probabilità delle sue regole, e vince il più probabile. È una grammatica context-free probabilistica (PCFG). Le sue probabilità, però, stanno sulle regole, che parlano di categorie: le due letture del binocolo usano le stesse parole, e a separarle restano le sole regole che agganciano un complemento al verbo o al nome. La PCFG sceglie l’aggancio da quelle frequenze, e darebbe lo stesso verdetto a «con il cappello», cioè sbaglia proprio dove a decidere sono le parole. Al posto dei conteggi si può mettere una rete neurale, che guarda anche le parole e non solo le categorie.
Costruire l’albero senza provarle tutte#
Due strategie classiche dominano il campo, una per ciascuno dei due disegni: la prima costruisce le scatole, la seconda le frecce. Le presentiamo con lo stesso schema: l’idea, il costo, il compromesso.
Sul tavolo c’è un mosaico a metà. Due tessere che combaciano formano un’isola, cioè una scatola di parole già chiusa; un’altra coppia ne forma un’altra, e le isole si uniscono fra loro quando sono pronte. Il primo metodo monta la frase così, e si chiama CKY dalle iniziali di Cocke, Kasami e Younger, che negli anni Sessanta lo scoprirono ciascuno per conto suo. Prima mette insieme tutti i tratti lunghi due parole («un uomo», «il binocolo»), poi quelli di tre («con il binocolo»), poi di quattro, e a ogni giro incolla due isole già montate. Un’isola montata non si smonta più: «il binocolo» lo capisce una volta sola, anche se poi servirà a dieci letture diverse. È il risparmio del navigatore di Viterbi, spostato dalle parole ai tratti di frase. In cambio del tempo che costa, questo metodo non sbaglia mai per fretta: monta tutte le isole possibili, quindi l’albero giusto, se la grammatica lo prevede, sul tavolo c’è di sicuro.
Il tavolo però si riempie, e si può contare di quanto. Metti in fila quattro parole. Le isole da provare, una per ogni scelta di dove cominciare e dove finire, sono dieci. Con otto parole diventano trentasei, quasi quattro volte tante. E ogni isola va provata in tutti i punti in cui la si può tagliare in due pezzi più piccoli: un tratto di quattro parole ne ha tre, uno di otto ne ha sette, circa il doppio. Quattro volte tante le isole, il doppio dei tagli per ciascuna: raddoppiando la lunghezza della frase il lavoro sul tavolo diventa circa otto volte tanto.
Il secondo metodo gioca a carte. Le parole della frase arrivano una alla volta, nel loro ordine, e accanto c’è una pila di carte scoperte di cui si vedono solo le prime due. A ogni turno si fa una mossa sola, e le mosse sono tre.
Prendi: la parola successiva della frase sale in cima alla pila.
Collega verso sinistra: fra le due carte in cima comanda quella sopra, e quella sotto esce dal tavolo.
Collega verso destra: il contrario, comanda quella sotto ed esce quella sopra.
I nomi guardano la frase e non la pila: «sinistra» vuol dire che la freccia, disegnata sopra la riga, punta all’indietro, verso la parola arrivata prima.
Una partita intera, su «Maria porta il pane», si gioca così. Prendi «Maria», prendi «porta»: comanda la carta di sopra, quindi collega verso sinistra, ed esce «Maria». Prendi «il», prendi «pane»: di nuovo comanda quella di sopra, verso sinistra, ed esce «il». Ora in cima ci sono «porta» e, sopra, «pane», e stavolta comanda la carta di sotto: collega verso destra, ed esce «pane». La carta che si collega esce di scena perché il suo posto nell’organigramma è ormai deciso. Le parole sono finite, sulla pila resta una carta sola, «porta», il capo di tutti, e l’albero è fatto.
A giocare è qualcuno che ha visto migliaia di frasi già analizzate a mano. Guarda le due carte in cima e quante parole restano da prendere, poi butta giù la mossa senza pensarci. Due mosse per parola, una sola passata sulla frase, e la partita è chiusa.
Una carta uscita dal tavolo, però, non ci torna più. Un collegamento messo storto alla terza parola resta storto fino all’ultima, ed è il difetto di ogni scelta ingorda, quella della traduzione compresa. Il rimedio è tenere aperte tre o quattro partite invece di una, e scartare alla fine quelle andate peggio.
Le carte hanno anche un limite di disegno: le frecce che producono non si incrociano mai. Nelle lingue in cui le parole si spostano con libertà due frecce che si scavalcano sono comuni, e lì il gioco sbaglia per costruzione, finché non gli si concede una quarta mossa, che rimette sotto la carta di sopra e così cambia l’ordine in cui le parole si incontrano.
C’è poi chi non gioca affatto a carte e fa come l’ufficio del personale: dà un voto a ogni coppia possibile di capo e impiegato fra le parole della frase, e cerca fra tutti gli organigrammi quello con il voto totale più alto, frecce incrociate comprese. Costa di più, e di solito sbaglia meno, soprattutto sulle frasi lunghe.
CKY. Il nome viene dalle iniziali di Cocke, Kasami e Younger, che negli anni Sessanta arrivarono all’algoritmo ciascuno per conto suo [JM26]. Richiede la grammatica in forma normale di Chomsky (regole binarie \(A \to B\,C\) o lessicali \(A \to w\); ogni CFG che non generi la stringa vuota vi si converte, e la conversione fa crescere \(|R|\), che è il fattore che compare nel costo di CKY). Il numero di alberi binari su \(n\) foglie è il numero di Catalan \(C_{n-1} = \frac{1}{n}\binom{2(n-1)}{n-1}\), dove le foglie non sono le parole ma i pezzi da imparentesare (il verbo, il sintagma nominale, e un sintagma preposizionale per ogni complemento); cresce come \(4^{n}\) a meno di un fattore polinomiale, e l’enumerazione è fuori discussione. CKY riempie una tabella triangolare indicizzata dagli intervalli della frase: \(T[i,j]\) è l’insieme delle categorie che possono coprire le parole dalla posizione \(i\) alla \(j\) (esclusa), calcolato dal corto verso il lungo. Il caso base sono gli intervalli di una parola sola, riempiti dalle regole lessicali (\(A \in T[i, i+1]\) se \(A \to w_i \in R\)); da lì in su vale la ricorrenza
dove \(k\) scorre sui punti di taglio interni all’intervallo e \(R\) sono le regole. Le celle sono \(O(n^2)\), ogni cella prova \(O(n)\) tagli per ognuna delle \(|R|\) regole: costo totale \(O(n^3\,|R|)\), contro l’esplosione esponenziale degli alberi espliciti. La stessa ricorrenza, con somme al posto delle unioni, conta gli alberi, ed è la versione contabile di CKY che il programma sulla frase del binocolo esegue; con probabilità sulle regole e massimi al posto delle somme restituisce l’albero più probabile: è Viterbi, trasportato dai prefissi agli intervalli. Una PCFG (probabilistic context-free grammar) associa a ogni regola \(A \to \alpha\) una probabilità \(P(A \to \alpha)\), con \(\sum_\alpha P(A \to \alpha) = 1\) per ogni \(A\), e la probabilità di un albero è il prodotto di quelle delle sue regole; su un treebank la stima di massima verosimiglianza è la frequenza relativa \(C(A \to \alpha)/C(A)\). L’assunzione che pesa è l’indipendenza: la probabilità di una regola non dipende né dal contesto in cui la si applica né dalle parole, ed è per questo che una PCFG semplice sceglie male proprio l’attacco del sintagma preposizionale, che dalle parole dipende («binocolo» o «cappello»). I parser a costituenti si valutano con le misure PARSEVAL: precisione, richiamo ed \(F_1\) sui costituenti etichettati (intervallo di parole e categoria) che l’albero prodotto ha in comune con quello annotato.
Parsing a transizioni. Per le dipendenze le strategie principali sono due.
La prima, lo shift-reduce, costruisce l’albero con una sequenza di mosse
scelte da un classificatore: è lineare nella lunghezza della frase, ma una mossa
sbagliata non si corregge. Una configurazione è una terna (pila \(\sigma\),
buffer \(\beta\), archi \(\mathcal{A}\)) e le mosse della variante arc-standard
sono tre: shift
(sposta la prossima parola sulla pila), left-arc e right-arc (creano un
arco etichettato tra le due parole in cima e ne rimuovono la dipendente). La
configurazione finale ha il buffer vuoto e sulla pila la sola radice, e una
frase di \(n\) parole ci arriva in circa \(2n\) mosse: costo lineare. La mossa la
sceglie un classificatore sullo stato corrente; dalla svolta neurale
[CM14] i tratti simbolici sono rimpiazzati dagli embedding delle
parole su pila e buffer, dati in ingresso a un MLP. La decodifica greedy
propaga gli errori; beam search e modelli globali attenuano il problema.
Sull’inglese, sul Penn Treebank convertito in dipendenze (il treebank originale
è a costituenti, e la conversione è un passaggio a parte), il parser di Chen e
Manning arriva al 92% di UAS (unlabeled attachment score, la quota di
parole agganciate alla testa giusta) analizzando più di mille frasi al secondo.
L’arc-standard produce soltanto alberi proiettivi, quindi sulle lingue a ordine
libero sbaglia per costruzione gli archi che si incrociano; li recupera una
quarta mossa, swap, che riordina pila e buffer [Niv09].
La seconda strategia è il parsing basato su grafi: si assegna un punteggio
\(s(h, d)\) a ogni arco possibile dalla testa \(h\) al dipendente \(d\) e si cerca
l’albero di punteggio massimo, con l’algoritmo di Eisner in \(O(n^3)\) se lo si
vuole proiettivo, con quello di Chu–Liu/Edmonds in \(O(n^2)\) se no
[MPRHajivc05]. Costa più del parsing a transizioni ed è in genere più
accurato, soprattutto sulle frasi lunghe, dove le teste stanno lontane dai
dipendenti [JM26]. Con i punteggi prodotti da una BiLSTM e
da un prodotto biaffine arriva, sullo stesso Penn Treebank, al 95,7% di UAS e
al 94,1% di LAS [DM17]; il LAS (labeled attachment score)
conta giusta una parola solo se sono corrette sia la testa sia l’etichetta
della relazione. I parser a grafo con punteggi biaffini sono la famiglia dei
sistemi migliori nelle campagne su Universal Dependencies.
Contare le analisi con CKY#
Il programma usa sei regole di montaggio, e ciascuna dice come due pezzi ne fanno uno più grande. «Un articolo seguito da un nome fa un sintagma nominale» è una regola; «un sintagma nominale seguito da un sintagma preposizionale fa un sintagma nominale più grande» è quella che genera l’ambiguità del binocolo, perché permette a «con il binocolo» di entrare dentro «un uomo». Sei regole così bastano per la nostra frase, e prima dei treebank le grammatiche si scrivevano tutte a mano, regola per regola, da linguisti in carne e ossa.
La versione «contabile» di CKY sta allora in una pagina: quelle sei regole, un elenco di parole con la loro categoria, e una tabella che invece di memorizzare gli alberi si limita a contarli. Il secondo complemento qui è «con il cappello», e non «nel parco» come nel conto fatto a mano, perché il vocabolario giocattolo del programma conosce una preposizione sola, «con»: la frase cambia, la forma no, e infatti il numero che esce è lo stesso.
# Grammatica giocattolo: ogni regola unisce esattamente due pezzi (6 regole + lessico)
lessico = {
    "ho": {"AUX"}, "visto": {"V"}, "un": {"DET"}, "il": {"DET"},
    "uomo": {"N"}, "binocolo": {"N"}, "cappello": {"N"},
    "gatto": {"N"}, "con": {"P"},
}
regole = [                    # A -> B C
    ("SN", "DET", "N"),       # "un uomo", "il binocolo"
    ("SP", "P",   "SN"),      # "con il binocolo"
    ("SN", "SN",  "SP"),      # attacco al nome: l'uomo HA il binocolo
    ("SV", "V",   "SN"),      # "visto un uomo"
    ("SV", "SV",  "SP"),      # attacco al verbo: ho guardato COL binocolo
    ("F",  "AUX", "SV"),      # "ho" + sintagma verbale
]

def conta_alberi(parole):
    n = len(parole)
    # tab[i][j] = {categoria: quanti alberi coprono parole[i:j]}
    tab = [[{} for _ in range(n + 1)] for _ in range(n + 1)]
    for i, w in enumerate(parole):
        for cat in lessico[w]:
            tab[i][i + 1][cat] = 1
    for lung in range(2, n + 1):          # intervalli dal corto al lungo
        for i in range(n - lung + 1):
            j = i + lung
            for k in range(i + 1, j):     # punto di taglio
                for A, B, C in regole:
                    if B in tab[i][k] and C in tab[k][j]:
                        tab[i][j][A] = (tab[i][j].get(A, 0)
                                        + tab[i][k][B] * tab[k][j][C])
    return tab[0][n].get("F", 0)

print(conta_alberi("ho visto un uomo con il binocolo".split()))        # 2
print(conta_alberi(
    "ho visto un uomo con il binocolo con il cappello".split()))       # 5
print(conta_alberi(
    "ho visto un uomo con il binocolo con il cappello con il gatto".split()))
2
5
14
Le due letture del binocolo ci sono; con il secondo complemento le analisi diventano cinque, il passo successivo dei numeri di Catalan, compresa quella in cui è il binocolo a indossare il cappello. La grammatica la genera senza batter ciglio, perché la grammatica dice solo che cosa si può montare, non che cosa ha senso: a scartare le assurdità tocca a qualcos’altro, e cioè a delle probabilità imparate su frasi vere o a una rete neurale. E con un terzo complemento, «con il gatto», le analisi sono già quattordici.
Da dove vengono gli alberi: i treebank#
Chi glieli insegna, ai modelli, gli alberi giusti? Persone. Un treebank è un corpus in cui ogni frase è accompagnata dal suo albero sintattico, tracciato e ricontrollato da annotatori esperti: un lavoro linguistico lento e prezioso, che nel NLP ha fatto da spartiacque. Quello che per decenni ha fatto da riferimento è il Penn Treebank [MSM93], costruito all’Università della Pennsylvania a partire dal 1989 e distribuito ai ricercatori attraverso il Linguistic Data Consortium: oltre quattro milioni e mezzo di parole etichettate per categoria grammaticale e un nucleo di circa un milione di parole di articoli del Wall Street Journal annotato con alberi a costituenti.
Da quelle decine di migliaia di frasi, per vent’anni, i parser hanno imparato quanto ciascuna regola di montaggio è frequente, e con quei numeri hanno imparato a scegliere fra le mille analisi possibili. È il ribaltamento importante: la grammatica ha smesso di essere scritta a mano, regola per regola, ed è diventata qualcosa che si conta nei dati.
Il progetto Universal Dependencies ha rifatto l’operazione in scala mondiale e con le frecce al posto delle scatole: per l’italiano il treebank di riferimento è ISDT (Italian Stanford Dependency Treebank), circa quattordicimila frasi nate dalla convergenza di risorse costruite negli anni da gruppi di Torino e Pisa. È su questi alberi che si addestrano tutti i parser di cui abbiamo parlato, ieri con le probabilità sulle regole, oggi con le reti neurali.
La sintassi al tempo dei modelli giganti#
I grandi modelli linguistici (in sigla LLM, large language model) fanno parsing? Non come un parser. Un modello addestrato a indovinare la parola successiva non costruisce alberi mentre legge, e il suo addestramento non glielo chiede; se glielo si chiede, un albero lo scrive come scrive qualunque altro testo, senza nessuna garanzia che sia un albero ben formato.
Eppure c’è un filone di studi che guarda dentro questi modelli, e si chiama probing, «sondaggio». Mentre un modello come BERT [DCLT19] legge una frase, ogni suo strato produce per ogni parola un vettore di centinaia di numeri, le attivazioni, cioè lo stato in cui quella frase lo mette. Il probing congela il modello, raccoglie le attivazioni di uno strato su un insieme di frasi annotate, e addestra su di esse una sonda: un modello piccolo, di solito una semplice trasformazione lineare (una moltiplicazione per una matrice, come lo strato lineare del tagger) o poco più, che deve ricavarne una proprietà, la categoria di ogni parola o la sua posizione nell’albero. La sonda deve restare piccola, perché una rete grande imparerebbe il compito per conto suo, e allora non si saprebbe niente del modello. Se una sonda piccola ci riesce, la spiegazione più semplice è che l’informazione nelle attivazioni ci fosse già, e che alla sonda sia bastato andarla a leggere.
Più semplice, però, non vuol dire unica, e Hewitt e Liang [HL19] hanno mostrato perché. Si assegna a ogni parola del vocabolario un’etichetta sorteggiata una volta per tutte, senza nessun senso grammaticale («gatto» riceve sempre la 7, «muro» sempre la 3), e si addestra la stessa sonda a ripeterla: sui vettori di un modello di linguaggio una sonda lineare ci riesce in buona parte, e una un po” più grande quasi del tutto, perché basta riconoscere la parola. Il loro controllo confronta allora la riuscita della sonda sul compito vero con quella sul compito sorteggiato: solo lo scarto fra le due dice quanto la sonda legge davvero nelle attivazioni, invece di imparare a memoria il vocabolario. Il metodo è raccontato per esteso nella sezione sull’interpretabilità.
Hewitt e Manning [HM19] cercano una trasformazione lineare delle attivazioni sotto cui la distanza fra due parole, al quadrato, approssima la loro distanza nell’albero a dipendenze, cioè quante frecce bisogna percorrere per andare dall’una all’altra nell’albero della frase: in «il gatto nero salta sul muro», «nero» dista una freccia da «gatto» e due da «salta». Dalle distanze ricostruite si risale a un albero, e con lo strato migliore di BERT-large quell’albero ha in comune con quello annotato l’82,5% delle frecce, senza contarne il verso, contro il 48,9% di un albero che lega semplicemente ogni parola alla successiva; e quegli alberi, al modello, nessuno li ha mai mostrati. È un indizio che qualcosa di simile alla struttura sintattica si formi da sola durante l’addestramento: un indizio, non la prova che il modello la usi come farebbe un linguista.
Il parsing esplicito, intanto, non è andato in pensione. Serve alla linguistica, che avendo tutte quelle lingue annotate con gli stessi criteri può finalmente confrontare le grammatiche del mondo contando, invece che per impressione. Serve ad alcuni sistemi di correzione grammaticale, dove segnalare un errore (un soggetto che non concorda con il verbo) chiede di sapere quale parola regge quale. E serve alle lingue di cui esiste poco testo, per le quali mancano i miliardi di parole che un modello gigante richiede, mentre un treebank di qualche migliaio di frasi è alla portata di un gruppo di annotatori.
La struttura, poi, si valuta con una misura più semplice di quella del dialogo: si prende una frase di cui qualcuno ha già disegnato l’albero giusto, si guarda l’albero prodotto dalla macchina, e si conta la quota di parole agganciate alla testa corretta, l’UAS; se si chiede anche la relazione giusta, la quota con testa e relazione corrette, il LAS. La misura presuppone che l’albero giusto sia uno solo, e qui di solito lo è, con un margine: su qualche freccia nemmeno gli annotatori sono d’accordo fra loro. Nel dialogo invece le risposte accettabili sono molte, e valutare diventa un problema a sé.
Da ricordare
L’ambiguità di «Ho visto un uomo con il binocolo» non sta nelle parole né nel mestiere che ciascuna fa: le etichette del POS tagging sono identiche nelle due letture. Sta in come le parole si raggruppano, e cioè se «con il binocolo» si attacca all’uomo o al vedere.
Le scatole del trasloco: certi gruppi di parole viaggiano insieme, e lo si scopre con due prove da fare a orecchio, sostituire il gruppo con una parola sola e spostarlo tutto intero. Le scatole stanno dentro altre scatole, fino alle singole parole; e una scatola può stare dentro una dello stesso tipo, così che pochi modi di inscatolare, riusati, bastino a frasi lunghe quanto si vuole, comprese quelle che nessuno ha mai pronunciato.
L’organigramma: la stessa struttura si può disegnare con delle frecce, ogni parola con un capo solo e il verbo principale in cima. L’ambiguità del binocolo diventa una domanda sola: per chi lavora «binocolo»? Le frecce reggono meglio le lingue che spostano le parole con libertà, come l’italiano, ed è il modo in cui sono annotate più di centocinquanta lingue.
Scatole o frecce, il disegno che ne esce si chiama albero. Con le scatole in cima c’è la frase intera e le parole sono le foglie; con le frecce ogni parola è un nodo, il verbo principale comanda su tutti, e sopra di lui resta una sola casella che parola non è, quella da cui il disegno parte.
Gli alberi possibili esplodono: due con un complemento, cinque con due, poi 14, 42, 132. Nessun programma può elencarli tutti, quindi ne condivide i pezzi (la stessa astuzia della griglia e del navigatore delle sezioni precedenti) e poi ne sceglie uno, con delle probabilità o con una rete.
Due modi di costruire l’analisi: il mosaico, che capisce prima i pezzi corti e poi incolla, sicuro ma costoso; e la pila, che legge da sinistra a destra decidendo mossa per mossa, velocissimo ma senza ripensamenti (e il rimedio è quello già visto per la traduzione, tenere aperte alcune alternative). La pila, da sola, non sa fare frecce che si incrociano: per quelle serve una mossa in più, o un metodo che dà un voto a ogni freccia.
Gli alberi giusti li insegnano delle persone: i treebank sono raccolte di testi in cui ogni frase è stata analizzata a mano, e da lì i programmi imparano. Per l’italiano quello di riferimento è ISDT, di circa quattordicimila frasi.
I modelli giganti non analizzano la frase mentre la leggono, e nessuno glielo ha insegnato; se glielo si chiede, un albero lo scrivono come qualunque altro testo, senza garanzia che stia in piedi. Andando a guardare dentro di loro con una sonda piccola, però, si ritrova qualcosa che somiglia all’analisi logica, purché si controlli che la sonda non stia soltanto riconoscendo le parole. È un indizio, non una prova.
Da ricordare
L’ambiguità di «Ho visto un uomo con il binocolo» è strutturale: le etichette POS sono identiche nelle due letture; a cambiare è l’attacco del sintagma preposizionale, al nome o al verbo.
I costituenti raggruppano le parole in sintagmi annidati (prove di sostituzione e spostamento); il formalismo è la grammatica context-free, con regole di riscrittura e alberi di derivazione: nasce con le grammatiche a struttura sintagmatica di Chomsky (1956), e il nome e il posto nella gerarchia li riceve nel 1959.
Le dipendenze collegano ogni parola alla sua testa con una relazione etichettata (
nsubj,obj,obl…); reggono bene le lingue a ordine flessibile come l’italiano e sono lo standard di Universal Dependencies. Un albero è proiettivo se i suoi archi, disegnati sopra la frase, non si incrociano; nelle lingue a ordine libero spesso non lo è.Il numero di alberi possibili esplode con i numeri di Catalan: 2, 5, 14, 42, 132… Nessun parser può enumerarli.
CKY è programmazione dinamica sugli intervalli, \(O(n^3\,|R|)\) con \(|R|\) regole, analogo a Viterbi; con una PCFG restituisce l’albero più probabile, e l’indipendenza dalle parole è il suo limite. Il parsing a transizioni costruisce l’albero a dipendenze in tempo lineare con mosse shift-reduce scelte da un classificatore neurale, ma solo proiettivo senza
swap; quello basato su grafi costa di più ed è in genere più accurato.I parser si addestrano sui treebank, il Penn Treebank per i costituenti, le UD (per l’italiano: ISDT) per le dipendenze, e si valutano con PARSEVAL i primi, con UAS e LAS i secondi.
I LLM non costruiscono alberi mentre leggono (un albero richiesto lo generano come testo, senza garanzia che sia ben formato), ma il probing suggerisce che una parte della struttura sintattica emerga nelle loro rappresentazioni, a patto di controllare con compiti sorteggiati che la sonda non stia solo memorizzando; il parsing esplicito resta utile a linguistica, a qualche sistema di correzione grammaticale e alle lingue a poche risorse.
Con le etichette del POS tagging e gli alberi del parsing, una macchina può dire chi fa che cosa a chi dentro una frase isolata. Ma le frasi, nella vita, arrivano in botta e risposta: domande, risposte, malintesi, sottintesi, e per capirne una bisogna ricordare che cosa è stato detto prima. Come una macchina si porti dietro quel ricordo da un turno all’altro è il problema del dialogo tra persone e macchine.