


Object detection e segmentazione#
Un’auto a guida autonoma si avvicina a un incrocio. Una rete di classificazione, di quelle viste finora, sa dirle una cosa sola: nell’immagine c’è un pedone. Vero, ma inutile. Per frenare in tempo l’auto deve sapere dove si trova quel pedone, se è uno o sono tre, se quello a destra è un ciclista, e (al limite) quale sagoma esatta occupa sull’asfalto. La classificazione risponde alla domanda «che cosa»; il rilevamento e la segmentazione rispondono anche a «dove, nella foto» e «con quali contorni».
Dalla classificazione al riquadro#
Salire dalla classificazione alla localizzazione è come passare da «in questa foto c’è un gatto» a «il gatto sta in quel rettangolo». Il compito si chiama object detection: per ogni oggetto presente, la rete deve produrre insieme un riquadro e un’etichetta.

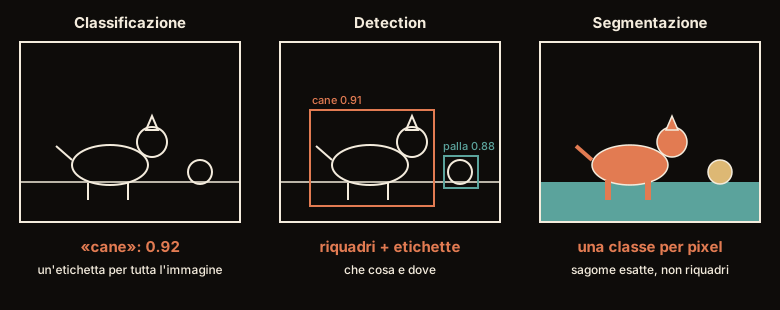
Fig. 11.6 Stessa foto, tre uscite: classificazione, rilevamento e segmentazione semantica, cioè tre dei quattro compiti classici. Salendo da sinistra a destra cresce la precisione della risposta.#
La progressione di Fig. 11.6 ha un prezzo, già messo in fila fra i compiti della visione: un’etichetta per foto si scrive in un secondo, un riquadro va trascinato col mouse, una maschera pixel per pixel costa minuti a immagine. È spesso questo, e non l’architettura, a decidere quale dei tre compiti si può davvero affrontare.
Prendi un pennarello, cerchia in una foto ogni oggetto interessante e scrivigli accanto un nome: «auto», «cane», «semaforo». Ogni cerchio è in realtà un rettangolo (lo chiamiamo bounding box, la «cornice») e ogni nome è la classe. Un rilevatore fa esattamente questo, ma in automatico e per molti oggetti insieme. Per ciascuno indovina tre cose alla volta: dove tracciare la cornice, cosa c’è dentro e quanto ci crede, cioè un numero fra 0 e 1 con cui dichiara la sua sicurezza che lì dentro qualcosa ci sia davvero.
Il terzo numero serve perché nessuno gli ha detto quante cornici disegnare. In una foto di strada gli oggetti possono essere due o quaranta, e prima di guardare non lo sa. Allora tiene pronte tantissime cornici sparse su tutta la foto e le riempie tutte, sapendo che per la stragrande maggioranza la risposta giusta è «qui non c’è niente».
Mentre impara, a ogni foto il rilevatore riceve tre penalità e le somma: una per la cornice storta, una per il nome sbagliato, una per la sicurezza fuori posto, cioè per aver detto «qui c’è qualcosa» dove c’era soltanto asfalto, o il contrario. Le tre non pesano uguale, e il rapporto si sceglie prima di cominciare: in uno dei primi rilevatori l’errore sulla cornice di un oggetto vero contava dieci volte più di un po’ di sicurezza spesa su una casella vuota. Le caselle vuote sono migliaia, e se contassero quanto le altre il rilevatore imparerebbe la scorciatoia più comoda del mondo, cioè rispondere «niente» dappertutto e avere quasi sempre ragione.
Per ogni oggetto la rete predice un vettore \((x, y, w, h, c, p_{\text{obj}})\): le coordinate del centro e le dimensioni del riquadro, la classe \(c\) e una confidenza \(p_{\text{obj}} \in [0,1]\) che stima se nel riquadro c’è davvero un oggetto. L’addestramento minimizza una loss composita che somma un termine di localizzazione (errore sulle coordinate, tipicamente smooth L1 o una IoU-loss), un termine di classificazione (cross-entropy sulla classe) e un termine di objectness che supervisiona la confidenza, spingendola verso l’alto dove un oggetto c’è e verso zero sullo sfondo. In YOLOv1 e YOLOv2 il bersaglio dell’objectness non era uno ma la IoU stessa fra riquadro predetto e riquadro vero (l’area in comune divisa per quella coperta in tutto), così che il punteggio incorporasse la qualità della localizzazione; da YOLOv3 in poi, è semplicemente uno. La formula unisce i tre termini:
Il coefficiente \(\lambda\) bilancia localizzazione e riconoscimento; YOLO ne usa in realtà due, e il secondo (\(\lambda_{\text{noobj}} = 0{,}5\) contro \(\lambda_{\text{coord}} = 5\)) serve proprio a smorzare il contributo delle moltissime celle vuote, cioè è un primo rimedio a quello squilibrio oggetto/sfondo su cui torneremo con la focal loss. Questa è la parametrizzazione di YOLO; nella famiglia Faster R-CNN il termine di objectness non sparisce, si sposta. Nel primo stadio, la Region Proposal Network, è proprio una objectness: ogni ancora viene classificata in binario come oggetto o sfondo, e il termine di regressione è attivo solo sulle ancore positive. Manca invece dalla testa del secondo stadio, dove la confidenza coincide con il punteggio softmax della classe perché lì lo sfondo è trattato come una classe in più. Un’immagine può contenere un numero variabile di oggetti: gestire questa cardinalità ignota è il vero nodo architetturale della detection.
Due stadi contro uno stadio#
Storicamente i rilevatori si dividono in due famiglie, e la differenza è un classico compromesso tra accuratezza e velocità. Gli uni procedono in due passi: prima propongono le zone dove conviene guardare, poi esaminano ciascuna zona per dire che cosa contiene e correggerne la cornice. Gli altri fanno tutto in un passo solo.

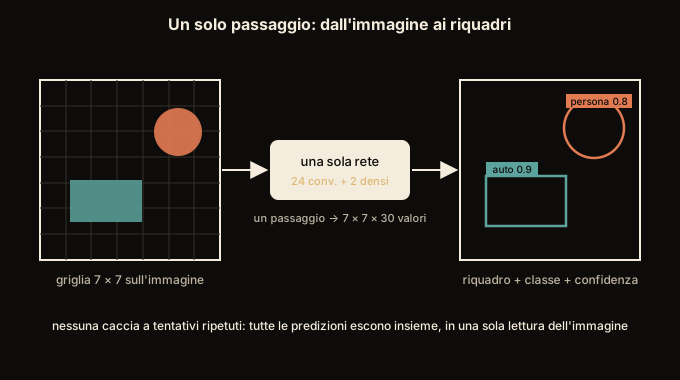
Fig. 11.7 L’approccio a stadio singolo, cioè una sola passata sull’immagine. La griglia è una divisione di responsabilità decisa in anticipo, non una ricerca.#
Guardiamo la seconda famiglia, quella della passata unica, perché Fig. 11.7 rende evidente cosa si guadagna e cosa si perde. Fare tutto in una passata sola è quello che rende possibile il tempo reale; il prezzo lo si legge nella griglia disegnata sopra la foto. Quella griglia è una divisione del lavoro decisa prima di guardare, in cui ogni casella (una cella) si prende la responsabilità degli oggetti che le cadono dentro. E siccome a ogni cella si concede in partenza un numero fisso di riquadri, due nel primo YOLO, oggetti piccoli e ammassati nella stessa cella se li contendono: il terzo passerotto dello stormo non ha una cornice a disposizione.
I rilevatori a due stadi lavorano come un revisore scrupoloso: prima propongono un po’ di zone «sospette» dove potrebbe esserci qualcosa, poi guardano con calma dentro ognuna per decidere cosa sia e correggere la cornice. Più lenti, e per anni i più precisi.
I rilevatori a uno stadio fanno tutto in un colpo solo: un’unica passata sull’immagine sputa fuori direttamente cornici ed etichette. A lungo sono stati meno precisi sui casi difficili, ma abbastanza rapidi da lavorare in tempo reale su un video, ed è per questo che si chiama YOLO, You Only Look Once.
La ragione di quella minore precisione sta in un conto. Il revisore in due tempi esamina con calma soltanto le zone sospette, e quasi tutto lo sfondo l’ha già scartato al primo passaggio. Chi guarda una volta sola deve invece dare una risposta per ogni casella dell’immagine, e le caselle con dentro un oggetto sono una manciata contro decine di migliaia di asfalto, cielo e muro. Alla correzione arrivano così diecimila risposte quasi tutte uguali e quasi tutte facili: sommate, seppelliscono le poche difficili, e il rilevatore impara benissimo a dire «niente» e molto peggio tutto il resto. Abbassare in blocco il peso di tutte le risposte vuote, come si faceva all’inizio, aiuta e non basta: fra quelle vuote ce ne sono migliaia di ovvie e qualcuna insidiosa, e un peso unico le tratta allo stesso modo. Il rimedio, trovato nel 2017, cambia il modo di correggere invece dell’architettura: una risposta facile, di quelle su cui il rilevatore ha già ragione ed è pure sicuro, conta quasi zero, e a decidere la lezione restano i pochi casi su cui sta ancora sbagliando. Da lì lo svantaggio in precisione si è in gran parte chiuso, e fra le due famiglie è rimasta soprattutto la differenza di velocità.
La famiglia a due stadi nasce con R-CNN [GDDM14], che fa passare nella rete, una per una, le circa duemila regioni proposte per ogni immagine da un algoritmo esterno. Fast R-CNN [Gir15] calcola le mappe di feature una volta sola sull’immagine intera e ne ritaglia le regioni con un RoI pooling, che porta ciascuna a una taglia fissa; Faster R-CNN [RHGS15] sostituisce le proposte esterne con la Region Proposal Network, che lavora sulle stesse mappe. Uno stadio propone regioni candidate, il secondo le classifica e ne raffina i riquadri, e le mappe dell’immagine si calcolano una volta sola per tutti e due. Accuratezza elevata, ma latenza maggiore, perché il secondo stadio lavora regione per regione. Lo squilibrio fra oggetti e sfondo i due stadi lo aggirano per costruzione: il primo riduce le posizioni candidate da circa centomila a uno o duemila, scartando quasi tutto lo sfondo, e nel secondo si campiona un rapporto fisso fra oggetti e sfondo (uno a tre) oppure si scelgono gli esempi più difficili [LGG+17].
La famiglia a uno stadio (YOLO [RDGF16] e SSD [LAE+16]) elimina la fase di proposta: una sola rete convoluzionale predice simultaneamente riquadri e classi su una griglia dell’immagine. Il prezzo storico è stato lo squilibrio tra i pochi riquadri con oggetto e i moltissimi di sfondo; la focal loss di RetinaNet [LGG+17] lo ha in gran parte sanato, avvicinando le due famiglie in accuratezza. Posto \(p_t = p\) se l’ancora è positiva e \(p_t = 1 - p\) se è sfondo, la cross-entropy \(-\log p_t\) diventa
dove \(\alpha_t\) vale \(\alpha\) sulle ancore positive e \(1 - \alpha\) sullo sfondo (un peso fisso per classe, come il \(\lambda_{\text{noobj}}\) di YOLO); il fattore \((1 - p_t)^{\gamma}\) è invece la vera novità, perché dipende da quanto l’esempio è già risolto. Con \(\gamma = 2\) un esempio con \(p_t = 0{,}9\) pesa cento volte meno che nella cross-entropy, uno con \(p_t \approx 0{,}968\) mille volte meno. Il lavoro usa \(\gamma = 2\) e \(\alpha = 0{,}25\), cioè pesa gli oggetti un terzo dello sfondo, al rovescio di \(\lambda_{\text{noobj}}\): spenti i negativi facili dal fattore focale, sono i positivi a chiedere meno enfasi. La somma si divide per il numero delle sole ancore positive.
Le ancore: non partire da zero#
Le due famiglie condividono un problema, e per anni hanno condiviso anche la soluzione (il primo YOLO non l’aveva ancora, le versioni recenti l’hanno tolta). Nello stesso punto dell’immagine possono trovarsi oggetti dalle forme opposte: un pedone alto e stretto, un’auto bassa e larga, un pallone quasi quadrato. Chiedere alla rete di disegnare il riquadro giusto partendo dal nulla è chiederle molto. La scorciatoia si chiama anchor box, l’»ancora»: un riquadro di partenza già pronto, da correggere invece che da inventare.

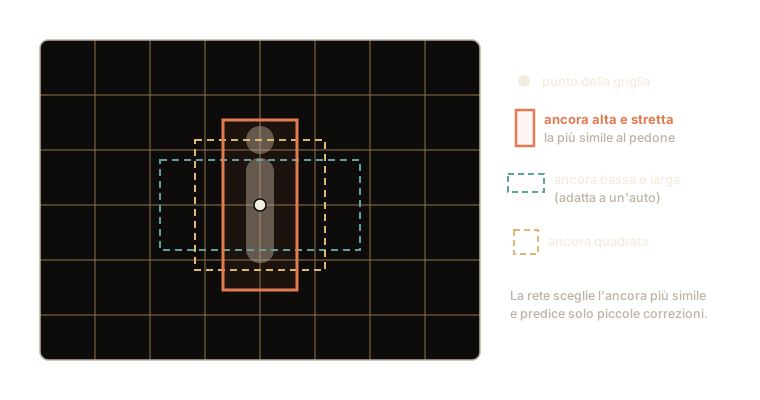
Fig. 11.8 In ogni punto della griglia la rete parte da più ancore di forma diversa: per il pedone, quella alta e stretta (terracotta) è già quasi giusta.#
Un corniciaio non costruisce una cornice su misura per ogni quadro che entra in bottega: tiene pronti alcuni formati standard (verticale per i ritratti, orizzontale per i paesaggi, quadrato) e poi ritocca quello che ci va più vicino. Le ancore funzionano allo stesso modo. In ogni punto dell’immagine la rete ha a disposizione qualche cornice predefinita, di taglie e proporzioni diverse (Fig. 11.8). Davanti a un pedone non deve inventarsi il rettangolo: prende la cornice verticale, che gli somiglia già, e la aggiusta. Correggere una cornice quasi giusta è molto più facile che disegnarne una dal nulla, e la rete impara proprio questo: piccole correzioni, più il nome di ciò che c’è dentro.
Le correzioni si dicono in frazioni della cornice stessa, mai in centimetri: «spostati a destra di un decimo della tua larghezza, allungati di un quinto». Detta così, la stessa istruzione va bene per la cornicetta del passerotto in fondo al prato e per quella del camion in primo piano. Detta in centimetri, tre centimetri manderebbero la cornice del passerotto lontano dal passerotto e quella del camion appena appena, e la rete dovrebbe imparare un ritocco diverso per ogni taglia.
Per imparare quale formato scegliere e di quanto ritoccarlo, il corniciaio ha bisogno di quadri di prova di cui conosce già la cornice giusta: mette la sua accanto a quella, e corregge la mano. Davanti a un quadro nuovo la cornice giusta non la conosce nessuno: allora la rete ritocca tutte le sue cornici, dicendo per ciascuna quanto è sicura che lì dentro ci sia qualcosa, e alla fine restano solo le più convinte.
Su ogni cella della mappa di feature si centrano \(k\) riquadri predefiniti (le ancore) a più scale e proporzioni. La rete non predice coordinate assolute: per ciascuna ancora produce i punteggi di classe e quattro offset che la deformano verso il riquadro vero,
dove \((x_a, y_a, w_a, h_a)\) sono centro e dimensioni dell’ancora e \((x, y, w, h)\) quelli del riquadro da raggiungere; in addestramento ogni oggetto è assegnato alle ancore che meglio lo ricoprono (la sovrapposizione si misura con la IoU). Quel confronto appartiene al solo addestramento, quando i riquadri veri ci sono: le ancore che ricoprono bene un oggetto diventano positive e imparano classe e offset verso di lui, le altre fanno da sfondo. In inferenza non c’è nessun riquadro vero da ricoprire: la rete produce punteggi e offset per tutte le ancore, ogni ancora deformata dagli offset diventa un candidato, e la IoU ricompare solo alla fine, misurata fra i candidati stessi, per sfoltire i doppioni sullo stesso oggetto. È il meccanismo della Region Proposal Network di Faster R-CNN [RHGS15], che usa \(k=9\) ancore per posizione (3 scale × 3 proporzioni), e di SSD [LAE+16], che le chiama default boxes e le distribuisce su mappe di feature a più risoluzioni, per coprire oggetti piccoli e grandi. Esistono anche rilevatori anchor-free, che predicono direttamente centri e distanze dai bordi senza riquadri di partenza; ma le ancore restano il modo più chiaro per capire come una griglia fissa possa produrre riquadri di ogni forma.
Grandi e piccoli: le piramidi#
Le ancore hanno più taglie, ma da sole non bastano. Per riempire una cornice la rete legge una mappa di feature, la griglia di numeri con cui uno dei suoi strati descrive l’immagine, e una mappa sola non va bene per gli oggetti piccoli e per quelli grandi. Le mappe degli ultimi strati sanno che cosa c’è ma sono sgranate, e un oggetto piccolo ci occupa una cella o meno; quelle dei primi strati hanno il dettaglio ma non il significato. La risposta che si è imposta dal 2017 è una piramide di feature: le mappe dei vari strati, sempre più piccole e messe una sopra l’altra come i piani di una piramide, in cui il significato degli ultimi strati viene riportato fino ai primi.
La bottega ha un problema che le cornici da sole non risolvono: in un quadro il passerotto in fondo al prato è una macchiolina di pochi puntini, il camion in primo piano prende mezza tela. Per decidere le cornici, la rete guarda il quadro con una fila di aiutanti, ciascuno un passo più lontano del precedente. Il primo sta a un palmo dalla tela e distingue ogni filo d’erba, ma ne vede un pezzetto alla volta e non sa che cosa rappresenti; l’ultimo, in fondo alla bottega, vede tutto il quadro e capisce che sul ramo c’è un uccello, ma da così lontano non saprebbe dire dove finisce.
Una soluzione antica è rifare tutto più volte: preparare copie del quadro ingrandite e rimpicciolite, e far guardare ciascuna da capo. Funziona, ma il lavoro cresce con la superficie di tutte le copie messe insieme, e una copia ingrandita al doppio costa da sola quanto quattro.
La piramide di feature costa molto meno, perché la fila fa un giro solo: chi sta più indietro non guarda il quadro da capo, lavora sugli appunti già riassunti da chi gli sta davanti. Poi il significato torna indietro. L’ultimo segna su un foglio di carta lucida, a grandi linee, «qui c’è un uccello»; l’aiutante davanti a lui ingrandisce il foglio fino alla misura dei propri appunti, ce lo posa sopra e lo ripassa con il suo tratto più fine, e così via fino al primo. Alla fine ognuno ha le due cose insieme: il dettaglio del proprio sguardo e il significato portato da chi vedeva l’insieme. E siccome tutti incorniciano seguendo lo stesso manuale, ognuno ricopia i propri appunti sullo stesso formato di foglio.
Ogni oggetto lo incornicia l’aiutante che lo vede della misura giusta, con le cornici adatte a quella misura: il passerotto chi sta vicino alla tela, il camion chi sta in fondo. Resta un limite: un passerotto di due o tre puntini non lo trova nessuno. Per ragioni di spazio nemmeno il primo aiutante si avvicina più di un palmo, e dettagli più fini di così non li vede; e la cornice più piccola della bottega gli sta comunque larga.
Le reti convoluzionali sono già piramidali. In una ResNet l’uscita \(\mathbf{C}_l\) dell’ultimo blocco dello stadio \(l\) ha passo \(2^l\) rispetto all’ingresso, cioè \(4, 8, 16, 32\) pixel per \(l = 2, \dots, 5\), e sempre più canali: meno risoluzione, più semantica. Le soluzioni precedenti sceglievano. Faster R-CNN legge da una mappa sola (\(\mathbf{C}_4\) con una ResNet, passo \(16\)), dove un oggetto di \(32\) pixel occupa due celle per lato. La piramide d’immagine rifà la rete su più ridimensionamenti: il costo è \(\sum_i s_i^2\) volte quello di un passaggio solo (con le scale \(\tfrac12\), \(1\) e \(2\) fa \(5{,}25\)), e addestrarla da capo a fondo non entra in memoria, così la si usa solo in inferenza, incoerente con l’addestramento. SSD predice da mappe a più profondità, ma per non usare quelle troppo deboli parte da strati già alti, e rinuncia proprio alle mappe più fini, che servono agli oggetti piccoli. La Feature Pyramid Network [LDollarG+17] costruisce invece un percorso dall’alto in basso con connessioni laterali, e predice da ogni livello:
con la seconda per \(l = 4, 3, 2\) e la terza per tutti i livelli. Ogni laterale \(\mathrm{conv}^{(l)}_{1\times1}\) ha i suoi pesi, perché i \(\mathbf{C}_l\) hanno numeri di canali diversi, e porta tutti i livelli a \(d = 256\); nessuna di queste convoluzioni ha un’attivazione. \(\mathrm{up}_2\) è il sovracampionamento per due al vicino più prossimo, che combacia con \(\mathbf{C}_l\) quando il lato d’ingresso è multiplo di \(32\) (le implementazioni riempiono l’immagine fino a esserlo), e la \(3\times3\) attenua i blocchi \(2\times2\) che quel sovracampionamento lascia. Ogni \(\mathbf{P}_l\) ha così la risoluzione di \(\mathbf{C}_l\) e la semantica che scende da \(\mathbf{C}_5\), a un costo molto inferiore a quello di una piramide d’immagine, concentrato sul livello più fine. Le teste sono condivise fra i livelli, come in una piramide d’immagine, ed è per questo che tutti vanno portati alla stessa \(d\). La novità rispetto a FCN e U-Net, che hanno anche loro un percorso dall’alto in basso, sta qui: si predice da ogni livello, con le stesse teste.
Nella RPN ogni livello ha ancore di una sola area, \(32^2, 64^2, 128^2, 256^2, 512^2\) pixel su \(\mathbf{P}_2, \dots, \mathbf{P}_6\), in tre proporzioni: tre ancore per posizione su ciascun livello, quindici forme distinte su tutta la piramide. \(\mathbf{P}_6\) sottocampiona \(\mathbf{P}_5\) con passo \(2\) e serve alla sola RPN. Nel secondo stadio una regione di lati \(w\) e \(h\), misurati sull’immagine che entra nella rete, si legge dal livello
troncato a \(l \in \{2, \dots, 5\}\). Il \(\log_2\) viene dal passo \(2^l\), e \(l_0 = 4\) imita il Faster R-CNN che legge da \(\mathbf{C}_4\): una regione con \(\sqrt{wh}\) fra \(224\) (la taglia di ImageNet) e \(448\) va su \(\mathbf{P}_4\), ogni dimezzamento di \(\sqrt{wh}\) scende di un livello, e sul proprio livello ogni regione copre fra \(14\) e \(28\) celle per lato. Il limite sugli oggetti piccoli è doppio. \(\mathbf{P}_2\) ha passo \(4\) (la \(\mathbf{C}_1\) è esclusa per la memoria), e l’ancora più piccola è \(32^2\): un oggetto di \(10 \times 10\) pixel ha con qualunque ancora una IoU di al massimo \(0{,}098\), molto sotto la soglia, e diventa positivo solo per la regola che assegna a ogni oggetto vero la sua ancora migliore.
Quanto è buona una predizione? IoU e mAP#
Un riquadro predetto non è mai esattamente sovrapposto a quello vero, e la misura della sovrapposizione è quella già incontrata fra i compiti della visione: l’Intersection over Union, l’area in comune divisa per l’area coperta in tutto. Qui serve a qualcosa di più, il voto complessivo di un rilevatore.

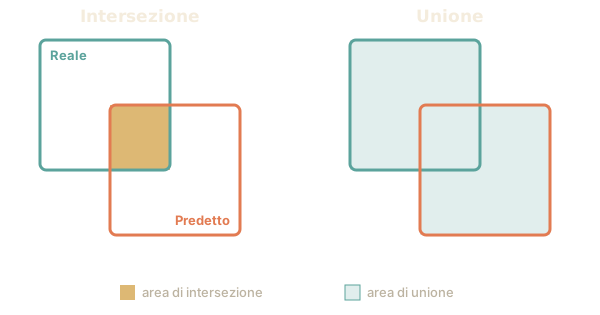
Fig. 11.9 L’Intersection over Union confronta il riquadro predetto (terracotta) con quello reale (teal): è l’area di intersezione divisa per l’area di unione.#
Chi corregge appoggia sulla foto del cane un foglio trasparente con la cornice giusta, e lo confronta con la cornice che il rilevatore ha tracciato (Fig. 11.9). Non combaciano mai. La foto è stampata su carta a quadretti, e allora la somiglianza si misura contando: i quadretti coperti da tutte e due, divisi per quelli coperti da almeno una. Trenta in comune, sessanta in tutto: \(30/60 = 0{,}5\). Il conto si chiama IoU e dà sempre un numero fra 0 e 1, dove 1 vuol dire cornici sovrapposte quadretto per quadretto e 0 cornici che non si toccano nemmeno.
Il correttore deve stabilire a che punto una cornice vale come buona. La regola solita è la metà: da 0,5 in su passa. Quella metà l’ha fissata una convenzione, e sposta i verdetti: portata a 0,7 o a 0,9, la classifica fra due rilevatori può ribaltarsi, perché chi azzecca sempre il nome ma disegna cornici approssimative crolla molto più in fretta di chi le disegna precise.
Mettiamo che in una foto i cani siano tre, e che il rilevatore consegni cinque cornici in fila, dalla più sicura alla meno sicura. Il correttore le prende in quest’ordine. Una cornice passa se copre abbastanza un cane che nessuna cornice precedente si è già presa, e da quel momento quel cane è suo: una seconda cornice sullo stesso animale, per quanto ben piazzata, va nella pila degli errori. Dopo ogni cornice giusta il correttore si ferma e conta quante ne ha viste giuste su quante ne ha guardate. Quella frazione è la precisione.
Diciamo che siano giuste la prima e le ultime due: le fermate sono tre, 1 su 1, cioè 1; poi 2 su 4, cioè 0,50; poi 3 su 5, cioè 0,60. I tre numeri ballano, perché ogni cornice sbagliata li tira giù e la giusta che viene dopo li rialza, su e giù come i denti di una sega. Prima di sommarli il correttore li appiattisce: al posto del numero di quel momento prende il più alto fra quello e tutti quelli che vengono dopo. I tre diventano 1, 0,60 e 0,60. È la precisione migliore che troverebbe accettando di andare un po’ più avanti nella fila, fino a una cornice giusta successiva. E rende il voto meno capriccioso: se due cornici quasi ugualmente sicure si scambiano di posto, i denti della sega si spostano, mentre il più alto fra adesso e dopo spesso resta dov’era. Spesso, non sempre: se si scambiassero le prime due cornici, la prima fermata cadrebbe a 1 su 2, e appiattita varrebbe 0,60 invece di 1.
La somma fa 2,20, e si divide per tre, cioè per i cani che c’erano davvero, non per le cinque cornici disegnate: 0,73. Un cane che nessuna cornice avesse cerchiato non aggiungerebbe niente alla somma e resterebbe comunque nel divisore. Chi disegna una cornice sola, la più sicura di tutte, tiene la precisione altissima e porta a casa un voto basso; chi ne disegna mille li cerchia tutti e tre e paga a ogni fermata gli errori che ha lasciato dietro. Quel 0,73 è il voto sui cani, e si chiama Average Precision (AP), precisione media: è già una media, fatta sui cani veri. Non tutti i correttori, però, si fermano dove si ferma lui: c’è chi guarda la fila in undici punti fissati prima, e chi in centouno, e due voti contati con regole diverse non si mettono a confronto.
Poi si rifà tutto sulle auto, sui semafori, sulle biciclette, e si fa la media dei voti delle varie categorie: è la «m» di mean della mAP, la media delle AP. Ne esce un numero fra 0 e 1: più è alto, più spesso il rilevatore azzecca insieme la cornice e il nome. Nelle gare serie il correttore rifà poi l’intero conto con dieci soglie, da 0,5 a 0,95, e fa la media delle dieci mAP: nessuno si presenta col metro tagliato su misura.
Dati il riquadro predetto \(A\) e quello reale \(B\), la IoU è
Fissata una soglia (ad esempio \(\text{IoU} \ge 0{,}5\)), le predizioni si scorrono in ordine di confidenza decrescente: una predizione è un vero positivo se supera la soglia con un oggetto reale non ancora assegnato, e quell’oggetto viene «consumato». Ogni oggetto reale si accoppia cioè a una sola predizione, e i duplicati, per quanto ben sovrapposti, contano come falsi positivi. Da qui si costruisce la curva precision–recall per ciascuna classe: l’area sotto la sua interpolata (l’inviluppo monotono decrescente, campionato a 11 punti di recall nel VOC fino al 2009, a tutti i cambi di recall dal 2010, a 101 punti in COCO) è l’Average Precision (AP). La curva grezza è a denti di sega, e basta che due predizioni di confidenza quasi uguale si scambino di posto perché i denti si spostino. L’inviluppo, che a ogni recall prende la precisione migliore ottenibile a recall uguale o maggiore, ne attenua l’effetto [EVGW+10]: uno scambio che non tocca quel massimo non sposta niente, uno che lo tocca sposta l’AP come prima. Le convenzioni di campionamento restano però diverse, e un AP a 11 punti non si confronta con uno a 101. La mean Average Precision (mAP) ne fa la media sulle classi. Il benchmark COCO irrigidisce la metrica mediando la mAP su dieci soglie di IoU, da \(0{,}5\) a \(0{,}95\) a passi di \(0{,}05\): premia i modelli che localizzano con precisione, non solo che indovinano la classe. Per la stessa ragione, la scelta di una soglia sola pesa sulla classifica. Alzandola, una predizione che indovina la classe con un riquadro approssimativo, accettata a \(0{,}5\), diventa un falso positivo e lascia il suo oggetto senza abbinamento; chi produce riquadri così perde AP più in fretta di chi localizza con precisione, e due rilevatori possono scambiarsi di posto, il primo avanti in \(\text{AP}_{50}\), il secondo in \(\text{AP}_{75}\) (l’AP alle soglie \(0{,}5\) e \(0{,}75\)).
Le predizioni che arrivano a questo conto, però, sono già state ripulite. La rete non produce un riquadro per oggetto: ne produce migliaia. In ogni punto della griglia tiene pronte le sue cornici di partenza, e i punti della griglia sono a loro volta migliaia. Il risultato è che attorno a ogni oggetto se ne accumulano decine quasi identiche, ciascuna con la sua confidenza, cioè il numero da 0 a 1 con cui la rete dichiara quanto è sicura che lì dentro un oggetto ci sia davvero.
La non-maximum suppression (alla lettera «soppressione di ciò che non è il massimo», e in genere la si chiama NMS) le sfoltisce con una regola semplice, una classe alla volta: si ordinano i riquadri per confidenza, si tiene il più sicuro e si scartano tutti quelli che gli si sovrappongono oltre una soglia di IoU fissata in partenza (di solito fra 0,3 e 0,7), poi si ripete sui rimasti finché non c’è più niente da esaminare. Siccome ogni riquadro tenuto si confronta con tutti quelli rimasti, nel caso peggiore il lavoro cresce col quadrato del numero di riquadri. È il passo finale, quasi mai disegnato negli schemi, di praticamente ogni rilevatore delle due famiglie: senza, ogni oggetto arriverebbe alla valutazione con un grappolo di doppioni, e tutti tranne uno conterebbero come errori.
Il suo punto debole sono le folle. Due persone vere, una un po’ dietro l’altra, hanno riquadri molto sovrapposti, e la regola cancella la meno sicura come se fosse un doppione. La Soft-NMS, invece di scartare, abbassa la confidenza dei riquadri sovrapposti tanto più quanto più si sovrappongono, e una persona vera parzialmente coperta ha così ancora una possibilità [BSCD17].
C’è però una terza via, che il problema lo toglie invece di risolverlo. Una famiglia di rilevatori inaugurata nel 2020 da DETR [CMS+20] (sta per detection transformer) chiede alla rete un numero fisso di risposte, per esempio cento, e durante l’addestramento le abbina agli oggetti veri una a una, come si assegnano i posti a tavola: ogni oggetto vero riceve una risposta sola, nessuna risposta serve due oggetti, e fra tutte le assegnazioni possibili si sceglie quella che nel complesso sbaglia meno. Il costo di una coppia premia la probabilità che la risposta dà alla classe giusta e punisce la distanza fra i due riquadri. In gergo è un abbinamento bipartito, e l’algoritmo ungherese lo trova senza provare tutte le combinazioni, con un lavoro che cresce come il cubo del numero di risposte. Gli oggetti veri si completano con «nessun oggetto» fino a cento, e tutte le risposte rimaste sono premiate per dire «qui non c’è niente». Chi produce un doppione viene quindi punito mentre impara, non ripulito dopo, e alla fine dell’addestramento i doppioni non li produce più. Spariscono così sia le cornici di partenza sia la fase di pulizia. Il prezzo è stato un addestramento molto più lungo (500 epoche, contro le 109 del rilevatore a due stadi di riferimento, Faster R-CNN, che il lavoro riallena per un confronto alla pari, e le 36 della sua versione di serie) e risultati peggiori sugli oggetti piccoli.
La famiglia YOLO: le impalcature tolte una alla volta#
Dieci anni di rilevamento si possono ripassare seguendo una famiglia sola. Il primo YOLO [RDGF16] aveva la griglia e nient’altro: niente ancore, una passata sola, riquadri grossolani e gli oggetti piccoli persi quando si affollano nella stessa cella. Le versioni successive adottano, uno per uno, gli attrezzi del mestiere. YOLOv2 [RF17] porta dentro le ancore, e invece di disegnarle a mano le ricava dai dati, raggruppando i riquadri veri del dataset per trovare le forme che ricorrono davvero. YOLOv3 [RF18] predice su tre griglie a risoluzione diversa, così anche l’oggetto piccolo trova una griglia abbastanza fitta da vederlo, e al posto della softmax mette tanti classificatori indipendenti, uno per classe, perché la stessa figura può essere insieme «persona» e «pedone».
Poi la famiglia si divide, e il filo da tenere è uno: le due impalcature del mestiere, le ancore e la pulizia dei doppioni, la famiglia le ha prima adottate e poi tolte tutte e due. Dal 2020 il nome lo portano due linee parallele. Da una parte ci sono articoli di gruppi di ricerca (YOLOv4 nel 2020 e YOLOv7 nel 2022, degli stessi autori, e YOLOv10 nel 2024); dall’altra il software della società Ultralytics [JQ26], la cui storia si legge soprattutto nei registri delle versioni: YOLOv5, una libreria PyTorch, non ha mai avuto un articolo scientifico, e quello di YOLO26 è uscito mesi dopo il software [JQL+26]. YOLOv8, nel 2023, toglie le ancore, predicendo direttamente centro e distanze dai bordi, come i rilevatori detti anchor-free. YOLO26, all’inizio del 2026, toglie anche la NMS: punisce i doppioni durante l’addestramento con la stessa idea dell’abbinamento uno a uno di DETR, che nella famiglia era entrata con YOLOv10, un lavoro dell’Università Tsinghua, e quello che la rete produce è già il risultato finale. Restano la griglia, la passata unica e il nome.
Provare l’ultima versione costa cinque righe. La libreria si installa con
pip install ultralytics, scarica i pesi alla prima esecuzione e porta con sé
una foto di prova: un minibus elettrico e, sul marciapiede, quattro figure, due
intere e due tagliate dai bordi della foto.
# pip install ultralytics; alla prima esecuzione scarica 5 MB di pesi.
from ultralytics import YOLO, ASSETS

modello = YOLO("yolo26n.pt")            # "n" come nano, la taglia più piccola
[esito] = modello(ASSETS / "bus.jpg", verbose=False)
for riquadro in esito.boxes:
    nome = esito.names[int(riquadro.cls)]
    print(f"{nome:10s} confidenza {float(riquadro.conf):.2f}")
bus        confidenza 0.92
person     confidenza 0.91
person     confidenza 0.91
person     confidenza 0.87
person     confidenza 0.53
Cinque oggetti, nessuna pulizia dopo: i riquadri escono così dalla rete. Le due persone intere valgono 0,91; quella di schiena sul bordo destro 0,87; e la 0,53 è la figura di cui la foto mostra soltanto una spalla, sul bordo sinistro: mezza persona, mezzo sì. I pesi stanno sul server di chi pubblica il modello, e se un giorno li riaddestrano le cifre esatte possono cambiare, mentre la lettura resta la stessa, con la confidenza che cala dove calerebbe la nostra.
Segmentare: dal riquadro alla sagoma#
Il riquadro è comodo ma grossolano: attorno a un pedone c’è sempre un rettangolo pieno di sfondo. Quando serve il contorno esatto, pixel per pixel, si passa alla segmentazione. Qui vanno distinte due varianti.
Prima, però, una forma che molte reti di segmentazione condividono: un ramo che riassume l’immagine e uno che la ricostruisce, e la più nota si chiama U-Net [RFB15] perché sullo schema disegna una U. Il problema da risolvere è questo: per capire che cosa c’è in una zona bisogna allontanarsi dai pixel e guardare largo, mentre per disegnarne il contorno esatto bisogna starci attaccati. Sono due esigenze opposte, e la U-Net non sceglie. Prima scende, rimpicciolendo l’immagine e capendo sempre meglio che cosa c’è; poi risale, tornando alla risoluzione di partenza per dire dove; e a ogni gradino della risalita si fa ripassare quello che aveva visto allo stesso gradino durante la discesa. Sono le connessioni orizzontali della figura, le skip connection: senza di quelle, il contorno tornerebbe su sfocato.

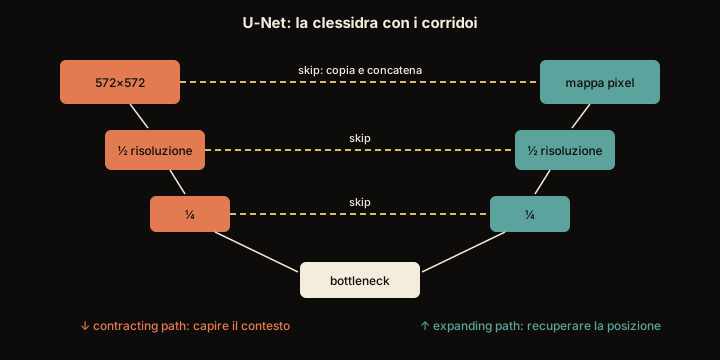
Fig. 11.10 La clessidra della U-Net. Scendendo si capisce cosa c’è nell’immagine e si perde dove; le connessioni orizzontali riportano il «dove» dal ramo di discesa a quello di risalita.#
In Fig. 11.10 le skip connection sono le linee tratteggiate: la rete fa le due cose incompatibili su due rami, e a ogni livello li ricuce.
La segmentazione semantica colora ogni pixel dell’immagine con la sua categoria: tutti i pixel di «strada» di un colore, quelli di «cielo» di un altro, quelli di «persona» di un terzo. Non distingue però i singoli individui: due pedoni vicini diventano un’unica macchia «persona».
La segmentazione di istanza fa un passo in più: separa anche gli individui. Pedone-1 e pedone-2 ricevono maschere distinte. È come colorare dentro le linee, ma tenendo ogni personaggio con la sua tinta.
Il modo più diffuso di ottenerla riusa il rilevatore. Prima si cerchia ogni pedone con la sua cornice, come per il rilevamento; poi, dentro ogni cornice e soltanto lì, si decide pixel per pixel chi è pedone e chi è marciapiede rimasto dentro il rettangolo. Le cornici tengono separati gli individui, la colorazione rifinisce la sagoma, e siccome ogni cornice arriva già con il suo nome, di ciascun pedone escono insieme cornice, nome e contorno.
La segmentazione semantica assegna a ogni pixel una classe. La svolta è la Fully Convolutional Network [LSD15], che sostituisce gli strati densi finali con convoluzioni e upsampling per produrre una mappa di classi a piena risoluzione, e che già introduce le skip connections: la sua sezione «Combining what and where» fonde la predizione grossolana con gli strati a stride più fine (sono le varianti FCN-16s e FCN-8s, che dal modello base si distinguono solo per quante skip hanno). U-Net [RFB15], nata per l’imaging biomedico e dello stesso anno, ne generalizza la forma: un decoder simmetrico che a ogni livello concatena l’intera mappa di feature dell’encoder, invece di sommare due mappe di punteggi di classe a due soli livelli.
La segmentazione di istanza unisce detection e maschere: Mask R-CNN [HGDollarG17] estende Faster R-CNN con un terzo ramo che, per ciascuna regione, predice una maschera binaria \(28 \times 28\) per ogni classe, con una sigmoide per pixel invece di una softmax fra classi. Solo la maschera della classe vera riceve gradiente, così le classi non competono pixel per pixel; e le feature della regione si estraggono con RoIAlign, che campiona la mappa per interpolazione bilineare invece di arrotondare le coordinate della regione alla griglia, che farebbe scivolare la maschera di frazioni di cella. Ottiene così, insieme, riquadro, classe e sagoma di ogni singola istanza. Sotto, come backbone, una ResNet (o una ResNeXt) con la piramide di feature, che nel confronto del lavoro supera la lettura dalla sola \(\mathbf{C}_4\) sia in accuratezza sia in velocità.
Le metriche seguono. Per la semantica la IoU si calcola per classe, sui pixel di tutto il dataset, \(\mathrm{IoU}_k = \mathrm{TP}_k / (\mathrm{TP}_k + \mathrm{FP}_k + \mathrm{FN}_k)\), e la mIoU ne fa la media sulle \(K\) classi. In ambito medico si preferisce il coefficiente di Dice,
che è la F1 calcolata sui pixel e, maschera per maschera, ordina le predizioni come la IoU (le medie invece possono invertirsi); la sua versione continua, con le probabilità al posto delle maschere binarie, si usa anche come loss, perché non si lascia sommergere dai moltissimi pixel di sfondo quando la lesione ne occupa pochi. Per l’istanza si riusa la mAP, con la IoU fra maschere al posto di quella fra riquadri.
Le due varianti si possono anche fondere in un compito solo, la segmentazione panottica [KHG+19]. Ogni pixel riceve una categoria, come nella semantica; i pixel delle cose che si contano (i pedoni, le automobili) ricevono in più il numero dell’individuo a cui appartengono, come nell’istanza, mentre quelli delle cose che non si contano (la strada, il cielo) restano una macchia unica. In inglese le due famiglie si chiamano things e stuff, e la misura che le valuta insieme, la panoptic quality, mette in un numero solo quanto sono giuste le sagome e quanti individui sono stati trovati.
Risalire di risoluzione: la convoluzione trasposta#
Nelle reti di segmentazione c’è un passaggio rimasto nell’ombra. Le convoluzioni e il pooling (il passaggio che riassume ogni quadratino di griglia in un numero solo) riducono le mappe, cioè le griglie di numeri che ogni strato consegna al successivo: dopo il ramo discendente della U, quello che comprime, un’immagine 512×512 può essersi ristretta a 16×16. Quel ramo ha un nome, encoder, e vuol dire «la parte che riassume»: è lo stesso mestiere che nella sezione sull’apprendimento senza etichette riassumeva un’immagine in una lista di numeri, solo che qui il riassunto è una griglia piccola. Ma il verdetto della segmentazione va dato pixel per pixel, alla risoluzione di partenza: serve una seconda metà che riespanda, e quella si chiama decoder. Come si risale? L’operazione che la Fully Convolutional Network [LSD15] ha reso standard è la convoluzione trasposta: una convoluzione che invece di rimpicciolire ingrandisce, con numeri che la rete impara.

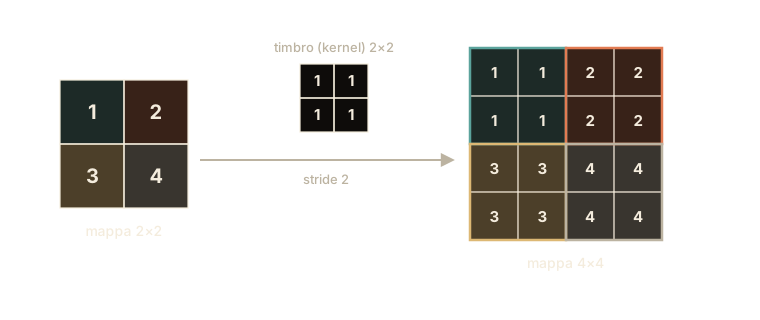
Fig. 11.11 Convoluzione trasposta con un kernel \(2 \times 2\) di tutti 1, applicato ogni due caselle: ogni valore della mappa piccola «timbra» un blocco \(2 \times 2\) della mappa grande.#
Una mappa piccola, \(2 \times 2\), con quattro numeri:
e un timbro, anch’esso \(2 \times 2\), con il disegno più semplice possibile: tutti 1. La convoluzione trasposta è una timbratura: ogni numero della mappa piccola dà un colpo di timbro su una tela più grande, e il valore del numero regola la forza della pressione. Quanto si sposta il timbro fra un colpo e l’altro lo decidiamo noi, e si chiama passo. Con passo 2, cioè spostandolo di due caselle ogni volta, i quattro colpi cadono uno accanto all’altro senza sovrapporsi, e la tela diventa \(4 \times 4\) (Fig. 11.11):
L’1 ha stampato un blocchetto di 1, il 4 un blocchetto di 4. Con passo 1, invece, i colpi si sarebbero sovrapposti e nelle caselle condivise i valori si sarebbero sommati; con un timbro di due caselle, però, ogni casella interna ne riceve lo stesso numero, e solo il bordo ne riceve meno. Il guaio arriva quando il timbro non copre un numero intero di passi, per esempio un timbro di tre caselle spostato ogni volta di due: allora una casella riceve due colpi e la vicina uno solo, alternandosi, e nell’immagine finale compare una trama regolare a quadretti che nella scena non c’era.
C’è poi una cosa che la timbratura non può sapere. La mappa \(2 \times 2\) di partenza l’ha prodotta la discesa, che aveva riassunto una tela più grande prendendone le caselle a due a due. Ma una tela di quattro caselle di lato e una di cinque si riducono tutte e due a quella stessa mappa: della quinta casella, spaiata, la discesa non sa che fare e la lascia fuori. Il riassunto non ricorda da quale delle due veniva, e timbrando si risale sempre alla più piccola. Chi mette in fila una discesa e una risalita si ritrova per questo, ogni tanto, le due metà della clessidra sfalsate di una casella, e deve dire a mano quale delle due taglie voleva.
Con questo timbro banale abbiamo solo ingrandito la mappa; il punto è che i numeri sul timbro non sono fissi, la rete li impara. Può scoprire timbri che sfumano i bordi e ricostruiscono i dettagli molto meglio di un semplice zoom. Può però anche fare il contrario, e imparare timbri che la trama a quadretti la disegnano da soli, anche quando i colpi cadono ordinati e ogni casella ne riceve lo stesso numero. Sistemare il passo, quindi, non mette al riparo, e molte reti recenti scelgono una via più prudente: ingrandire la mappa in un modo fisso, ricopiando ogni casella o sfumando fra una casella e la vicina, e passarci sopra una convoluzione ordinaria, di quelle che non ingrandiscono.
La forma dell’output segue una formula chiusa:
dove \(i\) è il lato della mappa in ingresso, \(k\) quello del kernel, \(s\) lo
stride e \(p\) il padding. Nell’esempio della figura \(i=2\), \(k=2\), \(s=2\),
\(p=0\), quindi \(o = 2 \cdot 1 + 2 - 0 = 4\). La formula assume dilatazione 1 e
output_padding nullo, e quel parametro esiste per una ragione precisa: la
convoluzione diretta manda taglie di ingresso diverse nella stessa uscita (con
\(k=3\), \(s=2\), \(p=1\) sia un \(7\) sia un \(8\) diventano \(4\)), quindi la risalita
non è univoca e la formula dà solo la più piccola delle partenze possibili. Chi
la applica a una U-Net vera e si ritrova le due metà della clessidra disallineate
di un pixel ha appena scoperto questo effetto. Il nome viene dall’algebra: se si
srotola l’input in un vettore, una convoluzione è la moltiplicazione per una
matrice sparsa \(\mathbf{C}\); la trasposta moltiplica per \(\mathbf{C}^\top\), che
riporta il
vettore alla dimensione di partenza. È la stessa operazione con cui la
backpropagation propaga il gradiente attraverso uno strato convoluzionale: il
forward della trasposta è il backward della convoluzione. Per questo il
vecchio nome «deconvoluzione» è fuorviante: non inverte la convoluzione, ne
inverte solo la geometria. In PyTorch è nn.ConvTranspose2d.
Una nota onesta: quando \(k\) non è multiplo di \(s\), i colpi di timbro si sovrappongono in modo disomogeneo e l’output mostra i tipici artefatti a scacchiera [ODO16]. Verrebbe da concludere che basti scegliere \(k\) multiplo di \(s\), ed è proprio la conclusione che la fonte citata smentisce: la scelta toglie la disomogeneità geometrica ma non gli artefatti, perché una rete impara volentieri kernel che li producono anche a sovrapposizione uniforme. È per questo, e non per la sola divisibilità, che molte architetture recenti preferiscono un upsampling fisso (bilineare o nearest-neighbor) seguito da una convoluzione ordinaria.
Dove serve davvero#
Nella guida autonoma, detection e segmentazione insieme dicono al veicolo dove sono i pedoni e dove finisce la carreggiata. Nell’imaging medico, U-Net e derivati delimitano un nodulo (un piccolo addensamento di tessuto, che può essere un tumore) o un organo su una TAC, la radiografia che ricostruisce il corpo a fette, e ne misurano il volume con una precisione che a occhio si perderebbe. Nell’industria, un rilevatore su una linea di produzione individua il graffio o il pezzo mal assemblato prima che arrivi al cliente.
Nessuno di questi sistemi è infallibile, e il margine di errore va comunicato con precisione, perché la sovrapposizione non conta gli errori: dice quanto una maschera combacia con quella vera. Una maschera con IoU \(0{,}9\) è una maschera buona, e vuol dire che di dieci quadretti coperti in tutto, nove sono in comune e uno no: un decimo dell’area cade nel posto sbagliato, per eccesso o per difetto. Su un nodulo quel decimo può anche non cambiare il volume misurato, perché la parte in più e quella in meno si compensano; a spostarsi è il contorno, che in qualche punto entra nel tessuto sano e in qualche altro lascia fuori del tumore.
E soprattutto restano gli oggetti mancati del tutto. La IoU si calcola fra due cornici, quella vera e quella disegnata, quindi per un pedone che il rilevatore non ha visto non c’è nessuna coppia da confrontare, e una media delle IoU sulle sole coppie trovate non peggiora di niente. Lo vedono invece le misure che contano anche gli assenti: la mAP, che divide per gli oggetti veri, e la IoU per classe della segmentazione, dove i pixel di un nodulo mancato entrano nell’unione e abbassano il voto. In medicina o alla guida sono le due cose insieme, il contorno approssimato e l’oggetto non visto, a chiedere un occhio umano.
Resta una domanda che nessuno di questi strumenti si pone: a quanti metri sta l’oggetto. Il riquadro e la maschera stanno nel piano della foto, e la distanza si ricostruisce con altri mezzi, quelli della sezione su geometria e profondità.
Da ricordare
Il rilevamento non dice solo che cosa c’è in una foto: per ogni oggetto disegna una cornice e ci scrive accanto il nome.
Due modi di farlo: in due tempi (prima si segnano le zone sospette, poi si guarda con calma dentro ognuna) o in un colpo solo (una passata sola sull’immagine sputa fuori cornici e nomi). Il primo è nato più preciso, il secondo abbastanza rapido da stare dietro a un video; poi è cambiato il modo di correggere e in precisione si sono quasi raggiunti, così che a separarli resta soprattutto la velocità.
Nessuno disegna le cornici dal nulla: come un corniciaio, la rete tiene pronti alcuni formati standard in ogni punto dell’immagine e si limita a ritoccare quello che ci va più vicino.
Gli oggetti piccoli e quelli grandi li trovano strati diversi: la rete guarda il quadro una volta sola, con una fila di aiutanti a distanze crescenti, e chi vede l’insieme passa all’indietro, su carta lucida, quello che ha capito. Un oggetto di pochi puntini resta comunque fuori.
Per dire quanto una cornice ci ha preso si guarda quanto si sovrappone a quella giusta: area in comune divisa per area totale, da 0 a 1. Il voto complessivo di un rilevatore si ottiene calcolando un voto per ogni categoria e poi facendone la media.
Attorno a ogni oggetto la rete produce decine di cornici quasi uguali: prima del verdetto si tiene la più sicura e si buttano quelle che le si sovrappongono troppo, altrimenti i doppioni conterebbero tutti come errori. Nelle folle, però, così si rischia di buttare una persona vera.
Quando la cornice non basta e serve la sagoma esatta si passa alla segmentazione: colorare ogni pixel con la sua categoria, o addirittura distinguere un pedone dall’altro. La forma tipica è la U: si scende per capire che cosa c’è, si risale per dire dove, e a ogni gradino della risalita si ripassa quello che si era visto scendendo. Le due colorazioni insieme, una tinta per categoria e una per ogni individuo, si chiamano segmentazione panottica.
Nessuno di questi sistemi è infallibile, e il margine è di due tipi: contorni approssimati, e oggetti mancati del tutto (che nella sovrapposizione di una coppia non compaiono, e che il voto complessivo invece conta, perché divide per gli oggetti veri).
Da ricordare
L’object detection predice per ogni oggetto un riquadro e una classe insieme.
Due famiglie: due stadi (R-CNN, Faster R-CNN) storicamente più accurate, uno stadio (YOLO, SSD) più veloci; la focal loss ha in gran parte sanato lo squilibrio oggetto/sfondo che costava quel divario, lasciando la velocità come differenza principale. E una terza via, i rilevatori a predizione di insieme (DETR), che abbinano una a una le risposte della rete agli oggetti veri (due insiemi distinti, e per questo l’abbinamento si dice bipartito) ed eliminano per costruzione sia le ancore sia l’NMS.
Le anchor box danno alla rete riquadri di partenza a più scale e proporzioni: si predicono piccoli offset, non riquadri dal nulla.
La FPN ricava dai \(\mathbf{C}_l\) della rete una piramide \(\mathbf{P}_2, \dots, \mathbf{P}_6\) con un percorso dall’alto in basso e connessioni laterali, tutta a \(d = 256\) canali perché le teste sono condivise; ogni regione si legge dal livello adatto alla sua taglia, \(l = \lfloor 4 + \log_2(\sqrt{wh}/224)\rfloor\) troncato a \(\{2, \dots, 5\}\).
La IoU misura la sovrapposizione riquadro-realtà, non un tasso di errore; la mAP (mean Average Precision) riassume in un numero solo la qualità complessiva del rilevatore, e nel farlo accoppia ogni oggetto a una sola predizione: i doppioni contano come errori.
Prima della valutazione la non-maximum suppression sfoltisce i doppioni: si tiene il riquadro più confidente e si scartano quelli sovrapposti oltre una soglia di IoU, a un costo quadratico nel caso peggiore; nelle scene affollate sopprime anche oggetti veri, e la Soft-NMS ne abbassa la confidenza invece di scartarli.
Semantica (FCN, U-Net) etichetta ogni pixel; istanza (Mask R-CNN) separa anche i singoli oggetti. Le skip connection fra encoder e decoder nascono con la FCN; la U-Net ne generalizza la forma concatenando a ogni livello. La segmentazione panottica unisce le due in un compito solo (things contati per istanza, stuff per sola classe).
La convoluzione trasposta riporta le mappe a piena risoluzione con un ingrandimento appreso: occhio agli artefatti a scacchiera (le griglie regolari che compaiono nell’uscita), che la sola divisibilità fra kernel e stride non basta a evitare.