


Dai sistemi dinamici a S4#
Nel 1960 l’ingegnere ungherese-americano Rudolf Kálmán pubblicò la formulazione che l’ingegneria avrebbe adottato per descrivere un sistema che evolve nel tempo: poche variabili che non si osservano direttamente, lo stato, che riassumono ciò che del passato serve a prevedere il futuro, e una sua misura, disturbata da errori (rumorosa, si dice). È la rappresentazione in spazio degli stati. Il filtro che porta il suo nome, quello delle capsule Apollo [MS85], stima lo stato (per un veicolo, posizione e velocità) da quelle misure rumorose; il ciclo di previsione e correzione su cui si regge l’avevano scritto anche altri prima di lui, come racconta la sezione sui modelli classici delle serie temporali. È un’idea di teoria del controllo e di elaborazione dei segnali, lontana dal linguaggio naturale.
Mezzo secolo dopo, la stessa idea ha dato una seconda strada verso l’obiettivo del capitolo sull’attenzione lineare: un modello di sequenze che si addestra in parallelo come un Transformer e che, in generazione, spende per ogni parola sempre lo stesso tempo e la stessa memoria, come una rete ricorrente. Là si partiva dall’attenzione e se ne toglieva il pezzo più costoso, fino a una memoria di taglia fissa aggiornata parola per parola; qui si parte da un sistema dinamico continuo e si arriva a una macchina dello stesso tipo. La sezione sulla dualità dirà in che punto le due strade si incontrano.
Un sistema che evolve nel tempo#
Il sistema di partenza è lineare, a tempo continuo e con un solo ingresso: un segnale \(u(t)\) entra, uno stato \(\mathbf{h}(t)\) lo riassume istante per istante, un segnale \(y(t)\) esce. Lo descrivono due equazioni. La prima lega lo stato alla sua velocità di variazione, cioè alla derivata incontrata nella sezione su analisi e ottimizzazione: dice quanto in fretta lo stato cambia, dati lo stato e l’ingresso di adesso. Un’equazione che lega una grandezza alla propria derivata si chiama equazione differenziale. La seconda non ha derivate, e ricava l’uscita dallo stato. Dentro le due equazioni lavorano tre matrici, che sono le tre regole del sistema: come lo stato evolve da solo, come l’ingresso vi entra, come se ne legge l’uscita.
La vasca dei due litri al minuto ha già tutti i pezzi. Il livello dell’acqua è lo stato: riassume tutta la storia di quanto hai aperto il rubinetto, senza bisogno di ricordarla minuto per minuto. Il rubinetto è l’ingresso, lo scarico la dinamica interna (se smetti di versare, il livello cala da solo, un po’ alla volta), l’ago l’uscita, che dipende dal livello. Un secondo ago, attaccato direttamente alla manopola del rubinetto, direbbe quanto è aperta in questo istante, senza memoria e senza ritardo: è una scorciatoia dall’ingresso alla lettura, e si tiene da parte, perché la parte interessante è quella che passa per la vasca.
Quanto in fretta il livello scende, a rubinetto chiuso, dipende da quanto è aperto lo scarico: largo, e la vasca dimentica in un minuto; stretto, e si ricorda per un’ora; tappato, e non dimentica più niente, perché tutta l’acqua che hai versato resta lì. E la vasca non cala soltanto: spingi l’acqua verso un capo e per qualche secondo ondeggia avanti e indietro prima di quietarsi. Ci sono poi sistemi che crescono da soli, come il microfono avvicinato troppo alla cassa che lo amplifica: il fischio si alza da sé finché qualcuno non lo allontana. Calare, ondeggiare o crescere è quello che un sistema del genere fa quando lo lasci in pace, e a deciderlo è la sua regola interna, non chi lo alimenta.
Un’eco in una valle funziona allo stesso modo: gridi (ingresso), il suono rimbomba e si spegne gradualmente (stato che decade), e quello che senti è una versione attenuata e ritardata del grido (uscita). In tutti questi casi lo stato è una fotografia compatta del passato: sapendo il livello dell’acqua adesso e cosa farai col rubinetto da adesso in poi, sai prevedere il futuro senza riavvolgere tutta la storia.
Un sistema lineare a tempo continuo, a ingresso e uscita scalari, si scrive
dove \(u(t)\in\mathbb{R}\) è l’ingresso, \(y(t)\in\mathbb{R}\) l’uscita e \(\mathbf{h}(t)\in\mathbb{R}^{N}\) lo stato interno di dimensione \(N\). Le tre matrici hanno ruoli distinti: \(\mathbf{A}\in\mathbb{R}^{N\times N}\) è la dinamica interna, governa come lo stato evolve da solo, in assenza di ingresso (gli autovalori di \(\mathbf{A}\) decidono se lo stato decade, oscilla o esplode); \(\mathbf{B}\in\mathbb{R}^{N\times 1}\) è la matrice d’ingresso, dice come il segnale in arrivo si scrive nello stato; \(\mathbf{C}\in\mathbb{R}^{1\times N}\) è la matrice d’uscita, legge lo stato e produce il segnale in uscita. Il termine \(D\,u(t)\) è una scorciatoia diretta dall’ingresso all’uscita, una skip connection: nei modelli che vedremo lo si tiene a parte (equivale a un residuo) e ci si concentra sulla parte con memoria, ponendo spesso \(D=0\) nella derivazione.
Questa è la rappresentazione in spazio degli stati della teoria del controllo: lo stato \(\mathbf{h}(t)\) è, per costruzione, una statistica sufficiente del passato. La derivata \(\mathbf{h}'(t)\) dice come lo stato cambia istante per istante, spinto in parte dalla dinamica propria (\(\mathbf{A}\,\mathbf{h}\), che con autovalori a parte reale negativa lo riporta verso lo zero) e in parte dal mondo esterno (\(\mathbf{B}\,u\)).
Una parola sulla notazione, perché qui si incrociano due tradizioni che danno alle stesse cose lettere diverse, e chi arriva dall’una legge male le formule dell’altra. Il controllo chiama \(\mathbf{x}\) lo stato e \(u\) l’ingresso, ed è la convenzione con cui S4 ([GGRe22]) scrive ancora il suo sistema: \(\mathbf{x}'(t) = \mathbf{A}\,\mathbf{x}(t) + \mathbf{B}\,u(t)\). La letteratura che tratta gli SSM come strati di rete neurale la ribalta e chiama \(\mathbf{h}\) lo stato, \(x\) l’ingresso: lo fa Mamba ([GD24]), con \(\mathbf{h}'(t) = \mathbf{A}\,\mathbf{h}(t) + \mathbf{B}\,x(t)\), ed è la forma che il campo ha adottato. Non è una questione di gusto: dentro una rete la lettera \(x\) è già presa dal dato che entra nello strato, e in un SSM quel dato è esattamente l’ingresso della ricorrenza, così che uno stato di nome \(x\) finirebbe a dividere la lettera con il proprio ingresso nella stessa equazione. Il libro segue la seconda convenzione, che è anche quella con cui \(\mathbf{h}\) indica lo stato nascosto fin dalle reti ricorrenti. L’unico residuo della prima è la \(u(t)\) del sistema a tempo continuo: appena discretizzeremo, con l’ingresso diventato una sequenza di campioni, prenderà il nome di \(x_t\).
Finora tutto è continuo: il tempo scorre senza gradini. Ma una frase è una sequenza di token (i pezzetti in cui il testo viene diviso, i «passi» di cui parlavamo), un segnale audio è una sequenza di campioni: dati discreti, uno dopo l’altro. Per usare questo sistema su una sequenza dobbiamo prima tradurlo dal continuo al discreto.
Dal continuo al discreto#
Il passaggio si chiama discretizzazione: al posto di seguire il cambiamento istante per istante, si va avanti a salti, di lunghezza fissa. Chiamiamo \(\Delta\) la durata di un salto (il tempo che passa tra una misura e la successiva) e riscriviamo il sistema in modo che vada di stato in stato, invece di scivolare con continuità.
Non esiste un solo modo di discretizzare. Quello che succede tra una misura e l’altra non si osserva, e ogni regola lo ricostruisce con un’ipotesi diversa; S4 e Mamba ne usano due diverse, che non vanno scambiate. S4 usa la trasformazione bilineare, che stima con la regola del trapezio quanto lo stato cala da solo durante il salto. Mamba usa lo zero-order hold (in sigla ZOH), che tiene l’ingresso fermo per tutto il salto e quel calo lo calcola esattamente.
Discretizzare è come campionare un segnale continuo: invece di seguire l’acqua della vasca in ogni istante, ne misuri il livello a intervalli regolari e ti chiedi come passare da una misura alla successiva. Ogni misura è un passo della sequenza (per un testo, una parola), e fra un passo e il successivo passano \(\Delta\) secondi. Le parole di un testo, però, non hanno secondi: per loro \(\Delta\) è un numero che il modello sceglie, e dice quanta storia della vasca far passare fra una parola e la successiva. Con \(\Delta\) piccolo, fra un passo e l’altro lo scarico porta via poco e la memoria si allunga; con \(\Delta\) grande, fra un passo e l’altro succede molto e di quel che c’era prima resta poco. È l’intervallo a decidere quanto in fretta il sistema dimentica, e più avanti Mamba lo sceglierà di nuovo a ogni parola.
Le due regole sono due modi diversi di indovinare cosa succede tra un passo e l’altro, e tutte e due tengono fermo il rubinetto per l’intero tratto, all’apertura che si legge adesso. Si separano sullo scarico, che tira di più a vasca piena e di meno man mano che il livello scende; e l’acqua che entra comincia a defluire appena è entrata. Lo zero-order hold, la scelta di Mamba, tiene conto di tutto questo, e fa il conto esatto di quanta acqua la vasca perde nel tratto. La bilineare, la scelta di S4, lo scarico lo stima alla buona: prende quanto tirava all’inizio del tratto e quanto tira alla fine, e ne fa la media, cioè misura un trapezio al posto della curva vera. Il risultato è lo stesso tipo di regola passo dopo passo; cambia quanto errore ti porti dietro a ogni passo, e l’errore, a forza di passi, si accumula.
Del suo conto esatto Mamba semplifica un pezzo. Per sapere quanta acqua, di quella entrata nel tratto, finisce davvero nella vasca, fa un rettangolo: apertura per durata, come se l’acqua non defluisse mentre entra. È il pezzo che Mamba-3, il modello più recente della famiglia, rifarà a trapezi.
Discretizzare significa ricavare, dalle matrici continue \(\mathbf{A}\) e \(\mathbf{B}\) e dal passo \(\Delta\), le matrici discrete \(\bar{\mathbf{A}}\) e \(\bar{\mathbf{B}}\) tali che la ricorrenza \(\mathbf{h}_t = \bar{\mathbf{A}}\,\mathbf{h}_{t-1} + \bar{\mathbf{B}}\,x_t\) approssimi l’evoluzione continua (\(x_t\) è l’ingresso campionato al passo \(t\)).
Lo zero-order hold assume che l’ingresso resti costante entro ciascun intervallo \(\Delta\) e integra esattamente il sistema su quel tratto:
Qui \(\exp(\cdot)\) è l’esponenziale di matrice, non elemento per elemento.
L’inversa \((\Delta \mathbf{A})^{-1}\) è apparente: la combinazione vale
\(\Delta\,\varphi_1(\Delta \mathbf{A})\,\mathbf{B}\) con \(\varphi_1(z)=\sum_{k\ge
0} z^k/(k+1)!\), una serie definita anche quando \(\mathbf{A}\) è singolare (per
\(\mathbf{A}\) diagonale con un autovalore nullo la formula scritta con l’inversa
non si può valutare, la serie sì). In codice si usa la serie, oppure
expm1(z)/z con il caso \(z=0\) trattato a parte: per \(z=\Delta a\) piccolo la
differenza \(e^{z}-1\), scritta come exp(z) - 1, perde le cifre significative
per cancellazione.
Se \(\mathbf{A}\) è diagonale, ogni suo autovalore \(a\) si discretizza per conto suo: \(\bar{a} = e^{\Delta a}\) e \(\bar{b} = \frac{e^{\Delta a}-1}{a}\,b\), ben definito anche nel limite \(a\to 0\), dove vale \(\Delta b\) (è \(\varphi_1(0)=1\)). È la scelta di Mamba, con una precisazione: lo ZOH vale per la transizione, \(\bar{\mathbf{A}} = \exp(\Delta \mathbf{A})\), mentre per l’ingresso l’implementazione (il paper dichiara lo ZOH anche lì) adotta la semplificazione al prim’ordine (Eulero) \(\bar{\mathbf{B}} = \Delta \mathbf{B}\), che dello ZOH è il troncamento per \(\Delta\) piccolo [LLC+26]. La si ritrova nel codice della sezione su Mamba.
La trasformazione bilineare sostituisce invece l’esponenziale con la sua approssimante razionale \([1/1]\), \(e^{z} \approx (1+z/2)/(1-z/2)\) (la regola del trapezio, accurata al second’ordine: l’errore locale è \(O(\Delta^3)\)), ottenendo
È la scelta di S4 [GGRe22]; fra i suoi successori diagonali, DSS e S5 usano lo ZOH, e S4D le ammette tutte e due [GGGRe22]. In entrambi i casi la \(\mathbf{C}\) resta invariata (\(\bar{\mathbf{C}}=\mathbf{C}\)), e i parametri effettivi del modello sono la quaterna \((\Delta, \mathbf{A}, \mathbf{B}, \mathbf{C})\): le matrici continue più il passo, da cui si generano le matrici discrete. Il passo \(\Delta\) decide molto: fissa la scala temporale del sistema, cioè quanto in fretta lo stato dimentica.
Quanto conti la scelta della regola, invece, lo dicono le ablazioni. Poco nel caso LTI: in S4D lo ZOH, la bilineare ed Eulero non fanno differenze apprezzabili, mentre l’inizializzazione di \(\mathbf{A}\) pesa molto di più [GGGRe22]. Nel caso selettivo conta un po” di più, ma resta una correzione piccola: lo misura il paper di Mamba-3, con i numeri riportati nella sezione sulla dualità.
Due facce della stessa medaglia: ricorrenza e convoluzione#
Finché le tre regole, cioè le matrici \(\bar{\mathbf{A}}\), \(\bar{\mathbf{B}}\) e \(\mathbf{C}\), restano le stesse a ogni passo (nel gergo della teoria dei segnali il sistema si dice lineare e tempo-invariante, in sigla LTI), la stessa uscita, a partire da uno stato nullo, si calcola in due modi: una forma ricorrente, un passo alla volta, e una forma convoluzionale, tutta la sequenza in un colpo.
È la stessa doppia natura che abbiamo visto nel capitolo scorso con l’attenzione lineare, dove un unico calcolo si poteva leggere in due modi: «passo dopo passo» oppure «tutto insieme». Qui le due forme tornano, con un attrezzo diverso per il «tutto insieme»: un filtro.
Da un lato la forma ricorrente: parti dallo stato, aggiungi il nuovo ingresso, ottieni il nuovo stato, leggi l’uscita, e ripeti. Un token alla volta, con una quantità di memoria che non cresce mai: perfetta per generare testo o processare un flusso audio in tempo reale. È il modo di lavorare di una RNN.
Dall’altro la forma convoluzionale: se il sistema non cambia nel tempo, si può dimostrare che l’intera uscita è una singola convoluzione dell’ingresso con un filtro fisso. E la convoluzione la conosciamo dalle reti convoluzionali: un filtro che scorre lungo il segnale e a ogni posizione moltiplica i propri pesi per i valori che ha sotto, poi somma. Due differenze. La prima è che qui il filtro è lungo quanto tutta la sequenza, non una finestrella di pochi elementi. La seconda è che nessuno lo scrive a mano: si ricava, con un conto, dalle tre regole del sistema. Ed è una buona notizia, perché il modello ha da imparare le tre regole, che sono poche, e non i numeri del filtro, che sono tanti quanto il testo è lungo. Quei numeri, uno per posizione, dicono quanto una parola di venti o di mille passi fa conta ancora sull’uscita di adesso: nella vasca dei due litri al minuto erano 1, 0,5, 0,25, 0,125 (quanto pesa ancora un getto entrato adesso, un minuto fa, due, tre). Il vantaggio è che una convoluzione si calcola in un colpo solo, in parallelo su tutta la sequenza: proprio ciò che serve per sfruttare le GPU in addestramento.
Morale: si addestra in forma convoluzionale (veloce, parallela) e si fa inferenza in forma ricorrente (economica, una parola alla volta). La stessa funzione, due vestiti diversi a seconda dell’occasione.
Tutto questo regge a una condizione: il filtro è uno solo, lo stesso dalla prima parola all’ultima. Se le tre regole cambiassero da una parola alla successiva, un filtro da calcolare una volta per tutte non ci sarebbe più, e per fare i conti tutti insieme servirebbe un’altra strada. Mamba prenderà proprio quella deviazione, sapendo quel che costa.
La forma ricorrente srotola la ricorrenza discreta:
Ogni passo costa \(O(N^2)\) (o \(O(N)\) se \(\bar{\mathbf{A}}\) è diagonale) e la memoria è \(O(N)\), costante nella lunghezza della sequenza: è l’inferenza a costo fisso per token tipica delle RNN.
La forma convoluzionale si ottiene sostituendo ripetutamente la ricorrenza in se stessa, con stato iniziale nullo:
cioè una convoluzione tra l’ingresso e un kernel (o SSM convolution kernel)
dove \(\bar{\mathbf{K}}\) è un filtro causale lungo quanto la sequenza. Calcolata questa volta sola, l’uscita \(\mathbf{y} = \mathbf{x} * \bar{\mathbf{K}}\) si ottiene per l’intera sequenza in parallelo, con la trasformata di Fourier veloce, la FFT, in tempo \(O(L \log L)\) (\(L\) è la lunghezza). Il termine \(\mathbf{C}\bar{\mathbf{A}}^{\,j}\bar{\mathbf{B}}\) misura quanto un ingresso di \(j\) passi fa pesa ancora sull’uscita di adesso: è la memoria del sistema, e decade con le potenze \(\bar{\mathbf{A}}^{\,j}\).
L’equivalenza \( \text{ricorrenza} \equiv \text{convoluzione} \) vale solo perché \(\bar{\mathbf{A}}, \bar{\mathbf{B}}, \mathbf{C}\) sono costanti nel tempo: è la tempo-invarianza a garantire che il kernel \(\bar{\mathbf{K}}\) sia unico e fisso. Quando, con Mamba, faremo dipendere questi parametri dall’ingresso, il sistema cesserà di essere LTI, il kernel di convoluzione fisso svanirà, e resterà solo lo scan ricorrente.
È la stessa doppia natura del capitolo sull’attenzione lineare (una forma parallela per addestrare, una ricorrente per generare), ottenuta con un meccanismo diverso: là un prodotto di matrici con una maschera, qui una convoluzione con un filtro fisso. La sezione sulla dualità mostrerà in quale caso i due meccanismi coincidono. La Fig. 18.2 mostra le due facce affiancate.

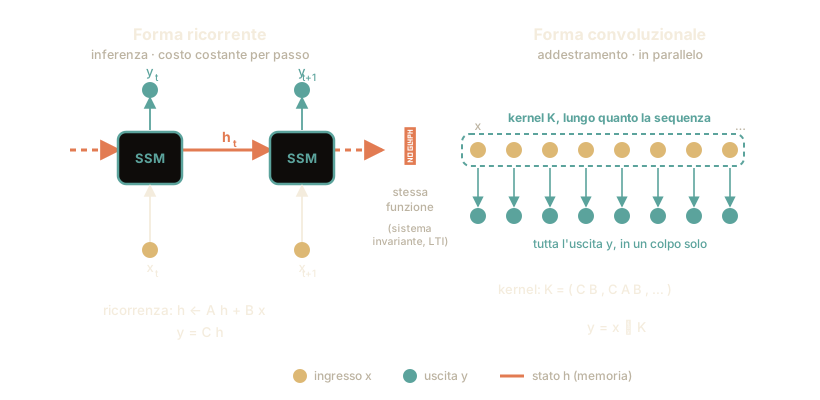
Fig. 18.2 Le due facce della stessa macchina, quando le sue regole non cambiano da un passo all’altro. A sinistra si va passo dopo passo: lo stato si aggiorna una parola alla volta, ed è il modo economico per generare. A destra si fa tutto insieme: un unico filtro, lungo quanto la sequenza, produce tutte le uscite in una volta sola, ed è il modo veloce per addestrare. Il simbolo al centro dice che è lo stesso calcolo, scritto in due modi. Nelle formule \(\mathbf{h}\) è lo stato, \(x\) l’ingresso e \(y\) l’uscita; \(\bar{\mathbf{A}}\), \(\bar{\mathbf{B}}\) e \(\mathbf{C}\) sono le tre regole (quanto lo stato cala da solo, come l’ingresso vi entra, come se ne legge l’uscita), e \(\bar{\mathbf{K}}\) è il filtro.#
HiPPO e S4: ricordare a lungo#
Nei modelli veri lo stato è un vettore \(\mathbf{h} \in \mathbb{R}^N\) di pochi numeri (in S4, \(N = 64\) per canale). Resta da capire perché uno stato così piccolo dovrebbe ricordare qualcosa avvenuto migliaia di passi prima.
Con una transizione scalare \(\bar{a} \in (0,1)\), il contributo di un ingresso di \(k\) passi fa pesa \(\bar{a}^{\,k}\). Con \(\bar{a} = 0{,}9\), che come decadimento è già lento, dopo cinquanta passi ne resta \(0{,}9^{50} \approx 0{,}005\), cioè mezzo per cento, e dopo cento \(0{,}9^{100} \approx 2{,}7 \cdot 10^{-5}\), mezzo per cento di mezzo per cento. È lo stesso decadimento esponenziale che mette in difficoltà le RNN classiche, in avanti per il ricordo e all’indietro per il gradiente (il gradiente che svanisce), ed è una delle ragioni per cui sono nate LSTM e GRU, con i loro cancelli (gate) che decidono a ogni passo quanto lasciar passare e quanto trattenere [HS97]. Per gli SSM la risposta sta invece nella scelta di \(\mathbf{A}\), la regola con cui lo stato decade: presa a caso, la memoria è corta; costruita con criterio, può essere lunghissima.
Un romanzo lunghissimo, e una pagina sola di appunti da tenere aggiornata mentre lo leggi. La pagina non si allunga mai: per far entrare una riga nuova, una vecchia deve stringersi. Se ogni frase nuova cancella la precedente, alla fine ti resta in mano solo l’ultimo capitolo.
C’è un modo migliore di riempirla, e nasce da una domanda precisa: fra tutte le pagine che stanno in quello spazio, da quale si potrebbe riscrivere il romanzo intero sbagliando meno? La risposta ha un nome, HiPPO. La pagina viene su a strati: l’idea generale, gli snodi principali, poi i dettagli più fini, sparsi su tutto il romanzo e non solo sull’ultimo capitolo. Il passato lontano si assottiglia e non sbiadisce del tutto.
Quella pagina arriva già impostata prima che la lettura cominci, con lo spazio ripartito fra gli strati. Chi comincia da lì ha la memoria lunga senza fare altro; chi comincia da una pagina bianca qualunque ricorda le ultime frasi e basta, e continuare a leggere non gliela allunga.
S4 prende quella pagina impostata e ci aggiunge la velocità. Per allenarsi in fretta gli serve sapere in anticipo quanto ogni frase già letta pesa sull’appunto di adesso: un elenco lungo quanto il romanzo, e ricavarlo voce per voce vuol dire ripercorrere la storia da capo ogni volta. Ridisegnare la pagina per renderla comoda da calcolare non era un’opzione: chi tocca quel disegno butta via la memoria lunga insieme a lui. Ma il disegno di HiPPO si lascia scomporre in due pezzi. Nel primo ogni riga della pagina si aggiorna per conto suo, senza guardare le altre, e per righe così l’elenco dei pesi si scrive con una formula, tutto in una volta. Il secondo è un ritocco piccolo, fatto di pochi ingredienti, che lega le righe fra loro, e un ritocco così si sistema alla fine con un solo conto in più. L’elenco intero esce in blocco. La memoria gliela dà la pagina di partenza, la velocità la scomposizione: senza tutt’e due sarebbe rimasto un esercizio.
Con tutt’e due è il primo modello che risolve Path-X, la prova più dura del Long Range Arena, la gara sulle dipendenze a lunghissimo raggio. Si guarda un’immagine di 128 pixel per 128, letta un pixel alla volta, in fila come se fosse un testo: 128 per 128 fanno \(16\,384\) passi. Alla fine si deve dire se due puntini sono uniti da un tratto oppure no, e per rispondere bisogna tenere insieme parti dell’immagine lontanissime nella fila. Lì i Transformer restavano al livello di chi tira a indovinare. Fuori dal Long Range Arena, sulle immagini e sul linguaggio, il distacco si accorcia senza sparire.
Una virtù, però, per strada si perde. Il modo di prendere appunti di HiPPO non si cura di quanto sia lungo il romanzo: cento pagine o mille, la pagina resta una e si riadatta da sé man mano che la storia si allunga. S4 lo congela in una macchina che procede a passi tutti uguali, e da quel momento la distanza su cui ricordare va decisa prima di cominciare a leggere. Il rimedio è non deciderla una volta sola. Un modello vero tiene molte pagine insieme, una per canale, e l’intervallo che regola quanta storia entra in un passo, che ogni pagina ha suo, viene messo su valori sparpagliati, dai lentissimi ai velocissimi: così le pagine si dividono il lavoro, una sull’ultima riga, una sul capitolo intero.
HiPPO (High-order Polynomial Projection Operators, Gu et al., 2020, [GDE+20]) formalizza la compressione online di un segnale come la sua proiezione ottima su una base di polinomi ortogonali (per esempio i polinomi di Legendre) rispetto a una misura sul passato. Lo stato \(\mathbf{h}(t)\) diventa il vettore dei coefficienti di quella proiezione: ricostruisce, nel modo meno sbagliato possibile, tutto il segnale visto fin lì. La variante HiPPO-LegS (scaled Legendre) usa una misura che copre uniformemente tutta la storia, ed è per costruzione robusta alla scala temporale: l’operatore originale è tempo-variante (il suo passo è \(1/t\), non \(\Delta\)) e non ha alcun iperparametro di scala, tanto che dilatare l’ingresso dilata semplicemente l’uscita. Attenzione a cosa si eredita e cosa no: S4 prende la matrice LegS, non quella robustezza, perché la congela dentro un sistema LTI con passo \(\Delta\) costante. Lì la scala temporale torna a essere fissata da \(\Delta\), che infatti non si sceglie a caso ma si inizializza su una gamma ampia di ordini di grandezza (tipicamente log-uniforme fra \(10^{-3}\) e \(10^{-1}\)), proprio per coprire orizzonti di memoria diversi. Il risultato pratico è una matrice \(\mathbf{A}\) specifica (la matrice HiPPO) con cui inizializzare l’SSM per dotarlo di memoria a lungo raggio. Per LegS, con indici \(n, k = 0, \dots, N-1\),
triangolare inferiore: il coefficiente di grado \(n\) riceve solo da quelli di grado più basso, e gli autovalori sono la diagonale.
S4 (Structured State Space Sequence model, Gu, Goel e Ré, ICLR 2022, [GGRe22]) parte proprio da qui, ma non è il primo strato a farlo. Il Linear State-Space Layer (LSSL) [GJG+21], dello stesso gruppo e comparso su arXiv cinque giorni prima, inizializzava già \(\mathbf{A}\) con HiPPO-LegS e simulava il sistema lineare come strato di una rete: sul MNIST sequenziale, rispetto a una \(\mathbf{A}\) casuale, l’accuratezza passava dal 60 al 98 per cento. Il suo ostacolo era computazionale. Costruire il kernel \(\bar{\mathbf{K}}\) richiede le potenze \(\bar{\mathbf{A}}^{\,j}\) fino a \(j = L-1\): farlo direttamente costa \(O(N^2 L)\) operazioni, proibitivo per stati e sequenze grandi. La mossa di S4 non è imporre ad \(\mathbf{A}\) una struttura, e la distinzione va tenuta ferma: se lo facesse perderebbe proprio la matrice che dà la memoria lunga, e l’argomento crollerebbe. S4 dimostra (Teorema 1 del paper) che le matrici HiPPO una struttura sfruttabile ce l’hanno già, e che è normale più basso rango (NPLR):
con \(\mathbf{V}\) unitaria, \(\boldsymbol{\Lambda}\) diagonale e \(\mathbf{P}\mathbf{Q}^{\top}\) una correzione di rango basso (\(\mathbf{P}\) e \(\mathbf{Q}\) sono matrici «alte e strette»). Coniugando con \(\mathbf{V}\) ci si riduce alla forma diagonale più basso rango (DPLR), \(\boldsymbol{\Lambda} - \tilde{\mathbf{P}}\tilde{\mathbf{Q}}^{*}\), che è quella su cui l’algoritmo lavora. Attenzione a chi sono gli autovalori: \(\boldsymbol{\Lambda}\) raccoglie gli autovalori della parte normale, non quelli di \(\mathbf{A}\), e per la HiPPO-LegS i due insiemi non si somigliano affatto (gli autovalori di \(\mathbf{A}\) sono reali, \(-1, \dots, -N\); quelli di \(\boldsymbol{\Lambda}\) hanno tutti parte reale \(-1/2\) e parti immaginarie che crescono). Gli autovalori di \(\mathbf{A}\) restano dove sono, perché una similitudine non li sposta: la retta verticale appartiene alla parte normale, quella che resta una volta scorporata la correzione di rango basso. Il guadagno sta lì: una matrice normale ha una base di autovettori ortonormale, mentre la base di autovettori di \(\mathbf{A}\) si mal condiziona in fretta al crescere di \(N\), tanto da rendere impraticabile la diagonalizzazione diretta. Per questo l’algoritmo lavora sulla forma DPLR.
Con questa struttura il kernel non si calcola più elevando a potenza una matrice piena: lo si ottiene passando alla sua funzione generatrice valutata sulle radici dell’unità, e sfruttando l’identità di Woodbury (per l’inversa di «diagonale + basso rango») e un kernel di Cauchy. Il costo scende a quasi-lineare in \(N + L\): S4 tiene la matrice dell’LSSL e cambia l’algoritmo, e a dimensione 512 il suo strato è circa trenta volte più veloce di quello dell’LSSL e occupa circa quattrocento volte meno memoria [GGRe22].
Uno strato S4 contiene molti SSM a ingresso scalare: dato un ingresso a \(H\) canali, ne applica \(H\) copie indipendenti, una per canale, ciascuna con il proprio passo \(\Delta\) e con i suoi \(5N\) parametri addestrabili (\(\boldsymbol{\Lambda}\), \(\mathbf{P}\), \(\mathbf{Q}\), \(\mathbf{B}\), \(\mathbf{C}\)); poi mescola i canali con una proiezione lineare applicata posizione per posizione e una non linearità. I parametri per strato sono \(O(H^2) + O(HN)\), e un passo della ricorrenza costa \(O(N)\) per canale [GGRe22].
Il guadagno non è solo teorico. Generando un token alla volta, S4 non ha una cache che cresce e produce l’uscita a costo costante, mentre un Transformer deve rileggere tutto il contesto; e sul Long Range Arena, il banco di prova delle dipendenze a lunghissimo raggio, è il primo modello a risolvere Path-X, il compito su sequenze da \(16\,384\) elementi su cui i Transformer restavano al livello del caso. Il paper dichiara di ridurre nettamente (non di annullare) il divario di qualità con i Transformer su immagini e linguaggio: la novità che resta, e che è di sostanza, è che una ricorrenza a stato piccolo arriva dove l’attenzione non arrivava.
Tappe verso il linguaggio#
S4 mostrò che uno stato piccolo, ben costruito, regge le sequenze lunghe meglio dell’attenzione; sul linguaggio restava indietro di poco, a 0,8 di perplessità dal Transformer su WikiText-103 [GGRe22]. Mamba sarà il primo modello senza attenzione a pareggiare in perplessità una ricetta di Transformer molto curata, la Transformer++ [GD24]. Fra i due stanno alcuni lavori del 2022 e del 2023, ciascuno su un pezzo del problema.
Fra S4 e Mamba ci sono tre modelli, ciascuno su un fronte diverso. S5 (2023) semplifica la macchina di S4 e, soprattutto, fa vedere che la forma «passo dopo passo» non è condannata a essere lenta. Sembrerebbe di sì, visto che ogni passo ha bisogno del risultato del precedente. Il fatto è che due passi consecutivi si possono fondere in un passo solo, che fa il lavoro di tutti e due; e le fusioni di coppie diverse non si aspettano fra loro, quindi si possono fare tutte nello stesso momento. Un giro dimezza i passi rimasti, il giro dopo li dimezza ancora, e in una manciata di giri si è arrivati in fondo. Il conto per esteso lo fa Mamba, che eredita lo stesso trucco.
H3 (2023) affronta invece la memoria «a richiamo»: ritrovare più avanti una cosa già letta («chi era il soggetto di quella frase?»). I modelli di questa famiglia, trattando ogni parola con la stessa regola, faticavano a farlo; H3 li aiuta accoppiando due memorie e un cancello che dosa quanto passa dall’una all’altra, così il modello riesce a trattenere un’informazione finché gli serve. Il suo modo di montare i pezzi diventerà il blocco di Mamba.
Hyena (2023), infine, prova la via più diretta: se l’ingrediente vincente è un filtro lungo che scorre su tutta la frase (come quelli delle reti convoluzionali, ma lunghi quanto l’intero testo), tanto vale imparare direttamente il filtro, senza passare dal sistema dinamico. Con un accorgimento, però: quei numeri Hyena non se li impara a memoria uno per uno, che sarebbe un elenco lungo quanto il testo. A disegnare il filtro mette una piccola rete, così le cose da imparare restano poche come prima; è cambiato soltanto chi tiene la matita. Funziona quasi come l’attenzione, costando molto meno. È una strada parallela più che una tappa: Mamba il filtro lungo lo abbandonerà, e Hyena resterà il concorrente con cui misurarsi.
Prima ancora c’è un passo che Mamba darà per scontato: togliere a S4 la correzione di rango basso. DSS [GGB22] e poi S4D [GGGRe22] mostrano che con \(\mathbf{A}\) soltanto diagonale la qualità resta vicina a quella di S4, purché l’inizializzazione sia scelta con cura. A reggere sono la parte normale di LegS (S4D-LegS), con parte reale \(-\tfrac12\) e parti immaginarie che vanno, secondo una congettura del paper verificata numericamente, come l’inverso dell’indice (la formula chiusa che ne discende è S4D-Inv), e la più semplice \(a_n = -\tfrac12 + i\pi n\) (S4D-Lin), che prende le frequenze di Fourier di un’altra matrice HiPPO, FouT. Conservare lo spettro, invece, non basta: i reali \(a_n = -(n+1)\) (S4D-Real), che sono proprio gli autovalori di LegS, nelle ablazioni di S4D perdono circa cinque punti e mezzo su sCIFAR e dieci su Speech Commands rispetto a S4D-Inv (quasi sei e dieci e mezzo rispetto a S4D-Lin). Il kernel diventa una somma di \(N\) esponenziali, \(\bar K_j = \sum_n C_n\, e^{j\Delta a_n}\, \bar b_n\), calcolabile con una matrice di Vandermonde, senza Cauchy né Woodbury. La \(\mathbf{A}\) diagonale e reale di Mamba è proprio l’inizializzazione di S4D-Real, e Mamba la sceglie per una ragione che il caso LTI non vede: con l’SSM selettivo e sul linguaggio, nelle ablazioni del suo paper S4D-Real batte S4D-Lin (perplessità 8,71 contro 9,16), mentre i numeri complessi servono per i segnali continui, tanto che l’audio è l’unico esperimento di Mamba che li usa [GD24].
S5 (Smith, Warrington e Linderman, ICLR 2023, [SWL23]) semplifica S4 su due fronti. Primo: usa un unico SSM MIMO (a più ingressi e più uscite) con matrice \(\mathbf{A}\) diagonale, invece di tanti SSM scalari indipendenti. Secondo, e più importante per il seguito: abbandona la convoluzione via FFT e calcola la ricorrenza con un parallel scan (un algoritmo che, sfruttando l’associatività della ricorrenza lineare, la calcola in parallelo in tempo logaritmico nella lunghezza). È il ponte diretto verso lo scan che sarà il cuore di Mamba: la forma ricorrente smette di essere il modo «lento», diventa anch’essa parallelizzabile.
H3 (Hungry Hungry Hippos, Fu, Dao et al., ICLR 2023, [FDS+23]) attacca il punto debole degli SSM sul linguaggio: il recall associativo, cioè ritrovare a distanza un’informazione già vista («chi era il soggetto di quella frase?»). Un SSM LTI puro fatica a copiare e confrontare token, cosa che l’attenzione fa con naturalezza. H3 impila due SSM, uno a spostamento (shift) e uno diagonale, intervallati da un gating moltiplicativo, un prodotto elemento per elemento tra due rami che permette al modello di confrontare token vicini e «trattenere» un valore fino a quando serve. Con l’aggiunta di pochissimi strati di attenzione, gli ibridi basati su H3 arrivano a taglie fino a 2,7 miliardi di parametri e reggono il confronto con i Transformer.
Hyena (Poli, Massaroli et al., ICML 2023, [PMN+23]) tira una riga di sintesi: se l’ingrediente utile è una convoluzione lunga, la si può apprendere direttamente. Hyena impila convoluzioni lunghe implicite (filtri lunghi quanto la sequenza, ma parametrizzati da una piccola rete invece che memorizzati numero per numero) alternate a un gating controllato dai dati. Non è un SSM in senso stretto, ma è imparentato: entrambi calcolano l’uscita come convoluzione lunga, entrambi girano in tempo \(O(L \log L)\) con la FFT. Hyena mostra che si può avvicinare la qualità dell’attenzione senza attenzione, con sole convoluzioni; nel paper di Mamba compare come termine di confronto, non come ingrediente [GD24].
Restava un limite comune a tutti. Il nucleo che accumula il passato (la ricorrenza di S4 e S5, la convoluzione lunga di Hyena) è LTI: aggiorna lo stato con la stessa regola per ogni token, incapace di scegliere che cosa ricordare in base al contenuto. Chi legge una parola importante e chi legge una virgola aggiornano lo stato con la stessa regola fissa. I cancelli di H3 e di Hyena dipendono dai dati, ma agiscono posizione per posizione e non lungo la sequenza: non decidono che cosa entra nello stato e che cosa ne esce. Rompere il vincolo (rendere il nucleo tempo-variante, capace di selezionare) è il passo che porta a Mamba.
Da ricordare
Un SSM nasce da un sistema che evolve nel tempo, come la vasca con il rubinetto aperto e lo scarico socchiuso: il livello dell’acqua è lo stato, una fotografia compatta del passato che basta a prevedere il futuro. Tre ingredienti: come lo stato si muove da solo (la vasca cala, altri sistemi ondeggiano o crescono), come l’ingresso lo alza, come si legge l’uscita. È l’altra strada verso un modello che regge i testi lunghi senza che il costo esploda, complementare all’attenzione lineare del capitolo precedente.
Per usarlo su una sequenza (parole, campioni audio) bisogna misurare a intervalli regolari e indovinare cosa succede tra un campione e il successivo. Le ricette non sono una sola e non vanno confuse: tutte e due tengono fermo l’ingresso per il tratto; S4 stima con un trapezio quanto lo stato cala nel frattempo, Mamba lo calcola esatto (è lo zero-order hold, la tenuta di ordine zero). Per calcolare quanta parte di ciò che entra finisce nella memoria, Mamba si accontenta del conto più sbrigativo, a rettangoli: è il pezzo che il modello più recente della famiglia, Mamba-3, rifarà a trapezi.
Finché le regole non cambiano da un passo all’altro, lo stesso calcolo si può fare in due modi: passo dopo passo (un token alla volta, con una memoria che non cresce mai: economico per generare) oppure tutto insieme, come un unico filtro lungo che scorre sulla sequenza (parallelo: perfetto per addestrare sulle GPU). Si allena nel secondo modo, si usa nel primo: la stessa dualità vista con l’attenzione lineare.
L’equivalenza regge solo finché quelle regole restano fisse: Mamba le farà dipendere da ciò che legge, e allora il filtro unico non c’è più. La ricorrenza resta, e per farla girare in parallelo servirà un’altra strada, lo scan.
HiPPO (Gu et al., 2020) è il modo studiato apposta per riassumere una storia lunghissima in pochi numeri, come appunti a più livelli su un romanzo: dice da quali numeri partire perché uno stato piccolo abbia memoria lunga. S4 (2022) parte da lì e rende il conto efficiente, sfruttando il fatto che quei numeri si scompongono in una parte semplice e in un piccolo ritocco, ed è il primo a risolvere Path-X (sequenze da \(16\,384\) elementi), la prova più dura della gara sulle dipendenze a lunghissimo raggio, Long Range Arena.
Le tappe verso il linguaggio: S5 (mostra che anche il passo dopo passo si può svolgere quasi tutto in parallelo) e H3 (due memorie e un cancello che dosa quanto passa dall’una all’altra, per ritrovare a distanza una cosa già letta) preparano Mamba; Hyena, che impara direttamente il filtro lungo, è la strada che Mamba non prende.
Da ricordare
Un SSM nasce da un sistema dinamico continuo \(\mathbf{h}'(t)=\mathbf{A}\,\mathbf{h}(t)+\mathbf{B}\,u(t)\), \(y(t)=\mathbf{C}\,\mathbf{h}(t)\): lo stato \(\mathbf{h}\) è una fotografia compatta del passato, con \(\mathbf{A}\) dinamica interna, \(\mathbf{B}\) ingresso, \(\mathbf{C}\) uscita. È l’altra strada verso il tempo lineare, complementare all’attenzione lineare del capitolo precedente.
Per usarlo su sequenze discrete serve un passo \(\Delta\) di discretizzazione: una regola per indovinare cosa succede tra un campione e il successivo. Di regole ce n’è più d’una e non vanno confuse. S4 usa la bilineare (trapezio sulla dinamica dello stato, ingresso tenuto fermo); Mamba usa lo zero-order hold (ZOH: l’ingresso resta fermo per tutto l’intervallo), che gli dà la transizione \(\bar{\mathbf{A}}=\exp(\Delta \mathbf{A})\). Per il termine d’ingresso, però, l’implementazione di Mamba si accontenta del conto a rettangoli, \(\bar{\mathbf{B}}=\Delta \mathbf{B}\) (il metodo di Eulero, cioè lo ZOH troncato al prim’ordine): è il pezzo che Mamba-3 rifarà a trapezi.
Se il sistema discretizzato è tempo-invariante (LTI), la stessa funzione ha due forme equivalenti: ricorrente \(\mathbf{h}_t=\bar{\mathbf{A}}\mathbf{h}_{t-1}+\bar{\mathbf{B}}x_t\) (inferenza a costo costante nella lunghezza) e convoluzionale \(\mathbf{y}=\mathbf{x}*\bar{\mathbf{K}}\) (addestramento parallelo). L’addestramento è convoluzionale, l’inferenza è ricorrente: la stessa dualità vista con l’attenzione lineare.
Questa equivalenza vale solo se \(\bar{\mathbf{A}},\bar{\mathbf{B}}, \mathbf{C}\) sono costanti: Mamba la romperà rendendoli dipendenti dall’ingresso, e allora resterà solo lo scan.
HiPPO (Gu et al., 2020) sceglie \(\mathbf{A}\) proiettando la storia su polinomi ortogonali: è ciò che dà memoria a lungo raggio a uno stato piccolo. L’LSSL l’aveva già messa in uno strato, a un costo di \(O(N^2L)\); S4 (2022) dimostra che quelle matrici sono già normali più basso rango e, coniugando, si riduce a diagonale + basso rango: il kernel si calcola in tempo quasi-lineare in \(N+L\). È il primo a risolvere Path-X (sequenze da \(16\,384\) elementi) su Long Range Arena.
Le tappe verso il linguaggio: DSS e S4D (la sola diagonale; da S4D-Real viene la \(\mathbf{A}\) reale di Mamba), S5 (SSM MIMO + parallel scan), H3 (due SSM + gating per il recall associativo, e il blocco che Mamba riprende). Hyena (convoluzioni lunghe implicite) è una strada parallela. Il nucleo di tutti resta LTI.