


Come funziona l’addestramento avversario#
Quella sera a Montréal è nata un’idea; adesso la smontiamo pezzo per pezzo. Al posto del confronto punto per punto con un originale, che per un dato nuovo non esiste, le GAN [GPAM+14] mettono una seconda rete, il cui unico mestiere è smascherare la prima.
Le due reti dell’apertura ricevono qui una lettera: il generatore è \(G\), il discriminatore è \(D\) (nella storia del falsario e dell’esperto d’arte, il falsario è \(G\) e l’esperto è \(D\)). Si comincia da che cosa entra e che cosa esce da ciascuna.
Il generatore: dal rumore al dato#
Il generatore riceve in ingresso un vettore di numeri estratti a caso, \(\mathbf{z}\), il rumore (termine tecnico che qui non ha a che fare con il suono: dice che quei numeri non portano nessuna informazione sul dato), e ne ricava un dato sintetico \(\tilde{\mathbf{x}}\) che deve sembrare autentico.
Il falsario, \(G\), lavora bendato: i quadri autentici non li vedrà mai, nemmeno uno, ed è una scelta di progetto, non una dimenticanza. Gli si consegna una manciata di numeri tirati a sorte, sempre diversi, e da quelli deve modellare qualcosa di sensato, per esempio l’immagine di un volto. All’inizio produce macchie informi; con l’allenamento impara a trasformare quei numeri in volti sempre più plausibili, e numeri diversi in ingresso danno volti diversi in uscita: è così che \(G\) genera varietà, non una sola immagine ripetuta. Di volti però non tiene nessun registro: sa fabbricarne uno, non sa dire quanto un volto sia probabile. E alla fine lo si giudica in blocco: i volti che sforna, tutti insieme, devono somigliare al mucchio di quelli veri.
Il generatore è una funzione \(G(\mathbf{z};\theta_G)\) parametrizzata da una rete neurale, che mappa un vettore di rumore \(\mathbf{z}\in\mathbb{R}^L\), con \(L\) la dimensione del latente, nello spazio dei dati:
Il vettore \(\mathbf{z}\) è campionato da un prior semplice, tipicamente \(p_z=\mathcal{N}(\mathbf{0}, \mathbf{I})\) o uniforme. \(G\) definisce implicitamente una distribuzione \(p_G\) sullo spazio dei dati: propagando campioni di \(\mathbf{z}\) attraverso la rete, otteniamo campioni di dati sintetici. L’obiettivo dell’addestramento è far convergere \(p_G\) verso la distribuzione reale \(p_{\text{dati}}\), senza mai scrivere esplicitamente la densità: da qui il nome di modello generativo implicito.
Il discriminatore: dal dato alla probabilità#
Il discriminatore fa il mestiere opposto, e più familiare: è un classificatore binario, una rete che assegna ogni ingresso a una di due classi, qui «reale» e «generato».
Davanti a \(D\), l’esperto d’arte, passano dei quadri, tanti veri (pescati dal dataset, il mucchio di esempi autentici che abbiamo raccolto) quanti falsi (sfornati da \(G\)), e su ciascuno deve rispondere a una sola domanda: è autentico? La sua risposta è un numero tra \(0\) e \(1\), una specie di livello di fiducia: vicino a \(1\) significa «sono quasi certo che sia reale», vicino a \(0\) significa «quasi certo che sia un falso». Il suo mestiere è non farsi ingannare, e lo impara nel modo consueto: su ogni quadro gli si dice se ha indovinato, e lui ci aggiusta l’occhio.
Il discriminatore è una funzione \(D(\mathbf{x};\theta_D)\in[0,1]\) che stima la probabilità che \(\mathbf{x}\) provenga dai dati reali anziché da \(G\). La formalizzazione passa da una mistura: il campione arriva metà delle volte dal dataset e metà dal generatore, e \(D\) stima la probabilità a posteriori che la sorgente sia quella reale, visto il campione:
È un classificatore addestrato con la consueta cross-entropy binaria: vuole assegnare \(D(\mathbf{x})\to 1\) agli esempi reali e \(D(G(\mathbf{z}))\to 0\) a quelli sintetici. L’uscita in \([0,1]\) si ottiene applicando una sigmoide al punteggio grezzo (il logit) dell’ultimo strato; nell’implementazione, come d’abitudine in PyTorch, la sigmoide sarà assorbita dentro la loss (nn.BCEWithLogitsLoss) per stabilità numerica.
Messi uno di fronte all’altro, \(G\) e \(D\) compongono la GAN per intero, e Fig. 26.2 la disegna.

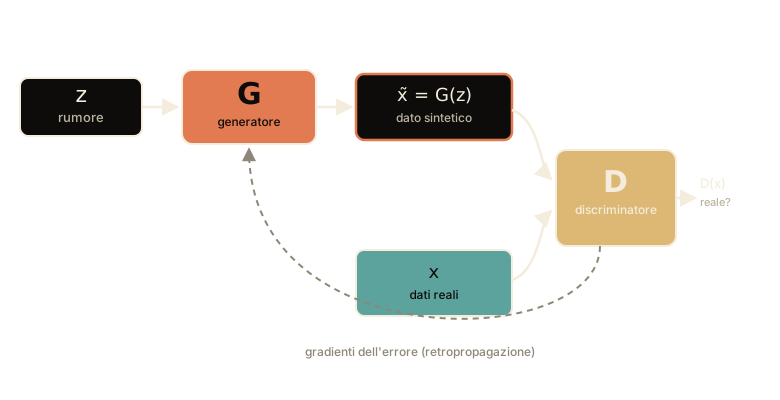
Fig. 26.2 Architettura di una GAN. Il generatore trasforma il rumore in un dato sintetico; il discriminatore riceve dati reali e dati sintetici e stima, per ciascuno, quanto è probabile che sia autentico. La freccia tratteggiata in basso è la correzione che dal giudizio torna indietro verso il generatore, e il suo nome tecnico è gradiente; quella con cui il discriminatore corregge sé stesso non è disegnata.#
Fra i dati reali e il generatore non passa nessuna freccia: \(G\) non li copia e non li confronta, e tutto ciò che sa dei dati gli arriva attraverso il gradiente di \(D\). È una scelta di progetto. Se \(G\) vedesse i campioni reali, il modo più semplice di ingannare \(D\) sarebbe riprodurne uno, e il modello restituirebbe i dati con cui è stato addestrato; tenuto lontano dai dati, \(G\) è costretto a generare. I dati entrano nel gioco da un lato solo, quello di \(D\), che a ogni passo è addestrato anche su campioni reali: nella funzione di valore è il termine \(\mathbb{E}_{\mathbf{x}\sim p_{\text{dati}}}[\log D(\mathbf{x})]\), l’unico in cui compaia \(p_{\text{dati}}\).
Se il falsario lavora bendato, la realtà da dove entra? Dall’esperto: a ogni turno, oltre ai falsi, gli si mostrano dei quadri autentici, e su quelli viene corretto. È l’unico momento in cui qualcuno, nella stanza, vede un quadro vero.
Quanto conti lo si capisce togliendolo. Un esperto allenato soltanto sui falsi impara una regola sola: «quello che fa il falsario è falso». Il falsario allora cambia maniera, e l’esperto boccia anche quella; il falsario ne prova un’altra, e così via. Si rincorrono per sempre su tutto il campo dei quadri possibili, e niente li tira verso i quadri veri, perché nessuno dei due ne ha mai visto uno. Rimesso al suo posto, il turno sui quadri autentici trasforma la rincorsa in una strada: l’esperto impara com’è fatto un quadro vero, e il falsario, inseguendo il suo «vero», va verso i quadri veri.
Il ruolo del termine sui dati si vede togliendolo. Senza \(\mathbb{E}_{\mathbf{x}\sim p_{\text{dati}}}[\log D(\mathbf{x})]\) la funzione di valore si riduce a \(\mathbb{E}_{\mathbf{z}\sim p_z}[\log(1 - D(G(\mathbf{z})))]\), che \(D\) massimizza ponendo \(D \equiv 0\) sul supporto di \(p_G\), libero altrove. Nessuna grandezza del gioco dipende più da \(p_{\text{dati}}\), e quindi nessun equilibrio, se esiste, ha ragione di stare in \(p_G = p_{\text{dati}}\); nella dinamica \(G\) insegue le regioni in cui \(D\) non è ancora nullo, e \(D\) le azzera appena \(G\) ci arriva. Con il termine, invece, il discriminatore ottimo è \(D^* = p_{\text{dati}}/(p_{\text{dati}} + p_G)\), come si ricava nel gioco minimax, e il gradiente che \(G\) riceve punta verso le regioni in cui \(p_{\text{dati}}\) prevale su \(p_G\).
Il gioco minimax#
La funzione di valore \(V(D,G)\) è quella del gioco a somma zero dell’apertura del capitolo, e qui la si guarda da dentro. Il nome minimax, contrazione di minimo e massimo, dice l’ordine in cui la si ottimizza: per ciascun generatore si considera il discriminatore migliore contro di lui, quello che porta \(V\) al massimo, e fra tutti i generatori si cerca quello per cui quel massimo è il più basso. Nel codice il minimax non si vede scritto da nessuna parte, perché le due reti si correggono un passo per volta: dice dove la partita andrebbe a finire, non come ci si arriva.
Il minimax si capisce con due numeri. Diciamo che il falsario possa scegliere fra due maniere di dipingere, e che contro la prima l’esperto migliore lo smascheri nove volte su dieci, contro la seconda sei su dieci. Il falsario non conta sull’esperto distratto: guarda, per ciascuna maniera, il peggio che gli può capitare, e sceglie la seconda, quella in cui il peggio è meno peggio. È il minimo dei massimi, e dà il nome al gioco.
I punti si segnano su un tabellone solo: l’esperto ne guadagna ogni volta che indovina, sui quadri autentici come sui falsi, e il falsario ogni volta che gliene fa perdere. Del tabellone il falsario ne tocca soltanto metà: sui quadri autentici l’esperto se la vede da solo, e l’unica cosa in potere del falsario è come vengono i propri quadri.
C’è poi un conto che dice che cosa il falsario sta davvero cercando di far scendere. Messo davanti all’esperto migliore possibile, il tabellone misura quanto i suoi quadri, presi tutti insieme, sono lontani dal mucchio di quelli veri, e tocca il fondo solo quando i due mucchi coincidono. Lì il gioco è in equilibrio, ed è il testa o croce dell’apertura: l’esperto può solo tirare a indovinare, cinquanta e cinquanta su ogni quadro. Vale per un esperto ideale, uno a cui è concesso qualunque criterio e una pazienza infinita; quello vero è una rete con un numero finito di pesi, e all’ideale ci somiglia soltanto fin dove ci arriva. Sapere dove sta il fondo, poi, non garantisce di arrivarci, e il duello vero a volte non ci arriva.
\(G\) e \(D\) giocano un gioco minimax sulla funzione di valore
Qui \(p_{\text{dati}}\) è la distribuzione dei dati reali, \(p_z\) il prior del rumore, \(D(\mathbf{x})\) la probabilità stimata di autenticità e \(G(\mathbf{z})\) il campione generato. \(D\) massimizza \(V\) (vuole \(D(\mathbf{x})\) grande sui reali e \(1-D(G(\mathbf{z}))\) grande sui falsi); \(G\) minimizza il secondo termine, l’unico che dipenda da lui (vuole \(D(G(\mathbf{z}))\to 1\)).
La dimostrazione di Goodfellow sta in due passaggi, e conviene rifarli per intero: il secondo è quello che dice che cosa una GAN stia davvero minimizzando, ed è un risultato che si cita spesso e si deriva di rado. Prima però le ipotesi, che non sono innocue: le due reti hanno capacità illimitata, cioè \(D\) è una funzione qualsiasi a valori in \([0,1]\) e non una rete con un numero finito di pesi, e le distribuzioni in gioco hanno densità rispetto alla stessa misura. Su quest’ultima conviene tenere un dito: nel caso vero è proprio lei a cadere, e la sezione sul duello che si inceppa ci torna sopra.
Primo passaggio: il discriminatore ottimo. Fissato \(G\), il secondo integrale si riscrive nello spazio dei dati invece che in quello del rumore, perché propagare \(\mathbf{z}\) attraverso \(G\) è esattamente ciò che definisce \(p_G\):
Ed è qui che serve l’ipotesi di capacità illimitata: poiché \(D\) non ha vincoli, l’integrale si massimizza massimizzando l’integrando punto per punto, cioè scegliendo per ogni \(\mathbf{x}\) separatamente il numero \(u = D(\mathbf{x}) \in [0,1]\) che rende massima \(a\log u + b\log(1-u)\), con \(a = p_{\text{dati}}(\mathbf{x})\) e \(b = p_G(\mathbf{x})\). Derivando in \(u\):
e la derivata seconda \(-a/u^2 - b/(1-u)^2\) è negativa, quindi quel punto è un massimo e non un minimo. Da cui
cioè proprio l’ottimo bayesiano della mistura descritta sopra. Il conto vale dove \(a+b>0\): fuori dall’unione dei due supporti l’integrando è nullo e \(D^*\) non è definito, ed è la ragione per cui tutti gli enunciati che seguono dicono «sul supporto dei dati» e non «ovunque».
Secondo passaggio: che cosa resta da minimizzare. Si sostituisce \(D^*\) in \(V\) e si chiama \(C(G) = V(D^*,G)\) ciò che rimane, funzione del solo generatore:
Il passaggio chiave è far comparire la mistura \(m = (p_{\text{dati}}+p_G)/2\), che si ottiene dividendo per \(2\) sopra e sotto dentro ciascun logaritmo: \(\frac{p}{p_{\text{dati}}+p_G} = \frac{1}{2}\cdot\frac{p}{m}\), e il fattore \(\tfrac12\) esce da ognuno dei due termini come un \(-\log 2\). Restano due divergenze di Kullback-Leibler:
dove l’ultima uguaglianza è la definizione stessa della divergenza di Jensen-Shannon, \(\mathrm{JSD}(p\,\|\,q) = \tfrac12\mathrm{KL}(p\,\|\,m) + \tfrac12\mathrm{KL}(q\,\|\,m)\). La \(\mathrm{JSD}\) è non negativa e si annulla se e solo se le due distribuzioni coincidono, quindi \(C(G)\) ha minimo globale \(-\log 4 \approx -1{,}386\) esattamente in \(p_G = p_{\text{dati}}\); e lì \(D^*(\mathbf{x})=\tfrac{1}{2}\) sul supporto dei dati, cioè l’esperto non sa più distinguere.
Questa però è una caratterizzazione dell’ottimo, non una promessa di arrivarci, e le due cose vanno tenute separate. La prova di convergenza del paper suppone che a ogni passo \(D\) raggiunga il proprio ottimo dato \(G\), e soprattutto che a muoversi sia la densità \(p_G\), dove \(V\) è convessa; nell’addestramento vero si muovono i parametri \(\theta_G\) di una rete, e lì la convessità che regge la dimostrazione non c’è più. Lo scrivono gli autori stessi, subito dopo la dimostrazione: usare un percettrone multistrato per definire \(G\) introduce molti punti critici nello spazio dei parametri, e le reti funzionano bene in pratica «despite their lack of theoretical guarantees».
Di questo gioco non esiste un fotogramma che lo racconti: quello che conta è il movimento, il falso che si avvicina al vero e l’esperto che perde terreno mentre succede. Fig. 26.3 lo mette in scena su un caso minuscolo, in sette tappe che si susseguono una dopo l’altra.
Il caso è minuscolo perché al posto delle immagini, che di puntini ne hanno milioni, ogni esempio è un numero solo: pensa all’altezza di una persona, o alla temperatura di un giorno. Così i dati si possono disegnare: si segna su una riga dove cade ciascun esempio e si guarda dove si ammucchiano. Ne viene una curva a campana, alta dove gli esempi sono fitti e bassa dove sono radi, che è la forma che prende quasi sempre un mucchio di misure: tanti valori vicini al centro, pochi agli estremi. Una campana per i dati veri, che sta ferma, e una per quelli del falsario, che si muove.

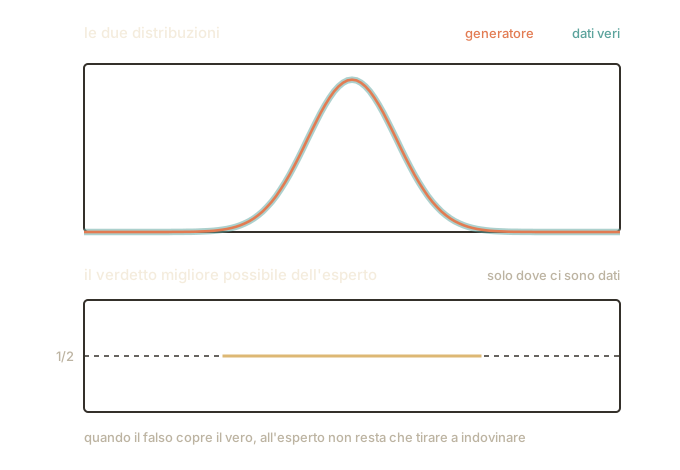
Fig. 26.3 Sopra: i dati veri stanno fermi, il generatore li insegue. Sotto: il verdetto migliore che l’esperto possa dare contro quel generatore. Finché le due campane sono separate il verdetto è netto; quando si sovrappongono diventa un mezzo dappertutto, cioè una moneta lanciata in aria.#
Il riquadro di sotto è il verdetto migliore possibile contro quel generatore, il discriminatore ottimo \(D^*(x) = p_{\text{dati}}(x)/\big(p_{\text{dati}}(x) + p_G(x)\big)\), e non un disegno fatto a mano: in ogni punto si prende l’altezza della curva vera e la si divide per la somma delle due altezze. Dove la curva vera è alta \(3\) e quella del generatore \(1\), il verdetto è \(3/(3+1) = 0{,}75\); dove cade solo roba vera il conto dà uno, dove cade solo roba falsa dà zero, dove le due curve sono alte uguali dà un mezzo. In ogni punto conta quindi quale delle due curve prevale, e di quanto, non quanto sono distanti fra loro i due picchi: dove le due curve sono alte uguali il verdetto sta a un mezzo anche se lì di esempi ne cadono pochissimi, e dove una prevale il verdetto si allontana da un mezzo anche se le due curve sono quasi sovrapposte.
Nell’animazione due cose si muovono insieme, e conviene guardarle una per volta.
La prima è il confine: il punto in cui il verdetto passa esattamente per il mezzo, cioè dove l’esperto smette di dire «falso» e comincia a dire «vero». All’inizio sta a sinistra, perché a sinistra il falsario è di casa; poi scivola verso destra mentre il falsario avanza.
La seconda è l’altezza della gobba, cioè quanto l’esperto è sicuro nel suo terreno migliore. Nella prima tappa la gobba arriva a \(0{,}93\), che è quasi certezza; nell’ultima è scesa a \(0{,}50\), che è nessuna certezza. Il confine si sposta e intanto la gobba si sgonfia, e quando la gobba tocca il mezzo il confine non c’è più, e non perché l’esperto abbia sbagliato posto: un posto giusto non esiste più.
La curva di sotto, infine, si ferma prima del bordo: dove non cade quasi nessun esempio, né vero né falso, non c’è niente da giudicare. Là fuori la regola un numero lo darebbe lo stesso, e direbbe «certamente falso» proprio dove non c’è niente.
Il pannello inferiore è \(D^*\) del passaggio precedente, valutato sulle due gaussiane del pannello superiore: i dati veri sono \(\mathcal{N}(0,\ 0{,}55^2)\) e stanno fermi, il generatore parte da \(\mathcal{N}(-1{,}75,\ 1{,}05^2)\) e raggiunge i dati in sette tappe, con media e deviazione standard interpolate linearmente. Due grandezze si muovono insieme.
Il punto di indifferenza, dove \(D^*=\tfrac12\) e quindi \(p_{\text{dati}}=p_G\): vale \(-0{,}80\), \(-0{,}72\), \(-0{,}63\), \(-0{,}53\), \(-0{,}42\), \(-0{,}29\) nelle prime sei tappe (il picco dei dati veri sta nell’origine), e alla settima non esiste più, perché le due densità coincidono ovunque. Due gaussiane di varianza diversa si incrociano in realtà in due punti, e il secondo cade attorno a \(x \simeq 2{,}1\): là però entrambe le densità sono dell’ordine di \(10^{-4}\), cioè fuori dal tratto disegnato.
Il massimo di \(D^*\), cioè la fiducia dell’esperto nel suo terreno migliore: \(0{,}93\), \(0{,}90\), \(0{,}87\), \(0{,}82\), \(0{,}74\), \(0{,}64\), \(0{,}50\). Il confine si sposta e il contrasto si appiattisce insieme a lui; all’ultima tappa \(D^*\) è la costante \(\tfrac12\), e di un confine non c’è più traccia.
La curva si ferma prima del bordo per la stessa ragione per cui la dimostrazione conclude \(D^*(\mathbf{x}) = \tfrac{1}{2}\) sul supporto dei dati: il rapporto fra due densità è definito ovunque, ma dove entrambe sono trascurabili non c’è niente da giudicare, e disegnarlo lì direbbe al lettore «certamente falso» in una regione vuota. La figura taglia dove la densità totale scende sotto \(0{,}02\).
L’addestramento alternato#
I due obiettivi tirano in direzioni opposte: quello che fa scendere l’errore di una rete lo fa salire all’altra. \(D\) e \(G\) si aggiornano allora a turni, con la discesa del gradiente stocastica: a ogni passo si calcola il gradiente della propria loss su un minibatch, un gruppetto di esempi estratti a caso, e si modificano i soli parametri della rete di turno, mentre quelli dell’altra restano fermi (il «congelamento»).
Le due loss del ciclo, loss_D e loss_G, sono la funzione di valore letta
dal lato di chi la deve far scendere, e d’ora in avanti «loss» vorrà dire
queste. Con una riserva: nel codice la riga con cui il generatore misura sé
stesso è scritta in una forma, la non-saturating loss, per cui loss_G non è
più l’esatto opposto di loss_D, e il gioco smette di essere a somma zero. La
ragione sta fra i dettagli del ciclo, dopo il codice.
Il ciclo completo sta in una ventina di righe. La variabile n è la
dimensione del minibatch di turno, che per l’ultimo di ogni giro può essere più
piccola delle altre (con \(1000\) esempi e minibatch da \(64\) l’ultimo ne contiene
\(40\)), e serve a preparare altrettante etichette «vero» e «falso»; opt_G,
opt_D e .detach() si spiegano dopo il codice.
import torch
from torch import nn

# G e D sono due nn.Module, ciascuno con il proprio allenatore
# (opt_G e opt_D): aggiornare l'uno non tocca i pesi dell'altro
criterio = nn.BCEWithLogitsLoss()        # il conto dell'errore (sigmoide dentro)

for epoca in range(n_epoche):
    for batch_reale in loader:
        n = batch_reale.size(0)          # quanti esempi ci sono in questo gruppo
        uni  = torch.ones(n, 1)          # etichette "reale"
        zeri = torch.zeros(n, 1)         # etichette "falso"

        # 1) Passo del discriminatore: distinguere reale da falso
        z = torch.randn(n, dim_rumore)   # rumore
        falsi = G(z).detach()            # campioni sintetici, staccati da G
        loss_D = (criterio(D(batch_reale), uni)   # spinge D(x) -> 1
                  + criterio(D(falsi), zeri))     # spinge D(G(z)) -> 0
        opt_D.zero_grad()
        loss_D.backward()
        opt_D.step()

        # 2) Passo del generatore: ingannare D (si aggiorna solo G)
        z = torch.randn(n, dim_rumore)
        loss_G = criterio(D(G(z)), uni)  # vuole D(G(z)) -> 1
        opt_G.zero_grad()
        loss_G.backward()
        opt_G.step()
Tre punti di questo ciclo meritano di essere guardati da vicino: che cosa esattamente torna indietro dall’esperto al falsario, come mai i due allenamenti non si mescolano, e una piccola astuzia sulla lezione impartita al generatore. Il ritorno è il meccanismo centrale del capitolo, e conviene partire da lì.
Che cosa torna indietro#
Quando l’esperto boccia un quadro, che cosa impara il falsario? Se ciò che torna indietro fosse il verdetto («falso»), non imparerebbe niente di utile: saprebbe di aver sbagliato, e basta.
Per una macchina un quadro è un elenco di numeri, uno per puntino, che dice quanto quel puntino è chiaro o scuro. Dipingere vuol dire scegliere quei numeri.
L’esperto, allora, è fatto in modo che gli si possa chiedere qualcosa di più fine di un giudizio, e cioè, per ogni singolo puntino del quadro: se questo puntino fosse un po’ più chiaro, il tuo giudizio salirebbe o scenderebbe, e di quanto? La risposta a quella domanda, posta per tutti i puntini insieme, è lunga quanto il quadro: per ciascun puntino, da che parte spostarlo e con quanta forza. È questo che torna indietro: l’esperto non dice «falso», dice «falso, e soprattutto per via di questo qui».
E qui l’inganno si capovolge. L’esperto risponde per i propri scopi: indica come cambierebbe il suo giudizio, che gli serve per smascherare. Il falsario prende la risposta e la percorre al contrario: dove l’esperto dice «se questo puntino fosse più chiaro mi insospettirei di più», il falsario lo scurisce, e usa contro l’esperto la mappa che l’esperto stesso gli ha dato.
Quell’elenco di spintarelle, una per puntino, si chiama gradiente, ed è la parola che si legge nelle figure e in ogni manuale: «i gradienti tornano indietro dal discriminatore al generatore» vuol dire esattamente questo.
Ed è anche la risposta alla domanda gemella: perché l’esperto dev’essere una rete, e non una persona o un elenco di regole? Una persona darebbe lo stesso verdetto, e magari un consiglio a parole («la firma non convince»); quello che non può dare è la lista. A un critico d’arte non si può chiedere di quanto spostare ciascuno dei due milioni di puntini di una fotografia. A una rete sì: è una formula, e la si costruisce apposta perché le si possa domandare come cambia il risultato se si muove un ingresso.
Resta un passaggio, ed è quello in cui il falsario impara davvero. L’elenco che gli arriva parla del quadro: dice come dovrebbe venire il prossimo. A lui serve invece sapere come cambiare sé stesso, cioè come ritoccare i propri pesi. Ma quel pezzo lo sa già per conto proprio, senza chiedere niente all’esperto: anche lui è una formula, e sa di quanto si muove ciascun puntino del quadro se ritocca un certo peso.
I due elenchi si compongono moltiplicando, ed è più facile con dei numeri inventati. Diciamo che schiarire di un’unità quel puntino faccia salire di \(2\) il giudizio dell’esperto, e che girare di un’unità un certo peso del falsario schiarisca quel puntino di \(3\): allora girare quel peso di un’unità fa salire il giudizio di \(2 \times 3 = 6\). Il falsario ha ottenuto quello che gli serviva, «di quanto conviene girare questo peso», ed è un conto in cui l’esperto ha messo il primo fattore e lui il secondo.
C’è una condizione nascosta, gemella di quella sull’esperto: il falsario deve dipingere, non scegliere. Il colore si stende un filo di più o un filo di meno, e il suo mezzo conto ha senso; con parole prese da un elenco, invece, un ritocco minuscolo a un peso o cambia la parola o non cambia niente, e quel secondo fattore non esiste più. Per questo le GAN sul testo sono sempre state faticose.
Le due loss, su un minibatch di \(m\) esempi reali \(\mathbf{x}_i\) e \(m\) rumori \(\mathbf{z}_i\), sono
la prima è l’opposto della stima di \(V\) sul minibatch, la seconda non è il secondo termine di \(V\) ma la sua forma non saturante, quella che usa il codice. La quantità che il passo di \(G\) propaga si scrive, per un campione, con la regola della catena, spezzata nel punto in cui le due reti si toccano (sul minibatch si somma sui campioni):
Il primo fattore è il gradiente della loss del generatore rispetto al dato generato, e vive nello spazio dei dati: ha una componente per ogni numero di \(\tilde{\mathbf{x}}\) (per un’immagine, una per pixel e per canale). È lì che sta la differenza fra un’informazione utile e un’informazione inutile: il verdetto \(D(\tilde{\mathbf{x}})\) è uno scalare, mentre \(\partial \mathcal{L}_G / \partial \tilde{\mathbf{x}}\) è un vettore che indica, componente per componente, in che verso spostare il dato perché il verdetto scenda, e quindi, percorso al contrario, in che verso spostarlo perché salga. Il secondo fattore è lo jacobiano del generatore rispetto ai propri parametri, e con \(D\) non ha niente a che vedere: è la parte che il falsario conosce già di sé.
Da qui discende un requisito di progetto, non un dettaglio di implementazione: \(D\) dev’essere derivabile rispetto al proprio ingresso. Un giudice umano, o un programma a regole, darebbe lo stesso verdetto e nessun vettore; la catena si spezzerebbe nel primo fattore e a \(G\) non arriverebbe niente. La stessa scomposizione spiega perché le GAN sui dati discreti (il testo, prima di tutto) siano sempre state faticose, e stavolta a cedere è l’altro fattore: se \(\tilde{\mathbf{x}}\) è una sequenza di simboli campionati, il secondo non esiste, e per aggirare la rottura servono stimatori a punteggio in stile REINFORCE o rilassamenti continui come Gumbel-softmax.
Un esempio minimo dà la misura della differenza fra le due informazioni. Il \(D\) giocattolo è una rete da quattro ingressi a un’uscita, il dato generato \(\tilde{\mathbf{x}}\) ha quattro componenti, e la loss è \(\mathcal{L}_G\) su quel solo campione, cioè la cross-entropy verso l’etichetta «reale»:
import torch
import torch.nn.functional as F
from torch import nn

torch.manual_seed(8)
D = nn.Sequential(nn.Linear(4, 8), nn.Tanh(), nn.Linear(8, 1))
# il dato generato, di cui si vuole il gradiente
x = torch.tensor([0.30, -0.70, 1.20, 0.10], requires_grad=True)
s = D(x)                                                    # il logit
loss_G = F.binary_cross_entropy_with_logits(s, torch.ones(1))  # verso "reale"
loss_G.backward()

print(f"verdetto D(x): {torch.sigmoid(s).item():.4f}")
print("gradiente su x:", " ".join(f"{g:+.4f}" for g in x.grad.tolist()))
x_nuovo = (x - 0.5 * x.grad).detach()                       # mezzo passo
print(f"verdetto dopo mezzo passo: {torch.sigmoid(D(x_nuovo)).item():.4f}")
verdetto D(x): 0.4098
gradiente su x: -0.0357 -0.0814 -0.0789 +0.1584
verdetto dopo mezzo passo: 0.4179
Il verdetto è un solo numero, \(0{,}4098\), che dice «propendo per il falso» e nient’altro. Il gradiente sullo stesso dato sono quattro numeri, e dicono di alzare le prime tre componenti e di abbassare nettamente la quarta. Muovendo il dato di mezzo passo in senso opposto al gradiente, cioè \(\tilde{\mathbf{x}} \leftarrow \tilde{\mathbf{x}} - 0{,}5\,\partial \mathcal{L}_G / \partial \tilde{\mathbf{x}}\), il verdetto sale a \(0{,}4179\): poco, perché il passo è piccolo, ma nella direzione voluta, e senza che nessuno abbia mai mostrato al generatore un dato autentico.
Che \(D\) restituisca a \(G\) un gradiente e non un verdetto serve per tutto quello che segue, perché i guasti dei duelli che si inceppano sono guasti di quel gradiente. A volte si assottiglia fino a sparire (i gradienti che svaniscono, in inglese vanishing gradients) e il generatore non sa più da che parte andare; altre volte diventa grande e cambia direzione da un passo all’altro, e l’aggiornamento si fa instabile. Anche uno dei rimedi, il gradient penalty, agisce sul gradiente di \(D\) rispetto al suo ingresso e non sul verdetto: penalizza il discriminatore quando la norma di quel gradiente si allontana da uno, in su o in giù.
Gli altri due dettagli#
Primo dettaglio. Nel codice, il lavoro di girare i pesi non lo fa la rete: lo
fa un pezzo di programma attaccato a lei, che si chiama allenatore (opt_G
per il falsario, opt_D per l’esperto). Sono la mano del falsario e la mano
dell’esperto, non due personaggi nuovi della storia: prendono le correzioni
calcolate e le applicano. Ciascuno conosce soltanto i pesi della propria rete,
ed è questo a garantire che ciascuna rete impari solo nel proprio turno: è il
«congelamento» dei pesi.
Nel codice, dove si mostrano i falsi all’esperto, compare la parola
.detach(). Non serve a separare i due allenamenti, a quello bastano i due
allenatori. Serve a non far preparare al programma, mentre studia l’esperto,
anche le correzioni per il falsario, che in quel turno nessuno userebbe: su
reti grandi è un bel risparmio. Con le righe del ciclo nell’ordine scritto il
risultato è lo stesso con o senza; se qualcuno le rimescolasse, quella parola
diventerebbe necessaria.
Secondo dettaglio: nel suo turno, il falsario misura il proprio errore come se i suoi falsi dovessero risultare autentici, e impara da quanto il verdetto se ne discosta. Non sta corrompendo l’arbitro, che infatti non se ne accorge: sta scegliendo con che metro misurare sé stesso. Detta così sembra una sfumatura, e invece cambia la domanda che si fa all’esperto. Non più «quanto è falso questo quadro?», ma «quanto manca perché passi per vero?».
Le due domande si comportano in modo diverso proprio dove serve. La correzione, lo abbiamo appena visto, è di quanto il voto cambierebbe, non il voto. Se l’esperto è sicurissimo che il quadro sia falso, il suo giudizio è schiacciato contro il fondo della scala e non può scendere oltre: un ritocco al quadro non lo sposta di una virgola, e alla prima domanda la risposta è sempre la stessa, «del tutto». Un principiante corretto così è come uno studente che prende zero a ogni compito senza mai sapere quale zero fosse meno grave: non ha modo di capire se l’ultimo ritocco andava nella direzione giusta.
La seconda domanda un fondo non ce l’ha, e si vede con due numeri. Supponiamo che l’esperto dia al quadro una probabilità di essere autentico di \(1\) su \(100\), e che un ritocco la porti a \(2\) su \(100\). Per la prima domanda non è successo quasi niente: da «falso al \(99\) per cento» a «falso al \(98\) per cento», un centesimo di scarto. Per la seconda il quadro ha appena raddoppiato le proprie probabilità, ed è un passo avanti enorme. Stesso ritocco, stesso esperto: cambia solo quale delle due domande gli si fa, e la seconda continua a distinguere anche laggiù in fondo, dove la prima ha smesso.
A rigore non è più lo stesso gioco. Il falsario non sta più cercando di far scendere il punteggio che l’esperto fa salire: ne insegue uno suo, e il tabellone unico non basta più a raccontare tutti e due i giocatori. Il trucco è già suggerito nell’articolo del 2014; il prezzo si paga quando il duello si inceppa.
La separazione fra i due allenamenti la garantiscono i due ottimizzatori:
opt_D non conosce i parametri di \(G\) e viceversa, quindi nessuno dei due passi
può toccare i pesi dell’altra rete. Il .detach() nel passo di \(D\) aggiunge un
risparmio: stacca i campioni sintetici dal grafo di \(G\), così il gradiente
attraverso il generatore non viene nemmeno calcolato. In questo ciclo, senza
.detach(), quel gradiente verrebbe calcolato, si depositerebbe in .grad e
sarebbe poi azzerato da opt_G.zero_grad() prima di essere usato: il risultato numerico è identico, pesi finali di \(G\) compresi, ma su una rete
grande si paga un passaggio all’indietro intero per niente. Attenzione
però che l’innocuità dipende dall’ordine delle righe: in una variante che
azzeri i gradienti in cima all’iterazione, o che legga .grad fra i due passi,
.detach() torna necessario.
C’è poi una scelta nascosta nella riga criterio(D(G(z)), uni), ed è la
formulazione che si usa nelle implementazioni con perdita logistica, come
questa (la Wasserstein GAN e le GAN con perdita hinge, come SAGAN e BigGAN,
ne usano altre): chiedere che i falsi siano etichettati «reale» equivale a
massimizzare \(\log D(G(\mathbf{z}))\), invece di minimizzare
\(\log(1-D(G(\mathbf{z})))\) come nella formula minimax. È la non-saturating
loss, già suggerita nel paper del 2014, e il motivo per cui la si preferisce
sta tutto in una derivata.
Sia \(s\) il logit che \(D\) produce sul campione falso, cosicché \(D(G(\mathbf{z})) = \sigma(s)\). Scritte entrambe come qualcosa da minimizzare, le due perdite del generatore sono \(\mathcal{L}^{\text{sat}} = \log\big(1-\sigma(s)\big)\) e \(\mathcal{L}^{\text{ns}} = -\log \sigma(s)\); ricordando che \(\sigma' = \sigma(1-\sigma)\), i due fattori di \(\sigma'\) si semplificano in modi opposti e restano
Le due spingono nello stesso verso (verso \(s\) grande, cioè \(D(G(\mathbf{z}))\to 1\)), ma con forze che agli estremi si scambiano. Quando \(G\) è pessimo e \(D\) lo smaschera, diciamo \(D(G(\mathbf{z})) = 0{,}01\), la prima ha modulo \(0{,}01\) e la seconda \(0{,}99\): novantanove volte più grande. In generale il rapporto fra le due vale \((1-\sigma)/\sigma = e^{-s}\) e cresce senza limite man mano che \(D\) si convince, mentre all’equilibrio \(\sigma=\tfrac12\) le due coincidono. La loss minimax non è debole in generale, quindi: è debole proprio dove servirebbe di più, all’inizio dell’addestramento, ed è il senso della frase con cui il paper la liquida: «same fixed point», ma «much stronger gradients early in learning».
Non sono però lo stesso gioco: con questa formulazione il gioco non è più a somma zero e non si lascia più scrivere con un’unica funzione di valore, come nota Goodfellow stesso nel proprio tutorial [Goo17]. Arjovsky e Bottou [AB17] mostrano che, se le due distribuzioni hanno densità e il discriminatore è quello ottimo \(D^*\), calcolato per il valore corrente di \(\theta_G\) e tenuto fisso mentre si deriva, il valore atteso del gradiente che il generatore riceve con questa loss è
una divergenza di Kullback-Leibler rovesciata, più un termine che spinge le due distribuzioni ad allontanarsi. L’ipotesi delle densità è la stessa che cade quando i supporti sono disgiunti, e il risultato torna nel mode collapse.
Quando il duello si inceppa#
Sulla carta il meccanismo è pulito: due reti, un punteggio, un equilibrio verso cui tendere. Nella pratica le GAN si sono guadagnate la fama di essere fra le reti più difficili da addestrare, e tre problemi ricorrono.
Instabilità. I due giocatori si rincorrono senza mai fermarsi: migliora uno, l’altro peggiora, e il punteggio oscilla invece di stabilizzarsi. Il falsario ritocca i quadri per piacere all’esperto di adesso, ma al turno dopo l’esperto è cambiato, e il ritocco che prima lo convinceva ora lo insospettisce. Nessuno dei due ha davanti un bersaglio fermo, perché ciascuno sposta quello dell’altro, e i due possono allontanarsi o girare in tondo. La corsa agli armamenti in cui si perfezionano a vicenda è quella che arriva in fondo; questa è quella che non ci arriva.
Conta poi quanto sono bravi l’uno rispetto all’altro. Quando l’esperto è molto più bravo del falsario si paga il prezzo annunciato poco fa: la domanda «quanto manca perché il quadro passi per vero?» tiene viva la correzione anche quando il falsario è pessimo, ma risponde ogni volta «moltissimo», e correzioni tutte grandi e tutte diverse fra loro lo fanno oscillare invece di guidarlo. Un esperto troppo ingenuo, all’opposto, si lascia convincere da tutto, e al falsario non dice niente su che cosa correggere.
C’è poi un guasto che non dipende da quanto si è allenato l’esperto. Il falsario parte da un centinaio di numeri e deve riempire milioni di puntini: tutti i quadri che sa fare si descrivono con quel centinaio di numeri, e fra tutti i quadri possibili sono pochissimi, come i punti di un filo teso dentro una stanza. Anche i quadri veri, quelli che hanno un senso, sono pochissimi (o almeno così si suppone): un altro filo. E due fili tesi in una stanza quasi mai si toccano. All’esperto basta allora un dettaglio che nessun falso ha mai, e li boccia tutti con la stessa sicurezza, venuti quasi bene o malissimo: la domanda «è autentico?» non registra più i progressi del falsario, e alternare meglio i turni non ci mette rimedio. Per uscirne bisogna cambiare domanda, e chiedere quanto distano i due mucchi di quadri, quello dei veri e quello dei falsi.
Mode collapse. Il falsario scopre un solo falso che inganna sempre l’esperto e si limita a rifarlo. Risultato: \(G\) genera sempre la stessa immagine (o pochissime varianti), buttando via tutta la varietà dei dati reali. A turni, il falsario risponde all’esperto che ha davanti in quel momento, e contro un esperto fermo la mossa migliore è proprio quella: il quadro che lui crede più vero, ripetuto. La causa precisa del guasto, però, è ancora discussa. Una spiegazione dà la colpa al metro con cui il falsario misura il proprio errore, che gli fa pagare carissimo un quadro implausibile e quasi niente un soggetto lasciato perdere; ma lo stesso guasto si presenta anche con un metro che i soggetti persi li fa pagare cari, e il metro, da solo, non basta a spiegarlo.
Mancata convergenza. È il più insidioso dei tre, perché da fuori non sembra un guasto: il duello gira regolarmente e non arriva da nessuna parte, le immagini cambiano a ogni turno senza peggiorare né migliorare, e non viene mai il momento di dire «ecco, è finito». Succede già nel caso più piccolo che si possa scrivere: un solo quadro vero, un falsario che sa dipingere un quadro solo e può soltanto spostarlo più a destra o più a sinistra, un esperto con un unico criterio, «più a destra è più falso» oppure il contrario. Quando il falsario sta a destra del quadro vero l’esperto impara a sospettare della destra, e il falsario si sposta a sinistra; appena lo supera l’esperto si gira, e il falsario torna indietro. Si girano attorno come due ballerini, senza avvicinarsi mai. Quanto sono lunghi i passi lo decide chi addestra, prima di cominciare: con passi corti il giro resta quello, con passi troppo lunghi si allarga. Il rimedio è una multa all’esperto quando il suo giudizio, proprio sul quadro vero, cambia bruscamente da un punto all’altro: con la multa, e passi abbastanza corti, il giro si stringe e i due si fermano sul quadro vero.
Instabilità. L’ottimizzazione simultanea di un gioco minimax non equivale a minimizzare una singola funzione: la dinamica può divergere o entrare in cicli limite. Se \(D\) diventa troppo accurato si ha \(D(G(\mathbf{z}))\to 0\), e con l’obiettivo minimax originale questo annulla i gradienti verso \(G\) (vanishing gradients); la non-saturating loss vista sopra scongiura l’annullamento, ma con un discriminatore quasi ottimo lo paga in aggiornamenti instabili e ad alta varianza [AB17]. Se invece \(D\) è troppo debole, non fornisce segnale utile.
Che \(D\) diventi «troppo accurato» non è però un incidente di dosaggio, ed è un punto che cambia il rimedio. Arjovsky e Bottou mostrano che \(p_G\), essendo l’immagine di uno spazio di rumore a poche decine o centinaia di dimensioni, vive su una varietà di dimensione bassa immersa nello spazio dei dati: con \(\mathbf{z} \in \mathbb{R}^{100}\) e immagini \(1024\times1024\) a colori, il supporto di \(p_G\) ha dimensione al più \(100\) dentro \(\mathbb{R}^{3\,145\,728}\). Supponi che anche \(p_{\text{dati}}\) stia su una varietà di dimensione bassa. È l’ipotesi della varietà, che Arjovsky e Bottou assumono senza dimostrarla, e chiede ai dati di starci sopra, non soltanto vicino. In quel caso due varietà così, salvo allineamenti perfetti, hanno supporti quasi certamente disgiunti, o che si intersecano in un insieme di misura nulla. Su supporti disgiunti un discriminatore perfetto esiste, e la \(\mathrm{JSD}\) vale \(\log 2\) qualunque sia la distanza fra le due distribuzioni. Il gradiente è nullo, e non soltanto piccolo, e resta nullo mentre \(G\) si avvicina. Ed è qui che si chiude il cerchio con le ipotesi del teorema: il conto che dava \(2\,\mathrm{JSD}\) presupponeva due densità, e un generatore vero una densità non ce l’ha. La caratterizzazione dell’ottimo resta vera; è il mondo in cui vale a non essere quello dell’addestramento. Alternare meglio i turni non lo risolve, ed è da qui che nasce l’idea di cambiare misura, cioè la Wasserstein GAN.
Mode collapse. \(G\) mappa molti \(\mathbf{z}\) diversi su una stessa uscita \(\tilde{\mathbf{x}}\): \(p_G\) collassa su pochi modi di \(p_{\text{dati}}\). Sembra un paradosso, visto che l’obiettivo ideale ha minimo solo in \(p_G = p_{\text{dati}}\) e la \(\mathrm{JSD}\) i modi mancanti li paga eccome; la spiegazione è che l’addestramento non sta ottimizzando quell’obiettivo. Da un lato conta l’ordine dei quantificatori [Goo17]: la soluzione di \(\max_D \min_G\) è esattamente il generatore che manda ogni \(\mathbf{z}\) sul punto che \(D\) crede più reale, e la discesa alternata non privilegia \(\min_G \max_D\) sull’altro ordine. Dall’altro c’è la loss non-saturating: il gradiente che \(G\) riceve da un \(D\) ottimo è quello di \(\mathrm{KL}(p_G \,\|\, p_{\text{dati}}) - 2\,\mathrm{JSD}\), e quella KL addebita un costo enorme a un campione implausibile (\(p_G > 0\) dove \(p_{\text{dati}} \approx 0\)) e un costo che tende a zero a un modo abbandonato (\(p_{\text{dati}} > 0\) dove \(p_G \approx 0\)). Arjovsky e Bottou [AB17] ne ricavano una spiegazione del collasso; ma è un’interpretazione e non una dimostrazione, e il tutorial di Goodfellow la contesta su due fatti. Le GAN addestrate a massima verosimiglianza, cioè a minimizzare la KL diretta che i modi abbandonati li fa pagare, producono campioni altrettanto nitidi e scelgono altrettanto pochi modi; e il generatore ne sceglie spesso meno di quanti la sua capacità gli permetterebbe, mentre la KL rovesciata preferisce coprirne quanti più può. Ne conclude che il collasso dipende da un difetto della procedura di addestramento più che dalla divergenza minimizzata. La causa precisa resta una questione aperta.
Mancata convergenza. L’equilibrio di Nash del gioco non è garantito raggiungibile con la discesa del gradiente, e il controesempio sta in due parametri. Nella Dirac-GAN di Mescheder, Geiger e Nowozin [MGN18] i dati sono un solo punto, \(p_{\text{dati}} = \delta_0\), il generatore ne produce uno solo, \(p_G = \delta_\theta\), e il discriminatore ha il logit lineare \(s(x) = \psi x\). Nella forma degli autori la funzione di valore è \(V(\theta,\psi) = f(\psi\theta) + f(0)\), con \(f(t) = -\log(1+e^{-t})\), che \(D\) massimizza e \(G\) minimizza. Il campo dei gradienti \(v(\theta,\psi) = \big(-\psi f'(\psi\theta),\ \theta f'(\psi\theta)\big)\) ha l’unico equilibrio in \((0,0)\), dove lo jacobiano ha autovalori \(\pm i\,f'(0) = \pm i/2\), sull’asse immaginario. In tempo continuo le traiettorie conservano \(\theta^2 + \psi^2\), cioè girano attorno all’equilibrio senza avvicinarsi; con la discesa simultanea la norma degli iterati cresce a ogni passo, per qualunque learning rate; con quella alternata gli autovalori dell’aggiornamento stanno sul cerchio unitario finché il passo è piccolo, ne escono quando è grande, e gli autori la osservano oscillare in cicli stabili. La penalità sul gradiente del discriminatore nei soli dati reali, \(R_1 = \tfrac{\gamma}{2}\,\mathbb{E}_{\mathbf{x}\sim p_{\text{dati}}} \lVert\nabla_{\mathbf{x}} s(\mathbf{x})\rVert^2\), qui vale \(\tfrac{\gamma}{2}\psi^2\) e sposta gli autovalori in \(-\tfrac{\gamma}{2} \pm \sqrt{\gamma^2/4 - f'(0)^2}\), a parte reale negativa per ogni \(\gamma > 0\): con passi abbastanza piccoli le due discese convergono. Gli autori estendono il risultato alla convergenza locale di una GAN generale regolarizzata con \(R_1\), sotto ipotesi sull’equilibrio (fra cui \(p_G = p_{\text{dati}}\) e un logit nullo attorno al supporto dei dati). È la penalità che usano StyleGAN, con \(\gamma = 10\), e StyleGAN2.
La loss non dice niente: come si misura una GAN#
C’è una domanda che a questo punto è inevitabile, e la risposta non è affatto ovvia: come si fa a sapere se sta funzionando?
In tutto il resto del libro la risposta è la stessa: si guarda la loss su un mucchietto di esempi tenuti da parte apposta, e se scende va bene. Qui non funziona, per un motivo strutturale. Le due loss non misurano la qualità: misurano chi dei due sta vincendo in questo momento. Se la loss del generatore scende può voler dire che genera meglio, oppure soltanto che il discriminatore si è indebolito. Al punto di equilibrio teorico, quando i falsi sono perfetti, il discriminatore tira a indovinare e le loss si assestano su valori che non distinguono un capolavoro da un disastro. Guardare le immagini a occhio, per contro, non regge sui numeri veri (nessuno esamina a una a una cinquantamila immagini) e soprattutto non vede il mode collapse: mille immagini bellissime e tutte uguali, se le si guarda una per volta, sembrano un successo.
Si può controllare. Si prende quel ciclo, riga per riga, e gli si dà un compito minuscolo di cui si conosce la risposta: generare punti del piano distribuiti come una mistura di otto gaussiane, disposte in cerchio e ben separate, così che si possa contare quante gaussiane il generatore ha imparato e quanti dei suoi punti ci cadono vicino.
Al posto delle immagini, punti su un foglio: quattromila, raccolti attorno a otto mucchietti disposti in cerchio come le ore di un orologio a otto ore. Ogni mucchietto è stretto, i suoi punti cadono quasi tutti entro \(0{,}15\) dal proprio centro, mentre da un centro al successivo ci sono circa \(1{,}5\): otto isolotti ben separati, che da lontano si contano a occhio. Il falsario deve imparare a produrre punti che sembrino usciti da lì, partendo da due soli numeri tirati a sorte.
Il vantaggio di un compito così è che permette di contare quello che su un volto non si potrebbe contare. Si fa generare al falsario un mucchio di punti suoi, e si guardano due cose: quanti di quei punti sono a segno, cioè cadono dentro un isolotto, e quanti isolotti ha imparato. Un isolotto conta come coperto se ci finisce almeno l’uno per cento dei punti del falsario: è una soglia larga, perché uno che li avesse imparati bene tutti e otto ne metterebbe in ciascuno un ottavo, il dodici e mezzo per cento, quindi un isolotto non coperto è proprio abbandonato, non servito male. Le correzioni sono piccole, che è il modo di tenere a bada l’instabilità, e l’esperimento si ripete quattro volte, cambiando soltanto il numero da cui parte il sorteggio.
I dati sono \(4000\) campioni di
e due medie adiacenti distano \(4\sin\tfrac{\pi}{8} \approx 1{,}53\), una trentina di deviazioni standard. Un punto generato è a segno se dista meno di \(0{,}15 = 3\sigma\) dalla media più vicina: per una gaussiana isotropa nel piano la distanza dalla media segue una legge di Rayleigh, e la frazione entro \(3\sigma\) è \(1 - e^{-9/2} \approx 98{,}9\%\), la quota di un generatore perfetto. Un modo è coperto se almeno l’\(1\%\) dei punti generati è a segno attorno alla sua media, contro il \(12{,}5\%\) di una copertura uniforme. \(G\) e \(D\) sono percettroni con due strati nascosti da \(128\) unità e LeakyReLU, \(\mathbf{z} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}_2)\), l’ottimizzatore è Adam con learning rate \(2\cdot10^{-4}\) su minibatch da \(256\), le epoche sono \(400\), la loss di \(G\) è quella non saturante, e i semi vanno da \(0\) a \(3\). Con \(\mathbf{z}\) gaussiano e \(G\) continuo il supporto di \(p_G\) è connesso: per raggiungere otto isole separate il generatore deve lasciare dei punti nei corridoi fra l’una e l’altra, e al \(98{,}9\%\) può solo avvicinarsi, con transizioni sempre più ripide.
# pt-lento: quattro addestramenti da quattrocento giri, circa un minuto su CPU
import math
import torch
from torch import nn

torch.set_num_threads(1)
angoli = torch.arange(8) * 2 * math.pi / 8
centri = torch.stack([2 * torch.cos(angoli), 2 * torch.sin(angoli)], 1)


def rete(ingressi, uscite):
    return nn.Sequential(nn.Linear(ingressi, 128), nn.LeakyReLU(0.2),
                         nn.Linear(128, 128), nn.LeakyReLU(0.2),
                         nn.Linear(128, uscite))


def giudica(G):
    """Mucchietti coperti (almeno l'1% dei punti) e quota di punti a segno."""
    with torch.no_grad():
        distanze = torch.cdist(G(torch.randn(5000, 2)), centri).min(1)
    a_segno = distanze.values < 0.15
    coperti = sum(bool((a_segno & (distanze.indices == k)).float().mean() >= 0.01)
                  for k in range(8))
    return coperti, a_segno.float().mean().item()


criterio = nn.BCEWithLogitsLoss()
for seme in range(4):
    torch.manual_seed(seme)
    dati = centri[torch.randint(0, 8, (4000,))] + 0.05 * torch.randn(4000, 2)
    G, D = rete(2, 2), rete(2, 1)
    opt_G = torch.optim.Adam(G.parameters(), lr=2e-4)
    opt_D = torch.optim.Adam(D.parameters(), lr=2e-4)
    for giro in range(400):
        somme = [0.0, 0.0]
        for batch_reale in dati[torch.randperm(4000)].split(256):
            n = batch_reale.size(0)
            uni, zeri = torch.ones(n, 1), torch.zeros(n, 1)
            falsi = G(torch.randn(n, 2)).detach()
            loss_D = criterio(D(batch_reale), uni) + criterio(D(falsi), zeri)
            opt_D.zero_grad(); loss_D.backward(); opt_D.step()
            loss_G = criterio(D(G(torch.randn(n, 2))), uni)
            opt_G.zero_grad(); loss_G.backward(); opt_G.step()
            somme[0] += loss_D.item() * n; somme[1] += loss_G.item() * n
        if giro in (0, 399):
            coperti, quota = giudica(G)
            print(f"seme {seme}, giro {giro + 1:>3}: loss_D {somme[0] / 4000:.2f}  "
                  f"loss_G {somme[1] / 4000:.2f}  coperti {coperti}/8  "
                  f"a segno {quota:.0%}")
seme 0, giro   1: loss_D 1.30  loss_G 0.70  coperti 0/8  a segno 0%
seme 0, giro 400: loss_D 1.26  loss_G 0.92  coperti 8/8  a segno 77%
seme 1, giro   1: loss_D 1.32  loss_G 0.72  coperti 0/8  a segno 0%
seme 1, giro 400: loss_D 1.29  loss_G 0.91  coperti 8/8  a segno 78%
seme 2, giro   1: loss_D 1.31  loss_G 0.70  coperti 0/8  a segno 0%
seme 2, giro 400: loss_D 1.31  loss_G 0.84  coperti 8/8  a segno 82%
seme 3, giro   1: loss_D 1.33  loss_G 0.73  coperti 0/8  a segno 0%
seme 3, giro 400: loss_D 1.25  loss_G 0.94  coperti 8/8  a segno 76%
Il conto dell’errore ha un valore di riferimento. Se l’esperto non sapesse distinguere niente e rispondesse «metà e metà» a qualunque quadro, il falsario avrebbe un conto di \(0{,}69\), quello di chi tira a indovinare, e l’esperto il doppio, \(1{,}39\), perché lui è giudicato due volte, su un vero e su un falso.
Al primo giro il falsario non ha imparato niente (nessun isolotto coperto, nessun punto a segno), eppure il suo conto è basso, fra \(0{,}70\) e \(0{,}73\), proprio lì attorno: non perché il gioco sia in parità, ma perché al primo giro anche l’esperto non sa ancora niente e risponde più o meno a caso. Quattrocento giri dopo, in tutti e quattro gli addestramenti il falsario copre gli otto isolotti, e il suo conto è più alto, fra \(0{,}84\) e \(0{,}94\): nel frattempo l’esperto è diventato bravo. Chi tenesse il falsario dal conto più basso terrebbe quello del primo giro, buono a niente.
Dal conto del falsario si ricava anche un minimo garantito di quanto l’esperto crede veri i suoi falsi: con \(0{,}84\) almeno il quarantatré per cento, con \(0{,}94\) almeno il trentanove. E fra un addestramento e l’altro il conto più basso (\(0{,}84\)) va col falsario che fa più centri (l’\(82\%\)), il più alto (\(0{,}94\)) con quello che ne fa meno (il \(76\%\)). Quattro prove però sono poche per farne una regola, e due stanno quasi alla pari. Soprattutto, nessuno dei conti dice quanto manca: un falsario perfetto farebbe centro quasi sempre, e qui siamo attorno a otto volte su dieci.
Le loss sono in nat. Un discriminatore che rispondesse \(\tfrac12\) a ogni ingresso pagherebbe \(\ln 2 \approx 0{,}693\) per decisione: \(\mathcal{L}_D = 2\ln 2 \approx 1{,}386\), un termine sui reali e uno sui generati, e \(\mathcal{L}_G = \ln 2\). Dalla loss del generatore si ricava un limite sulla grandezza che interessa, quanto \(D\) crede veri i falsi: per la disuguaglianza di Jensen \(\mathcal{L}_G = \mathbb{E}[-\log D(G(\mathbf{z}))] \ge -\log \mathbb{E}[D(G(\mathbf{z}))]\), quindi \(\mathbb{E}[D(G(\mathbf{z}))] \ge e^{-\mathcal{L}_G}\), cioè almeno \(0{,}43\) con \(\mathcal{L}_G = 0{,}84\) e almeno \(0{,}39\) con \(0{,}94\).
Dentro ciascun addestramento \(\mathcal{L}_G\) è più alta all’ultimo giro che al primo, mentre i modi coperti passano da \(0\) a \(8\): al primo giro \(D\) è vicino a una costante, e \(\mathcal{L}_G\) sta attorno a \(\ln 2\) per questo, non per una parità raggiunta. La loss misura la posizione relativa dei due giocatori, e un arresto sul minimo di \(\mathcal{L}_G\) sceglierebbe il generatore peggiore. Fra un addestramento e l’altro l’ordine delle quattro \(\mathcal{L}_G\) finali è l’inverso di quello delle quote a segno; ma con quattro punti un ordine perfetto ha probabilità \(1/4! \approx 4\%\) anche in assenza di qualunque relazione, e due valori distano \(0{,}01\) di loss e un punto di quota. Basta a sospettare una tendenza, non a usare \(\mathcal{L}_G\) per confrontare la qualità di due addestramenti. Su un’altra macchina, poi, le cifre possono cambiare: un processore diverso somma in un altro ordine, e in un addestramento avversario un ultimo bit diverso porta la traiettoria altrove, come un seme nuovo. Nessuna delle loss, infine, dice quanto manca: i quattro generatori sono attorno all’\(80\%\) di punti a segno, contro il \(98{,}9\%\) di quello perfetto.
Resta da dire che cosa questo esperimento non mostra. Il collasso vero e proprio, il generatore chiuso su uno o due mucchietti, con queste reti piccole e otto mucchietti ben separati non si presenta: in queste quattro prove sono coperti tutti e otto. È il guasto più temuto delle GAN, e per vederlo servono compiti più duri; il punto qui è un altro, e i numeri lo reggono da soli: dentro un addestramento le loss non misurano la qualità, misurano chi dei due sta vincendo in quel momento, e nessuna dice quanto si è lontani dalla meta.
Serve una misura che giudichi un insieme di immagini invece di una sola: in gergo, la loro distribuzione, cioè come si spartiscono fra i vari tipi possibili, quanti gatti e quanti cani e in quali pose, non soltanto se ciascuna presa da sé è venuta bene. La strada che si è imposta è obliqua: usare una rete già addestrata a riconoscere immagini (storicamente Inception, addestrata su ImageNet) come strumento di misura.
Il primo tentativo, l’Inception Score, chiede due cose insieme a un giudice esterno che sa riconoscere gli oggetti. E qui attenzione, perché entra in scena un personaggio nuovo, ed è un giudice terzo e non l’esperto d’arte del duello: una rete addestrata altrove a riconoscere cani, automobili e divani, che con la nostra partita non c’entra niente e non ha nessun interesse a farla finire in un modo o nell’altro. Il falsario e l’esperto restano dove sono; questo signore arriva a cose fatte e guarda i risultati.
Primo: guardando una singola immagine generata, il giudice deve saper dire con sicurezza cos’è («questo è un cane», non «forse un cane, forse un divano»); se esita, l’immagine è informe. Secondo: guardando tutte le immagini generate insieme, deve trovarci soggetti diversi; se sono tutti cani, c’è mode collapse. Un punteggio alto significa immagini nitide e varie.
Il difetto salta all’occhio appena lo si dice: in questa misura le immagini vere non entrano mai. Un generatore potrebbe produrre cani nitidi e assortiti che non somigliano a nessun cane esistente, e prendere un bel voto.
Il FID ripara proprio questo, e comincia da un’osservazione su come lavora il giudice. Una rete che riconosce oggetti non salta dall’immagine al nome in un colpo: ci arriva per gradini, e a ogni gradino l’immagine è diventata una lista di numeri più corta e più riassuntiva di quella di prima (prima i contorni, poi le parti, poi le cose). L’ultima lista prima del nome descrive l’immagine senza ancora nominarla, ed è quella che qui interessa: invece di chiedere al giudice come si chiama l’oggetto, gli si sbircia dentro e ci si prende quei numeri.
Da lì al disegno di una nuvola il passo è breve. Immagina che quei numeri siano due soltanto: allora ogni immagine diventa un punto su un foglio, come una città su una cartina, e mille immagini fanno mille punti. Immagini che si somigliano finiscono vicine, immagini diverse lontane, e l’insieme dei punti forma una macchia con una sua posizione e una sua forma: la nuvola. I numeri veri sono più di due (duemila e passa), il foglio quindi non si può disegnare, ma i conti si fanno lo stesso e la nuvola c’è.
Una nuvola per le immagini vere, una per quelle generate. Se le due nuvole si sovrappongono, il generatore ha imparato; se stanno in due posti diversi, no; e se quella generata è molto più stretta dell’altra, il generatore sta ripetendo poche cose. Il FID è la distanza fra le due nuvole, e più è basso, meglio è. (Le tre lettere stanno per Fréchet Inception Distance: Inception è il nome del giudice, la distanza è quella fra le due nuvole, e Fréchet è il matematico che ha definito il modo di misurarla.)
Con un’avvertenza da mettere subito accanto a quel «più è basso, meglio è»: di una nuvola il conto guarda soltanto dove sta il suo centro e quanto è larga. Due arcipelaghi, allora, con lo stesso centro e la stessa larghezza ma fatti in modo diverso: due isole lontane da una parte, un’unica macchia uniforme che le copre entrambe dall’altra. Per questo conto sono la stessa cosa, e non lo sono affatto: il secondo ha perso i due gruppi e ha riempito di roba proprio il vuoto che li separava. Un generatore che schiaccia la varietà dei soggetti in una poltiglia indistinta, invece di riprodurne i gruppi, può quindi prendere un ottimo voto.
L’Inception Score [SGZ+16] combina le due richieste in un’unica quantità:
dove \(p(y\mid \mathbf{x})\) è la distribuzione sulle classi che il classificatore assegna al campione \(\mathbf{x}\) e \(p(y) = \mathbb{E}_{\mathbf{x}\sim p_G}[p(y\mid \mathbf{x})]\) è la marginale sull’intero insieme generato. La divergenza KL è grande quando la prima è concentrata (campione riconoscibile) e la seconda è piatta (insieme vario): nitidezza e varietà in una formula sola. L’argomento dell’esponenziale è l’informazione mutua fra il campione e la classe sotto \(p_G\), che sta fra \(0\) e \(\log K\) con \(K\) il numero di classi, quindi \(1 \le \text{IS} \le K\) (\(K = 1000\) per ImageNet): più alto è meglio, e \(K\) si raggiunge solo con campioni riconosciuti senza esitazione e classi equiprobabili. Si valuta tipicamente su decine di migliaia di campioni. I limiti sono noti: non usa mai \(p_{\text{dati}}\), è cieco alla varietà dentro una classe, e dipende dalle mille classi di ImageNet, il che lo rende poco sensato fuori dalle immagini naturali.
La Fréchet Inception Distance [HRU+17] abbandona le classi e lavora sulle attivazioni di uno strato intermedio (il vettore da \(2048\) componenti del pooling finale di Inception). Si approssimano le due popolazioni di attivazioni, reali e generate, con due gaussiane \(\mathcal{N}(\boldsymbol{\mu}_r, \boldsymbol{\Sigma}_r)\) e \(\mathcal{N}(\boldsymbol{\mu}_g, \boldsymbol{\Sigma}_g)\), e si misura la distanza di Fréchet fra le due, che per gaussiane ha forma chiusa [DL82] ed è il quadrato della distanza di Wasserstein \(W_2\):
Più basso è meglio. Il primo termine confronta i centri delle due nuvole, il secondo la loro forma: è quest’ultimo a far pagare il collasso di varianza, perché un generatore che ripete sempre la stessa uscita ha covarianza nulla e paga \(\operatorname{Tr}(\boldsymbol{\Sigma}_r)\) anche col centro azzeccato. La radice di matrice costa \(O(d^3)\) con \(d = 2048\), e il prodotto \(\boldsymbol{\Sigma}_r\boldsymbol{\Sigma}_g\) non è simmetrico: le implementazioni ne calcolano la radice con un algoritmo generale e scartano la piccola parte immaginaria che gli errori numerici vi lasciano. Il FID correla meglio dell’IS con il giudizio umano ed è stato per anni lo standard di fatto; dal 2023 se ne contestano anche la scelta di Inception e l’ipotesi gaussiana, e si propongono alternative come la distanza di Fréchet calcolata su feature DINOv2 [SCH+23] o la CMMD, una discrepanza fra feature CLIP che non assume nessuna gaussiana [JRV+24].
Restano quattro avvertenze da tenere a mente quando si leggono due FID a confronto. È distorto verso l’alto con pochi campioni, quindi due valori calcolati su numerosità diverse non si confrontano. Dipende dai dettagli implementativi (come si ridimensionano le immagini, quale versione di Inception, quale interpolazione), al punto che numeri presi da paper diversi vanno maneggiati con prudenza. Resta un giudizio dato da un classificatore addestrato su fotografie: su volti, radiografie o disegni misura qualcosa, ma non esattamente ciò che dice di misurare.
E soprattutto: il FID vede solo i primi due momenti. Approssimare due popolazioni di attivazioni con due gaussiane significa non poterle distinguere quando media e covarianza coincidono, per quanto diverse siano davvero. Un esempio costruito apposta lo mostra bene, e sta in una dimensione sola: i dati reali sono la mistura in parti uguali di \(\mathcal{N}(-3,\,1)\) e \(\mathcal{N}(+3,\,1)\), il generatore emette la sola \(\mathcal{N}(0,\,10)\), di varianza \(10 = 1 + 3^2\) (il secondo argomento è la varianza, come in tutto il capitolo), che di quella mistura ha esattamente la media e la varianza. Per costruzione il FID fra le due è zero, e su un campione finito resta indistinguibile da zero:
import numpy as np

rng = np.random.default_rng(0)
m = 50_000
# i dati reali: metà da N(-3, 1) e metà da N(+3, 1)
reali = rng.normal(0, 1, m) + rng.choice([-3.0, 3.0], m)
# il generatore: una gaussiana sola, con la stessa media e la stessa varianza
generati = rng.normal(0, np.sqrt(10), m)


def fid_1d(a, b):
    """Il FID in una dimensione: medie e varianze invece di matrici."""
    va, vb = a.var(), b.var()
    return (a.mean() - b.mean()) ** 2 + va + vb - 2 * np.sqrt(va * vb)


print(f"media e varianza, reali:    {reali.mean():+.3f}  "
      f"{reali.var():.2f}")
print(f"media e varianza, generati: {generati.mean():+.3f}  "
      f"{generati.var():.2f}")
print(f"FID: {fid_1d(reali, generati):.1e}")
print(f"nella fascia |x| < 1: reali {np.mean(np.abs(reali) < 1):.1%}, "
      f"generati {np.mean(np.abs(generati) < 1):.1%}")
media e varianza, reali:    +0.006  10.02
media e varianza, generati: -0.002  10.07
FID: 1.1e-04
nella fascia |x| < 1: reali 2.3%, generati 24.7%
Un FID di un decimillesimo, eppure quel generatore ha perso per strada l’intera struttura a due modi, e riempie di campioni proprio la voragine che li separa: nella fascia \(|x| < 1\) finisce un quarto delle sue uscite, contro il \(2{,}3\%\) dei dati reali. Il termine sulle covarianze smaschera il collasso su un punto; la perdita di modi a momenti invariati, no. La risposta della letteratura è separare le due cose che il FID fonde in un numero [SBL+18]. Nella versione che si è imposta [KynkaanniemiKL+19] la precisione è quanta parte dei campioni generati cade nel supporto stimato dei dati, e il richiamo quanta parte dei dati cade nel supporto stimato dei generati; un generatore che abbandona un soggetto perde richiamo, uno che sporca le immagini perde precisione. Ma così si guarda il supporto e non quanta massa ci sta sopra, e nel controesempio della mistura, dove i due supporti coincidono, non si vede niente nemmeno così. Per la distorsione con pochi campioni c’è invece il KID [BinkowskiSAG18], uno stimatore non distorto della discrepanza fra le due popolazioni di attivazioni.
Un punto tornerà: nessuna delle due giudica una singola immagine, giudicano un insieme. L’Inception Score guarda l’insieme generato e basta, ed è il suo difetto; il FID lo confronta con l’insieme delle immagini vere. Ma il FID di una foto non esiste, e nemmeno il suo Inception Score. Ed è coerente con quello che una GAN cerca di fare, cioè avvicinare il mucchio delle immagini che genera a quello delle immagini vere: si valuta l’obiettivo dichiarato, non il singolo prodotto. Il FID sarà anche l’unità di misura con cui, nel capitolo sui modelli di diffusione, la nuova famiglia dimostrerà di aver superato le GAN.
Stabilizzare il duello#
Le tecniche per domare l’addestramento si dividono secondo ciò che modificano: l’architettura delle due reti, la distanza che il gioco minimizza, le regole dell’addestramento.
L’architettura si cambia dando alle due reti uno strumento adatto alle immagini invece che a una lista qualunque di numeri: è la ricetta delle DCGAN [RMC16], che la sezione sulle evoluzioni racconta per esteso.
La distanza si cambia con la Wasserstein GAN [ACB17], che al posto della probabilità «è autentico o no» minimizza la distanza \(W_1\) fra \(p_G\) e \(p_{\text{dati}}\), cioè fra il mucchio delle immagini generate e quello delle vere. A differenza della \(\mathrm{JSD}\), che vale \(\log 2\) per qualunque coppia di supporti disgiunti, \(W_1\) varia con continuità al variare dei parametri di \(G\): dice quanto manca e di quanto ci si è avvicinati all’ultimo passo, anche quando i due mucchi sono ancora lontanissimi. È il rimedio al guasto dei supporti che non si toccano, quello in cui un discriminatore perfetto boccia ogni falso con la stessa sicurezza. (È una distanza diversa da quella del FID, e si usa in un altro momento: questa la si stima durante l’addestramento, ed è ciò che il generatore cerca di far scendere.) Il discriminatore, che qui non stima più una probabilità ma un punteggio senza tetto né pavimento, prende il nome di critico.
Il prezzo è un vincolo sul critico: fra due immagini vicine, i suoi due giudizi non possono distare più di quanto distano le immagini (in gergo, dev’essere 1-lipschitziano). La WGAN lo otteneva obbligando ogni peso della rete a restare fra due valori; Gulrajani e colleghi [GAA+17] hanno poi mostrato che così il critico si impoverisce, e che i gradienti finiscono per esplodere o per sparire. L’idea che si è imposta è la loro: invece di stringere i pesi, si penalizzano i gradienti. Nel gradient penalty si aggiunge alla loss del critico un termine che cresce quando la norma del suo gradiente rispetto all’ingresso si allontana da uno, in su o in giù.
Il nome inglese della distanza dice come si calcola: earth mover’s distance, la fatica del movimento terra. I falsi sono un cumulo di sabbia, i veri un altro, e la distanza è quanta sabbia bisogna spostare per quanta strada, scegliendo il modo più economico di rifare l’un cumulo con l’altro. Due cumuli lontani costano molto, e avvicinarne uno di un metro fa scendere il conto di un metro per ogni carriola: è per questo che la correzione non si spegne mai, nemmeno quando i cumuli non si toccano. Il critico, cioè l’esperto di questa versione del duello, è chi stima quel conto guardando i due cumuli, e la multa gli vieta di dare giudizi che saltano più in fretta di quanto cambi il quadro.
La distanza è la \(W_1\) di Wasserstein:
dove \(\Pi\) è l’insieme delle congiunte con marginali \(p_{\text{dati}}\) e \(p_G\) (i piani di trasporto) e la seconda uguaglianza è la dualità di Kantorovich-Rubinstein. A differenza della \(\mathrm{JSD}\), \(W_1\) è continua nei parametri se \(G\) lo è, e quasi ovunque derivabile se \(G\) è localmente lipschitziana con costanti locali di valore atteso finito sotto \(p_z\); per una rete con attivazioni lipschitziane e un prior con \(\mathbb{E}\lVert\mathbf{z}\rVert < \infty\), gaussiano o uniforme, la condizione è soddisfatta (il teorema suppone lo spazio dei dati compatto, come \([0,1]^d\) per le immagini). Fra due segmenti paralleli a distanza \(\vartheta\) vale \(\lvert\vartheta\rvert\), mentre la \(\mathrm{JSD}\) resta \(\log 2\) per ogni \(\vartheta \ne 0\) [ACB17]. Il critico \(f_\omega\) approssima l’estremo superiore dentro una famiglia di reti: il taglio dei pesi in \([-c, c]\) la rende \(K\)-lipschitziana per qualche \(K\), e \(W_1\) esce stimata a meno di quel fattore. WGAN-GP [GAA+17] sostituisce il taglio con la penalità
con \(\lambda = 10\): il critico ottimo ha gradiente di norma unitaria sui segmenti fra i campioni che il piano di trasporto ottimo accoppia; quel piano non si conosce, e la penalità lo chiede allora lungo segmenti fra un vero e un falso estratti a caso, perché imporlo ovunque è intrattabile. La terza via, la normalizzazione spettrale [MKKY18], divide ogni matrice di pesi per la sua norma spettrale \(\lVert\mathbf{W}\rVert_2\), il massimo valore singolare, stimata con un passo di iterazione di potenza per aggiornamento: con attivazioni 1-lipschitziane la costante della rete è al più \(\prod_l \lVert\mathbf{W}_l\rVert_2\), cioè al più 1. Non costa passaggi all’indietro in più, e si usa come stabilizzatore anche per discriminatori che non stimano nessuna \(W_1\). Lo stesso vale per un’altra penalità sui gradienti, la \(R_1\) della Dirac-GAN, che spinge verso zero la norma del gradiente del discriminatore sui soli campioni reali: si usa con la loss non saturante, non chiede nessun vincolo di Lipschitz, ed è quella di StyleGAN e StyleGAN2 [MGN18].
Le regole dell’addestramento, infine, si cambiano in più modi. Il label smoothing unilaterale [SGZ+16] usa come bersaglio dei campioni reali un valore di poco inferiore a uno, per esempio \(0{,}9\) [Goo17], e lascia a zero quello dei falsi, perché il discriminatore non diventi troppo sicuro di sé. Lo stesso lavoro risponde anche a una domanda che il mode collapse fa nascere: perché il discriminatore non si accorge che le uscite del generatore sono tutte uguali? Perché giudica ogni campione per conto suo, mentre la ripetizione si vede soltanto confrontando i campioni fra loro: niente, in ciò che torna a \(G\), spinge le uscite ad allontanarsi l’una dall’altra. La minibatch discrimination gli fa vedere allora, insieme a ogni campione, delle statistiche sugli altri del minibatch, così che un generatore che ripete la stessa uscita sia smascherato dalla ripetizione. E si può regolare il rapporto fra i passi del discriminatore e quelli del generatore.
Con la Wasserstein GAN, però, il regolamento cambia senso. Il numero che il critico calcola è la distanza fra i due mucchi soltanto se il critico è vicino al proprio ottimo: se è mediocre, la sua risposta non misura niente, e il gradiente che consegna al generatore indica una direzione che non porta da nessuna parte. Quindi il consiglio si capovolge. Con la loss classica il discriminatore non deve diventare troppo bravo, altrimenti il suo giudizio si schiaccia sul «falso» e smette di correggere; con la distanza conviene addestrare il critico fino in fondo prima di muovere il generatore, e lo si fa a turni sbilanciati: cinque passi del critico per ogni passo del generatore, nei due lavori che hanno introdotto la ricetta [ACB17, GAA+17].
Con la penalità sui gradienti arriva anche un divieto, che nasce dallo stesso ragionamento. Nelle reti si usa spesso la batch normalization, un accorgimento che a ogni passaggio rimette in riga i valori di un minibatch guardandoli tutti insieme: nel critico non ci va, perché il giudizio su un’immagine finirebbe per dipendere dalle altre del minibatch, mentre la penalità è scritta per un’immagine alla volta [GAA+17].
Nessuna di queste tecniche garantisce la convergenza in generale. I risultati di convergenza locale, come quello della Dirac-GAN con la penalità \(R_1\), coprono alcune combinazioni di loss e regolarizzazione, e la scelta dipende ancora in buona parte dal confronto sperimentale su dati e architetture. È anche il motivo per cui la storia delle GAN è una fila di ricette, ciascuna che aggiusta un guasto della precedente, ed è la storia della sezione sulle evoluzioni.
Da ricordare
Una GAN è un duello fra due reti: il falsario parte da una manciata di numeri casuali e ne ricava un dato che sembri autentico, l’esperto guarda un dato e dice quanto lo crede vero.
Quello che torna indietro dall’esperto al falsario non è il verdetto: è una lista lunga quanto il quadro, che per ogni puntino dice da che parte tirare e con quanta forza. Per questo l’esperto dev’essere una rete: una persona darebbe lo stesso giudizio e nessuna lista. E la realtà entra nel gioco da un lato solo, perché è l’esperto (mai il falsario) a vedere i quadri autentici, e a essere corretto su quelli.
Sulla carta giocano un punteggio unico: quello che è un bene per uno è un male per l’altro. L’equilibrio arriva quando i falsi non si distinguono più dai veri, e lì l’esperto può soltanto tirare a indovinare.
Si allenano a turni, uno per volta, ed è un addestramento capriccioso: attenzione al mode collapse (il falsario trova un solo quadro che inganna sempre e si limita a rifarlo), la cui causa precisa è ancora discussa, e alla mancata convergenza (i due che si girano attorno senza fermarsi, finché una multa all’esperto non stringe il giro). Quando l’esperto è troppo bravo, il suo giudizio è talmente schiacciato sul «falso» che non si muove più, e senza movimento non c’è correzione: si rimedia chiedendo al falsario, nel suo turno, di far passare i propri quadri per autentici; il prezzo sono correzioni più sbalzate, e un duello che non si lascia più tenere con un punteggio solo.
Cambiando il modo di misurare (dalla probabilità «quanto lo credo vero» alla distanza fra il mucchio dei veri e quello dei falsi) chi giudica cambia mestiere e nome: diventa un critico che dà un punteggio senza tetto né pavimento. E si capovolge il consiglio di prima: il critico va lasciato allenare fino in fondo prima di muovere il falsario, cinque suoi giri per ogni giro dell’altro, perché soltanto un critico al meglio delle proprie possibilità sta misurando davvero qualcosa.
La loss, cioè il conto dell’errore, non misura la qualità: dice solo chi dei due sta vincendo. Si giudica confrontando insiemi di immagini, mai una alla volta: con l’Inception Score (nitidezza e varietà secondo un giudice esterno, che però le immagini vere non le guarda mai) e soprattutto con il FID, la distanza fra la nuvola delle immagini vere e quella delle generate: più è basso, meglio è. Neanche il FID però è infallibile: vede dove sta la nuvola e quanto è larga, quindi smaschera il falsario che ripete sempre lo stesso quadro, non quello che perde per strada interi soggetti lasciando la nuvola dov’era.
Da ricordare
Una GAN è un duello tra due reti: il generatore \(G\) trasforma rumore in dati sintetici, il discriminatore \(D\) stima la probabilità che un dato sia reale.
Ciò che \(D\) restituisce a \(G\) è \(\partial \mathcal{L}_G / \partial \tilde{\mathbf{x}}\), un vettore nello spazio dei dati, non il verdetto scalare; la regola della catena lo compone con \(\partial \tilde{\mathbf{x}} / \partial \theta_G\). Ne segue un requisito di progetto: \(D\) dev’essere derivabile rispetto al proprio ingresso, o si spezza il primo fattore. Sui dati discreti a mancare è invece il secondo, perché una sequenza di simboli campionati non si deriva rispetto a \(\theta_G\).
Nella formulazione originale condividono un’unica funzione di valore minimax: \(G\) la minimizza, \(D\) la massimizza; l’obiettivo ideale ha minimo in \(p_G = p_{\text{dati}}\), e lì il discriminatore ottimo vale \(D^*(\mathbf{x})=\tfrac12\) sul supporto dei dati. La caratterizzazione dell’ottimo non è però una garanzia di convergenza: la prova vive nello spazio delle densità, l’addestramento in quello dei parametri.
L’addestramento è alternato e notoriamente instabile. Il mode collapse ha una causa ancora aperta: la KL rovesciata della loss non saturante ne è una spiegazione proposta e contestata. La mancata convergenza si vede già nella Dirac-GAN, dove la discesa del gradiente gira attorno all’equilibrio senza raggiungerlo, e la penalità \(R_1\) ne dà la convergenza locale. I gradienti che svaniscono, invece, riguardano l’obiettivo minimax originale: la non-saturating loss usata nel codice li evita, al prezzo di aggiornamenti ad alta varianza quando \(D\) è quasi ottimo, e di un gioco che non è più a somma zero.
La Wasserstein GAN [ACB17] sostituisce la probabilità con una stima della distanza fra \(p_G\) e \(p_{\text{dati}}\): cade la sigmoide finale, \(D\) diventa un critico a valori in \(\mathbb{R}\) e va portato vicino all’ottimo prima di ogni passo di \(G\) (cinque iterazioni nei due lavori originali), perché quella distanza è definita come un estremo superiore sulle funzioni 1-Lipschitziane e solo lì il gradiente che \(G\) riceve la approssima. Il vincolo di Lipschitz è imposto con il weight clipping nel lavoro originale e con il gradient penalty [GAA+17] in quello che si è affermato; quest’ultimo esclude però la batch normalization nel critico, perché la penalità è definita campione per campione mentre la batchnorm accoppia i campioni del minibatch.
La loss non misura la qualità: dice solo chi sta vincendo. Si valuta confrontando distribuzioni, con l’Inception Score (nitidezza e varietà secondo un classificatore, fra \(1\) e il numero di classi, più alto è meglio, ma senza mai guardare i dati veri) e soprattutto con il FID, la distanza fra la nuvola delle attivazioni reali e quella delle generate: più basso è meglio. Il FID però guarda solo i primi due momenti: il termine sulle covarianze smaschera il collasso di varianza, non la perdita di modi a media e covarianza invariate.