


Natural Language Processing#
Duecentocinquanta voci di vocabolario, fra radici e desinenze, e sei regole di grammatica: con questo un calcolatore tradusse dal russo all’inglese, davanti alla stampa, più di sessanta frasi. Era il 7 gennaio 1954, a New York, e dietro c’era un gruppo di ricercatori della Georgetown University e di IBM [Hut04]. Il direttore del progetto, Leon Dostert, si spinse a prevedere che nel giro di cinque anni, forse di tre, la traduzione per via elettronica sarebbe diventata un fatto compiuto in importanti settori e per più lingue. Ne servirono molti di più, e la lezione che ne uscì non è invecchiata: il linguaggio umano sembra semplice perché lo maneggiamo senza sforzo, ma per una macchina è uno dei problemi più ostici che esistano.
Il Natural Language Processing (NLP, elaborazione del linguaggio naturale) è la disciplina che insegna ai calcolatori a leggere, capire e produrre testo. «Naturale» per distinguerlo dai linguaggi artificiali come Python: quelli li abbiamo progettati noi perché ogni istruzione voglia dire una cosa sola, l’italiano e l’inglese no.
Perché il linguaggio è così difficile#
Prendi la frase «Ho visto un uomo con il binocolo». Chi ha il binocolo? Tu, che guardavi, oppure l’uomo che hai visto? Nessuna delle due letture è sbagliata: la frase è ambigua, e solo il contesto scioglie il dubbio.
E il contesto cambia tutto. La parola «campo» vuol dire una cosa in «campo di grano», un’altra in «campo magnetico», un’altra ancora in «campo da calcio». Poi ci sono i sinonimi: «auto», «macchina» e «vettura» indicano lo stesso oggetto, e una macchina deve capirlo. Ci sono le parole piccole che da sole non vogliono dire niente e vanno a pescare il significato in quello che è già stato detto: in «Marco ha preso il libro e l’ha letto», quel «l’» è il libro, ma per saperlo bisogna ricordarsi la prima metà della frase. Questo rimando all’indietro ha un nome, l’anafora, e tornerà nell’ultima sezione del capitolo, quella sul dialogo: lì le parole piccole dovranno pescare il significato non nella stessa frase, ma in una battuta detta prima da un’altra persona. E c’è l’ironia: se dico «che bella giornata» mentre diluvia, intendo l’esatto contrario. Nessuna di queste cose è scritta nelle parole: sta tra le righe, ed è lì che le macchine si perdono.
Non esiste una regola che, presa la frase, ne restituisca il significato: nemmeno tu ne hai una. Davanti al binocolo scegli la lettura che ti torna di più, e ti torna di più per via delle migliaia di frasi simili che hai già sentito in vita tua. Una macchina addestrata sui testi fa lo stesso mestiere: pesa le letture possibili guardando le parole che ci stanno intorno, e punta su quella che le sembra più probabile. È una scommessa, e ogni tanto la perde.
La difficoltà del linguaggio si può decomporre in alcuni fenomeni ricorrenti:
Ambiguità a più livelli. Lessicale: un termine ha più sensi (la disambiguazione del senso è il compito noto come word sense disambiguation). Sintattica: «Ho visto un uomo con il binocolo» ammette due alberi di parsing diversi (attacco del sintagma preposizionale).
Dipendenza dal contesto. Il significato di un token è funzione della finestra che lo circonda; i pronomi (anafora) vanno risolti rispetto ad antecedenti anche lontani.
Sinonimia e polisemia. Forme diverse possono avere lo stesso senso (auto, macchina, vettura) e una stessa forma più sensi (campo): la relazione tra stringhe e significati è molti-a-molti.
Pragmatica. Ironia, sarcasmo e implicature richiedono conoscenza del mondo e dell’intenzione del parlante, non ricavabile dalla sola sintassi.
La conseguenza pratica è che il testo, da solo, non determina la propria interpretazione: la stessa stringa ne ammette più d’una, e quale valga dipende dal contesto e da ciò che chi legge sa del mondo. Nessuna regola scritta a mano copre tutti i casi: perciò il NLP moderno stima dai dati una distribuzione sulle interpretazioni, \(P(\text{interpretazione} \mid \text{testo}, \text{contesto})\), da cui sceglie la più probabile.
I compiti tipici#
Il NLP non è un problema unico ma una famiglia di compiti. Quattro tornano di continuo, e tre di loro avranno più avanti una sezione tutta per sé.
Classificazione e analisi del sentimento (nota ovunque con il termine inglese sentiment analysis): assegnare un’etichetta a un testo. È spam o no? Questa recensione è positiva o negativa? Questa email va allo sportello «reclami» o «fatturazione»?
Traduzione automatica (machine translation): trasformare una frase da una lingua all’altra preservandone il senso (il compito della dimostrazione di Georgetown del 1954).
Riconoscimento di entità nominate (Named Entity Recognition, NER): individuare nel testo persone, luoghi, organizzazioni, date. In «Enrico Fermi nacque a Roma nel 1901», un sistema NER etichetta Enrico Fermi come persona, Roma come luogo, 1901 come data.
Question answering: rispondere a una domanda posta in linguaggio naturale, estraendo la risposta da un testo o generandola. È l’unico dei quattro che qui non avrà una sezione sua: per rispondere sul serio bisogna prima andare a cercare il testo giusto in un archivio, e quel mestiere ha bisogno di attrezzi che arrivano con i Transformer, in Cercare per rispondere: retrieval e RAG.
Sono compiti diversi, e per decenni li hanno risolti programmi diversi: uno per lo spam, uno per la traduzione, uno per le entità. I grandi modelli di linguaggio li hanno quasi unificati, con una mossa più semplice di quanto sembri.
Un modello di linguaggio è un programma che nessuno ha scritto istruzione per istruzione. Lo si addestra su un’enorme raccolta di documenti a prevedere come prosegua un testo; di solito un secondo addestramento, basato sugli esempi e sulle preferenze di valutatori umani, gli insegna poi a seguire le istruzioni. Il suo mestiere resta continuare un testo, e allora si riscrive ogni compito in modo che la risposta sia la continuazione. Non gli si chiede «questa email è spam?»: gli si dà da finire un testo che dice «Email: vinci subito un premio. Questa email è spam? Risposta:», e la parola con cui continua è il verdetto. Non gli si chiede di tradurre: gli si dà «Italiano: il gatto nero salta sul muro. Inglese:». Il programma e i suoi parametri restano gli stessi; cambia soltanto il testo che gli si mette davanti.
Una parabola storica: dalle regole ai Transformer#
Come ci si sia arrivati è una storia in quattro tappe, e la Fig. 15.1 le mette in fila. A cambiare, di tappa in tappa, è sempre la stessa cosa: chi mette la conoscenza della lingua dentro il programma. Prima un linguista che scrive regole a mano, alla fine il testo stesso. L’ultima tappa porta il nome di un’architettura, il Transformer, che è il modo in cui oggi si costruiscono quasi tutte queste macchine; qui basta sapere che esiste, perché ha un capitolo tutto suo, il prossimo.

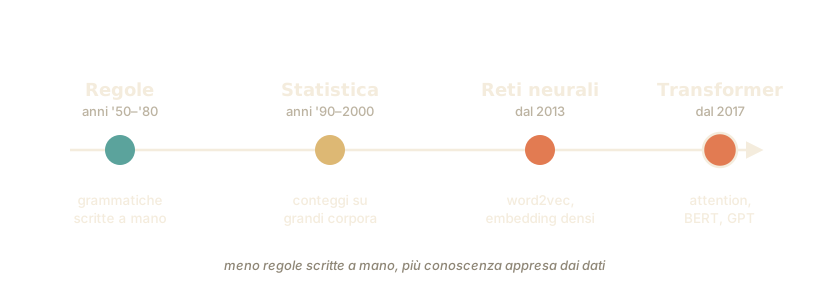
Fig. 15.1 Quattro stagioni del NLP. A ogni passaggio la conoscenza linguistica scritta a mano lascia spazio a programmi che la ricavano dai testi.#
Prima tappa, le regole. All’inizio si provò a spiegare la lingua alla macchina una regola per volta: liste di parole, grammatiche compilate a mano da linguisti. Funzionava su frasi semplici, ma le eccezioni dell’italiano sono infinite e le regole diventavano ingestibili.
Seconda tappa, i conteggi. Invece di dire alla macchina come funziona la lingua, le si dà da leggere montagne di testo e la si lascia notare le regolarità: dopo «buon» viene spesso «giorno», raramente «sasso». Con la diffusione di internet il testo da leggere è diventato praticamente infinito. Il testo grezzo però non bastava per tutti i mestieri: per insegnare alla macchina a riconoscere i verbi, qualcuno doveva prima segnarli a mano in migliaia di frasi, e per la traduzione servivano testi già tradotti da persone. Il lavoro a mano si era soltanto spostato, dallo scrivere le regole al preparare gli esempi.
Terza tappa, la mappa delle parole. Qui i programmi hanno cominciato a rappresentare ogni parola con qualche centinaio di numeri. Sono coordinate, come la latitudine e la longitudine di un posto sulla carta: ogni parola diventa un punto su una mappa. Con due soli numeri la mappa si disegnerebbe su un foglio; con trecento non si disegna più, ma la si può ancora misurare, e due punti vicini restano due parole affini. Il bello è che la mappa la disegna il programma da solo, e con una regola sciocca: mette vicine le parole che si trovano in mezzo alle stesse compagnie. «Re» e «regina» compaiono negli stessi posti (dopo «il» e «la», vicino a «trono», «corona», «regno»), quindi finiscono uno accanto all’altra.
Quarta tappa, il 2017. Fino a lì un programma leggeva la frase parola per parola, in fila, e a ogni passo si portava dietro un riassunto di quello che aveva già letto. L’ultimo salto è stato un modello che guarda l’intera frase tutta insieme e decide, parola per parola, quali delle altre contano davvero per capirla: si chiama Transformer, e a quel nome è dedicato il capitolo successivo a questo.
Cambiano due cose insieme. Con il riassunto, l’inizio di una frase lunga sbiadisce mentre si va avanti; guardando tutto in una volta, una parola può andarsi a prendere quella che sta venti parole indietro come se le fosse accanto. E leggere in fila obbliga ad aspettare: la centesima parola non si tratta prima della novantanovesima. Chi guarda tutta la frase insieme lavora su tutte le parole nello stesso momento, ed è così che si è potuto dare da leggere a queste macchine molto più testo di prima.
La traiettoria del NLP attraversa quattro fasi (Fig. 15.1):
Sistemi a regole (anni “50–“80). Grammatiche formali e basi di conoscenza scritte a mano; approccio symbolic AI. Fragile fuori dal dominio previsto, costoso da mantenere.
Metodi statistici (anni “90–2000). Modelli probabilistici stimati da corpora: \(n\)-gram per il language modeling, stimati da testo grezzo; Hidden Markov Model per il part-of-speech tagging, stimati da corpora annotati a mano; traduzione statistica appresa da testi paralleli, con allineamento a livello di parola. Il paradigma diventa «impara dai dati».
Reti neurali (dal ~2013). Le parole diventano vettori densi (embedding). Li imparava già il modello di linguaggio neurale di Bengio e colleghi [BDVJ03]; word2vec [MCCD13] li ha resi comuni, collocando ogni parola in \(\mathbb{R}^d\) così che il prodotto scalare catturi la similarità semantica. Reti ricorrenti (RNN, LSTM) modellano le sequenze.
Transformer (dal 2017). Il paper Attention Is All You Need [VSP+17] sostituisce la ricorrenza con il meccanismo di self-attention, permettendo parallelismo e dipendenze a lungo raggio. Da qui BERT, la famiglia GPT e i moderni large language model.
Il filo conduttore è una progressiva riduzione della conoscenza linguistica inserita a mano in favore di rappresentazioni apprese direttamente dal testo.
Dagli attrezzi alle reti#
Si parte dalla cassetta degli attrezzi classica: cercare in un testo tutti i pezzi che hanno una certa forma (le espressioni regolari), ripulirlo perché due varianti della stessa parola non contino come vocaboli diversi (la normalizzazione), misurare quanto due parole si somigliano (la distanza di edit, quella che sta dietro al correttore del telefono). Poi il testo diventa numeri: prima lo si taglia in pezzi (la tokenizzazione), poi si contano i pezzi (il bag-of-words, il «sacchetto di parole»), infine ogni parola riceve un pugno di coordinate che la collocano vicino alle parole affini (gli embedding).
Con i numeri in mano affrontiamo i compiti, uno alla volta.
Dare un’etichetta a un testo intero: spam o non spam, recensione entusiasta o stroncatura (i due metodi si chiamano Naive Bayes e regressione logistica).
Scommettere su quale parola seguirà, che è il mestiere della barra dei suggerimenti sul telefono (i modelli n-gram).
Ricordare ciò che si è letto prima, con le reti che leggono in fila tenendo un riassunto aggiornato (le reti ricorrenti).
Tradurre: una rete legge la frase in una lingua, una seconda la riscrive nell’altra (la coppia si chiama encoder–decoder), e fra le due si inserisce l’attenzione, il meccanismo da cui nasceranno i Transformer.
Dire il mestiere di ogni singola parola (nome, verbo, articolo) e riconoscere nomi di persona, di luogo e date: sono il POS tagging e il NER, e la sequenza di etichette più probabile la trova un procedimento del 1967, l’algoritmo di Viterbi.
Scoprire com’è costruita una frase, cioè quali parole vanno insieme e chi fa che cosa a chi (il parsing).
Parlare con le macchine: dialogo e chatbot, che chiude il cerchio aperto da ELIZA nell’Introduzione.
Ovunque, esempi in Python su scikit-learn e PyTorch, tenendo l’italiano come
lingua di lavoro.
Resta l’ultima tappa, i Transformer, che merita un capitolo tutto suo: è l’architettura che ha ridefinito non solo il NLP ma buona parte dell’AI contemporanea. Da un calcolatore che nel 1954 arrancava su una sessantina di frasi si arriva così a modelli che oggi traducono, riassumono e conversano, e la domanda se «capiscano» resta aperta. Un modello addestrato soltanto su testo non ha mai visto un gatto, aperto una porta o avuto fretta: quello che sa della parola gatto è dove quella parola compare rispetto a tutte le altre, ma non sa nulla di ciò a cui si riferisce. Che dalla sola forma delle frasi non si possa arrivare al significato è una tesi, sostenuta da Emily Bender e Alexander Koller [BK20] e contestata da altri, e i modelli che ricevono anche immagini e suoni la mettono alla prova. Ciò che sa un modello di solo testo resta comunque una conoscenza reale e misurabile, di un altro tipo dalla nostra.