


Data augmentation: moltiplicare i dati senza raccoglierli#
Per insegnare a un bambino che cos’è una tazza non servono diecimila tazze. Ne basta una: la gira tra le mani, la guarda dall’alto e di lato, la vede al sole e in penombra, mezza nascosta dietro la caffettiera. Ogni sguardo è un’immagine diversa dello stesso oggetto, e da quella manciata di occhiate il concetto di «tazza» esce solidissimo. Una rete neurale non ha mani. Ma possiamo girare noi l’oggetto al posto suo: prendere ogni fotografia del training set e mostrargliela specchiata, ritagliata, un po’ ruotata, più chiara o più scura. Si chiama data augmentation (letteralmente «aumento dei dati») ed è il modo più economico che esista per moltiplicare gli esempi senza raccoglierne di nuovi. Non è un’idea recente. Negli anni Novanta le cifre scritte a mano si moltiplicavano già spostandole, allungandole e inclinandole, e così addestrata la rete LeNet-5 sbagliava lo 0,8% delle prove invece dello 0,95% [LBBH98]; fra le architetture storiche del deep learning abbiamo visto che AlexNet, nel 2012, la usava in modo aggressivo (ritagli casuali, riflessioni, perturbazioni di colore). Bastano i primi due per ricavare da ogni immagine oltre duemila varianti possibili [KSH12], ed è una moltiplicazione, non una magia. Il conto si rifà a mano. Da un’immagine di 256 pixel di lato se ne ritaglia una di 224: il bordo sinistro del ritaglio può stare tutto a sinistra o scivolare di una, due, fino a \(256 - 224 = 32\) colonne, cioè in 33 posizioni, e il bordo alto in altrettante. Fanno \(33 \times 33 = 1089\) ritagli diversi, che lo specchio raddoppia a \(2178\). Gli autori scrivono \(2048\), cioè contano trentadue posizioni per lato invece di trentatré; la sostanza non cambia.
Cambiare i pixel, non l’etichetta#
Tutto il trucco sta in un vincolo: una trasformazione è ammessa solo se cambia l’immagine ma non cambia l’etichetta. Le trasformazioni buone catturano le invarianze del compito: i modi in cui il mondo può variare senza che la risposta giusta vari. E qui serve onestà: nessuna trasformazione è innocente in assoluto.
Specchia la foto di un gatto: è ancora, senza alcun dubbio, un gatto. La natura non distingue tra gatti «che guardano a destra» e gatti «che guardano a sinistra», quindi lo specchio è un modo gratuito di raddoppiare le foto di gatti. Ma prova a specchiare un cartello stradale: l’obbligo di svolta a destra diventa un obbligo di svolta a sinistra (stessa grafica, significato opposto). O prendi la cifra 6 e capovolgila: ottieni un 9. Una scritta ruotata di novanta gradi smette di essere leggibile. La stessa mossa che per i gatti è un regalo, per i cartelli o per le cifre è un sabotaggio: la trasformazione giusta dipende dal compito, non dall’immagine.
C’è un secondo modo di sbagliare, e stavolta la risposta giusta non cambia affatto. Una foto di strada scattata storta di cinque gradi è ancora una foto di strada, e di scatti storti così ne capitano tutti i giorni. Girala di novanta gradi. Resta una strada, con la sua etichetta intatta, ma i pedoni vengono sdraiati sul marciapiede, e una telecamera montata su un palo non riprenderà mai una scena simile. Allenarsi su foto del genere è tempo speso su un mondo che non esiste. Quindi le domande da farsi sono due, una sull’etichetta e una sul mondo. La risposta cambia? E la foto che ne esce potrebbe capitare davvero?
Sia \((\mathbf{x}, y)\) una coppia immagine-etichetta. Una trasformazione \(T\) è ammessa per il compito se la coppia \((T(\mathbf{x}), y)\) è ancora un esempio plausibile della stessa distribuzione: l’etichetta resta valida e l’immagine trasformata somiglia a qualcosa che il modello potrà davvero incontrare. L’insieme delle trasformazioni ammesse è conoscenza a priori sul dominio che iniettiamo nel modello: il flip orizzontale appartiene alle invarianze di «gatto contro cane», non a quelle del riconoscimento di cifre (un 3 specchiato non è nessuna cifra, e nemmeno le rotazioni ampie sono innocue: il 6 capovolto è un 9) né a quelle dei cartelli stradali, dove lo specchio inverte il significato. Conta anche l’intensità: una rotazione di 5 gradi su una foto di strada è realistica, una di 90 gradi produce pedoni sdraiati che in produzione non esistono. Scegliere le trasformazioni è progettazione, non un dettaglio tecnico.
Quando l’uscita ha una geometria (riquadri, maschere, punti chiave) la
condizione cambia forma: una trasformazione geometrica \(T\) dell’immagine chiede
la trasformazione corrispondente \(T'\) dell’etichetta, e si addestra su
\((T(\mathbf{x}), T'(y))\). Specchiando orizzontalmente un’immagine larga \(W\), il
riquadro \((x_1, y_1, x_2, y_2)\) diventa \((W - x_2,\ y_1,\ W - x_1,\ y_2)\) e la
maschera si specchia con l’immagine. È la richiesta di equivarianza, di cui
l’invarianza della classificazione è il caso con \(T'\) identità. Le
trasformazioni fotometriche (luce, contrasto, colore) lasciano la geometria
dov’è, e l’etichetta non si tocca; se siano ammesse lo decide il compito, come
sempre. In torchvision la gestisce transforms.v2, che applica la stessa \(T\)
all’immagine e ai riquadri o alle maschere passati insieme, purché avvolti in
tv_tensors.BoundingBoxes o tv_tensors.Mask (un tensore nudo lo lascia
com’è, senza avvisare); transforms trasforma soltanto l’immagine.

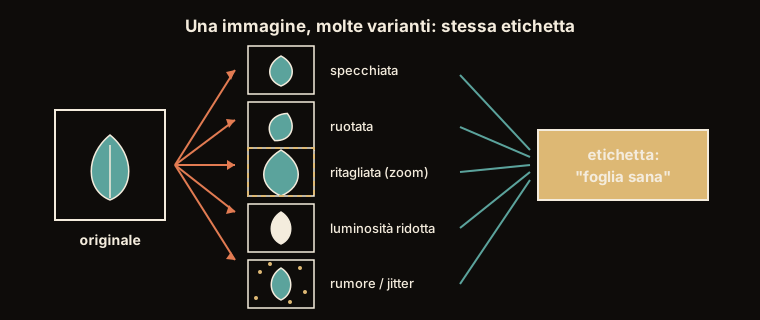
Fig. 11.4 Da una sola immagine, cinque esempi «nuovi»: i pixel cambiano, l’etichetta no.#
Come mostra Fig. 11.4, da una fotografia ne ricaviamo molte: tutte diverse per la rete, e tutte, per chi le guarda, la stessa foglia sana.
Ogni epoca un’immagine nuova, ma mai all’esame#
In pratica le trasformazioni non si applicano una volta per tutte: si estraggono a caso, al volo, ogni volta che un’immagine viene caricata. La raccolta di foto sul disco non cresce di un byte, ma la rete non rivede mai due volte la stessa identica immagine. Un giro completo su tutte le foto si chiama epoca, e a ogni epoca le stesse foto tornano deformate in modo diverso.
E c’è una regola d’oro che non ammette eccezioni disinvolte. Le foto sono divise in tre mucchi: quelle su cui la rete si allena (il training set), quelle su cui controlliamo strada facendo come sta andando per aggiustare le nostre scelte (il validation set) e quelle che restano chiuse in un cassetto fino alla fine, per il giudizio conclusivo (il test set). L’augmentation si applica solo al primo mucchio. Sugli altri due si fanno soltanto le operazioni che danno sempre lo stesso risultato: ridimensionare, ritagliare al centro e normalizzare. Normalizzare, qui, vuol dire sottrarre a ogni canale di colore una media e dividerlo per una deviazione standard fissate una volta per tutte, di solito quelle di ImageNet, così che i numeri entrino nella rete sulla stessa scala su cui è stata addestrata. È la stessa operazione per tutte le foto, quindi non pareggia la luce: una foto scattata in controluce resta più scura di una scattata al sole, e la differenza fra le due anzi si ingrandisce, perché si divide per un numero più piccolo di uno.
È la differenza tra i compiti a casa e il compito in classe. A casa l’insegnante ti dà ogni giorno lo stesso tipo di esercizio ma con i numeri cambiati: così impari il metodo, non il risultato a memoria. Il compito in classe, invece, dev’essere uguale per tutti e ripetibile: se ogni studente ricevesse una versione deformata a caso, il voto non misurerebbe più niente. Il test set è il compito in classe del modello: deve dirci come andrà sulle foto vere, così come sono, e deve dare lo stesso risultato ogni volta che lo ripetiamo. Il validation set, in mezzo ai due, è la simulazione che si fa la settimana prima: serve a noi per decidere che cosa cambiare, quindi anche lui va lasciato uguale a sé stesso, altrimenti non si capisce se a migliorare sia stato il modello o il caso.
Al compito in classe un’eccezione c’è, e regge perché è decisa prima. L’insegnante prepara tre versioni della stessa prova, le annuncia, le fa fare a tutta la classe e mette in pagella la media dei tre voti. Ripetibile lo è, perché le tre versioni restano quelle, ed equa pure, perché nessuno ne riceve una diversa dagli altri; e la media di tre prove misura un po’ meglio di una sola, qualche decimo di voto. Costa il triplo del tempo, e un voto ottenuto così si confronta solo con altri voti ottenuti allo stesso modo. Per una foto le versioni sono per esempio l’immagine intera, la stessa specchiata e qualche ritaglio fisso, gli angoli e il centro: sempre gli stessi, per ogni foto e per ogni modello.
A ogni epoca, per ogni esempio, si campiona una trasformazione \(T\) da una distribuzione fissata (un flip con probabilità \(0{,}5\), un ritaglio con scala casuale, una perturbazione di colore) e si addestra su \((T(\mathbf{x}), y)\): il numero di varianti potenziali è di fatto illimitato, a costo zero di memoria. In valutazione la pipeline dev’essere deterministica, per due ragioni: la metrica deve riflettere la distribuzione di deployment (le foto arrivano intere, non ritagliate a caso) e dev’essere riproducibile tra un’esecuzione e l’altra. Esiste un’eccezione consapevole, la test-time augmentation: si media la predizione su \(m\) copie della stessa immagine, trasformate in modo fissato, al costo di \(m\) passaggi in avanti. AlexNet la usava già, con dieci ritagli (i quattro angoli e il centro, più i loro specchi), e nell’articolo la media sui dieci abbassa l’errore top-5 su ImageNet 2010 dal \(18{,}3\%\) al \(17{,}0\%\) [KSH12]. È una scelta dichiarata di inferenza, non un’augmentation «dimenticata accesa», e il confronto con altri modelli va fatto a parità di questa scelta.
In pratica, con torchvision#
Nella sezione sul transfer learning la catena di operazioni da fare a ogni
immagine prima di darla alla rete ce la dava la rete stessa
(pesi.transforms()). Per aggiungere l’augmentation la scriviamo a mano con
torchvision.transforms, tenendo rigorosamente separate le due catene, quella
dell’allenamento e quella dell’esame.
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

media = (0.485, 0.456, 0.406)   # statistiche di ImageNet: le stesse
dev   = (0.229, 0.224, 0.225)   # usate dalla rete pre-addestrata

# Pipeline di TRAINING: trasformazioni casuali, diverse a ogni epoca
train_tf = transforms.Compose([
    transforms.RandomResizedCrop(224, scale=(0.7, 1.0)),  # ritaglio casuale
    transforms.RandomHorizontalFlip(p=0.5),               # specchio nel 50% dei casi
    transforms.ColorJitter(brightness=0.2, contrast=0.2,  # luce, contrasto,
                           saturation=0.2),               # saturazione
    transforms.ToTensor(),
    transforms.Normalize(media, dev),
])

# Pipeline di TEST: deterministica. Niente casualità, mai.
test_tf = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(media, dev),
])

train_ds = datasets.ImageFolder("dati/train", transform=train_tf)
test_ds  = datasets.ImageFolder("dati/test",  transform=test_tf)
train_dl = DataLoader(train_ds, batch_size=32, shuffle=True)
test_dl  = DataLoader(test_ds,  batch_size=32)
Tutto il resto, la rete e il ciclo che la addestra, è identico a quello della
sezione precedente: l’augmentation vive tutta dentro il Dataset, cioè nel
punto in cui le immagini vengono lette. E la scelta delle trasformazioni segue
il compito: per un classificatore di cifre o di cartelli stradali, il
RandomHorizontalFlip va tolto.
Perché funziona: un altro modo di mettere il freno#
Impedire a una rete di imparare a memoria è un problema vecchio, e i freni già incontrati sono due: la regolarizzazione \(\ell_2\), che penalizza i modelli che si affidano troppo a pochi numeri grossi (overfitting e validazione), e il dropout, che spegne a caso una parte della rete a ogni passo (ottimizzazione e regolarizzazione) [SHK+14]. Freni di questo genere si chiamano regolarizzazioni; l’augmentation è una di loro, ma agisce sui dati invece che sulla rete.
Torniamo ai compiti a casa, e chiediamoci perché l’insegnante cambi i numeri ogni volta. Cento ripetizioni dell’esercizio identico si imparano a memoria; se i numeri cambiano, memorizzare non serve più a niente e l’unico modo di rispondere bene è capire la regola. L’augmentation fa questo alla rete: le rende impossibile «fotografare» il training set, perché il training set non è mai due volte lo stesso. Ciò che sopravvive a specchi, ritagli e cambi di luce è proprio quello che vogliamo: l’idea di gatto, non i pixel di quel gatto. E il freno si vede nella risposta: alla rete che riceve la stessa foto un po’ storta, un po’ più chiara, un po’ più stretta, conviene darle sempre la stessa risposta, cioè diventare poco sensibile proprio a quei piccoli cambiamenti.
L’addestramento standard minimizza il rischio empirico \(\hat{R}(\theta) = \frac{1}{n}\sum_{i=1}^{n} \ell\big(f_\theta(\mathbf{x}_i), y_i\big)\), dove \(\ell\) è il costo di una singola predizione e la distribuzione empirica concentra tutta la massa sugli \(n\) punti osservati. L’augmentation sostituisce ogni punto con una nuvola di varianti:
dove \(\mathcal{T}\) è la distribuzione sulle trasformazioni ammesse. Così allarga il supporto della distribuzione empirica: invece di esigere la risposta giusta in \(n\) punti isolati, la esige su interi intorni, e questo spinge \(f_\theta\) verso funzioni invarianti alle trasformazioni scelte.
Per trasformazioni piccole l’equivalenza con un regolarizzatore si scrive per intero. Sia \(T\) lo spostamento dell’ingresso di \(\xi\,\mathbf{t}_i\) lungo la direzione \(\mathbf{t}_i\) che la trasformazione ha nel punto \(\mathbf{x}_i\), con \(\xi\) a media nulla e varianza \(\sigma_\xi^2\), e sia \(\ell = \frac{1}{2}(\hat{y} - y)^2\) con uscita scalare \(\hat{y} = f_\theta(\mathbf{x}_i)\). Si sviluppa \(f_\theta(\mathbf{x}_i + \xi\mathbf{t}_i)\) al secondo ordine in \(\xi\), si eleva al quadrato e si media su \(\xi\): i termini di primo grado si annullano, e restano quelli di secondo,
dove \(\mathbf{H}_i\) è l’hessiana di \(f_\theta\) rispetto all’ingresso in \(\mathbf{x}_i\). Il secondo termine è proporzionale al residuo: si annulla dove il modello interpola, e in media quando \(f_\theta\) è la media condizionata di \(y\), ma altrove non è trascurabile e può anche prevalere. Il primo, mediato sugli \(n\) esempi, è la penalità \(\frac{\sigma_\xi^2}{2}\frac{1}{n}\sum_i(\nabla_{\mathbf{x}} f_\theta(\mathbf{x}_i)^\top \mathbf{t}_i)^2\) sulla derivata dell’uscita lungo la trasformazione, la tangent propagation [SVLD92]; con un rumore gaussiano isotropo di varianza \(\sigma^2\) al posto di \(\xi\mathbf{t}_i\) diventa \(\frac{\sigma^2}{2}\lVert\nabla_{\mathbf{x}} f_\theta\rVert^2\), la regolarizzazione di Tikhonov sul gradiente rispetto all’ingresso [Bis95]. Con la cross-entropy il quadrato della derivata lascia il posto a \(\mathbf{g}_i^\top\big(\mathrm{diag}(\mathbf{p}) - \mathbf{p}\mathbf{p}^\top\big)\mathbf{g}_i\), dove \(\mathbf{g}_i\) è la derivata dei logit lungo \(\mathbf{t}_i\) e la matrice è l’hessiana della perdita rispetto ai logit, e il termine con le hessiane dei logit è pesato da \(\mathbf{p} - \mathbf{y}\), che fa la parte del residuo.
È l’idea del vicinal risk minimization, formulata da Chapelle, Weston, Bottou e Vapnik [CWBV00] (apprendere non dai punti, ma dai loro dintorni), portata alle estreme conseguenze da mixup [ZCisseDLP18].
Mescolare, cancellare, imparare la ricetta#
Le trasformazioni geometriche e di colore non esauriscono il repertorio. Le varianti più recenti mescolano due immagini, ne cancellano un rettangolo o affidano la scelta delle trasformazioni a una ricerca automatica: producono immagini che nessuna macchina fotografica scatterebbe, e regolarizzano più a fondo.
Mixup è come proiettare due diapositive sullo stesso schermo, una al 70% e una al 30% di luminosità: un’immagine che è per sette decimi un gatto e per tre decimi un cane. Anche la risposta richiesta si mescola nelle stesse proporzioni: «70% gatto, 30% cane». Sembra assurdo, e fa due cose. Fra un gatto e un cane, dove l’addestramento normale non dice niente, costringe la rete a passare dall’uno all’altro per gradi, invece di saltare di colpo da una risposta all’altra. E, come si è visto dopo, la tiene meno sicura di sé dove non ha capito: una rete addestrata solo su risposte secche («questo è un gatto, punto») impara a essere sicurissima sempre, perché il gioco premia soltanto chi si sbilancia. Quanto mescolare lo decide una manopola, e la si tiene bassa. Il 70 contro 30 è già una dose generosa, e il più delle volte esce qualcosa di molto più sbilanciato, una diapositiva quasi piena e l’altra appena un’ombra; il mezzo e mezzo capita di rado.
Cutout è ancora più semplice: si copre un rettangolo a caso della foto, come con un post-it. Se la rete riconosceva i gatti solo dalle orecchie, con il post-it sulle orecchie dovrà imparare anche zampe e coda.
Infine, invece di scegliere a mano le trasformazioni, si può lasciare che sia un algoritmo a cercare la combinazione migliore per il nostro archivio di foto: ne prova tante per davvero, addestra ogni volta un modello, guarda quale combinazione gli fa prendere il voto più alto a un esame di prova, e tiene quella. È l’idea delle policy apprese (una policy, qui, è semplicemente la lista delle trasformazioni scelte, con quanto forte applicarle). La prima versione costava carissimo, migliaia di addestramenti per una ricerca sola. Poi si è visto che bastano due manopole, quante trasformazioni pescare a caso e quanto forti applicarle, e provarne tutte le combinazioni è alla portata di chiunque.
Mixup [ZCisseDLP18] costruisce esempi virtuali per interpolazione convessa di coppie del training set:
dove \(\mathbf{x}_i, \mathbf{x}_j\) sono due immagini, \(\mathbf{y}_i,
\mathbf{y}_j\) le rispettive etichette in codifica one-hot e \(\lambda \in [0,1]\)
è estratto da una distribuzione \(\mathrm{Beta}(\alpha, \alpha)\), dove
l’iperparametro \(\alpha\) regola l’intensità della mescolanza: con \(\alpha\)
piccolo (su ImageNet il paper usa valori fra \(0{,}1\) e \(0{,}4\)) \(\lambda\) si
concentra vicino a \(0\) o a \(1\), e le miscele restano leggere; con \(\alpha = 1\),
che è quanto usa sui dataset più piccoli, \(\lambda\) è uniforme e il mezzo e
mezzo capita quanto tutto il resto. Il modello viene addestrato a produrre
predizioni che interpolano linearmente tra le classi, il che regolarizza il
comportamento tra gli esempi, dove il rischio empirico tace. Siccome la
cross-entropy è lineare nel bersaglio, \(\ell(\hat{\mathbf{y}}, \lambda
\mathbf{y}_i + (1-\lambda)\mathbf{y}_j) = \lambda\, \ell(\hat{\mathbf{y}},
\mathbf{y}_i) + (1-\lambda)\, \ell(\hat{\mathbf{y}}, \mathbf{y}_j)\), in codice
l’etichetta mescolata non si costruisce: si mescolano le due perdite. Un
effetto misurato dopo il lavoro originale è la calibrazione, cioè probabilità
meno sbilanciate verso la certezza [TCB+19]. CutMix
[YHO+19] mescola incollando invece che sfumando: con una maschera
binaria \(\mathbf{M}\) che vale \(0\) su un rettangolo casuale, \(\tilde{\mathbf{x}}
= \mathbf{M} \odot \mathbf{x}_i + (\mathbf{1} - \mathbf{M}) \odot
\mathbf{x}_j\), e il \(\lambda\) dell’etichetta è la frazione di area rimasta a
\(\mathbf{x}_i\). L’immagine resta naturale pezzo per pezzo, e a differenza di
Cutout nessun pixel del rettangolo va sprecato: lì la rete vede un’altra classe
e deve riconoscerla. Cutout [DT17] azzera un riquadro
casuale dell’immagine, impedendo alla rete di dipendere da una singola regione
discriminante: un dropout applicato allo spazio dei pixel. L’idea quasi
identica del random erasing lo riempie invece di valori casuali; torchvision
le fa tutte e due con transforms.RandomErasing (da applicare dopo
ToTensor), in cui il valore predefinito è zero, cioè Cutout, mentre per il
random erasing serve value="random". Infine AutoAugment
[CZMane+19] tratta la scelta delle trasformazioni come un
problema di ricerca: un controllore addestrato per rinforzo compone la policy
di augmentation che massimizza l’accuratezza in validazione; il successore
RandAugment ottiene risultati simili riducendo la ricerca a due soli
iperparametri (numero e intensità delle trasformazioni).
Quando aiuta, e quando no#
L’augmentation rende di più dove i dati scarseggiano, ed è la prima cosa da provare quando il modello impara a memoria invece di capire (insieme, non in alternativa, al transfer learning visto nella sezione precedente). Ma non è una moltiplicazione miracolosa: le varianti di una foto portano meno informazione di altrettante foto nuove, perché raccontano sempre la stessa scena.
Soprattutto, non colma da sola la distanza fra i dati su cui il modello si è allenato e quelli che troverà al lavoro. Se è addestrato su foto diurne e in produzione arrivano riprese notturne, o se il nuovo ospedale usa uno scanner diverso da quello del training set, i dati di lavoro non vengono più dalla stessa distribuzione: è lo shift di dominio, un caso del dataset shift di quando i dati cambiano. Le trasformazioni lo riducono soltanto per la parte che sanno imitare: un disturbo di luce e di contrasto copre un pezzo della differenza fra il giorno e la sera, e catene di trasformazioni costruite apposta rendono un modello più robusto a disturbi che non ha mai visto [HMC+20]. La fisica di uno scanner nuovo, o i pazienti di un’altra popolazione, nessuno specchio e nessun ritaglio li imita: lì servono dati rappresentativi del dominio reale.
Anzi, un’augmentation scelta male può peggiorare le cose, perché iniettare l’invarianza sbagliata significa insegnare alla rete una cosa falsa sul mondo. Una radiografia del torace specchiata mette il cuore a destra, un’anatomia rarissima: per un modello che deve dire dove sta il cuore, o da che parte passa un catetere, lo specchio insegna il falso, mentre per uno che cerca una polmonite può essere una trasformazione legittima. Le trasformazioni codificano le nostre ipotesi sul problema, e delle ipotesi, come sempre, si risponde.
Da ricordare
L’augmentation fabbrica varianti di ogni foto (specchiata, ritagliata, ruotata, più chiara) e le conta come esempi nuovi. Le domande da farsi sono due: la risposta giusta non deve cambiare (lo specchio va bene per i gatti e rovina i cartelli stradali, e non è solo lo specchio: un 6 capovolto diventa un 9), e la foto che ne esce dev’essere una foto che potrebbe capitare davvero.
Si applica solo alle foto su cui la rete si allena, e cambia a ogni passaggio. Sulle foto d’esame si fanno solo operazioni che danno sempre lo stesso risultato, altrimenti il voto non misura più niente.
Serve a impedire di imparare a memoria: se il compito non è mai due volte identico, memorizzarlo non conviene più, e l’unica strada che resta è capire.
Ci sono varianti che producono foto che nessuna macchina fotografica scatterebbe: mescolare due foto (e mescolare nelle stesse proporzioni la risposta), coprire un rettangolo a caso come con un post-it, oppure lasciare che sia un algoritmo a cercare la combinazione migliore.
Non è una moltiplicazione miracolosa, e non basta se le foto vere sono di un altro tipo: copre soltanto la parte della differenza che le deformazioni sanno imitare, e se ci si è allenati di giorno e in produzione arrivano riprese notturne servono anche foto nuove.
Da ricordare
L’augmentation genera varianti di ogni immagine con trasformazioni che preservano l’etichetta (o la trasformano insieme all’immagine, se è un riquadro o una maschera) e restano plausibili nel dominio: quali siano dipende dal compito (lo specchio va bene per i gatti, non per cartelli o cifre), e conta anche l’intensità (5 gradi di rotazione su una foto di strada sì, 90 no).
Si applica solo al training set, al volo, a ogni epoca; su validation e test solo operazioni deterministiche (resize, crop centrale, normalize).
È una regolarizzazione: allarga il supporto della distribuzione empirica e contrasta l’overfitting, come il dropout e la penalità \(\ell_2\). Per trasformazioni piccole equivale, a meno di un termine proporzionale al residuo, a una penalità sulla derivata dell’uscita lungo la trasformazione (tangent propagation).
Varianti moderne: mixup (interpolazione di immagini ed etichette), cutout/random erasing (occlusioni casuali), policy apprese (AutoAugment, RandAugment).
Riduce lo shift di dominio solo per la parte che le trasformazioni sanno descrivere (luce, rumore, sfocatura); per il resto servono dati del dominio nuovo.