


Una rete, molti compiti: l’apprendimento multi-compito#
Chi ha studiato il latino racconta spesso di aver capito meglio l’italiano. E non è un modo di dire affettuoso verso il liceo classico: le due materie poggiano sulla stessa impalcatura, e faticare sulla declinazione di una costringe a guardare in faccia una struttura che nell’altra si usava senza accorgersene. Imparare due cose imparentate insieme non costa il doppio, e a volte costa meno che impararne una sola.
Le reti della storia appena raccontata imparavano un compito ciascuna: classificare le fotografie di ImageNet, e nient’altro. L’idea che imparare più compiti insieme convenga anche a una rete neurale ha un articolo di riferimento e una data: Rich Caruana, 1997, in un lavoro il cui titolo è semplicemente Multitask Learning [Car97].
La tesi è questa. Si addestra una rete su più compiti collegati, tutti insieme, e si fa in modo che partano dallo stesso lavoro preliminare: gli stessi numeri intermedi, calcolati una volta sola, da cui poi ciascun compito ricava la sua risposta. È la rappresentazione condivisa. Se i compiti sono davvero collegati, il compito principale generalizza meglio, cioè sbaglia meno su esempi mai visti; e il guadagno viene dal compito in più, che porta informazione a quello principale, più che dal risparmio di memoria.
È una tecnica che si incontra dappertutto senza che quasi mai qualcuno la chiami per nome. Il rilevatore di oggetti che dice insieme che cosa c’è nella foto e in che punto si trova (la categoria e le quattro coordinate del riquadro che lo racchiude) fa multi-compito. La rete che da una sola fotografia di una strada stima insieme quanto è lontano ogni pixel e a quale oggetto appartiene fa multi-compito. Il sistema di raccomandazione che stima insieme la probabilità che tu clicchi su un prodotto e quella che tu lo compri fa multi-compito, e la seconda è rara quanto preziosa: di acquisti se ne vedono molti meno che di clic, e il compito abbondante aiuta quello raro.
Un tronco, tante teste#
Prima del perché, la forma: come è fatta materialmente una rete che fa più cose.
La struttura si disegna in un attimo: un tronco condiviso, che elabora l’ingresso, e in cima tante teste quante sono le cose da predire, una per compito. Il tronco è la rappresentazione condivisa di cui parlavamo: il lavoro fatto una volta sola e buono per tutti. Ogni testa lo traduce nella risposta che le serve.
L’immagine giusta è quella di un ufficio: c’è un archivio comune, dove il materiale viene letto e ordinato una volta sola, e poi ci sono gli sportelli specializzati che da quello stesso archivio ricavano risposte diverse. Nessuno rilegge i documenti da capo per ogni domanda.
Il conto, però, è uno solo. A fine giornata non si guarda uno sportello per volta: si somma quanto ha sbagliato ciascuno e ne esce un numero unico, ed è quel numero che si cerca di far scendere, sistemando insieme l’archivio e gli sportelli. Nel sommare bisogna decidere quanto conta ciascuno sportello, e quella decisione è la più delicata di tutte.
Non è l’unica forma possibile. A volte i compiti sono parenti ma non abbastanza da poter condividere tutto: allora si tengono due reti separate, ciascuna col suo lavoro, e si chiede soltanto che non si allontanino troppo l’una dall’altra. Vicine, qui, vuol dire con numeri simili al loro interno: alla fine di ogni passo si controlla quanto i pesi dell’una differiscono da quelli dell’altra, e più la differenza cresce più sale la multa che si aggiunge al conto. Sono due uffici distinti che però tengono le procedure allineate. Costa di più, perché le reti sono due, ma non obbliga due compiti diversi a usare per forza la stessa identica preparazione.
Nella pratica si finisce quasi sempre in mezzo: condiviso in basso, separato in alto. In basso una rete impara cose generiche (i bordi, le forme, la struttura della frase) che servono a chiunque; in alto cose specifiche del compito, che è giusto restino separate.
I mestieri si possono anche imparare uno alla volta, invece che tutti insieme. Si arriva in fondo lo stesso, con un rischio che l’altra via non corre: mentre impara il secondo mestiere l’ufficio riordina l’archivio come conviene a quello, e del primo si dimentica, perché a fine giornata nessuno gliene chiede più conto. Imparandoli insieme il primo resta nel conto tutti i giorni, e non può essere lasciato cadere in silenzio.
La forma standard è la condivisione dura (hard parameter sharing): un tronco \(g_\phi\) comune e \(T\) teste \(h_{\theta_t}\), addestrati minimizzando una somma pesata
Qui \(\mathbf{x}\) è l’esempio in ingresso, \(\phi\) sono i parametri del tronco condiviso e \(\theta_t\) quelli della testa del compito \(t\), \(y_t\) è l’etichetta di quel compito, \(\mathcal{L}_t\) la sua perdita e \(\lambda_t > 0\) il peso con cui entra nella somma. Quei pesi sono il punto delicato di tutto il metodo.
L’alternativa è la condivisione morbida (soft sharing): \(T\) reti separate, ciascuna con i propri parametri, legate da un termine di regolarizzazione che ne penalizza la distanza, per esempio \(\sum_{t \neq s} \lVert \psi_t - \psi_s \rVert_2^2\), dove \(\psi_t\) sono tutti i parametri della rete del compito \(t\) (qui di tronco condiviso non ce n’è, quindi la \(\phi\) di sopra non servirebbe). Costa \(T\) volte i parametri ma non impone una rappresentazione unica: si usa quando i compiti sono affini ma non sovrapponibili. Ha una manopola continua, la forza \(\mu\) con cui la penalità entra nella loss: con \(\mu = 0\) le reti sono indipendenti, e per \(\mu \to \infty\) i parametri penalizzati diventano uguali, quindi se la penalità esclude gli strati d’uscita il limite è la condivisione dura.
Le forme miste condividono gli strati bassi e lasciano separati gli alti, ed è quasi sempre la scelta pratica, per la ragione già vista parlando di rappresentazioni gerarchiche: le feature generiche stanno in basso e quelle specifiche in alto, quindi il punto in cui separare le teste è una decisione su quanto in alto arriva la parentela fra i compiti.
Il transfer learning già incontrato è lo stesso schema disteso nel tempo: là i compiti si affrontano in sequenza (si pre-addestra su uno, si rifinisce sull’altro), qui in parallelo. La differenza pratica è che il sequenziale può dimenticare il primo compito mentre impara il secondo, e il parallelo no, perché il primo è ancora nella loss.

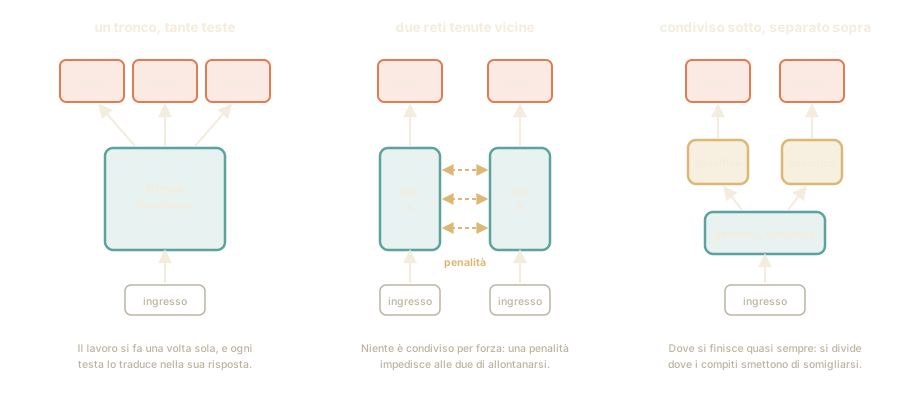
Fig. 10.17 Le tre forme, una accanto all’altra. Quello che cambia è dove passa la linea fra ciò che i compiti fanno insieme e ciò che ciascuno fa per conto suo: nel primo disegno passa in cima, nel secondo non passa affatto (le due reti non condividono niente), nel terzo passa a metà altezza.#
Messe in fila come in Fig. 10.17, le tre forme si rivelano tre risposte alla stessa domanda: fino a che altezza i compiti si somigliano. La prima scommette che si somiglino fino in cima, e ci rimette se la scommessa è sbagliata. La seconda non scommette niente, e il conto lo paga in numeri da imparare, che sono il doppio; ha però una manopola, la forza della penalità che tiene vicine le due reti, e più la si alza più le due reti si somigliano. La terza sceglie l’altezza a cui separare i compiti.
Perché funziona: il compito in più fa da freno#
Che funzioni è un fatto sperimentale vecchio di trent’anni; il perché, invece, non è uno solo. Le ragioni vanno tenute separate, perché dicono cose diverse su quando aspettarsi un guadagno e quando no.
Il motivo più ovvio è la quantità di segnale. Il compito in più porta con sé altre etichette, cioè altre risposte giuste scritte accanto agli esempi, come «in questa foto c’è un gatto». Le etichette costano, perché quasi sempre è una persona a doverle scrivere una per una, e a volte sono semplicemente rare (di persone che comprano ce ne sono molte meno di persone che guardano). Ogni etichetta in più è un’occasione in più di capire com’è fatto l’ingresso, e il guadagno è massimo quando il compito che ci sta a cuore ne ha poche e quello di contorno ne ha tante. Al contrario, se del compito principale abbiamo già esempi in abbondanza, questo vantaggio si assottiglia fino a sparire. E c’è un limite: le etichette in più aiutano a leggere l’archivio comune, ma ogni sportello deve imparare il proprio mestiere dai propri esempi, e lì il compito di contorno non lo può sostituire.
Un secondo motivo, più sottile: il compito in più fa da freno. Una rete lasciata sola con un compito trova la soluzione di comodo per risolverlo, e le soluzioni di comodo sono proprio ciò che non generalizza. Se la stessa rappresentazione deve servire anche a un secondo compito, quelle soluzioni smettono di essere convenienti, perché al secondo non servono. La rete è spinta verso soluzioni più generali, e questo è esattamente ciò che in gergo si chiama regolarizzazione: qualunque accorgimento che, restringendo le strade che la rete può prendere, la costringa a una risposta che vale in generale invece che a una perfetta sugli esempi già visti. Un freno rende dove c’è da frenare, cioè quando gli esempi sono pochi e la rete è libera di inventarsi qualunque cosa. Quando gli esempi abbondano le soluzioni di comodo sono già poche di loro, e il compito in più, invece di aggiungere, può cominciare a togliere.
Poi c’è l’attenzione, e qui la parola è quella di tutti i giorni: certi compiti dicono alla rete dove guardare. Se per rispondere alla seconda domanda serve un dettaglio che per la prima sembrava trascurabile, la rete impara comunque a rappresentarlo, e magari scopre che serviva anche alla prima.
L’argomento di Caruana è statistico, non ingegneristico: i compiti condividono un bias induttivo. Ogni algoritmo di apprendimento ne ha uno, cioè un insieme di assunzioni implicite che rendono preferibili certe ipotesi; addestrare su più compiti significa cercare l’ipotesi che soddisfa tutti i loro bias insieme, il che restringe lo spazio delle soluzioni ammissibili.
Caruana ne distingue i meccanismi [Car97]. L’amplificazione statistica dei dati: se due compiti usano la stessa feature nascosta e le loro etichette hanno rumore indipendente, la rete che li impara insieme stima quella feature mediando i due rumori, come con un campione più grande. La selezione degli attributi, che ne è una conseguenza: con pochi dati e molti ingressi irrilevanti, due segnali riconoscono meglio quali ingressi contano. L’eavesdropping, l’origliare: una feature facile da imparare per un compito e difficile per un altro viene appresa grazie al primo e usata dal secondo attraverso lo strato condiviso. Il bias di rappresentazione: fra le soluzioni che la discesa del gradiente può trovare, la rete a più compiti preferisce quelle che servono a tutti.
Chiedere alla stessa rappresentazione di servire più compiti restringe lo spazio delle ipotesi con informazione vera, e agisce da regolarizzazione: il rumore specifico di un compito viene mediato via, la struttura comune sopravvive. Nel compromesso bias-varianza già incontrato si accetta un po’ di bias in cambio di molta varianza in meno, ed è per questo che il guadagno è massimo dove la varianza è alta, cioè con pochi dati per il compito principale. Con dataset abbondanti l’effetto si assottiglia fino a sparire, e a volte si inverte.
La forma quantitativa la danno Maurer, Pontil e Romera-Paredes [MPRP16], per \(T\) compiti di \(m\) esempi ciascuno, una rappresentazione condivisa e un predittore per compito: l’eccesso di rischio medio sui compiti, rispetto alla scelta migliore nelle stesse classi, è limitato con probabilità almeno \(1-\delta\) da tre termini. Per classi limitate il primo, il prezzo della rappresentazione condivisa, va come \(O\big(1/\sqrt{mT}\big)\), cioè si ripartisce su tutti gli \(mT\) esempi; il secondo, il prezzo dei predittori specifici, va come \(O\big(1/\sqrt{m}\big)\) e da \(T\) non dipende; il terzo, di confidenza, come \(O\big(\sqrt{\ln(1/\delta)/(mT)}\big)\). Aggiungere compiti abbassa il primo e non il secondo: il guadagno è massimo quando \(m\) è piccolo e il costo sta nella rappresentazione.
Una nota a margine: la distinzione fra multi-compito e apprendimento auto-supervisionato è meno netta di quanto sembri. Un compito inventato apposta perché la rete impari qualcosa (predire la rotazione di un’immagine, ricostruire una parte mascherata) è un compito ausiliario a tutti gli effetti, con la comodità che le sue etichette sono gratis. Le due letterature descrivono lo stesso meccanismo arrivandoci da due direzioni.
Quando invece fa danno#
C’è però un limite importante, ed è la ragione per cui questa non è una tecnica da usare sempre.
Funziona se i compiti sono imparentati. Se non lo sono, si contendono la stessa rappresentazione e finiscono peggio di quando erano separati. Studiare latino aiuta l’italiano; studiare latino la sera prima di una gara di nuoto non aiuta il nuoto, e toglie ore all’allenamento.
Il meccanismo del danno è concreto. Il tronco ha una capacità finita: i numeri che può regolare sono tanti, ma sono un numero preciso, e quello che riesce a tenere a mente è limitato da quanti sono. Ogni pezzo di quella capacità speso per un compito che non c’entra è un pezzo tolto a quello che conta. Peggio: i due compiti possono chiedere al tronco cose incompatibili, e allora ogni passo che accontenta l’uno scontenta l’altro, e l’addestramento passa il tempo a oscillare invece di migliorare.
Il litigio si può smussare invece che subirlo, ed è quello che prova a fare il rimedio più noto: a ogni passo si guardano le correzioni che i due compiti chiedono al tronco, a ciascuna si toglie la parte che tira contro l’altra, e il resto si lascia intatto. Si chiama PCGrad, dall’inglese projecting conflicting gradients, «proiettare i gradienti in conflitto». L’idea è pulita e la diagnosi che la ispira regge; sulla cura si discute ancora. Chi ha rifatto i confronti su larga scala ha trovato che la semplice somma dei due errori, purché regolata con gli stessi accorgimenti che si userebbero per un compito solo (i freni contro l’imparare a memoria, il passo scelto con cura), tiene il passo o fa meglio.
C’è poi un problema più prosaico e altrettanto insidioso, e nasce dal fatto che il conto da far scendere è uno: si prende quanto la rete sbaglia sul primo compito, si prende quanto sbaglia sul secondo e si sommano. Quanto deve pesare ciascuno dei due in quella somma? Se un compito misura un errore in metri e un altro una probabilità, i loro numeri non sono paragonabili, e chi ha i numeri più grossi finisce per comandare l’addestramento senza che nessuno l’abbia deciso. Si può regolare a mano, provando, oppure lasciare che sia la rete a capire quanto fidarsi di ciascun compito: quelli su cui è molto incerta pesano meno. Con un’avvertenza: dichiararsi incerta deve costarle qualcosa, se no la strada più comoda è dirsi incertissima su tutto, dare a ogni compito un peso quasi nullo e ritrovarsi con un conto vicino a zero senza aver imparato niente.
E la domanda a monte, «questi due compiti sono imparentati?», non ha una formula. Si risponde provando.
Il rovescio ha un nome, trasferimento negativo (negative transfer), e una diagnosi meccanica proposta da Yu e colleghi: i gradienti in conflitto. I gradienti che due compiti imprimono ai parametri condivisi possono avere prodotto scalare negativo, e allora ogni passo che aiuta l’uno danneggia l’altro. PCGrad [YKG+20] interviene esattamente lì. Chiamati \(\mathbf{g}_i = \nabla_\phi \mathcal{L}_i\) i gradienti dei compiti rispetto ai soli parametri condivisi, quando \(\mathbf{g}_i^\top \mathbf{g}_j < 0\) si sostituisce \(\mathbf{g}_i\) con la sua proiezione sul piano normale a \(\mathbf{g}_j\),
e simmetricamente \(\mathbf{g}_j\) contro il \(\mathbf{g}_i\) originale, prima di sommarli: si toglie la sola componente distruttiva e si lascia intatto il resto. Con più di due compiti ogni gradiente si proietta contro gli altri uno alla volta, in ordine casuale, perché il risultato dipende dall’ordine. Il prezzo è nel conto: invece di un solo passaggio all’indietro sulla somma delle perdite ne servono \(T\), e in memoria \(T\) gradienti della dimensione di \(\phi\).
Il beneficio pratico di questa famiglia di metodi è però contestato: confronti su larga scala trovano che la somma pesata semplice, purché regolarizzata e stabilizzata come si farebbe per un compito solo, li eguaglia o li batte [KDPK+22], e che su compiti di visione e di linguaggio non producono guadagni oltre l’ottimizzazione ordinaria [XGG+22]. Il conflitto fra gradienti resta una buona diagnosi; che proiettarli sia la cura è meno stabilito di quanto la letteratura sui metodi lasci pensare.
Serve una cautela metodologica su questa diagnosi, perché è facile misurarla male: il prodotto scalare fra gradienti va guardato durante l’addestramento e sui parametri condivisi, non all’inizializzazione. All’inizio le teste sono casuali e possono assorbire un cambio di segno senza che il tronco se ne accorga, quindi un conflitto vero fra compiti può benissimo non comparire come coseno negativo.
Resta il problema dei pesi \(\lambda_t\), insidioso perché le loss di compiti diversi hanno unità e scale diverse (una cross-entropia e un errore in metri non sono commensurabili) e cercarli a mano è un’ottimizzazione in \(T-1\) dimensioni, ciascuna delle quali costa un addestramento. La soluzione di Kendall, Gal e Cipolla [KGC18] li tratta come funzione dell’incertezza omoschedastica di ciascun compito, parametrizzata da un \(\sigma_t\) appreso. Omoschedastica perché quel \(\sigma_t\) dipende dal compito e non dall’esempio, al contrario della regressione eteroschedastica di Da dove viene la loss, da cui prende però la stessa forma. Per compiti tutti di regressione:
dove il primo termine abbassa il peso dei compiti rumorosi e il secondo impedisce la soluzione degenere \(\sigma_t \to \infty\), che li azzererebbe tutti. I pesi smettono di essere iperparametri e diventano parametri. A pesi della rete fissati, il minimo in \(\sigma_t\) si trova in chiuso: è \(\sigma_t^2 = \mathcal{L}_t\), dove il compito pesa \(1/(2\mathcal{L}_t)\), inversamente alla propria loss corrente, e la loss congiunta vale \(\tfrac12\sum_t (1 + \log\mathcal{L}_t)\). Il criterio, cioè, equivale a minimizzare la somma dei logaritmi delle loss, a meno di costanti, e nessun compito può comandare solo perché i suoi errori sono numeri grandi. In pratica si impara \(s_t = \log\sigma_t^2\), che evita la divisione per zero e non ha vincoli di segno.
Il fattore però cambia con il tipo di compito, ed è la parte che si ricopia sbagliata. In un compito di classificazione \(\sigma_t\) fa un altro mestiere, la temperatura di una softmax, e il peso che ne discende è \(1/\sigma_t^2\), senza il \(2\): la loss congiunta di una regressione e di una classificazione è \(\frac{1}{2\sigma_1^2}\mathcal{L}_1 + \frac{1}{\sigma_2^2}\mathcal{L}_2 + \log\sigma_1 + \log\sigma_2\), e l’ultimo passaggio che le dà questa forma è un’approssimazione, esatta soltanto per \(\sigma_2 = 1\).
Sulla domanda a monte, quali compiti stiano bene insieme, non c’è una teoria utilizzabile: le misure di affinità fra compiti sono un’area di ricerca aperta, e in pratica si procede empiricamente, provando i compiti a coppie e tenendo quelli che aiutano.
In pratica: il guadagno si misura, e può essere negativo#
L’affermazione «un compito imparentato aiuta, uno che non c’entra niente danneggia» si può verificare, e l’esperimento sta in una pagina.
L’impianto è questo. Si inventa una quantità nascosta: un numero che non si vede, ricavato dall’ingresso con una regola fissa. Il compito principale, quello che ci sta a cuore, chiede di indovinare proprio quel numero, e di esempi etichettati ne ha pochissimi, quaranta. Accanto gli si mette un compito ausiliario, cioè un compito di contorno che serve solo ad aiutare il primo, e di esempi ne ha molti, ottocento. Di ausiliari ne proviamo due: uno imparentato, che chiede il quadrato della stessa quantità nascosta, e uno che non c’entra niente, il cui bersaglio è puro caso e che nessuna rete può imparare.
Poi si confrontano tre addestramenti sullo stesso identico tronco: senza ausiliario, con quello imparentato, con quello inutile; poi ancora due volte quello inutile, pesato di meno. I numeri che ne escono sono la risposta.
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.set_num_threads(1)   # su una macchina carica i thread si ostacolano

D, H = 12, 64
N_ETICHETTATI, N_AUSILIARI, N_TEST = 40, 800, 2000   # poche etichette dove servono

def dati(seme):
    g = torch.Generator().manual_seed(seme)
    n = N_AUSILIARI + N_TEST
    X = torch.randn(n, D, generator=g)
    w = torch.randn(D, generator=g)
    nascosto = torch.tanh(X @ w)                 # la quantità che conta davvero
    return X, {
        "principale": nascosto,                  # etichettata solo su 40 esempi
        "parente":    nascosto ** 2,             # dipende dalla STESSA quantità
        # bersaglio che non dipende da X: nessuna rete può impararlo
        "rumore":     torch.randn(n, generator=g),
    }

def addestra(X, y, ausiliario, seme, passi=800, peso=1.0):
    torch.manual_seed(seme)
    tronco = nn.Sequential(nn.Linear(D, H), nn.Tanh(), nn.Linear(H, H), nn.Tanh())
    teste = nn.ModuleDict({k: nn.Linear(H, 1) for k in y})
    ott = torch.optim.Adam(list(tronco.parameters()) + list(teste.parameters()),
                           lr=3e-3)
    for _ in range(passi):
        # il compito principale vede 40 esempi, l'ausiliario ne vede 800
        perdita = F.mse_loss(teste["principale"](tronco(X[:N_ETICHETTATI])).squeeze(-1),
                             y["principale"][:N_ETICHETTATI])
        if ausiliario:
            perdita = perdita + peso * F.mse_loss(
                teste[ausiliario](tronco(X[:N_AUSILIARI])).squeeze(-1),
                y[ausiliario][:N_AUSILIARI])
        ott.zero_grad(); perdita.backward(); ott.step()
    with torch.no_grad():
        pred = teste["principale"](tronco(X[N_AUSILIARI:])).squeeze(-1)
        return F.mse_loss(pred, y["principale"][N_AUSILIARI:]).item()

def prova(ausiliario, peso=1.0):
    """L'errore sul test di ciascuno dei cinque semi."""
    return [addestra(*dati(s)[:2], ausiliario, s, peso=peso) for s in range(5)]

base = prova(None)                       # cinque semi per configurazione
media_base = sum(base) / len(base)
print(f"ausiliario: {'nessuno':<14} errore sul test {media_base:.4f}   (  +0%)")
for ausiliario, peso in (("parente", 1.0), ("rumore", 1.0),
                         ("rumore", 0.1), ("rumore", 0.01)):
    errori = prova(ausiliario, peso)
    media = sum(errori) / len(errori)
    # lo stesso seme con e senza ausiliario: stessi dati, stessa partenza
    per_seme = [100 * (e - b) / b for e, b in zip(errori, base)]
    nome = ausiliario if peso == 1.0 else f"{ausiliario} x{peso}"
    print(f"ausiliario: {nome:<14} errore sul test {media:.4f}"
          f"   ({100 * (media - media_base) / media_base:+4.0f}%;"
          f" semi da {min(per_seme):+.0f}% a {max(per_seme):+.0f}%)")
ausiliario: nessuno        errore sul test 0.2829   (  +0%)
ausiliario: parente        errore sul test 0.0993   ( -65%; semi da -82% a -39%)
ausiliario: rumore         errore sul test 0.3523   ( +25%; semi da +15% a +36%)
ausiliario: rumore x0.1    errore sul test 0.3038   (  +7%; semi da -2% a +17%)
ausiliario: rumore x0.01   errore sul test 0.2871   (  +1%; semi da -2% a +7%)
Ogni numero è la media di cinque prove che differiscono solo per il seme, cioè per il punto da cui parte il generatore di numeri casuali: pesi iniziali diversi, dati diversi. Una prova sola misurerebbe anche la fortuna. E i numeri presi da soli non dicono niente, perché dipendono da quanto sono grandi le quantità che stiamo cercando di indovinare, che le abbiamo scelte noi: conta il confronto fra i tre. Fra parentesi, accanto alla variazione media, c’è quella più bassa e quella più alta fra i cinque semi, ciascuno confrontato con lo stesso seme senza ausiliario (stessi dati, stessa partenza).
nessun ausiliario: errore \(0{,}2829\). Quaranta esempi sono pochi, e si vede;
ausiliario imparentato: \(0{,}0993\), cioè il 65% di errore in meno, e su ogni seme fra il 39% e l’82% in meno. Il secondo compito non condivide le etichette del primo, condivide la quantità nascosta da cui entrambi dipendono, e ottocento esempi su quella quantità hanno insegnato al tronco quello che quaranta non bastavano a insegnare;
ausiliario che non ha niente da insegnare: \(0{,}3523\), cioè il 25% di errore in più, e per giunta su tutti e cinque i semi, fra il 15% e il 36%: peggio che non averlo. La capacità del tronco spesa a inseguire quel bersaglio è capacità sottratta al compito che contava.
Il terzo numero è il più importante dei tre, perché è quello che di solito non si racconta: il multi-compito non è una tecnica che si aggiunge e male che vada non fa niente. Male che vada fa danno. Va però letto per quello che è: il bersaglio del terzo braccio è rumore puro, un caso estremo che nessuna rete può imparare, quindi quello che l’esperimento misura con precisione è la prima delle due cause di danno, la capacità del tronco sprecata. Un compito diverso ma imparabile fa in genere molto meno danno di così.
C’è una seconda cosa che quel \(+25\%\) non dice, ed è la manopola. Le righe
parente e rumore sommano i due errori con peso uguale, cioè
\(\lambda_1 = \lambda_2 = 1\) (le \(\lambda\) sono i pesi con cui i due compiti
entrano nella somma): la scelta più innocente possibile, e anche la meno
difendibile, visto che poco fa si è detto che sono proprio quei pesi a
comandare l’addestramento senza che nessuno l’abbia deciso. Le ultime due
rifanno le stesse cinque prove con l’ausiliario pesato \(\lambda = 0{,}1\) e
\(\lambda = 0{,}01\): il danno medio scende a \(+7\%\), e su almeno un seme
l’ausiliario aiuta (da \(-2\%\) a \(+17\%\)), e poi a \(+1\%\), che sui cinque
semi non si distingue da zero (da \(-2\%\) a \(+7\%\)). Il trasferimento
negativo, cioè il danno che un compito fa a un altro, è insomma una proprietà
della coppia e del peso che le si dà, non della sola coppia di compiti.
E per simmetria va detto anche del primo numero, il migliore dei tre. Il compito «parente» è imparentato quanto è possibile esserlo: il suo bersaglio si ricava dalla stessa quantità nascosta del compito principale con un conto fisso (il quadrato), e nient’altro. Non ha una sola difficoltà propria: chi ha imparato il principale ha già in mano tutto quello che serve al «parente». Il contrario vale quasi, ma non del tutto, e quello che manca è il segno. Un numero e il suo opposto hanno lo stesso quadrato, quindi dal «parente» il tronco impara quale combinazione degli ingressi guardare, cioè la direzione \(\mathbf{w}\) della quantità nascosta \(\tanh(\mathbf{x}^\top\mathbf{w})\), ma il segno di quella quantità deve impararlo dai soli quaranta esempi etichettati. Il \(-65\%\) è dunque vicino al tetto di quello che un compito in più può fare, non a un caso tipico: due compiti davvero distinti condividono una parte della struttura, non tutta.
Che compiti in competizione peggiorino il risultato è comunque un fatto documentato su scala ben più grande di questa [SZC+20], e quanto danno facciano dipende da una domanda che nessuna formula risolve, cioè se i compiti siano davvero imparentati. Stabilire quali stiano bene insieme è ancora, in larga parte, un problema aperto: si misura empiricamente, provandoli a coppie, più che deducendolo.
Da ricordare
Una rete può imparare più cose insieme: un tronco comune, che legge l’ingresso una volta sola per tutti, e in cima una testa per ogni risposta da dare. È l’ufficio con l’archivio comune e gli sportelli specializzati.
Il compito in più aiuta per tre motivi diversi: porta altri esempi; fa da freno, perché le soluzioni di comodo per un compito solo smettono di convenire quando la stessa preparazione deve servire anche a un altro; e indica dove guardare, cioè quali dettagli valeva la pena notare.
Aiuta soprattutto quando del compito che ci sta a cuore abbiamo pochi esempi. Se ne abbiamo tanti, il vantaggio si assottiglia fino a sparire.
Ma solo se i compiti sono imparentati. Se non lo sono si contendono lo stesso tronco e finiscono peggio di quando erano separati: il latino aiuta l’italiano, non il nuoto. E non c’è una formula per saperlo prima: si prova.
Un altro problema pratico è quanto pesa ciascun compito nel conto dell’errore: se uno misura metri e l’altro una probabilità, quello con i numeri più grossi comanda l’addestramento senza che nessuno l’abbia deciso. Si può regolare a mano, oppure lasciare che sia la rete a fidarsi di meno dei compiti su cui è più incerta.
Misurato su un caso costruito apposta: un compito ausiliario imparentato ha tolto il 65% dell’errore, uno fatto di numeri casuali ne ha aggiunto il 25%. Non è una tecnica neutra. Sono però i due estremi, e contati dando ai due compiti lo stesso peso nella somma: dando all’ausiliario un peso dieci volte minore, il danno medio scende dal 25% al 7%.
Da ricordare
L’apprendimento multi-compito addestra una rete su più compiti insieme con una rappresentazione condivisa: un tronco comune e una testa per compito (condivisione dura), oppure reti separate tenute vicine da una penalità (condivisione morbida).
Il guadagno ha più meccanismi, che Caruana distingue: l’amplificazione statistica (più segnale sulla stessa feature, soprattutto se il compito principale ha poche etichette), la selezione degli attributi e l’eavesdropping (un compito indica alla rete che cosa conviene rappresentare), il bias di rappresentazione (la ricerca preferisce le soluzioni che servono a tutti). Nella forma quantitativa di Maurer e colleghi il prezzo della rappresentazione condivisa si ripartisce su tutti gli \(mT\) esempi, quello dei predittori specifici no.
L’argomento di Caruana è statistico: i compiti condividono un bias induttivo, e cercare l’ipotesi che li soddisfa tutti restringe lo spazio delle soluzioni. È regolarizzazione, quindi rende di più dove la varianza è alta, cioè con pochi dati.
Il rovescio è il trasferimento negativo: compiti non imparentati si contendono la rappresentazione e peggiorano il risultato. La diagnosi meccanica sono i gradienti in conflitto; proiettarli (PCGrad) è il rimedio più noto, ma che serva davvero è contestato dai confronti su larga scala.
I pesi \(\lambda_t\) delle loss non sono commensurabili fra compiti; si possono apprendere trattandoli come incertezza di ciascun compito (\(\mathcal{L} = \sum_t [\mathcal{L}_t/(2\sigma_t^2) + \log\sigma_t]\) per una regressione, con \(1/\sigma_t^2\) al posto di \(1/(2\sigma_t^2)\) per una classificazione), invece di cercarli a mano; all’ottimo ogni compito pesa l’inverso della propria loss, e il criterio diventa la somma dei logaritmi delle loss.
Misurato su un caso costruito: un ausiliario imparentato toglie il 65% dell’errore, un ausiliario fatto di puro rumore ne aggiunge il 25%. Non è una tecnica neutra. Entrambi i numeri sono estremi (il «parente» è una funzione deterministica del bersaglio principale) e valgono per \(\lambda_t\) uguali: con l’ausiliario pesato \(0{,}1\) il danno medio scende al 7%, con \(0{,}01\) all’1%, che sui cinque semi non si distingue da zero.
Resta un tronco solo che serve a più mestieri: la profondità costruisce una scala di descrizioni, dal bordo alla forma, e quella scala non appartiene al compito per cui era nata. Il che rende sensata la domanda successiva, e il meta-apprendimento la prende di petto: se quella scala non appartiene ai compiti che l’hanno costruita, quanto poco basta per farla servire a un mestiere che quando la si costruiva non esisteva?