


Modelli che vedono e parlano#
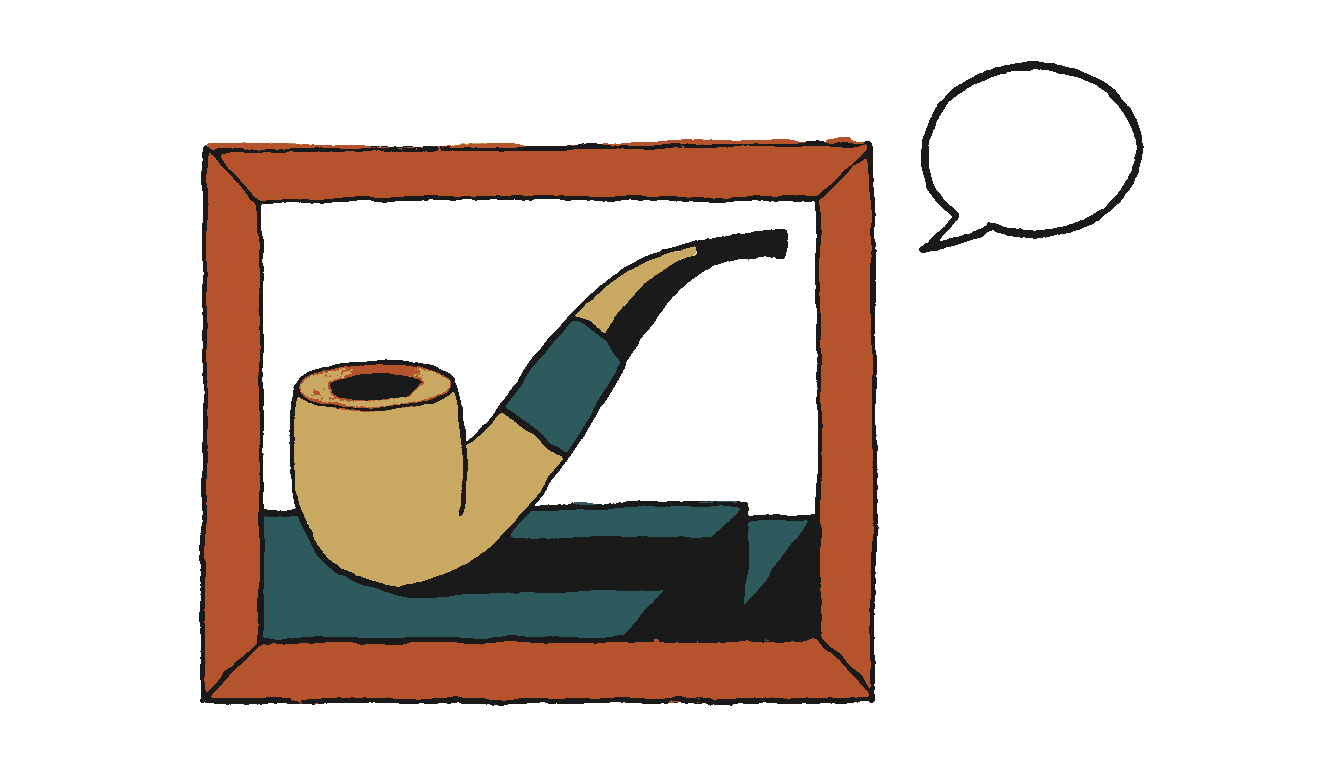
Nel 1929 René Magritte dipinge una pipa su fondo chiaro e, sotto, ci scrive a mano Ceci n’est pas une pipe: questa non è una pipa. È una constatazione esatta, non un gioco di parole. Il disegno non è la pipa, è un velo di colore steso su una tela; e la frase sotto è una fila di segni dipinti anch’essa. Eppure chi guarda il quadro attraversa quei due confini senza accorgersene: vede una forma, pensa a un oggetto, gli dà un nome.
Per una macchina quel passaggio non avviene da sé, ed è stato a lungo il confine fra due mestieri separati. Da una parte i programmi che guardano, addestrati a mettere una fotografia in una casella e poi a tacere; dall’altra i programmi che scrivono, addestrati a indovinare la parola dopo. Farli lavorare insieme non vuol dire attaccare una telecamera a un generatore di testo: vuol dire costruire un posto in cui le misure della luce e le parole di una lingua possano incontrarsi. Di posti così oggi sappiamo costruirne tre, e da ciascuno nasce una famiglia di modelli.
Due materie che non si somigliano#
Perché mettere insieme testo e immagini è un problema, e non una questione di formato? Perché le due materie prime hanno una natura opposta.
Una pagina di libro arriva già tagliata a pezzi: le parole. Sono in numero finito, ognuna ha un nome, e a separarle ci pensano gli spazi. «Il gatto nero salta sul muro» sono sei parole per tutti, sempre le stesse, sempre in quell’ordine.
Una fotografia no. È un tappeto di puntini colorati, dodici milioni in uno scatto da telefono, ciascuno con tre numeri per il rosso, il verde e il blu. Nel tappeto non c’è nessuna cucitura che dica «qui finisce il gatto e comincia il muro»: quel confine lo vediamo noi, non è scritto nei numeri. E se sposti la macchina di due centimetri, tutti e dodici i milioni di puntini cambiano valore mentre la scena resta la stessa; la frase, intanto, non si è mossa di una virgola.
Farli lavorare insieme vuol dire allora due cose: prima dare all’immagine dei «pezzi», poi decidere dove quei pezzi incontrano le parole.
Un testo è una sequenza \(\mathbf{x} = (x_1, \dots, x_T)\) con \(x_t \in V\), dove \(V\) è un vocabolario finito: discreto, ordinato in una dimensione, già simbolico, perché l’unità minima porta significato di per sé. Un’immagine è un tensore \(\mathbf{I} \in \mathbb{R}^{H \times W \times 3}\), con \(H\) e \(W\) altezza e larghezza in pixel e tre canali di colore: continuo, ordinato in due dimensioni e privo di unità naturali. Il pixel non è un simbolo, e non esiste una segmentazione canonica del reticolo in parti dotate di senso; la segmentazione è semmai l’esito di un modello, non il suo input.
La seconda asimmetria riguarda la metrica: la distanza \(\ell_2\) nello spazio dei pixel non è invariante rispetto alle trasformazioni che lasciano il contenuto identico. Una traslazione di pochi pixel porta un’immagine a una distanza dall’originale dello stesso ordine di quella che la separa da un’immagine qualunque di un’altra scena. Le invarianze che ci interessano (traslazione, illuminazione, punto di vista, scala) sono esattamente quelle che la metrica nativa non ha.
Servono quindi due decisioni distinte: in che modo rappresentare l’immagine come sequenza di vettori di dimensione fissa, in uno spazio dove la vicinanza sia somiglianza semantica, e dove i due flussi si incontrano, cioè a quale profondità del sistema informazione visiva e informazione linguistica smettono di essere separate.
Fare dell’immagine una sequenza#
La prima delle due decisioni, dare all’immagine delle unità, ha una risposta condivisa da quasi tutti i sistemi attuali: il Vision Transformer [DBK+21], descritto nella sezione sulle famiglie di modelli. L’immagine si divide in quadrati di lato fisso, le tessere (in inglese patch: da qui in avanti useremo i due termini come sinonimi); ogni tessera diventa un vettore per proiezione lineare, e a ogni vettore si somma una codifica di posizione, che registra il posto della tessera nella griglia.

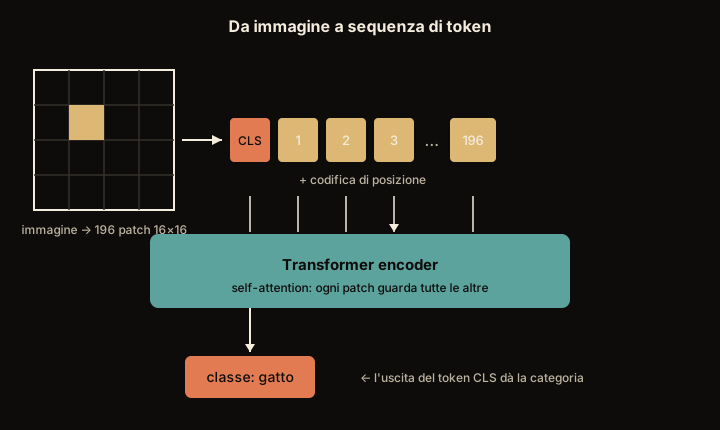
Fig. 19.1 Il gesto da richiamare. La codifica di posizione è la parte da non perdere:
senza, la sequenza sarebbe un mucchio di tessere e l’immagine non avrebbe più
un sopra e un sotto. Il token in testa alla fila, CLS (il token di classe),
non viene da nessuna tessera: è il posto in cui si raccoglie il riassunto
dell’immagine intera.#
Da qui il problema cambia forma: testo e immagine sono ora due sequenze di vettori, \(T\) token da una parte e \(N\) tessere dall’altra, cioè oggetti dello stesso tipo. Il numero di tessere però non è libero, perché ogni tessera in più ha un costo, e il conto va fatto subito.
Il taglio in tessere è quello già incontrato fra i Transformer: la foto a mosaico, le tessere in fila come le parole di una frase. Qui servono i suoi numeri. Prima di tagliarla, la foto da dodici milioni di puntini si rimpicciolisce, per esempio fino a \(224 \times 224\), poco più di cinquantamila puntini. Con tessere da \(16 \times 16\) ne stanno \(224 : 16 = 14\) per riga e altrettante per colonna, cioè \(14 \times 14 = 196\): una «frase» di 196 pezzi, ciascuno trasformato in una lista di numeri con attaccata l’etichetta del suo posto nel mosaico, altrimenti la rete non saprebbe quale tessera confina con quale. E vale quello che si è già visto: nessuno dice alla rete che due tessere vicine vanno insieme, e lei lo impara da sola guardando foto a milioni.
Il prezzo si paga sul numero di tessere, e non in proporzione. Per capire ogni tessera il modello la confronta con tutte le altre: con 196 tessere i confronti sono \(196 \times 196\), poco meno di quarantamila. Adesso raddoppiamo il lato della foto, da 224 a 448 puntini: le tessere diventano quattro volte tante (\(448 : 16 = 28\) per riga, cioè \(28 \times 28 = 784\)), e i confronti, che sono tessere per tessere, sedici volte tanti.
I confronti però sono solo una parte del lavoro. Il resto, quello che il modello fa su ogni tessera per conto suo, cresce quanto le tessere: quattro volte, non sedici. Con qualche centinaio di tessere questo resto pesa molto più dei confronti, e il quadrato prende il comando solo quando le tessere diventano migliaia, tanto più tardi quanto più il modello è grande. È un conto che si ritrova in ogni sistema che vede e parla.
Il ViT divide l’immagine in patch quadrate di lato \(p\), ne ottiene \(N = \lfloor H/p \rfloor \cdot \lfloor W/p \rfloor\) (con \(H = W = 224\) e \(p = 16\), esattamente \(N = 196\)), appiattisce ciascuna patch in \(\mathbb{R}^{3p^2}\) e la proietta linearmente in \(\mathbb{R}^{d}\), sommando un embedding di posizione. Ne esce una matrice \(\mathbf{X} \in \mathbb{R}^{N \times d}\) (più la riga del token di classe, quando c’è) con la stessa forma di una sequenza di embedding di token: i blocchi Transformer che seguono non dipendono dalla modalità da cui arrivano le righe. Le distribuzioni delle due specie di righe restano però diverse, ed è la ragione per cui più avanti servirà un connettore.
Ne seguono due conseguenze. La prima: il ViT ha meno bias induttivo di una CNN, perché località ed equivarianza alla traslazione restano soltanto negli strati feed-forward, applicati patch per patch, e nel taglio iniziale, mentre l’auto-attenzione è globale; la struttura bidimensionale rientra solo quando gli embedding di posizione si interpolano per una risoluzione diversa [DBK+21]. Con pochi dati un ViT è quindi meno efficace di una rete convoluzionale, e il suo vantaggio compare con pre-addestramenti molto grandi (da 14 a 300 milioni di immagini nel lavoro originale). La seconda: il costo dell’attenzione, \(O(N^2 d)\), dipende dal quadrato del numero di patch, e raddoppiare il lato dell’immagine quadruplica \(N\) e moltiplica per sedici quel termine. Il resto del blocco (proiezioni e feed-forward) costa \(O(N d^2)\), lineare in \(N\); contando i FLOP, circa \(4N^2 d\) contro \(24 N d^2\), il termine quadratico supera il lineare solo per \(N > 6d\), cioè oltre \(4608\) patch per un encoder con \(d = 768\). A \(196\) patch l’attenzione vale circa il \(4\%\) del blocco.
Resta la seconda decisione, quella da cui sono nate le architetture che seguono: in quale punto l’immagine e il testo si incontrano.
Tre modi di far incontrare due flussi#
L’immagine e il testo, ormai due sequenze di vettori, sono i due flussi che attraversano il sistema. Le risposte su dove farli incontrare che hanno resistito sono tre, e non sono tre epoche destinate a superarsi a vicenda: convivono, e servono a cose diverse.
La prima allinea due spazi senza fonderli: due encoder separati, uno per le immagini e uno per i testi, addestrati insieme su coppie immagine-didascalia, imparano a mandare una foto e la sua didascalia in due punti vicini di uno stesso spazio di embedding, e a tenere lontane le coppie che non si corrispondono. È l’idea di CLIP [RKH+21], addestrato su 400 milioni di coppie di immagine e testo raccolte dal web: il modello che ne esce non scrive una riga, ma sa dire quanto un’immagine e un testo si somigliano. Che cosa voglia dire «vicini» è meno ovvio di quel che sembra: la sezione sull’allineamento mostra che una foto è più vicina a un’altra foto che alla propria didascalia (il modality gap), e che quindi i coseni fra modalità diverse e quelli dentro una modalità non sono confrontabili.
La seconda innesta un occhio su un modello di linguaggio già addestrato, come si innesta un ramo su un ceppo che ha già le radici: fra un encoder visivo e il modello di linguaggio si mette un connettore, una funzione appresa che porta le feature delle patch nello spazio degli embedding del modello di linguaggio, dove vengono lette come token. Di norma l’encoder e il modello di linguaggio restano congelati e si addestra il connettore; in LLaVA, in una seconda fase, si riaddestra anche il modello di linguaggio.
La terza rinuncia alla distinzione: un solo Transformer elabora tessere e parole fin dall’ingresso, con gli stessi pesi. Nella versione più radicale anche l’immagine è ridotta a simboli presi da un elenco finito, token come le parole, e il modello li legge e li scrive tutti insieme.
Chiedersi dove si incontrano i due flussi è una buona bussola: spiega quasi sempre cosa un sistema sa fare e cosa gli costa.
Come lavorano insieme due persone che non parlano la stessa lingua? Se la cavano in tre modi diversi.
Nel primo non si parlano mai. Si sono però allenati insieme, con un gioco: davanti a mucchi di foto e di frasi, ciascuno segnava la sua su una stessa mappa, e si correggevano finché ogni foto e la sua frase cadevano vicine e le coppie sbagliate lontane. Finito l’allenamento, ognuno segna per conto suo, i segni restano lì e si misurano con un righello, e tanto basta per ritrovare le cose («quale di queste diecimila foto è il gatto nero sul muro?»). Per fare conversazione, no.
Nel secondo c’è un interprete in mezzo. Uno dei due guarda e racconta quello che vede, nella sua lingua; l’interprete lo traduce e lo sussurra all’altro, che è l’unico a parlare e continua a parlare come ha sempre fatto, al più con un breve ripasso per abituarsi alle domande sulle foto. Tutto il lavoro sta nell’insegnare all’interprete a tradurre bene, e costa poco, perché nessuno dei due ricomincia da capo.
Il terzo è una lingua sola, insegnata a tutti e due. Niente più da tradurre, e con quelle parole si compone di tutto: una frase, e allo stesso modo un disegno. In compenso quello che ciascuno sapeva prima serve a poco, e la scuola va rifatta, spesso da capo. E la lingua nuova ha un dizionario di parole contate: quel che si vede va detto con la parola più vicina che c’è, e la sfumatura che sta fra due parole va perduta.
La mappa serve a cercare, l’interprete a conversare, la lingua sola a produrre. Nessuna delle tre ha vinto, e capita spesso di trovare l’interprete e la lingua sola mescolati insieme.
Il criterio che le distingue è la profondità alla quale avviene la fusione.
Tardiva, nello spazio delle rappresentazioni. Due encoder producono due vettori nello stesso \(\mathbb{R}^{d}\), e l’unica interazione fra le modalità è un prodotto scalare alla fine. Gli embedding delle immagini si precalcolano e cercare in un archivio costa un prodotto matrice-vettore; in cambio non c’è interazione fine fra parti dell’immagine e parole, e non c’è un decoder: il modello misura somiglianze e non genera testo.
Intermedia, tramite connettore. Un encoder visivo produce \(\mathbf{Z} \in \mathbb{R}^{N \times d}\), e queste righe entrano in un modello di linguaggio pre-addestrato o come token in testa alla sequenza (un prefisso visivo) o attraverso strati di cross-attention inseriti fra i blocchi, con le query dal testo e chiavi e valori dall’immagine. Si addestra il connettore lasciando spesso congelati i due modelli: la variante più economica, e quella che riusa meglio ciò che esiste già.
Precoce, nello spazio dei token. Un solo Transformer elabora patch e testo fin dall’ingresso, in un’unica sequenza, con la stessa attenzione e gli stessi pesi per tutto: prima di lui l’immagine passa al più da un tokenizzatore che la comprime, non da un encoder che ne costruisce la rappresentazione. Se l’immagine viene quantizzata in simboli di un codebook, il modello diventa simmetrico (emette token visivi come emette parole), al prezzo dell’informazione persa nella quantizzazione; l’immagine può anche restare continua, come nella variante che genera per diffusione. In entrambi i casi il pre-addestramento è molto più lungo che per un connettore.
Il confine fra le ultime due è meno netto di quanto la tripartizione suggerisca, e i sistemi reali sono spesso ibridi. Chi lavora sui modelli a token, poi, ne conta due sole, e chiama tardiva anche la via intermedia, perché come la prima tiene un encoder per modalità: è il taglio che userà la sezione sulla fusione.
I pezzi già costruiti#
Dalla rappresentazione del testo serve l’embedding, la mappa del significato in cui una parola è un vettore e la vicinanza si misura con la similarità del coseno, un numero fra \(-1\) e \(+1\): gatto e felino hanno un coseno alto, gatto e mercoledì un coseno vicino a \(0\), perché non hanno niente da spartire (il \(-1\) vorrebbe dire direzioni opposte, e fra due parole non si vede quasi mai). Portare le fotografie nello stesso spazio è il lavoro che comincia adesso.
Dalla sezione sull’architettura serve la cross-attention: le query \(\mathbf{Q}\) vengono da una sequenza, qui il testo, e le chiavi \(\mathbf{K}\) e i valori \(\mathbf{V}\) da un’altra, qui l’immagine, così che ogni posizione del testo raccolga informazione dalle tessere. Dalla sezione sul post-training serve l’instruction tuning, che insegna a un modello abituato a continuare testi a eseguire una consegna: qui trasformerà un modello che descrive immagini in uno capace di rispondere a domande. E dalla sezione su classificazione e transfer learning serve il riuso di una rete pre-addestrata, con i pesi congelati o riaddestrati poco: nei sistemi che seguono, l’encoder visivo e il modello di linguaggio sono quasi sempre due reti già addestrate per conto proprio.
Un avvertimento, prima di cominciare#
Questi sistemi hanno un difetto specifico: possono produrre una risposta fluente determinata dal testo che la precede e non dall’immagine, e nominare così oggetti che nella fotografia non ci sono. Si chiama allucinazione visiva.
Uno studente ha letto migliaia di didascalie di fotografie. Gli mostri una spiaggia e ti dice che c’è il mare, la sabbia e qualche ombrellone. Ha ragione quasi sempre, e non perché abbia guardato: perché nelle didascalie di spiaggia ci sono quasi sempre mare, sabbia e ombrelloni. Il giorno in cui gli mostri una spiaggia senza ombrelloni, lui te li nomina lo stesso.
Non è il difetto di un modello sfortunato. Non è nemmeno l’unico modo di sbagliare (a volte la foto, per come arriva al modello, non mostra abbastanza), ma è quello che l’addestramento stesso apre: se le parole giuste si indovinano dal contesto, guardare diventa facoltativo, e chi è addestrato a indovinare bene impara a farne a meno.
Un modello che genera testo condizionato a un’immagine minimizza \(\mathcal{L}(\theta) = -\sum_t \log p_\theta(y_t \mid y_{<t}, \mathbf{I})\), dove \(y_t\) è il token al passo \(t\) e \(\mathbf{I}\) l’immagine. Nulla in questa funzione di costo obbliga il modello a usare \(\mathbf{I}\): se il prior linguistico concentra già la massa di probabilità sulla parola corretta, il gradiente che spinge a sfruttare l’informazione visiva è debole, e il modello impara la statistica delle didascalie invece della scena. È il primo dei meccanismi dell’allucinazione visiva, e viene da ciò che l’obiettivo premia, non da un incidente; gli altri due (un encoder che non distingue ciò che servirebbe, dati di istruzione scritti da chi l’immagine non l’ha vista) li mette in fila la sezione sull’allucinazione.
Allineare, innestare, fondere#
Le domande si susseguono in quest’ordine: come allineare due spazi, come collegarli, come fonderli, quanto costa il dettaglio, e se il sistema ha davvero guardato.
Allineare due spazi: due encoder separati imparano a mandare una foto e la sua didascalia vicine nello stesso spazio, ed è l’addestramento contrastivo di CLIP [RKH+21]: si impara per contrasto, avvicinando le coppie giuste e allontanando le sbagliate. Da lì viene un classificatore che si scrive a parole, il trasferimento senza esempi (zero-shot) che il lavoro originale mette al centro delle sue prove.
Innestare gli occhi: il connettore fra un encoder visivo e un modello di linguaggio già addestrato, di norma congelato. Di connettori ne sono stati provati tre, e nei modelli aperti si è diffuso il più semplice, per ragioni che contano più della sua forma.
Fusione precoce e tardiva, cioè presto o tardi lungo il percorso: l’immagine ridotta a simboli di un elenco fin dall’ingresso, come le parole. Cosa si guadagna a poterla anche produrre, e cosa si perde nell’arrotondarla alla voce di catalogo più vicina.
Il costo del dettaglio, cioè quanti puntini si danno da guardare: perché una foto grande occupa tanto posto, come la si spezza in riquadri, e cosa serve per leggere un documento invece che riconoscere una scena.
Vedere quel che non c’è: un modello che parla di una fotografia senza averla guardata, come lo si misura, e i sistemi che dalla percezione passano all’azione.
Da ricordare
La pipa di Magritte dice il problema in un colpo: il disegno non è la cosa, la parola non è il disegno, e a tenere insieme i tre pezzi è la nostra testa. Insegnare quel salto a una macchina è il problema dei modelli che vedono e parlano.
Le due materie prime hanno nature opposte: una pagina scritta arriva già tagliata a pezzi, le parole, sempre le stesse per tutti; una fotografia è un tappeto di puntini colorati senza cuciture, e il confine fra il gatto e il muro lo vediamo noi, nei numeri non c’è.
Il primo passo è sempre lo stesso: rimpicciolire la foto, tagliarla in tessere e metterle in fila come le parole di una frase, attaccando a ciascuna un’etichetta che dice dove stava. Da lì in poi immagine e testo sono due sequenze di pezzi, e resta da decidere dove si incontrano. Il prezzo si paga sul numero di tessere: se raddoppiano, i confronti fra tessere quadruplicano, mentre il lavoro che il modello fa su ogni tessera per conto suo raddoppia soltanto, e il quadrato comanda solo quando le tessere diventano migliaia.
La domanda da cui discendono questi modelli è dove i due flussi si incontrano, e le risposte che hanno retto sono tre: due che non si parlano ma, allenati insieme, segnano le cose sulla stessa mappa (cerca), un interprete che traduce per chi sa già parlare (conversa), una lingua sola insegnata a tutti e due (produce). Non si superano a vicenda.
Il rischio da tenere presente fin da subito: un modello che vede e parla può parlare benissimo senza aver guardato, come lo studente che ha letto migliaia di didascalie di spiaggia e ti nomina gli ombrelloni anche quando non ci sono. È quello che l’addestramento premia.
Da ricordare
Il problema non è di formato ma di raccordo fra rappresentazioni: quello che manca è uno spazio in cui la vicinanza voglia dire la stessa cosa per una misura di luce e per una parola.
Testo e immagine hanno nature opposte: il testo è discreto e già simbolico, l’immagine un reticolo continuo senza unità naturali, dove la distanza fra i pixel non misura la distanza fra i significati.
Il ViT [DBK+21] rende l’immagine una sequenza tagliandola in patch: con \(224 \times 224\) e patch \(16 \times 16\) sono 196 token. Il costo dell’attenzione cresce con \(N^2\), quello di proiezioni e feed-forward con \(N\), e il termine quadratico domina solo per \(N > 6d\).
Il punto in cui i due flussi si incontrano genera tre famiglie: allineare due spazi senza fonderli (CLIP [RKH+21]), innestare un connettore su un modello di linguaggio già addestrato, o elaborare patch e parole in un solo Transformer fin dall’ingresso, spesso con l’immagine ridotta a token di un unico vocabolario. Non si superano a vicenda: la prima cerca, la seconda conversa, la terza produce.
L’obiettivo di addestramento non obbliga il modello a guardare: quando il priore linguistico (la statistica delle didascalie, appresa prima e indipendentemente dall’immagine) basta a indovinare la didascalia, il modello può rispondere senza usare l’immagine. È una delle cause dell’allucinazione visiva, e viene dall’obiettivo, non da un caso sfortunato.