


Misurare la generazione: TTFT, TPOT e goodput#
Entro 0,1 secondi la risposta sembra istantanea, entro 1 secondo il filo del pensiero non si spezza, oltre 10 secondi l’attenzione se ne va altrove. Sono le tre soglie che Jakob Nielsen ha reso proverbiali in Usability Engineering, distillandole dal catalogo che Robert B. Miller (ricercatore dell’IBM di Poughkeepsie) aveva compilato venticinque anni prima, nel 1968, in un articolo intitolato Response Time in Man-Computer Conversational Transactions: i tempi di risposta che una persona tollera quando dialoga con una macchina. Numeri che hanno retto mezzo secolo, perché non misurano un computer: misurano una persona.
C’è però un presupposto nascosto, e i modelli generativi lo mandano in pezzi. Miller dà per scontato che la risposta sia un evento, l’istante in cui la macchina consegna il risultato. Per un classificatore è ancora così, e la latenza è un numero solo, il tempo fra la domanda e la risposta; la sezione Servire un modello ci ha insegnato a prometterlo per percentili.
Ma un modello che genera testo non consegna niente in un istante: consegna un pezzo alla volta, per secondi, e mentre consegna il lettore sta già leggendo. La domanda «quanto ci mette?» ha smesso di avere una risposta sola, e ne risentono tutte le tecniche di LLMOps: il continuous batching, la PagedAttention, lo speculative decoding, la quantizzazione dei pesi. Misurate con il metro sbagliato si valutano male, e prima di ottimizzarle bisogna decidere che cosa vuol dire, per questo servizio, andare veloce.
Scomporre la latenza#
La generazione ha due fasi, molto diverse fra loro, e sono quelle incontrate nei grandi modelli linguistici parlando di KV cache.
Nella prima il modello legge il prompt: tutti i token insieme, e per ciascuno calcola e conserva le chiavi e i valori che l’attenzione rileggerà a ogni passo successivo, cioè la KV cache. Questa fase si chiama prefill.
Nella seconda scrive la risposta, un token (un pezzo di parola) alla volta, e ogni token lo decide guardando tutti quelli già scritti. È il decode, ed è la fase lenta, quella dove il tempo se ne va nel rileggere i pesi (i miliardi di numeri del modello) anziché nel calcolare: è il punto su cui è costruita l’intera sezione su LLMOps.
Le due misure di base seguono le due fasi. Il TTFT (time to first token) è il tempo che il cliente aspetta fra l’invio della richiesta e l’arrivo del primo token, e lo decidono il prefill e l’eventuale fila davanti al modello. Il TPOT (time per output token) è il tempo medio fra due token successivi della stessa risposta, e lo decide il decode.
Che cosa ti fa spazientire, in un menù degustazione? Due cose diverse, e non vanno confuse: quanto aspetti la prima portata (sei seduto davanti a un tavolo vuoto e non succede niente) e ogni quanto arrivano le portate dopo (se si susseguono a ritmo la serata scorre, se fra una e l’altra passano venti minuti ti innervosisci, anche a parità di durata totale).
Nella generazione di testo è identico. La prima attesa si chiama TTFT: il tempo che passa da quando premi invio a quando compare la prima parola, attesa in fila compresa. La seconda si chiama TPOT: la pausa media fra una parola e la successiva.
Una media descrive bene un ritmo regolare, ed è per questo che il TPOT esiste. Ma se in mezzo a duecento pause da 20 millisecondi ne capita una da due secondi, la media sale a 30 e continua a sembrare un ritmo comodo, mentre il testo, sotto gli occhi, si è piantato in mezzo a una frase. Quindi accanto al TPOT si sorveglia sempre anche la pausa più lunga di quella risposta: è lei che il lettore ricorda.
Mettiamoci dei numeri, e teniamo a mente che un token è un pezzetto di parola, più corto di una parola intera. TTFT di 350 millisecondi, TPOT di 25 millisecondi, risposta lunga 200 token, cioè un centinaio di parole. Il primo token arriva dopo 0,350 secondi; poi ne mancano 199, uno ogni 0,025 secondi, cioè 4,975 secondi. In tutto 5,325 secondi. E il testo scorre sotto gli occhi a uno diviso 0,025 secondi (i 25 millisecondi riscritti in secondi, che è il passaggio che si dimentica), cioè 40 token al secondo. Dividere invece i 200 token per i 5,325 secondi dà 37,6: un terzo numero, che spalma l’attesa iniziale su tutta la risposta e non racconta nessun momento della cena.
Siano \(\text{TTFT}\) il tempo dall’invio della richiesta da parte del cliente alla ricezione del primo token, \(\text{TPOT}\) il tempo medio fra due token consecutivi della stessa risposta e \(N_{\text{out}}\) il numero di token generati. La latenza totale si ricompone come
dove \(N_{\text{out}} - 1\) conta gli intervalli fra token, uno in meno dei token stessi. Invertendo si ha la definizione con cui il TPOT si misura davvero, \(\text{TPOT} = (T - \text{TTFT}) / (N_{\text{out}} - 1)\). Per un testo letto mentre arriva, la grandezza percepita è più la velocità di scorrimento \(1/\text{TPOT}\), in token al secondo, che la durata \(T\).
Il servente vede soltanto un tratto del TTFT, quello dalla ricezione della richiesta all’emissione del primo token, cioè la fila e il prefill. Lo si chiama TTFT lato servente, ed è il solo che una replica può misurare da sé; il resto sono la rete e i passaggi fra il cliente e la replica, che Davanti ai modelli scompone tratto per tratto.
Con \(\text{TTFT} = 0{,}350\) s, \(\text{TPOT} = 0{,}025\) s e \(N_{\text{out}} = 200\): \(T = 0{,}350 + 199 \times 0{,}025 = 5{,}325\) s, con uno scorrimento di \(1/0{,}025 = 40\) token/s. Il rapporto \(N_{\text{out}}/T = 200/5{,}325 \approx 37{,}6\) token/s è invece il throughput medio della richiesta: ingloba l’attesa iniziale e non descrive nessun istante dell’esperienza.
Il TPOT è però una media, mentre ciò che l’utente vive è la distribuzione degli intervalli, la ITL (inter-token latency): coincidono solo se il flusso è regolare. Un singolo intervallo da due secondi in mezzo a duecento da 20 millisecondi sposta il TPOT di dieci millisecondi e rovina la risposta, e per questo va sorvegliata anche l’ITL massima per richiesta. Con lo speculative decoding la media inganna in un altro modo: i token arrivano a raffiche, più d’uno per passo, e la distribuzione dell’ITL si spezza in due gruppi, intervalli quasi nulli dentro una raffica e un passo intero fra una raffica e la successiva, che il TPOT medio confonde in un valore che non capita mai.
Che le due misure non siano intercambiabili si vede distribuendo la stessa attesa totale in due modi. Un sistema con TTFT di 0,350 s e TPOT di 25 ms impiega 5,325 secondi per 200 token; un secondo con TTFT di 2,340 s e TPOT di 15 ms impiega \(2{,}340 + 199 \times 0{,}015 = 5{,}325\) secondi, identici al millesimo. Ma il primo comincia a scrivere quasi subito e scorre a 40 token al secondo; il secondo lascia lo schermo vuoto per oltre due secondi e poi emette il testo a \(1/0{,}015 \approx 67\) token al secondo. Con un numero solo sarebbero indistinguibili.
Il secondo, per giunta, offre una velocità che chi legge non può sfruttare, e per capire perché serve sapere quanto vale un token in parole. Un token è più corto di una parola, perché le parole lunghe il modello le spezza in due o tre pezzi: su un paragrafo italiano ne servono fra uno e mezzo e due e mezzo, a seconda di come il modello è stato addestrato a spezzarle. Un lettore adulto legge tre o quattro parole al secondo, quindi sta consumando qualcosa come 4,5-10 token al secondo. Un sistema che ne consegna 40 va dunque da quattro a nove volte più veloce di chi legge, e accelerare ancora non si vede: le parole erano già lì prima che l’occhio le raggiungesse. Il TTFT invece si sente sempre, perché è tempo in cui sullo schermo non succede niente, e le soglie di Nielsen dicono quanto: sotto il decimo di secondo l’attesa passa inosservata, oltre il secondo il filo del pensiero comincia a spezzarsi. È il primo criterio di progetto: oltre una certa soglia il TPOT smette di essere percepibile, il TTFT no.
Il criterio vale per un testo che una persona legge mentre arriva. Quando la risposta serve solo intera (la legge un programma, come un agente che aspetta l’uscita per decidere il passo successivo; è un JSON che si usa solo completo; la precedono token di ragionamento che nessuno vede) conta la durata totale, e lì il TPOT torna a pesare per intero: su una risposta di 2.000 token, dieci millisecondi in meno per token sono venti secondi in meno.
Prefill e decode sono due mestieri diversi#
Dietro la scomposizione c’è più di una contabilità: le due metriche misurano fasi che sollecitano la GPU in modo opposto, il prefill limitato dal calcolo e il decode dalla banda della memoria, e da questa differenza discendono i due rimedi di scheduling che seguono.
Una fotocopiatrice industriale, per stampare anche una sola pagina, deve prima scaldarsi per un minuto. Con duemila pagine da copiare quel minuto si spalma su duemila fogli e non lo noti; con una pagina sola aspetti un minuto per un foglio, e la macchina passa quasi tutto il tempo a scaldarsi.
Il prefill è il primo caso: il modello legge tutte le parole del prompt in una volta, quindi «scaldare la macchina» (portare i miliardi di numeri del modello dalla memoria ai circuiti di calcolo) è ripagato da un mucchio di lavoro utile. Un prompt doppio richiede all’incirca il doppio del tempo, ed è per questo che l’attesa della prima parola cresce con la lunghezza di quello che hai scritto.
Il decode è il secondo: per una parola sola bisogna rileggere tutto il modello, e i circuiti restano quasi fermi ad aspettare. L’unico modo di far fruttare quel riscaldamento è raccogliere le pagine di sessantaquattro clienti diversi e stamparle nello stesso giro, una per ciascuno: il minuto si divide per sessantaquattro. È il mazzo (in inglese batch): le richieste che il servizio manda avanti in un giro solo.
Sono due lavori che non convivono bene sulla stessa macchina nello stesso momento: se, mentre venti persone ricevono la risposta parola per parola, arriva qualcuno con un prompt lunghissimo, la fotocopiatrice si dedica a quello e gli altri vedono il testo bloccarsi a metà frase. Un singhiozzo.
Riprendiamo l’intensità aritmetica del modello roofline, vista nel capitolo sulla GPU: quanti FLOP si eseguono per ogni byte letto dalla memoria. Per un modello da \(N_p\) parametri il costo di una passata in avanti è circa \(2 N_p\) FLOP per token elaborato, mentre i pesi in 16 bit occupano \(2 N_p\) byte e vanno letti una volta sola per passata. Se una passata elabora \(n_{\text{tok}}\) token insieme:
dove \(I\) è l’intensità aritmetica e \(n_{\text{tok}}\) il numero di token che viaggiano nella stessa passata (trascurando KV cache e attenzione, che spostano il conto ma non la conclusione). Si noti che \(n_{\text{tok}}\) conta i token, non le richieste: è la stessa quantità in prefill e in decode, ma la si riempie in due modi diversi. Le due fasi cadono così ai due lati del ginocchio del roofline, che sulle schede da datacenter sta fra un centinaio e qualche centinaio di FLOP/byte:
prefill: un prompt di 2.048 token dà \(I \approx 2048\) FLOP/byte, ben oltre il ginocchio. È compute-bound, e il tempo cresce all’incirca linearmente con la lunghezza del prompt (finché il termine quadratico dell’attenzione resta minoritario rispetto a quello lineare degli strati densi): ecco perché il TTFT è dominato da quella.
decode: una sequenza sola dà \(I \approx 1\) FLOP/byte, profondamente memory-bound come stabilito nella sezione precedente. Il batching serve proprio a spostare \(I\) verso destra: 64 sequenze insieme, un token ciascuna, portano l’intensità a circa 64 FLOP/byte.
Quando le due fasi condividono la GPU nella stessa iterazione dello scheduler, la lunga si mangia la corta. Un prefill da 8.000 token può occupare la scheda per centinaia di millisecondi, e ogni sequenza in decode aspetta quel tempo prima del token successivo: head-of-line blocking classico, con la coda dell’ITL che si allunga e la p99 del TPOT che peggiora mentre la media resta accettabile [AKP+24].
Le due intensità danno anche dei limiti inferiori ai tempi. Un prefill di \(L\) token non può durare meno del suo calcolo, e un passo di decode con \(b\) sequenze di contesto \(n_{\text{ctx}}\) non può durare meno della lettura dei pesi e della cache:
con \(P_{\text{picco}}\) il picco di calcolo della scheda, \(\eta\) la frazione che se ne ottiene, \(M_w = 2N_p\) i byte dei pesi, \(m_{\text{kv}}\) i byte di KV cache per token e \(B_{\text{picco}}\) la banda della memoria; il secondo è un limite inferiore del TPOT. Con \(N_p = 7\cdot10^9\), \(P_{\text{picco}} = 10^{15}\) FLOP/s, \(\eta = 0{,}5\) e \(B_{\text{picco}} = 3\) TB/s, un prompt di 2.048 token chiede almeno \(2\cdot 7\cdot10^9 \cdot 2048 / (0{,}5\cdot10^{15}) \approx 57\) ms di prefill, e un passo di decode di una sequenza sola, contando i soli pesi, \(14\cdot10^9 / (3\cdot10^{12}) \approx 4{,}7\) ms. Quanto il TPOT misurato resti lontano da questo limite lo dice la MBU di Quante repliche accendere.
Contro questo scontro si sono affermati due rimedi, che risolvono lo stesso problema con filosofie opposte: uno fa convivere meglio le due fasi, l’altro le separa.
Il primo rimedio è quello della cassa del supermercato. Se arriva un cliente col carrello pieno, la cassiera non gli passa tutta la spesa in un colpo lasciando in attesa chi ha in mano solo il pane: gli passa una decina di articoli, poi serve chi ha il pane, poi altri dieci, e così via. Il carrello finisce un po’ più tardi, ma nessuno resta fermo a lungo. Applicato ai modelli si chiama chunked prefill: il prompt lungo viene spezzato in pezzi, e fra un pezzo e l’altro si infilano i passi di generazione di tutti gli altri.
Quanti articoli passare per volta è la manopola da girare, e gira in due sensi. Cinquanta alla volta: il carrello se ne va presto, chi ha in mano il pane aspetta di più. Tre alla volta: tutti scorrono, ma la cassiera a ogni ripresa deve ritrovare il punto in cui era rimasta nel carrello, e a furia di ricominciare ci mette più che a farlo di seguito.
Il secondo è più radicale: due reparti separati. Un gruppo di macchine legge solo i prompt, un altro genera solo le risposte, ciascuno organizzato per il proprio mestiere. È la disaggregazione, e il prezzo è che gli appunti presi leggendo (la KV cache) vanno trasferiti dal primo reparto al secondo, il che costa tempo e cavi veloci. Due reparti vogliono poi lavoro per tutti e due: se in tutta la giornata passano tre clienti restano mezzi vuoti, e sarebbe bastata una cassa sola.
Il chunked prefill [AKP+24] sostituisce lo scheduling per richiesta con uno scheduling a budget di token per iterazione: un prefill lungo \(L\) token è spezzato in \(\lceil L/c \rceil\) pezzi di dimensione \(c\), e a ogni iterazione lo scheduler compone un batch con un pezzo di prefill più tutte le sequenze in decode pronte. L’idea nasce in Sarathi, che accosta i chunked prefill a decodifiche «a rimorchio» (piggybacked); Sarathi-Serve battezza stall-free batching lo scheduling che ne risulta, quello che non sospende mai le generazioni in corso. Il guadagno è doppio: il decode non si ferma mai per più del tempo di un pezzo, e il pezzo di prefill riempie di lavoro compute-bound un’iterazione che sarebbe stata memory-bound.
Il parametro \(c\) è un compromesso esplicito fra le due metriche. Con \(c\) grande il prefill finisce prima (TTFT più basso) ma il singhiozzo si allunga (TPOT peggiore); con \(c\) piccolo vale il contrario, e in più il pezzo \(k\)-esimo deve rileggere la KV cache dei pezzi \(1, \dots, k-1\), quindi spezzare troppo fa ricomparire il traffico di memoria che il prefill evitava. Un ordine di grandezza: 8.000 token in pezzi da 512 danno \(\lceil 8000/512 \rceil = 16\) iterazioni, e uno stallo massimo che dura quanto un pezzo invece che quanto l’intero prompt, cioè quasi sedici volte meno.
La disaggregazione [ZLC+24] prende la strada opposta: istanze distinte per prefill e decode, ciascuna dimensionata e parallelizzata per il proprio collo di bottiglia (il prefill vuole calcolo e batch di token, il decode vuole banda e batch di sequenze). Nessuna interferisce con l’altra, e i due obiettivi di servizio si regolano in modo indipendente. Il costo è il trasferimento della KV cache fra i due nodi, proporzionale alla lunghezza del prompt: su interconnessioni veloci (NVLink, InfiniBand) resta una frazione del tempo di prefill, su reti lente diventa il nuovo collo di bottiglia. E servono abbastanza richieste per tenere pieni due gruppi di GPU: sotto una certa scala, due reparti mezzi vuoti costano più di uno pieno.
Il goodput, ovvero contare solo ciò che è servito bene#
Con queste misure in mano si può dire perché il throughput da solo inganna: conta le richieste servite in un secondo, e non chiede come siano state servite. Il termine che ripara il difetto viene dalle reti, dove il goodput è la parte del traffico che arriva a destinazione ed è utile a chi la riceve, al netto di intestazioni e ritrasmissioni; qui lo si estende alle richieste servite entro le soglie dichiarate.
Un ristorante che stipa duecento coperti a sera, ma dove metà dei clienti aspetta il primo piatto quaranta minuti e se ne va prima del dolce, non sta servendo duecento coperti: ne serve cento e ne scontenta altrettanti. Se il proprietario guarda solo il numero dei coperti, il conto gli torna e continuerà a stipare.
Il throughput è il numero dei coperti: quante richieste il sistema ha sfornato in un secondo. Il goodput è il numero dei clienti serviti bene: si contano solo le richieste che hanno rispettato le promesse fatte, per esempio «il primo token entro mezzo secondo e gli altri a non più di 50 millisecondi l’uno dall’altro». Il conto quindi è una moltiplicazione: si prendono le richieste servite in un secondo e si tiene la frazione che ha rispettato tutte e due le promesse. Se ne servi venti al secondo e solo l’\(85\%\) è a posto, il goodput è \(20 \times 0{,}85 = 17\): ne hai servite venti e ne hai contentate diciassette.
C’è però un modo di passare l’esame senza meritarlo. Al cliente a cui le portate arrivano tutte puntuali tranne una, che tarda mezz’ora, la pausa media viene ancora buona: il registro lo segna fra i contenti, mentre lui di quella sera si ricorda solo la mezz’ora. Per questo, dove la scorrevolezza conta, nella promessa si mette la pausa più lunga al posto di quella media.
La differenza si sente appena si allarga il mazzo. Un mazzo più grande fa quasi sempre salire il throughput, perché la GPU, a ogni giro, lavora per più clienti insieme; ma un giro con più clienti dura di più, e ognuno lo aspetta per intero prima di ricevere la parola successiva. Finché la fila si allungava, il mazzo grande la smaltiva e conveniva a tutti. Quando il servizio sta già dietro a tutti quelli che arrivano, allargarlo ancora fa servire qualche cliente in più al secondo e allunga l’attesa di ciascuno, finché le promesse cominciano a saltare. Il throughput sale mentre il goodput crolla: si servono più persone, e se ne accontentano meno.
Siano \(\tau_{\text{f}}\) e \(\tau_{\text{p}}\) le soglie dichiarate per TTFT e TPOT, e \(R\) le richieste completate in una finestra di durata \(\Delta t\). Il goodput è
dove \(\mathbb{1}[\cdot]\) vale \(1\) se la richiesta \(i\) rispetta entrambe le soglie e \(0\) altrimenti. Costruito così, però, il goodput eredita il difetto del TPOT, che è una media: la richiesta con duecento intervalli da 20 ms e uno da due secondi ha \(\text{TPOT} = 29{,}85\) ms, quindi passa una soglia \(\tau_{\text{p}} = 50\) ms e viene contata fra quelle servite bene, benché l’utente l’abbia vista bloccarsi a metà frase. La stessa costruzione con \(\max_i \text{ITL}\) al posto del TPOT dà un goodput più severo e più aderente all’esperienza, ed è quello che si sorveglia quando la fluidità conta. Il throughput è la stessa somma senza l’indicatore, \(R/\Delta t\): il goodput è dunque il throughput moltiplicato per la frazione conforme, e non può mai superarlo. Nella pianificazione della capacità se ne usa la variante duale, quella con cui il termine si è diffuso nella letteratura sul serving degli LLM [ZLC+24]: il massimo tasso di richieste al secondo per GPU che mantiene la conformità sopra una quota fissata (per esempio il \(90\%\)). Definito così è la metrica su cui si dimensiona il servizio, perché tiene insieme il costo (le GPU) e la promessa (le soglie).
Due avvertenze. Il goodput dipende dalle soglie, quindi non è confrontabile fra sistemi che ne dichiarano di diverse, e resta un numero interno più che un vanto da comunicato. E il throughput misurato in token al secondo inganna più di quello in richieste al secondo, perché somma i token di prefill a quelli di decode: un carico di prompt lunghi e risposte corte produce un numero spettacolare senza che nessun utente veda il testo scorrere più in fretta.
Si vede su due configurazioni dello stesso sistema, con le promesse fissate a 500 ms sul TTFT e 50 ms sul TPOT.
La prima serve batch da 16 richieste: ne smaltisce 20,0 al secondo e ne tiene il 92,5% dentro entrambe le promesse, quindi il goodput è \(20{,}0 \times 0{,}925 = 18{,}5\). La seconda allarga il batch a 64: le richieste servite salgono a 32,0 al secondo, il \(60\%\) in più, ma la quota di quelle a posto crolla al 49,4% e il goodput scende a \(32{,}0 \times 0{,}494 = 15{,}8\), quasi il \(15\%\) in meno di prima. Il numero che si guarda per abitudine dice che la seconda configurazione è migliore; quello che conta dice il contrario, e ha ragione lui.
Sono due configurazioni simulate, non due misure su un sistema vero, e servono a mostrare che throughput e goodput possono muoversi in direzioni opposte, non a dire di quanto succeda su un modello particolare. Nella simulazione, per giunta, allargare il batch peggiora l’attesa di tutti della stessa quantità, mentre in un sistema vero penalizza molto di più chi ha la sfortuna di accodarsi in fondo.
C’è poi una grandezza che si misura per richiesta e non è un tempo: i token che quella richiesta consuma, visti dal lato del conto invece che da quello dell’orologio.

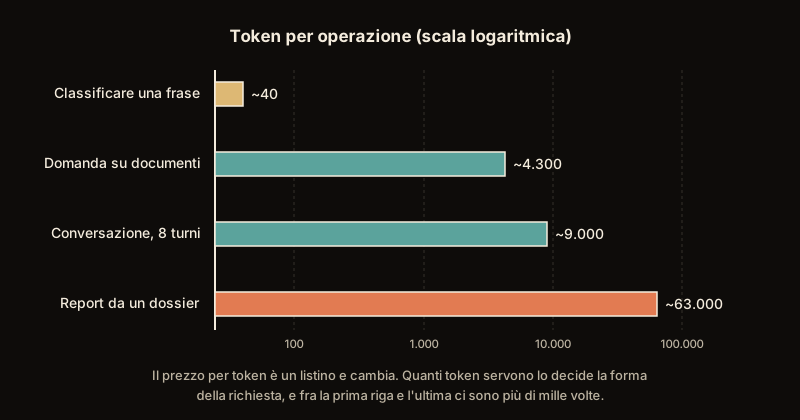
Fig. 36.16 Stesso modello, consumi incomparabili. La conversazione è la riga da guardare. Un modello non ha memoria fra un turno e l’altro: per rispondere gli si rimanda ogni volta tutto quello che ci si è detti fin lì. Se ogni turno aggiunge 250 token in tutto (la domanda più la risposta), il modello ne legge 250 al primo turno, 500 al secondo, 750 al terzo, e all’ottavo ne ha letti in tutto \(250 \times (1 + 2 + \dots + 8) = 9.000\). È il conto del caso peggiore, quello in cui il modello rilegge tutto da capo a ogni turno, e il riuso del prefisso lo evita. E attenzione a leggere le barre: una tacca in più non vuol dire un po’ di più, vuol dire dieci volte tanto (è la scala logaritmica, l’unico modo di far stare quaranta e sessantatremila nello stesso disegno).#
Il divario di Fig. 36.16 dice una cosa sola, e non riguarda i listini: quello che fa il costo è quanti token servono, cioè quanto testo entra e quanto ne esce, e quello lo decide la forma della richiesta. Classificare una frase manda poche parole e ne riceve una; riassumere un documento lungo ne manda migliaia; una conversazione le rimanda tutte a ogni turno. E i token che si pagano sono esattamente gli stessi che occupano lo spazio che il modello ha per leggere, riempiono la KV cache e allungano l’attesa: chi ne fa risparmiare uno risparmia insieme denaro, memoria e tempo.
Le medie mentono, e qui in tre modi#
I percentili li abbiamo imparati in Servire un modello: la p95 è il tempo entro cui è servito il 95% delle richieste, la p99 quello entro cui ne è servito il 99%, e la promessa si scrive su quelli e non sulla media. Da qui in poi «coda» indica la coda della distribuzione (tail): le richieste che superano un percentile alto, poche e molto più lente delle altre, quelle che fanno arrabbiare le persone. Attenzione a non confonderla con la fila d’attesa davanti al servente (queue), che in quella sezione chiamavamo coda e che qui si chiama fila.
Quando il modello genera, quella regola vale doppio, per tre ragioni sue.
La prima: i percentili vanno riportati separati per ciascuna delle due attese, non su quella totale. La coda del TTFT e quella del TPOT si allungano per cause diverse (la prima per i prompt lunghi e per la fila all’ingresso, la seconda per i batch troppo grandi e per le letture di prompt che si infilano fra un token e l’altro), e un numero solo le mescola e non dice a nessuno dove mettere le mani.
La seconda: quando una risposta è fatta di più pezzi, le code dei pezzi si combinano fra loro, e come si combinano dipende da com’è fatto il sistema. Il caso che morde è quello in cui una risposta aspetta molte chiamate lanciate tutte insieme: venti pezzi di documento da andare a recuperare in venti archivi diversi, oppure venti programmi esterni a cui il modello chiede una cosa ciascuno (che ora, un cambio, un prezzo) prima di poter rispondere. Lì non si aspetta la media, si aspetta la più lenta di tutte, e basta che una sia finita nella coda perché l’intera risposta ci finisca. Se ciascuna ha l’\(1\%\) di probabilità di essere lenta, e le venti sono lente per ragioni indipendenti, la probabilità che almeno una lo sia si trova al rovescio: si calcola quella che vadano bene tutte e venti (il prodotto di venti fattori tutti uguali a \(0{,}99\), circa l’\(82\%\)) e la si toglie da uno, cioè \(1 - 0{,}99^{20} \approx 18\%\). Ed è ancora una stima ottimistica, perché quell’\(1\%\) è misurato su una chiamata sola: venti che premono insieme sulla stessa scheda o sulla stessa rete si rallentano a vicenda, e la probabilità di partenza sale. Una p99 rassicurante sul singolo passo diventa un utente scontento su cinque sull’intera interazione, ed è l’argomento di Dean e Barroso [DB13].
Il conto si può anche rovesciare, ed è la forma che serve a chi progetta. Perché venti chiamate parallele indipendenti stiano tutte sotto la soglia 99 volte su cento, ciascuna deve starci con probabilità \(0{,}99^{1/20} \approx 0{,}9995\): la soglia della chiamata singola va fissata sulla sua p99,95, non sulla p99. Dean e Barroso propongono anche un rimedio, le richieste di copertura (hedged requests): se una chiamata non ha risposto entro il tempo in cui di solito risponde il 95% delle chiamate, se ne manda una copia a un’altra replica e si tiene la prima risposta che arriva. La coda si accorcia molto, e il carico in più resta attorno al 5%.
Nel caso opposto l’effetto si rovescia, e conviene saperlo per non applicare il conto dove non vale. Un agente che fa venti chiamate una dopo l’altra non aspetta la più lenta, le somma, e sommando, la sfortuna si diluisce. Venti passi da un secondo fanno venti secondi; se uno va male e ne impiega tre, il totale diventa ventidue, cioè il \(10\%\) in più, non il \(200\%\) che quel passo ha subìto per conto suo. Lì a sfondare la promessa è il totale, che di suo è venti volte più grande di un passo solo.
La terza si vede sulle due configurazioni di poco fa. Con batch da 64 il TTFT medio è 457 ms, dentro l’obiettivo di 500: a guardare la media, la promessa è mantenuta. La p95 però è 729 ms, ben oltre. E la simulazione conta anche le richieste che sforano il mezzo secondo: con batch da 64 sono il 33,4%, una su tre, contro il \(3{,}5\%\) dei batch da 16. Chi riportasse la media lo farebbe in buona fede, e sarebbe smentito da un terzo dei suoi utenti. È il modo più comune in cui un cruscotto tutto verde copre un servizio in rosso.
In produzione si presenta anche il caso che la simulazione non contiene: la media che migliora mentre la p95 o la p99 peggiorano. È un peggioramento, e si tratta come un guasto. Appartiene al primo dei tre livelli di Sorvegliare un modello vivo, quello che dice se il servizio è vivo e risponde in tempo prima ancora di chiedersi se risponde bene, declinato sulle due attese della generazione.
La leva che resta: riusare il prefisso#
Scelto come si servono le richieste e come si alternano lettura e scrittura, quale leva resta per far comparire prima la prima parola? Una soprattutto, e non riguarda il modello ma il traffico: nei sistemi reali le richieste non sono indipendenti fra loro, cominciano quasi tutte allo stesso modo.
Ogni atto di uno studio notarile comincia con le stesse quattro pagine di premesse, e solo dalla quinta si parla del caso. Un copista che trascrivesse ogni atto da capo riscriverebbe quelle pagine centinaia di volte: basta averne una copia pronta e aggiungere solo il seguito.
Nei sistemi che servono modelli generativi tre casi coprono quasi tutto il traffico. L’istruzione di sistema (le righe che spiegano al modello come comportarsi) è identica per tutti. Un documento allegato su cui si fanno dieci domande è lo stesso dieci volte. E una conversazione, al decimo turno, rimanda i nove turni precedenti più l’ultima domanda: quei nove li abbiamo già letti nove volte.
Gli appunti che il modello prende su un pezzo di testo dipendono solo da quel pezzo e da ciò che lo precede: se l’inizio è identico, gli appunti sull’inizio sono identici. Identico segno per segno, però: cambiata una virgola nella prima pagina, da lì in poi il copista ricomincia a scrivere.
Riprendiamo i 250 token per turno (la domanda più la risposta) della conversazione di Fig. 36.16, e allunghiamola a dieci turni: al primo il modello ne legge 250, al secondo 500, al terzo 750 e via salendo. Rileggere tutto ogni volta costa \(250 \times (1+2+\dots+10) = 13\,750\) token di lettura; riusare gli appunti significa leggerne 250 per turno, cioè \(250 \times 10 = 2\,500\) in tutto, cinque volte e mezzo di meno. Il risparmio è di lavoro: attesa e memoria. Quanto ne arrivi sulla fattura lo decide chi vende il servizio. E più la conversazione va avanti più conviene, perché rileggere da capo costa a ogni turno un po’ di più, mentre il riuso costa sempre gli stessi 250: a venti turni il risparmio sale a dieci volte e mezzo.
Lo scaffale delle copie pronte ha però una capienza, e quando si riempie si buttano via i fascicoli che nessuno chiede da più tempo. Chi torna dopo un’ora trova il suo atto da ricopiare da capo.
Nell’attenzione causale la coppia \((\mathbf{k}, \mathbf{v})\) della posizione \(j\) dipende solo dai token \(1, \dots, j\). Due richieste che condividono un prefisso hanno quindi, per quelle posizioni, la stessa KV cache in aritmetica esatta, a parità di pesi, precisione, eventuale adattatore LoRA e codifica posizionale; ricalcolata dentro un batch di forma diversa può differire nelle ultime cifre, per la stessa non associatività della somma che il batching dinamico già introduce, e riusarla non è quindi meno esatto che ricalcolarla. La chiave del riuso è la sequenza esatta di identificativi di token, non la stringa.
Il meccanismo di riferimento è la RadixAttention di SGLang [ZYX+24]: la cache non è una tabella piatta ma un albero dei prefissi compresso (un radix tree) i cui archi sono sequenze di token e i cui nodi puntano ai blocchi di KV cache. Una richiesta nuova cammina sull’albero finché i token coincidono, riusa i blocchi trovati e calcola il prefill solo per la parte restante; il ramo nuovo si innesta e resta disponibile per le richieste successive. Lo sfratto è a politica LRU con un conteggio dei riferimenti, così che i blocchi in uso non vengano rimossi, e lo scheduler può ordinare la coda per affinità di prefisso, in modo da massimizzare i colpi a cache prima che i rami vengano sfrattati.
Il legame con la sezione precedente è diretto: la condivisione è possibile perché la KV cache è già paginata in blocchi di taglia fissa con una block table [KLZ+23]. Condividere significa far puntare due block table allo stesso blocco fisico e incrementare un contatore, la stessa idea di copy-on-write dei sistemi operativi; RadixAttention aggiunge l’indice che rende la condivisione sistematica fra richieste diverse nel tempo, non solo fra sequenze compresenti nello stesso batch. L’effetto sul TTFT è quasi proporzionale alla frazione di prompt trovata in cache, e in una conversazione di \(n\) turni, ciascuno dei quali aggiunge \(m\) token (il prompt del turno \(k\) è quindi lungo \(k\,m\)), il prefill totale scende da \(m\,n(n+1)/2\) a \(m\,n\): da quadratico a lineare nei turni, con un risparmio di un fattore \((n+1)/2\).
Una cautela va aggiunta, perché riguarda la sicurezza e non le prestazioni. Se la cache dei prefissi è condivisa fra clienti diversi, il comportamento del servente rivela che cosa contiene. Un prefisso già in cache ha un TTFT più basso: chi attacca manda un testo scelto da lui, cronometra la prima parola e, se arriva stranamente in fretta, sa che qualcun altro aveva già mandato quel testo. È un canale laterale a base di tempo, cioè un’informazione che trapela da un effetto collaterale del calcolo e non dalla risposta. Gu e colleghi lo hanno cercato, nell’autunno del 2024, su diciassette fornitori di modelli via API, e in sette hanno trovato una cache condivisa fra tutti gli utenti [GLK+25]. Il tempo non è l’unica spia. Uno scheduler che serve per prime le richieste con il prefisso più lungo già in cache fa trapelare la stessa informazione dall’ordine in cui tornano le risposte, e su SGLang Wu e colleghi ne ricavano il prompt di un altro utente un token alla volta [WZZ+25]. È un parente dell’inferenza di appartenenza che il capitolo sull’AI responsabile tratta in Privacy e robustezza (decidere dall’esterno se un dato era presente), con il prompt di un altro cliente al posto dell’esempio di addestramento. Le difese sono di progetto, e non si ottengono tarando un parametro: si partiziona la cache per cliente, e si condividono solo i prefissi dichiaratamente pubblici, tipicamente l’istruzione di sistema del prodotto.
Anche la correttezza chiede una condizione. La KV cache riusata coincide con quella che il modello avrebbe calcolato soltanto se sono gli stessi il modello, gli eventuali pesi aggiuntivi che lo specializzano (la LoRA vista dopo il pre-addestramento) e la precisione numerica, cioè quante cifre hanno i suoi numeri. Se la chiave con cui la cache cerca un prefisso non comprende tutte e tre, a un modello arrivano i valori calcolati da un altro, e nessun errore lo segnala.
Quando la memoria finisce#
Riusare il prefisso e riempire il batch chiedono la stessa risorsa, la memoria per la KV cache, e la memoria finisce in due momenti. Durante la generazione, quando le risposte in corso hanno occupato tutti i blocchi di memoria e una di loro ne chiede un altro per il token che sta scrivendo; e nella cache dei prefissi, quando per far posto si butta un prefisso che qualcuno chiederà di nuovo fra un’ora. In tutti e due i casi la domanda è la stessa: dove mettere i blocchi di KV cache che non stanno più, e se convenga conservarli o ricalcolarli.
Lo scaffale del copista sta accanto al tavolo, nella stessa stanza, e la stanza è quella: più posto allo scaffale vuol dire meno tavolo. Quando lo scaffale si riempie, i fascicoli che nessuno chiede da più tempo non vanno per forza al macero. Si possono portare in archivio al piano di sotto, o più giù ancora, in cantina: nel calcolatore il piano di sotto è la memoria del computer in cui la scheda grafica è montata, la cantina il suo disco. Più si scende più c’è posto, e più ci vuole a riprenderli.
Portarli giù conviene se riprenderli costa meno che ricopiarli. Tutti e due i tempi crescono con le pagine del fascicolo, quindi la sua lunghezza pesa allo stesso modo sui due piatti della bilancia, e a decidere è quanto sono lente le scale rispetto alla mano del copista. Se scendere costa un minuto a pagina e ricopiare due, vince lo scendere, con dieci pagine come con cento. Solo con fascicoli lunghissimi la bilancia si sposta, e sempre dalla parte delle scale: lì ricopiare una pagina costa sempre di più, perché ogni riga nuova va confrontata con tutte quelle prima. Dal piano di sotto riprendere conviene quasi sempre, dalla cantina a volte si fa prima a ricopiare, e conta anche come si portano i fascicoli: dieci scatoloni pieni fanno le scale più in fretta di cento cartelline sciolte. In uno studio con molti copisti, poi, conviene dare ogni atto nuovo a chi ha già in archivio le premesse giuste, a meno che non sia sommerso di lavoro.
Lo stesso problema si presenta sul tavolo, mentre si lavora. Lì il copista non copia: scrive gli atti nuovi, una riga alla volta, e per ciascuno tiene accanto i suoi appunti, che crescono a ogni riga. Quando il tavolo è pieno e un atto ha bisogno di spazio per un appunto in più, qualcuno deve lasciare il tavolo, e lo lascia l’ultimo arrivato, perché chi aspetta da più tempo ha la precedenza. L’atto esce con tutti i suoi appunti: con metà degli appunti altrove non si può continuare.
Al suo ritorno ci sono le stesse due strade. Gli appunti si possono riprendere dall’archivio, oppure si buttano e si rifanno dalle righe già scritte, che restano e occupano poco. Rifarli va molto più in fretta di quanto sia servito la prima volta: allora ogni riga aspettava la precedente, perché la si stava componendo, adesso le righe ci sono tutte e gli appunti si rifanno di fila, in un colpo solo. È per questo che rifare, a volte, batte conservare.
Quale strada convenga dipende anche da quanto spazio occupano gli appunti, e questo lo decide com’è costruito il modello: c’è il copista che per ogni riga d’atto riempie quattro righe di appunti, e quello che ne riempie una. Rifarli costa lo stesso a tutti e due, perché si rifanno dalle righe dell’atto; portarli su e giù costa tanto più quanto più pesano. Con quattro righe di appunti per riga le due strade si equivalgono, o rifarli vince di poco; con una sola, conservarli vince nettamente.
Quando i blocchi liberi finiscono, lo scheduler descritto dagli autori di vLLM [KLZ+23] sospende (preempt) delle sequenze in ordine inverso d’arrivo, per restare fedele alla politica FCFS (chi aspetta da più tempo ha la precedenza, e nessuno resta indietro per sempre), e le sfratta per intero, tutti i blocchi o nessuno, perché una sequenza con parte della cache fuori dalla GPU non può avanzare. Al ritorno le ripristina in uno di due modi. Con lo swap i blocchi vengono copiati nella memoria dell’host e riportati indietro; con il ricalcolo vengono buttati e ricostruiti, e il ricalcolo costa meno di quanto sembri: i token già generati si concatenano al prompt e l’intera cache si ricostruisce con un solo prefill, parallelo, invece di rifare uno per uno i passi di decode. Per un contesto di \(L\) token, in prima approssimazione,
con \(m_{\text{kv}}\) i byte di KV cache per token, \(P_{\text{eff}}\) i FLOP al secondo che la scheda tiene davvero in prefill e \(B_{\text{host}}\) la banda effettiva fra host e scheda. Le ipotesi sono tre. Il prefill è compute-bound, cioè \(L\) supera il ginocchio del roofline (qualche centinaio di token): sotto, il ricalcolo costa almeno la lettura dei pesi, e il rapporto torna a dipendere da \(L\). Il termine quadratico dell’attenzione resta minoritario rispetto a quello lineare. E si conta un solo attraversamento del PCIe, il rientro, supponendo che l’uscita al momento della sospensione si sovrapponga al calcolo; se non si sovrappone, \(t_{\text{swap}}\) raddoppia. Con numeri tondi, \(B_{\text{host}} = 25\) GB/s (un PCIe di quarta generazione) e \(P_{\text{eff}} = 5 \cdot 10^{14}\) FLOP/s, un modello da \(7 \cdot 10^9\) parametri con attenzione multi-testa piena (\(m_{\text{kv}} = 512\) KiB per token, il conto di L’attenzione in pratica) dà \(2 \cdot 7\cdot10^9 \cdot 2{,}5\cdot10^{10} / (5\cdot10^{14} \cdot 524\,288) \approx 1{,}3\), praticamente la parità; lo stesso modello con GQA a otto teste di chiavi e valori (\(m_{\text{kv}} = 128\) KiB, la riga GQA della stessa tabella) dà circa 5,3, e lo swap vince nettamente. Contando anche l’uscita, i due rapporti diventano 0,67 e 2,7: con l’attenzione piena passa avanti il ricalcolo, con GQA resta avanti lo swap. La seconda ipotesi cede con i contesti lunghi: per quel modello il costo dell’attenzione causale nel prefill eguaglia quello degli strati densi attorno ai 53 mila token, e oltre il ricalcolo costa per token sempre di più, quindi conservare conviene sempre di più.
La banda effettiva, poi, dipende dalla granularità: con blocchi piccoli i trasferimenti sono tanti e minuti e la banda del PCIe crolla. Gli autori di vLLM misurano, su OPT-13B (attenzione multi-testa piena, cioè il primo dei due casi) e su una A100, che il ricalcolo conviene con blocchi piccoli, lo swap con blocchi grandi, e che fra 16 e 64 token per blocco i due si equivalgono. Nella versione più recente di vLLM il ricalcolo è diventato il comportamento di default, perché nella nuova architettura costa meno.
Lo stesso conto governa la cache dei prefissi quando la si estende oltre la GPU. I blocchi sfrattati dall’albero dei prefissi, invece di essere scartati, scendono in una gerarchia: la memoria dell’host, gli SSD locali, e in un cluster la memoria e i dischi di altre macchine raggiunti via rete. Un colpo in un livello di banda \(B_{\text{liv}}\) conviene se \(L\, m_{\text{kv}}/B_{\text{liv}} < 2N_pL/P_{\text{eff}}\), cioè se ricaricare costa meno che rifare il prefill, e il margine si stringe a ogni livello. Mooncake [QLH+25], la piattaforma che serve il chatbot Kimi, è costruita attorno a questa idea: separa prefill e decode, mette in comune la DRAM, gli SSD e le schede di rete poco usati del cluster in una cache globale di KV, e ha uno scheduler che sceglie dove mandare ogni richiesta pesando il prefisso già presente contro il carico delle istanze, e che può anche spostare la cache o ricalcolarla. Su tracce reali gli autori riportano una capacità effettiva più alta del 59-498% rispetto ai sistemi di riferimento, a seconda della soglia imposta alla pausa fra un token e l’altro.
Misurare in venti righe#
I numeri delle due configurazioni vengono da una simulazione di venti righe.
Per ogni richiesta arrivata in dieci secondi estrae a sorte un TTFT e un TPOT,
li confronta con le due promesse (gli SLO di Servire un modello, che nel codice sono SLO_TTFT e SLO_TPOT) e
ne ricava throughput, goodput e percentili. I tempi si sorteggiano da una
distribuzione lognormale, la riga rng.lognormal: quella di una grandezza
il cui logaritmo segue la curva a campana. È una scelta comune per i tempi di
servizio, perché ammassa le richieste attorno a un valore tipico, ne lascia
andare poche, sempre più rare, verso i tempi lunghi (la coda di cui si è
parlato fin qui) e non produce mai un tempo negativo. Resta un’ipotesi del
modello: le latenze vere hanno spesso code più pesanti, e più di un picco, per
esempio una richiesta trovata in cache e una no.
import numpy as np

rng = np.random.default_rng(0)

SLO_TTFT, SLO_TPOT = 0.500, 0.050   # obiettivi dichiarati: 500 ms e 50 ms
FINESTRA = 10.0                     # secondi di traffico osservato

def misura(nome, n, ttft_mediano, tpot_mediano, sigma=0.35):
    """Simula n richieste servite nella finestra e ne riassume le metriche."""
    ttft = rng.lognormal(np.log(ttft_mediano), sigma, n)  # code lunghe a destra
    tpot = rng.lognormal(np.log(tpot_mediano), sigma, n)
    ok = (ttft <= SLO_TTFT) & (tpot <= SLO_TPOT)          # rispetta ENTRAMBE
    sfora = (ttft > SLO_TTFT).mean()                      # guarda solo il TTFT
    p50, p95, p99 = np.percentile(ttft, [50, 95, 99]) * 1000
    print(f"{nome:<9}{n / FINESTRA:8.1f}{ok.sum() / FINESTRA:9.1f}{ok.mean():10.1%}"
          f"{sfora:9.1%}{ttft.mean() * 1000:9.0f}{p50:7.0f}{p95:7.0f}{p99:7.0f}")

print(f"{'config':<9}{'ric/s':>8}{'good/s':>9}{'conformi':>10}{'TTFT>SLO':>9}"
      f"{'TTFTmed':>9}{'p50':>7}{'p95':>7}{'p99':>7}")
misura("batch 16", 200, 0.28, 0.028)
misura("batch 64", 320, 0.43, 0.043)
config      ric/s   good/s  conformi TTFT>SLO  TTFTmed    p50    p95    p99
batch 16     20.0     18.5     92.5%     3.5%      297    285    486    530
batch 64     32.0     15.8     49.4%    33.4%      457    429    729    893
È la tabella delle due configurazioni commentate prima. Le sue due colonne di
percentuali contano cose diverse, e conviene tenerle separate. conformi è la
quota di richieste che rispettano tutte e due le promesse, quella sul primo
token e quella sul ritmo; TTFT>SLO guarda solo la prima e conta chi la sfora,
comunque vada il ritmo. Per questo a batch da 64 si legge sia «una su tre sfora
il mezzo secondo» sia «una su due non è a posto»: sono due bocciature diverse,
e la seconda comprende la prima.
Le stesse venti righe, girate su misure vere invece che su numeri sorteggiati, e ripetute a ogni finestra di dieci secondi, sono lo scheletro di un cruscotto: throughput, goodput e percentili sono tutto quello che serve per sapere se un servizio che genera testo sta funzionando, pur con un’avvertenza sui percentili alti. In una finestra di dieci secondi a venti richieste al secondo ci sono duecento richieste, e la p99 poggia sulle due o tre più lente: da una finestra all’altra oscilla parecchio anche se niente è cambiato. Per sorvegliarla servono finestre che contengano migliaia di richieste, più lunghe o sommate su più repliche.
Che cosa vuol dire funzionare#
Queste metriche sono la definizione operativa di cosa vuol dire, per questo servizio, funzionare, e non contabilità da presentare a fine mese. Sceglierle equivale a decidere quali richieste contano e quali no, e ogni ottimizzazione successiva si muoverà nella direzione che quella scelta indica. Un sistema tarato sul throughput diventerà bravissimo a servire molte richieste male; uno tarato sul TTFT medio diventerà bravissimo a nascondere la coda lenta a chi guarda i grafici. È lo stesso avvertimento già dato sulle metriche di un classificatore e sui surrogati del giudizio umano: ottimizzare contro una misura sbagliata non produce un fallimento rumoroso, produce un successo apparente.
Da ricordare
Per un modello che genera testo la velocità non è un numero solo, come al menù degustazione: c’è l’attesa della prima parola (TTFT), che dipende dalla fila e da quanto è lungo il prompt da leggere, e la pausa fra una parola e la successiva (TPOT), cioè il ritmo con cui il testo scorre. Due sistemi che finiscono nello stesso istante possono essere l’uno piacevole e l’altro irritante.
Leggere il prompt e generare le parole sono due lavori opposti: leggere tiene la macchina piena di lavoro utile, generare la costringe a scaldarsi ogni volta per un foglio solo. Sulla stessa scheda l’uno blocca l’altro, e i rimedi sono due: spezzare il prompt lungo in pezzi e infilare fra un pezzo e l’altro le parole di tutti gli altri (la cassa che alterna il carrello e chi ha in mano solo il pane), oppure separare i reparti, al prezzo di trasferire gli appunti presi leggendo.
Il goodput conta solo le richieste servite entro le promesse dichiarate. Servirne di più in una volta alza il numero dei coperti e abbassa quello dei clienti contenti: nell’esempio, \(+60\%\) di richieste servite e \(-15\%\) di richieste servite bene.
Le medie mentono: si guardano i percentili alti (p95 e p99, il tempo entro cui arrivano 95 e 99 richieste su cento), riportati separatamente per ciascuna delle due attese. E quando una risposta aspetta venti richieste lanciate insieme, si aspetta la più lenta: se una su cento è lenta, la probabilità che almeno una delle venti lo sia arriva al \(18\%\). Una media che migliora mentre il caso peggiore peggiora è un peggioramento.
La leva che resta è riusare l’inizio: istruzione di sistema, documento allegato e cronologia della conversazione si ripetono identici a ogni richiesta, come le pagine di premesse dello studio notarile. Tenerne gli appunti già pronti e ricopiare solo il seguito accorcia l’attesa della prima parola, e più la conversazione è lunga più conviene.
Se quegli appunti sono condivisi fra utenti diversi, una risposta anormalmente rapida rivela che qualcun altro aveva già inviato quel testo. Si tengono separati per cliente e si condivide solo ciò che è dichiaratamente pubblico.
Quando la memoria degli appunti finisce, quelli che non stanno più si portano in archivio, al piano di sotto o in cantina, oppure si buttano e si rifanno dalle righe già scritte, che per una risposta a metà va molto più in fretta della prima volta, perché si fa tutto di fila. La lunghezza del fascicolo pesa allo stesso modo sulle due strade: a scegliere sono la lentezza delle scale e quanto spazio occupano gli appunti, e con fascicoli lunghissimi conservare conviene sempre di più.
Da ricordare
Per un modello che genera, la latenza non è un numero solo: si scompone in TTFT (attesa del primo token vista dal cliente, fatta di fila e prefill e quindi crescente con la lunghezza del prompt) e TPOT o ITL (pausa fra token successivi, la fase decode memory-bound), e si ricompone come \(T = \text{TTFT} + (N_{\text{out}} - 1)\,\text{TPOT}\). Per un testo letto in streaming la velocità percepita è \(1/\text{TPOT}\); per una risposta che si usa solo intera conta \(T\).
Prefill e decode sono mestieri opposti: l’intensità aritmetica è pari al numero di token elaborati insieme, quindi il prefill è compute-bound e il decode memory-bound. Sulla stessa GPU l’uno blocca l’altro; i rimedi sono il chunked prefill [AKP+24], che spezza il prompt e lo intercala ai passi di decode, e la disaggregazione [ZLC+24], che li manda su GPU diverse al prezzo di trasferire la KV cache.
Il goodput conta solo le richieste servite entro gli obiettivi dichiarati: allargare il batch alza il throughput e può abbassare il goodput (nell’esempio \(+60\%\) di richieste servite e \(-15\%\) di richieste servite bene). È la misura che rende visibile il compromesso fra throughput e latenza.
Le medie mentono: p50, p95 e p99 vanno riportati per ciascuna metrica. Le code si compongono nel fan-out, dove si aspetta la più lenta di \(n\) chiamate parallele (\(1 - 0{,}99^{20} \approx 18\%\) con venti) [DB13]; in una catena sequenziale invece si sommano e la coda relativa si stringe, ma sfonda lo SLO il budget totale. Una media che migliora mentre la p99 peggiora è una regressione.
Il riuso del prefisso è la leva che resta: istruzione di sistema, documenti allegati e cronologia di conversazione rendono identica una parte della KV cache. Un albero dei prefissi la condivide fra richieste diverse [ZYX+24] (possibile perché la cache è già paginata in blocchi [KLZ+23]) e in una conversazione porta il prefill totale da quadratico a lineare nei turni.
La cache condivisa è però un canale laterale fra utenti: un TTFT anormalmente basso [GLK+25], o l’ordine delle risposte sotto uno scheduler che privilegia i prefissi in cache [WZZ+25], rivela che quel prefisso era già stato inviato da qualcuno. Si partiziona per cliente e si condividono solo i prefissi pubblici.
Quando i blocchi finiscono, vLLM sospende le sequenze arrivate per ultime e le ripristina con lo swap sulla memoria dell’host o con il ricalcolo, che rifà la cache in un solo prefill. Il rapporto fra i due tempi, \(2N_pB_{\text{host}}/(P_{\text{eff}} m_{\text{kv}})\), non dipende dalla lunghezza del contesto finché il prefill è compute-bound e l’attenzione resta minoritaria; con i contesti molto lunghi conservare conviene sempre di più. Lo stesso conto decide se una cache dei prefissi estesa a host, SSD e cluster [QLH+25] convenga più del prefill rifatto.
Le metriche dicono quanto bene si serve, e lasciano aperta la domanda successiva: quante repliche servono per servire così, e a che prezzo. La affronta Quante repliche accendere, che dal goodput appena definito ricava la capacità di una replica e, da questa, il numero di repliche da tenere accese e il costo di ogni token.