


Analisi e ottimizzazione: derivate e discesa del gradiente#
Nebbia fitta, nessuna mappa, e non si vede a un metro di distanza. Un’informazione, però, ce l’hai sempre: la pendenza del terreno sotto i piedi. Ti basta sentire da che parte scende, fare un passo in quella direzione, rimisurare e ripetere. Addestrare un modello con la discesa del gradiente funziona proprio così. La collina da scendere è la funzione che misura quanto il modello sbaglia (il costo o loss, che indichiamo con \(\mathcal{L}\)) e lo strumento che sente la pendenza sotto i piedi è la derivata.
La derivata: la pendenza istante per istante#
Una funzione è una regola che, dato un numero in ingresso, ne restituisce uno in uscita, sempre lo stesso a parità di ingresso: «raddoppia» è una funzione, «il prezzo del biglietto per un viaggio di tanti chilometri» è una funzione, e anche «di quanto sbaglia questo modello, se i suoi parametri valgono così» è una funzione. Disegnarla si può: si mette l’ingresso sull’asse orizzontale e l’uscita su quello verticale, e l’insieme dei punti che ne viene fuori è il grafico, di solito una curva che sale e scende. La derivata risponde a una domanda sola: se sposto l’ingresso di una quantità piccolissima \(h\), di quante volte \(h\) cambia l’uscita?
La posizione di un’auto cambia nel tempo, e la velocità è «quanto in fretta» cambia. Il tachimetro, quindi, sta già mostrando una derivata: la derivata della posizione.
Sul grafico si vede ancora meglio. Appoggia un righello alla curva in un punto e giralo finché, lì attorno, righello e curva si sovrappongono: quella è la retta tangente, e la sua inclinazione (di quanto sale ogni volta che si avanza di un passo verso destra) è la derivata lì. Dove la curva sale ripida il righello è ripido e la derivata è grande e positiva; dove scende, il righello punta in giù e la derivata è negativa; in cima a una gobba o in fondo a una conca, dove per un istante il terreno è piatto, il righello è orizzontale e la derivata vale zero.
La derivata di \(f\) in \(x\) è il limite del rapporto incrementale:
Misura la pendenza della retta tangente al grafico in \(x\), e presuppone che il limite esista: \(|x|\) in \(0\) non ha derivata. I punti in cui \(f'(x) = 0\) si dicono stazionari: massimi, minimi o flessi a tangente orizzontale (in più variabili, anche punti di sella). Se \(f\) è derivabile in un punto interno di minimo, lì \(f'(x)=0\) (teorema di Fermat); la condizione è necessaria e non sufficiente, e i candidati al minimo di una loss sono i punti stazionari più quelli in cui la derivata non esiste, come lo zero di una ReLU o di un valore assoluto. Lì le librerie mettono per convenzione un valore compreso fra le due derivate laterali (un sottogradiente): PyTorch dà \(0\) sia alla ReLU sia al valore assoluto, che in \(0\) ha derivate laterali \(-1\) e \(+1\).
Le derivate che tornano di continuo#
Nessuno, in pratica, va a misurare la pendenza punto per punto: per le funzioni che si incontrano di solito la derivata si ricava da poche regole, imparate una volta e riusate sempre, come le tabelline. E tre famiglie di funzioni compaiono ovunque nel machine learning.
Le tre «solite sospette» sono le potenze, l’esponenziale e il logaritmo. La prima famiglia la conosci già. La parabola \(x^2\), cioè «il numero moltiplicato per sé stesso», è la forma dell’errore quadratico, quello che si minimizza quando il modello deve prevedere un numero. Le altre due stanno dentro un libretto di risparmio.
Cento euro sul libretto, e ogni anno il capitale raddoppia. Dopo tre anni ce ne sono ottocento, cioè \(2\times2\times2 = 2^3 = 8\) volte il capitale. Il logaritmo parte dall’altro capo: quanti raddoppi servono per arrivare a otto volte tanto? Tre, e si scrive \(\log_2 8 = 3\); quel \(2\) in basso, il fattore che si ripete, si chiama base. Un libretto che decuplica ogni anno va da cento euro a centomila negli stessi tre anni, e \(\log_{10} 1000 = 3\) perché \(1000\) è \(10\times10\times10\).
Contare i fattori invece dei soldi schiaccia i numeri enormi. Fra un libretto da \(1000\) euro e uno da \(1\,000\,000\) ci sono novecentonovantanovemila euro di differenza, fra i loro logaritmi in base dieci ce ne sono tre (contati in raddoppi, una decina). E trasforma le moltiplicazioni in somme, perché moltiplicare due potenze vuol dire sommarne gli esponenti: tre anni di raddoppio e poi altri quattro moltiplicano il capitale per \(8\) e per \(16\) (\(128\) in tutto), mentre i raddoppi si sommano, \(3+4=7\). Un libretto che ogni giorno perde metà di quello che ha, dopo mille giorni tiene una cifra con più di trecento zeri dopo la virgola, ai limiti di quello che un calcolatore sa scrivere. Un modello che moltiplica fra loro mille probabilità di un centesimo arriva a duemila zeri, ben oltre quel limite, e il calcolatore arrotonda il risultato a zero. I mille logaritmi invece si sommano, e il risultato è lo stesso a meno di tradurlo indietro.
L’esponenziale è il logaritmo letto al contrario, e nasce da una regola sola cambiata sul libretto: gli interessi maturano in ogni istante invece che una volta l’anno, sempre in proporzione a quanto c’è già sul conto. Cento euro al cento per cento annuo, così, diventano circa \(271{,}83\) invece di duecento, cioè \(100\) per \(e \approx 2{,}718\). Quel simbolo indica sempre lo stesso numero, come \(\pi\) vale \(3{,}14\), e la curva \(e^x\) che ne viene fuori in ogni punto cresce esattamente quanto vale: con \(5\) sul conto gli interessi maturano al ritmo di \(5\), con \(10\) al ritmo doppio. Fuori dal libretto l’esponenziale sta dentro la sigmoide e la softmax, due ricette che prendono i punteggi grezzi sputati da un modello (numeri qualsiasi, anche negativi) e li restituiscono come probabilità fra zero e uno: la sigmoide un punteggio alla volta, quando la domanda è sì o no e le due risposte si spartiscono da sé l’intero; la softmax tutti insieme, quando le alternative sono più di due e le loro probabilità devono sommare a uno. Il logaritmo, dal canto suo, compare nella cross-entropy, il costo con cui si addestrano i classificatori, di cui parla per esteso la sezione sulla teoria dell’informazione.
Restano le pendenze, che si prendono da una tabella come si prende la formula dell’area del cerchio, senza dimostrarle. La pendenza di \(x^2\) è \(2x\), quindi nel punto \(x=3\) la parabola sale con pendenza \(6\). Quella di \(e^x\) è di nuovo \(e^x\), che è la regola del libretto detta in simboli, ed è il motivo per cui l’esponenziale rende i conti sopportabili: derivandolo, resta identico a sé stesso. E la pendenza del logaritmo naturale, quello che ha per base proprio \(e\), è «uno diviso il numero a cui si è arrivati»: su un conto da \(1000\) euro un euro in più sposta il conteggio di un millesimo, che è lo schiacciamento dei numeri enormi visto dal lato della pendenza.
Le tre regole che useremo senza più pensarci:
Ricorrono proprio queste tre per una ragione: l’errore quadratico medio è una potenza, la sigmoide \(\sigma(x)=1/(1+e^{-x})\) e la softmax sono costruite sull’esponenziale, la log-verosimiglianza e la cross-entropy sul logaritmo. La stabilità di \(e^x\) sotto derivazione è ciò che rende quei conti trattabili. Valgono anche la linearità, la regola del prodotto \((fg)'=f'g+fg'\) e del quoziente \((f/g)'=(f'g-fg')/g^2\), e ne discendono le due derivate che tornano di continuo: \(\sigma'(x)=\sigma(x)\big(1-\sigma(x)\big)\) e, per la softmax \(\mathbf{s}=\operatorname{softmax}(\mathbf{z})\), \(\partial s_i/\partial z_j=s_i(\delta_{ij}-s_j)\), da cui la cross-entropy \(\mathcal{L}=-\log s_y\) ha gradiente \(\partial\mathcal{L}/\partial\mathbf{z}=\mathbf{s}-\mathbf{e}_y\), con \(\mathbf{e}_y\) il vettore che vale uno nella posizione della classe vera.
Dal singolo numero al gradiente#
Un modello reale non ha un parametro solo, ne ha milioni, e la loss dipende da tutti insieme. Con due parametri il costo non è più una curva ma una superficie, un paesaggio di colline e conche in cui ogni punto del terreno è una coppia di valori dei parametri e la quota è l’errore che ne viene fuori. Un modo comodo di disegnare un paesaggio su un foglio è quello delle carte escursionistiche: guardarlo dall’alto e tracciare le curve di livello, cioè le linee che uniscono i punti alla stessa quota. Dove le linee sono fitte, il terreno è ripido; dove sono larghe, è pianeggiante.

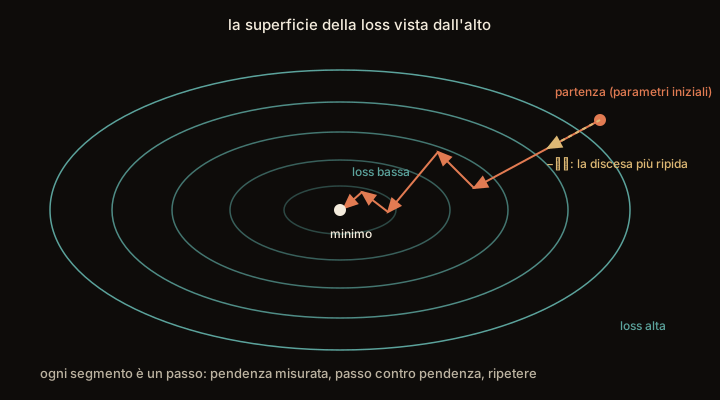
Fig. 3.9 Il paesaggio del costo visto dall’alto, come in una carta escursionistica: ogni anello unisce i punti in cui il modello sbaglia allo stesso modo, e il centro è il fondo della conca. Il gradiente disegnato sopra è la freccia che in ogni punto indica dove il terreno sale più ripido (nel disegno compare col segno meno, \(-\nabla\mathcal{L}\), perché per scendere si va nel verso opposto: il triangolino capovolto \(\nabla\) è il simbolo che lo indica, si legge «nabla»). Quella freccia taglia sempre ad angolo retto l’anello su cui si trova.#
Quell’angolo retto di Fig. 3.9 ha una ragione precisa: lungo una curva di livello la loss è costante, quindi la derivata nella direzione della curva è nulla, e il gradiente non ha nessuna componente lungo di essa. Per cambiare quota, il passo più efficace taglia gli anelli ad angolo retto.
È lo stesso angolo retto a spiegare un fastidio che si incontra sempre. Se la conca invece di essere tonda si allunga in una valle stretta, gli anelli diventano ovali schiacciati, e la perpendicolare a un ovale schiacciato punta verso il fianco vicino, non verso il fondo lontano. Il percorso allora zigzaga da una parete all’altra e avanza poco.
La derivata parziale è semplice: tieni fermi tutti i parametri tranne uno e misura la pendenza rispetto a quello, come lasciare ferme tutte le manopole di un mixer tranne una e ascoltare l’effetto di quella sola. Metti in fila tutte queste pendenze e ottieni il gradiente: un vettore che punta nella direzione in cui il costo cresce più in fretta (la salita più ripida). Per scendere, ci basta andare nel verso opposto. È lo stesso oggetto che nella sezione di algebra lineare risaliva la pila di tavole come messaggio di ritorno: dice, manopola per manopola, di quanto conviene girarla.
«Più ripida» rispetto a che cosa? Confrontare le direzioni presuppone passi della stessa lunghezza, misurati alla maniera ovvia: un metro è un metro, in qualunque direzione lo si faccia. Se però verso nord si affonda nella neve e verso est corre un sentiero battuto, i passi non costano tutti uguali, e la direzione che fa scendere di più a parità di fatica non coincide con quella della pendenza pura. Il gradiente vince finché i passi si misurano tutti allo stesso modo; cambiando il metro, cambia il vincitore. È la ragione per cui certi metodi di addestramento, invece di seguire il gradiente così com’è, allungano il passo nelle direzioni in cui costa poco e lo accorciano in quelle in cui costa molto.
Per una loss \(\mathcal{L}(\theta)\) che dipende dai parametri \(\theta = (\theta_1, \dots, \theta_n)\), il gradiente è il vettore delle derivate parziali:
Una convenzione, dichiarata una volta per tutte
Da qui in avanti vale il layout al denominatore: la derivata di uno scalare rispetto a un oggetto ha sempre la stessa forma di quell’oggetto. Il gradiente rispetto a un vettore è quindi un vettore colonna (per una funzione vettoriale \(\mathbf{f}:\mathbb{R}^n\to\mathbb{R}^m\) la jacobiana resta invece \((\mathbf{J}_{\mathbf{f}})_{ij}=\partial f_i/\partial x_j\), di forma \(m\times n\): la regola vale per i gradienti di scalari), e per una matrice di pesi \(\mathbf{W}\in\mathbb{R}^{m\times n}\) che manda un ingresso \(\mathbf{a}\in\mathbb{R}^n\) in \(\mathbf{z}=\mathbf{W}\mathbf{a}\in \mathbb{R}^m\), \(\partial\mathcal{L}/\partial\mathbf{W}\) è una matrice \(m\times n\) come \(\mathbf{W}\). Detto \(\boldsymbol{\delta}=\partial\mathcal{L}/\partial\mathbf{z}\in\mathbb{R}^m\), da \(z_i=\sum_j W_{ij}a_j\) segue \(\partial\mathcal{L}/\partial W_{ij}=\delta_i a_j\), cioè \(\partial\mathcal{L}/\partial\mathbf{W}=\boldsymbol{\delta}\mathbf{a}^\top\). La posta in gioco è la differenza fra \(\boldsymbol{\delta}\mathbf{a}^\top\) (\(m\times n\)) e \(\mathbf{a}\boldsymbol{\delta}^\top\) (\(n\times m\)), cioè fra un aggiornamento dei pesi che ha le dimensioni giuste e uno che non si può nemmeno scrivere. La sezione sulla backpropagation e quella su tensori e autograd compongono catene di derivate con questa convenzione, e chi le rifà a mano deve poterle attaccare senza trasposte a sorpresa.
Vale un fatto centrale: \(\nabla\mathcal{L}\) indica la direzione di massima crescita di \(\mathcal{L}\), quindi \(-\nabla\mathcal{L}\) è la direzione di massima discesa. È il verso in cui muoveremo i parametri, e si dimostra in due righe. La variazione di \(\mathcal{L}\) nella direzione di un versore \(\mathbf{u}\) (la derivata direzionale) è \(D_\mathbf{u}\mathcal{L} = \nabla\mathcal{L}^\top\mathbf{u}\); per la disuguaglianza di Cauchy–Schwarz vale \(|\nabla\mathcal{L}^\top\mathbf{u}| \le \lVert\nabla\mathcal{L}\rVert\), con uguaglianza se e solo se \(\mathbf{u}\) è parallelo a \(\nabla\mathcal{L}\). La perpendicolarità alle curve di livello si ottiene invece con la regola della catena in più variabili. Se \(\gamma(t)\) è una curva che resta su una curva di livello, allora \(\mathcal{L}(\gamma(t))\) è costante, quindi \(\frac{d}{dt}\mathcal{L}(\gamma(t)) = \nabla\mathcal{L}^\top \gamma'(t) = 0\): il gradiente è ortogonale a ogni direzione tangente all’insieme di livello.
Un’avvertenza: quel primato è relativo alla norma euclidea. «Il passo di lunghezza fissata che fa scendere di più» dipende da come si misura la lunghezza di un passo, e cambiando metrica cambia la direzione più ripida. Il metodo di Newton, che misura i passi con la curvatura, e Adam, che riscala ogni coordinata, si possono leggere come discese nella direzione più ripida secondo un altro metro: un’altra metrica, e con essa un’altra discesa. Il gradiente è la direzione migliore secondo il metro euclideo, e secondo quello soltanto.
Il gradiente porta l’informazione del primo ordine; la curvatura sta nella matrice hessiana \(\mathbf{H}(\theta)\in\mathbb{R}^{n\times n}\), con \(H_{ij}=\partial^2\mathcal{L}/\partial\theta_i\partial\theta_j\), simmetrica se \(\mathcal{L}\) ha derivate seconde continue (teorema di Schwarz). Insieme danno lo sviluppo di Taylor del secondo ordine,
e da qui la condizione del secondo ordine: in un punto stazionario, \(\mathbf{H}\) definita positiva (autovalori tutti \(>0\)) dà un minimo locale stretto, definita negativa un massimo, con autovalori di segni opposti una sella, anche se ce ne sono di nulli; il test tace solo quando i non nulli hanno tutti lo stesso segno e almeno uno è zero. Gli autovalori di \(\mathbf{H}\) sono le curvature lungo i suoi autovettori, e dove \(\mathbf{H}\) è definita positiva il loro rapporto \(\kappa=\lambda_{\max}/\lambda_{\min}\), il numero di condizionamento, misura quanto sono schiacciati gli anelli di Fig. 3.9: è lui a produrre lo zigzag della valle stretta [GBC16].
La regola della catena: il motore della backpropagation#
Una rete neurale è una funzione dentro una funzione dentro una funzione: strati impilati, ognuno che riceve l’uscita del precedente. Per sapere come un peso del primo strato influenza il costo finale servono le derivate delle funzioni composte.

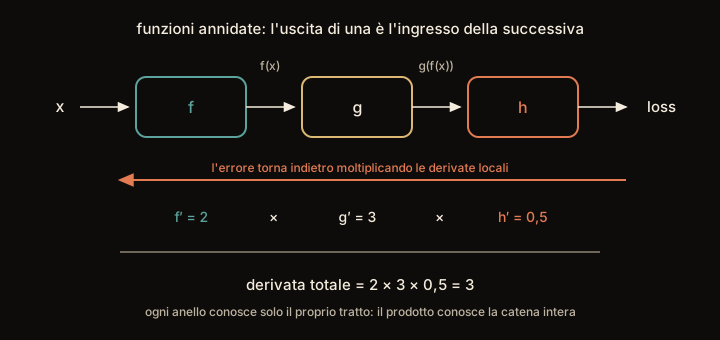
Fig. 3.10 La regola della catena in un numero. Le tre funzioni si chiamano \(f\), \(g\) e \(h\), e l’apostrofo accanto al nome (si legge «f primo») è il modo consueto di indicare la derivata di quella funzione: \(f' = 2\) vuol dire che quel tratto di catena amplifica per due. Nessun anello sa dove porti la catena: conosce solo quanto amplifica ciò che gli arriva, e il prodotto di quegli effetti locali dà l’effetto complessivo.#
L’ultima riga di Fig. 3.10 riassume tutto in una frase. Il calcolo si può fare localmente, anello per anello, senza che nessuno abbia in testa la funzione intera, ed è questo che rende derivabile una rete da milioni di parametri con lo stesso sforzo per ogni peso. La procedura che lo fa ha un nome che si incontra ovunque: si chiama backpropagation, cioè «propagazione all’indietro».
Tre ingranaggi in fila: A muove B, B muove C. Se B gira due volte più in fretta di A, e C una volta e mezza più in fretta di B, allora C gira rispetto ad A di \(2 \times 1{,}5 = 3\) volte. Gli effetti lungo la catena si moltiplicano.
E un ingranaggio è una derivata travestita, perché «quanti giri fa B per ogni giro di A» è esattamente la domanda della derivata: se muovo un po’ l’ingresso, di quanto si muove l’uscita? Sostituendo agli ingranaggi gli strati di una rete, la conclusione è la stessa: le pendenze si moltiplicano una dopo l’altra. La backpropagation è questo e nient’altro: moltiplicare le pendenze strato per strato, partendo dall’uscita e risalendo verso l’ingresso.
Per una funzione composta \(\mathcal{L} = f\big(g(w)\big)\) la regola della catena dà
il prodotto tra la pendenza della funzione esterna \(f\) (valutata in \(g(w)\)) e quella della funzione interna \(g\). In una rete profonda la catena si allunga di un anello per strato, e le derivate si moltiplicano una dopo l’altra. La backpropagation applica questa regola in ordine inverso (dall’uscita agli ingressi) riutilizzando i fattori condivisi tra i cammini. È ciò che permette di calcolare il gradiente rispetto a milioni di parametri in un’unica passata all’indietro, invece di derivare ogni peso da capo; il prezzo è la memoria, perché i valori intermedi del passaggio in avanti vanno conservati fino al ritorno (o ricalcolati). L’idea è la modalità inversa della differenziazione automatica [Lin70], applicata alle reti da Werbos [Wer74] e resa nota da Rumelhart, Hinton e Williams [RHW86].
In più variabili, per \(\mathbf{g}:\mathbb{R}^n\to\mathbb{R}^k\) e \(\mathbf{f}:\mathbb{R}^k\to\mathbb{R}^m\), la regola si scrive con le jacobiane: \(\mathbf{J}_{\mathbf{f}\circ\mathbf{g}}(\mathbf{w}) = \mathbf{J}_{\mathbf{f}}(\mathbf{g}(\mathbf{w}))\,\mathbf{J}_{\mathbf{g}}(\mathbf{w})\), il prodotto di una matrice \(m\times k\) per una \(k\times n\). Quando in fondo alla catena c’è uno scalare, con \(\mathbf{u}=\mathbf{g}(\mathbf{w})\) si ha \(\nabla_{\mathbf{w}}\mathcal{L}=\mathbf{J}_{\mathbf{g}}^\top\nabla_{\mathbf{u}}\mathcal{L}\): la backpropagation moltiplica un vettore per una jacobiana trasposta alla volta, partendo dall’uscita, e non forma mai le jacobiane intere. Per questo il gradiente costa un piccolo multiplo del passaggio in avanti, qualunque sia il numero di parametri, mentre derivare peso per peso costerebbe un passaggio in avanti per ogni peso.
La discesa del gradiente#
La discesa del gradiente ripete un passo: dal punto \(\theta\) in cui si è, si va nel verso opposto al gradiente, \(\theta\leftarrow\theta-\eta\,\nabla\mathcal{L}(\theta)\), dove \(\eta>0\), il learning rate, fissa la lunghezza del passo. È la ricetta dell’escursionista nella nebbia: un passo in discesa, si ricalcola la pendenza, si ripete (Fig. 3.11).

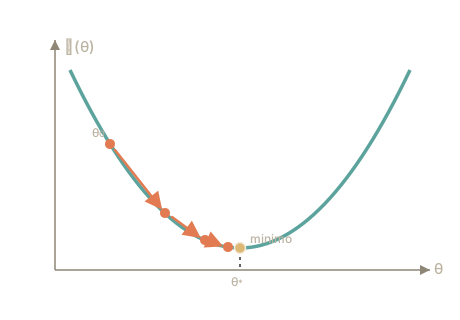
Fig. 3.11 La funzione di costo \(\mathcal{L}(\theta)\) come una scodella. Sull’asse orizzontale c’è il parametro da regolare, che per tradizione si scrive con la lettera greca \(\theta\) (si legge «theta»: è la stessa lettera che nel prodotto scalare indicava un angolo, e qui indica tutt’altro, cioè un parametro da regolare); il numerino in basso conta i passi, quindi \(\theta_0\) è la regolazione di partenza, quella scelta a caso prima che l’addestramento cominci, mentre \(\theta^*\), con l’asterisco, è quella in fondo alla scodella, la migliore che ci sia. Da lì ogni passo va nel verso opposto al gradiente, e i passi si accorciano avvicinandosi al minimo, dove la pendenza (e quindi il passo) tende a zero.#
La scodella è il caso gentile. Appena la valle si allunga in una direzione, la ricetta «vai dove è più ripido» smette di puntare verso il fondo.

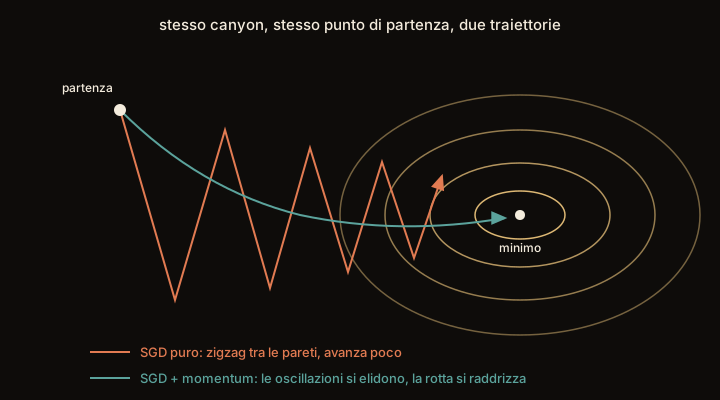
Fig. 3.12 Due modi di scendere nella stessa valle stretta. Il percorso etichettato «SGD puro» è la ricetta di base, un passo alla volta nella direzione più ripida del momento, e rimbalza da una parete all’altra. Quello etichettato «SGD + momentum» tiene conto anche dei passi precedenti e scorre diritto verso il fondo.#
Il meccanismo di Fig. 3.12 si chiama momento (momentum), e sotto il nome fisico c’è una ricetta più semplice dell’immagine della pallina che rotola: invece di muoversi lungo la pendenza sentita adesso, ci si muove lungo una somma pesata delle ultime pendenze sentite, in cui ogni pendenza conta \(\beta\) volte quella appena più recente (tipicamente \(\beta=0{,}9\)). Il perché funzioni si vede senza formule. In una valle stretta la pendenza ha due parti: quella che attraversa la valle, che a ogni passo cambia verso perché rimbalza prima contro una parete e poi contro l’altra, e quella che scende lungo la valle, che punta sempre dalla stessa parte. Nella somma la prima parte si cancella da sé (una volta è più uno, la volta dopo è meno uno) e la seconda si accumula: lungo la valle, dove la pendenza è sempre la stessa, il passo diventa \(1/(1-\beta)\) volte più lungo, dieci volte con \(\beta=0{,}9\). Restano meno rimbalzi e più avanzamento, che è appunto quel che mostra il disegno.
La sigla del disegno, SGD, sta per stochastic gradient descent, discesa stocastica del gradiente: è la discesa raccontata qui, con l’accorgimento che a ogni passo la pendenza non si misura su tutti i dati ma su un piccolo gruppo di esempi estratti a caso, il mini-batch. Ogni passo costa molto meno, e in cambio la direzione è una stima rumorosa della pendenza vera. È la variante che si usa in pratica, e su di essa il momento è quasi sempre attivo.
Cammini verso il basso e a ogni passo scegli la direzione di discesa. Quanto lungo sia il passo lo decidono due cose insieme: quanto è ripido lì dove sei (più ripido, passo più lungo) e una manopola che moltiplica tutto, il learning rate (tasso di apprendimento). La manopola è la sola che scegli tu, ed è un compromesso delicato: un passo troppo lungo scavalca il fondo e ti fa rimbalzare da una parete all’altra senza mai fermarti; un passo troppo corto arriva, ma dopo un’eternità. La scelta del learning rate è una delle più delicate per chi addestra modelli.
L’aggiornamento è una sola riga, ripetuta:
Qui \(\theta\) sono i parametri, \(\nabla\mathcal{L}(\theta)\) il gradiente della loss e \(\eta > 0\) il learning rate, che dosa l’ampiezza del passo. Nella pratica il gradiente non si calcola su tutti gli \(m\) esempi a ogni passo, ma su un lotto \(\mathcal{B}\) di \(b\) esempi estratti a caso (mini-batch): se \(\mathcal{L}=\frac1m\sum_{i=1}^m\ell_i\), con \(\ell_i\) la perdita del solo esempio \(i\), allora \(\mathbf{g}=\frac{1}{b}\sum_{i\in\mathcal{B}}\nabla\ell_i(\theta)\) è uno stimatore non distorto di \(\nabla\mathcal{L}(\theta)\), con varianza che cala come \(1/b\) (esattamente se si estrae con reimmissione). È la discesa stocastica del gradiente (SGD): un passo costa \(b/m\) di un passo pieno, e in cambio, con \(\eta\) fisso, il rumore impedisce di posarsi esattamente sul minimo, per cui la teoria classica chiede passi decrescenti con \(\sum_t\eta_t=\infty\) e \(\sum_t\eta_t^2<\infty\) (Robbins e Monro, 1951). Il momento della valle stretta si scrive \(\mathbf{v}\leftarrow\beta\mathbf{v}+\mathbf{g}\), \(\theta\leftarrow\theta-\eta\,\mathbf{v}\), con \(\beta\in[0,1)\), tipicamente \(0{,}9\): \(\mathbf{v}\) somma i gradienti passati con pesi \(\beta^k\) che decadono in progressione geometrica, e sulle componenti che cambiano segno a ogni passo i contributi si elidono. Adam aggiunge a tutto questo una scala per coordinata.
Minimi locali e globali: perché al deep learning basta così#
Con un passo abbastanza corto la discesa del gradiente scende a ogni iterazione. Ma «in fondo a cosa», esattamente?

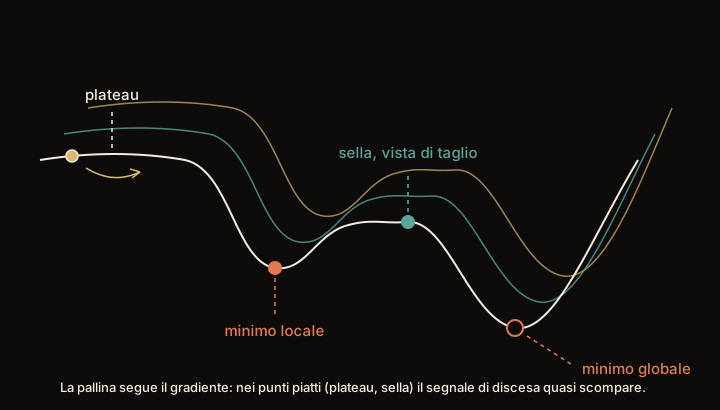
Fig. 3.13 I quattro luoghi dove una pallina che segue il gradiente può fermarsi o rallentare, con i nomi che si trovano nel disegno. Un plateau è un altopiano, un tratto in cui il terreno è quasi orizzontale su una distanza lunga. Un minimo locale è una conca vera, ma non la più profonda del paesaggio. Un punto di sella è il valico di un passo di montagna: lungo la cresta è il punto più basso, lungo la strada che attraversa il passo è il più alto, quindi non è né una cima né un fondo. Servono almeno due direzioni perché esista, e su un profilo a una dimensione sola come quello del disegno se ne vede solo la metà, il tratto che si appiattisce e poi riprende a scendere. L’ultimo è il minimo globale, il fondo più basso di tutti, ed è l’unico che vorremmo: nulla, nel gradiente, dice alla pallina in quale dei quattro si trova.#
Il guaio, guardando Fig. 3.13, non sono tanto i minimi locali quanto le zone piatte. In un minimo locale il gradiente è nullo e l’ottimizzazione si ferma, il che almeno si nota; su un plateau o vicino a una sella il gradiente è quasi nullo, l’addestramento procede lentissimo e non c’è modo di distinguerlo, dall’esterno, da un problema difficile.
Dipende dal paesaggio. Se è una scodella liscia, con un’unica valle, non ci sono conche secondarie in cui restare intrappolati: da qualunque punto si parta si scende verso quell’unico fondo, purché il passo non sia troppo lungo. È il caso convesso, il più comodo, anche se non sempre il più veloce: in una valle stretta e lunga il passo va tenuto corto per non sbattere contro le pareti ripide, e con quel passo corto il fondo lungo e quasi piatto si percorre a fatica.
Qui aiuta il momento, cioè la somma pesata delle pendenze vista come una pallina che rotola: a ogni passo conserva una parte della velocità che aveva (nove decimi, di solito), e quello che perde fa da attrito. Di traverso oscilla, ma con l’attrito ogni oscillazione si accorcia della stessa frazione della precedente, mentre lungo la valle la velocità si accumula; e con l’attrito regolato bene quella frazione è la stessa in ogni direzione, dalla più dolce alla più ripida.
Anche in una scodella, però, due guasti restano possibili. Se lontano dal centro le pareti si impennano sempre di più, partire troppo in alto rovina tutto: il passo si allunga dove è più ripido, quindi il primo balzo scavalca l’intera conca e atterra sul fianco opposto, ancora più su. Da lì il balzo dopo è più lungo ancora, e ogni rimbalzo allontana dal fondo. Quanto sia «troppo lungo» un passo, insomma, dipende anche da dove si parte. E la discesa deve avere un fondo: una rampa che scende per sempre, spianandosi senza mai finire, si percorre in eterno senza arrivare da nessuna parte.
Se invece il paesaggio è una catena montuosa piena di conche, si può finire intrappolati in una conca che non è la più profonda: un minimo locale, un buon posto ma non il migliore. Nei paesaggi delle reti grandi, però, abbondano conche profonde quasi quanto la più profonda, e fermarsi in una di loro dà ottimi risultati.
Una funzione è convessa se il segmento che unisce due punti qualsiasi del suo grafico non sta mai sotto la curva (la formulazione con il «non sotto» invece che con il «sopra» serve a non escludere le rette, che sono convesse e per cui il segmento sta sulla curva). Per una funzione convessa ogni minimo locale è anche globale: nessuna conca secondaria in cui restare intrappolati.
La convergenza della discesa del gradiente, però, richiede due ipotesi in più, e senza di esse l’affermazione è falsa. La prima è che il gradiente sia lipschitziano di costante \(L\), \(\lVert\nabla\mathcal{L}(\theta)-\nabla\mathcal{L}(\theta')\rVert\le L\,\lVert\theta-\theta'\rVert\) (per una funzione con derivate seconde continue, autovalori dell’hessiana limitati da \(L\) in modulo). Ne segue il lemma di discesa, \(\mathcal{L}(\theta-\eta\nabla\mathcal{L})\le\mathcal{L}(\theta) -\eta\,(1-L\eta/2)\,\lVert\nabla\mathcal{L}\rVert^2\): ogni passo fisso \(\eta<2/L\) abbassa il costo a ogni iterazione. La seconda è che il minimo esista. Nessuna delle due è gratis: \(f(x)=x^4\) è convessa e liscia (derivabile quante volte si vuole, senza spigoli), eppure \(f''(x)=12x^2\) è illimitata, nessun \(L\) le fa da tetto, e per ogni \(\eta\) fissato la discesa diverge se si parte abbastanza lontano (la soglia è \(|x_0| > 1/\sqrt{2\eta}\): con \(\eta=10^{-9}\) basta partire da \(x_0 = 23\,000\)); e \(f(x)=e^x\) è convessa con gradiente sempre positivo e nessun minimo, quindi la discesa scende per sempre senza convergere a niente. Anche restando dentro le ipotesi, un passo troppo lungo diverge in una scodella perfetta: su \(\mathcal{L}(\theta)=(\theta-3)^2\) basta \(\eta > 1\) perché ogni passo allontani dal minimo, oscillando da un fianco all’altro: lì \(L=2\), e la soglia \(2/L=1\) separa le due righe del codice che convergono da quella che scappa.
La velocità la decide il rapporto fra la curvatura massima e la minima. Se \(\mathcal{L}\) è anche \(\mu\)-fortemente convessa, con \(\eta=2/(L+\mu)\) la distanza dal minimo si contrae a ogni passo del fattore \((\kappa-1)/(\kappa+1)\), con \(\kappa=L/\mu\): per \(\kappa=100\) vale \(99/101\), e servono circa \(350\) passi per ridurre la distanza di un fattore mille. Sulle quadratiche il momento fa meglio, e il conto è una ricorrenza lineare del secondo ordine. Per \(\mathcal{L}(\theta) = \tfrac12(\theta-\theta^*)^\top \mathbf{H}\,(\theta-\theta^*)\), con gli autovalori di \(\mathbf{H}\) in \([\mu, L]\), l’aggiornamento \(\mathbf{v}\leftarrow\beta\mathbf{v}+\mathbf{g}\), \(\theta\leftarrow\theta-\eta\,\mathbf{v}\) si separa lungo gli autovettori di \(\mathbf{H}\): chiamata \(u_t\) la componente dell’errore \(\theta - \theta^*\) al passo \(t\) lungo un autovettore di autovalore \(\lambda\),
con polinomio caratteristico \(r^2 - (1+\beta-\eta\lambda)\,r + \beta\) (la radice qui si chiama \(r\), perché \(\lambda\) è già l’autovalore dell’hessiana). Il prodotto delle due radici è \(\beta\), quindi quando sono complesse coniugate hanno entrambe modulo \(\sqrt\beta\), qualunque sia \(\lambda\). Con la scelta che rende minimo il fattore nel caso peggiore su \([\mu, L]\), \(\eta = 4/(\sqrt L+\sqrt\mu)^2\) e \(\sqrt\beta = (\sqrt\kappa-1)/(\sqrt\kappa+1)\), il discriminante si annulla in \(\lambda = \mu\) e in \(\lambda = L\) ed è negativo in mezzo, e ogni componente si contrae del fattore \((\sqrt{\kappa}-1)/(\sqrt{\kappa}+1)\) a ogni passo [Pol64], che per lo stesso \(\kappa\) vale \(9/11\): è la ragione quantitativa per cui la traiettoria con il momento, nella valle stretta, arriva prima. Nei due estremi la radice è doppia, e il termine \(t\,r^t\) della radice doppia aggiunge un fattore lineare in \(t\) che il solo modulo non vede.
Le loss del deep learning, poi, sono quasi sempre non convesse: nessuna garanzia. La buona notizia empirica è che per reti molto grandi i minimi locali «buoni» sono tantissimi e quasi equivalenti al globale; gli ostacoli veri sono più i punti di sella che le conche profonde [DPG+14]. Ci si accontenta (con ottimi risultati) di un minimo abbastanza buono.
In pratica, con NumPy#
Un esempio giocattolo rende tutto concreto: minimizziamo \(\mathcal{L}(\theta) = (\theta - 3)^2\), la cui derivata è \(2(\theta - 3)\) e il cui minimo è ovviamente in \(\theta = 3\).
import numpy as np

# Costo da minimizzare: L(theta) = (theta - 3)^2, minimo in theta = 3
def grad(theta):
    return 2 * (theta - 3)          # derivata della loss

# eta è il learning rate; theta parte sul fianco della scodella
def scendi(eta, theta=-4.0, passi=20):
    for _ in range(passi):
        theta = theta - eta * grad(theta)   # un passo di discesa del gradiente
    return theta

print(round(scendi(0.1), 3))        # -> 2.919, ormai vicino al minimo 3
print(round(scendi(0.01), 3))       # -> -1.673, il passo corto non ci arriva
print(round(scendi(1.1), 3))        # -> -265.363, il passo lungo scappa via
Il valore di eta decide tutto, e le tre righe lo mostrano. Con 0.1
l’avvicinamento al minimo, che in gergo si chiama convergenza, in venti passi
porta \(\theta\) a \(2{,}919\); con 0.01 rallenta, e dopo gli stessi venti passi
\(\theta\) è a \(-1{,}673\), ancora lontano. Con 1.1 invece \(\theta\) diverge, cioè
scappa via anziché avvicinarsi, saltando a ogni passo da una parte all’altra del
minimo e sempre più lontano: dopo venti passi vale \(-265{,}363\). Vicino a un
minimo la loss di una rete è approssimata da una quadratica, e la soglia che qui
separa le due righe che convergono da quella che scappa, \(\eta<2/L\) con \(L=2\),
vale anche per una rete con miliardi di pesi, dove \(L\) è il massimo autovalore
dell’hessiana.
La valle stretta si misura allo stesso modo. Il blocco costruisce una scodella cento volte più ripida di traverso che per il lungo, conta quanti passi servono alla discesa semplice e a quella con il momento, ciascuna regolata al meglio, per avvicinarsi mille volte al fondo, e controlla, su mille pendenze fra la più dolce e la più ripida, di quanto si accorciano le oscillazioni a ogni passo.
import numpy as np
# una valle stretta: curvatura 1 lungo la valle e 100 di traverso
mu, L = 1.0, 100.0
kappa = L / mu
H = np.diag([mu, L])                    # l'hessiana; il minimo è nell'origine

eta_gd = 2 / (L + mu)                   # il passo migliore della discesa semplice
eta = 4 / (np.sqrt(L) + np.sqrt(mu)) ** 2
beta = ((np.sqrt(kappa) - 1) / (np.sqrt(kappa) + 1)) ** 2


def passi(eta, beta, partenza=(1.0, 1.0), soglia=1e-3, massimo=10_000):
    """Quanti passi perché la distanza dal minimo scenda sotto soglia."""
    theta, v = np.array(partenza), np.zeros(2)
    d0 = np.linalg.norm(theta)
    for t in range(1, massimo + 1):
        v = beta * v + H @ theta        # il gradiente di theta^T H theta / 2
        theta = theta - eta * v
        if np.linalg.norm(theta) < soglia * d0:
            return t
    return None


print(f"discesa semplice: fattore {(kappa - 1) / (kappa + 1):.4f}, "
      f"passi per dividere la distanza per mille: {passi(eta_gd, 0.0)}")
moduli = [np.abs(np.roots([1, -(1 + beta - eta * lam), beta])).max()
          for lam in np.linspace(mu, L, 1001)]
print(f"momento: accorciamento per passo fra {min(moduli):.4f} e "
      f"{max(moduli):.4f}, radice di beta {np.sqrt(beta):.4f}, "
      f"passi: {passi(eta, beta)}")
solo_fattore = int(np.ceil(np.log(1000) / -np.log(np.sqrt(beta))))
print(f"passi che chiederebbe il solo fattore: {solo_fattore}")
discesa semplice: fattore 0.9802, passi per dividere la distanza per mille: 346
momento: accorciamento per passo fra 0.8182 e 0.8182, radice di beta 0.8182, passi: 56
passi che chiederebbe il solo fattore: 35
La discesa semplice perde un cinquantesimo della distanza a ogni passo e ne impiega \(346\). Con il momento ogni pendenza, dalla più dolce alla più ripida, si accorcia dello stesso fattore a ogni passo, \(9/11 \approx 0{,}8182\), e i passi scendono a \(56\): più dei \(35\) che quel fattore da solo prometterebbe, perché nelle due direzioni estreme l’accorciamento parte in ritardo, ma più di sei volte meno della discesa semplice.
Da ricordare
La derivata misura la pendenza: di quanto cambia l’uscita se muovo di poco l’ingresso, come il tachimetro dice quanto in fretta cambia la posizione. Dove il terreno è piatto (in cima a una gobba, in fondo a una conca) vale zero.
Il gradiente mette in fila la pendenza rispetto a ogni parametro preso da solo, una manopola alla volta: indica la direzione in cui il costo cresce più in fretta, e per scendere si va nel verso opposto.
La discesa del gradiente è l’escursionista nella nebbia: un passo verso il basso, si risente la pendenza, si ripete. Il passo è tanto più lungo quanto più è ripido, moltiplicato per una manopola che si chiama learning rate: quella è la scelta delicata, perché con la manopola troppo alta si rimbalza da una parete all’altra e con quella troppo bassa si arriva dopo un’eternità.
Il logaritmo conta i fattori invece dei soldi: trasforma i prodotti in somme e schiaccia i numeri enormi. L’esponenziale cresce in ogni punto quanto vale, e derivandolo resta com’è. Stanno dentro la sigmoide, la softmax e la cross-entropy.
La regola della catena moltiplica fra loro le pendenze anello per anello, come ingranaggi che si trascinano: è così che la correzione risale dall’uscita fino ai primi strati (la backpropagation).
In pratica la pendenza si misura su un piccolo gruppo di esempi presi a caso (la discesa stocastica, SGD), e il momento somma le ultime pendenze con pesi che calano: i rimbalzi di traverso si cancellano, l’avanzamento lungo la valle si accumula.
Il paesaggio di una rete profonda non è una scodella liscia ma una catena montuosa: nessuno garantisce che si arrivi al fondo più basso, e in pratica una conca abbastanza profonda basta quasi sempre.
Da ricordare
La derivata misura la pendenza: di quanto cambia l’uscita se muovo di poco l’ingresso. È zero nei punti stazionari.
Il gradiente \(\nabla\mathcal{L}\) è il vettore delle derivate parziali: punta verso la massima crescita del costo, e noi andiamo nel verso opposto.
La discesa del gradiente aggiorna i parametri con \(\theta \leftarrow \theta - \eta\,\nabla\mathcal{L}(\theta)\); il learning rate \(\eta\) dosa il passo: con un gradiente lipschitziano di costante \(L\) e un minimo che esiste, ogni \(\eta<2/L\) fa scendere il costo a ogni passo, e oltre quella soglia una quadratica di curvatura \(L\) diverge. Su un mini-batch di \(b\) esempi il gradiente è uno stimatore non distorto di quello vero, con varianza che cala come \(1/b\).
La regola della catena propaga le derivate lungo gli strati: è il cuore della backpropagation.
In deep learning la loss non è convessa, ma un minimo «abbastanza buono» basta quasi sempre.
Derivate, gradiente e lunghezza del passo bastano a scendere in un paesaggio che si conosce e, sotto ipotesi precise, a fermarsi in un punto stazionario. Il costo di un modello, però, si calcola su esempi che sono un campione del mondo: il gradiente di un mini-batch è già una media campionaria, una stima con il suo errore. Per dire quanto fidarsi di quella stima, e del modello che ne esce, serve il linguaggio della probabilità.