


Probabilmente, approssimativamente corretto#
La definizione di Valiant, nella forma in cui oggi si scrive, ha due manopole e un prezzo. La prima manopola è la tolleranza \(\varepsilon\), quanto errore si accetta nel modello finale. La seconda è la confidenza \(1-\delta\): fra tutti i campioni di esempi che il caso può fornire si accetta che una frazione \(\delta\), i più sfortunati, porti fuori dalla tolleranza, e sugli altri si pretende di starci dentro. Il prezzo è il numero di esempi \(m\), e la domanda è come cresce quando si stringono le manopole e quando si allarga lo spazio delle ipotesi \(\mathcal{H}\) fra cui si sceglie. Si parte dal caso più semplice: una famiglia finita che contiene di sicuro la regola giusta.
Famiglie finite: contare le ipotesi#
Un investigatore ha una lista di mille sospettati, e sa per certo che il colpevole è fra loro. I sospettati sono le regole candidate, il colpevole la regola giusta, gli indizi gli esempi. Gli indizi arrivano uno alla volta, a caso, e ognuno scagiona chi lo contraddice: un’impronta di scarpa numero quarantadue esclude chi porta il trentotto. Dopo un certo numero di indizi restano solo i sospettati compatibili con tutti, e l’investigatore ne indica uno qualunque.
Il colpevole in persona non gli serve: gli basta uno che si comporti quasi sempre come lui, cioè che contraddica meno del cinque per cento degli indizi che potrebbero mai arrivare. È la prima manopola, la tolleranza. Un sospettato che ne contraddice di più è da scartare, e ogni indizio ha almeno cinque probabilità su cento di scagionarlo: lo lascia in lista al più novantacinque volte su cento. Per restarci dopo due indizi devono andargli bene tutti e due, e le probabilità si moltiplicano: al più \(0{,}95 \cdot 0{,}95 \approx 0{,}90\). Dopo quattordici indizi (\(0{,}95\) moltiplicato per sé stesso quattordici volte fa circa \(0{,}49\)) la probabilità scende sotto la metà, e ogni altri quattordici si dimezza ancora.
I sospettati da scartare però possono essere tanti, fino a novecentonovantanove, e basta che ne resti in lista uno solo per rovinare tutto, perché l’investigatore potrebbe indicare proprio lui. Qui le probabilità non si moltiplicano più, si sommano. Si moltiplicavano quando lo stesso sospettato doveva superare il primo indizio e poi il secondo; adesso basta che arrivi in fondo uno qualunque, e la probabilità non supera la somma di quelle di ciascuno, come in una lotteria da mille biglietti la probabilità che almeno uno vinca non supera la somma delle probabilità dei singoli biglietti. Mille probabilità piccole fanno una probabilità grande.
L’investigatore vuole che resti al massimo una possibilità su cento che anche uno solo arrivi in fondo. Quell’uno su cento è il rischio di fallire, e si chiama \(\delta\); i novantanove su cento in cui si riesce sono la confidenza, la seconda manopola (la stessa coppia di tolleranza e rischio del banco di prova della sezione sulla concentrazione, che mancava il bersaglio una volta su venti). Allora la somma delle mille probabilità deve stare sotto uno su cento, e ciascuna sotto uno su centomila. Portare una probabilità da uno a uno su cento chiede quasi sette dimezzamenti (\(2^7=128\)); dividerla ancora per mille ne chiede altri dieci (\(2^{10}=1024\)): in tutto diciassette dimezzamenti, che a quattordici indizi l’uno fanno \(238\). Il conto fatto senza arrotondare dice \(225\), perché i dimezzamenti sono in realtà un po” meno di diciassette e ciascuno chiede un po’ meno di quattordici indizi.
Raddoppiare i sospettati costa soltanto altri quattordici indizi, perché basta dimezzare ancora una volta la probabilità di ciascuno. Con un milione di sospettati invece di mille ne servono \(360\), non duecentoventicinquemila. Pretendere di più costa di più. Se il sospettato indicato deve contraddire meno dell’uno per cento degli indizi invece del cinque, ogni indizio scagiona un sospettato da scartare cinque volte più di rado, e gli indizi diventano cinque volte tanti. E il conto è prudente: tratta i mille sospettati come se ciascuno potesse restare in lista per conto suo, mentre due sospettati quasi identici, come due gemelli, vengono scagionati quasi sempre dagli stessi indizi.
Tutto questo regge a certe condizioni. Il colpevole deve essere nella lista: se non c’è, nessun sospettato è compatibile con tutti gli indizi, bisogna scegliere quello che ne contraddice di meno, e distinguere chi sbaglia il cinque per cento da chi sbaglia il sei chiede centinaia di migliaia di indizi invece di centinaia, come un sondaggio a cui si chieda un punto percentuale di precisione ha bisogno di molti più intervistati di uno a cui ne bastino cinque. La ragione è la legge dei grandi numeri: una percentuale stimata contando si stringe soltanto come la radice del numero dei conti, e per dimezzarne l’incertezza non basta il doppio degli indizi, ne servono quattro volte tanti. Gli indizi devono arrivare tutti dalla stessa scena del crimine. I sospettati devono essere un numero finito, perché con infiniti sospettati la somma non si chiude, e per contarli serve il modo della sezione sulla dimensione VC. E controllare mille sospettati uno per uno si fa, ma una lista di un miliardo di miliardi non si scorre nemmeno quando gli indizi basterebbero.
Definizione (Valiant [Val84], nella forma di Mohri e colleghi [MRT18]). Una classe di concetti \(\mathcal{C}\) è PAC-apprendibile se esistono un algoritmo \(\mathcal{A}\) e un polinomio \(\mathrm{poly}(\cdot,\cdot,\cdot,\cdot)\) tali che, per ogni \(\varepsilon>0\) e \(\delta>0\), per ogni distribuzione \(\mathcal{D}\) su \(\mathcal{X}\) e ogni concetto bersaglio \(c\in\mathcal{C}\), l’ipotesi \(h_S\) restituita da \(\mathcal{A}\) su un campione di taglia \(m\ge\mathrm{poly}\big(1/\varepsilon,1/\delta,n,\mathrm{size}(c)\big)\) soddisfa
dove \(n\) misura la taglia di un esempio e \(\mathrm{size}(c)\) quella della rappresentazione del bersaglio. Se \(\mathcal{A}\) gira in tempo polinomiale negli stessi argomenti, \(\mathcal{C}\) è efficientemente PAC-apprendibile. La taglia minima che basta è la complessità campionaria \(m(\varepsilon,\delta)\).
Nel caso consistente, o realizzabile, \(\mathcal{H}\) è finita e contiene il bersaglio, e l’algoritmo restituisce un’ipotesi con \(\hat{R}_S(h_S)=0\). Allora (Mohri e colleghi, teorema 2.5)
o, in forma di bound, \(R(h_S)\le\frac{1}{m}\big(\log|\mathcal{H}|+\log\frac{1}{\delta}\big)\) con probabilità almeno \(1-\delta\). La dimostrazione sta in due passi. Per ogni \(h\) con \(R(h)>\varepsilon\) gli esempi indipendenti danno \(\Pr[\hat{R}_S(h)=0]\le(1-\varepsilon)^m\), e la disuguaglianza dell’unione sulle al più \(|\mathcal{H}|\) ipotesi cattive dà
che si pone \(\le\delta\). La maggiorazione \(1-\varepsilon\le e^{-\varepsilon}\) costa poco: con \(|\mathcal{H}|=1000\), \(\varepsilon=0{,}05\) e \(\delta=0{,}01\) la forma con \((1-\varepsilon)^m\) chiede \(225\) esempi, quella esponenziale \(231\).
La dipendenza da \(|\mathcal{H}|\) è logaritmica, e \(\log_2|\mathcal{H}|\) è il numero di bit che servono a indicare un’ipotesi. Se ogni ipotesi si descrive con \(b\) bit, \(|\mathcal{H}|\le 2^b\) e \(R(h_S)\le\big(b\log 2+\log\frac{1}{\delta}\big)/m\), la versione quantitativa del rasoio di Occam (una regola corta e coerente con i dati generalizza). Lo stesso conto risponde a chi osserva che in macchina ogni famiglia è finita. Una rete con \(P\) pesi a \(32\) bit ha al più \(2^{32P}\) configurazioni, quindi \(b=32P\), e il bound resta sopra \(1\), cioè non dice niente, finché gli esempi non sono almeno una ventina di volte i pesi (\(32\log 2\approx 22\)). La dipendenza da \(\varepsilon\) è \(1/\varepsilon\). E l’unione è pessimista, perché somma le probabilità di eventi che per ipotesi quasi coincidenti si sovrappongono quasi del tutto: l’esperimento sulle mille soglie misura di quanto.
Senza realizzabilità (caso agnostico, o inconsistente) si controlla la deviazione di tutte le ipotesi insieme con Hoeffding e l’unione (Mohri e colleghi, teorema 2.13): con probabilità almeno \(1-\delta\),
(Il \(2\) davanti a \(\delta\) viene dalle due code di Hoeffding: il teorema controlla la deviazione in valore assoluto, e ne scrive un verso solo.)
Nel caso agnostico cambia anche la definizione, perché un errore nullo può non essere raggiungibile da nessuna ipotesi della famiglia: un algoritmo è PAC-apprendibile in senso agnostico se con probabilità almeno \(1-\delta\) restituisce un’\(h_S\) con \(R(h_S)\le\min_{h\in\mathcal{H}}R(h)+\varepsilon\) (Mohri e colleghi, definizione 2.14). Il bound di sopra basta a chi minimizza il rischio empirico. Detta \(h^*\) la migliore ipotesi di \(\mathcal{H}\) e \(\varepsilon_m\) il termine sotto radice, le due direzioni della deviazione danno
e quel fattore \(2\) è la ragione per cui, per garantire uno scarto di un punto dalla migliore, ogni stima deve stare entro mezzo punto.
Il tasso passa da \(1/m\) a \(1/\sqrt{m}\), e per garantire una deviazione \(\varepsilon\) servono \(\Theta(1/\varepsilon^2)\) esempi invece di \(\Theta(1/\varepsilon)\). La ragione è precisa: nel caso consistente basta escludere che un’ipotesi con errore \(\varepsilon\) abbia errore empirico nullo, un evento che decade come \((1-\varepsilon)^m\); nel caso agnostico si stimano frazioni non nulle, e la stima di una frazione ha un rumore dell’ordine di \(1/\sqrt{m}\).
Il quadro si rompe dove si rompono le sue ipotesi. Per \(\mathcal{H}\) infinita \(\log|\mathcal{H}|=\infty\) e il bound non dice niente. Un campione non i.i.d., o una distribuzione di prova diversa da quella di addestramento, lo invalidano per intero. E resta il versante che Valiant metteva in primo piano, il calcolo: una complessità campionaria polinomiale non basta all’apprendibilità efficiente, perché trovare un’ipotesi consistente in \(\mathcal{H}\) può essere un problema intrattabile anche quando gli esempi necessari sono pochi. La via d’uscita, quando c’è, è cercare in una famiglia più grande di quella che contiene il bersaglio. Le formule booleane in forma disgiuntiva con \(k\) termini, già per \(k=3\), non si imparano in tempo polinomiale se l’ipotesi restituita deve essere anch’essa una formula di quel tipo, a meno che \(\mathrm{RP}=\mathrm{NP}\); ma ciascuna si riscrive come una \(k\)-CNF, le \(k\)-CNF si imparano in tempo polinomiale, e restituendo una \(k\)-CNF la stessa classe diventa efficientemente apprendibile: si paga un’ipotesi più lunga e si compra il tempo (Mohri e colleghi, §2.2, esempi 2.8 e 2.9). L’apprendimento che cerca l’ipotesi nella classe del bersaglio si dice proprio, quello che la cerca in una famiglia più grande improprio.
Il conto si può mettere alla prova su una famiglia di cui si sa tutto: mille soglie su un segmento, cioè le regole \(h_t\) che rispondono \(1\) (sì) se \(x\ge t\) e \(0\) (no) altrimenti, con la soglia \(t\) che va da \(0\) a \(0{,}999\) a passi di un millesimo. Gli esempi sono numeri presi a caso fra \(0\) e \(1\), con la stessa probabilità in ogni punto, ed etichettati dalla soglia \(0{,}371\). L’errore vero di una soglia \(t\) è allora la distanza \(|t-0{,}371|\): sbaglia esattamente i punti che cadono fra le due soglie, e siccome gli esempi cadono ovunque con la stessa probabilità, ogni tratto del segmento ne raccoglie una frazione pari alla sua lunghezza. Le soglie compatibili con gli esempi sono quelle comprese fra l’esempio con etichetta \(0\) più a destra e quello con etichetta \(1\) più a sinistra, e basta guardare le due estreme per sapere se fra loro ce n’è una cattiva, cioè con errore oltre il cinque per cento.
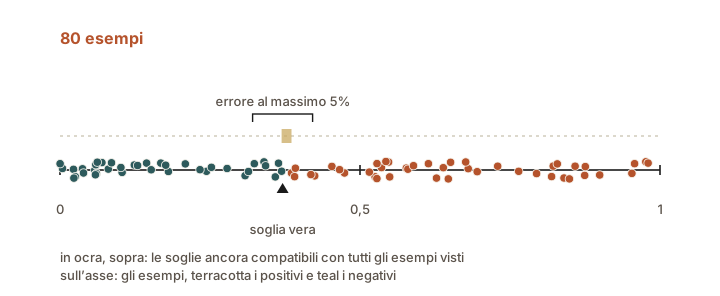
Fig. 5.1 Le soglie ancora compatibili con tutti gli esempi (la banda ocra) mentre gli esempi arrivano. A ogni gruppo la banda può solo stringersi, e si stringe quando un esempio nuovo cade al suo interno (fra dieci e venti esempi, in questa estrazione, nessuno ci cade e la banda resta ferma); le soglie che sbagliano più del cinque per cento vengono escluse una dopo l’altra. In questa estrazione con ottanta esempi non ne resta nessuna; non è garantito, e con ottanta esempi succede circa novantasette volte su cento.#
La Fig. 5.1 mostra una sola estrazione. Il blocco calcola il limite per le famiglie finite nelle sue due forme: \(225\) esempi con il conto che non arrotonda, quello con \((1-\varepsilon)^m\), e \(231\) con la versione esponenziale, \(e^{-\varepsilon m}\), un poco più larga e più comoda da scrivere. Poi ripete l’esperimento su ventimila campioni per ciascun numero di esempi e conta quante volte una soglia cattiva sopravvive. Nel caso delle soglie, poi, questa probabilità ha una formula esatta: una soglia cattiva sopravvive solo se nessun esempio cade in uno dei due tratti accanto alla soglia vera, larghi \(0{,}05\) più la distanza fra due soglie vicine, un millesimo; e quel conto esatto il blocco lo rifà anche con soglie dieci volte più fitte.
import numpy as np
from math import ceil, log

rng = np.random.default_rng(0)
N_IPOTESI = 1000                         # soglie t = 0,000; 0,001; ...; 0,999
VERA = 0.371                             # la soglia che genera le etichette
EPS, DELTA = 0.05, 0.01

# gli esempi che chiede il limite per le famiglie finite, nelle due forme
m_esatto = ceil(log(DELTA / N_IPOTESI) / log(1 - EPS))
m_bound = ceil((log(N_IPOTESI) + log(1 / DELTA)) / EPS)
print(f"conto con (1-eps)^m: {m_esatto} esempi; con e^(-eps m): {m_bound}")
print(f"con un milione di ipotesi: {ceil(log(DELTA / 1e6) / log(1 - EPS))} esempi")
print(f"con eps = 0,01: {ceil(log(DELTA / N_IPOTESI) / log(1 - 0.01))} esempi")

def quota_di_fallimenti(m, prove=20_000):
    """Su quanti campioni di m esempi sopravvive una soglia compatibile con
    tutti gli esempi ma con errore vero oltre EPS (l'errore di t è |t - VERA|)."""
    x = rng.random((prove, m))
    positivo = x >= VERA
    ultimo_neg = np.where(~positivo, x, -1.0).max(axis=1)
    primo_pos = np.where(positivo, x, 2.0).min(axis=1)
    griglia = np.arange(N_IPOTESI) / N_IPOTESI
    # le soglie compatibili sono quelle in (ultimo_neg, primo_pos]
    piu_bassa = np.searchsorted(griglia, ultimo_neg, side="right")
    piu_alta = np.searchsorted(griglia, primo_pos, side="right") - 1
    peggiore = np.maximum(VERA - griglia[piu_bassa], griglia[piu_alta] - VERA)
    return (peggiore > EPS + 1e-12).mean()

print(f"con {m_bound} esempi sopravvive una soglia cattiva nel "
      f"{quota_di_fallimenti(m_bound):.2%} dei campioni")
for m in (40, 80, 100, 120):
    print(f"  con {m:>3} esempi: {quota_di_fallimenti(m):.2%}")

# il conto esatto: nessun esempio nei due tratti larghi EPS + 1/N_IPOTESI
def p_fallimento(m, largo=EPS + 1 / N_IPOTESI):
    return 2 * (1 - largo) ** m - (1 - 2 * largo) ** m

for m in (80, 100, 102, 120):
    print(f"  esatto, {m:>3} esempi: {p_fallimento(m):.2%}")

# senza la regola giusta nella lista: la stima di ogni errore deve stare entro 0,005
dev = 0.005
print(f"caso agnostico, deviazione {dev}: "
      f"{ceil((log(N_IPOTESI) + log(2 / DELTA)) / (2 * dev**2))} esempi")

# quanto conta la griglia: con soglie più fitte i due tratti si stringono appena
for n_soglie in (1000, 10_000):
    m_min = next(m for m in range(1, 1000)
                 if p_fallimento(m, EPS + 1 / n_soglie) < 0.01)
    print(f"{n_soglie:>6} soglie: {m_min} esempi per scendere sotto l'1%")
conto con (1-eps)^m: 225 esempi; con e^(-eps m): 231
con un milione di ipotesi: 360 esempi
con eps = 0,01: 1146 esempi
con 231 esempi sopravvive una soglia cattiva nel 0.00% dei campioni
  con  40 esempi: 22.80%
  con  80 esempi: 3.08%
  con 100 esempi: 0.97%
  con 120 esempi: 0.33%
  esatto,  80 esempi: 3.02%
  esatto, 100 esempi: 1.06%
  esatto, 102 esempi: 0.96%
  esatto, 120 esempi: 0.37%
caso agnostico, deviazione 0.005: 244122 esempi
  1000 soglie: 102 esempi per scendere sotto l'1%
 10000 soglie: 104 esempi per scendere sotto l'1%
Il limite aveva ragione ma chiedeva più del necessario. Per scendere sotto l’uno per cento di fallimenti bastano poco più di cento esempi, meno della metà dei \(231\) del limite. La formula esatta ne chiede \(102\), e le ventimila prove se ne scostano solo quanto ci si aspetta da un sorteggio (danno lo \(0{,}97\%\) contro l’\(1{,}06\%\) della formula). La ragione è quella già vista: fra mille soglie, due vicine sbagliano quasi sugli stessi punti, e la somma delle probabilità (in gergo, la disuguaglianza dell’unione) le conta come se sbagliassero ciascuna per conto suo. La riga sul caso agnostico misura invece il salto del caso in cui la regola giusta non è fra le candidate (agnostico perché non presume niente su dove stia la regola giusta): per separare chi sbaglia il cinque per cento da chi sbaglia il sei le stime devono stare entro mezzo punto, e gli esempi diventano più di duecentoquarantamila.
Resta un ostacolo che nessun blocco può aggirare. Le soglie erano mille perché le si è prese su una griglia, ma una soglia vera può stare in qualunque punto del segmento, e allora le ipotesi sono infinite e il limite per le famiglie finite non si applica più. Eppure un centinaio di esempi basta comunque, e il numero quasi non dipende da quanto è fitta la griglia: con diecimila soglie invece di mille ne servono \(104\) invece di \(102\), perché le soglie vicine si comportano come una soglia sola. Per dirlo con un numero bisogna smettere di contare le regole e contare quello che le regole fanno sui dati.
Da ricordare
Imparare «probabilmente, approssimativamente» vuol dire accettare un errore piccolo e fissato, e pretendere di starci dentro quasi sempre: non sempre, perché il caso può mandare esempi sfortunati.
Con un numero finito di regole candidate, e la regola giusta fra loro, il conto dei sospettati dice quanti esempi servono. Raddoppiare le regole costa pochi esempi in più; pretendere un errore cinque volte più piccolo ne costa cinque volte tanti.
Se la regola giusta non è fra le candidate gli esempi necessari crescono molto più in fretta: stringere dieci volte la precisione richiesta ne costa cento volte tanti invece di dieci (nell’esempio, da centinaia a centinaia di migliaia); e se gli esempi futuri vengono da un’altra sorgente il conto non vale più.
Da ricordare
PAC: \(\Pr_{S\sim\mathcal{D}^m}[R(h_S)\le\varepsilon]\ge 1-\delta\) per ogni \(\mathcal{D}\) e ogni bersaglio, con \(m\) polinomiale in \(1/\varepsilon\), \(1/\delta\) e nelle taglie; l’apprendibilità efficiente chiede anche tempo polinomiale.
\(\mathcal{H}\) finita e consistente: \(m\ge\frac{1}{\varepsilon}(\log|\mathcal{H}|+\log\frac{1}{\delta})\), tasso \(1/m\); agnostica: \(R(h)\le\hat{R}_S(h)+\varepsilon_m\) per ogni \(h\), con \(\varepsilon_m=\sqrt{(\log|\mathcal{H}|+\log\frac{2}{\delta})/(2m)}\), tasso \(1/\sqrt{m}\), e per chi minimizza il rischio empirico \(R(h_S)\le\min_{\mathcal{H}}R+2\varepsilon_m\).
\(\log|\mathcal{H}|\) si legge in bit (rasoio di Occam); l’unione è pessimista con ipotesi correlate, e per \(\mathcal{H}\) infinita il bound è vuoto.
Una famiglia finita è un caso di scuola: le rette del piano, le regolazioni di una rete neurale, le soglie su un segmento vero sono infinite. Il passo che rende la teoria utile è accorgersi che una famiglia infinita, guardata attraverso un campione finito, si comporta come una famiglia finita, e misurare quanto grande.