


Dopo il pre-addestramento: istruzioni, preferenze, allineamento#
Prova a chiedere a un modello solo pre-addestrato: «Scrivi una poesia sul mare». Una risposta perfettamente plausibile è: «disse la maestra alla classe, richiudendo il registro». Sembra una presa in giro e non lo è: il modello ha trattato la tua richiesta come una battuta pronunciata da qualcuno dentro un racconto, e ha scritto quello che nel racconto viene dopo. Non è un guasto, è il compito che gli abbiamo insegnato. Un modello pre-addestrato completa il testo nel modo più probabile, e sul web una frase così compare più spesso in mezzo a una scena scolastica che in cima a una poesia. GPT-3 [BMR+20] era esattamente questo: un completatore geniale, capace di proseguire qualunque testo, ma senza la minima nozione di cosa significhi rispondere a qualcuno.
Tra GPT-3 (2020) e ChatGPT (novembre 2022) il salto che tutti hanno percepito non è (o non è solo) questione di taglia. È il post-training: una seconda fase di addestramento, molto più corta e mirata, che trasforma il completatore in un assistente. La prova più eloquente sta nell’articolo su InstructGPT [OWJ+22], il modello che ha preceduto ChatGPT: davanti a valutatori umani, le risposte di un modello da 1,3 miliardi di parametri passato per il post-training venivano preferite a quelle del GPT-3 da 175 miliardi, cioè a un modello più di cento volte più grande. Il confronto, però, si giocava sulle richieste che arrivavano davvero alla loro interfaccia pubblica, cioè lo stesso tipo di istruzioni su cui il modello piccolo era stato rifinito. Su altri banchi di prova il gigante resta avanti. La tesi dell’articolo sta nella sua prima riga: ingrandire un modello non lo rende, di per sé, più capace di seguire le intenzioni di chi lo usa.
La procedura, schematizzata in Fig. 16.19, ha due mosse principali. L’instruction tuning insegna il formato delle risposte con esempi svolti; l’apprendimento dalle preferenze affina le risposte con i giudizi delle persone, per due strade: l’RLHF, che passa da un modello addestrato a dare voti, e la DPO, che quel modello lo salta. Prima di esplorarle si apre un problema di memoria: come rifinire un modello i cui parametri non entrano in quella disponibile, ostacolo che si supera con LoRA. In coda, un terzo modo di migliorare le risposte, più recente: spendere più calcolo al momento della risposta, facendo «ragionare» il modello prima di rispondere.

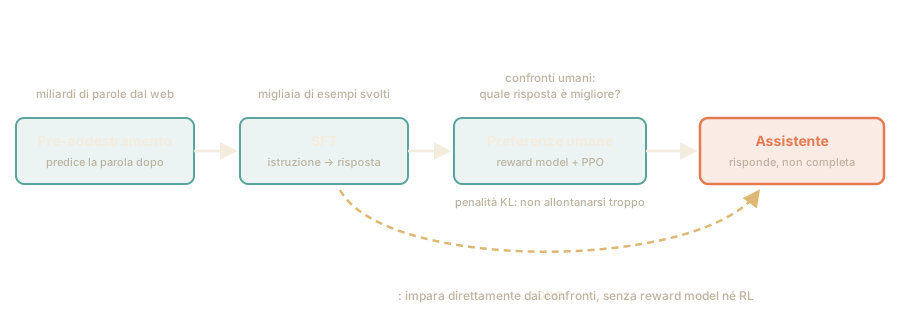
Fig. 16.19 Dal completatore all’assistente, in due mosse. Prima l’addestramento sugli esempi svolti (nel gergo SFT, supervised fine-tuning), poi l’apprendimento dai giudizi delle persone: o attraverso un modello addestrato apposta a dare i voti, il reward model, con il rinforzo di PPO (l’algoritmo del capitolo sul Deep Reinforcement Learning) tenuto vicino al punto di partenza dalla penalità KL, o saltando il reward model con la DPO.#
Studiare gli esempi svolti: l’instruction tuning#

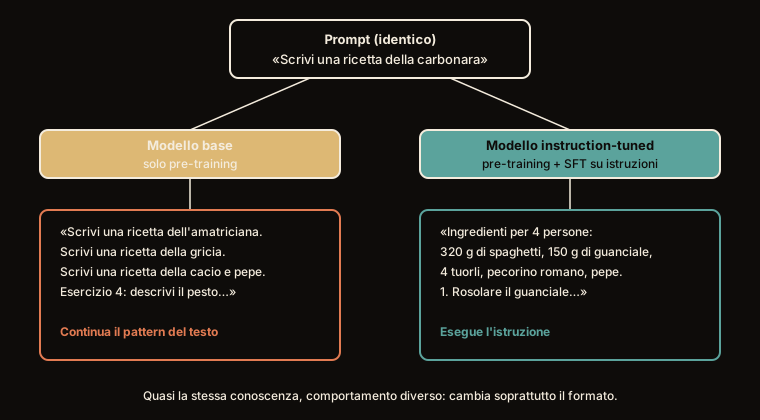
Fig. 16.20 Stesso prompt, due comportamenti. Il modello base non è più ignorante: sta facendo esattamente ciò per cui era stato addestrato, cioè proseguire il testo. L’instruction tuning gli insegna che quel testo era un ordine.#
La differenza mostrata in Fig. 16.20 è la ragione per cui il post-training esiste: un modello che completa e un assistente che esegue sanno quasi le stesse cose, e si distinguono soprattutto per come interpretano la richiesta. È l’ipotesi dell’allineamento superficiale [ZLX+23].
Il primo passo si chiama SFT (supervised fine-tuning), o instruction tuning: si raccoglie un dataset di coppie (istruzione, risposta) scritte da persone, «Riassumi questo articolo» seguito da un buon riassunto, «Traduci in inglese: il gatto nero salta sul muro» seguito da «The black cat jumps on the wall», e si continua l’addestramento del modello su questi esempi, con la stessa identica tecnica del pre-addestramento.
Un apprendista ha passato dieci anni a leggere tutta la biblioteca del suo mestiere: manuali, riviste, verbali, romanzi. Sa moltissimo, ma nessuno gli ha mai mostrato com’è fatto il lavoro vero e proprio: se gli chiedi qualcosa, ti recita il seguito più probabile della tua frase, come un’eco istruita. L’instruction tuning è il tirocinio: gli mettiamo davanti una decina di migliaia di compiti già svolti bene (la domanda di un cliente con accanto la risposta di un professionista esperto) e lui li studia uno per uno. Non impara quasi nulla di nuovo sul mondo: quello l’aveva già letto in biblioteca. Impara il formato: che quando arriva un’istruzione, la cosa da fare non è continuarla, ma eseguirla. E lo si corregge soltanto sulla parte che tocca a lui: la richiesta del cliente la legge, e nessuno gli chiede di saperla ripetere a memoria. È un tirocinio sorprendentemente breve (migliaia di esempi contro i miliardi di frasi della biblioteca, e a volte ne bastano mille scelti bene) proprio perché non aggiunge sapere: orienta quello che c’è già.
Il tirocinio però ha un limite preciso, e si vede subito: l’apprendista impara a imitare i compiti svolti, non a distinguere un lavoro eccellente da uno appena accettabile. Nessuno gli ha mai fatto vedere due risposte con scritto quale delle due è meglio. E per moltissime richieste (la poesia sul mare, appunto) non esiste la risposta giusta da fargli copiare. C’è poi un rischio: se fra i compiti svolti ci sono fatti che in biblioteca non aveva mai letto, li impara a fatica, e imparandoli prende il vizio di rispondere sicuro anche su quello che non sa.
Sia \(\mathcal{D}_{\text{SFT}} = \{(x^{(i)}, y^{(i)})\}\) un dataset di coppie istruzione–risposta. La SFT minimizza la stessa cross-entropia autoregressiva del pre-addestramento, ma applicata ai soli token della risposta:
dove \(\pi_\theta\) è il modello di linguaggio con parametri \(\theta\), \(x\) è
l’istruzione (il prompt), \(y_t\) è il \(t\)-esimo token della risposta,
\(y_{<t}\) sono i token che lo precedono e \(M\) è il numero totale di token di
risposta: la loss è la cross-entropia media per token, la stessa che calcola
F.cross_entropy sui token non mascherati (scriverla come somma cambia solo
una costante, che però si scarica sul learning rate efficace). In pratica i
token del prompt vengono mascherati nella loss: il modello li legge ma non
viene penalizzato su di essi, perché non vogliamo insegnargli a generare
domande, bensì risposte. L’ordine di grandezza dei dati è minuscolo rispetto al
pre-addestramento: per InstructGPT bastarono circa 13 000 dimostrazioni scritte
da annotatori [OWJ+22], e LIMA [ZLX+23] rifinisce
un modello da 65 miliardi di parametri con mille esempi scelti con cura, senza
reinforcement learning. Da qui l’ipotesi dell’allineamento superficiale dei
suoi autori: conoscenze e capacità si imparano quasi del tutto nel
pre-addestramento, e l’allineamento insegna quale sottodistribuzione di formati
usare. Il rovescio è che insegnare fatti nuovi con la SFT funziona male: gli
esempi che introducono conoscenza nuova si imparano più lentamente di quelli
coerenti con ciò che il modello sa, e una volta imparati aumentano linearmente
la sua tendenza ad allucinare [GYA+24]. Il limite
strutturale è quello di ogni behaviour cloning: il modello impara a imitare
le dimostrazioni, non a distinguere una risposta eccellente da una mediocre, e
per molte richieste («scrivi una poesia sul mare») non esiste la risposta
giusta da fargli copiare.
Proprio qui la SFT si ferma. Per andare oltre serve un’osservazione quasi banale: per un essere umano giudicare è più facile che scrivere. Pochi di noi saprebbero comporre una bella poesia sul mare; quasi tutti, davanti a due poesie, sanno dire quale preferiscono. Il post-training moderno è costruito su questa asimmetria.
Adattare senza riaddestrare tutto: LoRA#
Prima di passare ai giudizi, un problema pratico che la SFT e tutto quel che segue danno per risolto: rifinire un modello vuol dire aggiornarne i parametri, e il costo in memoria è alto.
Un modello «da sette miliardi» ha sette miliardi di parametri, e ciascuno, nel formato a 32 bit in cui si tiene mentre impara, occupa quattro byte: 28 GB solo per tenerlo fermo. Per farlo imparare con l’ottimizzatore Adam, però, servono altre tre copie della stessa taglia: il gradiente, che dice di quanto e in che direzione andrebbe corretto ogni parametro, e le due medie mobili di Adam, una delle correzioni recenti (il verso in cui si sta andando) e una della loro grandezza al quadrato (quanto le correzioni sono state ampie lì), che insieme dicono quali parametri muovere con decisione e quali con prudenza. Quattro copie della stessa taglia, cioè 16 byte per parametro: \(7 \times 10^9 \times 16 = 112\) GB, prima ancora delle attivazioni.
E tutto questo deve stare nella memoria delle schede grafiche, non nel disco, dove cento gigabyte non sono niente. Una scheda da centro di calcolo come la H100 ne ha 80, la H200 141; quelle di consumo, molti meno. Fuori dai centri di calcolo, per un modello che in questo campo è fra i piccoli, quasi nessuno può permetterselo.

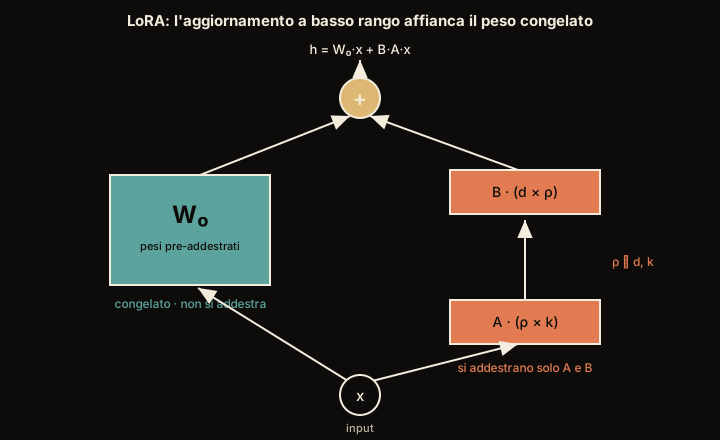
Fig. 16.21 LoRA non tocca la matrice dei pesi già appresi: le affianca due matrici strette, in parallelo. Nel disegno \(\mathbf{W}_0\) è la matrice congelata, con \(d\) righe e \(k\) colonne; \(\mathbf{A}\) (\(\rho \times k\)) e \(\mathbf{B}\) (\(d \times \rho\)) sono le due strette, e il rango \(\rho\), molto più piccolo di \(d\) e di \(k\), è lo spessore del collo di bottiglia. Solo \(\mathbf{A}\) e \(\mathbf{B}\) si addestrano.#
La forma di Fig. 16.21 spiega anche perché l’adattamento si possa staccare. Se ciò che si è imparato vive tutto nelle due matrici strette, e quella grande è rimasta identica, allora un adattamento è un file piccolo che si aggiunge o si toglie: lo stesso modello base può servire compiti diversi cambiando solo il ramo laterale.
Un architetto che deve cambiare dieci cose in una pianta già disegnata appoggia sul foglio un lucido, e le modifiche le disegna lì. La pianta di sotto resta intatta.
Dentro la rete quella pianta esiste davvero. I numeri stanno in tabelle, righe e colonne come un foglio di calcolo (in matematica si chiamano matrici), e una tabella sola può essere quattromila righe per quattromila colonne, cioè sedici milioni di caselle. Riscriverle tutte per adattare il modello a un compito nuovo è fuori portata, e da qui viene il lucido.
LoRA (Low-Rank Adaptation) [HSW+22] nasce da una cosa che si vede controluce. Le correzioni da fare sono sempre la stessa manciata, ripetuta in punti diversi e con intensità diverse: ogni riga del lucido si ottiene mescolando poche righe di partenza, in dosi diverse. Allora il lucido non ha tutte le sue righe da imparare: ha le poche righe di partenza, più qualche dose per riga.
In piccolo si vede subito. Una riga di partenza, \((4, 5, 6)\), e una colonna di dosi, \((1, 2, 3)\): moltiplicate nel modo standard (il prodotto di matrici della sezione di algebra lineare), danno una tabella tre per tre con le righe \((4, 5, 6)\), \((8, 10, 12)\) e \((12, 15, 18)\), cioè la stessa riga presa una, due e tre volte. Nove caselle calcolate a partire da sei numeri. Sul foglio vero le strisce sono due, sottili: una alta otto e larga quattromila, con le otto righe di partenza, e una alta quattromila e larga otto, con le otto dosi di ciascuna delle quattromila righe. Il loro prodotto è un foglio quattromila per quattromila, la misura esatta della pianta, e ci si appoggia sopra; ma i tratti da disegnare sono \(4000 \times 8 + 8 \times 4000 = 64\,000\) invece di sedici milioni, cioè lo \(0{,}4\%\). Le otto colonne sono la manopola, e si chiamano il rango: più è alto, più ricca può essere la correzione, e più tratti ci sono da disegnare.
Il lucido si comincia bianco, e finché non ci metti un tratto quello che si vede attraverso è la pianta di prima. L’adattamento parte esattamente dal comportamento che il modello aveva già, e da lì si sposta. Puoi tenerne molti (uno per il supporto clienti, uno per il codice, uno per il tono formale) e cambiarli in un istante sullo stesso disegno. Quando uno ti convince lo ricalchi sulla pianta una volta per tutte, così torni ad avere un foglio solo e consultarlo costa quanto prima.
Quello \(0{,}4\%\) vale per una tabella sola. Nello studio i fogli sono tanti, e sul modello intero dipende da quanti se ne coprono: con il lucido sui soli fogli che il lavoro originale preferiva si ridisegna meno di un numero su mille, con un lucido su ogni foglio, come serve per avvicinarsi a una riscrittura completa, qualcosa di più, ma sempre una piccola frazione. Quello che archivi pesa megabyte invece di gigabyte.
E le quattro copie di poco fa tornano una. Correzioni e medie servono soltanto ai numeri che si muovono, e qui a muoversi sono le due strisce: delle quattro tabelle resta in piedi la prima, cioè il modello fermo, ventotto gigabyte invece di oltre cento. È il conto che sembrava perso, rimesso in scala.
Il confine è quello del lucido, e sopra ci si disegnano le modifiche, non un edificio nuovo. Le due strisce sono strette apposta, e in quello stretto ci sta molto: un cambio di tono, di formato, di comportamento. Ci sta male una materia intera da imparare da capo, come un linguaggio di programmazione studiato su miliardi di parole: lì la riscrittura completa impara di più, e in cambio dimentica di più di quello che il modello sapeva.
Data una matrice di pesi pre-addestrata \(\mathbf{W}_0 \in \mathbb{R}^{d\times k}\), LoRA non la modifica: parametrizza l’aggiornamento come prodotto di due matrici a rango basso,
dove \(d\) e \(k\) sono le due dimensioni della matrice originale (righe e colonne) e \(\rho\) è il rango dell’aggiornamento, cioè lo spessore del collo di bottiglia. Il rango si scrive di solito \(r\) (così nella sezione sui sistemi lineari, con la stessa fattorizzazione); qui è \(\rho\) perché \(r\) è la ricompensa dell’RLHF.
Solo \(\mathbf{A}\) e \(\mathbf{B}\) ricevono gradiente. I parametri addestrabili passano da \(dk\) a \(\rho(d+k)\): per \(d=k=4096\) e \(\rho=8\) si scende da \(16{,}8\) milioni a \(65\,536\) per matrice, lo \(0{,}39\%\). All’inizio \(\mathbf{A}\) è inizializzata casualmente e \(\mathbf{B}\) a zero, così \(\Delta\mathbf{W} = 0\) e il modello parte esattamente dal comportamento pre-addestrato; \(\alpha/\rho\) è un fattore di scala che disaccoppia il learning rate efficace dalla scelta di \(\rho\). Su quali matrici inserire il ramo laterale è una scelta progettuale: il lavoro originale limita lo studio ai pesi dell’attenzione, e nella maggior parte degli esperimenti alle sole proiezioni \(\mathbf{W}^Q\) e \(\mathbf{W}^V\), ed è da lì che viene il conteggio minuscolo sul modello intero. QLoRA trova però che per eguagliare il fine-tuning completo servono adattatori su tutte le matrici lineari del blocco, FFN comprese, e che a quel punto il rango conta poco [DPHZ23].
Tre conseguenze pratiche:
Nessuna latenza aggiuntiva in inferenza. A differenza degli adapter inseriti in serie, \(\frac{\alpha}{\rho}\mathbf{B}\mathbf{A}\) si può sommare a \(\mathbf{W}_0\) una volta per tutte prima del deployment: il grafo di calcolo torna identico all’originale.
Adattatori componibili e leggeri. Si tengono in memoria molti LoRA sullo stesso modello di base e si scambiano per richiesta: è il meccanismo dietro il multi-tenant serving di modelli specializzati. I primi due punti sono però alternativi, e il paper lo dichiara: fusa la matrice, un batch non può più mescolare richieste con adattatori diversi. O si fonde e si serve un compito solo, o si tiene il ramo laterale e lo si paga.
QLoRA [DPHZ23] porta l’idea all’estremo: il modello base è quantizzato a \(4\) bit e congelato, gli adattatori restano a 16 bit, e il gradiente attraversa i pesi quantizzati, che si riportano a 16 bit al momento del calcolo. Tre accorgimenti rendono la quantizzazione quasi indolore: il tipo di dato NF4 (4-bit NormalFloat), costruito per pesi distribuiti in modo normale; la double quantization, che quantizza anche le costanti di quantizzazione (circa 0,37 bit per parametro in meno, circa 3 GB su 65 miliardi); e i paged optimizers, che nei picchi spostano gli stati dell’ottimizzatore nella memoria della CPU. I pesi di un modello da 65 miliardi passano così da 130 GB a 16 bit a circa 33 GB a 4 bit. Gli autori rifiniscono un modello di quella taglia su una sola scheda da 48 GB, mentre il fine-tuning completo a 16 bit dello stesso modello, per loro stesso conto, ne chiederebbe oltre 780: più di sedici schede di quelle, invece di una.
Il limite è di capacità, e le misure lo quantificano. Con le configurazioni a rango basso usuali LoRA rende sensibilmente meno del fine-tuning completo quando deve assorbire un dominio intero, come programmazione e matematica in un pre-addestramento continuato su miliardi di token, e lì il divario non si chiude nemmeno con ranghi alti; nell’instruction tuning ranghi più alti chiudono quasi tutto il divario. In cambio LoRA dimentica meno di quello che il modello sapeva [BPGO+24].
Il giudizio umano come segnale: RLHF#
Risolto l’ingombro, si torna all’asimmetria fra giudicare e scrivere. L’idea di farne un segnale di addestramento non nasce con i modelli di linguaggio. Nel 2017 Christiano e colleghi [CLB+17] insegnano a un robottino simulato a fare il salto mortale all’indietro. Normalmente un programma del genere si addestra a punti: si scrive una regola che assegna un premio a ogni istante («più in alto sei, più prendi»), il programma prova miliardi di volte e impara a fare i punti. Per il salto mortale quella regola nessuno sa scriverla: che cosa premi, esattamente? Allora si cambia strada, e si mostrano a una persona coppie di brevi video chiedendole solo: quale dei due somiglia di più a un salto mortale? Bastarono circa 900 confronti, meno di un’ora di tempo umano.

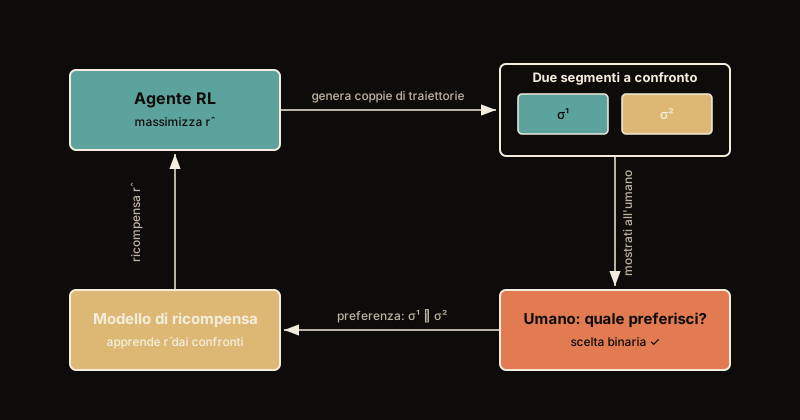
Fig. 16.22 Il giro che sostituisce la regola dei punti scritta a mano. La persona non spiega mai cosa sia un salto mortale: si limita a preferire, e il giudice artificiale in mezzo (il modello di ricompensa) deduce il resto.#
Il passaggio decisivo di Fig. 16.22 è il modello di ricompensa in mezzo. Senza di lui ogni passo di addestramento richiederebbe un giudizio umano, il che è impraticabile; con lui i confronti servono a insegnare una volta un giudice artificiale, che poi lavora quanto serve. La tecnica si chiama RLHF (Reinforcement Learning from Human Feedback), e con InstructGPT [OWJ+22] viene applicata in grande al linguaggio, in due tempi: prima i confronti umani addestrano un reward model, un modello che impara a dare voti; poi il reward model fa da giudice automatico mentre il modello di linguaggio viene ottimizzato con il reinforcement learning.
Un ristorante vuole perfezionare un piatto. Assumere un critico che descriva a parole il piatto perfetto è impossibile; far assaggiare due versioni e chiedere «quale preferisci?» è facilissimo. Si procede così: l’assaggiatore confronta centinaia di coppie di piatti, e da tutti quei confronti si distilla una specie di palato artificiale (un giudice automatico che, assaggiato un piatto qualsiasi, gli dà un voto coerente con i gusti raccolti). A quel punto il cuoco può lavorare anche di notte, senza l’assaggiatore: prova una variante, il palato artificiale la vota, e lui aggiusta la ricetta per far salire il voto.
Ridurre un piatto a un voto solo, però, è già una scommessa. Regge se i clienti hanno tutti più o meno lo stesso palato: se metà della sala ama il piccante e l’altra metà lo detesta, la media descrive un cliente che non esiste, e il cuoco finirà per cucinare per lui. E regge se le preferenze stanno in fila. Capita invece che girino in tondo (il primo piatto preferito al secondo, il secondo al terzo, e poi il terzo al primo), e un giro così in una classifica di voti non ci sta.
Poi c’è una regola d’oro appesa in cucina: mai stravolgere la ricetta di partenza. Serve a due cose. Il palato artificiale è un’imitazione e ha i suoi punti ciechi: se il cuoco insegue solo il voto, prima o poi scopre che raddoppiare la panna inganna il giudice, e finisce per servire piatti assurdi che «prendono voti alti» ma che nessun cliente vero vorrebbe. E la ricetta di partenza qualcosa di buono ce l’aveva già: rifarla da zero per rincorrere il voto vuol dire perdere per strada anche il mestiere che c’era dentro. La regola del «resta vicino alla ricetta» tiene la creatività al guinzaglio, e il guinzaglio ha una lunghezza che si sceglie: corto, e il piatto cambia appena; lungo, e il cuoco osa di più rischiando di più.
Fase 1: il reward model. Per un prompt \(x\) si generano due risposte e un annotatore indica la preferita, \(y_w\) (winner), contro la scartata, \(y_l\) (loser); scriveremo \(y_w \succ y_l\) per «la prima è preferita alla seconda». Il reward model \(r_\phi(x, y)\) (tipicamente lo stesso Transformer con una testa scalare al posto della softmax) viene addestrato assumendo il modello di Bradley–Terry [BT52], per cui la probabilità di preferenza dipende solo dalla differenza dei punteggi. Sotto quel modello stanno tre pretese, e non sono piccole: che esista un solo numero per risposta da cui discendono tutte le preferenze, e quindi che la struttura delle preferenze sia transitiva (il singolo giudizio può girare in tondo, e il modello lo assorbe come rumore; è la struttura sotto che non può) e che gli annotatori siano intercambiabili fra loro. Nessuna delle tre cose è ovvia sulle persone vere, ed è la stessa ipotesi su cui poggerà anche l’equivalenza fra DPO e RLHF.
dove \(\sigma\) è la sigmoide e \(\phi\) sono i parametri del reward model. Se ad esempio la differenza di punteggio è \(1{,}1\), il modello assegna alla preferenza osservata probabilità \(\sigma(1{,}1) \approx 0{,}75\). La loss è la log-verosimiglianza negativa dei confronti raccolti,
In InstructGPT ogni annotatore ordina \(K\) risposte allo stesso prompt, con \(K\) da 4 a 9, e i \(\binom{K}{2}\) confronti che ne escono formano un solo elemento del batch, pesati \(1/\binom{K}{2}\): rimescolati uno per uno nel dataset, confronti così correlati facevano sovra-adattare il reward model in una sola passata. La loss vede solo differenze: sommare a \(r_\phi\) una qualunque funzione del solo prompt non la cambia, e per questo il punteggio va tarato a parte prima del rinforzo. Tornerà utile nella DPO.
Fase 2: la policy. Il modello di linguaggio diventa una policy \(\pi_\theta\) nel senso del reinforcement learning (il prompt è lo stato, la risposta generata è l’azione) e si ottimizza
dove \(\pi_{\text{ref}}\) è il modello di riferimento congelato (di solito il modello SFT), \(D_{\mathrm{KL}}\) è la divergenza di Kullback–Leibler [KL51] vista nella sezione sulla teoria dell’informazione (là scritta in bit, qui in logaritmi naturali, che è la base necessaria per ricavare la forma chiusa dell’ottimizzazione) e \(\beta > 0\) regola la forza del vincolo. Si noti che entrambi i termini stanno dentro la stessa aspettazione sui prompt: la deriva si penalizza in media sulla distribuzione dei prompt \(\mathcal{D}_{\text{pr}}\), non su un prompt lasciato libero, altrimenti l’espressione non sarebbe funzione dei soli \(\theta\) e non ci sarebbe niente da massimizzare.
InstructGPT scrive l’obiettivo in forma campionata, con \(-\beta\log\frac{\pi_\theta(y\mid x)}{\pi_{\text{ref}}(y\mid x)}\) dentro l’aspettazione del termine di rinforzo, e gli aggiunge un terzo termine, \(\gamma\,\mathbb{E}_{x\sim\mathcal{D}_{\text{pretrain}}}[\log\pi_\theta(x)]\), dove \(\gamma\) è il suo peso e \(x\) è, solo qui, un testo del pre-addestramento invece di un prompt: rimescola nel gradiente un po’ di pre-addestramento per non perdere prestazioni sui compiti classici, e la variante si chiama PPO-ptx [OWJ+22].
La penalità KL ha una storia. Ziegler e colleghi la usano nel 2019 per addestrare un modello di linguaggio con le preferenze umane, sullo stile e sul riassunto, seguendo lavori precedenti di Jaques e colleghi [ZSW+19]; Stiennon e colleghi la usano per il riassunto con un reward model addestrato su confronti [SOW+20], e InstructGPT ne segue la procedura. Serve a due cose: impedisce alla policy di derivare verso le zone in cui \(r_\phi\) (addestrato su dati limitati) estrapola male (è il reward hacking), e preserva la fluidità linguistica accumulata nel pre-addestramento. Questa forma non è soltanto un espediente pratico: massimizzare una ricompensa restando vicini a una distribuzione di riferimento è formalmente la stessa cosa che fare inferenza bayesiana, con \(\pi_{\text{ref}}\) nel ruolo del priore [KPB22]. La sezione sull’inferenza attiva riprende quell’identità e ne mostra la conseguenza: il termine che qui trattiene la policy è, letto dall’altra parte, lo stesso che altrove spinge un agente a cercare informazione.
L’ottimizzazione usa PPO [SWD+17], l’algoritmo a gradiente di policy della sezione su A3C e PPO: aumentare la probabilità delle risposte con vantaggio positivo, a piccoli passi controllati per non destabilizzare la policy. Nella pratica l’ambiente è un bandit: un prompt, una risposta, un voto, e la ricompensa del reward model arriva solo all’ultimo token, mentre la penalità KL si somma a ogni token \(t\):
Un critico, la funzione valore, inizializzato dal reward model, stima il valore atteso, e il vantaggio si calcola per differenza [OWJ+22].
Passare da un gioco al linguaggio cambia i nomi, non il meccanismo: la policy aumenta la probabilità delle azioni in proporzione al vantaggio che ricevono, come nel gradiente di policy che faceva vincere partite di Go. Qui l’azione è un’intera risposta, e il segnale non viene dalle regole di un gioco ma dal reward model, addestrato a imitare i giudizi dei valutatori.
DPO: imparare dalle preferenze senza il giudice#
L’RLHF funziona, ma è un cantiere pesante. In memoria devono stare quattro modelli distinti, e non le quattro copie dello stesso modello del conto sull’ottimizzatore. Il primo è la policy che si sta addestrando. Il secondo è il riferimento \(\pi_{\text{ref}}\), una copia congelata della policy di partenza, che serve a calcolare la penalità KL: per sapere quanto ci si sta allontanando dal punto di partenza bisogna averlo sotto mano. Il terzo è il reward model. Il quarto è un critico, la funzione valore, che stima in anticipo il voto atteso: il segnale utile è lo scarto fra il voto ricevuto e quello atteso, e un sette dove ci si aspettava cinque è un successo, dove ci si aspettava nove è un passo indietro.
Quattro modelli che si addestrano o si usano insieme possono guastarsi a vicenda: se il reward model sbaglia, la policy impara a compiacerlo; se il critico stima male, i vantaggi escono fuori scala. Rafailov e colleghi descrivono la procedura come «complessa e spesso instabile» [RSM+23], nel senso preciso che due addestramenti fatti con gli stessi ingredienti possono finire uno bene e uno male. Nel 2023 gli stessi autori mostrano che si può arrivare quasi allo stesso punto con un normale addestramento supervisionato sulle coppie, senza reinforcement learning e senza reward model, allargando il distacco fra la risposta preferita e la scartata. Il sottotitolo del loro articolo è già la tesi: Your Language Model is Secretly a Reward Model, il tuo modello di linguaggio è, a sua insaputa, già un giudice.
La giustificazione sta in un conto. L’obiettivo dell’RLHF con penalità KL, il premio da una parte e la distanza dal riferimento dall’altra, ha una soluzione ottima in forma chiusa; invertendola, la ricompensa si scrive come \(\beta\log(\pi^*/\pi_{\text{ref}})\), cioè come il logaritmo di quanto la policy ottima ha alzato la probabilità di una risposta rispetto al riferimento, più un termine che dipende dalla domanda e non dalla risposta. Confrontando due risposte alla stessa domanda, quel termine si cancella, e resta soltanto il movimento rispetto al riferimento. Il metodo si chiama DPO (Direct Preference Optimization, ottimizzazione diretta delle preferenze).
Torniamo in cucina. Il metodo classico prevedeva due tempi: prima addestrare un giudice artificiale sui confronti degli assaggiatori, poi far cucinare il cuoco per il giudice. La DPO si accorge che il giro è più lungo del necessario: il cuoco può saltare il giudice e imparare direttamente dai confronti, perché il voto del giudice è già scritto nel cuoco. Quanto un piatto gli piace si legge da quanto ha cambiato idea su di lui rispetto alla ricetta di partenza: se prima lo preparava una volta su cento e adesso tre, quel piatto gli piace; se un altro, per la stessa cena, passa da due volte su cento a una, no. Quanto sia impegnativa la cena in sé, un pranzo per due o un banchetto, pesa uguale sui due piatti, e nel confronto sparisce. Per ogni coppia già valutata (piatto preferito, piatto scartato), ritocca la propria ricetta in modo da spostarla di un passo verso il piatto preferito e di un passo via da quello scartato. E il ritocco è dosato con intelligenza: se il cuoco già favorisce il piatto giusto, il confronto non insegna quasi nulla e la correzione è minima; se invece è ancora in pareggio, o peggio sta dalla parte sbagliata, la correzione è energica. Quello che il ritocco sorveglia, però, è il distacco fra i due piatti, non il gradimento di ciascuno: può finire che il cuoco creda un po’ meno in tutti e due, purché nello scartato creda molto meno. Anche la regola d’oro sopravvive, incorporata nel metodo: i ritocchi si misurano sempre rispetto alla ricetta di partenza, così il cuoco migliora senza stravolgere. Stessa destinazione dell’RLHF sulla carta, e senza il cantiere. Nei fatti le due strade non finiscono esattamente nello stesso punto, e la ragione principale è questa: qui il cuoco impara da un quaderno di confronti raccolti una volta per tutte, mentre nel metodo classico il palato artificiale è lì, in cucina, e assaggia anche i piatti che il cuoco inventa oggi. Un quaderno alle domande nuove non risponde, ed è lì che va cercata la differenza fra i risultati dei due metodi.
Il punto di partenza è un fatto notevole: l’obiettivo RLHF con penalità KL, se lo si massimizza fra tutte le policy possibili e non solo dentro la classe parametrica di \(\pi_\theta\), ha una soluzione ottima in forma chiusa,
dove \(Z(x) = \sum_y \pi_{\text{ref}}(y \mid x)\exp(r(x,y)/\beta)\) normalizza la distribuzione. Il conto è breve. Per un prompt fissato, raccogliendo i due termini sotto la stessa aspettazione,
Il secondo addendo non dipende da \(\pi\), e la KL è nulla se e solo se \(\pi = \pi^*\) (disuguaglianza di Gibbs): il massimo sta in \(\pi^*\). Invertendo la relazione, la ricompensa si può scrivere in funzione della policy ottima: \(r(x,y) = \beta \log \frac{\pi^*(y \mid x)}{\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x)\).
Da qui i due passaggi che rendono possibile il metodo. Il primo: \(Z(x)\) è una somma su tutte le risposte, quindi dipende dal prompt e non dalla risposta; siccome \(y_w\) e \(y_l\) stanno sotto lo stesso prompt, i due \(\beta\log Z(x)\) sono lo stesso numero e si elidono nella differenza che il modello di Bradley–Terry chiede. Ed è l’unico posto in cui \(Z(x)\) compare: quella somma sarebbe incalcolabile, e sparisce prima di dover essere calcolata. Il secondo passaggio è meno visibile e più importante: la relazione appena scritta dice che qualunque ricompensa è rappresentabile come \(\beta\log(\pi/\pi_{\text{ref}})\) per una qualche policy, a meno di una funzione del solo \(x\). Si può allora smettere di parametrizzare le ricompense e parametrizzare direttamente le policy, sostituire \(\pi^*\) con la \(\pi_\theta\) che stiamo addestrando, e fare massima verosimiglianza sulle preferenze osservate. Il risultato è una loss che dipende solo dalla policy:
dove \(\mathcal{D}_{\text{pref}}\) è il dataset di terne (prompt, risposta preferita, risposta scartata); \(x\) è il prompt, \(y_w\) la risposta preferita e \(y_l\) quella scartata; \(\pi_\theta\) è la policy in addestramento (l’unica di cui si aggiornano i parametri \(\theta\)); \(\pi_{\text{ref}}\) è il riferimento congelato, di norma il modello SFT; \(\beta > 0\) (valori tipici tra \(0{,}1\) e \(0{,}5\)) controlla la forza del vincolo implicito verso il riferimento, come la penalità KL dell’RLHF; \(\sigma\) è la sigmoide. La quantità \(\hat{r}_\theta(x,y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)}\) è la ricompensa implicita: la loss è una regressione logistica che chiede alla ricompensa implicita della risposta preferita di superare quella della scartata. Il gradiente lo dice in formula:
ogni coppia pesa quanto la ricompensa implicita la ordina male, e i confronti già «vinti» contribuiscono poco. La loss chiede solo che il margine cresca, non che la preferita diventi più probabile: in pratica possono scendere tutte e due, la scartata di più [PKD+24]. E se le preferenze sono deterministiche (e con un solo giudizio per coppia, nei dati lo sono sempre), il margine ottimo è infinito qualunque sia \(\beta\), e il vincolo verso il riferimento smette di trattenere; più le preferenze vi si avvicinano, meno trattiene. È il difetto da cui parte IPO [ARP+23]. Niente reward model esplicito, niente campionamento, niente PPO: un normale addestramento supervisionato su coppie. L’equivalenza con l’RLHF è esatta solo in quel limite non parametrico, e sulla distribuzione delle coppie raccolte: con una policy parametrica e coppie fissate una volta per tutte (la DPO non campiona mai da \(\pi_\theta\), il PPO sì) i due metodi in pratica divergono, ed è qui che va cercata la differenza fra i loro risultati.
La loss DPO è così compatta che si può scrivere per intero. La funzione
dpo_loss riceve quattro tensori di log-probabilità totali,
\(\log\pi(y\mid x) = \sum_t \log\pi(y_t\mid x, y_{<t})\): quelle che la policy
\(\pi_\theta\) assegna alla risposta preferita e a quella scartata, e quelle che
assegna il riferimento \(\pi_{\text{ref}}\). Il logaritmo, già incontrato nella
teoria dell’informazione, trasforma il
prodotto delle probabilità dei token in una somma: per una risposta lunga quel
prodotto può scendere sotto il più piccolo numero rappresentabile in
float32, la somma dei logaritmi no. Siccome le probabilità stanno sotto uno, i
loro logaritmi sono tutti negativi, e la regola di lettura è questa: più il
numero è vicino a zero, più il modello è convinto. \(-11{,}9\) indica una
risposta più probabile di una da \(-12{,}3\), come \(-3\) gradi è più caldo di \(-8\).
import torch
import torch.nn.functional as F

def dpo_loss(logp_w_policy, logp_l_policy,
             logp_w_ref, logp_l_ref, beta=0.1):
    """Loss DPO su un batch di coppie (preferita, scartata).

    Ogni argomento e' la log-probabilita' totale della risposta:
    somma dei log-prob dei suoi token, ottenuta con log_softmax
    sui logits del modello. Il riferimento e' congelato (no grad).
    """
    # ricompensa implicita: quanto ciascun modello "favorisce" la risposta
    margine_w = logp_w_policy - logp_w_ref   # risposta preferita
    margine_l = logp_l_policy - logp_l_ref   # risposta scartata
    # la preferita deve staccare la scartata: regressione logistica
    return -F.logsigmoid(beta * (margine_w - margine_l)).mean()

# tensori fittizi: log-prob totali di 4 coppie di risposte
logp_w_policy = torch.tensor([-12.3, -45.1,  -8.7, -30.2])
logp_l_policy = torch.tensor([-11.9, -47.8,  -9.5, -29.8])
logp_w_ref    = torch.tensor([-12.5, -46.0,  -8.9, -30.5])
logp_l_ref    = torch.tensor([-11.7, -46.5,  -9.1, -30.1])

print(dpo_loss(logp_w_policy, logp_l_policy, logp_w_ref, logp_l_ref))
# a policy uguale al riferimento i margini sono nulli, qualunque sia il batch
print(dpo_loss(logp_w_ref, logp_l_ref, logp_w_ref, logp_l_ref))
tensor(0.6548)
tensor(0.6931)
Il secondo numero ha una ragione precisa. Quando \(\pi_\theta = \pi_{\text{ref}}\) i due margini sono nulli, la sigmoide di zero vale \(\tfrac12\), e la loss vale \(-\log\tfrac12 = \log 2 \approx 0{,}693\) qualunque siano i dati: è il valore da cui parte ogni addestramento DPO, quando la policy coincide ancora con il riferimento. Le quattro coppie sono inventate, quindi non raccontano un modello che impara: mostrano come si legge la loss. Con questi tensori vale \(0{,}655\), appena sotto \(\log 2\), perché in tre coppie su quattro la preferita ha guadagnato rispetto al riferimento più della scartata; durante un addestramento vero la loss scende man mano che quei margini crescono.
Le coppie inventate nascondono un dettaglio istruttivo. Nella prima la policy, in assoluto, considera più probabile la risposta scartata (\(-11{,}9\) contro \(-12{,}3\): più vicino a zero vuol dire più convinto). Alla DPO però non importa il valore assoluto, importa il movimento rispetto al punto di partenza: rispetto al riferimento la preferita ha guadagnato terreno (\(-12{,}3\) contro \(-12{,}5\), cioè \(+0{,}2\)) e la scartata ne ha perso (\(-11{,}9\) contro \(-11{,}7\), cioè \(-0{,}2\)), quindi un divario di \(0{,}4\) a favore della preferita: la coppia va nella direzione giusta, anche se il margine è ancora piccolo. Nella quarta coppia, invece, i due movimenti si equivalgono (\(+0{,}3\) e \(+0{,}3\)): la policy è in pareggio su quel confronto, ed è la coppia su cui la correzione spinge di più.
E l’instruction tuning? Non richiede un ciclo nuovo: è il normale
ciclo di addestramento di PyTorch (forward,
loss, backward, step), con una maschera sulla loss. La cross-entropia si
calcola sui soli token della risposta, perché non vogliamo insegnare al modello
a inventare domande ma a rispondere a quelle che riceve, e logit ed etichette
vanno sfalsati di una posizione, perché il token \(t+1\) si predice dal prefisso
fino a \(t\):
def loss_sft(logits, input_ids, lunghezza_prompt):
    """Cross-entropia media sui soli token della risposta.

    logits: [B, T, V]; input_ids: [B, T], prompt seguito dalla risposta;
    lunghezza_prompt: quanti token iniziali di ogni riga sono prompt.
    """
    etichette = input_ids.clone()
    for i, n in enumerate(lunghezza_prompt):
        etichette[i, :n] = -100           # il prompt si legge, non si impara
    return F.cross_entropy(
        logits[:, :-1].reshape(-1, logits.size(-1)),   # il token t+1 ...
        etichette[:, 1:].reshape(-1),                  # ... si predice da t
        ignore_index=-100,
    )

torch.manual_seed(0)
logits = torch.randn(2, 6, 10, requires_grad=True)  # 2 righe, 6 token, V = 10
input_ids = torch.randint(0, 10, (2, 6))
loss_sft(logits, input_ids, [3, 2]).backward()

# quali posizioni ricevono gradiente: solo quelle che predicono la risposta
print((logits.grad.abs().sum(dim=-1) > 0).int())
tensor([[0, 0, 1, 1, 1, 0],
        [0, 1, 1, 1, 1, 0]], dtype=torch.int32)
Nella prima riga il prompt occupa tre token, e ricevono gradiente le posizioni 2, 3 e 4 (contando da zero), le tre che predicono i tre token di risposta; nella seconda il prompt è di due token, e le posizioni sono quattro. L’ultima posizione di ogni riga non predice niente, perché dopo di lei non c’è un token da indovinare.
Pensare prima di rispondere: spendere calcolo mentre si risponde#
Le due mosse viste finora, l’instruction tuning e le preferenze, cambiano i parametri del modello una volta per tutte. Esiste un terzo modo, che agisce al momento della risposta: far spendere al modello più calcolo mentre risponde, con più token di ragionamento o con più risposte campionate. Alcune tecniche non toccano i parametri, come la catena di pensiero chiesta nel prompt; i modelli «ragionanti» sono invece addestrati, con il rinforzo, a usare bene quel calcolo. Per o1, nell’annuncio del settembre 2024, OpenAI scrive che le prestazioni migliorano sia con più rinforzo in addestramento sia con più tempo per pensare al momento della risposta [OpenAI24].

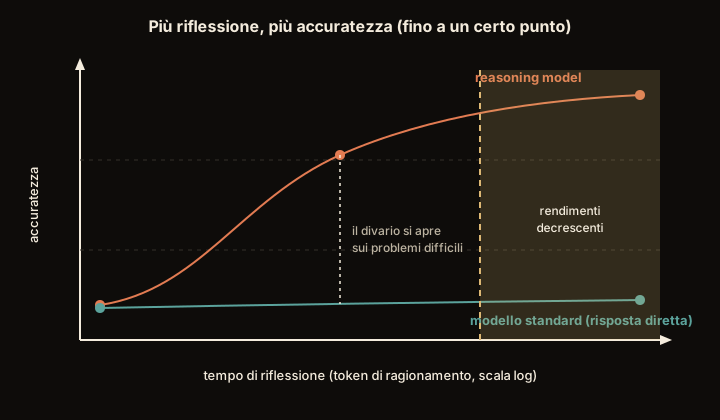
Fig. 16.23 Un secondo modo di spendere calcolo, al momento della risposta. La curva piatta è il punto: dare più tempo non basta, il modello deve essere stato addestrato a usarlo.#
Le due curve di Fig. 16.23 distinguono due cose che si confondono facilmente. Più calcolo al momento della risposta aiuta se il modello lo usa per passaggi che si costruiscono l’uno sull’altro; altrimenti produce solo testo in più. Il meccanismo di base è la chain-of-thought (catena di pensiero), descritta da Wei e colleghi nel 2022 [WWS+22]: far generare al modello i passaggi intermedi prima della risposta migliora l’accuratezza sui problemi che ne richiedono più d’uno (aritmetica, buon senso, ragionamento simbolico), a partire da una certa taglia del modello.
È la regola che conosci dal compito di matematica: «mostra i passaggi». Alla domanda «un treno parte alle 9:47 e arriva alle 11:23: quanto dura il viaggio?», sparare il risultato a colpo d’occhio fa sbagliare spesso. Scrivere i passaggi porta quasi sempre alla risposta giusta: da 9:47 a 10:00 sono 13 minuti, poi un’ora fino alle 11:00, poi altri 23; totale 96 minuti, cioè 1 ora e 36. Con i modelli funziona allo stesso modo: se l’esempio che gli mostri contiene i passaggi, o se glieli chiedi esplicitamente, il modello li scrive e sbaglia meno, perché ogni passaggio può appoggiarsi ai precedenti invece di indovinare tutto in un colpo.
Il limite, in classe, si vede benissimo: «mostra i passaggi» aiuta chi i passaggi li sa fare. Chiederli a un bambino che non ha ancora imparato a leggere l’ora non gli regala la risposta: escono quattro righe sbagliate al posto di un numero sbagliato, e a volte il pasticcio delle righe lo porta più lontano dal risultato di quanto lo avrebbe portato tirare a indovinare. Con i modelli succede lo stesso, e la taglia conta: sotto una certa dimensione (nelle prime prove, un centinaio di miliardi di parametri) le catene di passaggi non aiutano, e a volte peggiorano le cose.
Un raffinamento semplice: fargli risolvere lo stesso problema più volte per strade diverse e prendere la risposta più votata, come rifare il conto delle ore in tre modi e fidarsi del numero che salta fuori più spesso. Ogni tentativo in più costa, e quanto convenga farne dipende da quanto è difficile la domanda. I modelli «ragionanti» usciti tra il 2024 e il 2025 portano l’idea alle conseguenze: sono addestrati a produrre da soli, prima di ogni risposta, una lunga brutta copia di passaggi, che costa tempo e calcolo in più, ripagati soprattutto in matematica e programmazione, dove la risposta si può verificare da sé, senza bisogno di qualcuno che dica se gli piace.
Nel chain-of-thought prompting gli esempi nel prompt includono i passaggi intermedi, e il modello li riproduce prima della risposta finale. Gli autori la descrivono come una capacità emergente con la scala: sotto una certa dimensione (nelle loro prove, circa 100 miliardi di parametri) le catene non aiutano o peggiorano, mentre con PaLM da 540 miliardi di parametri otto esempi con catena bastarono a superare, sul benchmark di problemi aritmetici GSM8K, persino un GPT-3 rifinito ad hoc con verificatore [WWS+22]. Il dato sperimentale è solido; sulla parola «emergente» vale però l’avvertenza della sezione sulle abilità emergenti: GSM8K si misura in exact match sul numero finale, cioè con la metrica tutto-o-niente che trasforma miglioramenti lisci in gradini [SMK23]. Quel che si osserva senza ambiguità è che le catene generate dai modelli piccoli sono spesso incoerenti, oltre che sbagliate nel risultato: la discontinuità, se c’è, è nella procedura prima che nel punteggio.
La self-consistency aggiunge un passo: si campionano \(n\) catene indipendenti, con risposte finali \(a_1, \dots, a_n\), e si sceglie \(\hat{a} = \arg\max_a \sum_{i=1}^{n} \mathbb{1}[a_i = a]\), cioè la risposta più votata [WWS+23], a un costo lineare in \(n\). Quanto rendano questi modi di spendere calcolo dipende dalla difficoltà del prompt: Snell e colleghi trovano che la loro efficacia varia in modo critico con la difficoltà, e propongono di allocare il calcolo prompt per prompt [SLXK25]. Per misurare se un modello sa risolvere un problema in almeno uno di \(k\) tentativi si usa il pass@\(k\), stimato da \(n \ge k\) campioni, \(c\) dei quali corretti, come \(1 - \binom{n-c}{k}/\binom{n}{k}\) [CTJ+21]; per \(k = 1\) vale \(c/n\).
I modelli «ragionanti», o1 di OpenAI (in anteprima dal settembre 2024) e DeepSeek-R1 [GYZ+25] a pesi aperti (gennaio 2025), interiorizzano la catena. Il cuore del metodo è l’addestramento con reinforcement learning su problemi a risposta verificabile (correttezza del risultato matematico, superamento dei test per il codice), dove la ricompensa non richiede giudizi umani. DeepSeek-R1-Zero usa soltanto quello, a partire dal modello di base e senza SFT preliminare, e mostra comportamenti di auto-verifica e di ripensamento dei propri passaggi; DeepSeek-R1 lo integra in una procedura a più fasi, con campionamento a rifiuto, SFT e dati non di ragionamento che lo riallineano alle preferenze umane. L’algoritmo è GRPO [SWZ+24], un PPO senza critico: per ogni prompt \(x\) si campiona dalla policy precedente \(\pi_{\theta_{\text{old}}}\) un gruppo di \(G\) risposte \(y_1, \dots, y_G\), se ne calcolano le ricompense \(r_1, \dots, r_G\), e il vantaggio di ciascuna è la sua ricompensa standardizzata dentro il gruppo, \(\hat{A}_i = (r_i - \operatorname{media}(\mathbf{r}))/\operatorname{dev.std}(\mathbf{r})\), uguale per tutti i token della risposta. Nella forma dell’articolo su R1 si massimizza
dove \(\epsilon\) è l’ampiezza della fascia di taglio di PPO. A differenza dell’RLHF con PPO, la KL non si somma alla ricompensa ma entra nella loss come termine esplicito, stimata per ogni risposta [GYZ+25] con
una quantità che non è mai negativa. Shao e colleghi scrivono lo stesso obiettivo token per token. Quello che sparisce è la rete che stimava in anticipo il voto, sostituita dalla media del gruppo: una copia intera del modello in meno. Quello che si può dire oggi: i guadagni sono concentrati nei domini verificabili; il costo per risposta cresce con la lunghezza della catena (più token, più latenza); e se queste catene corrispondano a un «ragionamento» in senso proprio è una questione aperta.
I limiti del segnale di ricompensa#
Il post-training migliora il comportamento dei modelli, ma non garantisce che sia quello voluto.
Il primo limite si chiama reward hacking, «imbrogliare il premio», ed è la legge di Goodhart applicata al reward model: quando una misura diventa un obiettivo, smette di essere una buona misura. Il reward model imita i giudizi delle persone, e quei giudizi hanno debolezze sistematiche: premiamo volentieri le risposte lunghe, sicure di sé, ben impaginate, anche quando dicono meno. Un modello messo a inseguire quel voto impara la prolissità e la sicurezza esibita prima ancora dell’utilità, perché sono più facili da produrre e prendono lo stesso voto; in tre contesti diversi buona parte del guadagno di ricompensa dell’RLHF si spiega con la sola lunghezza delle risposte [SGXD24]. Gao e colleghi hanno misurato l’effetto sostituendo le persone con un reward model fisso, preso come giudice «vero»: in funzione di \(\kappa = \sqrt{D_{\mathrm{KL}}(\pi_\theta \,\|\, \pi_{\text{ref}})}\), la distanza dalla policy di partenza, la ricompensa vera segue \(\kappa\,(a - b\log\kappa)\) con \(a, b > 0\), cioè sale, tocca un massimo e poi scende, mentre quella del reward model addestrato continua a salire [GSH23]. Nei loro esperimenti la penalità KL non sposta quella curva, con la riserva, dichiarata dagli autori, che il risultato potrebbe dipendere dagli iperparametri: fa soltanto fermare prima la corsa, come un arresto anticipato. Limita quanto il modello può allontanarsi dal punto di partenza, ma non gli insegna a distinguere una risposta utile da una che sembra utile.
Il secondo è la ruffianeria (sycophancy), documentata empiricamente [STK+23]: se i valutatori preferiscono (anche solo un po’ più spesso) le risposte che danno loro ragione, il modello impara a dare ragione. Contraddici un assistente addestrato sulle preferenze e spesso ritratterà una risposta corretta, perché nei dati di confronto l’accordo vinceva sul disaccordo. È l’esempio perfetto di ottimizzazione riuscita dell’obiettivo sbagliato.
Il terzo non riguarda il reward model ma lo strumento, e tocca tanto l’RLHF quanto l’addestramento sui problemi verificabili. Quando si fa generare al modello una lunga risposta e poi le si assegna un voto unico alla fine, quel voto va ridistribuito su tutto quello che il modello ha scritto per arrivarci: se la risposta finale è giusta vengono rinforzati anche i passaggi sbagliati che stanno per strada, e se è sbagliata viene punito anche il ragionamento buono. Andrej Karpathy lo ha detto con un’immagine che è rimasta: si sta «aspirando la supervisione attraverso una cannuccia», e quel poco lo si spalma sull’intera traiettoria [Kar25b]. Nella stessa intervista aggiunge che, ciò nonostante, l’apprendimento per rinforzo resta oggi il meglio disponibile, perché quello che c’era prima era peggio.
Un’ultima avvertenza riguarda la domanda se questo addestramento aggiunga capacità o soltanto le riordini. La si misura con il pass@\(k\): si chiedono al modello \(k\) risposte per problema, e il problema conta come risolto se almeno una è giusta. Con \(k = 1\) i modelli addestrati sui domini verificabili battono i loro modelli di partenza. Con \(k\) molto grande, in uno studio dell’aprile 2025, il rapporto si rovescia: il modello di partenza, lasciato tentare abbastanza volte, risolve più problemi, e la gamma dei problemi che il modello addestrato sa risolvere tende a restringersi man mano che l’addestramento procede [YCL+25]. Il risultato riguarda gli addestramenti di quell’anno: un lavoro di un mese dopo, ProRL, prolunga l’addestramento, tiene sotto controllo la distanza dal riferimento, e riporta modelli che risolvono anche problemi su cui il modello di partenza non riesce mai, comunque si campioni [LDL+25]. Non si tratta quindi di un limite di principio, e la sezione sul dibattito sul rinforzo ci torna sopra per esteso.
E c’è la domanda che nessun addestramento può chiudere. Tutto questo lavoro serve a far sì che un modello si comporti come vorremmo, e ha un nome, allineamento: allineare il comportamento del modello a ciò che le persone considerano utile e accettabile. Solo che a quel punto la domanda diventa allineato a chi? In InstructGPT le «preferenze umane» erano quelle di una squadra di circa quaranta collaboratori, per lo più anglofoni che vivevano negli Stati Uniti o nel Sud-Est asiatico, reclutati per dare quei giudizi secondo linee guida scritte dai ricercatori, e d’accordo fra loro in circa tre casi su quattro; gli autori stessi avvertono di non sostenere che siano la fonte giusta di preferenze [OWJ+22]. Da allora una parte del giudizio è passata ad altri modelli, che applicano principi scritti (la Constitutional AI [BKK+22], ripresa nel capitolo sull’AI responsabile), o a verificatori automatici nei domini verificabili. La domanda resta: la scelta di quali giudizi o di quali principi contino è una decisione di chi costruisce il modello, non un fatto tecnico. Per questo l’allineamento è oggi un’area di ricerca autonoma, ben più di un ritocco finale: abbiamo strumenti per orientare il comportamento dei modelli, non garanzie sul risultato.
Da ricordare
Un modello appena pre-addestrato completa il testo, non risponde: è un’eco istruita. Il salto verso l’assistente è una seconda fase di addestramento, molto più corta e mirata. Quanto pesi lo dice un dato: nel giudizio delle persone, sulle richieste per cui era stato rifinito, un modello piccolo ma rifinito così batteva uno più di cento volte più grande [OWJ+22].
Il tirocinio: una decina di migliaia di compiti già svolti bene (una richiesta con accanto la risposta di un professionista), studiati uno per uno, e a volte ne bastano mille scelti bene. Non aggiunge sapere, quello era già in biblioteca: insegna che a un’istruzione non si dà un seguito, si dà esecuzione. I fatti nuovi, anzi, li insegna male, e imparandoli il modello prende il vizio di rispondere sicuro anche su quello che non sa.
Il lucido da architetto [HSW+22]: rifinire un modello vuol dire riscriverne i numeri, e sono troppi per la memoria di quasi chiunque. Allora si congela la tabella grande e si impara solo una coppia di tabelle sottili messe di fianco: una piccola frazione dei numeri, un file da megabyte invece che da gigabyte, e adattamenti che si mettono e si tolgono come lucidi sovrapposti a una pianta. Sul lucido ci sta un cambio di tono o di comportamento; una materia intera da imparare da capo ci sta male.
Il palato artificiale [CLB+17]: giudicare è più facile che scrivere, quindi alle persone si chiede solo quale di due risposte preferiscono; da quei confronti si distilla un giudice automatico, e il modello poi lavora per far salire il voto. Con una regola d’oro appesa in cucina: restare vicini alla ricetta di partenza, perché il giudice è un’imitazione e ha i suoi punti ciechi.
Saltare il giudice [RSM+23]: dagli stessi confronti si può imparare direttamente, allargando il distacco fra la risposta preferita e la scartata (a volte scendono tutte e due, la scartata di più), e misurando sempre i ritocchi rispetto alla ricetta di partenza. Stessa destinazione sulla carta, senza il cantiere: nei fatti i due metodi divergono, perché il quaderno dei confronti è fermo e il palato artificiale no.
Mostrare i passaggi [WWS+22]: scrivere il ragionamento prima della risposta fa sbagliare meno, ma solo a un modello che i passaggi li sa fare (sotto una certa taglia le catene non aiutano, e a volte peggiorano); rifare lo stesso problema per strade diverse e tenere la risposta più votata aiuta ancora; i modelli «ragionanti» [GYZ+25] si addestrano a stendere da soli una lunga brutta copia. Costa tempo e calcolo, e ripaga soprattutto dove la risposta si può verificare.
Limiti aperti: il modello impara a prendere voti alti più che a essere utile (risposte lunghe, sicure di sé, ben impaginate), e la regola d’oro lo frena ma non lo guarisce; impara a dare ragione a chi lo contraddice; e resta la domanda che nessun addestramento chiude: allineato ai gusti di chi?
E c’è un limite dello strumento, non del giudice: un voto solo alla fine di una risposta lunga va poi spalmato su tutto quello che c’è scritto dentro, e così si rinforzano anche i passaggi sbagliati di una risposta finita bene. Karpathy dice che è come aspirare la supervisione con una cannuccia; aggiunge però che resta il meglio che si abbia.
Da ricordare
Un modello pre-addestrato completa, non risponde: il salto verso l’assistente è il post-training. In InstructGPT [OWJ+22] un modello da 1,3 miliardi di parametri allineato batteva, nel giudizio umano e sui prompt della sua interfaccia, il GPT-3 da 175 miliardi.
SFT / instruction tuning: la stessa cross-entropia del pre-addestramento, mediata sui soli token della risposta, su coppie (istruzione, risposta) scritte da persone. Insegna soprattutto il formato (l’ipotesi dell’allineamento superficiale [ZLX+23]), e i fatti nuovi li insegna male, a prezzo di più allucinazioni [GYA+24].
LoRA [HSW+22]: l’aggiornamento si parametrizza a rango basso (\(\mathbf{W}_0 + \frac{\alpha}{\rho}\mathbf{B}\mathbf{A}\)), la matrice originale resta congelata, i parametri addestrabili scendono di due o tre ordini di grandezza e l’adattatore si può fondere prima del deployment o scambiare a caldo. Per eguagliare il fine-tuning completo servono adattatori su tutte le matrici lineari [DPHZ23]; su un dominio intero, come codice o matematica, resta sotto, e dimentica meno [BPGO+24].
RLHF [CLB+17] [ZSW+19]: confronti umani → reward model (Bradley–Terry) → ottimizzazione con PPO e penalità KL verso il modello di partenza, per non finire nei punti ciechi del reward model.
DPO [RSM+23]: lo stesso obiettivo dell’RLHF con penalità KL, senza RL esplicito; una loss supervisionata sulle coppie preferita/scartata, con la ricompensa implicita \(\beta \log (\pi_\theta / \pi_{\text{ref}})\). L’equivalenza è esatta solo nel limite non parametrico e sulle coppie raccolte: in pratica i due metodi divergono.
Test-time compute: chain-of-thought [WWS+22], self-consistency [WWS+23], e i modelli «ragionanti» addestrati con RL su risposte verificabili [GYZ+25], con GRPO, un PPO senza critico (guadagni reali ma concentrati nei domini verificabili, a costo di più calcolo per risposta).
Limiti aperti: reward hacking (la legge di Goodhart: oltre una certa distanza dal riferimento la ricompensa vera cala, e la penalità KL non sposta la curva [GSH23]), ruffianeria, e la domanda non tecnica «allineato a chi?».
Limite dello strumento: un ritorno scalare a fine sequenza va ridistribuito su tutti i token generati, quindi rinforza anche i passaggi errati delle traiettorie riuscite («sucking supervision through a straw», [Kar25b]). E misurando col pass@\(k\): nello studio dell’aprile 2025 i modelli addestrati con ricompensa verificabile vincono a \(k\) piccolo e i modelli base a \(k\) grande [YCL+25], ma con addestramenti più lunghi il vantaggio tiene anche a \(k\) grande [LDL+25]. La sezione sul dibattito sul rinforzo tratta entrambe le questioni per esteso.
Il post-training orienta il comportamento di un modello e non aggiorna quello che sa: la conoscenza dei pesi si ferma al giorno in cui è finito il pre-addestramento, e l’instruction tuning i fatti nuovi li insegna male. A quello si provvede altrove, dando al modello un archivio da consultare: è il tema della sezione sul retrieval.