


Message passing: il cuore delle GNN#
C’è un gioco che tutti conosciamo: il telefono senza fili. Una persona sussurra una frase all’orecchio del vicino, quello la ripete al suo, e così via. Cambiamo le regole. Invece di ascoltare un vicino, ognuno ascolta tutti i propri vicini in una volta sola, riassume ciò che ha sentito e si fa un’idea aggiornata; poi si ricomincia. Dopo un giro, ogni persona sa qualcosa dei suoi amici diretti. Dopo due giri, anche degli amici degli amici. Dopo \(K\) giri, la voce partita da un capo della rete è arrivata a chi sta a \(K\) strette di mano di distanza.
Una rete neurale su grafo elabora l’informazione allo stesso modo: a ogni giro ogni nodo mette insieme le file di numeri dei vicini e aggiorna la propria. La sezione «Il mondo come grafo» ha messo il dato in forma di tabelle, e per seguire queste pagine basta ricordare che cosa dicono: chi è collegato a chi e che cosa c’è scritto su ogni nodo. I nomi propri sono quattro: la matrice di adiacenza \(\mathbf{A}\) (chi è collegato a chi), la matrice delle feature dei nodi \(\mathbf{X}\) (le file di numeri dei nodi), la matrice diagonale dei gradi \(\mathbf{D}\) (quanti vicini ha ciascuno) e la versione con i cappi \(\tilde{\mathbf{A}} = \mathbf{A} + \mathbf{I}\) (con ogni nodo dichiarato vicino di sé stesso).
L’introduzione al capitolo ha dato un nome al meccanismo: message passing, «scambio di messaggi». Qui lo apriamo: prima nella sua forma generale, poi nella sua forma più usata, la Graph Convolutional Network. Di quella vedremo, in quest’ordine, la formula, i conti che ne escono su un grafo minuscolo, la ragione per cui è fatta così e infine da dove viene.
Un nodo, i suoi vicini, tre mosse#
L’idea si regge su un’operazione sola, ripetuta a ogni giro e uguale per ogni nodo: guarda i vicini, riassumili, aggiornati. La Fig. 32.4 la mostra tutta in un colpo d’occhio.

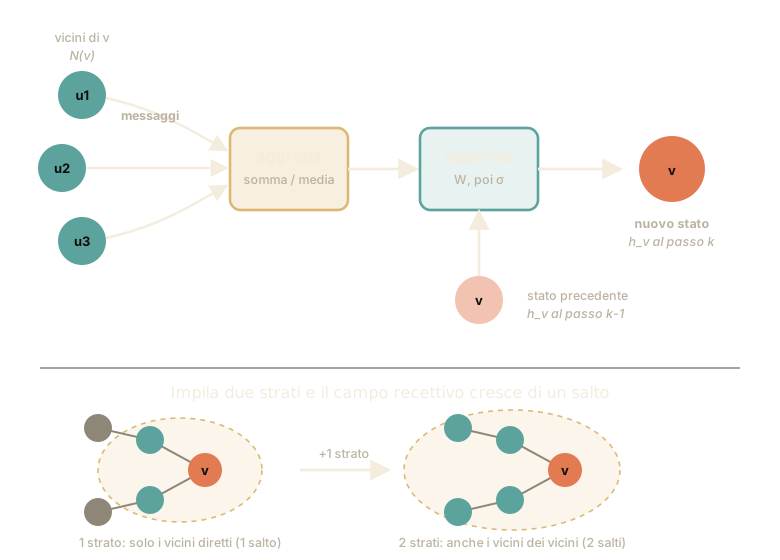
Fig. 32.4 Un passo di message passing su un nodo \(v\): i messaggi dei vicini (le loro file di numeri) si aggregano in un unico riassunto che non dipende dall’ordine in cui arrivano, poi la mossa di aggiornamento fonde quel riassunto con quello che il nodo sapeva già di sé. In basso: impilando due strati, il pezzo di grafo che un nodo riesce a sentire (il suo campo recettivo) cresce dai vicini diretti ai vicini dei vicini.#
Ogni nodo è una persona con una scheda su cui scrive «chi sono». Sulla scheda non c’è una frase: c’è una fila di numeri, uno per ogni caratteristica, come le tre caselline accanto a ogni nodo nella figura della sezione «Il mondo come grafo» (14 anni, 2 sport, 300 messaggi al giorno). È quella fila di numeri a viaggiare lungo gli archi.
A ogni giro un nodo fa tre cose, sempre nello stesso ordine. Prima ascolta, e ogni amico gli passa un bigliettino con sopra la propria fila di numeri (sono i messaggi). Poi riassume, e siccome i bigliettini sono file di numeri «riassumere» vuol dire fare i conti casella per casella, gli anni con gli anni, gli sport con gli sport. Il riassunto non deve dipendere dall’ordine in cui arrivano i bigliettini, perché tra amici non c’è un «primo» e un «ultimo», e la somma va bene proprio per questo: cambi l’ordine degli addendi e il totale non cambia. Vanno bene anche la media e il massimo, cioè il più grande dei numeri arrivati in quella casella. Infine aggiorna la propria scheda, mettendo insieme il riassunto degli amici e quello che già sapeva di sé.
Fatto questo per tutti i nodi, il giro è finito e se ne può fare un altro. È lo stesso identico meccanismo per ogni persona della rete: nessuno ha una regola speciale. Proprio come nella convoluzione delle immagini, dove lo stesso piccolo filtro scorre su tutti i pixel: solo che qui i «vicini» non sono i quattro pixel accanto, ma gli amici sul grafo, che possono essere due o dieci.
E se la domanda riguarda la comitiva intera invece della singola persona, finiti i giri si mettono insieme le schede di tutti, di nuovo in un modo che non guarda l’ordine.
Il quadro generale è la Message Passing Neural Network (MPNN) di Gilmer e colleghi [GSR+17], che unifica sotto un’unica notazione quasi tutte le GNN. Sia \(\mathbf{h}_v^{(k)}\) il vettore di stato del nodo \(v\) dopo \(k\) giri, con \(\mathbf{h}_v^{(0)} = \mathbf{x}_v\) (la sua feature iniziale). Un passo si scrive in due mosse:
Qui \(\mathcal{N}(v)\) è l’insieme dei vicini di \(v\); \(M_k\) è la funzione messaggio (una rete, che può usare anche la feature dell’arco \(\mathbf{e}_{vu}\)); il simbolo \(\bigoplus\) è l’aggregazione, un’operazione invariante alla permutazione dei vicini (tipicamente \(\sum\), la media o il massimo) che produce il messaggio aggregato \(\mathbf{m}_v^{(k)}\); e \(U_k\) è la funzione di aggiornamento che fonde lo stato precedente con \(\mathbf{m}_v^{(k)}\).
Per leggere la formula bisogna sapere di che oggetti parla: sono tutti vettori. Lo stato è \(\mathbf{h}_v^{(k)} \in \mathbb{R}^{F_k}\), il messaggio è \(\mathbf{m}_v^{(k)} \in \mathbb{R}^{F_m}\), e quindi \(M_k \colon \mathbb{R}^{F_{k-1}} \times \mathbb{R}^{F_{k-1}} \times \mathbb{R}^{F_e} \to \mathbb{R}^{F_m}\) e \(U_k \colon \mathbb{R}^{F_{k-1}} \times \mathbb{R}^{F_m} \to \mathbb{R}^{F_k}\), dove \(F_0 = F\) è il numero di feature d’ingresso e \(F_e\) quello delle feature d’arco. Il \(\bigoplus\) opera componente per componente su un numero variabile di vettori tutti della stessa lunghezza \(F_m\) e ne restituisce uno solo, sempre di lunghezza \(F_m\): è per questo che il grado variabile non rompe le dimensioni. (Attenzione al simbolo: qui \(\bigoplus\) è l’aggregazione, mentre nel resto del libro \(\oplus\) indica la concatenazione, che in questo capitolo si scrive \(\|\).) Dopo \(K\) passi, per un compito sull’intero grafo si applica una funzione di lettura (\(\mathrm{READOUT}\)), anch’essa invariante alla permutazione, \(\hat{y}_G = R\big(\{\, \mathbf{h}_v^{(K)} : v \in V \,\}\big)\).
L’invarianza di \(\bigoplus\) è ciò che garantisce l’equivarianza alla permutazione anticipata nell’introduzione: rinumerare i nodi non cambia i messaggi, perché una somma non ha un primo addendo. Ed è la stessa forma astratta («aggrega dai vicini, poi aggiorna») dello schema \(\mathrm{AGGREGATE}\)/\(\mathrm{UPDATE}\) visto in apertura del capitolo, qui resa esplicita nelle sue tre componenti: la funzione messaggio \(M_k\) e l’aggiornamento \(U_k\), che si apprendono, e l’aggregazione \(\bigoplus\), che è fissata (somma, media o massimo).
Dalla formula alla matrice: la GCN#
Lo schema delle tre mosse è un telaio, non un modello: per avere una rete funzionante bisogna decidere come si compongono i messaggi, come si aggregano e come si aggiorna lo stato dei nodi. La Graph Convolutional Network (GCN) di Thomas Kipf e Max Welling, circolata come preprint nel 2016 e pubblicata nel 2017 [KW17], fissa le tre scelte nel modo più semplice, ed è diventata il termine di paragone contro cui si misurano i modelli successivi.
Una parola sul vocabolario, perché da qui in avanti le due si alternano: ogni giro di passaparola è uno strato della rete. Sono la stessa cosa detta dai due lati, dal lato di chi ascolta e dal lato di chi la rete la costruisce.
La regola di propagazione della GCN, da uno strato al successivo, sta in una riga:
Ogni simbolo ha un ruolo preciso, e la riga si può leggere a due profondità.
È la scena dei bigliettini scritta in forma abbreviata, tutta in una riga e per tutti i nodi insieme.
\(\mathbf{H}^{(l)}\) è la pila delle schede al giro \(l\): una riga per nodo e, al giro zero, quello che ogni nodo sa di sé.
La \(\mathbf{A}\) col cappello è la rubrica: una riga per nodo, e in ogni riga, accanto al nome di ciascun vicino, un numero, il peso con cui quel vicino viene ascoltato. Ogni nodo vi figura anche come vicino di sé stesso (sono i cappi della sezione «Il mondo come grafo»: chi ascolta gli altri non deve dimenticare la propria scheda), e i pesi sono calcolati in modo che chi ha tanti vicini non copra la voce degli altri.
Moltiplicare la pila delle schede per la rubrica vuol dire fare, per ogni nodo, sempre lo stesso gesto: scorrere la sua riga della rubrica, prendere la scheda di ciascun nome che ci trova, moltiplicare ogni numero della scheda per il peso scritto accanto al nome e sommare tutto, casella per casella. È il giro di raccolta dei bigliettini, fatto per tutti in una volta: sulla catena di quattro nodi che arriva fra poco, il nodo 1 prende metà della propria scheda e quattro decimi di quella del nodo 2.
\(\mathbf{W}^{(l)}\) è la ricetta con cui ogni nodo riscrive la propria scheda dopo la raccolta, la stessa per tutti, come il filtro che scorre identico su tutta l’immagine in una rete convoluzionale; ed è qui che stanno i numeri che la rete impara. Infine \(\sigma\) è il solito ritocco finale, una funzione come la ReLU che ci accompagna fin dalle prime reti neurali. Un giro intero di passaparola, per l’intera rete, in una riga.
Resta la coda della formula, quella con l’ondina e gli esponenti: è soltanto il modo compatto di scrivere «i pesi da mettere sui collegamenti», e dice quel che si è appena detto a parole. Adesso quei pesi li vediamo all’opera su un grafo di quattro nodi, e subito dopo si dirà perché sono fatti così.
\(\mathbf{H}^{(l)} \in \mathbb{R}^{N \times F_l}\) raccoglie, riga per riga, gli stati di tutti i nodi allo strato \(l\); si parte da \(\mathbf{H}^{(0)} = \mathbf{X}\), le feature d’ingresso. (L’indice di strato è \(l\), come in Kipf e Welling: è il \(k\) dello schema generale, che qui resta libero per i polinomi della lettura spettrale.)
\(\tilde{\mathbf{A}} = \mathbf{A} + \mathbf{I}\) è l’adiacenza con i cappi (self-loop): aggiungere la matrice identità \(\mathbf{I}\) mette ogni nodo tra i propri vicini, così che nell’aggregazione un nodo tenga conto anche di sé stesso e non dimentichi la propria feature.
\(\tilde{\mathbf{D}}\) è la matrice diagonale dei gradi di \(\tilde{\mathbf{A}}\), cioè \(\tilde{D}_{ii} = \sum_j \tilde{A}_{ij}\) (il numero di vicini del nodo \(i\), più uno per il cappio).
\(\hat{\mathbf{A}} = \tilde{\mathbf{D}}^{-1/2}\,\tilde{\mathbf{A}}\,\tilde{\mathbf{D}}^{-1/2}\) è l’adiacenza normalizzata in modo simmetrico: il pezzo che pesa i messaggi.
\(\mathbf{W}^{(l)} \in \mathbb{R}^{F_l \times F_{l+1}}\) è la matrice dei pesi appresi dello strato (la stessa per tutti i nodi, come il filtro di una CNN) e \(\sigma\) una non-linearità (di solito la ReLU). È lei a decidere la larghezza del passo successivo: \(\mathbf{H}^{(l)}\mathbf{W}^{(l)}\) manda \(N \times F_l\) in \(N \times F_{l+1}\).
Letta nodo per nodo, la riga matriciale dice esattamente «aggrega, poi aggiorna»:
dove \(\tilde{d}_v\) è il grado di \(v\) in \(\tilde{\mathbf{A}}\). È un caso particolare della MPNN a tre condizioni. L’insieme su cui corre \(\bigoplus\) include il nodo stesso. La funzione messaggio è lineare, \(M(\mathbf{h}_v, \mathbf{h}_u, e_{vu}) = e_{vu}\,\mathbf{W}^{(l)\top}\mathbf{h}_u\), con il peso \(e_{vu} = 1/\sqrt{\tilde{d}_v\,\tilde{d}_u}\) passato come feature dell’arco, perché i gradi non sono argomenti di \(M\) in nessun altro modo. E l’aggregazione è la somma semplice, mentre l’aggiornamento è la non-linearità \(\sigma\) applicata al solo messaggio aggregato: la normalizzazione sta nel messaggio, e l’aggregazione non ne sa niente.
La simmetria promessa nella sezione «Il mondo come grafo» qui si dimostra in una riga. Se \(\mathbf{P}\) rinumera i nodi, \(\mathbf{A} \mapsto \mathbf{P}\mathbf{A}\mathbf{P}^\top\) e \(\mathbf{H} \mapsto \mathbf{P}\mathbf{H}\); \(\mathbf{P}\) permuta allo stesso modo \(\mathbf{I}\) e i gradi, quindi \(\hat{\mathbf{A}} \mapsto \mathbf{P}\hat{\mathbf{A}}\mathbf{P}^\top\), e
perché \(\mathbf{P}^\top\mathbf{P} = \mathbf{I}\) e \(\sigma\) agisce elemento per elemento: uno strato GCN è equivariante alla permutazione, e quindi lo è una pila di strati.
Il costo, con \(\hat{\mathbf{A}}\) sparsa e \(|E|\) archi: calcolare \(\mathbf{H}^{(l)}\mathbf{W}^{(l)}\) costa \(O(N F_l F_{l+1})\) e moltiplicarne il risultato per \(\hat{\mathbf{A}}\) costa \(O(|E|\,F_{l+1})\); nell’ordine opposto, \((\hat{\mathbf{A}}\mathbf{H}^{(l)})\mathbf{W}^{(l)}\), la propagazione costa \(O(|E|\,F_l)\), e conviene far viaggiare lungo gli archi la matrice più stretta. La memoria dell’addestramento sul grafo intero cresce come \(O(N \sum_l F_l)\), perché le attivazioni di tutti gli strati vanno tenute per il passo all’indietro, ed è questo che sui grafi grandi spinge verso il campionamento dei vicini.
Il conto, coi numeri#
Il calcolo di uno strato su un grafo minimo mostra che cosa fanno i pesi. Il grafo è una catena di quattro nodi in fila (1–2–3–4), ciascuno con un solo numero sulla scheda invece di una fila, cioè \(\mathbf{X} = (1,\, 2,\, 3,\, 4)^\top\). (La \(\top\) in alto vuol dire solo che quei quattro numeri vanno letti in colonna, uno per nodo, invece che in riga: è una convenzione di scrittura e non cambia niente.)
Delle tre mosse ne teniamo una sola. La ricetta di riscrittura e il ritocco finale li mettiamo a riposo (in formule, \(\mathbf{W} = \mathbf{I}\) e \(\sigma\) uguale all’identità: due modi di dire «per stavolta, lascia le cose come stanno»), così quello che si vede è l’effetto della sola raccolta dei bigliettini.
Ogni collegamento porta un peso, e il peso è tanto più piccolo quanti più vicini hanno i due nodi che collega, contando anche il cappio che ciascuno ha verso sé stesso. Qui i pesi sono tre: \(0{,}500\) sui due cappi dei nodi di bordo, che di vicini ne hanno uno solo; \(0{,}408\) sui due archi che uniscono un nodo di bordo a uno interno; \(0{,}333\) sull’arco fra i due nodi interni e sui loro cappi. Il nuovo valore di un nodo è la somma dei valori dei vicini (e del proprio), ciascuno moltiplicato per il peso del collegamento: da lì in poi è una moltiplicazione e un’addizione.
La matrice di adiacenza e quella con i cappi (\(\tilde{\mathbf{A}} = \mathbf{A} + \mathbf{I}\)) sono
Sommando le righe di \(\tilde{\mathbf{A}}\) si contano i vicini di ciascun nodo, cappio compreso: sono i gradi \(\tilde{\mathbf{d}} = (2,\, 3,\, 3,\, 2)\), perché i due nodi di bordo hanno un vicino e i due interni ne hanno due, più in tutti e quattro i casi sé stessi. Dunque
dove l’esponente \(-1/2\) vuol dire soltanto «uno diviso la radice quadrata»: \(2^{-1/2} = 1/\sqrt{2} \approx 0{,}707\). Quei quattro numeri sono uno sconto per nodo, tanto più forte quanti più vicini il nodo ha, e il peso di un arco è il prodotto degli sconti delle sue due estremità: \(0{,}707 \cdot 0{,}707 = 0{,}5\) sul cappio di un nodo di bordo, \(0{,}707 \cdot 0{,}577 \approx 0{,}408\) fra un bordo e un interno, \(0{,}577 \cdot 0{,}577 \approx 0{,}333\) fra due interni. La tabella dei pesi così ottenuta si chiama adiacenza normalizzata, e si scrive \(\hat{\mathbf{A}}\), la \(\mathbf{A}\) col cappello: «normalizzare» vuol dire appunto questo, dividere per rimettere tutti sulla stessa scala, e il perché lo si vede appena finito il conto. In una riga sola: \(\hat{A}_{vu} = \tilde{A}_{vu} / \sqrt{\tilde{d}_v\,\tilde{d}_u}\), cioè \(\hat{A}_{12} = 1/\sqrt{2\cdot 3} = 1/\sqrt{6} \approx 0{,}408\) e \(\hat{A}_{22} = 1/\sqrt{3\cdot 3} = 1/3 \approx 0{,}333\). La matrice completa è
La tabella è simmetrica, e non poteva essere altrimenti: gli archi qui non hanno un verso, quindi se il 2 è vicino dell’1 anche l’1 è vicino del 2, e il peso del collegamento è lo stesso letto nei due sensi. Il passo di propagazione è \(\mathbf{H}' = \hat{\mathbf{A}}\,\mathbf{X}\), cioè per ogni nodo la somma pesata di sé e dei suoi vicini:
Le moltiplicazioni sono fatte con i pesi esatti (\(\tfrac{1}{3}\) e \(\tfrac{1}{\sqrt6}\)) e arrotondate solo alla fine: chi le rifà con i valori tondi della tabella, \(0{,}333\) e \(0{,}408\), trova le ultime cifre diverse (per esempio \(0{,}333 \cdot 3 = 0{,}999\) e non \(1{,}000\)), e non ha sbagliato niente.
Il risultato è \(\mathbf{H}' \approx (1{,}316,\, 2{,}075,\, 3{,}300,\, 3{,}225)^\top\), e racconta bene cosa fa la GCN: i quattro valori si stringono. Partivano da \(1\) e arrivavano a \(4\), tre punti fra il più basso e il più alto; adesso vanno da \(1{,}32\) a \(3{,}30\), due punti scarsi. Il nodo 1, che valeva \(1\), sale a \(1{,}316\) perché è tirato in alto dal vicino 2; il nodo 4, che valeva \(4\), scende a \(3{,}225\) perché è tirato in basso dal 3.
I due nodi di mezzo salgono invece tutti e due, e la cosa smonta una scorciatoia che verrebbe naturale: questa non è la media dei vicini. Se lo fosse, il nodo 3, che vale \(3\) e sta fra un \(2\) e un \(4\), resterebbe a \(3\); invece sale a \(3{,}300\). La ragione è che i pesi di una riga non sommano a uno (in quella del nodo 3 fanno \(1{,}07\)), quindi ogni giro non è una media ma una somma pesata, che può alzare il livello generale. Quello che la GCN garantisce è che, ripetendo, le differenze di partenza si consumino, e non che ciascuno vada verso i suoi vicini a ogni singolo passo. Il livellamento si vedrà succedere, giro dopo giro, su questi stessi quattro numeri.
Perché normalizzare così#
Nel conto appena fatto ogni collegamento portava un suo peso, e i pesi erano tutti più piccoli di uno: qualcosa è stato diviso. Perché? Perché non sommare e basta i bigliettini dei vicini?
Un riassunto fatto sommando e basta, senza dividere niente. Un nodo con dieci amici riceve dieci bigliettini e li somma: un numerone. Un nodo con due amici ottiene un numero piccolo. Dopo qualche giro, i nodi «popolari» hanno valori enormi e quelli isolati valori minuscoli, non perché contino di più, ma solo perché hanno più connessioni. La rete finirebbe per confondere «essere importante» con «avere tanti amici».
Con la divisione tornano tutti più o meno sulla stessa scala: dieci opinioni o due, conta soprattutto il tenore. (Più o meno: nella catena di poco fa i pesi del nodo 3 sommano \(1{,}07\) e non \(1\), e infatti il suo valore è salito.)
Dividere, però, si può in due modi. Nel primo chi ascolta divide per il numero delle voci che sente, e fa la media. Nel secondo il peso di ogni collegamento si spartisce fra le due estremità, un po’ chi parla e un po’ chi ascolta: il messaggio di un amico molto popolare arriva più leggero, perché il suo tempo è diviso fra tanti, come il consiglio di chi conosce mezzo mondo vale un filo meno di quello dell’amico che hai solo tu.
Sulla scala i due modi si equivalgono, quindi la scelta si gioca altrove: sui due versi dello stesso collegamento. Prendi un popolare che, contando sé stesso, sente dieci voci, e un solitario che ne sente due, la propria e quella del popolare. Con la media il popolare dà alla voce del solitario un decimo, il solitario dà a quella del popolare metà: lo stesso collegamento pesa \(0{,}1\) in un verso e \(0{,}5\) nell’altro. Con la spartizione pesa \(1/\sqrt{10 \cdot 2} \approx 0{,}22\) in tutti e due, e la rubrica resta simmetrica, come il grafo. La GCN prende il secondo modo, e quella simmetria serve al conto da cui la formula è uscita, che arriva subito dopo.
Ci sono due normalizzazioni naturali. Quella per righe, \(\tilde{\mathbf{D}}^{-1}\tilde{\mathbf{A}}\), fa la media dei vicini: ogni riga somma a \(1\), è la matrice di transizione di una passeggiata aleatoria. La GCN usa invece quella simmetrica, \(\hat{\mathbf{A}} = \tilde{\mathbf{D}}^{-1/2}\tilde{\mathbf{A}}\tilde{\mathbf{D}}^{-1/2}\), in cui il peso dell’arco \((v,u)\) è \(1/\sqrt{\tilde{d}_v\,\tilde{d}_u}\): si sconta il grado di entrambi gli estremi.
La scala spiega perché si normalizza, ma non quale delle due forme scegliere. Le due matrici sono simili,
quindi hanno esattamente lo stesso spettro, contenuto in \([-1,1]\) con il massimo pari a \(1\). Tenere le attivazioni e i gradienti su una scala stabile, strato dopo strato, è il guadagno della normalizzazione in quanto tale rispetto a \(\tilde{\mathbf{A}}\) nuda (che sui nodi ad alto grado amplifica i valori in modo incontrollato): è il collegamento diretto con il problema dei gradienti nelle reti profonde, discusso nella sezione sulla backpropagation, ed è la sola cosa che Kipf e Welling rivendicano quando chiamano renormalization trick il passaggio da \(\mathbf{I}_N + \mathbf{D}^{-1/2}\mathbf{A}\,\mathbf{D}^{-1/2}\), che ha autovalori in \([0,2]\), alla forma \(\tilde{\mathbf{D}}^{-1/2}\tilde{\mathbf{A}}\tilde{\mathbf{D}}^{-1/2}\) con \(\tilde{\mathbf{D}}\) calcolata su \(\tilde{\mathbf{A}}\), cappi inclusi. Attenzione a non leggerci più di quanto ci sia: scala stabile non vuol dire informazione conservata, perché tutto ciò che non giace lungo l’autovettore dominante svanisce comunque.
Quel che distingue davvero la forma simmetrica è la simmetria stessa: \(\hat{\mathbf{A}}\) è autoaggiunta, quindi ha autovalori reali e una base di autovettori ortonormale, mentre \(\tilde{\mathbf{D}}^{-1}\tilde{\mathbf{A}}\) non è simmetrica e i suoi autovettori non sono ortogonali. È questa proprietà, e non il controllo delle scale, a rendere lecito tutto ciò che segue: decomporre un segnale sui nodi nelle sue «frequenze» con \(\mathbf{U}^\top\), moltiplicarle una per una e ricomporre con \(\mathbf{U}\) presuppone una base ortonormale, e senza di essa la lettura spettrale non sta in piedi.
Ed è anche la ragione per cui quella forma emerge dai calcoli invece di essere una scelta a priori. Qui sta il secondo punto, l’origine spettrale. La GCN nasce come approssimazione al prim’ordine di una convoluzione definita nel dominio spettrale del grafo: i filtri polinomiali di Čebyšëv di Defferrard, Bresson e Vandergheynst [DBV16]. Troncare quel polinomio al primo grado e legare i due coefficienti che restano lascia \(\mathbf{I}_N + \mathbf{D}^{-1/2}\mathbf{A}\mathbf{D}^{-1/2}\), che il renormalization trick sostituisce con \(\hat{\mathbf{A}}\): è da lì che la normalizzazione simmetrica emerge dai calcoli, e non è una scelta arbitraria. Rispetto al modello originale di Scarselli e colleghi [SGT+09], che iterava fino a un punto fisso, la GCN fissa un numero piccolo di strati e si addestra come una qualunque rete profonda.
Da dove viene la formula: le frequenze di un grafo#
La regola della GCN è ciò che resta di una convoluzione definita sulle frequenze del grafo, dopo due approssimazioni successive. La costruzione spiega anche il difetto più noto delle GNN, l’oversmoothing.
Su un’immagine, quanto in fretta le cose cambiano da un punto al punto accanto si chiama frequenza: bassa vuol dire zone di colore che cambiano piano, alta vuol dire dettagli fitti e bordi netti. Un filtro che «sfoca» toglie le alte e tiene le basse.
Su un grafo la stessa parola ha un senso preciso, e basta cambiare che cosa si guarda. Una configurazione di numeri sui nodi è a bassa frequenza se nodi collegati portano valori simili, ad alta frequenza se lungo ogni arco il valore salta. La più liscia di tutte è quasi lo stesso valore su ogni nodo (quasi: un po” più alto dove i vicini sono di più); la più agitata somiglia a una scacchiera, con ogni nodo di segno opposto ai suoi vicini.
Queste configurazioni, dalla più liscia alla più agitata, hanno un nome proprio: si chiamano gli autovettori del laplaciano del grafo. È un nome da registrare, perché nella sezione sui Graph Transformer torna a fare un mestiere che nessuno si aspetta: dire a ogni nodo dove sta nel grafo, come i Transformer dicono a ogni parola dove sta nella frase.
Da qui si può copiare il mestiere dell’equalizzatore di uno stereo, che scompone la musica in bande, dai bassi agli acuti, alza le une e abbassa le altre con un cursore per banda, e rimette tutto insieme. Sul grafo le bande sono quelle configurazioni: si scrivono i numeri sui nodi come somma di configurazioni, si decide con un cursore per ciascuna quanto tenerne, e si ricompone. È ciò che hanno fatto i primi lavori sulle reti convoluzionali su grafo, con i cursori regolati dall’addestramento, e i guai erano due. Il primo: le bande bisogna prima calcolarle, che su un grafo grande è un lavoro immane, e poi scomporre e ricomporre costa caro a ogni passaggio; i cursori, uno per configurazione, sono tanti quanti i nodi, e valgono per quel grafo e per nessun altro. Il secondo: muovere un cursore tocca in un colpo tutto il grafo, mentre il passaparola vuole sentire soltanto i vicini.
La GCN è quello che resta quando si rinuncia ai cursori liberi: un equalizzatore che sa fare un gesto solo, tenere i bassi e abbassare gli acuti, e che per farlo non ha bisogno di calcolare le bande, perché lo stesso effetto si ottiene facendo parlare ogni nodo con i vicini diretti. Il taglio rimedia a tutti e due i guai: niente calcolo immane, e quel che resta arriva a un salto per volta, come il passaparola. È un filtro che attenua le alte frequenze, cioè che smussa le differenze fra vicini.
Una frase da tenere a mente, questa, perché torna presto con un’aria molto meno amichevole.
Il laplaciano più semplice è \(\mathbf{D} - \mathbf{A}\): simmetrico, con le righe che sommano a zero e con forma quadratica \(\mathbf{x}^\top (\mathbf{D} - \mathbf{A})\, \mathbf{x} = \sum_{(u,v) \in E} (x_u - x_v)^2 \ge 0\), quindi semidefinito positivo. L’autovalore \(0\) ha autovettore \(\mathbf{1}\), e compare tante volte quante sono le componenti connesse del grafo. Normalizzandolo da entrambi i lati con \(\mathbf{D}^{-1/2}\) (su un grafo senza nodi isolati) si ottiene il laplaciano normalizzato del grafo,
simmetrico e semidefinito positivo, quindi diagonalizzabile con autovettori ortonormali \(\mathbf{U}\) e autovalori reali \(\lambda_i \in [0, 2]\).
Che gli autovalori siano «frequenze» non è un’analogia vaga: si legge dalla forma quadratica del laplaciano normalizzato, che vale
dove la somma percorre ogni arco non diretto una volta sola. È una somma di quadrati di differenze lungo gli archi, e la differenza è fra i valori divisi per la radice del grado: in un autovettore con \(\lambda\) piccolo è \(x_u/\sqrt{d_u}\) a variare poco fra nodi collegati, in uno con \(\lambda\) grande ad alternare. Su un autovettore di norma unitaria questa quantità è l’autovalore stesso, perché coincide con il quoziente di Rayleigh \(R(\mathbf{x}) = \mathbf{x}^\top \mathbf{L} \mathbf{x} / \mathbf{x}^\top \mathbf{x}\): la forma quadratica e il quoziente sono due oggetti distinti, da non confondere, ma su \(\lVert \mathbf{x} \rVert = 1\) dicono la stessa cosa, ed è il quoziente (con il principio di minimax) a caratterizzare gli autovalori come minimi della variazione. Su un ciclo, o su una griglia con i bordi periodici, gli autovettori del laplaciano sono seni e coseni, e questa costruzione si riduce alla trasformata di Fourier discreta. Su una catena con due estremi gli autovettori di \(\mathbf{D} - \mathbf{A}\) sono soli coseni, ed è la trasformata del coseno; quelli del laplaciano normalizzato lo sono quasi, perché i due estremi hanno un vicino solo.
Definita la trasformata come \(\hat{\mathbf{x}} = \mathbf{U}^\top \mathbf{x}\), un filtro è una moltiplicazione punto per punto nello spettro e un ritorno indietro:
che è la rete spettrale di Bruna e colleghi [BZSL14]. Nella forma con un moltiplicatore libero per ogni frequenza ha due difetti. Il primo è il costo: diagonalizzare \(\mathbf{L}\) costa \(O(N^3)\), una volta sola, e poi ogni filtraggio costa \(O(N^2)\), perché \(\mathbf{U}\) è densa; i parametri sono \(O(N)\) per filtro, e legati a quel grafo. Il secondo è che i filtri non sono localizzati, perché un \(g_\theta(\boldsymbol{\Lambda})\) arbitrario mescola nodi a distanza qualunque. Bruna e colleghi stessi propongono di recuperare la località chiedendo moltiplicatori lisci nella frequenza, che è la via che il passo successivo rende sistematica.
Entrambi i problemi si risolvono con lo stesso espediente: approssimare \(g_\theta\) con un polinomio di grado \(K\), e in particolare con i polinomi di Čebyšëv [HVG11],
con \(T_k(x) = 2x\,T_{k-1}(x) - T_{k-2}(x)\), \(T_0 = 1\), \(T_1 = x\), e con la barra a indicare lo spettro riscalato in \([-1, 1]\) (la tilde resta ai cappi). Il guadagno è doppio. Primo, poiché \(\mathbf{U} f(\boldsymbol{\Lambda}) \mathbf{U}^\top = f(\mathbf{L})\) per qualunque polinomio \(f\), gli autovettori spariscono dal conto: restano prodotti fra la matrice sparsa \(\mathbf{L}\) e un vettore, uno per grado, cioè \(O(K|E|)\) per filtraggio invece di \(O(N^2)\), e senza la diagonalizzazione iniziale; e i parametri sono \(K+1\) per filtro, qualunque sia il grafo. Secondo, una potenza \(\mathbf{L}^k\) è non nulla in \((u,v)\) solo se esiste un cammino di lunghezza \(\le k\) fra \(u\) e \(v\): un polinomio di grado \(K\) è quindi automaticamente \(K\)-localizzato, tocca soltanto i vicini entro \(K\) salti. È ChebNet [DBV16], ed è già una GNN: la localizzazione, che nella lettura spaziale era il punto di partenza, qui emerge dal troncamento.
L’ultimo passo è di Kipf e Welling [KW17], e consiste nel rinunciare a quasi tutto. Si pone \(K = 1\) (un solo salto per strato, la profondità la darà lo stack) e si approssima \(\lambda_{\max} \approx 2\), il che manda \(\bar{\mathbf{L}} = \frac{2}{\lambda_{\max}} \mathbf{L} - \mathbf{I}_N\) in \(-\mathbf{D}^{-1/2} \mathbf{A} \mathbf{D}^{-1/2}\). Restano due parametri liberi:
Legandoli con \(\theta = \theta'_0 = -\theta'_1\), per ridurre l’overfitting e i parametri a uno solo per canale, si ottiene
La matrice fra parentesi ha autovalori in \([0, 2]\) e applicarla ripetutamente fa esplodere i valori: da qui il renormalization trick, cioè sostituirla con \(\hat{\mathbf{A}} = \tilde{\mathbf{D}}^{-1/2}\tilde{\mathbf{A}}\tilde{\mathbf{D}}^{-1/2}\) dove \(\tilde{\mathbf{A}} = \mathbf{A} + \mathbf{I}_N\) e \(\tilde{\mathbf{D}}\) è la matrice dei gradi di \(\tilde{\mathbf{A}}\). È la formula della GCN, e il conto rimasto in sospeso è saldato: la normalizzazione simmetrica è quel che resta di una convoluzione spettrale dopo due approssimazioni, e non una scelta di comodo.
I cappi, per inciso, non riscalano soltanto: rendono il grafo non bipartito e staccano il fondo dello spettro da \(-1\) (su una catena di otto nodi il minimo passa da \(-1\) a \(-0{,}30\), su un ciclo di otto da \(-1\) a \(-0{,}33\)), cioè smorzano la componente a frequenza più alta [WSZ+19]. È già il filtro passa-basso che, applicato molte volte, appiattisce i nodi uno sull’altro, ed è comparso mentre credevamo di stare solo mettendo in sicurezza i numeri.
L’oversmoothing segue dalla stessa costruzione.
Riprendi la frase da tenere a mente: la GCN è un filtro che smussa le differenze fra vicini. Ogni giro di bigliettini ne cancella un po’; e se i giri sono tanti? Le differenze finiscono.
Si vede sulla catena di quattro nodi di poco fa, quella che partiva da 1, 2, 3 e 4. Rifacendo il giro più volte, sempre con la ricetta di riscrittura e il ritocco finale a riposo, i quattro valori vanno così:
dopo |
nodo 1 |
nodo 2 |
nodo 3 |
nodo 4 |
|---|---|---|---|---|
\(0\) giri |
\(1{,}00\) |
\(2{,}00\) |
\(3{,}00\) |
\(4{,}00\) |
\(1\) giro |
\(1{,}32\) |
\(2{,}07\) |
\(3{,}30\) |
\(3{,}22\) |
\(5\) giri |
\(1{,}95\) |
\(2{,}57\) |
\(2{,}88\) |
\(2{,}50\) |
\(20\) giri |
\(2{,}22\) |
\(2{,}72\) |
\(2{,}73\) |
\(2{,}23\) |
Guarda l’ultima riga. Il nodo che partiva da \(1\) e quello che partiva da \(4\) sono finiti praticamente sullo stesso numero, e così i due di mezzo. Delle differenze di partenza non è rimasto niente, e i due valori diversi che si vedono ancora (\(2{,}2\) e \(2{,}7\)) non dicono chi era il nodo: dicono soltanto quanti vicini ha, uno i due di bordo e due i due interni.
Il perché si vede a occhio. Se a ogni giro ognuno si rimescola con i vicini, e i vicini fanno lo stesso con i loro, dopo un po’ nessuno ha più niente di suo: è la classe in cui tutti copiano un po’ dal compagno di banco, e dopo un’ora i compiti si somigliano tutti e non si capisce più chi la lezione la sapeva davvero. Due classi in aule separate si livellano però ciascuna per conto suo: la copiatura non passa i muri, e i due gruppi restano diversi. E la ricetta di riscrittura, che qui abbiamo lasciato a riposo, non basta a salvarli: se moltiplica le schede per numeri grandi tiene in vita qualche differenza, se le moltiplica per numeri piccoli il livellamento arriva lo stesso.
Il livellamento si può anche misurare con un numero solo, che dice quanto cambiano ancora i valori da un nodo ai suoi vicini, tolta la differenza dovuta a quanti vicini ha ciascuno, e scende verso zero man mano che la classe si uniforma: sulla catena vale \(0{,}058\) all’inizio, \(0{,}026\) dopo un giro, \(0{,}002\) dopo cinque e meno di un milionesimo dopo venti.
Chiamiamo \(\lambda_i(\hat{\mathbf{A}})\) gli autovalori dell’operatore appena ottenuto: stanno in \([-1, 1]\), il più grande vale esattamente \(1\), e il suo autovettore è \(\tilde{\mathbf{D}}^{1/2}\mathbf{1}\), cioè la radice dei gradi. Uno strato GCN (a meno di \(\mathbf{W}\) e della non linearità) è la moltiplicazione per \(\hat{\mathbf{A}}\); \(K\) strati sono \(\hat{\mathbf{A}}^K\). Ma elevare alla \(K\) una matrice eleva alla \(K\) i suoi autovalori, e ogni autovalore di modulo minore di \(1\) svanisce: dopo abbastanza strati sopravvive solo la componente lungo l’autovettore dominante, che è la stessa per tutti i nodi a meno del loro grado. (Vale su un grafo connesso: se le componenti connesse sono più d’una, l’autovalore \(1\) ha la loro molteplicità e il collasso avviene dentro ciascuna componente separatamente. E capita davvero, perché un batch di molecole in PyTorch Geometric è un unico grafo sconnesso, una componente per molecola, e l’oversmoothing non le mescola fra loro.)
Sulla catena di quattro nodi, con \(\mathbf{X} = (1,2,3,4)^\top\), i quattro autovalori di \(\hat{\mathbf{A}}\) valgono \(1\), \(0{,}729\), \(0{,}167\) e \(-0{,}229\). Applicando \(\hat{\mathbf{A}}\) venti volte a \(\mathbf{X}\), il rapporto fra il valore di ogni nodo e la radice del suo grado con cappio vale \(1{,}5714\), \(1{,}5724\), \(1{,}5739\), \(1{,}5748\): i quattro nodi, che partivano da valori distinti, coincidono ormai nelle prime due cifre decimali. Il divario fra il più alto e il più basso è \(3{,}4 \cdot 10^{-3}\) e si stringe come la potenza \(K\)-esima del secondo autovalore, \(0{,}729^K\): a cinquanta applicazioni vale \(2{,}6 \cdot 10^{-7}\) e a cento \(3 \cdot 10^{-14}\) (con una cifra sola, perché la seconda la doppia precisione non la garantisce più). Anche lì i quattro numeri restano diversi fra loro (in doppia precisione li separano ancora un centinaio e mezzo di passi elementari, il gradino minimo fra due numeri rappresentabili, e quanti esattamente dipende dall’ordine in cui si fanno le moltiplicazioni), ma è una differenza che nessun modello può più usare: al passo successivo della rete, moltiplicata per pesi dell’ordine dell’unità, resta quello che era.
Il collasso si misura con un numero solo, il quoziente di Rayleigh del laplaciano costruito sulla matrice con i cappi,
cioè un’energia di Dirichlet normalizzata: è la forma quadratica della lettura spettrale, si annulla soltanto lungo l’autovettore dominante (su un grafo connesso) e cresce con la parte del segnale che sta ancora fuori da quella direzione. Sulla catena vale \(5{,}8 \cdot 10^{-2}\) al passo zero, \(2{,}6 \cdot 10^{-2}\) al primo, \(2{,}2 \cdot 10^{-3}\) al quinto e \(1{,}7 \cdot 10^{-7}\) al ventesimo.
A rigore l’argomento vale per l’operatore lineare \(\hat{\mathbf{A}}^K\), cioè per la GCN privata di \(\mathbf{W}\) e della non linearità. Nella rete completa i pesi possono contrastare il collasso, e Oono e Suzuki [OS20] dimostrano che avviene comunque quando le norme dei pesi restano sotto una soglia legata allo spettro di \(\hat{\mathbf{A}}\): per l’operatore è algebra, per la rete intera è un teorema con le sue condizioni.
Questo appiattimento ha un nome, oversmoothing, cioè «levigatura eccessiva», e la sezione su GraphSAGE, GAT e le applicazioni lo elencherà fra i limiti delle GNN. Adesso però sappiamo che è quello che fa, per costruzione, un filtro che smussa le differenze (in gergo un filtro passa-basso) quando lo si applica molte volte di fila. Non c’è nessun errore di programmazione da andare a cercare. C’è da decidere quanti strati mettere, oppure da cambiare filtro.
Il conto sta in poche righe, e stampa insieme i quattro valori giro dopo giro con la loro energia, i quattro autovalori e il divario che si consuma.
import numpy as np

# la catena 1–2–3–4: adiacenza, cappi, gradi
A = np.array([[0., 1, 0, 0], [1, 0, 1, 0], [0, 1, 0, 1], [0, 0, 1, 0]])
A_tilde = A + np.eye(4)
d = A_tilde.sum(1)                          # gradi col cappio: [2 3 3 2]
A_hat = A_tilde / np.sqrt(np.outer(d, d))   # normalizzazione simmetrica

X = np.array([1., 2., 3., 4.])
for giri in (0, 1, 5, 20):
    H = np.linalg.matrix_power(A_hat, giri) @ X
    E = H @ (H - A_hat @ H) / (H @ H)       # energia di Dirichlet normalizzata
    print(f"{giri:>2} giri: " + "  ".join(f"{v:.2f}" for v in H)
          + f"   energia {E:.1e}")

print("autovalori:", np.round(np.sort(np.linalg.eigvalsh(A_hat))[::-1], 3))
r = (np.linalg.matrix_power(A_hat, 20) @ X) / np.sqrt(d)
print("valore diviso la radice del grado:", np.round(r, 4))
# a 100 giri la seconda cifra del divario dipende già dall'ordine dei conti
for giri, cifre in ((20, 1), (50, 1), (100, 0)):
    r = (np.linalg.matrix_power(A_hat, giri) @ X) / np.sqrt(d)
    print(f"divario fra il più alto e il più basso dopo {giri:>3} giri: "
          f"{r.max() - r.min():.{cifre}e}")
 0 giri: 1.00  2.00  3.00  4.00   energia 5.8e-02
 1 giri: 1.32  2.07  3.30  3.22   energia 2.6e-02
 5 giri: 1.95  2.57  2.88  2.50   energia 2.2e-03
20 giri: 2.22  2.72  2.73  2.23   energia 1.7e-07
autovalori: [ 1.     0.729  0.167 -0.229]
valore diviso la radice del grado: [1.5714 1.5724 1.5739 1.5748]
divario fra il più alto e il più basso dopo  20 giri: 3.4e-03
divario fra il più alto e il più basso dopo  50 giri: 2.6e-07
divario fra il più alto e il più basso dopo 100 giri: 3e-14
Impilare gli strati: il campo recettivo a \(K\) salti#
Come vada a finire se si esagera lo sappiamo già. Resta da dire perché, fino a un certo punto, impilare gli strati conviene, e conviene molto: un solo strato di GCN fa vedere a ogni nodo i suoi vicini diretti, e il bello comincia appunto quando gli strati sono più d’uno.
Nella catena 1–2–3–4 il nodo 1 ha un vicino solo, il nodo 2, e al primo giro parla soltanto con lui. Ma nello stesso giro anche il nodo 2 ha parlato col nodo 3. Così, al secondo giro, quando il nodo 1 riascolta il nodo 2, dentro il nodo 2 c’è già un pezzo di nodo 3. Senza essersi mai «visti» direttamente, l’informazione del nodo 3 è arrivata al nodo 1 in due passi. Al terzo giro arriverebbe anche quella del nodo 4.
È esattamente ciò che succede in una rete convoluzionale, dove impilando i livelli ogni neurone «vede» una porzione via via più grande dell’immagine: il suo campo recettivo cresce con la profondità. Sul grafo vale la stessa legge, contata in salti: con \(K\) strati, ogni nodo raccoglie informazione da tutto ciò che sta entro \(K\) passi da lui. La striscia in basso nella Fig. 32.4 mostra proprio questo salto da uno a due.
Quanti giri servono, allora? Tanti quanti i passi che separano un nodo dall’informazione che gli serve, e in una rete di citazioni o di amicizie sono pochi: se ognuno ha una decina di amici, in due giri se ne sono già sentiti un centinaio. Andare oltre senza qualche accorgimento peggiora le cose, per il livellamento appena visto e perché una pila alta di strati è più difficile da addestrare.
Impilare \(K\) strati di GCN corrisponde ad applicare \(K\) volte l’operatore di propagazione: lo stato finale \(\mathbf{h}_v^{(K)}\) dipende da tutti i nodi \(u\) per cui esiste un cammino di lunghezza \(\le K\) fino a \(v\) (il campo recettivo a \(K\) salti, l’analogo esatto del campo recettivo che cresce con la profondità nelle CNN). Da qui due indicazioni pratiche. Primo, la profondità va scelta in base a quanti salti di distanza sta l’informazione che serve: sui grafi di citazioni come Cora bastano due o tre strati, perché il numero di nodi raggiunti cresce in fretta col grado (sui compiti in cui l’informazione sta lontana, invece, no, ed è il problema dell’over-squashing). Secondo, andare più a fondo senza accorgimenti peggiora i risultati, per due cause che si sommano e non sono facili da separare. Applicando molte volte \(\hat{\mathbf{A}}\), le rappresentazioni dei nodi di una componente connessa si avvicinano a vettori che dipendono soltanto dal grado (l’oversmoothing); e una pila profonda è difficile da addestrare di suo. Kipf e Welling, nella loro appendice sulla profondità, trovano il risultato migliore a due o tre strati e vedono l’addestramento farsi difficile oltre i sette senza connessioni residue [KW17].

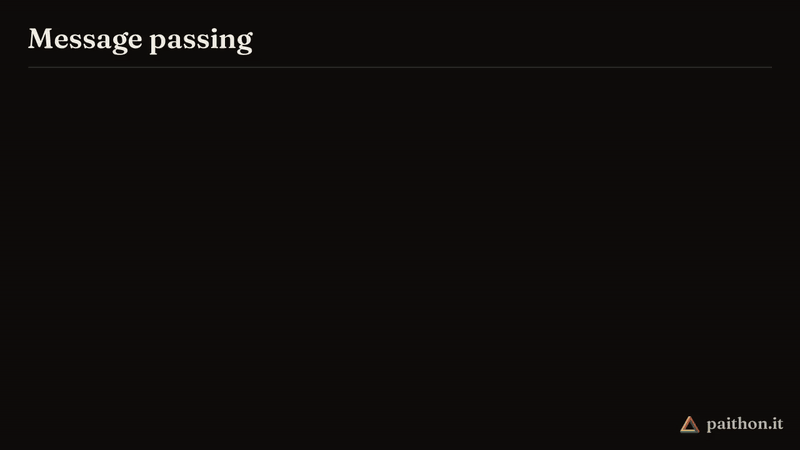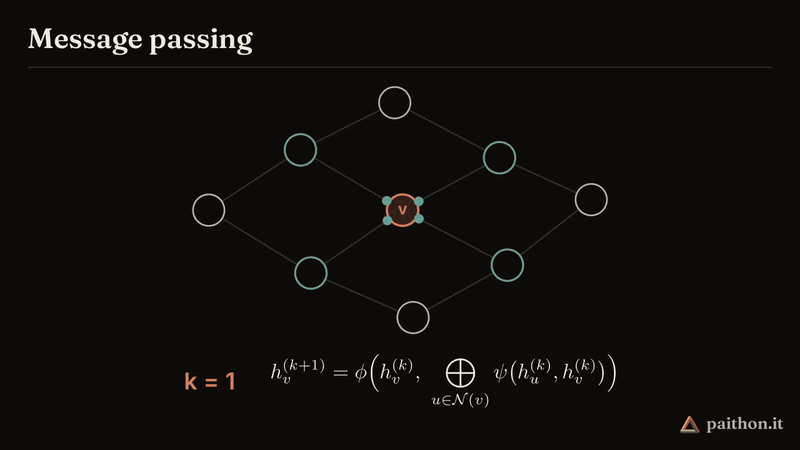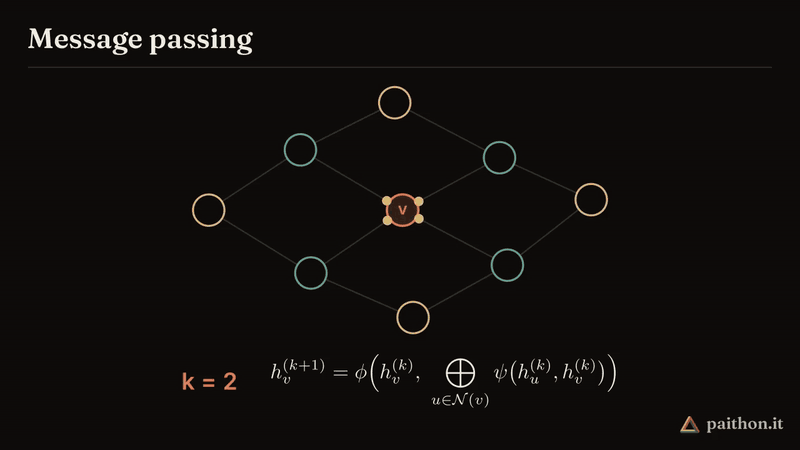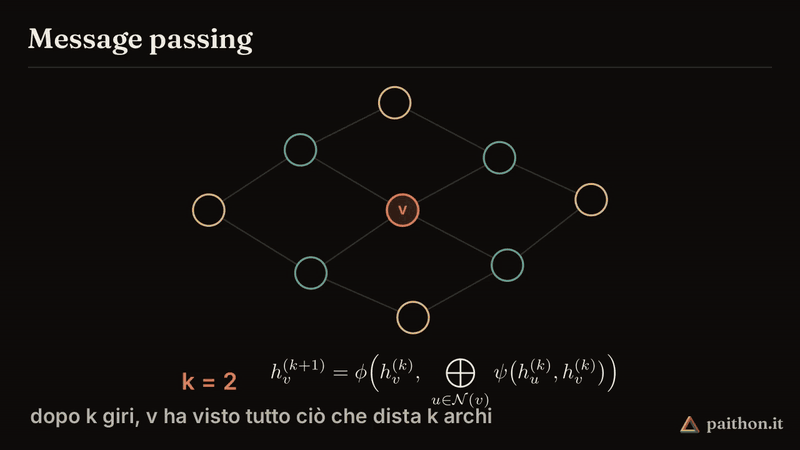
Fig. 32.5 Il campo recettivo che si allarga: al giro \(k=1\) arrivano a \(v\) solo i vicini diretti; al giro \(k=2\) i messaggi partono dai nodi a due salti, passano per i vicini e arrivano anch’essi.#
La Fig. 32.5 rende evidente il punto che rende delicata la profondità: l’informazione lontana non salta, transita. Ogni strato in più la fa passare per un altro nodo, che la mescola con la propria, ed è proprio questa mescolanza ripetuta a produrre, alla lunga, l’oversmoothing.
Addestrare: classificare i nodi con poche etichette#
Con lo schema in mano, addestrare una GCN non richiede niente di nuovo: si misura quanto la rete sbaglia, si calcola in che direzione muovere i pesi per sbagliare meno e ci si muove di un passo. Sono la loss, il gradiente e la backpropagation della sezione omonima. Cambia solo la forma del dato.
Il banco di prova classico è Cora, ed è un grafo di articoli scientifici. I nodi sono circa 2700 articoli e gli archi le citazioni: c’è un arco ogni volta che un articolo ne cita un altro, e in tutto sono circa 5400. Su ogni nodo c’è una fila di 1433 numeri, che dice quali parole compaiono nell’articolo. Il compito è assegnare a ciascun articolo una di 7 categorie tematiche.
La particolarità è che conosciamo l’argomento di pochissimi articoli (nella versione standard di Cora appena 20 per categoria, 140 nodi in tutto su 2700) e vogliamo indovinare quello di tutti gli altri. Come si fa con così poche risposte in mano? Sfruttando i collegamenti: un articolo tende a citare articoli del suo stesso campo. Lungo le citazioni scorrono le parole degli articoli, e dopo due giri ogni articolo porta addosso anche un po’ di quelli che cita; le venti risposte per categoria servono a insegnare alla rete che cosa cercare in quel miscuglio. È come indovinare gli hobby di una comitiva conoscendone solo alcuni: chi frequenta i patiti di scacchi, probabilmente gioca a scacchi anche lui.
Il trucco è che, pur pagando solo gli errori sui 140 articoli di cui sappiamo la risposta, per rispondere su quei 140 la rete ha dovuto far girare l’informazione su tutto il grafo. Aggiustandosi per i 140, quindi, migliora la fila di numeri di tutti: anche quella degli altri articoli, più di duemilacinquecento, su cui non le abbiamo mai detto se aveva ragione. Un apprendimento che parte da poche risposte e tanta struttura si chiama semi-supervisionato.
Formalmente è node classification semi-supervisionata in regime transduttivo: il grafo intero, feature comprese, è visibile in addestramento, ma solo un piccolo insieme \(\mathcal{V}_{\text{train}}\) di nodi è etichettato. Una GCN a due strati produce i logit per tutti i nodi,
e la loss è la cross-entropia calcolata sui soli nodi etichettati:
dove \(y_{vc}\) è l’etichetta one-hot del nodo \(v\) per la classe \(c\) e \(C\) il numero di classi. Il punto sottile è che \(\mathbf{z}_v\) dipende, tramite \(\hat{\mathbf{A}}\), dalle feature dell’intero vicinato a due salti: il gradiente di \(\mathcal{L}\) fluisce quindi indietro anche attraverso nodi non etichettati, che partecipano all’addestramento pur senza comparire nella somma. Nel loro articolo Kipf e Welling riportano su Cora l’\(81{,}5\%\) di accuratezza contro il \(75{,}7\%\) del miglior metodo che confrontano (e \(80{,}1 \pm 0{,}5\%\) su divisioni casuali dei dati, invece che su quella standard): un salto ottenuto con appena due strati, \(140\) nodi etichettati e pochi secondi di addestramento, che insieme alla semplicità del modello ha fatto della GCN il termine di paragone dei lavori successivi.
Uno strato GCN in PyTorch#
Tradurre la regola \(\mathbf{H}^{(l+1)} = \sigma(\hat{\mathbf{A}}\,\mathbf{H}^{(l)}\,\mathbf{W}^{(l)})\) in codice richiede poche righe. Uno strato è una trasformazione lineare seguita dal prodotto con l’adiacenza normalizzata, precalcolata una volta sola:
import torch
import torch.nn as nn
import torch.nn.functional as F

class GCNLayer(nn.Module):
    def __init__(self, in_dim, out_dim):
        super().__init__()
        self.lin = nn.Linear(in_dim, out_dim, bias=False)  # la matrice W

    def forward(self, H, A_hat):
        # H: (N, in_dim) stati dei nodi; A_hat: (N, N) adiacenza normalizzata
        return A_hat @ self.lin(H)  # Â (H W)

class GCN(nn.Module):
    def __init__(self, in_dim, hid, n_classi):
        super().__init__()
        self.gc1 = GCNLayer(in_dim, hid)
        self.gc2 = GCNLayer(hid, n_classi)

    def forward(self, H, A_hat):
        H = F.relu(self.gc1(H, A_hat))  # primo strato + ReLU
        H = self.gc2(H, A_hat)          # secondo strato: logit per nodo
        return H
L’addestramento è un normale ciclo di discesa del gradiente, con l’unico accorgimento di mascherare la loss sui soli nodi etichettati. Per vederlo girare senza scaricare Cora basta un grafo inventato: duecento nodi in due comunità da cento, con archi fitti dentro ciascuna e radi fra l’una e l’altra, sedici feature appena spostate secondo la comunità, e cinque etichette note per comunità. Lo stesso addestramento si fa due volte, con \(\hat{\mathbf{A}}\) e con la matrice identità al suo posto, cioè con ogni nodo che ascolta soltanto sé stesso: è la stessa rete, privata del grafo. L’esperimento si ripete con tre semi, perché il grafo, le feature e i pesi iniziali sono sorteggiati, e da un’estrazione sola non si capisce se l’ordine regge.
def prova(modello, X, A_in, y, mask_train):
    opt = torch.optim.Adam(modello.parameters(), lr=0.01, weight_decay=5e-4)
    for epoca in range(200):
        opt.zero_grad()
        logit = modello(X, A_in)                                  # tutti i nodi
        loss = F.cross_entropy(logit[mask_train], y[mask_train])  # etichettati
        loss.backward()                          # backprop su tutto il grafo
        opt.step()
    pred = modello(X, A_in).argmax(1)
    return (pred[~mask_train] == y[~mask_train]).float().mean().item()

N, n_feat = 200, 16
scarti = []
for seme in (0, 1, 2):
    torch.manual_seed(seme)
    # due comunità da 100 nodi: un arco è più probabile dentro che fuori
    y = torch.arange(N) // 100
    P = torch.where(y[:, None] == y[None, :], 0.08, 0.005)
    A = torch.triu((torch.rand(N, N) < P).float(), diagonal=1)
    A = A + A.T
    X = torch.randn(N, n_feat) + 0.3 * y[:, None].float()  # poco informative
    A_t = A + torch.eye(N)
    gradi = A_t.sum(1)
    A_hat = A_t / torch.sqrt(gradi[:, None] * gradi[None, :])
    mask_train = torch.zeros(N, dtype=torch.bool)
    mask_train[[0, 1, 2, 3, 4, 100, 101, 102, 103, 104]] = True  # 5 a testa

    con = prova(GCN(n_feat, 16, 2), X, A_hat, y, mask_train)
    senza = prova(GCN(n_feat, 16, 2), X, torch.eye(N), y, mask_train)
    scarti.append(con - senza)
    print(f"seme {seme}: con il grafo meglio che senza -> {con > senza}")

print("vantaggio di almeno venti punti su tutti e tre:", min(scarti) > 0.20)
seme 0: con il grafo meglio che senza -> True
seme 1: con il grafo meglio che senza -> True
seme 2: con il grafo meglio che senza -> True
vantaggio di almeno venti punti su tutti e tre: True
Su tutti e tre i semi la rete che usa il grafo indovina più nodi di quella che non lo usa, e di oltre venti punti percentuali; le cifre esatte cambiano con il seme e con il processore, l’ordine no. Dieci etichette su duecento nodi bastano perché lungo gli archi, fitti dentro le comunità, ogni nodo riceve le feature di molti suoi simili, e la media di molte feature rumorose è molto meno rumorosa di una sola. (Kipf e Welling, su Cora, aggiungono il dropout e regolarizzano soltanto il primo strato: qui non serve.)
In pratica non serve scrivere lo strato a mano: la libreria PyTorch
Geometric offre GCNConv, che aggiunge i cappi e applica la normalizzazione
simmetrica al volo. Al posto della matrice \(\hat{\mathbf{A}}\) intera prende il
grafo in un formato compatto, edge_index, che è la sola lista degli archi (di
forma (2, num_archi)). È l’unica strada praticabile sui grafi grandi, dove
\(\hat{\mathbf{A}}\) per intero non entrerebbe in memoria:
from torch_geometric.nn import GCNConv

conv = GCNConv(in_channels=1433, out_channels=16)
# forward: conv(x, edge_index), con x di forma (N, 1433)
La GCN, però, tratta tutti gli archi allo stesso modo: ogni collegamento porta un peso solo, fissato dai gradi, e una ricetta sola vale per tutti. È giusto quando gli archi dicono tutti la stessa cosa (cita, è amico di, è legato a), e non lo è più quando ciascun arco porta scritto sopra un verbo diverso: la sezione sui knowledge graph comincia da lì. Restano poi due domande che la GCN lascia aperte (che cosa fare se i vicini sono troppi per guardarli tutti, e se alcuni contano più di altri), e le affronta la sezione su GraphSAGE e GAT, con il campionamento dei vicini e i pesi di attenzione.
Da ricordare
Il passaparola (message passing) aggiorna ogni nodo in tre mosse, ripetute a ogni giro: ogni vicino passa un bigliettino con quello che sa, i bigliettini si riassumono in un modo che non guarda l’ordine (somma, media, massimo) e il nodo riscrive la propria scheda unendo il riassunto a quello che già sapeva di sé. È lo schema generale, valido per quasi tutte le reti su grafo [GSR+17].
La GCN [KW17] è la versione più usata: la raccolta dei bigliettini segue la rubrica di chi è collegato a chi, in cui ogni nodo figura anche come vicino di sé stesso per non dimenticare la propria scheda; poi una ricetta di riscrittura uguale per tutti i nodi (sono i numeri che la rete impara) e un ritocco finale non lineare.
I bigliettini si pesano invece di sommarli e basta: chi ha tanti vicini non deve coprire la voce degli altri, e il peso di ogni collegamento si spartisce fra chi parla e chi ascolta, secondo quanti vicini ha ciascuno dei due. Serve anche a tenere i valori sulla stessa scala giro dopo giro.
Anche su un grafo si può parlare di frequenze: bassa se nodi collegati portano valori simili, alta se lungo ogni collegamento il valore salta. Un giro di GCN è un filtro che attenua le alte, cioè smussa le differenze fra vicini; e la sua formula è ciò che resta, dopo aver tagliato il superfluo, dei filtri che si usano sui suoni e sulle immagini [DBV16].
Ogni strato in più allarga l’orecchio di un salto: con due giri arrivano gli amici degli amici, con tre quelli ancora dopo, come in una rete per immagini il campo visivo di un neurone cresce con la profondità. Ma smussando a ogni giro, troppi giri cancellano le differenze e i nodi diventano indistinguibili (è l’oversmoothing, la classe in cui tutti copiano dal compagno di banco finché i compiti si somigliano tutti): è quello che il metodo fa per costruzione, non un errore di programmazione. E una pila alta di strati è anche più difficile da addestrare.
L’addestramento tipico è indovinare la categoria di tutti i nodi conoscendola per pochissimi (Cora): si pagano solo gli errori su quei pochi, ma per rispondere la rete ha dovuto far girare l’informazione su tutto il grafo, e così impara a rappresentare bene anche gli altri.
Da ricordare
Il message passing aggiorna ogni nodo in tre mosse ripetute a ogni strato: calcola i messaggi dei vicini, li aggrega con una funzione invariante all’ordine (somma, media, max) e aggiorna lo stato del nodo. È il telaio generale delle MPNN [GSR+17].
La GCN [KW17] è l’istanza più usata: \(\mathbf{H}^{(l+1)} = \sigma(\hat{\mathbf{A}}\,\mathbf{H}^{(l)}\,\mathbf{W}^{(l)})\) con \(\hat{\mathbf{A}} = \tilde{\mathbf{D}}^{-1/2}\tilde{\mathbf{A}}\tilde{\mathbf{D}}^{-1/2}\) e \(\tilde{\mathbf{A}} = \mathbf{A}+\mathbf{I}\).
Normalizzare impedisce ai nodi ad alto grado di dominare e tiene gli autovalori in \([-1,1]\), stabilizzando le scale attraverso gli strati: vale però per entrambe le forme, quella per righe e quella simmetrica, che sono matrici simili e hanno lo stesso spettro. La GCN sceglie la simmetrica perché \(\hat{\mathbf{A}}\) è autoaggiunta, quindi ha autovettori ortonormali, ed è questo a rendere lecita la lettura spettrale da cui la formula discende (filtri di Čebyšëv, [DBV16]).
Sul grafo le frequenze hanno un senso preciso: un segnale è a bassa frequenza se nodi collegati portano valori simili, e gli autovalori del laplaciano le misurano. Una convoluzione spettrale con un moltiplicatore per frequenza costa \(O(N^3)\) per diagonalizzare e \(O(N^2)\) per ogni filtraggio, con \(O(N)\) parametri legati a quel grafo; troncarla a un polinomio di Čebyšëv di grado \(K\) la porta a \(O(K|E|)\) e la rende \(K\)-localizzata, e il caso \(K=1\) con \(\lambda_{\max}\approx 2\) è la GCN.
Impilare \(K\) strati dà a ogni nodo un campo recettivo a \(K\) salti, l’esatto analogo della profondità nelle CNN. Ma uno strato GCN è un filtro passa-basso, e applicarlo molte volte lascia sopravvivere solo l’autovettore dominante di \(\hat{\mathbf{A}}\): è l’oversmoothing, che per l’operatore lineare è algebra e per la rete intera, con i pesi e le non linearità, un teorema con le sue condizioni. Lo misura l’energia di Dirichlet normalizzata, che tende a zero; e il calo di accuratezza in profondità ha anche un’altra causa, la difficoltà di addestrare una pila alta.
L’addestramento tipico è la classificazione dei nodi semi-supervisionata (Cora): cross-entropia sui soli nodi etichettati, ma gradienti che fluiscono su tutto il grafo, con la solita discesa del gradiente.