


Da frase a frase: tradurre con le reti#
Prova a tradurre parola per parola: «Il gatto nero salta sul muro» diventerebbe «The cat black jumps on the wall», e un inglese storcerebbe il naso, perché l’aggettivo va prima del nome: «The black cat jumps on the wall». Sei parole sono diventate sette, e due si sono scambiate di posto. La traduzione prende il senso di una sequenza e lo riscrive in un’altra sequenza, invece di sostituire una parola per volta: di lunghezza diversa e con un ordine diverso.
La traduzione automatica è il compito su cui le reti ricorrenti dei modelli di sequenza sono state messe alla prova più a fondo, ed è su questo compito che, fra il 2014 e il 2017, nasce il meccanismo di attenzione, il passaggio che porta al capitolo sui Transformer.
Scommettere sulla prossima parola#
Prima di tradurre, un modello deve saper parlare la lingua d’arrivo. Lo strumento è il modello di linguaggio che conosciamo dalla sezione sugli *n-gram*: un sistema che, data una sequenza di parole, assegna una probabilità alla parola successiva (la tastiera che dopo «a domani e buona» suggerisce «serata» e quasi mai «carburatore»). La novità è chi fa la scommessa: non più una tabella di conteggi, ma una rete ricorrente con la sua memoria.
«Il gatto nero salta sul…»: detto a voce, la maggior parte delle persone completa con «muro», qualcuno con «tetto» o «divano», nessuno con «marmellata». Un modello di linguaggio fa esattamente questa scommessa, ma con i numeri: «muro» 35%, «tetto» 25%, «divano» 10%, e giù fino a briciole di probabilità per le parole assurde. (Le tre percentuali sono inventate qui per far vedere l’idea: in un modello vero le calcola la rete, che si è aggiustata i conti leggendo montagne di testo.) E per giudicare una frase intera si fa lo stesso gioco parola per parola: si scommette sulla prima, poi sulla seconda sapendo la prima, poi sulla terza sapendo le prime due, fino in fondo. Quanto la frase suona giusta lo dicono tutte quelle scommesse messe insieme.
Come misurare se scommette bene? Con la stessa pagella degli n-gram, la perplessità, che viene dalla teoria dell’informazione: il numero di facce del dado che il modello sembra tirare a ogni parola. Perplessità 20 vuol dire incerto come un dado a 20 facce, perplessità 5 quasi sicuro; più bassa, meglio è, perché il modello ha ristretto le alternative. Agli estremi, chi indovina sempre ha un dado a una faccia sola e perplessità 1, chi tira a caso fra le cinquantamila parole che conosce ha perplessità cinquantamila.
Un modello di linguaggio stima la probabilità di un’intera sequenza scomponendola, con la regola della catena, in predizioni della parola successiva:
dove \(w_t\) è la parola al passo \(t\). Una RNN implementa ciascun fattore in modo naturale: lo stato nascosto \(\mathbf{h}_{t-1}\) riassume il prefisso letto fin lì, e una softmax sul vocabolario produce la distribuzione \(P(w_t = v \mid w_{<t}) = \big[\mathrm{softmax}(\mathbf{W}_{hy}\,\mathbf{h}_{t-1} + \mathbf{b}_y)\big]_v\), cioè la componente \(v\) del vettore che esce dalla softmax. L’addestramento è la cross-entropia sulla parola successiva, e la qualità si misura con la perplessità per parola, vista nella sezione sulla teoria dell’informazione e già usata per valutare i modelli n-gram:
dove \(H\) è la cross-entropia media sul testo di test. La perplessità è il numero di alternative equiprobabili tra cui il modello «esita» a ogni passo: un modello perfetto avrebbe \(\mathrm{PP}=1\), uno che tira a caso su un vocabolario di \(50\,000\) parole avrebbe \(\mathrm{PP}=50\,000\).
Leggere in due direzioni#
Prima di tradurre una frase bisogna leggerla tutta, e chi la legge tutta può leggerla nei due versi: è l’attrezzo che manca alla rete che, in una traduzione, legge la frase di partenza. Le RNN dei modelli di sequenza leggono da sinistra a destra. Ma il senso di una parola dipende anche da ciò che viene dopo: in «La pesca era la sua passione» e «La pesca era matura», al momento in cui leggi «pesca» non puoi ancora sapere se si parla di ami o di frutta. Lo scopri solo alla fine. Da qui un’idea degli anni Novanta [SP97]: le RNN bidirezionali.
È come rileggere un giallo conoscendo il colpevole: alla seconda lettura ogni indizio va al suo posto, perché sai già come va a finire. Una rete bidirezionale fa le due letture insieme: una cella percorre la frase da sinistra a destra, un’altra da destra a sinistra, e per ogni parola si incollano i due riassunti (quello di ciò che precede e quello di ciò che segue). Attenzione però: questo trucco vale solo per capire un testo che esiste già tutto intero. Per generare una frase non funziona: mentre scrivi, le parole future non esistono ancora; nessun giallista può rileggere il capitolo che deve ancora scrivere. Per questo chi legge la frase può essere bidirezionale, ma chi la scrive procede sempre in avanti.
Una RNN bidirezionale mantiene due catene di stati indipendenti: una in avanti, \(\overrightarrow{\mathbf{h}}_t = f(\overrightarrow{\mathbf{h}}_{t-1}, \mathbf{x}_t)\), e una all’indietro, \(\overleftarrow{\mathbf{h}}_t = f'(\overleftarrow{\mathbf{h}}_{t+1}, \mathbf{x}_t)\), con due celle \(f\) e \(f'\) che non condividono i pesi. La rappresentazione della posizione \(t\) è la concatenazione
che condensa l’intera frase vista da quella posizione: prefisso e suffisso. È lo standard per i compiti di comprensione (classificazione, NER, encoding), ma è inapplicabile alla generazione autoregressiva: al passo \(t\) la catena all’indietro richiederebbe \(x_{t+1}, \dots, x_n\), che non sono ancora stati generati. Il decoder resta quindi unidirezionale per costruzione: un vincolo di causalità che ritroveremo, sotto forma di maschera, anche nei Transformer. Ortogonale a questo è l’impilamento (stacked RNN): più strati ricorrenti sovrapposti, dove la sequenza di stati dello strato \(\ell-1\) fa da input allo strato \(\ell\), per rappresentazioni via via più astratte.
In PyTorch la lettura nei due sensi si chiede con bidirectional=True quando si
costruisce la rete. Nella stessa chiamata compare anche num_layers=2, che
impila due celle una sopra l’altra: la seconda non legge le parole, legge quello
che ha capito la prima. Sono i due modi in cui una rete ricorrente si può far
crescere, in larghezza (le due direzioni) e in altezza (gli strati), e tutti e
due cambiano le dimensioni di ciò che la rete restituisce, come mostrano le due
forme stampate:
import torch
from torch import nn

lstm = nn.LSTM(
    input_size=64, hidden_size=128,
    num_layers=2,        # due strati impilati
    bidirectional=True,  # lettura in entrambe le direzioni
    batch_first=True,
)

x = torch.randn(1, 6, 64)  # 1 frase, 6 parole ("Il gatto nero salta sul muro")
out, (h, c) = lstm(x)
print(out.shape)  # torch.Size([1, 6, 256]): 2 direzioni x 128 per ogni parola
print(h.shape)    # torch.Size([4, 1, 128]): 2 strati x 2 direzioni
torch.Size([1, 6, 256])
torch.Size([4, 1, 128])
La prima forma dice che per ognuna delle sei parole esce un vettore di 256 numeri: i 128 della lettura in avanti accostati ai 128 di quella all’indietro. Chi mette uno strato lineare sopra questa rete lo deve quindi far partire da 256 numeri, non da 128. La seconda dice che gli stati finali sono quattro, da 128 numeri ciascuno: uno per ogni coppia di strato e direzione.
Comprimere una frase in un vettore#
Torniamo alla traduzione. Nel 2014 due gruppi di ricerca arrivano, per strade loro, alla stessa architettura: due reti ricorrenti in serie, che si chiamano encoder–decoder, o seq2seq. La prima, l’encoder («chi codifica»), legge la frase di partenza \(x_1, \dots, x_n\) e non scrive niente: la riduce a un vettore di dimensione fissa, il vettore di contesto \(\mathbf{c}\), che è il suo ultimo stato nascosto, \(\mathbf{c} = \mathbf{h}_n\). La seconda, il decoder («chi decodifica»), riceve dall’encoder soltanto \(\mathbf{c}\), e da lì genera la frase d’arrivo una parola per volta.
L’idea di comprimere la frase intera in un vettore e di ricavarne la traduzione con una rete ricorrente l’avevano avuta un anno prima Nal Kalchbrenner e Phil Blunsom [KB13], con una rete convoluzionale come encoder. La forma interamente ricorrente arriva nel 2014 con due lavori. Quello di Kyunghyun Cho e colleghi a Montréal [CvMerrienboerG+14], lo stesso articolo in cui nasce la GRU, non traduce ancora da solo: usa l’encoder–decoder come aiutante di un traduttore statistico, per dare un punteggio alle coppie di frammenti di frase che quel traduttore tiene in tabella. Quello di Ilya Sutskever, Oriol Vinyals e Quoc Le a Google [SVL14] lo usa invece per tradurre da solo.
Il decoder, mentre scrive, fa esattamente quello che fa un modello di linguaggio: scommette sulla parola successiva. Con una differenza: la sua scommessa non parte dal nulla, parte dal vettore di contesto. Si dice allora che è un modello di linguaggio condizionato dalla frase di partenza, che è il modo tecnico di dire «gli è stato detto di che cosa deve parlare».

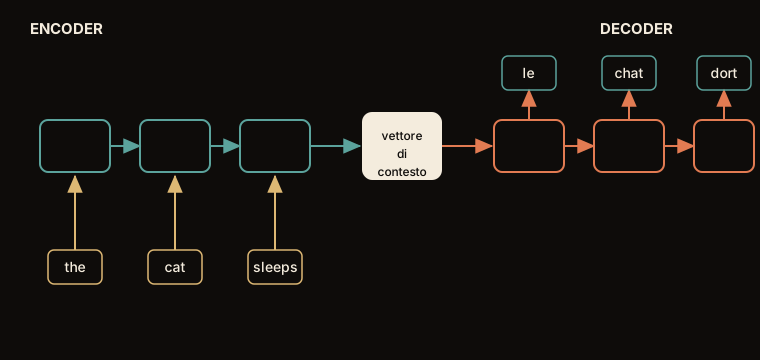
Fig. 15.17 Due reti e un vettore in mezzo, su una frase inglese tradotta in francese, il compito dell’articolo di Google. L’encoder finisce di leggere prima che il decoder cominci a scrivere: fra i due passa solo quel vettore, e nient’altro.#
Il «nient’altro» di Fig. 15.17 è il fatto da cui discende tutto il resto della storia. Quel vettore di contesto è una fila di numeri di lunghezza decisa in anticipo, mille per esempio, e resta di mille numeri sia che la frase da tradurre abbia cinque parole sia che ne abbia cinquanta: nessuno spazio in più per le frasi lunghe, per quanto ce ne sarebbe bisogno.
E c’è un dettaglio di cui l’attenzione si servirà, quindi mettiamolo a fuoco adesso. L’encoder, mentre legge, produce un riassunto dopo ogni parola: uno dopo «il», uno dopo «il gatto», uno dopo «il gatto nero», e così via fino in fondo. Sono tanti riassunti quante sono le parole, ciascuno con la sua fila di numeri. Di tutti questi, però, ne viene passato al decoder uno solo, l’ultimo. Gli altri esistono, sono già stati calcolati, e vengono buttati via.
Un interprete, a un convegno, ascolta chi parla e ripete in un’altra lingua quello che ha detto; di solito, mentre ascolta, prende appunti. Togliamogli il blocco: ascolta l’intervento intero, in italiano, lo tiene tutto a memoria e solo alla fine lo ripete in inglese. L’encoder è l’ascolto, il vettore di contesto è ciò che gli resta in testa, il decoder è la resa in inglese.
Nell’articolo di Google c’è un dettaglio curioso: far sentire all’interprete la frase al contrario («muro sul salta nero gatto Il») migliorava nettamente le traduzioni. Perché? Così l’inizio della frase, la prima cosa che dovrà dire, è l’ultima che ha sentito, ed è il ricordo più fresco. Il trucco tradisce il difetto di fondo: se la resa dipende da che cosa ha sentito per ultimo, la memoria unica è stretta. Nello stesso anno, a Montréal, chi misurò interpreti di questo tipo senza il trucco li trovò bravi sulle frasi brevi e sempre più in difficoltà man mano che il discorso si allungava, perché tutto non entra in un solo ricordo. Quello di Google, con il trucco e un cervello molto grande, reggeva anche le frasi lunghe.
«Migliorava nettamente» qualcuno l’ha dovuto misurare, e lo si fa come si corregge un compito: si mette per iscritto quello che l’interprete ha detto accanto alla versione di un traduttore in carne e ossa, e si contano le parole che coincidono, poi le coppie, le terne e le quaterne di parole consecutive, che dicono se anche l’ordine è giusto. Un interprete furbo potrebbe imbrogliare in due modi, e il correttore li para tutti e due. Chi dicesse «il il il il» avrebbe quattro parole su quattro presenti nella versione del traduttore: allora ogni parola vale al massimo quante volte compare là dentro, e le ripetizioni in più non contano. Chi dicesse due parole sole, scelte bene, avrebbe tutto giusto senza aver tradotto: allora chi resta più corto del traduttore paga una penalità, tanto più pesante quanto più è corto. Questo voto si chiama BLEU, ed è quello con cui la traduzione automatica ha fatto i conti per vent’anni. Nel 2014 le reti di Google (cinque, addestrate ciascuna per conto suo e fatte votare insieme su ogni traduzione) superano di poco il sistema statistico preso come termine di paragone, e restano sotto ai sistemi migliori dell’anno. La traduzione neurale non ha ancora vinto; ha fatto vedere che può.
Il correttore, però, è di grana grossa. Lo si fa lavorare su un pacco intero di frasi, perché i voti dei quattro conteggi si moltiplicano fra loro, e su una frase corta basta una quaterna mancata per azzerare tutto. Non conosce i sinonimi: l’interprete che dice «automobile» dove il traduttore ha scritto «macchina» perde punti pur avendo ragione. Cambia voto secondo come conta le parole (se «l’uomo» ne fa una o due), quindi due voti si confrontano solo se dati con le stesse regole e gli stessi traduttori accanto. E cerca nella versione del traduttore le parole dell’interprete, quindi castiga chi si inventa un pezzo, mentre chi salta un capoverso lo castiga poco, solo con la penalità sulla lunghezza.
Quando all’interprete si chiede un riassunto, invece, il peccato da temere è proprio saltare, e il conto si gira: si va a vedere quante parole del riassunto scritto da una persona sono finite nel suo. Questo voto si chiama ROUGE [Lin04], e da solo si fa imbrogliare dall’altro verso: chi ricopia mezzo intervento le ritrova quasi tutte, e prende il massimo. Per questo oggi i due conteggi, quello che castiga l’inventare e quello che castiga il saltare, si mettono insieme con la media armonica della sezione sulle metriche, la \(F_1\), in cui un voto basso non si può nascondere dietro un voto alto.
Il modello fattorizza la probabilità della frase di arrivo \(y = (y_1, \dots, y_m)\) data quella di partenza \(x = (x_1, \dots, x_n)\) come
dove \(y_{<i} = (y_1, \dots, y_{i-1})\), \(y_{m+1} = \texttt{</s>}\) è il token di fine frase, che rende \(P(\cdot \mid x)\) una distribuzione sulle frasi di ogni lunghezza, e \(\mathbf{c}\) è il vettore di contesto (lo stato finale dell’encoder). Ogni fattore è calcolato dal decoder, una RNN condizionata da \(\mathbf{c}\) con softmax sul vocabolario di arrivo: in Sutskever \(\mathbf{c}\) ne è lo stato iniziale, in Cho entra come ingresso a ogni passo, \(\mathbf{s}_i = f(\mathbf{s}_{i-1}, y_{i-1}, \mathbf{c})\).
I risultati che seguono si misurano in BLEU [PRWZ02], il metro con cui la traduzione automatica si è confrontata per vent’anni, e torna anche nella sezione sul dialogo. BLEU confronta la traduzione candidata con uno o più riferimenti umani contando quanti \(n\)-grammi hanno in comune, per \(n\) da 1 a 4. Due accorgimenti fanno tutto il lavoro. Il primo è il clipping: un \(n\)-gramma del candidato conta al massimo il numero di volte che compare nel riferimento, altrimenti «il il il il» otterrebbe precisione \(1\). Il secondo è la brevity penalty, \(\mathrm{BP} = \min\!\left(1,\, e^{1 - r/c}\right)\) con \(c\) la lunghezza totale in token delle traduzioni candidate del corpus e \(r\) la lunghezza di riferimento effettiva, cioè la somma, frase per frase, della lunghezza del riferimento più vicina a quella del candidato, e serve perché BLEU è fatto di sole precisioni: un termine di recall non c’è (non esiste un modo ovvio di calcolarlo su più riferimenti insieme) e senza freno la traduzione più corta sarebbe sempre la migliore. Il punteggio è
dove \(p_n\) è la precisione clippata degli \(n\)-grammi e \(w_n = 1/4\) il peso
uniforme dei quattro ordini. I limiti vanno detti subito, perché servono a
leggere i punteggi di Sutskever. BLEU è definito sul corpus e non sulla singola
frase: le \(p_n\) si accumulano su tutto il test set, e su una frase sola un
4-gramma mancante manda il punteggio a zero. Inoltre, dipende dalla
tokenizzazione e dal numero di riferimenti, tanto che due punteggi si
confrontano solo a protocollo identico. È la ragione per cui esiste
sacrebleu: Matt Post misura fino a 1,8 punti di differenza fra configurazioni
d’uso comune, e indica come prima causa la tokenizzazione e la normalizzazione
applicate ai riferimenti [Pos18]. Infine, è cieco alla parafrasi
corretta. Un punto di differenza è un segnale, non una sentenza.
Quel «un termine di recall non c’è» è la porta da cui entra il metro gemello. ROUGE [Lin04] (l’acronimo, coniato da Chin-Yew Lin, sta per Recall-Oriented Understudy for Gisting Evaluation) nasce per i riassunti, dove l’errore che conta è l’omissione. Con un riferimento la sua ROUGE-N è la stessa frazione di BLEU con il denominatore sull’altro lato:
dove \(R\) è il riassunto di riferimento, \(g_n\) i suoi \(n\)-grammi, \(\mathrm{Count}(g_n)\) quante volte \(g_n\) compare in \(R\) e \(\mathrm{Count}_{\text{match}}(g_n)\) quante di quelle occorrenze si ritrovano nel candidato. Detto a parole: BLEU conta quanti \(n\)-grammi del candidato stanno nel riferimento, ROUGE quanti \(n\)-grammi del riferimento stanno nel candidato.
La simmetria si rompe appena i riferimenti sono più d’uno, che è il caso normale. BLEU taglia il conteggio del candidato sul massimo fra i riferimenti; la ROUGE-N originale somma invece numeratore e denominatore su tutti i riferimenti, il che dà più peso agli \(n\)-grammi che compaiono in parecchi di loro, e il pacchetto dell’autore usa poi una terza ricetta ancora (il massimo delle ROUGE calcolate a coppie). Con il candidato «il gatto dorme» e i due riferimenti «il gatto dorme» e «il cane», BLEU conta \(3\) unigrammi su \(3\) (ciascuno tagliato alla sua occorrenza massima in un riferimento), la ROUGE-1 originale ne somma \(3 + 1 = 4\) su \(5\) parole di riferimento, e il massimo a coppie del pacchetto dà \(1\): nessuna delle tre formule si ottiene dall’altra scambiando un denominatore.
Accanto alla ROUGE-N si riporta quasi sempre la ROUGE-L, che al posto degli \(n\)-grammi conta la sottosequenza comune più lunga fra riferimento e candidato. Le due proprietà per cui esiste sono precise: non chiede che le parole in comune siano consecutive, quindi vede l’ordine senza pretendere la contiguità; e non chiede di fissare \(n\) in anticipo. Il prezzo è che una sottosequenza lunga si ottiene anche allungando il candidato, e per questo la si normalizza sulle lunghezze delle due sequenze prima di confrontare riassunti di taglia diversa (nel lavoro originale, dove i riassunti erano tagliati a una lunghezza fissa, quella normalizzazione era regolata per contare il solo richiamo).
E questa è la ragione per cui oggi si riportano quasi sempre le \(F_1\), cioè precisione e richiamo insieme: un richiamo puro non cala mai allungando il candidato, quindi da solo premia chi ricopia mezzo articolo.
Sutskever et al. usano LSTM a 4 strati con stati da 1000 dimensioni e riportano, sul benchmark WMT’14 (il Workshop on Machine Translation del 2014) inglese→francese, un BLEU di \(34{,}8\) (con un ensemble di cinque modelli) contro il \(33{,}3\) del sistema statistico a frasi di riferimento. Il confronto va letto per quello che è: il \(33{,}3\) è il sistema di riferimento, non lo stato dell’arte, che su quel compito stava a \(37{,}0\); la rete pura non lo raggiunge, e ci si avvicina (\(36{,}5\)) solo quando la si usa per riordinare le mille ipotesi prodotte dal sistema statistico. Nel 2014 il neurale non ha ancora vinto: la data del sorpasso è il 2016. Il trucco di invertire l’ordine delle parole sorgente è documentato nei numeri: leggere la frase al contrario fa scendere la perplessità di test da \(5{,}8\) a \(4{,}7\) e salire il BLEU da \(25{,}9\) a \(30{,}6\). Gli autori, che dichiarano di non averne una spiegazione completa, lo attribuiscono alle molte dipendenze brevi introdotte fra le prime parole di \(x\) e le prime di \(y\), che semplificano l’ottimizzazione. Ma il limite strutturale resta: qualunque sia \(n\), tutta l’informazione su \(x\) deve passare per un vettore di dimensione fissa. Con un encoder–decoder di questo tipo la qualità cala rapidamente al crescere della lunghezza della frase, come misurano nello stesso anno Cho e colleghi [CvMerrienboerBB14] (su modelli addestrati con frasi fino a trenta parole) e come mostra la curva di RNNencdec nella figura 2 di [BCB15]. La LSTM profonda di Sutskever e colleghi fa eccezione, e gli autori attribuiscono la sua tenuta sulle frasi lunghe proprio all’inversione della sorgente.
Tornare a guardare: la nascita dell’attenzione#
La soluzione è quasi contemporanea, e porta la data del settembre 2014 come il lavoro appena raccontato: la firmano Dzmitry Bahdanau, Kyunghyun Cho e Yoshua Bengio [BCB15], e nasce da una domanda tanto ovvia quanto ben posta: perché costringere il decoder a lavorare a memoria, se i riassunti intermedi ci sono già?
L’encoder calcola uno stato \(\mathbf{h}_j\) per ogni parola \(j\) della frase di partenza, e il vettore di contesto ne conserva soltanto l’ultimo. Si possono tenere tutti. A ogni parola \(i\) da produrre il decoder assegna a ciascuno stato un peso \(\alpha_{ij}\), non negativo, con somma uno sulle parole di partenza, e usa come contesto la media pesata degli stati, \(\mathbf{c}_i = \sum_j \alpha_{ij}\,\mathbf{h}_j\). Il meccanismo si chiama attenzione: i pesi dicono quali parole di partenza contano per la parola che si sta scrivendo, e si ricalcolano da capo a ogni parola prodotta.

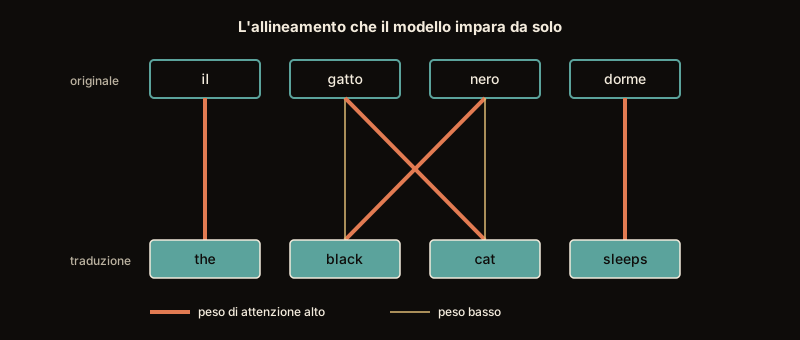
Fig. 15.18 L’allineamento che nessuno ha annotato. Le linee dicono, per ogni parola prodotta, dove il modello ha guardato: nessuno gliel’ha insegnato, si leggono a posteriori dai pesi che si è dato da solo.#
Il fatto che le due linee centrali di Fig. 15.18, nella stessa direzione dell’esempio del capitolo, dall’italiano all’inglese, si incrocino è la notizia, non un difetto: in italiano l’aggettivo segue il nome, in inglese lo precede, e il modello va a prendersi le parole fuori ordine, terza prima e seconda dopo. È la cosa che con il vettore unico non si poteva fare, e non perché fosse difficile: perché nel vettore unico l’informazione su dove stava ciascuna parola era già stata schiacciata via.

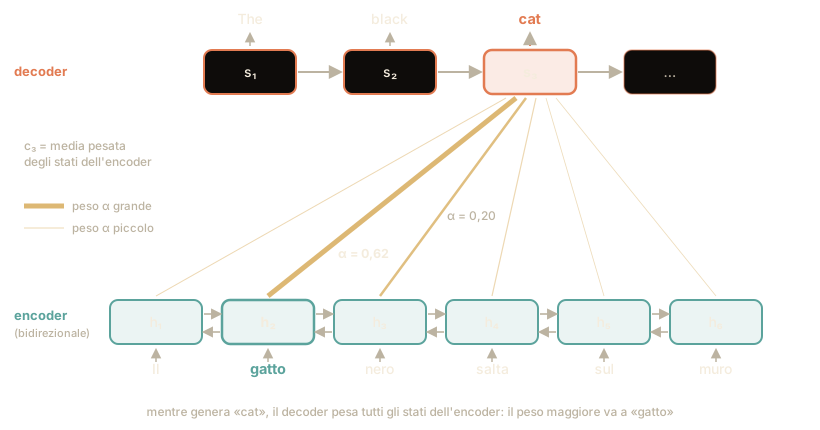
Fig. 15.19 Mentre genera «cat», il decoder (in alto, i suoi stati \(\mathbf{s}_1\), \(\mathbf{s}_2\), \(\mathbf{s}_3\)) consulta tutti gli stati dell’encoder \(\mathbf{h}_1, \dots, \mathbf{h}_6\): lo spessore di ogni freccia è il peso di attenzione, massimo su «gatto», e \(\mathbf{c}_3\) è la media pesata degli stati.#
Nella Fig. 15.19, i cui pesi sono disegnati a scopo illustrativo e non calcolati da un modello, mentre produce «cat» il decoder dà il peso più alto a «gatto» (\(0{,}62\)), un peso ancora apprezzabile a «nero» (\(0{,}20\)) e poco al resto. A ogni passo il profilo cambia: per «wall» il peso maggiore andrà su «muro».
(I pesi di attenzione non vanno confusi con i pesi della rete. Quelli della rete, le matrici che si imparano in addestramento, restano fissi una volta addestrato il modello; gli \(\alpha_{ij}\) invece si calcolano dall’ingresso, e cambiano a ogni parola prodotta.)
Con questo, il collo di bottiglia del vettore unico sparisce: nessuna fila di numeri di lunghezza fissa deve più contenere l’intera frase. Resta invece intatto il collo di bottiglia sequenziale dei modelli di sequenza: tutto questo si legge e si scrive in fila, un passo dopo l’altro. Due strozzature diverse: l’attenzione ne toglie una, e sarà il capitolo dopo a togliere l’altra.
Il nostro interprete adesso ha di nuovo il blocco, con un appunto per ogni parola ascoltata. Mentre traduce non recita più a memoria: per ogni parola che pronuncia ripassa tutti gli appunti e dà a ciascuno un voto, alto a quelli che gli servono in quel momento, basso agli altri. I voti si spartiscono un totale fisso, come l’attenzione di una persona: se ne dà di più a un appunto, ne resta di meno per gli altri, esattamente come quando in classe ascolti il professore e allora non senti chi ti parla da dietro. Poi mescola gli appunti in proporzione ai voti, e da quella miscela tira fuori la parola.
A dare i voti è un piccolo aiutante, che guarda un appunto e il punto in cui è arrivata la traduzione. Nessuno gli ha scritto dove guardare: durante l’addestramento ha imparato da sé che, quando sta per arrivare cat, conviene votare molto «gatto». Il prezzo è che a ogni parola tradotta gli appunti da votare sono tutti, e più il discorso è lungo, più voti servono. Sorpresa in regalo: disegnando dove cadono i voti si ottiene, quasi sempre, l’allineamento tra le parole delle due lingue («cat» ↔ «gatto», «wall» ↔ «muro») che nessuno aveva chiesto al modello di imparare. Quasi sempre, non sempre: c’è almeno una coppia di lingue su cui i voti cadono altrove e il disegno non somiglia a nessun allineamento.
L’encoder (bidirezionale, così che ogni \(\mathbf{h}_j\) rappresenti la parola \(j\) con tutto il suo contesto) produce gli stati \(\mathbf{h}_1, \dots, \mathbf{h}_n\). Al passo \(i\) il decoder, con stato \(\mathbf{s}_{i-1}\), calcola un punteggio di allineamento verso ogni posizione sorgente con una piccola rete a un solo strato nascosto:
dove \(\mathbf{W}_a\), \(\mathbf{U}_a\) e \(\mathbf{v}_a\) sono parametri appresi (è la cosiddetta attenzione additiva). I punteggi diventano pesi con una softmax, e i pesi definiscono un vettore di contesto diverso a ogni passo:
dove \(\alpha_{ij}\) è quanto il passo di decodifica \(i\) «guarda» la parola sorgente \(j\) (i pesi sommano a 1) e \(\mathbf{c}_i\) è la media pesata degli stati dell’encoder, che entra nel calcolo di \(\mathbf{s}_i\) e della parola successiva. Il costo è di \(n\) punteggi per ciascuno degli \(m\) passi di decodifica, \(O(n\,m)\) valutazioni della piccola rete: quadratico nella lunghezza quando le due frasi si somigliano, ed è il prezzo del collo di bottiglia tolto. L’anno dopo Luong, Pham e Manning [LPM15] confrontano forme più economiche del punteggio, calcolate tutte e due con lo stato corrente \(\mathbf{s}_i\) invece che con \(\mathbf{s}_{i-1}\). La prima è il prodotto scalare \(e_{ij} = \mathbf{s}_i^{\top}\mathbf{h}_j\), che chiede allo stato del decoder e agli stati dell’encoder la stessa dimensione (nel loro modello l’encoder legge in un verso solo). La seconda è la forma bilineare \(e_{ij} = \mathbf{s}_i^{\top}\mathbf{W}_a\mathbf{h}_j\), che non la chiede e dove \(\mathbf{W}_a\) è una matrice diversa da quella dell’attenzione additiva. È l’attenzione moltiplicativa, la famiglia da cui il Transformer prenderà la sua. La matrice dei pesi \(\alpha_{ij}\), visualizzata, si legge di solito come una mappa di allineamento fra le due frasi, appresa senza alcuna supervisione esplicita. Di solito e non sempre: misurata contro un allineatore automatico su sei coppie di lingue, la sovrapposizione sta fra il \(72\) e il \(78\%\) in cinque casi e crolla al \(15\%\) sul tedesco-inglese, che gli autori registrano come un caso isolato [KK17]. Chi vuole l’allineamento, e non solo l’intuizione, addestra l’attenzione con l’allineamento come bersaglio, cioè con la supervisione che qui non c’è.
È la stessa attenzione del capitolo sui Transformer, dove diventa l’architettura intera. Vediamola all’opera su tre riassunti soltanto, di tre numeri ciascuno:
riassunto |
numeri |
peso \(\alpha\) |
|---|---|---|
dopo «il» |
|
0,10 |
dopo «il gatto» |
|
0,70 |
dopo «il gatto nero» |
|
0,20 |
I pesi li ha decisi il decoder in base a ciò che gli serve in questo passo, e sono tre numeri positivi che sommano a uno (li produce una softmax, a partire da un punteggio per ogni riassunto): darne di più a uno ne toglie agli altri.
Adesso si mescola. Per la prima casella: \(0{,}10 \times 2 + 0{,}70 \times 0 +
0{,}20 \times 1 = 0{,}4\). Per la seconda: \(0{,}10 \times 0 + 0{,}70 \times 4 +
0{,}20 \times 1 = 3{,}0\). Per la terza: \(0{,}10 \times 1 + 0{,}70 \times 2 +
0{,}20 \times 0 = 1{,}5\). Il risultato è una fila di numeri nuova, 0,4 · 3,0 · 1,5, e si vede a occhio che somiglia molto al secondo riassunto e poco agli
altri: è il riassunto che il decoder aveva pesato di più. Questa operazione,
mescolare più file di numeri dando a ciascuna un peso, si chiama media pesata,
ed è il modo in cui l’attenzione legge gli stati; i pesi si calcolano a parte.
La fila che ne esce va al decoder, che la usa per scrivere la parola
successiva: al posto del solito vettore di contesto sempre uguale, ne riceve
uno fatto apposta per il passo che sta facendo.
Nel capitolo sui Transformer cambiano due cose. I punteggi da cui nascono i pesi non vengono più da una piccola rete addestrata insieme al resto, che riceve un riassunto dell’encoder e lo stato del decoder (l’attenzione additiva), ma da un prodotto scalare fra due vettori, molto più economico (l’attenzione moltiplicativa). E sparisce la ricorrenza attorno: l’attenzione, che qui è un accessorio del decoder, diventa l’intera architettura.
Addestrare il decoder: teacher forcing ed exposure bias#
Il decoder scrive una parola alla volta, e ogni parola la decide guardando quella che l’ha preceduta. Quale, però? Mentre si addestra le candidate sono due, la parola che il decoder ha appena prodotto e quella che la traduzione di riferimento ha in quel punto, e le due possono non coincidere. Prendere la seconda si chiama teacher forcing, alla lettera «imporre quella del maestro». A generazione, però, la traduzione di riferimento non c’è, e il decoder continua dalle parole che ha scritto lui, compresi i suoi errori: lo scarto fra le due situazioni si chiama exposure bias.
Per insegnarti a tradurre, il professore ha un metodo. Ti dà la frase italiana, tu scrivi la prima parola inglese, lui te la segna se è sbagliata (è da quel segno che imparerai) e poi, prima di chiederti la seconda, cancella la tua e ci mette la parola giusta; e così via fino in fondo. Ogni parola la scrivi partendo da un inizio corretto, anche quando la tua era sbagliata. Il foglio delle soluzioni è la traduzione umana che sta nei dati, e il professore è il conto che confronta la tua parola con quella.
Correggere così è anche il modo esatto di misurare quello che il professore vuole davvero: quanto è probabile che tu, lasciato fare, scriva la soluzione intera. Per scriverla tutta devi azzeccare la prima parola, poi la seconda dopo una prima giusta, poi la terza dopo due giuste, e così fino in fondo: sono proprio le domande che lui ti fa, ognuna a partire da un inizio corretto, e messe insieme misurano quella probabilità per intero, senza approssimarla.
Il metodo ha poi un vantaggio che non è la gentilezza. Il professore conosce tutte le venti domande prima che tu cominci, perché l’inizio di ognuna sta già scritto sulla soluzione; se partisse dalle tue parole, la settima domanda non saprebbe formularla finché non hai finito la sesta. Con le domande tutte pronte una macchina lavora in blocco, invece di fermarsi venti volte, ed è anche per questo che al metodo nessuno rinuncia. In una rete ricorrente, dove ogni parola aspetta comunque il riassunto di quella prima, il guadagno resta un risparmio; nel capitolo che segue, dove quell’attesa sparisce, diventa un unico passaggio per la frase intera.
Poi arriva il compito in classe, e lì nessuno cancella niente. Scrivi «The», e la seconda parola la scrivi partendo dal tuo «The». Se in quel punto il professore avrebbe messo «A», stai continuando da un inizio su cui non ti sei mai esercitato.
Da lì in poi peggiora, e questa è la parte che sorprende. Ogni parola successiva la scegli guardando una frase già sgangherata, che nell’esercizio non hai mai visto, quindi una parola storta rende più probabile che sia storta anche la successiva. Questo scarto fra come si impara e come si lavora è l’exposure bias: alla lettera «distorsione da esposizione», perché durante l’esercizio si è stati esposti solo ai testi giusti.
I rimedi che si usano sono due, e nessuno dei due lo risolve del tutto. Il primo è ammorbidire il metodo: ogni tanto il professore lascia stare la tua parola invece di correggerla, di rado all’inizio del corso e sempre più spesso man mano che migliori. Così ogni tanto ti eserciti anche a continuare da un inizio tuo.
Il secondo rimedio smette di correggere parola per parola: consegni la traduzione intera e il professore le dà un voto, con uno dei metri automatici già visti, BLEU o ROUGE, e con tutti i loro limiti. Il voto arriva alla fine e non dice quale parola fosse sbagliata, e tu impari per tentativi da una ricompensa, come nel reinforcement learning, che ha un capitolo suo. Anche così il professore non abbandona il suo metodo: comincia correggendo parola per parola, poi vota soltanto le ultime parole della frase, mentre le altre le corregge ancora una per una, e il pezzo votato si allunga finché copre tutta la frase.
Il primo rimedio ha però un buco, e si vede guardando che cosa quell’esercizio premia davvero. La parola che il professore si aspetta è sempre quella che segue sulla soluzione, qualunque cosa tu abbia scritto un attimo prima. Ma allora, per prendere il massimo dei voti, la tua frase non serve nemmeno guardarla: basta tenere il conto di quante parole sono passate e scrivere quella che, a quel punto della frase, le soluzioni mettono più spesso. Chi vince quell’esercizio può farlo ignorando quello che sta scrivendo, ed è esattamente quello che un traduttore non può fare.
Chi ha trovato il buco, però, non assolve nemmeno il metodo di partenza: anche correggere parola per parola, secondo lui, insegna a dare ragione alle soluzioni più che a scrivere frasi che suonino vere. Gli esercizi sono due, e nessuno dei due è proprio quello che si vorrebbe.
La verosimiglianza di una coppia sorgente-traduzione si fattorizza come
dove \(y_{<i}\) sono i token della traduzione di riferimento che precedono la posizione \(i\), e l’ultimo fattore è quello del token di fine frase, senza il quale la somma sulle sequenze di ogni lunghezza non farebbe uno. Massimizzarla prescrive di condizionare sul prefisso vero, e non su quello che il modello produrrebbe: il teacher forcing è la forma esatta della massima verosimiglianza su queste coppie, e non un’approssimazione adottata per comodità. Il nome è quello che gli danno Williams e Zipser [WZ89] in un contesto diverso, le reti ricorrenti addestrate in continuo, dove la pratica era già in uso.
Ne discende il guadagno computazionale. Con il prefisso vero disponibile in anticipo, tutti gli ingressi del decoder sono noti prima di cominciare, quindi cade la dipendenza dal campionamento: nessun passo deve attendere che il precedente estragga un token. Su una RNN resta la dipendenza dallo stato, cioè \(m\) passi in sequenza, e il guadagno è che le proiezioni ingresso-stato si fanno tutte insieme in un prodotto di matrici solo. Nelle architetture del capitolo seguente, dove la causalità è imposta da una maschera e non da una ricorrenza, cade anche la dipendenza dallo stato: un solo passaggio in avanti per l’intera frase.
A generazione, però, \(y_{<i}\) non esiste: al suo posto c’è \(\hat{y}_{<i}\), prodotto dal modello stesso. Il modello viene quindi interrogato su una distribuzione di prefissi che in addestramento non ha mai visto. Ranzato e colleghi [RCAZ16] battezzano lo scarto: «ci riferiamo a questa discrepanza come exposure bias, che si verifica quando un modello è esposto soltanto alla distribuzione dei dati di addestramento invece che alle proprie predizioni».
È lo stesso spostamento di distribuzione della clonazione comportamentale, che il capitolo sull’apprendimento per imitazione tratta per esteso: il decoder è una politica che imita le dimostrazioni dei dati, e a generazione visita stati, i prefissi, che le dimostrazioni non contengono. Per la clonazione comportamentale Ross e Bagnell danno il limite: un modello che sbaglia con probabilità \(\epsilon\) per passo sotto la distribuzione dei dati può accumulare, su un orizzonte di \(m\) passi, un costo \(O(\epsilon\,m^2)\) invece dell’\(O(\epsilon\,m)\) di un problema supervisionato ordinario, ed è un limite stretto [RB10]. Il meccanismo, visto da vicino: la conditional \(P_\theta(y_i \mid y_{<i}, x)\) è stimata bene dove i prefissi abbondano, cioè sul supporto dei dati; fuori di lì non c’è nessuna garanzia, perché i dati non permettono di distinguere fra ipotesi che coincidono sul supporto e divergono altrove. Un token deviante porta il modello in un contesto raro o inedito, dove sbaglia di più, il che rende più probabile il token deviante successivo. La popolazione delle sequenze si sdoppia: quelle ancora sul supporto sbagliano al tasso misurato in addestramento, quelle uscite sbagliano molto di più, e la media fra le due peggiora finché le proporzioni si assestano.
I rimedi seguono due strade, e nessuna delle due abbandona il teacher forcing. Lo scheduled sampling di Samy Bengio e colleghi [BVJS15] interpola: a ogni token si tira una moneta e con probabilità \(1-\epsilon\) si usa \(\hat{y}_{i-1}\) al posto di \(y_{i-1}\), con \(\epsilon\) portato da 1 verso 0 lungo l’addestramento (non lungo la frase), cioè un curriculum. MIXER, di Ranzato e colleghi, ottimizza la metrica di valutazione con il gradiente di policy di REINFORCE, ma parte da un modello già addestrato con l’entropia incrociata, tiene le due perdite mescolate e sposta il confine fra le due un pezzo di frase alla volta. Gli autori insistono che entrambi gli ingredienti sono necessari, chiamano curriculum anche il proprio, e dichiarano di prendere idee tanto dallo scheduled sampling quanto da DAgger [RGB11], il rimedio che per l’imitazione riporta il limite a lineare in \(m\).
Il punto di rottura sta sul primo rimedio. Huszár [Huszar15] mostra che l’obiettivo dello scheduled sampling è improprio, e che il suo ottimo non è la distribuzione dei dati nemmeno nel limite di dati e capacità infiniti: il modello che lo minimizza può ignorare il contenuto del prefisso e limitarsi a contare le posizioni. La derivazione è svolta su sequenze di lunghezza due, e al caso generale il lavoro non la estende, ma la direzione è chiara. Lo stesso lavoro, va detto per intero, sostiene che anche la massima verosimiglianza sia l’obiettivo sbagliato quando lo scopo è generare testo verosimile. La tensione corre allora fra due obiettivi di cui nessuno dei due è quello che si vorrebbe davvero, e il rimedio guasto contro il metodo sano è una lettura più comoda del vero.
Quanto costi l’exposure bias si può misurare senza addestrare niente, contando quante parole il modello sbaglia quando riparte ogni volta dall’inizio giusto e quante quando continua dalle sue. Serve una lingua giocattolo di dieci parole, numerate da 0 a 9, in cui l’unica frase legale è contare: dopo lo 0 viene 1, dopo il 7 viene 8, dopo il 9 si ricomincia da 0. E serve un modello che, come i decoder veri, guardi due parole per scegliere la terza, mentre a questa lingua ne basterebbe una: è questa sovrabbondanza a creare coppie di parole che i dati non contengono mai, come «3 7». Sulle coppie che i dati contengono il modello sbaglia una volta su cento; sulle altre tira a caso fra le dieci parole. La regola, là, varrebbe identica: sono i dati a non dire quale regola sia. Nei dati, dopo «3 4» viene sempre «5», che è insieme la parola dopo il 4 e la seconda dopo il 3; le due regole si separano solo su una coppia come «3 7», dove la prima direbbe «8» e la seconda «5», e quella coppia nei dati non c’è. Le ultime due righe stampate sono la controprova: lo stesso conto con un modello che quelle coppie le sappia continuare.
import numpy as np

V, T, N = 10, 60, 20000   # 10 parole, frasi lunghe 60, 20000 frasi per volta
FUGA = 0.01               # sulle coppie che i dati contengono sbaglia 1 su 100

def modello(sa_continuare_fuori):
    """Le probabilità della parola dopo, dato il paio che precede."""
    M = np.full((V, V, V), 1.0 / V)      # coppie mai viste: il modello tira a caso
    for a in range(V):
        coppie = range(V) if sa_continuare_fuori else [(a + 1) % V]
        for b in coppie:
            M[a, b] = FUGA / (V - 1)
            M[a, b, (b + 1) % V] = 1 - FUGA
    return M.cumsum(axis=2)

def scrivi(cum, da_se, seme=20260830):
    """N frasi; se `da_se` è falso, prima di ogni parola torna l'inizio giusto."""
    rng = np.random.default_rng(seme)
    seq = np.zeros((N, T), dtype=int)
    seq[:, 1] = 1
    scritte = np.zeros((N, T), dtype=int)
    for t in range(2, T):
        a, b = (seq[:, t-2], seq[:, t-1]) if da_se else ((t-2) % V, (t-1) % V)
        scelta = (cum[a, b] < rng.random(N)[:, None]).sum(axis=1).clip(0, V - 1)
        scritte[:, t] = scelta
        seq[:, t] = scelta if da_se else t % V
    return seq, scritte

reale = modello(False)
_, con_soluzione = scrivi(reale, da_se=False)
libere, _ = scrivi(reale, da_se=True)
ideali, _ = scrivi(modello(True), da_se=True)
ok_sol = con_soluzione[:, 2:] == np.arange(2, T) % V
ok_lib = libere[:, 2:] == (libere[:, 1:-1] + 1) % V
ok_ide = ideali[:, 2:] == (ideali[:, 1:-1] + 1) % V

print("parola  con la soluzione   da sé   da sé, sulle frasi ancora intatte   frasi intatte")
for t in (0, 8, 28, 57):
    intatte = ok_lib[:, :t].all(axis=1)      # nessun errore prima di questa parola
    print(f"{t+2:6}{100*ok_sol[:, t].mean():16.1f}%{100*ok_lib[:, t].mean():8.1f}%"
          f"{100*ok_lib[intatte, t].mean():36.1f}%{100*intatte.mean():16.1f}%")

print()
print("controprova, con un modello che sappia continuare anche fuori strada:")
print("  da sé      " + "  ".join(f"{100*ok_ide[:, t].mean():.1f}%" for t in (0, 8, 28, 57)))
print("  frasi intatte " + "  ".join(
    f"{100*ok_ide[:, :t].all(axis=1).mean():.1f}%" for t in (0, 8, 28, 57)))
parola  con la soluzione   da sé   da sé, sulle frasi ancora intatte   frasi intatte
     2            98.9%    98.9%                                98.9%           100.0%
    10            99.1%    94.2%                                99.1%            92.1%
    30            99.0%    91.2%                                99.0%            75.7%
    59            99.0%    90.9%                                99.0%            56.1%

controprova, con un modello che sappia continuare anche fuori strada:
  da sé      98.9%  99.1%  99.0%  99.0%
  frasi intatte 100.0%  92.1%  75.7%  56.1%
La prima colonna è piatta: con la soluzione accanto il modello sbaglia una parola su cento alla seconda posizione e una su cento alla cinquantanovesima, perché a ogni passo riparte da un inizio corretto. La seconda scende fino a nove errori su cento e poi si assesta lì, e la terza dice da dove viene quel calo: fra le frasi che non hanno ancora sbagliato niente, il modello continua a sbagliare una volta su cento, sempre, esattamente come in addestramento. Le frasi buone non peggiorano, diventano sempre meno, e la quarta colonna le conta: da cento su cento scendono a cinquantasei.
La controprova dice quale delle quattro colonne misuri davvero l’exposure bias, e la risposta è una sola. Con un modello che sappia continuare anche fuori strada, la seconda colonna resta al novantanove per cento a ogni posizione, mentre la quarta scende esattamente come prima, fino a quel cinquantasei: le frasi si rovinano lo stesso, perché anche un modello perfetto fuori strada sbaglia una parola su cento e in sessanta parole l’errore capita. Lo scarto fra la prima colonna e la seconda è tutto l’exposure bias, e le altre due non ne contengono niente. Il numero che l’addestramento misura è il primo; quello che descrive la macchina al lavoro è il secondo; e la distanza fra i due la fanno, per intero, le frasi su cui il modello non si è mai esercitato.
Generare la frase: greedy e beam search#
Resta un problema che finora abbiamo dato per scontato. A ogni passo il decoder non produce una parola: produce una distribuzione \(P(y_i \mid y_{<i}, x)\) su tutto il vocabolario, decine di migliaia di probabilità che sommano a uno. Per ottenere una frase serve una regola di decodifica, e la più semplice è la ricerca greedy, che a ogni passo prende la parola più probabile: come l’agente avido della sezione sui banditi, massimizza il guadagno immediato. Ma la parola migliore adesso non porta sempre alla frase migliore alla fine.
(E chi gli dice di smettere? Fra le voci del vocabolario ce n’è una che non è
una parola, ma il segnale di fine frase, lo stesso </s> incontrato con gli
n-gram. Quando il decoder sceglie quello, ha deciso che la traduzione è finita,
e ci si ferma. È una scelta come le altre, e come le altre può sbagliare: un
modello che lo tira fuori troppo presto tronca la frase, uno che non lo tira
fuori mai continua a scrivere finché qualcuno non lo interrompe.)
Un vocabolario da cinquantamila parole apre cinquantamila strade a ogni passo, e dopo dieci passi le frasi che si possono comporre sono un numero di quarantasette cifre: nessun calcolatore le percorrerà mai tutte per tenere la migliore. La frase si costruisce allora bivio per bivio, e la sola domanda è quanto guardare avanti prima di impegnarsi.
Al primo bivio i cartelli che contano sono due: «A» promette 0,50, «The» promette 0,40, e il terzo, «One», sta a 0,04 e non se lo fila nessuno. Chi ha fretta prende «A» e non torna più indietro.
Il primo cartello però non decide da solo. Una strada vale il prodotto di tutti i numeri incontrati lungo il cammino, perché sono cose che devono capitare tutte insieme, come i voti che si moltiplicavano nel filtro antispam. Al bivio dopo «A», «black» promette 0,30, e la strada «A black» vale 0,50 × 0,30 = 0,15. Dopo «The», «black» promette 0,60, e «The black» vale 0,40 × 0,60 = 0,24. La strada partita peggio è arrivata meglio.
Chi non vuole cadere nella trappola manda avanti più esploratori invece di uno, e la mossa si chiama beam search, «ricerca a fascio». Quanti mandarne si decide prima, e quel numero si chiama \(k\). A ogni bivio gli esploratori guardano tutte le strade che si aprono e tengono le \(k\) migliori; le altre si dicono potate, come i rami di un albero. Con \(k=2\) restano in piedi sia «A» sia «The», al bivio successivo si scopre che «The black» è in testa, e si prosegue di lì fino a «The black cat…».
Il confronto finale, però, ha un difetto, e si vede dai numeri dei cartelli. Sono tutti minori di uno, quindi ogni moltiplicazione rimpicciolisce il punteggio: la strada vincente vale \(0{,}40\) al primo bivio, \(0{,}24\) al secondo, \(0{,}19\) al terzo. Un cammino lungo scende sempre, anche quando sta andando benissimo. E alla fine i cammini da confrontare non sono lunghi uguali: un esploratore che imbocca il cartello di fine frase si ferma lì e lo si mette da parte, e il suo punteggio, fatto di due soli passi, batte quello di chi ha camminato per dieci. Chi confronta i totali nudi sceglie il più corto, e la traduzione esce troncata a metà.
Si rimedia mettendo i cammini sullo stesso metro: si tiene conto della lunghezza, così che a contare sia quanto vale un passo e non quanti passi ci sono. La correzione però non si fa per intero. Il gruppo di Google che ha messo la traduzione neurale in produzione era partito proprio da lì, dal valore medio di un passo, e ha trovato che le traduzioni venivano meglio compensando la lunghezza un po’ meno; la dose giusta l’ha cercata provando. Questa correzione si chiama penalità di lunghezza, e toglie alle frasi brevi un vantaggio che non si sono guadagnate.
Resta da decidere quanti esploratori mandare. Con uno solo si torna alla fretta del primo bivio. Con due, o con dieci, la strada migliore in assoluto può restare fuori lo stesso: se parte da un cartello che sembrava mediocre, è stata abbandonata lì, e nessuno torna indietro a riprenderla. Ogni esploratore in più costa un cammino da seguire fino in fondo, e la sorpresa è che oltre una certa quota la traduzione non migliora, peggiora. La penalità di lunghezza attenua il guaio delle frasi corte ma non lo toglie, perché a preferirle è il modello stesso: più esploratori si mandano, più è facile che uno trovi una frase corta che al modello piace più di tutte. Se si potessero provare proprio tutte le strade, per molte frasi quella preferita dal modello sarebbe la traduzione vuota. In traduzione di esploratori ne bastano quasi sempre una manciata, e non più di qualche decina.
Mandare esploratori a cercare la strada migliore ha senso quando una traduzione giusta c’è. In una chiacchierata o in un racconto la strada preferita dal modello è spesso la più banale, e allora gli esploratori restano a casa: la parola si tira a sorte fra quelle che i cartelli danno per buone.
Formalmente cerchiamo \(\hat{y} = \arg\max_y P(y \mid x)\), ma le sequenze possibili sono \(|V|^m\) (vocabolario \(V\), lunghezza \(m\)): la ricerca esaustiva è intrattabile e la scelta greedy è solo l’approssimazione con orizzonte 1. La beam search è una via di mezzo: a ogni passo estende le \(k\) ipotesi correnti con tutte le parole del vocabolario, ordina le sequenze per punteggio cumulato
e trattiene le migliori \(k\) (con \(k=1\) si torna alla greedy). Il costo è quello della greedy moltiplicato per \(k\), cioè in mezzo fra la greedy e la ricerca esaustiva. Non è una ricerca esatta: l’ottimo globale può sfuggire al fascio, e allargare \(k\) riduce gli errori di ricerca senza migliorare la traduzione oltre un certo punto. Koehn e Knowles misurano che «in quasi tutti i casi si trovano traduzioni peggiori oltre un’ampiezza ottima», che sulle otto coppie di lingue che provano va da \(4\) a circa \(30\). La causa è che con il fascio largo vincono le traduzioni corte [KK17]. La normalizzazione per lunghezza attenua il fenomeno senza toglierlo (l’ampiezza ottima sale fra \(30\) e \(50\), ma oltre la qualità cala ancora). È un risultato che va letto per quello che dice, e lo dice per intero una ricerca esatta: Stahlberg e Byrne trovano che per il \(51{,}8\%\) delle frasi del test WMT’15 inglese→tedesco la traduzione di punteggio massimo, per un Transformer base, è quella vuota [SB19]. A sbagliare è l’obiettivo, perché il massimo del modello premia il troppo corto, e un fascio stretto ripara senza volerlo l’errore del modello. Un dettaglio pratico: essendo una somma di logaritmi negativi, il punteggio penalizza le frasi lunghe, e il decoder tenderebbe a traduzioni troppo corte. Si corregge con una length penalty, per esempio dividendo il punteggio per \(|y|^{\alpha}\) con \(\alpha \approx 0{,}6\)–\(0{,}7\). Il sistema di traduzione di Google [WSC+16] parte proprio da questa euristica e la sostituisce poi con una variante appena più elaborata, \(lp(y) = \frac{(5+|y|)^{\alpha}}{6^{\alpha}}\), dove l’esponente agisce su \((5+|y|)\) e non su \(|y|\): per questo il valore che gli autori usano, \(\alpha = 0{,}2\), non è confrontabile con lo \(0{,}6\)–\(0{,}7\) dell’euristica di partenza, ed è da tenere a mente prima di citare «l’\(\alpha\) di GNMT». Alla correzione di lunghezza affiancano poi un secondo termine, che premia le traduzioni i cui pesi di attenzione hanno coperto tutte le parole di partenza.
La ricerca del massimo ha senso quando c’è una traduzione giusta da avvicinare. Nella generazione aperta (il dialogo, il racconto) è la scelta sbagliata, per lo stesso motivo: il massimo del modello è spesso generico o ripetitivo, e si campiona invece dalla distribuzione, con la temperatura e con i tagli top-\(k\) e top-\(p\) della sezione sui grandi modelli linguistici.

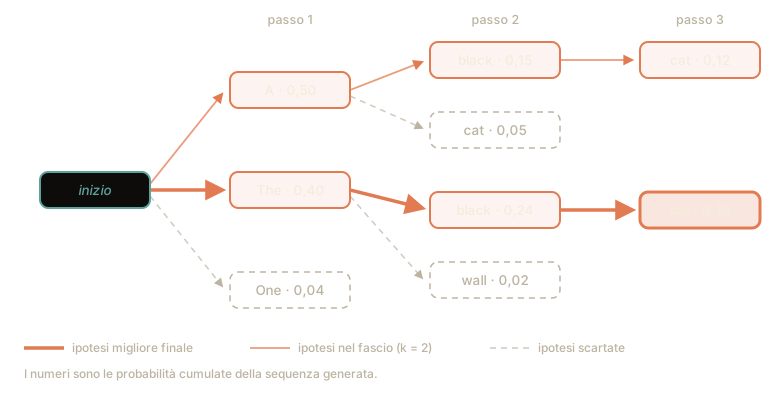
Fig. 15.20 Beam search con \(k=2\) sull’esempio del testo. Ogni numero è il punteggio della strada intera fino a lì, cioè il prodotto di tutte le probabilità incontrate lungo il cammino. La greedy si sarebbe fermata su «A» al primo passo; il fascio recupera «The black cat».#
In Fig. 15.20 i rami in terracotta sono le due strade tenute aperte, quelli grigi tratteggiati i rami potati: il ramo spesso è la traduzione che la strategia ingorda non avrebbe mai trovato.
2016: la traduzione neurale entra in produzione#

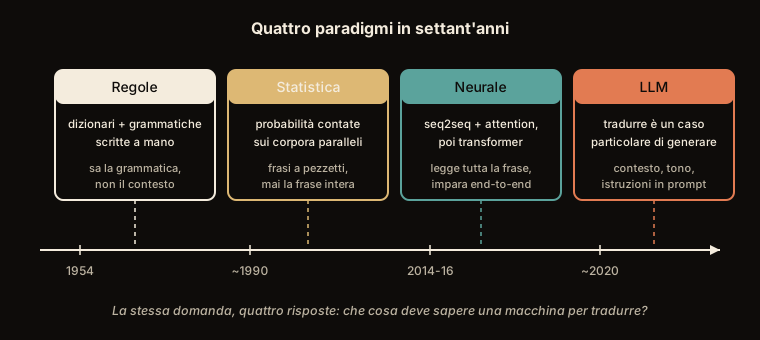
Fig. 15.21 Quattro modi di tradurre, in settant’anni. A ogni passaggio si sposta chi fornisce la conoscenza della lingua: prima il linguista che scrive le regole, poi una montagna di testi già tradotti da esseri umani (un romanzo e la sua traduzione, gli atti di un parlamento in due lingue), poi un modello addestrato apposta, infine un modello che non era stato pensato per questo.#
L’ultimo passaggio di Fig. 15.21 è il più singolare, e lo racconta il capitolo sui Transformer: la traduzione ha smesso di essere un compito con un’architettura propria ed è diventata una delle cose che un modello generalista sa fare. Qui però siamo alla terza tappa, ed è quella che ha portato la traduzione neurale in produzione.
Nel settembre 2016 Google annuncia GNMT (Google Neural Machine Translation) [WSC+16], un encoder–decoder con attenzione costruito sulla ricetta appena vista, con le aggiunte che servono a farlo reggere in grande: encoder e decoder sono pile di otto strati LSTM legati da connessioni residue, e le parole sono spezzate in pezzi più piccoli, i wordpiece. L’idea dell’impilamento è che il primo strato legge le parole, il secondo legge quello che ha capito il primo, e così via, ogni piano un po’ più astratto del precedente.
GNMT prende il posto del sistema statistico che alimentava Google Translate, uno che traduceva a pezzi di frase imparando da grandi raccolte di testi già tradotti da persone quali gruppi di parole si scambiano con quali. Si parte dalla coppia cinese→inglese, circa 18 milioni di traduzioni al giorno.
Il confronto con il vecchio sistema lo fanno delle persone, e non un punteggio calcolato da un programma (l’articolo riporta anche il BLEU sui banchi di prova pubblici). Per ogni frase i valutatori danno un voto da 0 a 6 a tre traduzioni messe fianco a fianco: quella del sistema statistico, quella di GNMT e quella di un traduttore umano che conosce bene le due lingue. GNMT recupera fra il 58% (inglese→cinese) e l’87% (inglese→spagnolo) della distanza fra il sistema statistico e il traduttore umano, a seconda della coppia di lingue. Gli autori la chiamano riduzione degli errori, e nell’abstract la riassumono in un 60% medio. La misura vale per le frasi su cui è fatta: 500 per coppia di lingue, isolate, prese da Wikipedia e da siti di notizie, e che gli autori stessi definiscono semplici. Da quel momento le reti ricorrenti che abbiamo studiato traducono ogni giorno per un servizio di massa, e non sono le sole: altri sistemi neurali entrano in produzione negli stessi mesi [KK17].
Questa storia ha anche un seguito, che la sezione sui modelli multilingue riprende per intero. Pochi mesi dopo, invece di un modello per coppia di lingue, lo stesso gruppo ne addestra uno solo su tutte le coppie insieme, e scopre che traduce anche fra due lingue che non ha mai visto appaiate [JSL+17]: è un indizio che dentro una rete addestrata su molte lingue si formi qualcosa di simile a una lingua franca interna.
Il passo successivo arriva nel 2017 [VSP+17]. Se l’attenzione collega direttamente ogni parola generata a tutte le parole di partenza, lo stato che scorre passo dopo passo non serve più, e una rete di sola attenzione si addestra in parallelo sull’intera frase: è l’architettura del capitolo sui Transformer.
Prima di arrivarci restano tre compiti in cui la frase non si traduce in un’altra lingua: assegnare un’etichetta a ogni parola (etichettatura di sequenze), ricostruire la struttura della frase (sintassi e parsing) e sostenere una conversazione (dialogo e chatbot). La loro storia comincia prima di quella delle reti neurali, e per raccontarla si torna indietro di qualche decennio.
Da ricordare
Un modello di linguaggio scommette sulla parola successiva, e la sua pagella è la perplessità: quante facce ha il dado con cui esita a ogni passo. Più è bassa, più il modello ha ristretto le alternative.
Le RNN bidirezionali rileggono la frase nei due sensi insieme, come un giallo di cui si conosce già il colpevole: preziose per capire un testo che esiste tutto intero, inutilizzabili per scriverne uno, perché mentre si scrive le parole future non ci sono ancora.
Seq2seq è l’interprete senza appunti: una rete (l’encoder) ascolta l’intera frase di partenza e la tiene in un unico ricordo, una seconda (il decoder) la ridice nell’altra lingua partendo da lì. Se la frase è lunga, in quel ricordo non ci sta tutto: è il collo di bottiglia.
L’attenzione di Bahdanau restituisce all’interprete i suoi appunti, uno per parola ascoltata: per ogni parola che pronuncia dà a ciascun appunto un voto, e i voti si spartiscono un totale fisso; poi mescola gli appunti in proporzione ai voti. Dove guardare nessuno gliel’ha insegnato, e quasi in regalo si ottiene l’allineamento fra le parole delle due lingue (quasi: su qualche coppia di lingue i voti cadono altrove). È la stessa idea che nei Transformer diventerà protagonista.
Mentre impara, il decoder riparte dopo ogni parola da quella giusta invece che dalla propria (teacher forcing), e per questo tutte le domande della frase sono note in anticipo, il che fa risparmiare molto lavoro. Quando poi lavora da sé quella correzione non c’è, e da un inizio sbagliato continua come non si è mai esercitato a fare: nella lingua giocattolo di dieci parole sbaglia nove parole su cento dove in addestramento ne sbagliava una, ed è lì, in quello scarto, che sta tutto il danno. Le frasi ancora senza errori continuano invece a sbagliarne una su cento, e quel nove è la media fra loro e quelle già uscite di strada. Si rimedia lasciandogli ogni tanto la propria parola già mentre impara, oppure dandogli un voto sulla traduzione intera; il primo rimedio però si può vincere ignorando quello che si è appena scritto, che è la cosa che un traduttore non può fare.
Prendere ogni volta la parola più probabile è miope, perché la strada che parte peggio può arrivare meglio: la beam search tiene aperte le poche strade più promettenti e decide qualche passo più avanti, con una correzione per la lunghezza che attenua senza toglierla la preferenza del modello per le frasi corte. Per questo, oltre una certa quota, più esploratori danno traduzioni peggiori.
Un testo generato si giudica confrontandolo con quello di una persona, e il verso del confronto dipende da quale errore costa. In traduzione costa inventare, e si guarda quante parole della macchina stanno nella versione umana (BLEU); in un riassunto costa saltare, e si guarda quante parole della versione umana stanno in quella della macchina (ROUGE). Chi legge un punteggio senza sapere in che verso è fatto legge un numero e basta.
Nel 2016 la traduzione neurale entra in produzione con GNMT di Google; nel 2017 il Transformer manda in soffitta la lettura passo dopo passo e tiene solo l’attenzione.
Da ricordare
Un modello di linguaggio assegna probabilità alla parola successiva; la sua qualità si misura con la perplessità \(2^H\): il numero di alternative equiprobabili tra cui esita a ogni passo.
Le RNN bidirezionali leggono la frase nei due sensi: preziose per capire, inutilizzabili per generare (il futuro non esiste ancora: il decoder è unidirezionale per costruzione).
Seq2seq: un encoder comprime la frase sorgente in un vettore di contesto, un decoder la riscrive nell’altra lingua. Il vettore fisso è un collo di bottiglia: la qualità dell’encoder–decoder di base cala con la lunghezza della frase (la LSTM profonda di Sutskever, con la sorgente invertita, fa eccezione).
L’attenzione di Bahdanau lo elimina: a ogni passo il decoder rivede tutti gli stati dell’encoder con pesi \(\alpha_{ij}\) appresi; è il precursore diretto della scaled dot-product attention dei Transformer.
L’addestramento condiziona su \(y_{<i}\) di riferimento (teacher forcing). È la forma esatta della massima verosimiglianza sulle coppie, token di fine frase compreso, e rende noti in anticipo gli ingressi del decoder: su una RNN restano comunque \(m\) passi in sequenza, mentre con una maschera causale il passaggio diventa uno solo. In generazione il condizionamento è su \(\hat{y}_{<i}\), cioè su prefissi fuori dal supporto dei dati. È l’exposure bias [RCAZ16], lo spostamento di distribuzione della clonazione comportamentale; si misura come scarto fra l’errore per token con prefisso vero e quello con prefisso proprio, non sulla quota di sequenze intatte, che scende uguale anche senza. Rimedi: scheduled sampling [BVJS15], il cui obiettivo è però improprio e lo stimatore inconsistente [Huszar15]; e MIXER, che mescola entropia incrociata e gradiente di policy invece di sostituirla.
In generazione la scelta greedy è miope; la beam search tiene aperte le \(k\) ipotesi migliori (con una length penalty per non penalizzare le frasi lunghe). Allargare il fascio riduce gli errori di ricerca ma oltre un’ampiezza ottima la traduzione peggiora, perché il massimo del modello premia il troppo corto [KK17], fino alla traduzione vuota [SB19]. Nella generazione aperta il massimo è generico, e si campiona.
BLEU [PRWZ02] è precisione di \(n\)-grammi con clipping, frenata dalla brevity penalty: definito sul corpus, dipendente dal protocollo, cieco alla parafrasi. Nel 2014 la rete pura (\(34{,}8\)) supera il sistema statistico di riferimento (\(33{,}3\)) ma non lo stato dell’arte (\(37{,}0\)).
Il gemello per i riassunti è ROUGE [Lin04]: un richiamo sugli \(n\)-grammi del riferimento, perché là il peccato è l’omissione. Con un riferimento solo è la frazione di BLEU col denominatore scambiato; con più riferimenti no, perché BLEU taglia sul massimo e ROUGE somma. La ROUGE-L usa la sottosequenza comune più lunga, che vede l’ordine senza pretendere la contiguità e non chiede di fissare \(n\); si riportano le \(F_1\) perché un richiamo puro premia il candidato lungo.
Nel 2016 la traduzione neurale entra in produzione con GNMT (valutazione umana su frasi semplici e isolate); nel 2017 il Transformer fa cadere la ricorrenza.