


State Space Model#
C’è un’idea che l’ingegneria usa da oltre mezzo secolo per descrivere qualunque sistema che evolve nel tempo: un termostato, la traiettoria di un razzo, un circuito elettrico. Si chiama modello a spazio degli stati (state space model, in sigla SSM): un pugno di equazioni che riassumono tutto il passato di un segnale (una grandezza che cambia nel tempo: il livello dell’acqua in una vasca, un suono, una sequenza di parole) in uno stato interno, e da quello prevedono il futuro. È la matematica del filtro di Kalman, che la NASA adottò nei primi anni Sessanta per studiare la navigazione delle capsule Apollo. Nell’intelligenza artificiale, questo modello porta allo stesso traguardo del capitolo sull’attenzione lineare: un lavoro che cresce quanto il testo e non quanto il suo quadrato, per un’altra strada.
La seconda strada si apre nell’autunno del 2021, quando Albert Gu, Karan Goel e Christopher Ré trovano il modo di far girare quelle equazioni vecchie di sessant’anni dentro uno strato di rete neurale a un costo sostenibile, e le mettono alla prova sul Long Range Arena [TDA+21], sei compiti scelti per misurare le dipendenze a lunghissimo raggio, cioè i legami fra parti lontane di una sequenza (in un giallo, per capire l’ultima pagina bisogna ricordare il nome che compariva alla prima). Le sequenze vanno da mille a sedicimila passi, dove un «passo» è un elemento della sequenza: una parola, un pixel, un campione audio (uno delle migliaia di valori al secondo con cui si registra un suono). Il loro modello, S4 [GGRe22], riesce là dove Transformer e reti ricorrenti si arrendevano, ed è il primo a risolvere il compito più lungo, quello in cui il legame da riconoscere si estende per sedicimila passi. Questa seconda strada viene da un’altra parte: dai sistemi dinamici.
Un sistema che riassume il passato#
Segui il livello dell’acqua in una vasca mentre entra ed esce di continuo. Non ti serve ricordare ogni singola goccia, ti basta un numero, quanta acqua c’è adesso. Quel numero si porta dietro tutta la storia, ed è lo stato.
Le cose che lo muovono restano sempre le stesse. Dal rubinetto entra acqua e il livello sale. Dallo scarico socchiuso ne esce, e più acqua c’è più in fretta cala, così di quello che c’era ogni minuto ne resta una frazione. Sul fianco della vasca un galleggiante muove un ago su una scala graduata, e quello che l’ago segna è la tua risposta a chi chiede. Che cosa entra, quanto resta di ciò che c’era, che cosa se ne legge, e la regola non ha altri pezzi.
Resta da scegliere ogni quanto guardare. L’acqua scorre senza interruzione, tu l’ago lo segni una volta al minuto, e di quel che è successo fra una segnatura e l’altra hai soltanto quello che riesci a ricostruire. Segnando fitto ti sfugge poco di ciò che è entrato. Segnando di rado può passare in mezzo un getto intero che non hai visto, e quello che ricostruisci esce grossolano.
Metti che dal rubinetto entrino due litri al minuto e che lo scarico porti via ogni minuto metà dell’acqua che trova. Parti da vasca vuota e segui l’ago: zero, due, tre (metà di due, più i due che entrano), 3,5, 3,75, 3,875. Il livello sale sempre più piano e si assesta sui quattro litri. Ogni getto intanto sbiadisce, e di quello entrato cinque minuti fa resta un trentaduesimo, di quello di mezz’ora fa meno di un miliardesimo.
Uno state space model fa questo con una sequenza. Dentro il modello una parola è una fila di qualche centinaio di numeri, i suoi canali, e ogni canale ha la sua schiera di vasche: qualche decina, ciascuna con il suo scarico, tutte alimentate dal numero che la parola porta su quel canale, e un ago che le legge tutte insieme. A ogni parola in arrivo le vasche si aggiornano tutte, ognuna al ritmo del suo scarico. Quante siano si decide prima di cominciare a leggere, e non cambia più, per lungo che sia il testo. È lo stesso spirito della rete ricorrente, con rubinetto, scarico e ago presi dai sistemi che evolvono nel tempo.
Proprio perché la regola non cambia mai, a quel 3,875 ci si arriva per due strade. Passo dopo passo, dal livello di prima a quello di adesso, una parola alla volta. Oppure tutto insieme, sommando i getti entrati da quando la vasca era vuota, ciascuno sbiadito secondo quanto tempo fa è entrato: 2 + 1 + 0,5 + 0,25 + 0,125 fa lo stesso numero. Le quote di sbiadimento, 1, 0,5, 0,25, 0,125 (quanto resta di un litro entrato adesso, un minuto fa, due, tre) e così via, sono le stesse a ogni minuto, e messe in fila formano un filtro: una fila di pesi da far scorrere lungo la sequenza dei getti. Al minuto dopo il filtro scivola di un posto e copre sei getti: alla somma si aggiunge in coda 0,0625, il getto più vecchio sbiadito cinque volte, e si arriva a 3,9375. La vasca dice lo stesso: metà di 3,875, più i due litri nuovi. Siccome nessun minuto aspetta il risultato di un altro, il filtro si fa scorrere su tutta la sequenza in un colpo solo. Sono la stessa identica cosa vista da due lati, ed è la doppia natura: si addestra il modello nel secondo modo, veloce perché fa tutti i conti in una volta, e lo si usa nel primo, economico perché a ogni parola gli basta il riassunto di prima.
Tutto questo sta in piedi finché nessuno tocca il rubinetto e lo scarico. Se qualcuno stesse alla vasca a girarli minuto per minuto, regolandoli in base all’acqua in arrivo, non ci sarebbe più una sola fila di sbiadimenti buona per l’intera storia, e quella non si potrebbe più far scorrere in un colpo solo. Modi di fare i conti tutti insieme ne restano, ma vanno ritrovati da capo, per un’altra strada.
Il mattone è un sistema lineare a tempo continuo che mappa un ingresso \(u(t)\) in un’uscita \(y(t)\) attraverso uno stato latente \(\mathbf{h}(t)\):
La matrice \(\mathbf{A}\) governa la dinamica interna (come lo stato evolve da solo), \(\mathbf{B}\) come l’ingresso vi entra, \(\mathbf{C}\) come se ne legge l’uscita. Per usarlo su una sequenza discreta lo si discretizza con un passo \(\Delta\), ottenendo una ricorrenza \(\mathbf{h}_t = \bar{\mathbf{A}}\, \mathbf{h}_{t-1} + \bar{\mathbf{B}}\, x_t\), dove \(x_t\) è l’ingresso campionato al passo \(t\) e \(\bar{\mathbf{A}}, \bar{\mathbf{B}}\) sono le versioni discrete di \(\mathbf{A}\) e \(\mathbf{B}\). E qui sta la ricchezza: finché i parametri sono costanti nel tempo, questa ricorrenza ha una doppia natura; si può calcolare passo per passo come una RNN (inferenza a costo costante per token) oppure, a stato iniziale nullo, tutta in una volta come una convoluzione (addestramento parallelo). È la stessa doppia natura parallelo/ricorrente che muove il capitolo sull’attenzione lineare, raggiunta però dalla teoria dei segnali. Quanto al passo \(\Delta\), fissa un baratto fra memoria e ingresso. Con \(\mathbf{A}\) stabile (autovalori a parte reale negativa) e la discretizzazione zero-order hold, che tiene l’ingresso costante dentro il passo (un’ipotesi tanto più grossolana quanto più il passo è lungo), \(\bar{\mathbf{A}} = \exp(\Delta\mathbf{A})\) tende all’identità per \(\Delta \to 0\): lo stato si conserva e l’ingresso, scalato da \(\bar{\mathbf{B}} \approx \Delta\mathbf{B}\), conta poco. Per \(\Delta\) grande, al contrario, \(\bar{\mathbf{A}}\) tende a zero: il passato si dimentica in fretta e domina l’ingresso corrente. Tolta l’invarianza nel tempo, con \(\bar{\mathbf{A}}_t\) e \(\bar{\mathbf{B}}_t\) diversi a ogni passo (come quando \(\Delta\) dipende dall’ingresso), non c’è più un filtro unico da far scorrere e la forma convoluzionale cade; il calcolo in blocco si ritrova con lo scan parallelo, che fonde i passi a coppie, poi a gruppi di quattro, e così via, grazie all’associatività della loro composizione.
Due strade, una meta#
L’attenzione lineare del capitolo precedente e gli state space model di questo nascono da mondi diversi e approdano a una famiglia comune. Tengono uno stato di taglia fissa e a ogni parola lo aggiornano con una regola lineare, \(\mathbf{h}_t = \mathbf{A}_t\,\mathbf{h}_{t-1} + \mathbf{b}_t\), dove \(\mathbf{A}_t\) e \(\mathbf{b}_t\) possono dipendere dalla parola in arrivo ma non dallo stato: il nuovo stato è il vecchio, trasformato, più ciò che entra adesso. Si addestrano lavorando su tutta la sequenza in una volta sola, e poi generano una parola alla volta senza che la memoria cresca.
Il nome per esteso è rete ricorrente lineare a stato di dimensione fissa, ed è la famiglia di ricorrenze lineari che il capitolo precedente mette in fila nella sezione sulla scrittura in memoria: «ricorrente» perché ogni passo riparte dal risultato del passo precedente, «lineare» perché il nuovo stato è una funzione lineare del vecchio (qui la parola indica com’è fatta l’operazione, non quanto costa calcolarla), «a stato di dimensione fissa» perché lo stato non si allarga mai. L’attenzione lineare ci arriva dal meccanismo di attenzione, gli state space model dai sistemi dinamici.

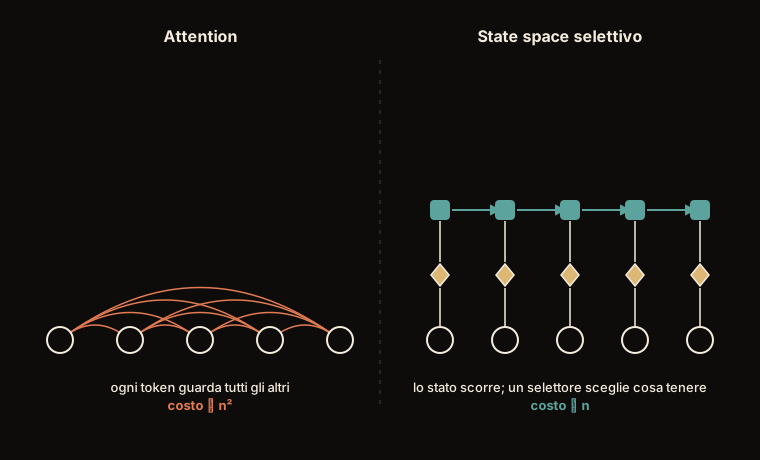
Fig. 18.1 Due modi di portarsi dietro il passato. L’attenzione lo tiene tutto e lo riguarda; la ricorrenza lo riassume in uno stato di taglia fissa e ci scrive sopra, decidendo di volta in volta che cosa vale la pena scrivere. Sotto ogni schema il costo, dove \(n\) è la lunghezza della sequenza e \(\propto\) si legge «proporzionale a». Il rombo, il selettore, è la selettività: non va confuso con il filtro fisso della forma convoluzionale, che è proprio quello che un modello selettivo perde.#
Fig. 18.1 mostra il guadagno, un costo proporzionale a \(n\) invece che a \(n^2\). Il prezzo è che uno stato di taglia fissa deve, prima o poi, dimenticare qualcosa. La selettività, il rombo sul lato destro, decide che cosa scrivere nello stato e che cosa lasciar cadere, in funzione di ciò che sta arrivando; ma non allarga lo stato, cambia come se ne usa lo spazio. Il tetto resta, ed è l’argomento di Panorama e limiti.
Con Mamba-2 [DG24] (che nel capitolo precedente era una riga della tabella delle ricorrenze) i due capitoli si toccano in un punto preciso. Uno state space model la cui transizione è uno scalare, cioè in cui tutto lo stato sbiadisce alla stessa velocità, calcola la stessa funzione di un’attenzione lineare mascherata: un’attenzione senza softmax che guarda solo all’indietro, in cui il confronto fra due parole è pesato da quanto della prima è sopravvissuto nel frattempo. Le due famiglie si incontrano su quel gradino, e fuori da lì restano parenti.
Ma prima c’è una tensione da sciogliere. La forma a convoluzione, cioè il filtro unico che si fa scorrere sull’intera sequenza, vale solo se il sistema è invariante nel tempo: le stesse regole a ogni passo. Ed è proprio questa rigidità che rompe Mamba, il modello con cui Albert Gu e Tri Dao chiudono il 2023 [GD24]. Mamba rende il sistema selettivo, cioè capace di decidere in base al contenuto che cosa ricordare e che cosa dimenticare, e in cambio perde il filtro unico. Il modo «tutto insieme» non scompare, ma va ricostruito su un’altra strada.
Dai sistemi dinamici a Mamba#
Quattro tappe, dall’idea di base alla frontiera.
Dai sistemi dinamici a S4: che cos’è una macchina che riassume il passato in un pugno di numeri, come si adatta a una sequenza fatta di passi separati, e come si fa a darle una memoria lunga: la ricetta HiPPO, che dice da quali numeri partire, e S4, che la rende veloce da calcolare.
Mamba: come si insegna alla macchina a scegliere invece di trattare tutte le parole allo stesso modo; che cosa costa quella scelta (si perde la convoluzione) e con quali due mosse si recupera la velocità: lo scan parallelo, che sfrutta il fatto che due passi di una ricorrenza lineare si fondono in un passo dello stesso tipo, e un algoritmo che tiene lo stato nella memoria veloce della GPU.
La dualità: la scoperta che questa macchina, quando la sua transizione è uno scalare, calcola la stessa funzione di un’attenzione lineare mascherata (la formula dei Transformer senza la softmax), e che scriverla così permette di usare i tensor core, le unità della GPU dedicate al prodotto fra matrici. Poi le tre novità di Mamba-3.
Panorama e limiti: una mappa che tiene insieme gli State Space Model e l’attenzione lineare, il collo di bottiglia di uno stato di taglia fissa, e le architetture ibride, che alternano pochi strati di attenzione a molti strati lineari.
Da ricordare
Un modello a spazio degli stati (in sigla SSM) condensa tutto quello che ha letto in un riassunto di dimensione sempre uguale, e a ogni parola lo aggiorna. Sono le stesse equazioni con cui l’ingegneria descrive un termostato o la traiettoria di un razzo; S4 [GGRe22] trova il modo di farle girare dentro una rete neurale a un costo sostenibile, ed è il primo a risolvere il compito del Long Range Arena in cui il legame da riconoscere è lungo sedicimila passi.
Il problema che vengono a risolvere: far guardare ogni parola a tutte le altre costa al quadrato (testo doppio, lavoro quadruplo). Qui il costo cresce di pari passo con la lunghezza, ed è ciò che si chiama costo lineare.
Finché le regole non cambiano da un passo all’altro, lo stesso calcolo si può fare in due modi: passo dopo passo (economico per generare) oppure con un filtro solo, fatto scorrere sull’intera sequenza (veloce per addestrare). È la doppia natura, la stessa già vista con l’attenzione lineare.
Mamba [GD24], il modello che Albert Gu e Tri Dao presentano alla fine del 2023, rompe quella regola fissa: lascia decidere alla parola in arrivo quanto scrivere e quanto dimenticare (è la selettività), e in cambio rinuncia al filtro unico. Mamba-2 [DG24] mostra poi che, nella sua versione più semplice (tutto lo stato sbiadisce alla stessa velocità), questa macchina fa lo stesso conto di un’attenzione senza softmax che guarda solo all’indietro: le due famiglie si incontrano su quel gradino, e fuori da lì restano parenti.
Il percorso: dai sistemi dinamici a S4 → Mamba (scegliere, e restare veloci) → la dualità (Mamba-2 e Mamba-3) → panorama, limiti e ibridi.
Da ricordare
Uno state space model riassume il passato in uno stato di dimensione fissa, con equazioni che l’ingegneria usa da decenni per i sistemi dinamici; S4 [GGRe22] ne trova la parametrizzazione che le rende calcolabili, e con essa risolve per primo Path-X, il compito del Long Range Arena a \(16\,384\) passi su cui tutti i lavori precedenti fallivano.
Discretizzato, un SSM invariante nel tempo ha una doppia natura: ricorrente (inferenza a costo costante per token) e convoluzionale, a stato iniziale nullo (addestramento parallelo). È la stessa doppia natura dell’attenzione lineare, da un’altra strada.
Mamba [GD24] rompe l’invarianza temporale con la selettività, e con essa la forma convoluzionale; il parallelismo si riconquista per un’altra via, lo scan. Mamba-2 [DG24] mostra che un SSM a transizione scalare, \(\bar{\mathbf{A}}_t = a_t\mathbf{I}\), calcola la stessa funzione di un’attenzione lineare mascherata: le due famiglie si incontrano su quel gradino, e fuori da lì restano parenti.
Il percorso: dai sistemi dinamici a S4 → Mamba (selezione e scan) → la dualità (Mamba-2 e Mamba-3) → panorama, limiti e ibridi.