


Il training loop: addestrare un modello#
Le cinque righe del ciclo mostrato in fondo alla sezione sulla backpropagation tornano, identiche, in ogni progetto PyTorch: dal tutorial per principianti al codice che addestra i grandi modelli linguistici. Sono il training loop, e il fatto che si scrivano a mano non è una dimenticanza della libreria: è una presa di posizione. Dove altri framework nascondono l’addestramento dietro un unico comando, PyTorch preferisce che ogni passo (previsione, errore, gradiente, correzione) resti visibile e modificabile. È più codice, ma è tuo: quando vorrai cambiare qualcosa nel modo di apprendere, saprai esattamente dove mettere le mani.
Il rito: i cinque passi#
Qui le si riprende una alla volta, e poi le si mette al lavoro su un problema vero, le cifre scritte a mano. Prima, due parole che nel codice compaiono senza presentazioni.
L’ottimizzatore è l’oggetto che a ogni giro corregge i pesi del modello usando il gradiente. Il suo iperparametro principale è il learning rate, \(\eta\) nelle formule (in italiano si dice anche, più brevemente, il passo): il fattore per cui il gradiente viene moltiplicato prima di essere sottratto dai pesi. Se è troppo piccolo la loss scende lentamente, e nel tempo dato può non arrivare in fondo; se è troppo grande la discesa scavalca il punto buono, oscilla, o diverge.
Di ottimizzatori ce ne sono parecchi, e per adesso ne bastano due. Il più semplice è quello del ciclo visto con la backpropagation, la discesa stocastica del gradiente (SGD, dall’inglese stochastic gradient descent): «stocastica» perché a ogni giro il gradiente si calcola su un mini-batch di esempi sorteggiati invece che su tutti quanti. SGD usa lo stesso passo per tutti i pesi. Adam invece adatta il passo di ciascun peso, a partire da due medie mobili dei suoi gradienti, ed è l’ottimizzatore che di solito si prova per primo (Fig. 7.7). Il nome non è di persona: sta per adaptive moment estimation.

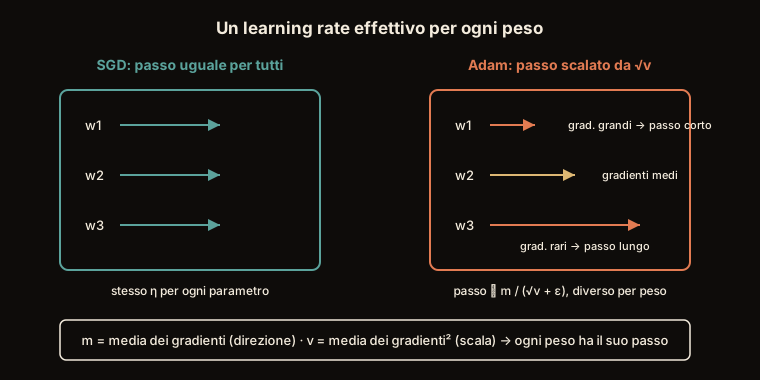
Fig. 7.7 Un learning rate per ciascuno. Adam non sceglie una velocità migliore: ne sceglie una diversa per ogni parametro, in base a quanto è costante la direzione in cui quel parametro viene spinto.#
La conseguenza pratica: con SGD il learning rate va tarato con cura, perché è uno solo per tutti i pesi; Adam è meno sensibile alla scala dei gradienti, perché ciascun peso riscala il proprio passo, ma \(\eta\) resta anche per lui l’iperparametro più importante.
Nel codice i componenti hanno il nome inglese: criterion è la funzione di perdita
(la loss, qui chiamata anche
«criterio»: tre nomi per un oggetto solo); dataloader è l’oggetto che
consegna gli esempi a mini-batch, uno per giro, e che costruiremo nel prossimo
paragrafo; optimizer è l’ottimizzatore appena presentato.
for X_batch, y_batch in dataloader:
    y_pred = model(X_batch)             # 1. forward: la previsione
    loss = criterion(y_pred, y_batch)   # 2. loss: quanto abbiamo sbagliato
    optimizer.zero_grad()               # 3. via i gradienti del giro prima
    loss.backward()                     # 4. backward: calcola i gradienti
    optimizer.step()                    # 5. aggiorna i pesi
Il terzo passo azzera i gradienti del giro precedente, ed è la somma vista con
autograd, il \(16\) al posto dell’\(8\): backward() aggiunge i gradienti nuovi a
quelli che trova in p.grad invece di sostituirli, e senza zero_grad()
l’aggiornamento del secondo giro userebbe anche il gradiente del primo. La
somma diventa utile quando la si vuole: chi ha una macchina piccola accumula i
gradienti di più mini-batch prima di un solo aggiornamento, per simulare un
batch più grande, come riprende la sezione su
replicare un paper. Quanto al posto, zero_grad() va
dopo lo step() del giro prima e prima del backward() di questo: all’inizio
del giro, come qui, o subito dopo lo step(), il risultato è lo stesso.
Quelle cinque righe dicono l’ordine, non il movimento: Fig. 7.8 le fa girare tre volte, cioè su tre mini-batch in fila, e mostra a ogni passo che cosa cambia dentro il modello.

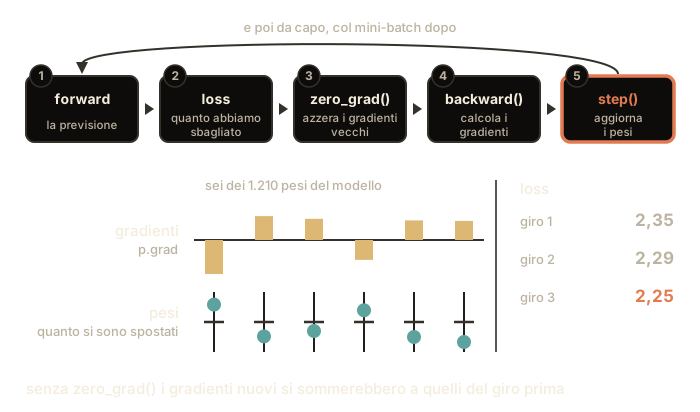
Fig. 7.8 Tre giri dello stesso ciclo, su una rete piccola presa a esempio. I gradienti
compaiono quando backward() li calcola, restano finché lo zero_grad() del
giro dopo non li toglie di mezzo, e intanto step() sposta i pesi. A destra la
loss dei tre giri: parte da \(2{,}35\), poco sopra il \(2{,}30\) di chi tira a
indovinare fra dieci cifre, e a ogni giro scende un poco.#
È il metodo con cui si impara con le flashcard, le carte per memorizzare. Guardi la domanda e provi a rispondere (passo 1, la previsione). Giri la carta e confronti con la risposta giusta: quanto eri lontano? (passo 2, l’errore). Butti via gli appunti del giro precedente (passo 3), capisci in che direzione hai sbagliato, troppo alto? troppo basso? (passo 4), e aggiusti di conseguenza il tuo modo di rispondere, un poco alla volta (passo 5). Poi passi al mazzetto successivo, e quando hai ripassato l’intero mazzo una volta, hai completato quella che si chiama un’epoca. Ripetuto per migliaia di carte ed epoche, questo giro è tutto ciò che serve a una rete per imparare.
A guardarlo da vicino, il terzo passo non cancella gli appunti riga per riga: toglie il foglio dal tavolo, e un foglio nuovo arriva solo quando si torna a scrivere. Per questo chi vuole controllare gli appunti di un giro, per esempio per vedere se una carta ha lasciato traccia, deve guardarli subito dopo averli scritti: dopo il terzo passo sul tavolo non c’è niente, nemmeno un foglio bianco. E dove il foglio non c’è non si corregge niente: quello che in un giro non ha lasciato appunti resta com’era.
Il foglio si cambia a ogni giro, tranne quando si vuole proprio sommare. Il caso classico è il tavolo piccolo. Ci stanno otto carte per volta, e la correzione, che decisa su più carte sbaglia di meno, la vuoi decidere su trentadue: fai quattro mazzetti da otto, scrivi gli appunti di tutti e quattro sullo stesso foglio, uno sotto l’altro, e alla fine correggi una volta sola, dividendo per quattro quello che hai sommato; solo allora cambi foglio. Chi cambia foglio a ogni mazzetto si corregge su otto carte credendo di averne guardate trentadue, il ripasso fila liscio uguale e non arriva nessun avviso.
Il loop realizza un passo di discesa del gradiente su mini-batch. Con \(\mathcal{L}\) la loss media sul batch e \(\theta\) i parametri:
dove \(\eta\) è il learning rate. loss.backward() calcola
\(\nabla_{\theta}\mathcal{L}\) via autograd e lo deposita in p.grad per ogni
parametro; optimizer.step() applica l’aggiornamento, e la formula esatta
dipende dall’ottimizzatore: la discesa semplice per optim.SGD, stime adattive
dei momenti per optim.Adam [KB15], fra gli ottimizzatori più
usati, anche se nessuno è il migliore in generale [GBC16].
zero_grad() è necessario perché autograd accumula i gradienti a ogni
backward(): senza, ogni passo userebbe la somma di tutti i gradienti
precedenti.
Il nome però dice meno di quello che il metodo fa. Da PyTorch 2.0 il default è
set_to_none=True, quindi p.grad non diventa un tensore di zeri: diventa
None. È un risparmio (nessuna memoria tenuta occupata da gradienti che non
ci sono, e un’operazione in meno per parametro) ed è una trappola per chi va a
controllare i gradienti nel posto sbagliato: un assert p.grad is not None
scritto dopo l’azzeramento fallisce su tutti i parametri, e quel controllo va
messo subito dopo il backward(). La differenza si vede anche nei pesi: un
parametro con p.grad a None viene saltato da step(), mentre con un
gradiente nullo un ottimizzatore che ha uno stato (il momento di SGD, le medie
di Adam) lo muove comunque, per inerzia. Succede ai parametri che in un giro
non partecipano al calcolo, come un ramo di if non preso o uno strato
congelato a metà addestramento.
L’ordine di forward, backward e step è fisso per costruzione, e
zero_grad() va fra uno step() e il backward() successivo; tutto il resto
è normale Python, e le aggiunte hanno un posto preciso. Il gradient clipping
(torch.nn.utils.clip_grad_norm_) sta fra backward() e step(); lo
scheduler del learning rate si avanza dopo optimizer.step(), e al
contrario PyTorch avvisa; con la mixed precision le chiamate diventano
scaler.scale(loss).backward(), scaler.unscale_(optimizer) prima del
clipping, scaler.step(optimizer) e scaler.update(). L’eccezione all’ordine
è una sola, ed è l’accumulo dei gradienti, il modo di simulare un batch
grande su una macchina piccola che vedremo in
replicare un paper: lì si eseguono \(k\) backward() e
un solo step(), quindi l’azzeramento esce dal giro e si fa una volta ogni
\(k\) micro-batch. Rispettare l’ordine solito lì è l’errore: il codice gira
identico, e la matematica no. L’accumulo fatto bene coincide con il batch
grande vero a meno dell’arrotondamento in virgola mobile, a tre condizioni: che
ogni loss sia divisa per \(k\) prima del backward() (con reduction="mean"
ogni micro-batch restituisce già una media, e \(k\) medie sommate danno \(k\) volte
il gradiente), che i micro-batch abbiano tutti la stessa dimensione, e che nel
modello non ci siano strati che si tarano sul batch, come la batch norm, che
continua a vedere il micro-batch. Quello con lo
zero_grad() a ogni micro-batch conserva soltanto il gradiente dell’ultimo
micro-batch, senza un messaggio d’errore.
Dataset e DataLoader: la catena di rifornimento#
Il gradiente non si calcola di norma né sull’intero dataset né su un esempio
solo, ma su un mini-batch: un gruppo di esempi, da qualche decina a qualche
migliaio secondo il problema. A prepararli ci pensano due classi di
torch.utils.data.
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# MNIST scaricato e trasformato in tensori con valori in [0, 1]
train_data = datasets.MNIST(root="data", train=True, download=True,
                            transform=transforms.ToTensor())
test_data = datasets.MNIST(root="data", train=False, download=True,
                           transform=transforms.ToTensor())

train_loader = DataLoader(train_data, batch_size=64, shuffle=True)
# in valutazione niente shuffle, e batch più grandi
test_loader = DataLoader(test_data, batch_size=256)
I due DataLoader differiscono per una ragione sola: in valutazione nessun
peso viene aggiornato. Il rimescolamento serve in addestramento perché i
mini-batch siano campioni diversi a ogni epoca, e il modello non si abitui a un
ordine; in valutazione l’ordine non conta. La dimensione del mini-batch, in
addestramento, è anche la frequenza degli aggiornamenti: 64 vuol dire una
correzione ogni 64 immagini. In valutazione non c’è niente da correggere, e la
si sceglie solo in base alla memoria: un batch più grande vale soltanto più
velocità.
Il Dataset è la dispensa: sa quanti esempi ci sono e sa consegnarti
l’esempio numero \(i\) quando glielo chiedi. Altro non gli si chiede, e per
questo la dispensa può essere quasi qualunque cosa, una cartella di
fotografie, un foglio di calcolo, un archivio su un altro computer. Il
DataLoader è l’aiutante di cucina: pesca dalla dispensa, mescola l’ordine a
ogni giro (così la rete non impara la sequenza a memoria, come uno studente che
ripassa sempre le carte nello stesso ordine) e porta ai fornelli vassoi da 64
esempi alla volta. Se un aiutante non tiene il passo dei fornelli, se ne
mettono di più.
Perché proprio a vassoi? Un esempio alla volta è uno spreco, la GPU resta ferma ad aspettare; tutti insieme non entrano in memoria. Il mini-batch è la via di mezzo che tiene i fornelli sempre occupati. E un vassoio dice quasi quello che direbbe il dataset intero. Assaggiare un cucchiaio dice quanto sale c’è in tutta la pentola, con la risposta giusta in media e un po’ di scarto da un cucchiaio all’altro. Allo stesso modo sessantaquattro esempi indicano la direzione in cui correggersi quasi come la indicherebbero tutti e sessantamila, e sbandano un poco a ogni giro. Lo sbandamento costa in precisione, e in cambio scuote la discesa quel tanto che basta a non farla restare ferma dove il terreno è quasi piatto.
Dataset (variante map-style) è un protocollo minimo: __len__ e
__getitem__. Qualunque classe che li implementi (un file CSV, una cartella
di immagini, un database) diventa una sorgente per il DataLoader, che
aggiunge campionamento (shuffle=True rimescola gli indici a ogni epoca),
batching (impila gli esempi lungo il primo asse: qui tensori
\((64, 1, 28, 28)\)), e caricamento parallelo (num_workers) con memoria
page-locked (pin_memory=True), che è la premessa del trasferimento
asincrono verso la GPU, non l’asincronia: quella richiede anche
non_blocking=True nel .to(), come si vedrà in
prestazioni. La transform ToTensor()
converte le immagini PIL in tensori float32 con valori in \([0, 1]\) e layout
channels-first \((C, H, W)\); per MNIST si può aggiungere
transforms.Normalize((0.1307,), (0.3081,)) (media e deviazione standard del
dataset), cioè la standardizzazione delle feature della sezione sulle SVM applicata ai pixel: su ingressi non
centrati la discesa del gradiente trova una valle più stretta e procede a
zigzag. Sulle fotografie la stessa operazione la fa la sezione sui
dati su misura. Statisticamente, con esempi estratti in
modo uniforme, il gradiente su un mini-batch di \(B\) esempi è una stima non
distorta del gradiente sull’intero insieme di \(m\) esempi, con covarianza
\(\boldsymbol{\Sigma}/B\), dove \(\boldsymbol{\Sigma}\) è la covarianza dei
gradienti dei singoli esempi (va moltiplicata per \((m-B)/(m-1)\) quando si estrae
senza reimmissione, come fa
shuffle=True dentro un’epoca). Il rumore scende quindi come \(1/\sqrt{B}\):
quadruplicare il batch lo dimezza. È il prezzo, e in parte il segreto, della
discesa stocastica.
MNIST da cima a fondo#
Mettiamo insieme tutto quello che il capitolo ha costruito: tensori, modello,
loss, dati. Questo è un programma completo che scarica MNIST, addestra il
percettrone multistrato della sezione sui moduli e lo valuta su
immagini mai viste, una volta prima di cominciare e poi a ogni epoca. Contiene
due chiamate nuove, model.train() e model.eval(), che mettono il modello in
modalità di addestramento o di valutazione, cioè gli dicono se sta imparando o
se deve soltanto rispondere, e il blocco torch.no_grad(), già incontrato fra
i tensori, che sospende la costruzione del grafo. Il paragrafo «Studiare e
dare l’esame» se ne occupa per esteso.
import torch
from torch import nn, optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

torch.manual_seed(0)                     # stessi numeri a ogni esecuzione
device = "cuda" if torch.cuda.is_available() else "cpu"

# --- dati ---
train_data = datasets.MNIST(root="data", train=True, download=True,
                            transform=transforms.ToTensor())
test_data = datasets.MNIST(root="data", train=False, download=True,
                           transform=transforms.ToTensor())
train_loader = DataLoader(train_data, batch_size=64, shuffle=True)
test_loader = DataLoader(test_data, batch_size=256)

# --- modello, loss, ottimizzatore ---
model = nn.Sequential(
    nn.Flatten(),
    nn.Linear(28 * 28, 128),
    nn.ReLU(),
    nn.Linear(128, 10),
).to(device)

criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)   # 1e-3 è 0,001

# --- valutazione: loss media e accuratezza sul test ---
def valuta():
    model.eval()                         # modalità valutazione
    perdita, corretti = 0.0, 0
    with torch.no_grad():                # niente gradienti: solo lettura
        for X, y in test_loader:
            X, y = X.to(device), y.to(device)
            y_pred = model(X)
            perdita += criterion(y_pred, y).item() * len(y)  # da media a somma
            # per ogni immagine prendi il punteggio più alto -> la cifra scelta;
            # confrontala con quella vera; conta i sì
            corretti += (y_pred.argmax(dim=1) == y).sum().item()
    return perdita / len(test_data), corretti / len(test_data)

perdita, accuratezza = valuta()          # prima di cominciare: pesi casuali
print(f"epoca 0: loss sul test {perdita:.3f}, accuratezza {accuratezza:.3f}")

# --- addestramento ---
for epoca in range(5):
    model.train()                        # modalità addestramento
    for X, y in train_loader:
        X, y = X.to(device), y.to(device)
        y_pred = model(X)
        loss = criterion(y_pred, y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    perdita, accuratezza = valuta()      # a fine epoca
    print(f"epoca {epoca + 1}: loss sul test {perdita:.3f}, "
          f"accuratezza {accuratezza:.3f}")
La riga che conta le risposte giuste combina quattro operazioni. y_pred è
una tabella con una riga per immagine e dieci punteggi per riga;
argmax(dim=1) scorre ciascuna riga e restituisce la posizione del
punteggio più alto, cioè la cifra che il modello ha scelto (dim sta per
dimension, cioè quale asse percorrere: dim=1 è il secondo, quello dei dieci
punteggi, perché il primo, dim=0, è quello delle immagini). Il confronto
== y mette a fianco la risposta vera e produce una colonna di sì e no, cioè
di valori booleani; .sum() conta i sì (che valgono uno) e .item() estrae
quel conteggio come numero Python normale, da poter sommare al totale. Sono i
quattro gesti con cui si conta ogni accuratezza, il rapporto fra i sì e il
totale: la quota di risposte giuste, e basta. La riga della loss fa un conto
simile: moltiplica la media del batch per il numero delle sue immagini, perché
l’ultimo batch ne ha meno degli altri e alla fine si vuole la media su tutte
(il conto per esteso sta nella sezione dal notebook agli script).
Prima di cominciare, con i pesi sorteggiati, la loss sul test vale circa
\(2{,}3\), il \(\ln 10\) di chi tira a indovinare fra dieci cifre, e l’accuratezza
è di circa un decimo: è il punto di partenza di cui parlava la sezione sui
moduli. Dopo cinque epoche la loss è scesa sotto \(0{,}1\) e l’accuratezza
arriva attorno al 97%: novantasette cifre su cento lette correttamente da
\(101\,770\) numeri che prima di partire erano casuali. Quanto ci vuole dipende
dalla macchina. Con un modello di poco più di centomila parametri il tempo se
ne va soprattutto nel DataLoader, che a ogni epoca converte in tensori
sessantamila immagini, e anche su un processore normale sono alcune decine di
secondi; il vantaggio di una scheda grafica cresce con la taglia del modello, e
la sezione sulle prestazioni spiega da dove viene.
Studiare e dare l’esame: train() ed eval()#
Nel programma compaiono due chiamate che cambiano il comportamento della rete,
model.train() e model.eval(), e il blocco torch.no_grad().
La rete ha due modalità, come uno studente. Quando studia
(model.train()) può usare trucchi che servono solo a imparare meglio, per
esempio coprirsi a caso qualche appunto per non adagiarsi (il dropout, che
vedremo nel capitolo sul deep
learning). Quando dà
l’esame (model.eval()) quel trucco si spegne: risponde e basta, al meglio
di quel che sa.
Non tutto si spegne, però. Certi pezzi hanno bisogno di sapere quanto sono grandi di solito i numeri che ricevono, per rimetterli in scala prima di passarli avanti (è la batch norm, di cui parla lo stesso capitolo). Studiando prendono quella misura sul mazzetto che hanno davanti; all’esame usano la media che si sono annotati durante il ripasso. Rimettere in scala lo fanno in tutti e due i casi, e a cambiare è soltanto da dove viene il metro. Per questo all’esame basta anche una carta sola, perché il metro è già annotato, mentre durante lo studio quella stessa carta sola blocca tutto: da una misura sola non si capisce quanto le cose varino, e il programma si ferma e lo dice invece di tirare a indovinare.
E torch.no_grad() dice al registratore dei gradienti di spegnersi: durante
l’esame non si prende appunti per migliorare, si risponde soltanto, e senza il
registratore acceso tutto è più veloce e leggero. I due gesti sono distinti, e
nessuno dei due sostituisce l’altro: spegnere il registratore lascia accesi i
trucchi dello studio, e dichiarare l’esame lascia acceso il registratore. Chi
ne fa uno solo o riempie fogli che nessuno leggerà, o dà l’esame con qualche
appunto ancora coperto.
train()/eval() commutano un flag che cambia il comportamento dei moduli «a
doppia personalità»: nn.Dropout (attivo solo in training) e le
nn.BatchNorm1d/2d/3d (statistiche del batch in training, medie mobili in
valutazione) sono i due casi principali. Di che cosa facciano davvero, e
perché aiutino, si occupa il capitolo sul deep learning in ottimizzazione e
regolarizzazione; qui
serve solo sapere che hanno due comportamenti e che l’interruttore è questo.
Attenzione a come si dice, perché la
formulazione sbrigativa («eval() spegne dropout e batch norm») è falsa per la
seconda: in eval() il dropout diventa davvero l’identità, la batch norm
invece continua a normalizzare, solo che usa le medie mobili accumulate invece
delle statistiche del batch corrente. Una nn.BatchNorm1d(3) che ha visto in
train() cento mini-batch con media attorno a \(10\) restituisce in eval()
uscite di media vicina a zero (con momentum=0.1 le medie mobili si assestano
in alcune decine di passi):
torch.manual_seed(0)
bn = nn.BatchNorm1d(3)
for _ in range(100):
    bn(torch.randn(32, 3) + 10)          # train(): aggiorna le medie mobili
bn.eval()
x = torch.randn(256, 3) + 10
print(f"ingresso {x.mean().item():.1f}, uscita {bn(x).mean().item():.1f}")
ingresso 10.0, uscita 0.0
La differenza non è terminologica: chi crede che eval() disattivi la batch
norm non capisce perché un modello valutato con un batch da un solo esempio
funzioni benissimo in eval() (le medie mobili non dipendono dal batch) e in
train() invece non parta affatto. Non con un nan, come si legge spesso:
con un’eccezione esplicita, ValueError: Expected more than 1 value per channel when training, che una nn.BatchNorm1d(3) solleva su un ingresso di
forma \((1, 3)\). Il messaggio è più utile della leggenda, perché
chi lo incontra riconosce il caso senza doverlo dedurre: con un esempio solo
la varianza per canale non è stimabile, e la libreria preferisce fermarsi
piuttosto che normalizzare per qualcosa che non ha calcolato. Dove invece i
valori per canale sono più di uno il conto si fa e nan non ne esce: un
ingresso \((1, 3, 5)\), o l’immagine \((1, 3, 4, 4)\) di una nn.BatchNorm2d,
passano senza storie, e su un ingresso costante l’uscita è zero, o un residuo
minuscolo di arrotondamento, e non nan, perché l’\(\varepsilon\) che si somma al
denominatore impedisce che si divida zero per zero.
torch.no_grad() è un context manager che sospende la
costruzione del grafo autograd: non vengono salvati i valori intermedi per un
backward() che non arriverà mai, con un risparmio di memoria che cresce con
la profondità della rete, e accelera l’esecuzione quando il modello risponde e
basta, senza più imparare niente. In gergo questa fase si chiama
inferenza, parola presa in prestito dalla statistica che qui indica soltanto
un modello già addestrato messo in uso, senza nessun ragionamento dentro.
Sono due meccanismi indipendenti e servono entrambi: eval() senza
no_grad() dà predizioni corrette ma spreca memoria; no_grad() senza
eval() lascia il dropout acceso e falsa le predizioni. Il nostro MLP non ha
né dropout né batch norm, quindi qui eval() è tecnicamente superfluo, ma
scriverlo sempre è un’abitudine che evita bug sottili appena il modello
cresce. Quando si fa soltanto inferenza esiste una forma più stretta di
no_grad(), torch.inference_mode(), che oltre a non registrare rinuncia
anche al version counter e al tracciamento delle viste: è leggermente più
veloce, al prezzo che i tensori che produce non possono poi rientrare in un
grafo autograd.
Quando fermarsi: la validazione#
Il numero stampato a fine epoca dice se il modello generalizza, cioè se risponde bene su immagini che non ha mai visto, o se sta imparando a memoria le sue. Usarlo per decidere, però, ha un costo. Nel programma su MNIST gli insiemi di dati sono due, addestramento e test, e a fine epoca abbiamo guardato il test. Se in base a quel numero decido quando fermarmi o che cosa cambiare, quelle immagini hanno partecipato alle mie decisioni, e il numero che mi danno non stima più l’errore su dati mai visti.
Per questo in un progetto serio gli insiemi sono tre, come nella sezione su overfitting e validazione. L’insieme di addestramento è quello su cui il modello impara. L’insieme di validazione si consulta a ogni epoca per decidere (gli iperparametri, il momento di fermarsi), e queste decisioni lo consumano un poco, perché ogni scelta presa guardandolo lo avvicina all’addestramento. L’insieme di test si tocca una volta sola, alla fine, e dà la stima onesta. Nel programma su MNIST ne abbiamo usati due per non appesantire il codice, ed è una scorciatoia comune negli esempi: fuori dagli esempi, il terzo insieme si ritaglia.

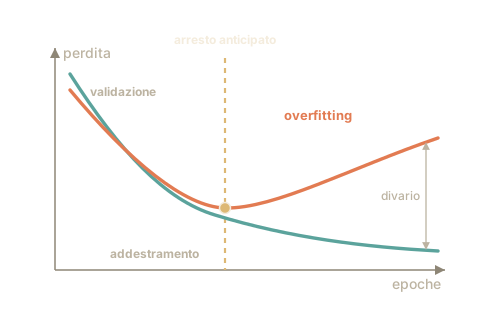
Fig. 7.9 La perdita di addestramento scende sempre; quella di validazione tocca un minimo e poi risale. Da lì in poi il modello memorizza il rumore: la linea dell’arresto anticipato marca il momento giusto per fermarsi.#
Guarda le due curve in Fig. 7.9. Attenzione al verso: qui in verticale c’è l’errore, quindi scendere è migliorare. La curva dell’addestramento è come i compiti fatti a casa: l’errore cala sempre, perché il modello rivede gli stessi esercizi. Quella della validazione è la simulazione d’esame con domande nuove. All’inizio scendono insieme, ed è buon segno. Poi quella della validazione tocca il fondo e ricomincia a salire, mentre quella dell’addestramento continua a scendere: da lì in avanti il modello non sta più imparando, sta imparando a memoria, ed è l’overfitting incontrato nel capitolo sul machine learning. La mossa giusta è fermarsi nel punto più basso della validazione, e tenere da parte la copia del modello salvata in quel momento. La distanza fra le due curve è la spia da guardare: finché resta stretta il ripasso serve a qualcosa, e quando si allarga il modello sta lavorando per i compiti a casa e non per l’esame. Fermarsi è il rimedio più immediato. L’altro è rendergli lo studio un po’ più difficile mentre impara, e lo racconta il capitolo sul deep learning.
Nel programma di poco fa niente di tutto questo c’è: cinque epoche e via,
perché su MNIST cinque epoche non bastano a mandare a memoria sessantamila
immagini. Aggiungerlo però costa poco, ed è un if: a ogni epoca si guarda il
numero della validazione, se è il migliore finora si salva una copia del
modello, e se non migliora per un po’ di epoche di fila si esce dal ciclo.
Salvare quella copia è una riga sola, e conta molto che cosa ci si mette dentro.
Nel loop esplicito la diagnosi si scrive da sé: si ritaglia un set di
validazione (ad esempio con
torch.utils.data.random_split(train_data, [55000, 5000])), a fine epoca si
misura \(\mathcal{L}_{\text{val}}\), e l’early stopping è un if: se la
validazione non migliora per un numero fissato di epoche (la patience), si
esce dal ciclo e si ricaricano i pesi dell’epoca migliore, salvati via via con
torch.save.
migliore, pazienza, da_quanto = float("inf"), 3, 0
for epoca in range(100):
    model.train()
    for X, y in train_loader:
        optimizer.zero_grad()
        criterion(model(X), y).backward()
        optimizer.step()

    model.eval()
    with torch.no_grad():
        # media pesata sugli esempi: l'ultimo batch è più corto
        perdita_val = sum(criterion(model(X), y).item() * len(y)
                          for X, y in val_loader) / len(val_loader.dataset)
    if perdita_val < migliore:           # nuovo minimo: si salva
        migliore, da_quanto = perdita_val, 0
        torch.save(model.state_dict(), "migliore.pt")
    else:
        da_quanto += 1
        if da_quanto == pazienza:        # tre epoche senza migliorare
            break

model.load_state_dict(torch.load("migliore.pt"))   # i pesi dell'epoca migliore
Ciò che Keras offre come callback preconfezionate, in PyTorch è una decina di
righe di controllo di flusso; in cambio, nessun limite: fermarsi su una
metrica composta o salvare solo a condizioni particolari sono varianti banali
dello stesso if. Riprendere da checkpoint no, ed è la trappola del
salvataggio: vuole anche lo stato dell’ottimizzatore. Il divario
\(\mathcal{L}_{\text{val}} - \mathcal{L}_{\text{train}}\) resta la bussola: se
si allarga, servono i freni (nn.Dropout, o il weight decay, che in
optim.Adam si chiede con weight_decay ed è una penalità L2 aggiunta al
gradiente, diversa dal decadimento disaccoppiato di optim.AdamW), che
approfondiremo in ottimizzazione e
regolarizzazione.
Salvare il lavoro: lo state_dict#
Un modello addestrato va messo al sicuro. In PyTorch non si salva l’oggetto
modello: si salva il suo state_dict, cioè l’elenco di tutti i suoi numeri
con accanto il nome del pezzo a cui appartengono (in Python un elenco fatto
così, dove a ogni nome corrisponde una cosa, si chiama dizionario). Dentro
non ci sono solo i pesi imparati, ma anche i buffer: numeri che fanno parte
dello stato del modello senza essere parametri, quindi senza gradiente, e che
l’ottimizzatore non tocca. Il caso tipico sono le medie della batch norm,
misurate sui dati invece che ricavate dall’errore (le incontreremo nella
sezione sulla normalizzazione); ma sono buffer anche le
costanti che il modello si porta dietro, come una maschera. Nel file finiscono
anche loro.
Il motivo per cui non si salva l’oggetto intero è pratico. Salvare l’oggetto
vuol dire affidarlo a pickle, il modulo di Python che trasforma oggetti in
byte, e pickle non scrive nel file il codice della classe: scrive il suo nome
e il modulo in cui sta, più i valori dei suoi attributi. Al ricaricamento
Python va a cercare quella classe per nome nel tuo codice, che intanto cambia:
se il file con la classe è stato spostato o rinominato il modello non si
ricostruisce, e se la classe ha ora un forward diverso si ricostruisce
diverso. Salvando solo i numeri, il file resta leggibile finché sai ricostruire
l’architettura, e l’architettura è scritta nel codice, dove si può leggere e
correggere. C’è anche una ragione di sicurezza. Un file di pickle non
contiene soltanto dati: contiene le istruzioni per ricostruire gli oggetti, e
chi lo prepara può farci eseguire, al momento del ricaricamento, qualunque
comando sul computer di chi lo apre. Per questo da PyTorch 2.6 torch.load
accetta di default solo tensori, numeri, stringhe e contenitori di questi
(weights_only=True), e un modello salvato intero, al ricaricamento, si ferma
con un errore.
torch.save(model.state_dict(), "mnist_mlp.pt")     # salva i numeri

model2 = nn.Sequential(                            # stessa architettura...
    nn.Flatten(), nn.Linear(28 * 28, 128), nn.ReLU(), nn.Linear(128, 10)
)
model2.load_state_dict(torch.load("mnist_mlp.pt")) # ...numeri ricaricati
model2.eval()                                      # pronto per l'uso
Il codice che definisce l’architettura resta la fonte di verità; il file .pt
contiene solo i numeri. È una divisione dei compiti coerente con tutto il
capitolo (il modello è codice, i pesi sono dati) ed è, insieme a
safetensors (un formato di soli tensori che non passa da pickle), il modo
in cui circolano i modelli pre-addestrati che riutilizzeremo nel capitolo sulla
visione artificiale, quando un modello nato per un compito verrà rifinito
(fine-tuning) su un altro.
C’è però una distinzione da fare subito, perché costa una riga farla e giorni scoprirla dopo: salvare per usare e salvare per riprendere non sono la stessa cosa.
Il file con i soli pesi serve a usare il modello: lo ricarichi, gli dai un’immagine, ti risponde. Non serve a riprendere l’addestramento dal punto in cui l’avevi interrotto.
La ragione è che Adam, mentre corregge i pesi, si costruisce una memoria di come si sono mossi finora, ed è quella memoria che gli permette di dare a ciascun peso il passo giusto, e in particolare di accorciarlo man mano che ci si avvicina. SGD, il più spartano dei due, quella memoria non ce l’ha, e con lui la ripresa cambia poco. Ricaricare i pesi e ripartire con un ottimizzatore appena creato è come rimettere qualcuno alla guida nel punto esatto in cui lo avevi lasciato, ma senza dirgli che sta arrivando in curva: la posizione è giusta, la velocità no, ed è troppa.
In che verso si sbaglia, di solito, lo si può dire. Dopo una ripresa fatta così il primo passo è lungo esattamente quanto dice il learning rate, per ogni peso, perché un ottimizzatore appena nato non ha ancora nessun motivo per moderarsi. La corsa non interrotta, arrivata vicino al fondo, ne avrebbe fatto di solito uno molto più corto, perché lì le spinte si fanno piccole e cambiano verso: è l’auto che entra in curva troppo veloce. Di solito, non sempre: un peso rimasto fermo a lungo, che riceve di colpo una spinta forte, con la memoria intatta fa un passo anche più lungo. Quello che resta vero in ogni caso è che il passo dopo la ripresa è diverso da quello della corsa interrotta.
Il rimedio costa una riga: nel file si mette anche lo stato dell’ottimizzatore, e al ritorno lo si ricarica. Lo stesso vale per qualunque altro pezzo del programma che tenga il conto di quello che è successo finora, perché un file per riprendere è un fascicolo, con dentro più di una cosa.
Con SGD nudo la questione è marginale; con optim.Adam, quello del programma
su MNIST, i momenti sono stato. Sono due medie mobili tenute per ogni peso,
\(m \leftarrow \beta_1 m + (1-\beta_1)\,g\) dei gradienti e
\(v \leftarrow \beta_2 v + (1-\beta_2)\,g^2\) dei loro quadrati, con \(g\) il
gradiente (qui \(m\) è la notazione di Kingma e Ba per il primo momento, e non
il numero di esempi del paragrafo sul DataLoader; \(\beta_1 = 0{,}9\) e
\(\beta_2 = 0{,}999\) di default, cioè memorie di circa dieci e mille passi), e
il passo è
\(\eta\,\hat{m}/(\sqrt{\hat{v}}+\varepsilon)\), dove \(\hat{m}\) e \(\hat{v}\) sono
le due medie corrette per il bias (\(m\) e \(v\) divisi per \(1-\beta_1^t\) e
\(1-\beta_2^t\)) ed \(\varepsilon\) è il termine minuscolo che evita la divisione
per zero. Ripartire senza di esse non riprende la stessa traiettoria. La parte
strutturale, quella che vale su qualunque problema, è questa: la correzione del
bias riparte da \(t = 1\), dove dà \(\hat{m} = g\) e \(\hat{v} = g^2\), quindi il
rapporto \(\hat{m}/(\sqrt{\hat{v}} + \varepsilon)\) vale \(\pm 1\) per
costruzione e il primo aggiornamento sposta ogni coordinata di \(\eta\), a meno
del minuscolo \(\varepsilon\). A regime il rapporto però non ha \(1\) per tetto.
Gli autori indicano come caso estremo un gradiente grande dopo una lunga serie
di gradienti nulli, che con i valori di default dà
\((1-\beta_1)/\sqrt{1-\beta_2} \approx 3{,}16\) [KB15]; ma
nemmeno quello è un tetto, se i passi sono abbastanza. Con gradienti che
crescono del \(2\%\) a ogni passo il rapporto vale \(2{,}28\) dopo \(200\) passi,
\(4{,}26\) dopo \(1000\) e \(4{,}99\) dopo \(2000\), e continua a salire; nessuna
sequenza di gradienti, per quanti passi duri, lo porta oltre
\((1-\beta_1)\big/\sqrt{(1-\beta_2)(1-\beta_1^2/\beta_2)} \approx 7{,}27\) (è la
disuguaglianza di Cauchy-Schwarz applicata alle due medie), e ci si avvicina
solo con gradienti che crescono di circa l’\(11\%\) a passo per migliaia di
passi.
import math

def rapporto_adam(g, b1=0.9, b2=0.999):
    """Il rapporto m̂/√v̂ di Adam dopo la sequenza di gradienti g."""
    m = v = 0.0
    for t, gt in enumerate(g, 1):
        m = b1 * m + (1 - b1) * gt
        v = b2 * v + (1 - b2) * gt**2
    return (m / (1 - b1**t)) / math.sqrt(v / (1 - b2**t))

for passi in (200, 1000, 2000):
    g = [1.02**t for t in range(1, passi + 1)]   # +2% a ogni passo
    print(passi, round(rapporto_adam(g), 2))
print(round(0.1 / math.sqrt(0.001 * (1 - 0.9**2 / 0.999)), 2))   # il tetto
200 2.28
1000 4.26
2000 4.99
7.27
Vicino a un minimo, con gradienti che si smorzano e cambiano segno, succede il contrario: \(|\hat{m}|\) cala più in fretta di \(\sqrt{\hat{v}}\), e il passo della corsa non interrotta è più corto di \(\eta\). Ricaricando lo stato, invece, il passo coincide esattamente con quello della traiettoria mai interrotta.
Di quanto sia più lungo dipende dal problema, perciò va misurato su un caso preciso: una quadratica \(\mathcal{L}(\theta) = \frac{1}{2}\|\theta\|^2\) con cento parametri inizializzati da una normale standard, venti passi di Adam con \(\eta = 0{,}1\), e poi la ripresa. La misura è la media quadratica dello spostamento al primo passo dopo la ripresa.
import torch
from torch import nn, optim

def primo_passo_dopo_ripresa(ricarica: bool) -> float:
    torch.manual_seed(0)
    theta = nn.Parameter(torch.randn(100))          # L = ||theta||^2 / 2
    opt = optim.Adam([theta], lr=0.1)
    for _ in range(20):
        opt.zero_grad()
        (0.5 * theta.pow(2).sum()).backward()
        opt.step()
    nuovo = optim.Adam([theta], lr=0.1)              # la ripresa
    if ricarica:
        nuovo.load_state_dict(opt.state_dict())
    prima = theta.detach().clone()
    nuovo.zero_grad()
    (0.5 * theta.pow(2).sum()).backward()
    nuovo.step()
    return (theta.detach() - prima).pow(2).mean().sqrt().item()

print(f"senza stato: {primo_passo_dopo_ripresa(False):.4f}")
print(f"con lo stato: {primo_passo_dopo_ripresa(True):.4f}")
senza stato: 0.1000
con lo stato: 0.0294
Senza lo stato il passo è esattamente \(\eta\), come previsto; ricaricandolo è \(0{,}0294\), un fattore \(3{,}4\), e nessun messaggio d’errore né con lo stato né senza. Il valore esatto cambia col seme, il verso no.
Lo stesso vale per ciò che ha uno state_dict e che il ciclo tocca: lo
scheduler del learning rate e il GradScaler della precisione mista. Non lo
hanno invece il DistributedSampler, di cui si salva l’epoca per poi
richiamare set_epoch, né i generatori casuali, il cui stato
(torch.get_rng_state()) va salvato a parte se si vuole riprendere con la
stessa sequenza. Un checkpoint completo è un dizionario, non un tensore.
Al ricaricamento si inciampa in tre punti. Di default ogni tensore torna sul
dispositivo da cui era partito, quindi un file salvato dalla GPU, aperto dove
la GPU non c’è, solleva un errore finché non si scrive
torch.load(percorso, map_location="cpu"). Le chiavi dello state_dict
portano il prefisso module. se il modello era avvolto in nn.DataParallel o
in DistributedDataParallel, e _orig_mod. se era passato da
torch.compile: load_state_dict solleva Missing key(s) e
Unexpected key(s) finché il prefisso non si toglie, o finché non si salva il
modello di dentro (model.module.state_dict()). E strict=False fa passare
le chiavi in più o in meno senza dirlo: serve solo quando la differenza è
voluta.
Ecco la forma minima, quella che si scrive una volta e si copia in ogni progetto, applicata al modello e all’ottimizzatore del programma su MNIST:
# checkpoint per RIPRENDERE: i pesi da soli non bastano
torch.save({"epoca": 5,
            "modello": model.state_dict(),
            "ottimizzatore": optimizer.state_dict()}, "checkpoint.pt")

stato = torch.load("checkpoint.pt")
model.load_state_dict(stato["modello"])
optimizer.load_state_dict(stato["ottimizzatore"])   # la riga che si dimentica
print(f"ripresa dall'epoca {stato['epoca']}; l'ottimizzatore ricorda "
      f"{len(stato['ottimizzatore']['state'])} tensori di parametri")
ripresa dall'epoca 5; l'ottimizzatore ricorda 4 tensori di parametri
Il numero stampato dice che cosa c’era da salvare. Lo state_dict
dell’ottimizzatore ha due chiavi: in state c’è la memoria accumulata su
ciascuno dei quattro tensori di parametri (i pesi e i bias dei due strati), in
param_groups ci sono le impostazioni, il learning rate per primo. Un
ottimizzatore appena creato ha state vuoto, e salvarlo vorrebbe dire
ripartire senza memoria.
Questo dizionario (pesi, stato dell’ottimizzatore, epoca) è la forma minima del checkpoint, e la sezione dal notebook agli script ci aggiunge le altre due cose che servono a rileggerlo fra sei mesi, i nomi delle classi e la configurazione dell’esperimento. Prima, però, i pezzi visti fin qui vanno messi in ordine: il flusso di lavoro è la sequenza di mosse che porta da un problema a un modello che funziona.
Da ricordare
Il giro di addestramento ha cinque passi fissi, sempre nello stesso ordine: prevedi, misura l’errore, butta gli appunti del giro prima, capisci in che direzione hai sbagliato, correggi. Il terzo passo serve perché altrimenti gli appunti si sommano.
Gli esempi arrivano a gruppi, i mini-batch: la dispensa (
Dataset) sa consegnarli uno per uno, l’aiutante (DataLoader) li mescola e li porta ai fornelli a vassoi.Quando il modello dà l’esame si aziona
model.eval(), e si aggiungetorch.no_grad()per non prendere appunti inutili. Sono due interruttori diversi e servono tutti e due.Le due curve, quella dell’addestramento e quella della simulazione d’esame, dicono quando è ora di fermarsi: quando la seconda smette di migliorare.
Del modello si salvano i numeri, non l’oggetto: l’architettura sta nel codice. E per riprendere l’addestramento dove si era interrotto serve anche la memoria dell’ottimizzatore, non solo i pesi.
Da ricordare
Il training loop ha cinque passi fissi: forward → loss →
zero_grad()→backward()→step(); il clipping va frabackward()estep(), lo scheduler dopostep(). Il terzo passo serve perché i gradienti si accumulano, e non li azzera: li toglie (p.gradtorna aNone, estep()salta quel parametro). Nell’accumulo dei gradienti si fa una volta ogni \(k\) micro-batch, ed è l’unica eccezione all’ordine.Datasetconsegna gli esempi,DataLoaderli rimescola e li impila in mini-batch: il gradiente sul batch è una stima non distorta, rumorosa ma economica, di quello vero.In valutazione:
model.eval()spegne il dropout e passa la batch norm alle medie mobili (non la spegne: continua a normalizzare);torch.no_grad()sospende autograd. Servono entrambi.Le curve di training e validazione diagnosticano l’overfitting; l’early stopping in PyTorch è un semplice
ifnel loop.Si salva lo
state_dict(torch.save/load_state_dict), non l’oggetto, di cuipicklesalverebbe solo un riferimento alla classe: contiene parametri e buffer. Per riprendere servono ancheottimizzatore.state_dict()e l’epoca; senza, con Adam il primo passo dopo la ripresa è quello di un ottimizzatore appena nato. Al ricaricamento:map_location, i prefissimodule.e_orig_mod., estrict=Falsesolo se la differenza è voluta.