


La struttura del Transformer#
Il meccanismo di attenzione è il motore; adesso montiamo l’automobile. Il Transformer descritto in Attention Is All You Need, l’articolo del 2017 da cui tutto è partito, è una macchina per tradurre: da un lato entra una frase («The black cat jumps on the wall»), dall’altro esce la traduzione («Il gatto nero salta sul muro»). Per farlo combina due pile di blocchi, l’encoder che legge e il decoder che scrive, più un ingrediente facile da sottovalutare: un modo per dire alla rete in che ordine stanno le parole.

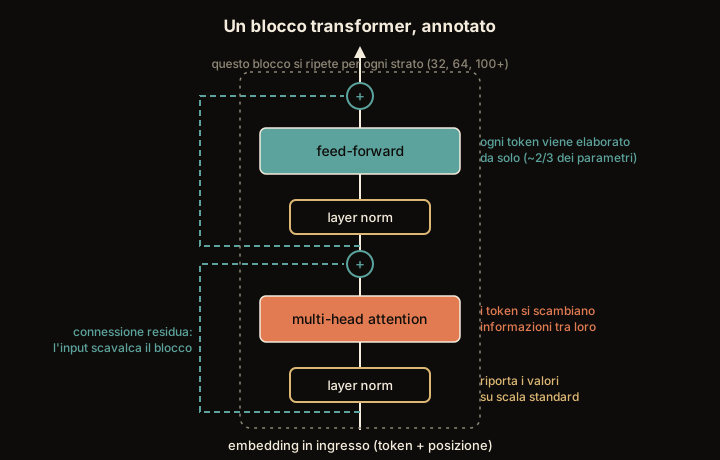
Fig. 16.3 Il blocco che si ripete, con la stessa forma a ogni strato. Dentro ci sono due sotto-strati: l’attenzione, dove le parole si scambiano informazioni, e la rete feed-forward, dove ogni parola viene rielaborata per conto suo. Attorno a entrambi ci sono la connessione residua e la normalizzazione descritte nella sezione sull’attenzione, che permettono di impilare decine di blocchi senza che i primi smettano di imparare. Il disegno mette la normalizzazione all’ingresso di ciascun sotto-strato, che è il montaggio dei modelli di oggi; quello del 2017 la metteva subito dopo la somma.#
Fig. 16.3 mostra il blocco, ed encoder e decoder sono due pile di blocchi di questo tipo: nell’encoder il blocco ha due sotto-strati, self-attention e feed-forward; nel decoder tre, perché fra i due si aggiunge la cross-attention verso l’encoder, e la self-attention porta la maschera causale.
Ogni token, dentro la rete, è un vettore \(\mathbf{h} \in \mathbb{R}^{d_{\text{model}}}\), la sua rappresentazione: quello che il modello ha ricavato della parola fino a quel punto, non la parola scritta. Ogni strato, cioè ogni piano della pila, la aggiorna, e il lavoro di encoder e decoder consiste in questi aggiornamenti successivi.
L’encoder, la parte che legge#
Si comincia dall’encoder, il più semplice dei due: trasforma la frase di partenza in una sequenza di rappresentazioni, una per token, in cui ogni parola porta con sé il contesto in cui si trova.
L’encoder è una pila di sei piani fatti allo stesso modo. Al primo piano le parole arrivano «grezze», cioè con la rappresentazione che avevano da sole, fuori da qualunque frase: «nero» vale «nero» e basta. A ogni piano otto lettori rileggono tutta la frase con il meccanismo di attenzione (ogni parola guarda tutte le altre e si arricchisce di quello che ha visto), poi ciascuna parola viene rielaborata per conto suo da una piccola rete di neuroni, e il risultato sale al piano di sopra. Piano dopo piano la rappresentazione di ogni parola si specializza: «nero» al sesto piano è diventato il colore di quel gatto in quella frase. Alla fine della salita, l’encoder consegna una versione della frase in cui ogni parola porta scritto addosso il proprio contesto.
Perché sei piani e non quattro? Come per le otto teste della sezione sull’attenzione, perché funzionava: è un numero provato sul campo, e i modelli venuti dopo sono arrivati a decine di piani, oltre cento nei più grandi.
L’encoder è una pila di \(n_{\text{strati}} = 6\) strati (l’articolo del 2017 chiama \(N\) questo numero, ma qui \(N\) serve ad altro e \(L\) conta le posizioni di query) con la stessa struttura e parametri propri (nel modello base, \(d_{\text{model}} = 512\)), ciascuno con due sotto-strati:
Multi-Head Self-Attention: ogni posizione attende a tutte le posizioni dell’input, catturando le relazioni a coppie in un solo passo;
Feed-Forward Network (FFN): una rete completamente connessa applicata indipendentemente e identicamente a ogni posizione.
Ogni sotto-strato è avvolto da residual connection e layer normalization nella forma Post-LN dell’articolo originale, \(\text{LayerNorm}(\mathbf{x} + \text{SubLayer}(\mathbf{x}))\), come visto nella sezione sull’attenzione, dove si è detto anche perché i modelli successivi preferiscono il Pre-LN, che è quello disegnato in Fig. 16.3: le formule che seguono sono quelle del 2017. La divisione dei ruoli è netta: l’attenzione mescola informazione tra le posizioni, la FFN la trasforma posizione per posizione; è l’alternanza dei due movimenti, ripetuta per \(n_{\text{strati}}\) strati, a costruire rappresentazioni via via più astratte. Per esteso, con \(\mathbf{H}^{(0)} = \sqrt{d_{\text{model}}}\,\mathbf{X}_{\text{emb}} + \mathbf{PE}\), lo strato \(\ell\) calcola
Il fattore \(\sqrt{d_{\text{model}}}\) davanti agli embedding è dell’articolo, che non ne dice la ragione; l’effetto, se gli embedding partono con varianza \(1/d_{\text{model}}\), è di portarli a varianza 1, sulla scala della codifica di posizione, i cui valori stanno fra \(-1\) e \(1\).
Bias e normalizzazioni esclusi, e con \(d_{\text{ff}} = 4d\) come nel modello base, uno strato di encoder ha \(4d^2\) parametri nell’attenzione e \(8d^2\) nella FFN, cioè \(12d^2\) con \(d = d_{\text{model}}\) (lo stesso conto che la matematica di un modello linguistico fa per GPT-3); uno strato di decoder, con la cross-attention, ne ha \(16d^2\).
Il decoder, la parte che scrive#
L’uscita dell’encoder è una sequenza di rappresentazioni, non ancora una traduzione. A produrre la frase d’arrivo, un token alla volta, è il decoder, la parte più delicata, perché mentre scrive non deve vedere le parole che non ha ancora scritto.
Il decoder genera la traduzione una parola alla volta, e mentre lo fa consulta due fonti: quello che ha già scritto (per non contraddirsi) e quello che l’encoder ha letto (per restare fedele all’originale). C’è però una regola ferrea, la stessa dei compiti in classe: non si sbircia avanti. Per capirla serve sapere come si addestra questa macchina, che è più semplice di quanto sembri: le si danno milioni di frasi con accanto la traduzione giusta, scritta da una persona, e la si costringe a indovinarla parola per parola, controllando ogni volta quanto ci è andata vicina. La traduzione giusta, insomma, durante lo studio ce l’ha davvero sotto gli occhi. Ed è proprio per questo che le si copre: quando impara a produrre la quarta parola può guardare solo le prime tre, altrimenti «imparerebbe» a copiare la quarta dalla soluzione, e il giorno in cui la soluzione non c’è (cioè sempre, una volta finito lo studio) non saprebbe fare nulla.
Una parola alla volta vuol dire proprio una. A ogni passo la macchina distribuisce la propria fiducia su tutte le parole che conosce, decine di migliaia, un po’ a questa e un po’ a quella; poi da quell’elenco ne prende una sola. È la parola presa a rientrare al passo dopo, in coda a quelle già scritte, perché l’ingresso è fatto per parole e un elenco di fiducie non ci passerebbe. Durante lo studio la parola che rientra è quella vera della soluzione, e non quella che la macchina avrebbe detto: così un inciampo alla terza parola non le fa sbagliare anche tutto il resto della frase. Il futuro, quello, resta coperto come prima.
Anche il decoder ha \(n_{\text{strati}} = 6\) strati, ma con tre sotto-strati ciascuno:
Masked Multi-Head Self-Attention: come la self-attention dell’encoder, ma con una maschera che esclude le posizioni future (somma \(-\infty\) ai loro punteggi prima della softmax, così che il loro peso sia zero): la posizione \(t\) vede solo \(1, \dots, t\). È ciò che rende il modello autoregressivo, e fa sì che il meccanismo di condizionamento sia lo stesso in addestramento e in generazione;
Cross-Attention: le query vengono dal decoder, key e value dall’output dell’encoder, è qui che la generazione «consulta» la frase di partenza;
Feed-Forward Network, identica a quella dell’encoder.
Per esteso, con \(\mathbf{E}\) l’uscita dell’encoder, \(\text{MultiHead}(\mathbf{Y}; \mathbf{X})\) l’attenzione a più teste con le query da \(\mathbf{Y}\) e chiavi e valori da \(\mathbf{X}\), e il pedice \(\mathbf{M}\) per la maschera causale, lo strato \(\ell\) del decoder calcola
dove chiavi e valori della cross-attention vengono dalla stessa \(\mathbf{E}\) in tutti gli strati.
In generazione il decoder produce un token alla volta: a valle della pila, una proiezione lineare sul vocabolario (nel paper con i pesi legati a quelli dell’embedding, §3.4) e una softmax danno la distribuzione del token successivo. Da quella distribuzione si sceglie un token, ed è il suo embedding a rientrare come input al passo dopo: non la distribuzione, che è un vettore di \(|\mathcal{V}|\) probabilità e non ha modo di entrare in un ingresso fatto per un token. Come si sceglie a generazione (il più probabile, oppure uno estratto a sorte) è una questione a sé, e la sezione sui grandi modelli linguistici la affronta per intero. In addestramento entra invece il token vero, ed è il teacher forcing: per una frase di partenza \(x_{1:n}\) e una traduzione di riferimento \(y_{1:m}\) si minimizza
con i valori \(y_{<t}\) presi dal riferimento stesso e la maschera causale che impedisce a ogni posizione di vedere \(y_t\) e i successivi. La maschera garantisce che il meccanismo sia lo stesso nei due casi, ma i prefissi su cui il decoder viene interrogato sono diversi: in addestramento sono quelli del riferimento, in generazione i propri, ed è l’exposure bias che la sezione sulla traduzione con le reti ha raccontato insieme al teacher forcing.

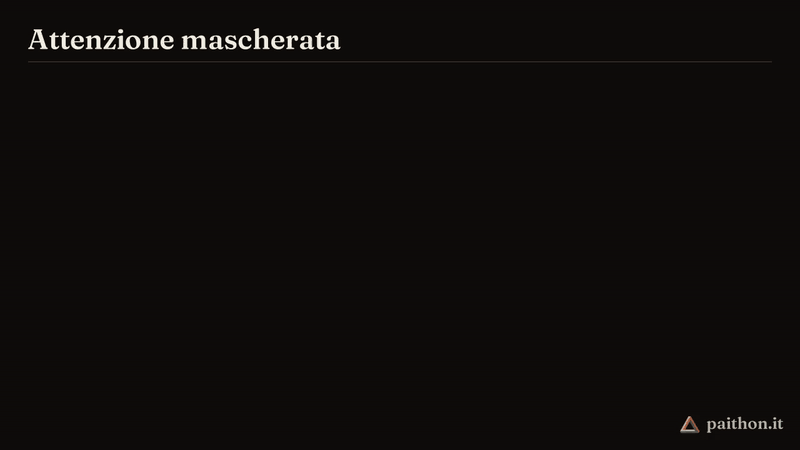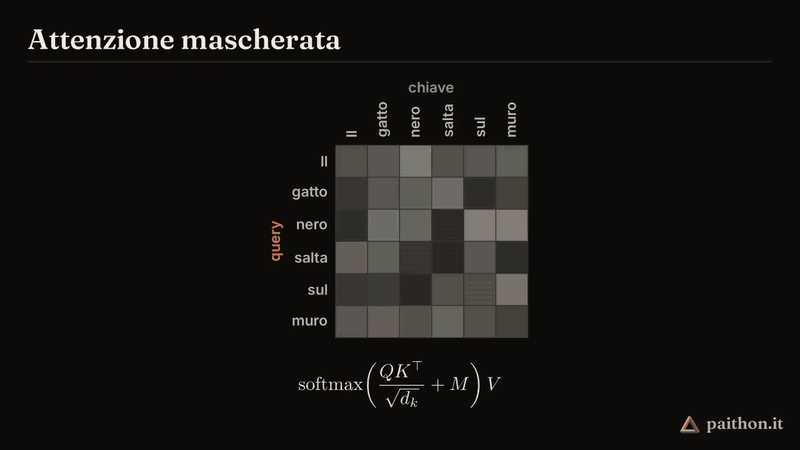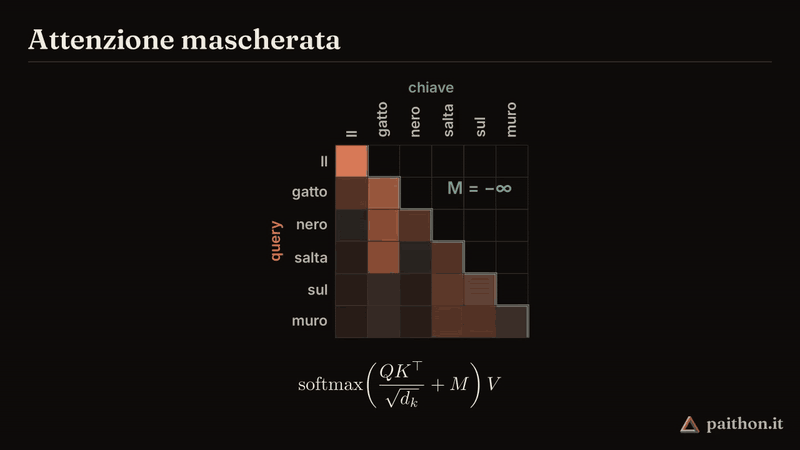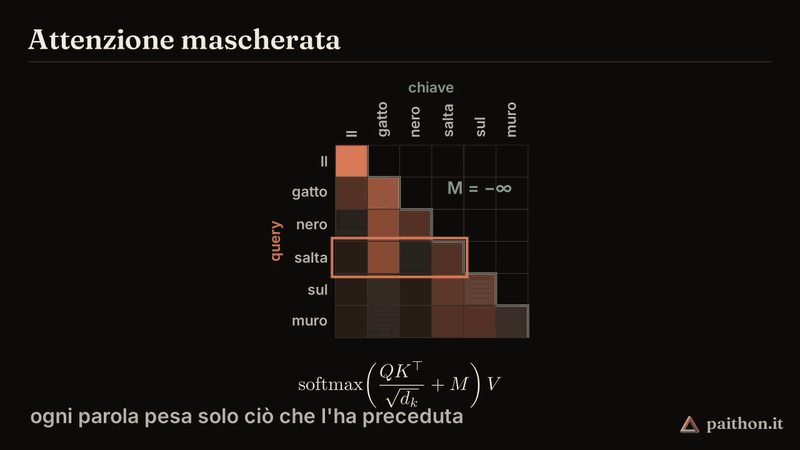
Fig. 16.4 Il divieto di sbirciare avanti, al lavoro: si chiama maschera causale, dove «causale» vuol dire che nessuna parola dipende da ciò che viene dopo. Le caselle verso il futuro si spengono, e ogni riga ridistribuisce tutto il suo peso su ciò che precede.#
Fig. 16.4 mostra la matrice dei pesi del decoder. Righe e colonne sono le parole nell’ordine della frase: una riga per ogni parola che guarda, una colonna per ogni parola guardata, e in ogni casella il peso che la prima dà alla seconda. La diagonale è la parola che guarda sé stessa, e resta accesa; il triangolo sopra la diagonale contiene le parole che vengono dopo, e i loro punteggi vanno a \(-\infty\) prima della softmax, come nella sezione sull’attenzione: per questo ne escono zeri esatti, e ogni riga somma a uno sulle sole posizioni permesse.
La codifica posizionale: dare un ordine alle parole#
La sezione sull’attenzione ha mostrato che l’attenzione da sola non vede l’ordine delle parole: rimescolare l’ingresso rimescola l’uscita e nient’altro. Le reti che leggevano in fila l’ordine lo ricevevano dal modo stesso di leggere; il Transformer deve aggiungerlo, e lo fa sommando all’embedding di ogni token un vettore che dipende dalla sua posizione: la codifica posizionale (positional encoding). Da lì in avanti «gatto» in prima posizione e «gatto» in quinta non sono più la stessa cosa, e resta da decidere come scrivere la posizione.

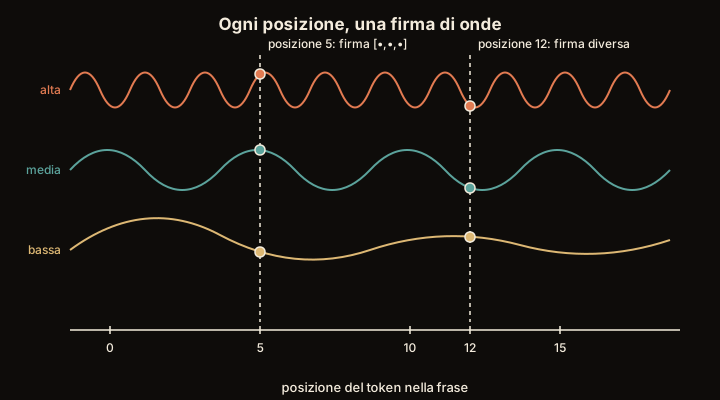
Fig. 16.5 Le frequenze del positional encoding. Nessuna onda da sola dice dove siamo: la firma di una posizione è la fila verticale dei punti che tutte le onde toccano lì (qui il disegno ne mostra tre, in un modello vero sono centinaia). Con tre sole onde, e così lente, la fila tornerebbe uguale ogni dieci posizioni; nel modello vero la più lenta compie un giro in oltre sessantamila, e due posizioni non ricevono mai la stessa firma.#
La firma della posizione c’è, ma non è scritta come un semplice contatore (1, 2, 3, …), ed è quello che mostra Fig. 16.5. Il contatore, in effetti, sarebbe la prima idea di chiunque, e ha due difetti. Il primo è che cresce senza fermarsi: la posizione diecimila porterebbe addosso il numero diecimila, un valore che schiaccia quelli dell’embedding a cui si somma e che, in generazione, può superare tutti quelli visti in addestramento. Il secondo è che normalizzarlo non aiuta: se per tenerlo piccolo si divide per la lunghezza della frase, «metà frase» diventa 0,5 sia in una frase di sei parole sia in una di seicento, e la stessa firma finisce a significare due cose diverse.
La soluzione del 2017 tiene insieme le due esigenze con una famiglia di sinusoidi, onde che salgono e scendono fra \(-1\) e \(1\), ciascuna con la sua frequenza, cioè con la sua velocità; e le frequenze decrescono in progressione geometrica, ognuna una frazione fissa della precedente. Siccome ogni coordinata oscilla fra \(-1\) e \(1\), nessun valore cresce con la posizione; le frequenze alte distinguono i vicini immediati, quelle basse dicono in quale parte della sequenza siamo: più scale insieme invece di una. Con \(d_{\text{model}} = 512\) la sinusoide più lenta ha un periodo, il numero di posizioni dopo cui torna uguale, di oltre sessantamila posizioni, e nessuna frase è abbastanza lunga perché la firma di una posizione si ripeta.
A teatro ogni spettatore ha un posto numerato, e la stessa persona in prima fila o in quinta non sta nello stesso punto della sala. Al Transformer serve lo stesso, un posto numerato per ogni parola, e la soluzione del 2017 lo scrive con tre orologi affiancati, uno veloce, uno medio, uno lento: a formare il numero di posto sono le loro lancette. Nessuna lancetta si allontana mai, perché gira e torna: qualunque posizione della frase, il numero che se ne legge resta sempre nella stessa fascia. E la lancetta veloce distingue i vicini immediati, quella lenta dice in quale parte della frase siamo: due scale insieme invece di una.
Il legame con la figura è che l’altezza della punta di una lancetta, disegnata mano a mano che l’orologio avanza, è proprio un’onda che sale e scende: le tre curve del disegno sono tre lancette a tre velocità. La firma di una posizione è allora la fila verticale dei tre punti che le tre onde toccano lì.
Una lancetta sola, certo, si ripete: alle tre di notte e alle tre di pomeriggio la lancetta delle ore sta nello stesso posto. Su un orologio da parete si ripete anche la fila intera delle tre, ogni dodici ore, perché lì le velocità sono l’una multipla dell’altra. Le velocità delle onde stanno molto più lontane fra loro, e la più lenta impiega oltre sessantamila posizioni a compiere un giro: nessuna frase è abbastanza lunga perché la fila dei punti torni uguale.
Il posto numerato, dunque, c’è, ma il numero è scritto con le lancette invece che in cifre. La sostanza però è quella del teatro: stessa parola, poltrona diversa, e la rete può accorgersi che l’ordine conta. Il modo in cui la firma viene consegnata è sbrigativo: non si aggiunge un pezzo in fondo alla lista della parola, si somma numero per numero alla lista che c’è già. Parola e posizione finiscono mescolate negli stessi numeri, e alla rete tocca imparare a distinguerle.
Le lancette hanno poi una comodità che un contatore non ha. Andare avanti di tre parole è sempre lo stesso gesto, in qualunque punto della frase lo si faccia: ogni lancetta scatta di un suo angolo fisso, quella veloce di parecchio, quella lenta di pochissimo, e quanto scatta dipende dal tre e non da dove si era prima. Chi legge le firme ha quindi un modo di riconoscere «tre parole più in là» che funziona uguale all’inizio e alla fine della frase; col contatore diviso per la lunghezza, invece, tre parole più in là valgono mezzo passo in una frase di sei parole e mezzo centesimo in una di seicento.
Nel 2017 quelle firme erano calcolate a tavolino, con una formula scritta a mano prima di cominciare: il modello non le impara, se le trova già pronte. Se quella comodità serva davvero al modello, però, non è sicuro, e a metterlo in dubbio sono stati gli autori stessi: hanno provato a lasciare che il modello si costruisse le firme da solo, e le traduzioni sono venute quasi uguali. Infatti i modelli venuti dopo hanno preso strade diverse (chi le fa imparare, chi scrive direttamente quanto due parole sono distanti invece di dove stanno), ma il posto numerato, in una forma o nell’altra, serve a tutti.
La codifica posizionale dell’articolo originale è deterministica, fatta di sinusoidi a frequenze diverse:
dove \(\text{pos}\) è la posizione del token e \(i\) non indicizza le coordinate ma le coppie di coordinate, cioè le frequenze: \(i\) va da \(0\) a \(d_{\text{model}}/2 - 1\), e ogni \(i\) riempie le due coordinate \(2i\) e \(2i+1\) con un seno e un coseno della stessa frequenza \(\omega_i\). È il punto in cui si sbaglia scrivendo il codice, perché il paper scrive «\(i\) is the dimension» e lascia credere che arrivi a \(d_{\text{model}}\).
Ogni posizione riceve così una firma unica, sommata all’embedding del token; e la scelta sinusoidale fa sì che la firma della posizione \(\text{pos} + k\) sia una trasformazione lineare di quella di \(\text{pos}\) con una matrice che dipende solo da \(k\). Questa condizione è tutto il contenuto: che due vettori siano legati da qualche matrice è vero sempre e non dice niente; che la matrice sia la stessa per ogni \(\text{pos}\) è ciò che rende la distanza relativa una cosa rappresentabile. Ed è una riga di trigonometria: dalle formule di addizione,
cioè una rotazione di angolo \(k\omega_i\) su ciascuna coppia, e \(\text{pos}\) è sparito dalla matrice. Da lì gli autori ipotizzarono che la rete potesse rappresentare facilmente le distanze relative: è una congettura, e la loro stessa ablazione la indebolisce, perché con positional embedding appresi i risultati sono «quasi identici» (Tabella 3, riga E, dell’articolo). Molti modelli successivi usano infatti encoding appresi (BERT); i modelli linguistici recenti usano quasi tutti la RoPE (rotary position embedding [SAL+24]), che prende quell’identità sul serio e la promuove da congettura a costruzione. La RoPE non aggiunge niente all’embedding: in ogni strato ruota query e chiave, coppia di coordinate per coppia, di un angolo proporzionale alla posizione assoluta del token, \(\mathbf{q}_m \mapsto \mathbf{R}_{m}\,\mathbf{q}_m\) e \(\mathbf{k}_n \mapsto \mathbf{R}_{n}\,\mathbf{k}_n\), dove \(\mathbf{R}_m = \operatorname{diag}\big(\mathbf{R}(m\omega_0), \dots, \mathbf{R}(m\omega_{d_k/2-1})\big)\) è diagonale a blocchi di rotazioni piane \(2 \times 2\) e \(\omega_i = 10000^{-2i/d_k}\): la stessa legge delle sinusoidi, calcolata però sulla larghezza \(d_k\) di una testa invece che su \(d_{\text{model}}\). Poiché \(\mathbf{R}(\alpha)^\top = \mathbf{R}(-\alpha)\) e due rotazioni nello stesso piano si compongono sommando gli angoli, nel prodotto scalare le due si riducono a una, \(\mathbf{R}_m^\top \mathbf{R}_n = \mathbf{R}_{n-m}\), e il punteggio \(\mathbf{q}_m^\top \mathbf{R}_{n-m}\,\mathbf{k}_n\) dipende dalle posizioni soltanto attraverso la distanza \(n-m\). Ogni vettore è ruotato secondo la posizione assoluta in cui sta, e l’attenzione vede solo le posizioni relative.
La stessa idea, scrivere nei punteggi la distanza invece della posizione, ha altre due forme. Shaw e colleghi [SUV18] sommano alla chiave un vettore appreso per ogni distanza \(j - i\) (tagliata oltre una soglia), così che ai punteggi arrivi un termine che dipende dalla query e dalla distanza; T5 [RSR+20] lo riduce a uno scalare per testa e per fascia di distanza; ALiBi [PSL22] somma una penalità fissa e lineare, \(-\lambda_h\,(i-j)\), con una pendenza \(\lambda_h\) diversa per ogni testa (la \(m\) dell’articolo, che qui è già la posizione della RoPE), e nessuna codifica all’ingresso. Gli schemi differiscono sull’estrapolazione: oltre la lunghezza vista in addestramento la RoPE incontra angoli mai visti e degrada se non se ne riscalano le posizioni o le frequenze, mentre ALiBi è stato costruito per reggere contesti più lunghi di quelli di addestramento. Il rimedio più semplice per la RoPE è l’interpolazione delle posizioni [CWCT23]: per allungare il contesto da \(n_{\text{add}}\) a \(n'\) posizioni si sostituisce la posizione \(m\) con \(m\,n_{\text{add}}/n'\), così che gli angoli restino dentro l’intervallo visto in addestramento, e basta una rifinitura breve, entro mille passi. Il principio, in ogni caso, resta lo stesso: iniettare l’ordine, perché la self-attention da sola è permutation-equivariante, cioè permutando i token in ingresso le uscite escono permutate allo stesso modo e la rappresentazione di ogni parola non dipende da dove sta.
La feed-forward network: il lavoro individuale#
Manca un pezzo solo, ed è quello che nella Fig. 16.3 sta subito dopo l’attenzione. Ha un nome inglese, feed-forward network, che vuol dire soltanto «rete che va in avanti», cioè senza cappi né ritorni: i numeri entrano da una parte ed escono dall’altra.
La riunione finisce e ognuno torna alla propria scrivania. Lì, da solo, rimette in ordine quello che ha appena sentito, e lo fa in tre gesti, con due moduli prestampati che sono gli stessi per tutti. Primo: la nota uscita dalla riunione, 512 numeri, viene ricopiata su un modulo quattro volte più lungo, da 2.048 numeri. Ogni numero in più è una miscela diversa di quelli di partenza, e fa venire fuori una combinazione che nella nota corta stava schiacciata insieme alle altre. Secondo: si ripassa il foglio e si mette a zero ogni numero venuto negativo. Lo zero resta al suo posto, e il foglio resta lungo uguale; è l’unico momento in cui alla scrivania si sceglie invece di mescolare. Terzo: un secondo modulo riporta il foglio alla lunghezza della nota di partenza, e di tutto quel materiale largo tiene solo quello che serve al piano di sopra. Riunione, scrivania, riunione, scrivania: la torre è tutta qui.
Quello che il modello ha imparato sta scritto nei numeri stampati sui moduli (si chiamano parametri, ed è quello che si conta quando si dice «un modello da sette miliardi»). In un piano della torre che legge, due terzi di quei numeri stanno sui moduli della scrivania e un terzo su quelli della riunione.
Il conto è alla portata. La riunione usa quattro moduli grandi uguali: uno per la query, uno per la key, uno per il value, uno per rimettere insieme le risposte degli otto lettori. La scrivania ne usa due soli, ma ciascuno quattro volte più grande, perché uno allarga e l’altro ricomprime: sono otto moduli della prima taglia. Otto contro quattro, due terzi contro un terzo. Nei piani della torre che scrive le riunioni sono due, la propria e la consultazione dell’altra torre, quindi lì si va a otto contro otto e la quota scende a metà; ma i grandi modelli linguistici di oggi tengono solo la torre che scrive e non consultano nessuno, e tornano ai due terzi. Il gesto più semplice della torre è anche quello che tiene la maggior parte dei numeri imparati, ed è lì che molti ricercatori sono andati a cercare dove il modello conservi quello che sa.
Tre gesti e due moduli: questo è il piano del 2017, e i modelli di oggi lo hanno ritoccato in due punti. I numeri negativi ora si scoloriscono invece di sparire di colpo: quanto più erano negativi, tanto più si avvicinano allo zero. E i fogli lunghi diventano due, compilati con due moduli diversi: il primo, quello con i negativi scoloriti, fa da filtro, e numero per numero decide quanto del secondo passa oltre. Perché il totale dei numeri stampati non cresca, i fogli si accorciano da quattro volte a poco meno di tre la nota di partenza: con il modulo che ricomprime, tre moduli così fanno di nuovo otto, e il conto di prima regge. Stessi numeri da regolare, e il modello riesce meglio.
La FFN applica a ogni posizione, separatamente e con gli stessi pesi, due trasformazioni lineari con una ReLU in mezzo:
Nel modello base la dimensione interna è \(d_{\text{ff}} = 2048\), quattro volte \(d_{\text{model}} = 512\): la FFN espande, applica la non linearità, ricomprime. Il fattore quattro è una scelta degli autori, non una derivazione: nella Tabella 3 dell’articolo una FFN più larga dà risultati migliori a parità del resto (con \(d_{\text{ff}} = 4096\) il BLEU sale da 25,8 a 26,2, con \(d_{\text{ff}} = 1024\) scende a 25,4), al prezzo di più parametri. Pur essendo la parte concettualmente più semplice, contiene circa due terzi dei parametri di uno strato di encoder (\(2\,d\,d_{\text{ff}} = 8d^2\) contro i \(4d^2\) delle quattro proiezioni dell’attenzione); negli strati di decoder, che hanno una seconda attenzione, la quota scende a metà. Nei grandi modelli linguistici, che sono decoder-only e quindi senza cross-attention, si torna ai due terzi, ed è lì che sta la maggior parte dei parametri. Una linea di ricerca legge la FFN come una memoria chiave-valore: le colonne di \(\mathbf{W}_1\) fanno da chiavi che si accendono su configurazioni dell’ingresso, e le righe corrispondenti di \(\mathbf{W}_2\) da valori che spostano la previsione del token successivo [GSBL21]. È un’interpretazione sostenuta da esperimenti, non una proprietà dell’architettura.
Questa è però la FFN del paper originale. I modelli successivi ne hanno cambiato la non linearità: prima la GELU [HG16], una ReLU ammorbidita (GPT, BERT, GPT-2), poi le varianti gated proposte da Shazeer [Sha20], e fra queste SwiGLU, che è la scelta prevalente nei modelli recenti:
dove \(\mathbf{W}_1, \mathbf{W}_3 \in \mathbb{R}^{d \times d_{\text{ff}}}\) e \(\mathbf{W}_2 \in \mathbb{R}^{d_{\text{ff}} \times d}\), \(\odot\) è il prodotto elemento per elemento, e nella Swish \(z\) è un numero singolo (la funzione si applica componente per componente) e \(\sigma\) è la sigmoide, così che \(\mathrm{Swish}\) sia una ReLU ammorbidita: quasi \(z\) per \(z\) grande, quasi zero per \(z\) molto negativo. (Shazeer chiama \(\mathbf{V}\) la matrice del ramo lineare; qui la lettera è già impegnata dai value dell’attenzione, e riusarla sarebbe una trappola.)
Il ramo che porta la Swish fa da cancello: moltiplicando elemento per elemento, decide quanto lasciar passare di ciascuna unità del ramo lineare \(\mathbf{x}\mathbf{W}_3\). Le matrici diventano tre invece di due, e per non gonfiare il conteggio dei parametri si riduce la dimensione interna da \(4d\) a circa \(\tfrac{8}{3}d\): così \(3 \cdot d \cdot \tfrac{8}{3}d = 8d^2\), esattamente quanto \(2 \cdot d \cdot 4d\) della versione classica. Stessi parametri, e nelle prove di Shazeer perplessità più bassa a parità di passi di addestramento; spiegazioni teoriche, l’autore dichiara di non averne.
Con la feed-forward il giro è completo, e quasi tutti i pezzi del blocco c’erano già prima del 2017: l’attenzione con il prodotto scalare, nella traduzione; la self-attention, in lavori sulla lettura e sul riassunto di testi; la piccola rete applicata a ogni posizione, come quelle del capitolo sulle reti neurali; la connessione residua e la normalizzazione; e perfino la codifica posizionale, che le reti convoluzionali per la traduzione usavano già, imparata. Come novità l’articolo porta la scala \(1/\sqrt{d_k}\), le teste multiple e le sinusoidi; e soprattutto il montaggio, perché il Transformer è il primo modello per trasformare una sequenza in un’altra che si regge sulla sola attenzione, senza ricorrenza né convoluzione [VSP+17]. Impila quel blocco, sempre nello stesso ordine: sei volte nel modello del 2017, qualche decina di volte in quelli su cui si fanno i conti oggi.
Per questo lo stesso blocco ha potuto crescere di quasi tremila volte, dai 65 milioni di parametri del modello base del 2017 ai 175 miliardi di GPT-3, tre anni dopo. Sono cambiate alcune scelte (dove sta la normalizzazione, la non linearità della feed-forward, il modo di scrivere la posizione) ed è cambiato il montaggio delle pile; il blocco, un’attenzione e una rete per posizione con scorciatoia e taratura attorno, è rimasto quello. Più che cambiarlo, bastava ripeterlo.
GPT-3 dice anche un’altra cosa, da anticipare perché altrimenti si resta con l’idea che il Transformer sia una macchina per tradurre e basta. È un Transformer solo decoder: tiene la pila che scrive, toglie quella che legge e con essa la cross-attention, così che dei tre sotto-strati di ogni blocco ne restano due, ed è addestrato a prevedere il token successivo. Davanti a un testo qualsiasi lo continua, e continuare un testo che è una domanda somiglia molto a rispondere. Le famiglie di modelli che nascono da questa scomposizione sono l’argomento della sezione sulle famiglie di modelli.
Da ricordare
Il Transformer originale è fatto di due torri: una legge la frase di partenza, l’altra scrive la traduzione. Sei piani ciascuna, fatti tutti allo stesso modo.
Ogni piano alterna una riunione (con l’attenzione, ogni parola ascolta tutte le altre; a condurla sono otto lettori in parallelo, ognuno attento a un tipo di legame) e un lavoro individuale (ogni parola rielabora per conto suo quello che ha sentito). Attorno a entrambi i momenti c’è l’impalcatura che permette di impilare tanti piani senza che l’addestramento si rompa.
La torre che scrive ha una regola ferrea, non si sbircia avanti: mentre produce la quarta parola può guardare solo le prime tre. E a ogni passo consulta quello che l’altra torre ha capito della frase originale.
L’attenzione da sola non sa in che ordine stanno le parole: a ciascuna viene sommato prima un posto numerato, la firma della sua posizione (calcolata a tavolino nel paper del 2017; i modelli successivi la fanno in altri modi, ma il posto numerato serve a tutti).
Da ricordare
Il Transformer originale è encoder-decoder: \(n_{\text{strati}} = 6\) strati per pila, \(d_{\text{model}} = 512\), 8 teste di attenzione.
Ogni strato alterna attenzione (le posizioni si scambiano informazione) e FFN (ogni posizione rielabora per conto suo), con residual e layer norm attorno a ogni sotto-strato.
Il decoder usa la maschera causale (vietato guardare il futuro) e la cross-attention verso l’encoder.
L’attenzione ignora l’ordine: la codifica posizionale (sinusoidale nel paper, appresa o relativa nei modelli successivi) lo reintroduce.
Prima delle famiglie di modelli resta da guardare il prezzo. Il confronto con i modelli precedenti mette il costo dell’attenzione accanto ai vantaggi che ha portato, e la sezione sull’attenzione in pratica lo rilegge mentre il modello genera, una parola alla volta.