


RAG avanzato: oltre il recupero ingenuo#
«Su cosa salta il gatto nero?». Nella sezione «Cercare per rispondere» il nostro cercatore in miniatura aveva risposto quasi bene: al primo posto il passaggio giusto, «Il gatto nero salta sul muro del giardino». Ma al secondo posto si era intrufolato un impostore, «Il gatto dorme accanto ai fornelli»: vicino per tema, muto sulla domanda. Era il quasi-pertinente, e non era un incidente di percorso.
Era il sintomo di un limite di fondo. Se il passaggio giusto non viene ripescato, il generatore non ha modo di rimediare: gli resta solo ricordare, e ricordando un modello inventa molto più che leggendo, senza per giunta lasciare accanto la fonte con cui lo si potrebbe controllare. La quota dei passaggi giusti che la ricerca riesce a ripescare ha un nome, la recall, ed è il tetto di tutto il sistema: nessun accorgimento applicato dopo può recuperare ciò che la ricerca non ha trovato.
Quanto sia duro quel tetto lo ha misurato l’articolo che ha inaugurato la RAG. Prendiamo le domande in cui la risposta non compare in nessuno dei documenti recuperati: il sistema di Lewis e colleghi le azzecca comunque poco più di una volta su dieci, l’\(11{,}8\%\) su Natural Questions, che è una raccolta di domande vere rivolte a un motore di ricerca [LPP+20]. Quel po’ che resta viene dalla memoria del modello, cioè da quello che gli era rimasto impresso in addestramento.
Il numero si legge in due modi. In un senso è tanto: un sistema che sapesse soltanto ritagliare la risposta dai documenti che ha davanti, senza poterla ricordare, in quei casi prenderebbe zero. In un altro senso è pochissimo: l’88,2% di quelle domande resta senza risposta giusta. È il dato di un sistema del 2020 su una sola raccolta, e dà l’ordine di grandezza di quanto si perde quando la ricerca manca il bersaglio.
La RAG di base prendeva i pochi passaggi più vicini alla domanda (diciamo i primi cinque), trovati con il cercatore di DPR [KOuguzM+20], e li incollava nel prompt prima di far scrivere la risposta. È un ottimo punto di partenza e un pessimo punto di arrivo.
E non la rende superflua la finestra lunga: con contesti da centinaia di migliaia di token si potrebbe incollare nel prompt l’archivio intero, e Li e colleghi trovano che, con risorse sufficienti, il contesto lungo dà in media risposte migliori, ma costa molto di più; il loro Self-Route sceglie domanda per domanda fra le due strade e si avvicina al contesto lungo spendendone una frazione [LLZ+24].
Le tecniche per migliorare la catena sono tre, e si distinguono per il punto in cui intervengono lungo la pipeline, la catena di passi che porta dalla domanda alla risposta. Prima di cercare si migliora la domanda, e questo alza la recall. Dopo aver cercato si riordinano i candidati, e questo alza la precisione, cioè la quota di materiale buono fra quello che arriva al generatore, e permette di pescare più candidati all’inizio senza consegnarli tutti. Attorno all’intero ciclo si lascia decidere al modello se e quando cercare, e questo alza la recall sulle domande che una ricerca sola non risolve. Chiudiamo con la domanda che fa da arbitro a tutto il resto: come si misura se un sistema RAG funziona davvero.

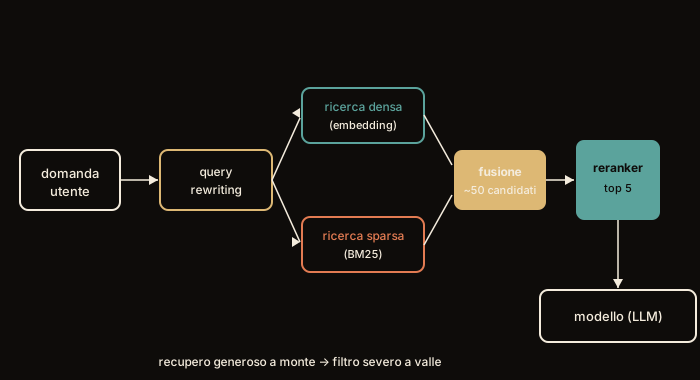
Fig. 20.8 La catena per intero. Rispetto alla RAG di base cambiano tre cose: la domanda non va a cercare com’è arrivata, la ricerca è doppia (per significato e per parole così come sono scritte) e fra il recupero e il modello si interpone un riordino.#
La regola che governa Fig. 20.8 è una sola: il recupero grezzo, quello all’inizio, deve essere generoso (meglio cento candidati mediocri che dieci scelti male, perché ciò che non entra lì è perduto per sempre) e ciò che viene dopo deve essere severo, perché al modello arrivi poco e buono. È il senso della scritta in fondo al disegno, dove a monte vuol dire all’inizio della catena e a valle alla fine, come per un fiume.
Il disegno chiama «densa» la prima delle due ricerche. La ricerca densa confronta gli embedding, i vettori di \(\mathbb{R}^d\) che stanno sulla mappa del significato di «Cercare per rispondere»: domanda e passaggi sono vettori, e si prendono i passaggi più vicini alla domanda (per coseno o prodotto scalare), anche quando non condividono una parola. La ricerca sparsa confronta invece i termini: il punteggio di un passaggio cresce con le occorrenze dei termini della domanda, pesa di più i termini rari (trovare «guarnizione» vale molto più che trovare «il») e tiene conto della lunghezza del passaggio. La funzione standard è BM25, degli anni Novanta, che resta una base di confronto difficile da battere fuori dal dominio su cui i cercatori densi sono stati addestrati [TRRuckle+21].
Le due ricerche sbagliano in modi diversi, ed è per questo che conviene farle entrambe. La densa avvicina «auto» e «vettura», ma può mancare un codice di prodotto scritto identico; la sparsa il codice lo trova al primo colpo, ma davanti a un sinonimo non trova niente.
Cercando due volte, però, ci si ritrova con due classifiche invece che con una, e vanno rimesse insieme: è la fusione del disegno. C’è un ostacolo, e un modo elegante di aggirarlo. L’ostacolo è che le due ricerche danno punteggi calcolati in modi diversi, e sommarli non vorrebbe dire niente, come sommare un voto in decimi a uno in centesimi. Il modo più robusto di aggirarlo, quando non si hanno esempi su cui tarare niente, è buttare via i punteggi e tenere solo la posizione in classifica: chi sta in alto in tutte e due le liste sale, chi sta in alto in una sola resta indietro, e non serve sapere quanto valgano i due voti né come siano stati calcolati. La regola che lo fa si chiama reciprocal rank fusion. Se invece si ha qualche esempio con la risposta nota, si può fare di meglio: si riportano i due punteggi sulla stessa scala e li si somma con un peso tarato sugli esempi [BGI23].
Fig. 20.9 guarda la stessa catena da un’altra angolatura: non dove si interviene, ma quando si paga.

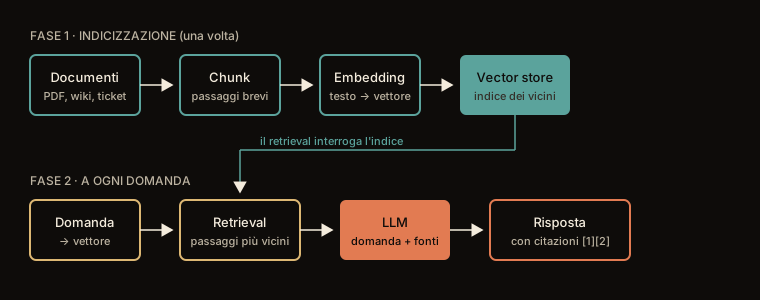
Fig. 20.9 Due fasi con tempi diversi. Nella prima si prepara l’archivio: i documenti si spezzano in passaggi (nel disegno, col nome inglese, chunk), ogni passaggio diventa un embedding e va a finire in un archivio di vettori (vector store). Si paga una volta sola e si riusa sempre. La seconda fase, invece, si paga a ogni domanda: si cercano i passaggi più vicini (retrieval), si incollano nel prompt e il modello risponde citando le fonti.#
Le tecniche che seguono intervengono quasi tutte nella seconda fase, quella che si paga di nuovo a ogni domanda ricevuta e che decide quanti secondi l’utente aspetta prima di vedere qualcosa, cioè la latenza. Ce n’è però una anche nella prima, ed è la più economica, perché si paga una volta: tagliare bene i passaggi e dare a ciascuno un po” del documento da cui viene. Il contextual retrieval di Anthropic antepone a ogni passaggio, prima di calcolarne l’embedding e di indicizzarlo per BM25, da cinquanta a cento token scritti da un modello che lo situano nel suo documento; sul proprio insieme di prova la quota di passaggi giusti mancati fra i primi venti scende dal 5,7% al 3,7%, e all’1,9% aggiungendo BM25 sul testo arricchito e il riordino [For24]. È una misura interna di un fornitore (settembre 2024).
Migliorare la domanda: riscrittura ed espansione#
La domanda dell’utente non coincide con la query, il testo che si manda davvero al cercatore, e la prima leva consiste nel non farle coincidere. La ricerca per significato presume che la query e il passaggio giusto abbiano embedding vicini; ma una domanda breve, ellittica o che dipende dalla conversazione è spesso una query povera, perché le mancano i termini che il passaggio giusto contiene. Chi ha appena letto una pagina sulla manutenzione dell’automobile e digita «e il tagliando?» manda a cercare tre parole che non dicono di quale tagliando si parla, e il manuale d’officina non lo trova.
L’idea è interporre, tra l’utente e la ricerca, un passaggio di riscrittura: un modello di linguaggio riformula la domanda in una o più query pensate per la ricerca. Le varianti sono tre, di ambizione crescente. La riscrittura rende esplicito il sottinteso («il tagliando» → «manutenzione periodica dell’automobile, intervalli e operazioni»). L’espansione aggiunge sinonimi e termini correlati, così da coprire più modi di dire la stessa cosa. La multi-query genera diverse riformulazioni della stessa domanda, cerca con ciascuna e fonde i risultati: se anche una sola variante «azzecca» le parole del documento giusto, quel documento entra.
«Ha qualcosa sul cane?». Se il bibliotecario prende la richiesta alla lettera cercherà la parola «cane» e ti porterà Il cane di terracotta, un romanzo che con i cani non c’entra nulla. Un bibliotecario esperto invece ci pensa su un attimo, capisce che cerchi l’educazione del cucciolo, e fa tre ricerche mirate: addestramento del cane, comportamento del cucciolo, comandi di base. Con tre reti gettate in punti diversi, la probabilità di tirare su il libro giusto sale.
C’è un trucco che a prima vista sembra assurdo. Invece di cercare con la domanda, cerchi con una risposta inventata: chiedi al modello di scrivere di getto la risposta ideale, dettagli sbagliati compresi, e poi cerchi i libri veri che somigliano a quella pagina finta. Gliene fai scrivere tre, diverse fra loro, e cerchi nel punto che sta in mezzo a tutte, la domanda di partenza compresa: uno sbaglio di una lo annegano le altre, e la domanda conta come una voce fra le quattro, non come quella che comanda. Funziona perché domanda e risposta sono scritte in modi diversi (una chiede, l’altra afferma), mentre due risposte sullo stesso tema si somigliano: l’esca finta pesca i libri veri meglio di quanto li peschi la domanda. Si chiama HyDE, dai «documenti ipotetici» che si fa scrivere.
Tutto dipende però da chi scrive l’esca. Se le tre paginette le butta giù uno che di cani non sa niente, portano lontano dallo scaffale giusto: meglio allora cercare con la domanda e basta. E c’è un caso in cui il trucco non è la prima cosa da provare: un cercatore si può addestrare sul proprio archivio, mostrandogli migliaia di domande con accanto i libri giusti, finché non impara a pescare quelli. Chi può permetterselo parte da lì; l’esca, sopra un cercatore già addestrato, a volte aiuta ancora e a volte peggiora, e lo si scopre solo provando. HyDE nasce per l’altro caso, il primo giorno, quando l’archivio è nuovo e nessuno ci ha ancora cercato niente.
Cercare con una risposta inventata invece che con la domanda ha un nome (HyDE, Hypothetical Document Embeddings [GMLC23]) e attacca un problema geometrico preciso: l’asimmetria tra query e documenti. Una domanda («su cosa salta il gatto?») e il passaggio che la soddisfa («il gatto salta sul muro») sono testi di forma diversa, e un encoder addestrato genericamente può collocarli non così vicini quanto vorremmo. HyDE aggira l’ostacolo: chiede a un LLM di generare \(M\) documenti ipotetici di risposta e interroga l’indice con la media dei loro embedding e di quello della query,
dove \(q\) è la domanda, le \(\tilde{d}_i\) sono \(M\) risposte ipotetiche campionate indipendentemente dal modello condizionato sulla domanda (il campionamento è essenziale: con una decodifica deterministica le \(M\) generazioni coinciderebbero e la media collasserebbe su un solo embedding), \(E_p\) l’encoder dei passaggi (lo stesso che ha indicizzato l’archivio, e che qui codifica anche la query, trattata come un documento in più) e \(\mathbf{v}_{\text{ricerca}}\) il vettore con cui si interroga l’indice. L’intuizione è che le \(\tilde{d}_i\), pur potendo contenere errori fattuali, vivono nello spazio delle risposte (la stessa regione dove abitano i passaggi veri) e ci somigliano più di quanto ci somigli la domanda. Attenzione però a non leggere il termine \(E_p(q)\) come un’àncora: la query entra nella media con peso \(1/(M+1)\), cioè conta esattamente quanto una delle ipotesi, e già con una manciata di documenti generati il suo contributo è minoritario. In pratica i documenti ipotetici sono generati dall’LLM e poi codificati con l’encoder dei documenti: le allucinazioni del modello non finiscono nella risposta finale, servono solo da esca per il recupero.
Il perimetro va dichiarato, perché è la cosa più utile a chi deve decidere se adottare il metodo, ed è scritta nel lavoro originale: HyDE nasce per il caso in cui non si hanno etichette di rilevanza, con un unico encoder contrastivo non supervisionato usato indifferentemente per query e documenti. Gli autori sono espliciti nel dire che l’uso con un retriever messo a punto sul proprio dominio non è quello previsto.
Il quadro che misurano è più sfumato di come lo si racconta di solito. Il voto è l’NDCG@10, che premia le classifiche che mettono in alto, nei primi dieci posti, i documenti giusti, ed è qui riportato in centesimi. Nel caso per cui è nato (Tab. 1 dell’articolo, generatore InstructGPT a temperatura \(0{,}7\)), senza etichette, HyDE porta l’NDCG@10 su TREC DL19 e DL20 a \(61{,}3\) e \(57{,}9\), da \(50{,}6\) e \(48{,}0\) di BM25 e da \(44{,}5\) e \(42{,}1\) del Contriever da cui parte; i retriever addestrati con le etichette stanno a \(62{,}2\) e \(65{,}3\) (DPR), \(64{,}5\) e \(64{,}6\) (ANCE), \(62{,}1\) e \(63{,}2\) (Contriever messo a punto). HyDE pareggia quasi i supervisionati su DL19 e resta da cinque a sette punti sotto su DL20. Sopra un retriever già addestrato sul dominio, invece, a decidere sono due cose insieme: quanto è buono il modello che genera le ipotesi, che stabilisce se si guadagna o si perde, e la raccolta su cui si misura, che stabilisce quanto. Con un generatore forte HyDE alza anche quel retriever, ma in modo asimmetrico: su DL19 da \(62{,}1\) a \(67{,}4\), su DL20 da \(63{,}2\) a \(63{,}5\), cioè tre decimi, che è niente. Con generatori più deboli lo peggiora su entrambe le raccolte, di poco. Dove le etichette ci sono, quindi, HyDE è una cosa da provare e misurare, non un guadagno che si somma a occhi chiusi. Gli autori stessi lo inquadrano come una fase: HyDE il primo giorno, quando non c’è ancora niente su cui addestrare, e via via che il registro delle ricerche cresce il traffico passa a un retriever supervisionato, lasciando a HyDE le domande rare e nuove.
Attenzione anche alla lettera della formula: qui c’è un encoder solo, mentre il bi-encoder di DPR scrive la similarità come \(E_q(q)^\top E_p(d)\), con due reti distinte. Applicare la ricetta di HyDE su un indice a due encoder significherebbe codificare la query con la rete sbagliata. Le riscritture multi-query si formalizzano invece come unione dei risultati, spesso fusi con la reciprocal rank fusion [CCButtcher09]: a ogni documento \(d\) si assegna il punteggio \(\mathrm{RRF}(d) = \sum_{m} 1/(c + \mathrm{rank}_m(d))\), con le lettere di «Cercare per rispondere»: la somma scorre le liste \(m\), \(\mathrm{rank}_m(d)\) è il rango di \(d\) nella lista \(m\) (contato da \(1\); una lista che non contiene \(d\) non contribuisce) e \(c\) una costante di smorzamento (\(60\) nell’articolo originale) che appiattisce il divario fra i primi posti: con \(c = 60\) il primo vale \(1/61 \approx 0{,}0164\) e il decimo \(1/70 \approx 0{,}0143\). Ne segue che un documento decimo in due liste (\(\approx 0{,}029\)) batte uno primo in una sola: la fusione premia l’accordo fra le liste più della vetta di una sola.
Riordinare i candidati: il reranking#
Riordinare vuol dire prendere quello che la ricerca ha pescato e rimetterlo in fila con più cura. Prima, però, conviene vedere come pesca un archivio vero, perché finora si è detto «prende i più vicini» senza dire come faccia a trovarli senza guardarli tutti.
Gli embedding sono vettori, cioè liste di numeri: quelli del mini-archivio di «Cercare per rispondere» erano lunghi quattro, e ciascuno dei quattro misurava quanto la frase parlasse di un certo tema (gatti, muri, automobili, cucina). In un sistema vero i numeri sono da qualche centinaio a qualche migliaio, e nessuno sa dire che cosa misuri ciascuno: li ha scelti l’addestramento.
La ricerca esatta confronta la domanda con ogni vettore dell’archivio, a uno a uno, e costa \(O(Nd)\) con \(N\) vettori di \(d\) numeri: insostenibile quando i passaggi sono milioni e le domande arrivano una dietro l’altra. Gli indici approssimati dei vicini più prossimi rinunciano alla garanzia di trovare sempre il vicino esatto in cambio di una ricerca enormemente più rapida. Uno dei più usati, HNSW, costruisce un grafo a strati (Fig. 20.10), con pochi nodi e archi lunghi in alto e tutti i nodi, collegati solo ai vicini, in basso, e lo percorre dall’alto, un po” come si raggiunge un posto lontano prima in autostrada, poi per le strade statali e infine per le vie del quartiere. Per strada qualche buon candidato si perde, ed è un altro motivo per cui il recupero grezzo va tenuto generoso.

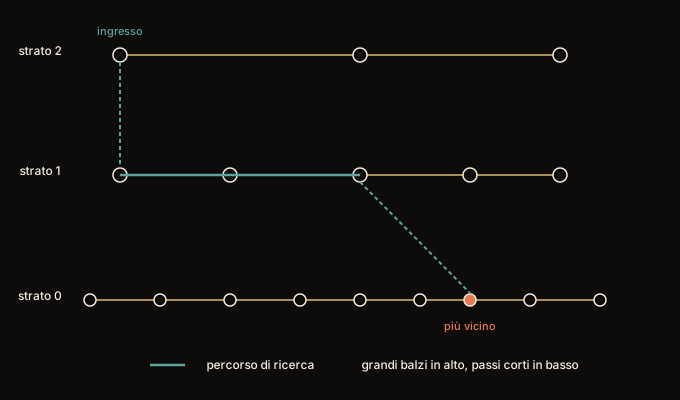
Fig. 20.10 Come si cerca fra milioni di vettori senza confrontarli tutti. Gli strati alti servono ad arrivare nella zona giusta con pochi salti lunghi; quelli bassi a trovare il vicino più prossimo con passi corti.#
La seconda leva agisce a valle del recupero, e poggia sulla distinzione fra due modi di confrontare una domanda con un passaggio. Il bi-encoder codifica domanda e passaggio separatamente e li confronta con un prodotto scalare: gli embedding dei passaggi si calcolano una volta, quando si prepara l’archivio, e la ricerca è velocissima. Il cross-encoder dà i due testi insieme a un unico Transformer, che emette un punteggio di pertinenza per la coppia: è molto più accurato, perché i token dell’uno guardano quelli dell’altro e il modello può accorgersi che una frase parla dello stesso argomento senza rispondere alla domanda, ma non si può precalcolare niente, e passare in rassegna così milioni di documenti è fuori discussione. La soluzione è usarli in due stadi.
Il primo stadio, il bi-encoder, fa il grosso: percorre l’archivio con l’indice approssimato e restituisce non i pochi passaggi che finiranno sotto gli occhi del modello, ma molti più candidati grezzi (cinquanta, cento) tra cui, si spera, ci sono anche i migliori. Il secondo stadio, il reranker cross-encoder, si applica solo a quella rosa ristretta e la riordina con cura, promuovendo i passaggi che davvero rispondono e affondando i quasi-pertinenti. È il compromesso classico dell’ingegneria del recupero: recuperare tanto e alla svelta, poi riordinare poco e per bene.
Mille curriculum per un posto, e un colloquio dura due ore: nessuno li fa tutti. Si fa prima una scrematura rapida, uno sguardo per foglio, e si tengono i cinquanta più promettenti; il colloquio vero, quello che costa tempo ma capisce chi hai davanti, si fa solo a quei cinquanta. Il bi-encoder è la scrematura: veloce, superficiale, va bene per buttare via i chiaramente fuori tema. Il cross-encoder è il colloquio: lento, ma guarda insieme il candidato e il posto da coprire, e non si fa ingannare da chi «suona simile» senza rispondere. Farlo a tutti e mille sarebbe rovinoso; farlo ai cinquanta scremati è esattamente il punto giusto.
La scrematura, però, perde i dettagli: un’occhiata al foglio intero dà un’impressione sola, e il candidato che ha proprio quello che serve in una riga finisce mescolato con il resto. Chi di curriculum ne legge tanti usa una via di mezzo. Va requisito per requisito: per «sa l’inglese?» cerca la riga del curriculum che ci va più vicino («tre anni a Londra»), per «sa guidare?» la riga più vicina («patente B»), e alla fine somma quanto ciascuna riga trovata somigliava al suo requisito. Le righe di ogni curriculum si possono schedare in anticipo, prima ancora di sapere per quale posto serviranno, e al momento della selezione restano da fare solo gli abbinamenti. È quasi fine come il colloquio, perché guarda i dettagli uno per uno, e quasi veloce come la scrematura, perché il grosso è già fatto; il prezzo è lo schedario, molto più grosso, con una scheda per ogni riga invece che una per candidato (e c’è modo di stringerlo parecchio). Si chiama ColBERT.
La struttura che rende possibile la ricerca «per scale» della figura è HNSW [MY20] (Hierarchical Navigable Small World): un grafo a strati in cui quelli alti tengono pochi nodi con archi lunghi, buoni per attraversare in fretta lo spazio, e quelli bassi tutti i punti con archi solo fra vicini. La discesa strato per strato è una ricerca approssimata: in cambio della garanzia di esattezza, il numero di confronti cresce molto più lentamente della dimensione dell’archivio, e raddoppiare i vettori costa un pugno di confronti in più invece del doppio.
Sulla forma esatta di quella crescita conviene però essere precisi, perché è il punto in cui si tende a promettere un teorema che non c’è. Gli autori sostengono una scalabilità logaritmica rispetto a \(N\), il numero di vettori nell’archivio, con un ragionamento che vale per un grafo di Delaunay esatto e di grado limitato, mentre HNSW ne costruisce solo un’approssimazione. La misurano poi su dati sintetici a bassa dimensione. A quattro dimensioni il parametro di ricerca che serve per una recall fissata smette di crescere quando l’archivio si allarga; a otto dimensioni, con dieci vicini cercati e la recall ferma a \(0{,}95\), osservano una complessità «non peggiore che logaritmica». È evidenza empirica, non una garanzia dimostrata in generale. E il logaritmo è in \(N\): il prezzo di vettori più lunghi non sparisce, si paga nel costo del singolo confronto e, sui dati veri ad alta dimensione (duecento milioni di descrittori SIFT a 128 dimensioni), anche in uno scostamento dal logaritmo che gli autori stessi registrano.
Formalmente il primo stadio ordina l’archivio con la similarità del bi-encoder già incontrata, \(E_q(q)^\top E_p(d)\) (\(d\) è il passaggio, \(E_p\) il suo encoder: le lettere sono quelle di HyDE, e «Cercare per rispondere» chiamava gli stessi due oggetti \(z\) ed \(E_z\)), e ne trattiene i primi \(k_1\); il secondo riordina questi \(k_1\) con il punteggio del cross-encoder \(\mathrm{score}(q, d) = \mathrm{CrossEnc}([q; d])\), dove \([q; d]\) è la concatenazione dei due testi data in input a un unico Transformer, e tiene i primi \(k\), cioè i passaggi che entreranno davvero nel prompt del generatore (si sceglie \(k_1 \gg k\): tipicamente \(k_1\) nell’ordine delle decine o centinaia, \(k\) pochi; \(N\) resta la dimensione dell’archivio, che è un’altra cosa e di parecchi ordini di grandezza più grande). Il costo del reranking è \(k_1\) inferenze di cross-encoder per query: accettabile con quei valori di \(k_1\), proibitivo sull’intero archivio.
Questa disposizione a stadi ha una sua letteratura, e conviene sapere dove guardare: Nogueira, Yang, Cho e Lin la montano con un cross-encoder BERT (il nome con cui si trova citata è monoBERT) e misurano che \(k_1\) è la manopola con cui si sceglie il punto di equilibrio fra qualità e latenza [NYCL19]. Da qui l’indicazione pratica su come sceglierlo: alzare \(k_1\) fa guadagnare recall ma costa attesa, quindi il valore giusto dipende da quanto l’attesa pesi nel sistema che si sta costruendo.
Tra i due estremi esiste una via di mezzo elegante: l’interazione tardiva di ColBERT [KZ20]. Invece di collassare ogni testo in un vettore (bi-encoder) o di rifare l’attenzione congiunta a ogni query (cross-encoder), ColBERT conserva un embedding per token e calcola la rilevanza con l’operatore MaxSim:
dove \(q_i\) è l’\(i\)-esimo token della query, \(d_j\) il \(j\)-esimo del documento, ed \(E(\cdot)\) il loro embedding contestuale: qui l’encoder è uno solo, che però legge la query e il documento con un marcatore diverso in testa. Per ogni token della domanda si prende la migliore corrispondenza tra i token del documento e si sommano: un confronto fine, token-a-token, ma con gli embedding dei documenti precalcolabili offline come nel bi-encoder. Nell’articolo ColBERT ottiene prestazioni paragonabili ai reranker basati su BERT, con una latenza di due ordini di grandezza più bassa e quattro ordini di grandezza in meno di operazioni per query; il prezzo è un indice molto più grande (un vettore per token, non per passaggio), che ColBERTv2 riduce da sei a dieci volte comprimendo i vettori come scarti da un centroide [SKSF+22].
Vediamo il riordino in azione, estendendo il cercatore in miniatura di «Cercare per rispondere». Teniamo lo stesso mini-archivio (ogni frase è riassunta da quattro numeri, uno per ciascuno dei quattro temi presenti: gatti, muri, automobili, cucina) e la stessa domanda; aggiungiamo lo stadio di reranking. Il punteggio del primo stadio è il coseno fra gli embedding, la stessa misura con cui era stato costruito il cercatore, che con le coordinate positive di questo giocattolo sta fra \(0\) (niente in comune) e \(1\) (stessa direzione).
Il cross-encoder è finto, non è un vero modello addestrato, ma imita la cosa che conta: legge la coppia. Il bi-encoder ha schiacciato ogni frase in un punto solo, e da lì «gatto» e «salta» sono ormai mescolati; il nostro reranker riceve invece domanda e passaggio e conta quanti concetti della domanda il passaggio copre. È lì la differenza: guardando i due testi insieme si vede se il gatto e il saltare ci sono tutti e due, e a rispondere non è il gatto, e nemmeno il saltare, ma un gatto che salta.
La regola esatta, così il conto si può rifare a mente: ogni concetto della domanda che il passaggio copre vale un punto, e ogni coppia di concetti coperti insieme ne vale due. La domanda porta tre concetti (gatto, nero, saltare); il passaggio giusto li copre tutti e tre, quindi fa \(3\) punti per i concetti più \(2 \times 3 = 6\) per le tre coppie che se ne ricavano, in tutto \(9\). «Il gatto dorme accanto ai fornelli» copre il solo «gatto»: un concetto, nessuna coppia, un punto. Il premio alle coppie non sposta la classifica, perché il conto si semplifica nel quadrato dei concetti coperti: con \(c\) concetti le coppie sono \(c(c-1)/2\), e \(c + 2 \cdot c(c-1)/2 = c^2\), cioè \(3^2 = 9\) contro \(1^2 = 1\). Tutto il suo lavoro lo fa sulla distanza fra i punteggi, che è quello che serve qui. Ed è la sola cosa finta di tutto il blocco: un cross-encoder vero non conta le coppie, legge quali concetti sono e come stanno insieme nella frase, e non lo si scrive a mano, lo si impara dagli esempi.
import torch
from itertools import combinations

# --- Stadio 1: recupero grezzo con il bi-encoder ---
# stesso mini-archivio della sezione «Cercare per rispondere»:
# quattro dimensioni leggibili [gatti, muri/casa, automobili, cucina].
passaggi = [
    "Il gatto nero salta sul muro del giardino.",
    "Il muro portante sostiene il solaio.",
    "La vettura elettrica si ricarica in garage.",
    "L'auto storica sfila per il centro.",
    "Il gatto dorme accanto ai fornelli.",
    "La ricetta prevede burro e salvia.",
]
E = torch.tensor([
    [0.9, 0.6, 0.0, 0.1],
    [0.1, 0.9, 0.1, 0.0],
    [0.0, 0.1, 0.9, 0.0],
    [0.1, 0.0, 0.8, 0.1],
    [0.8, 0.2, 0.0, 0.5],
    [0.0, 0.1, 0.1, 0.9],
])
E = E / E.norm(dim=1, keepdim=True)   # righe normalizzate: prodotto = coseno

domanda = "Su cosa salta il gatto nero?"
q = torch.tensor([0.9, 0.7, 0.0, 0.0])
q = q / q.norm()

# il bi-encoder e' veloce, quindi copre tutto l'archivio (qui sei passaggi, e
# li confrontiamo davvero uno a uno; in un archivio vero si userebbero gli
# strati della figura, che coprono tutto senza toccare tutto). Ma e' grezzo.
# recuperiamo di proposito piu' candidati di quanti ne serviranno: sono il
# terreno di caccia dello stadio successivo.
sim = E @ q
val, cand = torch.topk(sim, k=4)

print("Stadio 1 - bi-encoder (veloce, tutto l'archivio):")
for v, i in zip(val, cand):
    print(f"  coseno {v:.2f}  {passaggi[i]}")

# --- Stadio 2: reranking con un "cross-encoder" didattico ---
# Il bi-encoder ha collassato ogni frase in un unico vettore: cosi' un
# passaggio che condivide solo il tema "gatto" gli sembra vicino. Un
# cross-encoder legge domanda e passaggio INSIEME. Qui lo simuliamo con i
# concetti dei due testi, allargando la distanza fra chi copre tutta la
# domanda e chi ne copre un pezzo: a rispondere non e' il gatto, ne' il
# saltare, ma un gatto CHE SALTA.
concetti = {
    domanda: {"gatto", "nero", "saltare"},
    0: {"gatto", "nero", "saltare", "muro", "giardino"},  # copre tutto: risponde
    1: {"muro", "portante", "solaio"},
    2: {"vettura", "garage"},
    3: {"auto", "centro"},
    4: {"gatto", "dormire", "fornelli"},   # solo il tema "gatto": quasi-pertinente
    5: {"ricetta", "burro"},
}

def cross_encoder(domanda, i):
    """Punteggio della COPPIA (domanda, passaggio), non del solo passaggio.
    Ogni concetto della domanda coperto vale 1; ogni coppia di concetti
    coperti INSIEME vale 2, e i due termini insieme fanno il quadrato dei
    concetti coperti: stessa classifica, distanze molto piu' larghe."""
    coperti = concetti[domanda] & concetti[i]
    return len(coperti) + 2 * len(list(combinations(coperti, 2)))

# il cross-encoder e' costoso: lo applichiamo SOLO ai candidati dello stadio 1
riordino = sorted(cand.tolist(), key=lambda i: cross_encoder(domanda, i),
                  reverse=True)

print("\nStadio 2 - cross-encoder (preciso, solo sui 4 candidati):")
for i in riordino:
    print(f"  pertinenza {cross_encoder(domanda, i):.1f}  {passaggi[i]}")

# ora che i punteggi sono separati, una soglia ha senso: passa solo chi si
# avvicina al migliore, invece di riempire a forza un numero fisso di posti.
# Il minimo assoluto non e' un dettaglio: se nessuno rispondesse varrebbero
# tutti zero, e meta' di zero lascia passare tutti.
migliore = cross_encoder(domanda, riordino[0])
soglia = max(migliore / 2, 1)
rosa = [i for i in riordino if cross_encoder(domanda, i) >= soglia]

print("\nAl generatore va solo chi supera meta' del punteggio migliore:")
for n, i in enumerate(rosa, 1):
    print(f"  [{n}] {passaggi[i]}")
Stadio 1 - bi-encoder (veloce, tutto l'archivio):
  coseno 0.99  Il gatto nero salta sul muro del giardino.
  coseno 0.78  Il gatto dorme accanto ai fornelli.
  coseno 0.69  Il muro portante sostiene il solaio.
  coseno 0.10  L'auto storica sfila per il centro.

Stadio 2 - cross-encoder (preciso, solo sui 4 candidati):
  pertinenza 9.0  Il gatto nero salta sul muro del giardino.
  pertinenza 1.0  Il gatto dorme accanto ai fornelli.
  pertinenza 0.0  Il muro portante sostiene il solaio.
  pertinenza 0.0  L'auto storica sfila per il centro.

Al generatore va solo chi supera meta' del punteggio migliore:
  [1] Il gatto nero salta sul muro del giardino.
Ecco il punto, e non è quello che ci si aspetterebbe. L’ordine dei primi due non cambia: il quasi-pertinente «Il gatto dorme accanto ai fornelli» era secondo e resta secondo. Quello che cambia è il significato della distanza fra il primo e il secondo. Il bi-encoder li dava a \(0{,}99\) e \(0{,}78\), e nel giocattolo una soglia a \(0{,}9\) basterebbe già; ma è un effetto dei sei vettori scritti a mano. Con un modello vero la scala dei coseni cambia da un modello all’altro e da una domanda all’altra: un coseno di \(0{,}8\) può voler dire «risponde» per una domanda e «parla d’altro» per un’altra, e una soglia fissa sui coseni non si trasferisce. Il cross-encoder finto dà \(9{,}0\) contro \(1{,}0\) perché la sua regola fa il quadrato dei concetti coperti; uno vero è addestrato proprio a separare i passaggi che rispondono da quelli che parlano solo dello stesso tema, e sul suo punteggio una soglia si può tarare una volta, su un campione di domande di cui si conosce la risposta.
Da lì viene il guadagno vero, che è una decisione diventata possibile. Senza una soglia di cui fidarsi l’unica regola disponibile è «prendine i primi \(k\)», e riempiendo i posti si finisce per infilare nel prompt un passaggio che non risponde. Con punteggi separati si può mettere una soglia: qui teniamo chi supera metà del punteggio migliore, cioè \(4{,}5\), e l’unico a passare è il \(9\). Metà, però, vuole un minimo assoluto sotto, qui un punto: una domanda a cui nessun passaggio risponde li farebbe passare tutti, perché metà di zero è zero. Al generatore arriva un passaggio solo, quello giusto, senza compagnia fuorviante. Notiamo anche che «Il muro portante sostiene il solaio», che pure condivide una parola con la risposta, finisce a zero, ed è corretto: la domanda parlava di un gatto che salta, non di solai.
Non abbiamo alzato la recall, perché il passaggio giusto era già stato recuperato. Abbiamo alzato la precisione, la quota di passaggi utili fra quelli che consegniamo al generatore. Sono due misure gemelle e descrivono due problemi diversi: la recall dice quanto ci siamo persi per strada, la precisione quanto materiale irrilevante abbiamo consegnato insieme a quello utile. Il tetto del sistema resta il primo, perché ciò che non si trova non si recupera più; ma la seconda si può alzare a valle, ed è quello che abbiamo appena fatto, guadagnando la capacità di dire di no.
Il RAG che si corregge: Self-RAG e RAG agentico#
Fin qui abbiamo migliorato una catena che resta rigida: cerca sempre, una volta sola, poi genera. E cade in due modi opposti.
Cercare quando non serve è uno spreco, e non solo di tempo. «Traduci «buongiorno» in francese» non ha bisogno di alcun archivio, ma il sistema rigido ci va lo stesso, e quel che riporta finisce nel prompt: passaggi che non c’entrano niente, davanti agli occhi del modello, con qualche probabilità di distrarlo dalla cosa semplice che gli era stata chiesta.
Cercare una volta sola, all’opposto, a volte non basta. Ci sono domande la cui risposta vive nell’incrocio di due fatti che stanno in documenti diversi, e nessuna singola ricerca li riporta insieme: per trovare il secondo bisogna sapere il primo. Lì il sistema rigido non fallisce per distrazione, fallisce per costruzione.
La terza leva fa del recupero una decisione del modello: se cercare, quando e quante volte.
C’è anche una via diversa al secondo dei due problemi, e non passa dal cercare più volte: passa dal cambiare la forma dell’archivio. Se i fatti stanno in un knowledge graph, un grafo di conoscenza fatto di terne (soggetto, relazione, oggetto), come (Roma, capitale di, Italia), incrociare due fatti vuol dire percorrere due archi. Riprende l’idea, più avanti nel libro, la sezione sui knowledge graph, fra le reti su grafi. Un’idea vicina nel nome, GraphRAG [ETC+24], costruisce il grafo dal corpus con un modello di linguaggio, ne riassume in anticipo i gruppi di entità collegate e serve soprattutto alle domande che riguardano l’intero corpus («quali sono i temi principali di questi documenti?»), a cui nessuna ricerca di pochi passaggi può rispondere.
Torniamo allo studente all’esame a libro aperto. Lo studente ingenuo apre il libro a ogni domanda, anche a «quanto fa sette per otto»: perde tempo e rischia di copiare la pagina sbagliata. Lo studente maturo fa tre cose in più.
Si chiede se gli serve il libro, e non se lo chiede una volta sola: a metà di una risposta può saltare fuori una data che a memoria non ha, e allora apre; alle domande che sa già risponde e basta. E quando la pagina che ha davanti gli basta anche per la frase dopo, non ne cerca un’altra: tiene quella.
Quando lo apre, rilegge criticamente, con due domande diverse: «questa pagina risponde alla domanda che mi hanno fatto, o l’ho aperta a caso?» e, riga per riga, «quello che sto scrivendo sta davvero scritto qui, o l’ho aggiunto io?». E alla fine, che il libro l’abbia aperto o no, una terza: «quello che ho scritto serve a chi me l’ha chiesto?».
E se una pagina non basta ne apre un’altra, e un’altra ancora, finché non ha in mano tutto quello che serve; se gli vengono in mente due modi di rispondere, consegna quello che le pagine aperte reggono meglio, non quello che suona meglio.
Uno studente meno sicuro di sé fa un’altra cosa: prima di usare le pagine che ha aperto, chiede a un compagno di darci un’occhiata. Se il compagno dice «sono quelle giuste», le usa, ma ne tiene solo le righe che servono; se dice «non c’entrano», le chiude e va a cercare altrove, in rete; se non è sicuro, fa tutte e due le cose.
Non è più un gesto automatico (apri, copia) ma un piccolo ciclo di decisioni: mi serve cercare? ho trovato la cosa giusta? quello che ho scritto sta nelle pagine? serve a chi me l’ha chiesto? mi manca ancora qualcosa? È la differenza tra consultare un libro e saperlo consultare.
Chiedersi da sé se serve aprire il libro, rileggere con occhio critico quello che si è trovato e guardare alla fine se la risposta serve davvero sono le mosse di un modello che si chiama Self-RAG, cioè «RAG che si controlla da solo». Affidare il controllo delle pagine a un compagno è il Corrective RAG, o CRAG. Tornare a cercare quante volte serve fa invece il RAG agentico: lì cercare smette di essere un passo obbligato e diventa un attrezzo che si prende quando si vuole.
Il primo comportamento è Self-RAG [AWW+24]: il modello è
addestrato a emettere, intercalati al testo, degli speciali token di
riflessione. Le etichette per addestrarlo vengono da un modello critico, a sua
volta addestrato su giudizi di GPT-4, che inserisce i token nel corpus una volta
per tutte, prima dell’addestramento: il generatore impara poi con l’obiettivo
consueto, prevedere il token successivo, token di riflessione compresi, e non si
porta dietro nessun critico. Un token Retrieve decide, passo per passo, se in
quel momento serve recuperare (sì/no/continua, dove il terzo vuol dire
mantenere il passaggio corrente invece di cercarne un altro); quando
il recupero avviene, altri token critici danno tre giudizi diversi: se il
passaggio è rilevante per la domanda, se la frase appena generata è supportata
da quel passaggio o lo travisa, e se la risposta nel complesso serve a chi ha
fatto la domanda, che è l’unico dei tre a non guardare nessun passaggio e viene
emesso anche quando il recupero non c’è stato. In inferenza una ricerca a fascio
frase per frase sceglie il seguito con il punteggio più alto, che somma alla
probabilità del testo una combinazione pesata delle probabilità dei token
critici, e i pesi si possono cambiare all’uso, secondo che cosa conta di più. Il
modello impara così non solo a rispondere, ma a criticare le proprie fonti e sé
stesso, riducendo il caso in cui un passaggio recuperato ma irrilevante
trascina la risposta fuori strada.
Una variante dello stesso comportamento, Corrective RAG (CRAG) [YGZL24], mette il giudizio fuori dal generatore: un valutatore leggero (un T5-large messo a punto) assegna una confidenza ai documenti recuperati e fa scattare una di tre azioni. Se sono giusti (Correct), li scompone in frammenti, scarta quelli irrilevanti e ricompone il resto; se sono sbagliati (Incorrect), li scarta e ripiega su una ricerca web; se è incerto (Ambiguous), usa tutte e due le fonti. Lavora con qualunque cercatore e qualunque generatore, perché non chiede di riaddestrare nessuno dei due.
Il secondo comportamento è il RAG agentico: il recupero smette di essere un passo obbligato della pipeline e diventa uno strumento che un agente può invocare quando vuole, più volte, in un ciclo. È il tool use applicato alla ricerca (un modello che ragiona, decide di chiamare uno strumento, ne legge il risultato e decide la mossa successiva): l’agente formula una query, esamina i risultati, si accorge che gli manca un pezzo, formula una seconda query mirata, e itera finché ha raccolto abbastanza per rispondere. È ciò che serve alle domande multi-hop, dove la risposta vive nell’incrocio di fonti che nessuna singola ricerca restituisce insieme.
Ogni giro in più (una riscrittura, un riordino, una seconda tornata di ricerca, una pausa in cui il modello si chiede se quello che ha trovato serve davvero) vuol dire far lavorare il modello un’altra volta, e ogni volta si paga in attesa e in denaro, a token in ingresso e in uscita. Un RAG agentico che fa cinque giri non costa cinque volte un recupero secco: a ogni giro il modello rilegge tutto ciò che i giri prima hanno raccolto, e quella rilettura si paga per intero, a meno di usare la cache dei prefissi che alcuni fornitori offrono, con cui la parte già vista costa una frazione del prezzo pieno (un decimo, nel listino standard di Anthropic del 2026). Anche così il costo totale cresce più che linearmente con il numero di giri, e non è detto che la qualità cresca nella stessa misura. La domanda ingegneristica non è «quanti giri posso fare», ma «qual è il numero minimo di giri che risolve questa classe di domande»: sulle domande semplici, spesso, la risposta è zero.
Valutare un sistema RAG#
Tutte queste leve hanno senso solo se sappiamo dire quale migliora il sistema e quale no. Ma un RAG ha due pezzi, il cercatore e il generatore, e una risposta sbagliata può essere colpa dell’uno o dell’altro: o la ricerca ha mancato il documento giusto, o il documento c’era e chi ha scritto la risposta l’ha ignorato, o l’ha letto male. Un voto solo non distingue i due casi, e non offre indicazioni su dove intervenire. Servono misure separate, che sappiano dove guardare.
Un compito che cita le fonti non si corregge con un voto solo: le cose da guardare sono tre, e sono diverse fra loro. La fedeltà: prendi la risposta, la spezzi nelle singole affermazioni e per ognuna vai a vedere se sta davvero nella pagina citata; otto su dieci che reggono fanno \(0{,}8\), e quello è un voto, mentre «fedele» detto e basta non lo è. La pertinenza: la risposta parla della domanda che avevi fatto, o divaga su un tema vicino? Per saperlo basta coprire la domanda e chiedersi a quale domanda risponderebbe quel testo: se ne vengono in mente di molto diverse da quella vera, la risposta divaga. La qualità della ricerca: le pagine che ha aperto erano quelle giuste, o ne ha aperte di inutili e saltate di essenziali?
Fedeltà e pertinenza le giudichi con il solo compito davanti, e per metà anche la qualità della ricerca: le pagine inutili che ha aperto le vedi lì. Accorgersi che ne ha saltata una essenziale è un altro paio di maniche: devi sapere tu quali erano le pagine giuste, cioè esserti preparato la soluzione prima. Costa, e spesso si rinuncia.
Poi c’è la tentazione, quando i compiti sono migliaia: promuovere esaminatore un altro modello, che legge risposta e fonti e assegna i voti in un lampo. Comodissimo, a patto di ricordare che quell’esaminatore ha le sue debolezze: premia le risposte lunghe, si affeziona alla prima che ha letto, e secondo alcune misure preferisce le risposte scritte da lui. Va tenuto d’occhio come si tiene d’occhio uno studente che si autovaluta: si confrontano i suoi voti con quelli di una persona su un campione di compiti, e si vede quanto spesso vanno d’accordo.
Le metriche proprie di un sistema RAG smontano il giudizio nelle sue componenti. La fedeltà (o groundedness) misura se ogni affermazione della risposta è deducibile dai passaggi recuperati; un modo di stimarla è scomporre la risposta in singole claim e contare la frazione supportata dal contesto:
dove una claim è una singola affermazione verificabile estratta dalla risposta. La pertinenza della risposta valuta invece se la risposta indirizza la domanda posta (non un tema adiacente), e la precision/recall del contesto misurano la qualità del recupero a monte: quanti dei passaggi recuperati sono rilevanti (precision) e quanti dei rilevanti sono stati recuperati (recall); quest’ultimo è proprio il tetto da cui siamo partiti. Sul recupero da solo si usano la recall@k, la MRR e la nDCG definite nella sezione sul RAG: la recall@k misurata alla profondità che il generatore vedrà davvero è il tetto stesso, e la nDCG è la metrica dei numeri di HyDE su TREC DL. RAGAS [EJEAS24] è uno dei primi quadri di valutazione per la RAG (2023), con tre metriche senza risposte di riferimento (reference-free) affidate a un LLM che fa da giudice. La fedeltà è la frazione di affermazioni sostenute dal contesto. La pertinenza della risposta si stima al contrario: il giudice genera \(n\) domande a partire dalla risposta, e la metrica è la media dei coseni fra i loro embedding e quello della domanda vera, \(\mathrm{AR} = \frac{1}{n}\sum_{i=1}^{n} \cos(\mathbf{q}, \mathbf{q}_i)\); non guarda la fattualità, e penalizza le risposte incomplete o ridondanti. La rilevanza del contesto conta le frasi al posto dei passaggi, cioè la frazione di frasi del contesto recuperato che il giudice ritiene necessarie. Sul loro insieme di prova, con GPT-3.5 come giudice, la concordanza con i giudizi umani nei confronti a coppie è del 95% per la fedeltà, del 78% per la pertinenza e del 70% per la rilevanza del contesto. La recall del contesto fa eccezione: per contare i rilevanti mancati serve una risposta di riferimento annotata, e infatti la libreria la calcola solo se gliene si dà una. Il reference-free è comodo perché non richiede un dataset etichettato a mano, ma eredita in blocco i limiti dell’LLM-as-a-judge che vedremo più avanti, parlando di LLMOps: il position bias, il verbosity bias e una preferenza per i propri testi che lavori successivi misurano [PBF24]. Va perciò calibrato contro un campione di giudizi umani, mai preso per oracolo.
Un’ultima avvertenza, che vale per tutta la RAG. La fedeltà, la metrica più facile da scambiare per correttezza, non va confusa con la verità. Un sistema può essere perfettamente fedele e fattualmente sbagliato: se l’archivio contiene un documento errato, la risposta più fedele possibile a quel documento sarà errata, con tanto di citazione impeccabile. E vale anche il rovescio, già enunciato in «Cercare per rispondere»: una citazione formalmente corretta non rende vera una risposta che ne travisa il contenuto. La fedeltà dice che la risposta non ha inventato rispetto alle fonti; non dice nulla sulla bontà delle fonti, né sull’onestà con cui sono state riassunte. La RAG avanzata alza il tetto del recupero e ripulisce la rosa dei candidati, ma la qualità dell’archivio resta un presupposto che nessuna di queste tecniche garantisce.
Da ricordare
Quello che la ricerca non ripesca, la risposta quasi certamente non lo conterrà: la qualità del recupero è il tetto di tutto il sistema. Le tre leve intervengono prima di cercare (migliorare la domanda), dopo (riordinare i risultati) e attorno (decidere se e quando cercare): la prima e la terza alzano il tetto, la seconda ripulisce quello che si consegna al modello.
La domanda che scrive una persona è spesso un cattivo testo da mandare a cercare: troppo corta, piena di sottintesi. Conviene riscriverla, oppure farne tre versioni diverse e unire i risultati. C’è perfino il trucco di cercare con una risposta inventata (si chiama HyDE [GMLC23]), che fa da esca perché somiglia ai documenti veri più di quanto ci somigli la domanda. Nasce per il caso in cui non si ha modo di addestrare la ricerca sul proprio archivio: dove quel modo c’è, si parte da lì e l’esca semmai si prova dopo.
Due stadi: prima una scrematura rapida che tiene molti candidati, poi un esame lento e attento solo su quei pochi (la selezione dei curriculum e poi il colloquio). Il secondo stadio non serve tanto a cambiare l’ordine, quanto a separare i punteggi: quando il primo stacca nettamente gli altri, si può scartare il resto invece di riempire a forza i posti liberi. Una via di mezzo confronta i dettagli riga per riga, preparati in anticipo (ColBERT).
Un recupero che si corregge: il modello può decidere da sé se gli serve cercare e rileggere criticamente quello che ha trovato (è il Self-RAG), far controllare le pagine trovate a un giudice esterno che decide se usarle, scartarle per cercare altrove o fare tutte e due le cose (è il CRAG), oppure tornare a cercare finché non gli basta, usando la ricerca come un attrezzo invece che come un passo obbligato (è il RAG agentico). È lo studente maturo all’esame a libro aperto. Ma ogni giro in più è tempo di attesa e denaro: la domanda giusta non è «quanti giri posso fare» ma «qual è il minimo che risolve questa domanda».
Dare un voto vuol dire guardare tre cose separate: la risposta è davvero sostenuta dalle pagine citate? parla della domanda che era stata posta? le pagine trovate erano quelle giuste? Correggere a mano costa, e allora si promuove un altro modello a esaminatore: comodo, purché si ricordi che anche l’esaminatore ha i suoi pregiudizi e va controllato contro i voti di una persona su un campione.
Fedele non vuol dire vero: se l’archivio contiene un documento sbagliato, la risposta più fedele possibile a quel documento sarà sbagliata, con tanto di citazione impeccabile. Nessuna di queste tecniche garantisce la qualità dell’archivio.
Da ricordare
La recall del retriever è il vincolo dominante del sistema RAG: il generatore recupera dalla memoria parametrica solo una frazione di ciò che il recupero ha mancato (\(11{,}8\%\) su NQ nel lavoro originale [LPP+20]). La RAG avanzata interviene prima di cercare (migliorare la query: alza la recall), dopo (riordinare i candidati: alza la precisione e permette un \(k_1\) più grande) e attorno (decidere se e quando cercare: alza la recall sulle domande multi-hop). Il contesto lungo non la rende superflua: va in media meglio, ma costa molto di più [LLZ+24].
Query rewriting, espansione, multi-query: la domanda dell’utente spesso non è una buona query. HyDE [GMLC23] genera \(M\) risposte ipotetiche e cerca con la media dei loro embedding, perché vivono nello spazio dei documenti; la query pesa \(1/(M+1)\), quindi non è un’àncora. È pensato per il regime senza etichette di rilevanza: sopra un retriever messo a punto sul dominio gli autori dichiarano che non è l’uso previsto, e quel che misurano dipende dal generatore (con uno forte, \(62{,}1 \to 67{,}4\) di NDCG@10 su DL19 ma appena \(63{,}2 \to 63{,}5\) su DL20; con uno debole, peggiora entrambe). Senza etichette, su DL19 e DL20, porta BM25 da \(50{,}6\) e \(48{,}0\) a \(61{,}3\) e \(57{,}9\), a ridosso dei supervisionati su DL19 e da cinque a sette punti sotto su DL20.
Reranking in due stadi: il bi-encoder recupera tanti candidati grezzi (veloce, embedding precalcolati), un cross-encoder riordina solo quella rosa ristretta (preciso ma costoso, \(k_1\) inferenze per query, con \(k_1 \gg k\)). ColBERT [KZ20] è la via di mezzo, con MaxSim token-a-token ed embedding precalcolabili, al prezzo di un indice più grande. Il guadagno vero del secondo stadio è un punteggio su cui una soglia si può tarare, mentre la scala dei coseni cambia con il modello e la domanda.
RAG che si corregge: Self-RAG [AWW+24] addestra il modello a decidere se recuperare e a criticare i passaggi e la risposta con token di riflessione; CRAG [YGZL24] affida il giudizio a un valutatore esterno con tre azioni; il RAG agentico usa il recupero come strumento invocabile più volte (multi-hop). Ogni giro in più costa latenza e denaro, e la rilettura del contesto cresce con i giri (la cache dei prefissi ne abbassa il prezzo, non la crescita).
Valutare: fedeltà/groundedness (la risposta è supportata dai passaggi?), pertinenza della risposta, precision/recall del contesto. RAGAS [EJEAS24] stima fedeltà, pertinenza e rilevanza del contesto senza risposte di riferimento, con un LLM-giudice (la recall del contesto vuole una risposta annotata) e con i bias dell’LLM-as-a-judge di LLMOps; sul loro insieme di prova l’accordo con gli umani va dal 95% della fedeltà al 70% della rilevanza del contesto, e va ricalibrato sul proprio.
Fedeltà non è verità: una risposta fedele a un documento sbagliato è sbagliata, e una citazione corretta non salva una risposta che travisa la fonte.