


Dati su misura: Dataset, DataLoader e trasformazioni#
Nei manuali il dataset arriva sempre pronto: con una riga di codice MNIST (la
raccolta di cifre scritte a mano su cui il capitolo ha addestrato la sua prima
rete) si
scarica da solo, con le immagini già quadrate, già etichettate e già divise in
addestramento e test. Nella vita reale il primo giorno di un progetto
assomiglia piuttosto a questo: una cartella con quattromila fotografie, i nomi
dei file scritti da tre persone diverse, due immagini corrotte, una classe con
dodici esempi e un’altra con duemila. Prima di poter scrivere un nn.Module
bisogna costruire il tubo che porta quei file dentro la rete, e in PyTorch
quel tubo si costruisce con due pezzi soltanto, sempre gli stessi.
Il capitolo li ha già incontrati di sfuggita nella sezione
sull’addestramento: Dataset sa consegnare l’esempio
numero \(i\), DataLoader li impila in mini-batch. Qui li costruiamo noi, sui
nostri dati.
La convenzione delle cartelle#
Per le immagini esiste una convenzione che risparmia il lavoro: una cartella per classe, e il nome della cartella è l’etichetta.
dati/
├── addestramento/
│   ├── pizza/      img_001.jpg  img_002.jpg  ...
│   ├── bistecca/   img_331.jpg  ...
│   └── sushi/      img_780.jpg  ...
└── test/
    ├── pizza/      ...
    ├── bistecca/   ...
    └── sushi/      ...
Con questa disposizione, torchvision fa tutto da sé:
from torchvision import datasets, transforms

preparazione = transforms.Compose([
    transforms.Resize(256),          # il lato corto a 256, proporzioni intatte
    transforms.CenterCrop(224),      # poi il quadrato che serve alla rete
    transforms.ToTensor(),           # da immagine a tensore (un canale per
                                     # colore, poi altezza e larghezza) con i
                                     # valori portati fra 0 e 1
])

dati_train = datasets.ImageFolder(root="dati/addestramento", transform=preparazione)
dati_test = datasets.ImageFolder(root="dati/test", transform=preparazione)

print(dati_train.classes)         # ['bistecca', 'pizza', 'sushi']  (ordine alfabetico)
print(dati_train.class_to_idx)    # {'bistecca': 0, 'pizza': 1, 'sushi': 2}
print(len(dati_train))            # quante immagini in tutto
immagine, etichetta = dati_train[0]
print(immagine.shape, etichetta)  # torch.Size([3, 224, 224]) 0
L’indice di ogni classe segue l’ordine delle cartelle per codice del
carattere, e non l’ordine in cui le abbiamo in testa: le maiuscole vengono
prima di tutte le minuscole, e le lettere accentate vanno in fondo, dopo la
zeta. Per tradurre una predizione in una parola si usa
dati_train.classes[indice], l’unico modo che non riscrive quell’ordine: una
lista di nomi scritta a mano in un altro ordine produce un modello che sembra
sbagliare tutto mentre funziona benissimo.
Scrivere un Dataset a mano#
ImageFolder copre il caso fortunato. Appena i dati stanno in un CSV, in un
database, in file audio con le etichette in un foglio a parte (o appena
servono più informazioni della sola classe), bisogna scriversi la propria classe. È
meno lavoro di quanto sembri: tre metodi, il costruttore __init__ e le due
domande che PyTorch verrà a fare, __len__ e __getitem__.

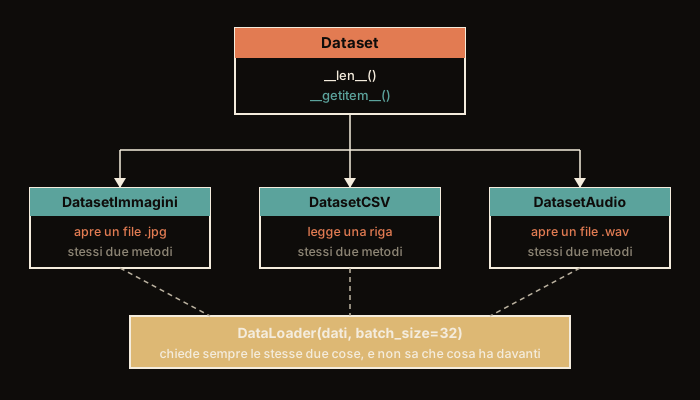
Fig. 7.11 Uno stampo di partenza, tre versioni specializzate. Chi consuma i dati non sa da dove vengano: chiede sempre le stesse due cose, e ognuna delle tre versioni risponde a modo suo, leggendo immagini, un foglio di calcolo o dei file audio.#
La Fig. 7.11 mostra il meccanismo che permette al
DataLoader di funzionare con qualunque Dataset senza saperne nulla, ed è
l’ereditarietà incontrata nella sezione sui moduli, usata qui per
un altro scopo. In cima c’è la classe base Dataset, lo stampo di partenza,
che non contiene quasi niente: fissa soltanto le due domande che si possono
fare. Sotto ci sono le classi che scriviamo noi, una per tipo di dato, e
ciascuna risponde a quelle due domande a modo proprio. Il guadagno è che il
DataLoader non deve conoscerle: gli basta che l’oggetto risponda a quelle due
domande (funziona perfino con una lista Python, che ce l’ha già). Finché la
nostra classe le rispetta, per il resto di PyTorch è indistinguibile da
ImageFolder, anche se legge un tipo di dato che chi ha scritto la libreria
non aveva previsto.
import pathlib
import torch
from torch.utils.data import Dataset
from PIL import Image

class DatasetImmagini(Dataset):
    """Legge le immagini da cartelle-classe, come ImageFolder, ma è nostro.

    La `transform` non è davvero facoltativa: senza, `__getitem__` restituisce
    una PIL.Image, e il collate di default non sa impilarla in un batch.
    """

    def __init__(self, radice: str, transform=None):
        # solo .jpg: ImageFolder invece accetta tutte le estensioni note
        self.percorsi = sorted(pathlib.Path(radice).glob("*/*.jpg"))
        self.classi = sorted({p.parent.name for p in self.percorsi})
        self.classe_a_indice = {c: i for i, c in enumerate(self.classi)}
        self.transform = transform

    def __len__(self) -> int:
        return len(self.percorsi)

    def __getitem__(self, indice: int):
        percorso = self.percorsi[indice]
        immagine = Image.open(percorso).convert("RGB")     # 3 canali sempre, anche
                                                           # da un bianco e nero
        etichetta = self.classe_a_indice[percorso.parent.name]
        if self.transform is not None:
            immagine = self.transform(immagine)
        return immagine, etichetta
Sono tre metodi, ma le domande sono due, ed è la distinzione che la
Fig. 7.11 disegna. Le due domande che il DataLoader
farà per tutto l’addestramento sono quanti esempi hai? (__len__) e dammi
il numero 137 (__getitem__). Qui si fa il lavoro di un esempio solo, si apre
il suo file e lo si prepara, ed è la parte che verrà eseguita milioni di volte.
Il terzo metodo, __init__, nessuno ce lo chiede: è la nostra preparazione,
quella che avviene una volta sola prima di cominciare, dove si elencano i file
o si legge il foglio con le etichette.
La seconda domanda chiede un numero preciso, e questo apre una possibilità. Un magazzino con gli scaffali numerati consegna il 137 senza toccare i centotrentasei che vengono prima, così i pezzi si possono chiedere nell’ordine che si vuole, per esempio in un ordine sorteggiato daccapo a ogni giro: è così che i dati vengono mescolati.
Certi dati però non stanno su uno scaffale, arrivano come un nastro che scorre, e da un nastro si prende quello che passa: chiedere il 137 non significa niente, perché per arrivarci bisogna aver lasciato passare tutti quelli davanti. Chi lavora così mescola come può, tenendo da parte un cesto di qualche centinaio di pezzi e pescando lì dentro, e almeno dentro il cesto l’ordine si mescola davvero. E se a prendere dal nastro sono due aiutanti, il nastro va diviso fra loro: altrimenti ciascuno porta tutto, e ogni pezzo arriva due volte.
La regola pratica sta tutta in questa divisione del lavoro: in __init__ ciò
che vale per tutto l’insieme e si fa una volta sola (elencare i file, leggere
il foglio delle etichette), in __getitem__ ciò che riguarda un esempio solo
(aprire quel file, applicare le trasformazioni), senza rifare niente che sia
uguale per tutti. Se in __init__ carichi in memoria tutte le immagini, un
dataset da 200 GB non parte nemmeno; se in __getitem__ riapri un file CSV di
300 MB per leggere una riga, l’addestramento diventa lentissimo, e la GPU, che
aspetta i dati, resta ferma a girarsi i pollici.
Una cosa in __init__ non ci va comunque: un file già aperto, o un
collegamento già avviato con un archivio di dati che sta su un altro computer.
La preparazione la fa una persona sola, e le richieste vengono poi smistate a
degli aiutanti, cioè a più processi che leggono i dati in parallelo (li accende
il DataLoader, e quanti lo decide un suo argomento, num_workers). Ogni
aiutante riceve una copia di tutto quello che la preparazione ha messo da
parte, e copiare un collegamento già avviato è come passare una telefonata in corso
a quattro persone insieme: parlano tutte sulla stessa linea, e nessuno
capisce più niente. Il lavoro muore con un errore che sembra venire da
tutt’altra parte. Il collegamento si apre alla prima richiesta, e lo apre
l’aiutante che quella richiesta la sta servendo.
È il protocollo map-style: una mappa da indice a esempio, che consente
campionamento casuale e quindi shuffle. Nella classe base è obbligatorio il
solo __getitem__; __len__ è facoltativo, ma lo pretendono il DataLoader
con il campionamento di default e quasi tutti i sampler, quindi in pratica il
contratto è a due. L’alternativa è IterableDataset (__iter__), pensata per
gli stream (file compressi letti in sequenza, code di messaggi, dataset che non
stanno su disco), dove il campionamento casuale non è possibile e lo shuffling
si approssima con un buffer. Con
num_workers > 0 ogni worker riceve una copia dello stream, e se __iter__
non divide il lavoro in base a torch.utils.data.get_worker_info(), ogni
esempio compare tante volte quanti sono i worker: con due worker, uno stream di
otto esempi ne consegna sedici.
from torch.utils.data import IterableDataset, get_worker_info

class Flusso(IterableDataset):
    def __iter__(self):
        info = get_worker_info()                # None senza worker
        for i in range(8):
            if info is None or i % info.num_workers == info.id:
                yield i                         # ogni worker prende i suoi
Due cose vanno sapute su __getitem__. La prima: con num_workers > 0 viene
eseguito nei processi worker, non in quello principale (col default,
num_workers=0, tutto resta nel processo principale). Ai worker viene passato
l’oggetto Dataset stesso, che dove i worker nascono per spawn o
forkserver (Windows e macOS, e da Python 3.14 anche Linux) deve quindi essere
serializzabile (pickle); e un handle già aperto in __init__ e usato
nel __getitem__ (un connettore a database, un file HDF5) è la causa classica
dei crash con num_workers > 0, qualunque sia il modo di avvio. Si apre
pigramente, al primo accesso, dentro il worker. La seconda: deve restituire
tensori (o tipi che il collate di default sa impilare); il default gestisce
tensori, numeri, stringhe, dizionari e tuple annidate, ma pretende che tutti
gli elementi del batch abbiano la stessa forma.
Le trasformazioni: preparare, e moltiplicare#
Una transform è una funzione che riceve un esempio e ne restituisce una
versione modificata. Serve a due scopi diversi, che è bene non confondere:
preparare (portare tutto alla stessa misura, allo stesso intervallo di
valori) e moltiplicare (generare varianti plausibili per rendere il
modello più robusto; la data augmentation, trattata in profondità nel
capitolo sulla visione).
from torchvision import transforms

# ADDESTRAMENTO: prepara e moltiplica
train_tf = transforms.Compose([
    transforms.Resize(256),                        # stessa geometria della valutazione
    transforms.RandomCrop(224),                    # ritaglio casuale
    transforms.RandomHorizontalFlip(p=0.5),        # specchiatura casuale
    transforms.ColorJitter(brightness=0.2, contrast=0.2),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406],   # statistiche di ImageNet
                         std=[0.229, 0.224, 0.225]),
])

# VALUTAZIONE: solo prepara. Nessuna casualità.
test_tf = transforms.Compose([
    transforms.Resize(256),                        # il lato corto a 256, senza
                                                   # schiacciare le proporzioni
    transforms.CenterCrop(224),                    # ritaglio sempre al centro
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406],
                         std=[0.229, 0.224, 0.225]),
])
All’esame le domande sono uguali per tutti. Specchiare le fotografie, schiarirle, ritagliarle ogni volta in un punto diverso serve mentre si studia, e insegna al modello che un gatto rivolto a sinistra è lo stesso gatto rivolto a destra. Farlo durante la prova vorrebbe dire sorteggiare domande diverse per ogni studente, e un voto così non si confronta con niente, né con quello di ieri né con quello di un altro.
Prima di tutto, però, le foto vanno portate alla stessa misura, perché la rete le riceve a mazzetti, e un mazzetto si impila bene solo con fogli della stessa misura. C’è un modo sbrigativo di farlo: schiacciarle a forza dentro un quadrato, che in una foto larga fa di una pizza tonda un ovale. Il modo giusto porta il lato più corto a 256 pixel (i puntini di cui è fatta un’immagine) e cambia l’altro nella stessa proporzione, così una foto di 400 per 300 diventa di circa 341 per 256; poi ritaglia il quadrato di 224 che la rete si aspetta. Si perde un po’ di bordo, ma le proporzioni restano quelle vere. Il primo passo è identico mentre si studia e all’esame. Il quadrato invece si ritaglia ogni volta in un punto diverso mentre si studia, e il margine fra 256 e 224 serve proprio a lasciargli spazio per spostarsi, mentre all’esame si ritaglia sempre al centro. Chi studia su pizze ovali e poi le trova tonde alla prova ha imparato a riconoscere una forma che all’esame non c’è. E schiacciare in tutte e due le occasioni non basta a rimediare quando si parte da un modello che ha già studiato altrove, come si fa quasi sempre: quello le pizze le ha viste tonde.
Un professore che racconta com’è andata la verifica non elenca ventidue voti,
dice «due sopra la media» e «uno sotto». I numeri diventano piccoli, e la
differenza fra un compagno e l’altro si vede a colpo d’occhio invece di restare
nascosta dentro cifre che si somigliano tutte. Normalize fa lo stesso ai
colori.
La media da sola non basta, e si vede con due materie. In italiano i voti stanno quasi tutti fra 5 e 7, in matematica vanno dal 2 al 10, e un 8 nella prima non è la stessa impresa di un 8 nella seconda. Allora lo scarto dalla media si divide per quanto quei voti si sparpagliano di solito, e lo sparpagliamento si chiama deviazione standard. Con media 6 e sparpagliamento 1 quell’8 diventa 2, con media 6 e sparpagliamento 4 diventa 0,5.
Le materie di Normalize sono i colori. Per il rosso, il verde e il blu tiene
una media e uno sparpagliamento a testa, ed ecco perché i numeri della riga sono
sei, due per colore. Al rosso più acceso, che dopo la conversione vale 1, toglie
0,485 e divide per 0,229: viene circa 2,2. Al nero, che vale 0, viene circa 2,1
sotto zero. Il rosso prima andava da 0 a 1, adesso si distende da 2,1 sotto zero
a 2,2 sopra.
La media di classe si fa sui voti, non sui compiti. Finché sono fogli si possono ricopiare, accorciare, riscrivere, ma nessuno ne fa la media. Ruotare, ritagliare e schiarire si possono fare tanto alla fotografia quanto ai numeri che ne escono; togliere una media e dividere per un numero, invece, si fanno soltanto ai numeri. Ecco perché l’ordine è quello: prima la foto, poi la conversione in numeri, e solo dopo la sottrazione. Scambiando le ultime due il programma si ferma.
I sei numeri vengono da ImageNet, la grande raccolta pubblica di fotografie etichettate su cui, dal 2012 in poi, si è misurata la visione artificiale. Perché la scala di ImageNet su delle foto di pizza? Perché quasi nessuno parte da zero: si prende un modello che ha già studiato là, e lui quella scala se l’aspetta, come uno studente abituato ai voti in decimi, che davanti a un giudizio a lettere non saprebbe più dire quanto è andato bene. Chi parte davvero da zero i sei numeri se li calcola sulle proprie foto, la prima volta che le scorre tutte.
ToTensor() converte una PIL.Image in un tensore float32 con layout
\((C, H, W)\) e valori riscalati in \([0,1]\); Normalize, date media \(\mu\) e
deviazione standard \(\sigma\), applica \(x' = (x - \mu)/\sigma\) canale per
canale. Serve all’ottimizzazione: con ingressi centrati e della stessa scala,
un passo di gradiente della stessa misura sposta allo stesso modo i pesi
collegati a ogni canale, mentre con scale diverse lo stesso passo è enorme per
uno e trascurabile per un altro, e la discesa procede a zig-zag in una valle
mal condizionata [LBOMuller98]. L’ordine conta: la
normalizzazione lavora su tensori, quindi va dopo ToTensor(), mentre le
trasformazioni geometriche e fotometriche lavorano tradizionalmente su PIL e
vanno prima.
Resize(256), con un intero, scala l’immagine in modo che il lato corto misuri
256 pixel e conserva il rapporto d’aspetto; Resize((256, 256)), con una
coppia, impone la risoluzione e deforma ogni immagine non quadrata. Il ritaglio
successivo (CenterCrop in valutazione, RandomCrop in addestramento) porta al
quadrato che la rete si aspetta sacrificando una fascia di bordo su ogni lato,
più larga lungo il lato lungo. RandomResizedCrop è un’altra cosa: sorteggia
sull’immagine originale un ritaglio di area (dall’8% al 100%) e di rapporto
d’aspetto (da 3/4 a 4/3) casuali e lo riporta alla misura richiesta, cioè fa da
sé ridimensionamento e ritaglio e si usa al posto di tutti e due, non dopo un
Resize. La deformazione delle proporzioni che introduce è casuale e cambia
verso da un ritaglio all’altro. L’ingrandimento invece ha un verso solo, perché
un ritaglio più piccolo dell’immagine, riportato a 224, mostra gli oggetti più
grandi di quanto faccia la pipeline di valutazione: con i valori di default,
nel conto di Touvron e colleghi, un oggetto visto in valutazione è in media
l’80% di come lo si vede in addestramento, e valutare a una risoluzione più
alta recupera accuratezza [TVDJegou19]. Le due pipeline devono
quindi condividere la geometria, o sapere dove non la condividono. Una
deformazione presente solo in addestramento è uno spostamento sistematico fra
la distribuzione su cui si addestra e quella su cui si valuta, introdotto da chi
prepara i dati; e anche una deformazione simmetrica ha un prezzo quando si
parte da pesi pre-addestrati, che hanno visto le proporzioni vere, perché lo
stesso spostamento cade allora fra i dati del pre-addestramento e i propri.
Le statistiche giuste sono quelle del dataset su cui il modello è stato
addestrato: se si fa transfer learning da pesi ImageNet si usano quelle di
ImageNet, e la scorciatoia più sicura è chiederle direttamente ai pesi;
torchvision.models.EfficientNet_B0_Weights.DEFAULT.transforms() restituisce
la pipeline di valutazione con cui quei pesi sono stati misurati (lato corto a
256 con interpolazione bicubica, ritaglio centrale a 224, le statistiche di
ImageNet), che è quella da replicare quando li si usa. Da torchvision
0.15 esiste torchvision.transforms.v2, che accetta anche box, maschere e
video insieme all’immagine (necessario per detection e segmentazione, dove la
trasformazione geometrica va applicata coerentemente a immagine ed
etichetta) ed è più veloce sui batch; l’API è retrocompatibile.
Il DataLoader sul serio#
Con un Dataset in mano, il DataLoader aggiunge il resto: batch,
mescolamento, parallelismo.
import os
from torch.utils.data import DataLoader

train_loader = DataLoader(
    dati_train,
    batch_size=32,
    shuffle=True,             # rimescola a ogni epoca: solo in addestramento
    num_workers=os.cpu_count(),   # processi che preparano i batch in parallelo:
                                  # è un punto di partenza, poi si misura
    pin_memory=True,          # memoria "bloccata": trasferimento più rapido alla GPU
    drop_last=True,           # scarta l'ultimo batch se incompleto
    persistent_workers=True,  # non li ricrea a ogni epoca
)

test_loader = DataLoader(dati_test, batch_size=64, shuffle=False,
                         num_workers=os.cpu_count(), pin_memory=True)
Ognuno di questi argomenti incide sul tempo che porta via il caricamento dei dati, e con modelli piccoli o medi quel tempo è spesso la parte più lunga dell’addestramento.
Durante l’addestramento la scheda grafica cucina un vassoio mentre qualcuno
prepara il successivo. Se a prepararli è il processo principale da solo, la
scheda finisce, aspetta, riceve il vassoio nuovo, finisce di nuovo: la parte
più cara della macchina resta ferma metà del tempo. Il rimedio è assumere degli
aiutanti che preparino i vassoi in anticipo, e quanti se ne assumono lo dice
num_workers: con quattro o otto aiutanti i vassoi successivi sono già pronti
quando servono. Oltre un certo numero, però, non paga: ogni aiutante è un
processo vero, con la sua memoria, e oltre il numero di core della macchina si
litiga soltanto. Il modo di scegliere è misurare, non indovinare.
Ogni aiutante tiene pronti due vassoi, se non si dice altro (lo regola
prefetch_factor). Con otto aiutanti sono sedici vassoi apparecchiati in giro
per la cucina, più quello in uso, e se i vassoi sono grandi il piano di lavoro
si riempie prima che la scheda li chieda: la macchina resta senza memoria per
una ragione che con la scheda grafica non c’entra niente.
Il passaggio dei vassoi alla scheda ha il suo punto stretto, il passavivande.
Mettere i dati su un piano d’appoggio accanto al passavivande (è pin_memory)
li rende prelevabili dalla scheda senza passaggi intermedi, ed è la premessa
perché la copia avvenga mentre il resto del lavoro va avanti; da sola non
basta, perché la sovrapposizione va chiesta con una seconda manopola, quando i
dati si passano alla scheda grafica.
Alla fine di ogni giro l’ultimo vassoio può restare mezzo vuoto: con duemila
esempi e vassoi da 32, l’ultimo ne ha 16. Di solito non è un guaio, ma ci sono
pezzi della rete che rimettono in scala i numeri usando le medie del vassoio
(la batch norm della sezione sul training loop), e su metà
vassoio quelle medie restano giuste e diventano soltanto più ballerine. Con
2049 esempi, però, l’ultimo vassoio ne avrebbe uno solo, e da un numero solo la
media si fa ma la misura di quanto i numeri si sparpagliano no. Quando quei
pezzi dal vassoio ricevono un solo numero per ogni esempio, un vassoio da uno
li ferma con un errore; su una fotografia no, perché lì i numeri su cui fanno
il conto sono i pixel, e restano tanti anche con una foto sola. Per non
pensarci si butta via l’ultimo vassoio quando è incompleto: è drop_last.
Alla fine di ogni giro, poi, gli aiutanti vengono licenziati e riassunti subito
dopo, e se prepararsi costa loro qualche secondo quei secondi si pagano a ogni
epoca: persistent_workers li tiene in servizio. E prima di ogni giro il mazzo
si mescola, così la rete non impara l’ordine (shuffle=True). Chi preferisce
pescare a modo suo, dando più probabilità agli esempi rari per esempio, passa
il proprio modo di pescare e toglie shuffle: o l’uno o l’altro, e chiedendoli
tutti e due si ottiene subito un errore.
Resta un tranello, che colpisce dove ogni aiutante appena assunto rilegge da
capo il foglio delle istruzioni: su Windows e macOS, e da Python 3.14 anche su
Linux. Se sul foglio, in mezzo alle altre righe, c’è scritto «assumi otto
aiutanti», ognuno proverebbe ad assumerne altri otto, e la catena non finirebbe
più: Python se ne accorge sulla porta e ferma tutto con un errore. Il rimedio è
mettere le righe che avviano il lavoro sotto if __name__ == "__main__":, che
è il modo di dire «questo pezzo lo esegue soltanto chi ha lanciato il
programma, non chi arriva dopo».
num_workers=k avvia \(k\) processi (non thread: il GIL, spiegato nel capitolo
su Python, serializzerebbe proprio il codice Python puro del preprocessing,
che è il lavoro da parallelizzare qui) che eseguono
__getitem__ e il collate in parallelo, riempiendo una coda da cui il
processo principale preleva. prefetch_factor (default 2) regola quanti batch
ogni worker tiene pronti in anticipo: la memoria occupata cresce come
\(k \times \text{prefetch\_factor} \times \text{dimensione batch}\), e su
macchine con poca RAM è la prima causa di out of memory che non riguarda la
GPU. persistent_workers=True evita il costo di riavviarli a ogni epoca. Quel
costo non è __init__, che gira una volta sola nel processo principale e ai
worker arriva già fatto: è l’avvio dei processi e, dove nascono per spawn o
forkserver, il re-import del modulo e la deserializzazione dell’oggetto
Dataset, cioè la sua dimensione.
pin_memory=True alloca i batch in memoria page-locked, che consente il
trasferimento DMA asincrono verso la GPU; combinato con
tensore.to(device, non_blocking=True) permette di sovrapporre copia e
calcolo. Su Windows e macOS i worker nascono per spawn, e da Python 3.14
anche su Linux, dove il metodo di avvio predefinito di multiprocessing non è
più fork ma forkserver: in tutti questi casi il codice che li avvia deve
stare sotto if __name__ == "__main__":, perché senza ogni worker rilegge il
modulo principale e prova a far ripartire il programma, e Python lo ferma sul
nascere con un RuntimeError.
drop_last=True scarta l’ultimo batch quando non è pieno. Su un batch corto la
media per canale della BatchNorm resta non distorta e diventa solo più
dispersa; la varianza no, perché in addestramento la normalizzazione usa lo
stimatore distorto, che divide per il numero \(n\) di valori per canale e non per
\(n-1\), e il cui valore atteso è \(\frac{n-1}{n}\sigma^2\). In una BatchNorm1d su
vettori \(n\) coincide con la taglia del batch \(B\): \(6\%\) sotto con \(16\) esempi,
\(3\%\) con \(32\). E siccome l’uscita di ogni batch ha varianza distorta \(1\), la
sua varianza non distorta vale \(n/(n-1)\), quindi l’ultimo batch corto esce un
po” più disperso degli altri. In una BatchNorm2d \(n\) è la taglia del batch
per \(H\,W\), un valore per pixel di ogni esempio, e la distorsione si perde nel
rumore. Il caso netto è il batch da un elemento, su cui la varianza campionaria
non esiste e nn.BatchNorm1d in train() alza ValueError: Expected more than 1 value per channel. Con \(m\) esempi e batch \(B\) succede quando
\(m \bmod B = 1\), che capita più spesso di quanto sembri.
Infine shuffle=True e l’argomento sampler sono mutuamente esclusivi:
shuffle è di fatto una scorciatoia per RandomSampler. Chi passa un sampler
personalizzato deve togliere shuffle.
Quando gli esempi non hanno la stessa forma: collate_fn#
Il pezzo che impila gli esempi in un batch pretende che abbiano tutti la stessa
forma. Si chiama collate, che in inglese vuol dire proprio «mettere in ordine
dei fogli sciolti», e nel codice compare come collate_fn. Con le immagini
ridimensionate la stessa forma è vera per costruzione; con il testo, l’audio o
le serie temporali non lo è quasi mai, perché una frase è lunga sette parole e
la successiva quarantatré. La soluzione è sostituire quel meccanismo con il
proprio.
import torch
from torch.utils.data import Dataset
from torch.nn.utils.rnn import pad_sequence

class DatasetSequenze(Dataset):
    """Frasi già tradotte in numeri, di lunghezza diversa fra loro."""

    def __init__(self, n=100):
        lunghezze = torch.randint(5, 40, (n,))
        self.esempi = [(torch.randint(1, 50, (int(l),)), int(l) % 2)
                       for l in lunghezze]

    def __len__(self):
        return len(self.esempi)

    def __getitem__(self, indice):
        return self.esempi[indice]

def raggruppa(batch):
    """Riceve una lista di (sequenza, etichetta); restituisce un batch imbottito."""
    sequenze, etichette = zip(*batch)
    lunghezze = torch.tensor([len(s) for s in sequenze])          # (B,)
    imbottite = pad_sequence(sequenze, batch_first=True,          # (B, L_max)
                             padding_value=0)
    return imbottite, lunghezze, torch.tensor(etichette)

torch.manual_seed(0)   # frasi e mescolamento sorteggiati sempre uguali
dati = DatasetSequenze()
loader = DataLoader(dati, batch_size=32, shuffle=True, collate_fn=raggruppa)

imbottite, lunghezze, etichette = next(iter(loader))
print(imbottite.shape, lunghezze.shape, etichette.shape)
# le lunghezze vere sono una per frase, la larghezza del batch è la massima:
print(lunghezze[:8].tolist(), "-> larghezza", imbottite.shape[1])
torch.Size([32, 37]) torch.Size([32]) torch.Size([32])
[37, 10, 7, 14, 8, 30, 5, 31] -> larghezza 37
I numeri cambiano da un batch all’altro, perché le frasi sono sorteggiate, e cambia con loro la larghezza del batch, che è la lunghezza della frase più lunga capitata dentro. Quello che non cambia sono le tre forme: trentadue righe, trentadue lunghezze, trentadue etichette.
In questo batch la frase più lunga misura trentasette, e tutte le altre sono portate a quella larghezza; accanto ci sono le trentadue lunghezze vere, una per frase (la stampa mostra le prime otto). La frase che ne aveva cinque è arrivata a trentasette con trentadue zeri in coda: è l’imbottitura (in inglese padding).
Le lunghezze vanno restituite insieme ai dati, perché dopo l’imbottitura tutte le frasi del batch hanno la stessa larghezza, e gli zeri aggiunti in coda sono indistinguibili da parole vere: senza sapere dove finisce la frase, il modello imparerebbe che lo zero è una parola come le altre, e passerebbe metà del suo tempo a studiare l’imbottitura. Le lunghezze sono l’informazione che permette di dire «da qui in poi non guardare». Il gesto ha due conseguenze. La sezione sull’etichettare le sequenze marca le caselle di imbottitura perché non entrino nel conto dell’errore, che è lo stesso lavoro fatto sulle etichette invece che sui dati. Nei Transformer quella stessa riga di «fin qui sì, da qui no» diventa un ingrediente dell’architettura e prende un nome, si chiama maschera, e serve anche a un secondo mestiere: vietare a una parola di guardare quelle che vengono dopo. Per ora basta avere in mano le lunghezze.
Classi sbilanciate: pescare con criterio#
Se una classe ha duemila esempi e un’altra dodici, il mescolamento uniforme mostrerà la classe rara di rado, e il modello tende a ignorarla: rispondere sempre con la classe frequente è la strada che abbassa di più la loss media. Un rimedio è cambiare il modo di pescare.
from torch.utils.data import WeightedRandomSampler

# Le etichette si leggono dall'indice, senza aprire una sola immagine:
# ImageFolder le tiene in .targets. Iterare il dataset le otterrebbe
# ugualmente, ma caricando tutti i file da disco, inutilmente.
etichette = torch.tensor(dati_train.targets)               # una per esempio
conteggi = torch.bincount(etichette)                       # esempi per classe
peso_per_classe = 1.0 / conteggi.float()                   # la classe rara pesa di più
# indicizzare con un elenco: per ogni etichetta va a prendere il peso della sua
# classe, quindi da 3 pesi (uno per classe) se ne ottiene uno per esempio
pesi = peso_per_classe[etichette]                          # un peso per esempio

campionatore = WeightedRandomSampler(weights=pesi,
                                     num_samples=len(pesi),
                                     replacement=True)

# Attenzione: con un sampler NON si passa shuffle.
loader = DataLoader(dati_train, batch_size=32, sampler=campionatore)
Il campionamento pesato tocca i dati, che è l’ultima delle quattro leve contro
lo sbilanciamento: prima vengono la metrica, la soglia e il peso delle classi
(weight in CrossEntropyLoss), e la sezione sulle classi sbilanciate le ordina dalla più economica alla
più invasiva.
Quella stessa sezione spiega perché, quando le classi sono sbilanciate così, l’accuratezza smette di dire la verità. Basta un conto: se su duemila foto millenovecento sono pizza, un modello che risponde «pizza» a occhi chiusi, sempre, prende novantacinque su cento e non ha imparato niente. Servono misure che guardino anche le classi rare, e sono precisione, richiamo e F1.
Dividere i dati senza barare#
Dividere in addestramento e test sembra un passaggio meccanico, ed è il punto in cui nasce la fuga di informazione dal test (data leakage): un danno che non dà nessun errore e fa sembrare il modello migliore di com’è.
import torch
from torch.utils.data import random_split

n_val = int(0.1 * len(dati_train))
n_train = len(dati_train) - n_val
generatore = torch.Generator().manual_seed(42)    # divisione riproducibile
sotto_train, sotto_val = random_split(dati_train, [n_train, n_val],
                                      generator=generatore)
La divisione a caso funziona solo se gli esempi sono davvero indipendenti. Non lo sono, per esempio, se il dataset contiene dieci fotografie dello stesso paziente, o dieci fotogrammi consecutivi dello stesso video: dividendo a caso, alcune finiscono nell’addestramento e altre nel test, il modello riconosce il paziente invece della malattia, e il voto d’esame risulta splendido (fino al giorno in cui arriva un paziente nuovo).
La regola è: si divide per gruppo, non per esempio. Tutti i dati di un paziente stanno o di qua o di là. E se i dati hanno una data, si divide per data: si addestra sul passato e si valuta sul futuro, perché è così che funzionerà davvero.
Conta anche come si ritaglia. Se la parte per le prove si ritaglia dalla stessa pila di foto che per lo studio vengono specchiate e schiarite, le deformazioni se le porta dietro, e le prove smettono di somigliare all’esame: va ritagliata dalle stesse foto, ma preparate come all’esame.
C’è un secondo modo di sbirciare, più difficile da vedere perché non sposta nemmeno una fotografia. Prima di dare i numeri alla rete si guarda com’è fatta la collezione (quanto è chiara in media, quanto variano i colori) per rimettere tutto sulla stessa scala. Se per calcolare quelle misure si guardano anche le foto d’esame, un pezzetto di loro è già entrato nelle decisioni prese prima dell’esame. Le misure si prendono sulle sole foto d’addestramento e si applicano tali e quali alle altre. Il regalo che ci si fa è piccolo, e basta a far sembrare vincente un metodo che non lo è.
È la data leakage da correlazione di gruppo: la divisione casuale assume
esempi i.i.d., ipotesi violata da qualunque struttura gerarchica (paziente,
sessione, utente, documento). La contromisura è una divisione per gruppi: gli
indici li calcola GroupShuffleSplit di scikit-learn, e si passano a
torch.utils.data.Subset.
from sklearn.model_selection import GroupShuffleSplit
from torch.utils.data import Subset

gruppi = [0, 0, 0, 1, 1, 2, 2, 2, 3, 3]   # il paziente di ogni esempio
esempi = list(range(10))                  # al posto del Dataset vero
div = GroupShuffleSplit(n_splits=1, test_size=0.25, random_state=42)
idx_train, idx_test = next(div.split(esempi, groups=gruppi))
sotto_train, sotto_test = Subset(esempi, idx_train), Subset(esempi, idx_test)
print({gruppi[i] for i in idx_train}, {gruppi[i] for i in idx_test})
{0, 2, 3} {1}
Nessun paziente sta da tutte e due le parti. Per dati temporali vale l’analogo temporale, la validazione a origine mobile (che si trova anche come walk-forward e come forward chaining).
Un secondo tranello, più sottile: le statistiche di normalizzazione e ogni altro parametro di preprocessing vanno calcolati solo sul training set e poi applicati agli altri. Calcolare media e deviazione standard su tutto il dataset prima di dividere lascia filtrare informazione dal test: un errore che gonfia i risultati di poco, ma abbastanza da falsare un confronto.
Il terzo riguarda il codice. random_split restituisce due sottoinsiemi dello
stesso dataset, quindi con la stessa transform: se contiene la
moltiplicazione (ritagli e specchiature casuali), la validazione viene
deformata come l’addestramento. Per avere trasformazioni diverse si estraggono
gli indici una volta sola e si applicano a due ImageFolder costruiti sulla
stessa cartella.
generatore = torch.Generator().manual_seed(42)
indici = torch.randperm(len(dati_train), generator=generatore).tolist()
n_val = int(0.1 * len(indici))
per_studio = datasets.ImageFolder("dati/addestramento", transform=train_tf)
per_prove = datasets.ImageFolder("dati/addestramento", transform=test_tf)
sotto_train = Subset(per_studio, indici[n_val:])
sotto_val = Subset(per_prove, indici[:n_val])
Il collo di bottiglia è spesso il caricamento dei dati#
Quando un addestramento è lento, l’istinto dice che la colpa è del modello. Con modelli piccoli o medi la causa è spesso il caricamento dei dati: la GPU finisce un mini-batch e resta ferma ad aspettare il successivo. È la diagnosi che quasi nessuno prova per prima, e spesso è quella giusta.
Come ci si accorge, se una scheda grafica c’è: si guarda quanto è occupata
mentre l’addestramento gira, con il comando nvidia-smi scritto in un’altra
finestra del terminale. Se sta al cento per cento in modo stabile, il collo di
bottiglia è il calcolo; se invece salta dal cento a zero e ritorno, la scheda
sta aspettando i dati, e ogni ottimizzazione del modello sarà tempo perso. Chi
lavora sulla sola CPU non ha quel termometro, e allora si cronometra a mano:
un’epoca intera, poi un’epoca in cui il modello non fa niente e si scorrono
soltanto i dati. Se i due tempi si somigliano, il modello non c’entra.
import time

t0 = time.perf_counter()
for X, y in train_loader:      # un'epoca in cui il modello non fa niente
    pass
print(f"solo dati: {time.perf_counter() - t0:.1f} s")   # da confrontare
Il numero è un cronometro, e va confrontato con quello di un’epoca completa misurata sulla stessa macchina, nello stesso momento.
I rimedi, di solito in quest’ordine:
Più aiutanti. Alzare num_workers: se il problema è che nessuno prepara i
vassoi mentre la scheda cucina, è la prima cosa da provare.
Ritagliare le foto una volta sola. Se ogni epoca ridimensiona quattromila fotografie da dodici megapixel a 224 pixel per lato, quel lavoro lo si sta rifacendo identico decine di volte. Farlo una volta e salvare le immagini già piccole su disco è un pomeriggio che si ripaga in un’ora.
Meno file, più grandi. È il rimedio che stupisce, perché risparmia un costo a cui non si pensa: con milioni di file piccoli, specie se stanno su un disco raggiunto attraverso la rete, il tempo se ne va nell’aprirli più che nel leggerli. Aprire un file è come chiedere al bibliotecario di andare a prendere un volume: il tempo lo fa il tragitto, non la lettura, e per un milione di volumi si fa un milione di tragitti. Impacchettare le immagini in pochi archivi grandi, letti di seguito, è chiedere al bibliotecario uno scaffale intero in una volta. Con i file sul proprio disco e non troppo piccoli il guadagno è modesto, perché lì pesa di più trasformare ogni foto in numeri; quando i file stanno in rete, invece, la differenza è enorme.
Spostare le trasformazioni pesanti sulla scheda grafica, che le fa più in fretta della CPU.
La diagnosi si fa con nvidia-smi a occhio o, meglio, con il profiler
torch.profiler, che separa il tempo speso in DataLoader da quello speso nei
kernel.
I rimedi, in ordine di efficacia: alzare num_workers; ridimensionare le
immagini una volta su disco invece che a ogni epoca; usare formati che si
leggono in blocco (.npy, WebDataset, LMDB) invece di milioni di piccoli file;
spostare le trasformazioni pesanti sulla GPU (torchvision.transforms.v2
lavora su batch di tensori, quindi anche su device).
Il rimedio dei file impacchettati guadagna dove il costo dominante è
l’apertura, cioè su uno storage di rete o con milioni di file piccoli: ogni
open() è una chiamata di sistema e un accesso ai metadati del filesystem, e
un milione di file produce un milione di accessi minuscoli e sparsi, lo schema
peggiore per qualunque disco, con in più la latenza di ogni accesso quando il
disco è in rete. Impacchettarli in pochi archivi letti in sequenza sposta il
lavoro dove l’hardware è veloce. Su un disco locale domina invece di solito la
decodifica: un JPEG si decodifica in un tempo molto più lungo di quello che
serve a leggerne i byte, e lì si interviene con num_workers,
ridimensionando le immagini una volta su disco o spostando le trasformazioni
sulla GPU.
C’è poi un secondo motivo per impacchettare i file, che si paga una volta e
serve per sempre. Mentre si scorre tutta la collezione per riscriverla, la si
sta già leggendo: costa zero calcolare intanto media e deviazione standard di
ogni colore, cioè i sei numeri che servono a Normalize e che erano stati
presi in prestito da ImageNet. Sui propri dati si calcolano, e vengono meglio.
Due avvertenze. La prima è quella della divisione dei dati: i sei numeri si calcolano sulle sole foto di addestramento, perché calcolarli su tutte fa entrare le foto d’esame nelle decisioni prese prima dell’esame. È una fuga di informazione dal test della stessa famiglia di quella che nasce dividendo a caso esempi che si assomigliano, e la sezione su overfitting e validazione la tratta per esteso. La seconda: se si parte da un modello già addestrato da altri, i sei numeri non si calcolano affatto, si prendono quelli con cui è stato addestrato lui. Le librerie li tengono insieme ai pesi proprio per questo, e un modello a cui si danno immagini centrate diversamente da come le ricorda risponde peggio senza dire niente.
Il tubo che porta i file dentro la rete è fatto. Quando qualcosa nel tubo o nel modello non torna, i messaggi d’errore sono pochi e si imparano a riconoscere: è l’argomento della sezione sui tre errori più comuni. La sezione sulle prestazioni riprenderà poi il discorso sulla velocità dal lato del calcolo.
Da ricordare
Un
Datasetsi scrive con tre metodi: la preparazione, che avviene una volta sola e mette in fila ciò che vale per tutto l’insieme (l’elenco dei file, le etichette); e le due domande che ilDataLoadergli farà davvero, quanti esempi hai e dammi il numero 137. La seconda gli verrà chiesta milioni di volte, e fa soltanto il lavoro di quell’esempio.Se le foto stanno in una cartella per classe,
ImageFolderfa tutto da sé. I nomi delle classi li assegna in ordine alfabetico: vanno riletti da lui, mai riscritti a mano in un altro ordine.Le trasformazioni servono a due cose: preparare (stessa misura, stessa scala di numeri) e moltiplicare (specchiare, schiarire, ritagliare in un punto a caso). Si moltiplica solo in addestramento, mai durante l’esame.
Per portare le foto alla stessa misura si porta il lato corto alla misura giusta, nello stesso modo durante lo studio e all’esame, e poi si ritaglia un quadrato, senza schiacciare: in un punto a caso mentre si studia, al centro all’esame.
Il
DataLoadersi regola con pochi argomenti, e il primo è il numero di aiutanti che preparano i vassoi in parallelo; e una regola: o si mescola a caso, o si passa un modo di pescare proprio, non tutti e due. Su Windows e macOS, e da Python 3.14 anche su Linux, le righe che avviano il lavoro vanno sottoif __name__ == "__main__":.I sei numeri di
Normalizesi calcolano sulle sole foto di addestramento, mai su tutte; e se si parte da un modello già addestrato da altri non si calcolano affatto, si prendono i suoi.Se gli esempi hanno lunghezze diverse (frasi, suoni) si allungano tutti alla stessa misura con degli zeri, e si restituiscono anche le lunghezze vere, altrimenti il modello studia l’imbottitura.
Si divide per gruppo (tutte le foto dello stesso paziente di qua o di là), o per data, mai a caso su esempi che si assomigliano: è il modo più comune di darsi un bel voto senza meritarlo. E la parte per le prove si prepara come all’esame, senza deformazioni.
Se l’addestramento è lento, sospetta i dati prima del modello.
Da ricordare
Un
Datasetsono tre metodi e un contratto a due:__init__prepara una volta ciò che vale per tutto l’insieme (indice dei file, etichette);__len__e__getitem__sono le domande delDataLoader, e__getitem__fa solo il lavoro di un esempio (lettura, decodifica, trasformazioni), cioè quello chenum_workersparallelizza.ImageFoldercopre il caso «una cartella per classe»; l’indice delle classi segue l’ordine alfabetico, e va riletto da.classes, mai riscritto a mano.Le trasformazioni preparano (resize,
ToTensor,Normalize) e moltiplicano (augmentation): moltiplicare solo in addestramento, mai in valutazione.Resize(256)conserva il rapporto d’aspetto,Resize((256, 256))deforma: addestramento e valutazione devono condividere la geometria, o la deformazione diventa uno spostamento sistematico fra le due distribuzioni.RandomResizedCropla condivide solo in parte: in addestramento mostra gli oggetti in media più grandi.Nel
DataLoadercontanonum_workers,pin_memory,drop_last,persistent_workers;shuffleesamplersi escludono a vicenda. Dove i worker nascono per spawn o forkserver (Windows, macOS, Linux da Python 3.14) ilDatasetva serializzato e l’avvio protetto daif __name__ == "__main__":; unIterableDatasetva diviso fra i worker.Con esempi di lunghezza diversa serve un
collate_fnche imbottisce e restituisce le lunghezze vere.Si divide per gruppo (paziente, video, utente) o per data, mai a caso su esempi correlati: è la forma più comune di data leakage.
random_splitcondivide latransform: per una validazione senza augmentation servono due dataset sugli stessi indici.Se l’addestramento è lento, sospetta il caricamento dei dati prima del modello: su disco locale pesa di solito la decodifica, in rete l’apertura dei file.