


Prompt, contesto e loop: programmare gli LLM#
Nel giugno 2025 Andrej Karpathy (tra i fondatori di OpenAI, per anni a capo dell’intelligenza artificiale in Tesla) ha dato il suo appoggio a un nome appena proposto per un mestiere che esisteva già. Su X, il social network che fino al 2023 si chiamava Twitter, ha scritto di preferire il termine context engineering a «prompt engineering», e lo ha definito così: l’arte e insieme la scienza, delicata, di riempire la finestra di contesto con la giusta informazione per il passo successivo [Kar25a].
Chi arriva dal capitolo sugli agenti queste parole le ha già incontrate nella sezione sul contesto come interfaccia, ed è da lì che si riparte. Il prompt, in senso stretto, è il messaggio che si scrive al modello, la richiesta vera e propria; tutto il testo che il programma le monta attorno è il contesto. Nell’uso corrente, e nei nomi del codice, «prompt» si allarga spesso a tutto il testo montato; qui i due oggetti vanno tenuti distinti, e nella prosa «prompt» vale in senso stretto. In un assistente per i clienti di un negozio, «il mio ordine non è arrivato» è il prompt; le istruzioni di servizio che il programma antepone sempre, i dati dell’ordine presi dall’archivio e i messaggi scambiati prima sono il contesto. Gli esempi già svolti stanno dall’una o dall’altra parte secondo chi ce li mette: nel prompt se li scrive chi fa la richiesta, nel contesto se li aggiunge il programma.
La finestra di contesto è il tetto di testo che un modello riesce a leggere in una volta sola: la richiesta, e insieme tutto ciò che vogliamo che il modello sappia prima di rispondere, deve starci dentro, e quando è piena qualcosa va tolto per far posto. È un limite deciso da chi il modello l’ha costruito, non una metafora, ed è la ragione per cui riempirla bene è un mestiere. «Il passo successivo», nella definizione di Karpathy, è la mossa dopo, in un lavoro che va avanti a riprese, una richiesta dopo l’altra: il lavoro è riempire bene una finestra, e rifarlo a ogni passo.
Karpathy aveva preparato il terreno da tempo. Anni prima aveva parlato di Software 2.0, una numerazione che presuppone un Software 1.0: il software di sempre, quello che qualcuno scrive riga per riga in un linguaggio di programmazione. Nel 2.0, cioè nei sistemi di apprendimento automatico, il programma non lo scrive più una persona riga per riga, lo si addestra, cioè gli si mostrano montagne di esempi e lo si lascia aggiustare da sé, un pochino alla volta, i numeri che ha dentro. Quei numeri sono i pesi della rete, milioni o miliardi, e sono in tutto e per tutto quello che il modello ha imparato: il suo codice. Nel 2025 ha aggiunto un terzo capitolo, il Software 3.0, osservando che oggi, con i grandi modelli linguistici, «si programma in inglese»: il prompt è il programma, scritto in lingua naturale invece che in Python (con «inglese» si intende la lingua naturale, e qui useremo l’italiano per gli esempi). È un’immagine forte, da prendere con prudenza; ma coglie qualcosa di vero, ed è il punto di partenza dell’ingegneria dei prompt.
Programmare a parole#
Prima di vedere come si programma un modello di linguaggio, conviene guardare che cosa fa davvero quando risponde. Un LLM, il grande modello di linguaggio (large language model) che il capitolo sugli agenti ha messo al centro di ogni ciclo, fa una cosa sola, e la fa moltissime volte di fila: guarda il testo che ha davanti e stima quale pezzo di testo verrà dopo.

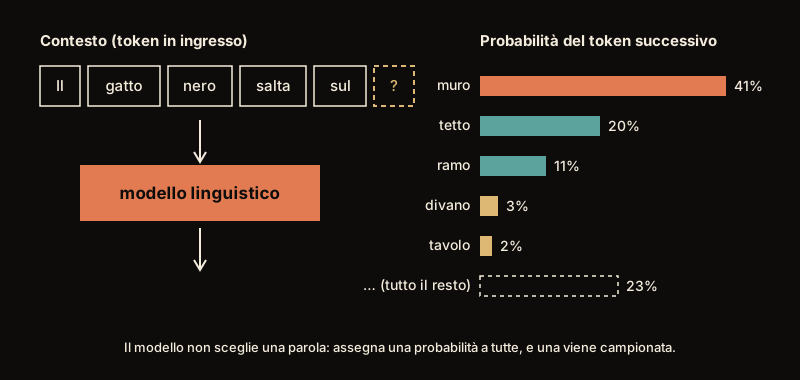
Fig. 21.1 Cosa restituisce davvero un LLM. Non una frase: una classifica di parole possibili, ciascuna con la sua probabilità. Tutto ciò che sembra dialogo è questo passaggio, ripetuto.#
Tenere presente Fig. 21.1 cambia il modo di leggere tutto il capitolo. Quello che esce dal modello è una classifica di parole candidate, ciascuna con la sua percentuale: dopo «il gatto nero salta sul» potrebbe dire muro 41%, tetto 20%, ramo 11%, e via calando fino alle ultime parole del vocabolario. La risposta nasce estraendo a sorte da quella classifica, con le percentuali come pesi: «muro» esce circa quattro volte su dieci, «tetto» due. Estrarre così si dice campionare, ed è la ragione per cui la stessa domanda può avere risposte diverse (la statistica chiama questa classifica «distribuzione»). Nella figura le voci si chiamano token, che è il pezzo di parola con cui il modello lavora davvero, come abbiamo visto nella sezione sui tokenizzatori. Diremo «parola» dove la differenza non conta, e «token» dove conta: cioè quando si tratta di contarli, perché è a token che si misura quanto testo entra nella finestra, ed è a token che si paga. In simboli, un modello di parametri \(\theta\) calcola \(P_\theta(x_t \mid x_{<t})\), la probabilità di ciascun token \(x_t\) dati i token \(x_{<t}\) che lo precedono; la risposta si costruisce un token alla volta, estraendolo e rimettendolo in coda al testo.
Questa classifica dipende dal testo che il modello ha davanti: cambia il testo e i numeri si spostano. Ecco perché «programmare a parole» non è un modo di dire. Le parole che gli scriviamo sono la leva che sposta la classifica, ed è l’unica che abbiamo finché non mettiamo le mani dentro al modello.
Ne segue che, con un LLM già addestrato, cioè uno di quelli che si trovano pronti e che sanno già leggere e scrivere, non si programma più toccando i pesi: quelli sono congelati, li ha fissati l’addestramento. «Congelati» non vuol dire immutabili per sempre (riaprirli e proseguire l’addestramento sui propri dati si può, si chiama fine-tuning, ma fra poco vedremo perché è la strada più costosa). Vuol dire che restano fermi mentre si lavora sul testo. Programmiamo con le parole, cioè con il testo che gli mettiamo davanti prima di chiedergli una risposta. Cambiare quel testo cambia il comportamento del sistema tanto quanto, nel software tradizionale, cambierebbe riscrivere una funzione.
È il collega nuovo del capitolo sugli agenti, quello a cui lasciavi il briefing sulla scrivania: bravissimo e velocissimo, ha letto mezza biblioteca, è appena arrivato e non sa nulla del tuo lavoro. Puoi anche mandarlo a un corso di formazione, ma è una faccenda lunga e costosa. Quello che puoi fare subito, ogni giorno, senza spedirlo da nessuna parte, è parlargli bene. Se gli dici «occupati dei clienti» otterrai una cosa; se gli lasci un foglio con il ruolo, tre esempi di risposte giuste e il tono da tenere, ne otterrai un’altra, molto migliore: stesso collaboratore, stesso cervello, solo parole diverse. E nota il dettaglio del foglio, perché tornerà per tutto il capitolo: quei tre esempi già svolti sono la cosa che lo aiuta di più, e lui non ha imparato niente, li ha soltanto letti. Ecco cosa vuol dire «programmare a parole»: non si cambia la persona, si cambia ciò che le si dice. Una cosa il foglio non te la dà: la stessa risposta due volte. Ridaglielo domani e avrai qualcosa di simile, non la copia di oggi, come succede con chiunque. E siccome parole diverse danno risultati diversi, a volte molto diversi, sceglierle diventa un mestiere.
È utile leggere questa tesi lungo la scala che Karpathy chiama Software 1.0 → 2.0 → 3.0. Nel Software 1.0 il comportamento è codice imperativo scritto a mano. Nel Software 2.0 è un vettore di parametri \(\theta\) appreso minimizzando una loss \(\mathcal{L}\) su dei dati: il programma emerge dall’ottimizzazione, non dalla penna del programmatore. Il Software 3.0 sposta di nuovo il piano: \(\theta\) resta fisso (il modello pre-addestrato non si tocca) e ciò che varia è il contesto \(C\) passato in ingresso. Il sistema genera
dove \(P_{\theta}\) è la distribuzione condizionata calcolata dal modello congelato, \(C\) è tutto il testo che gli forniamo (istruzioni, esempi, documenti, cronologia) e \(\hat{y}\) la risposta, campionata da quella distribuzione, eventualmente riscalata e troncata dai parametri di decoding (temperatura, top_p) che vedremo nella sezione sul prompt: lo stesso \(C\) può dare risposte diverse a temperatura non nulla e, come vedremo lì, perfino a temperatura zero. Programmare significa progettare \(C\). Il meccanismo che rende possibile tutto questo è l’in-context learning, documentato su larga scala da Brown e colleghi nel lavoro su GPT-3 [BMR+20]: bastano poche coppie richiesta → risposta nel contesto (il few-shot), perché il modello esegua un compito nuovo senza alcun aggiornamento dei pesi. Gli esempi non addestrano: condizionano. La scoperta è raccontata nella sezione sui grandi modelli linguistici, e la sua forma probabilistica è formalizzata nella sezione sul prompt engineering; qui ci basta la conseguenza: la programmazione avviene nel testo.
Detto così, sembra che il tutto si riduca a scrivere una buona frase. È l’equivoco da cui bisogna liberarsi subito, ed è la ragione per cui la terminologia è cambiata. Fra noi e il modello, in un’applicazione vera, c’è sempre un programma: il sito, l’assistente, le righe di codice che raccolgono la nostra richiesta e la spediscono. Il testo che arriva al modello lo scrive quel programma, ed è un carico fatto di parti con ruoli diversi, montate poco prima di partire, e non una frase. Ogni spedizione è una chiamata al modello, e in gergo il carico che viaggia con lei si chiama payload: dentro ci stanno anche le impostazioni della chiamata (per esempio quanto può essere lunga la risposta), e il contesto ne è la parte testuale. E il carico va costruito, misurato e ricostruito a ogni passo. Da qui i tre livelli del capitolo.
Tre cerchi concentrici#
Programmare a parole si fa a tre livelli, uno dentro l’altro come cerchi concentrici (Fig. 21.2), dal più piccolo al più grande.

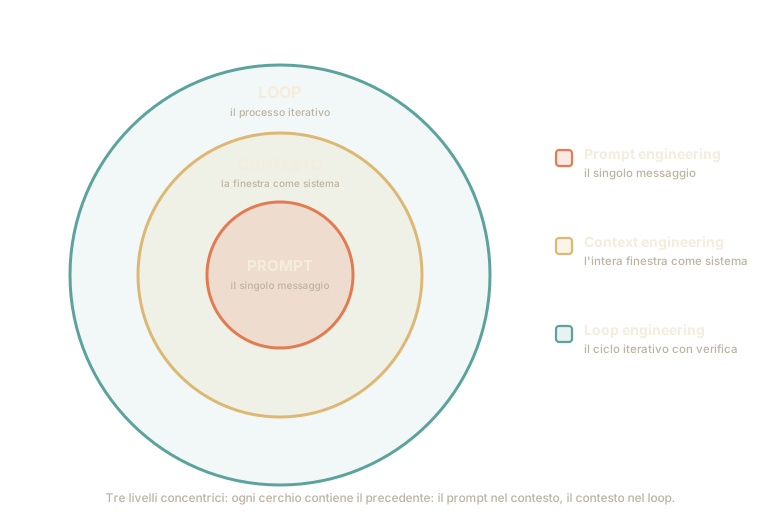
Fig. 21.2 I tre livelli del «programmare a parole», l’uno dentro l’altro: il prompt (il singolo messaggio) sta dentro il contesto (l’intera finestra come sistema), che a sua volta sta dentro il loop (il processo che la ri-riempie a ogni passo).#
Il primo cerchio, quello interno, è il prompt engineering: il singolo messaggio. Come si formula un’istruzione perché il modello faccia ciò che vogliamo: chiarezza, esempi, formato richiesto, il modo di chiedere il ragionamento passo passo. È il livello a cui si pensa istintivamente, ed è dove si comincia.
Il secondo cerchio, che racchiude il primo, è il context engineering: l’intera finestra come sistema. Qui il prompt dell’utente è solo un pezzo. Ci sono le istruzioni di fondo, gli esempi, la memoria di ciò che si è detto prima, i documenti recuperati da un archivio, le descrizioni degli strumenti a disposizione: le operazioni che il modello può chiedere al programma di eseguire per lui (cercare sul web, interrogare un archivio, mandare una mail). Gli strumenti sono il cuore del capitolo precedente, quello sugli agenti: un agente è un programma che si serve del modello a più riprese e che, a ogni ripresa, può lasciargli usare uno di questi strumenti, finché il compito non è finito. Il lavoro non è più «scrivere una frase» ma decidere cosa mettere nella finestra, in quale ordine, entro quale budget: perché la finestra è finita, e perché il testo si paga a quantità. Chi chiama un modello da un programma riceve una fattura proporzionale al testo che gli manda e a quello che riceve indietro: nella chat che si usa gratis quel conto lo paga qualcun altro, ma esiste, ed è il vincolo attorno a cui gira tutto il secondo cerchio.
Il terzo cerchio, il più esterno, è il loop engineering: il processo che sta attorno alle chiamate. Dentro c’è il ciclo dell’agente, osserva → ragiona → agisci, che a ogni giro ri-riempie e ripulisce la finestra; attorno c’è il programma che decide quando far partire quel ciclo. È lui a stabilire quali informazioni portare da un giro all’altro e dove memorizzarle quando la finestra è piena, come validare il risultato e quando fermarsi. Progettare questo processo è il livello più esterno e più difficile.
Sei al ristorante e chiedi al sommelier, quello che consiglia i vini: «mi consigli un vino per il pesce?». Quella domanda è il prompt. Il contesto è tutto ciò che lui ha davanti mentre risponde: il menù, la lista dei vini in cantina, quanto gli hai detto di voler spendere, la bottiglia che hai apprezzato la volta scorsa. Il loop è la serata intera: lui propone, tu assaggi, storci il naso, lui riparte da lì, e così via fino alla bottiglia giusta.
Il tavolo però è piccolo, come la finestra del modello, e dopo tre giri è pieno di bicchieri. Il sommelier bravo sparecchia, e prima di sparecchiare segna sul taccuino la riga che conta: «quel bianco no, troppo secco». Al quarto giro rilegge il taccuino, non il tavolo. Chi invece si limita a limare il modo di porre la domanda, e non sparecchia né annota niente, alla quarta bottiglia ti riporta quel bianco: la domanda era perfetta, la serata no. Domanda dentro il tavolo apparecchiato, il tavolo dentro la serata: ogni cerchio contiene quello prima.
L’annidamento è letterale, non metaforico. Il prompt è la stringa d’istruzione, ed è una delle componenti del contesto \(C\), cioè della parte testuale del carico montato prima della chiamata, \(C = [\,\text{system}, \text{esempi}, \text{memoria}, \text{documenti}, \text{strumenti}, \text{prompt}\,]\), dove \(\text{system}\) sono le istruzioni di fondo, quelle che fissano il ruolo. Il contesto, a sua volta, è ciò che il loop produce e consuma a ogni iterazione: detto \(C_t\) il contesto al passo \(t\), \(M_t\) la memoria esterna e \(o_t\) l’osservazione di ritorno (l’output del modello su \(C_t\), il risultato di uno strumento), il ciclo è
dove \(g\) è la politica che aggiorna finestra e memoria: aggiunge l’osservazione utile, comprime o scarta la cronologia superflua, scrive nella memoria esterna ciò che va conservato e ne reinietta ciò che serve al passo dopo. Il loop engineering progetta \(g\) e, insieme, il criterio che stabilisce quando il compito è finito. Ottimizzare il singolo prompt senza governare \(g\) significa curare un fotogramma e ignorare il film: il prompt vive un istante, il loop dura quanto il compito. Ecco perché i tre livelli non sono alternativi ma annidati, e perché conviene affrontarli dal piccolo al grande.
Perché «ingegneria» e non «magia»#
Chiamarlo engineering, ingegneria, non serve a darsi un tono. Serve a prendere le distanze da come la cosa veniva trattata agli inizi, cioè come una stregoneria: la caccia alla formula segreta, alla parola che «sblocca» il modello. Chiamarla ingegneria vuol dire ammettere tre cose poco romantiche ma vere: che le strade a disposizione costano, e in modo diverso; che quello che si fa si misura, invece di fidarsi a occhio; e che di ogni modifica si tiene traccia, come si fa col codice.
Il costo si vede meglio in una figura. Quando un modello non fa quello che vogliamo, abbiamo davanti tre strade, con costi crescenti: riscrivere il messaggio; recuperare i documenti che al modello mancano e fornirglieli insieme alla domanda (è il RAG, sigla di retrieval augmented generation, «generazione con recupero»); oppure riaprire i pesi e riaddestrarlo in parte sui nostri esempi (il fine-tuning). Le prime due lasciano il modello intatto, la terza lo altera, ed è la più costosa da mettere in piedi.

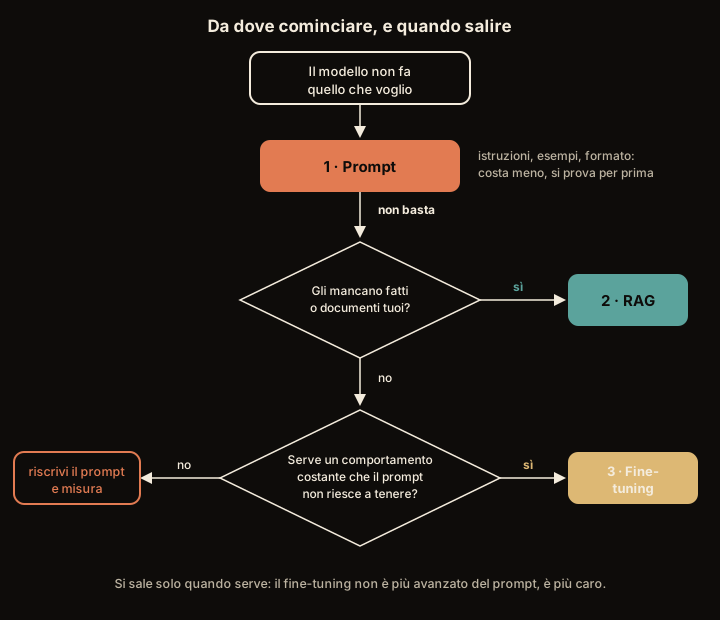
Fig. 21.3 Tre strade, in ordine di costo, ed è l’ordine in cui si provano. La prima domanda non è «quale tecnica è migliore» ma «il prompt ha già fallito?»; solo dopo viene «cosa manca davvero».#
L’ordine delle domande in Fig. 21.3 dice già come ragiona un ingegnere. Si comincia dalla strada che costa meno e si sale solo se serve: il fine-tuning è più caro del prompt, non più avanzato (vuole esempi raccolti a mano, macchine per addestrare, e va rifatto ogni volta che si cambia modello), e va giustificato da qualcosa che il prompt non poteva dare. La domanda che fa scegliere, quando il prompt non basta, è che cosa manchi davvero. Se mancano dei fatti (un manuale, l’archivio degli ordini, i dati di casa nostra) la risposta è il RAG. Se invece manca un comportamento, un modo di rispondere che nessuna istruzione riesce a tenere fermo su migliaia di richieste (il gergo di un settore, il tono di un marchio, il modo di rispondere di un servizio clienti), allora è il caso del fine-tuning. Le due strade hanno già la loro casa nel libro, il recupero e RAG per la prima e il post-training per la seconda: qui ci basta sapere quando si imboccano.
Il foglio del collaboratore si riscrive ogni giorno, ed è lì che si vede la differenza fra un incantesimo e un mestiere. L’incantesimo lo pronunci e speri.
Il mestiere lavora dentro dei vincoli: sul foglio ci sta solo una certa quantità di roba, e ogni riga in più è tempo che lui impiega a leggerla, cioè denaro. Poi c’è la misura. Tieni da parte venti richieste vere, di quelle che arrivano davvero; prima di adottare il foglio nuovo lo provi su quelle venti, e sulle stesse venti riprovi anche il vecchio. Vince quello che sbaglia meno, e a pari errori il più corto. Venti diverse a ogni prova non si potrebbero confrontare, e una sola non direbbe niente. Restano le versioni: i fogli vecchi si datano e si tengono nel cassetto, così quando il giovedì le risposte peggiorano sai che il colpevole è il foglio di mercoledì.
È noioso come tutta l’ingegneria, ed è per questo che funziona. Con un’avvertenza: è un mestiere nato ieri. Non ci sono leggi, ci sono regole pratiche che spesso funzionano e ogni tanto no. Chi ti promette la frase che funziona sempre ti sta vendendo qualcosa.
Tre proprietà rendono l’attività ingegneristica e non magica. Primo, i vincoli sono reali e quantificabili: la finestra ha un tetto di token, e ogni token pesa su latenza, memoria (la KV cache vista nel capitolo sui Transformer) e denaro, e del costo per token si occupa la sezione su capacità e costo. Non si ottimizza «la qualità» in astratto ma la qualità sotto vincolo di budget. Secondo, si misura: una versione del prompt o della politica di contesto si valuta su una batteria di casi e si confronta sugli stessi casi con la precedente prima di sostituirla; senza misura non c’è miglioramento, solo opinioni. Terzo, si versiona: il prompt è codice, va messo sotto controllo di versione e trattato come un artefatto del software, tema che ritroveremo in MLOps. Con una avvertenza di onestà intellettuale: è un’ingegneria giovane, fatta oggi più di euristiche che di garanzie. La terminologia stessa è in assestamento: per un buon tratto si è chiamato tutto «prompt engineering», finché non si è capito che il problema vero stava un cerchio più in fuori. Chi promette leggi certe, in questo campo, sta vendendo qualcosa.
Tre mestieri intorno allo stesso modello#
Il capitolo segue i tre cerchi, dal centro verso l’esterno. Del primo restano da vedere le fragilità, e il modo di chiedere esplicitamente il ragionamento passo passo, la chain-of-thought [WWS+22]. Del secondo il capitolo sugli agenti ha già visto la parte che tocca un agente (quanto spazio occupano gli strumenti e la traccia nella finestra, come memorizzare i ricordi in eccesso); qui lo si prende per intero, dal montaggio dentro un budget ai modi in cui si guasta. Il terzo è il più esterno e il più difficile, ed è quello che separa un modello che risponde da un sistema che porta a termine un compito.
Da ricordare
Un modello già addestrato non si tocca (riaprirlo si può, ma è la strada più cara): quello che si cambia è ciò che gli si mette davanti da leggere. Programmare a parole vuol dire questo, e Karpathy lo ha chiamato «programmare in inglese» (cioè in lingua umana: l’italiano va uguale).
Nel foglio che gli si lascia, la parte che pesa di più sono gli esempi: due o tre casi già risolti dentro il messaggio lo orientano verso il compito, senza che abbia imparato niente di nuovo. Alla fine della risposta è esattamente com’era prima.
Ci sono tre cerchi, uno dentro l’altro: il singolo messaggio che scrivi, tutto quello che il modello ha davanti mentre risponde (il contesto), e la conversazione o il processo che ripete la cosa più volte correggendo il tiro (il loop).
Si chiama ingegneria e non magia per tre ragioni concrete: c’è un limite (nella finestra ci sta solo una certa quantità di testo, e il testo si paga), si prova e si confronta invece di fidarsi a occhio, e si tiene traccia di cosa si è cambiato, così quando le risposte peggiorano si sa perché.
Quando il modello non fa quello che vuoi, le strade si provano in ordine di costo: prima si riscrive il messaggio; se gli mancano dei fatti, glieli si va a prendere (il RAG); solo se manca un modo di rispondere che nessuna istruzione tiene fermo si riapre il modello (il fine-tuning).
È un mestiere giovane: più regole pratiche che leggi. Nessuna frase garantisce un risultato; le pratiche buone spostano le probabilità, non comandano la macchina. Chi promette certezze sta vendendo qualcosa.
Il capitolo va dal centro verso l’esterno: prima il messaggio, poi la finestra, poi il ciclo.
Da ricordare
Con un LLM istruito non si programma coi pesi (congelati dall’addestramento) ma con le parole: il testo che gli mettiamo davanti. Congelati non vuol dire immutabili: riaprirli e proseguire l’addestramento sui propri dati si può, ed è il fine-tuning, ma è la strada più cara da mettere in piedi. Karpathy lo chiama Software 3.0 («si programma in inglese») e nel 2025 ha dato credito, per quel mestiere, al nome context engineering [Kar25a].
Il meccanismo che lo rende possibile è l’in-context learning: pochi esempi nel contesto (few-shot) orientano il modello senza aggiornarne i pesi [BMR+20]. Gli esempi non addestrano, condizionano.
Si programma a parole su tre livelli concentrici: il prompt (il singolo messaggio) dentro il contesto (l’intera finestra come sistema) dentro il loop (il processo che la ri-riempie a ogni passo). Ogni cerchio contiene il precedente.
Si dice ingegneria e non magia per tre motivi: i vincoli sono reali (finestra finita, costo per token), i risultati si misurano e si confrontano, e il prompt si versiona; «il prompt è codice», come in MLOps.
Le tre strade si provano in ordine di costo: il prompt per primo; il RAG se mancano fatti; il fine-tuning se manca un comportamento che nessuna istruzione tiene fermo, ed è il più caro, non il più avanzato.
È un mestiere giovane: più euristiche che garanzie, terminologia ancora in assestamento. Onestà sui limiti, zero formule magiche: si spostano le probabilità, non si comanda l’output.
Il capitolo procede dal centro verso l’esterno (prompt, contesto, loop) rimandando alla sezione sul contesto come interfaccia, nel capitolo sugli agenti, per la parte che riguarda un agente: quanto costa lo spazio della finestra e dove si tiene quello che non ci entra.