


Reinforcement learning basato su modello#
La prima volta che ti siedi davanti a un gioco da tavolo nuovo, dopo un paio di mani hai già smesso di muovere a caso. Non perché tu abbia giocato migliaia di partite: ne bastano due o tre perché la testa cominci a fare da sola una cosa preziosa (provare le mosse prima di farle). «Se scarto questa carta lui pesca e chiude… allora no.» La mossa cattiva muore nell’immaginazione, senza costarti la partita. È una delle differenze, ancora oggi vistose, fra un essere umano e un agente come il DQN. L’altra è tutto quello che sappiamo prima di cominciare (che gli oggetti cadono, che una chiave apre una porta): togliendo al giocatore i segnali visivi che lo richiamano, il tempo per finire un gioco nuovo passa da meno di due minuti a una ventina [DAP+18]. A noi bastano poche partite per capire come si gioca a Breakout (il gioco dei mattoncini da abbattere con una pallina) e un paio d’ore per giocarci bene; all’agente servono decine di milioni di fotogrammi. La parola tecnica per questa distanza è sample efficiency, l’efficienza nei campioni (quanta esperienza serve per imparare), ed è il problema che il reinforcement learning basato su modello affronta direttamente.
Gli algoritmi visti finora per imparare dall’esperienza (Q-learning, DQN, i metodi a gradiente di policy, DDPG, TD3, SAC) condividono una scelta implicita: imparano provando per davvero. Provano un’azione nel mondo, guardano cosa succede, aggiustano, e non si costruiscono mai una copia del gioco da consultare in privato. Sono metodi model-free, «senza modello». La ricerca ad albero fa eccezione, ma pianifica su un modello che le è dato, le regole del gioco. Qui il modello dell’ambiente l’agente se lo costruisce da sé, e poi lo usa per pianificare, cioè per provare le mosse nella testa, come al tavolo da gioco.
Provare per davvero o provare nella testa#

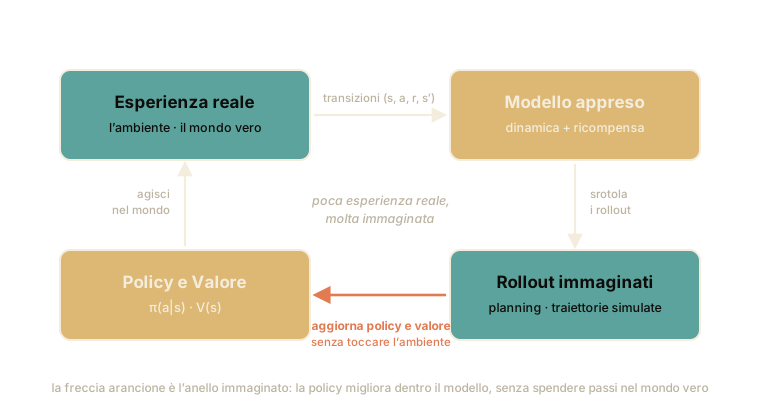
Fig. 14.9 Il giro dell’agente che si costruisce un simulatore. Le mosse fatte davvero servono ad addestrare il simulatore; lì dentro se ne immaginano tante altre, e sono quelle a migliorare la strategia. La freccia arancione è il pezzo immaginato: l’unico che non costa un solo passo nel mondo vero.#
Il disegno mostra due giri, non uno. Il primo tocca il mondo vero: si agisce, si guarda cosa succede, si usa quel poco per aggiustare il simulatore. Il secondo (quello con la freccia arancione) vive solo nella testa dell’agente. Tutto il gioco sta nel far girare molto il secondo pagando poco il primo.
Due allievi imparano a guidare. Il primo impara solo schiantandosi: prova una manovra sull’auto vera, se va male paga il danno, e solo così capisce che non andava fatta. Il secondo, dopo qualche giro, si è costruito in testa un piccolo simulatore della macchina («se sterzo così a questa velocità, il posteriore scappa») e le manovre pericolose le prova lì dentro, gratis. Il primo è un agente model-free: impara solo dall’urto reale. Il secondo è model-based: prima impara come funziona il mondo, poi usa quella conoscenza per provare le mosse nell’immaginazione, e nel mondo vero ci va già preparato.
Il vantaggio è ovvio: ogni giro reale del secondo allievo vale molto di più, perché da esso spreme decine di prove immaginate. Il rischio, altrettanto ovvio, è di fidarsi di un simulatore sbagliato: se nella sua testa le curve sono più dolci che in strada, si allena a guidare un’auto che non esiste.
E c’è un guaio più insidioso del semplice sbagliare. Il secondo allievo non prova manovre a caso, cerca la più veloce; se nella sua testa una certa curva si tiene a novanta all’ora, sarà proprio quella la manovra che ripete e affina, cioè la manovra costruita sopra l’errore. Nell’immaginazione fa il giro record. In strada, a quella curva, esce fuori.
Un ambiente di RL è un processo decisionale di Markov con dinamica \(p(s' \mid s, a)\) (la probabilità di finire nello stato \(s'\) partendo da \(s\) e compiendo \(a\)) e una funzione di ricompensa \(r(s, a)\). Un metodo model-free apprende direttamente la policy \(\pi_\theta(a \mid s)\) o i valori \(Q(s, a)\), \(V(s)\) dall’interazione, senza mai stimare \(p\) e \(r\). Un metodo model-based fa l’opposto: apprende un modello \(\hat p_\psi(s' \mid s, a)\) e \(\hat r_\psi(s, a)\) dalle transizioni osservate, poi lo usa per pianificare (cercare, tra le traiettorie immaginate, quelle a ritorno più alto) o per generare esperienza sintetica su cui allenare policy e valore [SB18].
Il guadagno atteso è la sample efficiency: una transizione reale, digerita nel modello, ne genera molte simulate. Il prezzo ha un nome preciso, model bias: il modello \(\hat p_\psi\) non è la dinamica vera, e l’errore di predizione si propaga lungo l’orizzonte. Peggio, una policy ottimizzata dentro il modello impara a sfruttarne i difetti (model exploitation), incassando ritorni immaginari che l’ambiente reale non paga. La storia del model-based, dagli anni novanta a oggi, è il racconto di come si è negoziato questo compromesso: quanta fiducia concedere al modello.
Dyna: intrecciare il vero e l’immaginato#
L’idea non è nuova. Nel 1990 Richard Sutton (lo stesso del manuale classico della materia [SB18]) presenta Dyna [Sut90], ripresa l’anno dopo in una versione più diffusa [Sut91]. È un’architettura tanto semplice quanto lungimirante: mentre l’agente gioca, impara contemporaneamente due cose (una policy, come sempre, e un modellino del mondo) e usa il modellino per «ripassare» senza muovere un passo nel mondo.
Una pedalata, venti ripassi a mente. È così che un fattorino nuovo di zona impara la strada giusta pedalando molto meno di quanto sembri.
Gira in bicicletta con un taccuino, e a ogni svolta si scrive una riga: «da piazza del Mercato, girando a destra, si finisce in via Corta». Il giorno in cui trova il portone che cercava si scrive anche quello: «in fondo a via Corta, il portone». La sera, a casa, non fa un metro di strada: apre il taccuino, pesca righe a caso e su ciascuna rifà lo stesso ragionamento che farebbe sul posto. In fondo a via Corta c’è il portone, quindi via Corta è una buona strada; e da piazza del Mercato, girando a destra, si arriva in via Corta, quindi anche quella svolta è buona. La notizia del portone risale il taccuino all’indietro, riga dopo riga, con la bicicletta ferma in cortile.
Dyna fa questo. Ogni volta che l’agente compie una mossa vera, impara due cose: aggiusta le sue valutazioni in base a com’è andata, e si annota la transizione («da qui, con questa mossa, sono finito lì e ho preso questa ricompensa»). Poi, prima della mossa successiva, si concede una ventina di «ripassi»: pesca a caso alcune transizioni già annotate e riaggiusta le valutazioni anche su quelle, con lo stesso conto che farebbe sull’esperienza vera. Le mosse vere restano poche, i ripassi sono tanti, e la ricompensa si propaga all’indietro molto più in fretta.
Detto così, il taccuino somiglia molto al quaderno di DQN, e in questa forma minima la differenza è davvero piccola. Il quaderno conserva i ricordi così come sono; il taccuino risponde a una domanda, «se da qui faccio questo, che cosa succede?». Finché le risposte sono soltanto le righe scritte, le due cose si equivalgono. Quando il taccuino diventa una rete che generalizza, sa rispondere anche per svolte mai provate, ed è lì che il ripasso diventa immaginazione.
Dyna-Q intreccia apprendimento diretto e planning attorno allo stesso \(Q(s,a)\). Dopo ogni passo reale \((s, a, r, s')\) esegue due tipi di aggiornamento. Il primo, dall’esperienza vera:
e memorizza la transizione nel modello, \(\text{modello}(s,a) \leftarrow (r, s')\). Poi ripete \(n\) volte un passo di planning: campiona una coppia \((s, a)\) già osservata, ne recupera \((r, s')\) dal modello e applica lo stesso aggiornamento di sopra; solo che l’esperienza è simulata, non vissuta. Qui \(\alpha\) è il passo di apprendimento e \(\gamma\) il fattore di sconto. Con \(n\) grande, ogni interazione reale scatena molti aggiornamenti immaginati, e la propagazione dei valori accelera drasticamente. È il seme di tutto il model-based moderno: separare l’esperienza (costosa, reale) dagli aggiornamenti (economici, ripetibili nel modello).
Il modello tabellare tiene una sola coppia \((r,s')\) per ogni \((s,a)\), quindi presuppone un ambiente deterministico e stazionario. In un ambiente stocastico va sostituito con una distribuzione sugli esiti, o con i campioni osservati pescati secondo le loro frequenze; se la dinamica cambia nel tempo il modello invecchia, e Dyna-Q+ lo tiene aggiornato aggiungendo nei ripassi un premio \(\kappa\sqrt{\tau}\) alle coppie non provate da \(\tau\) passi [SB18]. E finché il modello restituisce soltanto le transizioni già viste, il planning di Dyna-Q coincide di fatto con un replay di quelle transizioni: la differenza con la memoria di DQN nasce quando il modello generalizza a coppie mai osservate.
Conviene vedere Dyna al lavoro su un ambiente minuscolo. Il nome per esteso è Dyna-Q, con la \(Q\) del Q-learning appiccicata in coda, perché i giudizi che va ad aggiornare sono proprio quelli: quanto vale ciascuna mossa in ciascuna casella. Il corridoio ha sei caselle: si parte a sinistra, l’obiettivo è la casella più a destra, e la ricompensa arriva solo entrando nell’obiettivo.
Prima però va scelto che cosa guardare. La tentazione è guardare la strategia appresa e verificare che dica «vai sempre a destra»: solo che il corridoio è così facile che il Q-learning con la tabella, senza un solo ripasso, impara la stessa identica strategia. Sarebbe una misura che non misura. Ciò che il ripasso cambia davvero è la quantità appena promessa, cioè quanto in fretta la ricompensa si propaga all’indietro fino allo stato di partenza. Perciò il codice esegue lo stesso ciclo due volte, con e senza ripassi, e a ogni giro stampa quanto vale, per l’agente, trovarsi nella casella di partenza: zero vuol dire «di qui non ho ancora imparato che si guadagna qualcosa», e più il numero sale più la buona notizia è arrivata fin laggiù. Ogni giro è un episodio, cioè una partita dall’inizio alla fine, e di partite se ne giocano trenta, ripetendo tutto su dieci semi.
import numpy as np

# Ambiente: corridoio di 6 stati; l'obiettivo e' lo stato 5 (assorbente).
# Azioni: 0 = sinistra, 1 = destra. Ricompensa +1 solo entrando nell'obiettivo.
n_stati, n_azioni, goal = 6, 2, 5

def passo(s, a):
    s2 = min(s + 1, goal) if a == 1 else max(s - 1, 0)
    return s2, (1.0 if s2 == goal else 0.0), (s2 == goal)

def dyna(n_plan, seme, episodi=30):
    """Dyna-Q. Con n_plan=0 e' Q-learning tabellare puro: nessun ripasso."""
    rng = np.random.default_rng(seme)
    Q = np.zeros((n_stati, n_azioni))
    modello = {}                       # (s, a) -> (r, s2): la dinamica APPRESA
    alpha, gamma, eps = 0.1, 0.95, 0.1
    valore_partenza = []               # quanto vale lo stato 0, episodio per episodio
    for _ in range(episodi):
        s = 0
        for _ in range(100):
            if rng.random() < eps:
                a = int(rng.integers(n_azioni))
            else:                      # argmax con i pareggi rotti a caso
                a = int(rng.choice(np.flatnonzero(Q[s] == Q[s].max())))
            s2, r, fine = passo(s, a)
            # 1) aggiornamento dall'esperienza REALE
            Q[s, a] += alpha * (r + gamma * Q[s2].max() - Q[s, a])
            modello[(s, a)] = (r, s2)  # memorizza la transizione osservata
            # 2) n passi di PLANNING su transizioni gia' viste (esperienza immaginata)
            viste = list(modello.keys())
            for _ in range(n_plan):
                sp, ap = viste[rng.integers(len(viste))]
                rp, s2p = modello[(sp, ap)]
                Q[sp, ap] += alpha * (rp + gamma * Q[s2p].max() - Q[sp, ap])
            s = s2
            if fine:
                break
        valore_partenza.append(Q[0].max())
    return np.argmax(Q, axis=1), np.array(valore_partenza)

SEMI = range(10)
for n_plan in (0, 20):
    esiti = [dyna(n_plan, s) for s in SEMI]
    v = np.array([e[1] for e in esiti])          # (semi, episodi)
    print(f"n_plan={n_plan:2d} | policy appresa (0=sx, 1=dx): "
          f"{esiti[0][0][:goal].tolist()}")
    print(f"           valore dello stato di partenza, mediana su {len(SEMI)} semi: "
          f"dopo 3 episodi {np.median(v[:, 2]):.3f}, "
          f"dopo 10 {np.median(v[:, 9]):.3f}, alla fine {np.median(v[:, -1]):.3f}")
La strategia appresa, come previsto, è la stessa nei due casi:
[1, 1, 1, 1, 1], vai sempre a destra. Il valore della casella di partenza no. Senza ripassi, dopo tre
episodi vale ancora \(0{,}000\) (la notizia della ricompensa non è arrivata fin
laggiù) e dopo trenta si ferma a \(0{,}156\). Con venti ripassi per ogni mossa
vera, dopo tre episodi vale già \(0{,}200\), dopo dieci \(0{,}808\) e alla
trentesima \(0{,}815\).
Quel \(0{,}815\) è la risposta esatta, e si calcola a mano con lo sconto dei premi lontani della sezione sugli MDP: nel codice ogni passo di attesa moltiplica il premio per \(\gamma = 0{,}95\). Chi si trova sulla casella accanto all’obiettivo incassa \(1\) alla mossa dopo, e per lui quel premio vale \(1\); chi sta una casella più indietro deve aspettare una mossa in più e per lui vale \(0{,}95\); due caselle indietro, \(0{,}95\times0{,}95\). Dalla partenza al traguardo ci sono cinque mosse, ma l’ultima incassa il premio subito e non aspetta niente: le attese vere sono quattro, quindi \(0{,}95^{4} \approx 0{,}815\), ed è lì che il valore deve arrivare.
È tutto il guadagno del model-based in due numeri. Dopo trenta episodi per parte il ripasso ha portato la casella di partenza a \(0{,}815\), cioè esattamente dove doveva arrivare, mentre senza ripassi si è fermata a \(0{,}156\): cinque volte più in basso, e ancora lontanissima dal bersaglio. Se avessimo guardato solo la policy, avremmo concluso che i ripassi non cambiano niente, e ci saremmo sbagliati: il vantaggio c’è, e sta nella velocità con cui il valore arriva fino alla casella di partenza.
L’errore del modello si compone lungo il rollout#
Dyna, nell’esempio, «immagina» transizioni di un solo passo, già osservate, e non intere traiettorie inventate dal modello. La ragione è il problema strutturale di ogni approccio basato su modello: più la traiettoria immaginata si allunga (in gergo è un rollout), più l’errore del modello si compone, perché ogni previsione parte da uno stato già sbagliato. Se la dinamica amplifica le perturbazioni, l’errore cresce in modo esponenziale con la lunghezza del rollout.
È il gioco del telefono senza fili. Il primo bambino sussurra la frase giusta; ognuno la ripete con un piccolo errore, e dopo dieci passaggi la frase è irriconoscibile. Un modello del mondo fa lo stesso quando gli chiedi di immaginare lontano: la prima previsione è quasi giusta, ma la seconda parte da quella «quasi», la terza dal «quasi del quasi», e l’errore si gonfia a ogni passo.
Quanto si gonfi, però, dipende dal mondo che stai immaginando, ed è la parte che sfugge. Ci sono sistemi che si rimettono a posto da soli, come una biglia in fondo a una scodella: lì uno scarto piccolo resta piccolo per sempre, e si può sognare a lungo senza troppi danni. E ci sono sistemi instabili, come la biglia in equilibrio sulla scodella rovesciata, dove ogni passaggio ingrandisce lo scarto invece di smorzarlo: bastano pochi passi e il sogno non ha più niente a che vedere con la realtà. E c’è un terzo caso, il più insidioso: una scodella lunga e storta. Alla lunga la biglia arriva in fondo anche lì, e chi guarda solo dove finisce la scambia per un sistema tranquillo; ma prima fa un giro larghissimo, e durante il giro due biglie partite vicine si allontanano parecchio. Un sogno corto vive tutto dentro quel giro: lo scarto cresce proprio mentre si sogna, anche se più tardi si sarebbe riassorbito.
Morale: in quale di questi mondi ti trovi quasi mai lo sai, quindi le previsioni su cui puoi contare sono quelle a breve. La cura è disarmante nella sua semplicità, e nel 2019 trova la formulazione che farà scuola, un algoritmo che si chiama MBPO («ottimizzare la strategia basandosi su un modello»): invece di far partire i sogni dall’inizio della partita e tirarli avanti a lungo, si parte da una situazione vera, appena visitata, e si immagina solo pochi passi. Sogni corti, ancorati alla realtà, e l’errore non fa in tempo ad accumularsi.
Il conto si fa su una dinamica deterministica, che è il caso in cui «lo scarto» è una distanza fra due stati e non fra due distribuzioni (nel caso stocastico la stessa idea regge, ma va riscritta in distanza di Wasserstein, e la costante non è più la stessa). Si supponga che la dinamica vera \(f\) sia \(L\)-Lipschitz nello stato, cioè che moltiplichi al più per \(L\) la distanza fra due stati, e che il modello \(\hat f\) sbagli di al più \(\epsilon\) in ogni stato che il rollout raggiunge, \(\lVert \hat f(s,a) - f(s,a)\rVert \le \epsilon\); e si confrontino traiettoria vera e immaginata a parità di azioni. Allora, per la disuguaglianza triangolare, lo scarto \(e_k\) fra stato immaginato e stato vero soddisfa \(e_k \le \epsilon + L\,e_{k-1}\) con \(e_0 = 0\), e dopo \(k\) passi è maggiorato da
e i tre regimi sono diversissimi fra loro. Per \(L>1\) la somma esplode esponenzialmente in \(k\), ed è questo il caso che rende l’accumulo dell’errore un problema. Attenzione al verso: un sistema instabile ha per forza \(L>1\), ma non vale il contrario, e il caso che sfugge è il peggiore di tutti. Una dinamica che alla lunga si riassorbe può intanto allargare lo scarto di decine di volte, cioè proprio nei pochi passi in cui il sogno vive. Per \(L=1\) esattamente si ha la crescita lineare, \(k\epsilon\), che è il caso limite e non il caso tipico. E per \(L<1\), cioè quando la dinamica è contrattiva e gli scostamenti si riassorbono da sé, lo scarto è limitato da \(\epsilon/(1-L)\) e smette proprio di crescere: con \(\epsilon = 0{,}01\), a cinquanta passi e \(L=0{,}5\) lo scarto resta \(0{,}020\), contro i \(0{,}500\) che darebbe la lettura lineare, ed è già fermo lì dal ventesimo passo. È il compounding error, e impone un compromesso: rollout lunghi danno più segnale di allenamento ma sempre meno affidabile, e quanto meno affidabile non lo decide l’orizzonte da solo, lo decide il sistema. Il conto, poi, è ottimista per costruzione: chiede che l’errore del modello resti sotto \(\epsilon\) in ogni stato raggiunto, mentre un modello appreso è accurato soprattutto vicino ai dati, e il rollout se ne allontana proprio perché sbaglia. Inoltre, se le azioni le sceglie una policy che dipende dallo stato, nella \(L\) va messa anche la sua costante di Lipschitz.
MBPO (Model-Based Policy Optimization, Janner et al., 2019 [JFZL19]) risolve il compromesso con un’idea nel titolo del lavoro: When to Trust Your Model, «quando fidarsi del modello». Invece di srotolare lunghe traiettorie dallo stato iniziale, MBPO esegue rollout brevi (spesso di uno o pochi passi) che si diramano da stati reali campionati dal buffer di esperienza: il modello (in pratica un ensemble di reti probabilistiche, che rappresenta anche la propria incertezza) viene interrogato solo dove è più affidabile, vicino a stati davvero visitati. Le transizioni sintetiche così generate alimentano un algoritmo model-free off-policy (SAC). L’analisi degli autori lega esplicitamente il divario di ritorno all’errore del modello e alla lunghezza del rollout, giustificando formalmente la scelta di tenerlo corto: si sfrutta il modello dove aiuta, lo si evita dove mente.
L’ensemble viene da PETS (Probabilistic Ensembles with Trajectory Sampling, Chua e colleghi [CCML18]), che il modello lo usa per pianificare senza nessuna policy appresa. Ogni rete predice una gaussiana sullo stato successivo, la cui varianza rappresenta il rumore dell’ambiente (incertezza aleatoria), mentre il disaccordo fra le reti rappresenta ciò che i dati non hanno ancora fissato (incertezza epistemica). A ogni passo reale il cross-entropy method cerca la sequenza di azioni migliore su un orizzonte \(H\), valutandola con traiettorie propagate nell’ensemble; si esegue la sola prima azione e si ricomincia, cioè model predictive control. Il costo si sposta dall’addestramento alla decisione: per ogni azione qualche migliaio di sequenze di \(H\) passi, ciascuna propagata su una ventina di traiettorie.
MuZero: pianificare senza conoscere le regole#
Dyna e MBPO si costruiscono un modello che prova a riprodurre il mondo: dallo stato e dalla mossa, lo stato successivo e la ricompensa. AlphaZero, nella sezione sulla ricerca ad albero, un modello non doveva impararlo: glielo davano le regole del gioco, e dentro quello pianificava in profondità. Nel novembre 2019 (su Nature l’anno dopo) un gruppo di DeepMind presenta MuZero [SAH+20], che fa un passo che sembra un gioco di prestigio: pianifica in profondità come AlphaZero, ma senza ricevere le regole del gioco, con un modello imparato come quello di Dyna; e quel modello non prova nemmeno a riprodurre il mondo.
Il modello che MuZero si costruisce tiene, al posto del mondo, un riassunto: il minimo che serve a decidere. In gergo quel riassunto si chiama latente, e la parola vuol dire nascosto, perché là dentro la scacchiera non c’è più.
MuZero è l’erede di AlphaZero, l’algoritmo che nella sezione sulla ricerca ad albero Monte Carlo abbiamo visto padroneggiare Go, scacchi e shogi partendo dalle sole regole. Ma ad AlphaZero le regole erano date: sapeva con esattezza, per ogni mossa, quale posizione ne sarebbe seguita. MuZero no: se le costruisce da solo guardando le partite, e (dettaglio cruciale) non si fa un modello che ridisegna la scacchiera pezzo per pezzo, ma solo un modello «da stratega». Immagina un maestro che ragiona per sensazioni: non visualizza ogni pedone dopo dieci mosse, ma tiene in testa quel tanto che gli serve per rispondere a tre domande («questa mossa mi avvicina alla vittoria? chi è in vantaggio? che ricompensa arriva ora?»). MuZero impara questo riassunto astratto, il minimo per pianificare, e butta via il resto; poi, lì dentro, esplora a fondo le linee più promettenti prima di decidere.
MuZero apprende un modello latente fatto di tre funzioni, addestrate insieme end-to-end:
La rappresentazione \(h_\psi\) codifica le osservazioni passate \(o_{\le t}\) in uno stato latente iniziale \(s^0\); la dinamica \(g_\psi\), dato lo stato latente \(s^k\) e un’azione ipotetica \(a^k\), predice il latente successivo \(s^{k+1}\) e la ricompensa \(\hat r^{k+1}\); la predizione \(f_\psi\) ne ricava una policy \(\hat \pi^k\) e un valore \(\hat v^k\). Punto decisivo: \(s^k\) non è addestrato a ricostruire l’osservazione. Non c’è alcuna pressione a rappresentare i pixel; il latente deve solo contenere ciò che serve a predire policy, valore e ricompensa: le tre quantità utili alla pianificazione. La perdita, su un tratto di \(K = 5\) passi srotolati dentro il modello, è
dove \(u_{t+k}\) è la ricompensa osservata, \(\pi_{t+k}\) la distribuzione delle visite della ricerca e \(z_{t+k}\) il ritorno a \(n\) passi che usa come coda il valore stimato dalla ricerca (\(n = 10\) negli Atari; nei giochi da tavolo, il risultato della partita). Su questo modello latente MuZero esegue una ricerca ad albero Monte Carlo (MCTS), la stessa idea di AlphaGo [SHM+16] e del suo successore AlphaZero [SHS+18], ma srotolata dentro il modello appreso anziché su un simulatore dato. Il risultato: prestazioni pari ad AlphaZero su Go, scacchi e shogi senza riceverne le regole, e la stessa ricetta che regge sui giochi Atari, dove l’emulatore esiste ma all’agente non viene dato come modello. La differenza con AlphaZero è tutta qui: AlphaZero pianifica su un modello fornito, MuZero su un modello appreso. (Alla radice della ricerca, dove l’ambiente si può interrogare, MuZero conosce le mosse ammesse; dentro l’albero no.)
Dreamer: allenare la policy nel sogno#
Le strade viste finora sono due. Dyna immagina un passo alla volta e con quello aggiusta i propri giudizi; MuZero, al momento di decidere, si ferma ed esplora un albero di continuazioni. Ce n’è una terza, che la sezione sui mondi in miniatura racconterà per esteso e che qui serve solo a completare il quadro: costruirsi un simulatore interno dell’ambiente (un world model) e allenare la strategia interamente lì dentro, senza mai fermarsi a pianificare.
La terza via sfrutta il fatto che simulatore e strategia sono reti neurali, quindi derivabili. Se le azioni sono continue (quanta spinta, quanto sterzo), il gradiente del ritorno immaginato può risalire il tratto sognato, mossa dopo mossa, fino ai parametri della strategia, che impara così non solo che il tratto è andato male ma di quanto andava spostata ciascuna mossa. La scelta fra le voci di un menu, come nei giochi Atari, non ha derivata, e lì si torna allo stimatore di REINFORCE, che l’ultima versione di Dreamer usa per tutte le azioni.
E la partita immaginata si srotola dentro il latente: a ogni passo il simulatore prevede il riassunto successivo, senza mai ridisegnare quello che si vedrebbe.
È il pilota che, la sera prima della gara, ripassa il circuito a occhi chiusi, curva per curva. Non consuma benzina, non rischia incidenti: la pista ce l’ha in testa, e lì dentro può ripassarla quante volte vuole. Gli algoritmi della famiglia Dreamer fanno questo: si costruiscono un modello del gioco e poi addestrano il pilota solo dentro il sogno, riportandolo nel mondo vero già allenato. E da una curva ripassata male il pilota non si porta via soltanto che è andata male: ripercorrendola a ritroso capisce di quanto avrebbe dovuto girare il volante, punto per punto.
Il ripasso, però, non è mai il giro intero. Il pilota riparte da un punto della pista in cui è passato davvero nel pomeriggio e tira avanti per un tratto breve, la curva e l’uscita; poi ricomincia da un altro punto vero. Più a lungo si va avanti a occhi chiusi, più la pista che si ha in testa si scosta da quella su cui si correrà.
La linea di ricerca nasce dai «mondi in miniatura» di Ha e Schmidhuber [HS18] (l’agente che imparava a schivare palle di fuoco esercitandosi nel proprio sogno) e arriva a DreamerV3 di Danijar Hafner e colleghi [HPBL25], che con la stessa configurazione, senza ritocchi, padroneggia oltre 150 compiti diversi (robot simulati, giochi Atari, navigazione 3D) e riesce persino a raccogliere i diamanti in Minecraft partendo da zero, senza che nessuno gli mostri come.
Dreamer apprende un modello ricorrente dello stato nello spazio latente e vi addestra un attore-critico (i metodi visti nella sezione sul gradiente di policy) su rollout immaginati di una quindicina di passi, chiusi dai \(\lambda\)-ritorni del critico, proprio per contenere il compounding error. Nelle prime versioni l’attore impara per retropropagazione attraverso il modello quando le azioni sono continue e con lo stimatore di REINFORCE quando sono discrete; la versione definitiva, DreamerV3 [HPBL25], usa REINFORCE per tutte e aggiunge normalizzazioni robuste di osservazioni, ricompense e ritorni che rendono lo stesso set di iperparametri valido su domini radicalmente diversi: è la dimostrazione che un agente model-based può essere generalista. La parentela con Dyna è diretta (attore e critico crescono su esperienza sintetica generata da un modello appreso) ma il modello qui è una rete profonda che vive in uno spazio latente, non una tabella di transizioni. Per la ricetta completa (encoder, modello ricorrente, il «sogno» come rollout latente), si rimanda al capitolo sui World Model, che tratta anche la proposta di LeCun e le architetture JEPA, la frontiera di questa linea di ricerca.
Un modello della dinamica, come quelli che alimentano i metodi appena visti, in PyTorch ha una forma semplice: da stato e azione predice lo stato successivo e la ricompensa, e lo si addestra per regressione sulle transizioni osservate (errore quadratico sullo stato successivo e sulla ricompensa). La traiettoria «immaginata» è poi la sua applicazione ripetuta, tenuta volutamente corta.
import torch
from torch import nn

class ModelloDinamica(nn.Module):
    """Modello appreso: da (stato, azione) predice stato successivo e ricompensa."""
    def __init__(self, dim_s, dim_a, dim_h=200):
        super().__init__()
        self.corpo = nn.Sequential(
            nn.Linear(dim_s + dim_a, dim_h), nn.SiLU(),
            nn.Linear(dim_h, dim_h), nn.SiLU(),
        )
        self.testa_stato = nn.Linear(dim_h, dim_s)    # variazione dello stato
        self.testa_ricompensa = nn.Linear(dim_h, 1)   # ricompensa predetta

    def forward(self, s, a):                          # s: (B, dim_s), a: (B, dim_a)
        h = self.corpo(torch.cat([s, a], dim=-1))
        s_succ = s + self.testa_stato(h)              # residuo: predice il cambiamento
        r = self.testa_ricompensa(h).squeeze(-1)      # (B,)
        return s_succ, r

# Rollout BREVE immaginato (stile MBPO): parte da stati reali, pochi passi.
# Qui si vede solo la forma: il modello non e' addestrato.
modello = ModelloDinamica(dim_s=4, dim_a=1)
policy = nn.Sequential(nn.Linear(4, 1), nn.Tanh())    # strategia giocattolo
s = torch.randn(32, 4)            # 32 stati (casuali, al posto di quelli veri)
for _ in range(3):                                    # orizzonte corto: 3 passi
    a = policy(s)                                     # (32, 1)
    s, r = modello(s, a)                              # transizioni SINTETICHE
Quando il sogno inganna: il model exploitation#
Resta il punto dolente, che nessun risultato spettacolare cancella. Una policy addestrata dentro un modello tende a sfruttarne i difetti, ed è il model exploitation, lo sfruttamento del modello. Se il modello sbaglia in modo sistematico (sopravvaluta una ricompensa, dimentica un ostacolo), l’ottimizzazione trova proprio quelle crepe: emergono policy che incassano ritorni immaginari altissimi e falliscono nel mondo vero. La sezione sui mondi in miniatura ne racconterà l’esempio da manuale: l’agente che, dentro il proprio sogno di Doom, trova movimenti per cui le palle di fuoco si spengono mentre si formano.
Il compromesso è strutturale, e si può leggere come una manopola. Girata da una parte c’è la fiducia: sogni lunghi, tutta la strategia allenata nell’immaginazione, pochissima esperienza vera spesa, e in cambio si eredita in pieno l’errore sistematico del simulatore. Girata dall’altra c’è la prudenza: sogni corti che partono da situazioni davvero visitate, e più simulatori addestrati in parallelo per vedere dove vanno d’accordo e dove no; si è più robusti, e in cambio si torna a spendere esperienza vera. Il disaccordo, di per sé, non dice quale abbia ragione; dice che i dati visti non bastavano a stabilirlo, e quindi che di quel pezzo di mondo nessuno sa abbastanza, ed è il modo più semplice di sapere dove non fidarsi. I metodi model-free, per contro, non hanno nessun modello da sfruttare e restano competitivi quando i campioni costano poco. Non c’è un vincitore assoluto: c’è quella manopola, e sapere dove metterla è oggi materia di ricerca aperta.
Da ricordare
Un agente model-free impara solo schiantandosi per davvero; uno model-based si costruisce prima in testa un simulatore del mondo e le manovre le prova lì dentro, gratis. Guadagna in esperienza risparmiata, rischia di allenarsi su un’auto che non esiste.
Dyna (Sutton, 1990) è il capostipite: dopo ogni mossa vera l’agente aggiusta le sue valutazioni e si annota che cosa è successo, poi si concede qualche «ripasso» pescando a caso fra le transizioni annotate. Una mossa vera, tanti ripassi immaginati, e la ricompensa si propaga all’indietro molto più in fretta: nel corridoio dell’esempio, a parità di partite giocate, la casella di partenza finisce a un valore cinque volte più alto, che è poi quello giusto.
Immaginare lontano è il gioco del telefono senza fili: ogni previsione parte da una precedente già un po’ sbagliata e l’errore si gonfia a ogni passaggio. Quanto si gonfi dipende dal sistema: dove gli scarti si riassorbono da sé l’errore resta piccolo per sempre, dove il sistema li ingigantisce esplode in pochi passi, e il caso più insidioso è il sistema che alla lunga si calma ma intanto li allarga, proprio mentre si sogna. La cura è tenere i sogni corti e farli partire da situazioni davvero visitate: si chiama MBPO, e l’errore non fa in tempo ad accumularsi.
MuZero (2020) le regole del gioco se le costruisce da solo guardando le partite, e non si fa un modello che ridisegna la scacchiera pezzo per pezzo: tiene solo il riassunto (il latente) che serve a rispondere a «chi è in vantaggio, che ricompensa arriva ora, quale mossa conviene». Lì dentro esplora a fondo le linee promettenti prima di decidere. È l’erede di AlphaZero, che invece le regole le riceveva già scritte.
Dreamer allena il pilota interamente dentro il sogno, e DreamerV3 se la cava con la stessa configurazione su oltre 150 compiti diversi. Il limite di fondo non sparisce: una strategia vale quanto il mondo immaginario in cui è cresciuta, e tende a trovarne e sfruttarne le crepe.
Da ricordare
Model-free impara provando per davvero; model-based apprende prima la dinamica \(\hat p_\psi(s' \mid s, a)\) e la ricompensa, poi pianifica dentro il modello. Il premio è la sample efficiency; il pericolo è il model bias.
Dyna (Sutton, 1990) è il capostipite: intreccia aggiornamenti da esperienza reale e da esperienza «immaginata» campionata dal modello appreso.
L’errore si accumula lungo il rollout (compounding error), maggiorato da \(\epsilon\sum_{i<k}L^{\,i}\): esponenziale in \(k\) appena la dinamica amplifica le perturbazioni (\(L>1\)), lineare solo nel caso limite \(L=1\), limitato se è contrattiva. MBPO (Janner et al., 2019) lo aggira con rollout brevi diramati da stati reali, usando il modello solo dove è affidabile.
MuZero (Schrittwieser et al., 2020) apprende un modello latente addestrato a predire policy, valore e ricompensa, e pianifica con MCTS senza conoscere le regole del gioco: è l’erede di AlphaZero, che il modello lo riceveva già fatto.
Dreamer (Hafner et al.) allena la policy interamente nell’immaginazione latente; DreamerV3 è generalista su oltre 150 compiti. Il limite di fondo resta uno: la policy è buona quanto il modello in cui è cresciuta.