


Deep Reinforcement Learning#
Nel 2013 un laboratorio londinese ancora poco noto, DeepMind, pubblica un risultato che sembra un giochino e invece è uno spartiacque: una rete neurale impara a giocare a Breakout, il classico dei mattoncini dell’Atari 2600, guardando solo i pixel dello schermo e il punteggio. Nessuno le ha spiegato le regole, cosa sia la pallina, cosa sia la racchetta. Due anni dopo, con una rete più grande, qualche accorgimento in più e un addestramento cinque volte più lungo, lo stesso metodo non si limita a giocare bene: scopre da solo la tattica di scavare un tunnel sul lato del muro per far rimbalzare la pallina dietro i mattoni. Nessuno gliel’ha insegnata, e nel punteggio non c’era scritta.
Il capitolo sul reinforcement learning ha consegnato un Q-learning che tiene i suoi conti in una tabella: una casella per ogni situazione, e dentro un voto per ciascuna mossa possibile lì. Al suo posto arriva una rete neurale, e da questa sostituzione viene il deep, «profondo», l’aggettivo che si usa per le reti fatte di molti strati sovrapposti, quelle del capitolo sul deep learning.
Quando la tabella diventa impossibile#
Con una tabella si va benissimo in un labirinto di cento caselle: cento righe, e ci stanno su un foglio. Ma proviamo a giocare guardando lo schermo, come farebbe una persona.
La tabella del labirinto era un elenco con una riga per casella, e dentro ogni riga un voto per ciascuna mossa. Davanti a un televisore servirebbe una riga per ogni schermata che il gioco può mostrare.
Il conto delle schermate possibili l’ha già fatto la sezione sugli MDP: una griglia di 84 quadretti per lato, 256 sfumature di grigio per quadretto, e un numero di schermate di quasi diciassettemila cifre. Gli atomi dell’universo sono un 1 seguito da ottanta zeri: se ogni atomo tenesse un registro da un miliardo di righe, l’elenco non sarebbe nemmeno cominciato.
Il guaio non finisce con la carta. Per scrivere il voto di una riga bisogna aver giocato quella schermata almeno una volta, e basta che la pallina si sposti di un quadretto perché la schermata sia un’altra, con la sua riga da riempire. Otto ore al giorno per cinquant’anni fanno scorrere una trentina di miliardi di schermate, che non scalfiscono nemmeno quell’elenco.
Il modo di dare i voti regge. A cedere è l’elenco, cioè l’idea di tenere una riga per ciascuna schermata.
Un fotogramma di gioco, ridotto come nell’esperimento originale a \(84\times84\) pixel in \(256\) livelli di grigio, può presentarsi in \(256^{7056}\) modi, il numero di quasi diciassettemila cifre già incontrato nella sezione sugli MDP. Lo stato che l’esperimento passava alla rete era però una pila di quattro fotogrammi consecutivi, perché da un’immagine ferma non si legge il movimento, e quindi
un numero di quasi sessantottomila cifre, contro i \(\sim 10^{80}\) atomi dell’universo osservabile. Una \(Q\)-table richiederebbe una cella per ciascuno stato \(s\) e azione \(a\): né la memoria né i dati per visitarli tutti esisteranno mai. Il problema è la rappresentazione e non l’algoritmo: enumerare gli stati non scala.
L’idea: una rete al posto della tabella#
Se il valore di ogni schermata non si può elencare, lo si calcola sul momento con una funzione che generalizza, cioè che risponde anche su un caso mai visto perché somiglia a casi già visti: schermate simili ricevono valori simili. Per le immagini la scelta naturale è una rete convoluzionale, il tipo di rete costruito apposta per guardarle, che riceve i pixel e restituisce il valore \(Q(s,a)\) di ciascuna azione (Fig. 14.1).

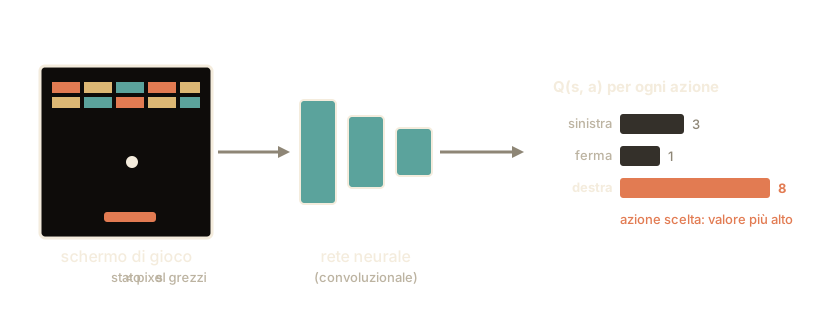
Fig. 14.1 Dal pixel alla decisione. La rete riceve lo schermo grezzo e restituisce, con un solo passaggio, il valore \(Q(s,a)\) di ciascuna azione \(a\) nella situazione \(s\), cioè quanto conviene farla lì; si sceglie l’azione di valore più alto.#
Invece dell’elenco con una riga per ogni immagine, addestriamo un «occhio esperto» che guarda lo schermo e, sul momento, dà un voto a ciascuna mossa possibile («vai a sinistra: 3», «resta fermo: 1», «vai a destra: 8»). Poi si sceglie la mossa col voto più alto. Il bello è che questo occhio, avendo visto tante partite, sa dare un voto sensato anche a una schermata mai vista prima, perché assomiglia ad altre che conosce. È la differenza fra imparare a memoria e capire.
Come impara a votare? Giocando, e correggendosi da solo. Dà un voto a una mossa, la fa, e guarda che cosa succede: i punti che arrivano subito, più il voto migliore che dà alla schermata che si trova davanti dopo. Quel secondo pezzo conta meno del primo, perché è roba che deve ancora arrivare; di quanto meno, lo si stabilisce una volta per tutte.
L’occhio aveva dato 8 a «vai a destra». Si fa la mossa: arriva 1 punto, e sulla schermata che compare, la mossa migliore prende 5. Contando quel 5 al novanta per cento, il voto giusto era 1 + 4,5 = 5,5, e l’8 era ottimista di due punti e mezzo. Quei due punti e mezzo sono l’errore, e l’occhio si corregge per ridurlo. Gli scarti grossi pesano più che in proporzione, perché contano per il loro quadrato, e quindi sono i primi a essere sistemati; oltre una certa misura, però, si contano soltanto in proporzione, così che un unico voto sballato non si trascini dietro tutto il resto. E l’occhio non si sposta per uno scarto isolato: si corregge sulla media di tante mosse giocate.
Il voto sulla schermata successiva, poi, non lo chiede a sé stesso di adesso: lo chiede a una sua copia di qualche tempo prima, messa da parte e lasciata com’era.
C’è anche una seconda strada, e il capitolo le percorre tutt’e due. Invece di dare un voto a ogni mossa e prendere il più alto, si allena direttamente la mano che sceglie, e la si sposta verso le mosse che nelle partite hanno reso di più.
Si parametrizza la funzione valore con una rete di pesi \(\theta\), scrivendo \(Q(s,a;\theta)\), e la si allena minimizzando lo scarto dal target di Bellman:
dove \(r\) è la ricompensa ottenuta, \(\gamma \in [0,1)\) il fattore di sconto, \(s'\) lo stato successivo e \(\theta^{-}\) i pesi di una copia «congelata» della rete. È l’algoritmo Deep Q-Network (DQN). Nell’implementazione di Mnih e colleghi lo scarto è tosato in \([-1,1]\) nel gradiente, cioè il quadrato diventa lineare oltre l’unità: è la perdita di Huber. In alternativa si può parametrizzare direttamente la policy \(\pi_\theta(a\mid s)\) e ottimizzarla per salita del gradiente sulla ricompensa attesa (policy gradient): due famiglie che il capitolo affronterà entrambe.
La svolta: da Atari a AlphaGo#

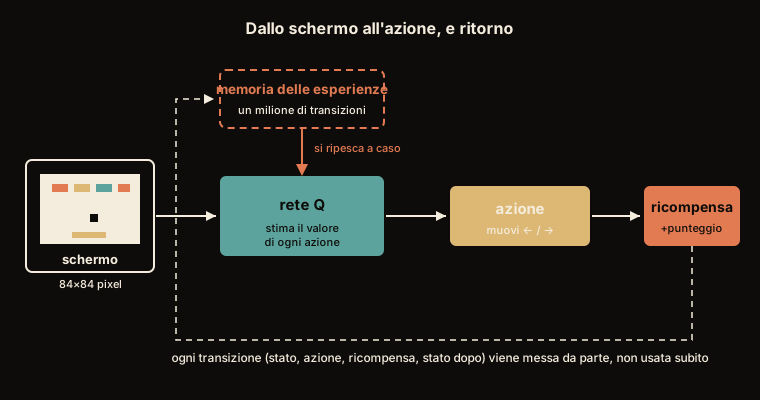
Fig. 14.2 Dai pixel all’azione, senza niente in mezzo. Alla rete non si dice cosa sia una navicella o un mattoncino: riceve lo schermo grezzo, come lo riceve una persona.#
Il blocco laterale di Fig. 14.2, la memoria delle esperienze (experience replay), è uno dei due accorgimenti che rendono stabile tutto il resto, e la sezione su DQN lo racconta per esteso. Addestrare sui fotogrammi nell’ordine in cui arrivano significa dare alla rete esempi consecutivi, e quindi quasi identici fra loro; ripescarli a caso dalla memoria li rimescola, e la rete torna a vedere situazioni diverse una dall’altra.
Quel primo lavoro, Playing Atari with Deep Reinforcement Learning (Mnih e colleghi, 2013), diventa nel 2015 un articolo su Nature, Human-level control through deep reinforcement learning: un’unica architettura, senza ritocchi specifici per gioco, regge il confronto con un collaudatore umano professionista su 49 titoli Atari, e in ventinove di essi raggiunge almeno il 75% del punteggio umano, con il solo schermo per guida e un punteggio avaro, che nei giochi Atari arriva ogni tanto e non spiega mai perché.
L’anno dopo arriva il colpo che raggiunge il grande pubblico. L’articolo su Nature del gennaio 2016 (Silver e colleghi) presenta AlphaGo e la vittoria per 5 a 0 sul campione europeo Fan Hui; due mesi più tardi, a Seul, una versione più forte dello stesso programma batte per 4 a 1 Lee Sedol, fra i più forti giocatori al mondo. Il Go, un gioco con più configurazioni che atomi nell’universo, era a lungo considerato fuori portata per le macchine. AlphaGo affianca alle reti una ricerca ad albero Monte Carlo, che prima di ogni mossa esplora le continuazioni più promettenti; la sezione su MCTS e AlphaGo la costruisce per intero. Il deep RL smette di essere una curiosità da laboratorio.
Il prezzo: un addestramento che balla, e milioni di partite#
L’entusiasmo non deve nascondere il conto da pagare. Il deep RL (abbreviazione di deep reinforcement learning, d’ora in avanti usata spesso) è notoriamente capriccioso.
Due difficoltà su tutte. La prima: l’allenamento è instabile. La rete si corregge inseguendo un numero che calcola lei stessa, e quel numero si sposta a ogni correzione: è come cercare di colpire la propria ombra, che si muove ogni volta che ti muovi tu. Basta poco (un ritocco alla velocità con cui la rete si corregge) e invece di assestarsi i suoi giudizi crescono senza fermarsi. È qui che servono i due accorgimenti incontrati poco fa, la memoria delle esperienze e la copia congelata della rete.
La seconda difficoltà: serve una quantità enorme di partite. L’agente impara per tentativi, e di tentativi ne vuole milioni: settimane di gioco. In un videogioco simulato va bene; con un robot vero che si può rompere, molto meno.
I campioni sono fortemente correlati (fotogrammi consecutivi) e il target \(r + \gamma \max_{a'} Q(s',a';\theta)\) si muove insieme ai pesi che stiamo aggiornando: la combinazione di approssimazione, bootstrapping e apprendimento off-policy è la celebre deadly triad che può causare divergenza. DQN la addomestica con due trucchi: l’experience replay (campionare a caso da un buffer di transizioni passate, decorrelandole) e la rete target \(\theta^{-}\) aggiornata di rado, che stabilizza il bersaglio. Resta il costo campionario: la versione di Nature usava \(50\) milioni di passi dell’agente per titolo, cioè \(200\) milioni di fotogrammi dell’emulatore (ogni azione è ripetuta per quattro), circa \(38\) giorni di gioco. La sample efficiency è tuttora un problema di ricerca aperto.
Una libertà in più, un contenimento in più#
Il percorso segue le domande, non gli acronimi: di ogni pezzo interessa perché esiste, cioè quale fragilità del pezzo precedente è venuto a curare. E la cura ha quasi sempre la stessa forma: si concede all’agente una libertà in più, e subito dopo bisogna inventarsi il modo di contenerla.
Si comincia dal DQN: la libertà è una rete al posto della tabella, e a contenerla sono i due accorgimenti che le impediscono di esplodere, la memoria delle esperienze e la copia congelata.
Poi si cambia famiglia. Invece di stimare il valore di ogni azione e prendere la migliore, si impara direttamente la policy, la regola che dice che cosa fare. Sono i metodi a gradiente di policy: alla policy, che qui si chiama attore, si affianca un critico che ne giudica le mosse una per una, e la famiglia arriva a PPO, l’algoritmo che oggi si prova per primo, studiato per tenere ogni aggiornamento vicino alla policy da cui è partito. Una policy appresa così è anche il consiglio che orienta la ricerca ad albero di AlphaGo; e dalla stessa famiglia viene la fase finale dell’addestramento degli assistenti conversazionali, quella che li porta verso le risposte che le persone preferiscono.
Quella famiglia serve subito. Nel controllo continuo (un braccio robotico, uno sterzo) le mosse sono una quantità da dosare e non un menu di poche voci, e la ricetta del DQN non si applica più.
Le sezioni che seguono attaccano tutte lo stesso problema, cioè che l’esperienza costa. Il RL basato su modello fa provare all’agente le mosse nella propria testa prima che nel mondo, e il prezzo è un simulatore di cui non fidarsi troppo. L’imitazione salta i tentativi ed errori: si guarda qualcuno che il compito lo sa già fare, e si scopre perché non basta. L’offline RL impara da un archivio di esperienze altrui senza mai agire, che è l’unica strada quando sbagliare è pericoloso, in terapia intensiva come al volante, e deve diffidare di tutto ciò che l’archivio non contiene. La gerarchia affianca alle mosse elementari le opzioni, pezzi di comportamento che si chiamano per nome e si riusano per obiettivi diversi: fanno risparmiare esperienza, ma un’opzione porta dove porta, e può scavalcare la scorciatoia che una mossa alla volta avrebbe trovato.
Si chiude sull’esplorazione: cosa fare quando la ricompensa arriva così di rado che non c’è nulla da inseguire, e cosa succede quando l’agente ottimizza troppo bene una ricompensa scritta male. Quest’ultima insidia, il reward hacking, è il ponte verso il problema dell’allineamento, nel capitolo sull’AI responsabile.