


Trovare gli iperparametri#
Nel dicembre 2017, dal palco di NIPS, la più importante conferenza mondiale di machine learning (oggi si chiama NeurIPS), Ali Rahimi ritirò un premio per un lavoro di dieci anni prima e ne approfittò per dire una cosa scomoda: «il machine learning è diventato alchimia».
Non ce l’aveva con i risultati, che ci sono: ce l’aveva con le fondamenta. Facciamo funzionare le cose, disse, senza sapere davvero perché funzionino, e portò tre esempi. Uno era un problemino minuscolo su cui la discesa del gradiente si pianta: non perché sia arrivata in fondo alla discesa, ma pur avendo ancora sotto i piedi un terreno in pendenza. Un altro era un ingrediente che a quel tempo tutti mettevano nelle reti (si chiama batch normalization, e la racconta la sezione su come far funzionare le reti profonde) di cui, a suo dire, «come disciplina non sappiamo quasi niente». Il terzo era la storia di un sistema che si era rotto senza che nessuno capisse perché: qualcuno aveva cambiato il modo di arrotondare i numeri dentro una libreria, e l’errore era passato da meno del 25% a quasi il 99%. La spiegazione, arrivata dopo, smentisce a metà l’aneddoto: quell’arrotondamento portava a uno un numero che doveva restare appena sotto, e da lì usciva una divisione per zero. Un difetto del programma, quindi, non del metodo.
Gli iperparametri, in quel discorso, non erano nominati nemmeno una volta. Ma se c’è un posto in cui l’alchimia si vede a occhio nudo sono loro: ricette tramandate di laboratorio in laboratorio, dosi aggiustate a occhio, risultati che arrivano senza che nessuno sappia spiegare fino in fondo perché.
Un iperparametro è una grandezza che si fissa prima di cominciare e che l’addestramento non modifica; nel gergo di laboratorio si chiamano anche manopole. Qualche esempio già incontrato: quanto è lungo il passo della discesa del gradiente (il learning rate \(\eta\), introdotto con la regressione lineare) e quanto è tirato il freno alla memorizzazione (la \(\lambda\), la lettera greca lambda, della regolarizzazione vista insieme all’overfitting). Qualche esempio che incontreremo: quante domande di fila può fare un albero di decisione, quanti strati ha una rete.
Non vanno confusi con i parametri, che sono i numeri interni aggiustati dall’addestramento. Gli iperparametri restano dove li abbiamo messi, e dalla loro scelta dipende molto la qualità del risultato. La sezione su overfitting e validazione ha già stabilito su quali dati giudicare questa scelta: il validation set, o meglio la cross-validation, mai il test. Resta da stabilire come esplorare lo spazio delle combinazioni: girare le manopole a mano finché «funziona» è l’alchimia di cui parlava Rahimi, mentre farlo per bene è un problema di ricerca (search) con algoritmi, costi e trappole propri.
Provarle tutte: la grid search#
L’idea più naturale è la forza bruta: per ogni iperparametro si sceglie una manciata di valori candidati e si prova ogni combinazione, tenendo quella con il punteggio di validazione migliore. È la grid search, la ricerca a griglia: esaustiva entro la griglia e facile da parallelizzare, perché ogni combinazione è indipendente dalle altre e si può valutare in parallelo su un altro calcolatore. Il difetto è il costo, che cresce esponenzialmente con il numero di iperparametri.
Chi regola una macchina del caffè professionale ha davanti quattro manopole (macinatura, temperatura, pressione, tempo di estrazione), ognuna con cinque livelli. Per assaggiare tutte le combinazioni servono \(5 \times 5 \times 5 \times 5 = 625\) caffè. E siccome un solo assaggio può ingannare (magari quella tazzina è venuta bene per caso, o è capitata a un cliente che il caffè lo prende amaro comunque), ogni regolazione va giudicata da cinque clienti diversi, uno per tavolo, e conta come è andata in media: è la cross-validation della sezione su overfitting e validazione, che a turno tiene da parte un blocco di dati diverso e giudica su quello. Quindi \(625 \times 5 = 3\,125\) caffè.
Se ogni «caffè» è un addestramento da due minuti, sono \(3\,125 \times 2 = 6\,250\) minuti, cioè quattro giorni e un terzo di macchina accesa. E se aggiungi una quinta manopola, sempre a cinque livelli, le combinazioni si moltiplicano ancora per cinque e i giorni diventano quasi ventidue. È l’esplosione combinatoria: ogni manopola in più moltiplica le prove, non le somma.
Anche i cinque livelli si scelgono uno per uno. Per il tempo di estrazione bastano passi uguali (venti, venticinque, trenta, trentacinque, quaranta secondi). Per la macinatura serve un altro passo, e si procede dimezzando, dalla grana del sale grosso a quella della farina: un millimetro, mezzo, un quarto, un ottavo, un sedicesimo. A passi uguali di un quarto di millimetro i livelli sarebbero invece uno, tre quarti, mezzo, un quarto e zero: quattro assaggi nella parte grossa, e fra il quarto di millimetro e la farina nemmeno uno.
Il conto si legge anche al contrario. Se il pomeriggio basta per venticinque combinazioni, e ognuna si porta dietro i suoi cinque assaggi, con due manopole restano cinque livelli per ciascuna, che è una prova seria; con quattro manopole restano poco più di due livelli a testa, cioè il minimo, il massimo e niente in mezzo. La griglia dà il meglio quando le manopole da girare sono una o due.
Con \(d\) iperparametri e \(n\) valori candidati ciascuno, la griglia è il prodotto cartesiano \(\Lambda = \Lambda_1 \times \dots \times \Lambda_d\) con \(|\Lambda| = n^d\) configurazioni; scriveremo \(\boldsymbol{\lambda} \in \Lambda\) per una singola configurazione, cioè l’intero vettore di iperparametri, di cui la forza di regolarizzazione \(\lambda\) è una componente. Con \(k\)-fold cross-validation il costo sale a \(k \cdot n^d\) addestramenti: esponenziale in \(d\). E a parità di budget la risoluzione per dimensione è misera, \(n = |\Lambda|^{1/d}\): con nove prove in due dimensioni si vedono appena tre valori per asse. La grid search resta ragionevole per \(d \le 2\), e ha il pregio che i punti, indipendenti tra loro, si valutano in parallelo; per i parametri di scala, come il learning rate e la forza di regolarizzazione, i candidati vanno disposti in progressione geometrica (\(10^{-4}, 10^{-3}, \dots\)).
Il caso batte la griglia: la random search#
La prima alternativa sembra una resa: invece di una griglia ordinata, estrarre le combinazioni a caso dentro gli stessi intervalli. Nel 2012 James Bergstra e Yoshua Bengio mostrarono che questa mossa apparentemente pigra trova modelli buoni quanto quelli della griglia, o migliori, in una frazione del tempo [BB12]. Il motivo sta in un fatto empirico: nei loro esperimenti, per la maggior parte dei dataset poche manopole contavano davvero, e non si sa in anticipo quali.
Fig. 4.18 mostra il caso più semplice, due sole manopole di cui una decisiva e l’altra ininfluente. Il quadrato è lo spazio delle prove possibili, una manopola per lato, e ogni pallino è una prova. La curva a campana disegnata sopra il quadrato dice come va il punteggio al variare della manopola che conta: più in alto, meglio è, e il colmo della campana è il valore che stiamo cercando.

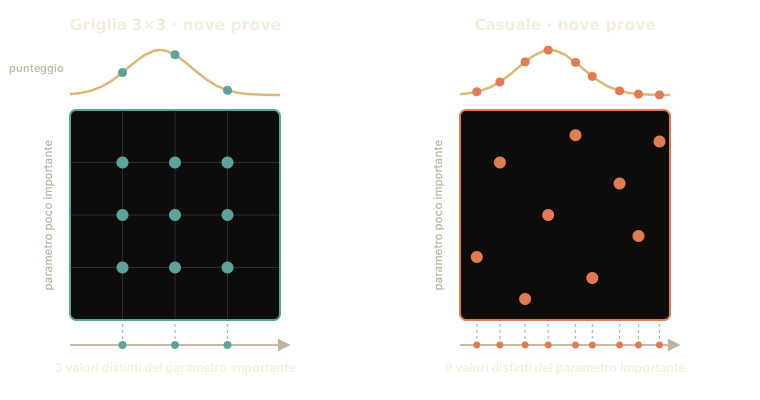
Fig. 4.18 Nove prove in griglia (a sinistra) si affacciano su appena tre valori della manopola che conta, perché tre a tre stanno in colonna. Nove prove casuali (a destra) ne toccano nove diversi, e una finisce a un passo dal colmo della campana.#
Su una vecchia radio la stazione si trova girando la sintonia; il volume, per trovarla, non conta nulla. Hai nove tentativi. Se li disponi in una griglia \(3 \times 3\), di frequenze ne provi tre soltanto: ogni colonna ripete la stessa sintonia a tre volumi diversi, e due tentativi su tre sono buttati. Nove tentativi a caso toccano nove frequenze tutte diverse, e non serve sapere in anticipo quale manopola conti, perché il sorteggio gira tutte le manopole insieme.
Con più tentativi il conto si fa esatto. Se la stazione si sente su un ventesimo della scala, un tentativo a caso la manca diciannove volte su venti; ma se i tentativi sono sessanta, la probabilità di mancarla tutte le volte scende sotto il cinque per cento, e novantacinque volte su cento almeno uno cade dentro. E il conto resta lo stesso con due manopole e con venti.
Tutto però dipende da quanto è larga la stazione. Se si sente su un centesimo di scala invece che su un ventesimo, gli stessi sessanta tentativi la trovano meno di una volta su due, e nessun sorteggio rimedia: il caso premia chi cerca qualcosa di abbastanza largo da essere incontrato per sbaglio.
Conta anche come si sorteggia. Con una manopola che lavora per divisioni, come la macinatura del caffè, si tira a sorte prima la fascia (i millesimi, i centesimi, i decimi) e poi il punto dentro la fascia. Sorteggiando alla cieca un numero fra un millesimo e uno, novantanove volte su cento esce qualcosa sopra il centesimo, e le grane fini non le prova nessuno.
L’argomento formale è la proiezione: se l’errore di validazione dipende in modo apprezzabile solo da un piccolo sottoinsieme delle \(d\) dimensioni (low effective dimensionality), una griglia di \(N\) punti ne proietta appena \(N^{1/d}\) distinti su ciascun asse, mentre \(N\) punti casuali ne proiettano \(N\) [BB12]. Indipendente dalla fonte, e vera in ogni dimensione, c’è poi una semplice contabilità del volume: se esiste una regione «buona» che copre il 5% del volume dello spazio di ricerca, la probabilità che \(N\) estrazioni indipendenti la manchino tutte è \((1-0{,}05)^N = 0{,}95^N\); quindi la probabilità di centrarla almeno una volta è il complementare, \(1 - 0{,}95^N\), che per \(N = 60\) vale \(0{,}954\): sessanta prove la centrano novantacinque volte su cento, in qualunque dimensione. Se la regione buona copre l’1% del volume, le stesse sessanta prove la centrano con probabilità \(1 - 0{,}99^{60} = 0{,}453\). (Vale se una tale regione esiste ed è così larga: è un’ipotesi sul problema, non una promessa.) In pratica contano anche le distribuzioni: per i parametri di scala si campiona in log-uniforme, cioè uniforme sull’esponente, così che il learning rate cada tra \(10^{-5}\) e \(10^{-4}\) con la stessa probabilità con cui cade tra \(10^{-2}\) e \(10^{-1}\).
Tornei a eliminazione: successive halving e Hyperband#
Griglia e ricerca casuale dedicano lo stesso budget a ogni candidato, anche a quelli che dopo poche epoche sono già chiaramente scadenti. I metodi multi-fidelity, a più livelli di fedeltà, ribaltano la logica: valutano tutti i candidati con un budget piccolo, per esempio poche epoche, e concedono un budget maggiore solo ai migliori; la valutazione breve è una versione poco fedele di quella completa, e la selezione ha la forma di un torneo a eliminazione diretta.
Il budget si misura in epoche, cioè in passate complete sull’insieme di addestramento (la sezione su overfitting e validazione le ha già incontrate): un addestramento serio ne fa decine o centinaia, e il costo di una ricerca è la somma delle epoche spese.
Contato in epoche, un torneo ha una proprietà che Fig. 4.19 mette in fila: il costo di un turno è lo stesso a ogni turno.
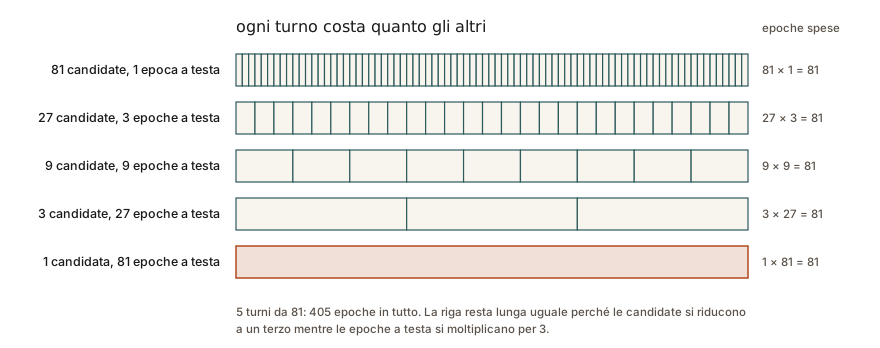
Fig. 4.19 Cinque turni, cinque righe lunghe uguali: le celle si allargano mentre diventano meno, e la lunghezza della riga, che è il costo del turno, non cambia mai. In tutto quattrocentocinque epoche.#
Un torneo di tennis non fa giocare cento partite a ogni iscritto: fa giocare a tutti una partita, e solo chi vince continua. Il successive halving fa lo stesso con le combinazioni di manopole: parti con 81 candidate e concedi a ciascuna una sola epoca di addestramento; le 27 migliori ne ricevono tre; le 9 migliori nove; le 3 migliori ventisette; la finalista arriva a 81. Il nome parla di dimezzare perché la prima versione a ogni turno ne buttava via la metà; quante ne passano è una manopola, e la scelta più comune è quella di qui, una su tre.
Il bello è che ogni turno costa quanto gli altri, perché a ogni giro i sopravvissuti si riducono a un terzo e le epoche a testa si triplicano: \(81 \times 1\), poi \(27 \times 3\), poi \(9 \times 9\), poi \(3 \times 27\), poi \(1 \times 81\). Fanno 81 epoche per turno, e i turni sono cinque: 405 epoche in tutto. Addestrare fino in fondo tutte e 81 le candidate ne costerebbe \(81 \times 81 = 6\,561\), sedici volte tanto.
C’è però un rischio, e nel torneo si vede bene: la giocatrice che ha bisogno di un set per scaldarsi perde il primo turno e torna a casa, anche se sulla distanza le avrebbe battute tutte. Le combinazioni di manopole si comportano allo stesso modo: certe partono piano e finirebbero forte, i «diesel», e un primo turno di una sola epoca le manda fuori proprio per questo. Hyperband copre il rischio organizzando più tornei con regole diverse: alcuni spietati (tantissimi iscritti, primo turno brevissimo), altri clementi (pochi iscritti, tanto tempo a testa fin dall’inizio). Quale sia il regolamento giusto non lo sa nessuno in anticipo. Provarli tutti costa qualche torneo invece di uno, e in cambio il vincitore è quasi quello che avrebbe dato il torneo giusto, scelto col senno di poi.
Il successive halving è di Karnin, Koren e Somekh (ICML 2013) [KKS13], che lo introdussero per il bandit stocastico a pura esplorazione; Jamieson e Talwalkar [JT16] lo portano agli iperparametri lasciandolo tale e quale, e ne riscrivono l’analisi per il caso non stocastico, dove i punteggi parziali non sono più estrazioni da una distribuzione. La forma con un fattore di eliminazione qualsiasi, invece della metà secca, è di Hyperband [LJD+18], ed è quella che si usa qui. Con fattore di eliminazione \(\eta\) (tipicamente 3; è la lettera dell’articolo di Hyperband, e qui non è il tasso di apprendimento): date \(n\) configurazioni con budget iniziale \(r\) ciascuna (epoche, o frazione del dataset), a ogni round tiene le migliori \(1/\eta\) e moltiplica per \(\eta\) il budget individuale. I round sono \(\lfloor \log_\eta n \rfloor + 1\) e ognuno costa circa \(n \cdot r\): per \(n=81\), \(r=1\), \(\eta=3\), 405 epoche-modello contro le \(81 \times 81 = 6\,561\) della valutazione completa. L’analisi inquadra il problema come best-arm identification in un bandit non stocastico (la famiglia di problemi della sezione sui banditi, dove ogni configurazione è una leva e addestrarla per un’epoca è un tiro): basta che le classifiche parziali siano abbastanza indicative di quelle finali. È proprio questa l’ipotesi fragile, perché una configurazione a convergenza lenta viene eliminata da giovane. Hyperband [LJD+18] aggira il dilemma tra molte configurazioni e molto budget per testa eseguendo \(s_{\max}+1\) istanze di successive halving (i bracket, \(s_{\max} = \lfloor \log_\eta R \rfloor\) con \(R\) budget massimo per configurazione), dalla più aggressiva (\(\sim \eta^{s_{\max}}\) configurazioni con budget iniziale \(R/\eta^{s_{\max}}\)) alla più conservativa, poche configurazioni a budget pieno; la garanzia teorica è restare entro fattori logaritmici dal bracket migliore col senno di poi.
L’early stopping (che vedremo all’opera nella pagina sull’addestramento in PyTorch) è il caso limite di questa idea: un torneo con un solo iscritto, che si ritira quando la validazione smette di migliorare.
C’è un dettaglio pratico che separa il torneo descritto qui da quello che gira davvero quando le prove sono distribuite su molte macchine.
Il successive halving appena descritto è sincrono: per decidere chi passa il turno aspetta che tutte le prove del turno siano finite. Su una macchina sola non cambia niente; su cento macchine, novantanove restano ferme ad aspettare la più lenta. La versione asincrona, ASHA [LJR+20], toglie la barriera cambiando il criterio di promozione: invece di chiedere «sei fra le migliori tre di nove?», a cui si può rispondere solo a turno completo, chiede «rispetto alle prove già finite, sei nel primo terzo?». Una prova che supera il controllo viene promossa subito, e la macchina che si libera prende il lavoro successivo. Il prezzo è che si decide con informazione incompleta e si può promuovere una prova che un confronto completo avrebbe scartato.
Cercare con giudizio: l’ottimizzazione bayesiana#
Griglia, caso e tornei condividono un ultimo difetto, il più profondo: ogni prova ignora ciò che le precedenti hanno scoperto. Se dieci esperimenti hanno già mostrato che con un passo troppo lungo l’errore, invece di scendere, schizza fuori controllo (si dice che il modello diverge: rimbalza da un fianco all’altro della valle e se ne allontana), l’undicesimo estratto a caso può cascarci di nuovo. L’ottimizzazione bayesiana [SLA12] tratta la ricerca degli iperparametri come un problema di apprendimento a sua volta: impara a prevedere quale punteggio darà una combinazione di manopole prima di provarla, e usa quella previsione per decidere dove provare. Si finisce così con due modelli in scena, uno dentro l’altro: quello che vogliamo addestrare, e questo secondo che studia il primo dall’esterno. Il nome «bayesiana», dal reverendo Thomas Bayes, viene dal modo in cui il secondo aggiorna le sue convinzioni ogni volta che arriva una prova nuova.
Tre pozzi scavati, e il quarto dove? Non a caso: ogni trivellazione costa cara, il geologo che cerca l’acqua può permettersene poche, e prima di scegliere disegna una mappa («qui l’acqua c’era a dieci metri, là il terreno era secco»), completa di zone d’ombra dove non sa ancora nulla. Il quarto pozzo lo piazza dove la promessa è massima: un po’ dove la mappa dice bene (sfruttare ciò che sa), un po’ dove la mappa è bianca (esplorare ciò che ignora). Cercare quel punto sulla carta costa qualche ora di matita, e la carta si fruga tutta prima di montare la sonda.
L’ottimizzazione bayesiana funziona così: dopo ogni addestramento aggiorna la sua mappa del punteggio e sceglie la combinazione successiva chiedendosi di quanto mi aspetto di battere il mio record, se provo qui? La domanda ha un nome, miglioramento atteso (expected improvement), ed è una domanda sola che tiene insieme le due esigenze. Un pozzo peggiore del migliore già scavato non conta come una perdita: nel conto vale zero, perché il record resta quello di prima. La risposta è alta dove la mappa promette bene, e anche dove la mappa è bianca, perché lì il record potrebbe essere battuto di parecchio. Ed è bassa, cioè quasi zero, dove il terreno è stato già scavato e si è rivelato secco: là non c’è più niente da sapere e niente da sperare, e il metodo smette di andarci senza che nessuno glielo debba dire.
La mappa però resta una scommessa, e sul campo si vede dove cede. Serve un pozzo alla volta, perché la carta si aggiorna solo quando l’acqua si vede, e mandare dieci squadre insieme vuol dire che nove scavano su una carta vecchia. E la mappa è disegnata credendo che il sottosuolo cambi con dolcezza, poco per volta da un punto al vicino. Se sotto c’è una faglia, a due passi dal pozzo buono il terreno è secco, e la carta continuerà a promettere acqua dove non ce n’è.
Due ingredienti. Il modello surrogato è una distribuzione di probabilità sulla funzione ignota \(f(\boldsymbol{\lambda})\) (l’errore di validazione della configurazione \(\boldsymbol{\lambda}\)) aggiornata dopo ogni osservazione; il surrogato standard è il processo gaussiano [RW06], che per ogni \(\boldsymbol{\lambda}\) fornisce una media \(\mu(\boldsymbol{\lambda})\) e una deviazione standard \(\sigma(\boldsymbol{\lambda})\): la stima e la sua incertezza. (La sezione sui processi gaussiani lo tratta per esteso.) La funzione di acquisizione traduce stima e incertezza in una decisione; la più usata è l’expected improvement:
dove \(f_{\min}\) è il miglior errore osservato finora e l’attesa è presa sulla distribuzione del surrogato. Con surrogato gaussiano l’attesa ha forma chiusa:
dove \(\gamma\) è il miglioramento rispetto al record, misurato in deviazioni standard del surrogato (niente a che vedere con il \(\gamma\) del kernel RBF della sezione sulle SVM: è la stessa lettera con un altro mestiere), e \(\Phi\) e \(\varphi\) sono la funzione di ripartizione e la densità della normale standard. La formula premia sia \(\mu(\boldsymbol{\lambda})\) basso (sfruttamento) sia \(\sigma(\boldsymbol{\lambda})\) alto (esplorazione); la prossima prova è \(\boldsymbol{\lambda}_{\text{next}} = \arg\max_{\boldsymbol{\lambda}} \mathrm{EI}(\boldsymbol{\lambda})\): un’ottimizzazione a sua volta, ma sul surrogato, che risponde in millisecondi. Il prezzo è la natura essenzialmente sequenziale del metodo (ogni scelta attende l’esito della precedente), la dipendenza dalle ipotesi del surrogato, a cominciare dalla scelta del kernel, e il costo del surrogato stesso: l’inferenza esatta di un processo gaussiano su \(n\) prove costa \(O(n^3)\), un costo trascurabile con qualche centinaio di prove ma proibitivo con decine di migliaia. Per questo il surrogato più diffuso in pratica è un altro, il Tree-structured Parzen Estimator (TPE) [BBBKegl11], campionatore di default di Optuna. Divide le prove in buone e cattive secondo un quantile del punteggio, stima la densità delle configurazioni in ciascun gruppo, \(p_{\text{buone}}(\boldsymbol{\lambda})\) e \(p_{\text{cattive}}(\boldsymbol{\lambda})\), e propone la configurazione che massimizza il loro rapporto; sotto quel modello è la stessa scelta che massimizza l’expected improvement, e si adatta con naturalezza a spazi misti di variabili continue, intere e categoriche, dove un kernel è scomodo.
Alla prova del codice#
scikit-learn offre le due strategie di base con la stessa forma d’uso:
GridSearchCV e RandomizedSearchCV racchiudono in un solo oggetto il giro
«prova una combinazione, valutala in cross-validation, tieni la migliore», e
lo ripetono da soli. Le proviamo
su un classificatore SVC, una support vector machine, che qui usiamo come
scatola nera: ci basta sapere che ha due manopole delicate, C e gamma. Sono
entrambe parametri di scala, il che significa che a contare è il loro
ordine di grandezza, non la differenza fra un valore e l’altro: fra \(0{,}001\) e
\(0{,}01\) c’è lo stesso salto che fra \(1\) e \(10\), mentre fra \(1\) e \(1{,}5\) non
c’è quasi niente. È per questo che i loro valori si provano moltiplicandoli per
dieci ogni volta invece che sommando una costante. (Il dataset è quello delle
cifre manoscritte incluso in scikit-learn.)
from scipy.stats import loguniform
from sklearn.datasets import load_digits
from sklearn.model_selection import (GridSearchCV, RandomizedSearchCV,
                                     train_test_split)
from sklearn.svm import SVC

X, y = load_digits(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42)   # il test resta nel cassetto

# Grid search: 4 x 4 = 16 combinazioni, x 5 blocchi di CV = 80 addestramenti
# (piu' il riaddestramento finale sul training intero, che sklearn fa da se')
griglia = {"C": [0.1, 1, 10, 100],
           "gamma": [1e-4, 1e-3, 1e-2, 1e-1]}
ricerca_griglia = GridSearchCV(SVC(), griglia, cv=5, n_jobs=-1)
ricerca_griglia.fit(X_train, y_train)
print(ricerca_griglia.best_params_, round(ricerca_griglia.best_score_, 3))

# Random search: 20 estrazioni log-uniformi (uniformi sull'esponente)
distribuzioni = {"C": loguniform(1e-2, 1e3),
                 "gamma": loguniform(1e-5, 1e0)}
ricerca_casuale = RandomizedSearchCV(SVC(), distribuzioni, n_iter=20,
                                     cv=5, random_state=42, n_jobs=-1)
ricerca_casuale.fit(X_train, y_train)
print(ricerca_casuale.best_params_, round(ricerca_casuale.best_score_, 3))

# quanto distano i due punteggi, contro quanto ballano fra un blocco e l'altro
for nome, ricerca in [("griglia", ricerca_griglia), ("caso", ricerca_casuale)]:
    i = ricerca.best_index_
    ballo = ricerca.cv_results_["std_test_score"][i]
    print(f"{nome}: {ricerca.best_score_:.4f} ± {ballo:.4f}")

# il test si apre una sola volta, alla fine
print(ricerca_casuale.score(X_test, y_test))
{'C': 10, 'gamma': 0.001} 0.99
{'C': np.float64(26.373339933815235), 'gamma': np.float64(0.0015876781526923994)} 0.989
griglia: 0.9896 ± 0.0038
caso: 0.9889 ± 0.0051
0.9888888888888889
Qui la griglia vince, ma di poco: \(0{,}9896\) con ottanta addestramenti contro \(0{,}9889\) con cento. Lo scarto fra i due punteggi è di sette decimillesimi, meno di quanto ciascuno dei due balli passando da un blocco di dati all’altro, ed è per questo che il blocco stampa anche quel ballo: senza, un pareggio si legge come una vittoria. Ed è il pareggio che ci si deve aspettare: il sorteggio guadagna dove le manopole sono tante e quasi tutte ininfluenti, e qui sono due, e contano tutte e due.
Il trucco di loguniform merita una riga, perché tornerà ogni volta che si
sceglie un learning rate: si sorteggia l’esponente, non il valore. Invece
di estrarre un numero a caso fra \(0{,}00001\) e \(1\), che nel \(99\%\) dei casi
darebbe qualcosa di grande, si estrae un numero a caso fra \(-5\) e \(0\), poniamo
\(-3{,}2\), e si usa \(10^{-3{,}2}\). Così ogni ordine di grandezza ha le stesse
probabilità degli altri.
scikit-learn implementa
anche il successive halving (HalvingGridSearchCV e HalvingRandomSearchCV,
ancora marcati come sperimentali); per l’ottimizzazione bayesiana e i tornei
in versione moderna la libreria di riferimento è Optuna, in cui lo spazio
di ricerca si descrive direttamente nel codice e le prove peggiori vengono
interrotte in corsa.
Una manopola alla volta: la curva di validazione#
Prima di cercare in più dimensioni conviene guardare una manopola sola. La curva di validazione riporta, al variare di un iperparametro e con tutto il resto fermo, il punteggio sugli esempi di addestramento e quello di validazione. È parente delle curve di apprendimento, che sull’asse orizzontale hanno invece il numero di esempi, e risponde a un’altra domanda: non se servono dati, ma dove mettere la manopola.
Si gira la manopola dal minimo al massimo, e a ogni posizione si segnano due voti: quello sugli esempi di studio e quello sugli esempi di prova (non quelli d’esame, che restano chiusi). Il disegno che esce dice da che parte si sbaglia. Dove i due voti sono bassi tutti e due, il modello è troppo rigido per il problema, e sbaglia anche dove ha studiato. Dove il voto di studio è pieno e quello di prova crolla, il modello sta imparando a memoria. In mezzo c’è la posizione giusta, quella con il voto di prova più alto, e la distanza fra i due voti dice quanto si è vicini al precipizio.
Il limite è nel «tutto il resto fermo». Le manopole non sono indipendenti: la posizione migliore di una dipende da dove stanno le altre, e girandole una alla volta si trova il meglio di una fetta, non del tutto. Per questo la curva serve a capire, e la ricerca a scegliere. E anche scegliere guardando il disegno è una piccola ricerca: il voto di prova della posizione scelta porta con sé la stessa fortuna della vincitrice di una ricerca, di cui si dice nelle avvertenze a fine sezione.
Per una coordinata \(\lambda_j\) della configurazione, con le altre fissate, la
curva di validazione riporta \(\hat{E}_{\text{train}}(\lambda_j)\) e
\(\hat{E}_{\text{val}}(\lambda_j)\), stimati in cross-validation; la curva di
apprendimento riporta invece gli stessi due errori in funzione della taglia \(m\)
del training, a configurazione fissata. Nella regione di bias alto i due errori
sono entrambi alti e vicini; in quella di varianza alta l’errore di
addestramento è piccolo e il divario grande; il minimo di \(\hat{E}_{\text{val}}\)
è il compromesso della curva a U, letto su un asse concreto. In scikit-learn la
calcola validation_curve, che di default riporta il punteggio del modello e
non l’errore: per un classificatore è l’accuratezza, cioè \(1 - \hat{E}\) con la
perdita 0-1, e il compromesso diventa un massimo. Due limiti: la curva è una
sezione dello spazio degli iperparametri, condizionata ai valori fissati degli
altri, quindi non vede le interazioni (il \(\gamma\) migliore di una SVM dipende
da \(C\)); e scegliere \(\lambda_j\) guardando la curva consuma la validazione come
qualunque ricerca, con l’ottimismo della vincitrice di una ricerca, che le
avvertenze a fine sezione misurano.
Il blocco fa girare il gamma della stessa SVM sulle cifre manoscritte, da
\(10^{-6}\) a \(10^{-1}\), con C fermo a \(10\), e stampa per ogni valore
l’accuratezza media sugli esempi di addestramento e su quelli di validazione
dei cinque blocchi.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import StratifiedKFold, validation_curve
from sklearn.svm import SVC

X, y = load_digits(return_X_y=True)
valori = np.logspace(-6, -1, 6)                 # una manopola sola: gamma, da 0,000001 a 0,1
blocchi = StratifiedKFold(5, shuffle=True, random_state=0)   # blocchi rimescolati, come nella ricerca
addestramento, validazione = validation_curve(SVC(C=10), X, y, param_name="gamma",
                                              param_range=valori, cv=blocchi)
for g, a, v in zip(valori, addestramento.mean(axis=1), validazione.mean(axis=1)):
    print(f"gamma {g:.0e}: addestramento {a:.3f}, validazione {v:.3f}")
gamma 1e-06: addestramento 0.914, validazione 0.908
gamma 1e-05: addestramento 0.979, validazione 0.969
gamma 1e-04: addestramento 0.997, validazione 0.986
gamma 1e-03: addestramento 1.000, validazione 0.988
gamma 1e-02: addestramento 1.000, validazione 0.840
gamma 1e-01: addestramento 1.000, validazione 0.106
Con gamma piccolo il modello è troppo liscio: \(0{,}914\) sugli esempi di
addestramento e \(0{,}908\) in validazione, vicini e bassi. Salendo, tutti e due
i voti crescono fino a \(10^{-3}\), dove la validazione tocca il massimo,
\(0{,}988\), con l’addestramento già al completo: è il valore che la griglia aveva
scelto, e il voto è in linea con il suo \(0{,}9896\). Oltre, l’addestramento resta
a \(1{,}000\) e la validazione crolla, a \(0{,}840\) e poi a \(0{,}106\), quasi il
caso su dieci cifre: ogni esempio di addestramento è diventato un’isola, e il
modello non riconosce più niente che non abbia già visto.
Tre avvertenze: costo, riproducibilità e ottimismo della scelta#
La prima è il costo. Se ogni combinazione si giudica in cross-validation su cinque blocchi, non costa un addestramento ma cinque, e quel fattore lo decide il modo di giudicare, non il modo di cercare: nessun algoritmo di ricerca lo toglie, e a toglierlo è semmai la scelta di giudicare su una validazione sola, che è quella con cui abbiamo contato le quattrocentocinque epoche del torneo. Griglia e caso hanno almeno il vantaggio di spalmarsi su tante macchine senza sforzo; l’ottimizzazione bayesiana no, perché è fatta per scegliere la prossima prova dopo aver visto l’esito della precedente. Esistono varianti che ne lanciano un gruppo alla volta (già Snoek e colleghi ne proponevano una [SLA12]), ma ogni prova, presa da sola, rende meno.
La seconda è la riproducibilità. Un computer non sa tirare a caso davvero:
produce numeri che sembrano casuali partendo da un numero iniziale, il
seme (in inglese seed, il random_state di scikit-learn). A parità di
seme, di versioni delle librerie e di macchina la sequenza di numeri «a caso» è
la stessa, e con essa il risultato; fra versioni o processori diversi le ultime
cifre possono cambiare, perché anche l’ordine delle somme in virgola mobile
dipende dall’hardware, e per questo si dichiarano anche le versioni. Con il seme
non fissato l’esito cambia a ogni esecuzione, e allora nessuno può ripetere il
tuo esperimento, nemmeno tu. Alla stessa famiglia appartiene un’altra
dimenticanza: dire «il metodo A batte il metodo B» senza dichiarare in quale
intervallo si è cercato e quante prove si sono fatte vale come aneddoto e non
come confronto, perché a parità di tempo il vincitore può capovolgersi.
La terza avvertenza riguarda l’ottimismo della scelta.
Se mille persone lanciano una moneta dieci volte, una decina di loro farà nove teste. Nessuna di quelle dieci ha un dono: sono le più fortunate di mille. Lo stesso vale per le configurazioni: il punteggio di validazione della vincitrice di una ricerca con centinaia di prove è in parte merito e in parte fortuna, e tende a essere troppo ottimista. Più a lungo cerchi, più il validation set si consuma: proprio come il test set che avevamo giurato di non sbirciare. Il rimedio è lo stesso di sempre: il numero da raccontare al mondo si misura una sola volta, alla fine, sul test rimasto intatto.
Due mosse aiutano. Una costa poco, ed è raccontare, accanto al punteggio della vincitrice, quanto quel punteggio cambia da un blocco all’altro dei cinque: un primo posto vinto per un soffio, con cinque numeri molto diversi fra loro, è un primo posto di rumore. L’altra costa di più, e serve quando il giudizio riguarda il modo di scegliere e non la singola configurazione: la ricerca si rifà da capo cinque volte, su cinque spezzoni diversi di dati, e ogni vincitrice viene misurata sullo spezzone che la sua ricerca non ha mai visto. E il conto si moltiplica: la ricerca intera, con tutte le sue combinazioni e i suoi cinque assaggi ciascuna, va rifatta dentro ognuno dei cinque giri esterni, e le \(3\,125\) tazzine della macchina del caffè diventano \(15\,625\). Sconti non ce ne sono.
Sia \(\hat{v}_i\) il punteggio di validazione della configurazione \(\boldsymbol{\lambda}_i\), e sia una stima corretta del punteggio vero \(v_i\): \(\mathbb{E}[\hat{v}_i] = v_i\). Siccome \(\max_i \hat{v}_i \ge \hat{v}_k\) per ogni \(k\), passando ai valori attesi
cioè il punteggio della vincitrice è ottimista in media anche se nessuna stima, presa da sola, lo è: selezionando la migliore si eredita anche il suo errore di stima favorevole. Aggiungere configurazioni non può abbassare il membro di sinistra, quindi a parità di vero massimo la distorsione non diminuisce con \(N\). In altre parole, una ricerca abbastanza lunga fa overfitting sul validation set [CT10]. L’ottimismo ha un ordine di grandezza: per la disuguaglianza dell’unione il limite superiore allo scarto cresce come \(\sqrt{\log N}\) nel numero \(N\) di configurazioni confrontate, come mostra la sezione sulla concentrazione. Le contromisure: riservare il test a un’unica valutazione finale; riportare media e deviazione standard sui fold, non il solo massimo; nei confronti metodologici, usare la nested cross-validation (un anello esterno per la stima onesta dell’errore, un anello interno per la selezione degli iperparametri) accettandone il costo, che è il prodotto dei due anelli.
L’ottimismo si misura facilmente dove si sa già la risposta, ed è la prova di Varma e Simon [VS06], in piccolo. Il blocco costruisce dieci archivi di puro rumore, in cui nessun modello può fare meglio del \(50\%\), e su ciascuno cerca trenta configurazioni della SVM; poi rifà la stessa ricerca dentro ognuno dei cinque blocchi di una cross-validation esterna, misurando ogni vincitrice sul blocco che la sua ricerca non ha visto.
import numpy as np
from scipy.stats import loguniform
from sklearn.model_selection import RandomizedSearchCV, cross_val_score
from sklearn.svm import SVC

vincitrici, annidate = [], []
for seme in range(10):                          # dieci archivi di rumore puro
    rng = np.random.default_rng(seme)
    X = rng.normal(size=(200, 20))
    y = rng.integers(0, 2, 200)                 # etichette a caso: il meglio possibile è 0,5
    ricerca = RandomizedSearchCV(SVC(), {"C": loguniform(1e-2, 1e3), "gamma": loguniform(1e-4, 1e1)},
                                 n_iter=30, cv=5, random_state=0)
    vincitrici.append(ricerca.fit(X, y).best_score_)             # il voto della vincitrice
    annidate.append(cross_val_score(ricerca, X, y, cv=5).mean())  # la ricerca rifatta dentro ogni blocco
print(f"voto della vincitrice, in media: {np.mean(vincitrici):.4f} (sempre sopra 0,5: {min(vincitrici) > 0.5})")
errore_standard = np.std(annidate, ddof=1) / np.sqrt(len(annidate))
print(f"stima annidata, in media: {np.mean(annidate):.4f} (errore standard {errore_standard:.3f})")
voto della vincitrice, in media: 0.5695 (sempre sopra 0,5: True)
stima annidata, in media: 0.5160 (errore standard 0.014)
Il voto della vincitrice supera il caso in tutti e dieci gli archivi, e in media dice \(0{,}5695\), quasi sette punti sopra quello che nessun modello può superare: è il premio della ricerca, non del modello. La stima annidata scende a \(0{,}5160\), con un errore standard di \(0{,}014\): poco più di un errore standard sopra il caso, cioè compatibile con il caso, e quello che resta è rumore di stima su archivi di duecento righe.
Le tre avvertenze hanno una morale sola: una ricerca degli iperparametri è essa stessa un addestramento, e come ogni addestramento può adattarsi ai dati che ha visto. Dichiarare spazio di ricerca, budget e semi, e tenere il test chiuso fino all’ultimo, ne fa una procedura il cui risultato altri possono ripetere e controllare: è la parte di metodo che all’alchimia di Rahimi mancava.
Da ricordare
Un iperparametro è una manopola che giriamo noi prima di cominciare e che l’addestramento non tocca. Si sceglie provando, e si giudica sui dati di prova, mai su quelli d’esame.
Provare tutte le combinazioni è la cosa più ovvia e la meno praticabile: la macchina del caffè con quattro manopole a cinque livelli chiede 3 125 assaggi. Ogni manopola in più moltiplica le prove.
Provarle a caso conviene quando poche manopole contano davvero, e nei confronti di riferimento era il caso più comune: se una sola manopola conta (la sintonia, non il volume), nove tentativi a caso provano nove sintonie diverse, mentre nove disposti in griglia ne provano tre.
I tornei a eliminazione danno a tutti un allenamento breve, poi solo ai migliori uno lungo: si spende dove serve. Il rischio è tagliare fuori i «diesel», quelli che partono piano e finirebbero forte.
Il metodo più furbo impara dalle prove già fatte, come il geologo che sceglie dove scavare il prossimo pozzo: un po’ dove la mappa promette bene, un po’ dove la mappa è ancora bianca.
Il punteggio del vincitore è troppo bello: fra mille che lanciano una moneta, qualcuno fa nove teste per fortuna. Il numero da raccontare al mondo si misura una volta sola, alla fine, sui dati d’esame rimasti intatti. Su dati di puro rumore la vincitrice di trenta prove sembra brava; rifacendo la ricerca dentro ogni blocco, il voto torna quello del caso.
Una manopola alla volta si guarda con la curva di validazione: dove i due voti sono bassi il modello è troppo rigido, dove quello di studio è pieno e quello di prova crolla impara a memoria, in mezzo c’è la posizione giusta.
Il seme fissa i numeri «a caso» e rende l’esperimento ripetibile: insieme alle versioni delle librerie, va dichiarato.
Da ricordare
Gli iperparametri non si imparano con il gradiente: si cercano, e si giudicano su validation o cross-validation, mai sul test.
La grid search è esaustiva ma esponenziale nel numero di iperparametri: ragionevole solo per una o due dimensioni.
La random search a parità di prove esplora più valori di ogni singola dimensione: vince quando pochi iperparametri contano davvero [BB12]. Parametri di scala in log-uniforme.
Successive halving e Hyperband sono tornei a eliminazione: poco budget a molti, molto budget a pochi [JT16, KKS13, LJD+18].
L’ottimizzazione bayesiana usa un surrogato (tipicamente un processo gaussiano) e una funzione di acquisizione per imparare dalle prove passate [SLA12].
Il punteggio del vincitore è ottimista in media anche quando ogni stima è corretta, \(\mathbb{E}[\max_i \hat{v}_i] \ge \max_i v_i\): numero finale solo dal test intatto, seed fissati, spazio e budget dichiarati. La nested CV misura la procedura di scelta: su rumore puro riporta il voto al caso.
Curva di validazione: \(\hat{E}_{\text{train}}\) e \(\hat{E}_{\text{val}}\) in funzione di un iperparametro a parità del resto (la curva di apprendimento li dà in funzione di \(m\)); è una sezione condizionata, cieca alle interazioni.