


Rappresentare il testo: dai token agli embedding#
Per un calcolatore un testo è già una sequenza di numeri, i punti di codice della cassetta degli attrezzi; ma con quei numeri non si fa aritmetica sensata, perché che il codice della g venga prima di quello della h non dice niente su gatto e gallo. Prima di costruire un traduttore automatico o un assistente conversazionale serve dunque una rappresentazione del testo: un modo di trasformare una frase come «Il gatto nero salta sul muro» in numeri che una rete neurale possa sommare, moltiplicare e confrontare, e su cui quei conti abbiano un senso. Gran parte della storia del NLP è la ricerca di rappresentazioni sempre più ricche, e il percorso va dalla più semplice, le parole contate una per una, fino agli embedding.
Spezzare il testo: la tokenizzazione#
Il primo passo è sempre lo stesso: tagliare il flusso di caratteri in unità discrete, cioè in pezzi separati che si possono contare, i token. Come si scelga il taglio è il tema di Come si spezza il testo; qui basta sapere che dopo il taglio si potranno assegnare numeri ai pezzi.
Tokenizzare vuol dire affettare la frase. La ricetta più intuitiva è
«spezza a ogni spazio»: «Il gatto nero salta sul muro» diventa la lista
["Il", "gatto", "nero", "salta", "sul", "muro"]. Sei parole, sei token.
L’elenco di tutti i pezzi che il sistema conosce si chiama vocabolario: è la scatola dei mattoncini disponibili, e niente che non ci sia dentro può essere rappresentato.
Riempire la scatola di parole intere non funziona. Le parole di una lingua non finiscono mai: la scatola diventa enorme e resta comunque incompleta, e la prima parola che manca lascia il sistema muto.
I posti nella scatola si contano allora in partenza, qualche decina di migliaia,
e si riempiono così. All’inizio ci si mette una lettera per posto: con le sole
lettere si scrive qualunque parola, anche se ci vogliono molti pezzi. Poi si
guarda un mucchio di testo e si cerca la coppia di pezzi vicini che ricorre più
spesso. Se i e z capitano attaccati un’infinità di volte, tanto vale
incollarli e tenere iz come pezzo unico: costa un posto solo e ne fa
risparmiare uno in ogni parola che lo contiene. La mossa si ripete finché i
posti finiscono. (Su quale coppia incollare i sistemi si dividono: c’è chi
prende la più frequente e chi quella che rende il testo più facile da indovinare
pezzo per pezzo.)
Alla fine nella scatola convivono pezzi di ogni taglia. Le parole comunissime, il e sul, ci stanno per intero; tokenizzazione è rara e non ci sta, quindi si scrive con qualche pezzo più corto, visto tante volte altrove. E una parola mai incontrata, un cognome o una sigla, si scrive lo stesso, al peggio lettera per lettera, purché quelle lettere fossero nel testo da cui la scatola è stata riempita. Condizione che pare scontata, finché non arriva un alfabeto che in quel testo non compariva, il greco o il coreano: al posto della parola finisce un segnaposto che non vuol dire niente. Come ci si è liberati anche di questo limite, scendendo sotto la lettera, lo racconta la sezione sui byte.
Formalmente definiamo un vocabolario \(V\), l’insieme dei token noti. La tokenizzazione è una funzione che mappa una stringa nella sequenza dei suoi token \(\in V\). La segmentazione a spazi bianchi soffre di due problemi: un vocabolario enorme e le parole fuori dizionario (out-of-vocabulary).
I sistemi moderni usano perciò tokenizzatori sottoparola (subword). Il Byte Pair Encoding porta il nome che gli diede Philip Gage [Gag94] e la forma con cui Sennrich e colleghi lo portarono sul testo [SHB16]: parte dai singoli caratteri e fonde iterativamente la coppia di simboli più frequente; WordPiece [SN12] adotta una strategia analoga, ma sceglie la coppia che fa crescere di più la verosimiglianza del corpus, e nella ricostruzione più diffusa questo diventa un criterio che premia le coppie sorprendenti invece di quelle semplicemente frequenti. In entrambi i casi il processo si arresta quando il vocabolario raggiunge una taglia fissata (da circa \(30\,000\) token in BERT a qualche centinaio di migliaia nei modelli recenti e multilingue). Ogni stringa fatta di simboli visti in addestramento resta rappresentabile, anche se la stringa intera è nuova; la copertura diventa totale solo scendendo al singolo byte.
Ogni parola un interruttore: il one-hot encoding#
Abbiamo i token, e adesso bisogna dar loro dei numeri. L’idea più diretta è numerarli in fila: gatto è 1, cane è 2, mercoledì è 3. Occupa pochissimo spazio e non funziona, e la Fig. 15.3 mostra perché su un esempio più semplice del testo: tre città.

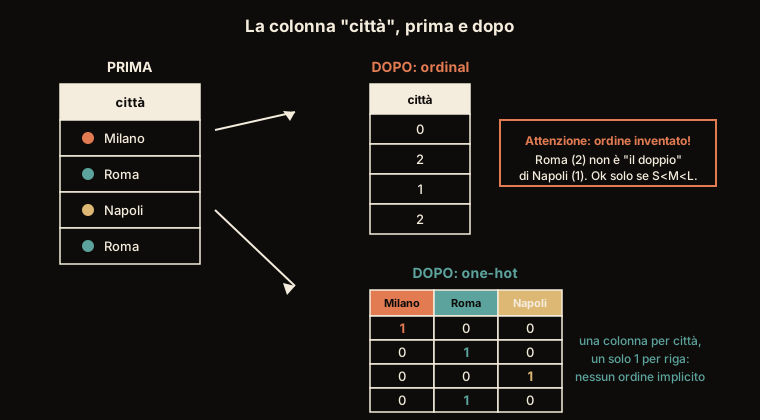
Fig. 15.3 Due codifiche, due significati impliciti. Numerare in fila (è la codifica che si chiama ordinal) dice che Milano viene prima di Napoli e che Roma dista da Milano il doppio di Napoli: cose che nessuno intendeva dire. Una casella per città, tutte a zero tranne una, non dice niente di tutto questo, ed è il suo pregio.#
Lo stesso vale per le parole. Con gatto = 1 e mercoledì = 3, un modello che tratta l’indice come una quantità (un modello lineare, una rete neurale) ne ricava un ordine e delle distanze che il vocabolario non ha: mercoledì risulterebbe «il triplo» di gatto. La codifica one-hot, «uno solo acceso», evita il problema assegnando a ogni parola un vettore con una componente per ogni voce del vocabolario, uguale a 1 nella posizione della parola e a 0 altrove. Costa una componente per voce, cioè decine di migliaia di numeri per scrivere una parola sola, ma non introduce relazioni che non esistono.
Una lunghissima pulsantiera, con un interruttore per ogni parola del vocabolario. Per rappresentare gatto accendi il suo interruttore e lasci spenti tutti gli altri.
Scrivi ora \(1\) per «acceso» e \(0\) per «spento», e leggi la pulsantiera da
sinistra a destra: quello che ottieni è una lunga fila di numeri,
0 0 1 0 0 ... 0. Una fila di numeri presa nel suo ordine si chiama
vettore, e dentro quella parola non c’è niente di più misterioso di così.
Quello di gatto è lungo quanto il vocabolario ed è tutto zeri tranne un
singolo \(1\).
Funziona, ma è uno spreco e, soprattutto, è cieco al significato. Per questa codifica gatto e felino sono lontani esattamente quanto gatto e mercoledì: ogni parola è un’isola, nessuna somiglianza è possibile.
La \(i\)-esima parola diventa il vettore della base canonica \(\mathbf{e}_i \in \mathbb{R}^{|V|}\): tutte componenti nulle tranne un \(1\) in posizione \(i\). Due parole distinte \(i \neq j\) danno vettori ortogonali,
cioè prodotto scalare nullo e distanza identica per qualsiasi coppia. La geometria non porta alcuna informazione semantica. In più, con un vocabolario di parole intere, \(|V|\) è dell’ordine di \(10^5\)–\(10^6\) (con le sottoparole scende a qualche decina di migliaia): i vettori sono enormi e sparsissimi.
Contare le parole: bag-of-words e TF-IDF#
Per rappresentare un documento intero, e non una parola sola, si conta quante volte compare ciascuna parola del vocabolario e si trascura l’ordine in cui comparivano. Il risultato si chiama sacchetto di parole (bag-of-words): un vettore di conteggi, con una componente per ogni voce del vocabolario, che del testo conserva quali parole c’erano e quante volte, e nient’altro.

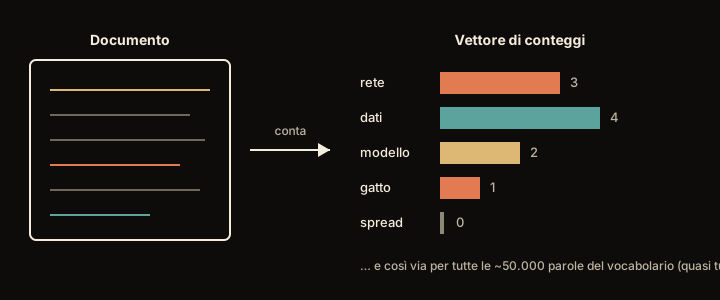
Fig. 15.4 Il documento diventa un vettore di conteggi. Il testo di partenza non si può più ricostruire: dell’ordine delle parole non resta traccia, e «il cane morde l’uomo» dà lo stesso vettore di «l’uomo morde il cane».#
L’esempio in coda a Fig. 15.4 è la misura esatta di cosa si butta via. Per molti compiti non è grave (per capire se una recensione è positiva, le parole contano più del loro ordine) ma è bene sapere che la perdita c’è, ed è definitiva: nessun programma messo dopo questo passaggio potrà recuperare l’ordine, perché a quel punto non è più scritto da nessuna parte.
È la pulsantiera di prima, con gli interruttori sostituiti da contatori: non più «c’è / non c’è», ma «c’è, e tante volte». Resta sparsa, che è il modo tecnico di dire che quasi tutte le caselle stanno a zero: un documento usa qualche centinaio di parole diverse, e le caselle disponibili sono decine di migliaia.
C’è però un problema: articoli e preposizioni come il o di compaiono ovunque, e proprio per questo dicono poco su cosa parla il testo. Parole rare come retina o sinapsi sono molto più rivelatrici.
Il peso TF-IDF corregge lo squilibrio moltiplicando fra loro due numeri, che sono poi le due metà della sigla. La frequenza nel documento (term frequency) è quante volte la parola compare nel testo che stiamo rappresentando: più ci compare, più conta. La rarità nella raccolta (inverse document frequency, la frequenza documentale rovesciata) guarda in quanti documenti la parola compare, e premia quelle che ne occupano pochi.
La rarità si calcola così: si divide il numero totale di documenti per il numero di quelli in cui la parola compare, e del risultato si prende il logaritmo naturale, che è solo un modo di schiacciare i numeri grandi perché non prendano il sopravvento. Su una raccolta di mille documenti: il compare in tutti e mille, mille diviso mille fa 1, e il logaritmo di 1 è zero. La rarità di il vale zero, e zero per qualunque cosa fa zero: il sparisce, che è esattamente quello che volevamo. Sinapsi compare in due documenti, mille diviso due fa cinquecento, e il logaritmo di cinquecento è circa 6,2. Sopravvive, e pesa.
Il prodotto dei due numeri gonfia dunque le parole rare e informative e sgonfia quelle comuni a tutti: stessa pulsantiera, contatori pesati meglio. Una cosa però non cambia: le caselle restano mute fra loro, come gli interruttori di prima. Un testo che parla di gatti e uno che parla di felini non hanno una sola casella in comune, e per il conteggio non si somigliano per niente.
Il bag-of-words rappresenta un documento \(d\) con il vettore dei conteggi \(\in \mathbb{R}^{|V|}\). Il peso TF-IDF (Term Frequency-Inverse Document Frequency) di un termine \(t\) è
dove \(\text{tf}(t,d)\) è la frequenza di \(t\) in \(d\), \(N\) il numero totale di documenti, \(\text{df}(t)\) il numero di documenti che contengono \(t\) (la misura è di Spärck Jones [SparckJ72]), e il logaritmo è quello naturale (la base cambia solo un fattore di scala comune a tutti i termini). Il fattore logaritmico penalizza i termini onnipresenti (df alto) fino ad azzerare chi compare ovunque: se \(\text{df}(t) = N\) allora \(\log(N/N) = 0\). Questa è la forma da manuale, e le librerie ne calcolano varianti lisciate; come peso dei termini, il prodotto \(\text{tf}\cdot\text{idf}\) si afferma con i sistemi di recupero di Salton [SB88]. Nei motori di ricerca la variante usata oggi è BM25, che limita il contributo di una parola ripetuta molte volte e normalizza per la lunghezza del documento (Cercare per rispondere: retrieval e RAG). Restano due limiti strutturali: i vettori sono ancora sparsi e \(|V|\)-dimensionali, e nessuna relazione lega parole diverse tra loro.
Con scikit-learn, la cassetta degli attrezzi che in Python raccoglie i metodi
classici di machine learning, tutto questo è una manciata di righe. La riga che
conta è fit_transform: legge i due testi, si costruisce da sé l’elenco delle
parole che ci trova (il vocabolario) e restituisce una tabella con una riga per
documento e una colonna per parola.
from sklearn.feature_extraction.text import TfidfVectorizer

corpus = ["il gatto nero salta sul muro",
          "il cane dorme sul divano"]

vec = TfidfVectorizer()
X = vec.fit_transform(corpus)   # matrice sparsa documenti x vocabolario
print(vec.get_feature_names_out())  # il vocabolario appreso
print(X.toarray().round(3))         # pesi TF-IDF per ciascun documento
['cane' 'divano' 'dorme' 'gatto' 'il' 'muro' 'nero' 'salta' 'sul']
[[0.    0.    0.    0.447 0.318 0.447 0.447 0.447 0.318]
 [0.499 0.499 0.499 0.    0.355 0.    0.    0.    0.355]]
I numeri che ne escono non sono però quelli del TF-IDF «da manuale»: la libreria ne usa una variante, per ragioni pratiche. Il verso resta quello, le parole rare pesano più di quelle comuni; i numeri no, e su una raccolta piccola la differenza si vede.
La variante serve a due cose. La prima è non trovarsi mai a dividere per zero, cosa che capiterebbe con una parola presente nel vocabolario ma in nessun testo: la libreria fa finta di avere un documento in più, che contiene tutte le parole, e così il conto della rarità si fa sempre. Poi, a quel conto, aggiunge sempre \(1\). La seconda è mettere sulla stessa scala documenti di lunghezza diversa, così che un testo lungo non risulti più «pesante» solo perché contiene più parole; a conti fatti ogni documento viene riportato alla stessa misura complessiva, e a contare sono le proporzioni fra le sue parole, non quante ne ha.
C’è un effetto collaterale, ed è meglio conoscerlo perché altrimenti i numeri a schermo sorprendono. Lo produce quell’\(1\) aggiunto alla rarità: con la ricetta da manuale una parola presente in tutti i documenti prendeva zero e spariva, con la variante della libreria le resta addosso un peso, e su una raccolta piccola quel peso è tutt’altro che poco. Nel primo dei due testi dell’esempio il esce con \(0{,}318\) e gatto con \(0{,}447\): l’articolo che sta in tutti e due i testi pesa circa sette decimi della parola che compare in uno solo. La distanza fra i due si allarga man mano che la raccolta cresce, perché la parola che sta dappertutto resta ferma dov’è mentre quella rara sale.
scikit-learn non applica alla lettera la formula da manuale. Con i parametri
predefiniti di TfidfVectorizer (smooth_idf=True, norm="l2",
sublinear_tf=False) il peso di \(t\) in \(d\) è
\(\text{tf}(t,d)\cdot\bigl(\ln\frac{1+N}{1+\text{df}(t)} + 1\bigr)\), con
\(\text{tf}\) il conteggio grezzo, e il vettore di ogni documento viene poi
diviso per la sua norma \(L^2\). Con sublinear_tf=True il conteggio diventa
\(1 + \ln \text{tf}\), che smorza le parole ripetute molte volte nello stesso
documento. Prima di tutto questo c’è la tokenizzazione, che per default
(lowercase=True e token_pattern=r"(?u)\b\w\w+\b") scarta ogni token di un
solo carattere: in italiano spariscono e, è, a, o e l’articolo eliso di
l’uomo, e in «non è affatto male» sparisce proprio il verbo. Il «\(+1\)» finale
ha una conseguenza da tenere a mente: un termine presente in tutti i documenti
non si annulla, come vorrebbe \(\log(N/\text{df})\), ma conserva idf pari a \(1\).
Nel corpus giocattolo dell’esempio (\(N = 2\)) non è affatto un residuo
trascurabile: nel primo documento il esce con peso \(0{,}318\) contro lo
\(0{,}447\) di gatto, cioè circa il 71% del peso di un termine che compare in
un solo documento. Il divario si apre solo al crescere del corpus, perché l’idf
del termine onnipresente resta fisso a \(1\) mentre quello del termine raro
cresce come \(\ln\frac{1+N}{2} + 1\).
Vettori densi: i word embedding#
Contare lascia un difetto che nessuna taratura corregge: un testo sui gatti e uno sui felini non hanno una sola casella in comune. Serve una rappresentazione in cui parole di significato vicino abbiano numeri vicini, e la si ottiene con vettori densi, cioè corti (qualche centinaio di numeri) e senza zeri, invece che lunghi quanto il vocabolario e quasi tutti a zero. I primi vettori di questo tipo sono del 1990: l’analisi semantica latente [DDF+90] li ricavava comprimendo la tabella che conta quante volte ogni parola compare in ogni documento (latente perché le dimensioni che ne escono non sono parole, ma combinazioni nascoste nei conteggi). Nel 2003 il modello di linguaggio neurale di Bengio e colleghi [BDVJ03] li imparava mentre scommetteva sulla parola successiva, e il salto che li ha resi comuni arriva nel 2013. L’idea guida è più vecchia ancora, e il linguista John Firth nel 1957 la riassunse così: «You shall know a word by the company it keeps» [Fir57], conoscerai una parola dalla compagnia che frequenta. Parole che appaiono in contesti simili hanno significati simili. Se lo facciamo dire ai numeri, otteniamo i word embedding: la parola inglese vuol dire «immersione», e l’immagine è quella di ogni parola calata dentro uno spazio, in un punto suo.
Come si fa in pratica lo mostra la Fig. 15.5. Si prende una finestra, cioè un ritaglio di poche parole che scorre lungo il testo, e a ogni posizione si guarda la parola al centro e quelle che le stanno intorno. La coppia «parola centrale, sue vicine» è un esempio; il programma ne raccoglie miliardi e aggiusta i numeri di ogni parola finché quelle che capitano in mezzo alle stesse compagnie si ritrovano vicine.

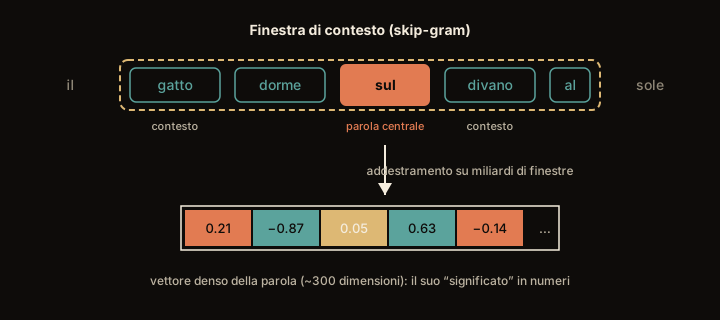
Fig. 15.5 La frase di Firth resa procedura. Nessuno dice al modello cosa significhi una parola: gli si fa vedere in quali compagnie compare, milioni di volte, e il vettore è il riassunto di quelle compagnie.#
Quella procedura non usa dizionari né spiegazioni scritte da qualcuno: le basta testo grezzo, che esiste in quantità enormi, ed è la ragione del suo successo. Un archivio di testi corredati a mano da esperti di etichette linguistiche (in gergo, annotato) costa invece mesi di lavoro, ed è sempre piccolo. L’insieme dei testi su cui un programma si addestra si chiama corpus (al plurale, alla latina, corpora).
Invece di migliaia di zeri con un solo uno, ogni parola diventa una corta lista di poche centinaia di numeri, tutti «pieni». Questi numeri non li scegliamo a mano: li impara un modello leggendo montagne di testo e notando quali parole si accompagnano.
Il risultato è una mappa del significato. Su questa mappa gatto e felino finiscono vicini, gatto e cane poco più lontani, gatto e mercoledì lontani, in direzioni che non hanno niente da spartire. La vicinanza geometrica diventa vicinanza di senso. Ogni parola, però, ha un punto solo: pesca il frutto e pesca lo sport finiscono nello stesso punto, a metà strada fra la frutta e il mare, e separare i due sensi sarà il mestiere di modelli che leggono anche la frase intorno.
Quella vicinanza ha un modo standard di misurarsi, ed è quello già visto con
le frecce dell’algebra lineare, dove il
conto è svolto per esteso su due numeri soli. Una fila come (3, 4) è anche
un punto su un foglio a quadretti, tre caselle a destra e quattro in su, e
quindi una freccia che ci arriva: è per questo che di due parole si dice che
«puntano» da qualche parte. La similarità del coseno guarda da che parte
puntano le due frecce e ignora quanto sono lunghe. È un numero fra \(-1\) e
\(+1\): vale \(+1\) quando puntano dalla stessa parte, \(0\) quando non hanno niente
da spartire. Un «coseno \(0{,}88\)» si legge «si somigliano molto», un «coseno
\(-0{,}26\)» «non c’entrano niente l’uno con l’altra». Fra due parole il \(-1\)
non si vede quasi mai: i valori negativi che si incontrano davvero sono
piccoli, e vogliono dire «estranei», non «contrari».
I due programmi che hanno reso comuni questi vettori portano nomi che si incontrano ovunque. word2vec, del 2013, è quello che lavora con la finestra scorrevole. Chiedergli a ogni finestra «quale delle centomila parole del vocabolario stava lì accanto?» costerebbe però una fortuna, e allora gli si chiede molto meno: accanto alla vicina vera si pescano a caso cinque o dieci parole qualsiasi dal testo, e il modello deve solo separare quella che c’era davvero dalle intruse. Una domanda piccola, ripetuta miliardi di volte.
GloVe, del 2014, arriva allo stesso risultato per un’altra strada. Prima conta, una volta per tutte, quante volte ogni parola compare vicino a ogni altra: una tabella enorme, con gatto e miagola vicini spesso e gatto e trattore quasi mai. Poi cerca per ogni parola una lista di numeri tale che, prese due parole, le loro due liste combinate ridiano quanto spesso le due stanno vicine. Non tutte le caselle della tabella contano allo stesso modo. Quelle a zero, coppie mai viste, non insegnano niente, e GloVe le salta invece di prenderle per una somiglianza mancata. Quelle enormi, le coppie con parole come di, che stanno vicino a tutto, varrebbero da sole più di tutte le altre: per questo il peso di una casella cresce con il suo conteggio solo fino a un tetto, cento incontri nel lavoro originale, e da lì resta fermo.
Un embedding è una funzione che associa a ogni token un vettore denso \(\mathbf{v} \in \mathbb{R}^{d}\) con \(d\) piccolo (tipicamente \(100\)–\(300\)), appreso dai dati. Quelli di word2vec, GloVe e fastText sono statici: un solo vettore per ogni tipo di parola, che mescola quindi i sensi di una parola polisemica (pesca il frutto e pesca lo sport); gli embedding contestuali ne danno uno diverso a ogni occorrenza, calcolato dalla frase che la contiene [DCLT19, PNI+18]. word2vec [MCCD13] addestra una rete poco profonda a predire il contesto data la parola (skip-gram) o viceversa (CBOW). Nello skip-gram l’obiettivo è massimizzare, su ogni coppia parola-vicina \((w, c)\) del corpus, la probabilità \(p(c \mid w) = \exp(\mathbf{u}_c^\top \mathbf{v}_w) / \sum_{c' \in V} \exp(\mathbf{u}_{c'}^\top \mathbf{v}_w)\), dove \(\mathbf{v}\) e \(\mathbf{u}\) sono i vettori della parola come centro e come contesto. Quella softmax corre però su tutto il vocabolario, e in pratica la si sostituisce con il negative sampling [MSC+13]: per ogni coppia vera si pescano \(k\) parole (da 5 a 20 sui corpora piccoli, da 2 a 5 su quelli grandi) da una distribuzione sulle frequenze, e non uniforme: Mikolov e colleghi trovano che l’unigramma elevato a \(3/4\) batte nettamente sia l’uniforme sia l’unigramma puro. Si addestra poi un classificatore binario a distinguere la vicina vera dalle intruse, massimizzando
con \(\sigma\) la sigmoide e \(c_1, \dots, c_k\) le intruse pescate. Due accorgimenti completano la ricetta. Le parole frequentissime si scartano a caso prima di formare le coppie, ciascuna occorrenza di \(w\) con probabilità \(\max\bigl(0,\, 1 - \sqrt{t/\hat{p}(w)}\bigr)\), dove \(\hat{p}(w)\) è la frequenza relativa di \(w\) e \(t \approx 10^{-5}\) una soglia (sotto la soglia non si scarta niente). Il codice di riferimento usa una forma un po’ diversa: tiene l’occorrenza con probabilità \(\min\bigl(1,\, \sqrt{t/\hat{p}(w)} + t/\hat{p}(w)\bigr)\), e la soglia predefinita è \(t = 10^{-3}\), per cui chi riproduce i vettori dal codice non ritrova esattamente le condizioni dell’articolo. La finestra, poi, ha una larghezza sorteggiata a ogni posizione, così che i vicini stretti contino più dei lontani. Che cosa calcoli davvero questo obiettivo lo hanno mostrato Levy e Goldberg [LG14]: se \(d\) è abbastanza grande da lasciare liberi tutti i prodotti scalari, e il rumore segue l’unigramma dei contesti, l’ottimo soddisfa
con \(\operatorname{pmi}\) l’informazione mutua puntuale di Teoria dell’informazione, qui in logaritmo naturale e calcolata sulle coppie parola-contesto del corpus. Lo skip-gram con negative sampling fattorizza dunque una matrice di PMI traslata di \(\log k\). Con \(d\) piccolo la fattorizzazione è approssimata e pesata dalle frequenze delle coppie, ed è lì che si separa da una SVD della stessa matrice. GloVe [PSM14] fattorizza invece la matrice globale di co-occorrenza \(\mathbf{X}\), minimizzando
dove \(X_{ij}\) conta quante volte la parola \(j\) compare nella finestra della parola \(i\), con ogni co-occorrenza pesata \(1/\delta\) e \(\delta\) la distanza fra le due. La somma corre sulle sole coppie con \(X_{ij} > 0\), e la pesatura è
con \(x_{\max} = 100\) e \(\alpha = 3/4\) nel lavoro originale. Le coppie mai viste restano così fuori (\(f(0)=0\) rende coerente l’esclusione del \(\log 0\)), e quelle frequentissime non dominano il conto. Il bersaglio \(\log X_{ij}\) viene da una richiesta sui rapporti: se \(\mathbf{v}_i^\top\tilde{\mathbf{v}}_j\) riproduce \(\log P(j \mid i)\) a meno dei bias, le differenze fra vettori catturano i rapporti \(P(m \mid i)/P(m \mid j)\) per ogni terza parola \(m\), che sono ciò che distingue due parole. Come embedding finale si usa la somma \(\mathbf{v}_i + \tilde{\mathbf{v}}_i\) delle due copie. Da \(\mathbb{R}^{|V|}\) sparso si passa a \(\mathbb{R}^{d}\) denso: meno dimensioni, ma cariche di struttura semantica.
Il compito su cui word2vec si addestra non l’ha preparato nessuno: la parola al centro e le sue vicine stavano già nel testo, ed è bastato separarle per farne una domanda e una risposta. Un compito costruito così si chiama auto-supervisionato (self-supervised): le etichette si ricavano dai dati stessi, senza annotazione. Sulle immagini l’ha già fatto Imparare senza etichette, coprendo un pezzo di foto e chiedendo di ricostruirlo, e lo racconta per esteso il capitolo sull’auto-supervisione.
Sotto la parola: fastText#
word2vec e GloVe hanno però un punto cieco: assegnano un vettore a ogni parola intera. Ne seguono due guai.
Il primo: se una parola nel corpus di addestramento non compare mai, per lei non c’è nessun vettore, e il programma resta muto. Il secondo riguarda le lingue come la nostra, in cui quasi ogni parola cambia forma secondo il genere, il numero, la persona o il tempo. Gatto, gatta, gatti, gattino sono quattro parole distinte da imparare quattro volte, e ciascuna singolarmente più rara dell’inglese cat, che sta al posto di tutte. fastText [BGJM17] risolve i due guai con una mossa sola: scendere sotto il livello della parola.
La mossa è scomporre ogni parola in mattoncini di poche lettere che si
sovrappongono. Prendiamo gatto e scriviamoci accanto due segnacci, uno
all’inizio e uno alla fine, per ricordarci dove la parola comincia e dove
finisce: <gatto>. Ora la si affetta a gruppi di tre caratteri, spostandosi di
uno per volta: <ga, gat, att, tto, to>. (Tre non è sacro: nella
pratica si tengono insieme le fette da tre fino a sei lettere, così da prendere
sia le sillabe sia le desinenze intere.)
Ogni mattoncino ha il proprio vettore, e il vettore di gatto è semplicemente
la somma dei vettori dei suoi mattoncini. Sommare due liste di numeri vuol
dire sommarle casella per casella: (3, 4) più (1, 2) fa (4, 6), e basta.
Fra i mattoncini di gatto c’è anche <gatto> per intero, che è un pezzo come
gli altri e per una parola comune è il più informativo di tutti.
I vantaggi sono due, e concreti. Primo: gatto, gatta e gattino
condividono i pezzi gat e att, quindi i loro vettori nascono già simili
(prezioso in una lingua di desinenze come la nostra). Secondo: di una parola mai
vista prima manca il mattoncino della parola intera, che nessuno ha avuto
occasione di imparare, ma le fette da tre, quattro, cinque lettere ci sono
tutte, e sommando quelle un vettore esce lo stesso. Nessuna parola resta più
senza rappresentazione.
I mattoncini aiutano dove il significato si legge nei pezzi, come nelle
desinenze. Dove non si legge, possono anche confondere: cane e canestro
condividono <ca e can, e i loro significati non c’entrano niente l’uno con
l’altro. Sulle domande di
significato puro, quelle che non dipendono dalla forma delle parole, fastText
non fa meglio dei vettori a parola intera, e a volte fa peggio.
fastText estende lo skip-gram di word2vec rappresentando ogni parola \(w\)
con l’insieme \(\mathcal{G}_w\) dei suoi n-grammi di caratteri (tipicamente
\(3 \le n \le 6\), con i delimitatori < e > a marcare i confini), più la
parola stessa. Per \(n = 3\), gatto produce <ga, gat, att, tto,
to>. Il vettore della parola è la somma dei vettori dei suoi n-grammi:
dove \(\mathbf{z}_g \in \mathbb{R}^{d}\) è il vettore appreso per l’n-gramma \(g\). Per contenere la memoria gli n-grammi non hanno ciascuno una riga propria: una funzione di hash (FNV-1a) li manda in \(K = 2\cdot 10^{6}\) righe, e n-grammi diversi che cadono nella stessa riga condividono il vettore. Due conseguenze pratiche: le parole out-of-vocabulary restano rappresentabili sommando i soli n-grammi, che hanno un vettore anche quando non si sono mai visti; e nelle lingue morfologicamente ricche le forme flesse di una stessa radice condividono parametri. Il guadagno però non è uniforme. Bojanowski e colleghi [BGJM17] lo misurano sulla similarità di parole e sulle analogie sintattiche, più marcato su lingue molto flessive come ceco e tedesco; sulle analogie semantiche il metodo non aiuta, e per tedesco e italiano peggiora, un effetto che gli autori legano alla lunghezza degli n-grammi scelti.
L’aritmetica del significato: re − uomo + donna ≈ regina#
Negli embedding densi alcune relazioni di significato prendono la forma di direzioni quasi costanti dello spazio, e si possono comporre sommando e sottraendo vettori, come frecce.

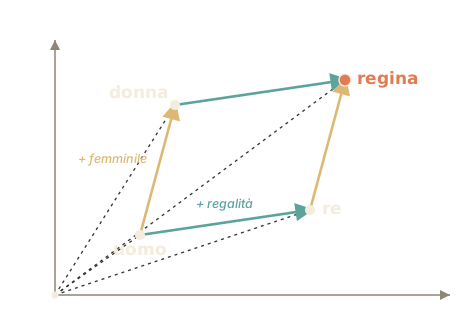
Fig. 15.6 I quattro embedding formano un parallelogramma: la stessa freccia «regalità» separa uomo da re e donna da regina; la stessa freccia «femminile» separa uomo da donna e re da regina. Il disegno è idealizzato: nello spazio vero le due frecce non sono identiche e il parallelogramma si chiude solo per approssimazione.#
Guarda la Fig. 15.6. La freccia che va da uomo a re significa più o meno «diventare regale». Se prendi quella stessa freccia e la applichi a donna, dove atterri? Molto vicino a regina.
Quella freccia si scrive con una sottrazione, ed è l’unico passaggio da
digerire. Provalo su due numeri soli, che si disegnano sul quaderno. Se uomo
sta in (1, 1) e re sta in (3, 4), la freccia che porta da uomo a re è
«due a destra e tre in su»: e infatti (3, 4) meno (1, 1), fatto casella per
casella, dà (2, 3). La regola sta tutta qui: si sottrae il punto di partenza
dal punto di arrivo, e quel che resta è la freccia che va dall’uno all’altro.
Applicarla a donna vuol dire sommargliela: se donna sta in (1, 5), atterro
in (3, 8), e se lì vicino c’è regina il gioco è fatto. In formula:
re − uomo + donna ≈ regina. I quattro punti disegnano un parallelogramma, e
questo è il segno che il modello ha catturato da solo il concetto di «regalità»
e quello di «genere», senza che nessuno glieli abbia mai spiegati.
C’è un’avvertenza che quasi nessuno racconta, e che invece è la parte più istruttiva. Se il conto lo si fa davvero, e poi si cerca la parola più vicina al punto di arrivo, la vincitrice non è regina: è re. Il perché si vede rileggendo la stessa somma dall’altro verso. Partire da donna e aggiungere la freccia che va da uomo a re porta nello stesso punto in cui si arriva partendo da re e aggiungendo la freccia che va da uomo a donna, quella del genere. E la freccia del genere è una spintarella, debole rispetto alla distanza che separa una parola dall’altra: sposta re quel tanto che basta a portare regina al secondo posto, non abbastanza da farle superare re. Tutti i programmi che fanno queste analogie tolgono dalla gara le tre parole della domanda, e solo così la risposta che esce è quella famosa. L’analogia geometrica esiste davvero, insomma, ma è più tenue di come la si disegna, e il parallelogramma della figura è un’idealizzazione.
E le frecce portano con sé anche quello che non vorremmo. I numeri vengono da testi scritti da persone, e le associazioni che stavano in quei testi ci finiscono dentro tali e quali. Fatta la stessa domanda con medico al posto di re, la risposta che esce per donna è infermiera. Il conto non ha sbagliato niente: ha restituito quello che nei testi c’era. Vale però anche qui la regola di poco fa, e va tenuta presente prima di prendere il risultato per una misura del pregiudizio: la risposta esce così perché medico è stato tolto dalla gara, e senza quella regola la parola più vicina tornerebbe a essere medico.
L’osservazione, resa celebre da Mikolov, Yih e Zweig [MYZ13], è che le analogie sono approssimativamente lineari nello spazio degli embedding:
Operativamente si calcola il vettore a sinistra e si cerca la parola il cui embedding gli è più vicino, misurando la prossimità con la similarità del coseno già incontrata in Algebra lineare, che per gli embedding \(\mathbf{v}_i\) e \(\mathbf{v}_j\) di due parole è il coseno dell’angolo fra i due vettori:
La ricerca però si fa escludendo dai candidati le tre parole della domanda,
una scelta che il lavoro di word2vec dichiara fra parentesi
[MSC+13], e quel vincolo pesa: senza di esso il primo
vicino è quasi sempre re stesso. Lo si vede su GloVe da \(100\) dimensioni
addestrato su 6 miliardi di token, nei vettori distribuiti come
glove-wiki-gigaword-100, sommati e sottratti come sono, senza normalizzarli
prima:
# pt-lento: 128 MB di vettori da scaricare la prima volta, e la libreria
# gensim, che va installata a parte
import numpy as np
import gensim.downloader as api

kv = api.load("glove-wiki-gigaword-100")    # 400 000 parole, 100 dimensioni

def coseno(a, b):
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b)))

for a, b, c, candidati in [("man", "king", "woman", ("king", "queen")),
                           ("man", "doctor", "woman", ("doctor", "nurse")),
                           ("good", "better", "bad", ("bad", "worse"))]:
    v = kv[b] - kv[a] + kv[c]               # b - a + c, senza normalizzare
    primo = kv.similar_by_vector(v, topn=1)[0][0]   # nessuna esclusione
    coseni = ", ".join(f"{w} {coseno(v, kv[w]):.3f}" for w in candidati)
    print(f"{a}:{b} = {c}:?  {coseni}  (primo vicino: {primo})")
man:king = woman:?  king 0.855, queen 0.783  (primo vicino: king)
man:doctor = woman:?  doctor 0.866, nurse 0.776  (primo vicino: doctor)
good:better = bad:?  bad 0.886, worse 0.839  (primo vicino: bad)
Il coseno con king vale \(0{,}855\) contro lo \(0{,}783\) di queen, e lo stesso succede con doctor e nurse e con bad e worse: in tutti e tre i casi il primo vicino è la parola da cui si è partiti. L’enunciato onesto non è dunque l’\(\approx\) della formula, ma
La lettura corretta è che l’analogia lineare è una direzione debole sovrapposta a una posizione forte: la geometria sposta il punto abbastanza da mettere regina al secondo posto, non abbastanza da farle superare re. Chi ha discusso a fondo la questione è Nissim, van Noord e van der Goot [NvNvdG20], che mostrano quanto di ciò che si legge sulle analogie, comprese quelle usate come prova di bias, dipenda da quella scelta di implementazione, mai scritta nelle equazioni.
Anche al netto dell’esclusione molte analogie falliscono, e i vettori ereditano le associazioni dei testi su cui sono addestrati, fra cui quelle di genere con certi mestieri. Quelle associazioni si misurano meglio con test diretti, come il WEAT di Caliskan, Bryson e Narayanan [CBN17], che confronta quanto due gruppi di parole bersaglio (nomi maschili e femminili, per esempio) stanno vicini a due gruppi di attributi (parole della carriera e della famiglia). Quello che resta è più modesto della formula celebre: la somiglianza dei contesti d’uso si lascia misurare con un prodotto scalare.
Dalla parola alla frase: gli embedding di frase#
Gli embedding visti finora danno un vettore per parola, ma molti compiti riguardano testi interi: trovare i documenti che rispondono a una domanda, accorgersi che due segnalazioni arrivate allo sportello sono lo stesso reclamo, raggruppare le recensioni per tema, pescare da un archivio i tre paragrafi giusti da mettere sotto gli occhi di un chatbot prima che risponda. Serve un vettore per frase, e ottenerlo non è altrettanto ovvio.
C’è anche una ragione di costo, e pesa sulla scelta dell’architettura. Un modello che legge le due frasi attaccate, come un testo solo (un cross-encoder), dà il giudizio migliore, ma vale per quella coppia sola: su diecimila frasi le coppie sono quasi cinquanta milioni (\(10\,000 \times 9\,999\) diviso \(2\)), e gli autori di Sentence-BERT [RG19] le stimano in circa 65 ore su una GPU V100. Calcolare invece un vettore per frase, una volta sola, costa circa cinque secondi per tutte le diecimila, e i cinquanta milioni di confronti fra vettori già pronti un centesimo di secondo: è la differenza fra un’idea e un prodotto.
Diecimila moduli di reclamo in uno scatolone, e bisogna trovare i due che dicono la stessa cosa.
L’impiegata riassume ogni modulo con una lista di numeri e confronta i riassunti. La media dei numeri già pronti di ogni parola, come primo tentativo, regge sorprendentemente bene, e si rompe in due punti. Mescolate, le parole perdono l’ordine, e «il cane morde l’uomo» e «l’uomo morde il cane» diventano lo stesso riassunto. E le parole piccole pesano quanto le altre, così fra «il film mi è piaciuto» e «il film non mi è piaciuto» il «non» annega.
Si fa aiutare da un lettore che l’ordine lo tiene, uno di quelli che il capitolo sui Transformer racconterà per esteso. Si chiama BERT, è del 2018, e si è allenato su tre miliardi di parole, fra libri e Wikipedia, con due esercizi: indovinare le parole che gli avevano cancellato, e dire se due frasi stessero davvero una dopo l’altra. Quell’allenamento si riusa per compiti diversissimi senza rifare tutto. Ma nessuno gli ha mai chiesto quanto due moduli vogliano dire la stessa cosa, e infatti lo giudica male: quello che si vuole da uno spazio bisogna insegnarglielo.
La somiglianza gliela insegna tre moduli per volta: uno di riferimento, l’ancora, uno che dice la stessa cosa, uno che parla d’altro. Chiede solo che l’ancora finisca più vicina al modulo che dice la stessa cosa che a quello che parla d’altro, e non di un soffio, ma di uno scarto minimo deciso in partenza, il margine; dove vadano i tre non lo dice. Le terne che rispettano già il margine non hanno più niente da insegnare, e le mette da parte. Su milioni di terne lo spazio si riordina da sé, e «vicino» diventa «stesso argomento».
Il lettore dev’essere lo stesso per tutti e tre i moduli, e la rete si dice siamese per questo: tre riassuntori diversi darebbero numeri non confrontabili. E le terne non si preparano una per una. Sul tavolo vanno mille coppie «reclamo e suo gemello», e per ognuna i moduli delle altre novecentonovantanove fanno da lontani: quasi mille, senza cercarne uno.
Quello che l’impiegata ha insegnato, però, è «questi due si somigliano», non «questo risponde a quello». «Chi ha scritto la Divina Commedia?» e «Dante Alighieri la compose fra il 1304 e il 1321» non hanno una parola in comune. Allo sportello delle domande servono allora due lettori distinti, uno per le domande e uno per i testi, allenati insieme perché una domanda e la sua risposta finiscano vicine. Cambia il compito, cambiano gli esempi, cambia lo spazio.
La media dei vettori di parola è una baseline seria (con pesatura inversa alla frequenza regge il confronto con molti metodi neurali [ALM17]), ma è invariante alla permutazione, quindi cieca alla sintassi, e diluisce le parole di funzione che ne rovesciano il senso.
Con un encoder contestuale il problema si sposta ma non sparisce. Prendere il
vettore del token [CLS] di un BERT pre-addestrato, o la media dei suoi token,
dà rappresentazioni peggiori della media di GloVe su compiti di similarità
semantica: [CLS] è ottimizzato per il next sentence prediction e per
essere rifinito, non per vivere in uno spazio metrico. La lezione è generale:
la geometria di uno spazio latente riflette l’obiettivo con cui è stato
addestrato, e la similarità del coseno non è una proprietà che si ottiene
per caso.
Sentence-BERT [RG19] risolve il problema con una
struttura siamese: lo stesso encoder \(f_\theta\) (pesi condivisi, non due
reti gemelle) applicato a ciascun ingresso, un pooling sui token (la media
funziona meglio del token riassuntivo [CLS], quello che BERT antepone alla
frase per tenerci il riassunto) e un obiettivo di messa a punto che rende i
due vettori confrontabili con il coseno. Il lavoro ne propone tre, e quale si
usi dipende da come sono annotati i dati: una classificazione a tre vie dove le
coppie portano un’etichetta, una regressione sul coseno dove l’annotazione è un
punteggio di somiglianza, la terna con il margine dove ci sono le terne. Il
modello distribuito nasce dalla prima.
Le funzioni obiettivo di questa famiglia, il metric learning, si distinguono per che cosa confrontano: una coppia di frasi, una terna, oppure un’ancora contro tutto il batch.
La contrastive loss [HCL06] lavora su coppie di frasi, con embedding \(\mathbf{s}_1\) e \(\mathbf{s}_2\) e un’etichetta \(y\) che vale \(1\) se le due frasi sono simili e \(0\) se non lo sono:
dove \(\mathrm{dist}(\cdot,\cdot)\) è la distanza euclidea fra due embedding e \(m > 0\) un margine. Avvicina le coppie simili e allontana le dissimili fino al margine; oltre il margine smette di spingere, altrimenti spenderebbe capacità a separare cose già separate. (Nel lavoro originale la convenzione su \(y\) è rovesciata, e ciascuno dei due termini ha un fattore \(\tfrac{1}{2}\).)
La triplet loss lavora su terne \((\mathbf{a}, \mathbf{p}, \mathbf{n})\), gli embedding di ancora, positivo e negativo, e chiede una disuguaglianza relativa:
dove \(\mathrm{dist}\) è di nuovo una distanza fra embedding (l’euclidea, o \(1-\cos\)) e \(m > 0\) il margine: cioè «il positivo deve stare più vicino del negativo, e di almeno \(m\)». È più robusta della contrastive perché non impone distanze assolute, che sarebbero arbitrarie, ma solo un ordinamento.
La multiple negatives ranking loss (o InfoNCE, la stessa forma già incontrata per SimCLR in Imparare senza etichette, e che tornerà per CLIP in Allineare due spazi) usa come negativi tutti gli altri elementi del batch:
dove \(\mathbf{a}\) è l’ancora e \(\mathbf{p}\) il suo positivo, \(\mathbf{p}_1, \dots, \mathbf{p}_B\) sono i positivi di tutti gli esempi del batch di taglia \(B\) (il proprio, che sta anche al numeratore, più i \(B-1\) altrui, che fanno da negativi), \(\mathrm{sim}\) è la similarità del coseno di poco sopra e \(\tau > 0\) è la temperatura, che decide quanto il denominatore sia dominato dai candidati più vicini. È una cross-entropia su un problema a \(B\) vie in cui la classe giusta è «il proprio positivo». Minimizzarla ha anche un significato preciso: van den Oord, Li e Vinyals [vdOLV18] mostrano che la sua media sul batch, \(\mathcal{L}\), limita dal basso l’informazione mutua fra ancora e positivo, \(I(\mathbf{a}; \mathbf{p}) \ge \log B - \mathcal{L}\), e il tetto \(\log B\) sale con il batch.
È oggi la scelta prevalente, perché un batch da 1024 fornisce 1023 negativi gratis a ogni esempio, ed è precisamente la ricetta degli in-batch negatives che Retrieval e RAG, nel capitolo sui Transformer, attribuisce a DPR [KOuguzM+20].
Due aspetti pratici decidono se il metodo funziona. Il primo è la scelta dei negativi: quelli presi a caso diventano presto banali (due testi su argomenti scorrelati si separano senza sforzo, e la loss va a zero senza insegnare altro), per cui si passa ai hard negatives, testi simili all’ancora ma non positivi, di solito estratti con un modello precedente. Il secondo è che la loss può azzerarsi anche con una soluzione degenere: la rete può mandare tutte le frasi di un argomento nello stesso punto, e perdere ogni distinzione fine fra frasi dello stesso argomento. Temperatura, margine e regolarizzazione controllano quanto la soluzione si avvicini a quell’estremo.
Un’ultima nota riguarda il retrieval: la similarità del coseno misura «si somigliano», non «questo risponde a quella». Una domanda e la sua risposta spesso non si somigliano affatto, e infatti il retrieval addestra due reti separate, un encoder \(E_q\) per le domande e uno \(E_p\) per i passaggi, che si incontrano solo alla fine, nel prodotto scalare. Ciascuna delle due si chiama una torre. I positivi diventano coppie domanda-passaggio e non coppie di parafrasi. Cambia il compito, cambiano i positivi, cambia lo spazio.
Che l’addestramento riorganizzi lo spazio si può guardare da vicino con un piccolo esperimento, senza scaricare nessuno dei modelli veri, che pesano gigabyte. Fabbrichiamo centoventotto finte frasi, divise in quattro argomenti da trentadue, e diamo a ciascuna una lista di sessantaquattro numeri, in due versioni. Nella prima i numeri sono tirati a caso e basta, e le frasi di uno stesso argomento non hanno niente in comune. Nella seconda ogni argomento ha una direzione sua, che le sue frasi portano con sé debolmente, sotto un rumore più forte: è la situazione di un encoder a cui la somiglianza non è mai stata insegnata, in cui l’argomento c’è ma la geometria quasi non lo mostra. Otto frasi per argomento restano fuori dall’addestramento e servono a misurare. Poi si applica la regola delle terne (ancora, simile, diverso, e l’ordine da rispettare), pescandole soltanto fra le frasi viste, e si guarda che cosa succede.
import torch
import torch.nn as nn
import torch.nn.functional as F

# Quattro argomenti, trentadue "frasi" ciascuno, sessantaquattro numeri a
# frase. Otto frasi per argomento restano fuori dall'addestramento: servono
# a misurare se quello che la rete impara vale anche per frasi mai viste.
N_ARG, PER_ARG, D = 4, 32, 64
argomento = torch.arange(N_ARG).repeat_interleave(PER_ARG)
tenute = torch.cat([torch.nonzero(argomento == k).flatten()[:8]
                    for k in range(N_ARG)])
viste = torch.tensor([i for i in range(len(argomento))
                      if i not in tenute.tolist()])
indici = [viste[argomento[viste] == k] for k in range(N_ARG)]
MARGINE = 0.3

def coseni(V, quali):
    """Coseno medio dentro l'argomento e fra argomenti diversi."""
    V = F.normalize(V[quali], dim=-1)
    S = V @ V.T
    stesso = argomento[quali][:, None] == argomento[quali][None, :]
    diverso = ~stesso
    stesso.fill_diagonal_(False)
    return S[stesso].mean().item(), S[diverso].mean().item()

def sorteggia(n):
    """Una terna per riga, solo fra le frasi viste."""
    a = viste[torch.randint(0, len(viste), (n,))]
    ka = argomento[a]
    kn = (ka + torch.randint(1, N_ARG, (n,))) % N_ARG    # argomento diverso
    pesca = lambda k: indici[k][torch.randint(0, len(indici[k]), (1,))][0]
    return (a, torch.stack([pesca(k) for k in ka]),
            torch.stack([pesca(k) for k in kn]))

def esperimento(segnale):
    torch.manual_seed(0)
    # Ogni frase porta la direzione del suo argomento, moltiplicata per
    # `segnale`, sotto un rumore più forte. Con segnale 0 è puro caso.
    direzioni = torch.randn(N_ARG, D)
    grezzi = segnale * direzioni[argomento] + torch.randn(N_ARG * PER_ARG, D)
    # La "torre": UNA sola rete, applicata a tutti e tre gli ingressi.
    # I pesi condivisi sono ciò che rende la rete siamese.
    torre = nn.Sequential(nn.Linear(D, 2 * D), nn.ReLU(), nn.Linear(2 * D, D))
    ott = torch.optim.Adam(torre.parameters(), lr=1e-2)
    for _ in range(400):
        a, p, neg = sorteggia(128)
        A, P, N = (F.normalize(torre(grezzi[i]), dim=-1) for i in (a, p, neg))
        # l'ancora deve stare più vicina al positivo che al negativo, e non
        # di poco: almeno di un margine. Chi già rispetta il margine non conta.
        perdita = F.relu(MARGINE - (A * P).sum(-1) + (A * N).sum(-1)).mean()
        ott.zero_grad(); perdita.backward(); ott.step()
    with torch.no_grad():
        dopo = torre(grezzi)
    return [("prima (tenute)", coseni(grezzi, tenute)),
            ("dopo (viste)", coseni(dopo, viste)),
            ("dopo (tenute)", coseni(dopo, tenute))]

print(f"{'':38}dentro    fra  distacco")
for nome, segnale in [("frasi a caso", 0.0), ("argomento sotto rumore", 0.4)]:
    for riga, (dentro, fra) in esperimento(segnale):
        d = dentro - fra
        print(f"{nome:22}  {riga:14}  {dentro:+.2f}  {fra:+.2f}     {d:+.2f}")
        nome = ""
                                      dentro    fra  distacco
frasi a caso            prima (tenute)  +0.02  +0.01     +0.02
                        dopo (viste)    +0.87  -0.28     +1.16
                        dopo (tenute)   +0.02  -0.03     +0.04
argomento sotto rumore  prima (tenute)  +0.13  +0.01     +0.12
                        dopo (viste)    +0.91  -0.22     +1.13
                        dopo (tenute)   +0.72  -0.08     +0.80
Il programma stampa il coseno medio fra due frasi dello stesso argomento (dentro), quello fra due frasi di argomenti diversi (fra) e la loro differenza, il distacco: prima dell’addestramento sulle frasi tenute da parte, dopo su tutti e due i gruppi. Se lo spazio sa il fatto suo il distacco è grande, e con numeri tirati a caso vale zero.
Con le frasi tirate a caso il distacco parte da zero e, dopo quattrocento passi, sulle frasi viste arriva a \(1{,}16\), mentre su quelle tenute da parte resta a zero (\(0{,}04\)): la rete ha spostato i punti che conosceva, cioè li ha memorizzati, perché fra le frasi di un argomento non c’era niente da imparare. Con l’argomento sotto il rumore il distacco delle frasi tenute da parte sale invece da \(0{,}12\) a \(0{,}80\): la rete ha trovato la direzione che distingue gli argomenti, e la usa anche su frasi che non ha mai visto. Gli argomenti, come tali, alla rete non li ha detti nessuno; le terne però li contengono tutti, perché dicono quale frase sta con quale. Quello che si vuole da uno spazio bisogna insegnarglielo, e la rete lo impara davvero soltanto se nei dati c’è.
Il rovescio della medaglia sta nelle frasi viste, dove in tutti e due i casi il coseno dentro l’argomento arriva a \(0{,}87\) e a \(0{,}91\): quelle frasi si sono ammucchiate quasi in un punto solo per argomento. Va bene se il compito è separare quattro temi; non va bene se serve distinguere due sfumature dentro lo stesso tema, perché lì le differenze sono state cancellate. Il rimedio, in un modello vero, è scegliere meglio la terza frase di ogni terna, quella che deve stare lontana: pescata a caso è quasi sempre di un argomento lontanissimo, la regola è già rispettata e la rete non impara niente. Si cercano allora apposta le frasi quasi uguali all’ancora e però diverse, che in gergo si chiamano negativi difficili e sono quelle che insegnano qualcosa. Ecco perché un modello di embedding si sceglie guardando il compito che si ha davvero, e non una classifica generica.
Da ricordare
Tokenizzare vuol dire affettare il testo in pezzi. I sistemi moderni usano pezzi più piccoli della parola, così anche una parola mai vista si ricostruisce dai suoi mattoncini, purché siano mattoncini che la scatola contiene.
Un vettore è una fila di numeri, e niente di più. Il modo più ingenuo di darne uno a una parola è la pulsantiera con un interruttore acceso e tutti gli altri spenti: funziona, ma per lei gatto e felino sono lontani esattamente quanto gatto e mercoledì.
Contare quante volte compare ogni parola di un documento (il sacchetto di parole) butta via l’ordine per sempre; il peso TF-IDF aggiusta i conti gonfiando le parole rare e sgonfiando quelle che stanno dappertutto.
Gli embedding danno a ogni parola poche centinaia di numeri, imparati leggendo montagne di testo: una mappa del significato, in cui la vicinanza si misura con la similarità del coseno, un numero fra \(-1\) e \(+1\). Un punto solo per parola, però: i due sensi di pesca finiscono nello stesso posto.
Re meno uomo più donna atterra vicino a regina, ma la risposta esce solo se dalla ricerca si tolgono le tre parole della domanda: la freccia del significato esiste, ed è più debole di come la si disegna.
fastText spezza le parole in mattoncini di poche lettere e ne somma i vettori: un vettore ce l’ha anche una parola mai vista, e gatto, gatta e gattino nascono già simili fra loro.
Per una frase intera, la media dei vettori delle sue parole è un punto di partenza onesto ma cieco all’ordine; e un BERT preso così com’è non fa meglio, perché nessuno gliel’aveva chiesto. Se vuoi che uno spazio abbia una certa proprietà, quella proprietà devi addestrarla: una sola rete usata tre volte, e terne di frasi da avvicinare e da allontanare. Su frasi nuove funziona solo se nei dati c’era qualcosa da imparare: altrimenti la rete memorizza le frasi che ha visto, e lo si scopre soltanto provandola su frasi tenute da parte.
Il coseno dice «si somigliano», non «questo risponde a quella»: chi cerca risposte addestra due reti separate, una per le domande e una per i testi.
Da ricordare
Tokenizzare spezza il testo in unità; i sistemi moderni usano token sottoparola: resta rappresentabile ogni stringa fatta di simboli visti in addestramento, e la copertura diventa totale solo scendendo al byte.
One-hot e bag-of-words / TF-IDF danno vettori enormi, sparsi e senza nozione di somiglianza tra parole diverse.
I word embedding (word2vec, GloVe) sono densi e a bassa dimensione: la vicinanza geometrica riflette la vicinanza di significato, misurata con la similarità del coseno. Sono statici: un vettore per tipo di parola, con i sensi di una parola polisemica mescolati.
L’analogia lineare (\(\mathbf{v}_{\text{re}} - \mathbf{v}_{\text{uomo}} + \mathbf{v}_{\text{donna}}\)) restituisce regina solo perché i tre termini di ingresso sono esclusi dai candidati: senza quel vincolo, mai scritto nelle equazioni, vince re [NvNvdG20].
fastText somma i vettori degli n-grammi di caratteri: dà un vettore anche alle parole mai viste e sfrutta la morfologia; un aiuto concreto per lingue a morfologia ricca, dove Bojanowski e colleghi misurano i guadagni maggiori (ceco e tedesco), mentre sulle analogie semantiche non aiuta.
Per un vettore di frase la media dei vettori di parola è una baseline onesta ma cieca all’ordine; e un BERT preso così com’è dà embedding di frase mediocri, perché è stato addestrato ad altro. La similarità va addestrata: reti siamesi (un solo encoder a pesi condivisi) e obiettivi sulle distanze (contrastive, triplet, in-batch negatives).
La scelta dei negativi decide il risultato: quelli casuali diventano presto banali, quelli difficili insegnano. Una loss vicina a zero non basta: la rete può far collassare un argomento in un punto, o memorizzare le frasi viste senza generalizzare, e la seconda cosa si vede soltanto misurando su frasi tenute da parte.
Attenzione a cosa si misura: il coseno dice «si somigliano», non «questo risponde a quella». È il motivo per cui il retrieval usa due torri, domande da una parte e passaggi dall’altra.
Fin qui i token sono stati un dato di partenza: i sistemi moderni spezzano il testo in pezzi più piccoli della parola, ma serve un criterio per decidere dove tagliare. È la domanda di Come si spezza il testo, e la risposta ha conseguenze che arrivano fino al costo di ogni richiesta fatta a un modello.