


Un’etichetta per ogni parola: POS tagging e riconoscimento di entità#
«La vecchia porta la sbarra». Leggi la frase una prima volta: c’è un’anziana signora («la vecchia»), e sta trasportando («porta») una sbarra di ferro. Ora rileggila cambiando i ruoli: c’è una porta malandata, «la vecchia porta», che a una donna sbarra il passaggio. In «la sbarra», adesso, «la» è lei e non più un articolo, e «sbarra» è un verbo. Nessun trucco di punteggiatura: le stesse cinque parole, nello stesso ordine, formano due frasi italiane complete e sensate.
Il bivio è tutto grammaticale, e sta in quattro parole su cinque: «vecchia» può essere nome o aggettivo, «porta» nome o verbo, «la» articolo o pronome, «sbarra» nome o verbo. Scegliere una lettura significa, senza accorgersene, assegnare a ogni parola il suo ruolo nella frase.
Noi lo facciamo in una frazione di secondo. Una macchina deve farlo esplicitamente: scrivere accanto a ogni parola un’etichetta con il suo ruolo. È il part-of-speech tagging (POS, etichettatura delle parti del discorso), uno dei compiti più antichi del NLP; suo cugino stretto è il riconoscimento di entità nominate, che tutti chiamano con la sigla inglese NER, da named entity recognition, e che abbiamo già incontrato nella panoramica del capitolo. Li raccontiamo insieme perché condividono la forma (un’etichetta per ogni parola) e la stessa storia, che comincia prima delle reti neurali: i modelli probabilistici, dagli HMM della fine degli anni Ottanta ai CRF del 2001, poi le reti ricorrenti dei modelli di sequenza.
Le parti del discorso#
A scuola si chiamava analisi grammaticale: articolo, nome, verbo, aggettivo… Il POS tagging è la stessa cosa, fatta da un algoritmo su milioni di frasi. Il risultato si scrive attaccando a ogni parola la sua etichetta con una barra, e per l’esempio ricorrente del libro viene così (una avvertenza prima di leggerlo: la frase dice «sul», e qui trovi «su» e «il» separati, perché l’italiano fonde preposizione e articolo in una parola sola e chi analizza li riapre):
Il/
DETgatto/NOUNnero/ADJsalta/VERBsu/ADPil/DETmuro/NOUN
Le sigle sono abbreviazioni inglesi, e conviene scioglierle subito: DET è il
determiner, cioè l’articolo; NOUN il nome; ADJ l’aggettivo; VERB il
verbo; ADP l’adposition, che raccoglie le nostre preposizioni e le
posposizioni di quelle lingue che le mettono dopo il nome invece che prima
(una categoria sola per tutte e due, così l’etichetta vale in ogni lingua).
Le altre dodici sono le stesse che si imparano a scuola più qualche
raffinatezza: pronome, avverbio, nome proprio, ausiliare, numerale,
interiezione, i due tipi di congiunzione, le particelle, la punteggiatura, i
simboli, e un’etichetta di riserva per ciò che non è niente di tutto questo.
Perché il gioco funzioni tra lingue diverse serve però un inventario di categorie condiviso: è il contributo del progetto Universal Dependencies [NdMG+16], un’impresa collettiva di linguisti che prendono testi veri e ci scrivono sopra, parola per parola, l’analisi giusta (si dice che li annotano), sempre con gli stessi criteri e nella stessa notazione. Alla presentazione del 2016 le lingue erano 33; oggi sono più di centocinquanta. Il nome parla di «dipendenze» e non di categorie perché il grosso di quel lavoro riguarda un piano più su, quello della struttura della frase; le diciassette etichette sono le fondamenta su cui quella struttura si appoggia.
«Porta» è un oggetto in «la porta cigola» e un’azione in «Maria porta il pane»: la stessa parola, due mestieri diversi. Le categorie grammaticali sono appunto i mestieri delle parole (il nome indica cose e persone, il verbo racconta azioni, l’articolo fa strada al nome), e il punto delicato è che alcune ne fanno due, cambiando divisa senza avvisare: «ancora» è un pezzo di nave se la pronunci àncora e un avverbio se la pronunci ancóra. Sulla pagina le due «ancora» sono identiche: solo le parole intorno rivelano quale hai davanti. Etichettare le parti del discorso è proprio questo: guardare il contesto e decidere, parola per parola, quale mestiere è in servizio.
Le parole a doppio mestiere sono poche, se le si conta sul vocabolario: aprilo a caso e quasi ogni voce ne ha uno solo. Sono però quelle che tornano di continuo («porta», «ancora», «la»), e in una frase qualsiasi ne incontri più d’una.
I linguisti del progetto Universal Dependencies hanno stilato una lista di 17 mestieri che funziona per l’italiano come per il finlandese o il giapponese: una specie di stele di Rosetta della grammatica. La lista sta ferma mentre la lingua si muove, e il motivo sta in come sono fatti i mestieri. Alcuni assumono di continuo: «googlare» è un verbo nato l’altro ieri, e nomi nuovi ne arrivano ogni settimana. Altri hanno chiuso le assunzioni da secoli, e nessuno si mette a inventare un articolo. Cambiano le parole, non l’elenco dei mestieri.
Formalmente il POS tagging è un problema di etichettatura di sequenze: data la frase \(w_1, \dots, w_n\), produrre la sequenza di etichette \(t_1, \dots, t_n\), una per token, dalla stessa lunghezza dell’input. È una struttura più semplice della traduzione (niente riordini, niente lunghezze diverse), ma la difficoltà si concentra nell’ambiguità: le parole ambigue sono una minoranza del vocabolario, però sono tra le più frequenti. Con il tagset del Penn Treebank, 45 etichette per l’inglese, le ambigue sono il 14–15% dei tipi di parola ma il 55–67% delle occorrenze nei testi correnti; con un altro tagset, come le 17 etichette universali, le percentuali cambiano.
Lo standard di riferimento è il tagset universale di Universal Dependencies [NdMG+16], 17 categorie valide per tutte le lingue del progetto:
Classi aperte |
Classi chiuse |
Altro |
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
Le classi aperte accolgono parole nuove di continuo («googlare» è un VERB
recente), quelle chiuse quasi mai: nessuno conia nuovi articoli.
Sull’inglese giornalistico i tagger moderni superano il 97% di accuratezza per
token: un numero da leggere con prudenza.
E a che cosa serve, oggi, un’etichetta grammaticale? A tre cose almeno.
Alla lemmatizzazione, che abbiamo incontrato nella cassetta degli attrezzi: ricondurre una parola alla forma con cui la si cerca sul vocabolario, il suo lemma. Per «porta» le forme di dizionario sono due, e per scegliere devi sapere prima se è il nome (e allora il lemma è porta) o il verbo (e allora è portare).
Alla sintesi vocale, cioè ai programmi che leggono un testo ad alta voce, il percorso inverso del riconoscimento vocale, che ha una sezione sua nel capitolo sul parlato: un lettore automatico davanti ad «ancora» deve scegliere tra àncora e ancóra, e l’accento giusto lo decide la categoria grammaticale.
E all’analisi sintattica: le etichette POS sono i mattoni con cui si costruisce l’impalcatura della frase, che è il tema della sezione sulla sintassi.
Chi, dove, quando: le entità nominate#
Il secondo compito lo abbiamo già visto all’opera nella panoramica del capitolo: in «Enrico Fermi nacque a Roma nel 1901» un sistema NER etichetta Enrico Fermi come persona, Roma come luogo, 1901 come data. Il riconoscimento di entità nominate (la sigla nasce alle Message Understanding Conference degli anni Novanta) cerca nel testo persone, luoghi e organizzazioni, più date, cifre e importi. Serve ogni volta che da un mucchio di testo bisogna ricavare delle schede: chi è nato dove e quando, quale azienda ha comprato quale altra, quali farmaci compaiono in una cartella clinica. È anche il primo passo per anonimizzare un documento, perché per cancellare i nomi bisogna prima sapere quali parole sono nomi di persona.
A prima vista sembra un problema diverso dal POS tagging: lì un’etichetta per parola, qui segmenti da ritagliare; «Enrico Fermi» è un’entità sola, lunga due parole. Il trucco che riporta tutto alla forma già nota è lo schema BIO: invece di dire dove comincia e dove finisce un segmento, si dà un’etichetta a ogni parola, e l’etichetta dice se lì un segmento comincia, se lo continua, o se lì fuori non c’è niente. Le tre lettere sono le iniziali inglesi di quelle tre parole (begin, inside, outside). Lo schema nasce nel 1995 con il lavoro di Lance Ramshaw e Mitchell Marcus sugli spezzoni di frase, dove il segnale di «comincia» compariva solo quando serviva a separare un’entità da quella subito prima. Nella versione oggi più diffusa lo si mette in testa a ogni entità, anche quando non ce ne sarebbe bisogno: costa un’etichetta in più e in cambio rende ogni parola leggibile per conto suo.
Tre evidenziatori colorati: giallo per le persone, azzurro per i luoghi, verde per le date. La penna però ce l’ha una persona all’altro capo del telefono, e tu devi dettarle dove passa, parola per parola. Bastano tre segnali: «qui comincio un’evidenziatura gialla», «qui la continuo», «qui la penna è sollevata». Sulla frase di Fermi: Enrico = comincio-giallo, Fermi = continuo-giallo, nacque, a = penna su, Roma = comincio-azzurro, nel = penna su, 1901 = comincio-verde.
La distinzione tra «comincio» e «continuo» sembra pignola ma è preziosa: in «il faccia a faccia Mattarella Macron», due «comincio-giallo» di fila dicono che le persone sono due; un «comincio» seguito da un «continuo» direbbe che è una sola, un improbabile signor Mattarella Macron.
Comincio e continuo si portano dietro il colore, e così le combinazioni diverse diventano sette: due per ciascuno dei tre evidenziatori, più la penna sollevata, che è una sola perché fuori dalle evidenziature il colore non c’è. Con un quarto evidenziatore sarebbero nove: due per colore, più uno.
Una cosa sola questi segnali non la sanno dettare: un’evidenziatura dentro un’altra. Con un quarto colore per le organizzazioni, in «l’Università di Roma» tutta l’università andrebbe in quel colore, e «Roma», lì dentro, in azzurro; ma ogni parola riceve un segnale solo, e allora o si evidenzia l’università o si evidenzia Roma. Nelle raccolte di testi annotati si sceglie la più grande.
Lo schema BIO trasforma l’estrazione di segmenti in etichettatura per token.
Per ogni tipo di entità \(X\) si definiscono due etichette, B-X (begin,
primo token del segmento) e I-X (inside, continuazione), più un’unica
etichetta O (outside) per i token fuori da ogni entità: con \(K\) tipi, il
tagset conta \(2K + 1\) etichette. La frase di Fermi diventa:
Enrico/
B-PERFermi/I-PERnacque/Oa/ORoma/B-LOCnel/O1901/B-DATE
La marca B è ciò che rende lo schema invertibile: senza di essa due entità
adiacenti dello stesso tipo si fonderebbero in una. La sequenza B-PER B-PER
codifica due persone consecutive; B-PER I-PER una sola entità di due token.
Due varianti vengono spesso confuse, e la differenza cade proprio su quel
punto. Nello schema originale del 1995 (oggi
chiamato IOB1) la B era parsimoniosa: compariva solo quando un
segmento ne seguiva immediatamente un altro dello stesso tipo, cioè solo dove
serviva davvero a separarli. Sotto IOB1 la frase di Fermi si etichetta
I-PER I-PER, non B-PER I-PER, e la B fa esattamente e soltanto il lavoro
di garantire l’invertibilità. La variante oggi più diffusa, IOB2 (la
introduce Adwait Ratnaparkhi nel 1998; il confronto sistematico fra le varianti
in circolazione è di Tjong Kim Sang e Veenstra, 1999), mette la B in testa a
ogni segmento senza eccezioni: costa un’etichetta in più dove non servirebbe,
e in cambio rende l’etichetta di un token indipendente da ciò che lo precede,
il che semplifica sia l’annotazione sia l’apprendimento. È la variante
dell’esempio di Fermi e di molti corpora recenti, ma non dei dati originali del
CoNLL-2003, il riferimento per il NER inglese e tedesco, che sono in IOB1: lì
la B-X compare solo fra due entità dello stesso tipo che si toccano, ed è per
questo che lo script di valutazione di quella campagna legge una I-X dopo una
O come l’inizio di un’entità. Esistono varianti più ricche (BIOES aggiunge
etichette esplicite di fine segmento e di entità a token singolo), ma l’idea non
cambia: una volta ridotto il NER a un’etichetta per token, qualunque modello di
etichettatura di sequenze (HMM, CRF, BiLSTM, Transformer) lo può affrontare, a
una condizione. Le entità devono essere piatte e non sovrapposte: un’entità
dentro un’altra («Università di Roma» contiene «Roma») non entra in uno schema
con un’etichetta sola per token, e infatti i dati del CoNLL-2003 dichiarano di
annotare, in quel caso, soltanto l’entità più esterna.
La grammatica dietro la tenda: gli HMM#
Come si insegna a una macchina a etichettare? La risposta classica, cuore della stagione statistica del NLP, è un modello dal nome intimidatorio e dall’idea limpida: lo Hidden Markov Model (HMM, modello di Markov nascosto). Il nome si scioglie pezzo per pezzo. Markov è il matematico russo che nella sezione sui modelli n-gram contava le lettere dell’Onegin, e la parola richiama il suo patto: quello che succede adesso dipende solo da quello che è successo subito prima. Model, modello, perché è appunto una descrizione semplificata di come nasce una frase. E hidden, nascosto, che è l’aggettivo importante: le categorie grammaticali non si vedono mai, perché sulla pagina ci sono soltanto parole, eppure sono loro a governare quali parole compaiono e in che ordine.
La tenda del palcoscenico resta chiusa per tutta la recita, e in platea arrivano solo le battute degli attori. Gli attori sono le categorie grammaticali, che si passano la scena secondo abitudini precise (dopo l’ARTICOLO entra quasi sempre il NOME, diciamo 7 volte su 10, e raramente il VERBO), e ognuna ha il suo copione di parole tipiche (quando è in scena l’ARTICOLO senti «la», «il», «un»…). Un HMM è questo teatro: due libretti di abitudini (chi passa la scena a chi e chi dice che cosa) imparati contando su migliaia di frasi già etichettate a mano. Etichettare una frase nuova è un ragionamento da detective: dopo aver sentito le battute «la porta cigola», qual è la sfilata di attori dietro la tenda che le spiega meglio? Certezze non ce ne sono («porta» potrebbe dirla il NOME o il VERBO) ma puoi calcolare quale storia è più probabile, ed è quella che scrivi.
E se in platea arriva una battuta che nessun copione contiene, come «googlare»? A contare, nessun attore l’ha mai detta, e qualunque storia che la contenga varrebbe zero. I sistemi veri tengono allora un copione di riserva, che indovina l’attore dalla fine della parola (-are fa pensare a un verbo) e dalla maiuscola.
Un HMM per il tagging ha come stati nascosti le etichette \(t_1, \dots, t_n\) e come osservazioni le parole \(w_1, \dots, w_n\). Due assunzioni lo definiscono: ogni etichetta dipende solo dalla precedente (catena di Markov del primo ordine) e ogni parola dipende solo dalla propria etichetta. La probabilità congiunta si fattorizza allora in
dove \(P(t_i \mid t_{i-1})\) sono le probabilità di transizione tra etichette (con \(t_0\) simbolo convenzionale di inizio frase) e \(P(w_i \mid t_i)\) le probabilità di emissione delle parole; entrambe si stimano come frequenze relative su un corpus annotato, \(P(t_i \mid t_{i-1}) = C(t_{i-1}, t_i)/C(t_{i-1})\) e \(P(w \mid t) = C(t, w)/C(t)\), dove \(C\) conta le occorrenze. Una parola mai vista in addestramento ha \(P(w \mid t) = 0\) per ogni \(t\), e azzererebbe la probabilità di qualunque sequenza la contenga: i tagger reali la trattano con un modello a parte per le parole sconosciute, costruito sulle ultime lettere e sulla maiuscola, come in TnT [Bra00]. Il tagging è la ricerca della sequenza di stati più probabile date le parole,
dove la seconda uguaglianza segue dalla regola di Bayes: il denominatore \(P(w_{1:n})\) non dipende dalle etichette. È un modello generativo: descrive come etichette e parole vengono prodotte insieme, e la lettura d’obbligo resta il tutorial di Rabiner [Rab89].
L’HMM, del resto, non è nato per la grammatica. L’articolo che lo ha reso popolare è del 1989, lo firma Lawrence Rabiner [Rab89] e parla di riconoscimento del parlato. Lì gli stati nascosti sono i fonemi, i suoni elementari della lingua, quelli che distinguono «pane» da «cane»; le osservazioni sono vettori di pochi numeri calcolati sul suono, uno per ogni fettina di qualche millesimo di secondo («quanta energia c’è sui toni bassi, quanta sugli alti»); e la sequenza di fonemi più probabile si trova con lo stesso algoritmo che, sulle parole, trova la sequenza di categorie, quello di Viterbi. Gli HMM hanno retto la trascrizione automatica per circa trent’anni, e li ritroveremo nel capitolo sul riconoscimento del parlato.
Viterbi, o l’arte di non provarle tutte#
Resta il problema pratico: trovare la sequenza di etichette più probabile. Contiamo quante sono. Per la prima parola posso scegliere fra 17 categorie; per ciascuna di quelle scelte, la seconda parola me ne offre altre 17, e siamo già a \(17 \times 17\); con venti parole le combinazioni sono \(17^{20}\), cioè circa quattro milioni di miliardi di miliardi. Provarle tutte è fuori discussione: non c’è computer che finisca.
La salvezza sta in una proprietà che il modello ha per costruzione: ogni etichetta dipende solo da quella immediatamente precedente, e non da tutte quelle prima ancora. È la stessa regola del patto di Markov, ed è il motivo per cui questi modelli si dicono «a catena»: come in una catena, ogni anello tocca solo il precedente e il successivo.
In che senso quella proprietà salva? Arrivato alla parola 12, non ho bisogno di ricordare tutta la storia di come ci sono arrivato: mi basta sapere, per ciascuna delle 17 categorie possibili, qual era il modo migliore di arrivarci alla parola 11. Tutto il resto si può buttare, perché non influenzerà nulla di ciò che viene dopo. Questo modo di procedere (calcolare una volta sola ogni pezzo che servirà più volte, e tenerselo da parte invece di rifarlo) si chiama programmazione dinamica, e torna spesso: la griglia della distanza di edit, nella cassetta degli attrezzi, era la stessa idea.
L’algoritmo che la applica qui porta il nome di Andrew Viterbi [Vit67], nato Andrea a Bergamo nel 1935 ed emigrato bambino negli Stati Uniti, che lo propose nel 1967 non per la grammatica ma per decifrare segnali arrivati storti lungo un canale disturbato: lo stesso algoritmo ha poi viaggiato dentro i telefoni cellulari di mezzo mondo.
Facciamo i conti fino in fondo su un modello giocattolo: tre categorie (DET,
l’articolo; NOUN, il nome; VERB, il verbo: le sigle del tagset universale) e
la frase «la porta cigola», dove «porta» ha la stessa doppiezza di «porta» nella
frase d’apertura. I numeri delle due tabelle di probabilità sono inventati per
l’esempio, scelti tondi perché i conti si possano rifare a mente: in un sistema
vero verrebbero dai conteggi su un corpus già etichettato.
La prima tabella, quella che dice quale categoria segue quale, contiene le
probabilità di transizione \(P(t_i \mid t_{i-1})\). Si legge riga per riga: la
riga «inizio frase» dice che sei frasi su dieci cominciano con un articolo, tre
con un nome e una con un verbo; la riga DET dice che dopo un articolo arriva
un nome sette volte su dieci, un verbo due e un altro articolo una.
categoria precedente ↓, successiva → |
|
|
|
|---|---|---|---|
inizio frase |
0,6 |
0,3 |
0,1 |
|
0,1 |
0,7 |
0,2 |
|
0,2 |
0,3 |
0,5 |
|
0,4 |
0,4 |
0,2 |
La seconda, quella che dice con quali parole si presenta ciascuna categoria, contiene le probabilità di emissione \(P(w_i \mid t_i)\), che si chiamano così perché ogni categoria «emette» le sue parole:
categoria ↓ |
emette «la» |
emette «porta» |
emette «cigola» |
|---|---|---|---|
|
0,5 |
0 |
0 |
|
0 |
0,2 |
0 |
|
0 |
0,2 |
0,3 |
Nessuna di queste righe somma a uno, e non è un errore: il resto della probabilità va a tutte le altre parole della lingua, che in questo esempio non compaiono. E siccome siamo in un modello giocattolo con tre sole categorie, il pronome non c’è: qui «la» la può dire solo l’articolo, anche se in italiano vero, come in «La vecchia porta la sbarra», potrebbe essere un pronome.
Un ultimo punto delicato: la parola «porta», da sola, non decide, perché il nome e il verbo la pronunciano con la stessa frequenza, 0,2 contro 0,2. Fig. 15.22 mostra il traliccio (trellis): una colonna per parola, una casella per categoria, e tutti i cammini che l’algoritmo valuta.

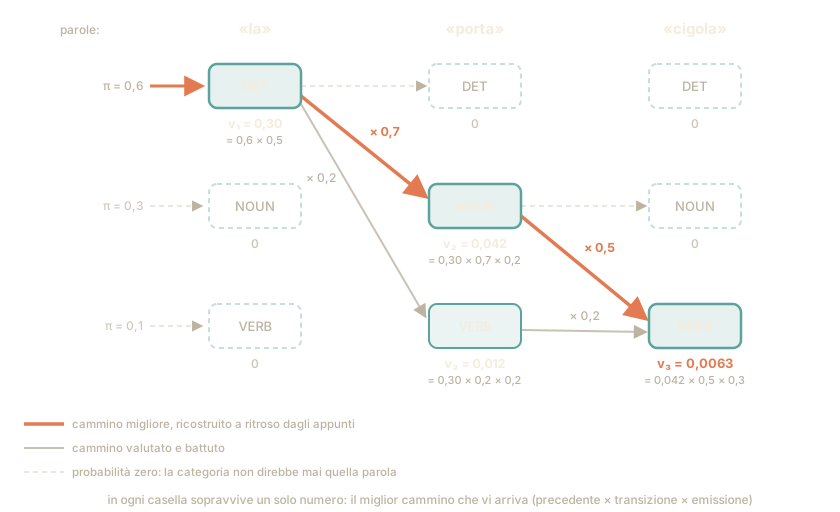
Fig. 15.22 Il traliccio di Viterbi su «la porta cigola»: in ogni casella sopravvive solo il migliore dei cammini che vi arrivano, e alla fine si risale all’indietro lungo la strada in terracotta. Nel disegno π sono le probabilità di cominciare la frase con ciascuna categoria (la riga «inizio frase» della prima tabella), e \(v_1\), \(v_2\), \(v_3\) i punteggi delle caselle, uno per parola.#
Un navigatore attraversa tre incroci, uno per parola, e a ogni incrocio sceglie fra tre corsie, una per categoria.
A «la» ne è aperta una sola, perché soltanto l’articolo sa dire «la». Il navigatore ci entra con \(0{,}6 \times 0{,}5 = 0{,}30\): sei frasi su dieci cominciano con un articolo, e una volta su due l’articolo di turno è «la».
A «porta» le corsie aperte sono due, il nome e il verbo. Nel nome si entra con \(0{,}30 \times 0{,}7 \times 0{,}2 = 0{,}042\), cioè il punteggio di prima, per le sette volte su dieci in cui dopo un articolo arriva un nome, per le due su dieci in cui quel nome è «porta». Nel verbo, stesso conto, \(0{,}30 \times 0{,}2 \times 0{,}2 = 0{,}012\). La parola non sposta niente, 0,2 e 0,2: a sbilanciare è la strada che ci porta, quello 0,7 contro 0,2.
A «cigola» apre solo il verbo, ma ci si entra da due parti. Il navigatore confronta prima e moltiplica dopo, perché l’ultimo tratto è lo stesso per tutte e due e non cambia la classifica: dal nome \(0{,}042 \times 0{,}5 = 0{,}021\), dal verbo \(0{,}012 \times 0{,}2 = 0{,}0024\). Tiene la prima e butta l’altra per sempre: da lì in avanti le due strade hanno davanti le stesse identiche possibilità, e quella entrata con meno punteggio non recupera più. Poi moltiplica per lo \(0{,}3\) con cui un verbo dice «cigola», e l’incrocio chiude a \(0{,}0063\).
A ogni strada tenuta il navigatore si era annotato da dove veniva. Adesso rilegge gli appunti all’indietro: verbo ← nome ← articolo. La frase esce così: la/articolo porta/nome cigola/verbo.
Tre parole e tre corsie si contano sulle dita. Con 17 categorie e 20 parole i percorsi interi sarebbero quei quattro milioni di miliardi di miliardi, ma gli incroci restano 20, con 17 corsie ciascuno: 17 × 20 = 340 in tutto. Un pugno di moltiplicazioni per corsia, e il percorso migliore in assoluto salta fuori comunque, garantito.
Sulle frasi lunghe, però, i punteggi si guastano. Ogni incrocio moltiplica per un numero minore di uno, e il punteggio si assottiglia in fretta: 0,30, poi 0,042, poi 0,0063, e dopo la virgola gli zeri si accumulano. Per scriverlo il navigatore ha un numero fisso di cifre, come un calcolatore, e dopo qualche decina di incroci non gli resta che zero: due percorsi diversi finiscono segnati con lo stesso zero, e la gara non si può più giudicare. Il rimedio è cambiare unità di misura. Invece di moltiplicare i punteggi si contano gli zeri, che a ogni incrocio si sommano tranquillamente; alla fine vince il percorso che ne ha di meno.
C’è anche un secondo navigatore, che a ogni incrocio, invece di tenere la strada migliore, somma i punteggi di tutte le strade che arrivano. A «cigola» trova \(0{,}0063 + 0{,}0024 \times 0{,}3 = 0{,}0063 + 0{,}00072 = 0{,}00702\): la probabilità della frase, sommata su tutte le strade che la possono produrre, di cui la strada migliore porta circa nove decimi. Fatto lo stesso giro anche dalla fine verso l’inizio, i due conti insieme dicono, per ogni parola, quanto è probabile ciascuna categoria tenendo conto di tutte le strade. Servono quando non ci sono frasi etichettate a mano su cui contare i due libretti: si parte da libretti tirati a indovinare, si usano quelle probabilità al posto dei conteggi, e si ripete, e a ogni giro i libretti spiegano le frasi un po” meglio. Per le parti del discorso, però, i libretti imparati così funzionano peggio di quelli contati su frasi etichettate, e conviene etichettarne a mano più che si può.
Definiamo \(v_i(s)\) come la probabilità del miglior cammino che arriva allo stato \(s\) dopo aver generato le prime \(i\) parole. L’algoritmo di Viterbi la calcola per ricorrenza:
dove \(\pi_s\) è la probabilità iniziale dello stato \(s\) e \(s'\) scorre su tutti gli stati al passo precedente; un retropuntatore \(\psi_i(s) = \arg\max_{s'} v_{i-1}(s')\, P(s \mid s')\) memorizza da dove proviene il massimo. Sul modello giocattolo la tabella dei massimi è:
stato |
«la» |
«porta» |
«cigola» |
|---|---|---|---|
|
0,30 |
0 |
0 |
|
0 |
0,042 ← |
0 |
|
0 |
0,012 ← |
0,0063 ← |
Al termine si prende lo stato finale con \(v_n\) massimo (qui VERB, con
\(0{,}0063\)) e si segue \(\psi\) a ritroso: DET → NOUN → VERB. Il cammino
alternativo completo DET → VERB → VERB vale
\(0{,}012 \times 0{,}2 \times 0{,}3 = 0{,}00072\): quasi nove volte meno. Detto
\(T\) il numero di etichette possibili, il costo è \(O(n\,T^2)\) (per ognuna delle
\(n\) parole, per ognuno dei \(T\) stati, un massimo su \(T\)
predecessori) contro gli \(O(T^n)\) cammini della forza bruta: con \(T = 17\) e
\(n = 20\), poche migliaia di operazioni al posto di \(10^{24}\), e con la
garanzia dell’ottimo globale; a differenza della beam search della
traduzione, che è un’euristica. In pratica si lavora
con i logaritmi, sommando
invece di moltiplicare, per evitare l’underflow.
Sostituendo il massimo con una somma, la stessa ricorrenza diventa l’algoritmo forward, \(\alpha_i(s) = \sum_{s'} \alpha_{i-1}(s')\,P(s \mid s')\,P(w_i \mid s)\), con \(P(w_{1:n}) = \sum_s \alpha_n(s)\) e lo stesso costo \(O(n\,T^2)\): sul modello giocattolo \(P(w_{1:3}) = 0{,}0063 + 0{,}00072 = 0{,}00702\), e il cammino di Viterbi ne raccoglie circa il \(90\%\). Affiancato alla ricorrenza speculare all’indietro, \(\beta_i(s) = \sum_{s'} P(s' \mid s)\,P(w_{i+1} \mid s')\,\beta_{i+1}(s')\) con \(\beta_n(s) = 1\), dà le probabilità a posteriori \(P(t_i = s \mid w_{1:n}) = \alpha_i(s)\,\beta_i(s) / P(w_{1:n})\): è il forward-backward. Serve dove i conteggi non si possono fare: senza un corpus annotato l’algoritmo di Baum–Welch, un caso dell’EM, usa quelle probabilità come conteggi attesi delle emissioni e, per le transizioni, le probabilità a coppie
e non fa mai scendere la verosimiglianza da un’iterazione all’altra, fino a un punto stazionario, di norma un massimo locale [Rab89]. Per il POS tagging, però, più verosimiglianza non vuol dire più accuratezza: Merialdo trova che le iterazioni di Baum–Welch su testo non annotato, partendo da un modello stimato su frasi annotate, in genere peggiorano l’etichettatura, tranne quando le frasi annotate sono pochissime [Mer94]. Per questo i tagger si stimano su corpora annotati, e Baum–Welch serve soprattutto dove l’annotazione manca, come nel riconoscimento del parlato. Nel caso sommato l’underflow si evita riscalando le \(\alpha_i\) a ogni passo, perché il logaritmo di una somma non è una somma.
Un HMM è un modello generativo: stima la probabilità congiunta \(P(t, w)\) di etichette e parole, cioè racconta come nascono insieme. Dal 2001 gli si affiancano i Conditional Random Field (CRF, alla lettera «campi casuali condizionati») [LMP01], modelli discriminativi che stimano direttamente \(P(t \mid w)\), la probabilità delle etichette date le parole, e si addestrano soltanto a scegliere l’etichetta giusta. È la stessa distinzione che separa Naive Bayes e regressione logistica nella sezione sulla classificazione, applicata alle sequenze invece che ai documenti. Il guadagno è che un CRF, non dovendo spiegare come nascono le parole, può guardare indizi che un HMM non sa usare: la maiuscola iniziale, le ultime tre lettere della parola, la presenza di un trattino, le parole vicine. Per anni i CRF sono stati il modello di riferimento per il NER, e per trovare la sequenza migliore usano ancora l’algoritmo di Viterbi.
Fra l’HMM e il CRF c’è stato un modello di mezzo, il MEMM, che gli indizi li sapeva già usare ma giudicava la sfilata un incrocio alla volta. A ogni incrocio il navigatore del MEMM sceglie come un classificatore qualunque, e le probabilità di una scelta fanno uno: ha un punto intero da spartire fra le strade che ripartono da lì, e guarda la parola solo per decidere come spartirlo. Il guaio si vede a un incrocio con una sola uscita: quella strada riceve per forza il punto intero, qualunque parola arrivi, e anche una parola che urlasse «qui c’è un errore» non cambierebbe niente. (Nell’HMM questo non succede, perché la parola entra come un voto a parte; ma l’HMM gli indizi non li sa usare.)
Un CRF aspetta la fine. Dà un punteggio a ogni percorso intero, sommando quanto ogni etichetta sta bene con le parole (una maiuscola in testa, una desinenza in -mente) e quanto sta bene con l’etichetta che la precede, e solo alla fine divide per la somma dei punteggi di tutti i percorsi possibili. Quella somma sembra impossibile, perché i percorsi sono miliardi di miliardi, ma la fa il secondo navigatore, quello che somma invece di scegliere, sullo stesso traliccio. Così un percorso intero può valere poco anche se ogni suo incrocio era obbligato.
Per imparare, si cercano i pesi che rendono più probabili i percorsi giusti degli esempi, e la ricerca ha una sola cima, senza cime false dove fermarsi per errore. Nella versione con le reti, i punteggi fra parole ed etichette li calcola una rete ricorrente che legge nei due sensi, come quella che nella traduzione leggeva la frase di partenza, imparata insieme a tutto il resto, e al CRF restano come pesi propri soltanto quelli fra un’etichetta e la successiva; con la rete in mezzo, però, la cima unica non è più garantita.
Un CRF a catena lineare modella direttamente la condizionata,
dove \(\mathbf{f}\) è un vettore di caratteristiche che possono guardare l’intera frase (maiuscola, suffissi, parole vicine) e \(\theta\) i loro pesi. La normalizzazione è globale: \(Z\) somma su tutte le \(T^n\) sequenze e si calcola con l’algoritmo forward in \(O(n\,T^2)\). È questo a separare il CRF dai MEMM (maximum-entropy Markov model) [MFP00], che lo precedono e normalizzano passo per passo: \(P(t_i \mid t_{i-1}, w_{1:n})\) somma a uno su ogni stato, qualunque sia la parola, quindi uno stato con un solo successore non può che passare a quello, e uno con pochi successori ignora di fatto l’osservazione. Lafferty e colleghi chiamano questo difetto label bias, e la normalizzazione globale del CRF lo elimina [LMP01]. L’addestramento massimizza la log-verosimiglianza condizionata, concava in \(\theta\), il cui gradiente è la differenza fra i conteggi empirici delle caratteristiche e quelli attesi sotto il modello, calcolati col forward-backward. La decodifica resta Viterbi sui punteggi \(\theta^\top\mathbf{f}\). Nella versione neurale le caratteristiche di emissione le produce una BiLSTM, addestrata insieme alle transizioni sulla stessa log-verosimiglianza condizionata [HXY15]: al CRF restano come parametri propri le sole transizioni fra etichette, e la concavità, che valeva a caratteristiche fissate, si perde. Lample e colleghi completano l’ingresso della BiLSTM con una rappresentazione di ogni parola costruita dai suoi caratteri [LBS+16]; e un livello di punteggi di transizione addestrato sulla verosimiglianza della frase intera, sopra una rete neurale, c’era già nel lavoro di Collobert e colleghi [CWB+11], che per il NER usavano una rete a finestra fissa di parole invece di una ricorrente.
La via neurale: una BiLSTM per etichettare#
E le reti ricorrenti? Nella sezione sulla traduzione abbiamo stabilito una regola: la lettura bidirezionale vale solo per capire un testo che esiste già tutto intero, non per generarlo. L’etichettatura è il caso ideale: la frase è lì, completa, e per decidere l’etichetta di «porta» servono tanto le parole prima quanto quelle dopo («la porta cigola» contro «la porta a scuola»). Un etichettatore neurale minimo (un tagger, dall’inglese tag, cartellino) ha tre componenti, tutti già incontrati: uno strato di embedding, che trasforma ogni parola nel suo vettore; una LSTM bidirezionale, che per ogni parola produce uno stato che dipende dall’intera frase, 128 numeri per direzione e 256 in tutto; e uno strato lineare, che trasforma quello stato in 17 punteggi, uno per etichetta. Vince l’etichetta col punteggio più alto.
import torch
from torch import nn

class TaggerBiLSTM(nn.Module):
    def __init__(self, vocab=10000, num_tag=17, dim=64, hidden=128):
        super().__init__()
        self.embedding = nn.Embedding(vocab, dim)   # parola -> vettore
        self.lstm = nn.LSTM(dim, hidden, batch_first=True,
                            bidirectional=True)     # legge nei due sensi
        self.out = nn.Linear(2 * hidden, num_tag)   # un logit per etichetta

    def forward(self, x, lunghezze):  # lunghezze: parole vere per frase
        e = self.embedding(x)      # (batch, lunghezza, dim)
        p = nn.utils.rnn.pack_padded_sequence(
            e, lunghezze.cpu(), batch_first=True, enforce_sorted=False)
        h, _ = self.lstm(p)        # ogni direzione legge solo la sua frase
        h, _ = nn.utils.rnn.pad_packed_sequence(
            h, batch_first=True, total_length=x.size(1))
        return self.out(h)         # logit per OGNI parola, non solo l'ultima
Confrontalo con il classificatore di sentiment dei modelli di sequenza: là si teneva solo l’ultimo stato (h[:, -1]),
un’etichetta per frase; qui si tengono tutti, un’etichetta per parola. La misura
dell’errore è quella di sempre, la cross-entropia (quanto la previsione si
discosta dall’etichetta giusta), applicata però parola per parola, e con un
accorgimento. Le frasi di un mini-batch hanno lunghezze diverse, e si pareggiano
riempiendo le più corte con caselle vuote (il padding), che vanno escluse dal
conto, altrimenti la rete si metterebbe a imparare il vuoto. In PyTorch lo fa
la funzione di perdita, CrossEntropyLoss: salta le caselle la cui etichetta
vale -100, il valore convenzionale che vuol dire «questa casella non conta»,
e basta scriverlo nelle etichette del riempimento. Escluderle dal conto, però,
non basta: la LSTM che legge all’indietro comincia dall’ultima casella, quindi
attraversa i riempitivi prima di arrivare alle parole vere, e l’etichetta di
«porta» cambierebbe con il numero di caselle vuote in coda. Per questo il
mini-batch, prima della LSTM, si impacchetta con
nn.utils.rnn.pack_padded_sequence, passando le lunghezze vere, e dopo si
srotola con pad_packed_sequence: così ciascuna direzione legge soltanto la
propria frase, ed è quello che fa il forward del tagger. Lo schema del ciclo
è questo:
modello = TaggerBiLSTM()
perdita = nn.CrossEntropyLoss(ignore_index=-100)  # -100 = padding da ignorare

# frasi: (batch, lunghezza), indici di parole; tag: stessa forma, -100 sul
# padding; lunghezze: (batch,), quante parole vere ha ciascuna frase
logits = modello(frasi, lunghezze)         # (batch, lunghezza, 17)
loss = perdita(logits.reshape(-1, 17),     # una riga per token
               tag.reshape(-1))            # un'etichetta per token
loss.backward()                            # poi optimizer.step(), come sempre
Questa ricetta ha però un buco: le etichette sono scelte una indipendentemente
dall’altra, senza guardare che cosa si è deciso per la parola prima. Possono
quindi comparire successioni che nello schema BIO dell’esempio di Fermi non
vogliono dire niente, come un I-PER (dentro una persona) subito dopo una O
(fuori da ogni entità). Si aggiunge allora in cima uno strato CRF
[HXY15]: i punteggi fra parole ed etichette sono quelli
della BiLSTM, quelli fra un’etichetta e la successiva sono parametri propri, e
la decodifica con Viterbi sceglie la sequenza migliore nel suo insieme, che può
escludere del tutto le successioni vietate (basta un punteggio \(-\infty\) sulla
transizione da O a I-PER).
Vettori che cambiano con la frase: ELMo#
Il tagger comincia con un embedding che dà a ogni parola un vettore solo, lo stesso in ogni frase, come quelli di word2vec: la BiLSTM deve poi imparare da capo, sui pochi esempi etichettati, che cosa vuol dire una parola in quel contesto. ELMo di Peters e colleghi [PNI+18] sposta quel lavoro prima, su testo senza etichette: addestra una coppia di LSTM come modello di linguaggio nei due versi, e consegna al tagger, per ogni parola, un vettore che dipende dall’intera frase.
Nella frase «la partita di calcio è finita tardi» e in «il latte porta calcio alle ossa» la parola è la stessa, e il vettore di word2vec anche. Per averne due diversi serve qualcuno che abbia letto la frase intera. ELMo mette al lavoro due lettori su milioni di frasi senza nessuna etichetta: uno legge da sinistra e a ogni parola cerca di indovinare la successiva, l’altro legge da destra e cerca di indovinare la precedente. Per indovinare bene devono capire il contesto, e quello che ciascuno ha in testa quando arriva su «calcio» è una fila di numeri che dipende dal pezzo di frase che ha letto: il primo da quello prima, il secondo da quello dopo. Messe accanto, le due file dipendono da tutta la frase.
Il tagger prende quelle file di numeri come ingredienti, accanto al suo embedding, e i due lettori restano come sono: non li si riaddestra. Ogni lettore è fatto di più strati, uno sopra l’altro, e ciascuno rilavora quello che gli passa lo strato di sotto; gli strati non sanno le stesse cose: quelli bassi sono più bravi con la grammatica (che ruolo ha la parola), quelli alti con il significato (quale calcio). Così ogni compito impara la propria ricetta, quanto prendere da ogni strato, e una manopola che alza o abbassa il tutto, come un volume.
I limiti sono due. I lettori sono fermi, quindi il compito non può correggerli per le proprie esigenze; e ciascuno dei due vede un lato solo della frase, perché le due letture si incontrano soltanto alla fine, quando si mettono accanto i loro risultati.
Il modello di linguaggio bidirezionale di ELMo massimizza, su \(N\) token,
con un LSTM per direzione e i parametri della rappresentazione d’ingresso e della softmax condivisi fra le due. L’ingresso è calcolato dai caratteri con una rete convoluzionale; ogni direzione ha \(L = 2\) strati LSTM da 4096 unità con proiezioni a 512 dimensioni e una connessione residua fra il primo e il secondo strato. Per il token \(k\) si ottengono così \(L + 1\) rappresentazioni \(\mathbf{h}_{k,j}\): lo strato d’ingresso, calcolato dai caratteri e condiviso fra le due direzioni, e i due strati LSTM, in ciascuno dei quali si concatenano gli stati delle due direzioni. Il compito ne usa la combinazione
con pesi \(s_j\) normalizzati da una softmax e uno scalare \(\gamma\), appresi entrambi sul compito, mentre i pesi del modello di linguaggio restano congelati. Il vettore si concatena all’ingresso del modello del compito, e in alcuni compiti anche alla sua uscita. (Il lavoro affina anche il modello di linguaggio sul testo del compito, senza etichette, prima di congelarlo: è un adattamento al dominio, non il fine-tuning supervisionato di cui si dice sotto.) L’analisi degli strati conferma la divisione del lavoro: il primo strato serve meglio l’etichettatura grammaticale, l’ultimo la disambiguazione del senso delle parole. Con questo schema ELMo migliorò sei compiti diversi, dalle domande e risposte all’implicazione testuale, dai ruoli semantici alla coreferenza, dal NER al sentiment. Sul NER del CoNLL-2003, aggiunto a una BiLSTM-CRF, porta la \(F_1\) da \(90{,}15\) a \(92{,}22\) (media su cinque semi), cioè il 21% di errore relativo in meno; il miglior risultato precedente era \(91{,}93\) [PNI+18]. Con il fine-tuning, sullo stesso test, BERT-large arriva a \(92{,}8\) [DCLT19]. BERT chiama lo schema di ELMo approccio feature-based, in cui le rappresentazioni preaddestrate entrano come ingressi aggiuntivi, per distinguerlo dal fine-tuning, in cui si riaddestra tutto il modello sul compito; e ne critica la bidirezionalità, che definisce una concatenazione superficiale di due modelli di linguaggio, uno per direzione, addestrati ciascuno sul proprio lato [DCLT19]. La critica riguarda come le due direzioni si combinano (si affiancano alla fine, senza parlarsi dentro gli strati), non l’obiettivo, che come si è visto le addestra insieme.
Il passo che ELMo non faceva lo fa BERT [DCLT19]: si prende un modello già addestrato su grandi quantità di testo non annotato, gli si mette sopra lo stesso strato lineare per parola del tagger, e si prosegue l’addestramento di tutti i parametri sul compito, per poche passate sui dati e con un tasso di apprendimento piccolo. Questa seconda fase corta si chiama fine-tuning, «rifinitura»: il modello parte da rappresentazioni della lingua già apprese, e il compito si impara con i pochi dati etichettati che ci sono. La lettura nei due sensi, che qui richiede due reti affiancate, in BERT sta dentro ogni strato, perché il suo preaddestramento nasconde alcune parole e le fa indovinare dal contesto dei due lati; se ne parla nel capitolo sui Transformer.
Misurare bene: token o entità?#
Un’ultima questione, meno contabile di quanto sembri: come si dà il voto a un etichettatore? La risposta giusta è diversa per i due compiti.
Per le parti del discorso il voto naturale funziona: quante parole hanno ricevuto l’etichetta giusta, su cento. Ma attenzione alle percentuali gonfiate. Prova a immaginare il sistema più stupido possibile: per ogni parola guarda qual è il mestiere che quella parola fa più spesso nei testi già etichettati, e scrive sempre quello, senza mai guardare il contesto. Un sistema così, che non ha capito niente di niente, sull’inglese dei giornali azzecca già 92 parole su cento, perché tantissime parole sono facili: «the» è sempre un articolo, «quickly» quasi sempre un avverbio (come da noi «il» e «velocemente»). Le parole ambigue sono meno numerose, ma sono quelle che si usano di più, e in un testo inglese di giornale coprono più della metà delle parole scritte. I sistemi seri stanno oltre il 97. Ecco perché quei numeri vanno letti sapendo da dove si parte: fra il 92 e il 97 c’è tutto il lavoro, e ci sono tutte le parole ambigue, cioè le uniche su cui valga la pena discutere.
Per le entità quel voto diventa una trappola. Prendi un testo di 100 parole che contiene una sola entità, «Enrico Fermi». Un sistema pigro che non evidenzia niente azzecca 98 parole su 100: 98%, e non ha trovato nulla! E un sistema che evidenzia solo «Enrico», lasciando fuori «Fermi», ha prodotto un’entità sbagliata: mezza persona non serve a nessuno. Per questo il NER si giudica a evidenziature intere (vale solo il segmento completo, del colore giusto) e con due domande: di quello che hai evidenziato, quanto era giusto? E di quello che andava evidenziato, quanto ne hai trovato? Sono la precisione e il richiamo della sezione sulle metriche, usati nella sezione sulla classificazione, dove si chiamavano con i loro nomi inglesi, precision e recall: sono la stessa identica coppia di domande. Il voto unico \(F_1\) le riunisce con la media armonica già vista là, quella in cui un voto basso non si nasconde dietro uno alto: si moltiplicano i due voti, si raddoppia il prodotto, e lo si divide per la somma dei due voti.
Prova con un testo che contiene dieci entità e un sistema che ne evidenzia una sola, azzeccandola. Primo voto: \(1{,}0\), perché tutto quello che ha segnalato era giusto. Secondo voto: \(0{,}1\), perché di dieci ne ha trovata una. La media di scuola gli darebbe un onorevole \(0{,}55\). Con la nostra: prodotto \(0{,}10\), raddoppiato \(0{,}20\), diviso la somma \(1{,}1\), fa \(0{,}18\). E ha ragione lei.
Per il POS tagging la metrica è l’accuratezza per token, \(\text{acc} = \frac{\#\{i : \hat{t}_i = t_i\}}{n}\). Va letta contro una base di confronto onesta: il baseline «assegna a ogni parola la sua etichetta più frequente nel corpus» arriva già al 92% sull’inglese giornalistico (con il tagset Penn, sul Wall Street Journal), quindi lo spazio reale di miglioramento, dal 92% al 97% che sui treebank inglesi raggiungono HMM, CRF e BERT allo stesso modo, sta tutto nelle occorrenze ambigue, le più difficili.
Per il NER si usano precisione, richiamo e F1 a livello di entità, con il criterio dell’exact match reso standard dalle campagne di valutazione CoNLL dei primi anni Duemila: un’entità predetta conta come corretta solo se coincidono sia i confini del segmento sia il tipo. Dette \(C\) le entità corrette, \(\hat{E}\) quelle predette ed \(E\) quelle di riferimento:
dove la precisione misura quanto ci si può fidare di ciò che il sistema estrae e il richiamo quanta parte del dovuto viene trovata. Il voto unico è la loro media armonica,
La severità
dell’exact match è motivata dall’uso a valle: un’entità dai confini
sbagliati inquina qualunque base di conoscenza la riceva. Ha però un costo
contabile: un’entità con un confine sbagliato conta due volte, come falso
positivo (il segmento predetto) e come falso negativo (quello vero mancato),
mentre non predire niente costa un falso negativo soltanto, sicché un sistema
che tace sui casi dubbi può guadagnare \(F_1\). I conteggi si sommano su tutti i
tipi prima di calcolare precisione e richiamo (media micro), e lo script di
CoNLL, come la libreria seqeval che lo riproduce, legge una I-X dopo una
O come l’inizio di un’entità. L’accuratezza per
token, dominata dall’etichetta O, qui non discrimina nulla: il sistema
che predice sempre O ne uscirebbe con punteggi altissimi e utilità zero.
Chiudiamo dove avevamo aperto. Davanti a «La vecchia porta la sbarra» un tagger sceglie la lettura più probabile secondo la sua esperienza: quasi certamente la signora con la sbarra, perché le statistiche della lingua pendono da quella parte. Ma sapere che «porta» è un verbo non dice ancora chi fa che cosa a chi: per questo bisogna salire di un piano, dalle etichette alla struttura della frase. È l’analisi sintattica, e i suoi mattoni sono esattamente queste etichette POS.
Da ricordare
Il POS tagging dà a ogni parola il suo mestiere nella frase (nome, verbo, articolo): la lista condivisa fra le lingue è quella dei 17 mestieri di Universal Dependencies. Le parole con due mestieri («porta», «ancora») sono una minoranza del vocabolario ma tornano di continuo nei testi, e a decidere quale sia in servizio è sempre il contesto.
Il NER cerca persone, luoghi, organizzazioni e date. Lo schema BIO è il modo di dettare al telefono dove passa l’evidenziatore, con tre soli segnali per parola (qui comincio, qui continuo, qui la penna è sollevata): così due persone di fila restano due persone e non diventano una sola. Un’evidenziatura dentro un’altra, però, non si sa dettare.
Lo HMM è la recita dietro la tenda: le parole sono le battute che senti, le categorie grammaticali gli attori che non vedi, e si passano la scena secondo abitudini fisse, ciascuno con il proprio copione di parole tipiche. I due libretti di abitudini si imparano contando su frasi già etichettate a mano. La stessa macchina, con i suoni al posto delle categorie, ha retto il riconoscimento vocale per trent’anni.
Viterbi è il navigatore che a ogni incrocio, per ogni corsia, conserva solo il modo migliore di arrivarci e butta via gli altri: invece di provarli tutti, che sono quei quattro milioni di miliardi di miliardi, ne visita poche centinaia di caselle, e trova comunque il percorso migliore in assoluto, garantito.
Alla recita dietro la tenda sono poi succeduti i CRF, che non raccontano più come parole ed etichette nascano insieme: si allenano soltanto a scegliere l’etichetta giusta, e possono guardare indizi che alla recita sfuggono (la maiuscola iniziale, la fine della parola, un trattino). Danno il punteggio al percorso intero, e non incrocio per incrocio come il modello di mezzo che li aveva preceduti. Per trovare il percorso migliore, però, chiamano ancora il navigatore.
Il tagger neurale legge la frase nei due sensi e produce un’etichetta per ogni parola, non una per l’intera frase; leggere anche all’indietro è lecito perché il testo è già lì tutto intero. ELMo gli dà in più, per ogni parola, un vettore che cambia con la frase, preso da due lettori addestrati su testo senza etichette a indovinare la parola dopo e quella prima. Oggi il NER migliore si ottiene rifinendo un modello già addestrato (BERT).
Come si dà il voto: per le parti del discorso si contano le parole etichettate bene, ma il numero va letto sapendo da dove si parte. Un sistema che dà a ogni parola la sua etichetta più frequente, senza guardare il contesto, azzecca già 92 parole su cento; i sistemi seri stanno oltre 97, e quei cinque punti sono tutto il mestiere. Per le entità si giudica a evidenziature intere, confini e colore compresi, perché mezza persona non serve a nessuno.
Da ricordare
Il POS tagging assegna a ogni parola la sua categoria grammaticale: lo standard è il tagset universale a 17 categorie di Universal Dependencies. Le parole ambigue («porta», «ancora») sono poche nel vocabolario ma frequentissime nei testi: decide il contesto.
Il NER trova persone, luoghi, organizzazioni e date; lo schema BIO (
B-X,I-X,O) lo trasforma in un’etichetta per token e tiene distinte le entità adiacenti, purché siano piatte e non sovrapposte. La variante IOB2 mette laBsu ogni entità, la IOB1 dei dati originali del CoNLL-2003 solo fra due entità contigue dello stesso tipo.Lo HMM è un modello generativo con stati nascosti (le etichette) e osservazioni (le parole): \(P(t,w) = \prod_i P(t_i \mid t_{i-1}) P(w_i \mid t_i)\); transizioni ed emissioni si stimano come frequenze relative su un corpus annotato, con un modello a parte per le parole sconosciute. La stessa macchina, con i suoni al posto delle etichette, regge il riconoscimento vocale storico.
L’algoritmo di Viterbi trova la sequenza di stati ottima con la programmazione dinamica sul traliccio: \(O(n\,T^2)\) invece di \(O(T^n)\), tenendo in ogni casella solo il miglior cammino in arrivo. I CRF sono la variante discriminativa, e la loro normalizzazione globale evita il label bias dei MEMM.
Il tagger neurale è una BiLSTM con testa lineare per token e cross-entropia per token: la bidirezionalità è legittima perché il testo è tutto disponibile. ELMo vi aggiunge rappresentazioni contestuali da un modello di linguaggio bidirezionale congelato, combinate per strato (\(\gamma \sum_j s_j \mathbf{h}_{k,j}\)): è l’approccio feature-based. Oggi il NER di punta è fine-tuning di BERT.
Valutazione: accuratezza per token per il POS (con un baseline già al 92% sull’inglese, tagset Penn), F1 a livello di entità con exact match per il NER; perché mezza entità è un’entità sbagliata.