


Agenti: quando i modelli linguistici agiscono#
Fra rispondere bene a una domanda e portare a termine un lavoro c’è un salto, e qualcuno ha provato a misurarlo con una gara di riparazioni. La gara prende 2.294 segnalazioni di errore reali, inviate dagli utenti agli autori di un programma quando qualcosa non funziona, tratte da dodici progetti open source scritti in Python, e le usa come compiti d’esame: al sistema si dà la segnalazione insieme al codice del progetto, e deve produrre la correzione. Si chiama SWE-bench [JYW+24].
A dire se ha funzionato non c’è una persona, ma i test del progetto: pezzi di programma che gli sviluppatori scrivono apposta per controllare il proprio lavoro, e che a ogni modifica rispondono «a posto» oppure «rotto». Sono quelli che avevano approvato la correzione scritta, a suo tempo, da uno sviluppatore in carne e ossa, e sono di due specie: quelli che falliscono finché l’errore c’è e passano quando è corretto, e quelli che passavano già e devono continuare a passare, perché la correzione non rompa altro. Il sistema non li vede, e la segnalazione conta come risolta solo se li supera tutti. È un compito che nessun completamento di testo, per quanto scorrevole, chiude in un colpo solo: bisogna trovare i file giusti, provare, sbagliare, rileggere il messaggio d’errore, correggere. Nell’articolo che presentava la gara, nell’ottobre 2023, il migliore dei modelli provati, Claude 2, ne risolveva l’1,96%. Un numero così basso misura quanto costi tenere insieme molte mosse di fila. E la misura stessa, si scoprirà nella sezione sul valutare un agente, richiedeva cautela: rileggendo a mano i successi del sistema che nel 2024 guidava la classifica, una parte non derivava da capacità reali.
Che un modello possa agire, del resto, lo ha già mostrato la sezione sul passaggio dalla percezione all’azione: un braccio robotico comandato a token, che interviene fisicamente nel mondo, ma l’obiettivo lo riceve da qualcun altro («prendi la tazza»).
Fra il 2023 e il 2024 si diffondono i sistemi che decidono da sé quando smettere di scrivere e andare a guardare: cercano sul web una notizia di ieri, eseguono un pezzo di codice per controllare se gira, compilano un modulo, prenotano, propongono una correzione a un programma vero. È il mondo di SWE-bench, ed è il mondo degli agenti.
Prima di andare avanti, un paletto che vale per tutto quel che segue. Un modello è la rete che, dato un testo, ne predice la continuazione: quello che abbiamo studiato nel capitolo sui Transformer. Un agente è un sistema costruito attorno a un modello: un programma che guarda l’ambiente, lascia che il modello decida la mossa successiva, la esegue davvero, osserva com’è andata e ricomincia. L’ambiente è tutto ciò su cui l’agente può intervenire e da cui può ricevere informazioni: le pagine del web, i file di un computer, i servizi a cui si può chiedere qualcosa. Il modello sceglie la mossa; l’agente è tutto il resto, cioè il programma che gli prepara il contesto (il testo che il modello legge prima di scegliere: la richiesta, le mosse già fatte, i loro esiti), esegue la mossa scelta, ne raccoglie l’esito e decide quando fermarsi.
Dal completare testo all’agire#
Il primo passo fuori dal modello è stato piccolo, e si è visto nella sezione «Cercare per rispondere». Ha un nome, RAG, e Fig. 20.1 è lo schema con cui è stato presentato al mondo.

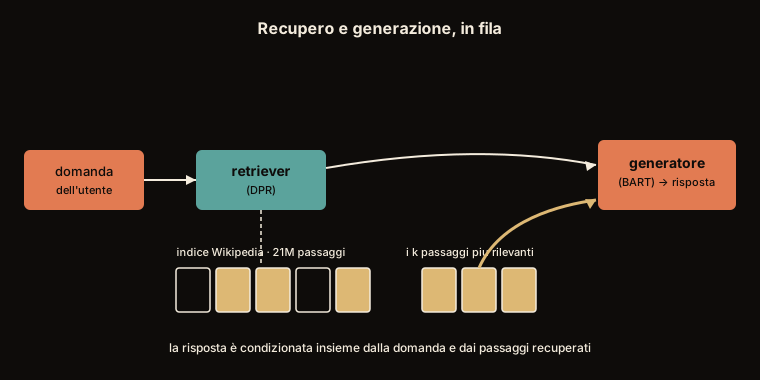
Fig. 20.1 Il disegno ha tre pezzi: chi cerca nell’archivio (in inglese il retriever, il cercatore), l’archivio stesso, che nell’articolo è fatto di ventun milioni di brani di Wikipedia, e chi scrive la risposta, il generatore. La domanda entra da sinistra, passa dal cercatore e arriva a chi scrive insieme ai pochi brani che il cercatore ha pescato, i primi \(k\) della sua classifica. Le due sigle sul disegno, DPR e BART, sono i nomi dei due modelli che l’articolo usa per cercare e per scrivere. La conoscenza, così, non sta più tutta dentro il modello.#
Le tre lettere stanno per Retrieval-Augmented Generation, cioè «generazione aiutata da un recupero», e sono di Lewis e colleghi [LPP+20]. Quel che fa si dice in una riga: prima di scrivere la risposta, il sistema va a prendere da un archivio i brani che riguardano la domanda e li mette davanti al modello. È il primo passo del modello fuori da sé, ma la catena resta fissa: cerca sempre, una volta sola, e poi scrive. Che sia il modello a decidere se e quando cercare è la novità degli agenti.
Il «fuori di sé» va preso alla lettera. Quello che un modello sa sta nei suoi pesi, fissati dall’addestramento e invariati finché lo si usa: è la sua memoria parametrica, e aggiornarla vuol dire riaddestrare. La RAG sposta una parte della conoscenza in un archivio esterno, una memoria non parametrica, che si corregge e si aggiorna senza toccare i pesi.
Perché il completamento di testo, da solo, non basta? Perché agire è un processo: richiede più mosse in sequenza, ciascuna scelta in base all’esito della precedente. Comprare un biglietto significa cercare i treni, confrontare gli orari, scegliere, pagare, ricevere la conferma, e se a metà strada il treno scelto risulta pieno, tornare indietro e riprovare. Una risposta sola, scritta tutta d’un fiato, non può farlo.
Quell’andirivieni (una mossa, il suo esito, la mossa seguente decisa alla luce dell’esito) si chiama ciclo dell’agente.
Un consulente ti dà consigli a parole: «per andare a Milano ti conviene il treno delle 9, poi prenota un hotel in centro». Ottimo, ma il lavoro resta tutto a te: sei tu che apri il sito, digiti le date, paghi. L’assistente, invece, le cose le fa: telefona, prenota, compila il modulo, ti mette in mano il biglietto. La stessa testa, ma con le mani.
Un agente è il salto dal consulente all’assistente. Il modello continua a essere il cervello (sa cosa andrebbe fatto) ma attorno gli mettiamo delle mani (gli strumenti) e un metodo di lavoro: fai una mossa, guarda com’è andata, decidi la prossima.
Quel metodo si regge su un elenco. L’assistente ci scrive tutto, in ordine: ho telefonato all’albergo, era pieno; ho provato quello accanto, ha una stanza libera. Prima di ogni telefonata rilegge l’elenco dall’inizio, perché è lì che sa a che punto è arrivato. E si ferma in due casi: quando ti mette il biglietto in mano, oppure quando le telefonate diventano troppe e torna da te a mani vuote invece di andare avanti all’infinito.
Quell’elenco è tutto ciò che sa del lavoro in corso. Se diventa troppo lungo e lo riduce a un riassunto, quello che ha cancellato non lo sa più: alla telefonata dopo decide su quello che è rimasto.
Se lavora male non lo rimandi a scuola: gli spieghi come vuoi che lavori («prima il preventivo, poi la prenotazione») e il giorno dopo si comporta in un altro modo. Quello che sa non è cambiato di una virgola.
Formalmente, un agente è un ciclo di controllo (osserva → ragiona → agisci → osserva) in cui il modello fa da policy: dato il contesto \(s_t\) campiona l’azione, \(a_t \sim \pi_\theta(\cdot \mid s_t)\), con \(\theta\) i pesi del modello. È la stessa nozione di policy vista nel capitolo sul reinforcement learning, ma qui lo «stato» è una sequenza di testo (il contesto accumulato: la richiesta, le mosse fatte, i loro risultati) e l’«azione» è, tipicamente, l’invocazione di uno strumento oppure la risposta finale. Lo \(s_t\) non è lo stato del mondo, che l’agente non vede: è la storia di ciò che ha osservato e fatto, quindi il problema è un POMDP, in cui la storia completa è sufficiente per decidere, purché rientri nella finestra. Quando il contesto viene troncato o riassunto, come nella sezione sul contesto, quella proprietà cade, e la policy decide su un riassunto della storia. A ogni passo:
il sistema fornisce al modello lo stato \(s_t\) (il contesto);
il modello genera un’azione \(a_t\), per esempio «cerca sul web X»;
il runtime esegue \(a_t\) e produce un’osservazione \(o_t\) (i risultati);
si aggiorna lo stato, \(s_{t+1} = s_t \oplus a_t \oplus o_t\), e si ricomincia,
dove \(\oplus\) denota la concatenazione al contesto e il ciclo termina quando il modello emette un’azione speciale di «risposta finale» o si raggiunge un limite di passi. La differenza cruciale con il reinforcement learning classico sta nel soggetto dell’ottimizzazione: chi costruisce l’agente, di norma, non ottimizza \(\theta\). La policy è un modello di linguaggio già addestrato (spesso proprio con ricompense ed episodi, nel post-training che gli ha insegnato a seguire istruzioni e a usare strumenti) e qui il suo comportamento si governa con istruzioni in linguaggio naturale: non si aggiornano i pesi, si scrive il prompt.
Al ciclo si aggiunge spesso un accorgimento: far «ragionare ad alta voce» il modello prima di agire. Invece di saltare all’azione, il modello scrive il proprio ragionamento («prima di correggere devo capire quale pezzo del programma si è lamentato») e solo dopo sceglie la mossa. Questa catena di ragionamento scritta ha un nome inglese che incontrerai dappertutto, chain-of-thought [WWS+22], e nel capitolo sui Transformer l’abbiamo vista far salire il numero di risposte giuste sui problemi che richiedono più passaggi.
Quel guadagno, però, è più circoscritto di come lo si racconta di solito: una rassegna dei risultati di oltre cento studi lo trova concentrato sui compiti matematici e simbolici, quelli in cui si manipolano numeri e regole (un conto, un’espressione algebrica, un problema di logica), e piccolo altrove [SYR+25]. In un agente la traccia scritta ha altre funzioni, che gli autori di ReAct hanno elencato guardando le tracce dei loro esperimenti: scomporre l’obiettivo in un piano, estrarre da un’osservazione la parte che serve, tenere il conto dei progressi, correggere il piano quando qualcosa va storto [YZY+23].
L’anatomia di un agente#
Smontiamo l’agente. Al di là delle mille varianti, ogni agente ha quattro ingredienti, e conviene tenerli distinti perché ognuno ha problemi suoi.
Il modello legge il contesto e sceglie la prossima azione: è il componente che decide, e tutto il resto è codice che gli sta attorno.
Gli strumenti (in inglese tool) sono le funzioni che l’agente può far eseguire: una ricerca sul web, un programma che esegue del codice al posto suo, una ricerca in un archivio di dati, la richiesta a un servizio esterno. Quest’ultima passa dalla sua API (dall’inglese application programming interface): l’insieme delle domande, scritte in un formato concordato, con cui un programma ne interroga un altro senza sapere niente di come sia fatto dentro. Gli strumenti sono ciò che permette all’agente di toccare il mondo: leggere dati freschi e produrre effetti.
Il ciclo di controllo è il metodo di lavoro: il programma che alterna percezione e azione, passa il contesto al modello, esegue l’azione scelta, raccoglie il risultato e decide se continuare o fermarsi. In inglese si dice loop, ed è la parola che si sente più spesso.
La memoria è ciò che l’agente si porta dietro. Nel breve termine è la finestra di contesto: la quantità di testo, misurata in token, che il modello elabora in una volta sola, con dentro tutto quello che ha letto e scritto finora. È larga ma finita, e ogni token che ci entra si paga in memoria, in tempo e in denaro. Nel lungo termine è invece una memoria esterna: un archivio di documenti o di ricordi passati da cui pescare quando serve, senza tenere tutto in testa.

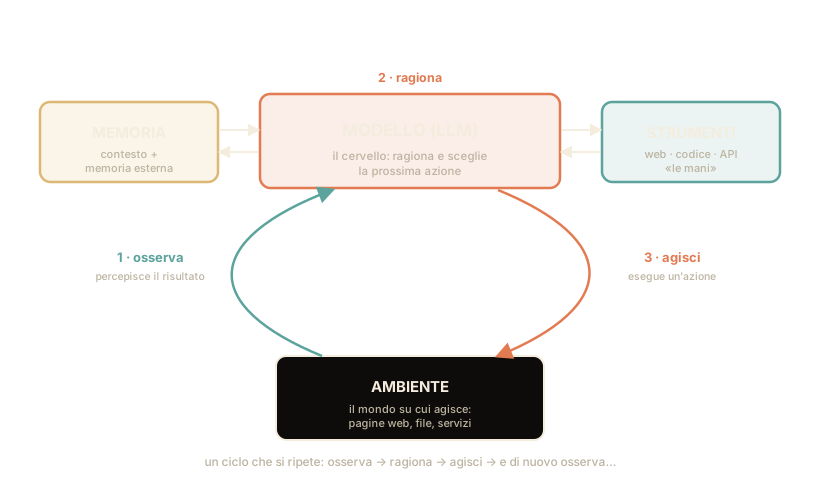
Fig. 20.2 I quattro ingredienti e il ciclo di controllo: il modello ragiona al centro, usa gli strumenti per agire sull’ambiente e la memoria per non ripartire ogni volta da zero. Il ciclo osserva → ragiona → agisci si ripete fino alla risposta.#
Come mostra Fig. 20.2, il modello non tocca mai il mondo direttamente: lo fa attraverso gli strumenti, e ogni azione torna indietro come un’osservazione che rientra nel contesto. Il passaggio più delicato è proprio questo, l’uso degli strumenti (in inglese tool use, ed è il nome che troverai ovunque). Come fa un modello che sa solo scrivere testo a mettere in moto un pezzo di programma? In informatica un pezzo di programma con un nome, che fa una cosa quando qualcuno lo invoca, si chiama funzione: la domanda, detta in gergo, è come faccia un modello a chiamare una funzione.
Il trucco è che il modello non esegue niente: scrive un bigliettino d’ordine. Un cuoco chiuso in cucina non può uscire in sala: quando gli serve qualcosa scrive un ordine su un foglietto («portami due uova») e lo passa a un cameriere. Il cameriere va, prende le uova, torna e le posa sul bancone. Il cuoco non è mai uscito dalla cucina, ma le uova sono arrivate.
Il cuoco però non ordina quello che gli passa per la testa: sulla parete c’è un cartello con le cose che si possono chiedere e come si scrivono («uova, quante»). Un foglietto scritto fuori da quel cartello il cameriere non lo capisce, e torna a mani vuote.
Con un agente succede lo stesso. Il modello, invece delle uova, scrive «cerca_sul_web(previsioni Roma domani)», e il cartello sulla parete è l’elenco degli strumenti che gli abbiamo descritto. Non è lui a navigare: il programma che gli sta attorno legge quel foglietto, esegue davvero la ricerca e gli riporta i risultati, che il modello ritrova nel contesto al giro dopo, come il cuoco ritrova le uova sul bancone.
Chi esce in sala decide anche che cosa non fare: se sul foglietto c’è «svuota la cassa», il cameriere resta fermo, perché le chiavi della cassa ce le ha lui e non il cuoco. Con un agente è il programma, e non il modello, a decidere che cosa si esegue davvero. E il bancone ha una misura: foglietti e piatti consegnati restano lì tutti, e a fine serata non c’è più posto per appoggiare niente. Il bancone del modello è la sua finestra di contesto, e ogni chiamata la riempie un po”.
Meccanicamente, una chiamata a strumento è testo strutturato che il modello impara a produrre. Al modello si descrivono, nel prompt, gli strumenti disponibili (nome, cosa fanno, quali argomenti accettano) di solito con uno schema formale (spesso JSON). Quando decide di usarne uno, il modello non esegue nulla: emette una stringa che rappresenta la chiamata, per esempio
cerca_sul_web(query="previsioni meteo Roma domani")
Il runtime dell’agente intercetta questa stringa, la interpreta, esegue davvero la funzione corrispondente nel codice ospite, e appende l’osservazione (l’esito della funzione) al contesto. Al passo successivo il modello vede la propria richiesta e la risposta, e prosegue il ragionamento.
Due conseguenze pratiche. Primo: la separazione è netta, il modello propone, il runtime dispone; l’esecuzione effettiva (con i suoi permessi, i suoi limiti, i suoi controlli di sicurezza) resta fuori dal modello, ed è lì che si bloccano le azioni pericolose. Secondo: ogni chiamata è del testo che entra e del testo che esce, e quindi consuma finestra di contesto; un loop lungo la riempie in fretta, ed è il problema da cui parte la sezione sul contesto.
Perché adesso#
Tre dei quattro ingredienti appena elencati (qualcosa che decide, degli strumenti, un ciclo che li mette in moto) non sono un’idea nuova. Alla fine degli anni Sessanta, allo Stanford Research Institute, il robot Shakey è stato il primo a mettere insieme percezione, pianificazione ed esecuzione [RN20]: osservava la stanza, pianificava le mosse con il pianificatore STRIPS [FN71], le eseguiva e ne sorvegliava l’esito, rifacendo il piano quando il mondo non era come previsto. Era un agente a tutti gli effetti, con regole e simboli scritti a mano da un programmatore. Quello che gli mancava era un modo di capire una consegna che nessuno avesse tradotto prima in simboli.
Perché allora gli agenti basati su LLM, sui grandi modelli linguistici (large language model), nascono solo ora? Perché questi modelli hanno acquisito da poco proprio quella capacità: capire ed eseguire una consegna scritta come la si scriverebbe a una persona, in linguaggio naturale, senza che qualcuno ne programmi i casi uno per uno.
Prima, per far usare uno strumento a un programma, dovevi scrivergli tu, riga per riga, quando e come usarlo: nessuna sorpresa era ammessa, tutto andava previsto in anticipo. Era come istruire qualcuno che esegue alla lettera e non capisce una parola fuori copione.
Gli LLM di oggi hanno imparato, durante l’addestramento, a seguire istruzioni scritte come le scriveresti a una persona: «hai a disposizione una ricerca web; usala quando ti serve un’informazione che non conosci». Non devi più programmare ogni caso: descrivi lo strumento e l’obiettivo, e il modello capisce da sé quando ha senso usarlo.
C’è dell’altro. Un commesso che sa già il mestiere, il primo giorno in un negozio nuovo, lo metti al lavoro con mezza pagina di istruzioni sul bancone: «se chiedono una taglia che non c’è, guarda nel magazzino di sotto», e sotto un caso capitato ieri con la sua soluzione. Legge, e lavora così da subito. Nessun corso, nessun apprendistato: quelle righe sono bastate. Con il modello vale uguale: il mestiere l’ha imparato prima, durante l’addestramento, e quelle righe gli dicono soltanto come si lavora in questo negozio. Senza quell’addestramento a seguire istruzioni nessun foglio sul bancone basterebbe; con quello, basta il foglio.
Due proprietà, entrambe discusse nel capitolo sui Transformer, si combinano. La prima è l’instruction tuning: la fase di post-training in cui il modello viene addestrato su coppie istruzione → buona risposta, imparando a trattare una consegna in linguaggio naturale come qualcosa da eseguire, non solo da continuare. La seconda è l’in-context learning: la capacità, emersa con la scala, di adattarsi a un compito descritto (magari con qualche esempio) nel solo prompt, senza toccare i pesi. Messe insieme, rendono eseguibile una consegna come «ecco gli strumenti a tua disposizione, usali per raggiungere l’obiettivo»: il prompt diventa la specifica del comportamento dell’agente.
Due avvertenze, prima di andare avanti. La prima: gli agenti basati su LLM sono un campo giovane e in rapido movimento [XCG+23]. Manca una teoria che ne preveda il comportamento, e le pratiche in uso sono procedure provate su casi particolari, senza garanzia di funzionare altrove.
La seconda avvertenza è un problema strutturale: gli errori si sommano lungo il ciclo. Se il modello sbaglia una mossa su dieci, dieci mosse di fila senza un solo inciampo gli riescono poco più di una volta su tre. Su cento tentativi il primo passo ne lascia passare novanta, il secondo ottantuno, il terzo circa settantatré, e dopo dieci passi ne restano trentacinque. In simboli: se ogni passo sbaglia con probabilità \(p\) e gli errori sono indipendenti, cioè sbagliare un passo non rende più probabile sbagliare il successivo, la probabilità di attraversare \(n\) passi senza errori è \((1-p)^n\), che con \(p = 0{,}1\) e \(n = 10\) fa \(0{,}9^{10} \approx 0{,}35\). L’indipendenza è un’ipotesi comoda e poco realistica, e la sezione sul valutare un agente mostra che cosa cambia quando cade. La sostanza però tiene: non basta essere bravi a un passo, bisogna esserlo per molti passi di seguito, ed è una delle ragioni per cui compiti lunghi come quelli di SWE-bench [JYW+24] sono difficili.
Un antenato: i chatbot a regole#
Un antenato più vicino agli assistenti di oggi sta nel dialogo. Nel capitolo sul Natural Language Processing, parlando di dialogo e chatbot, abbiamo incontrato i primi programmi capaci di sostenere una conversazione.
Il primo è ELIZA, che negli anni Sessanta rispondeva rigirando le parole dell’interlocutore con schemi scritti a mano. Il secondo è GUS, del 1977, che faceva l’agente di viaggio: conduceva la conversazione riempiendo le caselle di un modulo (dove, quando, quanti) con domande mirate, e a modulo completo prenotava. I sistemi fatti così si chiamano a modulo, o a frame dalla parola inglese, e quel modulo mezzo pieno era la loro piccola memoria: l’unica cosa che si portavano dietro da una battuta all’altra.
Erano già agenti, a modo loro. Avevano una percezione, cioè quello che arriva dall’esterno; avevano delle azioni, cioè le risposte da dare e la prenotazione da fare; e in mezzo avevano una regola che, vista la situazione, sceglieva la mossa successiva. Quella regola si chiama politica, nel senso di linea di condotta (in inglese policy), ed è la stessa parola del capitolo sul reinforcement learning, l’apprendimento per tentativi e ricompense.
Il limite di quei sistemi era la rigidità. Un assistente a moduli sa fare benissimo ciò che è previsto: chiede dove, quando, quanti, e a modulo pieno prenota. «Vorrei il finestrino, ma solo se il viaggio dura più di tre ore» non ha nessuna casella dove entrare, e lui resta lì senza sapere che pesci prendere: ogni comportamento gliel’aveva scritto un programmatore, uno per uno.
Quelle caselle però davano qualcosa in cambio. Inventare non poteva, perché fuori dalle caselle non c’era dove scrivere; se qualcosa andava storto si vedeva quale era rimasta vuota; e alla fine il biglietto c’era o non c’era, quindi sapevi se aveva funzionato.
Al posto delle regole scritte a mano arriva un impiegato che capisce le parole. Il mestiere resta lo stesso (ascolta, decide, fa) e il finestrino dopo le tre ore lo capisce, insieme a mille richieste che nessuno aveva previsto. Il prezzo è che ti dice «fatto» con la stessa faccia sicura quando ha prenotato e quando ha capito male, e sulla stessa richiesta, due volte di fila, può comportarsi in due modi diversi. Per questo i due modi di lavorare convivono ancora: lo si lascia parlare libero con il cliente, e prima di pagare gli si fa comunque riempire il modulo, casella per casella.
Il salto è da una policy scritta a mano a una policy espressa in linguaggio. Nei sistemi a frame la logica di controllo era una macchina a stati esplicita: slot tipizzati, una domanda per ogni slot vuoto, transizioni codificate da un ingegnere. Robusta e prevedibile (nessuna risposta inventata, errori localizzabili, successo misurabile) ma incapace di uscire dallo spazio di stati previsto.
L’agente LLM tiene l’ossatura (uno stato, una policy, delle azioni) ma la policy diventa un modello di linguaggio orientato da un prompt, al posto di un diagramma di flusso. Lo spazio delle azioni si allarga enormemente, e con esso la copertura dei casi non previsti; in cambio si perde parte del controllo e della prevedibilità che rendevano affidabili i sistemi a frame. È uno scambio, non un rimpiazzo indolore, e i due mondi convivono ancora; spesso un agente flessibile viene racchiuso dentro binari rigidi proprio per riottenere un po’ di quelle garanzie.
Dal ciclo alla valutazione#
Le quattro sezioni che seguono riprendono uno per uno i pezzi montati fin qui.
Il ciclo dell’agente: come un modello chiama davvero gli strumenti e compone le azioni in sequenza (tool use, ReAct, la riflessione sugli errori), con il codice di un agente giocattolo.
RAG avanzato: il recupero dei documenti giusti prima di rispondere, oltre la forma base già vista nel capitolo sui Transformer (riscrivere la domanda prima di cercare, rimettere in ordine i risultati con un secondo giudice più attento, lasciare che sia l’agente a decidere quando cercare).
Il contesto è l’interfaccia: la finestra di contesto vista da un agente, cioè quanto ne consumano gli strumenti e la traccia, dove si tiene quello che non ci sta più, quanto costa far pensare il modello a voce alta.
Architetture e valutazione: come si compongono più agenti in un sistema, e il problema aperto di dare loro un voto, dove si chiude il discorso su SWE-bench [JYW+24]. Il problema gemello, come si dà un voto a un modello che si limita a rispondere quando non esiste una risposta giusta sola, ha un posto suo più avanti, con LLMOps.
Da ricordare
Un modello indovina come continua un testo; un agente è il sistema che gli mette attorno delle mani e un metodo di lavoro, così che non risponda soltanto ma agisca: cerchi, esegua, prenoti, corregga il codice. Il modello è il motore, l’agente è l’automobile.
Il cuore è un ciclo che si ripete, osserva → ragiona → agisci → osserva, con il modello nel ruolo di chi sceglie la mossa. Farlo «ragionare ad alta voce» prima di agire (la catena di ragionamento, in inglese chain-of-thought [WWS+22]) aiuta, ma soprattutto sui conti e sui problemi di logica [SYR+25].
I quattro ingredienti: il modello (il cervello), gli strumenti (le mani: cercare sul web, far girare del codice, interrogare un servizio esterno), il ciclo di controllo (guarda, agisci, riguarda) e la memoria (quello che tiene sott’occhio adesso, più un archivio esterno). Il modello scrive il bigliettino d’ordine; il programma che gli sta attorno lo esegue.
Gli agenti nascono adesso perché i modelli hanno imparato a capire una consegna scritta a parole: basta descrivere lo strumento e l’obiettivo, e mostrare un caso già risolto, invece di programmare ogni caso. È però un campo giovane [XCG+23], e i piccoli errori si sommano lungo il ciclo: nove mosse giuste su dieci vogliono dire arrivare in fondo a dieci mosse poco più di una volta su tre.
I chatbot a regole della sezione su dialogo e chatbot (ELIZA, i sistemi a modulo) sono gli antenati rigidi: bravissimi dentro il previsto, muti fuori. L’agente guadagna versatilità e perde prevedibilità: è uno scambio, non un regalo.
Per dare un voto a un agente su lavoro vero c’è SWE-bench [JYW+24]: segnalazioni di errore reali, giudicate dai test del progetto. Anche quel voto, però, va controllato.
Da ricordare
Un modello predice la continuazione di un testo; un agente è il sistema che gli mette attorno strumenti e un ciclo di controllo, così che non risponda soltanto ma agisca: cerchi, esegua, prenoti, corregga il codice.
Il cuore è un ciclo osserva → ragiona → agisci → osserva, con l’LLM nel ruolo di policy: campiona l’azione dato il contesto, \(a_t \sim \pi_\theta(\cdot \mid s_t)\), e il contesto è la storia delle osservazioni e delle azioni, non lo stato del mondo (un POMDP, che finché la storia entra nella finestra si decide sulla storia intera). Farlo «ragionare ad alta voce» (chain-of-thought [WWS+22]) aiuta, ma i guadagni misurati si concentrano su matematica e ragionamento simbolico [SYR+25]; in un agente la traccia scompone il compito, estrae dalle osservazioni, tiene il conto dei progressi [YZY+23].
I quattro ingredienti: il modello, gli strumenti (web, codice, API), il loop di controllo (percezione-azione) e la memoria (contesto + memoria esterna). Il modello propone le azioni; il runtime le esegue.
Gli agenti diventano possibili adesso perché gli LLM istruiti sanno seguire una consegna in linguaggio naturale: instruction tuning e in-context learning rendono eseguibile «usa questo strumento». È però un’area giovane [XCG+23], e gli errori si accumulano lungo il loop.
I chatbot a regole della sezione su dialogo e chatbot (ELIZA, sistemi a frame) sono gli antenati rigidi: l’agente LLM generalizza la stessa idea con un motore linguistico flessibile, guadagnando versatilità e perdendo prevedibilità.
SWE-bench [JYW+24] misura un agente su compiti reali: 2.294 segnalazioni di errore da dodici progetti Python, risolte solo se passano tutti i test del progetto, che il sistema non vede (nel 2023 il migliore dei modelli provati ne risolveva l’1,96%). Anche quella misura va messa alla prova.