


Audio oltre la voce#
Un mattino di primavera, punti il telefono verso una siepe e apri un’applicazione. Un merlo canta, invisibile tra le foglie, e sullo schermo compare un nome: Turdus merula. L’app si chiama BirdNET, nasce dal laboratorio di ornitologia della Cornell University insieme all’università tecnica di Chemnitz, e fa una cosa che cinquant’anni fa sarebbe sembrata magia: riconosce migliaia di specie di uccelli dal solo canto (un compito che a un umano richiede anni di orecchio allenato). Nessuna parola, nessuna frase: solo un fischio modulato, e un modello che sa a chi appartiene.
Il canto degli uccelli è solo un angolo di un mondo enorme. C’è la musica che un modello genera su richiesta, un brano al pianoforte che non è mai stato suonato da nessuno. C’è il sistema di sorveglianza di un magazzino che deve distinguere, nel buio, un allarme da una sirena lontana, il tintinnio di un vetro rotto dal rumore del vento. C’è il tecnico che, dal ronzio anomalo di un motore, capisce che un cuscinetto sta per cedere. Tutto questo è audio, ed è quasi tutto tranne la voce.
Quanto è grande questo mondo? Un’idea la dà AudioSet, il catalogo con cui Google, nel 2017, ha provato a mettere ordine [GEF+17]. Prima hanno fatto l’elenco dei suoni che esistono, ordinandolo ad albero dal generale al particolare, e ne sono venute fuori 632 categorie: dal latrato di un cane al colpo di tosse, dal fruscio della pioggia al suono di una chitarra elettrica. Poi hanno riempito quelle caselle ritagliando frammenti da dieci secondi da video di YouTube ed etichettandoli a mano, e oggi i frammenti raccolti sono oltre due milioni. Non tutte le caselle si sono riempite: alcune sono soltanto rami dell’albero, che raggruppano altre voci senza descrivere un suono; altre sono state tenute fuori dall’etichettatura perché troppo oscure o troppo facili da confondere; per altre ancora non si sono trovate abbastanza registrazioni. Nella raccolta che si scarica le categorie sono 527.
Un catalogo così fitto presuppone che i suoni che non sono parole si lascino distinguere l’uno dall’altro, e così è: la sorgente lascia nel segnale tracce regolari di timbro, di ritmo e di durata. Un temporale non comincia a caso; un motore che si sta guastando suona storto in un modo suo, riconoscibile. Quello che manca, rispetto a una lingua, è la sintassi, cioè un vocabolario di unità con un significato e le regole per combinarle.
Il riconoscimento vocale si dedicherà a un caso particolare e cruciale: la voce, dal parlato al testo e ritorno (ascoltare e parlare). Qui si guarda più in largo (sentire il mondo, non solo le parole di chi lo abita), e si gettano le fondamenta comuni ai due.
Il suono, oltre la voce#
Nel riconoscimento vocale il traguardo è sempre lo stesso: da un’onda sonora ricavare le parole giuste. Qui il traguardo cambia forma. Non c’è più necessariamente un testo in fondo: a volte vogliamo un’etichetta («questo è un violino»), a volte una lista di etichette valide insieme, i tag («pioggia, tuono, traffico»), a volte un suono nuovo che prima non esisteva.
Ed è diverso anche il suono da cui si parte. La voce è fatta in un modo tutto suo: i pochi suoni elementari di una lingua, il timbro che ciascuno di noi ha perché la gola e la bocca fanno da cassa, il ritmo di chi parla. Un accordo, un temporale o il rombo di un motore non seguono nessuna di quelle regole.
La differenza è quella tra due mestieri. Il primo è la stenografa che trascrive una riunione: sente parole e scrive parole, il senso sta tutto lì. Il secondo è il fonico di un teatro, che a occhi chiusi riconosce ogni cosa dal suono: «quello è un violino, quello un clacson in strada, là fuori sta arrivando un temporale». Non trascrive niente (non ci sono parole da trascrivere) eppure capisce benissimo cosa sta succedendo, e sul copione segna il secondo in cui il tuono comincia e quello in cui smette, perché l’attore deve attaccare la sua battuta appena il tuono è finito.
I due lavorano con le stesse orecchie. Quello che cambia è il foglio su cui finisce l’ascolto: righe di dialogo per l’una, nomi di suoni e istanti per l’altro.
Il riconoscimento vocale ci rende bravi come la stenografa. Il mestiere del fonico è un altro: dare un nome ai suoni, elencare tutto ciò che si sente in una scena, dire quando ciascuno comincia e finisce, e perfino inventarne di nuovi. Sono compiti diversi, su suoni diversi, e per la maggior parte non c’entrano niente con la voce.
Lo Speech Recognition è, formalmente, un problema di trascrizione di sequenze: da \(\mathbf{X} = (\mathbf{x}_1, \dots, \mathbf{x}_T)\) acustica a una sequenza di parole \(\hat{W}\). I compiti dell’audio generale hanno firme diverse:
classificazione, dato un segmento, un’unica etichetta su \(C\) classi (\(\hat{y} = \arg\max_c P(c \mid \mathbf{X})\): «violino» vs «pianoforte»);
tagging multi-etichetta, più eventi compresenti, ognuno presente o assente (\(\hat{\mathbf{y}} \in \{0,1\}^C\): pioggia e tuono e traffico insieme);
rilevazione temporale, quando comincia e finisce ogni evento;
generazione: campionare un \(\mathbf{X}\) nuovo da una distribuzione appresa, eventualmente condizionata da testo.
La radice comune è che le rappresentazioni tempo–frequenza restano quelle: la costruzione dello spettrogramma e della scala mel è la stessa per un colpo di tamburo e per una vocale, e a cambiare sono i parametri (la finestra standard di 25 ms è tarata sul parlato: abbastanza corta perché il tratto vocale si possa considerare stazionario, abbastanza lunga da contenere almeno due o tre periodi della fondamentale; chi lavora sulla musica allunga la finestra, per separare note vicine, e alza il numero di bande). Cambia poi tutto a valle (l’obiettivo, la funzione di perdita, l’architettura), perché la struttura statistica di musica e suoni ambientali non è quella, quasi-periodica e vincolata dal tratto vocale, del parlato.
Questi compiti non sono esercizi da laboratorio. Riconoscere i canti degli uccelli, moltiplicato per migliaia di microfoni in una foresta, diventa uno strumento per misurare la biodiversità senza disturbarla. Ascoltare il rumore di una macchina utensile e accorgersi che «suona storto» è manutenzione predittiva: si interviene prima che il pezzo si rompa. Distinguere un vetro infranto o un grido in una registrazione è sorveglianza acustica. E la classificazione di scene sonore («cucina», «stazione», «ufficio») aiuta un apparecchio acustico a regolarsi da solo a seconda di dove si trova chi lo indossa. Ogni volta, il punto di partenza è lo stesso: un suono che non è parola, e un modello che deve capirlo.
Le fondamenta, prima di tutto#
Il passaggio da un’onda di pressione ai numeri con cui lavora un modello lo costruisce la sezione Dal suono alle feature, ed è lo stesso per qualunque suono, voce compresa. I suoi pezzi sono questi:
il campionamento, che trasforma l’onda continua in una sequenza di misure, con il teorema di Nyquist a dettare quante ne servono al secondo (più del doppio della frequenza più alta che si vuole conservare), e la quantizzazione, che arrotonda ciascuna misura a uno di un numero finito di livelli;
la trasformata di Fourier, che scompone un tratto di segnale nelle frequenze pure di cui è fatto, e, applicata a finestre brevi una dopo l’altra, lo spettrogramma: l’immagine del suono, con il tempo su un asse e le frequenze sull’altro;
la scala mel e gli MFCC, che riscrivono e riassumono quell’immagine secondo la risoluzione dell’orecchio.
Da lì in poi torna spesso lo spettrogramma log-mel: uno spettrogramma con le frequenze riscritte sulla scala mel, più fitta sui suoni gravi e più rada sugli acuti come l’orecchio, e con le intensità passate al logaritmo, così che un sussurro e un urlo stiano sulla stessa scala. Lo si tratta come un’immagine a un canale, e vale identico per il canto di un merlo, per un accordo di chitarra, per il fragore di un temporale.
L’idea nuova: l’audio come sequenza di token#
La strada già battuta è quella di Fig. 23.1, in quattro passaggi: l’onda diventa immagine, e dall’immagine un modello ricava le parole. Le parole escono a destra, una per riquadro, e ciascun riquadro è un token: un simbolo preso da un insieme finito, fissato in anticipo. Il pezzo che un token rappresenta cambia da modello a modello (nel disegno una parola intera, altrove una sillaba o un frammento di suono), ma tutto si scrive con i simboli di quell’elenco. È la parola che regge il capitolo, e qui vale in questo senso stretto; altrove i Transformer chiamano token anche le tessere in cui tagliano un’immagine, che a nessun elenco finito appartengono.

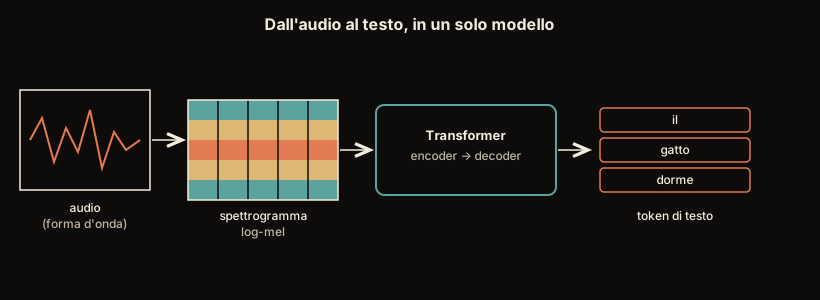
Fig. 23.1 La via classica, quella del riconoscimento vocale: l’onda diventa immagine, l’immagine diventa testo. Nel disegno il Transformer è un blocco solo, ma dentro fa due mestieri: la parte che legge (l’encoder) riassume lo spettrogramma e la parte che scrive (il decoder) ne ricava le parole, una alla volta. È la strada che il capitolo sullo Speech Recognition, subito dopo questo, percorre per intero. Il secondo modo di guardare l’audio, quello che viene dopo, sostituisce i primi due riquadri: al posto dell’onda e della sua immagine mette una fila di simboli, ricavata dall’onda e non dallo spettrogramma.#
C’è infatti un secondo modo di guardare l’audio, ed è il filo che tiene insieme tutti i modelli per l’audio. Poggia sulla distinzione fra discreto e continuo, la stessa che Probabilità e statistica usa per separare le due specie di variabile aleatoria, applicata qui a un segnale. Una grandezza è discreta se assume valori separati, presi da un insieme finito o al più numerabile: le ventuno lettere dell’alfabeto, fra la A e la B delle quali non si infila nulla. È continua se può assumere ogni valore di un intervallo, come la pressione dell’aria in un istante, o una sfumatura di grigio.
Un testo nasce discreto, perché è fatto di lettere. Un suono nasce continuo: l’onda di pressione che arriva all’orecchio non ha né scalini nel tempo né scalini nel valore. Dentro un calcolatore, però, quell’onda non c’è più. Quello che c’è è una fila di numeri interi presi da un elenco chiuso: ogni misura si scrive con sedici risposte sì/no, cioè sedici bit, e siccome ogni risposta raddoppia i casi possibili, ciascuna vale uno fra 65.536 livelli. Ogni livello è una lettera possibile, e un alfabeto, dunque, ce l’abbiamo già. È però l’alfabeto sbagliato, per due ragioni: le lettere sono troppe (65.536 contro una ventina), e arrivano troppo fitte, perché per il parlato si prendono sedicimila misure al secondo, contro le poche parole al secondo di chi parla. Da dove vengano i sedici bit e le sedicimila misure lo racconta Dal suono alle feature.
Lo spettrogramma di Fig. 23.1 il problema non lo risolve, lo sposta: le sue caselle sono numeri con la virgola, e di elenco chiuso non resta nemmeno l’ombra. Un modello che legge sa già trattarle così come sono (è ciò che fa l’encoder del disegno). Un modello che scrive un simbolo alla volta deve invece assegnare una probabilità a ciascun simbolo possibile della posizione successiva, e una probabilità così si distribuisce soltanto su un elenco: è la softmax dei modelli di linguaggio, che vuole un vocabolario finito. Si può generare anche senza alfabeto, predicendo direttamente numeri continui, oppure partendo da rumore e ripulendolo un passo alla volta: sono altre strade, e la sezione sulla generazione ne incontra una. La domanda del capitolo è allora questa: esiste per il suono un alfabeto abbastanza piccolo da imparare e abbastanza lento da arrivare in fondo a un brano? Se esiste, tutto l’armamentario costruito per il linguaggio diventa di colpo applicabile al suono.
Un testo è fatto di una manciata di lettere, un alfabeto finito, e con quelle poche decine di simboli si scrive qualsiasi cosa. Un modello di linguaggio ha imparato proprio questo: dato un pezzo di frase, indovinare il simbolo successivo, lettera dopo lettera, parola dopo parola.
Al suono si può dare lo stesso trattamento, e gli ornitologi lo fanno da sempre a mano: sul taccuino il canto appena sentito diventa «tsii-tsii-tsiuu», perché fra le sillabe che si sanno scrivere si prende ogni volta quella che somiglia di più. Il canto vero non era esattamente quello, e la differenza resta fuori dal taccuino; con tre sole sillabe a disposizione, tutti gli uccelli del bosco finirebbero per cantare uguale. Il rimedio ovvio, allargare il prontuario delle sillabe e spezzare il canto più fitto, costa dall’altra parte: il taccuino si riempie di pagine, e chi deve rileggerlo dall’inizio alla fine per indovinare come continua non ci arriva. Fra un alfabeto povero e un taccuino illeggibile ci sta tutto il mestiere dei codec neurali e della generazione.
Un modello fa lo stesso su qualunque suono, con un «alfabeto sonoro» tutto suo, costruito apposta: ritaglia il suono in pezzetti e a ciascuno dà il nome del pezzetto-tipo più somigliante, preso da un elenco fissato prima. Quel nome è un token, e sta a un pezzetto di suono come una lettera sta a una parola scritta. Da lì un brano musicale diventa una frase scritta in quell’alfabeto, e generare musica nuova diventa la stessa cosa che generare testo nuovo: indovina il pezzetto successivo, poi il prossimo, poi il prossimo. La macchina che scrive romanzi impara a comporre melodie, senza cambiare mestiere.
Il passaggio chiave è la quantizzazione: sostituire la rappresentazione continua dell’audio con una sequenza di indici discreti presi da un vocabolario appreso (un codebook di \(K\) vettori prototipo). Un breve segmento di segnale viene prima compresso da un encoder in un vettore latente, e a essere mappato sul prototipo più vicino è quel vettore, non il segnale: di esso si tiene solo l’indice intero, ed è il token. Con \(\mathbf{z}_i\) il latente del segmento \(i\) e \(\mathbf{e}_1, \dots, \mathbf{e}_K\) i prototipi,
che è la quantizzazione vettoriale del VQ-VAE [vdOVK17]. L’audio diventa così una fila di \(L\) interi, \(\mathbf{k} = (k_1, \dots, k_L)\) con \(k_i \in \{1, \dots, K\}\), esattamente la forma di un testo tokenizzato (con i codec a più codebook ogni passo porta più di un indice, e la fila diventa un fascio di file parallele: è materia della sezione sui codec). Quanto si accorci la fila lo decide il rapporto fra la frequenza di campionamento e quella dei latenti: un codec come EnCodec, a \(24\) kHz, produce \(75\) latenti al secondo, uno ogni \(320\) campioni, e trenta secondi di audio passano da \(720\,000\) campioni a \(L = 2250\) passi.
Da lì il collegamento con i modelli linguistici è diretto: un Transformer autoregressivo può modellare
dove \(k_i\) è il token audio in posizione \(i\) e ogni fattore è una softmax sulle \(K\) voci del codebook: la stessa fattorizzazione, parola per parola, del capitolo sui Transformer, con i token audio al posto delle parole. È la ricetta dietro sistemi come AudioLM e MusicLM: prima si impara un alfabeto del suono, poi ci si scrive sopra con un modello di linguaggio. Le due difficoltà (costruire un buon alfabeto che perda poco fedeltà, e modellare bene sequenze di token lunghissime) sono i due nodi che i codec neurali e i modelli di generazione devono sciogliere.
C’è un’asimmetria onesta da segnalare subito. Il testo nasce discreto: le lettere e le parole sono già simboli, l’alfabeto ce lo dà la lingua. L’audio no: è un’onda continua, e l’alfabeto sonoro non esiste in natura; va costruito, ed è di per sé un problema di apprendimento difficile. Un alfabeto troppo povero rende il suono metallico e irriconoscibile; e più lo si vuole fedele, più lunga diventa la fila di token da scrivere e da leggere, finché nessun modello ci arriva in fondo. Il compromesso è il mestiere dei codec neurali, ed è per questo che la loro costruzione deve precedere la generazione: senza un buon alfabeto, non c’è nulla su cui scrivere.
Dal riconoscere al generare#
Dal riconoscere al creare la strada è una sola: dare un nome ai suoni, imparare com’è fatto il suono senza che nessuno lo spieghi, costruirne l’alfabeto, e infine scriverci sopra suono nuovo.
Classificazione audio: dare un nome ai suoni. Come si passa dallo spettrogramma a un’etichetta o a una lista di tag, dalle prime reti convoluzionali (CNN) fino ai Transformer audio, con AudioSet come banco di prova.
Rappresentazioni auto-supervisionate: come un modello impara com’è fatto il suono senza che nessuno gli dica mai cosa sta ascoltando, sfruttando le montagne di audio che nessuno ha mai trascritto. È la strada che wav2vec 2.0 e i suoi parenti hanno percorso sulla voce.
Codec neurali, l’alfabeto sonoro di cui abbiamo appena parlato: come una rete impara a comprimere l’audio in pochi token e a ricostruirlo, fondendo compressione e apprendimento.
Generazione audio e musica: scrivere suono nuovo. Prima un campione alla volta (WaveNet), poi i token di un codec prodotti da un Transformer, e infine lo spartito al posto del suono. Accanto, la diffusione, il metodo nato per le immagini che parte da rumore puro e lo ripulisce un passo alla volta, e che il capitolo sui modelli di diffusione racconta per intero più avanti nel libro.
Un filo, quattro nodi: si parte dall’ascoltare per arrivare a comporre, e in mezzo c’è sempre la stessa idea (trasformare il suono in qualcosa che una rete sa maneggiare, che sia un’immagine tempo–frequenza o un alfabeto di token).
Da ricordare
L’audio è molto più della voce: musica, suoni dell’ambiente, versi di animali. AudioSet [GEF+17] (oltre due milioni di frammenti da dieci secondi presi da YouTube, su 527 categorie di suoni) dà l’idea di quanto sia grande il mondo che c’è là fuori.
Cambiano le domande: non più (solo) «che cosa ha detto», ma «che suono è questo», «quali suoni ci sono in questa registrazione», «quando comincia ciascuno», e perfino «fammene sentire uno nuovo».
Il punto di partenza (come un suono diventa numeri, e i numeri un’immagine) lo costruisce la prossima sezione, Dal suono alle feature, e vale per qualsiasi suono: è il punto da cui ripartono tutte le sezioni che seguono, e il capitolo sul riconoscimento vocale insieme a loro.
Il filo conduttore: se il suono si può scrivere con un alfabeto di poche migliaia di simboli e non troppi al secondo (i token), allora la stessa macchina che indovina la parola successiva di una frase può indovinare il pezzetto di suono successivo di un brano. Un alfabeto ce l’abbiamo già, quello dei livelli con cui si misura l’onda, ma ha troppe lettere e troppo fitte.
I quattro nodi: riconoscere i suoni, imparare dal suono senza etichette, costruire l’alfabeto, generare suono nuovo.
Da ricordare
L’audio è molto più della voce: musica, suoni ambientali, bioacustica. AudioSet [GEF+17] (ontologia di 632 categorie; la raccolta pubblicata conta oltre 2 milioni di clip da YouTube su 527 classi) dà la scala del problema.
Cambiano i compiti: non più (solo) trascrivere, ma classificare, taggare più eventi insieme, rilevarne l’istante, generare suono nuovo. Il segnale di musica e ambiente ha una struttura diversa da quella del parlato.
Le feature di base (campionamento, quantizzazione, spettrogramma, scala mel, MFCC) sono costruite nella prossima sezione, Dal suono alle feature, e valgono per qualsiasi suono: sono il punto di partenza comune, e non si ripetono più.
Il filo conduttore: l’audio digitale è già discreto (interi su \(2^{16}\) livelli, decine di migliaia al secondo), ma quell’alfabeto ha troppe lettere e troppo fitte (WaveNet ci scrive riducendole a \(256\), e paga un passo per campione). Serve un vocabolario appreso, piccolo e a passo lento, su cui una softmax autoregressiva si possa distribuire; allora tutto l’armamentario dei Transformer diventa applicabile. È il ponte verso i codec neurali e la generazione.
I quattro nodi: classificazione, rappresentazioni auto-supervisionate, codec neurali, generazione audio e musica.
Si comincia dal basso, cioè da che cosa diventa un suono quando entra in un calcolatore: misure, livelli, frequenze, e l’immagine che le mette in fila. È la sezione Dal suono alle feature, e il resto del capitolo, compreso l’alfabeto che si sta cercando, ci si appoggia.