


Il salto probabilistico: l’ELBO e la riparametrizzazione#
La sezione precedente si è chiusa con una diagnosi: l’obiettivo dell’autoencoder, la sola ricostruzione, non dice niente su come si dispongono i codici, e da un latente così non si sa pescare.
Si cambia allora obiettivo, e in modo radicale. La domanda nuova è: quanto era probabile che uscisse proprio questa cifra? Cioè si massimizza \(\log p_\theta(\mathbf{x})\), la log-verosimiglianza dei dati sotto il modello a variabile latente dell’apertura del capitolo. A prima vista sembra un peggioramento, perché \(p_\theta(\mathbf{x})\) è proprio l’integrale che non si sa calcolare. Il resto della sezione racconta come mai è invece la domanda giusta, e come mai la regola che all’autoencoder mancava, quella su dove vanno messi i codici, non bisogna aggiungerla: scaturisce da sola dal tentativo di approssimare quell’integrale.
Il percorso è in quattro passi: l’integrale che non si può calcolare; la distribuzione di proposta \(q_\phi(\mathbf{z} \mid \mathbf{x})\), che dice dove guardare; il limite inferiore che ne esce, l’ELBO, con due termini dai significati netti; e la riparametrizzazione, senza la quale il gradiente non arriverebbe all’encoder.
Il conto che non si può fare#
L’apertura del capitolo lo ha già detto a parole, con i sacchetti di biglie: la probabilità di un dato è la somma, su tutte le cause nascoste possibili, di quanto ciascuna lo spiega, contata per quanto quella causa stessa era probabile. Con due sacchetti la somma ha due addendi; con un latente continuo di \(L\) numeri è un integrale su \(\mathbb{R}^L\).
L’istinto dice: se sommare tutto non si può, si tira a sorte. Pesco mille schede a caso, guardo quanto ciascuna spiega bene la cifra che ho in mano, faccio la media, e ho una stima. È un metodo onesto e in tanti problemi funziona.
Qui non funziona, e la ragione è semplice da dire e sorprendente da vedere: fra tutte le schede possibili, quelle che spiegano questa cifra sono pochissime. Pescandone mille a caso, quasi tutte descrivono qualcosa che con la nostra cifra non c’entra niente, e valgono zero. Il valore vero sta tutto dentro le pochissime che hanno avuto fortuna, e se quelle non capita di pescarle, la media viene fuori troppo bassa e nessuno se ne accorge.
Il guaio peggiora in fretta man mano che la scheda si allunga. Con una scheda da un numero solo la fortuna capita quasi sempre; con una da quaranta non capita mai. È lo stesso motivo per cui indovinare una parola di quattro lettere tirando a caso si può fare e indovinarne una di quaranta no: con quattro lettere dell’alfabeto italiano le parole possibili sono circa duecentomila, con quaranta il loro numero ha cinquantatré cifre. Le possibilità non crescono, si moltiplicano.
La stima Monte Carlo dal prior,
dove \(S\) è il numero di campioni e \(\mathbf{z}^{(s)}\) l’\(s\)-esimo, è non distorta per \(p_\theta(\mathbf{x})\) ma inutile in pratica. Il motivo è che \(p_\theta(\mathbf{x} \mid \mathbf{z})\), come funzione di \(\mathbf{z}\), è concentrata in una regione la cui massa sotto il prior decade esponenzialmente con \(L\): la somma è dominata da pochissimi termini, e la sua varianza relativa cresce anch’essa esponenzialmente.
Due conseguenze si misurano su un caso in cui \(p_\theta(\mathbf{x})\) si conosce in forma chiusa. La prima: in scala logaritmica la stima è distorta verso il basso, perché \(\log\) è concava e la disuguaglianza di Jensen impone \(\mathbb{E}[\log \hat{p}] \le \log \mathbb{E}[\hat{p}] = \log p_\theta(\mathbf{x})\). La seconda: la quota che il campione più grosso si prende sul totale è la misura diretta del guasto, e passa da una briciola a un terzo del totale mentre \(L\) va da 1 a 40.
Il modello del blocco che segue è un giocattolo, scelto apposta perché la risposta giusta si conosce in anticipo e ci si può confrontare invece di fidarsi. La causa nascosta è un vettore sorteggiato attorno allo zero, il dato è quella causa più un po’ di scarto sorteggiato anche lui, e in un caso così semplice la probabilità del dato si sa scrivere con carta e penna.
Nella tabella «dimensioni» vuol dire quanti numeri ha la causa nascosta, ed è il conto che si allunga da uno a quaranta. Le colonne «vero» e «stimato» riportano il logaritmo naturale della probabilità, perché la probabilità stessa è troppo piccola per leggersi: a quaranta dimensioni vale circa \(e^{-47}\), un numero con venti zeri dopo la virgola. In questa scala la differenza fra due valori si legge in nat, e ogni nat è un fattore 2,718 fra le due probabilità: dieci nat di scarto sono dieci fattori 2,718 uno dopo l’altro, cioè una probabilità ventiduemila volte più piccola. La colonna che conta è quella dell’errore, la differenza fra stimato e vero.
import math
import torch

torch.manual_seed(0)
torch.set_num_threads(1)      # numeri riproducibili su qualunque macchina

# modello giocattolo: z ~ N(0, I), x|z ~ N(z, sigma^2 I). Qui p(x) si sa:
# marginalizzando due gaussiane ne esce una sola, N(0, (1 + sigma^2) I).
SIGMA, CAMPIONI = 0.5, 100_000


def log_p_vero(x):
    var = 1 + SIGMA ** 2
    return (-0.5 * (x ** 2).sum() / var
            - 0.5 * len(x) * math.log(2 * math.pi * var)).item()


def log_p_stimato(x, campioni=CAMPIONI):
    """La media di p(x|z) su z sorteggiati dal prior, in scala logaritmica."""
    z = torch.randn(campioni, len(x))
    log_p_x_dato_z = (-0.5 * ((x - z) ** 2).sum(1) / SIGMA ** 2
                      - 0.5 * len(x) * math.log(2 * math.pi * SIGMA ** 2))
    return torch.logsumexp(log_p_x_dato_z, 0).item() - math.log(campioni), log_p_x_dato_z


print(f"{'dimensioni':>10} {'log p(x) vero':>14} {'stimato':>10} "
      f"{'errore':>8} {'peso del piu grosso':>21}")
for L in (1, 2, 5, 10, 20, 40):
    x = torch.full((L,), 0.6)          # un dato qualunque, lo stesso in ogni dimensione
    stima, pesi = log_p_stimato(x)
    quota = (pesi.max() - torch.logsumexp(pesi, 0)).exp().item()
    print(f"{L:>10} {log_p_vero(x):>14.2f} {stima:>10.2f} "
          f"{stima - log_p_vero(x):>8.2f} {quota:>20.1%}")
dimensioni  log p(x) vero    stimato   errore   peso del piu grosso
         1          -1.17      -1.17     0.00                 0.0%
         2          -2.35      -2.35     0.00                 0.0%
         5          -5.87      -5.86     0.01                 0.1%
        10         -11.75     -11.83    -0.08                 2.1%
        20         -23.49     -24.27    -0.78                20.6%
        40         -46.98     -57.04   -10.06                35.1%
Con una causa nascosta da un numero solo, centomila sorteggi danno la risposta esatta a due cifre decimali. Con quaranta numeri sbagliano di dieci nat, cioè stimano una probabilità ventiduemila volte più piccola di quella vera. E l’errore, salendo di dimensione, è tutto dalla stessa parte: per difetto. Con poche dimensioni la stima oscilla ancora nei due versi (a cinque il segno è positivo per un centesimo), ma la spinta verso il basso diventa schiacciante quando le dimensioni crescono. La colonna a destra dice perché: su centomila sorteggi, uno solo si prende il trentacinque per cento del totale. Non stiamo facendo una media, stiamo aspettando un colpo di fortuna.
E il latente delle nostre cifre ha otto numeri soltanto. Quello che permette a Stable Diffusion, il modello che disegna un’immagine a partire da una frase scritta, di girare su un computer di casa, ne ha sedicimila.
Campionare dove serve: la posterior approssimata#
Se il problema è che si pesca nel posto sbagliato, la soluzione è pescare nel posto giusto, e il posto giusto dipende dal dato: sono i valori del latente compatibili con questa cifra, cioè la posterior \(p_\theta(\mathbf{z} \mid \mathbf{x})\) (dall’inglese, «ciò che viene dopo»: quello che si sa della causa nascosta dopo aver visto il dato, come il prior è quello che se ne sa prima). Calcolarla non si può, ma la si può approssimare con una rete che guarda \(\mathbf{x}\) e propone una distribuzione sul latente: l’encoder, che qui si scrive \(q_\phi(\mathbf{z} \mid \mathbf{x})\).
La mossa è allora questa. Invece di sorteggiare dal prior, si sorteggia da \(q_\phi(\mathbf{z} \mid \mathbf{x})\), e si corregge il conto pesando ogni campione per il rapporto fra la probabilità che aveva sotto il modello e quella che aveva sotto la proposta. È il campionamento per importanza, lo stesso importance sampling dei metodi Monte Carlo del reinforcement learning: se la proposta somiglia alla posterior i pesi sono quasi uguali, e la stima ha poca varianza. L’encoder fa lo stesso mestiere di quello della sezione precedente, con una differenza sola: non propone un codice, propone una zona.
Devi trovare una persona in una città che non conosci. Il metodo a sorte è aprire l’elenco del telefono a caso e chiamare: in una città grande non la trovi mai. Il metodo sensato è chiedere a qualcuno che la conosce «in che quartiere abita?», andare lì, e cercare in quel quartiere.
Cercando solo dove ha detto lui non si perde niente: il conto si corregge apposta per il fatto che si è guardato in una fetta sola, e resta giusto. (Serve una sola condizione: che il conoscente non escluda mai del tutto un quartiere dove la persona potrebbe abitare, perché lì nessuno andrebbe a cercarla e il conto non se ne accorgerebbe. Qui il suo consiglio è una zona sfumata, che si dirada allontanandosi ma non chiude fuori nessun quartiere, e la condizione vale sempre.) Quello che ne esce, però, è una stima prudente e non la probabilità vera, cioè un numero che sta sicuramente sotto a quello giusto.
Perché sotto e non sopra? Non per via della fetta, ma per l’ordine di due operazioni. I numeri in gioco sono minuscoli, e per maneggiarli si schiacciano: di ciascuno si tiene solo quanti zeri ha, il suo ordine di grandezza (i matematici lo chiamano logaritmo). Prendi 1 e 100: la loro media è 50,5. Schiacciati diventano 0 e 2, la cui media è 1; e 1, rigonfiato, torna a valere 10. Dieci invece di cinquanta: il 100, che nella media vera si prendeva quasi tutto, nella media dei numeri schiacciati non pesa quasi niente. Noi sappiamo calcolare soltanto la media dei numeri schiacciati, e il valore vero, la media dei numeri veri, sta sempre più in alto.
Il divario fra la stima e il vero dipende da una cosa sola, da quanto il consiglio era buono: se il conoscente sapeva davvero il quartiere, il divario è quasi zero; se ha tirato a indovinare, è grande.
Qui c’è il regalo, ed è la ragione per cui tutto questo funziona. Noi vorremmo due cose: un modello che spieghi bene i dati, e un archivista che sappia dire dove guardare. Spingendo in alto la stima prudente si lavora su tutte e due insieme, perché quel numero sale sia quando il modello migliora, sia quando il consiglio dell’archivista si fa più preciso. Una sola cosa da spingere in alto, due mestieri che imparano. (Che salgano davvero tutti e due, e non uno a spese dell’altro, è quasi sempre vero e non sempre.)
La via più battuta per arrivare all’ELBO passa dalla disuguaglianza di Jensen. Qui si segue quella di Kingma e Welling [KW19], che di disuguaglianze non ne usa nessuna: scrive un’identità esatta e legge il limite fra i suoi addendi. Costa un passaggio in più e restituisce ciò che l’altra strada perde per via, cioè non soltanto che il limite sta sotto, ma di quanto.
Si introduce una distribuzione ausiliaria \(q_\phi(\mathbf{z} \mid \mathbf{x})\), detta modello di inferenza o posterior approssimata, con parametri \(\phi\) condivisi da tutti i dati. L’inferenza variazionale classica ottimizza una distribuzione separata per ogni esempio; qui una sola rete la produce per qualunque \(\mathbf{x}\) con una passata in avanti, ed è l’inferenza variazionale ammortizzata [KW19]. Il prezzo è che una rete condivisa può approssimare la posterior di un singolo dato peggio di un’ottimizzazione dedicata, e il divario che segue ne risente. Poi si scrive un’identità esatta. Poiché \(p_\theta(\mathbf{x})\) non dipende da \(\mathbf{z}\), la si può mettere dentro un valore atteso rispetto a \(q_\phi\) senza cambiarla:
dove i passaggi sono tre: la log-verosimiglianza si può mettere dentro un valore atteso rispetto a \(q_\phi\) perché non dipende da \(\mathbf{z}\) e perché \(q_\phi\) è normalizzata; poi si applica la definizione di probabilità condizionata, \(p_\theta(\mathbf{z} \mid \mathbf{x}) = p_\theta(\mathbf{x}, \mathbf{z}) / p_\theta(\mathbf{x})\); e infine si moltiplica e si divide per \(q_\phi(\mathbf{z} \mid \mathbf{x})\) dentro il logaritmo, spezzandolo poi in due. È quest’ultimo passaggio, non i primi due, a far comparire l’ELBO. (Perché il secondo dei due addendi sia finito serve che \(p_\theta(\mathbf{z} \mid \mathbf{x})\) sia positiva ovunque lo sia \(q_\phi(\mathbf{z} \mid \mathbf{x})\), cioè che l’encoder non proponga zone che il modello dichiara impossibili. Qui la condizione è soddisfatta sempre, ma per due ragioni e non per una: la posterior vera è proporzionale a \(p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})\), e con un prior gaussiano e una verosimiglianza positiva ovunque nessuno dei due fattori si annulla.) I due addendi hanno un nome: il primo è l’ELBO (evidence lower bound, limite inferiore dell’evidenza), il secondo è la divergenza di Kullback–Leibler fra la posterior approssimata e quella vera. L’ordine degli argomenti, con \(q_\phi\) a sinistra, lo decide il campionamento: i valori attesi si prendono rispetto a \(q_\phi\) perché da \(q_\phi\) si sa campionare, mentre l’ordine inverso chiederebbe campioni dalla posterior vera, cioè proprio quello che manca. Quindi
dove \(\mathcal{E}_{\theta,\phi}(\mathbf{x})\) è l’ELBO, e la disuguaglianza vale perché una divergenza di Kullback–Leibler non è mai negativa. Ne discendono i due fatti che reggono tutto il metodo [KW19]:
il divario fra l’ELBO e la log-verosimiglianza vera è la distanza fra la posterior approssimata e quella vera. Non la limita, la eguaglia. Un encoder perfetto rende l’ELBO esatto;
massimizzando l’ELBO rispetto a \(\theta\) e \(\phi\) insieme si ottengono due cose con un’azione sola: si spinge in alto (approssimativamente) \(\log p_\theta(\mathbf{x})\), cioè si migliora il modello generativo, e si stringe il divario, cioè si migliora l’encoder. È il «due al prezzo di uno» di Kingma e Welling.
La strada di Jensen, per confronto, parte dal campionamento per importanza, che la stessa \(q_\phi\) rende esatto:
purché \(q_\phi\) sia positiva dove lo è la posterior. Il rapporto è la correzione per aver pescato dove l’encoder suggeriva invece che dal prior; con \(S\) campioni da \(q_\phi\) dà uno stimatore non distorto di \(p_\theta(\mathbf{x})\), di varianza tanto più piccola quanto \(q_\phi\) è vicina alla posterior, ed è quello con cui si valuta un VAE già addestrato [KW19]. Portare il logaritmo dentro il valore atteso dà, per Jensen, l’ELBO; portarlo dentro soltanto dopo aver mediato \(K\) pesi dà
il limite dell’importance weighted autoencoder [BGS16], che per \(K = 1\) è l’ELBO, non decresce con \(K\) e, se il peso \(p_\theta(\mathbf{x}, \mathbf{z}) / q_\phi(\mathbf{z} \mid \mathbf{x})\) è limitato, tende a \(\log p_\theta(\mathbf{x})\) per \(K \to \infty\). Il prezzo è quello della stima dal prior, attenuato: in alta dimensione i pesi tornano a concentrarsi su pochi campioni, e la stima costa \(K\) passate del decoder per ogni dato.
Come funziona la diffusione, più avanti, userà una versione ripesata di questo stesso limite, e chi ci arriverà riconoscerà l’oggetto. E chi arriva dalla sezione su riduzione e clustering riconosce la struttura dell’algoritmo EM, che alterna il miglioramento del bound rispetto a \(q\) e rispetto a \(\theta\); la differenza è che qui \(q\) non si calcola in forma chiusa, si apprende.[1]

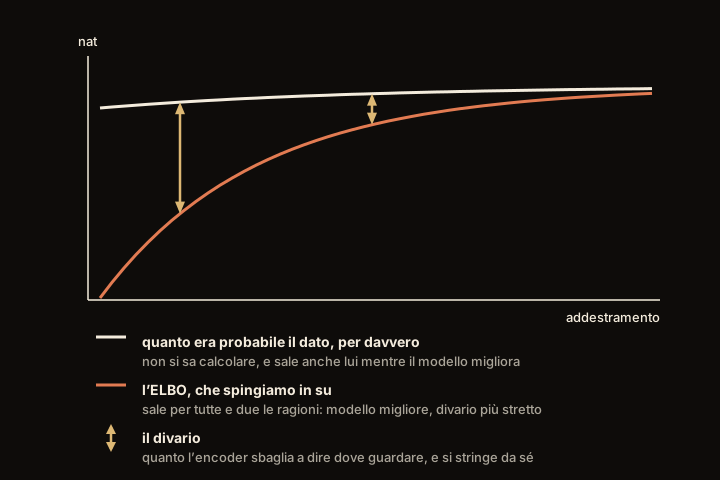
Fig. 25.3 Il limite e il divario. La riga in alto è il valore che vorremmo e non sappiamo calcolare; la curva è quello che calcoliamo e spingiamo in su. La distanza fra le due misura esattamente quanto la zona proposta dall’encoder differisce da quella giusta. Salgono tutte e due, ed è il punto: la curva guadagna sia perché il tetto si alza, sia perché lo raggiunge meglio. (Le due curve sono disegnate, non misurate: quello che si vuole far vedere è la forma del divario, non la sua grandezza, che dipende dal modello.)#
La curva di Fig. 25.3 guadagna quasi sempre da tutte e due le parti. Che salga soltanto perché il divario si stringe, mentre il modello peggiora, è possibile e ogni tanto succede; ma è l’eccezione, e in cambio si ottiene una cosa che si addestra come qualunque altra rete.
I due termini, e il costo di descrizione#
Quel limite inferiore si chiama ELBO, dall’inglese evidence lower bound: sta sotto \(\log p_\theta(\mathbf{x})\), l’evidenza, e a differenza di lei si sa calcolare. Con questo nome compare dappertutto, nei programmi come nei paper.
Scritto tutto insieme, l’ELBO è compatto e opaco. Spezzato in due termini diventa la cosa che si programma, e quei due termini hanno un significato da prendere sul serio.
La stima prudente, che da qui in avanti chiameremo col suo nome, ELBO, si spezza in due voci, e sono le due voci di una spesa.
Prima voce: quanto male ridipinge il copista. È la stessa della sezione precedente, nient’altro che il vecchio «la copia somiglia all’originale?».
Seconda voce: quanto costa scrivere la scheda. Qui c’è la novità, ed è la regola che mancava. Un vocabolario comune è stato fissato prima che i due cominciassero, e non lo decidono loro. È la «forma decisa in anticipo per il cassetto» che prima mancava: la stessa preferenza per il centro del righello (il prior) con cui il capitolo si apre, vista stavolta da chi scrive la scheda. È un modo standard di descrivere un quadro, che vale per tutti i quadri e non è stato adattato a nessuno. Quando l’archivista scrive una scheda, paga solo per quello che si discosta da quel vocabolario. Descrivere un quadro come «uno dei soliti» non costa niente; descriverlo nel dettaglio, con precisione al millimetro, costa molto.
L’archivista si trova quindi stretto fra due spinte opposte, e questo è il cuore di tutto. Se resta sul vago, la scheda costa poco e il copista dipinge male. Se è precisissimo, il copista dipinge benissimo e la scheda costa un’esagerazione. Il punto di equilibrio è la scheda più vaga che ancora basta: gli si chiede di essere impreciso quanto può permettersi.
Ed è quella imprecisione voluta a riempire i buchi della sezione precedente. Se ogni quadro non è descritto da un punto ma da un alone, gli aloni di quadri diversi si toccano, sulla mappa non restano zone vuote, e una scheda inventata cade dentro l’alone di qualcuno.
C’è una seconda conseguenza, meno ovvia. Il vocabolario comune è uno solo e sta in un posto solo: quindi pagare poco non vuol dire soltanto essere vaghi, vuol dire anche stare lì attorno. Le schede si raccolgono tutte nella stessa zona, che è poi la zona in cui si andrà a pescare, ed è per questo che pescare funziona.
Il punto di rottura c’è, e va detto: se il vocabolario comune è troppo povero, o se il copista è troppo bravo a cavarsela da solo, all’archivista conviene non scrivere niente. Costo zero, e il copista dipinge sempre lo stesso quadro medio. Succede davvero, si chiama collasso della posterior (cioè: la zona proposta dall’archivista è collassata sul vocabolario comune, e non dice più niente sul singolo quadro).
Spezzando \(p_\theta(\mathbf{x}, \mathbf{z}) = p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})\) dentro il logaritmo, l’ELBO si riscrive
dove il primo termine premia i codici da cui il dato si ricostruisce bene e il secondo penalizza gli encoder che si allontanano dal prior. Il secondo è la regolarizzazione che la sezione precedente cercava, e il punto è che non è stata aggiunta: è comparsa spezzando in due un’identità. Agisce però su un esempio alla volta, e mediato sui dati si scompone in due pezzi [HJ16]:
dove \(q_\phi(\mathbf{z})\) è l’aggregato della sezione precedente e \(I_q\) l’informazione mutua fra dato e codice sotto la congiunta \(p_{\text{dati}}(\mathbf{x})\, q_\phi(\mathbf{z} \mid \mathbf{x})\). Basta spezzare il logaritmo, \(\log \frac{q_\phi(\mathbf{z} \mid \mathbf{x})}{p(\mathbf{z})} = \log \frac{q_\phi(\mathbf{z} \mid \mathbf{x})}{q_\phi(\mathbf{z})} + \log \frac{q_\phi(\mathbf{z})}{p(\mathbf{z})}\), e prendere il valore atteso sulla congiunta. Il termine fa quindi due cose insieme: avvicina l’aggregato al prior, che è la regola cercata, e fa pagare l’informazione che il codice porta sul dato. Questa seconda spinta è la ragione per cui il termine può spegnere intere componenti del latente.
La lettura come costo di codifica è precisa e non è una metafora. La divergenza di Kullback–Leibler dei richiami di matematica misura quanto si paga in più codificando con la distribuzione sbagliata (là il conto è in bit, qui in nat: cambia solo la base del logaritmo); qui è il sovrapprezzo di descrivere \(\mathbf{z}\) con la posterior specifica di quel dato invece che con il codice comune \(p(\mathbf{z})\). Il negativo dell’ELBO si legge allora come un costo di descrizione totale, i nat spesi per la scheda più quelli spesi per rifare il dato a partire dalla scheda, ma a una condizione che la lettura ingenua salta. Chi trasmette un \(\mathbf{z}\) pescato da \(q_\phi(\mathbf{z} \mid \mathbf{x})\) con il codice \(p(\mathbf{z})\) spende in media \(\mathbb{E}_{q_\phi}[-\log p(\mathbf{z})]\), cioè la divergenza più l’entropia \(H(q_\phi)\); il sovrapprezzo scende alla sola divergenza soltanto se quei nat di entropia li si recupera, usando la casualità del sorteggio per trasportare altri bit, lo schema bits-back di Hinton e van Camp [HvC93]. Con un latente continuo serve in più discretizzare \(\mathbf{z}\) a una precisione fissa, che aggiunge ai due termini la stessa costante. Sotto queste condizioni massimizzare l’ELBO è minimizzare quel costo, che è la formulazione a minimum description length del metodo.
Con prior \(\mathcal{N}(\mathbf{0}, \mathbf{I})\) e posterior gaussiana a covarianza diagonale, il secondo termine si scrive in forma chiusa e non serve stimarlo:
dove \(\mu_j\) e \(\sigma_j^2\) sono media e varianza della \(j\)-esima componente prodotte dall’encoder, e \(L\) è la dimensione del latente. Il conto si fa componente per componente, perché \(q_\phi\) e \(p\) si fattorizzano. Per una componente, con i valori attesi presi rispetto a \(\mathcal{N}(\mu_j, \sigma_j^2)\),
e poiché \(\mathbb{E}[(z_j - \mu_j)^2] = \sigma_j^2\) ed \(\mathbb{E}[z_j^2] =
\mu_j^2 + \sigma_j^2\) restano \(\tfrac12(\mu_j^2 + \sigma_j^2 - \log
\sigma_j^2 - 1)\), che sommato su \(j\) dà la formula. Nel codice l’encoder
produce \(\log \sigma_j^2\) (log_var) invece di \(\sigma_j^2\), perché il
logaritmo vive su tutta la retta reale e non chiede vincoli di positività. Il
termine si annulla quando \(\mu_j = 0\) e \(\sigma_j^2 = 1\) per ogni \(j\), cioè
quando l’encoder ignora il dato e restituisce il prior: è il minimo di quel
termine, ed è anche il modo in cui il metodo può fallire.
Il trucco della riparametrizzazione#
Resta un problema di calcolo, e senza risolverlo niente di tutto questo si addestrerebbe in un tempo ragionevole. Nell’ELBO compare un valore atteso rispetto a \(q_\phi(\mathbf{z} \mid \mathbf{x})\), cioè rispetto a una distribuzione che dipende proprio dai parametri \(\phi\) dell’encoder, rispetto ai quali va preso il gradiente. L’encoder consegna una zona, e da quella zona si pesca: la correzione che deve tornargli indietro riguarda la zona, ma il decoder ha visto soltanto il punto pescato.
La backpropagation calcola il gradiente risalendo una catena di funzioni, una derivata alla volta, e un campione estratto da \(q_\phi\) non è una funzione derivabile di \(\phi\): la risalita si ferma lì. Uno stimatore del gradiente che non ha bisogno di attraversare il campione esiste, lo stimatore a punteggio, ma la sua varianza è alta.
Il rimedio, lo stesso che nella sezione sul controllo continuo fa passare il gradiente attraverso le azioni di SAC, non elimina il campionamento: lo rende un ingresso del grafo di calcolo, un rumore \(\boldsymbol{\epsilon}\) la cui distribuzione non dipende da \(\phi\) (Fig. 25.4).
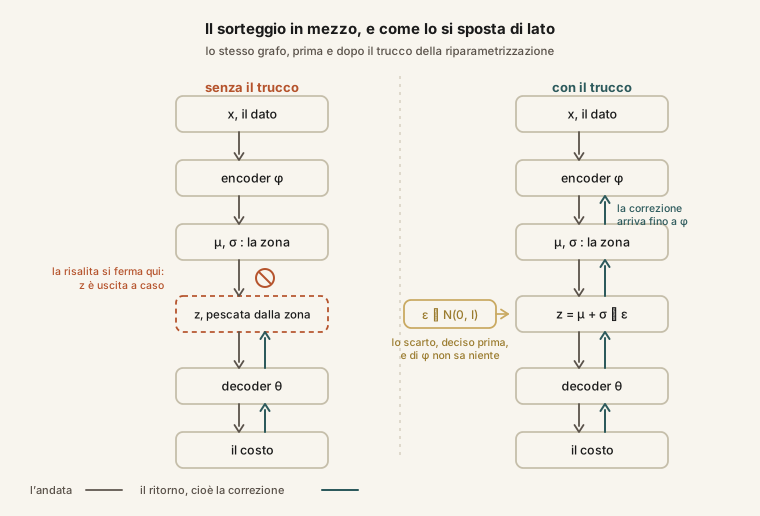
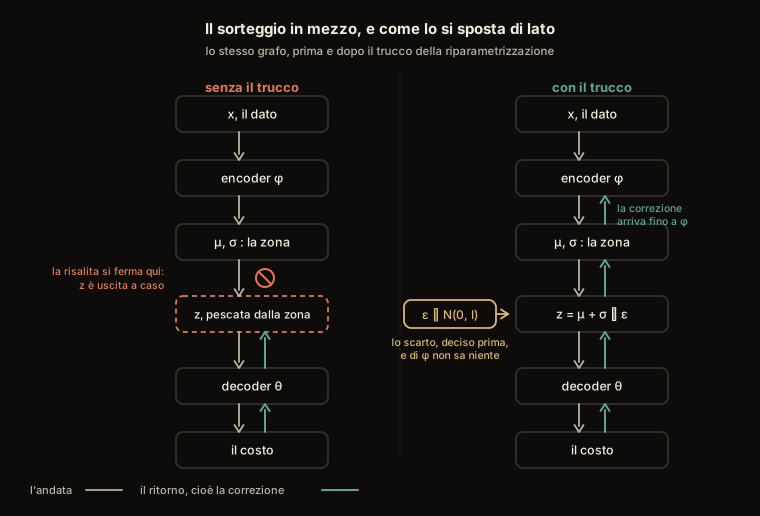
Fig. 25.4 Lo stesso grafo, prima e dopo. A sinistra la causa nascosta si pesca dalla zona che l’encoder propone, e la correzione, risalendo dal costo, si ferma lì: un numero uscito a caso non ha una derivata rispetto ai parametri dell’encoder. A destra il caso è stato spostato di lato, e si sorteggia a parte: la causa nascosta diventa il centro della zona più uno scarto allargato quanto la zona è larga. Da lì in poi sono tutti conti derivabili, e la correzione arriva fino ai numeri dell’encoder.#
Giochi a freccette, e vuoi sapere una cosa precisa: se sposto la mira di un centimetro a destra, il punteggio medio sale o scende? Il modo diretto è provare: sposti la mira e tiri altre dieci freccette. Ma quelle dieci sono andate dove sono andate anche per conto loro, e il punteggio è cambiato per due motivi mescolati, lo spostamento e la fortuna. Per districarli servono migliaia di tiri.
Il trucco è decidere gli scarti prima, e tenerli. Stabilisci in anticipo: questa freccetta cade tre centimetri sopra il punto di mira, la seconda uno a destra, la terza due sotto. Adesso sposti la mira, e tutte e dieci le freccette si spostano insieme a lei, rigidamente, perché il loro scarto dal punto di mira è inchiodato. Il punteggio cambia solo per lo spostamento, e con dieci tiri lo vedi.
La formula è tutta qui: invece di dire «pesco un punto dalla zona», si dice «prendo uno scarto a caso, e poi lo appoggio dove sta la zona, allargandolo quanto è larga la zona». Il caso è finito fuori, in un pezzo che non dipende da niente di ciò che vogliamo aggiustare, e la strada per le correzioni resta aperta.
C’è anche un altro modo di rispondere alla domanda: invece di seguire dove va la freccetta, si tiene conto di quanto era probabile che finisse proprio lì. Funziona, non imbroglia, e si usa quando gli scarti non si possono decidere prima. Ma la mano trema molto di più, e la differenza si misura. Trema un po’ meno se a ogni tiro, prima di pesarlo, si toglie il punteggio tipico, così che conti soltanto di quanto quel tiro è andato meglio o peggio del solito.
Il punto di rottura, che serve alla sezione seguente: il trucco degli scarti decisi prima si può fare soltanto se la zona è una di quelle che si spostano e si allargano, come una nuvola su un piano. Se la scelta nascosta fosse «quale dei dieci cassetti», non esisterebbe nessuno scarto da decidere in anticipo, perché fra il cassetto tre e il cassetto quattro non c’è niente in mezzo. E lì il trucco non si applica.
Il gradiente rispetto a \(\theta\) non pone problemi, perché \(\theta\) non compare nella distribuzione su cui si prende il valore atteso e l’operatore di derivata entra dentro. Rispetto a \(\phi\) sì:
perché è la misura stessa a dipendere da \(\phi\); \(f\) è la funzione di cui si prende il valore atteso. Il trucco della riparametrizzazione, proposto indipendentemente da Kingma e Welling [KW14] e da Rezende, Mohamed e Wierstra [RMW14], riscrive la variabile aleatoria come funzione derivabile di una sorgente di rumore che di \(\phi\) non sa niente (e non furono i primi: Salimans e Knowles [SK13] avevano usato una riscrittura simile per apprendere i parametri naturali di una distribuzione approssimante della famiglia esponenziale, invece del latente di un modello ammortizzato, come ricorda la monografia di Kingma e Welling [KW19]):
dove \(\boldsymbol{\mu}_\phi\) e \(\boldsymbol{\sigma}_\phi\) sono le uscite dell’encoder, \(\boldsymbol{\epsilon}\) è la sorgente di rumore e \(\odot\) è il prodotto componente per componente. Adesso il valore atteso è rispetto a \(p(\boldsymbol{\epsilon})\), che di \(\phi\) non dipende, l’operatore di derivata entra, e un solo campione basta a dare uno stimatore non distorto del gradiente:
Le condizioni sono tre: \(\mathbf{z} = g_\phi(\boldsymbol{\epsilon}, \mathbf{x})\) con \(g_\phi\) derivabile in \(\phi\), una distribuzione di \(\boldsymbol{\epsilon}\) che da \(\phi\) non dipende, e un \(f\) derivabile in \(\mathbf{z}\), più la regolarità che permette di scambiare derivata e valore atteso (basta un integrando dominato). Valgono per le famiglie di posizione e scala, come la gaussiana, e, in una dimensione, per ogni distribuzione con funzione di ripartizione inversa derivabile, prendendo \(\epsilon\) uniforme su \([0, 1]\); con una covarianza piena \(\boldsymbol{\Sigma} = \mathbf{C}\mathbf{C}^\top\) si scrive \(\mathbf{z} = \boldsymbol{\mu} + \mathbf{C}\boldsymbol{\epsilon}\). Per una variabile discreta una \(g_\phi\) derivabile non esiste.
Quella disuguaglianza è scritta per un \(f\) che di \(\phi\) non dipende, mentre nell’ELBO l’integrando contiene \(-\log q_\phi(\mathbf{z} \mid \mathbf{x})\), che da \(\phi\) dipende eccome. Il conto completo ha allora un addendo in più, e quell’addendo ha media nulla, perché è \(-\mathbb{E}_{q_\phi}[\nabla_\phi \log q_\phi(\mathbf{z} \mid \mathbf{x})]\). Lasciarlo cadere dà quindi un secondo stimatore, anch’esso non distorto, e con una proprietà notevole: la sua varianza tende a zero man mano che la posterior approssimata si avvicina a quella vera. È lo stimatore detto sticking the landing [RWD17].
L’alternativa è lo stimatore a punteggio, \(\nabla_\phi \mathbb{E}_{q_\phi}[f] = \mathbb{E}_{q_\phi}[f(\mathbf{z})\, \nabla_\phi \log q_\phi(\mathbf{z} \mid \mathbf{x})]\), che è il gradiente di policy di REINFORCE incontrato nella sezione sul gradiente di policy. Anche quello è non distorto, e ha il vantaggio decisivo di funzionare su variabili discrete, dove la riparametrizzazione non si applica. Paga in varianza, e quel prezzo si misura.
I due metodi si mettono alla prova su un caso minuscolo in cui la risposta giusta si conosce in anticipo, così non si tratta di fidarsi. Il gioco è questo: si sorteggia un numero attorno a un centro (qui il centro vale 2), si guarda il suo quadrato, e ci si chiede di quanto cambierebbe la media di quel quadrato se il centro si spostasse. La risposta esatta si sa: la media del quadrato vale il quadrato del centro più uno (l’uno è quanto balla il sorteggio), quindi spostando il centro di un pochino la media cambia del doppio del centro. Con dei numeri: col centro a 2 la media del quadrato è \(2 \times 2 + 1 = 5\); col centro a 2,01 è \(2{,}01 \times 2{,}01 + 1 = 5{,}0401\). Il centro si è mosso di un centesimo e la media di quattro centesimi, quattro volte tanto. Col centro a 2, la risposta è 4. Vediamo quanto ci si avvicinano i due metodi, e soprattutto con quanta mano ferma.
import torch

torch.manual_seed(0)

# Vogliamo la derivata rispetto a mu di E[z^2] con z ~ N(mu, 1).
# Il valore vero si sa: E[z^2] = mu^2 + 1, quindi la derivata e' 2*mu.
MU, PROVE = 2.0, 200_000

epsilon = torch.randn(PROVE)
z = MU + epsilon                      # gli stessi sorteggi per i due metodi

# 1. si deriva attraverso il sorteggio: z e' mu piu' rumore, quindi d(z^2)/dmu = 2z
riparametrizzato = 2 * z

# 2. non si deriva il sorteggio, si deriva la probabilita' di averlo pescato:
#    per una gaussiana, d(log q)/dmu = z - mu
punteggio = z ** 2 * (z - MU)

# 3. lo stesso punteggio con la migliore linea di base costante, che qui vale
#    E[z^2 (z-mu)^2] / E[(z-mu)^2] = mu^2 + 3: sottrarla non sposta la media
con_base = (z ** 2 - (MU ** 2 + 3)) * (z - MU)

for nome, stima in (("riparametrizzazione", riparametrizzato), ("punteggio", punteggio),
                    ("punteggio con base", con_base)):
    print(f"{nome:>20}: media {stima.mean():6.3f}   "
          f"deviazione standard {stima.std():7.3f}")
print(f"{'valore vero':>20}: {2 * MU:6.3f}")
print(f"\nla varianza del secondo e' {(punteggio.var() / riparametrizzato.var()):.0f} "
      f"volte quella del primo, {(con_base.var() / riparametrizzato.var()):.1f} "
      f"con la linea di base")
 riparametrizzazione: media  3.993   deviazione standard   2.000
           punteggio: media  3.974   deviazione standard   9.306
  punteggio con base: media  4.000   deviazione standard   6.165
         valore vero:  4.000

la varianza del secondo e' 22 volte quella del primo, 9.5 con la linea di base
Tutti e due i metodi puntano al valore giusto, 4: nessuno dei due imbroglia. La differenza è la mano, che nel secondo trema molto di più, e a dirlo è la deviazione standard, cioè quanto una singola risposta balla attorno al valore giusto: 2,0 per il primo metodo, 9,3 per il secondo. Il numero in fondo eleva al quadrato quelle due, che è il passaggio con cui si arriva alla varianza: 9,3 al quadrato contro 2 al quadrato, cioè ventidue volte tanto.
Ventidue volte di varianza vuol dire, a parità di precisione, ventidue volte i campioni. Lo stimatore a punteggio ha un rimedio classico, la linea di base del gradiente di policy: da \(f\) si sottrae una costante, che non sposta la media perché il punteggio \(\nabla_\mu \log q\) ha media nulla, e la si sceglie in modo da rendere minima la varianza (qui vale \(\mu^2 + 3\)). La deviazione standard scende da 9,3 a 6,2, e il rapporto delle varianze da ventidue a nove e mezzo: la riparametrizzazione resta avanti, di meno. In un addestramento, che di campioni ne tira uno per esempio, quella varianza diventa rumore nei passi di ottimizzazione. E il rapporto non è una costante: questo vale per un quadrato in una dimensione, e cambia con la funzione e con la dimensione del latente.
Tutto insieme#
I pezzi ci sono tutti. L’encoder, invece di un codice, produce due file di numeri, una media e una larghezza; da lì si pesca con lo scarto deciso prima; il decoder ricostruisce; e la perdita è la somma delle due voci di spesa.
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.datasets import load_digits

torch.manual_seed(0)
torch.set_num_threads(1)
X = torch.tensor(load_digits().data / 16.0, dtype=torch.float32)
LATENTE = 8


class VAE(nn.Module):
    def __init__(self):
        super().__init__()
        self.tronco = nn.Sequential(nn.Linear(64, 48), nn.ReLU())
        self.testa = nn.Linear(48, 2 * LATENTE)   # media e log-varianza insieme
        self.decoder = nn.Sequential(nn.Linear(LATENTE, 48), nn.ReLU(),
                                     nn.Linear(48, 64))

    def codifica(self, x):
        return self.testa(self.tronco(x)).chunk(2, dim=1)


vae = VAE()
opt = torch.optim.Adam(vae.parameters(), lr=3e-3)
for passo in range(4000):
    media, log_var = vae.codifica(X)
    # il sorteggio scritto in modo derivabile: rumore fisso, media e scala apprese
    z = media + torch.exp(0.5 * log_var) * torch.randn_like(media)

    ricostruzione = F.binary_cross_entropy_with_logits(
        vae.decoder(z), X, reduction="sum") / len(X)
    costo_descrizione = (-0.5 * (1 + log_var - media ** 2
                                 - log_var.exp()).sum(1)).mean()
    perdita = ricostruzione + costo_descrizione     # cioe' -ELBO

    opt.zero_grad()
    perdita.backward()
    opt.step()

print(f"ricostruzione      {ricostruzione.item():6.1f} nat")
print(f"costo descrizione  {costo_descrizione.item():6.1f} nat")
print(f"ELBO              {-perdita.item():7.1f} nat  "
      f"(log p(x) sta piu' in alto di qui)")
ricostruzione        20.2 nat
costo descrizione     3.6 nat
ELBO                -23.8 nat  (log p(x) sta piu' in alto di qui)
Il primo risultato è che la ricostruzione è peggiorata: 20,2 nat contro i 16,3 dell’autoencoder, sulle stesse cifre e con la stessa architettura, a parte la testa dell’encoder che qui produce anche la varianza. Il decoder riceve un campione della zona proposta e non il suo centro, e il codice porta meno informazione: il costo di descrizione, 3,6 nat per cifra, misura quanta ne porta rispetto al prior. Quei quasi quattro nat di ricostruzione in più sono la vaghezza che abbiamo comprato.
L’ultima riga dice che \(\log p_\theta(\mathbf{x})\) sta più in alto dell’ELBO, ma non di quanto. Lo si stima con il campionamento per importanza di poco fa, usando l’encoder come proposta e \(K\) campioni per cifra: è il limite dell’importance weighted autoencoder, che con \(K = 1\) coincide con l’ELBO e al crescere di \(K\) sale verso \(\log p_\theta(\mathbf{x})\).
import math

# un generatore a parte, cosi' i sorteggi dei blocchi che seguono restano
# quelli di sempre
gen = torch.Generator().manual_seed(1)


def stima_log_p(x, K):
    """log p(x) per importanza: K campioni dalla zona proposta dall'encoder,
    ciascuno pesato per p(x, z) / q(z | x)."""
    with torch.no_grad():
        media, log_var = vae.codifica(x)
        eps = torch.randn(K, *media.shape, generator=gen)
        z = media + torch.exp(0.5 * log_var) * eps
        log_p_x_dato_z = -F.binary_cross_entropy_with_logits(
            vae.decoder(z), x.expand(K, *x.shape), reduction="none").sum(-1)
        # log p(z) - log q(z | x): le costanti con 2*pi si cancellano
        log_peso = (log_p_x_dato_z - 0.5 * (z ** 2).sum(-1)
                    + 0.5 * (eps ** 2).sum(-1) + 0.5 * log_var.sum(-1))
        return torch.logsumexp(log_peso, 0) - math.log(K)


print(f"{'campioni K':>10}   stima di log p(x)")
for K in (1, 10, 100, 1000):
    # cento cifre alla volta, perche' i tensori restino piccoli
    stime = [stima_log_p(X[i:i + 100], K) for i in range(0, len(X), 100)]
    print(f"{K:>10}   {torch.cat(stime).mean().item():8.2f} nat")
campioni K   stima di log p(x)
         1     -23.76 nat
        10     -23.52 nat
       100     -23.48 nat
      1000     -23.47 nat
Con \(K = 1\) la stima è l’ELBO, ricalcolato con sorteggi nuovi, e torna il valore dell’addestramento. Con dieci campioni sale di un quarto di nat, e da cento in su quasi si ferma: anche la stima per importanza sta per difetto, ma smette di salire, segno che lì è ormai vicina a \(\log p_\theta(\mathbf{x})\). Su questo modello, quindi, l’ELBO sta circa tre decimi di nat sotto la verosimiglianza, su ventiquattro: il limite è quasi stretto, e la zona proposta dall’encoder è vicina alla posterior vera. È una proprietà di questo modello piccolo, che del latente usa poche componenti; con un encoder che approssima male la posterior il divario cresce. (Vale anche qui la riserva di tutti i nat del capitolo: su livelli di grigio continui la verosimiglianza di Bernoulli non è normalizzata, e questo è il \(\log p_\theta(\mathbf{x})\) del modello così come è scritto.)
La macchina che abbiamo appena montato ha un nome, ed è quello del capitolo: autoencoder variazionale, in sigla VAE. «Variazionale» è la parola dell’apertura: alla risposta esatta si è rinunciato, e si è cercata la migliore fra le risposte di una forma fissata, che qui sono le gaussiane a covarianza diagonale che l’encoder propone. Vediamo che cosa abbiamo preso in cambio di quei quasi quattro nat.
Per generare si pesca un codice dal prior, \(p(\mathbf{z}) = \mathcal{N}(\mathbf{0}, \mathbf{I})\), cioè dalla distribuzione del codice prima di aver visto un dato, e lo si fa decodificare.
LIVELLI = " .:-=+*#%"


def affianca(*immagini):
    griglie = [(im.reshape(8, 8) * 8).round().long().clamp(0, 8) for im in immagini]
    return "\n".join("   ".join("".join(LIVELLI[i] for i in g[r]) for g in griglie)
                     for r in range(8))


with torch.no_grad():
    # si pesca dal prior N(0, I) e si decodifica
    nuove = torch.sigmoid(vae.decoder(torch.randn(500, LATENTE)))

print("quattro cifre pescate dal prior e decodificate")
print(affianca(*nuove[:4]))
quattro cifre pescate dal prior e decodificate
   -#=       -*#+.     .+#**.      *%#=.
  :***.     .##--.     -%#=:      :*=*=
  =*=*.     :%:  .     +%:        .. *-
 .*##*      =%-:-.     +%-         -+#*+
 .*##+.     -#-=*.     :*+=       .*%#+:
 .+=**.     .-.+*.      .+*.       .#:
  --**.      -=#-       :#*        -#
   -#*.      -#=       .*%:        #-
Una precisazione prima di guardarle, perché cambia come si leggono: quello che il blocco stampa è il grigio medio che il decoder dichiara per ciascun pixel, non un sorteggio. Sorteggiando davvero uscirebbe sale e pepe, e una parte della morbidezza che si vede è quindi una scelta di come disegnare, non solo del modello.
Detto questo, non sono capolavori: grosse, un po’ molli, e su qualcuna si esita fra due cifre. Quello che conta è un’altra cosa: non è stato dato in pasto niente. Quei quattro disegni vengono da quattro file di otto numeri sorteggiate da una gaussiana, e da nient’altro, e quella gaussiana era dichiarata in partenza. All’autoencoder della sezione precedente una gaussiana si era dovuta adattare ai codici a cose fatte, sperando che ci somigliassero: è lì che si era aperto il buco.
Il metro della sezione precedente lo dice senza aggettivi. Rimettiamo in piedi
anche l’autoencoder semplice, la classe Clessidra, così i due numeri li
stampa la stessa macchina.
class Clessidra(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Sequential(nn.Linear(64, 48), nn.ReLU(),
                                     nn.Linear(48, LATENTE))
        self.decoder = nn.Sequential(nn.Linear(LATENTE, 48), nn.ReLU(),
                                     nn.Linear(48, 64))


torch.manual_seed(0)
ae = Clessidra()
opt = torch.optim.Adam(ae.parameters(), lr=3e-3)
for passo in range(4000):
    perdita_ae = F.binary_cross_entropy_with_logits(
        ae.decoder(ae.encoder(X)), X, reduction="sum") / len(X)
    opt.zero_grad()
    perdita_ae.backward()
    opt.step()


def quanto_e_vuoto(visti, sorteggiati):
    """Di quante spaziature tipiche un codice sorteggiato manca il bersaglio."""
    fra = torch.cdist(visti, visti)
    fra.fill_diagonal_(float("inf"))
    return (torch.cdist(sorteggiati, visti).min(1).values.median()
            / fra.min(1).values.median()).item()


def quanto_somiglia(immagini, veri):
    return torch.cdist(immagini, veri).min(1).values.median().item()


with torch.no_grad():
    codici_ae = ae.encoder(X)
    sorteggiati_ae = codici_ae.mean(0) + codici_ae.std(0) * torch.randn(500, LATENTE)
    media, log_var = vae.codifica(X)
    codici_vae = media + torch.exp(0.5 * log_var) * torch.randn_like(media)
    sorteggiati_vae = torch.randn(500, LATENTE)
    nuove_ae = torch.sigmoid(ae.decoder(sorteggiati_ae))
    # le righe che il VAE usa davvero: costo di descrizione medio sopra 0,05
    usate = (-0.5 * (1 + log_var - media ** 2 - log_var.exp())).mean(0) > 0.05

fra_veri = torch.cdist(X, X)
fra_veri.fill_diagonal_(float("inf"))
print(f"{'':<26}{'buchi nel latente':>18}{'distanza dalle vere':>22}")
print(f"{'cifra vera':<26}{'':>18}{fra_veri.min(1).values.median():>22.2f}")
print(f"{'autoencoder':<26}{quanto_e_vuoto(codici_ae, sorteggiati_ae):>17.1f}x"
      f"{quanto_somiglia(nuove_ae, X):>22.2f}")
print(f"{'autoencoder variazionale':<26}{quanto_e_vuoto(codici_vae, sorteggiati_vae):>17.1f}x"
      f"{quanto_somiglia(nuove, X):>22.2f}")
# lo stesso, sulle sole righe usate: con i campioni delle zone e con i centri
vuoto_usate = quanto_e_vuoto(codici_vae[:, usate], sorteggiati_vae[:, usate])
vuoto_centri = quanto_e_vuoto(media[:, usate], sorteggiati_vae[:, usate])
print(f"{'  sulle righe usate':<26}{vuoto_usate:>17.1f}x")
print(f"{'  solo i centri delle zone':<26}{vuoto_centri:>17.1f}x")

# il metro ha un punto cieco: una media di cifre vere, cioe' una cifra sfocata
# che nessuno ha scritto, sta alle vere piu' vicino di quanto stiano fra loro
etichette = torch.tensor(load_digits().target)
sfocate = torch.stack([X[torch.nonzero(etichette == k % 10).squeeze()]
                       [torch.randperm(150)[:5]].mean(0) for k in range(500)])
print(f"{'media di cinque cifre':<26}{'':>18}{quanto_somiglia(sfocate, X):>22.2f}")
print(f"\nrighe del codice usate dal VAE: {int(usate.sum())} su {LATENTE}")
                           buchi nel latente   distanza dalle vere
cifra vera                                                    1.01
autoencoder                             2.2x                  1.62
autoencoder variazionale                1.0x                  1.09
  sulle righe usate                     1.1x
  solo i centri delle zone              1.8x
media di cinque cifre                                         0.98

righe del codice usate dal VAE: 4 su 8
Le due macchine non sono misurate allo stesso modo, e conviene dirlo prima di leggere. Per il VAE si pesca dal prior, fissato in partenza e usato nell’addestramento; l’autoencoder un prior non ce l’ha, e gli si adatta a cose fatte una gaussiana diagonale sui codici. Anche i codici di riferimento sono di due specie: per l’autoencoder sono le uscite dell’encoder, per il VAE campioni delle zone proposte, perché è su quelli che il suo decoder si è addestrato. Quella differenza è la differenza fra le due macchine.
La prima colonna è la geometria. Un codice pescato dal prior cade, per il VAE, alla distanza tipica fra due codici che il decoder ha visto in addestramento; per l’autoencoder distava più del doppio. Delle otto righe del codice il VAE ne usa quattro, e sulle altre i campioni delle zone sono campioni del prior; ma anche sulle sole righe usate il rapporto resta vicino a 1. Contro i soli centri delle zone, invece, sale a 1,8, più o meno come per l’autoencoder. A riempire i vuoti, quindi, è soprattutto la larghezza delle zone attorno a ciascun centro, che il costo di descrizione impedisce di stringere, più che una disposizione più fitta dei centri.
La seconda colonna è la conseguenza: una cifra vera dista dalla sua vicina 1,01; una cifra inventata dal VAE dista 1,09, cioè l’otto per cento in più; una inventata dall’autoencoder dista 1,62, cioè più del sessanta per cento in più. Con questo metro un dato inventato dal VAE sta alle cifre vere quasi quanto una cifra vera sta alle altre; uno inventato dall’autoencoder no. Il metro però ha un punto cieco, e l’ultima riga della tabella lo mostra: la media di cinque cifre vere della stessa classe, una cifra sfocata che nessuno ha mai scritto, dista dalla cifra vera più vicina 0,98, meno di quanto due cifre vere vicine distino fra loro (1,01). La distanza euclidea premia la media, e la media è il difetto che questa famiglia si porta dietro: la tabella dice che il VAE pesca dove il decoder è stato, non che le sue cifre siano nitide.
La stessa differenza, guardata mentre avviene invece che a conti fatti, è quella di Fig. 25.5.

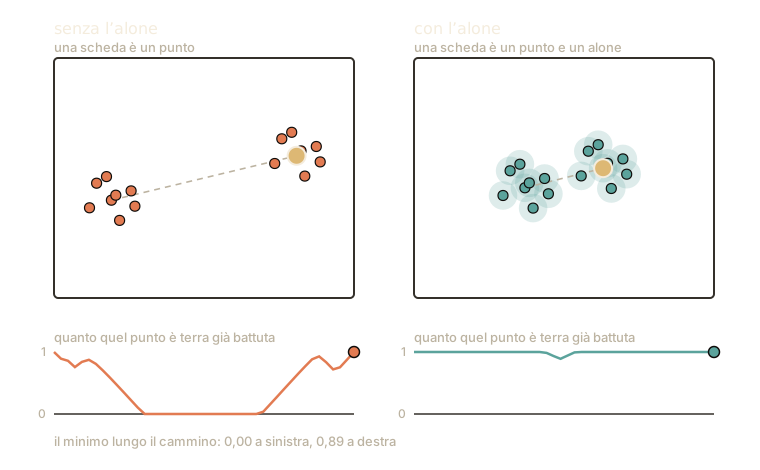
Fig. 25.5 Lo stesso cammino, nei due archivi. La curva sotto ciascun riquadro misura quanto il punto in cui il segnalino si trova sia terra già battuta: a sinistra crolla a zero a metà strada, a destra scende appena e non tocca mai il fondo, e i due minimi (0,00 e 0,89) sono stampati in basso a sinistra. Fra i pannelli cambiano due cose, e sono quelle che cambiano davvero: a destra i due gruppi stanno più vicini, perché il costo di descrizione li tira verso il centro, e ciascun codice occupa un alone invece che un punto. (Sono sedici codici su un piano perché così si guardano, e la soglia che decide che cosa sia «battuto» è scelta a mano: è un’illustrazione del meccanismo, non una misura. Nell’esperimento sulle cifre i codici sono quasi milleottocento in otto dimensioni, e a dirlo resta solo la tabella.)#
Che cosa il VAE non fa bene#
I VAE hanno tre limiti noti: la sfocatura, il collasso della posterior e lo scarto fra il prior e la distribuzione dei codici. Vengono tutti e tre dall’obiettivo stesso, e allenare di più non li toglie.
Le immagini vengono morbide, e allenando di più non si risolve. La pagella con cui il copista è giudicato lo punisce senza limite se dichiara quasi impossibile un quadro che invece esiste: se a un quadro vero dà una probabilità di uno su un milione la pena è enorme, e cresce ancora man mano che quella probabilità si avvicina a zero. Se invece dichiara possibile un quadro che non esisterebbe mai, l’unico prezzo è che quella probabilità sprecata manca un po’ ai quadri veri. Le due pene non sono pari, e allora conviene abbondare: dichiarare possibile più di quel che serve, e nel dubbio coprire. Un archivio che copre più di quello che c’è produce quadri che somigliano un po’ a tutto e precisamente a niente, ed è quello che sullo schermo si legge come sfocatura. C’è poi una seconda ragione, che qualcuno ritiene quella vera: quando la stessa scheda può venire da quadri molto diversi, il copista, che deve dipingerne uno solo, ne dipinge la media, e la media di tanti quadri diversi è morbida.
L’archivista può decidere di non scrivere niente. Se il copista se la cava già bene da solo, o se all’inizio dell’addestramento la ricostruzione conta poco, la strada più conveniente è la scheda vuota: costo di descrizione zero, e il copista dipinge il quadro medio. Da quello stato è difficile uscire, perché qualunque ritocco alla scheda costa subito e rende solo dopo. Si rimedia con mestiere (far pesare poco la seconda voce all’inizio, oppure garantire un minimo di informazione per riga della scheda), ma è una toppa, non una soluzione.
L’archivio, guardato tutto insieme, non è proprio quello promesso. La regola tiene ogni singola scheda vicina al vocabolario comune, una alla volta. Che poi l’insieme di tutte le schede assomigli al vocabolario comune non è garantito da nessuno, e infatti non succede del tutto: restano zone che il vocabolario dichiara plausibili e in cui il copista è stato poco. Sono le schede da cui escono i disegni deboli.
La sfocatura deriva dal fatto che massimizzare l’ELBO su tutto l’insieme di dati equivale a minimizzare \(D_{\mathrm{KL}}(q_{\mathcal{D},\phi}(\mathbf{x}, \mathbf{z}) \,\|\, p_\theta(\mathbf{x}, \mathbf{z}))\), dove \(q_{\mathcal{D},\phi}(\mathbf{x}, \mathbf{z}) = p_{\text{dati}}(\mathbf{x})\, q_\phi(\mathbf{z} \mid \mathbf{x})\) è la congiunta che si ottiene pescando un dato vero e poi codificandolo: è una KL in cui la distribuzione dei dati sta a sinistra. In quella direzione il costo di mettere probabilità quasi nulla dove i dati ci sono diverge, mentre il costo di metterne dove i dati non ci sono è mite: il modello ottimale è quindi più disperso dei dati, e su immagini «più disperso» si legge come sfocato. È la spiegazione che danno Kingma e Welling [KW19], i quali osservano anche che il rimedio non è cambiare obiettivo ma rendere più flessibili la posterior o il decoder. A questa causa se ne somma una seconda, che sta nella verosimiglianza scelta: con \(p_\theta(\mathbf{x} \mid \mathbf{z})\) fattorizzata sui pixel, tutto ciò che \(\mathbf{z}\) non determina viene trattato come rumore indipendente pixel per pixel, e la media \(\mathbb{E}[\mathbf{x} \mid \mathbf{z}]\) che si disegna è una media su tutte le immagini compatibili con quel codice, sfocata per costruzione; campionando invece di prendere la media esce rumore, non dettaglio. Zhao, Song ed Ermon [ZSE17] indicano questa seconda causa come quella vera: in certe condizioni, mostrano, la sfocatura non viene dalla massima verosimiglianza, ma da una \(q_\phi\) che manda sullo stesso codice immagini troppo diverse perché una gaussiana fattorizzata le rappresenti. Per questo i VAE più nitidi hanno decoder autoregressivi, latenti gerarchici o latenti discreti.
Il collasso della posterior si innesca perché all’inizio dell’addestramento il termine di ricostruzione è debole, e \(q_\phi(\mathbf{z} \mid \mathbf{x}) \approx p(\mathbf{z})\) è un equilibrio stabile da cui è difficile uscire: il costo di descrizione va a zero e il latente smette di portare informazione. Nel caso lineare-gaussiano dell’apertura del capitolo, la PCA probabilistica, il collasso si calcola: all’ottimo la colonna di \(\mathbf{W}\) che corrisponde a un autovalore non superiore alla varianza del rumore \(\sigma^2\) è nulla, e la posterior di quella componente coincide con il prior [TB99]. Un rumore più grande spegne le componenti a partire dalla più debole, e in quel caso il collasso è l’ottimo globale della verosimiglianza, non un incidente dell’ottimizzazione. Lucas e colleghi [LTGN19] mostrano che l’ELBO del VAE lineare non aggiunge massimi locali spuri rispetto alla verosimiglianza, e che l’analisi lineare resta predittiva anche per VAE profondi con decoder gaussiano, dove aiuta a spiegare il legame fra varianza del rumore di osservazione e collasso. Il fenomeno è documentato su testo da Bowman e colleghi [BVV+16], che propongono di far salire lentamente il peso del termine KL; l’alternativa dei free bits [KSJ+16] impone invece un minimo di nat per gruppo di componenti latenti. Il caso peggiore è un decoder molto espressivo (autoregressivo, per dire), che può modellare i dati da solo e rende il latente superfluo.
Resta lo scarto fra prior e posterior aggregata: il termine KL agisce su un esempio alla volta, quindi vincola ciascuna \(q_\phi(\mathbf{z} \mid \mathbf{x})\) e non l’aggregato \(q_\phi(\mathbf{z}) = \mathbb{E}_{p_{\text{dati}}}[q_\phi(\mathbf{z} \mid \mathbf{x})]\). I due non coincidono [HJ16, RLM18], e nello scarto restano regioni con massa apprezzabile sotto il prior che il decoder ha visitato poco: campionarle dà i risultati deboli. È un limite del metodo, non un difetto di implementazione, e la sezione su Stable Diffusion, nel capitolo sui modelli di diffusione, mostra come lo si aggiri in pratica invece di risolverlo.
Una semplificazione va dichiarata. La verosimiglianza usata è una Bernoulli per pixel applicata a livelli di grigio continui, che è la ricetta consueta su questi dati e non è una densità normalizzata su \([0,1]\): il numero stampato come ELBO è quindi un ELBO rispetto a quel modello, non rispetto a una densità propria. La correzione esiste, si chiama Bernoulli continua [LGC19]: i suoi autori misurano che applicarla cambia i punteggi e rende i campioni più nitidi, cioè tocca proprio la sfocatura. Il confronto fra autoencoder e VAE regge lo stesso, perché i due sono addestrati con la medesima verosimiglianza; il valore assoluto dei nat, no.
Tre difetti veri, quindi, ed è per loro che, per generare immagini, servono altre due famiglie, ciascuna con il suo capitolo. Sono anche il motivo per cui questa macchina, dentro quelle due famiglie, continua a lavorare: le si affida un mestiere diverso, in cui i tre difetti non mordono. Qual è, lo dice la sezione sul latente che si usa.
Da ricordare
Si cambia domanda: non «la copia somiglia all’originale?» ma «quanto era probabile che uscisse proprio questo dato?». La regola che mancava non si aggiunge: esce da sola provando a rispondere.
Quel conto non si può fare, e non basta tirare a sorte: quasi tutte le cause sorteggiate a caso spiegano il dato malissimo, e con quaranta numeri nascosti uno solo su centomila sorteggi si prende un terzo del totale.
Si chiede allora all’archivista, che il dato ce l’ha sotto gli occhi, dove conviene guardare. Ne esce una stima prudente, sicuramente più bassa del vero, e il divario è esattamente quanto il consiglio è impreciso. Spingerla in alto migliora, quasi sempre, il modello e il consiglio insieme.
La stima ha due voci: quanto male si ricostruisce, e quanto costa scrivere la scheda rispetto a un vocabolario comune deciso prima. La seconda voce è ciò che riempie i buchi.
Per addestrare serve decidere gli scarti prima: si sorteggia uno scarto, e lo si appoggia sulla zona proposta. Così le correzioni tornano indietro. L’altro modo (tenere conto di quanto era probabile pescare proprio quel punto) funziona e non imbroglia, ma ha la mano molto meno ferma: in questo esempio ventidue volte, nove e mezzo togliendo la migliore linea di base.
Il risultato: le cifre pescate dal nulla sono grosse e molli, e su qualcuna si esita fra due cifre, ma vengono da niente; e un codice sorteggiato cade dove il copista è già stato. Il prezzo è una ricostruzione un po’ peggiore, e restano tre difetti veri: le immagini vengono morbide, l’archivista può decidere di non scrivere niente, e l’archivio nell’insieme non è proprio quello promesso.
Da ricordare
Identità esatta: \(\log p_\theta(\mathbf{x}) = \mathcal{E}_{\theta,\phi}(\mathbf{x}) + D_{\mathrm{KL}}(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\|\, p_\theta(\mathbf{z} \mid \mathbf{x}))\). L’ELBO è un limite inferiore e il divario coincide con l’errore della posterior approssimata: massimizzarlo migliora modello ed encoder insieme. Il divario si stima a modello addestrato con il limite IWAE: sulle cifre del capitolo è di circa 0,3 nat.
Forma operativa: \(\mathcal{E} = \mathbb{E}_{q_\phi}[\log p_\theta(\mathbf{x} \mid \mathbf{z})] {} - D_{\mathrm{KL}}(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\|\, p(\mathbf{z}))\). Con prior \(\mathcal{N}(\mathbf{0}, \mathbf{I})\) e posterior gaussiana diagonale il secondo termine è in forma chiusa e si annulla se e solo se l’encoder restituisce il prior. Mediato sui dati vale \(I_q(\mathbf{x}; \mathbf{z}) + D_{\mathrm{KL}}(q_\phi(\mathbf{z}) \,\|\, p(\mathbf{z}))\): avvicina l’aggregato al prior e insieme fa pagare l’informazione che il codice porta sul dato.
La stima Monte Carlo dal prior è non distorta e inservibile: la sua versione logaritmica è distorta verso il basso per Jensen, e in 40 dimensioni sbaglia di 10 nat con \(10^5\) campioni.
Riparametrizzazione [KW14, RMW14]: \(\mathbf{z} = \boldsymbol{\mu}_\phi + \boldsymbol{\sigma}_\phi \odot \boldsymbol{\epsilon}\) con \(\boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\). Sposta il caso fuori dal grafo delle derivate; nell’esempio ha varianza 22 volte minore dello stimatore a punteggio (REINFORCE), 9,5 se a quello si toglie la migliore linea di base costante. Lo stimatore a punteggio, però, si applica anche ai latenti discreti, dove la riparametrizzazione non arriva.
Limiti strutturali: sfocatura (la direzione della KL per Kingma e Welling, il decoder fattorizzato che fa la media per Zhao e colleghi), collasso della posterior [BVV+16, KSJ+16] (nel caso lineare-gaussiano è l’ottimo, per ogni componente con autovalore non superiore a \(\sigma^2\)) e scarto fra prior e posterior aggregata [HJ16, RLM18].
Ne esce una macchina che comprime e che sa anche pescare codici nuovi. La sezione sul latente che si usa smette di guardarla da dentro e ne studia l’uso: che cosa succede pesando di più il costo di descrizione, che cosa succede se il codice si fa di simboli invece che di numeri, e in quanti capitoli questa macchina stesse già lavorando senza essere stata presentata.