


Reinforcement Learning: imparare per tentativi#
Nessuno insegna a un bambino a camminare elencandogli la sequenza esatta di contrazioni muscolari. Il bambino ci prova, oscilla, cade, si rialza, fa un passo e cade di nuovo. Ogni tentativo il mondo gli restituisce un giudizio implicito (un tonfo doloroso oppure un metro guadagnato verso il divano) e settimana dopo settimana quel giudizio scolpisce un modo di muoversi che nessun manuale ha mai descritto. Questo è, in una frase, il reinforcement learning (apprendimento per rinforzo, spesso abbreviato in RL): imparare a comportarsi non da esempi già etichettati, ma dalle conseguenze delle proprie azioni.
Il nome si è già incontrato in fondo al capitolo sulla ricerca, come la strada che resta quando le regole del mondo non si possono più interrogare. Il bambino è esattamente in quella condizione: un passo non lo può provare nella propria testa per vedere dove lo porta, lo deve fare, e che cosa succede lo scopre dopo.
Agente, ambiente, ricompensa#
Il problema ha tre protagonisti. L’agente è chi decide: il bambino, un robot, un programma che gioca a scacchi. L’ambiente è tutto il resto, il mondo che l’agente non controlla ma con cui interagisce. La ricompensa è un numero che l’ambiente restituisce dopo ogni azione, per dire quanto è andata bene. A ogni passo l’agente osserva la situazione in cui si trova, lo stato, cioè la descrizione del mondo su cui basa la scelta, e compie un’azione; l’ambiente passa a un nuovo stato e gli consegna una ricompensa, poi il ciclo ricomincia (Fig. 13.1). Quello che l’agente cerca di rendere più grande possibile non è la ricompensa di adesso, ma la somma di tutte quelle che verranno da qui alla fine: quella somma si chiama ritorno (in inglese return).
Nella somma i premi lontani entrano ridotti: ogni passo di attesa li moltiplica per uno stesso numero \(\gamma\) compreso fra zero e uno, il fattore di sconto. Con \(\gamma\) minore di uno, e premi che non crescono senza limite, la somma resta un numero finito anche su una partita che non finisce mai, e il perché lo mostra il conto della sezione MDP e funzioni valore.

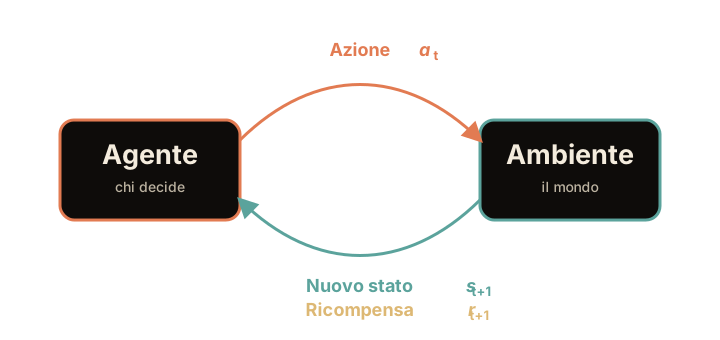
Fig. 13.1 Il ciclo di interazione del reinforcement learning: l’agente compie un’azione, l’ambiente risponde con un nuovo stato e una ricompensa, e l’anello si richiude. Accanto a ogni etichetta il disegno mette una lettera con un numeretto in basso: la lettera è l’iniziale (\(a\) per azione, \(s\) per stato, \(r\) per ricompensa) e il numeretto è il conto dei passi. L’azione la si compie al passo \(t\), lo stato nuovo e la ricompensa arrivano subito dopo, al passo \(t+1\).#
Una domanda viene prima di ogni algoritmo: chi decide la ricompensa? Non l’agente, e nemmeno il mondo: la scrive chi imposta il problema. In un videogioco il punteggio esiste già e si prende quello; per un robot che deve imparare a camminare qualcuno deve stabilire che cadere vale \(-5\) e che un metro guadagnato vale \(+1\). È una scelta di progetto, ed è una scelta seria, perché un agente ottimizza esattamente i numeri che gli sono stati dati e non le intenzioni di chi glieli ha dati: premiato per la velocità, può imparare a buttarsi in avanti e cadere in fretta. Chi imposta il problema può anche aggiungere premi intermedi, per guidare l’agente invece di lasciarlo cercare a vuoto: si chiama reward shaping, «dare forma alla ricompensa». È un’arma a doppio taglio, perché un premio intermedio può cambiare quale sia il comportamento migliore senza che nessuno se ne accorga: premiato per ogni passo che lo avvicina all’uscita, un robot può scoprire che gli conviene fare avanti e indietro davanti alla porta, incassando a ogni andata. C’è un solo modo di aggiungere premi che lascia sempre intatta la strategia migliore [NHR99], e lo racconta la sezione su esplorazione e ricompensa.
La regola con cui l’agente sceglie l’azione in ogni stato si chiama politica, o all’inglese policy, e si indica con \(\pi\). Imparare, nel reinforcement learning, vuol dire trovare una politica che renda il più grande possibile il ritorno medio.
In un videogioco vedi lo schermo, premi un tasto e il gioco risponde: schermata nuova, e qualche punto in più o in meno. Lo schermo è lo stato, il tasto è l’azione, i punti sono la ricompensa. Il numero da far crescere è il totale che avrai a fine partita, e quello è il ritorno: il punteggio di questo istante conta solo per quanto aggiunge al totale. Tutto quello che si chiede all’agente deve stare in quel numero: se lo si vuole veloce e anche prudente, velocità e prudenza vanno messe insieme in un punteggio solo, e quanto conti l’una rispetto all’altra lo decide chi imposta il gioco.
Dentro il totale i punti lontani possono pesare meno di quelli vicini. Quanto contano lo decide una manopola, il fattore di sconto, che chi imposta il problema gira prima che l’agente cominci a giocare. Tenuta al minimo, l’agente raccoglie tutte le monete che ha sotto il naso e ignora la chiave in fondo al livello. Tenuta al massimo, passa oltre le monete e va a prendere la chiave, perché dietro la porta ce n’è molto di più.
Tenerla al massimo ha però un prezzo, e si paga nei giochi senza traguardo, quelli in cui si corre, si raccolgono monete e, finché non si sbaglia, si va avanti per sempre. Se un punto fra mille schermate contasse quanto un punto adesso, «quanti ne prendo in tutto» resterebbe senza risposta per chi gioca bene: la sua partita non finisce, e il totale non si ferma su nessun numero. Nelle partite che a un certo punto finiscono il problema non si pone: i punti da sommare sono contati, e la manopola si può tenere al massimo senza rischi.
Con l’esperienza l’agente si costruisce un voto: per ogni schermata e per ogni tasto, quanti punti gli frutterà in tutto premerlo lì e poi tirare avanti con le solite abitudini. Quelle abitudini («in questa schermata salto sempre») sono la politica, e si migliorano a turno con i voti. Si può cominciare da abitudini qualsiasi, anche tirate a sorte: i voti dicono quanto rendono, le abitudini si spostano verso i tasti coi voti più alti, e per le abitudini nuove si rifanno i voti. A ogni giro migliorano gli uni e le altre.
Formalmente l’interazione è un processo decisionale di Markov (Markov Decision Process, MDP). A ogni passo \(t\) l’agente osserva lo stato \(S_t\), sceglie un’azione \(A_t\) secondo la sua politica \(\pi(a \mid s)\), e l’ambiente transita in \(S_{t+1}\) restituendo una ricompensa scalare \(R_{t+1}\) (maiuscole per le variabili aleatorie, minuscole \(s\), \(a\), \(r\) per i valori che assumono). L’obiettivo è massimizzare non la ricompensa immediata ma il ritorno (return) scontato:
Dietro la scelta c’è un’ipotesi, che Sutton e Barto chiamano ipotesi della ricompensa (reward hypothesis): che ogni scopo si possa esprimere come massimizzazione del valore atteso della somma di un segnale scalare [SB18]. Come ogni ipotesi può cadere: obiettivi multipli, o vincoli da rispettare, ci rientrano solo scegliendo come combinarli in un numero solo, e quella scelta fa parte del progetto.
Qui \(\gamma\) è il fattore di sconto: vicino a \(1\) l’agente è lungimirante e dà peso al futuro lontano; vicino a \(0\) è miope e insegue solo il premio immediato. \(\gamma < 1\) è la strada standard nei compiti continui, che non terminano mai, perché senza sconto quella somma infinita può non convergere (basta una ricompensa costante); l’alternativa, in quei compiti, è cambiare criterio e massimizzare la ricompensa media per passo. Nei compiti episodici, che finiscono da soli, la somma ha un numero finito di termini e \(\gamma = 1\) è ammesso e usatissimo. Cercare la politica ottima \(\pi^{*}\) significa massimizzare \(\mathbb{E}_\pi[G_t]\). Molti algoritmi lo fanno stimando funzioni di valore come \(Q^\pi(s,a) = \mathbb{E}_\pi[G_t \mid S_t=s,\, A_t=a]\), il ritorno atteso partendo da \(s\), giocando \(a\) e poi seguendo \(\pi\). Da lì migliorano la politica scegliendo, in ogni stato, l’azione di valore stimato più alto. Altri metodi, come il gradiente di policy, ottimizzano invece \(\pi\) in modo diretto.
Cosa lo distingue dall’apprendimento supervisionato#
Nell’apprendimento supervisionato ogni esempio arriva con la sua risposta corretta, la sua etichetta: questa foto è un gatto, quella casa vale 300 000 euro. Il programma deve solo imparare a imitare quelle risposte. Nel reinforcement learning le risposte corrette non esistono: nessuno le conosce.
Nessuno dice mai all’agente «la mossa giusta era questa». Riceve solo una ricompensa che dice quanto è andata bene, non cosa avrebbe dovuto fare. E il punto più difficile è il ritardo: negli scacchi il punteggio resta a zero per tutta la partita, e che una mossa fosse un errore lo capisci trenta mosse dopo, quando perdi. Quale mossa ringraziare per la vittoria? Quale incolpare per la sconfitta? Questo si chiama problema dell’assegnazione del merito (credit assignment), ed è il cuore di tutta la difficoltà.
C’è una seconda differenza, meno vistosa e non meno seria. Chi impara a riconoscere i gatti riceve un mazzo di foto già pronto, e quel mazzo resta lo stesso sia che risponda bene sia che risponda male. Chi impara a giocare a scacchi il suo mazzo se lo fabbrica muovendo: se apre sempre allo stesso modo, per anni vedrà le stesse posizioni e delle altre non saprà niente. Le partite su cui ci si allena dipendono dal modo in cui si gioca, e appena quel modo cambia cambiano anche loro.
Aspettare la fine della partita per sapere chi ringraziare costa caro. La via d’uscita è dare a ogni mossa, in ogni posizione, un voto provvisorio, anche grossolano: quanti punti mi aspetto di raccogliere da lì in avanti se la faccio. È il voto delle posizioni di mezzo del capitolo sulla ricerca, con una differenza: qui nessuno lo scrive a mano, lo si impara giocando. Si fa la mossa, e si mettono insieme due cose: quello che si è guadagnato subito, e il voto migliore fra le mosse possibili dalla posizione nuova, ridotto dal fattore di sconto perché quei punti arriveranno un passo più tardi. Con quel totale si corregge il voto della mossa appena fatta. Nessuno ha aspettato l’ultima mossa; eppure il giudizio finale, quando arriva, risale indietro di posizione in posizione fino all’apertura.
La differenza è strutturale. Nel supervisionato i dati \((\mathbf{x}, y)\) sono indipendenti e l’etichetta \(y\) è il segnale di errore diretto. Nel RL il segnale è una ricompensa scalare, potenzialmente ritardata e sparsa, e i dati non sono indipendenti: l’azione di adesso determina lo stato successivo, quindi la distribuzione degli esempi dipende dalla politica stessa. L’assegnazione del merito temporale si affronta con i metodi a differenza temporale (temporal-difference, TD) e con l’equazione di Bellman, che spezza il ritorno in premio immediato più valore scontato dello stato futuro:
Aggiornare \(Q\) verso il lato destro di questa uguaglianza è, in sostanza, ciò che fanno Q-learning e le sue versioni profonde.
Il dilemma esplorazione–sfruttamento#
C’è una tensione che nessun agente può ignorare, e che riconosciamo tutti.
Hai un ristorante preferito che non delude mai. Provi quello nuovo appena aperto o resti sul sicuro? Se scegli sempre il noto (sfruttamento), non scoprirai mai un posto migliore. Se provi sempre cose nuove (esplorazione), sprechi serate in locali mediocri. Un buon agente fa entrambe le cose: sfrutta ciò che sa quasi sempre, ma ogni tanto azzarda, perché solo azzardando può scoprire ricompense che non sospettava.
Questa ricetta ha un nome, \(\varepsilon\)-greedy, che si legge «epsilon-greedy». Greedy è l’inglese per «avido», cioè chi prende sempre quello che al momento sembra il meglio; ed \(\varepsilon\) (epsilon) è la piccola probabilità con cui invece si azzarda, per esempio una volta su dieci.
Quanto grande tenere quella probabilità dipende da quanto conosci la città. Appena trasferito non hai un preferito da difendere, e i giudizi che ti sei fatto valgono poco: tanto vale provare quasi ogni sera un posto diverso. Dopo un anno di cene i giudizi sono solidi, e continuare a tirare a caso una sera su dieci diventa uno spreco di serate. La quota di azzardo parte alta e si abbassa man mano che si impara.
L’azzardo, poi, si può dosare meglio di un sorteggio. Fra due posti che finora sono sembrati ugualmente buoni si torna volentieri in quello provato meno volte, perché è lì che una sorpresa è ancora possibile; e fra tutti gli altri si torna più spesso in quelli che promettono di più, invece di trattarli tutti allo stesso modo.
Il compromesso si formalizza con strategie come \(\varepsilon\)-greedy: con probabilità \(1-\varepsilon\) l’agente sceglie l’azione stimata migliore, con probabilità \(\varepsilon\) ne prende una a caso.
In pratica \(\varepsilon\) parte alto e decresce nel tempo: si esplora molto all’inizio, quando le stime di \(Q\) sono grezze, e si sfrutta sempre di più man mano che diventano affidabili. Approcci più raffinati non affidano l’esplorazione a una moneta: softmax distribuisce la probabilità in base ai valori stimati, dando più peso alle azioni che promettono di più, mentre Upper Confidence Bound e i bonus di curiosità privilegiano le azioni su cui la stima è più incerta.
Da TD-Gammon in poi#
Il RL non è un’idea nuova, ma ha avuto pochi momenti che ne hanno mostrato la potenza. Nei primi anni Novanta, all’IBM, Gerald Tesauro costruì TD-Gammon [Tes95], un programma che imparò a giocare a backgammon (il gioco da tavolo con le pedine e i dadi) quasi al livello dei campioni umani. Una rete neurale stimava, da ogni posizione, la probabilità di vincere, e dopo ogni mossa la stima della posizione appena lasciata veniva avvicinata a quella della posizione nuova: è l’apprendimento per differenze temporali, nella variante TD(\(\lambda\)) che la sezione sul Q-learning e le differenze temporali ricostruisce. Le partite le giocava contro sé stesso, muovendo da tutte e due le parti, e l’unico segnale esterno era l’esito: nessuno gli diceva quale mossa fosse buona, ma alla fine uno dei due lati aveva vinto, e quel giudizio bastava per capire quali stime rivedere. Le versioni migliori si allenarono su un milione e mezzo di partite, e ne uscirono aperture che i maestri poi adottarono.
Le due tappe successive (il DQN che nel 2015 ha imparato i videogiochi Atari dai soli pixel dello schermo e AlphaGo che nel 2016 ha battuto Lee Sedol al Go) richiedono reti profonde al posto delle tabelle, e aprono il capitolo sul Deep Reinforcement Learning.
Dalla leva sola al mondo che cambia#
Cominciamo da una versione del problema spogliata di tutto tranne il dilemma appena descritto: i bandit a più braccia, cioè file di leve da casinò fra cui scegliere, dove la situazione non cambia mai e l’unica domanda è quale leva tirare. Poi rimettiamo al suo posto la situazione che cambia, e con essa la domanda che tiene insieme tutto il resto: quanto vale trovarsi in una certa situazione, cioè quanti punti ci si può aspettare di raccogliere da lì in avanti.
Dopo i bandit restano tre sezioni, e sono tre risposte a quella domanda, in ordine di quanto pretendono di sapere. La prima pretende la mappa del mondo, cioè dove porta ogni mossa e quanto paga, e con la mappa in mano calcola quei valori senza giocare nemmeno una partita: è ancora pianificazione, come nel capitolo sulla ricerca, e fissa i conti che le altre due rifanno senza mappa. La seconda non pretende niente: gioca partite intere e fa la media di com’è andata. La terza non aspetta nemmeno la fine della partita e corregge a ogni mossa, ed è la strada dell’algoritmo più famoso del campo, il Q-learning. Tutte e tre riempiono la stessa cosa: una grande tabella, con una casella per ogni situazione in cui scrivere quanto vale.
Il passo verso il deep reinforcement learning, dove reti neurali stimano quei valori o direttamente la politica, è una necessità e non un ampliamento facoltativo, perché la tabella diventa impraticabile appena le situazioni possibili sono tante, e va sostituita da qualcosa che sappia indovinare il valore di situazioni mai viste prima. Lo affronta il capitolo sul deep reinforcement learning, che ricostruisce proprio l’agente che ha imparato a giocare a partire dai pixel. Sotto tutte le sigle c’è una domanda sola, guardata da angolazioni diverse: come si impara a decidere quando l’unico maestro è l’esperienza.
Da ricordare
Ci sono tre protagonisti: qualcuno che decide (l’agente), un mondo che risponde (l’ambiente) e un punteggio che dice quanto è andata bene (la ricompensa). Si agisce, il mondo cambia e paga, si ricomincia.
Nessuno dice mai qual era la mossa giusta: il punteggio dice quanto è andata bene, non cosa si doveva fare. E spesso arriva tardi, molte mosse dopo quella che lo ha meritato: capire chi ringraziare è la difficoltà centrale.
Quel che si vuole rendere grande non è il punteggio del momento ma il totale da qui alla fine (il ritorno). Di solito i premi lontani contano meno di quelli vicini, e nei giochi che non finiscono mai è la scelta normale: senza sconto il totale può non fermarsi su nessun numero.
Chi decide i punti è chi imposta il problema, non il mondo: numeri scelti male insegnano il comportamento sbagliato.
Bisogna sempre scegliere fra tornare dove si sa che si sta bene e provare qualcosa di nuovo (il dilemma del ristorante): quasi sempre il noto, ogni tanto una prova a caso.
Tre risultati che hanno fatto la storia: TD-Gammon a backgammon, DQN sui vecchi videogiochi Atari, AlphaGo al Go nel 2016.
Da ricordare
Il RL si regge su tre elementi: un agente che decide, un ambiente che risponde, una ricompensa che valuta. Il ciclo azione → nuovo stato + ricompensa si ripete.
A differenza del supervisionato non ci sono etichette, ma un segnale scalare spesso ritardato: da qui il problema dell’assegnazione del merito.
L’obiettivo è massimizzare il ritorno scontato \(G_t\), non la ricompensa immediata; il fattore \(\gamma\) regola quanto conta il futuro, e nei compiti continui si prende di norma \(\gamma < 1\), perché senza sconto la somma può non convergere (l’alternativa è massimizzare la ricompensa media per passo).
Ogni agente deve bilanciare esplorazione e sfruttamento (per esempio con \(\varepsilon\)-greedy).
La funzione di ricompensa è una scelta di progetto, non un dato dell’ambiente: l’agente ottimizza ciò che è scritto, non ciò che si intendeva, e che ogni scopo stia in un segnale scalare è un’ipotesi (la reward hypothesis).
Tappe simbolo: TD-Gammon (backgammon), DQN sui giochi Atari, AlphaGo (Go, 2016).