


Modelli trasparenti e importanza delle feature#
A metà degli anni Novanta, addestrando un modello per stimare il rischio di morte dei pazienti ricoverati per polmonite, un gruppo di ricercatori di Pittsburgh scoprì che l’algoritmo aveva imparato una regola sorprendente: chi soffre d’asma ha un rischio più basso. Preso alla lettera, un consiglio pericoloso: gli asmatici sono pazienti fragili. La spiegazione era clinica, e sta tutta in quello che i medici facevano con loro. Negli ospedali un asmatico con la polmonite veniva mandato subito in terapia intensiva, proprio perché considerato a rischio, e quelle cure aggressive gli abbassavano la mortalità sotto quella di tutti gli altri. L’asma, di suo, non offriva alcuna protezione. A proteggere era la corsia in cui l’asma ti faceva finire. Il modello aveva colto una correlazione vera nei dati e ne aveva tratto una conclusione che, usata per decidere chi mandare a casa, avrebbe ucciso. La storia (raccontata anni dopo da Rich Caruana e colleghi [CLG+15]) è diventata il manifesto di un campo: se non possiamo guardare dentro un modello, non sappiamo su quali scorciatoie si regge, e non possiamo fidarcene quando la posta è alta.
Ci sono due strade per capire un modello. La prima è sceglierlo trasparente per costruzione, così semplice che la sua logica si legge a occhio nudo. La seconda è tenere il modello com’è, anche se dentro ha milioni di numeri e non si legge affatto, e interrogarlo da fuori: gli si passano dei casi, si guardano le risposte, e si deduce il resto. È la scatola nera della storia degli asmatici; un modello che si legge, per contrasto, si dice scatola bianca.
La prima strada si percorre per intero; della seconda si prende il primo attrezzo che vi si incontra: una classifica delle colonne dei dati, ordinate per quanto pesano sulle risposte. Le colonne di una tabella di dati si chiamano feature, e quella classifica si chiama quindi importanza delle feature. Per un panorama sistematico dell’intero campo il riferimento è il manuale di Molnar [Mol22].
Modelli trasparenti per costruzione#
Alcuni modelli non hanno bisogno di essere spiegati: sono la loro spiegazione. L’esempio più puro è quello che risponde facendo una somma: prende ogni colonna, la moltiplica per un numero suo, e somma tutto. Sono i due modelli incontrati nella sezione sull’apprendimento supervisionato con i nomi di regressione lineare (quando la risposta è una quantità, un prezzo) e regressione logistica (quando è un sì o un no). Quei numeri, uno per colonna, si chiamano pesi (o, con la parola che si usa più spesso in statistica, coefficienti: sono la stessa cosa), e una somma fatta così si dice pesata. Quei pesi descrivono per intero come il modello calcola la risposta: non c’è un altro conto nascosto da qualche parte.

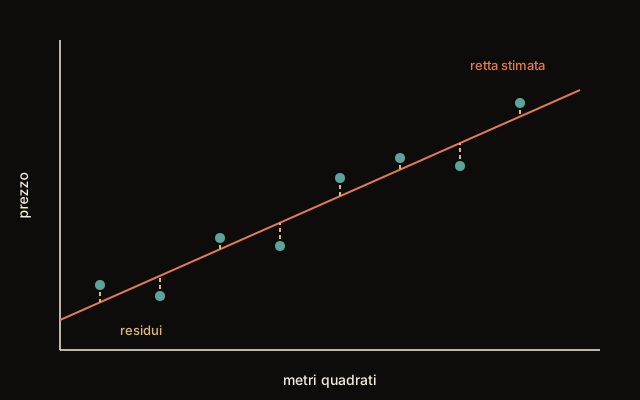
Fig. 37.2 La retta e ciò che le sfugge. Ogni punto è un esempio (una casa, con i suoi metri quadri e il suo prezzo) e il segmento verticale è di quanto il modello sbaglia proprio su quello: si chiama residuo. La retta scelta è quella che li rende complessivamente più piccoli, e li lascia tutti in bella vista.#
C’è una qualità di Fig. 37.2 che un modello con milioni di numeri dentro non ha, ed è la ragione per cui si comincia da qui: la regola che ha prodotto quella retta si legge per intero, ed è una riga sola di somma. I residui, invece, si misurano per qualunque modello, perché basta confrontare la risposta con la verità. Quello che con un modello opaco non si può fare è aprire la regola e vedere quale pezzo del conto ha prodotto proprio quella risposta. Un modello è trasparente quando una persona può leggere per intero la procedura con cui calcola la risposta, e questo vale finché il modello resta piccolo: pochi coefficienti, un albero poco profondo. Una somma con diecimila voci o un albero con trenta livelli di domande sono fatti allo stesso modo, ma nessuno li legge più. E trasparente, comunque, non vuol dire accurato.
Un modello che stima il prezzo di una casa può rispondere come una ricevuta: tanti euro per ogni metro quadro, tanti per ogni stanza, un bonus o un malus per il quartiere. Ogni peso è un cartellino col prezzo appeso a una caratteristica, «\(+2\,000\) € al metro quadro», e i \(210\,000\) € della risposta si leggono voce per voce.
voce |
quanto |
peso |
contributo |
|---|---|---|---|
metri quadri |
90 |
\(+2\,000\) €/m² |
\(+180\,000\) € |
stanze |
3 |
\(+8\,000\) € a stanza |
\(+24\,000\) € |
quartiere |
centro |
\(+6\,000\) € |
\(+6\,000\) € |
totale |
\(210\,000\) € |
Quella tabella è il modello: non c’è un altro posto in cui guardare, e un metro quadro in più fa salire il totale di \(2\,000\) €, senza che nessuna altra riga si muova.
Confrontare due cartellini fra loro è un’altra faccenda. La stanza dice \(8\,000\) e il metro quadro \(2\,000\), e sembrerebbe che le stanze pesino quattro volte tanto; ma una stanza non è un metro quadro, e voci misurate in unità diverse non si mettono in fila. E dove due voci vanno sempre insieme la ricevuta si può riscrivere: se nei dati le case hanno quasi sempre una stanza ogni 30 metri quadri, il cartellino del metro quadro può scendere di 100 € e quello della stanza salire di \(3\,000\) €, e il totale resta \(210\,000\) € (novanta metri fanno \(-9\,000\) €, tre stanze \(+9\,000\) €), e resta quasi uguale su tutte le case fatte così. Il prezzo finale regge; quale delle due righe se lo meriti, non lo dice più nessuno. È il limite della ricevuta: quando due voci vanno sempre insieme, i dati fissano bene il loro totale e male la spartizione, e i due cartellini, letti uno per uno, possono raccontare una storia che con un altro campione di case sarebbe diversa.
Vale lo stesso per la regressione logistica, che al posto di una quantità dà una probabilità: non «sì» o «no» secchi, ma «questo cliente restituirà il prestito con probabilità del 65%». La somma delle voci non è ancora quella probabilità: un totale può venire enorme o negativo, mentre una probabilità sta fra zero e uno, e un ultimo passaggio lo schiaccia dentro quell’intervallo. I pesi si leggono comunque uno per uno, e il segno dice da che parte tira ciascuno, verso il sì o verso il no. Un modello così si stampa su mezza pagina e si discute con chi non ha mai visto una formula, finché le voci sono poche: una ricevuta di diecimila righe si legge riga per riga, ma tutta insieme non la tiene in testa nessuno.
In un modello lineare \(\hat{y} = \mathbf{w}^\top \mathbf{x} + b\) ogni coefficiente \(w_j\) è l’effetto marginale della feature \(j\): a parità di tutte le altre, un aumento unitario di \(x_j\) sposta la predizione di esattamente \(w_j\). Nella regressione logistica \(\hat{y} = \sigma(\mathbf{w}^\top \mathbf{x} + b)\) l’interpretazione passa alle log-odds: detta \(p = P(y = 1 \mid \mathbf{x})\) la probabilità che il modello assegna alla risposta positiva, \(w_j\) è la variazione di \(\log\frac{p}{1-p}\) per un incremento unitario di \(x_j\), cosicché \(e^{w_j}\) moltiplica l’odds \(p/(1-p)\) ed è quindi l’odds ratio fra il dopo e il prima dell’incremento.
Due avvertenze rendono onesta questa lettura. Primo, i coefficienti sono confrontabili tra loro solo se le feature sono standardizzate (stessa scala): un \(w_j\) grande può riflettere semplicemente un’unità di misura piccola. Secondo, l’inciso «a parità di tutte le altre» è fragile quando le feature sono correlate, e la fragilità si misura. Per i minimi quadrati con rumore omoschedastico di varianza \(\sigma_\varepsilon^2\) (la varianza del rumore, da non confondere con la sigmoide \(\sigma\) di poco sopra) vale \(\operatorname{Var}(\hat{\mathbf{w}}) = \sigma_\varepsilon^2(\mathbf{X}^\top\mathbf{X})^{-1}\), e per la singola componente
dove \(R_j^2\) è il coefficiente di determinazione della regressione di \(x_j\) sulle altre feature. Il secondo fattore è il variance inflation factor: con \(R_j^2 = 0{,}99\) la varianza del coefficiente è cento volte quella che avrebbe con feature scorrelate, e il segno stesso di \(\hat{w}_j\) può cambiare da un campione all’altro mentre la predizione resta stabile, perché quello che i dati determinano bene è la somma degli effetti, non la loro spartizione. È la stessa multicollinearità che rende preziosa la regolarizzazione Ridge e Lasso della sezione sull’overfitting, al prezzo di una stima distorta.
Che cosa voglia dire «trasparente» lo precisa Lipton [Lip18], che ne distingue tre livelli: un modello è simulabile se una persona può eseguirne a mente il calcolo per intero, scomponibile se ogni sua parte (un coefficiente, una soglia) ha un’interpretazione, algoritmicamente trasparente se si capisce come l’addestramento ci arriva. Il primo livello dipende dalla dimensione e non dalla famiglia: una regressione su migliaia di feature, una lista di regole ingestibile o un albero profondo smettono di essere simulabili, ed è per questo che Lipton nega che lineari, regole e alberi siano interpretabili di per sé.
La trasparenza non finisce con i modelli lineari. Gli alberi di decisione, studiati nella sezione su alberi e metodi ensemble, sono l’altro archetipo di «scatola bianca»: si parte dalla domanda in cima (che si chiama radice, perché l’albero si disegna capovolto, con le foglie in basso) e a ogni risposta si scende di un ramo, fino a una casella finale che porta la decisione (una foglia). Quel percorso è la spiegazione.

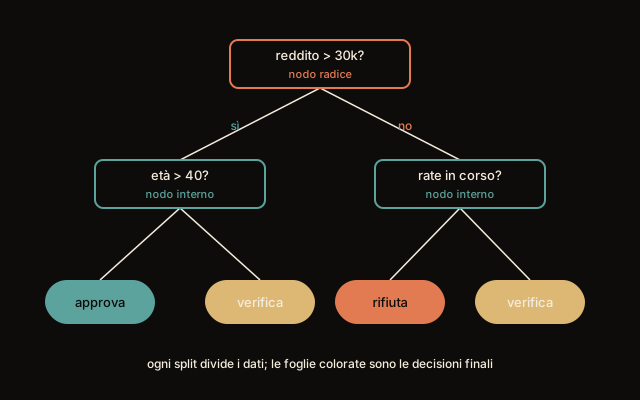
Fig. 37.3 La spiegazione è il percorso. Per sapere perché un esempio ha ricevuto quella risposta si parte dalla radice e si segue, a ogni nodo, il ramo che le sue risposte scelgono: le domande incontrate scendendo sono poche, e si leggono una per una.#
Fig. 37.3 mostra una forma di trasparenza diversa da quella dei modelli lineari, e per certi versi più forte. Un modello lineare spiega con dei pesi, che valgono per tutti gli esempi insieme; un albero spiega questo esempio con una catena di condizioni verificabili una per una.
Sempre fra i modelli trasparenti, e sempre dalla parte della somma anziché da quella delle domande sì/no, stanno i modelli additivi generalizzati, che estendono la regressione lineare sostituendo a ogni peso una curva. Il nome dice il meccanismo: additivi perché la risposta resta una somma di contributi, uno per colonna, che non si mescolano fra loro; generalizzati perché lo stesso impianto va bene sia quando la risposta è una quantità sia quando è una probabilità. Si citano quasi sempre con la sigla inglese, GAM. Come si costruiscono, e che cosa costa la loro ipotesi quando è falsa, lo racconta la sezione su spline e modelli additivi; qui interessa l’altra metà, cioè perché si lasciano leggere.
Nel modello lineare ogni caratteristica porta un cartellino fisso: «\(+2\,000\) € al metro quadro», sempre, dal primo metro all’ultimo, come nella ricevuta di poco fa. Un GAM ammette che il prezzo del metro quadro cambi lungo la scala: i primi cinquanta metri valgono molto, i successivi meno, e oltre una certa soglia quasi niente. Al posto di un numero c’è quindi una curva per ogni caratteristica, che si può guardare e discutere («ecco come cambia il rischio al variare dell’età»). La trasparenza resta intatta, perché le curve non si mescolano: si legge una caratteristica alla volta, come le voci di una ricevuta.
Un GAM scrive
dove ogni \(f_j\) è una funzione liscia stimata dai dati (spline, smoother) e \(g\) è la funzione di legame ereditata dai modelli lineari generalizzati: l’identità in regressione, il logit in classificazione. È \(g\) il «generalizzato» del nome, ed è ciò che rende il modello utilizzabile fuori dal caso di una risposta continua: senza di essa la somma additiva vivrebbe su tutta la retta reale anche quando la quantità da prevedere è una probabilità. Nel caso logit ogni \(f_j\) si legge come contributo alle log-odds, come il termine \(w_j x_j\) della regressione logistica, con la differenza che l’effetto di un’unità in più cambia lungo la scala di \(x_j\) invece di restare \(w_j\) [HT86]. L’additività è ciò che conserva la leggibilità: nessun termine di interazione, quindi ogni curva si può guardare da sola.
E ci sono i sistemi a regole, elenchi di condizioni del tipo «SE il reddito è sotto 20 000 E il contratto è a termine ALLORA nega il prestito», che decidono in un modo che si può leggere riga per riga.
Un sistema a regole si può anche far scrivere ai dati. RuleFit, di Jerome Friedman e Bogdan Popescu [FP08], prende un insieme di alberi già addestrato, ne smonta ogni percorso in una regola del tipo «SE … E …» e fa scegliere a un Lasso le poche regole che servono, accanto a un termine lineare per ogni colonna. Il Lasso è una regressione che fa pagare ogni coefficiente diverso da zero, e per questo ne azzera molti: è la regolarizzazione L1 della sezione sull’overfitting.
Una banca ha un modello fatto di cinquanta alberi, che decide bene e che nessuno sa leggere: ogni risposta è la somma di cinquanta percorsi, uno per albero, e nessuno li segue tutti. Ogni strada che scende dalla cima di un albero fino a uno dei suoi bivi è però una frase che si legge: «SE l’età è sopra 0,6 E il reddito è sotto 0,4», con età e reddito riportati su una scala da 0 a 1, dove 0 è il cliente più giovane (o più povero) e 1 il più anziano (o più ricco). Valgono anche le strade che si fermano a metà, al primo o al secondo bivio: sono frasi più corte, che riguardano più clienti. Da cinquanta alberi escono centinaia di frasi, troppe per chiunque.
Allora si scrive un modello che dà punti, e il totale dei punti è la sua risposta (per la banca, quanto il cliente è rischioso). A ogni frase vera per un cliente si aggiungono i punti di quella frase, e per ogni colonna qualche punto per unità, come in una ricevuta. I punti li sceglie la regola del Lasso. Ogni punto dato costa, e costa uguale che sia il primo o l’ultimo, e lo si compra solo se migliora le risposte più di quanto costa; a una frase che aiuta poco, allora, non conviene darne nemmeno uno, e chi non serve riceve zero punti e sparisce dall’elenco. Quanto conta una frase dipende sia dai suoi punti sia da quanti clienti riguarda. Una frase vera per tutti dà a tutti gli stessi punti e non distingue nessuno, una vera per un cliente su mille ne sposta uno solo. Resta una ricevuta corta, e le frasi con più di una condizione dicono le cose che nessun termine per colonna saprebbe dire, come «l’età conta solo se il reddito è basso».
Proprio perché ogni punto costa, il Lasso ne dà un po” meno del giusto anche alle frasi che servono. Due frasi quasi uguali si dividono i punti che spetterebbero a una sola. E se la regola vera non scatta d’un colpo ma cresce piano, per imitarla servono tante frasi, una per ogni gradino, e la ricevuta torna lunga. RuleFit non promette di battere gli alberi da cui nasce: promette di dire con poche frasi quello che loro dicono con centinaia.
Il modello è
dove \(K\) è il numero di regole estratte e ogni regola \(r_k\) è il prodotto degli indicatori delle condizioni lungo il percorso \(P_k\) dalla radice a un nodo di uno degli alberi; la condizione \(m\) chiede che la colonna \(x_{j_m}\) cada nell’intervallo \(S_m\). Contano tutti i nodi tranne la radice, non solo le foglie, quindi un albero con \(t\) foglie dà \(2(t-1)\) regole. Il termine lineare \(l_j\) della colonna \(j\) (con \(d\) il numero di colonne e \(b_j\) il suo coefficiente, da non confondere con l’intercetta \(a_0\)) è la colonna winsorizzata, con i valori oltre i quantili \(\beta\) e \(1-\beta\) (\(\beta \approx 0{,}025\)) riportati a quei quantili, e poi riscalata a \(0{,}4\,l_j/\mathrm{sd}(l_j)\). Il \(0{,}4\) è la deviazione standard media di una regola con supporto uniforme (\(\mathbb{E}\sqrt{s(1-s)} = \pi/8\) per \(s \sim U(0,1)\)), e mette il termine lineare alla pari con un indicatore davanti alla penalità. Le regole invece si lasciano come sono, di proposito, e così a parità di effetto sulle previsioni paga di più, perché le serve un coefficiente più grande, una regola con supporto vicino a \(0\) o a \(1\), che è stimata su pochi esempi. L’insieme di alberi viene da un procedimento che gli autori chiamano ISLE, di cui il gradient boosting è un caso, con sottocampionamento e un numero di foglie casuale per albero, e i coefficienti si stimano con una penalità L1,
con \(\ell\) il costo di una previsione e \(\lambda\) scelto per validazione incrociata. L’importanza di una regola di supporto \(s_k\) (la frazione di esempi su cui è vera) è \(|a_k|\sqrt{s_k(1 - s_k)}\), cioè il coefficiente per la deviazione standard dell’indicatore; quella di un termine lineare è \(|b_j|\) per la deviazione standard di \(l_j\). Le regole con due o più condizioni sono le interazioni, e si leggono direttamente. I limiti vengono dal Lasso e dalla base. Il Lasso restringe i coefficienti verso lo zero, e fra regole quasi collineari (o fra un termine lineare e le regole a soglia sulla stessa colonna) spartisce il peso in modo instabile da un campione all’altro; la base è fatta di gradini e di rette, e una funzione vera liscia e curva chiede molte regole, cioè una lista lunga.
Il blocco costruisce dati in cui la risposta nasconde una regola a soglia fra due colonne, che quando è vera aggiunge \(3\), più una terza colonna che conta in proporzione, \(2\) per unità, e un rumore. Addestra un gradient boosting (alberi costruiti uno dopo l’altro, ciascuno a correggere gli errori dei precedenti) di cinquanta alberi tutti di due livelli (il lavoro originale ne varia la grandezza), ne estrae le regole e le fa scegliere al Lasso. Poi confronta sui dati di prova tre modelli, la sola somma pesata delle colonne (la regressione lineare), il boosting e RuleFit, con l’\(R^2\), che vale \(1\) per chi indovina ogni risposta e \(0\) per chi risponde sempre la media; e stampa l’\(R^2\) della regola vera, il tetto che il rumore lascia a chiunque.
import numpy as np
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.linear_model import LassoCV, LinearRegression
from sklearn.metrics import r2_score

rng = np.random.default_rng(0)
n, nomi = 3000, ["età", "reddito", "anzianità", "rate", "figli"]
X = rng.uniform(0, 1, size=(n, 5))
# la regola nascosta: un'interazione a soglia, più un effetto lineare
y = 3.0 * ((X[:, 0] > 0.6) & (X[:, 1] < 0.4)) + 2.0 * X[:, 2] + rng.normal(0, 0.3, n)
X_tr, X_te, y_tr, y_te = X[:2000], X[2000:], y[:2000], y[2000:]

foresta = GradientBoostingRegressor(n_estimators=50, max_depth=2, learning_rate=0.1,
                                    subsample=0.5, random_state=0).fit(X_tr, y_tr)

def regole(albero):
    """Ogni nodo che non è la radice è una regola: le condizioni del percorso."""
    t, trovate = albero.tree_, []
    def scendi(nodo, condizioni):
        if t.children_left[nodo] == -1:
            return
        # soglie arrotondate al centesimo e condizioni in ordine fisso:
        # la stessa regola trovata da alberi diversi diventa una sola
        j, s = t.feature[nodo], round(float(t.threshold[nodo]), 2)
        for figlio, segno in ((t.children_left[nodo], "<="), (t.children_right[nodo], ">")):
            nuove = condizioni + ((j, segno, s),)
            trovate.append(tuple(sorted(nuove)))
            scendi(figlio, nuove)
    scendi(0, ())
    return trovate

tutte = sorted({r for stima in foresta.estimators_[:, 0] for r in regole(stima)})
def vale(regola, X):
    ok = np.ones(len(X), bool)
    for j, segno, s in regola:
        ok &= (X[:, j] <= s) if segno == "<=" else (X[:, j] > s)
    return ok.astype(float)
# i termini lineari, riscalati come nel lavoro originale: 0,4 / deviazione standard
# (la winsorizzazione qui si omette: dati uniformi in [0, 1] non hanno code)
scala = 0.4 / X_tr.std(axis=0)
def colonne(A):
    return np.column_stack([vale(r, A) for r in tutte] + [A * scala])
R_tr, R_te = colonne(X_tr), colonne(X_te)
lasso = LassoCV(cv=5).fit(R_tr, y_tr)

# attivi i coefficienti non nulli; secondo il processore alcuni zeri escono
# come residui di arrotondamento dell'ordine di 1e-17, e non vanno contati
attive = np.flatnonzero(np.abs(lasso.coef_) > 1e-10)
print(f"regole candidate: {len(tutte)}, termini tenuti dal Lasso: {len(attive)}")
for nome, modello, A in [("lineare", LinearRegression().fit(X_tr, y_tr), X_te),
                         ("boosting", foresta, X_te),
                         ("RuleFit", lasso, R_te)]:
    print(f"R^2 sul test, {nome:8}: {r2_score(y_te, modello.predict(A)):.2f}")
# il tetto: la regola vera senza il rumore, che nessun modello può battere
vera = 3.0 * ((X_te[:, 0] > 0.6) & (X_te[:, 1] < 0.4)) + 2.0 * X_te[:, 2]
print(f"R^2 sul test, la regola vera: {r2_score(y_te, vera):.2f}")
testo = lambda r: " E ".join(f"{nomi[j]} {s_} {v:.2f}" for j, s_, v in r)
pesi = [(abs(lasso.coef_[k]) * R_tr[:, k].std(), k) for k in attive]
tot = sum(p for p, _ in pesi)
print(f"peso dei tre termini più importanti: {sum(p for p, _ in sorted(pesi, reverse=True)[:3]) / tot:.0%}")
for _, k in sorted(pesi, reverse=True)[:3]:
    if k < len(tutte):
        print(f"{lasso.coef_[k]:+.2f}  SE {testo(tutte[k])}")
    else:                                  # riportato all'unità della colonna
        j = k - len(tutte)
        print(f"{lasso.coef_[k] * scala[j]:+.2f}  per ogni unità di {nomi[j]}")
# l'anzianità non sta solo nel suo termine lineare: di quanto sale in tutto la
# previsione per un'unità in più (da 0,05 a 0,95, sui dati di prova)
alto, basso = X_te.copy(), X_te.copy()
alto[:, 2], basso[:, 2] = 0.95, 0.05
salto = lasso.predict(colonne(alto)) - lasso.predict(colonne(basso))
salita = salto.mean() / 0.9
sola = sum(1 for k in attive
           if k < len(tutte) and all(j == 2 for j, _, _ in tutte[k]))
print(f"regole sulla sola anzianità: {sola};",
      f"in tutto, per unità: {salita:+.2f}")
regole candidate: 239, termini tenuti dal Lasso: 18
R^2 sul test, lineare : 0.47
R^2 sul test, boosting: 0.92
R^2 sul test, RuleFit : 0.95
R^2 sul test, la regola vera: 0.95
peso dei tre termini più importanti: 92%
+2.81  SE età > 0.60 E reddito <= 0.40
+1.64  per ogni unità di anzianità
+0.11  SE età > 0.59 E reddito <= 0.40
regole sulla sola anzianità: 10; in tutto, per unità: +1.94
Delle 239 regole candidate (i 300 percorsi dei cinquanta alberi, sei per albero, meno quelli che coincidono una volta arrotondate le soglie al centesimo) e dei cinque termini lineari il Lasso tiene diciotto termini, e i primi tre portano più di nove decimi del peso. In testa c’è la regola nascosta, «età sopra 0,6 E reddito sotto 0,4», con \(2{,}81\) punti contro i \(3\) veri. Una parte di quelli che mancano va a una regola quasi identica, con la soglia a \(0{,}59\) invece che a \(0{,}60\), che l’arrotondamento non ha fuso con la prima e che si prende \(0{,}11\); il resto va ad altre regole quasi uguali, più piccole, e al Lasso stesso, che fa pagare ogni punto e quindi ne dà un po” meno del giusto. Sull’anzianità si vede l’altro limite. Il suo termine lineare, cioè i punti per ogni unità di anzianità, vale \(1{,}64\) contro i \(2\) veri, e qui l’avarizia del Lasso c’entra poco: dieci piccole regole a soglia sulla sola anzianità aggiungono ciascuna un gradino, e gradini e termine lineare insieme fanno salire la previsione di \(1{,}94\) per unità. Con un altro campione la spartizione fra gradini e retta cambierebbe, e il termine lineare con lei. RuleFit arriva al tetto che il rumore consente, lo stesso \(R^2\) della regola vera, e supera il boosting da cui nasce perché i dati hanno proprio la forma del modello, una regola più una retta, e la retta il boosting la può solo imitare a gradini; sulle funzioni simulate del lavoro originale il vantaggio medio c’è, ma è piccolo. Il modello lineare si ferma a \(0{,}47\) perché una regola a soglia fra due colonne non è una somma di rette.
Si sente dire che la trasparenza si paghi in accuratezza. Dipende dai dati, come ha già mostrato la storia degli asmatici: su tabelle con colonne che hanno un senso il divario fra un modello trasparente ben costruito e una scatola nera è spesso piccolo o nullo, su immagini, testo e suoni le reti profonde sono nettamente più accurate. Resta da vedere come si costruisce, su una tabella, un modello trasparente che regga il confronto con quello che lì va più forte.
Sulle tabelle il modello da battere è di solito il boosting: centinaia di alberi costruiti uno dopo l’altro, ciascuno a correggere gli errori dei precedenti, e nessuno sa leggerlo. Lo si può però costringere a lavorare in un altro modo. A ogni giro un alberello minuscolo che guarda una colonna sola, a turno: prima l’età, poi il reddito, poi la pressione, e di nuovo da capo. Alla fine tutti gli alberelli dell’età si sommano in una curva sola, quanto pesa l’età a ogni età, e lo stesso per ogni colonna. È di nuovo una ricevuta, una voce per colonna, solo che al posto del cartellino fisso c’è una curva; ci si aggiungono poche voci a due colonne, per le coppie che contano davvero insieme, scelte provandole tutte in fretta.
Con un modello di questo tipo Caruana e colleghi sono tornati sui pazienti con la polmonite dell’apertura: la voce dell’asma abbassava il rischio, si vedeva a occhio, e una volta vista la si è potuta correggere a mano.
Ne segue un consiglio pratico, di buon senso: parti dal modello trasparente e misura quanto perdi davvero passando a uno più complicato, invece di darlo per scontato. Se la differenza è minima, la chiarezza è un guadagno netto, e lo è soprattutto dove una decisione sbagliata ha un costo umano. E quando la scatola nera serve per davvero, gli attrezzi che la interrogano da fuori danno una stima di come si comporta, non la regola con cui decide.
Il presunto compromesso accuratezza/interpretabilità è stato messo in discussione, in particolare da Cynthia Rudin [Rud19], che sostiene come su dati strutturati con feature dotate di senso il divario tra un modello interpretabile ben ingegnerizzato e una scatola nera sia spesso trascurabile o nullo. La ragione è che il vantaggio del deep learning si manifesta soprattutto là dove serve apprendere le rappresentazioni da dati grezzi ad alta dimensione (pixel, forme d’onda, token); sui dati tabellari le feature sono già significative, e un modello additivo cattura spesso quasi tutta la struttura utile restando ispezionabile. Il gradient boosting con centinaia di alberi resta fuori: è anzi la scatola nera tipica delle tabelle. Lo diventa se lo si costringe alla forma additiva, addestrando per boosting un albero minuscolo alla volta su una feature sola, a turno, e sommando gli alberi di ogni feature in una curva \(f_j\): è il GA²M di Lou e colleghi [LCGH13], che a \(\sum_j f_j(x_j)\) aggiunge pochi termini a coppie \(f_{jk}(x_j, x_k)\), scelti fra tutte le coppie con una graduatoria rapida (FAST) di quanto ciascuna, su una griglia grossolana, riduce l’errore residuo, e che la libreria InterpretML distribuisce col nome di Explainable Boosting Machine. Con un modello di questa famiglia Caruana e colleghi hanno riletto il caso della polmonite e dell’asma [CLG+15]: la curva dell’asma si poteva guardare, e correggere a mano.
Ne discende una gerarchia metodologica: preferire un modello intrinsecamente interpretabile quando le prestazioni sono comparabili, e riservare gli strumenti post-hoc (importanza delle feature, PDP, e i metodi delle spiegazioni locali) ai casi in cui la scatola nera è davvero necessaria. Gli strumenti post-hoc spiegano il modello dall’esterno e sono approssimazioni: non sostituiscono la trasparenza di progetto.
L’importanza delle feature: quali colonne contano#
Passiamo agli strumenti che interrogano un modello già addestrato, quale che sia. La prima domanda, la più naturale, è: su quali colonne si regge? Vogliamo cioè una classifica delle feature, ordinate per quanto contano nelle risposte.
Spesso la classifica si misura per buttare via qualche colonna: si tira una riga, e le colonne che restano sotto si eliminano dai dati. Quel secondo passo si chiama selezione delle feature, e viene così subito dopo il primo che lo si confonde con lui.

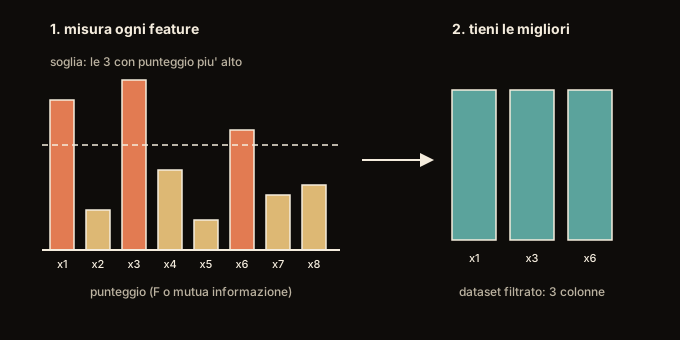
Fig. 37.4 I due passi affiancati. A sinistra si misura: una barra per colonna, e il punteggio scritto sotto è uno dei tanti possibili. A destra si è deciso, e sono rimaste tre colonne su otto.#
I due passi che Fig. 37.4 affianca sono di natura diversa. Una classifica si misura, e viene quel che viene. La riga tratteggiata invece non la dice nessun dato: la decide una persona, e va giustificata con qualcosa d’altro, il costo di raccogliere una colonna, un vincolo di leggibilità, una prova che il modello ridotto non peggiora. Qui interessa la classifica.
Cominciamo dal modo più generale di costruirla. È un metodo che non guarda dentro il modello: lo tratta da scatola nera, gli passa dei casi e si tiene solo le risposte, quindi funziona con qualunque modello.
L’importanza per rimescolamento#
L’ha proposto Leo Breiman nel 2001 per le foreste casuali, e Fisher, Rudin e Dominici l’hanno poi formalizzato per un modello qualsiasi.
L’idea è quasi impertinente: se una colonna conta davvero, allora rovinarla deve far crollare le risposte giuste. Prendiamo un modello che prevede se un cliente restituirà un prestito, e mettiamolo alla prova su 100 clienti mai visti: indovina 90 volte su 100. Ora prendiamo una colonna sola (il reddito) e ne rimescoliamo i valori tra i 100 clienti: ognuno si ritrova il reddito di qualcun altro. Il resto è intatto, ma quella colonna adesso porta numeri che con la persona non c’entrano niente: è diventata rumore, cioè dati che non portano informazione. Riproviamo il modello: ora indovina solo 72 volte. Ha perso 18 punti solo perché gli abbiamo scombinato il reddito, segno che ci si appoggiava molto, e quel calo, \(90\% - 72\% = 18\) punti, è l’importanza del reddito.
Rifacciamo lo stesso gioco con una colonna che non c’entra nulla, il colore preferito: rimescolandola, il modello continua a indovinare 90 volte. Calo zero, importanza zero. Poiché il rimescolamento è casuale, lo si ripete qualche volta e si fa la media, per non farsi ingannare da un mescolamento fortunato. Il bello è che il trucco funziona con qualsiasi modello: basta potergli fare delle domande e sentire le risposte.
Rimescolare i valori di una colonna, in matematica, si dice permutarli: da qui il nome con cui il metodo si trova nelle librerie, permutation importance.
C’è un caso in cui quel calo va letto con attenzione, ed è quello delle colonne gemelle dell’apertura. Se la tabella tiene, accanto al reddito dell’anno, anche lo stipendio del mese, rimescolare il reddito non fa danni: il modello legge l’altra colonna e il calo resta piccolo. Quel numero basso è vero se la domanda è di che cosa il modello ha bisogno, perché gli basta una delle due colonne; inganna chi ci legge quanta informazione porti il reddito, che ne porta eccome. È il bivio dell’apertura, quello fra spiegare il programma e spiegare il mondo, che torna qui con un numero. Il rimedio è rimescolare le due gemelle insieme, con lo stesso giro di carte: il calo che ne esce dice quanto valgono le due assieme, comunque il modello se le sia spartite.
C’è poi il guasto opposto, e viene dal rimescolamento stesso: si fabbricano clienti impossibili, un ventenne con la pensione di un ex dirigente. Su gente mai vista il modello risponde come capita, il calo si gonfia, e quella colonna sembra contare più del vero.
Formalizziamo. Sia \(f\) il modello addestrato e \(e_{\text{orig}} = \mathcal{L}(f, \mathcal{D})\) il suo errore (o l’opposto di uno score: MSE in regressione, \(1-\text{acc}\) in classificazione) su un insieme di valutazione \(\mathcal{D} = (\mathbf{X}, \mathbf{y})\). Per la feature \(j\) si costruisce \(\mathbf{X}_{\pi_j}\), copia di \(\mathbf{X}\) in cui i valori della sola colonna \(j\) sono permutati casualmente lungo le righe (rompendo il legame tra \(x_j\) e \(y\) ma preservandone la distribuzione marginale) e si misura \(e_{\pi_j} = \mathcal{L}(f, (\mathbf{X}_{\pi_j}, \mathbf{y}))\). L’importanza è il peggioramento
media su \(K\) permutazioni indipendenti (in scikit-learn, n_repeats), che
fornisce anche una deviazione standard. Introdotta da Breiman con le foreste
casuali [Bre01a] e in seguito formalizzata da Fisher, Rudin e
Dominici [FRD19] come model reliance (nella loro variante
il rapporto
\(e_{\pi_j}/e_{\text{orig}}\) anziché la differenza) è model-agnostic:
richiede solo il forward del modello e un insieme etichettato.
Due accortezze. La misura va calcolata su dati held-out: sul training essa racconta quanto il modello si è appoggiato a \(x_j\) per memorizzare, non quanto quella feature aiuti a generalizzare. E le feature correlate portano due guai distinti. Il primo: il modello recupera l’informazione dalla colonna gemella non permutata, e l’importanza, spartita fra le due, risulta sottostimata. Il secondo: la permutazione crea combinazioni irrealistiche (un’altezza da adulto con un peso da bambino) su cui il modello viene interrogato fuori dal supporto dei dati, e l’errore così gonfiato può sovrastimare l’importanza delle feature coinvolte [HMZ21]: la stessa patologia di estrapolazione che affligge il Partial Dependence Plot (PDP). I due guasti non si correggono insieme: permutare \(x_j\) dentro gruppi di righe simili (permutazione condizionata) toglie di mezzo le combinazioni irrealistiche, ma accentua la sottostima, perché a ciascuna delle due colonne gemelle resta soltanto l’informazione che aggiunge all’altra. E la sottostima pesa su chi chiede «quanta informazione porta questa colonna»; a chi chiede «di che cosa ha bisogno questo modello» quel valore basso risponde il vero, ed è la forcella vista in apertura di capitolo. Il rimedio pratico alla sottostima è l’importanza di gruppo: si applica la stessa permutazione delle righe a tutte le colonne di un gruppo correlato e si legge l’importanza dell’insieme, che non dipende da come il modello si è spartito il lavoro fra loro. Quanto all’incertezza, la deviazione standard che accompagna \(\mathrm{FI}_j\) misura la variabilità dei rimescolamenti, non quella del campione di valutazione: con poche righe di prova sottostima l’incertezza vera.
Importanza da impurità (e la sua distorsione)#
C’è un secondo modo di fare la classifica, e viene gratis con gli alberi.
Ogni taglio di un albero (in inglese split) è una domanda con una soglia dentro, «il reddito supera i 30 000?», e l’albero sceglie la colonna e la soglia che rendono più omogenei i due gruppi di esempi in cui il taglio divide il nodo. Quanto un gruppo è mescolato si chiama impurità, e si misura con l’indice di Gini o con l’entropia, già incontrati nella sezione su alberi e metodi ensemble: è massima quando nel gruppo ci sono risposte di tutti i tipi, zero quando sono tutte uguali. Il calo d’impurità che un taglio produce è il merito che si accredita alla colonna su cui il taglio è stato fatto. E per una colonna con tanti valori diversi le soglie fra cui scegliere sono tantissime.
L’albero, dunque, mentre impara tiene già il conto di questi meriti, e basta
sommarli per avere la classifica. In una foresta casuale, come quella
dell’apertura del capitolo, i meriti si sommano su tutti gli alberi, che sono
centinaia e crescono ciascuno su un campione delle righe estratto a sorte (e,
a seconda delle impostazioni, su un sottoinsieme a sorte delle colonne). Questa
misura si chiama, con la sigla inglese che si trova ovunque, MDI (mean
decrease in impurity, cioè calo medio dell’impurità), ed è quella che
scikit-learn restituisce in feature_importances_. È rapidissima, perché non
c’è niente da calcolare dopo, ma va letta con prudenza, per due ragioni.
L’importanza da impurità premia le feature che l’albero usa spesso per tagliare. Il problema è che una feature con tanti valori diversi (un’età precisa al giorno, un importo in centesimi) offre all’albero un’enorme quantità di soglie tra cui scegliere, e con così tante possibilità ne trova quasi sempre una che, per puro caso, separa un po’ i dati. Così accumula «meriti» anche quando non porta vera informazione. Una feature con pochi valori (sì/no, tre categorie) parte invece svantaggiata: ha poche soglie da provare.
Il risultato è che l’importanza da impurità tende a gonfiare le feature continue o con molte categorie e a sminuire quelle a pochi valori: un difetto strutturale, non del singolo insieme di dati. Due colonne di puro rumore date in pasto al modello, una con tanti valori e una con due soli, lo mettono in chiaro: valgono zero tutte e due, e questa misura ne premia una sette volte più dell’altra.
C’è poi un guasto di natura diversa. Questi meriti l’albero se li accredita mentre impara, cioè sugli stessi esempi da cui sta imparando. Ma su quegli esempi un taglio sembra sempre utile, anche quando ha soltanto imparato a memoria una particolarità di quei dati che non si ripeterà altrove (si dice che il modello sovradatta). Il merito resta accreditato lo stesso. Il rimescolamento, che si può misurare su esempi che il modello non ha mai visto, di questo problema non soffre: a una colonna inutile dà zero in media, anche se su quelle con tanti valori, che gli alberi usano di più, il risultato oscilla di più da una prova all’altra. Ed è la ragione per cui, dovendo scegliere, ci si fida di quello.
Prima la definizione. Nell’albero \(t\) ogni nodo interno \(v\) divide i suoi \(n_v\)
esempi in un figlio sinistro \(L\) e uno destro \(R\), con una riduzione di
impurità pesata
\(\Delta i(v) = i(v) - \frac{n_L}{n_v}\,i(L) - \frac{n_R}{n_v}\,i(R)\), dove \(i\)
è l’indice di Gini o l’entropia in classificazione e la varianza in
regressione. L’importanza della feature \(j\) nell’albero è la somma dei
\(\frac{n_v}{n}\,\Delta i(v)\) sui nodi \(v\) che tagliano su \(j\), con \(n\) gli
esempi alla radice; scikit-learn la normalizza perché sommi a uno su tutte le
feature dell’albero, e poi media sui \(T\) alberi:
con \(j(v)\) la feature su cui taglia il nodo \(v\) (in una foresta \(n_v\) conta gli esempi del campione bootstrap, ripetizioni comprese). Poiché \(i\) è concava, \(\Delta i(v) \ge 0\) per ogni taglio: la MDI non può essere negativa.
Il bias della MDI è verso le feature ad alta cardinalità e quelle continue, ed è stato stabilito da Strobl, Boulesteix, Zeileis e Hothorn [SBZH07], che ne identificano due sorgenti distinte.
La prima è combinatoria: il numero di split candidati cresce con
il numero di valori distinti, e massimizzare la riduzione d’impurità su molti
tagli equivale a un test statistico con molte comparazioni (una feature
puramente casuale ma continua ottiene, in aspettazione, un guadagno positivo
per sovradattamento locale). La seconda sta nel campionamento bootstrap con
reimmissione, che è il default di RandomForestRegressor: pescare con
ripetizione induce fra le feature e la risposta associazioni che nella
popolazione non ci sono, e l’effetto è tanto più marcato quanti più valori la
feature ha. A
queste si aggiunge il fatto, indipendente dai due, che la stessa documentazione
di scikit-learn ricorda: feature_importances_ è calcolata sul training
set, quindi ogni colonna su cui gli alberi hanno tagliato accumula merito
anche quando quel taglio era sovradattamento.
Rispetto alla permutation importance, la MDI ha due svantaggi: è legata alla struttura interna del modello (vale solo per gli alberi) ed è misurata sui dati di addestramento. La permutazione, calcolata su un hold-out, è model-agnostic e riflette la generalizzazione; è la stima che la sezione sugli alberi e gli ensemble già raccomandava di preferire. Nemmeno la permutazione, però, esce indenne dal lavoro di Strobl. Calcolata come nelle foreste di Breiman, sugli esempi rimasti fuori dal campione bootstrap di ciascun albero, sulle colonne inutili ha media vicina a zero, come deve, ma una dispersione che cresce con il numero di valori distinti, perché gli alberi le usano di più: in una singola prova una colonna con tanti valori può risultare sopra o sottostimata per puro caso. La loro soluzione completa prevede alberi a selezione non distorta più sottocampionamento senza reimmissione. Su un campione di prova indipendente, poi, una colonna di puro rumore, indipendente dalla risposta e dalle altre colonne, ha importanza attesa esattamente nulla per qualunque modello fissato, comunque gli alberi l’abbiano usata: rimescolarla non cambia la distribuzione congiunta dei dati, quindi in media non può cambiare l’errore. Entrambe, comunque, restano misure di importanza globale: dicono quanto una feature conta in media su tutto il dataset, non per la singola predizione.
Come agisce una feature, non solo quanto#
Sapere quanto una feature conta non dice come agisce. Il prezzo sale o scende con i metri quadri? Ogni metro in più vale quanto il precedente, o dopo i primi cento non conta più niente? La prima domanda è sul segno, la seconda sulla forma, e per rispondere serve disegnare una curva: sull’asse orizzontale i valori della colonna, su quello verticale la risposta del modello. Tre strumenti permettono di disegnare quella curva in modi diversi, e si citano tutti con la sigla inglese.
Il primo si chiama PDP (Partial Dependence Plot) ed è come chiedere a tutta la popolazione: «e se aveste tutti quarant’anni?». In pratica si prende l’elenco dei clienti, si riscrive a tutti la stessa età, quaranta, lasciando invariato tutto il resto, si chiedono al modello le risposte e se ne fa la media. Poi si rifà con 41 anni, con 42, e così via. Unendo i punti viene fuori una curva, ed è l’effetto medio dell’età.
C’è un limite: la media può nascondere storie opposte. Se l’età fa salire la risposta per metà dei clienti e scendere per l’altra metà, la curva media resta piatta e ti fa credere che l’età non conti. Il rimedio è la curva ICE (Individual Conditional Expectation): invece della sola media, disegni una curva per ogni cliente. Un fascio di curve che vanno in direzioni diverse rivela subito che l’effetto non è uguale per tutti.
C’è un secondo limite, più insidioso, e per quello esiste un attrezzo diverso. Riscrivere a tutti la stessa età va bene finché l’età non è legata ad altro; ma se due colonne vanno sempre insieme (l’altezza e il peso, per dire) riscriverne una sola fabbrica persone che non esistono, alte due metri e pesanti cinquanta chili. Di persone del genere il modello non ne ha mai viste, quindi risponde a caso, e la curva che ne esce è la media di un mucchio di risposte a caso.
Il rimedio si chiama ALE (Accumulated Local Effects, effetti locali accumulati), e il nome dice il metodo. Non si chiede più niente a tutta la popolazione: si divide la colonna in fascette sottili (i quarantenni, i quarantunenni, e così via) e dentro ciascuna fascetta si lavora solo con chi in quella fascetta ci sta davvero. Per quelle persone, e solo per loro, si interroga il modello due volte: una con l’età portata all’estremo basso della fascetta e una all’estremo alto. La differenza fra le due risposte, mediata su di loro, è quanto conta un anno in più per chi ha quell’età lì, ed è uno scalino. Nessuno viene inventato, perché a un quarantenne stiamo chiedendo di avere quarantun anni, non cinquanta.
Poi quegli scalini si sommano uno dopo l’altro, dal primo all’ultimo (ecco gli «accumulati»): il primo parte da zero, il secondo si appoggia sul primo, e la scaletta che viene fuori è la curva. Si preferisce al PDP proprio quando le colonne si muovono insieme. Una scaletta per l’età, però, racconta l’età da sola: se l’età conta in un modo per chi guadagna poco e in un altro per chi guadagna tanto, per vederlo serve una scaletta a due colonne insieme.
Per la feature \(j\), la partial dependence è l’attesa della predizione marginalizzando sulle altre feature \(\mathbf{X}_{-j}\), stimata sul dataset come
dove si fissa \(x_j = v\) e si mediano le predizioni su tutti gli esempi [Fri01]. La curva ICE è la stessa quantità prima di mediare: \(f(v, \mathbf{x}_{-j}^{(i)})\) per il singolo esempio \(i\) [GKBP15]. Il PDP è dunque la media verticale del fascio di ICE; quando le curve ICE si sventagliano, un effetto medio piatto maschera interazioni o eterogeneità.
Il difetto profondo del PDP è l’estrapolazione con feature correlate: fissare \(x_j = v\) mentre si tengono i valori reali di \(\mathbf{X}_{-j}\) genera punti \((v, \mathbf{x}_{-j}^{(i)})\) implausibili (altezza 2 m con peso 50 kg) su cui il modello viene interrogato fuori dal supporto dei dati, producendo curve fuorvianti. L’Accumulated Local Effects (ALE) di Apley e Zhu [AZ20b] corregge il tiro: invece di marginalizzare su tutta la distribuzione, media le differenze di predizione entro piccoli intervalli di \(x_j\), usando la distribuzione condizionata e restando così nelle regioni densamente popolate. Divisa la scala di \(x_j\) in intervalli di estremi \(z_{0,j} < z_{1,j} < \dots < z_{H,j}\) (di solito ai quantili, così che ciascuno contenga lo stesso numero di esempi), e detto \(N_j(h)\) l’insieme degli esempi con \(x_j\) nell’intervallo \(h\), lo stimatore non centrato è
dove \(h_j(v)\) è l’intervallo che contiene \(v\); gli si sottrae poi la media sugli esempi, così che l’effetto medio sia nullo. Ogni esempio viene spostato solo fino ai bordi del proprio intervallo, mai fino a un valore lontano, e lì sta la protezione dall’estrapolazione; il prezzo è una curva che dipende dal numero di intervalli e che, con pochi esempi per intervallo, si fa rumorosa. È la scelta da preferire quando le feature sono marcatamente correlate. Costa anche meno: PDP e ICE su una griglia di \(G\) valori interrogano il modello \(G\,m\) volte, l’ALE \(2m\) volte, perché ogni esempio si porta soltanto ai due estremi del suo intervallo. La curva ALE di primo ordine descrive però l’effetto principale di \(x_j\), e le interazioni con un’altra feature chiedono gli effetti di secondo ordine, definiti dagli stessi autori su coppie di feature. La scelta fra i due non è fra un metodo giusto e uno sbagliato, ma è di nuovo la forcella dell’apertura: il PDP marginale risponde a «che cosa farebbe questo modello se gli riscrivessi una colonna», l’ALE condizionato a «come si comporta la predizione lungo i dati che esistono davvero».
In pratica: rimescolamento contro impurità#
Torniamo alle due classifiche, per rimescolamento e da impurità, e mettiamole
a confronto su dati veri. PDP, ICE e ALE rispondevano a «come agisce una
colonna»; adesso si torna alla domanda di prima, «quanto conta», e si guarda
quale dei due modi di misurarla è affidabile. Ne useremo una raccolta che si
studia da decenni, distribuita insieme alla libreria scikit-learn e che si
chiama diabetes. È una tabella di 442 righe, una per paziente diabetico, e
dieci colonne di misure cliniche: l’età, il sesso, l’indice di massa corporea
(bmi), la pressione (bp) e sei valori del sangue, chiamati da s1 a s6.
La cosa da prevedere, in ogni riga, è quanto la malattia sarà progredita dopo un
anno; la colonna da prevedere si chiama, in gergo, il target, ed è l’unica
che il modello non riceve in ingresso.
I 442 pazienti li dividiamo in un insieme di addestramento, circa il 70% (309 righe), su cui il modello impara, e in un insieme di prova, o test, il restante 30% (133 righe), che il modello vede solo alla fine, su casi che non ha mai incontrato. La distinzione fra i due è metà della morale.
E poi un accorgimento, che è il vero esperimento: aggiungiamo alla tabella due colonne inventate, riempite di numeri tirati a sorte e senza alcun rapporto con la malattia. Una continua (numeri con la virgola, tutti diversi fra loro), una binaria (soltanto 0 o 1). Sappiamo per costruzione che non valgono niente, tutte e due allo stesso modo, e proprio per questo servono: sono il metro con cui leggere ciò che le due misure diranno. Su questa tabella a dodici colonne facciamo crescere una foresta casuale, e poi chiediamo a entrambe le tecniche quali colonne contano. Il programma stampa le dodici colonne ordinate per importanza da impurità, con accanto quella per rimescolamento.
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split
from sklearn.inspection import permutation_importance

dati = load_diabetes()
X, y, nomi = dati.data, dati.target, list(dati.feature_names)

# Due colonne di puro rumore, scorrelate dal target: una continua e una binaria.
# Non valgono niente ne l'una ne l'altra: servono da metro per le due misure.
rng = np.random.default_rng(0)
X = np.column_stack([X, rng.normal(size=len(y)), rng.integers(0, 2, size=len(y))])
nomi += ["rumore_cont", "rumore_bin"]

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0)

rf = RandomForestRegressor(n_estimators=300, random_state=0)
rf.fit(X_tr, y_tr)
print("R^2 sul test:", round(rf.score(X_te, y_te), 3))  # -> 0.315

# Importanza da permutazione, misurata sul TEST (10 mescolamenti per feature)
pi = permutation_importance(rf, X_te, y_te, n_repeats=10, random_state=0)

print("feature      (impurita)   perm-import   valori distinti")
for i in np.argsort(rf.feature_importances_)[::-1]:   # dalla piu alta per la MDI
    print(f"{nomi[i]:>11}   {rf.feature_importances_[i]:.4f}      "
          f"{pi.importances_mean[i]:+.3f} +/- {pi.importances_std[i]:.3f}"
          f"   {len(np.unique(X_tr[:, i])):5d}")
R^2 sul test: 0.315
feature      (impurita)   perm-import   valori distinti
        bmi   0.2972      +0.179 +/- 0.023     140
         s5   0.2959      +0.188 +/- 0.065     156
         bp   0.0914      +0.035 +/- 0.012      87
         s3   0.0584      -0.015 +/- 0.015      59
         s6   0.0506      -0.001 +/- 0.008      56
rumore_cont   0.0467      +0.004 +/- 0.012     309
         s2   0.0420      +0.002 +/- 0.009     238
        age   0.0411      +0.005 +/- 0.011      57
         s1   0.0374      +0.002 +/- 0.007     127
         s4   0.0253      -0.009 +/- 0.008      53
        sex   0.0075      +0.004 +/- 0.002       2
 rumore_bin   0.0065      -0.002 +/- 0.002       2
Prima di leggere la classifica, i tre numeri che la compongono, uno alla volta.
Il primo è l’\(R^2\) del modello sui dati di prova, già incontrato con RuleFit: vale \(1\) per chi indovina la progressione di ogni paziente, \(0\) per chi risponde sempre la media, e scende sotto zero per chi fa peggio della media. Il nostro modello prende \(0{,}315\), cioè spiega circa un terzo della variabilità della progressione, e il numero va tenuto a mente: l’importanza che stiamo per leggere descrive questo modello, che non è molto accurato, non la verità clinica.
Il secondo, la colonna dell’impurità, è il merito accumulato dai tagli. È distribuito su tutte le colonne come una torta: i dodici numeri sommano a 1, e infatti si leggono come frazioni del merito totale.
Il terzo, la colonna del rimescolamento, è il calo di quel primo numero,
l’\(R^2\), quando la colonna viene rimescolata. Le due colonne di numeri non sono
quindi nella stessa unità di misura: la prima è una fetta di torta, la seconda
è un danno misurato in \(R^2\) perduto. Il «\(\pm\)» accanto dice quanto quel danno
balla fra un rimescolamento e l’altro dei dieci provati (nella stampa, dove i
simboli matematici non si possono scrivere, quel «più o meno» compare come
+/-).
Fatta la lettura, le due misure concordano sull’essenziale: bmi e s5 (un
valore del sangue legato ai grassi che vi circolano) dominano, bp le segue,
il resto conta poco. Ma emergono anche le differenze attese, e le due colonne
inventate le rendono misurabili.
La prima differenza è il segno. Diverse colonne hanno un’importanza da
rimescolamento lievemente negativa (s3, s4, s6, e il rumore binario):
rimescolarle migliora di un soffio le risposte. Nessun paradosso: sono
numeri dell’ordine del centesimo, e quel poco dipende da quali 133 righe sono
capitate nell’insieme di prova, tanto che estraendole in un altro modo lo
stesso s3 può venire positivo. Il modo giusto di leggerli è «quella colonna
non serviva». La misura da impurità questo non lo può dire, perché non scende
mai sotto zero: con i criteri che gli alberi usano nessun taglio può alzare
l’impurità, quindi ogni taglio accredita merito positivo, e nel suo linguaggio
la frase «questa colonna non serve» letteralmente non esiste.
La seconda differenza è la distorsione, e adesso si vede. Il rumore_cont
prende un’impurità di \(0{,}0467\): più di s2, di age, di s1 e di s4, che
sono indicatori clinici veri. Il rumore_bin, altrettanto inutile, prende
\(0{,}0065\): fra due colonne che valgono entrambe esattamente zero c’è un
fattore \(7{,}2\). La differenza che conta sta nell’ultima colonna della
stampa, quanti valori distinti contengono nelle 309 righe su cui gli alberi
sono cresciuti: 309 la prima, cioè un valore diverso per ogni riga; due la
seconda. È la distorsione verso le colonne con tanti valori, misurata invece
che affermata.
E il rimescolamento, sulle stesse due colonne inventate, dà \(+0{,}004\) e \(-0{,}002\): zero entrambe, come dev’essere. Su questo non si fa ingannare dal numero di valori, perché non guarda le soglie: guarda soltanto se il modello peggiora. Il numero di valori si vede semmai nell’oscillazione, \(\pm 0{,}012\) per la colonna continua, che gli alberi usano di più, contro \(\pm 0{,}002\) per la binaria.
La riga di sex, invece, va letta con prudenza. È una colonna vera, non
inventata da noi, ed è ferma a \(0{,}0075\), cioè al livello del rumore binario, e
verrebbe voglia di dire che è la sua binarietà a penalizzarla. Può darsi, ma la
tabella non lo dimostra: anche il rimescolamento le dà quasi zero, quindi il
sesso potrebbe semplicemente contare poco per questo modello, e le due
spiegazioni producono lo stesso numero. È esattamente per questo che le colonne
inventate servono: di quelle sappiamo in partenza che non valgono niente, e ogni
merito che ricevono è distorsione e basta.
Resta da spiegare perché s3 e s6 prendano un’impurità non trascurabile
(circa \(0{,}05\)) benché il rimescolamento li dichiari inutili. Qui le due
ragioni agiscono insieme, dentro lo stesso numero. La prima è quella di
poco fa: l’ultima colonna della stampa dice che nelle 309 righe di
addestramento s3 e s6 hanno 59 e 56 valori distinti, molti meno del rumore
continuo ma moltissimi di più di sex, che ne ha due, e tante soglie fra cui
scegliere bastano perché una colonna debole si guadagni comunque un po’ di
merito. La seconda è che i meriti sono accreditati sulle stesse 309 righe da
cui gli alberi hanno imparato: là un taglio su s3 sembrava utile, sulle 133
righe di prova non serve più. Due meccanismi diversi, sommati dentro un numero
solo che non dice quanto spetti a ciascuno: è per questo che la colonna
dell’impurità non va letta come una classifica.
Spiegare con gli esempi: prototipi e critiche#
Le spiegazioni viste finora parlano di colonne: quali contano e come agiscono. Si può spiegare anche con degli esempi, come fa chi, per far capire che cosa c’è in un archivio, ne mostra pochi pezzi scelti bene. Sono i prototipi, pochi casi che rappresentano bene l’insieme dei dati, accompagnati da qualche critica, i casi che i prototipi rappresentano male. MMD-critic di Kim, Khanna e Koyejo [KKK16] sceglie gli uni e gli altri con la maximum mean discrepancy (MMD): un numero che dice quanto due raccolte di punti si spargono in modo diverso, e che vale zero quando si spargono allo stesso modo. È la stessa misura con cui il monitoraggio della deriva confronta la finestra di riferimento con quella corrente; qui le due raccolte sono i dati e i soli prototipi. Con un modello la sintesi lavora in due modi. I prototipi possono diventare essi stessi un classificatore, che risponde col prototipo più vicino e si spiega mostrandolo; oppure si guardano le risposte di una scatola nera proprio su prototipi e critiche, dove una lacuna dei dati si fa vedere.
Chi deve capire in fretta che cosa c’è in un archivio di diecimila foto di animali non vuole le medie dei pixel: vuole dieci foto scelte bene. Le dieci foto devono stare dove le foto sono tante, e distribuirsi come l’archivio: se metà dell’archivio sono cani, metà delle foto scelte sono cani.
Per misurare quanto la selezione somiglia all’archivio si dispongono le foto su un grande tavolo, quelle che si somigliano vicine fra loro. Poi si passa in rassegna ogni zona del tavolo, e in ciascuna si confronta quante foto dell’archivio le stanno vicine con quante della selezione, in proporzione (se attorno a una zona sta il 30% dell’archivio, lì dovrebbero cadere tre delle dieci foto scelte). La differenza, elevata al quadrato e sommata su tutte le zone, è la MMD al quadrato, che fa zero solo se le due raccolte si spargono sul tavolo allo stesso modo.
Tutto dipende da che cosa vuol dire «vicino». Con una misura troppo larga ogni foto è vicina a ogni altra, e dieci foto qualunque sembrano rappresentare tutto; con una troppo stretta ogni foto è un caso a sé, e dieci non bastano mai.
Si sceglie una foto alla volta, ogni volta quella che abbassa di più la differenza. È un modo svelto, e non promette di trovare la selezione migliore. La garanzia che il metodo dichiara vale solo con un «vicino» così stretto che ogni foto è un caso a sé, e lì non serve, perché tutte le selezioni di dieci foto si equivalgono. Con un «vicino» utile si va senza garanzie, e si sceglie così perché in pratica funziona.
Poi si cercano le critiche. La stessa differenza, zona per zona e senza elevarla al quadrato, dice dove l’archivio ha più foto di quante la selezione ne lasci immaginare: si chiama funzione testimone, perché testimonia, punto per punto, dove le due raccolte differiscono, e le critiche sono le foto dove è più alta. Un piccolo gruppo di animali rari, poniamo duecento foto su diecimila, può restare senza nessuna delle dieci foto scelte: ognuna ne rappresenta in media un migliaio, e a ogni passo una foto in più fra i cani abbassa la differenza più di una foto fra i rari. Ed è proprio lì che le critiche puntano. Mostrare solo i prototipi darebbe un’idea troppo pulita dell’archivio: le critiche dicono dove la sintesi tace. Le critiche, poi, si vogliono diverse fra loro, perché tre foto dello stesso animale raro direbbero tre volte la stessa cosa. E si guarda anche il verso opposto, le zone dove la selezione promette più foto di quante l’archivio ne abbia.
Siano \(X = \{\mathbf{x}_1, \dots, \mathbf{x}_n\}\) i dati in \(\mathbb{R}^d\), \(Z\) un insieme di prototipi scelti fra loro e \(k\) il nucleo gaussiano di larghezza \(\sigma\), \(k(\mathbf{x}, \mathbf{x}') = \exp\big(-\lVert\mathbf{x} - \mathbf{x}'\rVert^2 / (2\sigma^2)\big)\). La stima dell’MMD al quadrato fra la distribuzione empirica dei dati e quella dei prototipi è
Con il nucleo gaussiano è, a meno del fattore \((2\pi\sigma^2)^{d/2}\), l’integrale del quadrato della differenza fra le due distribuzioni lisciate con una gaussiana di larghezza \(\sigma/\sqrt{2}\), e si annulla solo quando le due coincidono, perché il nucleo gaussiano è caratteristico. I prototipi si scelgono in modo avido, aggiungendo a ogni passo quello che abbassa di più \(\mathrm{MMD}^2\), cioè che alza di più \(J(Z)\), l’opposto di \(\mathrm{MMD}^2\) senza il termine fra i soli dati, che non dipende dalla scelta. Gli autori enunciano che \(J\) è monotona e submodulare se la matrice del nucleo ha diagonale costante \(k^*\) e termini fuori diagonale fra \(0\) e \(k^*/(n^3 + 2n^2 - 2n - 3)\), e ne ricavano, con il risultato classico sulle funzioni submodulari [NWF78], che la scelta avida arriverebbe almeno a \(1 - 1/e \approx 0{,}63\) del valore ottimo di \(J\) fra gli insiemi della stessa taglia. Quella condizione però fa del nucleo quasi l’identità (con un nucleo gaussiano chiede una larghezza sotto la distanza fra i due punti più vicini divisa per circa \(\sqrt{2\ln n^3}\)), e lì \(J(Z) = k^*\,(2/n - 1/|Z|)\) a meno di \(O(k^* n^{-3})\), per qualunque \(Z\). Gli insiemi della stessa taglia si equivalgono, e per \(|Z| < n/2\) il valore è negativo, sotto \(J(\emptyset) = 0\): la monotonia cade al primo passo, e un rapporto fra due valori negativi non promette niente. Nell’uso la scelta avida è un’euristica senza garanzia, che gli autori difendono col buon comportamento pratico dell’avido sui problemi submodulari. Le critiche vengono dalla funzione testimone,
positiva dove i dati sono più densi di quanto i prototipi dicano, negativa dove i prototipi li sovrarappresentano; la sua media sui dati meno la sua media sui prototipi è di nuovo \(\mathrm{MMD}^2\). La \(\mathrm{MMD}\) chiede ai prototipi di riprodurre le proporzioni dei dati, non di coprirne lo spazio: un gruppo piccolo può restare senza prototipi, perché ogni prototipo in più dove la massa è grande abbassa \(\mathrm{MMD}^2\) di più (un clustering che minimizza le distanze, come il \(k\)-means, al gruppo lontano un centro lo darebbe), ed è lì che \(\psi\) è positiva e grande. Il lavoro originale sceglie un insieme di critiche \(C\) che massimizza \(\sum_{\mathbf{x} \in C} |\psi(\mathbf{x})|\) più il log-determinante del nucleo ristretto a \(C\), un termine che le vuole diverse fra loro; i due termini si sommano senza un peso, e la scelta è di nuovo avida. La matrice del nucleo costa \(O(n^2)\) valutazioni, e la larghezza decide tutto: troppo larga e ogni insieme sembra rappresentativo, troppo stretta e nessuno lo è. Negli esperimenti degli autori il parametro del nucleo si sceglie con la validazione incrociata del classificatore al prototipo più vicino.
Il blocco rifà la scena in piccolo, con punti su un piano al posto delle foto: due gruppi grandi di duecento punti e uno raro di venti. Il «vicino» è una campana: due punti coincidenti si somigliano per \(1\), e la somiglianza cala in fretta man mano che si allontanano (è il nucleo gaussiano, con larghezza \(\sigma = 1\)). Il blocco sceglie dieci prototipi uno alla volta, ogni volta quello che abbassa di più la differenza (la scelta che si dice avida: prende il meglio subito, senza guardare avanti), e poi cerca le critiche in due modi. Prima i tre punti dove la funzione testimone è più alta, cioè dove i dati superano di più i prototipi; poi come il metodo originale, che guarda anche il verso opposto (dove i prototipi promettono più punti di quanti ce ne siano) e vuole le critiche diverse fra loro.
import numpy as np

rng = np.random.default_rng(0)
# due gruppi grandi e un gruppetto raro, che una sintesi per medie rischia di perdere
grande_a = rng.normal([0, 0], 0.5, size=(200, 2))
grande_b = rng.normal([4, 0], 0.5, size=(200, 2))
raro = rng.normal([2, 3], 0.3, size=(20, 2))
X = np.vstack([grande_a, grande_b, raro])
gruppo = np.array(["a"] * 200 + ["b"] * 200 + ["raro"] * 20)

def nucleo(A, B, larghezza=1.0):
    d2 = ((A[:, None, :] - B[None, :, :]) ** 2).sum(-1)
    return np.exp(-d2 / (2 * larghezza ** 2))

K = nucleo(X, X)
media_dati = K.mean(axis=1)                  # quanto ogni punto somiglia ai dati, in media

def mmd2(scelti):
    """MMD al quadrato fra i dati e i soli prototipi scelti (a meno della costante dei dati)."""
    S = np.array(scelti)
    return K[np.ix_(S, S)].mean() - 2 * media_dati[S].mean()

prototipi = []
for _ in range(10):                          # scelta avida: il prototipo che abbassa di più l'MMD
    candidati = [i for i in range(len(X)) if i not in prototipi]
    prototipi.append(min(candidati, key=lambda i: mmd2(prototipi + [i])))
print("prototipi per gruppo:", {g: int((gruppo[prototipi] == g).sum()) for g in ("a", "b", "raro")})

# la funzione testimone: dove i dati sono più fitti dei prototipi (positiva) o meno (negativa)
testimone = media_dati - K[:, prototipi].mean(axis=1)
critiche = np.argsort(-testimone)[:3]         # dove i dati sono più fitti di quanto i prototipi dicano
print("critiche:", [str(gruppo[i]) for i in critiche])
print(f"testimone più alta, nel gruppo raro {testimone[gruppo == 'raro'].max():.3f},"
      f" fuori {testimone[gruppo != 'raro'].max():.3f}")
distanza = max(np.linalg.norm(X[i] - X[j]) for i in critiche for j in critiche)
print(f"distanza massima fra le tre critiche: {distanza:.2f}")
vicine = np.linalg.slogdet(K[np.ix_(critiche, critiche)])[1]
print(f"log-determinante del nucleo sulle tre critiche: {vicine:.2f}")

# il metodo originale: la testimone in valore assoluto più il log-determinante
# del nucleo sulle critiche scelte, che le vuole lontane fra loro
def punteggio(scelte):
    return (np.abs(testimone[scelte]).sum()
            + np.linalg.slogdet(K[np.ix_(scelte, scelte)])[1])

fuori = [i for i in range(len(X)) if i not in prototipi]
diverse = []
for _ in range(3):                           # di nuovo una alla volta
    diverse.append(max((i for i in fuori if i not in diverse),
                       key=lambda i: punteggio(diverse + [i])))
print("critiche col log-determinante:",
      [f"{gruppo[i]} {testimone[i]:+.3f}" for i in diverse])
prototipi per gruppo: {'a': 5, 'b': 5, 'raro': 0}
critiche: ['raro', 'raro', 'raro']
testimone più alta, nel gruppo raro 0.043, fuori 0.014
distanza massima fra le tre critiche: 0.14
log-determinante del nucleo sulle tre critiche: -12.44
critiche col log-determinante: ['raro +0.043', 'b -0.041', 'a +0.014']
I dieci prototipi si dividono in parti uguali fra i due gruppi grandi, e il gruppo raro, venti punti su quattrocentoventi, non ne riceve nessuno: a ogni passo un prototipo in più in uno dei gruppi grandi abbassa l’MMD più di uno fra i rari. Le tre critiche cadono tutte lì, dove la funzione testimone supera il suo massimo fuori dal gruppo raro, cioè proprio nel posto che la sola lista dei prototipi avrebbe nascosto. Ma senza un termine che le voglia diverse cadono anche tutte nello stesso gruppetto, a non più di \(0{,}14\) l’una dall’altra, e dicono tre volte la stessa cosa. Il metodo originale le vuole diverse con un termine in più, il log-determinante del nucleo sulle critiche scelte: vale zero quando sono lontanissime fra loro e scende sotto zero quanto più si somigliano. Lo somma alla testimone senza un peso, e su questi dati decide lui: sulle tre critiche vicine vale \(-12{,}44\), mentre la testimone si muove di qualche centesimo. La prima critica resta nel gruppo raro, la seconda va in un punto dove la testimone è negativa, cioè dove i prototipi promettono più punti di quanti ce ne siano, e la terza in un gruppo grande.
Prototipi e critiche, insieme, sono un riassunto onesto di un insieme di dati: i primi dicono che cosa c’è di tipico, le seconde dove la sintesi tace. Ed è lì, sul gruppo raro, che conviene guardare che cosa risponde un modello prima di fidarsene.
Che una feature conti, non come, né perché#
L’avvertenza più importante sulle colonne è la stessa che chiudeva la storia degli asmatici. L’importanza delle feature (per rimescolamento o da impurità) dice che una colonna pesa sulle risposte del modello. Non dice come agisce (per quello servono le curve di poco fa), non dice se l’effetto sia lo stesso per tutti (lo dicono le curve ICE, e caso per caso i metodi delle spiegazioni locali), e soprattutto non dice che quella colonna sia la causa di niente. Attenzione a questa parola, che somiglia a un’altra molto frequente in statistica: «casuale» vuol dire tirato a sorte, «causale» vuol dire che una cosa ne provoca un’altra, ed è quest’ultima che stiamo negando.
Un esempio, e sta tutto nella storia degli asmatici di apertura. Là l’asma risultava importante, e chi avesse letto quel numero come una causa avrebbe concluso che l’asma protegge dalla polmonite. La causa vera erano le cure intensive; l’asma era soltanto la colonna che, nei dati, viaggiava insieme a quelle cure. Il modello ha visto quali cose vanno insieme, non che cosa provoca che cosa, e le due sono diverse ogni volta che in mezzo c’è qualcosa che nella tabella non compare. Confondere «colonna importante per il modello» con «causa del fenomeno» è l’errore che trasforma uno strumento per trovare i difetti in una fonte di decisioni sbagliate. L’interpretabilità apre la scatola: sta a noi non leggerci dentro più di quel che c’è.
Da ricordare
I modelli trasparenti sono già la propria spiegazione, finché restano piccoli. Nel modello che stima il prezzo di una casa ogni peso è un cartellino col prezzo appeso a una caratteristica, e la risposta si legge come una ricevuta, voce per voce; in un albero la spiegazione è il percorso di domande che porta alla risposta. Della famiglia fanno parte anche i modelli additivi generalizzati, con una curva al posto del cartellino fisso, e i sistemi a regole, che si possono anche far scrivere ai dati (RuleFit).
Il presunto scambio fra accuratezza e chiarezza non vale sempre, e sui dati a righe e colonne spesso non vale affatto.
L’importanza per rimescolamento (Breiman, 2001; in inglese permutation importance) rimescola i valori di una sola colonna e guarda quanto peggiora il modello: se rimescolando il reddito le risposte giuste scendono dal \(90\%\) al \(72\%\), quella colonna vale 18 punti. Funziona con qualunque modello, va misurata su dati che il modello non ha mai visto in addestramento e ripetuta più volte, facendo la media. Vale finché le colonne non dicono la stessa cosa: se ce n’è una gemella il modello legge quella, e il calo resta piccolo anche per una colonna che conta eccome (le gemelle si rimescolano allora insieme). E vale finché il rimescolamento non fabbrica clienti impossibili: su quelli il modello risponde a caso, e il calo si gonfia.
L’importanza da impurità degli alberi (l’impurità è quanto sono mescolate le risposte dentro un gruppo: l’albero taglia per fare gruppi più omogenei) arriva gratis con l’addestramento ma è distorta: premia le colonne con tanti valori diversi, che offrono moltissime soglie fra cui scegliere, e penalizza quelle con due o tre valori; in più è calcolata sui dati di addestramento, dove ogni taglio sembra utile. Due colonne di puro rumore aggiunte apposta lo fanno vedere: quella con tanti valori si prende sette volte l’altra (\(0{,}0467\) contro \(0{,}0065\)), e valgono zero tutte e due. Meglio fidarsi del rimescolamento.
Sapere quanto una colonna conta non dice come agisce. Il PDP riscrive a tutti lo stesso valore («e se aveste tutti quarant’anni?») e fa la media delle risposte; l’ICE disegna una curva per ogni esempio e rivela i casi in cui l’effetto è opposto da persona a persona e la media lo nasconde. Quando due colonne vanno sempre insieme (l’altezza e il peso), il PDP chiede al modello di persone che non esistono, e la curva inganna; l’ALE confronta solo valori vicini fra chi quei valori li ha davvero.
Un insieme di dati si spiega anche con pochi esempi. I prototipi si scelgono uno alla volta perché si spargano come i dati; le critiche sono i casi che i prototipi rappresentano male, come un gruppo raro rimasto senza prototipo, ed è lì che conviene guardare il modello. Tutto dipende da che cosa vuol dire «vicino».
L’importanza dice che una colonna pesa sulle risposte, non come agisce né che ne sia la causa: è l’errore della regola sugli asmatici, dove a proteggere non era l’asma ma la corsia in cui l’asma faceva finire. Il panorama completo è nel manuale di Molnar.
Da ricordare
I modelli trasparenti (lineari/logistici, alberi, GAM, regole, anche estratte da un insieme di alberi con RuleFit, dove un Lasso sceglie regole e termini lineari) sono la propria spiegazione: nella regressione lineare ogni coefficiente \(w_j\) è l’effetto marginale della feature \(j\). La simulabilità (Lipton) cala con la dimensione, non con la famiglia. Il presunto compromesso accuratezza/interpretabilità non vale sempre, specie sui dati tabellari (EBM).
La permutation importance [Bre01a] mescola i valori di una sola colonna e misura il calo di performance (\(\mathrm{FI}_j = e_{\pi_j} - e_{\text{orig}}\)): è model-agnostic, va calcolata su dati held-out e mediata su più permutazioni. Con feature correlate il numero va letto con la domanda in mano: la gemella non permutata lo sottostima (rimedio: l’importanza di gruppo), l’estrapolazione fuori supporto lo sovrastima.
L’importanza da impurità (MDI) negli alberi è gratis ma distorta [SBZH07]: gonfia le feature continue e ad alta cardinalità (per via del numero di split candidati e del bootstrap con reimmissione), ed è misurata sul training. Preferire la permutazione, calcolata su un hold-out indipendente: due colonne di puro rumore, una continua e una binaria, ricevono MDI in rapporto sette a uno e permutazione nulla entrambe.
PDP mostra l’effetto marginale medio di una feature, ICE una curva per istanza (rivela le interazioni che il PDP media via); con feature correlate il PDP estrapola e inganna: meglio ALE, che costa \(2m\) valutazioni contro \(G\,m\) e vede le interazioni solo al secondo ordine.
MMD-critic [KKK16] sceglie i prototipi in modo avido abbassando \(\mathrm{MMD}^2\) fra dati e prototipi, che riproduce le proporzioni dei dati e non ne copre lo spazio; le critiche stanno dove la funzione testimone è grande in valore assoluto, rese diverse da un log-determinante. La scelta avida non ha una garanzia utile, e la larghezza del nucleo decide tutto.
L’importanza dice che una feature conta, non come né se è causale. Correlazione nel modello non è causazione nel mondo. Panoramica completa in Molnar [Mol22].