


Quando i dati cambiano#
Nel 2008 Google lanciò un servizio dal nome ambizioso: Google Flu Trends. L’idea, presentata anche sulle pagine di Nature, era elegante: chi si sente febbricitante corre a cercare in rete «sintomi influenza» o «febbre alta rimedi». Contando queste ricerche si poteva stimare la diffusione dell’influenza negli Stati Uniti in tempo quasi reale, con una o due settimane di anticipo sui CDC, l’ente federale che raccoglie i dati dai medici. Per qualche anno funzionò, e il servizio divenne il manifesto di una promessa che in quegli anni si sentiva dappertutto: adesso che ogni gesto lascia una traccia in rete, perché fare sondaggi lenti e costosi, quando i dati arrivano da soli?
Poi arrivò l’inverno 2012–2013. A febbraio 2013 Google Flu Trends stimava una quota di visite mediche per sintomi influenzali più che doppia rispetto a quella registrata dai CDC. E non era un incidente isolato: tra l’agosto 2011 e il settembre 2013 il servizio aveva sovrastimato l’influenza in 100 settimane su 108. Nel 2014 un gruppo di ricercatori firmò su Science l’autopsia del progetto, con un titolo diventato proverbiale: The Parable of Google Flu (la «parabola», nel senso del racconto che ammonisce [LKKV14]). Nell’agosto 2015 Google chiuse il servizio.
Che cosa era andato storto? Gli autori dell’articolo su Science indicano due cause, e solo la seconda è un invecchiamento. La prima nasce con il modello: i termini di ricerca erano stati scelti cercando, fra cinquanta milioni di candidati, quelli che seguivano meglio 1152 rilevazioni settimanali dei CDC, e molti seguivano l’inverno più che l’influenza. Il modello, scrivono, era in parte un rilevatore di influenza e in parte un rilevatore d’inverno: nel 2009 mancò la pandemia di H1N1, arrivata fuori stagione, e fu corretto. La seconda è il tempo. Il modo di cercare in rete era cambiato, e Google stessa aggiornava il motore: dal giugno 2011 cominciò a proporre altri termini da cercare (a chi chiedeva dell’influenza suggeriva di cercarne le cure), dal febbraio 2012 a rispondere alle ricerche sui sintomi con le diagnosi possibili (chi cercava «febbre» o «tosse» si vedeva proporre l’influenza). Erano due spinte verso l’influenza che arrivavano anche a chi stava benissimo, e la catena si chiude da sé: più suggerimenti, più ricerche sull’influenza; e siccome il modello contava proprio quelle ricerche, più malati stimati. Intanto i giornali parlavano di epidemia e la gente cercava per curiosità, non per febbre. Il modello, tarato sul mondo di qualche anno prima, continuava a leggere il presente con gli occhiali di allora. Che cosa succede quando i dati che un modello incontra non somigliano più a quelli su cui è stato addestrato?
L’ipotesi nascosta: che la distribuzione non cambi#
L’impianto dell’apprendimento supervisionato (addestramento, validazione, test) poggia su un’assunzione che di solito non viene dichiarata: che i dati su cui il modello è addestrato e quelli che incontrerà dopo siano estratti dalla stessa distribuzione, e che ogni esempio sia estratto senza essere condizionato dagli altri. È l’ipotesi i.i.d. (indipendenti e identicamente distribuiti). Finché vale, l’errore misurato sugli esempi di test stima quello che il modello farà sugli esempi futuri. Nessuna legge assicura che il mondo continui a rispettarla.
Un sondaggio elettorale intervista mille persone e prevede il voto di milioni. Funziona per una sola ragione: le mille persone sono scelte in modo da somigliare ai milioni. Tutto quello che abbiamo visto finora (training, validation, test) è, in fondo, un sondaggio: peschiamo esempi da un’urna e contiamo, fidandoci che l’urna di domani sia la stessa di oggi.
Se in un’urna ben mescolata il 30% delle palline è rosso, in una manciata di cento ne troverai più o meno trenta rosse: la manciata «parla» per l’urna intera. Ma se stanotte qualcuno sostituisce metà delle palline, la manciata pescata ieri non dice più nulla sull’urna di oggi. È quello che è successo a Google Flu Trends: l’urna (il modo in cui la gente usa un motore di ricerca) era cambiata, e nessuno aveva avvisato il modello.
La manciata parla per l’urna anche a un’altra condizione, e riguarda il momento in cui si decide la domanda. «Quante rosse?» stabilito prima di pescare, e la manciata risponde per l’urna. Stabilito dopo, no. Chi pesca cento palline e poi va a cercare, fra mille domande possibili, quella a cui quelle cento rispondono nel modo più vistoso ha ritagliato la domanda addosso alla manciata, e sull’urna intera quella domanda non dice niente. È l’overfitting visto dal lato dell’urna, ed è anche la prima delle due cause di Google Flu Trends, che aveva scelto i suoi termini di ricerca fra cinquanta milioni guardando come andavano su quei dati. Ci si difende allo stesso modo, tenendo corto l’elenco delle domande che ci si concede prima di pescare.
Questa urna ha anche un nome tecnico. La distribuzione di una cosa è, semplicemente, il resoconto di quanto spesso ciascun valore capita: le palline rosse al 30% e le altre al 70% sono la distribuzione dei colori in quell’urna. «La distribuzione degli input è cambiata» vuol dire esattamente «l’urna non è più quella». E un’urna si cambia in più di un modo, mettendoci dentro palline diverse, oppure cambiando quanto spesso la risposta giusta è una o l’altra, oppure cambiando quello che il colore di una pallina significa.
Formalmente, assumiamo che le coppie \((\mathbf{x}^{(i)}, y^{(i)})\) del training e quelle che il modello vedrà in produzione siano estratte in modo indipendente e identicamente distribuito (i.i.d.) da un’unica distribuzione congiunta \(P(\mathbf{x}, y)\). Sotto questa ipotesi l’errore misurato sul campione converge, per la legge dei grandi numeri, all’errore atteso di qualunque modello fissato in anticipo. Perché la stessa garanzia valga per il modello scelto minimizzando sui dati serve di più: che la classe di ipotesi abbia capacità limitata (in gergo, la convergenza uniforme, che la teoria dell’apprendimento tratta per esteso). È lo stesso controllo della complessità incontrato con l’overfitting, che di quella garanzia è appunto il controesempio: quando la capacità non è limitata, l’errore sul campione può essere azzerato senza che questo dica più nulla sull’errore atteso. Quando invece valgono entrambe le condizioni, campionamento i.i.d. e capacità limitata, minimizzare la loss empirica è una buona approssimazione del minimizzare il rischio vero.
Quando le due distribuzioni divergono, \(P_{\text{train}}(\mathbf{x}, y) \neq P_{\text{prod}}(\mathbf{x}, y)\), con \(P_{\text{prod}}\) la distribuzione che il modello incontra in produzione, si parla di dataset shift [QuinoneroCSSL09], e le garanzie cadono: il minimo della loss sotto \(P_{\text{train}}\) non è più, in generale, un buon punto sotto \(P_{\text{prod}}\). La congiunta si scrive in due modi,
dove \(P(\mathbf{x})\) è la distribuzione degli input, \(P(y)\) quella delle etichette, \(P(y \mid \mathbf{x})\) la relazione input-etichetta che il modello cerca di apprendere e \(P(\mathbf{x} \mid y)\) come si presentano gli input di ciascuna classe. I fattori non cambiano per conto loro (con \(P(y \mid \mathbf{x})\) ferma, cambiare \(P(\mathbf{x})\) cambia anche \(P(y)\)), e le famiglie di shift si distinguono da quale condizionata resta ferma.
Tre modi in cui il mondo cambia#
Non tutti i cambiamenti sono uguali, e la distinzione che conta è quale parte della congiunta si è mossa: da questa dipende che cosa si può correggere senza etichette nuove. Le famiglie più usate sono tre, covariate shift, label shift (o prior probability shift) e concept shift, nella sistemazione di Moreno-Torres e coautori [MTRARodriguez+12], e nella pratica arrivano mescolate. Fig. 4.40 mostra il caso più semplice da visualizzare: le densità di una stessa caratteristica (i metri quadri, l’età, il numero di ricerche) in addestramento e in produzione, con i valori in orizzontale e in verticale quanto spesso ciascuno capita. Le due curve sfalsate dicono che i valori frequenti in addestramento non sono quelli frequenti in produzione, e che il modello viene interrogato dove ha visto pochi esempi.

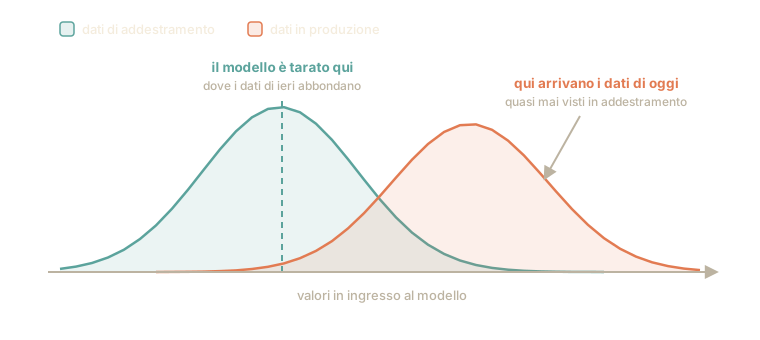
Fig. 4.40 Due distribuzioni a confronto: la curva dei dati di addestramento e quella dei dati che il modello incontra una volta al lavoro. La linea tratteggiata segna il valore attorno a cui il modello è tarato, cioè dove i dati di ieri si addensavano; i dati di oggi cadono in gran parte altrove, dove di esempi non ne ha quasi mai visti.#
Cambiano le domande, cioè gli input che arrivano al modello (covariate shift). Un’app che riconosce le piante, addestrata su foto scattate d’estate, viene usata d’inverno: luce bassa, rami spogli, neve sullo sfondo. Le foto che arrivano sono diverse da quelle viste a lezione, ma attenzione: un abete resta un abete. La regola che collega foto e risposta non è cambiata; è cambiato il tipo di foto che arriva. Davanti a un ramo spoglio nella neve una risposta la dà lo stesso, e la dà su un caso che d’estate non poteva capitarle, allungando quello che sa oltre il punto in cui l’ha imparato.
Cambiano le proporzioni delle risposte (label shift). Un modello aiuta a diagnosticare una malattia che, quando è stato addestrato, colpiva una persona su mille. Arriva un’epidemia e diventa una su cinquanta. I sintomi della malattia sono identici a prima: cambia solo quanto spesso la risposta giusta è «positivo».
Se i sintomi sono gli stessi, perché il modello dovrebbe sbagliare? Perché la rarità, di nascosto, è entrata nel suo giudizio. Un modello che ha imparato su un mondo in cui i malati sono uno su mille ha anche imparato che dire «sano» paga: ci prende 999 volte su 1000, e per convincerlo del contrario servono sintomi molto chiari. Davanti a un caso dubbio resterà prudente e dirà «sano», il che era la scommessa giusta ieri ed è quella sbagliata oggi, che i malati sono venti volte tanti.
Cambia la regola stessa (concept shift). Che cos’è lo spam? Le stesse parole («offerta», «clicca qui», «solo per oggi») che nel 2005 gridavano truffa, oggi arrivano da negozi legittimi; e intanto i truffatori hanno imparato a scrivere come una banca. Qui non cambiano solo le domande: cambia la risposta giusta alla stessa domanda. Allo spam sono serviti anni; altrove la regola cambia da un giorno all’altro, come quando una legge nuova stabilisce che cosa conta come transazione sospetta. È il caso più insidioso, perché nessuna quantità di dati vecchi può insegnare una regola nuova.
Nel mondo vero i tre cambiamenti non arrivano in fila e ben separati. L’inverno porta insieme foto più scure e più abeti che margherite, cioè domande diverse e proporzioni diverse in una volta sola. E capire quale dei tre pesi di più, guardando i soli dati in arrivo, è difficile: per sapere se l’app ha sbagliato bisogna che qualcuno guardi la foto e dica che pianta era, e quel qualcuno arriva tardi, o non arriva affatto.
Con le due fattorizzazioni della congiunta, le tre famiglie si distinguono da quale condizionata resta ferma [MTRARodriguez+12]:
Covariate shift: cambia \(P(\mathbf{x})\), resta invariata \(P(y \mid \mathbf{x})\). Le foto invernali hanno una distribuzione diversa da quelle estive, ma la mappa immagine \(\to\) specie è la stessa. È il caso della figura: il modello è accurato dove \(p_{\text{train}}(\mathbf{x})\) è densa, e viene interrogato dove è quasi nulla (di fatto, un’estrapolazione).
Label shift (o prior probability shift): cambia \(P(y)\), resta invariata \(P(\mathbf{x} \mid y)\). La malattia si presenta come prima, ma la sua prevalenza è diversa. Un classificatore bayesiano tarato sul prior vecchio produce probabilità a posteriori sistematicamente distorte.
Concept shift: cambia \(P(y \mid \mathbf{x})\). La relazione input-etichetta stessa si sposta, gradualmente (i gusti musicali) o di colpo (una nuova legge cambia cosa è «transazione sospetta»). Nella letteratura sui flussi di dati è il real concept drift; concept drift da solo indica di solito qualunque cambiamento della congiunta nel tempo [GvZliobaiteB+14].
Nella pratica le tre forme arrivano mescolate, e distinguere quale domini a partire dai soli dati è un problema difficile: spesso mal posto, se le etichette nuove tardano ad arrivare. La terna non esaurisce i casi: un cambiamento di \(P(\mathbf{x} \mid y)\) a \(P(y)\) fisso, per esempio, non è nessuna delle tre [MTRARodriguez+12].
Perché la validazione classica non protegge#
Validation set, test tenuto da parte e cross-validation, presentati in Overfitting e validazione, restano necessari, ma hanno un punto cieco: estraggono i loro esempi dallo stesso passato da cui viene il training set, quindi stimano l’errore sotto la distribuzione di addestramento, non sotto quella che il modello incontrerà dopo.
Train, validation e test sono tre ritagli della stessa fotografia. Se la fotografia invecchia, invecchiano tutti e tre insieme, e i loro voti restano alti proprio mentre il modello, nel mondo reale, comincia a sbagliare. È come guidare guardando lo specchietto retrovisore: ti dice benissimo la strada già percorsa, ma non la curva che sta arrivando.
Google Flu Trends, sui dati con cui era stato validato, andava bene: era stato validato sul passato. Ma quel voto misurava quanto il modello somigliasse al passato, non quanto avrebbe retto a un’altra stagione o a un altro modo di cercare, e fra i termini scelti ce n’erano di legati all’inverno più che all’influenza. La validazione risponde a «quanto sbaglierò su dati come questi?», non a «quanto sbaglierò domani?».
C’è però un modo di rendere onesta anche la domanda, e vale ogni volta che i dati hanno una data sopra: invece di tagliarli a caso, si taglia nel tempo. Il modello studia su gennaio-ottobre e viene interrogato su novembre-dicembre, che al momento dell’addestramento erano il futuro. Se già lì peggiora, è un segnale serio che in mezzo al mondo vero peggiorerà (a meno che la finestra scelta abbia una stagionalità sua, come le feste di dicembre); se non peggiora non è una garanzia, ma è un indizio molto migliore di un rimescolamento che gli lascia sbirciare il domani.
La stima di validazione approssima \(\mathbb{E}_{(\mathbf{x},y)\sim P_{\text{train}}}\!\left[\ell\big(f_\theta(\mathbf{x}), y\big)\right]\): un valore atteso sotto la distribuzione di addestramento. Se la distribuzione operativa è un’altra, questo numero non vincola l’errore reale senza un’ipotesi sulla distanza fra le due distribuzioni: può restare ottimo mentre l’errore sotto \(P_{\text{prod}}\) diverge.
Con dati temporali c’è di peggio: la cross-validation rimescolata distrugge
l’ordine cronologico e lascia che il modello «veda il futuro» dei fold di
validazione (una forma di leakage temporale), gonfiando le stime. Lo stress
test più onesto è lo split temporale: addestrare sul passato e validare sul
futuro relativo (ad esempio, addestrare su gennaio–ottobre e validare su
novembre–dicembre). Ripetuto su più tagli successivi, con l’origine che avanza,
è la validazione a origine mobile, quella che TimeSeriesSplit di
scikit-learn implementa. Se le prestazioni degradano già lì, è probabile che
degradino anche in produzione (salvo effetti stagionali propri della finestra);
se non degradano, non è comunque una garanzia, solo un indizio migliore.
Rimedi onesti#
Nessun algoritmo rende un modello immune al tempo, e i rimedi di uso più comune sono operativi prima che matematici. Sono tre:
Monitoraggio del modello in produzione, cioè acceso su dati veri, con utenti veri: va trattato come un impianto, non come un quadro appeso, e si confrontano nel tempo la distribuzione degli input, quella delle predizioni e, appena le etichette arrivano, l’errore effettivo, misurabile con gli strumenti descritti in Sorvegliare un modello vivo.
Riaddestramento (retraining) periodico su dati recenti, perché la distribuzione di addestramento segua quella di produzione.
Valutazione su dati successivi all’addestramento, raccolti dopo che il modello è stato fissato, e non su un altro ritaglio dei dati di partenza.
Un modello in produzione è come la bilancia del mercato, che per legge va ritarata periodicamente, perché con l’uso e il tempo si starano tutte, ed è meglio accorgersene prima del cliente. In pratica si tengono d’occhio tre cose. Le domande, per cominciare. Se un filtro antispam riceveva email lunghe in media 80 parole e ora ne arrivano da 200, è un campanello. Poi le uscite. Se ieri segnalava come spam il 20% dei messaggi e oggi il 45%, qualcosa è cambiato, nel mondo o nel modello. Infine gli errori veri, appena si scopre la risposta giusta (l’utente ha ripescato l’email dal cestino?).
Sui conteggi si può fare un aggiustamento, la ripesatura, ed è quello che gli istituti di sondaggi fanno da sempre. Il campione di mille persone ne contiene 50 sotto i trent’anni, il 5%, mentre nel paese quella fascia pesa il 20%, quattro volte tanto. Allora ogni giovane intervistato viene contato quattro volte (20 diviso 5), e chi viene da una fascia sovrarappresentata conta meno di una persona intera. Nessuno torna a bussare a nessuna porta, cambia solo il peso che ogni risposta ha nella media finale, e il totale torna a somigliare al paese invece che al campione. Lo stesso conto ripara il caso della malattia diventata comune, dove i malati erano uno su mille e adesso sono uno su cinquanta: ogni malato del vecchio mucchio di esempi conta venti volte.
Ripesare ripara un guasto solo, quello di aver intervistato le persone sbagliate. Se nel frattempo la gente ha cambiato idea, i giovani del campione hanno detto quello che pensavano allora, e moltiplicare per quattro una risposta vecchia dà una risposta vecchia quattro volte.
E se sotto i trent’anni non è stato intervistato nessuno, non c’è peso che tenga, perché qualunque numero moltiplicato per zero fa zero. Di quella fascia il sondaggio non sa niente, e nessun conto può inventare le interviste che non sono state fatte.
Il caso che inganna di più sta in mezzo. Se sotto i trent’anni ne sono capitati due invece di cinquanta, quei due devono valere per il 20% del paese e contano cento volte ciascuno; basta che uno dei due cambi idea perché un partito perda dieci punti. Il conto resta giusto, e il risultato balla. E le fasce quasi vuote si moltiplicano appena si ripesa per più cose insieme, età e regione e titolo di studio e reddito, perché più le caselle sono strette e meno gente ci finisce dentro.
Da qui viene anche il permesso di passare la mano. Davanti a un caso che non somiglia a nulla di già visto, meglio dire «non lo so, decida un umano» che sparare una risposta sicura e sbagliata.
Sul versante algoritmico, il rimedio classico per il covariate shift puro è l’importance weighting: ripesare la loss di training così che gli esempi frequenti in produzione ma rari in addestramento contino di più,
dove \(w(\mathbf{x})\) è il rapporto tra la densità degli input in produzione e quella in addestramento e \(m\) è il numero di esempi. Il motivo è un cambio di misura: per ogni \(\theta\) fissato,
dove l’ultimo passo usa \(p_{\text{prod}}(y\mid\mathbf{x}) = p_{\text{train}}(y\mid\mathbf{x})\), cioè il covariate shift, e la divisione chiede \(p_{\text{train}}(\mathbf{x}) > 0\) dovunque \(p_{\text{prod}}(\mathbf{x}) > 0\): il supporto di produzione deve stare dentro quello di addestramento, e dove manca nessun peso può inventare esempi mai raccolti. Quindi \(\mathcal{L}_w(\theta)\) è una stima corretta del rischio in produzione per ogni \(\theta\), e il suo minimo converge a quello giusto al crescere di \(m\); con \(m\) finito la sua varianza cresce con \(\mathbb{E}[w^2]\), e stimare il rapporto di densità in alta dimensione è difficile, con pesi enormi su pochi esempi che la fanno esplodere. Il rimedio di Shimodaira è appiattire i pesi, \(w^\lambda\) con \(\lambda \in [0,1]\): \(\lambda = 0\) ignora lo shift, \(\lambda = 1\) lo corregge per intero, e in mezzo si scambia distorsione con varianza [Shi00]. Quanti esempi contano davvero lo dice la taglia effettiva, \(m_{\text{eff}} = \bigl(\sum_i w_i\bigr)^2 / \sum_i w_i^2\), che crolla appena pochi pesi dominano. Le due densità, però, non vanno stimate una per una: un classificatore che distingue addestramento e produzione, addestrato su \(m_{\text{tr}}\) e \(m_{\text{prod}}\) esempi, dà \(w(\mathbf{x}) = \frac{m_{\text{tr}}}{m_{\text{prod}}}\,\frac{P(\text{prod}\mid\mathbf{x})}{1 - P(\text{prod}\mid\mathbf{x})}\), ed è lo stesso classificatore di dominio che serve ad accorgersi della deriva. Infine il ripeso conta soprattutto quando il modello è mal specificato: se la famiglia contiene la vera \(P(y \mid \mathbf{x})\), il minimo non pesato è già consistente e i pesi aggiungono soltanto varianza [Shi00].
Per il label shift il conto è più semplice, perché il rapporto dipende dalla sola classe. Con \(P(\mathbf{x} \mid y)\) invariata, \(p_{\text{prod}}(y \mid \mathbf{x}) \propto p_{\text{train}}(y \mid \mathbf{x})\;\pi_{\text{prod}}(y)/\pi_{\text{train}}(y)\), dove \(\pi(y)\) è la prevalenza della classe: un classificatore calibrato si corregge senza riaddestrarlo, moltiplicando le posteriori per \(\pi_{\text{prod}}(y)/\pi_{\text{train}}(y)\) e rinormalizzando (per la malattia passata da uno su mille a uno su cinquanta, \(20\) sui positivi e \(0{,}98/0{,}999 \approx 0{,}98\) sui negativi). Resta da stimare \(\pi_{\text{prod}}\), che senza etichette nuove si ricava con un EM sulle posteriori [SLD02] o invertendo la matrice di confusione del modello [LWS18]. Complementare a tutto questo è l’out-of-distribution detection: riconoscere gli input troppo lontani dalla distribuzione di addestramento e, invece di predire con finta sicurezza, astenersi o segnalare; un problema particolarmente delicato per le reti profonde, che su input fuori distribuzione tendono a essere confidenti e sbagliate insieme. I primi strumenti sono già comparsi: la densità di una mistura gaussiana (Riduzione e clustering) e la One-Class SVM (Il kernel trick) segnalano gli input che cadono dove la distribuzione di addestramento ha densità bassa.
Un cambiamento della distribuzione nel tempo si chiama deriva (drift), e per accorgersi di una deriva negli input basta un classificatore di dominio (classifier two-sample test) [LPO17]. Si uniscono i dati di addestramento e quelli raccolti in produzione, si scarta l’etichetta originale \(y\) e se ne assegna una nuova a ogni esempio: 0 se viene dall’addestramento, 1 se viene dalla produzione. Un modello addestrato a indovinare la nuova etichetta dalle sole caratteristiche \(\mathbf{x}\) ci riesce solo se le due distribuzioni degli input differiscono, e il suo punteggio misura quanto. Lo chiameremo il detective.
Il punteggio da guardare è l’AUC della sezione sulle metriche: \(0{,}5\) vuol dire che il detective non distingue le due popolazioni, cioè che tira a indovinare, e \(1\) che le separa senza errori.
Un’AUC vicina a \(0{,}5\) non equivale a «va tutto bene», per due ragioni. La prima è che il detective vede solo gli input, non le risposte: del cambio di regola, in cui gli input restano gli stessi e a cambiare è la risposta giusta, non può accorgersi per costruzione, ed è il caso più insidioso dei tre. La seconda è che un’AUC vicina a \(0{,}5\) può anche voler dire che gli esempi nuovi sono ancora troppo pochi: uno scarto piccolo ma reale resta sotto il rumore di campionamento dell’AUC, e un classificatore di capacità limitata può non vedere un’interazione fra molte caratteristiche. Non aver trovato non è aver dimostrato che non c’è niente. È uno strumento da avere, purché letto per quello che è: un allarme quando suona, non un certificato quando tace.
import numpy as np
from sklearn.datasets import make_classification
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import cross_val_score, train_test_split

X, y = make_classification(n_samples=400, n_features=8, n_informative=5,
                           n_redundant=1, random_state=0)
X_vecchi, X_nuovi, _, _ = train_test_split(X, y, test_size=0.25, random_state=0)

# in produzione arrivano gli stessi input, ma con la prima caratteristica
# scivolata di 1,5: è la deriva che il detective deve scoprire
X_derivati = X_nuovi.copy()
X_derivati[:, 0] += 1.5

def sospetto(X_prima, X_dopo):
    """Quanto bene un modello indovina da quale epoca viene un esempio."""
    X_tutti = np.vstack([X_prima, X_dopo])
    origine = np.hstack([np.zeros(len(X_prima)), np.ones(len(X_dopo))])
    return cross_val_score(GradientBoostingClassifier(random_state=0),
                           X_tutti, origine, cv=5, scoring="roc_auc").mean()

print(f"produzione con la deriva : {sospetto(X_vecchi, X_derivati):.3f}")
print(f"produzione senza deriva  : {sospetto(X_vecchi, X_nuovi):.3f}")
produzione con la deriva : 0.736
produzione senza deriva  : 0.508
I due numeri sono le due letture possibili dello strumento, e vanno tenuti vicini perché da soli non si interpretano. Il secondo, \(0{,}508\), è il caso in cui non è cambiato niente: il detective tira a indovinare, come chi lanciasse una monetina. Il primo, \(0{,}736\), è l’allarme: una sola caratteristica scivolata di un’unità e mezza basta perché l’epoca di provenienza diventi in buona parte indovinabile.
Imparare un esempio alla volta#
Riaddestrare a intervalli aggiorna il modello a scatti: fra un riaddestramento e il successivo resta fermo. L’alternativa è aggiornarlo a ogni esempio, appena se ne conosce la risposta giusta, tenendo soltanto i parametri e non gli esempi già visti: è l’apprendimento online (online learning). Cambia la domanda di partenza: non più quanto il modello sbaglierà su esempi estratti dalla stessa distribuzione dell’addestramento, perché qui non si suppone che gli esempi vengano da una distribuzione fissa. Il metro del successo diventa il rimpianto (regret): quanto si è perso rispetto alla migliore scelta fissa, fatta col senno di poi su tutti gli esempi arrivati.
Il filtro antispam impara una email alla volta. Arriva un messaggio, il filtro dà il suo verdetto, e poco dopo tu gli dici se aveva ragione, lasciando l’email dov’è o ripescandola dal cestino. Allora il filtro corregge un poco le sue regole, nella direzione che su quell’email avrebbe ridotto l’errore, e passa alla successiva: è la discesa del gradiente, fatta un esempio alla volta. Le email vecchie non le conserva, perché gli bastano le regole che ha adesso. E le regole le tiene dentro un recinto (tutti i pesi insieme non possono crescere oltre una certa misura), perché una parola che compare in mille spam non finisca per pesare all’infinito.
Quanto correggere ogni volta è la scelta che decide tutto. Correzioni grandi inseguono ogni singola email; correzioni piccole imparano con lentezza. La ricetta che funziona meglio sta nel mezzo e cambia col tempo: la correzione si accorcia man mano che le email si accumulano, come uno diviso la radice di quante ne sono arrivate, e alla centesima vale un decimo della prima.
A fine anno, con tutte le email davanti, cerchi il miglior filtro fisso: quello che, applicato dal primo giorno, avrebbe sbagliato meno di tutti. Il rimpianto è quanto il filtro che ha imparato strada facendo ha sbagliato in più. Un teorema garantisce che il rimpianto cresce al più come la radice del numero di email, cioè più piano delle email stesse: se dopo cento email fosse dieci, dopo diecimila sarebbe al più cento, e il rimpianto per email scenderebbe da un decimo a un centesimo. Per email, quindi, tende a zero.
Più piano della radice, in generale, non si può promettere. Se le email fossero decise a testa o croce nessun filtro potrebbe indovinarle; eppure a fine anno uno dei filtri fissi sembrerebbe più bravo degli altri, per pura fortuna, di una quantità che cresce proprio come la radice (lanciando cento monete ci si aspettano cinquanta teste, e cinquantacinque sono normali; con diecimila, cinquemila più o meno cinquanta).
Si fa meglio solo se il problema aiuta. Quando ogni email punisce con decisione qualunque filtro lontano dal migliore, con un errore che sale come una conca ripida e non come un fondovalle piatto, la correzione si può accorciare più in fretta, come uno diviso il numero di email, e il rimpianto cresce appena come il logaritmo, cioè quasi niente. E la garanzia non chiede niente alle email: vale anche se chi le scrive prova apposta a ingannare il filtro, perché il paragone è sempre con il miglior filtro fisso su quelle stesse email.
Se poi le email vengono davvero tutte dalla stessa urna, c’è un regalo in più. Fai la media dei filtri usati giorno per giorno, regola per regola (il peso medio che ogni parola ha avuto lungo l’anno), e il filtro che ne esce va bene su email nuove quasi quanto il miglior filtro fisso, che con un’urna fissa è il migliore in assoluto; e il mucchio intero non l’hai mai dovuto tenere da parte. La media e non l’ultimo filtro, perché il rimpianto è una somma su tutti i giorni, e la garanzia sulla somma passa alla media dei filtri, non all’ultimo.
Il punto di rottura sta nel paragone. Il rimpianto si misura contro il miglior filtro fisso, e se a metà anno gli spammer cambiano trucco nessun filtro fisso va bene per tutto l’anno: un rimpianto piccolo, allora, promette poco. Peggio, le correzioni che si accorciano rendono il filtro sempre più lento: dopo diecimila email ogni correzione vale un centesimo della prima, e il trucco nuovo lo trova testardo. Con correzioni di misura fissa il filtro resta pronto a seguire, e lo paga oscillando anche quando non cambia niente, perché ogni email lo strattona della stessa misura anche quando aveva già ragione. Quale misura scegliere dipende da quanto spesso gli spammer cambiano trucco, che non si sa in anticipo. C’è anche chi cambia il paragone: invece del miglior filtro fisso, il miglior filtro a cui è permesso cambiare qualche volta durante l’anno, e contro quello il rimpianto torna a promettere qualcosa.
Il quadro è l’online convex optimization. A ogni turno \(t = 1, \dots, T\) l’algoritmo sceglie \(\mathbf{w}_t\) in un insieme convesso \(\mathcal{K}\) di diametro \(D\), poi viene rivelata una perdita convessa \(\ell_t\) e l’algoritmo paga \(\ell_t(\mathbf{w}_t)\). Sulle \(\ell_t\) non si fa nessuna ipotesi statistica, e può sceglierle un avversario che conosce l’algoritmo. Il rimpianto confronta con il miglior punto fisso col senno di poi,
e un algoritmo è senza rimpianto (no-regret) se \(R_T = o(T)\), cioè se il rimpianto medio \(R_T/T\) tende a zero. L’idea di competere con la migliore strategia fissa col senno di poi viene dai giochi ripetuti [Han57].
La discesa del gradiente online [Zin03] fa un passo di gradiente sulla perdita appena pagata e proietta su \(\mathcal{K}\),
e con \(\|\nabla \ell_t\| \le G\) e \(\eta_t = D/(G\sqrt{t})\) garantisce \(R_T \le \tfrac{3}{2}\,GD\sqrt{T}\) [Haz16]. L’ordine \(\sqrt{T}\) non si migliora senza altre ipotesi: con perdite lineari scelte a caso ogni algoritmo subisce un rimpianto atteso \(\Omega(GD\sqrt{T})\). Con più struttura sì: se le \(\ell_t\) sono \(\alpha\)-fortemente convesse, il passo \(\eta_t = 1/(\alpha t)\) porta il rimpianto a \(O\big((G^2/\alpha)\log T\big)\) [HAK07].
Quando invece i dati sono i.i.d., il rimpianto diventa una garanzia statistica. Con una perdita convessa nel primo argomento e a valori in \([0,1]\), il punto medio \(\bar{\mathbf{w}} = \frac{1}{T}\sum_t \mathbf{w}_t\) ha, con probabilità almeno \(1-\delta\), rischio al più la perdita media pagata online più \(\sqrt{2\ln(1/\delta)/T}\) [CBCG04], dove il rischio \(L(\mathbf{w}) = \mathbb{E}[\ell(\mathbf{w};\mathbf{x},y)]\) è la perdita attesa su un esempio nuovo. La perdita media online supera di \(R_T/T\) quella del miglior punto fisso sul campione, che a sua volta non supera la perdita empirica del minimizzatore del rischio, e questa, per la disuguaglianza di Hoeffding, sta entro \(\sqrt{\ln(1/\delta)/(2T)}\) dal suo rischio: messi insieme, con probabilità almeno \(1-2\delta\) il rischio di \(\bar{\mathbf{w}}\) resta entro \(\min_{\mathbf{w}\in\mathcal{K}} L(\mathbf{w}) + R_T/T + O\big(\sqrt{\ln(1/\delta)/T}\big)\). È la conversione online-to-batch, in cui il rimpianto medio fa la parte dell’errore di stima.
Il punto di rottura è il confronto con un punto fisso. Se il bersaglio si muove, il metro giusto è il rimpianto dinamico contro una successione \(\mathbf{u}_1, \dots, \mathbf{u}_T\), di lunghezza di cammino \(P_T = \sum_t \|\mathbf{u}_{t+1} - \mathbf{u}_t\|\); con passo fisso \(\eta\) la discesa online lo tiene sotto \(\frac{7D^2}{4\eta} + \frac{D\,P_T}{\eta} + \frac{\eta\,G^2 T}{2}\) [Zin03]. Il terzo termine è il prezzo del passo fisso, che si paga anche quando niente si muove; il secondo punisce il passo piccolo quando il bersaglio si sposta, e il passo che bilancia i due, \(\eta \propto \sqrt{(D^2 + D\,P_T)/(G^2 T)}\), dipende da \(P_T\), che non si conosce in anticipo. Nel caso a esperti lo stesso problema ha la risposta di Herbster e Warmuth, che confrontano con il miglior esperto autorizzato a cambiare un numero fissato di volte [HW98].
Il rimpianto torna più avanti in due posti: nell’apprendimento per imitazione, dove è la proprietà che l’algoritmo DAgger chiede alla successione dei modelli che addestra, e in Capire è accorciare, nel capitolo sull’auto-supervisione, dove si misura in bit, come lunghezza di un file compresso rispetto al miglior compressore possibile.
Il primo esperimento misura il rimpianto su flussi di esempi sempre più lunghi. Il modello è la regressione logistica, che si corregge dopo ogni esempio con passo \(1/\sqrt{t}\) e riporta i pesi dentro una palla di raggio \(5\) se ne escono, come chiede la garanzia. Il teorema di Zinkevich prende infatti \(D/(G\sqrt{t})\), con \(D\) il diametro dell’insieme ammesso per i pesi e \(G\) il massimo della norma del gradiente, e ne ricava la costante \(\tfrac32 GD\). La palla di raggio \(5\) è l’insieme convesso \(\mathcal{K} = \{\mathbf{w} : \lVert\mathbf{w}\rVert \le 5\}\) della formula, i pesi la cui lunghezza non supera \(5\). La perdita è la sua cross-entropy (o log-loss), il modo della regressione logistica di contare quanto ha sbagliato. Il miglior modello fisso col senno di poi si trova risolvendo la regressione sull’intero flusso (il suo minimo cade dentro la palla, quindi è anche il migliore in \(\mathcal{K}\)), e il rimpianto è la differenza fra le due perdite totali.
import numpy as np

rng = np.random.default_rng(0)
w_vero = np.array([2.0, -1.5, 1.0, 0.5, -0.5])   # la regola che genera le risposte
RAGGIO = 5.0                                      # K: i pesi di norma al più 5

def perdita(w, X, y):
    """La cross-entropy della regressione logistica, esempio per esempio (y vale 0 o 1)."""
    z = X @ w
    return np.logaddexp(0, z) - y * z

def online(X, y):
    """Discesa del gradiente online, passo 1/radice(t): risponde, paga, corregge."""
    w = np.zeros(X.shape[1])
    pagato = 0.0
    for t in range(len(y)):
        z = X[t] @ w
        pagato += np.logaddexp(0, z) - y[t] * z       # prima risponde, poi scopre y
        w -= (1 / np.sqrt(t + 1)) * (1 / (1 + np.exp(-z)) - y[t]) * X[t]
        if np.linalg.norm(w) > RAGGIO:                # la proiezione su K
            w *= RAGGIO / np.linalg.norm(w)
    return pagato

def col_senno_di_poi(X, y, passi=25):
    """La perdita del miglior w fisso sull'intero flusso (metodo di Newton)."""
    w = np.zeros(X.shape[1])
    for _ in range(passi):
        p = 1 / (1 + np.exp(-X @ w))
        w -= np.linalg.solve((X * (p * (1 - p))[:, None]).T @ X, X.T @ (p - y))
    return perdita(w, X, y).sum()

for T in (1_000, 10_000, 100_000):
    X = rng.uniform(-1, 1, size=(T, 5))
    y = (rng.random(T) < 1 / (1 + np.exp(-X @ w_vero))).astype(float)
    R = online(X, y) - col_senno_di_poi(X, y)
    print(f"T = {T:>6}: rimpianto {R:5.1f}   per esempio {R / T:.4f}"
          f"   diviso la radice di T {R / np.sqrt(T):.2f}")
T =   1000: rimpianto  20.0   per esempio 0.0200   diviso la radice di T 0.63
T =  10000: rimpianto  27.6   per esempio 0.0028   diviso la radice di T 0.28
T = 100000: rimpianto  63.2   per esempio 0.0006   diviso la radice di T 0.20
Il rimpianto cresce, da \(20\) a \(63\), mentre gli esempi crescono di cento volte, e per esempio scende da due centesimi a sei decimillesimi. Anche diviso per \(\sqrt{T}\) scende. Il \(\sqrt{T}\) della garanzia è il caso peggiore, quello di un avversario, e su esempi estratti da un’urna fissa il rimpianto può crescere più piano, come fa qui; ma nessuna delle garanzie appena viste lo promette per questo algoritmo: quella logaritmica chiede perdite fortemente convesse dappertutto, e la cross-entropy non lo è. E tre flussi estratti una volta sola non bastano a dire con quale legge cresca.
Il secondo esperimento mette alla prova il punto di rottura. Venti flussi di ventimila esempi, con la regola che a metà cambia; quattro allievi: uno addestrato sui primi duemila esempi e poi lasciato fermo, e tre che imparano online con passi diversi. Per ciascuno si misura la perdita in più rispetto a chi conosce la regola vera, prima del cambio, subito dopo e alla fine.
import numpy as np

rng = np.random.default_rng(0)
FLUSSI, T, CAMBIO = 20, 20_000, 10_000
w_prima = np.array([2.0, -1.5, 1.0, 0.5, -0.5])
w_dopo = np.array([-1.0, -1.5, 2.0, 0.5, 1.5])    # a metà flusso la regola cambia
RAGGIO = 5.0                                       # K: i pesi di norma al più 5

X = rng.uniform(-1, 1, size=(FLUSSI, T, 5))
Z = np.where(np.arange(T) < CAMBIO, X @ w_prima, X @ w_dopo)   # i punteggi veri
y = (rng.random((FLUSSI, T)) < 1 / (1 + np.exp(-Z))).astype(float)
perdita = lambda z, y: np.logaddexp(0, z) - y * z
minima = perdita(Z, y)          # quello che paga chi conosce la regola, istante per istante

def online(passo):
    """Venti flussi insieme, uno per riga: la perdita pagata a ogni esempio."""
    w = np.zeros((FLUSSI, 5))
    pagata = np.empty((FLUSSI, T))
    for t in range(T):
        z = (X[:, t] * w).sum(axis=1)
        pagata[:, t] = perdita(z, y[:, t])            # prima risponde, poi scopre y
        w -= passo(t + 1) * (1 / (1 + np.exp(-z)) - y[:, t])[:, None] * X[:, t]
        norme = np.sqrt((w * w).sum(axis=1, keepdims=True))
        w *= np.minimum(1.0, RAGGIO / norme)          # la proiezione su K
    return pagata

def fermo():
    """Addestrato una volta sui primi 2000 esempi di ogni flusso, e mai più toccato."""
    pagata = np.empty((FLUSSI, T))
    for f in range(FLUSSI):
        A, b, w = X[f, :2000], y[f, :2000], np.zeros(5)
        for _ in range(25):                           # metodo di Newton
            p = 1 / (1 + np.exp(-A @ w))
            w -= np.linalg.solve((A * (p * (1 - p))[:, None]).T @ A, A.T @ (p - b))
        pagata[f] = perdita(X[f] @ w, y[f])
    return pagata

finestre = {"prima del cambio": slice(5_000, CAMBIO),
            "i 1000 dopo": slice(CAMBIO, CAMBIO + 1_000),
            "gli ultimi 2000": slice(T - 2_000, T)}
print(" " * 22 + "".join(f"{nome:>18}" for nome in finestre))
for nome, pagata in [("fermo", fermo()),
                     ("passo 1/radice(t)", online(lambda t: 1 / np.sqrt(t))),
                     ("passo fisso 0,05", online(lambda t: 0.05)),
                     ("passo fisso 0,2", online(lambda t: 0.2))]:
    in_piu = pagata - minima      # la perdita in più rispetto a chi conosce la regola
    print(f"{nome:22}" + "".join(f"{in_piu[:, s].mean():18.4f}" for s in finestre.values()))
                        prima del cambio       i 1000 dopo   gli ultimi 2000
fermo                             0.0012            0.3884            0.3894
passo 1/radice(t)                 0.0008            0.2246            0.0010
passo fisso 0,05                  0.0033            0.0678            0.0031
passo fisso 0,2                   0.0138            0.0303            0.0133
Il modello fermo è buono finché il mondo resta quello dei suoi duemila esempi, e dopo il cambio paga \(0{,}39\) in più a ogni esempio, per sempre. Fra gli allievi online l’ordine si rovescia da una colonna all’altra. Nei periodi tranquilli il passo che si accorcia è il più preciso, con \(0{,}0008\) contro i \(0{,}0138\) del passo fisso più lungo; subito dopo il cambio è il più lento, con \(0{,}2246\) contro \(0{,}0303\), più di sette volte tanto. Il passo fisso più corto sta in mezzo in tutte le colonne, ed è il compromesso fra prontezza e precisione, e nessun passo fisso lo scioglie. La figura segue due degli allievi su un solo flusso, e invece della perdita misura quanto i loro pesi distano da quelli della regola vera (Fig. 4.41).
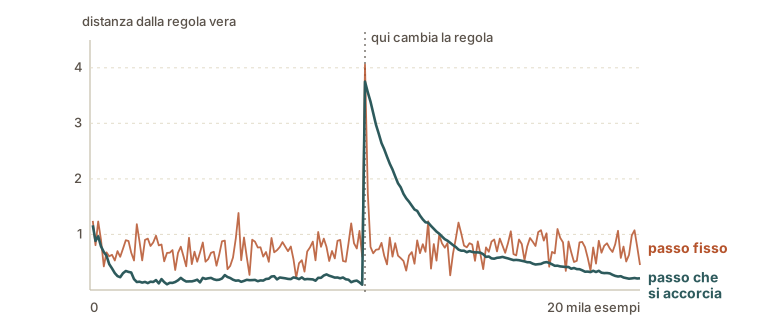
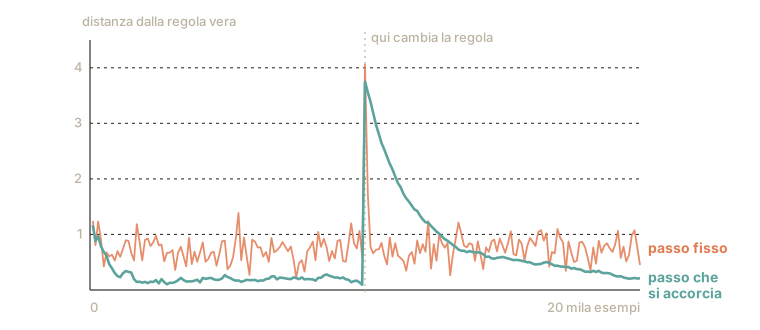
Fig. 4.41 La distanza fra i pesi di due allievi online e quelli della regola vera, su un flusso come quelli dell’esperimento. Col passo che si accorcia la distanza scende e resta bassa, ma quando a metà la regola cambia ci mette migliaia di esempi a riavvicinarsi; col passo fisso da \(0{,}2\) si riavvicina in poche centinaia, e in cambio non smette mai di oscillare.#
Quando è il modello a cambiare i dati#
C’è un ultimo caso, il più sottile: quello in cui i dati non cambiano nonostante il modello, ma a causa sua. Gli autori della «parabola» lo avevano notato già in Google Flu Trends: era anche Google, aggiornando il motore di ricerca (i termini di ricerca suggeriti, le diagnosi proposte per i sintomi) a cambiare i dati che il suo stesso modello leggeva [LKKV14].
Nei sistemi moderni questo circuito di retroazione (feedback loop) è ovunque. Un sistema di raccomandazione mostra i contenuti che prevede piaceranno; l’utente sceglie tra quelli, e i clic raccolti confermano al modello che aveva ragione, qualunque cosa avesse mostrato. Un modello di credito nega il prestito a chi giudica rischioso: di quelle persone non sapremo mai se avrebbero restituito i soldi, e i dati futuri conterranno solo le storie di chi il prestito l’ha avuto. In entrambi i casi il modello non osserva più il mondo: osserva le conseguenze delle proprie decisioni. E sui propri numeri può perfino sembrare sempre più bravo, mentre in realtà sta restringendo il mondo a ciò che aveva già deciso: chi guarda un video di cucina ne riceve altri dieci di cucina e non scoprirà mai la musica, e chi si è visto negare un prestito non avrà mai modo di dimostrare che l’avrebbe restituito.
Riaddestrare spesso, il secondo dei rimedi, qui non basta da solo: ogni riaddestramento usa dati che il modello precedente ha contribuito a produrre, e la domanda diventa se questa rincorsa si ferma.
Un sistema che consiglia video viene riaddestrato ogni settimana sui clic della settimana prima. Ma quei clic li ha prodotti lui: gli utenti hanno scelto fra i video che lui aveva deciso di mostrare. Così ogni riaddestramento insegue un bersaglio che il modello precedente ha spostato.
Possono succedere due cose. Se i consigli spostano i gusti di poco, meno di quanto basterebbe a cambiare la lezione che il modello ne ricava (l’utente guarda qualche video di cucina in più, ma resta quello che era), le rincorse si accorciano settimana dopo settimana, e il modello si ferma in un punto in cui, riaddestrato sui clic che lui stesso produce, non cambia più: un equilibrio. Se invece i consigli spostano molto i gusti, ogni settimana il modello trova un pubblico diverso da quello su cui si è preparato, e i riaddestramenti possono girare senza fermarsi mai.
E anche quando ci si ferma, l’equilibrio può non essere il migliore possibile: il modello e i gusti che ha contribuito a creare si danno ragione a vicenda, e basta. Il video di cucina che non porterà mai alla musica è un equilibrio di questo tipo.
Il quadro formale è la performative prediction [PZMDunnerH20]. Il modello di parametri \(\theta\) induce la distribuzione dei dati futuri, \(\mathcal{D}(\theta)\), e il rischio che conta è quello performativo, \(\mathrm{PR}(\theta) = \mathbb{E}_{z \sim \mathcal{D}(\theta)}\,\ell(z;\theta)\), con \(z = (\mathbf{x}, y)\) un esempio. Riaddestrare a intervalli è l’iterazione
Se la perdita è \(\gamma\)-fortemente convessa in \(\theta\) e \(\beta\)-liscia (in \(\theta\) e nei dati insieme), e il modello sposta i dati poco, \(W_1\big(\mathcal{D}(\theta), \mathcal{D}(\theta')\big) \le \varepsilon\,\lVert\theta - \theta'\rVert\) con \(W_1\) la distanza di Wasserstein-1 fra distribuzioni e \(\varepsilon < \gamma/\beta\), l’iterazione converge in modo lineare a un unico punto performativamente stabile: un \(\theta\) che resta ottimo sui dati che esso stesso produce. La condizione è stretta: se una delle ipotesi cade, il riaddestramento può non convergere affatto. E stabile non vuol dire ottimo: il punto fisso del riaddestramento in generale non minimizza \(\mathrm{PR}\).
Ci torneremo nel capitolo sui sistemi di raccomandazione, dove il circuito di retroazione è la struttura stessa del problema, e non un effetto collaterale.
Da ricordare
L’apprendimento supervisionato poggia su un’ipotesi tacita: che i dati di ieri e quelli di domani vengano dalla stessa urna. Il mondo non ha firmato quel contratto.
Tre modi in cui l’urna cambia, e vanno distinti perché chiedono rimedi diversi: cambiano le domande (l’app che riconosce le piante, addestrata d’estate e usata d’inverno: le foto sono altre, ma un abete resta un abete); cambiano le proporzioni delle risposte (la malattia rara che diventa un’epidemia: i sintomi sono gli stessi, la loro frequenza no); cambia la regola (le parole che nel 2005 gridavano truffa e oggi arrivano da un negozio serio). L’ultimo è il peggiore, perché nessuna quantità di dati vecchi può insegnare una regola nuova.
La validazione classica non protegge, perché studio, prove ed esame sono tre ritagli della stessa vecchia fotografia: è guidare guardando lo specchietto retrovisore. Se i dati hanno una data, la prova onesta è addestrare sul passato e verificare sul futuro.
I rimedi più usati sono abitudini prima che formule: sorvegliare il modello mentre lavora (gli ingressi somigliano a quelli di ieri? le risposte sono cambiate di colpo?), riaddestrarlo ogni tanto su dati recenti, giudicarlo su dati freschi. E dargli il permesso di dire «non lo so».
Un modello può anche imparare mentre lavora, un esempio alla volta. Lo si giudica col rimpianto, quanto sbaglia in più del miglior modello fisso scelto col senno di poi, e la garanzia vale qualunque cosa facciano i dati; ma se il mondo cambia a metà strada un rimpianto piccolo promette poco, correzioni che si accorciano lo rendono lento davanti al cambio, e correzioni di misura fissa lo fanno oscillare sempre.
Attenzione a quando è il modello stesso a fabbricare i dati di domani: se mostra solo certi contenuti, vedrà solo clic su quelli; se nega il prestito, non saprà mai chi avrebbe restituito. Da lì in avanti guarda le conseguenze delle proprie decisioni invece del mondo, e riaddestrarlo spesso può non bastare: la rincorsa si ferma con sicurezza quando il modello sposta i dati di poco, e anche allora l’equilibrio non è per forza il migliore.
Google Flu Trends è la parabola da ricordare: un modello che va bene sul passato può sbagliare per due ragioni, perché ha imparato l’inverno invece dell’influenza e perché il mondo in cui cerca cambia sotto di lui, e gli esami fatti sul passato non se ne accorgono.
Da ricordare
L’apprendimento supervisionato poggia su un’ipotesi tacita: dati di addestramento e dati reali vengono dalla stessa distribuzione (i.i.d.).
Tre famiglie di dataset shift, distinte da quale condizionata resta ferma: covariate shift (cambia \(P(\mathbf{x})\), resta \(P(y \mid \mathbf{x})\)), label shift (cambia \(P(y)\), resta \(P(\mathbf{x} \mid y)\)), concept shift (cambia \(P(y \mid \mathbf{x})\), cioè la regola stessa). La terna non esaurisce i casi, e concept drift in letteratura indica spesso qualunque cambiamento nel tempo.
La validazione classica non protegge: validation e test sono ritagli dello stesso passato, e senza un’ipotesi sulla distanza fra le distribuzioni non vincolano l’errore in produzione. Con dati temporali, meglio lo split temporale a origine mobile.
Rimedi onesti: monitoraggio in produzione, retraining periodico, validazione su dati freschi; l’importance weighting corregge il covariate shift (è un cambio di misura) ma solo se il supporto di produzione sta dentro quello di addestramento e il rapporto di densità si sa stimare, e con pesi appiattiti per tenere bassa la varianza.
Apprendimento online: su perdite convesse, la discesa del gradiente online ha rimpianto \(O(GD\sqrt{T})\) senza ipotesi statistiche sui dati, e con dati i.i.d. la media degli iterati eredita la garanzia (online-to-batch). Contro un bersaglio che si muove il passo decrescente è lento e il passo fisso paga \(\eta G^2 T/2\) anche da fermo: il passo giusto dipende da quanto si muove il mondo.
Attenzione ai feedback loop: quando le decisioni del modello generano i dati futuri (raccomandazioni, credito), il modello smette di osservare il mondo e inizia a osservare se stesso. Nel quadro della performative prediction il riaddestramento ripetuto converge a un punto stabile se la perdita è fortemente convessa e liscia e \(\varepsilon < \gamma/\beta\), e stabile non vuol dire ottimo.
Google Flu Trends resta la parabola di riferimento: un modello che va bene sul passato può invecchiare in silenzio, e il suo adattamento iniziale ai dati era in parte spurio [LKKV14].
Un modello che invecchia in silenzio non avverte quando lo si interroga lontano dai suoi esempi, che è proprio quello che fa il covariate shift. Resta da vedere un modello che accompagna ogni previsione con la propria incertezza, larga dove gli esempi mancano e stretta dove abbondano: sono i processi gaussiani. Sul cambio di regola non avvertirà nemmeno lui, perché la sua incertezza guarda dove stanno gli esempi, non che cosa dicono.