


Apprendimento supervisionato: regressione e classificazione#
Chi affianca per una settimana un agente immobiliare esperto non impara nessuna formula: vede centinaia di case già vendute (metri quadri, numero di stanze, quartiere) e accanto a ciascuna il prezzo finale. Dopo un po’, davanti a un appartamento mai visto, sa già proporre una cifra ragionevole. Ha imparato dagli esempi etichettati, ed è, in una frase, ciò che fa l’apprendimento supervisionato: mostrare a un modello abbastanza coppie domanda-risposta perché impari a rispondere da solo.
Imparare una funzione dagli esempi#
I dati di partenza sono quasi sempre una tabella: una riga per esempio (un appartamento, un’email, un paziente) e una colonna per caratteristica. Le colonne però non sono tutte dello stesso tipo, e il tipo decide che cosa ha senso farci sopra:
una colonna numerica contiene numeri veri, su cui somme, differenze e medie hanno un senso: i metri quadri di una casa, la sua età;
una colonna categorica contiene nomi, senza nessun ordine: il quartiere, il colore, la marca. Milano e Roma non sono uno più dell’altro, e la loro media non esiste;
una colonna ordinale sta in mezzo: i valori sono in fila (classe energetica A, B, C; «lieve», «moderato», «grave») ma non sappiamo di quanto disti uno dall’altro.

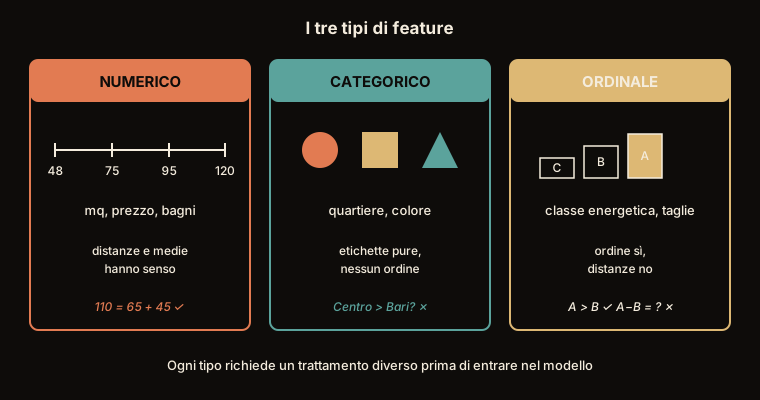
Fig. 4.3 Le tre colonne appena elencate, una accanto all’altra, con sotto le operazioni che ciascuna ammette. Confonderle è l’errore che porta un modello a calcolare la media fra «Milano» e «Roma».#
Stabilire di quale dei tre tipi sia ciascuna colonna, come in Fig. 4.3, è la prima decisione di ogni progetto, e la prende chi prepara i dati, non il modello. Se al quartiere «Milano» si assegna il numero 1 e a «Roma» il 2 per poterli passare a un programma (codifica a interi), la colonna diventa numerica a tutti gli effetti: un modello lineare o basato sulle distanze tratta Roma come il doppio di Milano e ammette un valore intermedio a 1,5, cioè un ordine e delle distanze che nessuno voleva introdurre. Il rimedio è la codifica one-hot, già incontrata con le parole di un vocabolario nella sezione sulla matematica di un modello linguistico: una colonna sì/no per ogni valore, in modo che nessun valore risulti più grande o più vicino di un altro.
Di ogni appartamento teniamo tre numeri in fila (metri quadri, stanze, piano; il quartiere, che è una categoria, entrerebbe con la codifica one-hot): un elenco ordinato di numeri si chiama vettore, ed è lo stesso oggetto della sezione sull’algebra lineare. Lo scriviamo \(\mathbf{x}\), in grassetto minuscolo, proprio per ricordare che non è un numero solo. A ciascun appartamento associamo poi un’etichetta \(y\) (il prezzo). Il «supervisore» è proprio quella \(y\) nota: qualcuno, in passato, ha già registrato la risposta giusta. Messi uno sotto l’altro, i vettori di tutti gli appartamenti formano la matrice dei dati \(\mathbf{X}\) della sezione sull’algebra lineare, una riga per esempio e una colonna per caratteristica, e le etichette il vettore \(\mathbf{y}\).
Una colonna è una direzione, un esempio è un punto
Prendi una tabella con due sole colonne: metri quadri e stanze. Puoi disegnarla su un foglio a quadretti, con i metri quadri sull’asse orizzontale e le stanze su quello verticale: ogni appartamento diventa un punto, e la tabella diventa una nuvola di punti. Con tre colonne servirebbe una scatola invece di un foglio, e i punti starebbero sospesi in aria. Con quattro colonne non riusciamo più a disegnarla, e tuttavia i conti si fanno lo stesso, identici a prima: si continua a parlare di punti, di distanze fra punti, di iperpiani che li separano (rette, in due dimensioni).
Quindi: ogni colonna della tabella è una direzione dello spazio, ogni riga è un punto in quello spazio. Una tabella con cento colonne descrive punti in uno spazio a cento dimensioni: «dimensione» indica una colonna, e nient’altro. Ridurre le dimensioni vorrà dire togliere direzioni; «spazio delle caratteristiche» sarà il nome di quello spazio lì; e frasi come «due esempi vicini» vorranno dire «due punti vicini», cioè due appartamenti simili in tutte le colonne insieme.
Abbiamo tante coppie (descrizione, risposta): la descrizione è la nostra \(\mathbf{x}\), la risposta è la \(y\). L’obiettivo è trovare una regola che, data una nuova descrizione, indovini la risposta. Chiamiamo questa regola \(f\):
Si legge così: dài la descrizione \(\mathbf{x}\) alla regola \(f\), e lei ti restituisce una risposta. È la stessa scrittura dei tasti di una calcolatrice (dài un numero a «radice quadrata» e ottieni un risultato), solo che qui quello che entra è un elenco di numeri e la regola è tutta da trovare. Il cappello su \(\hat{y}\) ricorda che è una previsione, non la verità: è la migliore stima del modello.
Per dire quanto vale una regola servono due conti, e non sono lo stesso conto. Il primo guarda un esempio alla volta e dice quanto quella singola risposta è sbagliata. Il secondo mette insieme tutti i primi e ne fa la media, come il voto di un compito che nasce dai punteggi delle sue domande. Con dieci esempi ci sono dieci errori singoli e un solo numero riassuntivo, con diecimila esempi diecimila e uno. I due servono in momenti diversi: l’errore singolo dice dove la regola sta sbagliando, la media dice se nel suo insieme sta migliorando. Quella media è la loss, e si può anche calcolare su una manciata di esempi per volta invece che su tutti, per risparmiare conti, come fa la discesa stocastica della sezione su analisi e ottimizzazione. Imparare significa scegliere la \(f\) che rende quella media più piccola che si può sugli esempi già noti, sperando che se la cavi bene anche su quelli nuovi.
La \(f\), però, non si sceglie fra tutte le regole immaginabili. Si sceglie dentro un catalogo deciso prima di guardare gli esempi (per il prezzo delle case, le sole regole «tanto al metro quadro, più un tanto fisso», che su un foglio a quadretti disegnano delle rette), e quel catalogo si chiama spazio delle ipotesi. Decide che cosa il modello potrà mai imparare, e sbagliarlo costa in due modi opposti. Se è troppo povero, la regola buona non c’è, e nessuna quantità di esempi la fa comparire: fra le rette non si trova una curva. Se è troppo ricco, ci sono dentro anche regole che azzeccano gli esempi noti per pura coincidenza (una formula tutta curve che passa esattamente per i prezzi delle dieci case note, e sull’undicesima sbaglia di centomila euro), e scegliendo la migliore sugli esempi si rischia di prendere una di quelle. È la stessa cosa che succede quando mille persone lanciano una moneta dieci volte: qualcuna fa dieci teste e sembra bravissima, ma alla prova successiva fa come tutti. Le persone sono le regole del catalogo e i dieci lanci le dieci case note: più regole ci sono, più è facile che una le azzecchi tutte per caso. Il pericolo cala con il numero degli esempi, perché una coincidenza che regge su dieci case regge molto più di rado su diecimila.
Partiamo da un insieme di addestramento di \(m\) esempi etichettati,
e cerchiamo una funzione \(f:\mathcal{X}\to\mathcal{Y}\) che approssimi la relazione ignota tra ingressi e uscite, con \(\hat{y}=f(\mathbf{x})\). La qualità di \(f\) si misura con una funzione di costo (o loss), e i due oggetti che portano quel nome vanno tenuti distinti: \(\ell\) è il costo di una predizione, \(\mathcal{L}\) è quello sull’intero insieme, cioè la media dei primi. L’addestramento è il problema di ottimizzazione
dove \(\theta\) sono i parametri del modello. La distinzione fra \(\ell\) e \(\mathcal{L}\) tornerà utile più avanti, quando il gradiente si calcolerà su un sottoinsieme di esempi invece che su tutti. La natura di \(\mathcal{Y}\) distingue i due problemi cardine: continuo per la regressione, discreto per la classificazione.
La minimizzazione non corre su tutte le funzioni da \(\mathcal{X}\) a \(\mathcal{Y}\), ma su una famiglia fissata prima dei dati, lo spazio delle ipotesi \(\mathcal{H} = \{f_\theta : \theta\in\Theta\}\): le funzioni affini per la regressione lineare, gli alberi di profondità limitata, le reti di una data architettura. Il principio si chiama minimizzazione del rischio empirico. La scelta di \(\mathcal{H}\) è un’ipotesi sul problema presa prima di vedere un solo esempio, ed è la forma più netta del bias induttivo del modello (restriction bias); l’altra forma è la preferenza fra funzioni della stessa famiglia, per esempio quella espressa da una penalità (preference bias) [Mit97]. Nulla di questo ha a che fare con il termine noto \(b\) delle rette, che si chiama anch’esso bias. L’effetto della scelta di \(\mathcal{H}\) si divide in due errori [MRT18]. Con \(R(f) = \mathbb{E}\big[\ell(f(\mathbf{x}), y)\big]\) il costo atteso sulla distribuzione, di cui \(\mathcal{L}\) è la media campionaria (il rischio empirico), e \(R_{\min}\) il più piccolo costo atteso fra tutte le funzioni (nella notazione dell’Introduzione, dove si massimizzava un’utilità \(U=-\ell\), \(R\) è \(-J\) e \(\mathcal{L}\) è \(-\hat J\); il numero degli esempi, che lì si chiamava \(n\), qui si chiama \(m\), e \(n\) conta le caratteristiche),
Se \(\mathcal{H}\) non contiene niente di vicino alla relazione vera, l’errore di approssimazione resta, e nessuna quantità di dati lo toglie. Se \(\mathcal{H}\) è ricca, la funzione che minimizza il costo sul campione può costare, sulla distribuzione, parecchio più della migliore di \(\mathcal{H}\), e l’errore di stima cresce. Quando tutti i costi empirici distano al più \(\varepsilon\) dai veri, la funzione scelta perde al più \(2\varepsilon\) rispetto alla migliore; e per \(\mathcal{H}\) finita, esempi i.i.d. e perdita \(\ell\) in \([0,1]\), la disuguaglianza dell’unione della sezione sulla concentrazione (dove il numero di esempi si chiama \(n\)) dà, con probabilità almeno \(1-\delta\), \(\varepsilon = \sqrt{\big(\log\lvert\mathcal{H}\rvert + \log(2/\delta)\big)/(2m)}\), cioè \(\varepsilon\) dell’ordine di \(\sqrt{\log\lvert\mathcal{H}\rvert / m}\) a \(\delta\) fissato. È un limite superiore, che cresce con la ricchezza di \(\mathcal{H}\) e cala con \(m\). Le famiglie appena elencate però sono infinite, e il conto che per loro sostituisce \(\log\lvert\mathcal{H}\rvert\) con la dimensione VC è il tema del capitolo sulla teoria dell’apprendimento; perché per le reti la lettura «più ricca, più errore» non basti lo mostra la doppia discesa.
Due domande, due problemi#
Ciò che distingue i due problemi è il tipo di risposta. «Quanto costa questa casa?» chiede un numero su una scala continua: è regressione. «Questa email è spam, sì o no?» chiede un’etichetta da un insieme finito: è classificazione, e le etichette possibili si chiamano classi (spam e non spam sono due classi). Stesso impianto, imparare \(f\) da coppie \((\mathbf{x}, y)\), due geometrie diverse, come mostra Fig. 4.4: a sinistra cerchiamo una linea che segua i punti, a destra una linea che li separi.

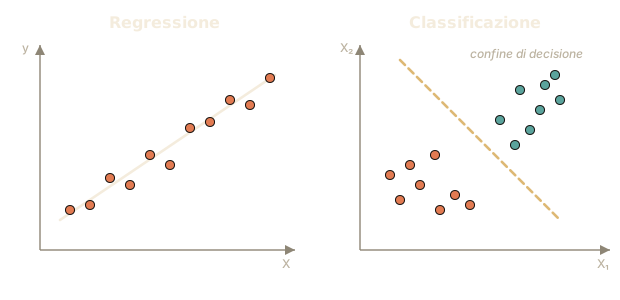
Fig. 4.4 Due volti dello stesso problema. Nella regressione (sinistra) la retta approssima i dati; nella classificazione (destra) la retta separa le classi.#
Il nome «regressione» non dice quello che il metodo fa, ed è un incidente storico. Lo mette in circolazione Francis Galton in un articolo del 1886 [Gal86], dove misura la statura di genitori e figli e trova che i figli dei genitori alti sono sì più alti della media, ma meno dei genitori: la statura regredisce verso il centro. Galton chiamò rette di regressione quelle che disegnava per mostrarlo, e da lì la parola è rimasta attaccata alla tecnica invece che al fenomeno; nomi più onesti sarebbero stati «approssimazione di una funzione» o «previsione di un numero» [RN20].
La regressione lineare: la retta di best fit#
Il modello più semplice, e spesso sorprendentemente efficace, assume che ogni caratteristica sposti la risposta di una quantità proporzionale al suo valore: dieci metri quadri in più aggiungono sempre la stessa cifra, a qualunque superficie si parta, e una stanza in più vale sempre lo stesso tanto, che sia la seconda o la quinta.
Il conto si fa a mano. A ogni caratteristica \(x_j\) si associa un numero \(w_j\), il suo peso, che dice di quanto quella caratteristica sposta la risposta; si moltiplica ogni caratteristica per il suo peso, si sommano i prodotti e si aggiunge un termine fisso \(b\), il punto di partenza. Con \(n\) caratteristiche:
Niente potenze, niente caratteristiche moltiplicate fra loro. Una risposta ottenuta così, moltiplicando e sommando e basta, è una combinazione lineare delle caratteristiche più un termine costante: in senso stretto una funzione affine, che in machine learning si chiama comunque lineare. La parola «lineare» indica sempre questo.
Guardando i soli metri quadri, l’agente se la cava con una regola sola: duemila euro al metro quadro più cinquantamila di partenza. Un appartamento di \(80\) m² viene \(2\,000 \cdot 80 + 50\,000 = 210\,000\) €. Con le lettere, quella regola è una retta:
dove \(w\) è la pendenza (quanto sale il prezzo per ogni metro quadro in più) e \(b\) il punto di partenza. Di rette ce ne sono infinite, e l’agente vuole quella che passa più in mezzo alle case già vendute, la retta di best fit (l’espressione inglese vuol dire «che si adatta meglio», e in italiano si dice anche retta di regressione).
Per trovarla apre l’archivio. Gli \(80\) m² sono andati proprio a \(210\,000\) €, scarto zero; un \(60\) m² è stato venduto a \(160\,000\) € e la regola ne chiede \(170\,000\), diecimila di troppo; un \(100\) m² è andato a \(260\,000\) € e la regola ne chiede \(250\,000\), diecimila in meno. Sommati come stanno, il \(+10\,000\) e il \(-10\,000\) si cancellano, e la regola sembra perfetta dopo aver mancato due case su tre. Allora l’agente eleva gli scarti al quadrato, che li rende tutti positivi, e ne fa la media: in migliaia di euro, \(0\), \(+10\) e \(-10\) diventano \(0\), \(100\) e \(100\), e la media è \((0 + 100 + 100)/3 \approx 67\). Quel \(67\) è in migliaia di euro al quadrato, quindi non è un prezzo: serve a dire quale retta batte quale, e più è piccolo, migliore è la retta. Il quadrato fa anche un secondo mestiere, voluto: uno scarto doppio pesa quattro volte tanto (\(10\) al quadrato fa \(100\), \(20\) ne fa \(400\)), e vince la retta che sbaglia poco su molte case, non quella che le azzecca quasi tutte e prende un abbaglio su una. Lo stesso mestiere ha un rovescio: una casa sola registrata a un prezzo assurdo (un affare fra parenti, uno zero di troppo) ha uno scarto enorme, e il quadrato lo ingigantisce: uno scarto dieci volte più grande pesa cento volte tanto. Per non pagarlo, la retta si piega verso quella casa sola.
Provarle tutte non si può. L’agente ne prende una qualsiasi e la aggiusta a piccoli passi, come chi scende da una collina nella nebbia: un passo dalla parte in cui il terreno cala, poi un altro da lì, finché non c’è più discesa. La posizione sul fianco è la coppia \((w, b)\), l’altezza è quanto quella retta sbaglia sulle case dell’archivio. Il piede, qui, non serve: l’errore è scritto in una formula, e la pendenza si calcola stando fermi, come quella di una rampa dalle sue misure. La direzione in cui il terreno sale più ripido si chiama gradiente, e camminare nel verso opposto, passo dopo passo, è la discesa del gradiente. La lunghezza del passo la decide chi cammina, e cambia tutto: a passi corti ci si mette un’eternità, a passi lunghi si scavalca il fondovalle e si rimbalza da un fianco all’altro. Si chiama learning rate (il tasso di apprendimento, \(\eta\)), e come si sceglie lo spiega la sezione su discesa del gradiente e learning rate.
Nella nebbia, di solito, ci si ferma nella prima conca, senza sapere che dietro il crinale ce n’era una più profonda. Qui no: con la media degli scarti al quadrato la collina è una scodella con un fondo solo, e da qualunque retta si parta si arriva lì, purché i passi non siano troppo lunghi. Vale per la retta e non per ogni modello: le reti neurali camminano su terreni molto più accidentati. E per una retta si può anche non camminare, perché un conto diretto dà i pesi migliori in un colpo solo; si usa finché i dati stanno comodi, e con migliaia di colonne, o con tanti esempi da non stare in memoria, la passeggiata torna a costare meno.
Un guasto, però, la nebbia non lo spiega. In archivio la superficie è finita due volte, in metri quadri da una fonte e in centimetri quadrati da un’altra, e il fondo della scodella si allunga in un fondovalle piatto: duemila euro al metro quadro e niente all’altra colonna, oppure mille euro al metro quadro e dieci centesimi al centimetro quadrato, danno su ogni casa lo stesso prezzo (su \(80\) m², cioè \(800\,000\) cm², la superficie porta \(160\,000\) € nei due modi). Due colleghi partiti da punti diversi si fermano in due punti diversi di quel fondo, con due regole diverse, e il conto diretto si inceppa, perché di punti più bassi ce n’è una fila intera. I prezzi restano buoni, ma i pesi non si leggono più, e la frase «i metri quadri contano duemila euro» perde senso. Lo stesso succede quando le colonne sono più delle case in archivio: tanti pesi, poche vendite da rispettare.
Con \(n\) caratteristiche il modello diventa un prodotto scalare più un bias:
I parametri \(\mathbf{w}\in\mathbb{R}^n\) e \(b\in\mathbb{R}\) si stimano minimizzando l’errore quadratico medio (Mean Squared Error):
\(\mathcal{L}\) è convessa in \((\mathbf{w},b)\): niente minimi locali in cui restare intrappolati. Se le colonne della matrice dei dati, insieme alla colonna costante del bias, sono linearmente indipendenti, il minimo è anche unico e si raggiunge in forma chiusa con le equazioni normali; con feature collineari (una feature costante basta, perché replica la colonna del bias), o con meno esempi che feature, i punti di minimo diventano infiniti (un intero sottospazio, tutti con lo stesso valore della loss) e le equazioni normali degenerano. Su grandi dataset, in ogni caso, si preferisce la discesa del gradiente. Con \(\tilde{\mathbf{X}} \in \mathbb{R}^{m\times(n+1)}\), la matrice dei dati con in più la colonna di uni, la soluzione è \((\hat{\mathbf{w}}, \hat{b}) = (\tilde{\mathbf{X}}^\top\tilde{\mathbf{X}})^{-1}\tilde{\mathbf{X}}^\top\mathbf{y}\), e la sezione su ortogonalità e proiezioni spiega perché la si calcola con una fattorizzazione QR invece di invertire. Le equazioni normali si ottengono annullando il gradiente, \(\nabla_{\theta}\mathcal{L} = \tfrac{2}{m}\tilde{\mathbf{X}}^\top(\tilde{\mathbf{X}}\theta - \mathbf{y}) = \mathbf{0}\), con \(\theta = (\mathbf{w}, b)\), cioè \(\tilde{\mathbf{X}}^\top\tilde{\mathbf{X}}\,\theta = \tilde{\mathbf{X}}^\top\mathbf{y}\): i residui sono ortogonali a ogni colonna, compresa quella costante. Il costo è \(O(mn^2 + n^3)\), contro \(O(mn)\) per un passo di discesa del gradiente: con \(n\) nell’ordine delle migliaia, o con dati che non stanno in memoria, si passa all’iterativo, \(\theta \leftarrow \theta - \eta\,\nabla_\theta\mathcal{L}(\theta)\), con \(\eta\) il tasso di apprendimento, il primo degli iperparametri di cui tratta la sezione sulla loro ricerca. Minimizzare l’MSE equivale poi alla stima di massima verosimiglianza sotto il modello \(y = \mathbf{w}^\top\mathbf{x} + b + \varepsilon\) con \(\varepsilon \sim \mathcal{N}(0,\sigma^2)\) indipendenti: è l’ipotesi che si firma usando questa loss, e i modelli lineari generalizzati la allentano. Elevare al quadrato rende la loss differenziabile ovunque, e ha un prezzo, la sensibilità ai valori anomali: il minimo della perdita quadratica rispetto a una costante è la media, quello della perdita assoluta è la mediana, e un solo punto molto lontano sposta la retta ai minimi quadrati molto più di quella che minimizza l’errore assoluto. La perdita di Huber, quadratica vicino a zero e lineare lontano, sta in mezzo.
La discesa del gradiente, qui al lavoro su una retta sola, è il metodo con cui si addestrano quasi tutti i modelli che hanno una loss derivabile, reti neurali comprese. Per questo la loss fa due mestieri: dà un voto alla regola e, con il suo gradiente, le indica in che verso spostare i parametri. In una rete, dove i parametri possono essere milioni, quel gradiente lo calcola un procedimento apposito, la backpropagation.
La regressione logistica: dal numero alla probabilità#
Per la classificazione la retta da sola non basta. Siccome un modello lavora su numeri, le due risposte si scrivono per convenzione \(0\) («no») e \(1\) («sì»): è una scelta di notazione, e scambiarle cambia solo il segno dei pesi, non le previsioni. Fatto questo, la differenza con la regressione salta all’occhio: un prezzo può valere \(310\,000\), mentre la risposta a «spam sì/no» vale solo \(0\) o \(1\). La regressione logistica (il nome è storico: serve a classificare) risolve il problema in due mosse: calcola un punteggio lineare delle caratteristiche e lo converte in una probabilità.
Arriva un’email, e il filtro ne guarda alcune caratteristiche: quante volte compare la parola «offerta», quanti collegamenti contiene, se il mittente è in rubrica. Moltiplica ciascuna per il suo peso, somma tutto e aggiunge il numero di partenza, come per la retta. Ne esce un punteggio che può valere qualsiasi cosa, \(-7\) o \(+412\).
Poi lo schiaccia dentro una regola a forma di «S», la sigmoide, che di qualunque numero ne fa uno compreso fra \(0\) e \(1\). Per farlo usa le potenze di un numero fisso, \(e \approx 2{,}718\) (lo racconta la sezione su analisi e ottimizzazione): al punteggio \(2\) dà \(0{,}88\), allo zero esattamente la metà, \(0{,}5\), a \(-2\) dà \(0{,}12\). Quel numero si legge come una probabilità, cioè come la sicurezza del filtro che l’email sia spam: \(0{,}9\) vuol dire «ci scommetterei», \(0{,}52\) «non ne ho idea, ma se proprio devo dico sì». La risposta secca il filtro non la dà da solo: la dà un taglio fissato da chi lo usa, per abitudine \(0{,}5\), con «sì» sopra e «no» sotto.
I pesi si trovano scendendo di nuovo una collina, ma l’altezza adesso si misura come in una scommessa: il filtro punta la sua sicurezza, e se sbaglia paga una multa tanto più salata quanto più era sicuro. La multa sale di un gradino ogni volta che la sicurezza lasciata alla risposta giusta si divide per dieci, e di circa mezzo gradino quando si divide per tre, perché tre per tre fa quasi dieci (contare le divisioni per dieci è il logaritmo della sezione su analisi e ottimizzazione). Dare \(0{,}6\) a un’email che spam non era lascia \(0{,}4\) al «no», uno diviso due volte e mezza: meno di mezzo gradino. Darle \(0{,}99\) lascia \(0{,}01\), uno diviso due volte per dieci: due gradini, cinque volte tanto. Chi puntasse tutto sbagliando pagherebbe senza fondo.
Con la media degli scarti al quadrato della retta, invece, il terreno farebbe gobbe e ripiani. Quando il filtro è sicurissimo e sbaglia, la S è già piatta: spostare i pesi quasi non cambia la sua sicurezza, e il terreno sembra in piano proprio dove l’errore è più grande. La multa rende una scodella con un fondo solo, tranne in un caso. Se un confine mette da una parte tutte le spam e dall’altra tutte le altre, senza nemmeno un’eccezione, al filtro conviene essere sempre più sicuro, e gli basta ingrandire i pesi: il terreno scende senza fine, e un fondo non c’è.
Con più di due risposte, per esempio la cartella in cui mettere l’email (lavoro, amici, promozioni), ogni cartella ha i suoi pesi e il suo punteggio. Il filtro rende i punteggi positivi, perché una sicurezza sotto zero non esiste, elevando lo stesso \(e\) della S a ciascun punteggio (con un altro numero cambierebbe solo la scala dei pesi): il più alto resta il più alto, e anche un punteggio negativo diventa un numero piccolo ma positivo. Poi divide ciascuno per la somma di tutti, così le sicurezze sommano a uno. Con \(2\) per il lavoro, \(1\) per gli amici e \(0\) per le promozioni vengono \(7{,}39\), \(2{,}72\) e \(1\), che sommano a \(11{,}11\): le sicurezze sono \(0{,}67\), \(0{,}24\) e \(0{,}09\).
Alzare di uno tutti i punteggi non cambia niente. Con \(3\), \(2\) e \(1\) i numeri sono tutti moltiplicati per \(e\), \(20{,}09\), \(7{,}39\) e \(2{,}72\), la somma pure, \(30{,}19\), e nella divisione il fattore si semplifica come in una frazione. Conta solo la distanza fra i punteggi, e chi cerca i pesi trova infinite versioni pari merito senza sapere dove fermarsi. Si fa come con un termometro, che per misurare ha bisogno di uno zero: le promozioni stanno sempre a zero, e le altre cartelle si misurano da lì. Un \(2\) per il lavoro vuol dire allora che il lavoro è \(e^2 \approx 7{,}39\) volte più probabile delle promozioni, non due volte. Con due sole cartelle, una ferma a zero, torna la S: \(2\) contro \(0\) dà \(7{,}39\) e \(1\), e \(7{,}39\) diviso \(8{,}39\) fa \(0{,}88\), lo stesso numero della S al punteggio \(2\). Il conto delle potenze divise per il totale si chiama softmax, e il modello intero regressione logistica multinomiale, cioè a più risposte.
Alla stessa ricetta si arriva anche da un’altra strada, che le dà un secondo nome, massima entropia (entropia è il nome che la teoria dell’informazione dà alla misura dell’incertezza). L’idea è non credere più di quanto dicano i dati. Se fra le email d’esempio con «offerta» sette su dieci erano promozioni, il filtro deve dare in media sette su dieci alle promozioni su quelle email; per il resto, meno convinzioni si inventa meglio è, perché una convinzione che i dati non sostengono sbaglia sulle email nuove. Senza nessun fatto, la scelta più onesta è un terzo a testa; con i fatti, la ricetta meno convinta che li rispetta tutti è proprio quella delle potenze di \(e\). E se i fatti sono netti, perché tutte le email con «offerta» erano promozioni, la meno convinta compatibile con loro è la certezza: di nuovo il confine senza eccezioni, e pesi che crescono senza fine.
Sia \(z = \mathbf{w}^\top \mathbf{x} + b\) il punteggio lineare. La sigmoide (o logistica) è
e interpretiamo \(\hat{y} = \sigma(z)\) come \(P(y=1 \mid \mathbf{x})\). La previsione di classe si ottiene con una soglia a \(0{,}5\), che equivale a \(z = 0\): l’insieme
è il confine di decisione, un iperpiano che divide lo spazio in due regioni. I parametri si stimano minimizzando la cross-entropy, cioè la log-verosimiglianza negativa di una Bernoulli di parametro \(\hat{y}^{(i)} = \sigma(z^{(i)})\):
Grazie a \(\sigma'(z) = \sigma(z)\,(1-\sigma(z))\) il gradiente ha la forma di
quello dei minimi quadrati, \(\nabla_{\mathbf{w}}\mathcal{L} =
\frac{1}{m}\sum_i\big(\hat{y}^{(i)} - y^{(i)}\big)\,\mathbf{x}^{(i)}\), e
l’hessiana \(\frac{1}{m}\sum_i
\hat{y}^{(i)}\big(1-\hat{y}^{(i)}\big)\,\mathbf{x}^{(i)}\mathbf{x}^{(i)\top}\) è
semidefinita positiva: la loss è convessa. L’MSE composto con la sigmoide
invece non lo è, e ha un difetto peggiore: il suo gradiente contiene il fattore
\(\sigma'(z)\), che si annulla proprio sugli esempi sbagliati con grande
sicurezza, e la discesa si ferma dove l’errore è massimo. Non c’è forma chiusa:
si risolve con il metodo di Newton (l’IRLS dei modelli lineari generalizzati) o
con L-BFGS, che è il solver di default di scikit-learn.
Con \(K\) classi la regressione logistica multinomiale assegna a ogni classe un vettore di pesi e pone
cioè la funzione softmax dei punteggi (la sezione sulle funzioni di attivazione la riprende come ultimo strato di una rete). Aggiungere lo stesso vettore a tutti i \(\mathbf{w}_k\), e lo stesso numero a tutti i \(b_k\), non cambia le probabilità, quindi i parametri si identificano fissando una classe di riferimento: con \(\mathbf{w}_K = \mathbf{0}\) e \(b_K = 0\), i log-odds \(\log\big(P(y=k\mid\mathbf{x})/P(y=K\mid\mathbf{x})\big) = \mathbf{w}_k^\top\mathbf{x} + b_k\) sono lineari. Per \(K = 2\), nella parametrizzazione libera, si ritrova la sigmoide di \(P(y=1\mid\mathbf{x})\), con \(\mathbf{w} = \mathbf{w}_1 - \mathbf{w}_2\) e \(b = b_1 - b_2\). In scikit-learn, come nell’ultimo strato di una rete, restano tutti i \(K\) vettori senza nessuna classe fissata, e a sceglierne il rappresentante è la penalità \(\ell_2\) della libreria, che porta a \(\sum_k \mathbf{w}_k = \mathbf{0}\). La loss è la cross-entropy categorica, \(\mathcal{L} = -\frac{1}{m}\sum_{i} \log P(y = y^{(i)} \mid \mathbf{x}^{(i)})\), ancora convessa, con gradiente
e all’ottimo il modello riproduce sul campione, classe per classe, le medie empiriche delle \(x_s\,\mathbb{1}[y=k]\), con \(x_s\) la componente \(s\) di \(\mathbf{x}\). Sono i vincoli del problema di massima entropia condizionata [BDPDP96]. Fra le \(P(y \mid \mathbf{x})\) che riproducono sul campione i valori attesi empirici di un insieme di feature \(f_r(\mathbf{x}, y)\), quella di entropia condizionata massima ha la forma log-lineare \(P(y\mid\mathbf{x}) \propto \exp\big(\sum_r \lambda_r f_r(\mathbf{x}, y)\big)\), e i moltiplicatori \(\lambda_r\) sono le stime di massima verosimiglianza di quel modello, perché i due problemi sono duali. Con le feature \(x_s\,\mathbb{1}[y=k]\) e \(\mathbb{1}[y=k]\) l’esponente vale \(\mathbf{w}_y^\top\mathbf{x} + b_y\), e la forma log-lineare diventa la softmax. Per questo nella letteratura sul linguaggio lo stesso classificatore circola con due nomi. La dualità chiede però che la verosimiglianza abbia un massimo. Sotto separazione perfetta la soluzione di massima entropia esiste ancora, ma è soltanto il limite di modelli log-lineari con moltiplicatori che divergono. Mohri e colleghi (teorema 13.1) allentano i vincoli e ottengono come duale la verosimiglianza con penalità \(\ell_1\); la penalità \(\ell_2\) di scikit-learn è la loro variante del §13.8 [MRT18].

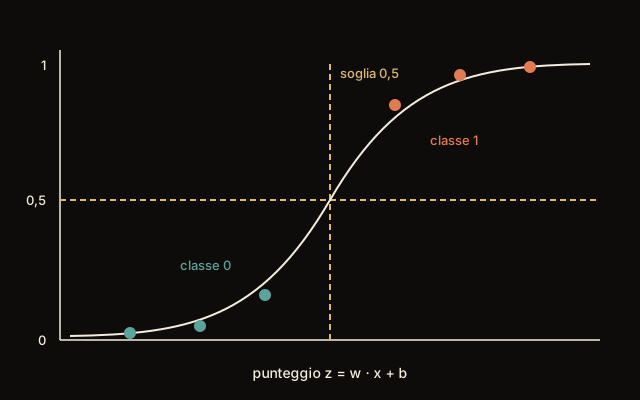
Fig. 4.5 Dalla retta alla probabilità. La sigmoide non decide: produce un numero fra zero e uno, e la decisione arriva dopo, quando si sceglie dove tagliare.#
I due gesti che Fig. 4.5 tiene separati (produrre un numero, e poi decidere) torneranno nella sezione sulle metriche. Il punto in cui si taglia si chiama soglia, e quel \(0{,}5\) è una convenzione, non un risultato: possiamo spostarlo. Abbassandolo si segnalano più email come spam, quindi meno spam passa ma più messaggi buoni finiscono nel cestino; alzandolo succede l’opposto. Nessuno dei due errori sparisce, si scambiano l’uno con l’altro. La cosa notevole è che per farlo non serve riaddestrare niente: il modello resta quello, cambia solo dove mettiamo il taglio.
C’è poi una cosa da sapere prima di scrivere la prima riga di codice, perché è una piccola sorpresa.
Quando in scikit-learn si scrive LogisticRegression() e basta, non si ottiene
la regressione logistica «pura», quella fatta di punteggio, schiacciamento e
nient’altro. La libreria ci aggiunge di
suo un freno, cioè quel prezzo alla complessità che vedremo nella prossima
sezione: senza dire niente, tiene i pesi più piccoli di quanto sarebbero.
È quasi sempre un bene. Con dati così facili che una linea li separa alla perfezione, il modello, per prendere pieni voti, non deve solo azzeccare le risposte, deve anche essere sicuro, e per essere più sicuro gli basta ingigantire i pesi. Un punteggio di \(10\) dà una probabilità del \(99{,}99\%\), uno di \(100\) ne dà una ancora più vicina a \(1\): non c’è mai un motivo per fermarsi, e senza freno i pesi crescono all’infinito. Il freno è ciò che dice «basta così».
Il freno si vede nei numeri. Su quattro punti messi in modo che una linea li
separi senza incertezze, il peso che esce con le impostazioni di fabbrica vale
circa \(1\), e chiedendo di togliere il freno diventa quasi nove volte tanto, ma
solo perché a un certo punto il calcolo smette di cercare: chiedendogli più
precisione, il peso cresce ancora. Il confine fra le due classi, intanto, resta
esattamente dov’era. La manopola si chiama C, e ha un verso che confonde,
perché il numero da scrivere dice quanto freno si toglie: più è grande, meno
freno c’è. È comunque il tipo di dettaglio che va saputo, perché il modello che
gira non è quello della definizione, e chi confronta quei due pesi senza saperlo
pensa di aver sbagliato i conti.
Quello che gira davvero quando si scrive LogisticRegression() non è la stima
di massima verosimiglianza: scikit-learn aggiunge di suo una
penalità \(\ell_2\) sui
pesi, di intensità C=1.0 (in quella parametrizzazione \(C\) è l’inverso della
forza del freno, come nelle SVM). Il modello che esce, quindi, minimizza la
cross-entropy più quella penalità, e la differenza non è cosmetica: sui
quattro punti \(x = -2, -1, 1, 2\) con etichette \(0, 0, 1, 1\) (una dimensione,
linearmente separabili) il coefficiente
stimato vale \(1{,}01\) con i default, e chiedendo C=np.inf vale \(8{,}85\), un
numero che non ha niente di speciale: è dove L-BFGS si ferma con la tolleranza
di default, e con tol=1e-8 sale a \(17{,}86\). Sotto separazione perfetta il
massimo di verosimiglianza non esiste e i pesi vorrebbero andare all’infinito:
con i default li ferma il freno, senza li ferma soltanto il criterio
d’arresto. Chi vuole la stima non regolarizzata deve chiederla
sapendo che cosa sta chiedendo.
I quattro punti, con il freno e senza:
import numpy as np
from sklearn.linear_model import LogisticRegression

X = np.array([-2.0, -1.0, 1.0, 2.0]).reshape(-1, 1)
y = np.array([0, 0, 1, 1])
print(LogisticRegression().fit(X, y).coef_[0, 0].round(2))   # con il freno
for tol in (1e-4, 1e-8):
    senza = LogisticRegression(C=np.inf, tol=tol).fit(X, y)
    print(tol, senza.coef_[0, 0].round(2))    # senza: dipende dalla tolleranza
1.01
0.0001 8.85
1e-08 17.86
Lineare, logistica, Poisson: una famiglia sola#
I due modelli visti finora rispondono a due domande diverse: la retta dice quanto (un prezzo, una temperatura, un numero qualsiasi), la logistica dice sì o no. Ce n’è una terza, altrettanto comune, alla quale nessuna delle due risponde: quante volte. Quanti clienti entrano in farmacia fra le nove e le dieci, quanti guasti registra una linea in un turno, quante volte un utente apre l’applicazione in una settimana. Sono conteggi: numeri interi, mai negativi, e con una particolarità che la retta non sa gestire.
Provare comunque con la retta è istruttivo, perché fallisce in due modi visibili. Su duemila giornate (inventate al calcolatore, così che la risposta giusta si conosca in anticipo e si possa controllare se il modello la ritrova) la retta migliore prevede un numero negativo di clienti in duecentoquarantasette casi, il che è una risposta che nessuno può usare; e i suoi scarti si aprono a ventaglio, piccoli dove i clienti sono pochi e grandi dove sono tanti, mentre la media degli scarti al quadrato, che è il metro con cui la retta si giudica, li conta tutti allo stesso modo, come se lo sbaglio tipico fosse lo stesso dappertutto.
La riparazione non butta via niente di quello che si è imparato: tiene il punteggio lineare, cambia il modo di leggerlo, e cambia la regola con cui si misura lo scarto. Fatto per la terza volta, il gesto si riconosce come uno solo, e ha un nome, modelli lineari generalizzati, che gli hanno dato John Nelder e Robert Wedderburn nel 1972 [NW72]. Fig. 4.6 mette i tre casi uno accanto all’altro.
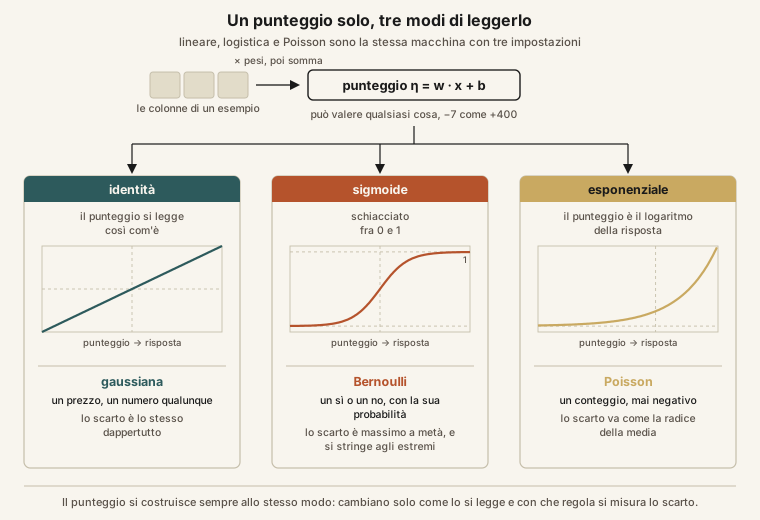
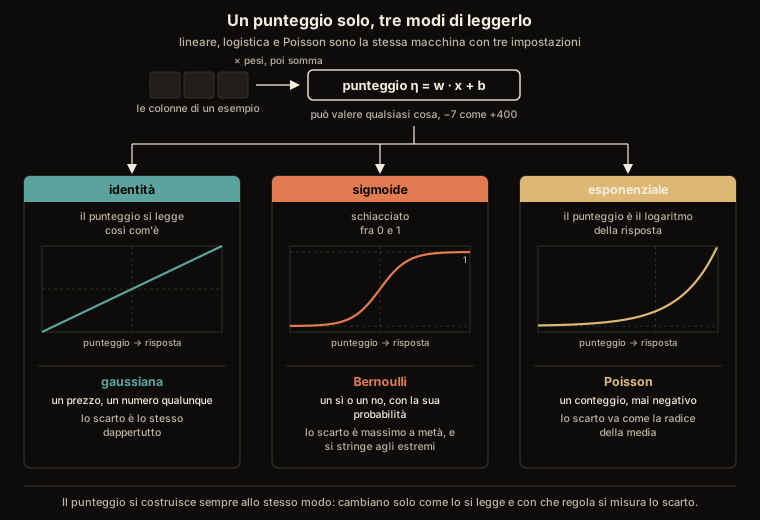
Fig. 4.6 Il punteggio è sempre lo stesso conto: colonne per pesi, sommate. Cambiano la funzione che lo legge (così com’è, schiacciato fra zero e uno, oppure preso come logaritmo della risposta) e la regola con cui si misura lo scarto.#
Il farmacista vuole sapere quanti clienti aspettarsi alle nove del mattino, e ha le colonne di sempre: che giorno è, che tempo fa, se c’è una promozione in corso, quanto si è dentro la stagione dell’influenza. Moltiplica ogni colonna per il suo peso, somma tutto, e ottiene il solito punteggio, che può valere qualsiasi cosa, meno sette o più quattrocento.
Qui le tre risposte si separano. Per un prezzo il punteggio si legge così com’è; per un sì o no lo si schiaccia fra zero e uno con la curva a esse. Il farmacista fa una terza cosa: prende il punteggio come logaritmo del numero di clienti, e per tornare ai clienti fa il conto all’incontrario, elevando a quel punteggio il numero \(e\), lo stesso che rendeva positivi i punteggi delle cartelle. Un numero positivo elevato a qualunque cosa resta positivo, anche a un esponente negativo, quindi la previsione non può più dire meno tre clienti.
Cambia però il senso dei pesi. Nel punteggio si sommano, come sempre, ma disfare un logaritmo trasforma le somme in prodotti, e sui clienti i pesi moltiplicano. Un peso che vale un mezzo non aggiunge mezzo cliente: moltiplica per la radice quadrata di \(2{,}718\) (elevare a un mezzo è fare la radice quadrata, perché due mezzi fanno uno), cioè per \(1{,}65\). Il sabato non aggiunge dodici clienti: il sabato raddoppia.
Il farmacista deve anche guardare l’orologio. Dodici clienti in un’ora e dodici in una giornata sono due fatti diversi, e se le finestre contate non durano tutte uguale, la durata entra nel conto come un ingrediente con il peso già deciso, che il modello non impara: quello che stima diventa il ritmo, cioè i clienti per ora.
Resta la regola con cui si misura lo scarto, perché un conteggio non si sparpaglia come un prezzo. Se in media entrano due clienti l’ora, i giorni oscillano fra zero e cinque; se ne entrano cento, fra ottanta e centoventi. In proporzione l’oscillazione si stringe, e in valore assoluto cresce come la radice della media: da due a cento la media si moltiplica per cinquanta e l’oscillazione per poco più di sette, che è la radice di cinquanta. È la regola dei conteggi che capitano ciascuno per conto proprio, e porta il nome di Poisson: prenderla al posto della curva a campana completa la ricetta.
Prezzo, sì o no, clienti: la stessa macchina con tre impostazioni, che cambiano solo come si legge il punteggio e con che regola si misura lo scarto. Anche il modo di imparare è uno solo: si guarda la differenza fra i clienti venuti e quelli attesi, e si spingono i pesi in quella direzione.
I modi di sbagliare sono due. Leggere il punteggio come un logaritmo è una scelta di chi costruisce il modello, e dice che gli effetti si moltiplicano: se in quella farmacia il sabato aggiunge davvero dodici clienti invece di raddoppiarli, la lettura è sbagliata, e i pesi che ne escono raccontano una storia che non c’è. Il secondo guaio morde più spesso, perché i conteggi veri sono quasi sempre più irregolari di quanto la regola prometta. Basta che i clienti arrivino a gruppetti, perché scende un autobus o è finita la messa, e l’oscillazione diventa il doppio di quella prevista. I pesi restano vicini al vero; la fiducia che il modello dichiara, invece, è troppa, e il farmacista che le crede prepara i turni su un’oscillazione che non esiste. La cura più leggera corregge la fiducia dichiarata e lascia i pesi dove sono; quella che cambia modello aggiunge un numero da stimare, che regola l’irregolarità separatamente dalla media, e si chiama binomiale negativa.
Un modello lineare generalizzato (GLM) si definisce con tre componenti [NW72]: una distribuzione per \(y \mid \mathbf{x}\) scelta nella famiglia esponenziale; un predittore lineare \(\eta = \mathbf{w}^\top\mathbf{x} + b\); e una funzione di legame \(g\) che li unisce, con \(g(\mu) = \eta\) e \(\mu = \mathbb{E}[y \mid \mathbf{x}]\).
La famiglia esponenziale in forma canonica raccoglie le densità
dove \(h\) dipende dalla sola \(y\) (la misura di base: vale \(1\) per la Bernoulli, \(1/y!\) per la Poisson), \(\theta\) è il parametro naturale (una lettera che qui non indica i parametri del modello, che restano \(\mathbf{w}\) e \(b\)) e \(A(\theta) = \log\int h(y)e^{\theta y}\,dy\) è la log-partizione, cioè il logaritmo di ciò che serve a far tornare l’integrale a uno, e che dipende da \(\theta\). Da \(A\) discende tutto, derivando sotto il segno di integrale (lecito all’interno dell’insieme dei \(\theta\) per cui quell’integrale converge):
Tre casi bastano qui. La gaussiana a varianza unitaria ha \(\theta = \mu\) e \(A(\theta) = \theta^2/2\), quindi media \(\theta\) e varianza \(1\); con una varianza nota diversa da uno servono \(\theta = \mu/\sigma^2\) e \(A(\theta) = \sigma^2\theta^2/2\), oppure la forma con un parametro di dispersione a parte. La Bernoulli ha \(\theta = \log\frac{\mu}{1-\mu}\) (il logit) e \(A(\theta) = \log(1+e^{\theta})\), quindi \(A'(\theta) = \sigma(\theta)\): la sigmoide, dunque, è la derivata della log-partizione. La distribuzione di Poisson, che descrive un conteggio di eventi indipendenti in una finestra fissa con \(P(y=k) = e^{-\mu}\mu^k/k!\), ha \(\theta = \log\mu\) e \(A(\theta) = e^{\theta}\), da cui \(A'(\theta) = A''(\theta) = \mu\): media e varianza coincidono, e quindi l’ampiezza tipica dell’oscillazione va come \(\sqrt{\mu}\).
Il legame canonico è quello che pone \(\theta = \eta\), cioè \(g = (A')^{-1}\): identità per la gaussiana, logit per la Bernoulli, logaritmo per la Poisson. Con quella scelta, e assumendo le \(y_i\) indipendenti date le \(\mathbf{x}_i\), la log-verosimiglianza di \(m\) osservazioni è
perché \(A'(\eta_i) = \mu_i\). Il gradiente ha la stessa forma per tutti e tre i modelli: residuo per feature, sommato sugli esempi. All’ottimo si annulla, cioè i residui risultano ortogonali a ogni colonna; e derivando rispetto a \(b\) si ottiene \(\sum_i (y_i - \mu_i) = 0\), cioè la loro somma nulla (senza intercetta quella condizione non c’è). È la stessa condizione del primo ordine dei minimi quadrati vista nella sezione su ortogonalità e proiezioni, ma non la stessa geometria, perché \(\mu_i = A'(\eta_i)\) non appartiene allo span delle colonne e non c’è nessun teorema di Pitagora da invocare.
Due garanzie discendono da \(A''>0\). La log-verosimiglianza è concava in
\(\mathbf{w}\), quindi non ci sono ottimi locali e il massimo, quando esiste,
è unico a meno di colonne collineari: che esista non è garantito, ed è di nuovo
il caso della separazione perfetta appena visto per la logistica. E l’hessiana
\(-\sum_i A''(\eta_i)\mathbf{x}_i\mathbf{x}_i^\top\) si scrive come una matrice
di pesi, il che rende il passo di Newton una regressione ai minimi quadrati
pesata, rifatta a ogni iterazione: è l’algoritmo IRLS del lavoro del 1972, che
ancora oggi gira in glm() di R e in statsmodels, mentre scikit-learn
preferisce un ottimizzatore generico.
I punti di rottura sono tre. Il legame è un’ipotesi di modello e non un fatto: con il logaritmo gli effetti sono moltiplicativi, e un fenomeno additivo va modellato con il legame identità e distribuzione di Poisson, che è legittimo ma non canonico. L’esposizione: se le finestre di osservazione hanno durate diverse \(t_i\), i conteggi non sono confrontabili, e si aggiunge un offset \(\log t_i\) al predittore lineare, cioè un termine con coefficiente fissato a uno. E soprattutto la sovradispersione: la Poisson impone \(\operatorname{Var} = \mu\), e i conteggi reali quasi sempre oscillano di più, perché gli eventi si raggruppano o perché resta eterogeneità non osservata. Purché la media sia specificata bene (legame e predittore giusti) i coefficienti restano consistenti, e a uscire sbagliati sono gli errori standard, troppo piccoli di un fattore \(\sqrt{\hat\phi}\), con \(\hat\phi\) la dispersione stimata. Il rimedio più diretto è quindi correggere quelli, per quasi-verosimiglianza o con uno stimatore sandwich, senza toccare le stime; il rimedio che cambia modello è la binomiale negativa, che aggiunge un parametro di dispersione (e a dispersione libera non è più un GLM nel senso appena definito). Torna come distribuzione di uscita di una rete nella sezione sul forecasting neurale.
I due difetti della retta sui conteggi si vedono in un blocco solo, insieme al modo in cui leggere il punteggio come logaritmo (il legame logaritmico) li ripara, e al limite che resta dopo.
import numpy as np
from sklearn.linear_model import LinearRegression, PoissonRegressor

rng = np.random.default_rng(0)
n_giorni = 2000
# l'indice di stagione: zero d'estate, due al picco influenzale
stagione = rng.uniform(0, 2, n_giorni)
log_media = 0.4 + 1.5 * stagione         # gli effetti si moltiplicano
clienti = rng.poisson(np.exp(log_media))  # un conteggio, mai negativo
X = stagione.reshape(-1, 1)

# 1. la retta: prevede clienti negativi, e gli scarti si aprono a ventaglio
retta = LinearRegression().fit(X, clienti)
print(f"retta:  {retta.intercept_:.4f} + {retta.coef_[0]:.4f} * stagione")
negative = (retta.predict(X) < 0).sum()
print(f"        {negative} previsioni negative su {n_giorni}")
scarti = clienti - retta.predict(X)
for lo, hi in ((0.0, 0.5), (0.75, 1.25), (1.5, 2.0)):
    m = (stagione >= lo) & (stagione < hi)
    print(f"        stagione {lo}-{hi}: scarto tipico {scarti[m].std():.2f}")

# 2. lo stesso punteggio, letto come logaritmo della media
glm = PoissonRegressor(alpha=0.0, max_iter=10000, tol=1e-10).fit(X, clienti)
media = glm.predict(X)
print(f"legame log:  {glm.intercept_:.4f} + {glm.coef_[0]:.4f} * stagione")
print(f"        un punto di stagione moltiplica per"
      f" {np.exp(glm.coef_[0]):.4f}")
print(f"        scarti sommati, e per colonna: "
      f"{np.round([(clienti - media).sum(), stagione @ (clienti - media)], 3)}"
      f"  su {clienti.sum()} clienti")

# 3. il limite: conteggi piu' irregolari di quanto Poisson ammetta
dispersione = lambda y, mu: float((((y - mu) / np.sqrt(mu)) ** 2).mean())
print(f"dispersione sui dati di Poisson:  {dispersione(clienti, media):.4f}")

sovra = rng.negative_binomial(3, 3 / (3 + np.exp(log_media)))
g2 = PoissonRegressor(alpha=0.0, max_iter=10000, tol=1e-10).fit(X, sovra)
m2 = g2.predict(X)
d = dispersione(sovra, m2)
print(f"su conteggi sovradispersi:  {g2.intercept_:.4f}"
      f" + {g2.coef_[0]:.4f} * stagione")
print(f"        dispersione {d:.4f}, radice {np.sqrt(d):.4f}")
retta:  -3.0126 + 12.5509 * stagione
        247 previsioni negative su 2000
        stagione 0.0-0.5: scarto tipico 2.06
        stagione 0.75-1.25: scarto tipico 2.57
        stagione 1.5-2.0: scarto tipico 5.92
legame log:  0.3784 + 1.5158 * stagione
        un punto di stagione moltiplica per 4.5531
        scarti sommati, e per colonna: [-0. -0.]  su 19022 clienti
dispersione sui dati di Poisson:  1.0224
su conteggi sovradispersi:  0.4086 + 1.4990 * stagione
        dispersione 3.8411, radice 1.9599
La retta prevede \(-3{,}01\) clienti quando l’indice di stagione vale zero, cioè d’estate, e finisce sotto zero in \(247\) giornate su duemila; i suoi scarti tipici passano da \(2{,}06\) a \(5{,}92\) attraversando l’intervallo, che è il ventaglio annunciato. Il modello che legge il punteggio come logaritmo ritrova invece i due numeri con cui i dati erano stati inventati, \(0{,}4\) e \(1{,}5\), e il suo peso si legge come moltiplicatore: un punto in più di stagione moltiplica i clienti per \(4{,}55\). La riga sugli scarti è un controllo: moltiplicandoli per ciascuna colonna e sommandoli si ottiene zero al millesimo su quasi ventimila clienti, cioè quello che il modello non è riuscito a spiegare non ha più niente in comune con le colonne che ha usato. Se ne avesse ancora, quei pesi si potrebbero migliorare: è la stessa condizione che il conto diretto della retta risolve in un colpo solo.
Le ultime due righe sono il limite, e il conto è questo: si prende ogni scarto, lo si divide per la radice del numero atteso, e si guarda quanto quei rapporti si sparpagliano. Se l’oscillazione cresce davvero come la radice della media, come Poisson promette, quel valore deve venire circa uno, e sui dati generati da una Poisson viene \(1{,}0224\). Rifacendo tutto su conteggi generati con la versione a due parametri, la binomiale negativa, i pesi restano quelli (\(0{,}4086\) e \(1{,}499\)) ma lo stesso valore sale a \(3{,}84\). Il numero che conta per chi deve decidere è la sua radice, \(1{,}96\), perché la dispersione misura le varianze e le oscillazioni si leggono nella loro radice: le oscillazioni vere sono quasi il doppio di quelle che il modello annuncia, e il farmacista che gli crede prepara i turni per un sabato tranquillo che non arriverà.
k-NN: chiedi ai vicini#
Non tutti i modelli imparano dei parametri. Alcuni memorizzano gli esempi, e il più semplice è il k-NN (dall’inglese k-nearest neighbors, i \(k\) vicini più prossimi): davanti a un caso nuovo cerca fra gli esempi visti i \(k\) più simili e li fa votare. Il numero \(k\) di vicini da interpellare è un iperparametro, e va fissato prima di cominciare.

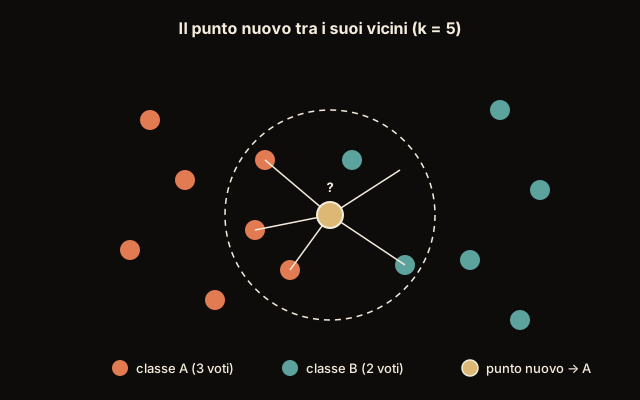
Fig. 4.7 Nessun addestramento, solo un conteggio. La classe del punto nuovo è quella che vince fra i suoi \(k\) vicini, e cambiare \(k\) può cambiare il verdetto: con cinque vicini vince la classe di sinistra, tre voti a due, ma il vicino più prossimo di tutti è dell’altra, e con un vicino solo la risposta si ribalta.#
Il cerchio disegnato in Fig. 4.7 è il parametro principale del metodo: allargandolo si interpellano vicini via via più lontani, e la risposta diventa più stabile (pochi voti anomali non la ribaltano) ma più grossolana, perché smette di seguire le variazioni locali. Con \(k=1\) il modello ripete il vicino più prossimo, rumore compreso. Il rumore è la parte della risposta che le caratteristiche non spiegano: l’errore di chi ha misurato, la casa venduta a poco perché il proprietario aveva fretta, la giornata storta, cose successe davvero che non si ripeteranno. Con \(k\) pari al numero di esempi, all’estremo opposto, votano tutti e il modello risponde sempre la stessa cosa: la classe più frequente, o in regressione la media di tutti gli \(y\).
Per classificare una casa nuova si cercano le \(k\) case più simili fra quelle che già si conoscono, e le si lascia votare. Se i \(5\) vicini più prossimi stanno per lo più in «quartiere costoso», ci starà anche lei. Se la domanda invece è un prezzo, al posto del voto si fa la media dei prezzi di quei \(5\), che è la stessa mossa con una risposta di tipo diverso.
Non c’è addestramento vero e proprio: il modello tiene in memoria tutti gli esempi e decide solo al momento della domanda. Per questo si dice non parametrico: non riassume i dati in pochi numeri, li usa tutti. Il lavoro non sparisce, si sposta. Ogni volta che arriva una casa nuova bisogna confrontarla con tutte quelle in archivio, e ogni confronto va fatto colonna per colonna. Con centomila case e venti colonne sono due milioni di operazioni per una sola risposta, da rifare da capo alla domanda successiva.
E «simili» va deciso con attenzione, perché la somiglianza si calcola sommando gli scarti di tutte le colonne, e le colonne non hanno la stessa taglia. Una casa da \(100\) m² con tre stanze, e due case che si contendono il posto di vicina. La prima ha \(108\) m² e una stanza sola, la seconda \(115\) m² e tre stanze. Sommando gli scarti così come sono, la prima dista \(8 + 2 = 10\) (otto metri quadri e due stanze), la seconda \(15 + 0 = 15\), e vince la prima: il numero di stanze non conta quasi niente, perché la superficie si muove fra \(40\) e \(200\) mentre le stanze stanno fra \(1\) e \(5\). Rimettendo le due colonne sulla stessa taglia, cioè contando ogni scarto in rapporto all’intervallo che la sua colonna copre, la prima dista \(8/160 + 2/4 = 0{,}55\) e la seconda \(15/160 \approx 0{,}09\), e l’ordine si rovescia, e la vicina diventa la seconda, quella con lo stesso numero di stanze. Chi fa votare i vicini senza questa precauzione lascia decidere tutto alla colonna con i numeri più grandi.
Dato un punto \(\mathbf{x}\), si ordinano gli esempi di addestramento per distanza, tipicamente euclidea, \(\lVert \mathbf{x} - \mathbf{x}^{(i)}\rVert_2\), e si prendono i \(k\) più vicini. In classificazione si assegna la classe di maggioranza; in regressione si fa la media dei loro \(y^{(i)}\). Non esiste una fase di ottimizzazione: il costo si sposta interamente sulla previsione, ed è \(O(mn)\) per query nella versione ingenua: \(m\) distanze, ciascuna da \(n\) operazioni, una per colonna. Quel fattore \(n\) conta due volte, perché il numero di colonne pesa sul costo e decide anche se il metodo funziona, e la sezione su riduzione e clustering lo mette al centro. Con \(m\to\infty\) e dimensione fissata, l’errore del 1-NN tende a un valore non superiore a \(2R^\star(1-R^\star)\) per due classi, dove \(R^\star\) è l’errore di Bayes [CH67], e il \(k\)-NN è consistente se \(k\to\infty\) e \(k/m\to 0\) [Sto77]: converge all’ottimo senza assumere una famiglia di funzioni, a prezzo di una velocità che peggiora con la dimensione dei dati. Il valore di \(k\) regola il compromesso: \(k\) piccolo segue il rumore, \(k\) grande liscia troppo. La distanza euclidea, inoltre, impone di normalizzare le feature, altrimenti quella con la scala più ampia domina il conto.
Due raffinamenti sono già in scikit-learn. Il voto pesato
(weights="distance") fa contare di più i vicini più prossimi invece di dare
a tutti e \(k\) lo stesso peso. Le strutture di indicizzazione (KD-tree,
ball-tree) partizionano lo spazio in anticipo e abbattono il numero di distanze
da calcolare, da \(m\) a circa \(\log m\). Proprio quegli indici, però, smettono di
essere utili oltre poche decine di dimensioni, dove le distanze fra i punti si
assomigliano tutte e il partizionamento non riesce più a escludere nessuna
regione.
Avvertimento
k-NN ha un nemico naturale: le troppe dimensioni. Tutto il metodo poggia sull’idea che «vicino» voglia dire «simile». Ricordando che ogni colonna della tabella è una direzione e ogni esempio un punto, «tante dimensioni» vuol dire semplicemente «tante colonne»: cento misure per ogni paziente, mille parole contate per ogni email. Lassù quell’idea si sgretola, e la ragione si capisce coi dadi.
La distanza fra due punti si ottiene sommando gli scarti su tutte le colonne. Con una colonna sola quella somma ha un addendo, e due esempi possono essere identici o lontanissimi: il caso decide tutto. Con mille colonne gli addendi sono mille, e succede quello che succede lanciando mille dadi: il totale cade quasi sempre attorno a \(3\,500\), perché i lanci alti e quelli bassi si compensano a vicenda, e vedere mille sei di fila non capita mai. Allo stesso modo, due esempi qualsiasi saranno un po’ diversi su certe colonne e un po’ simili su altre, e la somma finisce quasi sempre attorno allo stesso valore. Le distanze fra tutte le coppie si assomigliano, e lo scarto fra il vicino più prossimo e il più lontano diventa trascurabile rispetto alle distanze stesse. È come chiedere a qualcuno di indicare il migliore amico in una folla dove tutti stanno esattamente alla stessa distanza: la domanda perde senso, e il voto dei \(k\) vicini diventa un voto casuale.
Per questo il k-NN sulle colonne grezze regge quando i dati occupano in realtà uno spazio di dimensione molto minore di quella nominale (con le \(64\) colonne delle cifre manoscritte arriva al \(96\%\) di risposte esatte), e soffre quando le colonne sono molte e quasi indipendenti fra loro: in quel caso si riducono le colonne, tenendo quelle che servono o riassumendole in poche. Il fenomeno, con i conti, è la maledizione della dimensionalità, ed è il punto di partenza della sezione su riduzione e clustering.
Le cifre manoscritte che scikit-learn distribuisce sono immagini di \(8\times 8\) pixel, cioè \(64\) colonne, ma i pixel vicini si muovono insieme e i dati occupano uno spazio di dimensione molto minore: il k-NN con cinque vicini, provato su immagini tenute da parte (a turno, un quinto alla volta), le riconosce quasi tutte.
from sklearn.datasets import load_digits
from sklearn.model_selection import cross_val_score
from sklearn.neighbors import KNeighborsClassifier

X_cifre, y_cifre = load_digits(return_X_y=True)     # 1797 immagini, 64 colonne
print(cross_val_score(KNeighborsClassifier(5), X_cifre, y_cifre, cv=5)
      .mean().round(3))
0.963
Un’ombra all’orizzonte: l’overfitting#
Un modello abbastanza flessibile (capace di adattarsi a forme arbitrarie: una curva contorta lo è, una retta no) può adattarsi agli esempi di addestramento, rumore compreso, e poi sbagliare su dati nuovi. È l’overfitting, il problema centrale del machine learning applicato, e si scopre solo misurando l’errore su dati che il modello non ha usato per imparare. La sezione su overfitting e validazione lo tratta per intero, insieme al modo di tenere da parte i dati con cui giudicare.
In pratica, con scikit-learn#
In Python la retta, la logistica e il k-NN sono tre righe, con la stessa
interfaccia fit/predict:
from sklearn.linear_model import LinearRegression, LogisticRegression
from sklearn.neighbors import KNeighborsClassifier

# Regressione: prevede un valore continuo (es. il prezzo)
reg = LinearRegression().fit(X_train, y_prezzo)
prezzo_stimato = reg.predict(X_nuovo)

# Classificazione lineare: prevede una probabilità, poi una classe
clf = LogisticRegression().fit(X_train, y_spam)      # y_spam vale 0 oppure 1
# predict_proba dà due colonne, la probabilità del no e quella del sì:
# [:, 1] vuol dire «tieni la seconda», cioè quanto è probabile lo spam
prob_spam = clf.predict_proba(X_nuovo)[:, 1]

# k-NN: niente da stimare, "vota" con i 5 vicini più simili
knn = KNeighborsClassifier(n_neighbors=5).fit(X_train, y_spam)
etichetta = knn.predict(X_nuovo)
fit per imparare e predict per rispondere: l’interfaccia è la stessa per
quasi tutti i modelli di scikit-learn.
Da ricordare
Supervisionato vuol dire imparare da esempi che portano già con sé la risposta giusta: tante coppie (descrizione, risposta), e una regola da trovare che leghi le une alle altre.
Non tutte le colonne sono dello stesso tipo: su alcune i numeri sono numeri veri, su altre sono nomi senza ordine (Milano, Roma) e su altre ancora sono una fila di gradini di cui non si sa la distanza. Quale sia quale non lo decide il modello, lo decide chi prepara i dati: dare \(1\) a Milano e \(2\) a Roma vuol dire dirgli che Roma è il doppio e che a metà strada c’è qualcosa; il rimedio è una colonna sì/no per ogni valore.
Ogni colonna della tabella è una direzione, ogni riga un punto in quello spazio. Con due colonne il disegno sta su un foglio; con cento no, ma i conti sono gli stessi, e «vicini» continua a voler dire «simili».
La regola si cerca dentro un catalogo scelto prima: troppo povero, la regola buona non c’è; troppo ricco, se ne prende una che azzecca gli esempi per coincidenza.
Se la risposta è un numero si cerca una retta che passi in mezzo ai punti; se è un sì o no si cerca una linea che li separi, dopo aver trasformato il punteggio in una probabilità e aver scelto dove tagliare. Con più di due risposte la ricetta è la stessa: \(e\) elevato a ciascun punteggio, diviso per la somma di tutti.
E se la risposta è un conteggio («quante volte») non va bene nessuna delle due: il punteggio si legge come il logaritmo del numero atteso, così la previsione non può venire negativa e i pesi moltiplicano invece di sommare. Le tre risposte sono la stessa macchina con tre impostazioni. Attenzione però ai conteggi veri, che quasi sempre oscillano più di quanto quel modello ammetta: i pesi restano giusti, la fiducia dichiarata no.
La retta buona si può trovare con un conto diretto, che però con moltissime colonne (o troppi dati per la memoria) costa più della passeggiata: allora si parte da una qualsiasi e la si sposta a piccoli passi nella direzione in cui l’errore cala (la discesa del gradiente), decidendo quanto lunghi sono i passi.
LogisticRegression()di scikit-learn aggiunge di suo un freno sui pesi: il modello che gira non è quello della definizione, e senza freno, con dati separabili, i pesi crescono senza fine.Il k-NN non impara niente: tiene in memoria tutti gli esempi e, alla domanda, fa votare i \(k\) più simili. Semplicissimo, ma tende a soffrire quando le colonne sono moltissime e quasi indipendenti fra loro, perché allora i punti sono quasi tutti alla stessa distanza.
L’insidia di tutto il capitolo è imparare a memoria invece che capire (l’overfitting): è la prossima sezione.
Da ricordare
Supervisionato significa imparare \(f:\mathcal{X}\to\mathcal{Y}\) da esempi già etichettati, minimizzando una loss \(\mathcal{L}\) su \(m\) coppie \((\mathbf{x}^{(i)}, y^{(i)})\).
La minimizzazione corre su uno spazio delle ipotesi \(\mathcal{H}\) fissato prima dei dati: un \(\mathcal{H}\) povero lascia un errore di approssimazione che i dati non tolgono, uno ricco un errore di stima, che con alta probabilità è \(O\big(\sqrt{\log\lvert\mathcal{H}\rvert/m}\big)\) per \(\mathcal{H}\) finita e perdita limitata.
Regressione = uscita continua (MSE, retta di best fit); classificazione = uscita discreta (sigmoide, confine di decisione \(\mathbf{w}^\top\mathbf{x}+b=0\); con \(K\) classi softmax, cioè logistica multinomiale, duale della massima entropia condizionata quando la verosimiglianza ha un massimo).
I modelli lineari generalizzati [NW72] mettono i due casi (e la Poisson per i conteggi) sotto un solo impianto: distribuzione nella famiglia esponenziale, predittore lineare \(\eta=\mathbf{w}^\top\mathbf{x}+b\), legame \(g(\mu)=\eta\). Con il legame canonico \(g=(A')^{-1}\) la log-verosimiglianza è concava e il gradiente vale \(\sum_i (y_i-\mu_i)\mathbf{x}_i\) per tutti e tre, da cui l’IRLS. La Poisson impone \(\operatorname{Var}=\mu\): contro la sovradispersione, binomiale negativa.
Il tipo di ogni colonna (numerica, categorica, ordinale) è una decisione di chi prepara i dati: una categorica codificata come intero acquista un ordine e delle distanze che nessuno intendeva metterci.
k-NN è non parametrico: non stima parametri, ricorda i dati e li fa votare. Costo \(O(mn)\) per query (\(m\) distanze da \(n\) coordinate ciascuna), che gli indici spaziali (KD-tree, ball-tree) portano a circa \(O(n\log m)\) sotto le poche decine di dimensioni; sopra, se le coordinate variano in modo quasi indipendente, la concentrazione delle distanze affossa gli indici e il metodo insieme.
Attenzione all’overfitting: imparare a memoria non è capire. Ne parliamo nella sezione dedicata.