


PyTorch: costruire reti in pratica#
C’è stato un periodo, tra il 2011 e il 2016, in cui per fare deep learning all’avanguardia conveniva imparare Lua, un linguaggio di scripting nato in Brasile e famoso soprattutto per gli addon di World of Warcraft. Il motivo si chiamava Torch, una libreria di calcolo scientifico potente e veloce. La usavano il gruppo di Yann LeCun alla New York University e i primi anni di DeepMind, e la si comandava appunto da Lua. Nel 2016, nei laboratori di Facebook AI Research (oggi Meta AI), un piccolo gruppo (tra cui lo stagista Adam Paszke, Sam Gross e Soumith Chintala) decise di rifare da zero l’interfaccia, cioè la parte con cui il programma parla alla libreria. La riscrisse in Python, tenendo all’inizio il motore di calcolo in C su cui Torch già girava. Il risultato, uscito in versione di prova a inizio 2017, si chiama PyTorch [PGM+19]. In pochi anni è diventato lo strumento standard della ricerca mondiale sull’intelligenza artificiale: la grande maggioranza dei modelli pubblicati su Hugging Face (il grande archivio pubblico dove la comunità condivide i propri modelli) e degli articoli di ricerca recenti è scritta così.
In PyTorch era scritto anche il ciclo di cinque righe mostrato nella sezione sulla backpropagation, e da quelle righe si riparte: prima la riga che calcola da sola il giro all’indietro, poi i pezzi del ciclo uno alla volta, fino a rimontarlo intero e farlo girare sulle stesse cifre scritte a mano.
La filosofia: il grafo si costruisce mentre giri#
La scelta di fondo di PyTorch riguarda quando i conti vengono eseguiti. I conti si fanno sui tensori, cioè su array di numeri a più dimensioni, che la sezione che porta il loro nome presenta per esteso. Il grafo del titolo è il grafo computazionale: le operazioni collegate da frecce, dove ogni freccia dice quale risultato entra in quale operazione successiva (in gergo, un grafo orientato senza cicli). È la struttura su cui si calcoleranno le derivate, e la domanda è se vada dichiarata tutta prima di eseguire qualcosa o se possa nascere mentre il programma gira.
Due modi di seguire un percorso in auto. Il primo: stampi l’itinerario completo prima di partire e lo esegui alla lettera; se una strada è chiusa, devi tornare a casa e ristampare tutto. Il secondo: usi il navigatore, che ricalcola strada facendo e a ogni incrocio sa dove sei. I primi framework di deep learning (un framework è una libreria abbastanza grande da dettare anche il modo in cui si scrive il programma, non solo da offrire funzioni pronte) funzionavano nel primo modo: prima descrivevi tutta la rete, cioè scrivevi tutto il grafo, poi la consegnavi al motore ed eseguivi, e se qualcosa andava storto capirlo era un’impresa. PyTorch funziona come il navigatore: ogni riga di codice viene eseguita subito, puoi fermarti a guardare i numeri in qualunque punto, e correggere è facile come in qualsiasi programma Python.
Col navigatore acceso il viaggio cambia forma mentre lo fai. Piove, e prendi la statale. Il traffico è fermo, ed esci un’uscita prima. Le commissioni oggi sono tre invece di una, e il giro si allunga di conseguenza. Le decisioni si prendono all’incrocio, con quello che si vede da lì, e un modello scritto in PyTorch decide allo stesso modo: una riga che dice «se il valore è negativo, prendi l’altra strada», un giro di calcoli che si ripete due volte oggi e sette domani perché la frase da leggere è più lunga. Con l’itinerario stampato, quel giro andava previsto tutto in anticipo, sul foglio.
Quella comodità si paga. Chi tiene in mano il foglio conosce tutto il tragitto prima di muoversi, e se lo può studiare a tavolino: accorpare due commissioni che stanno nella stessa via, tagliare il giro largo, fare benzina nell’unico punto in cui costa meno. Il navigatore quella vista d’insieme non ce l’ha, perché decide un incrocio alla volta, e per anni i programmi scritti così hanno girato un po’ più lenti di quelli descritti tutti in anticipo. Poi i navigatori hanno imparato il mestiere: quando si accorgono che il tragitto è sempre quello, se lo studiano una volta sola e da lì in avanti lo percorrono di filato; dove la strada non si lascia prevedere tornano a decidere incrocio per incrocio, e se il tragitto cambia se lo ristudiano. PyTorch lo fa dal 2023, e il ritardo si recupera in parte, tanto più quanto più il viaggio è lungo e sempre uguale: su un tragitto breve, studiarselo può costare più di quanto fa risparmiare.
È il paradigma define-by-run (reso popolare dal framework giapponese
Chainer nel 2015): il grafo delle operazioni non viene dichiarato in anticipo
ma costruito dinamicamente durante l’esecuzione, registrando le operazioni
man mano che avvengono. Il contrario del define-and-run di TensorFlow 1.x,
dove si compilava un grafo statico da eseguire in una Session. Le
conseguenze pratiche: il control flow è normale Python (if, for,
ricorsione) anche dentro il modello; il debugging usa gli strumenti ordinari
(print, pdb); reti a struttura variabile (sequenze di lunghezza diversa,
alberi) si scrivono in modo naturale. Il costo storico era la minore
ottimizzazione rispetto a un grafo compilato; da PyTorch 2.0 (2023)
torch.compile ne recupera una parte: cattura dal bytecode Python i tratti di
grafo che riesce a tracciare, li compila just-in-time in kernel fusi e torna
all’esecuzione ordinaria dove non ci riesce (un graph break), ricompilando
quando cambiano le forme dei tensori o il ramo preso. Il codice non va
riscritto; quanto si guadagna dipende dal modello, e su quelli piccoli può
essere negativo. TensorFlow stesso, con la
versione 2.0 del 2019, è passato all’esecuzione eager di default: su questo
punto la storia ha dato ragione a PyTorch.
Perché ha vinto nella ricerca#
Nel 2017 il posto di PyTorch era già occupato. Lo teneva TensorFlow [ABC+16], la libreria di Google, uscita nel 2015 e allora la più usata: era lei lo strumento con cui si faceva deep learning, e PyTorch era l’ultimo arrivato. Cinque anni dopo i rapporti si erano invertiti, almeno nei laboratori, dove ormai la maggior parte degli articoli scientifici dichiara di aver usato PyTorch.
La ragione sta nel modo in cui lavora la ricerca: si scrive un’idea, quasi
sempre sbagliata, la si esegue, si guardano i valori intermedi e si cambia.
Serve uno strumento che si lasci aprire e guardare dentro mentre gira. Con un
grafo dichiarato tutto in anticipo il programma si scrive in due lingue
insieme, Python e quella del grafo, e un errore si cerca con strumenti diversi
da quelli di Python; con il grafo costruito mentre il programma gira bastano un
print e il debugger di sempre. Attorno a questa comodità si è avviato un
circolo che si alimenta da sé: gli articoli pubblicano il loro codice in
PyTorch, chi vuole riprodurli usa PyTorch, e le librerie costruite sopra
(Hugging Face Transformers per i modelli di linguaggio, torchvision per le
immagini) nascono pensate prima di tutto per questo framework. Nel 2022 Meta ha
ceduto il progetto alla neonata PyTorch Foundation, dentro la Linux Foundation:
da progetto di un’azienda a progetto di una fondazione neutrale, che ne governa
lo sviluppo.
Non ha vinto ovunque: TensorFlow resta diffuso dove il modello non si studia più ma si usa per lavoro, dentro i sistemi di un’azienda o dentro un’app del telefono. E i concetti sono identici nei due mondi: imparato uno, l’altro si legge senza fatica.
Lo stack: Python sopra, C++ sotto#
La comodità di PyTorch potrebbe far pensare a uno strumento lento, visto che Python non è famoso per la velocità. Python però decide soltanto quali operazioni eseguire; a eseguirle è un motore di calcolo compilato, scritto in C++, che da lì le manda all’hardware disponibile (Fig. 7.1).

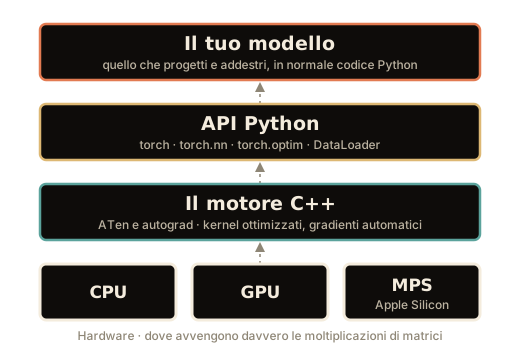
Fig. 7.1 Lo stack: il tuo modello è normale codice Python, ma ogni operazione scende nel motore di calcolo scritto in C++ e da lì sull’hardware disponibile.#
In un ristorante la sala (il menu, il cameriere che prende l’ordine) è Python: accogliente, flessibile, parla la tua lingua. La cucina è scritta in C++: quando ordini «moltiplica queste due matrici», il piatto lo preparano cuochi velocissimi, cioè routine di calcolo già compilate. Tu non entri mai in cucina: ordini in Python, e la velocità è quella della cucina.
La cucina tiene anche il registro delle comande, in ordine di arrivo. Serve a ripercorrere all’indietro tutto quello che è stato fatto, ed è il gesto su cui si regge l’apprendimento di una rete.
Le postazioni poi sono più d’una, e sullo stesso piatto non lavorano insieme. Il fornello di casa fa bene qualunque cosa, un piatto alla volta: è la CPU. La griglia grande sforna in una passata sola una montagna di piatti identici: è la scheda grafica. A decidere c’è il capocuoco, che guarda dove stanno già gli ingredienti di quell’ordine e manda lì la comanda, perché trascinare le casse da una postazione all’altra costa tempo. Se le casse sono alla griglia e l’ordine arriva al fornello, il piatto non parte proprio: prima qualcuno deve spostarle, e a dirglielo sei tu.
Che la velocità sia quella della cucina vale finché l’ordine è grosso. Chiedi un chicco di riso alla volta e la griglia resta ferma: il tempo se ne va tutto nel cameriere che fa avanti e indietro con foglietti da una riga. Per questo in PyTorch si lavora su blocchi interi di numeri, e non su un numero per volta.
L’API Python (torch, torch.nn, torch.optim, torch.utils.data) è un
guscio sottile sopra ATen, la libreria C++ dei tensori, e sopra il motore
autograd che registra le operazioni e calcola i gradienti. Un dispatcher
smista ogni operazione al kernel giusto per il dispositivo del tensore: BLAS e
simili su CPU; su GPU NVIDIA cuBLAS per le moltiplicazioni fra matrici e cuDNN
per convoluzioni e normalizzazioni; Metal Performance Shaders (MPS) su Apple
Silicon. Il dispatcher però non muove i dati: se un’operazione riceve tensori
su dispositivi diversi solleva un errore, e il trasferimento va comandato da
Python. Per il passaggio in produzione: torch.compile (fusione e compilazione
JIT dei kernel), l’esportazione in ONNX verso runtime esterni, ed ExecuTorch
per mobile ed embedded. La divisione del lavoro è netta: Python decide cosa
calcolare, il motore C++ decide come.
Il passaggio da Python al motore ha un costo fisso. Ogni operazione attraversa
il dispatcher prima di arrivare al kernel, e quel tragitto, dell’ordine dei
microsecondi, non dipende dalla dimensione dei tensori: su un tensore da
diecimila elementi è trascurabile, su diecimila operazioni da un elemento è
quasi tutto il tempo. Per questo si lavora su blocchi interi di numeri e non su
un numero per volta, e per questo torch.compile fonde in un solo kernel le
operazioni piccole in sequenza.
import time
import torch

x = torch.zeros(10_000)
t0 = time.perf_counter()
for i in range(len(x)):
    x[i] += 1                      # diecimila operazioni da un numero
t_ciclo = time.perf_counter() - t0
t0 = time.perf_counter()
x += 1                             # un'operazione da diecimila numeri
t_vettore = time.perf_counter() - t0
print(f"il ciclo costa {t_ciclo / t_vettore:.0f} volte l'operazione vettoriale")
Il rapporto stampato è un cronometro, e cambia da una macchina all’altra e da un’esecuzione all’altra, ma non scende sotto le migliaia.
Installazione e primo contatto#
Due parole prima del comando, perché compaiono subito e conviene averle. La
GPU è la scheda grafica, il chip nato per i videogiochi che si è rivelato
bravissimo a fare tanti conti identici tutti insieme; CUDA è il nome che
NVIDIA, che quelle schede le costruisce, dà al modo in cui i programmi le
parlano (per questo nel codice il dispositivo si chiamerà "cuda" e non
"gpu").
PyTorch si installa come qualunque pacchetto Python, cioè scrivendo una riga
nel terminale, la finestra in cui si danno comandi scritti al computer; sul
sito ufficiale (pytorch.org) un selettore genera la riga adatta al proprio
sistema operativo e alla propria scheda. Per gli esempi che seguono basta la
versione senza GPU:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu
I pacchetti sono due: torch è PyTorch, torchvision è la sua cassetta di
attrezzi per le immagini (dataset pronti, trasformazioni, modelli
pre-addestrati), e serve dalla sezione sull’addestramento in poi.
L’indirizzo in coda conviene non saltarlo. Su Linux il pacchetto che pip
(il programma che scarica e installa le librerie di Python) prende di sua
iniziativa si porta dentro le librerie CUDA: qualche gigabyte che su una
macchina senza scheda grafica non serve a niente, e che paghi in banda e in
disco senza accorgertene. Su Windows e su macOS il pacchetto predefinito non
si porta dietro le librerie CUDA (quello per macOS ha invece il supporto alla
scheda grafica dei Mac con chip Apple), e la riga si accorcia a
pip install torch torchvision.
Ed ecco il primo contatto, un assaggio delle due cose che vedremo nelle prossime sezioni: i tensori e i gradienti automatici.
import torch

print(torch.__version__)          # versione installata
print(torch.cuda.is_available())  # True con una GPU NVIDIA o AMD utilizzabile

x = torch.tensor(3.0, requires_grad=True)  # un tensore "osservato"
y = x**2 + 2*x                             # y = x² + 2x, calcolato subito
y.backward()                               # gradiente automatico
print(x.grad)                              # la derivata di y in x=3 -> tensor(8.)
Niente da dichiarare in anticipo e niente da preparare prima di partire: si
scrivono i conti come si scriverebbero su un foglio, e la derivata esce da
sola. La derivata misura quanto cambia il risultato quando l’ingresso si
sposta di poco. Qui vale \(8\), e \(8\) vuol dire questo: spostando \(x\) da \(3\) a
\(3{,}01\), cioè di un centesimo, \(y\) passa da \(15\) a \(15{,}0801\), e cresce di
circa otto centesimi, otto volte lo spostamento. Quel numero, nel mestiere, si
chiama gradiente, ed è quello che la riga y.backward() calcola e che PyTorch
deposita in x.grad: è il giro all’indietro che la sezione sulla
backpropagation lasciava a una libreria, fatto in una riga. Le regole di
derivazione della sezione su analisi e ottimizzazione danno lo stesso numero: la derivata di
\(x^2 + 2x\) è \(2x + 2\), che in \(x = 3\) vale appunto \(8\). In miniatura, è il
meccanismo che addestra ogni rete neurale.
Gli attrezzi e il mestiere#
Il percorso ha due parti.
La prima mette in mano gli attrezzi, e sono tre. I tensori, gli array di numeri su cui tutto si appoggia, insieme al meccanismo che calcola le derivate da solo. I moduli, cioè come si mette insieme un modello pezzo per pezzo, e come si misura quanto sbaglia. L’addestramento, cioè il giro di cinque mosse che in PyTorch si scrive a mano invece di chiederlo a un comando, e che qui si vede all’opera su un problema vero: leggere cifre scritte a mano.
La seconda insegna a usarli su un problema che non è un esercizio. Il flusso
di lavoro, cioè l’ordine delle mosse che si ripete in ogni progetto e il
ciclo con cui un modello si migliora. I dati su misura: come si porta
dentro la rete una cartella di file propri, con Dataset, DataLoader e
trasformazioni. I tre errori più comuni (forma, tipo, dispositivo), che sono
fra le cause più frequenti di blocco per chi comincia. Il passaggio dal
notebook agli script, quando un esperimento va reso ripetibile. E infine
replicare un paper, cioè un articolo scientifico: il metodo per
trasformare quattro equazioni in codice che gira. Chiude il capitolo una
sezione sulle prestazioni, per quando il modello funziona ma è troppo
lento.
Alla fine si sa leggere, e scrivere, un programma di addestramento completo (dati, modello, loss, ottimizzatore, valutazione, salvataggio), che è l’ossatura anche del codice con cui si fa ricerca in deep learning.
Se vuoi lo stesso percorso in forma di corso
Qui si spiega come funziona; per esercitarsi con i notebook alla mano, il corso gratuito Learn PyTorch for Deep Learning di Daniel Bourke copre lo stesso terreno in inglese, con codice eseguibile e video. È una buona palestra parallela.
Un ripasso, prima di aprire la scatola dei tensori.
Da ricordare
PyTorch nasce nel 2016 nei laboratori di Facebook (oggi Meta) come versione in Python di un vecchio strumento chiamato Torch, che si usava con un altro linguaggio; oggi non appartiene più a un’azienda sola.
Ogni riga viene eseguita subito, come su una calcolatrice: puoi fermarti a guardare i numeri in qualunque punto, e correggere un errore è come correggerlo in un normale programma Python.
Python è la sala del ristorante; la cucina è scritta in un linguaggio più veloce e sta sotto, invisibile. Tu ordini in Python, la velocità è quella della cucina, ma solo se l’ordine è grosso: un chicco di riso alla volta e il tempo se ne va tutto nel portare le comande.
È lo strumento con cui oggi si fa la maggior parte della ricerca. Non è l’unico: imparato questo, gli altri si leggono senza fatica, perché le idee (numeri in scatole, strati, gradienti) sono le stesse.
Da ricordare
PyTorch nasce nel 2016 a Facebook AI Research (oggi Meta AI) come interfaccia Python del vecchio motore Torch (Lua); beta pubblica a inizio 2017, dal 2022 governato dalla PyTorch Foundation.
Filosofia define-by-run: ogni operazione è eseguita subito e il grafo dei calcoli si costruisce dinamicamente; debugging e control flow sono normale Python.
Python è la superficie: sotto lavorano ATen e autograd in C++, con kernel dedicati per CPU, GPU (CUDA) e Apple Silicon (MPS). Ogni operazione paga un costo fisso di invio, quindi si lavora su blocchi di numeri;
torch.compile(PyTorch 2.0) aggiunge la compilazione JIT.È lo standard de facto della ricerca; TensorFlow resta un onesto vicino di casa, e i concetti si trasferiscono senza attrito.