


Validare e rappresentare: backtesting e feature temporali#
Un analista quantitativo mostra il grafico di un suo modello: rendimento annuo del 40%, curva che sale liscia come una pista da sci. Lo mette a lavorare sui soldi veri e nel giro di un mese è in rosso. Cos’è successo? Ricostruendo il codice, si scopre che tra le variabili in ingresso ce n’era una calcolata sulla media dell’intero periodo: futuro compreso. Il modello, in fase di prova, «sapeva» dove sarebbe andato il prezzo. Sul passato era un veggente; sul futuro, un ciarlatano.
Questo errore ha già un nome: è il data leakage della sezione su overfitting e validazione, la fuga di informazione dai dati su cui il modello sarà giudicato verso quelli su cui impara. Qui la fuga ha una direzione sua, dal futuro verso il passato, e per questo si dice leakage temporale.
Trend, stagionalità e autocorrelazione dicono che cos’è una serie; a decidere se una previsione vale qualcosa sono altre due domande: come le si dà un voto senza barare col futuro, e come si rappresenta il tempo perché un normale modello tabellare (uno che vuole una tabella di righe, come la regressione o gli alberi) possa impararlo. Le colonne di quella tabella si chiamano feature.
Il modo di valutare che vedremo si chiama backtesting, ed è esattamente quello che il nome dice: provare all’indietro. Si finge di essere in un giorno del passato, si prevede quello che sarebbe successo dopo, e si confronta con quello che è successo davvero; poi si sposta in avanti quel giorno, e si rifà.
Perché mescolare i dati è un errore#
Con i dati tabellari gli esempi si dividono in tre insiemi: uno su cui il modello impara, uno su cui se ne regolano le scelte, uno su cui lo si esamina alla fine e che prima non si tocca. E prima di dividerli si mescolano, perché un ordine già presente nel file (tutte le foto di gatti in fondo, per esempio) renderebbe i tre insiemi diversi per costruzione. La k-fold cross-validation ripete la divisione più volte, tenendo da parte ogni volta una fetta diversa, e fa la media degli errori: il voto che ne esce è più stabile.
Con le serie temporali, invece, è proprio il rimescolamento a falsare la misura.
Alleni uno studente a prevedere il meteo. Gli dai in mano i dati di tutto l’anno mescolati a caso: alcuni giorni per esercitarsi, altri per l’esame. Ma tra i giorni d’esame c’è il 3 marzo, e tra quelli d’esercizio il 4 e il 5 marzo. Lo studente, «esercitandosi» sul 4 e 5, ha di fatto sbirciato cosa c’era intorno al 3: la sua previsione del 3 marzo sembrerà miracolosa, ma solo perché ha spiato i giorni vicini nel futuro.
Nel mondo vero non funziona così: quando prevedi domani, hai solo ieri e prima. Non puoi allenarti sui risultati di domani per indovinare domani. Mescolare i dati di una serie temporale rompe proprio questa regola (mette futuro e passato nello stesso mucchio) e ti regala un modello che sul foglio va benissimo e nella realtà crolla. Ci sono casi in cui il guaio pesa poco (un modello semplicissimo, che guarda solo i giorni appena prima e sbaglia soltanto per puro caso, dai giorni vicini non ha niente da imparare), ma vanno verificati uno per uno; nel dubbio, prima e dopo non si mescolano.
Il problema è che gli esempi di una serie sono ordinati e fortemente autocorrelati, quindi tutt’altro che indipendenti. Uno split casuale, o una k-fold con shuffle, mette nel training istanti \(t+1, t+3, \dots\) e nel validation l’istante \(t\): il modello osserva valori successivi a quello che deve prevedere, e sfrutta l’autocorrelazione per «interpolare» all’indietro. La stima dell’errore che ne esce è sistematicamente ottimista: un caso di data leakage, la stessa fuga di informazione per cui il test non si tocca mai.
La regola è netta: ogni dato usato per addestrare deve precedere nel tempo ogni dato usato per validare. Il confine tra train e validation è un istante \(t_0\), non un’estrazione a sorte.
La regola ha però un perimetro, e conviene conoscerlo. Per un modello puramente autoregressivo, i cui ingressi sono soltanto ritardi della serie, la k-fold ordinaria resta valida a patto che gli errori del modello siano incorrelati [BHK18]: ogni riga porta con sé i ritardi che le servono, e con errori bianchi il resto della serie non le aggiunge niente. Se invece il modello è troppo povero e i suoi errori restano correlati, la k-fold sottostima l’errore in modo sistematico; e la teoria che la giustifica presuppone una serie stazionaria. Con feature che guardano oltre la riga, serie non stazionarie o residui che nessuno ha controllato, che sono i casi più comuni, resta la regola temporale.
Validazione temporale: lo split cronologico#
La cura è semplice da enunciare: rispettare la freccia del tempo. Ci si allena sul passato, si verifica sul futuro, mai il contrario. Un taglio solo, però, non basta, perché darebbe un voto solo, misurato su una manciata di giorni: se in quei giorni è capitato un fatto strano (una nevicata, uno sciopero), il voto racconta la nevicata e non il modello. Meglio tagliare in molti punti diversi e fare la media dei voti. È il backtesting dell’apertura, e gli altri due nomi con cui lo si incontra sono walk-forward e valutazione «su origine mobile»: tre parole, una cosa sola [HA21].
Si rifà più volte lo stesso gioco onesto (allena sul prima, prova sul dopo), spostando ogni volta il confine in avanti. Ci sono due modi.
Con la finestra espansa (expanding), a ogni giro tieni tutto il passato disponibile e lo allunghi: prima usi i primi due mesi per prevedere il terzo, poi i primi tre per prevedere il quarto, e così via. Come uno storico che, più anni studia, più contesto ha.
Con la finestra scorrevole (rolling), tieni invece una finestra di lunghezza fissa che scivola in avanti: sempre, per esempio, gli ultimi dodici mesi. Utile quando il passato troppo lontano non è più rappresentativo: le abitudini d’acquisto di dieci anni fa dicono poco su quelle di oggi.
In entrambi i casi il pezzo di prova (il test) sta sempre a destra di quello d’allenamento (il train), cioè nel futuro, come mostra la Fig. 34.6. E se il modello ha delle manopole da regolare, anche quelle si regolano a ogni giro guardando soltanto il prima: regolarle una volta per tutte sull’intera serie vorrebbe dire aver già sbirciato il dopo.
Sia la serie \(y_1, \dots, y_n\). La lettera è \(y\) e non \(x\) perché la serie diventa il target di un problema supervisionato, e le previsioni si scrivono \(\hat{y}\), come nel resto del libro; altrove nel capitolo la serie resta \(x_t\). Fissato un training minimo e un orizzonte \(h\), il walk-forward produce una sequenza di coppie \((\text{train}, \text{test})\) in cui il blocco di test cade sempre dopo il blocco di train. Nella variante espansa l’\(i\)-esima iterazione addestra su \(y_1, \dots, y_{t_i}\) e valuta su \(y_{t_i+1}, \dots, y_{t_i+h}\), con \(t_i\) crescente; nella variante scorrevole il training è \(y_{t_i-v+1}, \dots, y_{t_i}\), con ampiezza \(v\) costante. L’errore finale è la media degli errori sui blocchi di test, e la Fig. 34.6 mostra le due varianti una sopra l’altra. Rispetto al singolo train/test split, questa procedura usa più segmenti futuri come banco di prova e riduce la varianza della stima, senza mai violare l’ordine temporale [HA21].
Anche la scelta degli iperparametri (gli ordini di un ARIMA, l’ampiezza di una finestra mobile, il numero di armoniche di Fourier) è un uso dei dati, e va fatta dentro lo schema: a ogni origine \(t_i\) si sceglie sul solo training \(y_1, \dots, y_{t_i}\), con un walk-forward interno a quel training, e si valuta il modello scelto sul blocco di test che segue. È la versione temporale della nested cross-validation della sezione sugli iperparametri, e ne eredita il costo: il numero di stime è il prodotto tra origini, tagli interni e candidati. Per questo in pratica si riduce la griglia, o si ripete la scelta soltanto ogni \(s\) origini. Scegliere sull’intera serie e poi misurare sulla stessa serie è la forma di leakage che la sezione sui modelli classici ha anticipato a proposito degli ordini \(p\) e \(q\).

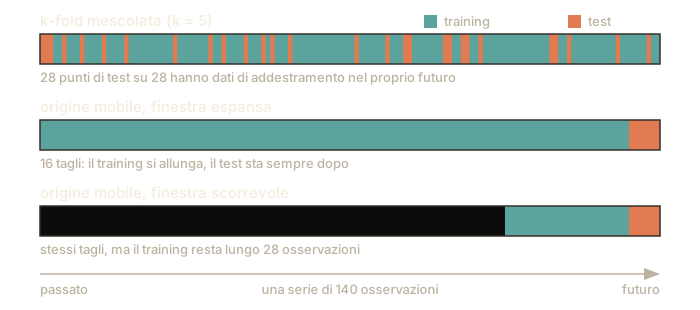
Fig. 34.6 In alto la k-fold mescolata: i blocchi di prova finiscono sparsi fra quelli di addestramento, e il modello si allena su ciò che dovrà prevedere. In basso l’origine mobile: il confine avanza di taglio in taglio e il test resta sempre dopo il training, sia a finestra espansa sia a finestra scorrevole.#
Misurare l’errore: dalle metriche note alle metriche scalate#
Con lo schema di validazione in mano, resta la domanda che la sezione sulle metriche si poneva per i modelli tabellari: con che numero giudichiamo una previsione? Il MAE e l’RMSE, già incontrati per la regressione, restano i mattoni di base, e la differenza fra i due sta tutta in come trattano gli errori grandi.
Il MAE (errore assoluto medio) è la media dei valori assoluti degli errori, e si esprime nell’unità della serie: un giorno sbagliato di tre gradi in più e uno sbagliato di tre in meno valgono uguale. L’RMSE (la radice dell’errore quadratico medio, già incontrata con il Netflix Prize nel capitolo sui sistemi di raccomandazione) eleva gli errori al quadrato prima di mediarli, e così pesa di più quelli grandi: un errore di otto contribuisce con sessantaquattro, uno di due con quattro, sedici volte meno.
Due modelli che il MAE giudica identici: uno sbaglia di due gradi tutti e quattro i giorni, l’altro ne azzecca tre e sbaglia di otto il quarto. MAE due contro due, pari. Con l’RMSE il primo fa \(\sqrt{(4+4+4+4)/4} = \sqrt{4} = 2\) e il secondo \(\sqrt{(0+0+0+64)/4} = \sqrt{16} = 4\): il doppio, perché quel giorno sbagliato di molto gli altri tre non lo compensano.
Il guaio è che entrambi dipendono dall’unità di misura della serie: un MAE di 500 è ottimo per il PIL, disastroso per la temperatura. Servono numeri che si possano confrontare fra serie diverse.
Il primo tentativo è misurare l’errore in percentuale: sbagliare di 500 su 50 000 è l’1%, su 500 è il 100%. Questa è la MAPE, l’errore percentuale medio. Comoda da spiegare, ma con tre difetti seri, e il primo si vede proprio sulla temperatura di poco fa: una percentuale ha senso solo dove lo zero della scala è uno zero vero, e in gradi Celsius non lo è, sicché lo stesso errore di un grado vale il 5% a venti gradi e il 50% a due. Gli altri due riguardano il conto. Se il valore vero è zero (un giorno senza vendite), si divide per zero e la metrica esplode. Ed è asimmetrica: prevedere troppo alto o troppo basso non costa uguale. Col valore vero a 100, se prevedi 0 hai sbagliato del 100%, ed è il massimo che puoi sbagliare per difetto, perché sotto lo zero non si va. Se prevedi 1000, hai sbagliato del 900%, e non c’è nessun tetto. Sbagliare per eccesso costa quindi di più, e alla lunga la metrica premia i modelli timidi.
La strada che funziona è un’altra: invece di guardare l’errore in sé, si guarda quante volte è più grande dell’errore di qualcuno che non fa niente di intelligente. Se il tuo modello sbaglia in media di 4 gradi e chi si limita a copiare il giorno prima ne sbaglia 8, il tuo numero è \(4/8 = 0{,}5\). È la MASE, sigla inglese per «errore assoluto medio scalato», e scalato vuol dire proprio questo: diviso per il metro di qualcun altro. Se viene 1 sbagli quanto lui, se viene \(0{,}5\) sbagli la metà, se viene 2 il doppio: un numero solo, senza unità di misura. Perché ci sia un metro, però, la serie deve muoversi: su una che si ripete sempre identica chi copia non sbaglia mai, il suo errore è zero, e per zero non si divide.
Ci sono due modi per usarla male. Uno è tacere quale pigrizia si è presa a paragone: chi copia può copiare ieri, oppure lo stesso giorno della settimana scorsa se la serie ha un ritmo settimanale, e il numero che ne esce è diverso.
L’altro è leggerla come una gara alla pari, e non lo è. L’errore di chi copia si misura una volta sola, prima che la prova cominci, sulla strada già percorsa, quella su cui ti sei allenato, e chiedendogli ogni volta soltanto il giorno dopo; tu invece corri sui giorni nuovi, e magari ne stai prevedendo dodici in una volta (Fig. 34.7). Nel conto di prima, gli 8 gradi di chi copia fanno da metro e non da avversario: servono a trasformare i tuoi 4 gradi in quel \(0{,}5\) che non ha più unità di misura. Ed è una scelta voluta da chi la MASE l’ha inventata, Rob Hyndman e Anne Koehler: se il metro si prendesse sui giorni di prova, con una previsione sola chi copia avrebbe un errore solo, magari zero, e per zero non si divide; la strada già percorsa, invece, di giorni ne ha sempre tanti. Sbagliare quanto lui, allora, non vuol dire pareggiare: su dodici giorni avanti è un ottimo risultato, su un giorno solo sarebbe mediocre.
Per un blocco di test di \(h\) punti, con valori veri \(y_t\) e previsioni \(\hat{y}_t\):
L’errore percentuale medio e la sua versione «simmetrica» sono
La MAPE è indefinita per \(y_t=0\) ed è asimmetrica: per serie e previsioni non negative la sottostima (\(\hat{y}_t<y_t\)) è limitata al \(100\%\), la sovrastima no, così la metrica favorisce chi sottoprevede.
La sMAPE mette la somma dei due valori al denominatore, e con il nome promette di aver corretto l’asimmetria. In realtà la rovescia: a parità di errore assoluto penalizza di più chi sottoprevede. Con \(y=100\) e uno scarto di \(50\) costa il \(66{,}7\%\) per difetto contro il \(40\%\) per eccesso, e il divario cresce con l’errore. Nella forma qui scritta, con i valori assoluti al denominatore, ha in più un tetto del \(200\%\) che la MAPE non ha, e resta indefinita quando \(y_t = \hat y_t = 0\), cioè proprio sulle serie intermittenti per cui la si andava cercando. Hyndman e Koehler la definiscono invece senza quei valori assoluti, e annotano che metterceli sarebbe più naturale ma non è l’uso corrente: la loro versione perde il tetto e in cambio può uscire negativa, cioè smette di essere un errore percentuale. In tutte e due le forme, gli stessi della MASE ne sconsigliano l’uso [HK06].
La MASE (Mean Absolute Scaled Error), proposta da Rob Hyndman e Anne Koehler nel 2006 [HK06] con il passo fisso a uno e generalizzata al passo stagionale da Hyndman e Athanasopoulos [HA21], scala l’errore del modello sull’errore in-sample del naive calcolato sul training:
I due simboli non sono lo stesso oggetto, e la distinzione è la parte che si sbaglia più spesso: \(e_j\) sono gli \(h\) errori del modello sul blocco di test, mentre \(y^{\text{tr}}\) è la serie di training, lunga \(n\). Il denominatore non si calcola mai sul test. Il passo \(m\) è il periodo stagionale: vale \(1\) su una serie senza stagionalità, e va posto pari al periodo su una serie che ne ha una [HA21]. Altrimenti al denominatore finisce un avversario che su quella serie sbaglia molto più del dovuto, e ogni modello ne esce lusingato.
Poiché è un rapporto tra errori nella stessa unità, la MASE è adimensionale e confrontabile tra serie, e non ha problemi con gli zeri purché la serie di training non si ripeta identica a passo \(m\): non basta che non sia costante, perché su una serie perfettamente periodica di periodo \(m\) il denominatore è zero comunque, e la MASE stagionale si usa proprio sulle serie che un periodo ce l’hanno. La lettura, però, va data per esteso, perché la versione corta («sotto 1 batte il naive») è la fonte di un equivoco: un valore sotto \(1\) vuol dire che l’errore del modello è inferiore a quello commesso, a un passo di stagione e sui dati di addestramento, dal predittore che copia il ciclo precedente. È una scala e non un duello: il denominatore serve a togliere l’unità di misura della serie, non a fare da avversario. Un modello con MASE \(0{,}9\) su un orizzonte a dodici passi non ha battuto nessuno alla pari: ha sbagliato il 90% di quanto sbaglia a un passo chi copia, il che su dodici passi è ottimo e su un passo sarebbe mediocre. Se si vuole davvero il duello, il naive va fatto correre sullo stesso test e sullo stesso orizzonte, ed è quello che si fa con le linee di base ingenue. Su più serie, infine, serve una regola per aggregare: le competizioni M usano l’OWA (overall weighted average), la media di sMAPE e MASE, ciascuna divisa per quella di un metodo di riferimento sull’insieme delle serie (il Naive 2, un naive sulla serie destagionalizzata), così che \(1\) voglia dire «pari al riferimento» [MSA20].
Quando la previsione non è un singolo numero ma una distribuzione (un intervallo, o un insieme di quantili), si usa la pinball loss (o quantile loss). Per il quantile di livello \(\tau\in(0,1)\), con previsione \(\hat{y}_\tau\) e valore vero \(y\):
Qui \(\tau\) è il livello del quantile (per esempio \(0{,}9\) per il novantesimo percentile): la formula penalizza in modo asimmetrico gli sforamenti sopra e sotto, tanto da spingere \(\hat{y}_\tau\) verso il vero quantile \(\tau\)-esimo della distribuzione. Mediata su più livelli, approssima un punteggio proprio per l’intera previsione probabilistica [HA21].
Il fattore due che in molte scritture moltiplica i due rami qui non c’è: ometterlo è una convenzione e non altera la definizione. Hyndman e Athanasopoulos lo tengono, e annotano che spesso si omette. Raddoppiare ogni perdita non sposta il minimo né l’ordine fra due modelli, ma raddoppia le cifre, e due punteggi si confrontano solo se vengono dalla stessa forma.
Attenzione però a cosa misura, perché non è la calibrazione. Essere un punteggio proprio significa che è minimizzata in media dalla distribuzione vera, e quindi che serve benissimo come funzione di costo in addestramento e come criterio di confronto complessivo. Ma premia insieme la calibrazione (la banda copre davvero quello che dichiara) e la finezza (la banda è stretta), e non sa dire quale delle due manca. Il conto si fa contro una gaussiana vera, con tre previsori che azzeccano tutti la mediana e sbagliano solo la larghezza, e mediando i nove decili.
import numpy as np
from scipy.integrate import quad
from scipy.stats import norm

# La pinball loss è scritta qui senza il fattore due davanti ai due rami.
def pinball(y, q, tau):
    return tau * (y - q) if y >= q else (1 - tau) * (q - y)

livelli = np.round(np.arange(0.1, 0.91, 0.1), 2)   # i nove decili

def punteggio(larghezza):
    """Pinball media contro una N(0,1) vera, per chi dichiara quella larghezza."""
    perdite = []
    for tau in livelli:
        q = larghezza * norm.ppf(tau)       # il quantile che il modello dichiara
        peso = lambda y: pinball(y, q, tau) * norm.pdf(y)
        perdite.append(quad(peso, -12, q)[0] + quad(peso, q, 12)[0])
    return np.mean(perdite)

def copertura(larghezza):
    """Quanto copre davvero la banda fra il decimo e il novantesimo dichiarati."""
    z = larghezza * norm.ppf(0.9)
    return norm.cdf(z) - norm.cdf(-z)

print("larghezza dichiarata   pinball (nove decili)   banda «all'80%»")
for larghezza, come in [(0.5, "metà di quella vera"),
                        (1.0, "quella vera        "),
                        (2.0, "il doppio          ")]:
    print(f"  {come}          {punteggio(larghezza):.3f}"
          f"                {copertura(larghezza):.0%}")
larghezza dichiarata   pinball (nove decili)   banda «all'80%»
  metà di quella vera          0.329                48%
  quella vera                  0.309                80%
  il doppio                    0.356                99%
Il punteggio li ordina, ma non dice che chi dichiara metà della larghezza vera sta mentendo sull’incertezza e chi la dichiara doppia la sta sprecando: il minimo ce l’ha il modello calibrato, ed è quello che ci si aspetta da un punteggio proprio.
La formulazione canonica della materia, dovuta a Gneiting, Balabdaoui e Raftery [GBR07], è «massimizzare la finezza sotto vincolo di calibrazione», e la calibrazione si controlla a parte: si conta quante volte il valore osservato cade dentro la banda all’80% e si guarda se fa l’80%. La macchina per farlo è il walk-forward.
Le due corse, messe sulla stessa linea del tempo, si colgono in un colpo solo (Fig. 34.7): il modello parte dove finisce la storia e copre tutto l’orizzonte in una volta; chi copia, invece, resta di qua dal confine e avanza di un passo per volta.
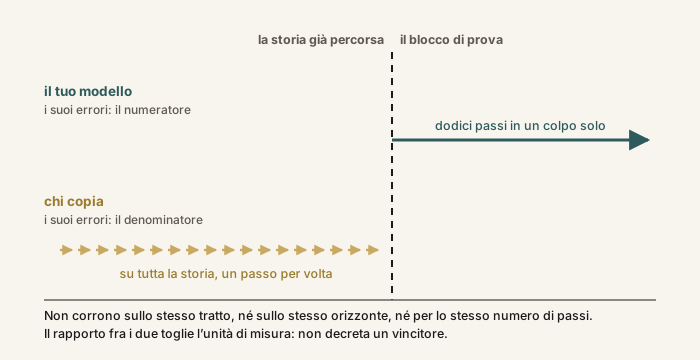
Fig. 34.7 Che cosa mette a confronto la MASE. Sopra il numeratore, gli errori del modello sul blocco di prova e sull’orizzonte intero; sotto il denominatore, gli errori di chi copia sulla storia già percorsa, un passo alla volta e per tutta la sua lunghezza, quindi molte più volte. Sono due corse su tratti diversi, a orizzonti diversi e per un numero diverso di passi, ed è per questo che il loro rapporto è un righello e non un verdetto.#
Le linee di base che bisogna sempre battere#
Prima di dichiarare vittoria con una rete neurale, un modello va confrontato con avversari volutamente banali. Se non li batte, non serve. È l’idea di linea di base incontrata con gli alberi decisionali e metodi ensemble, il termine di paragone volutamente semplice che un modello più elaborato deve battere; una serie storica ha i suoi.
Le classiche sono quattro [HA21], e la prima è già in mano: rispondere sempre la media di tutto quello che si è osservato, parente stretta della linea piatta contro cui la sezione sui modelli classici ha misurato l’MA(2) (là era la costante che l’ARIMA si stima da sé, qui è la media dei dati osservati e basta). Le altre tre si scrivono con pochi simboli, gli stessi del resto del capitolo: \(y_t\) è il valore osservato all’istante \(t\), e \(T\) l’ultimo istante osservato, l’origine da cui si guarda avanti; il cappellino di \(\hat{y}\) vuol dire «previsto» invece che «osservato»; \(h\) è quanti passi avanti si guarda, cioè l’orizzonte della previsione; e \(m\) è la lunghezza del ciclo stagionale (7 per una settimana, 12 per un anno di mesi).
Naive, cioè ingenuo: la previsione per ogni istante futuro è l’ultimo valore osservato, \(\hat{y}_{T+h}=y_T\). Sembra una resa, ma su una passeggiata aleatoria, che a ogni passo fa un salto sorteggiato, è la previsione migliore che esista. Lì ogni scossa sposta il livello e ce lo lascia, perché il passo dopo riparte da dove la scossa ha portato; tutto quello che è successo fin lì è già dentro il valore di oggi, e quello che verrà è un sorteggio non ancora fatto, a media zero. Il valore atteso del futuro, dato il passato, è quindi il valore di oggi, \(\mathbb{E}[y_{T+h} \mid y_1, \dots, y_T] = y_T\) a ogni orizzonte, e nessun modello fa meglio in media. I prezzi finanziari, in prima approssimazione, si comportano così. Vale finché non c’è anche una deriva a tirare la serie da una parte: se c’è, il metodo giusto è il drift, che chiude l’elenco.
Naive stagionale: si ripete il valore dello stesso istante del periodo precedente. Le vendite di questo dicembre sono quelle dello scorso dicembre. Quando l’orizzonte supera un ciclo intero, però, «lo stesso istante del periodo precedente» cade a sua volta nel futuro, e non è ancora stato osservato; si ricicla allora sempre l’ultimo ciclo osservato. Con i numeri: siamo a dicembre e vogliamo prevedere quindici mesi avanti, cioè il marzo dell’anno dopo il prossimo. Il marzo dell’anno prossimo non è ancora successo, e l’ultimo marzo visto davvero è quello di nove mesi fa: la previsione ricopia quello. In formula è \(\hat{y}_{T+h}=y_{T+h-m(k+1)}\), dove \(k = \lfloor (h-1)/m \rfloor\) conta i cicli interi che si chiudono prima dell’istante da prevedere (le due parentesi tagliate in basso vogliono dire «arrotonda per difetto»). Qui \(m = 12\), \(k = \lfloor 14/12 \rfloor = 1\), e l’indice da andare a pescare è \(T + 15 - 12\cdot 2 = T - 9\). Con \(h = m\), un ciclo tondo avanti, \(k\) vale zero, e lo stesso mese dell’anno prima è proprio l’ultimo osservato. È la stessa contabilità del metodo Holt-Winters della sezione sui modelli classici, ed è la linea di base da battere ogni volta che c’è stagionalità.
Drift, cioè deriva: come il naive, ma con una retta di tendenza tirata fra i due estremi della serie, \(\hat{y}_{T+h}=y_T+h\cdot\frac{y_T-y_1}{T-1}\): la frazione è la salita media per passo (quanto è cresciuta la serie dal primo all’ultimo punto, diviso quanti passi ci sono voluti), e moltiplicandola per \(h\) si prolunga in avanti il segmento che unisce il primo e l’ultimo punto. Con i numeri: la serie è partita da 10, adesso sta a 40, e fra il primo e l’ultimo punto sono passati 30 giorni; sale dunque di \(30/30 = 1\) al giorno, e la previsione per fra una settimana è \(40 + 7 = 47\).
Disegnate sulla stessa serie sono quattro forme, e una forma si ricorda meglio di una formula (Fig. 34.8): una riga piatta a mezz’altezza, una riga piatta all’ultimo valore, l’ultimo ciclo ricopiato in avanti, una retta che prolunga la salita. La scena è quella del conto di poco sopra, una serie che finisce a dicembre e una previsione a quindici mesi, e l’arco fa vedere anche la cosa che il conto serve a evitare: oltre l’anno si ricicla sempre l’ultimo ciclo osservato, non quello dell’anno appena prima di quello da prevedere, che non è ancora accaduto.
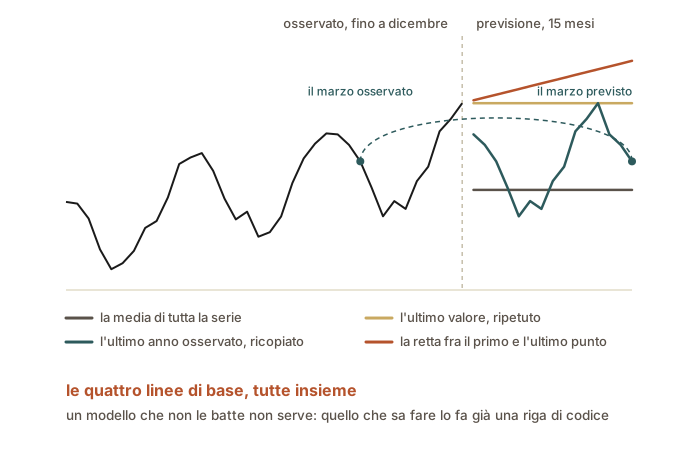
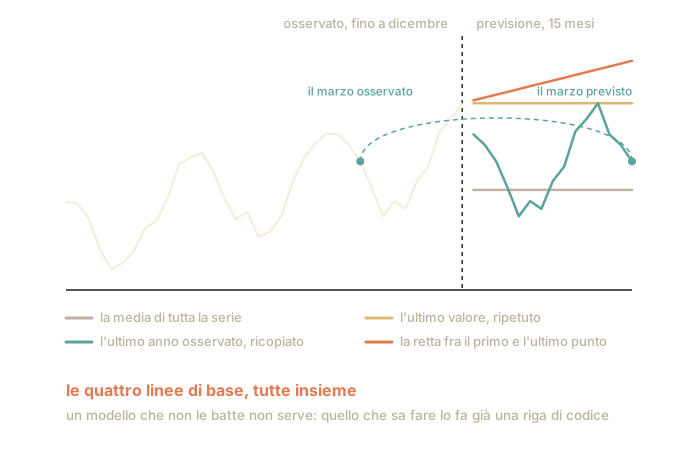
Fig. 34.8 Le quattro linee di base sulla stessa serie. A sinistra i tre anni osservati, a destra i quindici mesi previsti da ciascuna: nessuna delle quattro guarda i dati più di così, ed è per questo che battere tutte e quattro è il minimo che si chieda a un modello.#
Farle correre accanto al proprio modello è il modo più diretto di accorgersi quando un modello complicato sta imitando, e per giunta peggio, quello che una riga di codice farebbe da sola.
Perché le bande di previsione escono spesso troppo strette#
Una previsione che dichiara una forbice («domani fra 22 e 26 gradi») tende a dichiararla più stretta di quanto sarebbe onesto. È un’osservazione dei manuali prima che una teoria: come la maggior parte degli intervalli di previsione, quelli di un ARIMA escono di solito troppo stretti, perché il loro calcolo tiene conto della sola variabilità delle scosse e tratta come certi i parametri stimati, l’ordine del modello scelto e la persistenza nel futuro delle regolarità del passato [HA21]. È la parentesi che l’apertura del capitolo ha lasciato aperta, là dove dice che una previsione seria porta con sé la propria incertezza: qui ci sono gli attrezzi per chiuderla.
Prima però va detto per bene che cosa promette una forbice, perché è una promessa precisa e si può controllare. Quando un modello dice «fra 22 e 26, all’80%» sta dicendo: se ripetessi questa previsione mille volte, il valore vero cadrebbe al suo interno ottocento volte. È un conto che il modello ha fatto, non una speranza, e poggia su ipotesi. Due si possono guardare da vicino con un esperimento: che i parametri siano noti invece che stimati, e che gli scarti si distribuiscano secondo la gaussiana della sezione su probabilità e statistica. Nessuna delle due è vera, e non sbagliano nello stesso verso.
La prima si racconta in una riga. Per dire «fra 22 e 26» il modello usa due numeri suoi, quanto ieri pesa su oggi e quanto di solito le giornate si discostano, e quei due numeri non glieli ha dati nessuno: se li è ricavati dalla stessa storia che sta guardando, e poteva ricavarli un po” diversi. Il conto della forbice fa finta di no. È un’incertezza che c’è e che nessuno conta, e siccome nessuno la conta la forbice esce più stretta del dovuto: sempre, e tanto più quanto la storia è corta e quanto più in là si guarda.
La seconda è più curiosa, perché non sbaglia sempre nello stesso verso. Prendi due fenomeni che nel complesso si agitano uguale, ma uno dei due ogni tanto fa un salto enorme. Quei pochi salti enormi, nel bilancio dell’agitazione, pesano tantissimo, per la ragione già vista con l’RMSE: il bilancio somma i quadrati, e il quadrato di otto è sessantaquattro. Siccome il bilancio totale deve restare lo stesso, tutti gli altri giorni devono essere più tranquilli. I valori, cioè, si accalcano attorno al centro, qualcuno finisce lontanissimo, e a diradarsi sono le vie di mezzo.
Adesso contali, e il conto viene al contrario di come sembra. Col fenomeno tranquillo, una forbice che promette otto casi su dieci ne raccoglie, appunto, otto su dieci. Col fenomeno che fa i salti, la stessa forbice sta proprio lì dove i valori si sono accalcati, e ne raccoglie di più: quasi nove su dieci. Una forbice larghissima, quella che promette novantanove casi su cento, arriva invece fin quasi in fondo alla coda, e i pochi mostri gliela passano oltre: i casi raccolti sono meno di novantanove.
Messe insieme, allora. Sulle forbici strette, quelle che si usano tutti i giorni, i due errori tirano in versi opposti: il primo stringe la forbice, il secondo la allarga, e quale dei due vinca dipende da quanto è corta la storia, da quanto in là si guarda e da quanto sono rari e grandi i salti. Chi promette di coprire quasi tutto se li trova invece tutti e due contro. E poi ci sono gli errori che nessun esperimento con una regola nota mette in scena: il modello scelto sbagliato, e il futuro che cambia regole. Quelli tirano da una parte sola, ed è per questo che sulle serie vere le forbici escono di solito troppo strette.
La prima ipotesi è che i parametri, stimati, vengano trattati come noti. L’intervallo si costruisce con \(\hat\phi\) e \(\hat\sigma\) al posto di \(\phi\) e \(\sigma\), e da lì in poi si ragiona come se fossero i valori veri. L’incertezza sulla stima non entra nella varianza di previsione, che esce quindi più piccola di quella giusta, e la copertura effettiva sta sotto il livello dichiarato [HA21]. Il verso è uno solo, e lo sconto cresce al calare della lunghezza della storia e al crescere dell’orizzonte, perché l’errore sui parametri si compone a ogni passo.
La seconda è che i residui siano gaussiani. Quelli delle serie vere sono di solito leptocurtici: a parità di varianza hanno più massa al centro e più massa nelle code, e a diradarsi sono le zone intermedie. La conseguenza sui quantili non ha un verso unico. Su una \(t\) di Student a quattro gradi di libertà, riscalata alla stessa deviazione standard della gaussiana (è la forma con cui si modellano di solito i rendimenti finanziari), la banda gaussiana dichiarata all’80% copre l’85,6% e quella dichiarata al 99% copre il 97,8%: sovracopertura sulle bande strette, sottocopertura su quelle larghe, e il pareggio attorno al 95%.
Messe insieme, le due ipotesi non fissano il segno dell’errore complessivo. Sulle bande di uso quotidiano tirano in versi opposti e vince la più grossa, che dipende dalla lunghezza della storia, dall’orizzonte e dalla pesantezza delle code; sulle bande molto larghe si sommano, ed è lì che la sottostima è peggiore. È anche la ragione per cui allargare a forfait non basta: ripara il livello su cui lo si è tarato e sposta l’errore su tutti gli altri. La sottostima che si osserva di solito sulle serie vere viene dalle ipotesi che nessun esperimento con la regola nota può violare, cioè che il modello sia quello giusto e che il futuro segua le regole del passato, e quelle tirano da una parte sola.
Le due ipotesi, quindi, non tirano dalla stessa parte, e su una banda di uso quotidiano il segno dell’errore dipende da quale delle due pesa di più. A dover stare in guardia su tutte e due è chi promette di coprire quasi tutto.
La buona notizia è che tutto questo si misura, e la misura ha un nome, copertura empirica: si prende il walk-forward di poche righe fa, si conta quante volte il valore osservato è caduto davvero dentro la banda, e si confronta con il livello dichiarato.
Il conto si fa sulla stessa serie della sezione sui modelli classici, quella in cui il valore di domani è il 60% di quello di oggi più quattro, più una scossa casuale. I due numeri del modello (il 60% e il quattro) si ricavano dalla storia con la retta dei minimi quadrati, esattamente come là, e la prova si ripete ventimila volte. Le scosse sono gaussiane, oppure a code pesanti: una \(t\) di Student a quattro gradi di libertà riscalata alla stessa varianza, cioè la stessa agitazione media con salti rari e grandi. E la banda si guarda a due livelli, all’80% e al 99%.
import numpy as np
from scipy.stats import norm, t as student

def copertura(n_storia, orizzonte, stima, code=False, livello=0.80,
              prove=20_000, seme=0):
    """Quante volte il valore vero cade nella banda dichiarata a quel livello.
    Con code=True le scosse sono una t di Student a quattro gradi di libertà,
    riscalata a varianza 1: stessa agitazione media, salti rari e grandi."""
    c, phi, sigma = 4.0, 0.6, 1.0
    z = norm.ppf(0.5 + livello / 2)          # 1.2816 all'80%, 2.5758 al 99%
    rng = np.random.default_rng(seme)

    def scosse():
        if code:
            return sigma * rng.standard_t(4, prove) / np.sqrt(2)
        return rng.normal(0, sigma, prove)

    # una riga per prova: la stessa storia dell'AR(1), rigenerata da capo
    y = np.empty((prove, n_storia))
    y[:, 0] = c / (1 - phi) + rng.normal(0, sigma / np.sqrt(1 - phi**2), prove)
    for t in range(1, n_storia):
        y[:, t] = c + phi * y[:, t - 1] + scosse()
    vero = y[:, -1].copy()
    for _ in range(orizzonte):
        vero = c + phi * vero + scosse()

    if stima:      # i due numeri si ricavano dalla storia, come nella realtà
        x, b = y[:, :-1], y[:, 1:]
        mx, mb = x.mean(1, keepdims=True), b.mean(1, keepdims=True)
        p = ((x - mx) * (b - mb)).sum(1) / ((x - mx) ** 2).sum(1)
        cc = mb[:, 0] - p * mx[:, 0]
        res = b - (cc[:, None] + p[:, None] * x)
        s = np.sqrt((res ** 2).sum(1) / (n_storia - 3))
    else:          # regalati già giusti: il caso che non esiste in natura
        p, cc, s = (np.full(prove, v) for v in (phi, c, sigma))

    prev = y[:, -1].copy()
    for _ in range(orizzonte):
        prev = cc + p * prev
    var = s ** 2 * sum(p ** (2 * k) for k in range(orizzonte))
    return np.mean(np.abs(vero - prev) <= z * np.sqrt(var))

print("copertura su 20.000 prove                       all'80%    al 99%")
for code, n_storia, orizzonte, stima in [
        (False, 30, 1, False), (False, 30, 5, False), (False, 30, 1, True),
        (False, 100, 1, True), (False, 30, 5, True),
        (True, 30, 1, False), (True, 30, 1, True), (True, 100, 1, True),
        (True, 30, 5, True)]:
    scosse = "a code pesanti" if code else "gaussiane"
    come = "stimati" if stima else "regalati"
    avanti = "1 passo" if orizzonte == 1 else f"{orizzonte} passi"
    a80, a99 = (copertura(n_storia, orizzonte, stima, code, livello)
                for livello in (0.80, 0.99))
    print(f"  {scosse:14s}  {come:8s}  {n_storia:3d} di storia  {avanti:7s}"
          f"   {a80:6.1%}   {a99:6.1%}")

# il conto esatto per le sole code pesanti, a parametri noti e a un passo
for livello in (0.80, 0.99):
    z = norm.ppf(0.5 + livello / 2)
    esatta = 2 * student.cdf(z * np.sqrt(2), 4) - 1
    print(f"code pesanti, banda gaussiana di livello {livello:.0%}: "
          f"copre {esatta:.1%}")
copertura su 20.000 prove                       all'80%    al 99%
  gaussiane       regalati   30 di storia  1 passo    80.2%    98.9%
  gaussiane       regalati   30 di storia  5 passi    79.9%    99.0%
  gaussiane       stimati    30 di storia  1 passo    77.7%    97.9%
  gaussiane       stimati   100 di storia  1 passo    79.5%    98.7%
  gaussiane       stimati    30 di storia  5 passi    73.8%    96.8%
  a code pesanti  regalati   30 di storia  1 passo    85.8%    98.0%
  a code pesanti  stimati    30 di storia  1 passo    81.1%    96.7%
  a code pesanti  stimati   100 di storia  1 passo    83.8%    97.3%
  a code pesanti  stimati    30 di storia  5 passi    75.5%    95.3%
code pesanti, banda gaussiana di livello 80%: copre 85.6%
code pesanti, banda gaussiana di livello 99%: copre 97.8%
Su ventimila prove il margine di questi numeri è di circa mezzo punto all’80% e di un decimo di punto al 99%, quindi contano solo gli scarti più grandi. Le prime cinque righe hanno scosse gaussiane, e isolano la prima ipotesi. Se al modello i due numeri si regalano già giusti, la banda all’80% copre l’80%, e lo copre anche a cinque passi: la promessa è mantenuta. Appena invece glieli si fa ricavare dalla storia, la copertura cede, e cede di più via via che l’orizzonte si allunga e la storia si accorcia: \(77{,}7\%\) con trenta osservazioni a un passo, \(73{,}8\%\) a cinque passi, quasi l’80% con cento osservazioni.
Le altre quattro righe hanno le scosse a code pesanti. Con i parametri regalati c’è la seconda ipotesi da sola: la banda all’80% copre l’\(85{,}8\%\) e quella al 99% il \(98{,}0\%\), come prevede il conto esatto delle ultime due righe. Con i parametri stimati le due ipotesi si incontrano, e il verso dipende dai numeri: con trenta osservazioni a un passo quasi si compensano (\(81{,}1\%\)), con cento la banda all’80% copre più di quanto promette (\(83{,}8\%\)), a cinque passi meno (\(75{,}5\%\)). La banda al 99% resta invece sotto in tutte le righe con i parametri stimati, fino al \(95{,}3\%\): lì le due ipotesi tirano dalla stessa parte. È la diagnostica più semplice della previsione probabilistica, e costa poche righe più del walk-forward che c’è già.
Trasformare il tempo in una tabella#
Resta da rappresentare il tempo in modo che un modello tabellare lo possa usare. Buona parte dei modelli che conosciamo (la regressione, gli alberi decisionali, le reti) non sanno nulla di «tempo». Vogliono una tabella, come quelle della sezione sull’apprendimento supervisionato: una riga per ogni caso, alcune colonne di domanda (le feature) e una colonna di risposta giusta (il target), e ogni riga deve poter essere letta da sola, senza sapere che cosa c’è nelle righe accanto. Imparare da una tabella così è il solito apprendimento supervisionato, quello in cui per ogni riga la risposta è già scritta. Costruire una tabella del genere a partire da una serie si chiama feature engineering temporale, e serve a questo: una volta fatta, prevedere il futuro torna a essere il solito problema tabellare che sappiamo già risolvere.
Una riga per ogni giorno, scritta la sera, quando le vendite del giorno sono già note: sopra il riassunto del recente passato, e una domanda sola, quanto venderò fra una settimana? I mattoni del riassunto sono quattro.
I lag: i valori di oggi, di ieri, di una settimana fa. Sono la memoria grezza della serie: spesso «quanto ho venduto oggi» è già un’ottima indicazione su domani.
Le finestre mobili: media e deviazione degli ultimi 7 o 30 giorni. La media cattura il livello recente lisciando il rumore; la deviazione (quella standard, che misura quanto i valori si sparpagliano attorno alla loro media) dice quanto la serie è stata mossa di recente.
L’encoding del tempo, cioè trasformare la data in numeri: dal calendario ricaviamo il giorno della settimana, il mese, se è un giorno festivo. Sono le informazioni che spiegano perché il lunedì è diverso dalla domenica e agosto da novembre.
I termini di Fourier. Per dire al modello a che punto del ciclo annuale siamo si potrebbe mettere una colonna per ciascuno dei 365 giorni, con un \(1\) sul giorno giusto e \(0\) sugli altri: funziona, ma sono 365 colonne per un’informazione sola. C’è un modo più compatto, lo stesso con cui la sezione dal suono alle feature scomponeva un accordo al pianoforte nelle poche note che lo compongono: una curva che si ripete si descrive con poche onde regolari sovrapposte. Quelle onde si chiamano seno e coseno, salgono e scendono all’infinito sempre uguali a sé stesse, e bastano due o tre coppie per disegnare quasi ogni stagionalità liscia. Il nome viene da Joseph Fourier, il matematico che all’inizio dell’Ottocento mostrò come scomporre così una curva periodica.
Un guaio resta sul confine fra i giorni d’allenamento e quelli di prova. Mettiamo che la prima previsione vera si faccia la sera di un lunedì, a vendite del lunedì già note, e chieda quelle del lunedì dopo. Fra le righe d’allenamento, quella del lunedì precedente chiede proprio le vendite di questo lunedì: la sera della previsione sono già note, e la riga resta. Le sei righe dopo, da martedì a domenica, chiedono invece di giorni che quella sera non sono ancora arrivati, e sono risposte che nel momento della previsione nessuno conosce: si buttano via. Sono una meno dei giorni d’anticipo, sei con una settimana e nessuna se si prevede soltanto il giorno dopo: un pugno di esempi in cambio di un confine pulito. Che la riga del lunedì sera, per fare le sue medie, guardi indietro ai giorni d’allenamento non guasta niente, perché quei giorni sono già passati. L’operazione si chiama purga, e il nome viene dalla finanza.
Data la serie \(y_t\), si costruisce una matrice di progetto \(\mathbf{X}\) in cui la riga all’istante \(t\) contiene l’informazione fino a \(t\) compreso, cioè quella disponibile quando la previsione si emette, e mai oltre, per non reintrodurre leakage:
Lag: \(y_t, y_{t-1}, \dots, y_{t-p+1}\), gli ultimi \(p\) valori osservati.
Finestre mobili di ampiezza \(w\): media \(\frac{1}{w}\sum_{i=0}^{w-1} y_{t-i}\), deviazione standard, minimo, massimo.
Variabili di calendario: giorno della settimana, mese, indicatori di festività, tipicamente one-hot.
Termini di Fourier per una stagionalità di periodo \(m\): per \(k=1,\dots,K\) si aggiungono le colonne \(\sin\!\bigl(\tfrac{2\pi k t}{m}\bigr)\) e \(\cos\!\bigl(\tfrac{2\pi k t}{m}\bigr)\). Poche armoniche (\(K\) piccolo) bastano a rappresentare stagionalità lisce con un pugno di regressori, invece delle \(m-1\) dummy stagionali [HA21].
Il target della riga \(t\) è \(y_{t+h}\) per l’orizzonte \(h\) desiderato. A quel punto qualunque regressore tabellare (dai modelli lineari al gradient boosting) diventa un modello di forecasting.
Il divieto vale anche per le trasformazioni: media, deviazione, minimo e
massimo usati per scalare le colonne vanno stimati sul solo training di quel
giro e poi applicati al test, mai calcolati sull’intera serie. Uno
StandardScaler applicato prima dello split ricade nello stesso errore
dell’analista con la curva liscia come una pista da sci.
E attenzione a dove cade il taglio, perché la regola «netta» del confine
temporale si viola da sé, al bordo. Se si costruisce la tabella sull’intera
serie e poi si divide train e test guardando l’istante \(t\) delle righe, le
ultime righe di training hanno un bersaglio \(y_{t+h}\) che cade oltre l’ultimo
istante che la prima riga di test conosce. Si tagliano via quelle righe, ed è
un’operazione che ha un nome, la purga, preso dal capitolo settimo di
Advances in Financial Machine Learning di Marcos López de Prado
[LopezdP18], intitolato appunto alla cross-validation in
finanza. Quante siano discende dalla regola stessa. La prima riga di test,
all’istante \(t_0\), usa osservazioni fino a \(y_{t_0}\), che è quanto il
previsore sa quando la emette; una riga di training all’istante \(t < t_0\) è
lecita se il suo bersaglio era già noto a quel punto, cioè se \(t + h \le t_0\),
e le righe da togliere in fondo al training sono \(h-1\), da \(t_0-h+1\) a
\(t_0-1\): nessuna per \(h=1\), sei con un orizzonte di una settimana. In
scikit-learn è il parametro gap di TimeSeriesSplit, da porre a \(h-1\). Il
conto dipende da dove finisce la riga: con la convenzione, che si incontra
anche, di una riga \(t\) che legge fino a \(y_{t-1}\), le righe diventano \(h\), e
chi cambia convenzione deve rifarlo. Ritardi e finestre mobili non allungano
il conto: che una riga di training abbia per
bersaglio un valore che la prima riga di test legge fra le sue feature non è una
fuga, perché quando si prevede quel valore è già osservato, e in produzione il
modello lo avrebbe in mano allo stesso modo. Togliere anche quelle righe
butterebbe via dati leciti e renderebbe la stima pessimista invece che onesta. È
anche il criterio di López de Prado, per il quale l’etichetta di una riga occupa
il tratto che va dall’istante della riga al suo bersaglio: si purgano le righe
di training il cui tratto si sovrappone a quello di una riga di test.
Quanto costi tenersele, quelle righe, dipende da quanto è lungo il training: sei righe sono una frazione trascurabile di un training di qualche migliaio, e una frazione grossa di uno di qualche decina. È quando i dati sono pochi che l’ottimismo può farsi vedere, cioè proprio quando si è più tentati di tenersele.
L’embargo, che quel capitolo affianca alla purga, qui invece non serve, e chi li importa tutti e due butta via dati per difendersi da una minaccia che non c’è. L’embargo mette una zona morta anche dopo il blocco di test, e serve quando un blocco di addestramento viene dopo un blocco di prova nel tempo, come nelle validazioni incrociate combinatorie in cui i fold si alternano lungo la serie. Nella validazione a origine mobile il training è sempre un prefisso e il test sempre il blocco immediatamente successivo: nessun dato di addestramento segue mai un dato di prova, e la zona morta a destra non avrebbe niente da proteggere.
La regola, messa sugli indici, è quella di Fig. 34.9: a contare è dove cade il bersaglio di ogni riga, non quanto la riga guarda indietro.
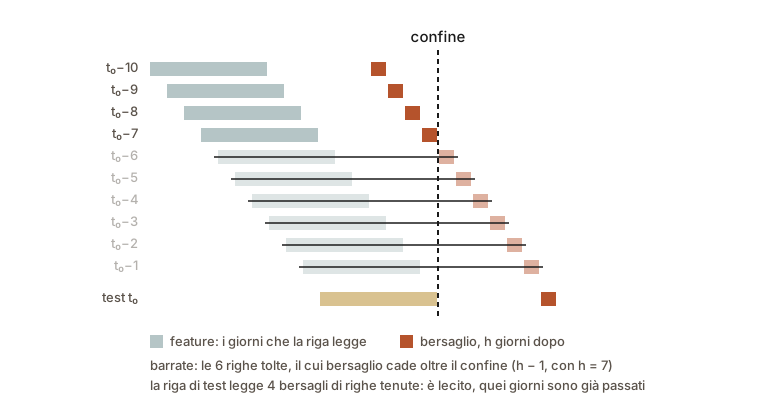
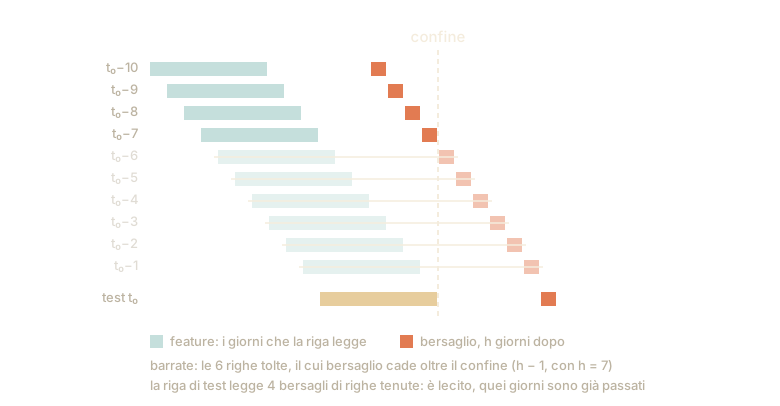
Fig. 34.9 Le ultime dieci righe di training e la prima di test, con un orizzonte di una settimana. Si tolgono le sei righe il cui bersaglio cade oltre il confine, una meno dei giorni d’anticipo; la riga di test legge fra le sue feature giorni che sono bersagli di righe tenute, e non è una fuga, perché quando si prevede quei giorni sono già passati.#
Prevedere più passi avanti#
Finora abbiamo parlato di un orizzonte, ma spesso servono molti passi: le vendite dei prossimi 30 giorni, non solo di domani. Ci sono tre strategie, con compromessi diversi.
Le prime due strade le abbiamo già incontrate nell’apertura del capitolo, con la temperatura di domenica, e adesso hanno un nome. La strategia ricorsiva è quella del lunedì previsto e trattato come misurato per arrivare a martedì: un solo modello a un passo, fatto girare a catena, economico ma con l’errore che si trascina. La strategia diretta è quella del metodo apposta per domenica: un modello diverso per ogni orizzonte, che non eredita gli errori degli altri. Costa tanti modelli, e c’è un guaio in più che l’apertura non diceva: nessuno di loro sa che cosa hanno risposto gli altri, e le previsioni, messe in fila, possono raccontare storie che non stanno insieme.
La strategia multi-output usa un unico modello che sputa fuori tutti i passi futuri in un colpo solo, tutti i trenta giorni insieme invece che uno per volta, e proprio perché escono insieme il modello può legare un giorno all’altro: è la via naturale per le reti neurali, che possono avere molte uscite.
Volendo prevedere \(h\) passi \(\hat{y}_{t+1}, \dots, \hat{y}_{t+h}\) a partire dalla riga \(t\), che legge fino a \(y_t\) compreso:
Ricorsiva (o iterata): si stima un solo modello a un passo \(\hat{y}_{t+1}=f(y_t, y_{t-1}, \dots)\) e lo si applica in cascata, reinserendo le proprie previsioni come input, \(\hat{y}_{t+2}=f(\hat{y}_{t+1}, y_t, \dots)\). Se il modello a un passo è approssimato, lo sbaglio si riapplica a ogni passo; se è lineare e ben specificato, la ricorsione è la previsione ottima.
Diretta: si addestra un modello distinto \(f_j\) per ciascun passo \(j=1,\dots,h\), con \(\hat{y}_{t+j}=f_j(y_t, y_{t-1}, \dots)\). Nessuno sbaglio di specificazione ereditato, ma \(h\) modelli da stimare, più varianza e nessuna coerenza imposta tra i passi.
Multi-output (MIMO): un’unica funzione a valori vettoriali \((\hat{y}_{t+1}, \dots, \hat{y}_{t+h}) = f(y_t, y_{t-1}, \dots)\), che modella congiuntamente le dipendenze tra gli orizzonti (la forma tipica delle reti neurali, con \(h\) neuroni in uscita).
L’incertezza che cresce con l’orizzonte non distingue fra le tre: fra \(t\) e \(t+h\) cadono \(h\) innovazioni ancora da osservare, qualunque strategia si scelga.
Non esiste una scelta sempre migliore, e la regola di prima resta sovrana: qualunque strategia si scelga, la si valuta col walk-forward, mai mescolando il tempo.
In pratica: walk-forward e MASE con NumPy#
Mettiamo insieme lo split walk-forward e la MASE in poche righe di NumPy, la libreria di calcolo numerico, e niente altro. La serie è inventata da noi, con una salita leggera e un ciclo di sette giorni. Confrontiamo due linee di base: il naive stagionale (ripete l’ultima settimana) e il naive semplice (ripete l’ultimo valore).
import numpy as np

def walk_forward_split(n, min_train, horizon):
    """Split cronologico a finestra espansa (walk-forward / backtesting):
    restituisce coppie (indici_train, indici_test) col test sempre nel futuro."""
    for t in range(min_train, n - horizon + 1, horizon):
        yield np.arange(t), np.arange(t, t + horizon)

def mase(y_vero, y_pred, scalatore):
    """MASE: MAE del modello sul test, diviso per lo scalatore, che è il MAE
    del naive a passo m calcolato in-sample sul training."""
    return np.mean(np.abs(y_vero - y_pred)) / scalatore

# --- serie sintetica: trend leggero + stagionalità settimanale + rumore ---
rng = np.random.default_rng(0)
n, m = 140, 7
t = np.arange(n)
serie = 10 + 0.05 * t + 3 * np.sin(2 * np.pi * t / m) + rng.normal(0, 0.4, n)

# Lo scalatore è il naive a passo m (la serie ha un ciclo di 7 giorni: il
# metro giusto è chi copia la settimana scorsa, non chi copia ieri) ed è
# fissato UNA volta sul training iniziale, così i MASE dei vari giri sono
# tutti espressi nella stessa unità e si possono mediare.
scalatore = np.mean(np.abs(serie[m:28] - serie[:28 - m]))
scalatore_1 = np.mean(np.abs(serie[1:28] - serie[:27]))   # il metro a un passo

mase_stagionale, mase_semplice = [], []
mase_stag_1, mase_sempl_1 = [], []          # gli stessi due, con l'altro metro
for idx_train, idx_test in walk_forward_split(n, min_train=28, horizon=m):
    storia, futuro = serie[idx_train], serie[idx_test]
    # naive stagionale: ricicla l'ultimo ciclo osservato. np.resize lo ripete
    # quanto serve se l'orizzonte supera m: e' la formula con k, in NumPy
    pred_stagionale = np.resize(storia[-m:], len(futuro))
    pred_semplice = np.full(len(futuro), storia[-1])   # ripeti l'ultimo valore
    mase_stagionale.append(mase(futuro, pred_stagionale, scalatore))
    mase_semplice.append(mase(futuro, pred_semplice, scalatore))
    mase_stag_1.append(mase(futuro, pred_stagionale, scalatore_1))
    mase_sempl_1.append(mase(futuro, pred_semplice, scalatore_1))

print(f"iterazioni di walk-forward: {len(mase_stagionale)}")
print(f"MASE medio - naive stagionale: {np.mean(mase_stagionale):.3f}")
print(f"MASE medio - naive semplice:   {np.mean(mase_semplice):.3f}")
print("con il metro a un passo invece che a sette:")
print(f"MASE medio - naive stagionale: {np.mean(mase_stag_1):.3f}")
print(f"MASE medio - naive semplice:   {np.mean(mase_sempl_1):.3f}")

# lo stesso conto su dieci semi: lo scalatore e' stimato su ventun differenze
# sole, quindi il metro balla, ed e' bene sapere di quanto
def mase_stagionale_con(seme):
    rng = np.random.default_rng(seme)
    s = 10 + 0.05 * t + 3 * np.sin(2 * np.pi * t / m) + rng.normal(0, 0.4, n)
    sc = np.mean(np.abs(s[m:28] - s[:28 - m]))
    return np.mean([mase(s[te], np.resize(s[tr][-m:], len(te)), sc)
                    for tr, te in walk_forward_split(n, 28, m)])

su_dieci = [mase_stagionale_con(seme) for seme in range(10)]
print(f"su dieci semi diversi: da {min(su_dieci):.2f} a {max(su_dieci):.2f}")
iterazioni di walk-forward: 16
MASE medio - naive stagionale: 1.056
MASE medio - naive semplice:   5.058
con il metro a un passo invece che a sette:
MASE medio - naive stagionale: 0.343
MASE medio - naive semplice:   1.643
su dieci semi diversi: da 0.81 a 1.36
Il naive stagionale esce a \(1{,}06\), cioè attorno a uno, ed era prevedibile: su una serie con un ciclo settimanale il metro è lui, quindi sta pareggiando con sé stesso. Attorno, non esattamente: il denominatore è stimato su ventun differenze sole, e su dieci semi diversi il valore oscilla fra \(0{,}81\) e \(1{,}36\). Il naive semplice, cieco alla settimana, sta a \(5{,}06\): sbaglia cinque volte tanto. La morale è che su una serie stagionale il metro giusto è quello, e chi non lo batte non ha un modello.
La scelta del metro cambia il verdetto, ed è una scorciatoia che si incontra spesso: mettendo sotto la linea di frazione il naive a un passo invece che a sette, gli stessi due predittori escono a \(0{,}343\) e \(1{,}643\), come stampano le ultime due righe, e il primo sembrerebbe bravissimo. Non ha previsto meglio di prima: è cambiato il righello. È la lettura che rende la MASE preziosa e insieme la sua unica insidia: un numero senza unità dice al volo se un modello vale più della pigrizia, purché si dichiari quale pigrizia.
Da ricordare
Mescolare i dati di una serie, la cosa che altrove si fa sempre, qui falsa quasi sempre la misura. Mettere futuro e passato nello stesso mucchio è come far esercitare lo studente sul 4 e sul 5 marzo e poi interrogarlo sul 3: la previsione sembrerà miracolosa, e non lo è. Ogni dato su cui ci si allena deve venire prima, nel tempo, di ogni dato su cui si verifica.
Si valuta provando all’indietro (backtesting): ci si mette in un giorno del passato, si prevede il seguito, si confronta con quello che è successo, e poi si sposta quel giorno in avanti e si rifà. Il pezzo su cui ci si allena può allungarsi ogni volta (finestra espansa) o restare lungo uguale e scivolare in avanti (finestra scorrevole), come nella Fig. 34.6. Anche le manopole del modello si regolano a ogni giro, guardando solo il prima.
Le misure d’errore che dipendono dall’unità della serie (500 è ottimo per il PIL e disastroso per la temperatura) non si possono confrontare fra serie diverse. La percentuale toglie l’unità di misura ma ha guai suoi, a partire dalle scale il cui zero non è uno zero vero. Quella che funziona è la MASE: dice di quanto sbagli rispetto a chi copia e basta, e se viene 1 sbagli quanto lui, se viene \(0{,}5\) la metà. Non è però un duello alla pari, perché chi copia corre a un passo solo e sulla strada già percorsa: sbagliare quanto lui su dodici giorni avanti è tutt’altra impresa che su domani. E va detto quale pigrizia si è messa al denominatore, perché su una serie con un ciclo settimanale il paragone giusto è con chi copia la settimana scorsa, e cambiando paragone cambia il verdetto.
Vanno sempre battute le linee di base: chi risponde sempre la media, chi copia l’ultimo valore, chi copia il ciclo precedente, chi prolunga la retta fra il primo e l’ultimo punto. Se il modello non le supera, non serve.
Una serie si trasforma in una tabella dando al modello, per ogni giorno, un riassunto del suo passato recente: i valori dei giorni prima, le medie degli ultimi giorni, il calendario, e poche onde regolari per dire a che punto del ciclo siamo. Mai niente che venga dal futuro, nemmeno di striscio; e al confine fra i giorni d’allenamento e quelli di prova la regola si viola da sé, perché le ultime righe d’allenamento chiedono di giorni che cadono già di là. Si buttano via, una meno dei giorni d’anticipo, ed è la purga.
Per prevedere molti giorni ci sono tre modi: uno alla volta rimettendo dentro la propria previsione (ricorsivo: economico, ma l’errore si trascina), un modello per ciascun giorno futuro (diretto: robusto, ma costa), o un modello solo che li sputa fuori tutti insieme (multi-output).
Una previsione che dichiara una forbice («fra 22 e 26 gradi») di solito la dichiara più stretta di quanto sarebbe onesto, perché i suoi conti trattano come certi i numeri del modello e il modello stesso. Il verso non è però sempre quello: con salti rari e grandi, una forbice stretta può coprire più di quanto promette, e una larghissima copre sempre meno. Si controlla contando quante volte il valore vero cade davvero dentro: e qui, a differenza degli altri numeri, non si punta al più alto né al più basso. Deve venire proprio quello promesso, perché una forbice larga il doppio copre quasi sempre e non dice più niente.
Da ricordare
Con le serie temporali la cross-validation con shuffle produce leakage, con stime dell’errore troppo ottimiste, salvo un caso stretto: modello puramente autoregressivo con errori incorrelati [BHK18]. Ogni dato di training deve precedere nel tempo ogni dato di validazione, e al confine la regola va difesa con la purga (con la riga \(t\) che legge fino a \(y_t\) e il bersaglio \(y_{t+h}\), le \(h-1\) righe il cui bersaglio cade oltre l’ultimo istante noto alla prima riga di test, cioè
gap\(= h-1\)), non con l’embargo, che qui non ha nulla da proteggere.Si valida col walk-forward (backtesting): split cronologici ripetuti col test sempre nel futuro, a finestra espansa (tutto il passato) o scorrevole (ampiezza fissa) [HA21]. Gli iperparametri si scelgono dentro lo schema, su ogni training, con un walk-forward annidato.
MAE e RMSE dipendono dalla scala; la MAPE ha problemi con gli zeri ed è asimmetrica, e la sMAPE non attenua quell’asimmetria, la rovescia; la MASE [HK06] scala l’errore su quello del naive in-sample a passo \(m\) ed è adimensionale, ma il denominatore è una scala, non un avversario: dichiarare quale \(m\) si è usato è parte del numero. Per le previsioni probabilistiche si usa la pinball loss, che è un punteggio proprio ma premia insieme calibrazione e finezza: la calibrazione si controlla a parte, con la copertura empirica, che a differenza di tutte le altre non si minimizza né si massimizza, deve coincidere col livello dichiarato.
Vanno sempre battute le linee di base: media, naive, naive stagionale (\(\hat y_{T+h} = y_{T+h-m(k+1)}\), con \(k = \lfloor (h-1)/m \rfloor\)), drift. Se il modello non le supera, non serve.
Il feature engineering temporale (lag, finestre mobili, calendario, termini di Fourier) riduce il forecasting a un problema supervisionato tabellare, senza mai usare informazione dal futuro, comprese le statistiche usate per scalare le colonne.
Per il multi-step si sceglie tra strategia ricorsiva (economica, ottima se il modello a un passo è ben specificato, ma se non lo è lo sbaglio si riapplica a ogni passo), diretta (un modello per orizzonte, più varianza) e multi-output (un solo modello, tutti i passi).
Le bande di previsione escono di solito troppo strette, perché il loro calcolo tratta come certi i parametri stimati, il modello scelto e la persistenza delle regolarità [HA21]. La normalità degli scarti è un’ipotesi a parte, il cui verso dipende dal livello: con code pesanti una banda nominale all’80% copre di più, una al 99% di meno. Messa insieme alla stima dei parametri, sulle bande strette il segno dell’errore dipende da storia, orizzonte e code, sulle larghe la sottostima si somma. Su un AR(1) gaussiano con trenta osservazioni e parametri stimati ai minimi quadrati, un intervallo nominale all’80% copre il 77,7% a un passo e il 73,8% a cinque.