


La legge dentro la loss#
Dalla sezione sui tensori e su autograd in poi, la differenziazione automatica di PyTorch ha calcolato quasi sempre una sola famiglia di derivate: quelle della loss rispetto ai pesi, \(\partial\mathcal{L}/\partial\theta\), cioè la risposta alla domanda se ritocco questo peso, quanto cambia l’errore? Milioni di volte la stessa domanda, per addestrare classificatori, traduttori, generatori.
Autograd però non sa che cosa siano «i pesi». Deriva qualunque grandezza del calcolo rispetto a qualunque tensore che vi compare, e la stessa sezione sui tensori lo ha mostrato su \(y = x^3\), con la derivata prima e la seconda. La domanda si può quindi cambiare, e puntare sull’ingresso della rete.
Prendiamo una rete che riceve un istante di tempo \(t\) e restituisce un numero \(u_\theta(t)\), per esempio la posizione di un oggetto in quell’istante (\(\theta\) sta per tutti i pesi della rete messi insieme): disegnata su un foglio, è una curva. La derivata dell’uscita rispetto all’ingresso, \(u_\theta'(t)\), è la pendenza della curva in quel punto, cioè quanto in fretta sta salendo o scendendo proprio lì; derivando ancora si ottiene \(u_\theta''(t)\), la curvatura, cioè quanto in fretta cambia la pendenza, quanto la curva piega. Autograd le restituisce esatte, a meno dell’arrotondamento della macchina, e non come rapporti fra i valori in due istanti vicini, che è il modo in cui una pendenza si stima di solito.
La rete diventa così una funzione di cui si conoscono, in ogni punto, il valore, la pendenza e la curvatura, ed è esattamente ciò che serve per chiederle di rispettare un’equazione differenziale, che di quelle tre cose parla e non d’altro. Perché la curvatura esista dappertutto, però, la curva non deve avere spigoli (in matematica: dev’essere derivabile due volte), e questo dipende dalla funzione di attivazione che la rete applica fra uno strato e l’altro: prima di scrivere il codice bisognerà sceglierla con cura.
Tutto il metodo delle PINN sta in questa mossa, chiedere le derivate rispetto all’ingresso invece che ai pesi: la tecnica è quella di sempre, nuovo è l’uso che se ne fa, imporre un’equazione. Vediamola all’opera.
Tre vincoli e una penalità#
L’idea si capisce meglio raccontandola come un compito in classe.
Uno studente ha un compito insolito: disegnare, su un foglio a quadretti, la curva di una molla che oscilla, cioè di quanto il corpo appeso è spostato dalla sua posizione di riposo, istante per istante. Il tempo scorre verso destra; la riga di mezzo è il riposo, sopra il corpo è più in alto, sotto più in basso. Nessuna tabella di valori da copiare. Solo tre vincoli:
la curva deve partire dal punto giusto (la molla è stata tirata fino a una certa altezza);
deve partire in piano, cioè con pendenza zero (il corpo è stato lasciato andare da fermo: se non si muove, la curva non sale né scende);
in ogni punto del foglio deve rispettare la regola della molla: quanto la curva piega in quel punto dev’essere coerente con quanto è alta e con quanto sta scendendo lì («coerente» vuol dire che c’è una formula che lega le tre cose, e la scriveremo con i numeri veri).
Il professore corregge in modo semplice e spietato: controlla la partenza, poi punta il dito su una manciata di istanti e lì verifica la regola; ogni violazione costa punti. Quegli istanti li ha sorteggiati una volta sola, all’inizio, e da lì in poi controlla sempre quelli: sembra un dettaglio da bidello, e sarà la chiave di tutto. Lo studente ritocca la curva e riconsegna, ancora e ancora, finché i punti persi non si riducono a briciole.
E qui sta la stranezza: nessuno dei due conosce la soluzione. Il professore sa solo verificare la partenza e la regola. Eppure la curva giusta può saltare fuori, perché tra tutte le curve possibili quella vera è l’unica che parte così e rispetta la regola dappertutto. Una PINN è esattamente questo studente: la curva è la rete, i punti persi sono la loss, e gli istanti su cui il professore punta il dito si chiamano punti di collocazione.
C’è però una scorciatoia. Anche una riga piatta sul riposo rispetta la regola (un corpo fermo al centro resta fermo), e un foglio così perde soltanto i punti della partenza. Per questo il professore, come si usa con questi compiti, fa pesare la partenza cento volte le altre voci. È una scommessa, però, e non una garanzia: lo studente può rispettare la partenza e poi, per sistemare il resto del foglio, scivolare subito verso la riga piatta, pagando la regola solo nel breve tratto in cui scende. Il peso in più non basta sempre a tenerlo sulla strada giusta.
Su quel «dappertutto» conviene tenere un dito, perché è la parola su cui si gioca tutto. La curva vera rispetta la regola in ogni singolo punto del foglio; il professore la controlla in una manciata di punti soltanto. Sono due cose diverse, e ci costeranno care.
Sia \(u_\theta : [0, T] \to \mathbb{R}\) una rete neurale con parametri \(\theta\), candidata a risolvere un’equazione differenziale che scriviamo in forma compatta \(\mathcal{N}[u](t) = 0\), dove \(\mathcal{N}\) raccoglie l’operatore differenziale dell’equazione, con condizioni iniziali \(u(0) = u_0\) e \(u'(0) = v_0\). Il residuo della candidata è \(r_\theta(t) = \mathcal{N}[u_\theta](t)\): vale zero esattamente dove la rete rispetta l’equazione. La loss da minimizzare è
dove i \(t_j\) sono gli \(N_c\) punti di collocazione (istanti sparsi nel dominio, casuali o equispaziati, nei quali esigiamo il rispetto dell’equazione) e \(\lambda_0 > 0\) bilancia i due termini. Lo chiamiamo \(\lambda_0\), e non \(\lambda\), perché non è lo stesso peso della loss vista in apertura di capitolo: là \(\lambda\) moltiplicava il termine di fisica, qui il peso sta sulle condizioni iniziali. Dove metterlo è convenzione; ciò che conta è il rapporto fra i termini. Per una PDE su un dominio spaziale si aggiunge un termine identico per le condizioni al contorno, con punti campionati sul bordo; e se esistono misure \((t_i, u_i)\) si aggiunge il termine dati \(\frac{1}{N_d}\sum_{i=1}^{N_d} \big(u_\theta(t_i) - u_i\big)^2\), come nella loss vista in apertura di capitolo. Tutte le derivate che compaiono in \(r_\theta\) (per noi \(u_\theta'\) e \(u_\theta''\)) le fornisce la differenziazione automatica rispetto all’ingresso \(t\): esatte, senza rapporti incrementali né passo di discretizzazione.
Il termine di fisica, da solo, ha un minimo banale, perché la funzione \(u \equiv 0\) risolve l’equazione omogenea con residuo nullo ovunque. Il termine sulle condizioni iniziali serve dunque a selezionare, dentro la famiglia delle soluzioni dell’equazione (per una lineare del secondo ordine come quella della molla che ci farà da banco di prova, uno spazio a due dimensioni), proprio la nostra: senza di esso nulla distingue la traiettoria che parte da \(u(0)=1\) da quella che se ne sta ferma a zero. Attenzione però a non promettere troppo: nemmeno con quel termine il minimizzatore della loss è unico in senso stretto. Con \(N_c\) punti di collocazione finiti, infinite funzioni annullano il residuo in quei punti e rispettano le due condizioni iniziali; la soluzione vera è l’unico minimo globale se ci si restringe alle soluzioni dell’equazione, ovvero nel limite in cui il residuo è controllato su tutto il dominio e non solo sul campione. Nel mezzo dovrebbe pensarci la regolarità della rete, che a rigore non le impedisce affatto di oscillare fra un punto di collocazione e il successivo: è un argomento asintotico, vale infittendo i punti, e a \(N_c\) finito garantisce assai meno di quanto sembri. Ecco perché i punti vanno abbastanza fitti rispetto alle scale della soluzione, e perché fra poche pagine vedremo una rete addestrata così infilare un picco di residuo proprio nel buco fra due punti di controllo.
Per un’equazione lineare la grandezza che controlla l’errore si scrive in una riga. Sia \(e = u_\theta - u\) lo scarto dalla soluzione esatta della molla che useremo come banco di prova, \(m u'' + c u' + k u = 0\), sottosmorzata. Poiché \(u\) risolve l’equazione omogenea, lo scarto risolve \(m e'' + c e' + k e = r_\theta\), con \(e(0) = u_\theta(0) - u_0\) ed \(e'(0) = u_\theta'(0) - v_0\), e per variazione delle costanti \(e(t) = e_h(t) + \int_0^t G(t - s)\, r_\theta(s)\,\mathrm{d}s\), dove \(e_h\) è la soluzione omogenea con i dati iniziali dello scarto e \(G(\tau) = e^{-\gamma\tau}\sin(\omega_d\tau)/(m\,\omega_d)\) è la funzione di Green, con \(\gamma\) e \(\omega_d\) il tasso di decadimento e la pulsazione che la sezione sulla molla ricaverà. Poiché \(|G| \le 1/(m\,\omega_d)\),
L’errore è controllato dagli scarti iniziali e dall’integrale del residuo su tutto l’intervallo (a sua volta, per Cauchy-Schwarz, non più grande di \(\sqrt{T\int_0^T r_\theta^2}\), la versione continua del termine di fisica), non dalla media di \(r_\theta^2\) sui punti di collocazione: la loss stima quell’integrale con \(N_c\) campioni, e un picco stretto che cade fra due di essi pesa nell’integrale e non nella loss. La differenza fra le due quantità è il divario di generalizzazione della PINN.
Perché allora in pratica si sceglie \(\lambda_0\) ben maggiore di 1? La ragione che se ne dà non è selezionare il minimo, ma raggiungerlo: i due termini non pesano allo stesso modo sulla discesa, e il rischio è che i pesi si muovano quasi solo nella direzione dettata dalla fisica, trascurando l’unico ancoraggio che c’è. Le ragioni per cui succede sono due, e conviene tenerle distinte perché non agiscono sempre insieme.
La prima è l’ampiezza dei gradienti. Il residuo si ottiene applicando alla rete degli operatori differenziali, e i gradienti che tornano indietro da quel ramo possono essere di ordini di grandezza più grandi di quelli del termine sulle condizioni iniziali. Wang, Teng e Perdikaris lo documentano su equazioni come quella di Helmholtz in due dimensioni, dove l’hessiana del termine di fisica ha autovalori fino a \(10^5\) e domina la rigidezza del flusso del gradiente, e lo correggono con pesi ristimati durante l’addestramento [WTP21]. Sull’oscillatore che ci fa da banco di prova, però, il divario misurato è molto più modesto. All’inizializzazione, cioè nel momento in cui \(\lambda_0\) va scelto, il rapporto fra le ampiezze medie dei gradienti dei due rami (la media di \(|\partial \mathcal{L}_{\text{fisica}} / \partial \theta|\) su tutti i pesi, contro la stessa media per il termine sulle condizioni iniziali preso senza \(\lambda_0\), sui semi da 0 a 19) ha mediana \(2{,}4\), e in quattro semi su venti è addirittura rovesciato. Su una ODE del secondo ordine con due scalari imposti al tempo zero, «ordini di grandezza» sarebbe una parola grossa.
La seconda, ed è quella che qui morde davvero, riguarda la direzione dei
gradienti più che la loro ampiezza. Il residuo in un istante tardo, poniamo
\(t_j = 8\), non sa niente della partenza: lo annulla qualunque soluzione
dell’equazione, compresa \(u \equiv 0\), e il gradiente che ne arriva spinge la
rete verso quella più vicina, che all’inizializzazione è quasi sempre la curva
piatta. L’informazione di \(u(0)=1\) dovrebbe invece propagarsi in avanti
attraverso il residuo, un tratto dopo l’altro, e la discesa del gradiente non ha
alcun motivo di rispettare quell’ordine. Wang, Sankaran e Perdikaris lo chiamano
violazione della causalità, e lo correggono pesando il residuo di ogni istante
con \(w_j = \exp\!\big(-\varepsilon \sum_{t_k < t_j} r_\theta(t_k)^2\big)\),
calcolati a gradiente fermo (in PyTorch con .detach(): se il gradiente li
attraversasse, la discesa spegnerebbe un istante alzando i residui di quelli
prima), così che un istante conti solo quando quelli che lo precedono sono già
risolti [WSP24]. Infittire i punti di collocazione non sposta
questa bilancia (entrambi i termini restano medie); la sposta l’ordine in cui i
vincoli vengono soddisfatti.
Nel primo caso il rimedio è dare voce al termine debole con un peso più grande; nel secondo è cambiare l’ordine in cui la discesa soddisfa i vincoli, e un peso sulla sola partenza non basta a imporlo. E in tutti e due i casi la manopola (\(\lambda_0\), o la \(\varepsilon\) dei pesi causali) si sceglie a mano, provando. È il primo dei limiti che la sezione su dove la fisica aiuta e dove no mette in fila.
Attenzione però a non dare per scontato l’effetto. Sull’oscillatore il moltiplicatore non garantisce l’ancoraggio, perché a \(\lambda_0 = 1\) la rete rispetta le condizioni iniziali lo stesso, e non assicura nemmeno il percorso: sugli stessi dieci semi le corse che collassano sono cinque con \(\lambda_0 = 1\) e cinque con \(\lambda_0 = 100\), e fra le riuscite la mediana sbaglia di \(7 \cdot 10^{-3}\) con 1 e di \(0{,}25\) con 100 (lo stampa il confronto fra semi). Un peso grande sulla partenza, qui, costa precisione senza ridurre i fallimenti: è una regola d’uso da verificare caso per caso, non una garanzia.

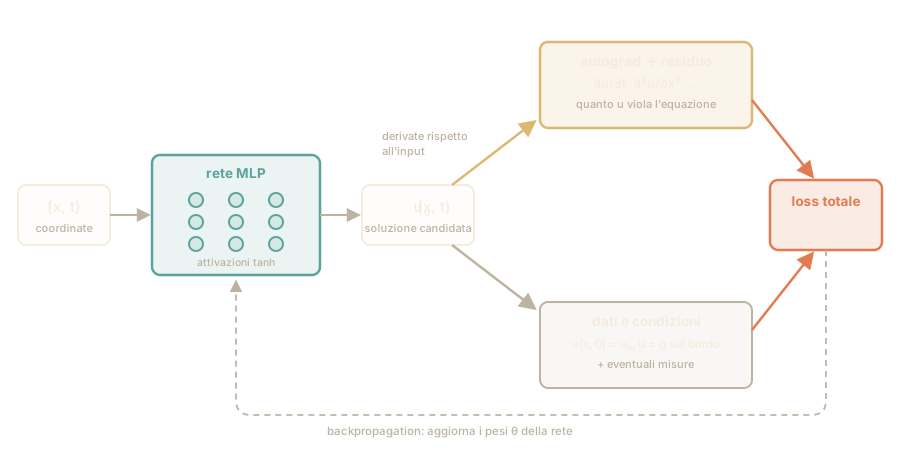
Fig. 35.1 L’anatomia di una PINN, da sinistra a destra: le coordinate entrano nella rete, che risponde con la curva candidata; da lì partono due controlli, quello della regola fisica (in alto) e quello delle condizioni di partenza, dei bordi e delle eventuali misure (in basso); i due si sommano in un punteggio unico, e la correzione torna indietro fino ai pesi della rete.#
La Fig. 35.1 riassume il metodo. La rete \(u_\theta\) riceve le coordinate e restituisce la candidata, e da lì partono due rami. In alto autograd ne calcola le derivate rispetto all’ingresso, e con quelle si misura di quanto la candidata viola l’equazione; in basso la si confronta con le condizioni di partenza, con quelle al bordo (\(u = g\), dove \(g\) è il valore che la soluzione deve assumere lì) e con le eventuali misure. I due contributi si sommano nella loss \(\mathcal{L}\), che si minimizza rispetto ai pesi \(\theta\). Il simbolo nuovo è la derivata parziale \(\partial\), che serve quando la grandezza dipende da più variabili: la temperatura della sbarra di ferro dell’apertura del capitolo cambia sia lungo il ferro sia nel tempo, e \(\partial u / \partial t\) è la sua variazione nel tempo a posizione fissata.
Lo scarto fra i due lati dell’equazione, quello che il ramo in alto calcola in
ogni punto, si chiama residuo, \(r_\theta(t)\): è lo stesso oggetto che nel
racconto del compito in classe erano i punti persi per una violazione della
regola. La media dei suoi quadrati sui punti di collocazione è il termine di
fisica della loss, \(\mathcal{L}_{\text{fisica}}\) (loss_fisica nel codice). Il
quadrato serve a due cose, a contare uguale una violazione in su e una in giù,
e a far pesare di più quelle grosse; e la conseguenza da tenere a mente è che
la loss di fisica cresce con il quadrato della violazione. Se il residuo vale 3
in un punto e 1 in un altro, i due contano 9 e 1: una loss cento volte più alta
vuol dire una violazione dieci volte più grossa.
Lo schema è disegnato nel caso generale, quello di un’equazione con una coordinata di spazio e una di tempo; nel resto della sezione lavoreremo sul caso più semplice, con il solo tempo in ingresso. Le derivate rispetto all’ingresso altrove sono un accessorio (il gradient penalty delle GAN deriva rispetto all’ingresso del critico); qui sono il motore.
Una molla come banco di prova#
Ci serve un problema abbastanza semplice da avere una soluzione esatta con cui dare i voti alla rete, e abbastanza ricco da non essere un giocattolo. Il classico dei classici: l’oscillatore armonico smorzato, cioè un corpo appeso a una molla, con un po’ d’attrito che spegne piano piano le oscillazioni. La legge di Newton per questo sistema è
dove \(u(t)\) è lo spostamento dalla posizione di riposo, \(u'\) e \(u''\) sono la pendenza e la curvatura di poco fa, \(m\) è la massa, \(c\) il coefficiente di smorzamento (l’attrito) e \(k\) la rigidezza della molla. Quel «\(= 0\)» chiede una cosa sola: in ogni istante i tre pezzi, sommati, devono dare zero. È la regola che la curva deve rispettare punto per punto. La riga a destra, \(u(0)=1\) e \(u'(0)=0\), dice invece da dove si parte: al tempo zero il corpo è spostato di 1 e viene lasciato andare da fermo. Di 1 che cosa non importa, perché non l’abbiamo mai fissato: centimetri, metri, quello che si preferisce. Tutti gli scarti che seguono andranno letti nella stessa unità, come frazioni di quello spostamento iniziale. Scegliamo poi numeri concreti per la molla: \(m = 1\), \(c = 0{,}4\), \(k = 4\).
Prima di leggere l’equazione, saldiamo i due vocabolari. La curva sul foglio è il movimento del corpo appeso: la sua pendenza è la velocità (quanto in fretta il corpo si sposta) e la sua curvatura è l’accelerazione (quanto in fretta cambia quella velocità). Due nomi diversi, un oggetto solo. È il motivo per cui una regola sul moto di un corpo si può far rispettare a una linea tracciata su un foglio.
Adesso l’equazione si legge come una regola di buon senso. Portiamo a destra tutto tranne il primo pezzo; la massa vale 1 e non si vede, e resta: accelerazione \(= -4 \times\) posizione \(- 0{,}4 \times\) velocità. Due forze, cioè. La molla richiama sempre verso il centro, tanto più forte quanto più sei lontano, ed è il fattore 4; l’attrito frena sempre, tanto più quanto più vai veloce, ed è il fattore 0,4. I due segni meno dicono che tutte e due tirano all’indietro: la molla contro lo spostamento, l’attrito contro il movimento. Il conto a mano sull’istante iniziale: posizione 1, velocità 0, quindi accelerazione \(= -4 \cdot 1 - 0{,}4 \cdot 0 = -4\), e il corpo parte richiamato con decisione verso il centro.
Il film lo conosce chiunque abbia giocato con una molla: il corpo oscilla su e giù, e ogni oscillazione è più bassa della precedente, perché l’attrito ruba energia a ogni passaggio. Con i nostri tre numeri un’oscillazione completa dura 3,16 secondi, e dopo 10 secondi l’ampiezza (l’altezza del rimbalzo, misurata dalla posizione di riposo) è scesa al 13,5% di quella di partenza. L’attrito è debole: dieci volte tanto, e i rimbalzi sparirebbero del tutto, con il corpo che torna piano al centro e si ferma.
Nessuno dei due valori viene da un laboratorio: escono dai tre numeri della molla. La durata di un’oscillazione la decide la rigidezza rispetto alla massa, e conta la radice di quel rapporto: una molla quattro volte più dura oscilla due volte più in fretta. Il calo lo decide l’attrito, e sempre allo stesso ritmo: ogni secondo l’ampiezza perde poco meno di un quinto di quello che ha, e a forza di perdere quella quota si dimezza ogni 3,47 secondi. In dieci secondi di dimezzamenti ce ne stanno quasi tre, da 1 a poco più di un ottavo, cioè al 13,5% che resta. Questa è la curva che lo studente del compito in classe deve disegnare, e che la nostra rete dovrà imparare senza vederne neppure un punto, tranne la partenza.
È un’equazione lineare del secondo ordine a coefficienti costanti: si risolve con l’equazione caratteristica \(m s^2 + c s + k = 0\), ovvero \(s^2 + 0{,}4\,s + 4 = 0\) (la lettera \(s\), e non \(r\), che in questo capitolo è già il residuo). Il discriminante è negativo (\(0{,}16 - 16 < 0\)): radici complesse coniugate \(s = -\gamma \pm i\,\omega_d\), con
dove \(\gamma\) è il tasso di decadimento e \(\omega_d\) la pulsazione smorzata, appena più lenta della pulsazione naturale \(\omega_0 = \sqrt{k/m} = 2\): il fattore di smorzamento vale \(\zeta = \gamma/\omega_0 = 0{,}1\), smorzamento debole. La soluzione generale è \(e^{-\gamma t}(A\cos\omega_d t + B\sin\omega_d t)\); imponendo \(u(0)=1\) si ottiene \(A = 1\), imponendo \(u'(0)=0\) si ottiene \(B = \gamma/\omega_d \approx 0{,}1005\). Quindi
Verifica dei conti: \(u(0) = 1 \cdot (1 + 0) = 1\); derivando, \(u'(0) = -\gamma \cdot 1 + \omega_d \cdot \gamma/\omega_d = -0{,}2 + 0{,}2 = 0\). Tornano entrambe. Il periodo vale \(2\pi/\omega_d \approx 3{,}16\) e l’inviluppo \(e^{-\gamma t}\) dimezza ogni \(\ln 2/\gamma \approx 3{,}47\) s, quindi vale \(e^{-2} \approx 0{,}135\) per \(t = 10\): in tre oscillazioni abbondanti l’ampiezza cala al 13,5% di quella iniziale. Questa formula sarà la pagella con cui giudicheremo la PINN.
La curva dev’essere liscia: perché tanh e non ReLU#
Prima di scrivere la rete c’è una scelta da fare, e in ogni altro capitolo del libro sarebbe stata automatica. Una rete non è fatta solo di somme: fra uno strato e l’altro ogni numero passa attraverso una funzioncina che lo piega, la funzione di attivazione, ed è lei a decidere che forma possono avere le curve che la rete sa disegnare. Dalla sezione sulle funzioni di attivazione in poi abbiamo usato quasi sempre la stessa, la ReLU, che è la scelta giusta praticamente ovunque. Qui è squalificata in partenza, e Fig. 35.2 mostra il motivo.
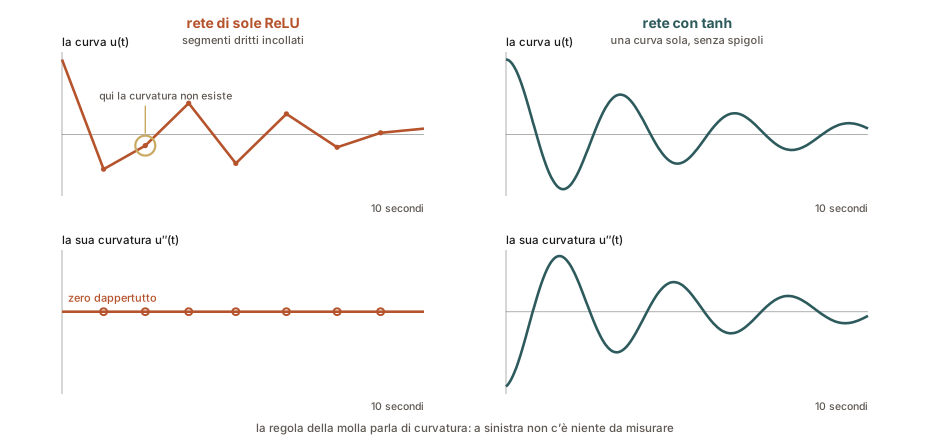
Fig. 35.2 Sopra, la stessa oscillazione disegnata da due reti diverse; sotto, la curvatura di ciascuna. Una rete di sole ReLU sa solo incollare tratti dritti, e un tratto dritto non piega: la riga in basso a sinistra resta appoggiata sullo zero, con un buco in ogni vertice. La tanh piega dappertutto, e la sua curvatura è a sua volta una curva.#
La curva dev’essere liscia, e la ReLU non sa disegnare curve lisce. La
ReLU è fatta di due tratti dritti attaccati in un angolo, e una rete di sole
ReLU produce curve fatte così: segmenti dritti incollati uno dopo l’altro,
come una spezzata. Il motivo è che la ReLU non piega mai: taglia in un punto e
per il resto lascia dritto. E sommando tratti dritti si ottengono ancora
tratti dritti, quindi con tanti neuroni i pezzi diventano tantissimi, ma
restano pezzi dritti. Una spezzata però non ha curvatura da nessuna parte,
perché un tratto dritto non piega, e negli angoli, dove piegherebbe, la
curvatura non si riesce nemmeno a calcolare. Ma la regola della molla parla
proprio di curvatura, che ne è anzi il termine principale: con una curva a
spezzata il professore non vedrebbe più il pezzo più importante della regola,
e darebbe voti alti a curve che con la molla non c’entrano niente. Serve
dunque una funzioncina che
pieghi dolcemente dappertutto, senza angoli. Quella che si usa è una S
sdraiata e centrata nello zero: viene su da sinistra dove è quasi piatta, si
impenna passando per il centro e torna a spianarsi a destra, e in nessun punto
ha uno spigolo. Si chiama tanh e nel programma si scrive
nn.Tanh(). Nel resto del deep learning la ReLU l’aveva mandata
in pensione; qui si prende la rivincita.
La ReLU è fatta di due semirette: una rete di sole ReLU calcola una funzione
lineare a tratti, la cui derivata prima è a gradini e la cui derivata
seconda è zero quasi ovunque («quasi» perché nei punti di piega non esiste
affatto, e sono un insieme di misura nulla, quindi in pratica la si legge come
zero dappertutto). Quante siano quelle regioni, e
come crescano con la profondità, lo conta la sezione «Quante regioni taglia
una rete» del capitolo sul deep learning. Ma
nel nostro residuo compare \(u''\): per una rete ReLU verrebbe zero ovunque
autograd riesca a calcolarlo, e il termine principale dell’equazione
diventerebbe invisibile alla loss. E il modo in cui fallisce merita una riga:
chiedendo a autograd la derivata seconda di una rete ReLU non si ottiene un
errore né un None, si ottengono zeri, e da quegli zeri nessun peso riceve
più una spinta. Il termine c’è, costa il suo tempo di calcolo e non muove
nulla: un guasto perfettamente silenzioso. La tanh, al contrario, è
liscia (derivabile infinite volte, con derivate continue a ogni ordine) e
infatti è la scelta standard delle PINN; funzionano anche il seno e la
softplus (una versione arrotondata della ReLU), perché il requisito, qui, è la
regolarità. Il che non vuol dire che siano intercambiabili: le attivazioni
periodiche cambiano quali frequenze la rete impara in fretta, ed è un effetto
di cui la sezione sui limiti si serve come rimedio.
La condizione dipende dall’ordine \(p\) dell’equazione: il residuo contiene derivate della rete fino all’ordine \(p\), e l’attivazione deve averne altrettante continue. Con la ReLU un’equazione del primo ordine si addestra ancora (la derivata della rete è costante a tratti, il residuo è discontinuo ma il gradiente rispetto ai pesi non si annulla); dal secondo ordine in poi la derivata che serve vale zero quasi ovunque, ed è il caso della molla.
La PINN, riga per riga#
Il codice è completo ed eseguibile, e viene in tre pezzi: prima la preparazione, poi il cuore (le derivate rispetto all’ingresso), infine il confronto con la soluzione esatta.
import numpy as np
import torch
from torch import nn

torch.manual_seed(42)

# Parametri fisici della molla: massa, smorzamento, rigidezza
m, c, k = 1.0, 0.4, 4.0

# La candidata soluzione: un MLP che da t produce u(t)
rete = nn.Sequential(
    nn.Linear(1, 32), nn.Tanh(),
    nn.Linear(32, 32), nn.Tanh(),
    nn.Linear(32, 32), nn.Tanh(),
    nn.Linear(32, 1),
)

# Punti di collocazione: 200 istanti a caso in [0, 10]
t_c = 10.0 * torch.rand(200, 1)     # shape (200, 1)
t_c.requires_grad_(True)            # derivate RISPETTO ALL'INPUT

# L'istante iniziale, dove imporremo u(0)=1 e u'(0)=0
t_0 = torch.zeros(1, 1, requires_grad=True)

ottimizzatore = torch.optim.Adam(rete.parameters(), lr=1e-3)
Due righe meritano una sosta. t_c.requires_grad_(True) chiede ad autograd
di tracciare le derivate rispetto all’ingresso, non rispetto a un peso: è
l’inversione di prospettiva da cui siamo partiti. E la rete è minuscola, un MLP
con tre strati nascosti da 32 unità e attivazione tanh, perché la funzione
da rappresentare è una curva liscia in una dimensione; i commenti shape
danno la forma dei tensori, qui 200 righe per una colonna.
Il cuore del metodo sono due chiamate a torch.autograd.grad, con due
argomenti che il ciclo di addestramento ordinario non usa; create_graph
l’abbiamo incontrato nella sezione sui tensori, per le derivate di ordine
superiore, e nel meta-apprendimento, per la stessa ragione: tenere derivabile
la derivata appena calcolata. Il ciclo che le contiene ripete trentamila volte
lo stesso giro di correzione, e ciascuno di quei giri si chiama epoca:
for epoca in range(30_000):
    ottimizzatore.zero_grad()

    # 1) fisica: residuo m*u'' + c*u' + k*u sui punti di collocazione
    u = rete(t_c)                                        # shape (200, 1)
    u_t = torch.autograd.grad(u, t_c, torch.ones_like(u),
                              create_graph=True)[0]      # u'(t)
    u_tt = torch.autograd.grad(u_t, t_c, torch.ones_like(u_t),
                               create_graph=True)[0]     # u''(t)
    residuo = m * u_tt + c * u_t + k * u
    loss_fisica = (residuo ** 2).mean()

    # 2) condizioni iniziali: u(0) = 1 e u'(0) = 0
    u_0 = rete(t_0)
    u_t0 = torch.autograd.grad(u_0, t_0, torch.ones_like(u_0),
                               create_graph=True)[0]
    loss_iniziale = (u_0 - 1.0).pow(2).mean() + u_t0.pow(2).mean()

    # 3) loss totale, con piu' peso all'unico ancoraggio che abbiamo
    loss = loss_fisica + 100.0 * loss_iniziale
    loss.backward()
    ottimizzatore.step()

    if epoca % 5_000 == 0:
        print(f"epoca {epoca:6d} | loss {loss.item():.2e}"
              f" | di cui fisica {loss_fisica.item():.2e}")
Il primo argomento nuovo è torch.ones_like(u): u è una colonna di 200
valori, uno per punto di collocazione, e il vettore di uni dice ad autograd
«dammi la derivata di ciascuno», tutte le 200 in un colpo solo[1]. Poiché
ogni \(u_j\) dipende soltanto dal suo \(t_j\), non c’è alcuna
mescolanza: nella colonna u_t la riga \(j\) è esattamente \(u_\theta'(t_j)\).
Il secondo è create_graph=True, e senza non funzionerebbe niente: chiede ad
autograd di registrare anche il calcolo della derivata, così che la derivata
resti a sua volta derivabile. Ci serve due volte. Primo, per derivare di
nuovo: u_tt è la derivata di u_t, quindi il grafo di u_t deve esistere.
Secondo, più sottile: u_t e u_tt finiscono dentro la loss, e quando
chiamiamo loss.backward() il gradiente deve poter attraversare anche il
calcolo delle derivate per arrivare fino ai pesi. È una derivata di una
derivata, ed è il motivo per cui ogni epoca di una PINN costa più di un’epoca
di regressione ordinaria: oltre alla passata in avanti ce ne sono una per la
derivata prima e una per la seconda, e la backward finale le attraversa tutte.
Resta il \(100\) che moltiplica loss_iniziale, il coefficiente \(\lambda_0\) della
loss. Il termine di fisica, da solo, non ha una risposta sola: qualunque moto di
quella molla lo soddisfa, compresa una curva piatta ferma sullo zero per
sempre (un corpo fermo al centro, senza nessuno che lo sposti, resta fermo, e la
regola dice proprio questo). A distinguere la nostra traiettoria da tutte le
altre ci sono soltanto le due condizioni di partenza, e la prassi è dare loro un
coefficiente ben maggiore di uno, qui 100, perché la discesa non le trascuri. Se
serva davvero, su questo problema, lo misura il confronto fra semi più avanti,
rilanciando lo stesso addestramento con il coefficiente a 1.
Trentamila epoche dopo, ecco il verdetto. A guidare l’addestramento è Adam [KB15], la nostra scelta di partenza dalla sezione su come far funzionare le reti profonde in poi, e a fare da pagella è la formula esatta della molla, quella ricavata poco fa, calcolata qui in NumPy:
# La soluzione analitica, per dare i voti alla rete
gamma = c / (2 * m)                        # 0.2
omega_d = np.sqrt(k / m - gamma ** 2)      # sqrt(3.96) ~ 1.98997

t_test = np.linspace(0.0, 10.0, 500)
u_esatta = np.exp(-gamma * t_test) * (
    np.cos(omega_d * t_test) + (gamma / omega_d) * np.sin(omega_d * t_test)
)

def diagnosi(rete, t_controllo):
    """Tre misure che conviene tenere separate: la loss di fisica DOVE la
    rete e' stata controllata, la stessa media su una griglia fitta che non
    ha mai visto, e l'errore vero contro la formula esatta."""
    def loss_fisica_su(t):
        u = rete(t)
        u_t = torch.autograd.grad(u, t, torch.ones_like(u),
                                  create_graph=True)[0]
        u_tt = torch.autograd.grad(u_t, t, torch.ones_like(u_t))[0]
        return ((m * u_tt + c * u_t + k * u) ** 2).mean().item()

    t_griglia = torch.tensor(t_test, dtype=torch.float32).reshape(-1, 1)
    t_griglia.requires_grad_(True)
    with torch.no_grad():
        errore = np.abs(rete(t_griglia).squeeze().numpy() - u_esatta)
    return loss_fisica_su(t_controllo), loss_fisica_su(t_griglia), errore


res_punti, res_griglia, errore = diagnosi(rete, t_c)
primi, ultimi = errore[t_test <= 5.0].max(), errore[t_test > 5.0].max()
print(f"loss di fisica sui 200 punti di collocazione: {res_punti:.2e}")
print(f"loss di fisica su una griglia fitta         : {res_griglia:.2e}")
print(f"errore massimo                              : {errore.max():.3f}")
print(f"  sui primi 5 secondi                       : {primi:.3f}")
print(f"  sugli ultimi 5 secondi                    : {ultimi:.3f}")

# La promessa si verifica sul posto.
assert errore.max() < 0.45, (
    f"errore massimo {errore.max():.3f}: la rete non sta ricostruendo "
    "l'oscillazione, e' collassata sulla curva piatta ferma sullo zero."
)
Lanciando il programma (su CPU bastano pochi minuti) si ottengono le righe che seguono. Le ultime cifre sono l’impronta del processore su cui gira: trentamila passi di Adam amplificano le differenze di arrotondamento fra due modi di sommare gli stessi numeri, quelle della sezione sull’analisi numerica, e su un’altra macchina la seconda cifra può già cambiare. Reggono invece gli ordini di grandezza e i rapporti fra le righe, ed è su quelli che si appoggia il ragionamento.
epoca      0 | loss 1.03e+02 | di cui fisica 2.56e-01
epoca   5000 | loss 7.31e-02 | di cui fisica 7.30e-02
epoca  10000 | loss 4.80e-02 | di cui fisica 4.80e-02
epoca  15000 | loss 3.78e-02 | di cui fisica 3.22e-02
epoca  20000 | loss 3.91e-02 | di cui fisica 3.00e-02
epoca  25000 | loss 1.35e-02 | di cui fisica 1.35e-02
loss di fisica sui 200 punti di collocazione: 7.77e-03
loss di fisica su una griglia fitta         : 3.12e-02
errore massimo                              : 0.154
  sui primi 5 secondi                       : 0.070
  sugli ultimi 5 secondi                    : 0.154
Nelle stampe 7.77e-03 sta per \(7{,}77 \cdot 10^{-3}\): il punto fa da virgola,
e la e è il «per dieci alla» che la sezione dal notebook agli script ha sciolto per 1e-3. Le stampe si
fermano a 25 000 perché arrivano ogni cinquemila epoche e l’ultima cade lì;
l’addestramento prosegue fino a 30 000, e le cinque righe in fondo sono
misurate alla fine.
La loss parte dall’ordine del centinaio e scende di circa quattro ordini di grandezza, cioè si divide per diecimila. Quel centinaio, però, è quasi tutto il termine sulla partenza: all’inizio la rete parte da un punto qualsiasi invece che da 1, e quello sbaglio, moltiplicato per 100, fa da solo il grosso del numero, mentre la fisica vale appena 0,26. A cinquemila epoche la loss e la sua parte di fisica coincidono già: il termine sulla partenza si è esaurito presto, e torna solo a tratti (a ventimila epoche ne vale un quarto). Il lavoro, da lì in poi, lo fa la fisica, che in trentamila epoche si divide soltanto per una trentina, da 0,26 a 0,0078.
Le cinque righe finali dicono due cose diverse (ed è raro che un esempio da manuale sia così onesto).
La prima è che il metodo funziona. La rete non ha mai visto un solo valore della soluzione, solo la partenza e la legge, e ne esce una curva che oscilla con il periodo giusto e si smorza con il ritmo giusto. Sui primi cinque secondi lo scarto dalla formula esatta resta attorno ai sette centesimi dell’ampiezza iniziale. Per una curva ricostruita da una regola e da due numeri, è molto.
La seconda è che quella curva non è accurata quanto la loss di fisica lascerebbe credere. Sui 200 punti in cui la regola è stata controllata la loss di fisica vale \(8 \cdot 10^{-3}\), cioè la molla risulta obbedita quasi alla lettera; ma lo scarto massimo dalla soluzione vera è \(0{,}15\), il 15% dello spostamento di partenza, e le due curve messe una sull’altra si distinguono benissimo.
E quel 15% si può leggere in un modo più severo. Quello scarto non è sparso: sui primi cinque secondi resta attorno a 0,07, negli ultimi arriva a 0,15, e lì la rete comincia ad appiattirsi mentre la molla vera sta ancora oscillando. Ma nella coda l’oscillazione vera si è ormai ridotta parecchio, e al decimo secondo è scesa al 13,5% dello spostamento di partenza. Uno scarto di 0,15 in un tratto dove la molla vera si muove ormai di così poco vuol dire che lì, di fatto, la rete l’oscillazione non la sta più seguendo. Sui primi cinque secondi è brava; nella coda ha smesso.
Si noti infine la loss di fisica sulla griglia fitta, ed è quella che dice di più: sugli istanti che la rete non ha mai visto vale \(3 \cdot 10^{-2}\), quattro volte più che nei punti controllati. La rete va un po’ meglio dove la si guarda che dove non la si guarda. Qui è uno scarto modesto, e fra poche righe vedremo quanto può diventare grande.

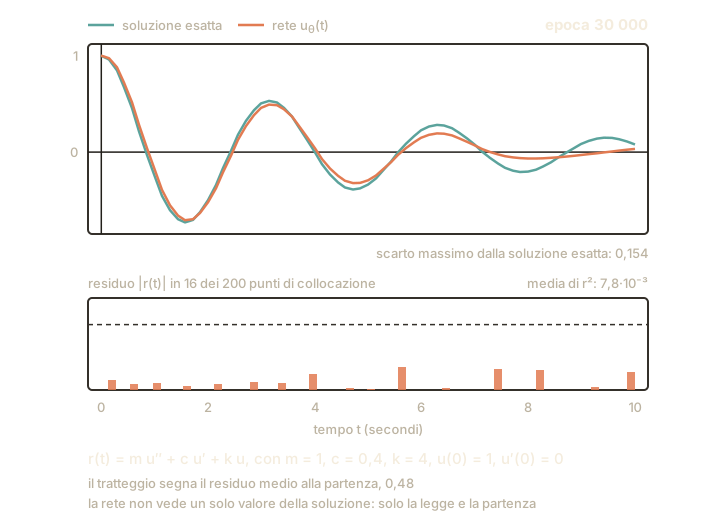
Fig. 35.3 Lo stesso addestramento guardato dai due lati che contano: mentre la curva della rete si accosta alla soluzione esatta (in alto), il residuo nei punti di collocazione si abbassa fino a diventare una briciola (in basso). Le istantanee sono epoche vere dello stesso addestramento, con il seme 42.#
La Fig. 35.3 mette le due misure una sopra l’altra e le fa correre dall’inizializzazione alla trentamillesima epoca. Il numero in basso a destra è il termine di fisica, e lì si vede la trentina di poco fa: parte da \(2{,}6 \cdot 10^{-1}\), ventisei centesimi, e arriva a \(7{,}8 \cdot 10^{-3}\), otto millesimi scarsi. Nel pannello di sopra si vede invece dove resta lo scarto: le due curve stanno appiccicate per metà intervallo e si staccano nella coda.
Conviene vedere fin dove arriva quello scarto fra i due numeri, la loss di fisica piccola e l’errore grande.
Lo stesso codice, un altro seme#
C’è una riga del programma che non abbiamo commentato: torch.manual_seed(42),
in cima al programma. Una rete comincia sempre con i pesi sorteggiati a caso,
perché partendo tutti uguali i neuroni resterebbero uguali per sempre, e il
sorteggio dipende da un numero di partenza che si chiama seme: dando lo stesso
seme si ottiene lo stesso sorteggio, e quindi lo stesso risultato. Fissarlo è
una cortesia al lettore, che così rifacendo il conto ritrova i nostri numeri.
Qui è molto di più: cambiando quel 42, cambia la conclusione. Il seme 7, però,
l’abbiamo scelto apposta fra quelli con cui la corsa fallisce, per guardare da
vicino come fallisce. Quanto spesso succeda lo dice il conto su dieci semi che
viene dopo, ed è quello il numero da portarsi via: su un’altra macchina, dove le
cifre dell’addestramento cambiano, a fallire potrebbe essere un altro seme, ma
la frazione di corse che falliscono è la grandezza che regge.
Rimettiamo l’addestramento di prima dentro una funzione, così da poterlo rilanciare cambiando soltanto quel numero. È lo stesso codice riga per riga, con in più la stampa periodica delle due misure che ci interessano.
def addestra(seme, epoche=30_000, peso=100.0, verboso=True):
    """Come l'addestramento di sopra: cambia solo il punto di partenza
    (e, se lo si chiede, il moltiplicatore delle condizioni iniziali)."""
    torch.manual_seed(seme)
    rete = nn.Sequential(
        nn.Linear(1, 32), nn.Tanh(),
        nn.Linear(32, 32), nn.Tanh(),
        nn.Linear(32, 32), nn.Tanh(),
        nn.Linear(32, 1),
    )
    t_c = 10.0 * torch.rand(200, 1)
    t_c.requires_grad_(True)
    t_0 = torch.zeros(1, 1, requires_grad=True)
    ottimizzatore = torch.optim.Adam(rete.parameters(), lr=1e-3)

    for epoca in range(epoche):
        ottimizzatore.zero_grad()
        u = rete(t_c)
        u_t = torch.autograd.grad(u, t_c, torch.ones_like(u),
                                  create_graph=True)[0]
        u_tt = torch.autograd.grad(u_t, t_c, torch.ones_like(u_t),
                                   create_graph=True)[0]
        loss_fisica = ((m * u_tt + c * u_t + k * u) ** 2).mean()

        u_0 = rete(t_0)
        u_t0 = torch.autograd.grad(u_0, t_0, torch.ones_like(u_0),
                                   create_graph=True)[0]
        loss_iniziale = (u_0 - 1.0).pow(2).mean() + u_t0.pow(2).mean()

        (loss_fisica + peso * loss_iniziale).backward()
        ottimizzatore.step()

        # loss di fisica ed errore vero, fianco a fianco
        if verboso and epoca % 2_500 == 0:
            errore_ora = diagnosi(rete, t_c)[2].max()
            print(f"epoca {epoca:6d} | loss di fisica {loss_fisica.item():.2e}"
                  f" | errore vero {errore_ora:.3f}")

    return rete, t_c


rete_7, t_c7 = addestra(seme=7)
res_punti_7, res_griglia_7, errore_7 = diagnosi(rete_7, t_c7)

print(f"\n{'':<24}{'seme 42':>10}{'seme 7':>12}")
print(f"{'loss fisica, suoi punti':<24}{res_punti:>10.2e}{res_punti_7:>12.2e}")
print(f"{'loss fisica, griglia':<24}{res_griglia:>10.2e}{res_griglia_7:>12.2e}")
print(f"{'errore vero':<24}{errore.max():>10.3f}{errore_7.max():>12.3f}")

# Dentro la corsa del seme 7, su una griglia di ventimila istanti
t_f = torch.linspace(0.0, 10.0, 20_001).reshape(-1, 1).requires_grad_(True)
u_f = rete_7(t_f)
u_f_t = torch.autograd.grad(u_f, t_f, torch.ones_like(u_f),
                            create_graph=True)[0]
u_f_tt = torch.autograd.grad(u_f_t, t_f, torch.ones_like(u_f_t))[0]
r_f = (m * u_f_tt + c * u_f_t + k * u_f).detach().numpy().ravel()
u_f, t_f = u_f.detach().numpy().ravel(), t_f.detach().numpy().ravel()
picco = np.abs(r_f).argmax()
punti = np.sort(t_c7.detach().numpy().ravel())
prima, dopo = punti[punti < t_f[picco]].max(), punti[punti > t_f[picco]].min()
buco = (t_f >= prima) & (t_f <= dopo)
sopra = np.abs(r_f) > np.abs(r_f[picco]) / 2      # il picco a meta' altezza
sx = dx = picco
while sopra[sx - 1]:
    sx -= 1
while sopra[dx + 1]:
    dx += 1
largo = t_f[dx] - t_f[sx]
print(f"\nseme 7: u(0) = {u_f[0]:.4f}, e per t > 2 resta entro "
      f"{np.abs(u_f[t_f > 2]).max():.3f} dallo zero")
print(f"residuo massimo in valore assoluto {np.abs(r_f[picco]):.0f}, "
      f"a t = {t_f[picco]:.3f}, largo {largo:.2f} a metà altezza")
print(f"fra i punti di collocazione {prima:.3f} e {dopo:.3f} la curva "
      f"scende a {u_f[buco].min():.3f}")
print(f"e risale a {u_f[buco][-1]:.3f}")

# Le tre affermazioni che i numeri qui sopra devono reggere:
assert res_punti_7 < res_punti, (
    "il seme 7 non ha piu' la loss di fisica piu' bassa dei due."
)
assert errore_7.max() > errore.max(), (
    "il seme 7 non collassa piu' su questa versione di PyTorch."
)
assert res_griglia_7 > res_griglia, (
    "la loss di fisica fuori dai punti di collocazione non e' piu' alta."
)
Ecco che cosa stampa la corsa con il seme 7, epoca per epoca. Nella colonna «errore vero» c’è la distanza massima fra la curva della rete e la formula esatta, sempre in frazioni dello spostamento di partenza, che vale 1: 0,879 vuol dire che in qualche istante la rete sbaglia di quasi tutto lo spostamento da cui il corpo era partito.
epoca |
loss di fisica |
errore vero |
|---|---|---|
0 |
\(1{,}44 \cdot 10^{-1}\) |
0,879 |
2 500 |
\(6{,}10 \cdot 10^{-2}\) |
0,497 |
5 000 |
\(5{,}62 \cdot 10^{-2}\) |
0,467 |
7 500 |
\(5{,}41 \cdot 10^{-2}\) |
0,453 |
10 000 |
\(5{,}22 \cdot 10^{-2}\) |
0,444 |
12 500 |
\(4{,}74 \cdot 10^{-2}\) |
0,440 |
15 000 |
\(3{,}67 \cdot 10^{-2}\) |
0,431 |
17 500 |
\(3{,}35 \cdot 10^{-2}\) |
0,432 |
20 000 |
\(8{,}57 \cdot 10^{-3}\) |
0,499 |
22 500 |
\(3{,}24 \cdot 10^{-4}\) |
0,709 |
25 000 |
\(9{,}03 \cdot 10^{-5}\) |
0,720 |
27 500 |
\(5{,}46 \cdot 10^{-5}\) |
0,723 |
Si guardi la seconda metà della tabella, perché è il punto di tutta la sezione. Fra le 17 500 e le 27 500 epoche la loss di fisica si divide per seicento, da \(3{,}3 \cdot 10^{-2}\) a \(5 \cdot 10^{-5}\): chiunque guardasse soltanto la loss direbbe che proprio lì l’addestramento ha fatto un salto di qualità. Nello stesso tratto l’errore vero peggiora, da 0,43 a 0,72, cioè da mezzo spostamento di partenza a quasi tutto. Le due colonne, che dovrebbero raccontare la stessa storia, vanno in direzioni opposte.
Alla fine il programma mette a confronto le due corse e misura la curva del seme 7 su ventimila istanti fitti:
                           seme 42      seme 7
loss fisica, suoi punti   7.77e-03    4.77e-04
loss fisica, griglia      3.12e-02    1.23e+03
errore vero                  0.154       0.720

seme 7: u(0) = 0.9993, e per t > 2 resta entro 0.012 dallo zero
residuo massimo in valore assoluto 659, a t = 1.263, largo 0.02 a metà altezza
fra i punti di collocazione 1.205 e 1.415 la curva scende a -0.565
e risale a -0.007
Che cosa sia successo lo dicono le ultime righe. La partenza la curva la rispetta in pieno (\(u_\theta(0) = 0{,}9993\)); poi scende, e scendendo sprofonda una volta sola fin sotto lo zero; e da lì in avanti si appiattisce e non si muove più. Dal secondo 2 in poi, per otto secondi buoni, resta a meno di \(0{,}012\) dallo zero, mentre la molla vera in quel tratto compie ancora due oscillazioni e mezza. Lo zero lo attraversa una volta sola, contro le sei della soluzione vera, una a ogni mezza oscillazione (li conta il confronto fra semi più avanti): contarli è un modo rapido di vedere se una curva sta ancora oscillando, purché si guardi anche quanto è ampia, perché una curva che si limita a increspare lo zero li fa tutti e sei senza oscillare affatto. Questa ha rinunciato: si è arresa alla riga dritta sullo zero, quella che rispetta la regola senza dire niente, e che d’ora in poi chiameremo la soluzione banale.
Il confronto fra le due corse dice qualcosa di più, ed è la ragione per cui conviene misurare la loss di fisica in due posti invece che in uno. Sui duecento istanti in cui è stata controllata, la rete del seme 7 ha una loss di fisica più di dieci volte più bassa di quella del seme 42. Sulla griglia fitta di istanti che non ha mai visto, la sua è decine di migliaia di volte più alta. E fra le sue due loss, quella dove è stata guardata e quella dove non lo è stata, corre un fattore di milioni: stessa rete, stesso momento, due giudizi opposti. (Sono rapporti fra medie di quadrati, e per risalire a quanto la regola è violata davvero bisogna prendere la radice: un fattore di milioni fra le loss vuol dire uno di migliaia fra le violazioni. Resta un abisso.)[2]
Una loss di fisica bassa non garantisce la soluzione giusta anche perché è stata ottenuta proprio e soltanto nei punti che si stanno guardando. La rete ha imparato a essere impeccabile all’esame e sregolata fuori.
È la scorciatoia di cui parlavamo prima, quella che il peso cento sulla partenza doveva rendere sconveniente. Uno studente che consegna un foglio con una riga dritta sullo zero non sta violando la regola della molla: un corpo fermo al centro, senza nessuno che lo sposti, resta fermo, e la regola dice esattamente questo. Il professore, che la soluzione non la conosce e sa solo verificare la regola, non ha nulla da eccepire. L’unica cosa che distingue quel foglio da quello giusto è la partenza, e la partenza, come si è visto, lo studente la rispetta comunque: è il resto del foglio che scivola verso la riga piatta.
E c’è il trucco in più, quello che spiega i due punteggi così diversi. Ricordi il «dappertutto» su cui avevamo chiesto di tenere un dito? Ecco il conto. Il professore non controlla dappertutto: controlla duecento istanti, sempre gli stessi. Lo studente lo ha capito, e ha imparato a stare in riga esattamente lì.
E adesso guardiamo che cosa fa in mezzo, perché c’è da restare a bocca aperta. Due dei suoi punti di controllo cadono a 1,205 e a 1,415 secondi: fra loro corrono due decimi di secondo, quattro volte il passo medio del campione, che con duecento punti su dieci secondi è un ventesimo di secondo. Quei punti sono stati sorteggiati, e il caso li ha lasciati radi lì. La curva arriva lì scendendo, tocca il fondo a \(-0{,}57\) e in quei due decimi di secondo risale fino a sfiorare lo zero, dove resta per tutto il tempo che avanza: mezzo foglio risalito di scatto fra un controllo e l’altro. È lo strappo con cui smette di oscillare. Proprio perché è così stretto, lì la curva piega in modo mostruoso, e la regola della molla parla soprattutto di quanto la curva piega. Se il professore ci mettesse il dito, quel compito verrebbe stracciato.
Il professore lì non ci mette il dito. Sul suo registro il compito è quasi perfetto; il disegno è sbagliato due volte, perché è piatto dove dovrebbe oscillare e perché per diventare piatto ha dato uno strappo dove nessuno guarda. Non è furbizia di nessuno: l’unico modo che ha di prendere voti è stare in riga dove si guarda, e nulla in quel punteggio gli chiede di comportarsi anche altrove.
Due meccanismi distinti si sommano qui, e conviene separarli.
Il primo è la degenerazione del termine di fisica, già annotata quando abbiamo scritto la loss: \(u \equiv 0\) risolve esattamente l’equazione omogenea, quindi il minimo della sola loss di fisica è degenere e la soluzione banale ne fa parte. Il termine sulle condizioni iniziali dovrebbe selezionare la nostra fra le infinite soluzioni, ma agisce su un singolo istante, e \(\lambda_0 = 100\) rende quella scorciatoia meno attraente, non la vieta: la rete infatti la paga per intero, \(u_\theta(0) = 0{,}9993\), e si tiene il residuo quasi nullo nei punti in cui viene interrogata. È il fenomeno che la sezione sui limiti chiamerà mancanza di ordine causale: la loss somma residui su punti sparsi nel dominio e nulla obbliga la rete a propagare in avanti nel tempo l’informazione della partenza.
Il secondo è il campionamento finito, che verifica direttamente l’avvertenza di
poco fa: fra un punto di collocazione e il successivo la regolarità della rete
non le impedisce affatto di oscillare. Qui infatti oscilla: misurato su una
griglia da 20 000 istanti, il residuo puntuale \(|r_\theta|\) tocca un massimo di
\(6{,}6 \cdot 10^2\) a \(t = 1{,}263\), con un picco largo \(0{,}02\) secondi a metà
altezza. I due punti di collocazione che se lo trovano in mezzo stanno a
\(1{,}205\) e a \(1{,}415\): fra loro corrono \(0{,}21\) secondi, quattro volte il
passo medio del campione. Il picco sta nel buco fra due punti di controllo, ed
è largo un decimo di quel buco. E non è un’increspatura invisibile nella
soluzione: dentro quello stesso intervallo \(u_\theta\) tocca il fondo a
\(-0{,}565\) e risale a \(-0{,}007\), un salto di \(0{,}56\) compiuto per intero fra
due istanti in cui la rete non viene interrogata. È lì che la rete abbandona la
discesa e passa alla piattezza che terrà fino alla fine. Fuori di lì è davvero
piatta: per \(t > 2\) resta entro \(1{,}2 \cdot 10^{-2}\) dallo zero. È la
situazione della stima con la funzione di Green: il picco pesa per intero
nell’integrale di \(|r_\theta|\), che controlla l’errore, e per niente nella
media sui punti di collocazione, che è quella minimizzata. Una rete tanh con
tre strati da 32 neuroni ha abbastanza capacità per infilare una guglia dove
non viene interrogata, e duecento punti su dieci secondi non bastano a
impedirglielo. La regolarità della rete è un argomento asintotico, non una
garanzia a \(N_c\) finito: dice che infittendo i punti la cosa si chiude, non che
sia già chiusa.
Il seme 7 non è l’unico a fallire. Rilanciamo lo stesso programma su altri quattro semi, 0, 1, 2 e 3, e mettiamo le sei corse in fila, il 42 e il 7 compresi, dalla loss di fisica sui duecento punti più bassa alla più alta. Sei corse di cui due scelte non sono però un campione, e il campione viene subito dopo: lo stesso programma porta i semi a dieci (da 0 a 8, più il 42) e li addestra due volte, con il coefficiente \(\lambda_0\) delle condizioni iniziali a 100 e a 1, contando le corse che collassano, cioè quelle che sbagliano di più di 0,45, la soglia che il primo addestramento usava per dire collassata. Misura infine, sui semi da 0 a 19, il rapporto fra i gradienti dei due termini all’avvio. Sono diciotto addestramenti in più, una ventina di minuti su CPU.
def attraversamenti(rete):
    """Quante volte la curva della rete passa per lo zero in dieci secondi."""
    t = torch.tensor(t_test, dtype=torch.float32).reshape(-1, 1)
    with torch.no_grad():
        u = rete(t).squeeze().numpy()
    return int((np.sign(u[1:]) != np.sign(u[:-1])).sum())

risultati = {42: (rete, t_c), 7: (rete_7, t_c7)}
for seme in (0, 1, 2, 3):
    risultati[seme] = addestra(seme, verboso=False)

righe = []
for seme, (r, tc) in risultati.items():
    res, _, err = diagnosi(r, tc)
    righe.append((res, seme, err.max(), attraversamenti(r)))
print("seme   loss fisica   errore   zeri")
for res, seme, err, zeri in sorted(righe):
    print(f"{seme:4d}   {res:11.1e}    {err:.3f}   {zeri:4d}")

# il moltiplicatore a 1, sullo stesso seme 42
rete_1, t_c1 = addestra(seme=42, peso=1.0, verboso=False)
res_punti_1, res_griglia_1, errore_1 = diagnosi(rete_1, t_c1)
with torch.no_grad():
    u0_1 = rete_1(torch.zeros(1, 1)).item()
print(f"\npeso 1: loss di fisica sui punti {res_punti_1:.2e}, "
      f"sulla griglia {res_griglia_1:.2e}")
print(f"        errore vero {errore_1.max():.3f}, u(0) = {u0_1:.4f}")

# i due moltiplicatori, 1 e 100, sugli stessi dieci semi
semi = (0, 1, 2, 3, 4, 5, 6, 7, 8, 42)
for seme in (4, 5, 6, 8):
    risultati[seme] = addestra(seme, verboso=False)
con_peso_1 = {42: (rete_1, t_c1)}
for seme in semi[:-1]:
    con_peso_1[seme] = addestra(seme, peso=1.0, verboso=False)
print()
for peso, corse in ((1, con_peso_1), (100, risultati)):
    err = np.array([diagnosi(*corse[s])[2].max() for s in semi])
    riuscite, n_coll = err[err <= 0.45], (err > 0.45).sum()
    # intervallo di Wilson al 95% per la frazione di corse che collassano
    q, z = n_coll / 10, 1.96
    centro = (q + z**2 / 20) / (1 + z**2 / 10)
    mezzo = z * np.sqrt(q * (1 - q) / 10 + z**2 / 400) / (1 + z**2 / 10)
    print(f"peso {peso:3d}: collassano {n_coll} corse su 10 "
          f"(al 95%, fra {centro - mezzo:.0%} e {centro + mezzo:.0%})")
    print(f"          riuscite: la migliore sbaglia di {riuscite.min():.3f}, "
          f"la mediana di {np.median(riuscite):.3f}")

def rapporto_gradienti(seme):
    """Ampiezza media dei gradienti della fisica contro quelli delle
    condizioni iniziali, sulla rete appena inizializzata."""
    torch.manual_seed(seme)
    r = nn.Sequential(
        nn.Linear(1, 32), nn.Tanh(),
        nn.Linear(32, 32), nn.Tanh(),
        nn.Linear(32, 32), nn.Tanh(),
        nn.Linear(32, 1),
    )
    tc = 10.0 * torch.rand(200, 1)
    tc.requires_grad_(True)
    t0 = torch.zeros(1, 1, requires_grad=True)
    u = r(tc)
    u_t = torch.autograd.grad(u, tc, torch.ones_like(u), create_graph=True)[0]
    u_tt = torch.autograd.grad(u_t, tc, torch.ones_like(u_t),
                               create_graph=True)[0]
    fisica = ((m * u_tt + c * u_t + k * u) ** 2).mean()
    u0 = r(t0)
    u_t0 = torch.autograd.grad(u0, t0, torch.ones_like(u0),
                               create_graph=True)[0]
    iniziale = (u0 - 1.0).pow(2).mean() + u_t0.pow(2).mean()
    pesi = list(r.parameters())
    g_f = torch.autograd.grad(fisica, pesi, retain_graph=True)
    g_i = torch.autograd.grad(iniziale, pesi)
    media = lambda gs: torch.cat([g.abs().flatten() for g in gs]).mean()
    return (media(g_f) / media(g_i)).item()

rapporti = np.array([rapporto_gradienti(s) for s in range(20)])
print(f"\nrapporto fra i gradienti all'avvio: "
      f"mediana {np.median(rapporti):.1f}, "
      f"rovesciato in {(rapporti < 1).sum()} semi su 20")
seme   loss fisica   errore   zeri
   7       4.8e-04    0.720      1
   3       1.7e-03    0.629      4
  42       7.8e-03    0.154      6
   1       1.7e-02    0.212      5
   0       2.7e-02    0.259      5
   2       3.1e-02    0.289      5

peso 1: loss di fisica sui punti 1.94e-05, sulla griglia 2.78e+00
        errore vero 0.729, u(0) = 0.9994

peso   1: collassano 5 corse su 10 (al 95%, fra 24% e 76%)
          riuscite: la migliore sbaglia di 0.005, la mediana di 0.007
peso 100: collassano 5 corse su 10 (al 95%, fra 24% e 76%)
          riuscite: la migliore sbaglia di 0.154, la mediana di 0.250

rapporto fra i gradienti all'avvio: mediana 2.4, rovesciato in 4 semi su 20
Le due corse con la loss di fisica più bassa in assoluto sono le due sbagliate, e sono anche quelle che restano più lontane dai sei attraversamenti dello zero della soluzione vera: uno e quattro, contro i cinque o sei delle altre. Solo il seme 42 li fa tutti. Fra le altre quattro la loss di fisica torna a essere una guida sensata (chi ce l’ha più bassa sbaglia meno), il che rende la trappola ancora più insidiosa: la loss è informativa finché la rete sta risolvendo il problema giusto, e smette di esserlo esattamente quando serve, cioè quando ha smesso di risolverlo.
Quanto spesso succeda lo dicono i dieci semi: con il coefficiente a 100 collassano cinque corse su dieci, su un’equazione che si risolve a mano in mezza pagina. Dieci corse sono poche, e la frazione vera sta, con una confidenza del 95%, fra un quarto e tre quarti; ma anche il limite basso vuol dire una corsa su quattro.
Il coefficiente \(\lambda_0\) non cambia il quadro. Con \(\lambda_0 = 1\), sul seme 42, la loss di fisica scende a due centomillesimi, quattrocento volte meno che con 100, e verrebbe da dire che è andata meglio. Invece l’errore vero è \(0{,}73\), quasi tutto lo spostamento di partenza. La partenza quella rete la rispetta lo stesso (\(u_\theta(0) = 0{,}9994\)); quello che ha fatto è azzerare il residuo dove veniva controllata e lasciarlo correre altrove, e sulla griglia fitta la sua loss di fisica vale \(2{,}8\), più di centomila volte quella dei duecento punti. Sui dieci semi le corse che collassano sono cinque con \(\lambda_0 = 1\) come con \(\lambda_0 = 100\), e fra quelle riuscite la mediana sbaglia di sette millesimi con 1 e di un quarto con 100. Su questo problema il coefficiente non garantisce la strada giusta, e quando la strada è giusta costa precisione. Nemmeno la ragione che di solito lo giustifica, lo squilibrio fra i gradienti dei due termini, qui c’è: all’avvio il rapporto fra le loro ampiezze medie ha mediana 2,4, e in quattro semi su venti è rovesciato.
Ne seguono tre indicazioni pratiche. La prima: in una PINN la loss non è una pagella. In un problema di apprendimento ordinario un punteggio che scende è una buona notizia; qui la loss di fisica può scendere allontanandosi dalla risposta, e nella loss che si sta minimizzando non c’è niente che lo segnali. Confrontare con la soluzione vera, come abbiamo fatto qui, nei casi veri non si può: se quella soluzione ce l’avessimo, non staremmo usando una PINN. La seconda: un risultato ottenuto con un solo seme non è un risultato. Il modo minimo di lavorare seriamente con questi metodi è rilanciare con qualche seme diverso e guardare quanto le risposte si somigliano fra loro, che è l’unica cosa che si può fare quando la risposta giusta non si conosce.
La terza la suggeriscono da sé le due loss affiancate: la loss di fisica va misurata anche dove la rete non è stata addestrata, su una griglia fitta o su punti estratti di nuovo. È lo stesso motivo per cui, nei capitoli sull’apprendimento, un modello si giudica su dati tenuti da parte e mai visti in addestramento: un punteggio calcolato dove il modello si è allenato misura anche quanto bene ha imparato a compiacere quel campione. C’è anche un rimedio, e costa poco: ricampionare i punti di collocazione a ogni epoca, cioè sorteggiarne di nuovi ogni volta, così che non esista un esame su cui prepararsi. I punti si possono estrarre uniformi o da sequenze a bassa discrepanza, e anche addensare dove il residuo resta più alto [LMMK21]; ciascuno costa una passata in avanti e una per ogni ordine di derivata, come nel ciclo di addestramento della molla. Qui i duecento punti restano fermi dal principio alla fine, ed è tenendoli fermi che la scorciatoia si vede a occhio nudo.
Niente di tutto questo smentisce il metodo, e non è il caso di esagerare in senso opposto: su dieci semi, metà delle corse ricostruisce un’oscillazione smorzata riconoscibile partendo da un punto e da una regola, il che resta notevole. Ma «funziona», senza un tasso accanto, non è una garanzia, e su un problema da manuale, con soluzione nota, tre parametri e una sola variabile, a separare la corsa buona da quella fallita è il seme del generatore casuale. È il motivo per cui, nella sezione sui limiti, la rassegna dei limiti è più lunga di quella delle applicazioni.
Non unire i puntini, non calcolarli: una terza via#
Fermiamoci a guardare che cosa è successo, perché è facile passarci sopra.
Confrontiamo con i due mestieri che già conosciamo. La regressione della sezione sull’apprendimento supervisionato è unire i puntini: senza puntini non parte nemmeno, e per disegnare questa curva le sarebbero servite decine di misure sparse su tutti i 10 secondi. La nostra rete ha ricevuto zero misure: un punto di partenza, una regola, fine; la fisica ha fatto il lavoro dei dati. Il solutore classico visto in apertura di capitolo, il conto a passettini del caffè, la curva la sa calcolare; ma la calcola su una griglia di istanti, e i valori in mezzo li ricostruisce interpolando fra quelli che ha in mano (i solutori maturi lo fanno bene, non tirando una retta fra due puntini). La PINN invece restituisce una funzione: chiedile il valore a \(3{,}7\) secondi, o quanto sta salendo lì, o le due cose in qualunque altro punto, e risponde, perché la soluzione ormai abita dentro la rete.
Su questo problemino il conto a passettini vince su tutta la linea: qualche centesimo di secondo contro i minuti dell’addestramento, e uno scarto dalla formula esatta di \(5 \cdot 10^{-11}\), cioè cinque centomiliardesimi, contro il nostro \(0{,}15\)[3]. E se la curva la vuoi oltre i dieci secondi, a lui basta continuare ad avanzare, mentre la rete fuori dal tratto su cui è stata addestrata si inventa quello che le pare e va riaddestrata da capo. Il vantaggio della PINN è altrove, e comincia dove dati e legge vanno mescolati, come vedremo tra un attimo.
Rispetto alla regressione pura: minimizzare solo il termine dati richiede \(N_d\) grande e non promette nulla tra un campione e l’altro, mentre qui il residuo vincola \(u_\theta\) nei punti di collocazione, e per il loro tramite, con le riserve appena viste, l’intero dominio: bastano le condizioni iniziali, e il termine di fisica agisce come una regolarizzazione informata dalla legge. Rispetto a un integratore classico (Eulero, Runge–Kutta): quello discretizza il tempo con passo \(h\), propaga sequenzialmente e offre garanzie di convergenza con errore \(O(h^p)\) (sotto le ipotesi del caso: stabilità dello schema e soluzione abbastanza regolare); la PINN sostituisce la propagazione con un’ottimizzazione globale non convessa: nessuna garanzia formale, costo superiore di ordini di grandezza su un problema standard come questo, ma soluzione mesh-free e continua, valutabile e derivabile in qualunque punto. Su quest’ultimo vantaggio conviene non calcare troppo: un integratore a passo adattivo offre da decenni l’output denso, cioè un’interpolante di ordine appena inferiore a quello del metodo, richiamabile in qualunque istante. Quello che resta davvero alla rete è la derivabilità, e il fatto che la stessa impalcatura non cambia passando a più variabili o a un problema inverso.
Quanto alla storia, un’onestà dovuta: l’idea non nasce nel 2019, e nemmeno nel
1998. La loss delle PINN, esattamente com’è scritta qui (un MLP che approssima
la soluzione, il residuo minimizzato ai punti di collocazione e le condizioni
imposte come penalità nella stessa funzione obiettivo), è di Dissanayake e
Phan-Thien nel 1994 [DPT94], e reti neurali messe a
risolvere equazioni differenziali compaiono già in Lee e Kang nel 1990, con un
impianto però diverso: lì la rete non rappresenta la soluzione come funzione
delle coordinate, minimizza l’errore di uno schema alle differenze finite già
discretizzato [LK90]. Isaac Lagaris, Aristidis Likas e Dimitrios
Fotiadis, nel 1998, pubblicano la variante che di solito viene citata come
capostipite [LLF98], ed è utile distinguerla perché non è
la stessa cosa: Lagaris costruisce la soluzione di prova in modo che condizioni
iniziali e al contorno siano soddisfatte esattamente, per costruzione, e
resta da minimizzare il solo residuo. Sul nostro problema basterebbe cercare la
soluzione nella forma \(\hat{u}(t) = 1 + t^2\,u_\theta(t)\), che dà
\(\hat{u}(0)=1\) e, derivando, \(\hat{u}'(t) = 2t\,u_\theta + t^2 u_\theta'\),
quindi \(\hat{u}'(0) = 0\) qualunque cosa faccia la rete (purché sia derivabile,
e una tanh lo è): niente \(\lambda_0\) da scegliere, e la soluzione banale non
è più raggiungibile. È il vincolo imposto a priori; la PINN, come la
formulazione del 1994, lo impone invece come penalità, una scelta che tiene il
metodo generale (una forma così va riscritta per ogni geometria e ogni tipo di
condizione) ma che, come abbiamo appena visto con il seme sfortunato e come
vedremo fra i limiti, ha un costo. Ma nel 1994 le derivate della rete andavano
ricavate con formule scritte a mano, caso per caso, e l’ottimizzazione girava
su CPU dell’epoca: l’idea restò di nicchia per un quarto di secolo. Quando
Maziar Raissi, Paris Perdikaris e George Karniadakis la rilanciano nel 2019
[RPK19] (il nome «physics-informed neural networks» lo
avevano già usato nei due preprint del 2017 da cui quel lavoro nasce), la
differenza non è concettuale ma infrastrutturale: la differenziazione
automatica in modalità inversa, disponibile in librerie generali (i lavori
originali usano TensorFlow; qui usiamo PyTorch [PGM+19], con
le due chiamate a torch.autograd.grad della molla), e le GPU per
l’addestramento. A volte, nella ricerca, l’idea giusta deve solo aspettare i
suoi attrezzi.
Il problema inverso, in tre righe di codice#
Chiudiamo con la variazione promessa in apertura di capitolo: quella su cui le PINN hanno costruito la loro fortuna. Finora abbiamo fatto il percorso in un verso: legge nota, e da lì la curva. Adesso lo percorriamo all’incontrario, curva osservata e da lì un pezzo di legge, ed è per questo che si chiama problema inverso.
Ecco la situazione. La molla è dentro una scatola chiusa e la sua rigidezza \(k\) non la sappiamo; in compenso un sensore ci passa 25 misure della posizione, equispaziate lungo i dieci secondi e sporche, come è giusto che siano, di un rumore casuale di ampiezza tipica \(0{,}05\), cioè un ventesimo dello spostamento iniziale. (Il sensore non esiste: le 25 misure le abbiamo fabbricate noi, prendendo la formula esatta con \(k = 4\) e aggiungendoci il rumore. È l’unico modo di sapere, alla fine, se la stima era giusta.) Nel codice cambia pochissimo, tre cose in tutto:
# k non lo conosciamo piu': diventa un parametro da apprendere
k_appreso = nn.Parameter(torch.tensor(1.0))   # partenza volutamente sbagliata

ottimizzatore = torch.optim.Adam(
    list(rete.parameters()) + [k_appreso], lr=1e-3
)

# nel ciclo di addestramento: il residuo usa il k appreso...
residuo = m * u_tt + c * u_t + k_appreso * u
# ...e accanto alla fisica c'e' il termine dati sulle misure rumorose
loss_dati = ((rete(t_oss) - u_oss) ** 2).mean()
loss = loss_fisica + 100.0 * loss_dati
dove t_oss e u_oss sono le colonne di numeri con gli istanti e le misure.
Il programma completo, con le misure fabbricate e due semi diversi, è questo
(due addestramenti, qualche minuto su CPU):
def problema_inverso(seme, epoche=30_000):
    """La molla nella scatola chiusa: k si impara insieme alla curva."""
    torch.manual_seed(seme)
    rete = nn.Sequential(
        nn.Linear(1, 32), nn.Tanh(),
        nn.Linear(32, 32), nn.Tanh(),
        nn.Linear(32, 32), nn.Tanh(),
        nn.Linear(32, 1),
    )
    t_c = 10.0 * torch.rand(200, 1)
    t_c.requires_grad_(True)
    # 25 misure equispaziate: la formula esatta con k = 4, piu' rumore
    t_oss = torch.linspace(0.0, 10.0, 25).reshape(-1, 1)
    t_np = t_oss.numpy()
    u_vera = torch.tensor(np.exp(-gamma * t_np) * (
        np.cos(omega_d * t_np) + (gamma / omega_d) * np.sin(omega_d * t_np)
    ), dtype=torch.float32)
    u_oss = u_vera + 0.05 * torch.randn(25, 1)

    k_appreso = nn.Parameter(torch.tensor(1.0))
    ottimizzatore = torch.optim.Adam(
        list(rete.parameters()) + [k_appreso], lr=1e-3
    )
    for _ in range(epoche):
        ottimizzatore.zero_grad()
        u = rete(t_c)
        u_t = torch.autograd.grad(u, t_c, torch.ones_like(u),
                                  create_graph=True)[0]
        u_tt = torch.autograd.grad(u_t, t_c, torch.ones_like(u_t),
                                   create_graph=True)[0]
        loss_fisica = ((m * u_tt + c * u_t + k_appreso * u) ** 2).mean()
        loss_dati = ((rete(t_oss) - u_oss) ** 2).mean()
        (loss_fisica + 100.0 * loss_dati).backward()
        ottimizzatore.step()

    t_griglia = torch.tensor(t_test, dtype=torch.float32).reshape(-1, 1)
    with torch.no_grad():
        errore = np.abs(rete(t_griglia).squeeze().numpy() - u_esatta).max()
    rumore = (u_oss - u_vera).abs().max().item()
    return k_appreso.item(), errore, rumore

for seme in (42, 7):
    k_stimato, errore_inv, rumore = problema_inverso(seme)
    print(f"seme {seme:2d}: k stimato {k_stimato:.2f}, scarto massimo "
          f"{errore_inv:.3f}, misura peggiore {rumore:.3f}")
seme 42: k stimato 3.95, scarto massimo 0.064, misura peggiore 0.114
seme  7: k stimato 3.76, scarto massimo 0.067, misura peggiore 0.122
E la loss_iniziale? Non serve più: l’ancoraggio che prima spettava alle
condizioni di partenza ora lo danno le 25 misure, e il loro termine ne prende
il posto, coefficiente compreso.
Il metodo non cambia. La rigidezza \(k\) è un parametro in più accanto ai pesi, e Adam lo aggiorna con la stessa regola, a partire dalla derivata \(\partial\mathcal{L}/\partial k\) che la backpropagation fornisce insieme ai gradienti della rete. Curva e legge si aggiustano nello stesso ciclo, finché non vanno d’accordo con le osservazioni.
Partendo dal valore volutamente sbagliato \(k = 1\), la stima arriva vicino al valore vero \(k = 4\), quello con cui avevamo fabbricato le misure: con il seme 42 (venticinque istanti equispaziati da 0 a 10 secondi, estremi compresi; rumore gaussiano di scarto tipico 0,05, sorteggiato dopo i punti di collocazione; trentamila epoche) si ferma a \(3{,}95\), e per arrivarci ricostruisce l’intera traiettoria. La rigidezza della molla, che nessuno ha misurato, esce come sottoprodotto dello stesso addestramento. Con il seme 7, che cambia insieme l’inizializzazione della rete e il rumore delle misure, si ferma a \(3{,}76\): una corsa sola non è una misura, e nemmeno due.
E c’è un dettaglio da raccogliere, dopo la brutta figura di poco fa. Qui la traiettoria ricostruita è più accurata di quella che avevamo ottenuto conoscendo la legge per intero, pur essendo il problema più difficile dei due: lo scarto massimo dalla curva vera è \(0{,}064\), e \(0{,}067\) con il seme 7, contro lo \(0{,}15\) di prima. Il motivo è tutto nella disposizione degli ancoraggi: prima la rete aveva un solo punto fermo, l’istante zero, e più si andava avanti nel tempo più era libera di inventare; qui ha venticinque misure sparse su tutto l’intervallo, che la tengono per mano fino in fondo. Sono rumorose e sono poche, ma sono dappertutto, ed è quello che conta.
Restano due sospetti legittimi. Con venticinque punti stesi su tutta la curva, non basterebbe unirli? E se la legge la conosciamo a meno di un numero, non basterebbe cercare quel numero direttamente, come si fa da sempre, adattando ai dati il moto della molla calcolato da un solutore classico? Le due prove si fanno in pochi secondi, e su cento sorteggi del rumore invece che su due:
from scipy.integrate import solve_ivp
from scipy.interpolate import CubicSpline
from scipy.optimize import least_squares

t_mis = np.linspace(0.0, 10.0, 25)                 # i 25 istanti delle misure
u_vera_mis = np.exp(-gamma * t_mis) * (
    np.cos(omega_d * t_mis) + (gamma / omega_d) * np.sin(omega_d * t_mis)
)

def molla(t, rigidezza, u0, v0):
    """Il moto della molla, integrato con un solutore classico."""
    moto = lambda _, y: [y[1], -(c * y[1] + rigidezza * y[0]) / m]
    sol = solve_ivp(moto, (0.0, 10.0), [u0, v0], t_eval=t,
                    rtol=1e-6, atol=1e-8)
    return sol.y[0]

rng = np.random.default_rng(0)
k_mq, err_mq, err_curva = [], [], []
for _ in range(100):
    u_mis = u_vera_mis + 0.05 * rng.standard_normal(25)
    # minimi quadrati sul modello fisico: incogniti k, u(0) e u'(0),
    # partendo da k = 1 come la PINN
    stima = least_squares(lambda p: molla(t_mis, *p) - u_mis,
                          x0=[1.0, u_mis[0], 0.0]).x
    k_mq.append(stima[0])
    err_mq.append(np.abs(molla(t_test, *stima) - u_esatta).max())
    # una curva morbida per i 25 punti, che della legge non sa niente
    curva = CubicSpline(t_mis, u_mis)(t_test)
    err_curva.append(np.abs(curva - u_esatta).max())

k_mq, err_mq = np.array(k_mq), np.array(err_mq)
print(f"curva per i punti: scarto massimo mediano {np.median(err_curva):.3f}")
print("minimi quadrati sul modello della molla:")
print(f"  scarto massimo mediano {np.median(err_mq):.3f}, "
      f"sotto {np.quantile(err_mq, 0.9):.3f} in 90 sorteggi su 100")
print(f"  k mediano {np.median(k_mq):.2f}, in 90 sorteggi su 100 fra "
      f"{np.quantile(k_mq, 0.05):.2f} e {np.quantile(k_mq, 0.95):.2f}")
print(f"  fermi su una frequenza sbagliata: {(k_mq < 3).sum()} su 100")
curva per i punti: scarto massimo mediano 0.112
minimi quadrati sul modello della molla:
  scarto massimo mediano 0.033, sotto 0.059 in 90 sorteggi su 100
  k mediano 3.99, in 90 sorteggi su 100 fra 3.91 e 4.09
  fermi su una frequenza sbagliata: 1 su 100
Unire i puntini con una curva morbida lascia uno scarto massimo attorno a \(0{,}11\), quanto sbagliano le misure peggiori: chi si limita a unire i puntini ne ricopia anche gli errori, e più preciso dei puntini che ha non può diventare. La PINN, a \(0{,}064\) e \(0{,}067\), sta sotto lo scarto delle misure che le sono state date: sbaglia meno del sensore da cui ha imparato, perché fra tutte le curve che passano vicino a quei venticinque punti la legge tiene solo quelle che una molla potrebbe davvero percorrere, e le altre le scarta, rumore compreso.
Il rivale giusto, però, è l’altro. L’adattamento ai minimi quadrati del modello della molla, con le stesse tre incognite che la PINN ricava di fatto (la rigidezza, la posizione e la velocità di partenza), fa meglio su tutti e due i fronti: lo scarto massimo mediano è la metà di quello della PINN, e in novanta sorteggi su cento resta sotto tutte e due le sue corse; la rigidezza esce fra \(3{,}91\) e \(4{,}09\) in novanta sorteggi su cento, un intervallo da cui il \(3{,}76\) del seme 7 resta fuori. Non è infallibile nemmeno lui (il problema non è convesso, e partendo da \(k = 1\) ogni tanto si ferma su una frequenza sbagliata), ma su un problema con tre incognite e un solutore a disposizione rimane superiore alla PINN. Il vantaggio della rete sta altrove: lo stesso impianto regge senza modifiche quando l’incognita è un campo intero invece di tre numeri, o quando l’equazione è alle derivate parziali e un adattamento come questo chiederebbe un solutore, e il suo aggiunto, scritti su misura.
Questa volta allo studente non si dice da dove parte la molla, e nemmeno quanto è dura. Gli si danno venticinque puntini segnati da un sensore un po’ distratto, ciascuno spostato di qualche centimetro in su o in giù, e la regola della molla con un buco al posto della rigidezza. Lui disegna una curva e scrive un numero nel buco; il professore dà i voti come prima sulla regola nei suoi istanti, e adesso anche sulla distanza dai venticinque puntini, che prendono il posto della partenza. A ogni consegna lo studente ritocca insieme la curva e il numero.
Il numero si lascia trovare perché la curva lo tradisce: una molla più dura oscilla più in fretta, e i puntini dicono quanto in fretta oscilla questa. Se fossero tutti sullo zero, nessun numero nel buco sarebbe meglio di un altro.
Un compagno che si limitasse a unire i puntini con un tratto morbido copierebbe anche gli sbagli del sensore, gobba per gobba. Lo studente no: una gobba che nessuna molla farebbe, la regola gliela fa pagare, e togliendola toglie anche buona parte dello sbaglio. Ma in classe c’è un terzo compagno, il più bravo. Sa già disegnare il moto di qualunque molla, purché gli si dica quanto è dura, da dove parte e con che velocità, e prova tre numeri finché il disegno passa vicino ai puntini. Fa meglio dello studente, anche se ogni tanto, partendo da una molla troppo morbida, si ferma su un’oscillazione sbagliata. Il suo segreto è anche il suo limite: funziona finché quello che manca sono pochi numeri e c’è già un programma che sa disegnare il moto. Quando a mancare è una mappa intera, come la pressione in ogni punto di un’arteria, lo studente fa lo stesso lavoro di sempre, e il compagno bravo deve farsi scrivere un programma nuovo.
Il problema risolto è \(\min_{\theta,k}\ \frac{1}{N_c}\sum_j r_{\theta,k}(t_j)^2 + \frac{\lambda_d}{N_d}\sum_i \big(u_\theta(t_i) - \tilde u_i\big)^2\), con \(r_{\theta,k} = m\,u_\theta'' + c\,u_\theta' + k\,u_\theta\), \(\lambda_d = 100\) e \(\tilde u_i\) le misure rumorose; la derivata rispetto a \(k\) del termine di fisica è \(\frac{2}{N_c}\sum_j r_{\theta,k}(t_j)\,u_\theta(t_j)\), e arriva con la stessa backward dei pesi. Le condizioni iniziali non sono imposte: \(u_0\) e \(v_0\) diventano incognite di fatto, fissate dai dati. Il parametro è identificabile perché la soluzione dipende da \(k\) attraverso \(\omega_d = \sqrt{k/m - \gamma^2}\), e su dieci secondi tre oscillazioni abbondanti ne fissano il periodo; con dati che non oscillano (una molla ferma al riposo) il residuo si annullerebbe per ogni \(k\).
Il termine di fisica agisce come una proiezione dei dati sulla varietà a tre
dimensioni delle soluzioni dell’equazione, parametrizzata da
\((k, u_0, v_0)\): l’interpolante cubica, che la ignora, ha un errore dell’ordine
del rumore, e la PINN scende sotto. Il termine di paragone corretto è però la
stima parametrica,
\(\min_{k,u_0,v_0}\sum_i \big(u(t_i;\,k,u_0,v_0) - \tilde u_i\big)^2\), con \(u\)
calcolata da un integratore (RK45 in solve_ivp) e minimizzata con un metodo a
regione di fiducia (least_squares): sotto rumore gaussiano indipendente è lo
stimatore di massima verosimiglianza, e su questi dati dimezza lo scarto della
PINN e concentra \(\hat k\) attorno a 4. Il suo punto debole è la non convessità
in \(k\), comune a ogni stima di una frequenza: la somma dei quadrati ha minimi
locali a frequenze sbagliate, e partendo da \(k = 1\) una piccola frazione delle
corse vi si ferma. La PINN si porta dietro lo stesso paesaggio in un’altra
forma, la varianza fra semi (\(3{,}95\) contro \(3{,}76\)). Il suo vantaggio è
strutturale: quando l’incognita è un campo (una diffusività
\(\alpha(\mathbf{x})\), una sorgente) la stima parametrica diventa un problema
vincolato da una PDE, che si risolve con il metodo dello stato aggiunto e un
solutore scritto su misura [Ple06], mentre la PINN resta lo
stesso problema non vincolato.
Sembra poco: tre modifiche. È moltissimo: è il medico legale che risale all’ora del decesso, il geofisico che deduce la struttura del sottosuolo dalle onde sismiche, l’ingegnere che stima l’usura di un componente dai sensori. È la famiglia di problemi in cui le PINN sono più naturali, ed è da lì che parte la sezione su dove la fisica aiuta e dove no, con l’avvertenza che «il meglio delle PINN» non vuol dire «meglio di tutti».
Da ricordare
Lo stesso meccanismo che finora diceva di quanto ritoccare ciascun peso sa dire anche quanto la curva della rete sale o scende in un istante, e quanto in fretta cambia quella pendenza, senza approssimazioni. La rete diventa una curva liscia, alla quale si può chiedere di rispettare una regola.
Il punteggio da abbassare somma due voci: le violazioni della regola negli istanti di controllo scelti a caso (i punti di collocazione) e gli scarti sulla partenza, cioè il punto da cui si parte e la pendenza con cui si parte (dove conta anche lo spazio, come nella sbarra che si scalda, entra qui pure quello che succede ai bordi). Alla partenza si dà di solito più peso, qui cento volte le altre voci. Ma su dieci ripartenze il peso cento e il peso uno sbagliano strada lo stesso numero di volte, cinque, e fra le corse riuscite quelle con il peso uno arrivano molto più vicine alla curva vera: quel peso si sceglie provando, e non garantisce la strada giusta.
La curva dev’essere liscia: se è fatta di segmenti dritti incollati uno dopo l’altro, come quelli che escono dalla ReLU, non ha curvatura da nessuna parte, e il professore non vedrebbe più il pezzo più importante della regola. Per questo qui si torna alla vecchia S centrata nello zero.
Il meccanismo deve registrare anche i propri conti (
create_graph=True): la pendenza appena calcolata serve altre due volte, per ricavarne la curvatura e per far arrivare la correzione fino ai pesi. È il motivo per cui un giro di addestramento di una PINN costa più di uno normale.Sulla molla con attrito (massa 1, attrito 0,4, rigidezza 4) la rete ricostruisce l’oscillazione senza aver mai visto un solo valore della soluzione oltre la partenza: un’oscillazione ogni 3,16 secondi e ampiezza scesa al 13,5% dopo 10 secondi. Non però con la precisione che la loss lascerebbe credere: lo scarto dalla curva vera arriva a 0,15, cioè al 15% dello spostamento di partenza, e nella seconda metà si fa più che doppio (0,07 sui primi cinque secondi, 0,15 sugli ultimi), lontano dall’unico ancoraggio: alla fine dell’intervallo l’oscillazione vera vale ormai quanto lo scarto, e là la rete ha smesso di seguirla.
Un punteggio basso non vuol dire risposta giusta, ed è la lezione da portarsi via. Le ripartenze con il punteggio migliore possono essere proprio quelle che sbagliano di più: stanno in riga dove il professore guarda e si lasciano andare in mezzo, fino a spegnere del tutto l’oscillazione. Su dieci ripartenze dello stesso programma metà finiscono così, e per accorgersene bisogna controllare la regola anche dove il professore non guarda, e rilanciare più di una volta.
Alla fine resta una curva intera, non una tabella di valori: le si chiede il valore a 3,7 secondi, o quanto sta salendo lì, in qualunque punto si voglia. Il valore fra due istanti calcolati lo dà bene anche un solutore maturo; della rete resta la curva liscia, con le sue pendenze.
Problema inverso: se un pezzo della regola manca (quanto è rigida la molla), diventa un numero in più che l’addestramento regola insieme alla curva, purché le misure ne portino traccia (una molla più dura oscilla più in fretta). Sono le misure, allora, a fare da ancoraggio al posto della partenza, e la regola ne scarta buona parte del rumore. Quando però a mancare sono pochi numeri e c’è già un programma che sa disegnare il moto, provare quei numeri direttamente fa meglio; il terreno delle PINN comincia dove a mancare è una mappa intera.
Da ricordare
Le stesse derivate automatiche usate finora sui pesi, calcolate rispetto all’ingresso (con
create_graph=Trueper poterle derivare ancora), rendono la rete \(u_\theta\) una funzione derivabile su cui si può imporre un’equazione differenziale.La loss di una PINN somma la media dei quadrati dei residui sui punti di collocazione (la fisica) e gli scarti su condizioni iniziali e al contorno (più gli eventuali dati), con coefficienti sugli ancoraggi da scegliere provando: sull’oscillatore \(\lambda_0 = 100\) non riduce le corse che collassano rispetto a \(\lambda_0 = 1\), e costa precisione. L’errore è controllato dall’integrale di \(|r_\theta|\) su tutto il dominio, che la loss stima solo sui punti di collocazione.
tanh, non ReLU: la ReLU ha derivata seconda nulla quasi ovunque e renderebbe cieco il residuo; l’attivazione deve avere tante derivate continue quante ne ha l’operatore.create_graph=Trueè la chiave pratica: mantiene derivabile la derivata, per poter calcolare \(u''\) e per far passarebackward()attraverso il residuo.Sull’oscillatore smorzato (\(m=1\), \(c=0{,}4\), \(k=4\)) la PINN si avvicina alla soluzione analitica \(u(t)=e^{-0{,}2t}(\cos\omega_d t + 0{,}1005\,\sin\omega_d t)\), \(\omega_d=\sqrt{3{,}96}\), senza aver visto un solo dato oltre le condizioni iniziali; ma con uno scarto massimo di \(\approx 0{,}15\), non di \(10^{-3}\), concentrato nella coda dell’intervallo.
Loss di fisica piccola non implica soluzione corretta. Su sei semi, le due corse con \(\mathcal{L}_{\text{fisica}}\) più bassa sono quelle con l’errore più grande: \(u \equiv 0\) annulla il residuo dell’equazione omogenea, e \(\lambda_0=100\) rende quella scorciatoia meno attraente ma non la vieta. Su dieci semi collassano cinque corse (al 95%, una frazione fra 0,24 e 0,76). Corollario operativo: più semi, la loss di fisica misurata anche fuori dai punti di collocazione, e mai fidarsi della sola loss.
L’idea è del 1994 [DPT94] (vincolo soft, penalità nella loss), con antecedenti al 1990 [LK90]; Lagaris 1998 [LLF98] è la variante a vincolo hard. L’esplosione del 2019 [RPK19] arriva quando la differenziazione automatica in librerie generali e le GPU la rendono praticabile.
Problema inverso: un coefficiente promosso a
nn.Parametersi stima da poche misure rumorose insieme alla soluzione, purché sia identificabile. Con tre incognite e un integratore a disposizione, però, l’adattamento ai minimi quadrati del modello fa meglio della PINN; il vantaggio della PINN è l’uniformità quando l’incognita è un campo.