


I modelli di riconoscimento#
Quando pronunci la parola «casa», il microfono del telefono non registra quattro lettere: registra circa sedicimila numeri al secondo. Ogni numero è un campione, la pressione dell’aria misurata in un istante. Sedicimila al secondo è la scelta abituale per la voce, e Dal suono alle feature la ricava dal teorema di Nyquist: bastano per tutte le frequenze che servono a capire chi parla, mentre la musica ne vuole quasi il triplo.
Il compito del riconoscimento vocale automatico (Automatic Speech Recognition, ASR) è trasformare questa fila di campioni in una fila di caratteri, e la difficoltà sta nella sproporzione: sedicimila numeri al secondo in ingresso, una quindicina di caratteri in uscita, e nessuna indicazione di quale pezzo di suono vada con quale lettera. È il problema dell’allineamento, e per decenni ha deciso il modo di costruire questi modelli.
Il problema dell’allineamento#
Prima di arrivare alla rete il segnale diventa uno spettrogramma: lo si taglia in finestre di circa 25 millesimi di secondo, una nuova ogni 10, e per ciascuna si misura quanta energia c’è a ogni frequenza, cioè a ogni altezza sonora. È la finestra di Hann del capitolo sull’audio, con i bordi sfumati e il passo che la fa sovrapporre alla vicina, e ogni finestra è uno dei frame della panoramica: un secondo di parlato ne dà un centinaio.
La riduzione non cancella la sproporzione: cento frame al secondo contro quei quindici caratteri, e nessuno ci dice quale frame corrisponde a quale lettera.
Sottotitolare un video a orecchio, senza avere i tempi. Chi parla lento, chi veloce; una vocale tenuta a lungo («caaasa») occupa molti fotogrammi ma resta una sola lettera; tra una parola e l’altra ci sono pause e respiri che non vanno scritti. Sai cosa è stato detto, ma non quando comincia e finisce ogni suono. Questo è l’allineamento: appaiare i tanti pezzetti di audio ai pochi caratteri del testo.
Una cosa però la sai già: si va nello stesso verso. Il video scorre, il testo scorre con lui, e quello che si sente prima è anche scritto prima. Un passaggio impastato lo si riascolta quante volte si vuole; quello che non capita mai è che una lettera debba scavalcare quella di prima.
I tempi si potrebbero anche segnare a mano, col cronometro, suono per suono: su un video si fa, su milioni di ore di registrazioni non lo farà nessuno. Restano le due cose che costa poco avere, la registrazione e la sua trascrizione, e da quelle due i tempi bisogna tirarli fuori da sé.
Abbiamo un input \(\mathbf{X} = (\mathbf{x}_1, \dots, \mathbf{x}_T)\) di \(T\) frame e un target \(y = (y_1, \dots, y_U)\) di \(U\) token (caratteri o sotto-parole): è la trascrizione che nella panoramica chiamavamo \(W\), vista qui come sequenza di simboli. Con \(T \gg U\), l’allineamento è monotono (l’audio scorre in avanti come il testo) ma sconosciuto: non abbiamo etichette frame per frame. Segmentare a mano milioni di ore per dire «da qui a qui c’è una a» è impraticabile. Serve un modello che impari l’allineamento da solo, dalla sola coppia (audio, trascrizione).
CTC: imparare ad allineare da soli#
La svolta arriva nel 2006, e l’idea è di Alex Graves e colleghi: aggiungere all’alfabeto un simbolo speciale, il «vuoto» (blank, \(\varnothing\)), che significa «qui non produco nessun carattere». Di mestieri ne fa due: sta dove non si pronuncia niente, nei silenzi e nei respiri, e tiene separate due lettere uguali di fila, che altrimenti si fonderebbero in una. Il metodo si chiama Connectionist Temporal Classification, in sigla CTC [GFernandezGS06].
Per ogni frame la rete non sceglie un simbolo secco: emette una distribuzione di probabilità sull’alfabeto esteso con il vuoto, \(p_t(\cdot \mid \mathbf{X})\), cioè un numero fra zero e uno per ogni simbolo, e tutti insieme sommano a uno. È come spartire cento punti di fiducia fra i simboli, dieci alla «A», due alla «B» e così via fino a esaurirli: nessun simbolo resta escluso, e tutta la fiducia finisce da qualche parte.
In Fig. 24.2 è disegnato, per ogni frame, il simbolo più probabile. Poi una regola di collasso ripulisce la sequenza: prima unisce i caratteri uguali consecutivi, poi elimina i vuoti.

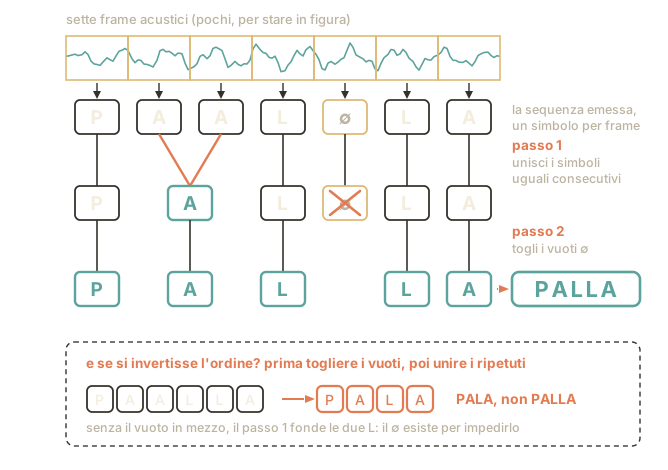
Fig. 24.2 Il meccanismo della CTC, un passo alla volta. Per ogni frame è disegnato il simbolo più probabile, e fra i candidati c’è anche il «vuoto» ∅; poi si uniscono i ripetuti consecutivi, e solo dopo si tolgono i vuoti. L’ordine decide tutto: invertendolo la doppia «L» si perde, ed è per impedirlo che il ∅ esiste. I frame disegnati sono sette perché ci stiano: per una parola come «palla» ne servirebbero una cinquantina, uno ogni dieci millesimi di secondo.#
Molti modi di etichettare i frame danno la stessa parola. Per «PALLA» va bene
P A A L ∅ L A, ma anche P P A L ∅ L A: entrambi, dopo aver unito i doppioni
e tolto i vuoti, diventano PALLA. Ciascuno dice quale pezzo di suono va con
quale lettera, e per questo si chiama allineamento.
Ogni allineamento ha una sua probabilità, cioè quanto la rete ci crede, e si ottiene moltiplicando fra loro i voti che la rete ha dato ai sette simboli di quella riga (i punti di fiducia, scritti come percentuali). Si moltiplica perché la rete vota ogni frame senza guardare che cosa ha votato negli altri: sette giudizi che non si parlano fra loro, come sette dadi tirati uno accanto all’altro, e allora la probabilità che escano tutti come vogliamo è il prodotto dei sette. Che i giudizi non si parlino è una scelta di chi ha costruito la CTC, e il suo prezzo arriva fra poco.
Sette voti moltiplicati fra loro danno un numero piccolo; mettiamo che il primo allineamento valga il 3% e il secondo il 2% (sono numeri inventati per l’esempio). Tutti e due, ripuliti, danno «PALLA»: quindi finora «PALLA» vale il 5%, più di quanto valga ciascuno da solo. «Finora», perché di modi che danno «PALLA» ce ne sono altri, e vanno sommati anche quelli.
La CTC, dunque, non chiede alla rete di indovinare l’allineamento giusto: somma le probabilità di tutti quelli che danno la trascrizione corretta, e l’addestramento chiede soltanto di alzare quel totale. Su quale modo spostare i voti per alzarlo sono affari della rete.
Gli allineamenti sono tanti anche per una parola di cinque lettere, e si
possono contare a mano. Il più corto mette una lettera per frame, più il vuoto
obbligatorio fra le due «L»: P A L ∅ L A, sei frame, e in sei frame non ce
n’è nessun altro. In cinque frame non ce ne sta nessuno: la parola giusta ha
probabilità zero, e l’addestramento non ha niente da alzare. Per questo la CTC
serve ad ascoltare e non a parlare: nella sintesi si parte dal testo, corto, e
si deve arrivare al suono, lungo, mentre la CTC sa soltanto accorciare. E i
frame che contano sono quelli su cui la rete vota davvero: se prima di votare
ne riassume otto in uno, dei cento frame di un secondo restano dodici voti e
mezzo, meno delle lettere che chi parla svelto pronuncia in un secondo, e la
sua frase non ci sta. Con pezzi di parola al posto delle lettere singole, i
voti tornano a bastare.
Con sette frame il settimo si può spendere in due modi. Il primo è allungare
uno dei sei simboli della riga, tenendolo per due frame: sei simboli, sei modi
(P P A L ∅ L A, P A A L ∅ L A, …). Il secondo è aggiungere un vuoto dove
non ce n’è già uno: all’inizio, alla fine o fra due lettere attaccate, e i
punti così sono cinque (aggiungerlo accanto al vuoto che c’è già vorrebbe dire
allungare quello, cioè un caso già contato). Sei più cinque, undici.
Con cinquanta frame, che sono quelli che «palla» occupa davvero, i modi
diventano quasi ventiquattro miliardi: a mano non si contano più, e a contarli
è la stessa tabella con cui si sommano. Sommarli tutti sembra un lavoro
impossibile, e invece si fa in fretta, perché i modi si somigliano: prendine
due che per i primi tre frame sono identici e si separano al quarto, e il
conto dei primi tre frame è lo stesso per tutti e due. Basta farlo una volta e
riusarlo. Messi insieme i modi che condividono l’inizio, il lavoro diventa
riempire una tabella lunga cinquanta colonne, una per frame, e alta quanto
«palla» scritta con i vuoti dentro e ai lati, ∅P∅A∅L∅L∅A∅: undici righe, e
cinquecentocinquanta caselle in tutto. È lo stesso risparmio del navigatore
di Viterbi di
POS tagging ed entità,
con una differenza che fra poco conterà: là in ogni casella sopravviveva il
cammino migliore, qui si sommano tutti.
C’è però un prezzo. La rete vota un frame alla volta, e ogni voto lo dà guardando il suono e nient’altro: non si rilegge mai quello che ha già scritto. Non sa, cioè, che dopo «c-a-n» in italiano viene molto più facilmente una «e» che una «q». È un’ignoranza che le costerà cara, e a cui qualcun altro dovrà rimediare al posto suo.
La probabilità di una trascrizione \(y\) è la somma su tutti i percorsi frame-level \(\pi\) che, collassati, la producono:
dove \(\pi = (\pi_1, \dots, \pi_T)\) è un allineamento a livello di frame,
\(p_t(\pi_t \mid \mathbf{X})\) è la probabilità che la rete assegna al simbolo
\(\pi_t\) al frame \(t\), e \(\mathcal{B}\) è la funzione di collasso. Qui \(T\)
conta le posizioni su cui la rete emette una distribuzione: se l’encoder
sottocampiona l’asse del tempo, come di solito accade, sono meno dei frame in
ingresso, e tutto quello che segue vale per loro. Quanti sono i
termini si conta con la stessa formula, mettendo tutte le \(p_t\) a uno: per
PALLA sono undici sui sette frame della figura, mille e uno su dieci frame,
quasi ventiquattro miliardi sui cinquanta che quella parola occupa davvero. La
somma si calcola comunque in tempo \(O(T \cdot U)\) (lineare nella lunghezza
dell’audio, a trascrizione fissata) per programmazione dinamica sul reticolo
della trascrizione estesa
\(y' = (\varnothing, y_1, \varnothing, y_2, \dots, y_U, \varnothing)\), lunga
\(2U+1\). Sia \(\alpha_t(s)\) la probabilità totale dei prefissi di percorso lunghi
\(t\) che finiscono su \(y'_s\) e, collassati, danno il prefisso di \(y\) che
\(y'_{1:s}\) contiene. Si parte da
\(\alpha_1(1) = p_1(\varnothing \mid \mathbf{X})\),
\(\alpha_1(2) = p_1(y_1 \mid \mathbf{X})\), zero altrove, e si avanza con
dove il terzo addendo è il salto che scavalca un vuoto, vietato fra due simboli uguali; alla fine \(p(y \mid \mathbf{X}) = \alpha_T(2U+1) + \alpha_T(2U)\), perché il percorso può chiudere sull’ultimo vuoto o sull’ultima lettera. È la ricorsione forward degli HMM di POS tagging ed entità, con la somma al posto del massimo di Viterbi; la gemella all’indietro \(\beta_t(s)\), che nel paper conta anche lei il voto al frame \(t\), dà con \(\alpha_t(s)\beta_t(s)/p_t(y'_s \mid \mathbf{X})\) la massa dei percorsi che passano per \((t, s)\), e da lì il gradiente rispetto a ogni uscita \(p_t(k \mid \mathbf{X})\) [GFernandezGS06]. Su mille frame un prodotto di probabilità scende sotto il più piccolo numero che il formato sa scrivere, e per questo la ricorsione si fa in log, o riscalando ogni colonna come nel paper. Si addestra minimizzando \(\mathcal{L} = -\log p(y \mid \mathbf{X})\).
Due limiti strutturali. Il primo è una conseguenza diretta della formula: la
CTC emette esattamente un simbolo per posizione, quindi le posizioni devono
bastare, e la soglia è \(T \ge U + r\), dove \(r\) conta le coppie di simboli
uguali consecutivi in \(y\), ciascuna delle quali vuole in mezzo un vuoto che la
separi. Sotto quella soglia \(\mathcal{B}^{-1}(y)\) è l’insieme vuoto,
\(p(y \mid \mathbf{X}) = 0\) e la loss vale \(+\infty\): ctc_loss di PyTorch
restituisce proprio inf, e con zero_infinity=True azzera quelle loss e i
loro gradienti, che altrimenti guasterebbero l’addestramento. PALLA ha
\(U = 5\) e \(r = 1\): in cinque posizioni non ci sta, in sei ci sta in un modo
solo (P A L ∅ L A), e da lì in poi i modi si moltiplicano. Siccome \(T\) è la
lunghezza dopo il sottocampionamento, il vincolo pesa sulla scelta dell’unità
di uscita: con un encoder che riduce l’asse del tempo di un fattore \(8\), le
posizioni sono \(12{,}5\) al secondo, meno dei caratteri di un parlato svelto,
mentre con un’unità più lunga, la sotto-parola, il vincolo torna largo. È
anche il motivo per cui il metodo serve all’ascolto e non alla sintesi vocale,
dove il testo in ingresso è più corto del suono in uscita
[Gra12]. Il secondo, il più citato, è invece un’ipotesi che
la formula presuppone invece di dedurla, e l’articolo del 2006 la dichiara
[GFernandezGS06]: il prodotto
\(\prod_t p_t(\pi_t \mid \mathbf{X})\) si può scrivere solo perché le uscite ai
vari frame sono condizionatamente indipendenti, e a garantirlo è un vincolo di
architettura, nessuna connessione di ritorno dallo strato di uscita a se
stesso. Nel prodotto non c’è quindi nessun fattore della forma
\(p(y_u \mid y_{<u})\); e togliere quel vincolo è esattamente la mossa del
trasduttore. Non è che la
CTC modelli «non bene» le dipendenze fra i caratteri in uscita: non ha il posto
dove metterle. Torneremo su questo punto parlando del modello di linguaggio,
perché è di lì che discende tutto il resto.
Una conseguenza dell’addestramento si vede alla prima esecuzione: la rete concentra ogni simbolo su un frame, o su pochi, e dà il vuoto quasi a tutti gli altri, sicché le sue uscite formano una fila di picchi separati da vuoti [GFernandezGS06]. La CTC dice in che ordine vengono i simboli e più o meno dove cadono, ma non quanto durano: per le durate dei fonemi serve un allineatore forzato, come quello che La voce sintetica incontra in FastSpeech 2.
Il reticolo su cui si fa quella somma, cioè la tabella con una colonna per frame e una riga per simbolo, ha una forma, e conviene guardarla: Fig. 24.3 lo disegna sui sette frame della parola d’esempio.
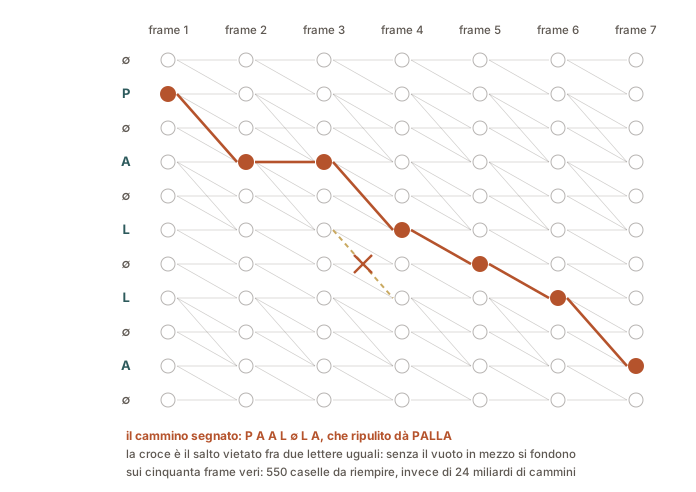
Fig. 24.3 Le righe sono «palla» con i vuoti dentro e ai lati, le colonne i frame. Da ogni casella si può restare dove si è, scendere di una riga o scenderne due scavalcando un vuoto, e il salto è l’unica mossa che ha un divieto: fra le due «L» il vuoto va attraversato, o le due lettere si fondono. Ogni cammino che arriva in fondo è un allineamento, e la somma di tutti si fa riempiendo le caselle una volta sola invece di seguire i cammini uno per uno.#
Alla CTC non importa da dove vengano le distribuzioni che somma, e per questo si monta volentieri sopra reti addestrate per altro. wav2vec 2.0 e HuBERT, i modelli di Imparare dal suono senza etichette, imparano com’è fatto il parlato da decine di migliaia di ore di audio senza trascrizione [BZMA20, HBT+21]; per farli trascrivere ci si aggiunge sopra uno strato che emette una distribuzione per posizione, e lo si addestra con questa stessa loss su poche ore trascritte, a volte dieci minuti. Le condizioni della CTC restano tutte: il vincolo sulla lunghezza conta le posizioni del modello pre-addestrato, una ogni venti millesimi di secondo, e i caratteri in uscita restano indipendenti fra loro, un debito che si salda con il modello di linguaggio.
Dalla rete alla frase: la decodifica#
Fin qui si è visto come si addestra un modello CTC, non come gli si fa produrre una trascrizione. Il passaggio dalle distribuzioni di ogni frame alla frase scritta si chiama decodifica, e le due strade più ovvie non portano allo stesso risultato.
La più semplice prende, frame per frame, il simbolo più probabile, e poi collassa la sequenza. Si chiama decodifica del percorso migliore (best path), costa un passo per frame, ed è quella di quasi tutto il codice di esempio. Calcola però il percorso più probabile, non la trascrizione più probabile, e i due in generale non coincidono.
Il caso più piccolo possibile: due frame soltanto, e un alfabeto di due simboli, il vuoto ∅ e la lettera «A». Su ciascuno dei due frame la rete dà il 60% al vuoto e il 40% alla «A». Ci sono quattro percorsi, e per ognuno la probabilità è il prodotto dei due voti:
percorso |
probabilità |
dopo la ripulitura |
|---|---|---|
∅ ∅ |
0,6 × 0,6 = 36% |
(niente) |
∅ A |
0,6 × 0,4 = 24% |
A |
A ∅ |
0,4 × 0,6 = 24% |
A |
A A |
0,4 × 0,4 = 16% |
A (le due si fondono) |
Il percorso più probabile è ∅ ∅, con il 36%, e non scrive niente. Ma la
lettera «A» esce da tre percorsi diversi, e insieme fanno 24 + 24 + 16 = 64%:
quasi il doppio. Prendendo il percorso migliore avremmo trascritto il
silenzio; sommando come fa la CTC, la risposta è «A».
E succede davvero, non solo negli esempi costruiti ad arte: capita ogni volta che una trascrizione è sostenuta da tanti percorsi mediocri e un’altra da un percorso solo, molto convinto; e di percorsi che danno la stessa parola ce ne sono a miliardi, come abbiamo contato per «palla».
Il best path massimizza il singolo allineamento,
mentre l’obiettivo che il modello è stato addestrato a massimizzare è
\(\arg\max_y p(y \mid \mathbf{X})\), cioè la somma su
\(\mathcal{B}^{-1}(y)\). Le due
quantità sono diverse perché \(\mathcal{B}\) non è iniettiva: molti percorsi
cadono sulla stessa etichettatura, e la loro massa può battere il massimo
puntuale. Il controesempio minimo ha \(T = 2\) e alfabeto
\(\{\varnothing, \texttt{A}\}\), con \(p_t(\varnothing) = 0{,}6\) su entrambi i
frame: il percorso migliore è \(\varnothing\varnothing\) e vale \(0{,}36\), ma
l’etichettatura A raccoglie i tre percorsi restanti e vale
\(0{,}24 + 0{,}24 + 0{,}16 = 0{,}64\).
Graves e colleghi lo scrivono già nel paper del 2006 [GFernandezGS06], nella sezione in cui costruiscono il classificatore: per l’\(\arg\max\) esatto «non conosciamo un algoritmo di decodifica trattabile in generale». Al suo posto propongono due metodi approssimati. Il primo è proprio il best path, che costa niente e non garantisce di trovare l’etichettatura più probabile. Il secondo è la prefix search decoding, che lavora sui prefissi invece che sui percorsi e, dato tempo a sufficienza, l’etichettatura più probabile la trova davvero. Il tempo però cresce in fretta, perché il numero di prefissi da espandere cresce esponenzialmente con la lunghezza dell’audio; gli autori osservano che se la distribuzione in uscita è abbastanza appuntita la ricerca finisce comunque in tempi ragionevoli, ma per il loro stesso esperimento servì un’euristica in più (spezzare la sequenza dove il vuoto è molto probabile). Quella che si usa oggi è la versione con un tetto: una ricerca a fascio sui prefissi, che ne tiene aperti \(k\) e getta gli altri.
La ricerca a fascio (beam search) l’abbiamo già incontrata in Da frase a frase: tradurre con le reti: invece di decidere subito, si tengono aperte le \(k\) ipotesi più promettenti (Whisper, più avanti, ne tiene cinque) e si va avanti qualche passo prima di scegliere. L’idea è la stessa, ma una cosa cambia, ed è proprio quella di prima: qui molti percorsi diversi danno la stessa identica parola. Nella traduzione le ipotesi competono: due strade diverse sono due frasi diverse, e alla fine ne resta una. Nella CTC no: due percorsi che si ripuliscono nello stesso testo sono la stessa ipotesi, e i loro punteggi vanno sommati invece di essere messi in concorrenza. Una ricerca a fascio che se ne dimentica può scartare la trascrizione giusta, come il percorso migliore.
Il caso dei due frame si rifà in poche righe di codice, elencando i quattro percorsi e sommandoli, ed è il modo più rapido di convincersene: il percorso più votato vale 0,36 e non scrive niente, la lettera «A» vale 0,64.
import itertools

VUOTO = "∅"
# i voti della rete: due frame, due simboli
voti = [{VUOTO: 0.6, "A": 0.4},
        {VUOTO: 0.6, "A": 0.4}]

def collassa(percorso):
    """Prima unisce i simboli uguali consecutivi, poi toglie i vuoti."""
    uniti = [s for i, s in enumerate(percorso)
             if i == 0 or s != percorso[i - 1]]
    return "".join(s for s in uniti if s != VUOTO)

def probabilita(percorso):
    p = 1.0
    for t, s in enumerate(percorso):
        p *= voti[t][s]
    return p

# tutte le trascrizioni, con la somma dei percorsi che le producono
totali = {}
for percorso in itertools.product(VUOTO + "A", repeat=len(voti)):
    testo = collassa(percorso)
    totali[testo] = totali.get(testo, 0.0) + probabilita(percorso)

# il percorso migliore: il simbolo più votato a ogni frame
migliore = tuple(max(v, key=v.get) for v in voti)

print("percorso migliore:", "".join(migliore),
      "->", repr(collassa(migliore)), round(probabilita(migliore), 3))
for testo, p in sorted(totali.items(), key=lambda kv: -kv[1]):
    print(f"  p(y = {testo!r}) = {p:.2f}")

# la promessa del testo, resa eseguibile
assert totali["A"] > totali[collassa(migliore)]
percorso migliore: ∅∅ -> '' 0.36
  p(y = 'A') = 0.64
  p(y = '') = 0.36
Da qui in avanti, quando diremo che un sistema CTC «trascrive», intendiamo una ricerca di questo tipo, non il simbolo più votato frame per frame.
Ascoltare e attendere: i modelli con attenzione#
La CTC è una prima famiglia di modelli. Ce n’è una seconda, e il vuoto non ce l’ha proprio. Il lavoro qui è diviso fra due parti della stessa rete: una ascolta tutto l’audio e se lo riassume (si chiama encoder, «codificatore»), l’altra scrive il testo un carattere alla volta (il decoder), e ogni carattere lo sceglie tenendo conto di quelli che ha già scritto. In gergo si dice che procede in modo autoregressivo, cioè rileggendosi.
A ogni passo il decoder deve decidere quale pezzo di audio guardare, e la cosa che glielo fa decidere si chiama attenzione. È di nuovo l’allineamento da cui siamo partiti, e anche qui il modello se lo impara da solo; la differenza con la CTC è che la CTC è obbligata ad andare avanti frame per frame, mentre l’attenzione può dare peso a qualunque punto dell’audio, avanti o indietro: l’allineamento diventa morbido, una distribuzione di pesi sui frame invece di un cammino che li visita uno dopo l’altro. L’architettura di riferimento è Listen, Attend and Spell [CJLV16], ed è da lì che viene «ascoltare e attendere»: «attendere» traduce l’inglese attend, che non vuol dire aspettare ma «fare attenzione a».
Un interprete che traduce a discorso finito prima ascolta l’intera frase, poi la ridice parola per parola. Mentre pronuncia ogni parola, la sua attenzione torna al punto giusto di ciò che ha sentito. Il modello fa lo stesso: genera un carattere, si «riguarda» la porzione di audio più rilevante, genera il prossimo.
E l’interprete non riparte da zero a ogni parola: tiene il filo di quello che ha appena detto, e dopo «i bambini» dirà «giocano», non «gioca». Da questo rileggersi il modello ricava gratis un orecchio per la lingua, che nessuno gli ha insegnato: sa come continuano le frasi, e ci si appoggia quando il suono è confuso.
L’interprete, però, paga due prezzi. Il primo è che, per cominciare, deve aver ascoltato la frase fino in fondo: un modello così non può scrivere mentre uno sta ancora parlando. Il secondo è che niente gli impedisce di sbagliare punto. Può riguardare un pezzo di audio che ha già tradotto, o saltarne uno del tutto, e allora ripete una sillaba o si mangia una parola; nei casi peggiori si impunta e ripete la stessa cosa all’infinito. La CTC questo difetto non ce l’ha, perché va avanti frame per frame e indietro non torna mai.
Al passo \(i\) il decoder costruisce un vettore di contesto come media pesata degli stati dell’encoder \(\mathbf{h}_j\) (è la stessa formula dell’attenzione di Bahdanau vista nella traduzione automatica, con l’audio al posto della frase sorgente):
dove i pesi di attenzione \(\alpha_{ij}\) dicono quanto lo stato \(j\) conta per produrre il token \(i\)-esimo, e \(T_{\text{enc}} \le T\) è il numero di stati dell’encoder: l’encoder tipicamente sottocampiona l’asse temporale (in LAS di un fattore 8), proprio per rendere trattabile l’attenzione su sequenze lunghe. A differenza della CTC, il decoder condiziona ogni token su quelli già emessi: modella cioè le dipendenze del testo in uscita, ed è per questo che un modello del genere si porta dentro un modello di linguaggio senza che nessuno gliel’abbia messo.
Il prezzo si paga altrove, e non è la generazione sequenziale più lenta. È che nulla vincola \(\alpha_{ij}\) ad avanzare al crescere di \(i\): la CTC ha la monotonia per costruzione, l’attenzione la deve imparare, e niente le impedisce di saltare una porzione di audio, di riguardarne una già trascritta o di restare ferma dov’è. Da lì vengono le parole mancanti, le sillabe ripetute e i loop di ripetizione, che ritroveremo identici (stessa causa, altro compito) nella sintesi vocale. C’è poi un secondo prezzo, che conta appena si esce dal laboratorio: la somma corre su tutti gli stati dell’encoder, quindi il primo token non può uscire prima che sia arrivato l’ultimo frame. Un modello così non trascrive mentre ascolta.
Una tecnica di addestramento ha contato, per questi modelli, quanto un’architettura. SpecAugment [PCZ+19] non tocca la rete: guasta l’ingresso, e lo guasta sullo spettrogramma invece che sull’onda. A ogni esempio azzera alcune bande di frequenza contigue e alcuni tratti di frame contigui (e, nella versione originale, deforma leggermente l’asse del tempo), con larghezze estratte a caso entro un tetto. Il modello impara così a trascrivere anche quando un pezzo dell’immagine manca, che è la condizione di un fonema coperto da un rumore o di una banda tagliata da un microfono. Con quel guasto nell’ingresso, e con la stessa architettura resa più grande e addestrata più a lungo, LAS arrivò al miglior risultato pubblicato di allora su LibriSpeech, la raccolta di audiolibri letti che fa da prova d’esame comune. La ragione, scrivono gli autori, è che i dati guastati trasformano un problema di overfitting (la rete che impara a memoria gli esempi) in uno di underfitting (la rete che non riesce più a seguirli tutti), e a quel punto una rete più grande torna a rendere. Coprire a tratti l’ingresso è anche il gesto di wav2vec 2.0, un anno dopo: le sue rappresentazioni del suono le copre con una strategia che dichiara simile a questa, e ne fa un compito, indovinare che cosa c’era sotto, invece di un disturbo da sopportare.
Il trasduttore neurale (RNN-T)#
Messe una accanto all’altra, le due famiglie sembrano costringere a una scelta. La CTC scorre l’audio in avanti e non torna mai indietro, ma non sa niente di quello che ha già scritto. Il decoder con attenzione sa benissimo che cosa ha già scritto, ma per farlo deve aver ascoltato tutto, e per giunta può perdere il segno. La scelta si evita con una terza famiglia, che tiene le due cose insieme: il trasduttore neurale, proposto da Alex Graves nel 2012 [Gra12], cioè da chi aveva scritto la CTC sei anni prima. Nei testi si trova sempre con la sigla RNN-T, dove le prime tre lettere sono le reti ricorrenti del capitolo sul linguaggio naturale, quelle che leggono una sequenza un pezzo alla volta tenendosi in mente il pezzo di prima.
Quella data va guardata. Il trasduttore non arriva dopo i modelli con attenzione per rimediare ai loro difetti: precede di tre anni Listen, Attend and Spell (2015, in conferenza l’anno dopo) e di due il primo riconoscitore con attenzione. È nato dal lato della CTC, per toglierle il difetto che il suo autore le conosceva meglio di chiunque.
Scrivere mentre si ascolta, però, non viene gratis né alla CTC né al trasduttore: dipende dall’encoder, la parte che ascolta. Se prima di decidere su un frame ascolta la registrazione anche dalla fine verso l’inizio, per sapere come va a finire la parola, deve aspettare che la registrazione sia finita, ed erano di questo tipo tanto la rete dell’articolo del 2006 quanto quella del 2012. Con un encoder che guarda solo il passato, CTC e trasduttore trascrivono in diretta; il decoder con attenzione no, perché vuole tutto l’audio prima di cominciare.
E se si scrivesse mentre l’altro parla? È il mestiere dello stenografo sotto dettatura: non aspetta la fine del discorso come l’interprete, scrive mentre ascolta, e non torna mai indietro sul nastro. Però ha sotto gli occhi il foglio, cioè quello che ha appena scritto, e quel foglio lo aiuta: se ha scritto «buon», la parola dopo sarà più probabilmente «giorno» che «gnorno».
Il trasduttore è questo. A ogni istante ha due mosse possibili: scrivere un carattere (e allora rilegge il foglio aggiornato, ma resta fermo sull’audio) o passare al frame successivo senza scrivere niente. Questa seconda mossa è il vuoto, che qui cambia mestiere: non separa più le lettere, dice soltanto «avanti». Alternando le due mosse copre tutto l’audio e produce tutto il testo, senza mai tornare indietro e senza mai dimenticare quello che ha già messo giù. Le due «L» di PALLA, qui, non hanno bisogno di niente in mezzo: nessuno fonde più i simboli uguali, si scrivono due volte e basta.
Quando scrivere e quando spostarsi non gliel’ha detto nessuno. I ritmi possibili sono moltissimi, come i modi di etichettare i frame nella CTC, e in addestramento contano tutti insieme: quello che si spinge in alto è il totale, non un ritmo in particolare.
Restando fermo sull’audio, in teoria, potrebbe scrivere all’infinito: a fermarlo non c’è una regola, c’è il fatto che dopo aver scritto quello che quel pezzo di suono conteneva, il vuoto, cioè l”«avanti», diventa la mossa più votata, e allora si sposta. Se un modello mal addestrato si incaponisce a scrivere, infatti, esce proprio quello: una parola ripetuta finché qualcuno non stacca la spina.
E quel foglio, quello che lo stenografo si rilegge, dentro il trasduttore è una rete a sé: la prediction network, «la rete che prevede», il cui unico mestiere è guardare le lettere già scritte e dire cosa ci si aspetta dopo. È la cosa che alla CTC manca del tutto.
Il trasduttore accoppia tre reti: un encoder (o transcription network) che produce \(\mathbf{h}_t\) dai frame acustici, una prediction network che produce \(\mathbf{g}_u\) dai soli token già emessi \(y_{<u}\), e una piccola joint network che fonde le due e proietta sul vocabolario esteso col vuoto (dove il vuoto non separa più simboli uguali: vuol dire «passa al frame dopo»),
dove \(s\) è il simbolo candidato, \(\phi\) una non linearità (di solito una tangente iperbolica) e \(\mathbf{W}_o\) la proiezione sul vocabolario (il pedice la tiene distinta dal \(W\) della trascrizione). Scritta così, la somma presuppone che \(\mathbf{h}_t\) e \(\mathbf{g}_u\) abbiano la stessa dimensione: nelle implementazioni ciascuna passa prima per una proiezione lineare propria, \(\phi(\mathbf{W}_h\mathbf{h}_t + \mathbf{W}_g\mathbf{g}_u + \mathbf{b})\). Nella formulazione originale del 2012 le due reti si sommavano direttamente nello spazio delle uscite; la joint network con la non linearità in mezzo è la forma che si è imposta dopo, ed è quella che si trova nelle librerie.
Lo spazio degli allineamenti non è più una sequenza di \(T\) etichette ma un
reticolo: emettere un token muove di uno in verticale, emettere il vuoto muove
di uno in orizzontale, e ogni cammino monotono che copre tutti i frame ed emette
tutti i token è un allineamento valido. L’ultimo simbolo è sempre un vuoto,
quello che chiude l’ultimo frame, quindi liberi da disporre restano \(T-1\) vuoti
e \(U\) token: i cammini sono \(\binom{T+U-1}{U}\), cioè \(3\,162\,510\) per PALLA
sui cinquanta frame di prima, e non i \(3\,478\,761\) di \(\binom{T+U}{U}\), che è
la forma che si scrive dimenticando il vuoto finale. La probabilità della
trascrizione è ancora la somma su tutti i cammini. Con \(\alpha(t,u)\) la massa
dei cammini che sono arrivati al frame \(t\) (ne hanno chiusi \(t-1\), un vuoto per
ciascuno) dopo aver emesso i primi \(u\) token,
e \(p(y \mid \mathbf{X}) = \alpha(T,U)\,p(\varnothing \mid T,U)\): due transizioni invece delle tre della CTC, e la loss è ancora \(-\log p(y \mid \mathbf{X})\) [Gra12]. Il costo che la formula nasconde è la memoria: la joint network si valuta in ogni nodo del reticolo e restituisce una distribuzione sull’intero vocabolario \(\mathcal{V}\) (vuoto compreso), quindi il tensore delle uscite è \(T \times (U+1) \times |\mathcal{V}|\). Con mille frame, cento token e quattromila sotto-parole sono quattrocento milioni di numeri, \(1{,}6\) GB in precisione singola per un solo esempio; per questo le implementazioni lo calcolano a pezzi, o potano il reticolo attorno a un allineamento stimato.
Due conseguenze, ed è tutto il punto. La prediction network è a tutti gli effetti un modello di linguaggio interno, condizionato sui token già emessi: il trasduttore modella cioè le dipendenze uscita-uscita che la CTC non ha dove mettere. E con un encoder causale \(\mathbf{h}_t\) dipende solo dai frame fino a \(t\), quindi la decodifica è frame-sincrona e non ha bisogno della fine dell’audio: si trascrive mentre si ascolta.
L’encoder causale, però, va scelto apposta. Nel paper del 2012 la transcription network era una rete ricorrente bidirezionale, perché ogni uscita dipendesse dall’intera sequenza in ingresso [Gra12], e il trasduttore originale lo streaming non lo faceva: la versione che trascrive in diretta è venuta dopo, con un encoder che guarda solo il passato [HSP+19]. Oggi l’encoder, di un trasduttore come di una CTC, è spesso un Conformer [GQC+20]: un Transformer in cui ogni blocco affianca all’auto-attenzione, che lega posizioni lontane, un modulo convolutivo, che coglie le regolarità locali come il passaggio da un fonema al successivo.
Il trasduttore è anche l’architettura che Google ha portato dentro il telefono: He e colleghi descrivono un riconoscitore che trascrive in diretta senza mandare l’audio a un server, due volte più veloce del tempo reale su un telefono Pixel [HSP+19]. È la condizione della dettatura, dove la risposta deve arrivare mentre si parla e il modello deve stare dentro il dispositivo. Fra poco ci chiederemo a che cosa serva ancora, oggi, la vecchia catena a stadi.
Whisper e i Transformer end-to-end#
Nel settembre 2022 OpenAI rilascia Whisper, e la novità si dice in una riga: una rete sola, che riceve lo spettrogramma log-mel del suono e restituisce il testo, senza un dizionario di pronuncia né un modello di linguaggio separati. La rete è un Transformer, diviso in encoder e decoder come i modelli con attenzione di poco fa; e il log-mel è lo spettrogramma di sempre, con le altezze sonore («mel») e i volumi («log») misurati come li sente l’orecchio, e non come li misurerebbe uno strumento. È la stessa catena della figura di Whisper nel capitolo sull’audio, con il blocco del Transformer aperto nelle sue due metà.

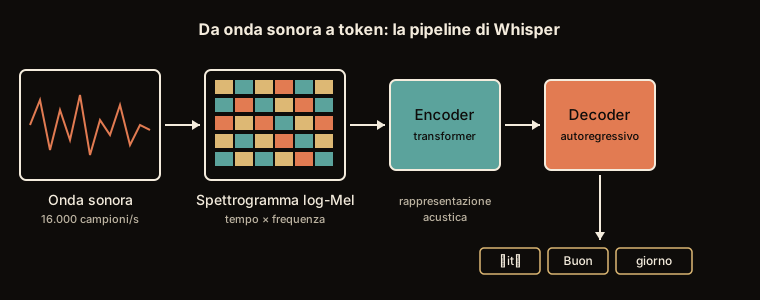
Fig. 24.4 La catena di Whisper, tutta qui. Fra lo spettrogramma e il testo non c’è nessuno stadio con regole scritte a mano: encoder e decoder sono addestrati insieme, in un pezzo solo.#
Quello che manca in Fig. 24.4 conta quanto quello che c’è. Un riconoscitore a stadi ha tre pezzi da mettere a punto lingua per lingua: il modello acustico, che giudica a quali suoni somiglia ogni frammento; il modello di linguaggio; e, fra i due, il dizionario di pronuncia, un elenco compilato a mano che dice di quali fonemi è fatta ogni parola. La catena di montaggio di Fig. 24.1 mostrava i primi due, e il terzo non compare in nessuno dei due disegni.
Quei tre compiti restano anche qui, ma nessuno li ha più assegnati a un pezzo suo: sono sparsi nei pesi, cioè nei numeri che la rete ha imparato. Con un modello solo non c’è più niente da compilare a mano lingua per lingua, il dizionario di pronuncia per primo: aggiungere una lingua vuol dire darle altro audio con la sua trascrizione, non scriverle un pezzo su misura. Che convenga mettere tante lingue e tanti compiti nella stessa rete, però, dipende dalla taglia. Gli autori di Whisper lo misurano sul riconoscimento dell’inglese: a parità di calcolo, i modelli piccoli addestrati su tutte le lingue e tutti i compiti sbagliano più di quelli addestrati sul solo inglese, e solo i più grandi rovesciano il confronto.
La sua forza, del resto, sta più nei dati che nell’architettura: le 680.000 ore di audio della panoramica, raccolte dal web con etichettatura debole, cioè trascrizioni già esistenti in rete, scritte da qualcuno per i propri scopi e non per addestrare un modello. «Debole» non vuol dire «non curata». Gli autori le passano al setaccio con filtri automatici, buttando via quelle prodotte da altri riconoscitori (imparare da un altro riconoscitore vuol dire ereditarne gli errori) e i duplicati; e ispezionano a mano le fonti che sbagliano di più, per eliminarle. Le coppie in cui la lingua parlata non è quella scritta le buttano via anche loro, con un’eccezione che conta: se il testo è in inglese la coppia resta, e diventa un esempio di traduzione. Sono 125.000 ore, e sono la ragione per cui lo stesso modello, oltre a trascrivere, traduce.
Quelle ore coprono quasi cento lingue, l’inglese e altre novantasei, ma non allo stesso modo: l’inglese se ne prende circa due terzi, e la maggior parte delle altre sta sotto le mille ore. È da qui che viene il salto di qualità che si sente passando all’italiano, e gli autori ne ricavano una stima, da una regressione fatta fra le lingue: il tasso di errore, cioè la quota di parole sbagliate, si dimezza ogni volta che le ore si moltiplicano per sedici. Da mille a sedicimila ore l’errore atteso si dimezza, e per dimezzarlo ancora ne servirebbero duecentocinquantaseimila: il costo di fare meglio cresce in fretta. La regressione confronta lingue diverse, però, e non dice che portare una lingua precisa a sedicimila ore ne dimezzi davvero l’errore: questo il paper non lo misura.
Con lo stesso modello Whisper trascrive, traduce verso l’inglese e riconosce
la lingua. A dirgli quale dei tre mestieri fare sono delle istruzioni infilate
nel decoder sotto forma di simboli che non si pronunciano (in gergo token
speciali): uno dice in che lingua si sta parlando, un altro se il compito è
trascrivere o tradurre. La fila che il decoder scrive è
<|startoftranscript|> <|it|> <|transcribe|> <|notimestamps|>, poi il testo,
poi <|endoftext|>, e ogni campo è una predizione come le altre: la lingua il
modello la dichiara da sé, <|nospeech|> dice che nella finestra non parla
nessuno, e se i tempi servono, al posto di <|notimestamps|> scrive token di
istante quantizzati a \(20\) ms prima e dopo ogni frase. L’addestramento chiede
soltanto di indovinare il token successivo, con la stessa entropia incrociata
dei modelli di linguaggio, senza CTC e senza un modello di linguaggio esterno
[RKX+23].[1]
Gli autori rivendicano per Whisper una cosa precisa, diversa dallo sbagliare meno di tutti: peggiorare meno degli altri quando esce di casa. Per confrontare i riconoscitori si usano dei benchmark, che sono prove d’esame standard: raccolte di registrazioni con accanto la trascrizione giusta, sempre le stesse per tutti. La grandezza che gli autori misurano è la robustezza zero-shot, cioè come se la cava Whisper su una prova su cui non si è mai allenato: ci va meglio di quanto la sua bravura altrove lascerebbe prevedere, e con il rumore di fondo che sale peggiora più lentamente dei quattordici modelli addestrati su LibriSpeech con cui lo confrontano, soprattutto sui rumori naturali come il brusio di un locale. Sull’audio pulito, invece, i modelli allenati apposta per quella prova gli restavano davanti.
E ha un fianco scoperto, che il paper dichiara. I dati vengono dal web, e sul web stanno anche i benchmark: se le frasi dell’esame erano già dentro il materiale di studio, il voto è gonfiato. Gli autori il controllo l’hanno fatto, ma su una raccolta sola (TED-LIUM 3, registrazioni di conferenze TED) e confrontando le trascrizioni scritte, non l’audio; il che vuol dire che una registrazione ripubblicata altrove con parole leggermente diverse sarebbe passata inosservata.
Due precisazioni, per non lasciare a Whisper meriti che non ha e difetti che non sono solo suoi.
La prima: la catena a stadi non l’ha mandata in pensione Whisper, che del passaggio a una rete sola, cominciato anni prima con la CTC e i modelli con attenzione, è soltanto la vetrina più visibile. E la vecchia catena non è nemmeno sparita: dove le parole da riconoscere sono poche e note in anticipo (i comandi di un centralino telefonico, i codici letti ad alta voce in un magazzino) i sistemi a stadi restano in servizio, perché sono piccoli e la grammatica delle frasi ammesse si cambia senza riaddestrare niente. Anche un modello end-to-end si può costringere dentro un elenco di parole, ma ci vuole un grafo di decodifica o un addestramento fatto apposta.
La seconda riguarda la trascrizione in diretta, e va detta perché Whisper è così famoso che si finisce per credere che faccia tutto. Questo no: prima di scrivere la prima parola deve aver ascoltato tutto quello che gli è stato dato, e gliene diamo trenta secondi alla volta, quindi trascrive a blocchi. La dettatura che compare sullo schermo mentre parli è un’altra cosa, ed è quella dei trasduttori di poco fa, che sono end-to-end come lui ma tengono il passo dell’audio frame per frame.
Dal decoder con attenzione vengono anche i suoi limiti, che gli autori dichiarano onestamente. Il decoder non è obbligato a scorrere l’audio in avanti, e quando il legame fra testo e suono si allenta quello che resta è un modello di linguaggio molto bravo che continua a scrivere per conto proprio, senza più guardare il suono. Sull’audio lungo il guasto si aggrava, perché ogni finestra di trenta secondi comincia dove il modello stesso ha deciso che finiva la precedente: se ha sbagliato a decidere, l’errore passa alla finestra dopo. Il paper elenca tre sintomi: le prime o le ultime parole di un segmento che non vengono trascritte, le ripetizioni in loop, e il testo inventato di sana pianta (in gergo allucinato: il modello scrive parole che nessuno ha detto). È quello che si vede nei sottotitoli automatici quando riempiono di frasi un passaggio in cui non parla nessuno.
Per questo prendere a ogni passo il simbolo più probabile, la decodifica che in gergo si dice ingorda (greedy), qui non basta. Somiglia al percorso migliore della CTC nel gesto, ma non nel guasto: là molti percorsi diversi davano la stessa frase, qui ogni scelta condiziona tutte quelle dopo, e un errore iniziale può chiudere il decoder in un giro di ripetizioni da cui non esce più. Gli autori usano al suo posto una ricerca a fascio a cinque ipotesi, e quando il testo prodotto insospettisce alzano la temperatura, la manopola che decide quanto il modello si tiene stretta la propria prima scelta: è la stessa dei grandi modelli linguistici.
Il sospetto lo danno due controlli automatici, e non serve nessuno che ascolti. Il primo guarda quanto il testo si comprime: un testo che si ripete si comprime moltissimo, e se il rapporto di compressione (misurato con gzip) supera \(2{,}4\) il pezzo è scartato. Il secondo guarda quanto la rete era convinta di ciò che ha scritto: se la log-probabilità media dei token generati scende sotto \(-1\), il pezzo è scartato anche lui. Un pezzo scartato si rigenera a temperatura più alta, salendo da \(0\) fino a \(1\) a passi di \(0{,}2\) [RKX+23]; e siccome una temperatura alta rende il modello meno incaponito sulla parola che gli sembra ovvia, gli capiterà di provarne una diversa, che è esattamente quello che serve per uscire da un loop.
Il modello di linguaggio nella decodifica#
Quello che dice il suono, da solo, non basta mai. In italiano «l’ago» e «lago», «l’una» e «luna» si pronunciano allo stesso identico modo: a decidere è il contesto. Qui entra il modello di linguaggio (LM), che sa quali sequenze di parole sono frasi plausibili e sposta la trascrizione verso ciò che «suona» come italiano corretto.
Il modo di farlo entrare cambia con l’epoca. Nei sistemi classici il modello di linguaggio non arrivava dopo il riconoscitore: ci stava dentro. Prima di ascoltare, quei sistemi componevano in un’unica rete di percorsi tutto ciò che si poteva dire, collegando gli stati degli HMM ai fonemi, i fonemi alle parole attraverso il dizionario di pronuncia e le parole alle frasi attraverso il modello di linguaggio. Ogni collegamento aveva un costo, il meno logaritmo di una probabilità, così che sommare i costi lungo un percorso equivale a moltiplicarne le probabilità; e trascrivere voleva dire cercare il percorso meno costoso, con l’algoritmo di Viterbi e un fascio di candidati aperti. In gergo quella rete si chiama trasduttore a stati finiti pesato (WFST), e un peso regolava quanto contassero i giudizi del linguaggio rispetto a quelli dell’orecchio.
Nei modelli end-to-end quella rete non si costruisce più, e lo stesso effetto si ottiene in due modi. O si somma il punteggio di un modello di linguaggio esterno a quello del riconoscitore a ogni passo della ricerca a fascio (si chiama shallow fusion, «fusione superficiale» [KWN+18]), o si lascia finire la ricerca e si riordinano con il modello di linguaggio le prime \(n\) ipotesi che ha prodotto.
Quanto serva, però, dipende dall’architettura. Un modello che scrive rileggendosi, come Whisper o come il Listen, Attend and Spell di prima (in gergo: con decoder autoregressivo), un modello di linguaggio ce l’ha già dentro. Lo ha imparato senza volerlo, perché sceglie ogni pezzo di testo guardando quelli che ha già scritto. Un modello di linguaggio esterno gli serve comunque, e Kannan e colleghi lo misurano: la fusione superficiale porta un decoder con attenzione dal 10,3 al 6,9 per cento di parole sbagliate sul corpus del Wall Street Journal, dove si legge ad alta voce testo di giornale, e dal 7,7 al 7,0 sulle ricerche vocali. Ma il guadagno si assottiglia man mano che le trascrizioni viste in addestramento aumentano, perché il decoder diventa da sé un modello di linguaggio robusto, e quello che resta è soprattutto sui termini rari o di dominio (nomi propri, sigle, gergo medico).
Un modello CTC, invece, decide ogni frame per conto suo, guardando il suono e mai le lettere che ha già scritto, ed è l’ignoranza già annunciata: non ha il posto dove mettere un modello di linguaggio interno, e per lui quello esterno pesa molto di più. Quanto, lo mostrano Baevski e colleghi con wav2vec 2.0 e una testa CTC a caratteri [BZMA20]. Rifinito su dieci minuti di parlato trascritto e decodificato senza modello di linguaggio, sbaglia il 40,2 per cento delle parole sugli audiolibri puliti di LibriSpeech, e gli errori sono quasi tutti di ortografia, parole quasi giuste che non esistono (coud per could, stil per still); con un modello di linguaggio Transformer scende al 4,8. Rifinito su tutte le 960 ore trascritte, passa dal 2,2 all’1,8: il modello di linguaggio serve sempre, ma il suo peso cala man mano che crescono le trascrizioni. Il trasduttore sta in mezzo, e ora si capisce perché: la sua prediction network (il foglio che lo stenografo si rilegge) è il modello di linguaggio interno che alla CTC mancava.
Misurare gli errori: il Word Error Rate#
Come diciamo che una trascrizione è «buona»? La metrica standard è il Word Error Rate (WER), ed è la distanza di edit che portava da carta a casa, con le parole al posto delle lettere: il numero minimo di correzioni (cambia una parola, toglila, aggiungine una) che servono per trasformare la trascrizione prodotta in quella di riferimento.
dove \(S\) è il numero di sostituzioni, \(D\) le cancellazioni, \(I\) le inserzioni e \(N\) il numero di parole nel riferimento, che è anche \(S + D + C\) con \(C\) le parole indovinate. Attenzione ai nomi, perché sono dal punto di vista del sistema e non di chi corregge: una cancellazione è una parola che il sistema si è mangiato, un’inserzione è una parola che ha aggiunto di suo. Chi corregge fa il gesto opposto, ma l’errore si chiama così. Il WER si minimizza: \(0\) è la trascrizione perfetta, e il rapporto può anche superare \(1\). Quando, lo dice un passaggio solo: siccome \(N = S + D + C\), chiedere \(S + D + I > N\) vuol dire chiedere \(S + D + I > S + D + C\), dove \(S\) e \(D\) stanno da tutt’e due le parti e si cancellano. Resta \(I > C\): basta che le parole aggiunte siano più di quelle azzeccate, e non serve affatto che siano più di quante ne contiene il riferimento. E succede: nelle tabelle di Whisper alcune lingue con poche ore di addestramento superano il 100 per cento, cioè il modello vi aggiunge più parole di quante ne indovini [RKX+23].
Un conto per intero, fatto come quello fra carta e casa nel capitolo sul linguaggio naturale, ma sulle parole. Il riferimento è «il gatto nero salta sul muro», sei parole; il sistema ha scritto «il gatto nemo salta muro». Gli errori sono due: ha scritto «nemo» al posto di «nero» (una sostituzione) e si è mangiato «sul» (una cancellazione). Due errori su sei parole, il WER è \(2/6 = 0{,}33\), cioè il 33%.
Trovare quei due errori a occhio è facile su sei parole e impossibile su seicento, perché le combinazioni sono tante e ne vogliamo il numero minimo. Si riempie la stessa tabella di allora, quella della distanza di Levenshtein.
import numpy as np

def wer(rif, ip):
    r, h = rif.split(), ip.split()
    # matrice di distanza di edit riempita per programmazione dinamica
    D = np.zeros((len(r) + 1, len(h) + 1), dtype=int)
    D[:, 0] = np.arange(len(r) + 1)   # cancellazioni pure
    D[0, :] = np.arange(len(h) + 1)   # inserzioni pure
    for i in range(1, len(r) + 1):
        for j in range(1, len(h) + 1):
            costo = 0 if r[i - 1] == h[j - 1] else 1
            D[i, j] = min(D[i - 1, j] + 1,          # cancellazione
                          D[i, j - 1] + 1,          # inserzione
                          D[i - 1, j - 1] + costo)  # sostituzione (o parola uguale)
    return D[len(r), len(h)] / len(r)

print(round(wer("il gatto nero salta sul muro",
                "il gatto nemo salta muro"), 3))
0.333
Il WER è comodo ma fragile, prima ancora che grezzo. Conta le parole come stringhe, quindi «9:30» contro «nove e trenta», una maiuscola o una virgola valgono un errore ciascuna anche quando la trascrizione è giusta: ogni confronto presuppone una normalizzazione del testo, di riferimento e ipotesi, identica per tutti i sistemi, che è la normalizzazione della sintesi vocale percorsa al contrario. Gli autori di Whisper ne hanno scritta una apposta, e su alcune raccolte la sola normalizzazione abbassa il WER fino alla metà, quasi sempre per una stranezza del riferimento, come le contrazioni inglesi staccate con uno spazio. Avvertono anche il rischio: sviluppata guardando gli errori di Whisper, potrebbe essere tarata sul suo stile. Messa a confronto con un normalizzatore scritto da altri, quello del progetto FairSpeech, sulla maggior parte delle raccolte le due si equivalgono, ma su tre (WSJ, CallHome, Switchboard) la loro abbassa il WER di Whisper molto più di quanto abbassi quello degli altri modelli [RKX+23]. Un WER riportato senza dire come è stato normalizzato il testo, dunque, non si confronta con niente. E anche normalizzato resta grezzo. Pesa allo stesso modo un errore grave e uno banale, e tratta male le lingue che attaccano le parole fra loro: in tedesco Geschwindigkeitsbegrenzung («limite di velocità») è una parola sola, quindi sbagliarne una sillaba conta come sbagliarla tutta, mentre in italiano lo stesso inciampo ne intaccherebbe una su tre. Per questo, accanto al WER, si riporta spesso il Character Error Rate (CER), con la stessa formula e i caratteri al posto delle parole. E come ogni media su una prova finita, il WER ha un margine: su poche centinaia di parole uno scarto di un decimo di punto non separa due sistemi, e l’intervallo si stima per esempio ricampionando le frasi della prova. Nessuna misura, però, cattura del tutto ciò che conta davvero: se la frase trascritta, letta da un essere umano, significa ancora la cosa giusta.
Da ricordare
L’audio è lunghissimo e il testo è corto, e nessuno dice quale pezzetto di suono corrisponde a quale lettera: è il problema centrale del riconoscimento vocale.
La CTC lo aggira con il simbolo «vuoto»: prova tutti i modi di etichettare i frame e somma le probabilità di quelli che danno la parola giusta. I modelli con attenzione invece scrivono una lettera alla volta, rileggendosi ogni volta il pezzo di audio che serve; il trasduttore fa come uno stenografo, scrive mentre ascolta senza tornare indietro e con sotto gli occhi il foglio di quello che ha già messo giù.
Trovare la trascrizione non è prendere il simbolo più votato a ogni frame: quello è il percorso più probabile, che non è la parola più probabile. Si cerca a fascio, tenendo aperte più strade.
Whisper mette tutto in un modello solo, che fa molte lingue insieme. Se perde il filo fra suono e testo continua a scrivere per conto suo: sono le frasi inventate che ogni tanto compaiono nei sottotitoli automatici.
Il modello di linguaggio è il pezzo che sceglie fra «l’ago» e «lago», e serve soprattutto alla CTC, che di suo non sa niente delle lettere già scritte; il WER conta quante correzioni servono per rimettere a posto una trascrizione, diviso il numero di parole, e più è basso meglio è.
Da ricordare
Audio e testo hanno lunghezze diverse e l’allineamento non è dato: è il problema centrale dell’ASR.
La CTC lo risolve con il simbolo «vuoto» e sommando tutti gli allineamenti possibili, al prezzo dell’indipendenza condizionale fra i frame e del vincolo \(T \ge U + r\) sulle posizioni in uscita dall’encoder (dopo il sottocampionamento), che le vieta il verso opposto (la sintesi, dove il testo è più corto del suono); i modelli con attenzione lo imparano in modo morbido, un token alla volta, ma perdono monotonia e streaming; il trasduttore [Gra12] tiene il reticolo monotono e ci aggiunge una prediction network, cioè un LM interno. Lo streaming, per CTC e trasduttore, richiede un encoder causale.
Addestramento e decodifica non sono la stessa cosa: il best path non massimizza \(p(y \mid \mathbf{X})\), e la beam search della CTC somma i percorsi che collassano nello stesso prefisso invece di metterli in concorrenza.
I Transformer end-to-end come Whisper [RKX+23] uniscono acustica, pronuncia e linguaggio in un solo modello multilingue (il log-mel resta calcolato fuori); zero-shot è il protocollo (nessuna messa a punto sulla prova d’esame), e ciò che si misura è di quanto si peggiora fuori casa, non quanto si è bravi; i loro loop nascono dall’allineamento testo-audio che si stacca.
Il modello di linguaggio disambigua gli omofoni, si integra per shallow fusion o per riordino delle \(n\) ipotesi, e pesa di più sulla CTC, che non ne ha uno implicito; il suo guadagno cala man mano che crescono le ore trascritte. Il WER misura gli errori come distanza di edit fra parole, si minimizza, può superare \(1\), e non si confronta senza la normalizzazione del testo con cui è stato calcolato.
Dal suono si è arrivati al testo, e la strada si può fare anche al contrario: La voce sintetica parte dal testo, ritrova dall’altra parte lo spettrogramma log-mel, calcolato con finestre sue, e ne ricava una voce.