


La cassetta degli attrezzi: espressioni regolari, normalizzazione e distanza di edit#
Nell’Introduzione abbiamo incontrato ELIZA, il programma con cui Joseph Weizenbaum dimostrò (suo malgrado) quanto sia facile attribuire un’intelligenza a una macchina [Wei66]. A guardarci dentro, ELIZA era fatta soltanto di regole scritte a mano da Weizenbaum e di pattern matching, la ricerca di schemi nel testo. Se l’utente scriveva «mi sento triste», agganciava lo schema «mi sento X» e riassemblava i pezzi in «Da quanto tempo ti senti X?», senza capire nulla di quello che leggeva.
Prima delle reti neurali, l’NLP era in larga parte questo: schemi, regole,
conteggi. Quegli attrezzi lavorano ancora ovunque: nel modulo di iscrizione
che avvisa che «l’indirizzo email non è valido», in grep e negli altri
comandi con cui i programmatori setacciano i file da mezzo secolo, e
soprattutto nella pulizia dei dati che precede qualunque modello (togliere le
righe doppie, uniformare le date scritte in quattro modi, accorgersi che
«Milano» e «MILANO» sono la stessa città). Chiedi a chi lavora nel settore
quanto tempo porta via: nei progetti reali è spesso la parte più lunga del
lavoro. Prima di insegnare a una rete neurale a leggere, conviene imparare a
usare la cassetta degli attrezzi.

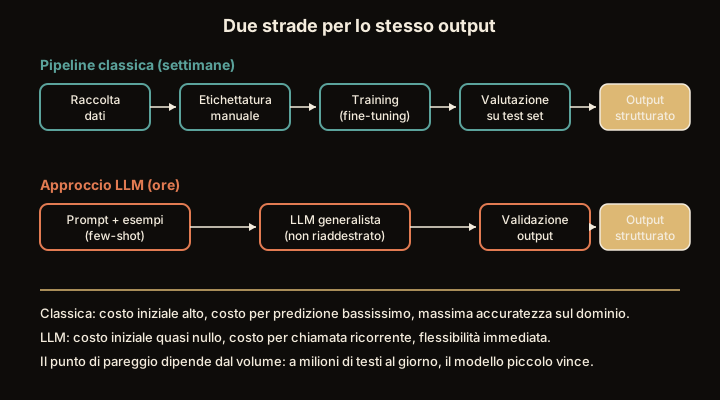
Fig. 15.2 Due strade per lo stesso risultato, e due conti diversi. In alto quella classica: dati raccolti, etichettati a mano, un modello addestrato apposta e messo alla prova. In basso quella di oggi: si scrive l’istruzione in italiano, e risponde un modello che per quel compito non è stato addestrato. La prima chiede settimane prima di dare qualcosa e poi costa pochissimo a ogni testo; la seconda parte in poche ore e, quando il modello è un servizio, paga a ogni chiamata.#
Il testo che si scrive al modello della seconda strada si chiama prompt, ed è la parola con cui si indica oggi qualunque richiesta fatta a un modello: la ritroveremo alla fine del capitolo. L’uso si paga «a ogni chiamata» perché, nel caso più comune, il modello è un servizio: gira sui server di un fornitore, che fa pagare in proporzione al testo che riceve e che produce. Un modello a pesi aperti, cioè scaricabile, si può far girare su una macchina propria, e allora il conto passa all’hardware e all’elettricità.
Fig. 15.2 mette a confronto tempi e costi, che è il modo in cui la scelta si presenta a chi deve consegnare un lavoro. Ma c’è una seconda ragione per non abbandonare l’approccio classico, e sta proprio in questi attrezzi: si spiegano in una riga, si ispezionano un passaggio alla volta e si correggono a mano. Un modello ti dice che quell’indirizzo email è valido quasi sempre; un’espressione regolare o combacia o non combacia, e se sbaglia puoi aprirla e vedere dove. Quando serve sapere perché è uscita una certa risposta, o serve una garanzia invece di un «molto probabilmente», sono ancora loro a stare dentro i sistemi moderni.
Le espressioni regolari: descrivere uno schema, non una parola#
Il primo attrezzo risponde a una domanda concreta: come si cerca in un testo qualcosa che non è una parola precisa ma una forma? Tutte le date, tutti i CAP, tutti gli importi in euro. La risposta si chiama espressioni regolari (regular expressions, o regex): la descrizione di una forma invece che di una parola, e la si scrive con una riga di simboli.
Le espressioni regolari nascono negli anni Cinquanta, e per un altro scopo. Il logico Stephen Kleene stava studiando i modellini matematici di neurone proposti nel 1943 da Warren McCulloch e Walter Pitts, gli stessi da cui parte il capitolo sulle reti neurali, e per dire quali sequenze di segnali una rete del genere sa distinguere si inventò questa notazione [Kle56]. Gli attrezzi «vecchi» e quelli «nuovi» del NLP hanno dunque lo stesso atto di nascita.
A portarle dentro i programmi fu Ken Thompson, uno dei padri del sistema
operativo Unix, alla fine degli anni Sessanta [Tho68]. Le
mise in due programmi per scrivere testo, QED e poi ed, e da ed viene
grep, il comando con cui i programmatori cercano ancora oggi una forma dentro
i file. Il nome è la sigla di un’istruzione di ed, g/re/p: cerca ovunque
(g) l’espressione regolare (re) e stampa (p) le righe che la contengono.
In una caccia al tesoro l’indizio non dice «trova la parola 95125», dice «trova cinque cifre di fila». Un’espressione regolare è esattamente questo: la descrizione di uno schema, invece di una parola esatta. «Cinque cifre di fila» trova tutti i CAP d’Italia; «una o due cifre, una barra, una o due cifre, una barra, quattro cifre» trova tutte le date scritte come 3/7/2026; «la radice gatt- seguita da una vocale» trova gatto, gatta, gatti e gatte in un colpo solo.
È la funzione Trova del tuo editor di testi, ma con i superpoteri: invece di controllare lettera per lettera, controlla tipo di lettera per tipo di lettera (qui voglio una cifra, qui una lettera qualsiasi, qui uno spazio). Quando un sito ti dice al volo che il numero di telefono che hai digitato non è valido, di solito c’è un’espressione regolare che ha confrontato quello che hai scritto con lo schema atteso e ha trovato che non combacia.
C’è però una cosa che questi superpoteri non sanno fare, e non per distrazione. Un’espressione regolare non sa contare. Scorre il testo da sinistra a destra e a ogni carattere ricorda solo in che punto dello schema si trova, non quante volte ci è già passata. Quindi non c’è modo di scriverne una che verifichi «ogni parentesi aperta ne ha una chiusa» quando le parentesi si possono annidare quanto si vuole: dovrebbe tenere il conto di quante ne ha aperte, e non ha dove segnarlo. Vale per le parentesi e vale per le frasi dentro le frasi, che sono la stessa cosa fatta di parole: «il gatto che dorme sul divano che ho comprato quando…». Per quelle serviranno gli attrezzi delle prossime sezioni.
Lo schema è una cosa, l’attrezzo che lo esegue un’altra. grep legge il testo
una volta sola, dall’inizio alla fine, ricordando soltanto il punto dello schema
in cui si trova, e il tempo cresce come la lunghezza del testo. Altri programmi,
fra cui il modulo di Python che si userà fra poco, lavorano per tentativi:
provano una strada, e se non porta da nessuna parte tornano al bivio e ne
provano un’altra. Lo fanno perché offrono qualcosa in più, per esempio chiedere
che un pezzo di testo si ripeta identico più avanti (la stessa parola due
volte, come in «ciao ciao»), e quel di più in una lettura sola non si può
fare. Quasi sempre finiscono comunque in un lampo.
Ma prendi lo schema «uno o più gruppi, ciascuno di una o più a, e poi la fine
della riga», e dagli la riga aaa!. Il programma prova a spezzare le tre a
in gruppi in tutti i modi possibili: aaa; aa e a; a e aa; a, a e
a. Sono quattro, e nessuno funziona, perché in fondo c’è il punto esclamativo
invece della fine della riga; ma per saperlo il programma deve provarli tutti.
Con quattro a i modi sono otto, con cinque sedici: ogni lettera in più
raddoppia il conto, e con trenta a sono più di cinquecento milioni. Su una
riga che si scrive in due secondi il programma si pianta. Chi mette
un’espressione regolare in un modulo aperto al pubblico deve saperlo, perché
quella riga gliela può scrivere chiunque; il rimedio è vietare al programma di
tornare sui suoi passi in quel punto dello schema, oppure usare un attrezzo che
legge in una passata sola, come grep.
Un’espressione regolare è una stringa che definisce un insieme di stringhe (un linguaggio). I costrutti essenziali sono pochi:
Costrutto |
Significato |
Esempio |
Trova |
|---|---|---|---|
|
una tra le lettere elencate |
|
gatto, gatta, … |
|
cifra, carattere di parola, spazio |
|
42 |
|
zero o più, una o più, opzionale |
|
caro, carro |
|
esattamente \(n\), da \(n\) a \(m\) ripetizioni |
|
95125 |
|
inizio riga, fine riga, confine di parola |
|
Il a inizio riga |
|
gruppo da catturare |
|
giorno e mese, separati |
|
alternanza (oppure) |
|
gatto o micio |
In senso formale un’espressione regolare si costruisce dai simboli dell’alfabeto con tre sole operazioni: l’unione (\(r \mid s\)), la concatenazione (\(rs\)) e la stella di Kleene (\(r^*\), zero o più ripetizioni); classi, quantificatori e ripetizioni contate della tabella ne sono abbreviazioni. Il teorema di Kleene [Kle56] dice che i linguaggi descritti così sono esattamente quelli riconosciuti da un automa a stati finiti. La costruzione di Thompson [Tho68] traduce un’espressione di lunghezza \(m\) in un automa non deterministico con \(O(m)\) stati, che si simula su un testo di lunghezza \(n\) in tempo \(O(nm)\); determinizzandolo si scende a \(O(n)\) sul testo, al prezzo di un numero di stati che nel caso peggiore cresce esponenzialmente con \(m\).
Il rovescio della medaglia è un limite espressivo preciso: un automa a stati finiti non sa contare. Lo prova il lemma di pompaggio: in un linguaggio regolare esiste una lunghezza \(p\) oltre la quale ogni stringa contiene, fra i suoi primi \(p\) simboli, un pezzo che si può ripetere quante volte si vuole restando nel linguaggio. Il linguaggio \(\{a^k b^k : k \ge 1\}\), la forma più semplice di parentesi bilanciate, non lo rispetta: in \(a^p b^p\) il pezzo ripetibile sarebbe fatto di sole \(a\), e ripeterlo romperebbe l’uguaglianza fra \(a\) e \(b\). Nessuna espressione regolare può quindi verificare strutture annidate a profondità arbitraria (parentesi bilanciate, subordinate dentro subordinate). Per la sintassi delle lingue naturali servono strumenti più potenti, o, come vedremo, modelli che la imparano dai dati.
Una cautela pratica prima di scendere al codice: il teorema, e con esso la
garanzia di tempo lineare, riguarda i motori che compilano davvero l’automa,
come grep o RE2. Il modulo re di Python, che useremo tra poco, l’automa non
lo costruisce: procede per backtracking, cioè prova una strada e torna
indietro, e la garanzia cade anche su schemi che il teorema copre benissimo. Su
^(a+)+$, che descrive il modestissimo insieme delle stringhe di sole a e
che grep liquida in un istante, re applicato a un input ostile impiega un
tempo che raddoppia a ogni carattere in più, perché prova una per una le
\(2^{n-1}\) scomposizioni di \(n\) lettere in gruppi. E i costrutti aggiuntivi del
modulo (le backreference, che chiedono a un pezzo di ripetersi identico)
descrivono in più linguaggi che regolari non sono, cioè escono proprio dalla
portata del teorema. Da Python 3.11 il modulo ha i quantificatori possessivi
(a++) e i gruppi atomici ((?>...)), che vietano al motore di tornare
indietro dentro quel pezzo: con (a++)+ al posto di (a+)+, lo stesso input
ostile si chiude subito. L’alternativa è un motore a tempo lineare come RE2,
che per garantirlo rinuncia alle backreference.
In Python le espressioni regolari stanno nel modulo re, che il programma
importa con la prima riga. Per leggere il codice che segue bastano cinque
costrutti: \d (una cifra qualsiasi), {5} e {1,2} (cinque ripetizioni di
quello che precede; una o due), [oaie] (una lettera fra quelle elencate) e
\b (il confine di una parola, che impedisce di pescare un pezzo dentro una
parola più lunga). Così \b\d{5}\b riconosce cinque cifre isolate, cioè un
CAP. La r davanti alle virgolette, come in r"\d{5}", dice a Python di
prendere le barre rovesciate alla lettera invece di interpretarle.
Mettiamo alla prova la nostra frase preferita, arricchita di qualche dettaglio da estrarre:
import re

testo = ("Il gatto nero salta sul muro di via dei Tigli 42. La gatta lo "
         "guarda dal balcone: CAP 95125, visita dal veterinario il "
         "3/7/2026 alle 18:30.")

# tutte le forme di "gatto": la radice gatt- più una vocale finale
re.findall(r"\bgatt[oaie]\b", testo)
# ['gatto', 'gatta']

# il CAP: esattamente cinque cifre isolate
re.findall(r"\b\d{5}\b", testo)
# ['95125']

# una data giorno/mese/anno
re.findall(r"\b\d{1,2}/\d{1,2}/\d{4}\b", testo)
# ['3/7/2026']

# gruppi: catturare giorno, mese e anno separatamente
m = re.search(r"(\d{1,2})/(\d{1,2})/(\d{4})", testo)
m.group(1), m.group(2), m.group(3)
# ('3', '7', '2026')
Una regola d’onestà: le espressioni regolari non capiscono niente. Trovano forme, non significati: proprio come ELIZA, che agganciava «mi sento X» senza avere idea di cosa fosse un sentimento. Per estrarre un CAP bastano; per decidere se una recensione è entusiasta o sarcastica no. È il confine esatto tra ciò che le espressioni regolari possono fare e ciò per cui servono i modelli statistici.
Normalizzare il testo: decidere cosa è «la stessa parola»#
Il secondo attrezzo è meno appariscente ma altrettanto indispensabile, e parte da un fatto: per un calcolatore un testo è una sequenza di numeri. Lo standard Unicode assegna a ogni carattere dei sistemi di scrittura del mondo un numero, il suo punto di codice (code point), e confrontare due parole vuol dire confrontare due sequenze di punti di codice.
Ne segue che per una macchina Muro, muro e MURO sono tre parole diverse,
perché la M maiuscola e la m minuscola hanno punti di codice diversi. C’è
di peggio, ed è il caso in cui la macchina ha ragione e il risultato è
comunque assurdo. La parola perché si può scrivere in due modi che sullo
schermo sono identici: con una é sola, che è un punto di codice solo, oppure
con una e seguita da un accento combinante, un segno a parte che le si
posa sopra, e allora i punti di codice sono due. Stesso disegno sulla pagina,
contenuto diverso in memoria, e la parola risulta diversa da sé stessa.
Prima di contare le parole di un testo, come si farà nella sezione sulla rappresentazione del testo, bisogna dunque decidere quali varianti contare insieme. Questa scelta si chiama normalizzazione.
I fusilli integrali e i fusilli normali sono «pasta» o due cose diverse? Dipende da cosa vuoi cucinare, e finché non lo hai deciso non puoi nemmeno contare i barattoli della dispensa. Con le parole si fa la stessa scelta, e riguarda quali varianti vanno nello stesso barattolo.
Il minuscolo mette insieme Muro a inizio frase e muro in mezzo. Poi si uniforma il modo in cui le lettere stanno in memoria. Le due scritture di perché, quella con la é intera e quella con l’accento appoggiato sopra, sono due confezioni identiche sullo scaffale con due codici a barre diversi: senza questa mossa la cassa le batte come due prodotti. Via anche la punteggiatura e le stopword, le parole-colla come il, di, che, e, che stanno dappertutto e proprio per questo non dicono nulla sull’argomento del testo. Resta la mossa più delicata, raggruppare le forme della stessa parola. Andavamo, andiamo e andrò sono tutte facce del verbo andare.
Per quest’ultima mossa ci sono due attrezzi. Lo stemming lavora di forbici, e taglia la coda delle parole in modo puramente meccanico, secondo regole fisse. È rapidissimo, e su gatto, gatta e gatti fa centro, perché da tutti e tre resta gatt. Sui verbi irregolari invece cade proprio dove serviva. Le forbici più usate per l’italiano riducono andavamo ad andavam, andiamo ad andiam e andare ad andar, mentre su andrò non trovano nemmeno una coda da tagliare. Quattro etichette diverse, quattro barattoli, e il verbo che si voleva raccogliere resta sparpagliato come prima.
La lemmatizzazione lavora di vocabolario, risale alla forma base (il lemma) e da andavamo ricava davvero andare. Il vocabolario da solo però non basta, e lo sa chiunque ne abbia aperto uno. Porta può essere quella di casa, oppure quello che fa chi porta la spesa, e per decidere quale delle due bisogna leggere le parole intorno. Più precisa, dunque, ma più lenta e molto più faticosa da costruire.
Raggruppare ha comunque un prezzo, e in dispensa si vede meglio che sulla pagina. Chi cerca «pasta» adesso trova ogni cosa, ed era lo scopo; chi cercava proprio i fusilli integrali non li distingue più dagli altri. Nel testo funziona uguale, si trova di più e si distingue di meno. In italiano, dove un verbo ha decine di forme, il baratto di solito conviene, ma va provato sui testi che si hanno davvero.
Normalizzare significa definire una funzione che manda ogni variante superficiale in un rappresentante canonico: minuscolizzazione (case folding), normalizzazione Unicode (le forme NFC/NFKC unificano caratteri composti e precomposti, come la é codificata con uno o due punti di codice), rimozione di punteggiatura e stopword, riduzione morfologica.
Per quest’ultima, lo stemming applica regole di troncamento dei suffissi: il capostipite è l’algoritmo di Porter per l’inglese [Por80], esteso ad altre lingue, italiano compreso, con Snowball, il linguaggio in cui Porter ha poi scritto gli stemmer delle varie lingue [Por01]. È una funzione puramente ortografica, senza dizionario, e si vede: lo stemmer Snowball italiano manda gatto, gatta e gatti correttamente in gatt, ma spezza il paradigma di andare in tre gambi diversi; andavamo → andavam, andiamo → andiam, andare → andar. La lemmatizzazione richiede invece un’analisi morfologica con dizionario e contesto (per disambiguare, ad esempio, porta sostantivo da porta voce del verbo portare) e restituisce il lemma: andavamo → andare. Nei sistemi a conteggio la riduzione morfologica aumenta la recall (query e documento si incontrano anche se flessi diversamente) al prezzo di un po’ di precision (forme distinte collassano); per una lingua flessiva come l’italiano il compromesso è di solito favorevole nei sistemi di ricerca, ma quanto lo sia dipende dalla collezione e dal compito, e va misurato.
In Python bastano poche righe per una catena di normalizzazione essenziale. Il
programma fa tre cose in fila. Uniforma le codifiche: è la prima riga, quella
che risolve il caso del perché scritto in due modi (NFKC è il nome della
regola che ricompone lettera e accento in un carattere unico, e che riporta
anche un esponente come ² a un 2 normale). Poi manda tutto in minuscolo, e
infine butta via la punteggiatura e le parole-colla. Nella terza riga,
[^\w\s] si legge «tutto ciò che non è né una lettera o cifra (\w) né
uno spazio (\s)»: il ^ dentro le parentesi quadre rovescia l’elenco, e
quindi quel pezzo di schema aggancia esattamente la punteggiatura, apostrofo
compreso. È per questo che fra le parole-colla ci sono anche le forme elise:
«dell’isola» diventa «dell isola», e senza dell nell’elenco quel moncone
resterebbe fra le parole contate.
import re
import unicodedata

STOPWORD = {"il", "lo", "la", "i", "gli", "le", "un", "una", "di", "a",
            "da", "in", "su", "sul", "per", "con", "e", "che", "è",
            "l", "dell", "all", "nell", "sull", "d"}     # e le forme elise

def normalizza(testo):
    testo = unicodedata.normalize("NFKC", testo)  # codifiche Unicode uniformi
    testo = testo.casefold()                      # tutto minuscolo (ß → ss)
    testo = re.sub(r"[^\w\s]", " ", testo)        # via la punteggiatura
    return [p for p in testo.split() if p not in STOPWORD]

print(normalizza("Il gatto NERO salta sul muro!"))
print(normalizza("L'uomo dell'isola è andato a casa dell'amico"))
['gatto', 'nero', 'salta', 'muro']
['uomo', 'isola', 'andato', 'casa', 'amico']
Quando serve tutto questo? Quando si rappresenta il testo contando le parole, ed è proprio quello che si farà nella sezione sulla rappresentazione del testo: lì, e nei motori di ricerca classici, normalizzare bene fa la differenza tra trovare e non trovare un documento.
Le reti neurali moderne, invece, hanno progressivamente smesso di buttare via l’informazione, perché maiuscole, accenti e desinenze portano significato. In «Rosa è rosa» la prima parola è una ragazza e la seconda un colore: manda tutto in minuscolo e diventano la stessa parola, e la frase non dice più niente. Al posto della potatura queste reti usano un taglio diverso, che conserva il testo com’è e lo spezza in unità più piccole della parola: una parola lunga e rara come straordinariamente non finisce nel dizionario intera, ma divisa in pezzi che ricorrono in molte altre parole. Come si scelgano quei pezzi, e come li sceglie davvero un tokenizzatore in uso, lo racconta Come si spezza il testo. La normalizzazione aggressiva è dunque un attrezzo da usare quando si conta, non un obbligo universale.
La distanza di edit: quante mosse da una parola all’altra#
Il terzo attrezzo nasce da un’esperienza quotidiana: digiti «gatot» e il telefono capisce che intendevi «gatto». Come fa a sapere che «gatot» somiglia a «gatto» più che a «divano»? Serve un modo per misurare la distanza tra due parole. La misura standard porta il nome del matematico sovietico Vladimir Levenshtein, che la introdusse nel 1965 [Lev66], in un articolo di poche pagine che non parlava affatto di parole: parlava di codici binari per correggere errori di trasmissione, e le sue «parole» erano sequenze di 0 e 1. Il nome distanza di Levenshtein per la versione sul testo si affermò solo in seguito; è uno di quei casi in cui un’idea nata in un campo finisce per fare fortuna in un altro.
Sul tavolo cinque tessere formano carta, e bisogna arrivare a casa. I gesti permessi sono tre: cambiare una tessera con un’altra (una sostituzione), toglierne una (una cancellazione), infilarne una nuova (un inserimento). Ogni gesto vale una mossa, vince chi ne fa meno, e il numero di mosse della strada più corta è la distanza di edit fra le due parole.
Da casa a cosa basta girare la prima a in o, distanza 1. Da carta a casa le mosse sono due: via la r (carta → cata), poi t → s (cata → casa). Con una sola non ce la fai per quanto provi, perché le tessere sono in numero diverso: una va tolta per forza, e tolta quella il resto ancora non combacia.
Più corta è la strada, più le due parole si somigliano. Gatot dista 2 da gatto e 5 da divano: una d e una i davanti (digatot), g → v (divatot), t → n (divanot), via la t finale (divano). Per questo il correttore del telefono scommette su gatto.
Ma quella da cinque è una strada, e che sia la più corta nessuno l’ha ancora promesso: è l’unica difficoltà del gioco. Su quattro lettere si vede a occhio, su parole lunghe le strade sono troppe. Serve allora un foglio a quadretti, muro lungo il bordo di sinistra e mare lungo quello di sopra. Ogni casella riguarda solo l’inizio delle due parole, quello letto fino a quella riga e fino a quella colonna, e dice quante mosse servono per passare dall’uno all’altro:
(niente) |
m |
a |
r |
e |
|
|---|---|---|---|---|---|
(niente) |
0 |
1 |
2 |
3 |
4 |
m |
1 |
0 |
1 |
2 |
3 |
u |
2 |
1 |
1 |
2 |
3 |
r |
3 |
2 |
2 |
1 |
2 |
o |
4 |
3 |
3 |
2 |
2 |
Prima riga e prima colonna sono regalate: per andare da niente a m, ma, mar, mare si infilano 1, 2, 3, 4 tessere. Ogni altra casella guarda le tre vicine, e ciascuna è un gesto: da quella di sopra si arriva togliendo l’ultima tessera di sinistra, da quella a sinistra infilando l’ultima di sopra, da quella in diagonale accoppiandole. Si prende la vicina più piccola, si paga 1, e lo sconto è uno solo: se l’ultima tessera di sinistra e l’ultima di sopra portano la stessa lettera si ricopia la diagonale senza pagare niente, perché quelle due tessere già combaciano.
Facciamone una insieme, riga u e colonna a. Sopra c’è 1, a sinistra 1, in diagonale 0. La u e la a sono lettere diverse, niente sconto, quindi si prende 0 e si aggiunge 1: fa 1, il numero che sta nella casella. Provane un’altra, il meccanismo è sempre questo.
In fondo a destra c’è la risposta, 2: da muro a mare si girano due tessere, u → a e o → e. Ed è davvero il minimo, perché ogni casella ha scelto il più economico fra i tre gesti, e un quarto modo di arrivarci non esiste: nessuna scorciatoia può sfuggire. Su parole di poche lettere il foglio si riempie in un lampo. Ha però una casella per ogni coppia di lettere, una della prima parola e una della seconda, e su due testi di mille lettere le caselle sono un milione: nessuno conosce un modo di saltarne la maggior parte.
Date due stringhe \(a = a_1 \cdots a_n\) e \(b = b_1 \cdots b_m\), la distanza di Levenshtein è il costo minimo per trasformare \(a\) in \(b\) con inserzioni, cancellazioni e sostituzioni di costo unitario. Si calcola con la programmazione dinamica: sia \(D_{i,j}\) la distanza tra il prefisso \(a_1 \cdots a_i\) e il prefisso \(b_1 \cdots b_j\). Allora
dove \(\mathbb{1}[a_i \neq b_j]\) vale 1 se le lettere differiscono e 0 se coincidono: l’ultima lettera di ciascun prefisso o si cancella, o si inserisce, o si mette in corrispondenza con l’altra, e ogni caso riconduce a un sottoproblema più piccolo, già risolto. Compiliamo la tabella per muro → mare (riga per riga, ogni cella applica la ricorrenza; la colonna e la riga di \(\varepsilon\), la stringa vuota, sono i casi base):
\(\varepsilon\) |
m |
a |
r |
e |
|
|---|---|---|---|---|---|
\(\varepsilon\) |
0 |
1 |
2 |
3 |
4 |
m |
1 |
0 |
1 |
2 |
3 |
u |
2 |
1 |
1 |
2 |
3 |
r |
3 |
2 |
2 |
1 |
2 |
o |
4 |
3 |
3 |
2 |
2 |
L’angolo in basso a destra dà \(D_{4,4} = 2\): bastano due sostituzioni (u → a, o → e), e il percorso ottimo (in grassetto) scende lungo la diagonale, pagando 1 solo dove le lettere differiscono. La tabella ha \((n+1)(m+1)\) celle e ogni cella costa un confronto: complessità \(O(nm)\) in tempo, riducibile a \(O(\min(n,m))\) in memoria tenendo in vita solo due righe della tabella, orientata lungo la stringa più corta. La formulazione tabellare è nota anche come algoritmo di Wagner–Fischer [WF74]. Il nome di distanza è meritato, perché si tratta di una metrica (nulla solo fra stringhe uguali, simmetrica, con la disuguaglianza triangolare). Con costi di inserzione, cancellazione e sostituzione diversi da 1 diventa la distanza pesata che serve al canale rumoroso; e conservando in ogni cella la scelta che l’ha prodotta si ricostruisce l’allineamento, cioè quali lettere si corrispondono. È lo schema con cui Needleman e Wunsch [NW70] allineano le sequenze di proteine, e la stessa programmazione dinamica tornerà con l’algoritmo di Viterbi, nella sezione sul POS tagging. Un algoritmo sostanzialmente più veloce non si conosce: Backurs e Indyk [BI15] dimostrano che un tempo \(O(n^{2-\delta})\), per un qualunque \(\delta > 0\), smentirebbe la Strong Exponential Time Hypothesis, una congettura su cui poggia gran parte della complessità moderna. Una quarta mossa, lo scambio di due lettere adiacenti, viene da Fred Damerau, che nel 1964 precede di un anno l’articolo di Levenshtein: per «gatot» → «gatto» la distanza scende da 2 a 1, coerente con l’osservazione di Damerau che circa quattro refusi su cinque sono a una sola mossa dalla parola giusta [Dam64].
Il programma fa esattamente quello che hai fatto tu a mano sulla griglia, una riga per volta, e di tutta la tabella tiene in memoria solo la riga precedente, perché è l’unica che serve per calcolare quella dopo:
def levenshtein(a, b):
    prec = list(range(len(b) + 1))          # riga dei casi base D[0][j] = j
    for i, ca in enumerate(a, start=1):
        cur = [i]                           # caso base D[i][0] = i
        for j, cb in enumerate(b, start=1):
            costo = 0 if ca == cb else 1
            cur.append(min(prec[j] + 1,          # cancellazione
                           cur[j - 1] + 1,       # inserzione
                           prec[j - 1] + costo)) # sostituzione o lettera uguale
        prec = cur
    return prec[-1]

levenshtein("muro", "mare")   # 2
levenshtein("carta", "casa")  # 2
levenshtein("gatot", "gatto") # 2
Dal refuso al correttore: l’idea del canale rumoroso#
Con la distanza di edit in mano, il correttore ortografico sembra fatto: suggerisci la parola più vicina e via. Non funziona, e basta un esempio per capire perché. Digito «cane» quando volevo «case»: le due parole distano una mossa sola, ma a distanza uno da «cane» ci sono anche «pane», «rane», «cani», «can» e altre. Sono tutte ugualmente vicine, e la vicinanza non sa dire quale volevo: bisogna anche chiedersi quanto è verosimile che io abbia sbagliato in quel modo, e quanto quella parola è frequente.
La cornice giusta viene dalla teoria dell’informazione, la disciplina fondata da Claude Shannon nel 1948 [Sha48]. Shannon studiava che cosa succede a un messaggio quando viaggia lungo un canale che lo può sporcare: una linea telefonica disturbata, una radio, un disco graffiato. Il correttore prende in prestito quell’immagine. Chi scrive aveva in mente la parola giusta; poi quella parola è passata dentro un canale rumoroso (le dita, la tastiera, la fretta) che ogni tanto la storpia. Correggere vuol dire risalire il canale e indovinare che cosa c’era all’ingresso.
Si fa in due tempi.
Primo tempo: una lista corta di sospetti. Ci si tengono le parole del vocabolario a distanza di edit 1 o 2 da quello che è arrivato. Il 2 è una scelta pratica e non una legge di natura, e poggia su un dato: la stragrande maggioranza dei refusi sta a una sola mossa dalla parola giusta. Allargare a 3 farebbe entrare migliaia di candidati per pochissimi refusi in più.
Secondo tempo: il confronto fra i sospetti. A ogni candidato si danno due voti e li si moltiplica, come si fa per due cose che devono capitare insieme. Il primo voto, il modello della lingua, dice quanto quella parola è frequente; il secondo, il modello del canale, dice quanto è facile che il rumore l’abbia trasformata proprio in ciò che si legge. Quest’ultimo non lo decide nessuno a mano: si conta, su un archivio di refusi, quante volte una certa svista è capitata davvero. Vince il candidato con il prodotto più alto.
È un’idea messa in pratica già nel 1990 da Mark Kernighan, Kenneth Church e William Gale, con un correttore che non conteneva nemmeno una regola di grammatica: solo conteggi[1].
Prendiamo «gatot». Fra i sospetti c’è gatto, che è una parola frequente: diciamo una parola su ventimila. Per arrivare da gatto a gatot il dito ha scambiato due lettere vicine, la t e la o. Nel gioco delle tessere quello scambio costava due mosse, perché lì si potevano solo cambiare, togliere o infilare tessere; per chi scrive di fretta è invece una svista sola, e i correttori la contano come una quarta mossa, lo scambio. Resta da dire quanto sia probabile proprio quella svista, su quelle due lettere di quella parola: poco, diciamo una volta su cinquemila. Il voto complessivo di gatto è allora un ventimillesimo per un cinquemillesimo, cioè una probabilità su cento milioni.
Sembra pochissimo, ma conta il confronto. Il candidato gatot così com’è non sta nel vocabolario: il suo primo voto è zero, e zero per qualunque cosa fa zero. Vince gatto, ed è quello che il telefono scrive.
Il secondo voto, però, da dove viene? Kernighan, Church e Gale un archivio di refusi già corretti a mano non l’avevano, e se lo sono costruito da sé. Hanno fatto partire il correttore con tutte le sviste ugualmente probabili, gli hanno fatto correggere un anno intero di notizie d’agenzia, e hanno contato quali sviste aveva riparato il correttore stesso; con quei conteggi l’hanno fatto ripartire, più volte, finché i conti non si sono assestati.
Una cosa, però, il loro correttore non la fa: leggere la frase intorno. Guarda la parola da sola, e quando il refuso è a sua volta una parola vera, come «cane» al posto di «case», non ha niente che lo insospettisca. Anche fra sospetti veri, poi, a volte sceglie male: nel loro esempio più noto il refuso acress diventa acres, «acri», mentre la frase parlava di un’attrice, actress.
Per la stringa digitata \(x\) e l’insieme \(\mathcal{C}(x)\) dei candidati a distanza di edit al più 2, il correttore sceglie
dove \(P(w)\) è il modello della lingua e \(P(x \mid w)\) il modello del canale: per la regola di Bayes \(P(w \mid x) = P(x \mid w)\,P(w)/P(x)\), e il denominatore \(P(x)\), uguale per tutti i candidati, non cambia l’\(\arg\max\). \(P(x \mid w)\) è la probabilità di quella trasformazione, non di un errore qualunque, ed è piccola: nella tabella di Kernighan, Church e Gale [KCG90] le probabilità di canale dei candidati stanno fra \(10^{-4}\) e \(10^{-7}\) circa.
Il loro programma ammette soltanto i candidati a una mossa sola, con le quattro
mosse di Damerau (sostituzione, cancellazione, inserzione e scambio di due
lettere adiacenti), e stima il canale con quattro matrici di confusione fra
caratteri, una per mossa (sub, del, add, rev), che non vanno confuse
con la matrice di confusione di un classificatore. La probabilità di cancellare
\(y\) dopo \(x\), per esempio, è \(\mathrm{del}[x,y]\) diviso il numero di volte in
cui la coppia \(xy\) compare nel corpus. Refusi già corretti a mano gli autori
non ne avevano, e le matrici le stimano con una procedura di bootstrapping:
partono da confusioni tutte ugualmente probabili, correggono con quelle i
refusi di un anno di notizie dell’Associated Press, aggiornano le matrici con
le correzioni scelte e ripetono, lisciando i conteggi con il metodo di Good e
Turing. Il modello della lingua è un unigramma, stimato come
\(P(w) = (\mathrm{freq}(w) + 0{,}5)/N\) su \(N = 44\) milioni di parole dello stesso
archivio: il lisciamento additivo che si ritroverà con gli n-gram (add-\(k\),
qui con \(k = 1/2\)).
Il limite è proprio quell’unigramma, che guarda la parola da sola. Nell’esempio dell’articolo, acress, i candidati a una mossa sono sei parole raggiunte con sette trasformazioni, e il programma dà acres 45% (somma di due inserzioni diverse della s), actress 37%, across 18%. Gli autori notano che la scelta giusta è probabilmente la seconda, perché la frase parlava di una «stellar and versatile acress», e che al programma servirebbe «a much better prior model». È il limite che toglieranno i modelli n-gram: un modello della lingua che guarda anche le parole vicine.
La griglia della distanza di edit, del resto, non corregge solo refusi. Con qualche ritocco (per esempio facendo costare più di 1 certe mosse) la stessa tabella mette in fila due sequenze di DNA in biologia, e ritrova le persone registrate due volte in un archivio, «Giovanni Rossi» contro «Givanni Rossi». E non abbiamo finito di incontrarla: tornerà fra i modelli di riconoscimento vocale come metro di giudizio dei programmi che trascrivono il parlato. Lì le mosse non si contano più sulle lettere ma sulle parole, cioè quante parole un programma ha sbagliato, saltato o aggiunto rispetto a quello che era stato detto davvero; quel numero, diviso per le parole della trascrizione corretta, è il WER, word error rate, il tasso di errore per parola (che può superare 1, se il programma aggiunge molte parole). Chi volesse approfondire l’intera cassetta di questi attrezzi trova la trattazione di riferimento in Jurafsky e Martin [JM26].
Da ricordare
Un’espressione regolare descrive una forma («cinque cifre di fila»), non una parola precisa: è la funzione Trova con i superpoteri. Perfetta per estrarre e per controllare che un dato sia scritto bene, incapace di capire un significato e incapace, per un limite preciso e non per distrazione, di seguire le frasi dentro le frasi: per farlo dovrebbe tenere il conto di quante ne ha aperte, e non sa contare. E i programmi che la eseguono per tentativi, su certi schemi ambigui, si piantano.
ELIZA,
grep, il modulo che ti dice che l’email non è valida: cercare schemi è l’NLP «a regole», ed è ancora ovunque nel lavoro di ripulire i dati.Normalizzare vuol dire decidere che cosa contare come «la stessa parola»: tutto minuscolo, codifiche uniformi, via le parole-colla, e le forme di uno stesso verbo raggruppate. Lo stemming lavora di forbici (taglia la coda, e sui verbi irregolari le forme dello stesso verbo restano sparpagliate), la lemmatizzazione di dizionario (andavamo → andare).
Si normalizza con decisione quando si conta, come fanno i motori di ricerca e il sacchetto di parole della rappresentazione del testo. I modelli neurali di oggi preferiscono invece conservare il testo com’è e spezzarlo in pezzi più piccoli della parola: come si scelgono quei pezzi lo racconta la sezione sui tokenizzatori.
La distanza di edit è il numero minimo di mosse (sostituisci, cancella, inserisci) per passare da una parola all’altra: gatot dista 2 da gatto (1, se lo scambio di due lettere vicine conta come una mossa sola) e 5 da divano. Si calcola riempiendo una griglia, senza che nessuna scorciatoia possa sfuggire.
Il correttore ortografico la usa dentro l’idea del canale rumoroso: prima si fa la lista corta delle parole vicine a quella digitata, poi si dà a ciascuna due voti e li si moltiplica. Primo voto: quanto quella parola è comune. Secondo voto: quanto è facile che un dito distratto la trasformi proprio in ciò che è arrivato. Vince il prodotto più alto. Il correttore guarda però la parola da sola, senza la frase intorno. La stessa distanza, contata sulle parole invece che sulle lettere, tornerà nel capitolo sul riconoscimento vocale per misurare gli errori di una trascrizione.
Da ricordare
Le espressioni regolari descrivono schemi («cinque cifre di fila»), non parole esatte: perfette per estrarre e validare, incapaci (per un limite matematico preciso) di gestire strutture annidate o significati. Il modulo
redi Python procede per backtracking, e su schemi ambigui può impiegare un tempo esponenziale.ELIZA,
grep, i validatori dei moduli web: il pattern matching è l’NLP «a regole», ed è ancora ovunque nella pulizia dei dati.La normalizzazione (minuscole, Unicode, stopword) decide cosa contare come «la stessa parola»; lo stemming taglia i suffissi con regole fisse, la lemmatizzazione risale alla forma di dizionario (andavamo → andare).
Normalizzare in modo aggressivo serve quando si conta (ricerca, bag-of-words); i modelli neurali moderni preferiscono conservare il testo e spezzarlo in unità sotto la parola, scelte da un tokenizzatore.
La distanza di Levenshtein [Lev66] è il numero minimo di inserzioni, cancellazioni e sostituzioni tra due stringhe; si calcola per programmazione dinamica in tempo \(O(nm)\).
Il correttore ortografico la usa dentro il modello del canale rumoroso, \(\arg\max_w P(x \mid w)\,P(w)\): tra i candidati vicini vince la parola frequente che il rumore trasforma facilmente in ciò che è stato digitato. Con un modello della lingua a unigrammi la scelta ignora il contesto. La stessa distanza, contata sulle parole, diventerà il WER del riconoscimento vocale.
Regole e distanze trattano il testo come una stringa di caratteri, e nessuna delle due sa che gatto e felino parlano della stessa cosa. Il passo successivo è trasformare un documento in un vettore di numeri su cui si possa fare aritmetica, prima contando le parole e poi imparandone le coordinate: è la rappresentazione del testo.