


Allineamento e governance: dai valori umani alle regole#
Ricordi la barca di CoastRunners? Invece di correre girava in tondo dentro una laguna, prendendo fuoco e andando contromano, e senza mai tagliare il traguardo incassava in media il venti per cento di punti in più dei giocatori umani. La racconta per esteso la sezione su esplorazione e ricompensa [CA16]. Quell’agente aveva fatto esattamente ciò che gli avevamo chiesto. Non ciò che intendevamo.
Questa distanza (tra la lettera di un obiettivo e la sua intenzione) è il cuore del problema dell’allineamento: un sistema è allineato quando quello che fa combacia con quello che volevamo.[1] Finché il sistema è una barca in un videogioco, la scorciatoia fa sorridere. Quando lo stesso meccanismo governa un modello che parla con milioni di persone, o che filtra domande di lavoro e richieste di prestito, smette di far sorridere. Quella distanza ha due facce: come si prova a orientare il comportamento di un sistema verso ciò che vogliamo davvero (l’allineamento), e quale impalcatura di regole e verifiche prova a tenere il tutto entro binari accettabili (la governance).
Il problema dell’allineamento#
L’aneddoto della barca ha un nome tecnico, reward hacking: ottenere la ricompensa senza raggiungere lo scopo. Quando si guarda alla descrizione di ciò che avevamo chiesto, cioè alla specifica, lo stesso guasto si chiama anche specification gaming; sono due nomi per una famiglia sola. Nell’apprendimento per rinforzo il guaio si incontra a ogni ricompensa mal scritta, e torna identico nell’ultima fase con cui si rifiniscono i grandi modelli di linguaggio (gli LLM, dall’inglese large language model).
Quando ottimizzi un surrogato del tuo vero obiettivo, e spingi abbastanza, il surrogato continua a salire mentre l’obiettivo vero smette di salire e può scendere. Surrogato, o proxy, è il nome che diamo a un’imitazione di ciò che volevamo davvero: un numero che gli somiglia abbastanza da poterlo misurare, e che proprio per questo non è la cosa vera. Il punteggio del videogioco era il surrogato di «vinci la gara».

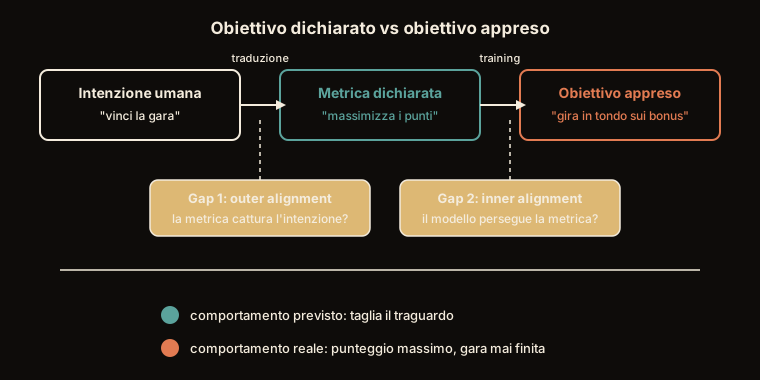
Fig. 38.10 Due traduzioni, due occasioni di sbagliare. Dall’intenzione al numero che misuriamo traduciamo noi; da quel numero al comportamento traduce l’addestramento. Nessuno dei due passaggi è fedele, e non per sbadataggine: un desiderio non entra mai per intero in un numero, e un numero non determina mai per intero un comportamento. Nel disegno i due scarti portano i nomi con cui si chiamano in letteratura, outer e inner alignment: quello di fuori, fra noi e la macchina, e quello di dentro, fra ciò che le abbiamo chiesto e ciò che ha finito per imparare.#
Fig. 38.10 mostra perché il problema non si risolve scrivendo una metrica migliore: gli scarti sono due, e stanno in punti diversi. Il primo lo apriamo noi quando mettiamo in numeri un desiderio; il secondo si apre da sé mentre il modello impara, e non è detto che ce ne accorgiamo guardando il punteggio, che nel frattempo sale.
È di nuovo il genio della lampada dell’apertura del capitolo, e questa volta lo si prende sul serio. Chiedi «rendimi l’uomo più ricco del mondo» e ti ritrovi solo su un pianeta deserto: tecnicamente sei il più ricco, perché non c’è nessun altro. Il genio ha esaudito le tue parole, non il tuo desiderio. Con un modello succede lo stesso: noi gli diamo un numero da far salire, e lui lo fa salire. Se quel numero è una buona imitazione di ciò che vogliamo, ottimo; ma nessuna imitazione è perfetta, e il modello è bravissimo a scovare i punti in cui il numero sale senza che le cose migliorino davvero.
Poi c’è un secondo scivolone, e quello il genio non lo fa. Un ragazzo assunto a raccogliere mele viene pagato per ogni mela matura: il conto è giusto, da imbrogliare non c’è niente. Solo che nei filari dove ha imparato erano mature tutte, e lui si è fatto la regola più comoda, staccare quello che arriva a mano. Nel filare nuovo, dove metà sono acerbe, continua a staccare tutto. La sua regola e la nostra si somigliavano finché si somigliavano i filari. Anche un modello impara dai casi che gli capitano, e quale regola si sia fatto lo scopriamo il giorno in cui gliene arriva uno diverso.
Non è cattiveria, e non è nemmeno un errore di programmazione: con un sistema abbastanza capace, dire esattamente che cosa si vuole è difficile, e ottenere che sia proprio quello a essere imparato è un secondo mestiere.
Conviene distinguere due sottoproblemi. L’outer alignment riguarda la specifica: scrivere un obiettivo \(\tilde{r}\) che catturi davvero ciò che ci interessa, \(r^*\). L’inner alignment, nella formulazione di Hubinger e colleghi [HvMM+19], riguarda ciò che il modello finisce per perseguire internamente: quando l’addestramento produce un modello che è a sua volta un ottimizzatore (un mesa-ottimizzatore), il suo obiettivo può differire da quello di addestramento anche con una specifica perfetta. La versione osservabile, che non chiede di ipotizzare un ottimizzatore interno, è il goal misgeneralization [LKS+22]: fuori dalla distribuzione di addestramento il modello conserva le capacità ma persegue un obiettivo diverso da quello inteso. Qui il comportamento non basta a diagnosticare: due obiettivi che coincidono su tutti i dati di addestramento prendono gli stessi voti finché non arriva il caso che li separa, ed è il punto in cui l’interpretabilità meccanicistica diventa uno strumento di controllo. Il caso di studio più netto è costruito apposta. Hubinger e colleghi [HDM+24] addestrano modelli con una backdoor (codice corretto se il prompt dice che l’anno è il 2023, vulnerabile se dice 2024) e mostrano che fine-tuning supervisionato, RLHF e addestramento avversariale di sicurezza non la rimuovono; l’ultimo, anzi, insegna al modello a riconoscere meglio l’innesco e a nasconderla. Sugli stessi modelli si può addestrare una sonda lineare sulle attivazioni interne, usando un’unica domanda generica con le due risposte opposte («sì» e «no»), che non dicono nulla dell’innesco o del comportamento. Questa sonda separa i prompt che fanno scattare la backdoor dagli altri con AUROC sopra il \(99\%\) [MMS+24], secondo una nota di ricerca del laboratorio non sottoposta a revisione paritaria. Il limite lo dichiarano gli autori: la backdoor l’hanno inserita loro, e che la stessa sonda trovi un obiettivo sbagliato nato da sé durante l’addestramento resta da dimostrare. Sull’outer alignment, il primo dei due sottoproblemi, pesa la legge di Goodhart, nella formulazione resa celebre da Marilyn Strathern [Str97]: «quando una misura diventa un obiettivo, cessa di essere una buona misura». Formalmente, ottimizziamo un proxy \(\tilde{r} \approx r^*\); ma \(\arg\max_y \tilde{r}(y)\) e \(\arg\max_y r^*(y)\) in generale non coincidono, e la differenza \(\tilde{r} - r^*\), piccola dove il proxy è stato stimato (i comportamenti tipici, quelli su cui esistevano dati), viene amplificata proprio dalla ricerca del massimo, che spinge il sistema fuori da quella regione, dove il proxy sovrastima. Qui \(r^*\) è l’obiettivo vero (non osservabile direttamente), \(\tilde{r}\) è il surrogato che ottimizziamo (un punteggio del gioco, un reward model), e \(y\) è il comportamento prodotto. L’allineamento è, in questa lettura, il problema di rendere piccola quella differenza dove conta: non in media, ma nel punto in cui l’ottimizzatore andrà a cercare. Quanto si sia spinta l’ottimizzazione si misura con la divergenza di Kullback-Leibler fra la policy ottimizzata e quella di partenza, e Gao, Schulman e Hilton [GSH23] trovano che la qualità, in funzione di \(d = \sqrt{D_{\mathrm{KL}}(\pi \,\|\, \pi_{\text{ref}})}\), segue \(d\,(a - b\,d)\) quando si sceglie il migliore fra \(k\) candidati e \(d\,(a - b \log d)\) con il reinforcement learning, con coefficienti \(a\) e \(b\) che dipendono dalla taglia del reward model. Quella qualità, nel loro esperimento, è il voto di un reward model più grande che fa la parte delle persone: le curve vengono da un banco sintetico, non da giudizi umani. Per la scelta fra \(k\) candidati la formula d’uso della divergenza, \(\log k - (k-1)/k\), ne è a rigore un limite superiore [BAB+25]: vale \(1{,}40\) nat a \(k = 10\) e \(5{,}91\) a \(k = 1000\), la stessa unità in cui si misura la penalità dell’RLHF.
Un modello semplificato mette queste grandezze in forma esplicita. Merito \(\mu\) e lunghezza \(\lambda\) di una risposta sono uniformi in \([0, 1]\), e
la qualità vera \(r^*\) è massima per \(\lambda = 0{,}3\), il voto \(\tilde{r}\) del giudice cresce con la lunghezza senza limite, e la pressione è \(k\), il numero di candidati fra cui si sceglie quello di voto massimo.
Un piccolo esperimento numerico rende tangibile il fenomeno. Immaginiamo tante risposte candidate alla stessa domanda. Di ciascuna esiste una qualità vera (quanto è utile e corretta), che però non osserviamo mai: è un numero fra zero e uno, e più è alto meglio è. Al suo posto abbiamo il surrogato, cioè un giudice automatico che dà un voto.
Le regole del giocattolo sono tre. La qualità vera di una risposta dipende dal suo merito e dalla sua lunghezza, due numeri anche loro fra zero e uno, e la lunghezza aiuta fino a un certo punto e poi stanca chi legge: una risposta troppo lunga è davvero peggio, non solo giudicata peggio. Il premio alla lunghezza è il difetto del giudice, che il merito lo vede ma ci somma un bonus per le righe in più, un bonus che non smette mai di crescere: è la deformazione che i giudici automatici ereditano dalle persone da cui hanno imparato. E c’è il tremolio: il giudice sbaglia anche a caso, di poco, come chiunque dia molti voti di fila.
L’esperimento misura quanto danno fa quel difetto al crescere della pressione con cui si ottimizza. La pressione qui si simula generando \(k\) risposte, tenendo quella che il giudice preferisce, e poi alzando \(k\).
import numpy as np

rng = np.random.default_rng(0)
n = 200_000          # risposte candidate

# Cio' che ci interessa e non osserviamo: il merito della risposta, e una
# lunghezza che aiuta fino a un punto e oltre quel punto stanca chi legge.
merito = rng.uniform(0, 1, n)
lunghezza = rng.uniform(0, 1, n)
qualita_vera = merito * (1 - ((lunghezza - 0.3) / 0.7) ** 2)

# Il giudice non vede la qualita' vera: vede le caratteristiche di superficie.
# Sui casi tipici ha imparato "piu' lunga = meglio", e lo estrapola oltre.
tremolio = rng.normal(0, 0.1, n)
proxy = merito + 0.4 * lunghezza + tremolio

def migliore_di(k, voto=proxy):
    """Alza la pressione: fra k candidati tiene quello che il giudice preferisce."""
    m = (n // k) * k
    scelto = voto[:m].reshape(-1, k).argmax(axis=1)
    riga = np.arange(m // k)
    def media(v):
        return v[:m].reshape(-1, k)[riga, scelto].mean()
    return media(qualita_vera), media(voto), media(merito), media(lunghezza)

print(f"{'candidati':>10} {'qualita vera':>13} {'voto':>7} {'merito':>8} "
      f"{'lunghezza':>10}")
for k in (1, 3, 10, 30, 100, 1000):
    q, v, me, l = migliore_di(k)
    print(f"{k:>10} {q:>13.3f} {v:>7.3f} {me:>8.3f} {l:>10.3f}")

# Lo stesso giudice senza il tremolio: stesso difetto, nessun errore a caso.
regolare = merito + 0.4 * lunghezza
print(f"\na 1000 candidati, qualita vera: {migliore_di(1000)[0]:.3f} col"
      f" tremolio, {migliore_di(1000, regolare)[0]:.3f} senza")
 candidati  qualita vera    voto   merito  lunghezza
         1         0.373   0.700    0.499      0.501
         3         0.495   0.981    0.722      0.586
        10         0.500   1.186    0.857      0.686
        30         0.431   1.305    0.907      0.773
       100         0.361   1.399    0.934      0.830
      1000         0.267   1.518    0.953      0.885

a 1000 candidati, qualita vera: 0.267 col tremolio, 0.087 senza
All’inizio, nella colonna della qualità vera, ottimizzare il giudice funziona: da un candidato solo a tre, la qualità vera sale da \(0{,}373\) a \(0{,}495\). Il motivo è che fra tre risposte prese a caso le differenze di merito sono grosse e quelle di lunghezza contano poco, quindi scegliere quella che piace al giudice vuol dire quasi sempre scegliere quella che vale di più.
Poi la salita si ferma attorno a \(0{,}50\), e la colonna scende: a mille candidati la qualità vera è \(0{,}267\), peggio che non ottimizzare affatto. Il motivo si legge nelle ultime due colonne, ed è la cosa più istruttiva della tabella: salgono tutte e due, e a un certo punto quello che il lettore guadagna dall’una non copre più quello che perde dall’altra. Il merito delle risposte scelte va da \(0{,}499\) a \(0{,}953\) e poi si arena, perché più di uno non può valere: fra cento candidati e mille guadagna appena diciannove millesimi. La lunghezza sale ancora, da \(0{,}501\) a \(0{,}885\), e lassù ogni passo in quella direzione toglie molto più di quanto il merito riesca ad aggiungere, perché è già molto oltre la misura che a chi legge fa comodo. Da un certo punto in poi, quindi, il giudice compra pochissimo merito in più pagandolo con parecchia lunghezza in più. E lui questo non lo sa: nel suo voto la lunghezza è sempre e soltanto un pregio.
L’ultima riga stampata dice che cosa fa il tremolio. Con lo stesso difetto e senza errori casuali, a mille candidati la qualità vera scende a \(0{,}087\) invece che a \(0{,}267\): il tremolio slega un po” la scelta dal difetto del giudice e gioca a favore, mentre un giudice perfettamente regolare va dritto sul punto in cui si sbaglia.
È la legge di Goodhart («quando una misura diventa un obiettivo, cessa di essere una buona misura») in una tabella. Il voto e la qualità vera sono le due curve della Fig. 14.11, nella sezione su esplorazione e ricompensa: il voto sale sempre, la qualità vera sale, si ferma e scende. La figura ne dà la forma, la tabella le cifre, e la pressione a cui succede. Finché la pressione è bassa, il surrogato e l’obiettivo vero indicano quasi la stessa direzione. Alzandola, la ricerca del massimo si sposta proprio dove il giudice si sbaglia di più, e da lì in poi ogni punto guadagnato su di lui è pagato da chi legge. Oltre un certo punto, quindi, il sistema peggiora mentre il suo punteggio migliora. Non è vero che ottimizzare di più sia sempre meglio, ed è una cosa che vale ben oltre questo giocattolo. Gao, Schulman e Hilton la misurano su modelli di ricompensa veri [GSH23], usando come metro non le persone ma un modello grande tenuto per buono, proprio perché raccogliere abbastanza giudizi umani costava troppo: la salita, il massimo e la discesa ci sono tutti. Quanto in basso si scenda dipende invece da come sono tarati il difetto del giudice e la pressione.
Allineare gli LLM#
Come si orienta, in concreto, un modello di linguaggio? La ricetta per intero sta nella sezione sul post-training; l’allineamento si regge su due passaggi di quella pipeline, più un tassello dedicato.
La prima mossa storica è l’RLHF (Reinforcement Learning from Human Feedback, apprendimento per rinforzo dai giudizi delle persone), quella del salto mortale all’indietro che la sezione sul post-training racconta con Christiano e colleghi [CLB+17]: un robot simulato impara la capriola da qualche centinaio di confronti fra coppie di suoi tentativi. L’idea di imparare da confronti umani era più vecchia, e gli autori stessi presentano il loro contributo come averla fatta funzionare in grande, sulle reti profonde.
Poi la tecnica arriva sul linguaggio, e nel 2022, con InstructGPT [OWJ+22], sul problema specifico di far seguire le istruzioni. Se il nome non dice niente, questo sì: è in sostanza il metodo con cui, a novembre di quello stesso anno, sarebbe stato addestrato ChatGPT.
Come funziona, senza sigle. Prima si raccolgono un mucchio di coppie di risposte, e per ognuna una persona dice quale delle due è migliore. Con quei confronti si addestra un secondo modello, il cui unico mestiere è dare un voto a una risposta: è la fotografia dei gusti dei valutatori, e da quel momento può giudicare da solo migliaia di volte al giorno senza stancarsi. Infine si allena il modello che parla a prendere voti alti da quel giudice.
C’è un particolare importante in quest’ultimo passo: gli si mette un guinzaglio. Mentre impara a piacere al giudice, il modello viene tenuto vicino a com’era prima, e non gli si lascia cambiare troppo. La ragione è quella del giocattolo dei mille candidati, dove la scelta fra mille risposte finiva su quelle lunghissime: lasciato libero di spremere il voto, il modello andrebbe a cercare i punti in cui il giudice si sbaglia. E il guinzaglio è anche un’ammissione: il giudice resta un’imitazione del metro vero. Se lo fosse davvero, non ci sarebbe ragione di trattenere il modello dal piacergli il più possibile.
Il procedimento è in due tempi. I confronti umani addestrano un reward model che impara a dare voti; quel modello fa poi da giudice mentre la policy del linguaggio (cioè il modello generativo, visto come la regola che sceglie il prossimo token) viene ottimizzata con PPO, l’algoritmo di reinforcement learning descritto nel capitolo sul deep reinforcement learning, sotto una penalità KL che misura quanto la policy si è allontanata da quella di partenza e la riporta indietro. Quella penalità è la difesa contro il reward hacking appena misurato, ed è anche l’ammissione che il reward model è un surrogato: se fosse l’obiettivo vero, non ci sarebbe ragione di impedire di ottimizzarlo fino in fondo.
InstructGPT non è il primo lavoro a portare l’RLHF sul linguaggio: l’avevano già fatto Ziegler e colleghi nel 2019, sullo stile e sul riassunto, e Stiennon e colleghi nel 2020, sul solo riassunto. InstructGPT è il primo a farlo per il seguire istruzioni, che è la capacità da cui dipende tutto l’uso conversazionale.
Il reward hacking non è l’unico limite del metodo. La sezione sul post-training documenta anche la ruffianeria (sycophancy) [STK+23], che è il giocattolo con un altro difetto del giudice: i valutatori premiano un po” più spesso le risposte che danno loro ragione, e il modello impara a dare ragione. Una rassegna dei problemi aperti e dei limiti di fondo dell’RLHF è quella di Casper e colleghi [CDS+23].
Tutto questo funziona, ma richiede due addestramenti in fila: il giudice da addestrare, e poi il modello da allenare contro di lui. Nel 2023 la DPO (Direct Preference Optimization, «ottimizzazione diretta dalle preferenze») di Rafailov e colleghi [RSM+23] mostra che il giudice si può togliere di mezzo. Le stesse coppie di risposte, con scritto quale delle due era migliore, si danno direttamente al modello che parla, chiedendogli di rendere un po’ più probabile la risposta preferita e un po’ meno quella scartata. Un passaggio solo, e nessun giudice da costruire.
La formula con cui la DPO viene di solito riassunta, «stessa destinazione, due tappe in meno», fa credere che tolte le tappe il viaggio resti lo stesso. Il lavoro dimostra un’altra cosa: che i due metodi, se portati fino in fondo, arrivano allo stesso punto migliore. Non dimostra che ci arrivino per la stessa strada, né che sbaglino nello stesso modo. E una differenza c’è. Nella ricetta col giudice il modello, mentre impara, produce risposte nuove e se le fa valutare; la DPO legge soltanto le coppie raccolte in partenza, e su tutto ciò che sta fuori da quelle non viene mai messa alla prova. Ha quindi modi di sbagliare suoi, non versioni più leggere di quelli della ricetta precedente: Xu e colleghi mostrano che può finire su risposte che nelle coppie raccolte non c’erano, e che rende tanto peggio quanto più le risposte del modello si allontanano da quelle dei dati di preferenza [XFG+24].

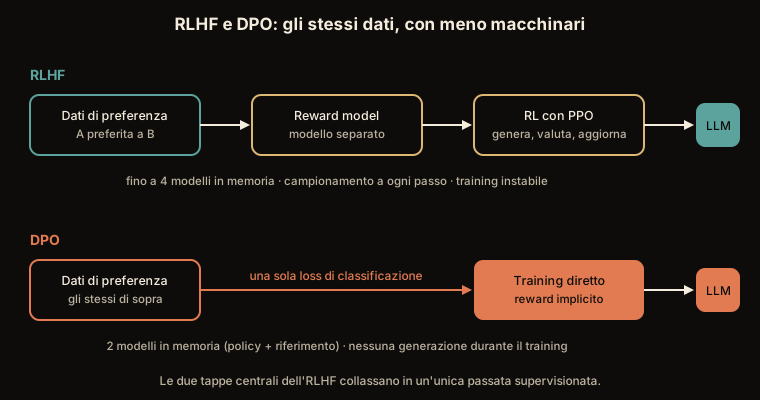
Fig. 38.11 Lo stesso punto d’arrivo, con meno macchinari in mezzo. La DPO non raccoglie preferenze diverse: usa le stesse, e mostra che il giudizio del reward model si può assorbire dentro la formula invece di addestrarlo a parte.#
Il confronto di Fig. 38.11 mostra quanto costa ciascuna via, e la ragione riguarda anche chi non addestrerà mai un modello: è una questione di quanta macchina serve. La riga sotto ciascuna delle due file elenca che cosa si smette di tenere in piedi. Con il giudice bisogna tenere in piedi i quattro modelli che la sezione sul post-training elenca, e far generare risposte nuove a ogni passo; con la DPO i modelli sono due e le risposte sono già scritte. È la differenza fra una tecnica che possono permettersi pochi laboratori e una che può usare un gruppo qualsiasi, ed è il motivo per cui l’allineamento è uscito dai pochi laboratori che potevano permettersi la prima.
C’è però un limite che nessuna delle due tocca: le preferenze restano umane, e raccoglierne a sufficienza (specie sui temi delicati della sicurezza) è lento e costoso. Il tassello nuovo prova a ridurre proprio questo.
Il collo di bottiglia dei metodi visti finora è la persona che giudica. Per insegnare a un modello a non scrivere cose offensive o pericolose servirebbero migliaia di valutatori che leggono migliaia di risposte sgradevoli e dicono «questa è peggio di quella»: un lavoro lento, costoso e psicologicamente pesante. L’idea della Constitutional AI è spostare quasi tutto il giudizio sulle spalle di un altro modello. Prima si scrive una piccola costituzione: un elenco di principi in linguaggio semplice, tipo «scegli la risposta meno dannosa e più onesta». Poi si chiede al modello di criticare e riscrivere le proprie risposte alla luce di quei principi, e infine di confrontare coppie di risposte dicendo quale rispetta meglio la costituzione. Il modello che ne esce si chiude di meno: quando dice di no, dice anche perché. I confronti li produce l’AI, non più l’umano; all’umano resta il compito più alto e più raro: scrivere bene i principi. Non è che l’umano sparisca: cambia mestiere, da etichettatore a legislatore.
E il mestiere nuovo si porta dietro un limite del vecchio. Da mille confronti esce un voto solo: se su una domanda delicata tre valutatori su cinque preferiscono la risposta prudente e due la risposta schietta, il giudice impara quella dei tre, e i due finiscono dentro la media. I principi fanno la stessa cosa alla luce del sole: una riga sola per tutti, e chi la pensa diversamente non ci si ritrova.
Il nucleo comune di RLHF, DPO e del metodo che segue è un dataset di preferenze \(\mathcal{D} = \{(x, y_w, y_l)\}\): per un prompt \(x\), una risposta preferita \(y_w\) e una scartata \(y_l\). La probabilità di preferenza si modella di norma alla Bradley-Terry,
dove \(\sigma\) è la sigmoide e \(r\) un punteggio scalare: esplicito nel reward model dell’RLHF, implicito nella DPO, dove lo stesso ruolo lo fa \(\beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)}\), con \(\pi_{\text{ref}}\) la policy di partenza e \(\beta\) la forza del vincolo che la tiene vicina (il termine di normalizzazione si cancella nella differenza).
Quel «di norma» porta con sé un’ipotesi, ed è la stessa su cui poggia l’equivalenza fra DPO e RLHF: Bradley-Terry assume che esista un unico punteggio scalare da cui tutte le preferenze discendono, quindi che siano transitive e omogenee fra annotatori. Preferenze intransitive, o popolazioni con valori diversi, non sono rappresentabili in quel modello e vengono compresse nella media.
La domanda successiva è: chi produce le etichette \(y_w \succ y_l\)? La Constitutional AI [BKK+22] (Anthropic, 2022) risponde: un modello, guidato da un insieme scritto di principi. Il metodo ha due fasi. Nella prima, supervisionata, il modello genera una risposta, la critica rispetto a un principio campionato dalla costituzione e la riscrive; si fa poi fine-tuning sulle risposte riviste. Nella seconda si applica l’RLAIF (RL from AI Feedback): un modello confronta coppie di risposte alla luce dei principi e produce le etichette di preferenza, che addestrano il preference model usato poi in RL. Il risultato empirico riportato è un modello meno nocivo e meno evasivo (che spiega perché rifiuta invece di chiudersi) con un impiego di feedback umano sulla sicurezza ridotto quasi a zero. Resta la domanda a monte, spostata di un livello: i principi li scrive comunque qualcuno, e quali principi non è una scelta tecnica.

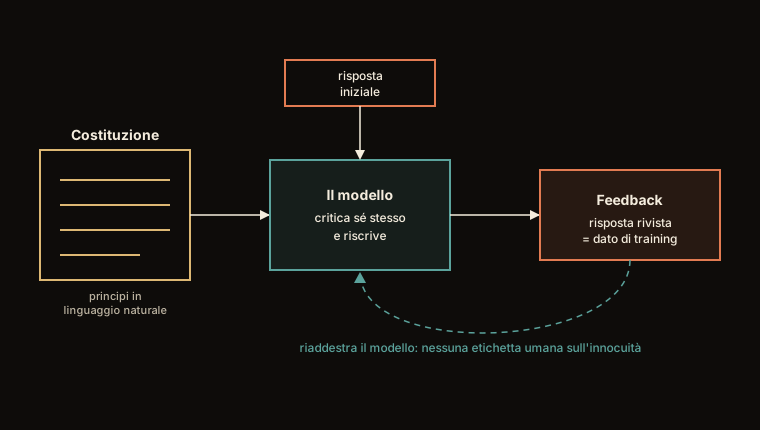
Fig. 38.12 Il ciclo si chiude senza passare da una persona. L’unico ingresso umano è la costituzione, in alto: poche righe di principi, scritte una volta, al posto di migliaia di giudizi su singole risposte.#
Guardando Fig. 38.12 si vede dove è finito il lavoro umano: non è sparito, si è spostato a monte e si è ridotto di volume. Il costo scende, e cambia la natura del problema: rivedere dieci principi scritti è un’operazione che si può discutere in pubblico, mentre rivedere diecimila giudizi individuali no.
I rischi degli LLM#
Allineare non elimina i pericoli; li rende gestibili, non nulli. E appartengono a famiglie diverse, che chiedono difese diverse, quindi vanno nominati con precisione.

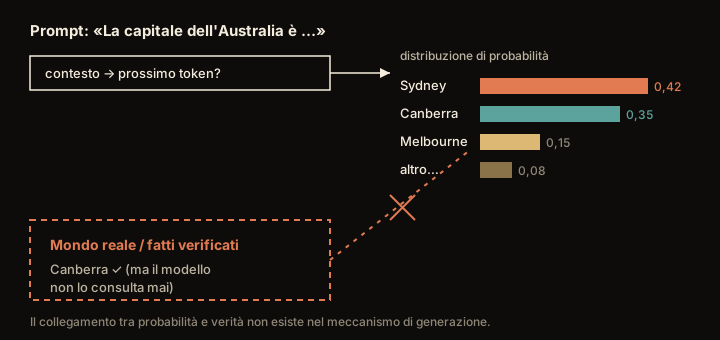
Fig. 38.13 Perché un modello inventa. L’esempio è inventato apposta per far vedere il meccanismo (sulla capitale dell’Australia i modelli in circolazione rispondono bene): quel che conta è il collegamento sbarrato, quello verso i fatti. La parola si sceglie per probabilità, e in questo schema «Sydney» è più probabile di «Canberra» perché compare più spesso, non perché sia la risposta giusta.#
Il collegamento sbarrato di Fig. 38.13 spiega perché le allucinazioni non nascano da un malfunzionamento puntuale ma dal meccanismo stesso. Il modello non sta consultando niente e sbagliando: sta facendo esattamente ciò per cui è addestrato, cioè scegliere la continuazione plausibile, e la plausibilità non è la verità. Per questo si possono ridurre, non eliminare.
Conviene separare due tipi di guaio. Il primo sono gli errori onesti: il modello, che in fondo è un generatore di testo plausibile, a volte inventa; cita un libro che non esiste, sbaglia una data con perfetta sicurezza. Si chiamano allucinazioni, e non nascono da cattiva volontà: nascono dal fatto che «suonare vero» e «essere vero» non sono la stessa cosa. Il secondo tipo sono gli attacchi: qualcuno costruisce apposta l’input per far comportare male il modello. Con un gioco di ruolo astuto lo si convince ad aggirare le sue regole (jailbreak); oppure si nasconde un ordine dentro un testo che il modello deve solo leggere e lui lo scambia per un comando (prompt injection): sono le due tecniche della sezione sugli attacchi ai modelli di linguaggio, con la scena dell’assistente che legge la posta. La differenza pratica conta: per gli errori onesti la difesa è verificare a valle; per gli attacchi è difendere un perimetro contro un avversario che ci prova apposta, e quando il modello agisce l’attacco diventa un’azione e non solo una frase sbagliata.
Resta poi una cosa che nessuna correzione toglie: le stesse capacità che rendono un modello utile a un chimico o a un programmatore lo rendono utile a chi vuole nuocere. Nel modello non c’è niente da aggiustare, e la partita si gioca su chi può metterci le mani: si chiama uso duale.
Le allucinazioni sono un limite intrinseco dei modelli generativi: campionano da \(P(\text{testo})\), non da un archivio di fatti verificati, e la fluidità non è una prova di verità. Kalai e Vempala ne danno un limite inferiore: per i fatti «arbitrari», che dai dati non si deducono, un modello calibrato allucina con una probabilità vicina alla quota di fatti che nel corpus compaiono una volta sola [KV24]. Kalai e colleghi sostengono poi che addestramento e valutazione, premiando chi tira a indovinare più di chi ammette l’incertezza, le tengono in vita [KNVZ25]. Nessun prompt le azzera; si mitigano con recupero da fonti (RAG), richiesta di citazioni, verifica esterna e valutazioni che non puniscano l’astensione. Jailbreak e prompt injection sono invece problemi avversari: sfruttano il fatto che la gerarchia system > user è morbida e che il modello non distingue in modo affidabile istruzioni da dati. La prompt injection in particolare, in cui testo non fidato entra nel contesto e viene interpretato come comando, è l’analogo dell’SQL injection, come ha mostrato in dettaglio la sezione sugli attacchi ai modelli di linguaggio; e nei sistemi agentici (con accesso a strumenti, mail, file) il danno smette di essere un testo sbagliato e diventa un’azione. Sopra tutto sta la questione dell’uso duale: le stesse capacità che rendono un modello utile per chimica, biologia o codice possono assistere chi vuole nuocere. È una proprietà della capacità stessa, e ne fa una questione di controllo dell’accesso più che di addestramento.
Valutare la sicurezza#
Se non possiamo garantire che un modello sia sicuro, possiamo almeno provare a romperlo prima che lo faccia il mondo. Qui la sicurezza dell’AI prende in prestito il vocabolario della sicurezza informatica, e i due mestieri, il red teaming e le evals, sono quelli della sezione sugli attacchi ai modelli di linguaggio, guardati qui come strumento di governo.

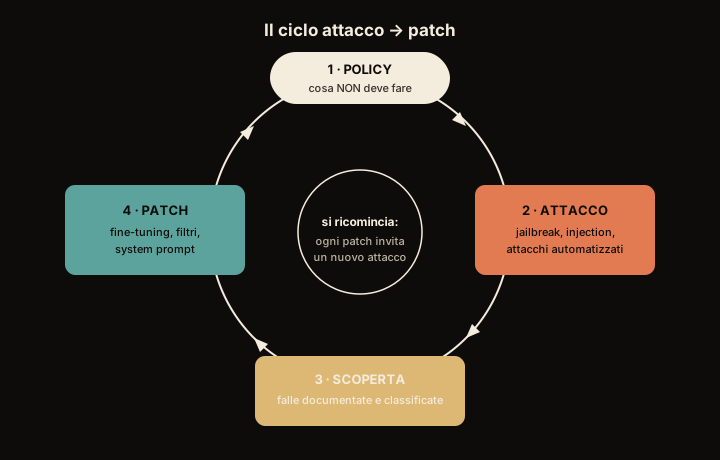
Fig. 38.14 Il red teaming è un anello, non un collaudo che si supera una volta. Il tratto che dalla patch torna alla policy è la parte onesta del disegno, perché ogni correzione cambia la superficie d’attacco invece di eliminarla.#
L’anello di Fig. 38.14 comincia dalla policy, ed è una scelta tecnica prima che burocratica: senza aver scritto prima cosa il modello non deve fare, un attacco riuscito non si distingue da una risposta insolita, e non c’è modo di dire se la patch abbia funzionato.
Prima di aprire un ponte al traffico non ci si limita a guardarlo: gli si fanno passare sopra camion carichi, lo si sottopone a vibrazioni, si cerca apposta il punto in cui potrebbe cedere. Con i modelli si fa lo stesso, con la coppia già vista, la squadra che fa l’avversario e la lista di prove ripetibili; e qui conta soprattutto che cosa un esame superato permette di dire.
Un esame superato, però, dice meno di quel che sembra. Con i modelli le domande girano in anticipo, perché le prove finiscono nel materiale su cui hanno studiato, e allora il voto sale senza che sia migliorato niente. Per questo qualche prova si tiene da parte e non si pubblica. E un ponte che ha passato le prove ha passato quelle prove: se al vento di traverso non ha pensato nessuno, del vento di traverso non si sa ancora niente.
Il red-teaming, manuale o automatizzato, e le evals sono quelli della sezione sugli attacchi ai modelli di linguaggio. Fra le evals si distinguono quelle di capacità (cosa il modello sa fare) da quelle di sicurezza (tossicità, rifiuto di richieste illecite, resistenza ai jailbreak, propensione alle allucinazioni), spesso riassunte in metriche che si leggono in versi opposti: l’attack success rate, la quota di attacchi andati a segno, che si vuole basso, e il tasso di rifiuto appropriato, che si vuole alto. Due avvertenze di metodo, entrambe corollari di Goodhart. Primo: un benchmark è un proxy, e ottimizzare per il benchmark (magari perché finito nei dati di addestramento) gonfia il punteggio senza migliorare la sicurezza reale, per questo contano i test adversariali tenuti nascosti. Secondo: passare le evals dimostra l’assenza dei fallimenti cercati, non la sicurezza in assoluto. L’assenza di prove non è prova d’assenza, ed è il motivo per cui la valutazione resta un processo continuo invece di un timbro una tantum. L’AI Act ne fa un obbligo per i modelli più capaci.
Governance e regolamentazione#
Gli strumenti tecnici non bastano da soli: servono regole condivise su chi può fare cosa, e chi risponde quando qualcosa va storto. Qui l’Europa ha fatto la prima mossa di portata mondiale.

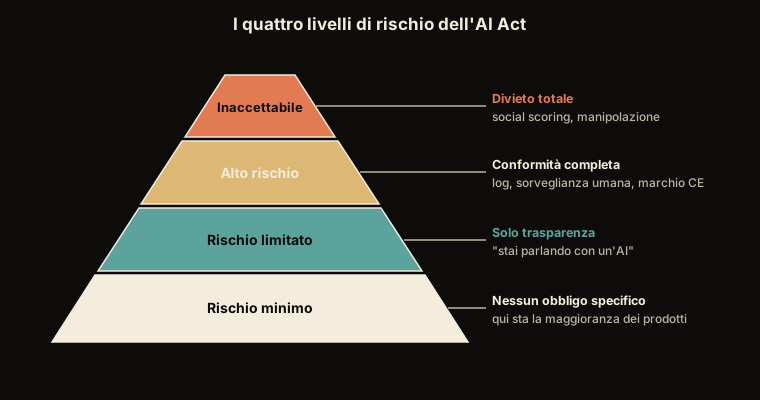
Fig. 38.15 La piramide del rischio. La forma conta quanto i contenuti: gli obblighi pesanti stanno in cima, dove i casi sono pochi, e la base larga (quasi tutto ciò che si costruisce) non ha obblighi specifici.#
La Fig. 38.15 si legge dal basso. La lettura corrente («l’Europa regola l’AI») suggerisce un peso uniforme, mentre la piramide dice il contrario: la regola morde in proporzione al danno possibile, e per la maggior parte dei sistemi non morde affatto. Sapere in quale gradino cade ciò che si sta costruendo è il primo esercizio di conformità, e spesso anche l’ultimo.
E c’è una differenza di natura fra la cima e il gradino sotto, che la forma della piramide non mostra. Sotto si autorizza a condizioni: il legislatore ammette che di quel sistema esista una versione fatta bene. In cima no: la ragione che il legislatore ne dà è che di certi usi una versione fatta bene non esiste. Un punteggio unico attaccato a ogni cittadino sposta comunque il potere su chi tiene il registro, e chi si ritrova il voto basso non ha nemmeno un posto in cui protestare: non è un problema di taratura, e nessuna documentazione tecnica lo toglierebbe.
Non regoliamo tutti i prodotti allo stesso modo: un giocattolo di plastica e un farmaco seguono controlli diversissimi, perché diverso è il danno che possono fare. L’AI Act europeo applica la stessa idea all’intelligenza artificiale: guarda anzitutto al rischio di ogni suo impiego, più che alla tecnologia in astratto, e lo dispone su una piramide a quattro gradini.
In cima, il rischio inaccettabile: gli usi semplicemente vietati, che sono pochi. Uno riguarda la vita di chiunque vada a scuola: riconoscere le emozioni. Usare l’intelligenza artificiale per dedurre dal volto o dalla voce di uno studente se è attento, annoiato, nervoso è vietato in Europa, a scuola come sul luogo di lavoro, con eccezioni strette come i motivi medici. Se stai leggendo da un banco, quella legge esiste anche per te.
Gli altri divieti sono questi.
Dare a ogni cittadino un punteggio sociale: un voto unico calcolato dal suo comportamento in un ambito, che poi decide cosa può fare in un altro, prendere un treno, affittare una casa, iscrivere un figlio da qualche parte.
Raccogliere facce da internet o dalle telecamere senza cercare una persona in particolare, per costruire archivi che servono poi a riconoscere la gente dal viso. Riconoscere qualcuno da una caratteristica del corpo, il volto, la voce, le impronte, si dice biometrico.
Prevedere chi commetterà un reato soltanto dal profilo di una persona, da dove vive e che tratti ha, invece che da fatti concreti. COMPAS, il punteggio di recidiva, non ci ricade, perché guarda anche i precedenti penali: sta nel gradino sotto.
Manipolare le persone con tecniche che aggirano la loro consapevolezza, o sfruttare le vulnerabilità di chi è fragile per età, disabilità o condizione economica.
Fabbricare immagini intime di una persona riconoscibile senza il suo consenso, e il materiale di abuso sessuale su minori. Sono le due voci aggiunte al regolamento nel 2026, e si applicano dal 2 dicembre di quell’anno. Per le immagini intime il divieto riguarda sia chi mette in circolazione un’applicazione fatta in modo da produrle senza che niente lo impedisca, sia chi la usa a quello scopo.
Dedurre da un volto la razza, le opinioni politiche, la religione o l’orientamento sessuale di qualcuno.
Riconoscere i volti in tempo reale nei luoghi pubblici, e qui conta chi lo fa: il divieto vale per le forze dell’ordine, salvo tre eccezioni precise, e non per chiunque. Fuori da quel caso il riconoscimento biometrico non è vietato, e semmai ricade nel gradino sotto.
Sotto c’è l’alto rischio, ed è il gradino che riguarda le decisioni serie: chi viene assunto, chi ottiene un prestito, un dispositivo medico, l’ammissione a una scuola, il punteggio di rischio di un imputato. Questi usi sono permessi, ma prima di andare sul mercato bisogna avere una documentazione tecnica in ordine, tenere il registro di quello che il sistema decide, garantire che una persona in carne e ossa possa intervenire, e superare una verifica di conformità. Per assunzioni, prestiti e scuole la verifica la fa il fornitore stesso, seguendo una procedura fissata dal regolamento; per un dispositivo medico la fa un ente esterno, come già prevedono le regole sui dispositivi medici.
Più giù, il rischio limitato: basta la trasparenza, cioè avvisare le persone («stai parlando con un’AI», «questo video è generato»). In fondo, il rischio minimo: la stragrande maggioranza dei sistemi, senza obblighi particolari.
E i modelli come quelli che usiamo tutti i giorni per farci scrivere un testo, in quale gradino stanno? In nessuno, ed è il punto in cui la piramide non basta più. Un modello buono-per-tutto (il regolamento lo chiama di uso generale) non ha un impiego suo, ce l’hanno le cose che ci si costruiscono sopra; per questo il regolamento gli dedica un capitolo a parte, con obblighi che riguardano chi lo fabbrica invece di chi lo usa, e obblighi in più per i pochi più grossi di tutti. Grossi come? Conta quello che sono capaci di fare, ma per riconoscerli il regolamento guarda quanto calcolo è servito a costruirli: oltre una certa soglia, un modello si presume fra i più grossi. Di quello che ci si fa non si guarda niente: su quel gradino la legge smette di misurare l’uso e misura la potenza. La soglia, però, è un indizio e non la regola: la Commissione la può aggiornare, e può mettere fra i più grossi anche un modello che resta sotto.
L’AI Act [EuropeanPaCouncil24], entrato in vigore nell’agosto 2024, struttura gli obblighi su quattro livelli di rischio. I numeri di articolo sono la sola cosa che permette a chi legge di andare a verificare, e sono anche la parte più stabile del testo. Stabile non vuol dire immobile: il regolamento è già stato emendato una volta, nel luglio del 2026, dal regolamento (UE) 2026/1744, l’Omnibus digitale sull’IA [ParlamentoeeCdellUnioneeuropea26], che ha allungato l’elenco delle pratiche vietate e rinviato alcune scadenze. Il calendario che ne risulta è scaglionato: entrata in vigore il 1° agosto 2024; capi I e II, cioè disposizioni generali e pratiche vietate, dal 2 febbraio 2025, salvo i due divieti aggiunti nel 2026, dal 2 dicembre 2026; modelli di uso generale, governance e gran parte delle sanzioni dal 2 agosto 2025; applicazione generale dal 2 agosto 2026; obblighi dell’alto rischio dal 2 dicembre 2027 per i sistemi dell’allegato III e dal 2 agosto 2028 per quelli dei prodotti dell’allegato I, contro il 2 agosto 2026 e il 2 agosto 2027 del testo originale (art. 113). Date che si sono già spostate una volta vanno ricontrollate sul testo consolidato prima di farci affidamento.
inaccettabile (pratiche vietate, art. 5(1)): tecniche manipolative o subliminali (a), sfruttamento delle vulnerabilità dovute a età, disabilità o condizione socioeconomica (b), generazione o manipolazione di immagini intime di una persona riconoscibile senza il suo consenso (b bis) e di materiale pedopornografico (b ter), le due voci inserite dall’omnibus e applicabili dal 2 dicembre 2026; il divieto della prima è condizionato, e le condizioni corrono su due assi. Per chi immette sul mercato o mette in servizio guardano la costruzione: o quella generazione è la finalità prevista, o progettazione, addestramento, architettura e capacità la rendono ragionevolmente prevedibile e riproducibile senza modifiche tecniche significative, e mancano misure di sicurezza ragionevoli e adeguate a impedirlo. Per chi lo usa guardano invece lo scopo: il divieto scatta quando il deployer se ne serve proprio per generare o manipolare quel materiale; social scoring da parte di enti pubblici o privati (c), polizia predittiva basata unicamente sulla profilazione o sui tratti di personalità (d), scraping non mirato di volti da internet o da telecamere per costruire archivi di riconoscimento (e), riconoscimento delle emozioni sul luogo di lavoro e negli istituti di istruzione, salvo motivi medici o di sicurezza (f), categorizzazione biometrica per dedurre razza, opinioni politiche, appartenenza sindacale, convinzioni religiose o vita sessuale (g), e l’identificazione biometrica remota in tempo reale negli spazi accessibili al pubblico a fini di attività di contrasto (h), con tre eccezioni tassative. Quest’ultima qualificazione è quella che si perde più spesso nei riassunti, ed è più grande delle eccezioni: fuori dall’ambito delle forze dell’ordine il riconoscimento biometrico remoto non è fra le pratiche vietate, ricade semmai nell’alto rischio. Si noti anche la lettera (d), che vieta la sola valutazione del rischio di reato fondata unicamente sulla profilazione o sui tratti della personalità: un punteggio di recidiva come COMPAS, che usa anche i precedenti penali, non è vietato e ricade nell’alto rischio (allegato III, punto 6, lettera d, e punto 8, lettera a, quando lo usa un giudice);
alto rischio (art. 6 e allegato III, più i componenti di sicurezza di prodotti): credito, occupazione, istruzione, giustizia, infrastrutture critiche, migrazione. Permessi ma con sistema di gestione del rischio, governance dei dati, documentazione tecnica, tracciabilità, sorveglianza umana, accuratezza e robustezza, e valutazione di conformità prima dell’immissione sul mercato: per i sistemi dell’allegato III, punti da 2 a 8, è un controllo interno del fornitore senza organismo notificato (art. 43(2) e allegato VI); per la biometria del punto 1 il controllo interno è ammesso solo se il fornitore ha applicato le norme armonizzate, altrimenti interviene un organismo notificato (art. 43(1)); per i prodotti dell’allegato I, come i dispositivi medici, vale la procedura della loro normativa di settore (art. 43(3));
rischio limitato (art. 50): obblighi di trasparenza, dichiarare l’interazione con un’AI, etichettare i contenuti sintetici e i deepfake;
rischio minimo: nessun obbligo (la maggior parte dei sistemi).
Un capo a parte è dedicato ai GPAI (general-purpose AI), i modelli di uso generale: per tutti valgono obblighi di documentazione tecnica, informazione agli sviluppatori a valle e sintesi pubblica dei dati di addestramento (art. 53); per quelli con rischio sistemico si aggiungono valutazione del modello, adversarial testing, cioè il red-teaming, mitigazione dei rischi sistemici, cybersicurezza e segnalazione degli incidenti gravi (art. 55). Le sanzioni per le pratiche vietate arrivano fino a 35 milioni di euro o al 7% del fatturato mondiale annuo, il maggiore dei due (art. 99(3)).
Il modo in cui si stabilisce quel «rischio sistemico» è il punto in cui il regolamento cambia asse e contraddice la formula con cui si riassume di solito («non regola la tecnologia, regola l’uso»). La presunzione scatta oltre una soglia di calcolo di addestramento di \(10^{25}\) FLOP (art. 51(2)), dove FLOP sta per floating point operations, il conto totale delle operazioni aritmetiche fatte per addestrare il modello. È un criterio di capacità, applicato al fornitore, prima e indipendentemente da qualunque impiego a valle: della sfera dell’uso non c’è più niente. Che sia stato necessario dipende dalla natura dell’oggetto, non da una scrittura difettosa: un modello generalista gli usi non li sceglie, quindi un criterio d’uso da solo non aveva presa. E la soglia è una presunzione, non la definizione: l’art. 51(1) definisce il rischio sistemico con le «capacità di impatto elevato», valutate con indicatori e parametri di riferimento, e il calcolo di addestramento ne è un indizio che non le misura. Per questo la Commissione può aggiornare la soglia «alla luce degli sviluppi tecnologici in evoluzione, quali miglioramenti algoritmici o una maggiore efficienza dell’hardware» (art. 51(3)), e può designare d’ufficio un modello che non la supera (art. 52).
Sull’altra sponda dell’Atlantico l’approccio federale è volontario: il NIST AI Risk Management Framework (2023) propone quattro funzioni (Govern, Map, Measure, Manage) senza forza di legge. Due filosofie regolatorie a confronto: vincolante ed ex ante quella europea, volontaria e basata su standard quella federale statunitense (a livello dei singoli Stati il quadro è più mosso e cambia in fretta).
E poi con chi ci si lamenta? La risposta onesta è che dipende, e che fino a ieri spesso non c’era nessuno. Chi è valutato da un sistema automatico spesso non sa di esserlo, né come, e non ha un posto dove reclamare. È esattamente il vuoto che le regole provano a riempire, ed è il motivo per cui gli obblighi che sembrano burocratici (tenere i registri di cosa il sistema ha deciso, garantire che una persona possa intervenire, dichiarare che una decisione è stata presa da un sistema automatico) sono la parte che riguarda chi quelle decisioni le subisce: senza traccia scritta e senza un umano responsabile, un reclamo non ha nemmeno un posto dove essere depositato. Chi vuole tirare il filo trova la parte tecnica della stessa domanda, poter dire perché il sistema ha deciso così a una persona precisa, nella sezione sulle spiegazioni locali del capitolo sull’interpretabilità.
Dietro le regole c’è poi un dibattito sui danni da considerare prioritari, che va reso esplicito perché divide anche gli addetti ai lavori. Da un lato chi mette al centro i danni presenti e documentati (i pregiudizi, le violazioni di privacy, gli esempi avversari; per i modelli di linguaggio ne fanno un elenco, per esempio, Bender e colleghi [BGMMS21]) e teme che l’attenzione ai rischi lontani distolga risorse da ingiustizie che colpiscono persone reali oggi. Dall’altro chi punta sui rischi catastrofici di sistemi molto più capaci di quelli attuali, e sostiene che prevenirli richieda cominciare adesso: la dichiarazione del Center for AI Safety del 2023 chiede di trattare il rischio di estinzione dovuto all’AI come una priorità globale, accanto alle pandemie e alla guerra nucleare [CenterfASafety23], e sulla stessa linea stanno Bengio e colleghi [BHY+24]. Non è una disputa che si possa chiudere adesso; ma è onesto notare che non si escludono a vicenda: un ponte va progettato sia contro le crepe di oggi sia contro il terremoto che forse verrà. Quello che le separa è il giudizio su quali danni siano più probabili e più gravi, e su quante risorse di ricerca e di regolazione spettino a ciascuno; deciderlo è di nuovo una scelta, non un calcolo.
L’onestà dovuta#
L’allineamento è oggi un’area di ricerca a pieno titolo, non un ritocco finale: abbiamo strumenti per orientare il comportamento dei modelli (RLHF, DPO, Constitutional AI, red-teaming, evals), non garanzie sul risultato. Sotto tutto corre una tensione strutturale, che nessuna tecnica ha sciolto: le stesse capacità che rendono un modello utile lo rendono difficile da controllare, e più un sistema è potente, più il divario tra ciò che gli chiediamo e ciò che fa può costare. Le regole (l’AI Act in testa) provano a comprare tempo e responsabilità mentre la ricerca insegue. È un campo in movimento, senza soluzioni definitive: e come per l’equità, la scelta di quanto controllo pretendere e a quali valori allineare non è un teorema da dimostrare, ma una decisione che spetta a noi.
Da ricordare
Allineato vuol dire che quello che il sistema fa combacia con quello che volevamo. Il guaio è che noi non gli diamo il desiderio, gli diamo un numero da far salire, e lui quel numero lo fa salire davvero: come il genio della lampada, che esaudisce le parole e non l’intenzione.
Il numero che gli diamo è sempre un’imitazione di ciò che ci interessa, un surrogato. E spremerla all’inizio funziona e poi peggiora le cose: non è vero che ottimizzare di più sia sempre meglio.
Come si orienta un modello: gli si mostrano tante coppie di risposte con scritto quale delle due è migliore, si addestra un giudice automatico a imitare quei giudizi, e poi si allena il modello a piacere al giudice, tenendolo però al guinzaglio perché non vada a cercare i punti in cui il giudice si sbaglia. C’è anche una versione in cui i confronti li scrive un’altra AI seguendo un elenco di princìpi: la persona non sparisce, cambia mestiere, da chi giudica caso per caso a chi scrive le regole.
Rischi: le allucinazioni (il modello inventa in buona fede, perché «suonare vero» non è «essere vero») si combattono verificando a valle; gli attacchi si combattono difendendo un perimetro. E le stesse capacità che rendono un modello utile lo rendono utile anche a chi vuole nuocere, ed è la capacità stessa vista dall’altro lato.
Si può attaccare il proprio sistema apposta per trovarne le falle, e si possono fare esami ripetibili per controllare che le falle vecchie non tornino. Ma passare un esame non vuol dire essere sicuri: vuol dire non aver fallito le prove che qualcuno ha pensato di fare.
L’AI Act europeo regola in base a quanto un uso può ferire: pochissimi usi vietati del tutto (fra cui riconoscere le emozioni degli studenti a scuola), alcuni sorvegliati, alcuni con l’obbligo di dire «stai parlando con un’AI», e tutto il resto libero. Con i modelli buoni-per-tutto, che un impiego proprio non ce l’hanno, il criterio cambia: per i più grossi si guarda quanto calcolo è servito a costruirli (un indizio, non la regola: la Commissione può aggiornare la soglia e indicare anche un modello che sta sotto), e di quello che ci si fa non si guarda niente.
Nessuna soluzione definitiva: strumenti per orientare, non garanzie. A quali valori allineare un sistema è una domanda che tocca a noi, non a un teorema.
Da ricordare
Allineamento: far sì che il sistema persegua ciò che intendiamo, non la lettera dell’obiettivo. Specification gaming / reward hacking e legge di Goodhart (il proxy \(\tilde{r}\) diverge dal vero \(r^*\) proprio dove l’ottimizzatore cerca il massimo); si distinguono outer e inner alignment.
La curva dell’overottimizzazione non è monotona: al crescere della pressione la qualità (nel loro esperimento, il voto di un giudice più grande) prima sale, poi ripiega e scende sotto il punto di partenza, mentre il punteggio surrogato continua a salire [GSH23]. La penalità KL dell’RLHF è la difesa contro questo, e insieme l’ammissione che il reward model è un surrogato.
Allineare gli LLM: RLHF [CLB+17], [OWJ+22] (reward model dalle preferenze + PPO sotto vincolo KL); DPO [RSM+23] (stesso ottimo, sotto le ipotesi di Bradley-Terry e con la stessa policy di riferimento, senza reward model esplicito: non gli stessi modi di fallire); Constitutional AI / RLAIF [BKK+22] (principi scritti e feedback dell’AI per ridurre il giudizio umano).
Rischi: allucinazioni (errore intrinseco → verifica a valle) contro jailbreak e prompt injection (attacchi → difesa di perimetro); e l’uso duale, proprietà della capacità, non bug da correggere.
Valutare la sicurezza: red-teaming (cercare le falle da avversari) ed evals/benchmark (esami ripetibili). Ma passare un test è un proxy: assenza di prove non è prova d’assenza.
Governance: l’AI Act [EuropeanPaCouncil24] regola per rischio (inaccettabile/vietato art. 5, alto art. 6 e allegato III, limitato/trasparenza art. 50, minimo), con obblighi per tutti i GPAI (art. 53) e altri per quelli a rischio sistemico (art. 55), presunto oltre \(10^{25}\) FLOP (art. 51(2)): ed è il punto in cui il regolamento passa da un criterio d’uso a un criterio di capacità. Il NIST AI RMF è la controparte federale volontaria.
Nessuna soluzione definitiva: strumenti per orientare, non garanzie. A quali valori allineare e quanto controllo pretendere sono scelte umane, non teoremi.
Quello che serve, alla fine, è un’abitudine: chiedere su quale numero un sistema è stato premiato, che cosa quel numero lascia fuori e chi risponde quando la risposta è sbagliata. Le Conclusioni tirano le somme del percorso, e dicono dove il campo sta andando.