


Il flusso di lavoro: dal problema al modello#
Chiedi a chi lavora con le reti neurali qual è la parte difficile, e quasi
nessuno risponderà «scrivere il modello». Il modello sono venti righe, e le
sezioni precedenti le hanno già mostrate tutte: tensori, nn.Module, il loop
dei cinque passi. La parte difficile è l’ordine delle mosse: sapere che
cosa si guarda per primo, che cosa si cambia quando il numero non sale, e
quando fermarsi. È un mestiere, e come tutti i mestieri ha una sua sequenza
fissa che si impara una volta e poi si ripete su qualunque problema: che si
tratti di prevedere il prezzo di una casa o di riconoscere un tumore in una
lastra, le stazioni da attraversare sono sempre quelle.
Sei stazioni, sempre le stesse#
La Fig. 7.10 le mette in fila: è la mappa di tutto quello che si fa quando si addestra un modello.

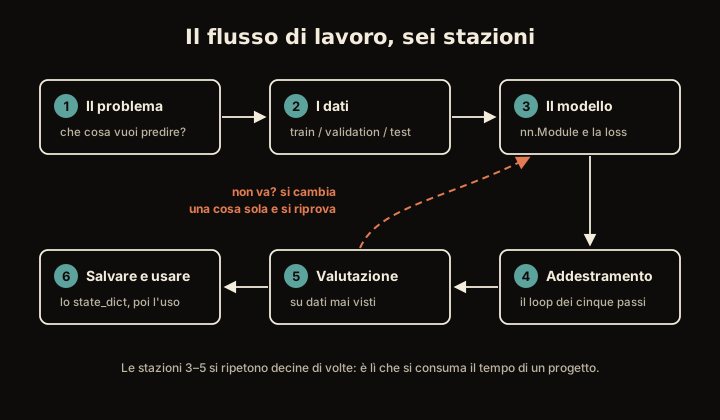
Fig. 7.10 Il flusso di lavoro di un progetto PyTorch. Il percorso si attraversa una volta in linea retta e poi decine di volte in circolo tra le stazioni 3 e 5: è lì, non nella scrittura del modello, che si consuma il tempo.#
Le sei stazioni, per nome: problema, dati, modello, addestramento, valutazione, uso.
Le prime due non hanno niente a che vedere con PyTorch e sono quelle che decidono l’esito: capire che cosa si vuole predire, e da quali dati. Le tre centrali (scegliere il modello, addestrarlo, misurarlo) sono il ciclo vero e proprio, e si ripercorrono decine di volte. L’ultima, mettere il modello al lavoro per qualcuno che non sia chi l’ha costruito, è quella che quasi sempre si dimentica di pianificare, e la riprende per esteso il capitolo sull’MLOps, che si occupa appunto del mestiere di tenere in piedi modelli che qualcuno usa davvero.
Una ricetta nuova si prepara con le stesse mosse, nello stesso ordine. Prima decidi che piatto vuoi (la stazione 1), poi controlli che cosa hai in dispensa (2). Solo allora scegli il procedimento (3), e con esso due cose che si dimenticano sempre: che cosa vorrà dire «venuto bene» (salato al punto giusto? cotto al punto giusto?) e di quanto aggiusterai per volta, un pizzico o mezza manciata. Poi cucini (4). Poi (ed è il passaggio che distingue chi cucina bene) assaggi (5), e l’assaggio non lo fai sul cucchiaio che hai già leccato: usi una porzione che non hai ancora toccato, altrimenti ti convinci che sia buono solo perché lo hai fatto tu. Se manca sale, torni indietro e cambi una cosa sola, altrimenti al secondo assaggio non saprai se è merito del sale o del tempo di cottura.
In questo andirivieni c’è una trappola, e la conosce chiunque abbia cucinato a lungo la stessa cosa: a forza di assaggiare e correggere il palato si abitua, e dopo il quinto cucchiaio il sale che c’è non lo senti più. Gli assaggi si consumano man mano che li usi per decidere. Ecco perché conta il momento in cui il piatto va in tavola (6): chi lo mangia non ha cucinato, il suo giudizio è l’unico rimasto intatto, e lo hai una volta sola, perché se lo chiami in cucina a metà cottura e correggi su quello che ti ha detto hai consumato anche lui.
Formalizzato: si fissa uno spazio di ipotesi \(\mathcal{H} = \{f_\theta\}\) (l’architettura), una loss per esempio \(\ell\) e un algoritmo di ottimizzazione, e si stima \(\theta\) minimizzando il rischio empirico sugli \(m\) esempi di addestramento,
poi si misura il rischio su un campione indipendente, che stima senza distorsione l’errore di generalizzazione di \(f_{\hat{\theta}}\) solo finché non viene usato per scegliere. Le stazioni 3–5 sono un ciclo di ricerca su iperparametri e architettura, guidato dalla metrica di validazione, e ogni decisione presa guardando quel numero lo consuma un po’, perché il set di validazione diventa a poco a poco parte dell’addestramento. Per questo il test set si tocca una volta sola, alla fine: è l’unica stima onesta che rimane. Il capitolo sul machine learning tratta per esteso questa contabilità in overfitting e validazione.
Un problema di cui conosciamo già la risposta#
Il modo migliore per imparare un flusso di lavoro è percorrerlo su un problema truccato: uno di cui conosciamo la soluzione in anticipo, così da poter verificare a colpo d’occhio se il modello l’ha trovata. Costruiamo dei dati con una formula nota (una retta di pendenza \(0{,}7\) e intercetta \(0{,}3\)) e poi buttiamo via la formula, lasciando al modello solo i punti.
Quei due nomi meritano una sosta, perché dicono che cosa sia davvero un peso.
La pendenza di una retta è quanto la retta sale ogni volta che ci si sposta di
uno verso destra; l’intercetta è l’altezza a cui la retta taglia l’asse
verticale, il punto da cui parte. Nel vocabolario delle reti neurali quei due
numeri si chiamano peso \(w\) e bias \(b\): il modello di questo problema è
\(\hat{y} = wx + b\), e un nn.Linear(1, 1) ha esattamente questi due
parametri. Il peso dice quanto l’ingresso conta, il bias da dove si parte; una
rete vera ne ha milioni invece di due, ma il mestiere di ciascuno è questo.
import torch
from torch import nn

torch.manual_seed(42)          # stessi numeri casuali a ogni esecuzione

# I parametri "veri": il modello dovrà ritrovarli da solo, senza mai vederli.
peso_vero, bias_vero = 0.7, 0.3

X = torch.arange(0, 1, 0.02).unsqueeze(dim=1)   # 50 punti, shape (50, 1)
y = peso_vero * X + bias_vero                   # shape (50, 1)

taglio = int(0.8 * len(X))                      # 80% per addestrare, 20% per il test
X_train, y_train = X[:taglio], y[:taglio]       # (40, 1)
X_test,  y_test  = X[taglio:], y[taglio:]       # (10, 1)
Due dettagli tornano in ogni progetto.
unsqueeze(dim=1) trasforma la fila di cinquanta numeri in una tabella di
cinquanta righe e una colonna: gli strati di PyTorch vogliono una riga per
esempio, e su ogni riga le caratteristiche di quell’esempio (in inglese
feature, ed è la parola che si troverà nel codice: in_features,
out_features). Qui la caratteristica è una sola, ma la colonna ci vuole lo
stesso, ed è per questo che il conto delle dimensioni è il primo dei
tre errori più comuni. E manual_seed fissa il
generatore di numeri casuali: senza, due esecuzioni dello stesso codice danno
risultati diversi e non si può nemmeno ripetere un esperimento. Fissarlo,
però, non basta a dire che un miglioramento sia reale: per quello si ripete
l’esperimento con più semi, come spiega la sezione
dal notebook agli script.
Il modello è la retta più semplice che si possa scrivere: un nn.Linear con
un ingresso e un’uscita, cioè esattamente due numeri da imparare.
class RegressioneLineare(nn.Module):
    def __init__(self):
        super().__init__()
        self.strato = nn.Linear(in_features=1, out_features=1)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.strato(x)

modello = RegressioneLineare()
print(modello.state_dict())   # peso e bias, per ora casuali
# OrderedDict({'strato.weight': tensor([[0.7645]]), 'strato.bias': tensor([0.8300])})
Lo state_dict, che già conosciamo, qui contiene due soli numeri, ed è
interessante che siano già pieni: nessuno ha ancora addestrato niente, ma un
modello nasce sempre con dei numeri a caso dentro, sorteggiati da PyTorch nel
momento in cui lo si costruisce. È da lì che l’addestramento parte, e per
questo manual_seed conta: fissa anche quel sorteggio. (Il \(0{,}7645\) che esce
dal caso somiglia al \(0{,}7\) vero per pura coincidenza; il bias, \(0{,}83\)
contro \(0{,}3\), è bello lontano.)
Adesso il ciclo, che cambia in tre punti rispetto a quello del training loop. Primo: qui i quaranta punti entrano tutti insieme a ogni giro, non a mini-batch, perché sono quaranta e starebbero in un mini-batch solo; quindi qui «epoca» e «un giro di correzione» coincidono, mentre su MNIST un’epoca erano quasi mille giri. Secondo: l’ottimizzatore è SGD e non Adam, perché con due soli parametri il vantaggio di Adam (un passo diverso per ciascuno) non si vede, e SGD lascia vedere meglio quello che succede. Terzo: ogni tanto ci si ferma a misurare anche sui dati messi da parte.
criterio = nn.L1Loss()                                     # errore assoluto medio
# lr è il learning rate, il "passo" del training loop
ottimizzatore = torch.optim.SGD(modello.parameters(), lr=0.01)

for epoca in range(1000):
    modello.train()
    y_pred = modello(X_train)
    perdita = criterio(y_pred, y_train)
    ottimizzatore.zero_grad()
    perdita.backward()
    ottimizzatore.step()

    if epoca % 199 == 0:                                   # il "termometro"
        modello.eval()
        with torch.no_grad():
            perdita_test = criterio(modello(X_test), y_test)
        print(f"epoca {epoca:>4} | train {perdita.item():.4f} "
              f"| test {perdita_test.item():.4f}")

print(modello.state_dict())
epoca    0 | train 0.5552 | test 0.5740
epoca  199 | train 0.0103 | test 0.0003
epoca  398 | train 0.0013 | test 0.0138
epoca  597 | train 0.0103 | test 0.0003
epoca  796 | train 0.0013 | test 0.0138
epoca  995 | train 0.0103 | test 0.0003
OrderedDict({'strato.weight': tensor([[0.6968]]), 'strato.bias': tensor([0.3025])})
Alla fine dell’addestramento state_dict() stampa due numeri
molto vicini a \(0{,}7\) e \(0{,}3\): \(0{,}6968\) e \(0{,}3025\), cioè \(0{,}70\) e
\(0{,}30\) arrotondati al centesimo.
Non identici, perché la discesa del gradiente si ferma quando è abbastanza
vicina. È una verifica che nella maggior parte dei problemi veri non potremo
mai fare, e proprio per questo conviene farla almeno una volta: qui sappiamo
con certezza che la macchina funziona.
Nelle ultime epoche i valori si ripetono: \(0{,}0103\) e \(0{,}0013\) tornano a turno. Verso la fine la perdita non si ferma su un valore, alterna fra quei due, un giro sì e un giro no.
Perché lo faccia si dice in una riga. La misura dell’errore scelta nel codice,
nn.L1Loss, cioè l’errore assoluto medio, corregge sempre della stessa
quantità, che si sia lontanissimi o a un capello dal bersaglio: sbagliare di
\(10\) e sbagliare di \(0{,}001\) producono la stessa spinta. Non «frena»
avvicinandosi. E il passo è fisso, sempre \(0{,}01\). Quindi, arrivata a un
capello dal punto giusto, la correzione lo scavalca; il giro dopo lo scavalca
all’indietro; e da lì in poi i valori oscillano attorno a quello giusto per
sempre, ripetendosi a due a due (un ciclo di periodo 2), con un’ampiezza più o
meno pari al passo.
Ecco perché la riga che misura sui dati messi da parte (il «termometro» del codice) stampa ogni \(199\) epoche e non ogni \(200\). Stampando ogni \(200\), cioè un numero pari, si guarderebbe sempre la stessa fase del ciclo: dopo la prima riga si vedrebbero quattro righe con lo stesso identico numero, e il modello sembrerebbe fermo sull’ottimo mentre gli sta girando attorno. Col \(199\) le due fasi si vedono tutte e due, ed è la verità.
La L1Loss conta gli sbagli così come sono: è la distanza media tra quello
che il modello dice e quello che dovrebbe dire. Se stampa \(0{,}05\) e stiamo
predicendo dei prezzi in euro, il modello sbaglia in media di cinque centesimi,
un numero che si può raccontare a chiunque.
C’è un altro modo di sommarli, e la scelta fra i due cambia quello che il
modello impara. Il secondo moltiplica ogni sbaglio per sé stesso: sbagliare il
doppio conta quattro volte, sbagliare dieci volte tanto conta cento volte (è
l’errore al quadrato, quello di nn.MSELoss). Dieci case stimate: nove
sbagliate di mille euro e una di diecimila. Sommando gli euro, la casa storta
pesa diecimila contro novemila, poco più di tutte le altre insieme. Coi
quadrati pesa undici volte tutte le altre insieme.
Comanda chi grida più forte. Coi quadrati il modello passa la giornata a inseguire quell’unica casa, che magari è un prezzo battuto male nel listino, e peggiora sulle altre nove; sommando gli euro la ignora quasi. Il rovescio c’è ed è serio: se quella casa è vera (una villa in mezzo ai monolocali), la misura che la ignora ti lascia un modello che sulle ville sbaglierà sempre.
La misura al quadrato, in compenso, frena: la spinta a correggere si
ammorbidisce man mano che ci si avvicina al prezzo giusto, quindi il ballo fra
i due valori non ci sarebbe. La via di mezzo si chiama nn.SmoothL1Loss:
quadrati per gli sbagli piccoli, euro contati come sono per quelli grossi, così
frena vicino al bersaglio senza farsi trascinare dalla villa. Nel nostro
problema truccato la scelta cambia pochissimo: i punti stanno esattamente sulla
retta, non c’è nessuna villa da domare, e quel po’ di ballo è tutto l’errore
che rimane.
Dei due numeri stampati a ogni riga, quello da guardare è il secondo, misurato sui dieci punti messi da parte, che stanno tutti in fondo alla retta, oltre quelli usati per imparare: è l’unico preso su domande mai viste. Guardandolo sei volte durante la corsa stiamo prendendo la stessa scorciatoia del programma su MNIST: su un problema truccato come questo è innocua, perché non stiamo decidendo niente in base a quel numero, lo stiamo solo guardando scendere. In un progetto vero quel ruolo lo farebbe una terza porzione dei dati, la validazione, e il test resterebbe chiuso fino alla fine.
nn.L1Loss calcola l’errore assoluto medio
\(\mathcal{L} = \frac{1}{B}\sum_{i=1}^{B} |\hat{y}_i - y_i|\) sui \(B\) esempi del
batch (qui tutti e quaranta), mentre nn.MSELoss media i quadrati. La
differenza pratica sta nei gradienti e negli outlier: il
gradiente della L1 rispetto al residuo è \(\pm 1\), costante, quindi un punto
molto lontano non domina l’aggiornamento, la L1 è robusta; con il lr fissato,
però, il modello non converge esattamente ma oscilla in un intorno di ampiezza
\(\sim \eta\) attorno all’ottimo. Qui l’oscillazione è un ciclo limite di
periodo 2, e si misura: il residuo cambia segno tutto insieme, quindi il
gradiente sul bias vale \(\pm 1\) e il passo è esattamente \(\pm \eta\); sul peso
il gradiente è \(\pm \overline{|x_i|} = \pm 0{,}39\), e l’ampiezza scala di
conseguenza. È la ragione per cui il «termometro» stampa a passo dispari: a
passo pari si campionerebbe sempre la stessa fase. La MSE, il cui gradiente è
proporzionale al residuo, converge in modo più pulito ma insegue gli outlier. La
nn.SmoothL1Loss (o Huber) è il compromesso: quadratica vicino allo zero,
lineare lontano. Qui la scelta è quasi indifferente perché i dati sono
esattamente su una retta: la loss finale è limitata solo dalla granularità dei
passi.
Nella stampa la perdita di
addestramento è quella calcolata prima dello step(), e quella di test viene
dopo, quindi le due cifre appartengono a fasi opposte del ciclo; le due
perdite degli stessi pesi si leggono su due righe consecutive, e sono
\(0{,}0103\) e \(0{,}0138\) in una fase, \(0{,}0013\) e \(0{,}0003\) nell’altra. E i
dati sono divisi per posizione: il test (\(x \in [0{,}80;\, 0{,}98]\)) sta oltre
l’intervallo di addestramento (\([0;\, 0{,}78]\)), quindi misura anche
un’estrapolazione, dove l’errore sul peso conta di più perché si moltiplica per
\(x\). Per una retta è innocuo; in un progetto vero il campione di test si
estrae a caso, o per gruppo e per data, come spiega la sezione sui
dati su misura.
Loss e ultimo strato: una scelta che dipende dal problema#
«Quale loss uso?» è una domanda che ha una risposta quasi meccanica: la decide il tipo di problema, e insieme a lei decide anche la forma dell’ultimo strato. Le configurazioni di base sono quattro, e corrispondono a quattro domande che si possono fare a un modello: quanto?, sì o no?, quale fra tanti?, quali fra tanti? Ognuna ha la sua riga nella tabella. Le due lettere che vi compaiono stanno per «quanti numeri entrano nell’ultimo strato» (\(d\)) e «quante categorie ci sono» (\(K\)). Molti errori dei principianti nascono da una riga sbagliata qui.
Tipo di problema |
Ultimo strato |
Funzione di perdita |
Per leggere l’output |
|---|---|---|---|
Regressione (un numero) |
|
|
niente, è già il numero |
Classificazione binaria |
|
|
|
Classificazione a \(K\) classi |
|
|
|
Multi-etichetta (\(K\) sì/no) |
|
|
|
Su un banco di smistamento postale, della stessa busta si possono chiedere
quattro cose diverse. Quanto pesa? Un numero solo, letto com’è: è la
regressione, il caso dell’esempio con la retta. È pubblicità, sì o no? Ancora
un numero solo, che la sigmoid schiaccia fra zero e uno perché lo si legga
come probabilità. Quale, fra i dieci reparti? Un numero per reparto, e vince il
più alto. Quali bollini, fra i dieci: fragile, urgente, da firmare? Un numero
per bollino, ma stavolta ognuno è un sì o un no per conto suo. Fra i reparti se
ne sceglie uno, di bollini se ne accendono quanti se ne vuole: è il caso
multi-etichetta.
Il punteggio che lo smistatore scrive sulla busta può uscire meno tre come più
quaranta: nessuno gli ha chiesto una percentuale. Quei punteggi grezzi sono i
logit della sezione sui moduli, ed è la sillaba che si ritrova
nei nomi delle funzioni: BCEWithLogitsLoss, la perdita del sì o no, vuol
dire «con i logit». Li vuole grezzi, ed è lei a convertirli in probabilità, al
suo interno.
Tenerli grezzi serve anche a non perdere gli sbagli grossi. Un meno ottocento, messo in percentuale, diventa un numero così piccolo che la macchina finisce le cifre e scrive zero tondo. E da uno zero non si sa più né di quanto lo smistatore abbia sbagliato né da che parte correggerlo.
La probabilità serve eccome, ma dopo: sigmoid e softmax si applicano sul
risultato, quando il numero lo deve leggere una persona. Messe dentro il
modello, come ultimo strato, consegnerebbero alla funzione di perdita dei
punteggi già convertiti, che lei convertirebbe una seconda volta: è il guasto
già visto con la cross-entropy, e anche qui il modello impara male senza
nessun messaggio rosso, solo con numeri che non migliorano.
Resta una manopola, che serve appena si esce dagli esempi: le risposte quasi mai sono in pari. Su mille buste, novecentonovanta lettere vere e dieci pubblicità. Lo smistatore trova subito la furbizia: dire sempre «lettera vera», sbagliare dieci volte su mille e portare a casa un risultato che sulla carta sembra ottimo, mentre la pubblicità passa tutta. Alla funzione di perdita si può dire quanto pesa ciascuna risposta: se una pubblicità lasciata passare costa quanto novantanove lettere vere buttate, le due risposte tornano in pari e alla furbizia non conviene più.
BCEWithLogitsLoss e CrossEntropyLoss incorporano rispettivamente la
sigmoide e la log-softmax, e vanno alimentate con i logit. Il motivo è
numerico: il calcolo congiunto usa il log-sum-exp trick, che evita
l’underflow di \(\log(\hat{y})\) quando \(\hat{y} \to 0\). Per un logit \(z\) e
un’etichetta \(y \in \{0, 1\}\) la perdita della BCEWithLogitsLoss si scrive
che non trabocca per nessun \(z\): è lo stesso trucco, con due termini. Con
\(z = -800\) e \(y = 1\) la sigmoide vale zero in virgola mobile e
\(\log \sigma(z)\) vale \(-\infty\), mentre la forma stabile dà
\(0 + 800 + \log(1 + e^{-800}) \approx 800\), la perdita giusta. Le versioni
«nude» (nn.BCELoss, nn.NLLLoss) esistono per i casi in cui la
normalizzazione è già avvenuta, ma nel dubbio si usa sempre la variante con i
logit. Due note sulla
forma dei tensori: BCEWithLogitsLoss vuole target float32 della stessa
shape dei logit, tipicamente si applica squeeze(1) all’uscita
\((B,1) \to (B,)\) (con squeeze() senza argomento un batch da un solo esempio
perderebbe anche il suo asse); CrossEntropyLoss vuole logit \((B,K)\) e target
\((B,)\) di dtype int64, cioè gli indici di classe, e un one-hot di interi
solleva un errore (la forma \((B,K)\) passa solo in float, dove è letta come
distribuzione di probabilità sulle classi). Per classi molto sbilanciate,
entrambe accettano un peso per classe (weight, o pos_weight per la
binaria), che rialza il contributo della classe rara.
Il ciclo di miglioramento: una leva alla volta#
Il modello gira, e il numero che conta (quello sui dati messi da parte, non quello sui dati su cui ha studiato) non è buono abbastanza. È il momento in cui si consuma il grosso di un progetto, ed è anche quello in cui si prendono le decisioni peggiori: si cambiano cinque cose insieme, il risultato migliora, e non si sa quale delle cinque abbia funzionato, quindi non si sa nemmeno quale spingere ancora.
Un rubinetto che gocciola non si aggiusta smontando tutto il bagno: l’idraulico chiude l’acqua, cambia una guarnizione, riapre e guarda. Una chiave alla volta, partendo da quello che si rompe più spesso. Sul modello le chiavi sono sei.
Più dati, o dati migliori: la leva più potente, e la più noiosa. Mille esempi in più valgono di solito più di qualunque astuzia architetturale.
Addestrare più a lungo, con un occhio all’errore sulla validazione, la simulazione d’esame: se ricomincia a salire, il momento di fermarsi è passato.
Un modello più capiente, più strati e più unità. Ma solo dopo aver verificato che il piccolo non ce la faccia davvero: su dati sbagliati, uno grande impara a memoria le cose sbagliate.
Il passo, cioè il learning rate: è la chiave più delicata delle sei, e se l’addestramento è instabile o non scende è la prima da guardare. È la manopola della temperatura di una doccia: il punto giusto è uno solo e stretto, e spostarlo di un fattore dieci in su o in giù separa un modello che impara da uno che non parte. Si trova con una corsa breve in cui il passo cresce a ogni giro, come girare piano la manopola verso il caldo: il valore giusto non è quello in cui l’acqua comincia a scottare, cioè in cui l’errore si impenna, ma uno nettamente più basso, dove l’errore scendeva più in fretta.
I freni, che rendono la vita più difficile al modello mentre studia, apposta perché non si limiti a memorizzare (dropout e weight decay, spiegati nel capitolo sul deep learning). Si mettono solo se la distanza fra l’errore in addestramento e quello in validazione si allarga.
Cambiare strada: un’altra architettura, o un modello già addestrato da altri, il transfer learning del capitolo sulla visione.
L’idraulico scrive sul foglio dell’intervento che cosa ha toccato. E prima di ogni prova: fissa il seme casuale, annota che cosa hai cambiato, tieni il risultato. Un quaderno di laboratorio, letteralmente.
Una chiave alla volta vale finché a girarle sei tu. Quando le prove le lanci in blocco e vai a dormire, i valori conviene sorteggiarli a caso invece di disporli in una griglia ordinata. Con due manopole e nove prove la griglia prova tre valori per manopola in tutte le combinazioni: della temperatura ne avrai viste tre sole. Nove tiri a caso te ne fanno vedere nove, ed è tutta lì la differenza.
Un controllo però viene prima di tutti e sei, e costa cinque minuti: l’idraulico apre il rubinetto e guarda se l’acqua arriva, perché se non arriva la guarnizione non c’entra. Il rubinetto, per un modello, è un solo mazzetto di esempi, una decina: si addestra su quelli, con un passo normale e senza freni, finché l’errore non è quasi zero. Dieci esempi li manda a memoria qualunque rete con più pesi che esempi, e se la tua non ci riesce quasi sempre c’è un errore nel codice: stai girando le manopole sbagliate.
Formalmente si sta esplorando lo spazio degli iperparametri con un budget
limitato, e la sensibilità non è uniforme: il learning rate è di solito
l’iperparametro che conta di più [GBC16], e per ogni
problema contano pochi iperparametri, diversi da un problema all’altro
[BB12]. Da qui due pratiche standard. La prima è la ricerca
casuale invece della ricerca a griglia [BB12]: con \(n\)
prove su \(h\) iperparametri la griglia prova \(n^{1/h}\) valori per asse (nove
prove su due assi sono tre valori ciascuno), la casuale \(n\) valori distinti
per ogni asse, e quando la loss dipende davvero da pochi assi, com’è la
regola, quegli assi la casuale li esplora \(n^{1-1/h}\) volte più fitti. La
seconda è il learning rate range test [Smi17]: si fa
crescere \(\eta\) da un valore piccolo a uno grande in una corsa breve
(linearmente nell’articolo originale, esponenzialmente nelle implementazioni
più diffuse, come lr_find di fastai, da \(10^{-7}\) a \(10\) in cento
iterazioni) e si guarda come risponde l’addestramento. Smith annota il valore
in cui l’accuratezza comincia a salire e quello in cui rallenta, diventa
irregolare o scende, e li usa come estremi di un intervallo; le
implementazioni suggeriscono il punto in cui la loss scende più ripida, o un
decimo di quello in cui tocca il minimo. Il valore in cui la loss esplode non
si usa mai: è già fuori dall’intervallo buono.
C’è poi una diagnosi che viene prima di tutto il resto: sovradattare di proposito un solo batch di una decina di esempi. Se il modello non ci riesce con un learning rate ordinario e senza regolarizzazione, il problema è quasi sempre un bug e non una questione di iperparametri; il protocollo e i sospettati sono nella sezione sui tre errori più comuni. Il repertorio completo (regolarizzazione, scheduler, normalizzazione) è nel capitolo sul deep learning; l’infrastruttura per non perdere il conto degli esperimenti in dal notebook alla produzione.
Predire su dati nuovi: tre condizioni e due interruttori#
Il modello è addestrato. Arriva un dato mai visto e va passato alla rete: è un gesto semplice, e fallisce spesso. Il dato nuovo deve soddisfare tre condizioni (stesso dispositivo, stesso tipo, stessa forma dei dati di addestramento, a parte la dimensione del batch) e vanno azionati due interruttori.
modello.eval()                                  # interruttore 1: modalità esame
with torch.no_grad():                           # interruttore 2: niente gradienti
    x_nuovo = torch.tensor([[0.95]],            # forma: (1, 1), non (1,)
                           dtype=torch.float32) # tipo: come in addestramento
    x_nuovo = x_nuovo.to(next(modello.parameters()).device)  # stesso dispositivo
    stima = modello(x_nuovo)
print(stima.item())        # ~ 0.7 * 0.95 + 0.3 = 0.965
La riga con next(modello.parameters()).device sembra più complicata di quello
che è. Un modello, come i suoi dati, sta fisicamente da qualche parte: nella
memoria del processore o in quella della scheda grafica. E i due possono
lavorare insieme solo se stanno nello stesso posto. Quella riga legge il
dispositivo del primo parametro del modello (gli chiede, cioè, dove abita) e
ci manda il dato nuovo. Il vantaggio è che così la risposta viene dal modello
stesso invece che da una variabile scritta altrove nel programma, che prima o
poi qualcuno cambierà senza ricordarsi di aggiornare anche questa riga.
Che cosa succede quando una delle tre condizioni salta, e come si legge il messaggio d’errore che ne esce, lo spiega la sezione sui tre errori più comuni.
Il mestiere sta in queste sei stazioni e nel ciclo che le lega. Il primo pezzo da esplorare nel dettaglio, e quello che nella pratica dà più lavoro di tutti, sono i dati.
Da ricordare
Il flusso di lavoro ha sei stazioni: che cosa voglio predire, con quali dati, quale modello, addestrarlo, assaggiarlo, usarlo. Le tre centrali si ripetono in circolo, ed è lì che va tutto il tempo.
Costruirsi un problema con la risposta nota (punti generati da una retta che si conosce) è il modo più rapido per verificare che la propria macchina funzioni davvero: alla fine i due numeri devono tornare.
La domanda che si fa al modello decide l’ultimo strato e la misura dell’errore: quanto? sì o no? quale fra tanti? quali fra tanti? Sbagliare questa riga è uno degli errori più frequenti di chi comincia.
Nel migliorare un modello si cambia una cosa alla volta: più dati, più tempo, un modello più grande, la manopola del passo, i freni, e alla fine si cambia strada. Il passo è la manopola più delicata, e si cerca con una corsa breve, tenendosi ben sotto il valore in cui l’errore si impenna.
Prima di girare qualunque manopola, il collaudo che costa cinque minuti: il modello deve riuscire a mandare a memoria dieci esempi. Se non ci riesce, con un passo normale e senza freni, l’errore è quasi sempre nel codice e non in una manopola.
Per dare al modello un dato nuovo servono tre condizioni (stesso posto, stesso tipo di numeri, stessa forma) e due interruttori (modalità esame, niente appunti).
Da ricordare
Il flusso di lavoro ha sei stazioni: problema, dati, modello, addestramento, valutazione, uso. Le tre centrali si ripetono in ciclo, ed è lì che va il tempo.
Costruirsi un problema con la risposta nota (dati generati da una formula) è il modo più rapido per verificare che la propria macchina funzioni davvero.
Loss e ultimo strato si scelgono dal tipo di problema:
MSELoss/L1Lossper la regressione,BCEWithLogitsLossper il sì/no,CrossEntropyLossper le \(K\) classi; le ultime due vogliono i logit.Nel ciclo di miglioramento si cambia una leva alla volta: dati, durata, capacità, learning rate, regolarizzazione, architettura. Il learning rate è di solito la più sensibile, e il range test ne dà l’intervallo, non il valore in cui la loss esplode.
Prima di ottimizzare qualunque cosa: verifica che il modello riesca a mandare a memoria dieci esempi. Se non ci riesce, con un learning rate ordinario e senza regolarizzazione, è quasi sempre un bug, non un iperparametro.
Per predire su dati nuovi servono tre condizioni (device, dtype, shape) e due interruttori (
eval(),no_grad()).