


Riconoscere i suoni: classificazione e tagging#
Chiudi gli occhi in una stanza e prova a nominare quello che senti: il ronzio del frigorifero, un’auto che passa, il tuo stesso respiro. Il cervello lo fa di continuo, in sottofondo, senza fatica, ed è un lavoro sorprendentemente difficile da imitare. In Dal suono alle feature abbiamo imparato a trasformare un suono in immagine: lo spettrogramma, la «parola visibile» di Potter. Fatto quel passaggio, la domanda «che suono è questo?» diventa in gran parte un problema di visione. Un abbaiare, un vetro che si rompe, una corda di chitarra pizzicata: ognuno lascia sullo spettrogramma una firma diversa (bande, righe verticali, macchie), e riconoscere motivi di quel genere è ciò che una rete addestrata sulle immagini sa fare bene. In gran parte, e non del tutto, perché sullo spettrogramma i due assi non si equivalgono, ed è il primo punto in cui il suono si separa dalla foto.
Non è un esercizio di scuola. Sistemi di questo tipo ascoltano le foreste per sentire il rumore di una motosega dove non dovrebbe esserci, riconoscono il canto di un uccello dal telefono di un escursionista, avvisano quando in casa si rompe un vetro. È l’audio oltre la voce: non più «cosa hai detto», ma «cosa sta suonando».
Dallo spettrogramma alla classe#
Il punto di partenza è quello costruito nella prima sezione, Dal suono alle feature: l’onda diventa una tabella con il tempo su un asse e le frequenze sull’altro, riletta come la sente un orecchio (lo spettrogramma mel). Da lì in avanti il suono diventa un’immagine. E riconoscere un’immagine è il mestiere delle reti convoluzionali, in sigla CNN: la stessa macchina che nel capitolo di visione riconosceva un gatto in una foto.
Lo spettrogramma è una radiografia del suono: una lastra dove ogni rumore lascia una sagoma riconoscibile. Un fischio è una riga sottile e netta che sale; una vocale è fatta di bande orizzontali parallele; un vetro che si rompe è uno schizzo verticale improvviso, pieno di frequenze alte tutte insieme. Il medico impara a leggere le lastre a forza di vederne; una rete neurale fa lo stesso, mostrandole migliaia di spettrogrammi già etichettati finché non impara a collegare la sagoma al nome del suono. La cosa sorprendente è che non serve inventare un metodo nuovo: è lo stesso tipo di rete che riconosce i gatti nelle foto, perché ormai il suono, per lei, è una foto.
Una cosa però il medico la sa, e la rete no: sulla lastra spostarsi a destra e spostarsi in alto non sono la stessa cosa. La stessa macchia più a destra è lo stesso latrato mezzo secondo dopo; più in alto è un suono più acuto, cioè un’altra vocale, un’altra nota, un altro strumento. La rete invece cerca le sagome dappertutto allo stesso modo, in basso come in alto, come se una sagoma spostata in alto fosse ancora lo stesso suono. È qui che la lastra sonora smette di essere una foto: in una foto un gatto più in alto è ancora un gatto, sulla lastra un fischio più in alto è un altro fischio. La rete se la cava lo stesso, perché le sagome che contano sono piccole, ma quell’ipotesi, presa alla lettera, è falsa. Correggerla costa poco: le si scrive accanto a ogni riga della lastra a che altezza si trova, e la rete impara da sola a tenerne conto.
E c’è un regalo in più, che viene proprio da quella somiglianza con le foto. Una rete che ha già passato mesi a guardare fotografie ha imparato a riconoscere bordi, macchie, righe, motivi che si ripetono: roba che sulla lastra sonora c’è eccome. Allora non si riparte da zero: le si fanno vedere spettrogrammi finché non si riabitua, e in poco tempo diventa brava anche lì.
Lo spettrogramma mel è una matrice \(\mathbf{S} \in \mathbb{R}^{F \times T}\): \(F\) bande di frequenza (tipicamente 64 o 128) per \(T\) finestre temporali. La trattiamo come un’immagine a un solo canale (l’analogo di una foto in scala di grigi) e la forniamo in ingresso a una CNN 2D, con i filtri convoluzionali che scorrono contemporaneamente sull’asse del tempo e su quello della frequenza. È esattamente la pipeline convoluzione + non linearità + pooling della classificazione di immagini, con un’unica differenza concettuale: qui i due assi non sono omogenei (uno è il tempo, l’altro la frequenza). La conseguenza però non riguarda la località, che non è mai stata in discussione (una firma sonora è un motivo locale nel piano tempo–frequenza esattamente come un occhio lo è in una foto): riguarda la condivisione dei pesi. Applicare gli stessi filtri a ogni banda rende ogni strato convoluzionale equivariante per traslazione (un motivo spostato produce la stessa risposta, spostata), e il pooling, soprattutto quello globale finale, trasforma l’equivarianza in invarianza: la rete completa assume che traslare un motivo non ne cambi la classe. Lungo il tempo è una simmetria vera, un latrato è un latrato mezzo secondo dopo; lungo la frequenza no, perché su una scala quasi logaritmica traslare verso l’alto equivale a trasporre, e la trasposizione cambia la vocale, la nota, lo strumento. Funziona lo stesso perché i motivi utili restano locali, ma è un bias solo approssimato, e va tenuto a mente quando si legge una CNN su spettrogrammi come se fosse una CNN su fotografie. I rimedi restituiscono alla rete la posizione in frequenza: un canale in più all’ingresso che contiene la coordinata della banda (la tecnica che in visione si chiama CoordConv), o filtri che cambiano con la banda, come la frequency dynamic convolution [NKKP22]. Anche il transfer learning si trasporta di peso: si parte spesso da una rete pre-addestrata su ImageNet e si rifinisce sugli spettrogrammi, replicando il canale grigio sui tre canali RGB attesi in ingresso.
La forma della risposta, poi, decide la funzione di perdita. Chiedersi «che strumento sta suonando?» presuppone che la risposta sia una: pianoforte oppure chitarra oppure violino, classi che si escludono a vicenda. Ma una clip di dieci secondi di strada cittadina contiene, tutte insieme, il traffico e una voce e un clacson e il vento, e nell’audio ambientale la presenza di più suoni insieme è la regola. Sono due problemi diversi, la classificazione a etichetta singola e il tagging multi-etichetta, e l’immagine li conosce entrambi; nel suono il secondo è il caso comune.
«Di questi tre strumenti, quale senti?» è una domanda a crocetta unica: la risposta è una sola, e le probabilità dei candidati si fanno concorrenza, se sale una scende un’altra. Poi c’è la lista della spesa: «segna tutti i suoni presenti in questa registrazione», e qui possono essere veri contemporaneamente il traffico, una voce e un cane, senza togliersi spazio a vicenda. La crocetta si chiama classificazione a etichetta singola, la lista della spesa tagging multi-etichetta. E si può chiedere ancora di più: non solo quali suoni, ma quando ciascuno inizia e finisce, come sottotitolare i rumori di un film. Questo si chiama rilevamento degli eventi sonori.
E qui c’è un nodo. Chi ha preparato gli esempi di solito ha segnato soltanto che cosa c’è in ogni registrazione, non quando: «c’è un cane», e basta. La macchina dà una risposta per ogni istante, e per confrontarla con l’etichetta la deve riassumere in una risposta sola, per tutta la registrazione. Come la riassume decide se impara a mettere i sottotitoli al posto giusto. Chi guarda soltanto l’istante più convinto impara a riconoscere quello, e lascia senza sottotitolo il resto dell’abbaiare; chi fa la media di tutti gli istanti si convince che il cane abbai dappertutto. Funziona meglio una via di mezzo, che pesa di più gli istanti di cui la macchina è già abbastanza convinta.
Nella classificazione a etichetta singola le classi sono mutuamente esclusive: si usa una softmax sulle \(C\) classi (le stesse \(C\) classi dell’apertura del capitolo) e la cross-entropia, come in visione. La softmax normalizza a somma 1, imponendo la competizione tra le alternative.
Nel tagging multi-etichetta ogni classe è invece una domanda sì/no indipendente. Si sostituisce la softmax con una sigmoide su ciascuna delle \(C\) uscite e si addestra con la binary cross-entropy sommata sulle classi:
dove \(z_c\) è il logit della classe \(c\), \(\hat{y}_c \in (0,1)\) la probabilità indipendente che quel suono sia presente e \(y_c \in \{0,1\}\) l’etichetta vera. Nessun vincolo di somma: più classi possono essere «accese» insieme. Il rilevamento degli eventi sonori (sound event detection, il cuore delle sfide DCASE, la gara annuale sul rilevamento e la classificazione di scene ed eventi acustici) si spinge oltre, chiedendo una predizione per ogni istante (un tagging frame per frame con i confini temporali di ogni evento). Si valuta confrontando gli intervalli predetti con quelli veri, in due modi [MHV16]: per segmenti, dividendo il tempo in tratti di un secondo e contando in ciascuno le classi indovinate, mancate e in più; o per eventi, dove un evento predetto conta come giusto se il suo inizio cade entro una tolleranza da quello vero (il collar, da 100 a 250 millisecondi nelle edizioni di DCASE). Da quei conteggi si ricavano l’F1 e il tasso d’errore, e il PSDS [BFT+20] li riassume su tutte le soglie di decisione in un numero solo. Il nodo è che le etichette sono quasi sempre della clip e non del frame, cioè deboli: è apprendimento a istanze multiple, dove la clip è un sacco di frame e l’etichetta dice soltanto se nel sacco c’è almeno un evento. Il modello produce allora probabilità per frame \(\hat{y}_{c,t}\), una funzione di pooling le riduce a una probabilità di clip \(y_c\), e su quella si calcola la BCE.
Wang e colleghi ne confrontano cinque [WLM19]: il massimo, \(y_c = \max_t \hat{y}_{c,t}\); la media, \(y_c = \frac{1}{T}\sum_t \hat{y}_{c,t}\); la linear softmax, \(y_c = \sum_t \hat{y}_{c,t}^2 / \sum_t \hat{y}_{c,t}\); la exponential softmax, \(y_c = \sum_t \hat{y}_{c,t}\,e^{\hat{y}_{c,t}} / \sum_t e^{\hat{y}_{c,t}}\); e l’attenzione, \(y_c = \sum_t w_{c,t}\,\hat{y}_{c,t} / \sum_t w_{c,t}\), con pesi \(w_{c,t}\) appresi. Il massimo è fedele alla definizione ma passa il gradiente a un frame solo, e lascia spenti gli altri frame dell’evento; la media lo spalma su tutti, e sulle clip positive accende anche i frame dove l’evento non c’è. La linear softmax sta in mezzo, e la derivata dice come:
positiva soltanto per i frame sopra metà della probabilità di clip. Su una clip positiva, dove la perdita spinge \(y_c\) verso 1, quei frame vengono alzati e gli altri abbassati: le probabilità di frame si polarizzano, che è ciò che serve a localizzare. L’attenzione, che impara quali frame pesare, sulle clip negative finisce invece per pesare proprio i frame a probabilità bassa, e lascia accesi gli altri, che diventano falsi positivi. Sulla Task 4 di DCASE 2017 (17 classi di veicoli e segnali d’allarme) la linear softmax risulta la migliore delle cinque, e localizza almeno quanto il massimo (tasso d’errore dell’84 % contro l’85 %), mentre media, softmax esponenziale e attenzione superano il 100 %. Da quella scelta dipende se i confini temporali che escono dal modello valgono qualcosa, visto che nessuno glieli ha mai mostrati.
I dati: AudioSet#
Per i suoni del mondo il riferimento è AudioSet, pubblicato da Google nel 2017 [GEF+17]: oltre due milioni di clip da dieci secondi, contro le 2000 di ESC-50 [Pic15] e le 8732 di UrbanSound8K [SJB14], due raccolte di suoni ambientali messe insieme a mano negli anni precedenti. Sono due ordini di grandezza in più, pagati con etichette meno precise.
Due milioni di frammenti non si possono etichettare secondo per secondo. Ciascuno porta un’etichetta che dice quali suoni contiene, scelti da un catalogo di centinaia di categorie, dal miagolio al motore diesel al rumore della pioggia; ma è un’etichetta «alla buona», che dice che in quei dieci secondi c’è un cane e non in quale secondo abbaia. Poche certezze precise, ma tantissimi esempi: è un baratto che, con le reti profonde, conviene quasi sempre.
Il catalogo però non si riempie in modo uniforme. La musica e il parlato compaiono ovunque; il verso di un uccello raro sta in un centinaio di frammenti su due milioni. E il modello lo si giudica categoria per categoria, facendo poi la media dei voti, quindi quelle caselle quasi vuote pesano quanto la musica. Un modello bravissimo sulla musica e sordo alle centinaia di categorie rare prende un voto mediocre, anche se ha ragione su quasi tutti i frammenti: la media per categoria è fatta apposta per non lasciarsi abbagliare dalle caselle affollate, e costringe a imparare anche quelle con pochi esempi.
L’articolo che presenta AudioSet [GEF+17] descrive un’ontologia di 632 categorie sonore organizzate a gerarchia e una prima raccolta di \(1\,789\,621\) segmenti da 10 secondi. La raccolta pubblicata è poi cresciuta oltre l’articolo, e la versione che si scarica oggi conta \(2\,084\,320\) clip su 527 categorie: sono queste ultime a formare il benchmark di classificazione standard su cui si confrontano i modelli, e quando si citano quei due numeri la fonte è la pagina del dataset, non l’articolo. Le etichette sono deboli (weak labels): indicano la presenza di un suono nella clip, senza localizzazione temporale, ed essendo multi-etichetta si prestano naturalmente alla coppia sigmoide + BCE. La metrica di riferimento non è l’accuratezza (inadatta a un problema multi-etichetta e sbilanciato) ma la mean Average Precision (mAP), che per ogni classe fa la media delle precisioni raggiunte a ciascuna soglia, pesandole con l’aumento di richiamo che quella soglia porta, e poi media sulle classi. Si massimizza. Un dataset grande e debolmente etichettato sposta il collo di bottiglia: non più «troppi pochi dati», ma «etichette rumorose e code lunghe di classi rare», un regime in cui la capienza del modello e il pre-addestramento contano più della precisione di ogni singola annotazione. C’è poi una complicazione pratica: AudioSet distribuisce gli identificatori dei video di YouTube e gli intervalli da ritagliare, non l’audio. Ogni gruppo scarica i video da sé, e quelli rimossi nel frattempo fanno sì che l’insieme davvero disponibile cambi da un gruppo all’altro: due mAP di articoli diversi si confrontano alla pari solo se i clip coincidono.
Quando l’attenzione arriva all’audio: l’AST#
Fino al 2021 gli spettrogrammi si classificavano con reti convoluzionali, al più con uno strato di attenzione sopra l’ultimo strato convoluzionale: i filtri che scorrono sull’immagine cercando lo stesso motivo dappertutto erano il pezzo attorno a cui il resto era costruito. L’Audio Spectrogram Transformer (AST) [GCG21] li elimina del tutto: lo spettrogramma è diviso in tessere quadrate (patch), e le tessere, messe in fila, passano a un Transformer (Fig. 23.4).
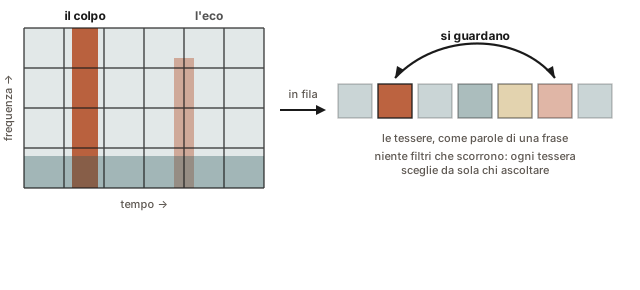
Fig. 23.4 Lo spettrogramma tagliato in tessere, e le tessere messe in fila: il colpo e la sua eco, lontani nel tempo, si guardano direttamente.#
Torna il trucco con cui il Transformer ha imparato a guardare le foto. Si taglia l’immagine in tante tessere quadrate, le si mette in fila come le parole di una frase, e poi ogni tessera guarda tutte le altre e decide quali le interessano. Quel «guardare le altre e scegliere» si chiama attenzione, e lo abbiamo incontrato con il Vision Transformer.
L’AST fa la stessa identica cosa sulla radiografia del suono: taglia lo spettrogramma in tessere, le mette in fila e lascia che ciascuna guardi le altre, collegando per esempio un colpo secco all’inizio con la sua eco un istante dopo, anche se sulla lastra sono lontani. Niente filtri che scorrono: solo tessere che si guardano tra loro. E guardarsi tutte costa: dieci secondi di suono sono milleduecento tessere, e le coppie da confrontare, a ogni passaggio, quasi un milione e mezzo.
Non è gratis, però. I filtri che scorrono portavano con sé un’idea già pronta (quello che conta sta vicino a quello che gli sta accanto), e a un modello che riceve un’idea in regalo bastano meno esempi per imparare. Le tessere quell’idea non ce l’hanno e se la devono costruire dai dati, quindi di esempi ne chiedono molti di più: addestrato da zero su poca roba, un Transformer audio resta dietro a una rete convoluzionale. La scappatoia è quella di prima: partire da una rete che ha già guardato milioni di fotografie e riadattarla agli spettrogrammi.
L’AST applica un Transformer in stile ViT direttamente allo spettrogramma log-mel, senza alcuna convoluzione, e si presenta come il primo modello di classificazione audio puramente attentivo. Lo spettrogramma viene suddiviso in patch \(16 \times 16\) (parzialmente sovrapposte), ciascuna proiettata linearmente in un embedding e trattata come un token, con un positional embedding per la posizione tempo–frequenza; da lì in poi è il consueto stack di self-attention del capitolo sui Transformer. Il vantaggio è il campo recettivo globale fin dal primo strato: ogni patch può pesare qualunque altra, mentre una CNN allarga la propria vista solo strato dopo strato. Il prezzo si conta: con \(128\) bande e \(1024\) frame (dieci secondi a passo di \(10\) ms, con un breve riempimento), patch \(16 \times 16\) e passo \(10\) nei due assi, cioè sovrapposte di \(6\), le tessere sono \(12 \times 101 = 1212\), e la self-attention ne confronta ogni coppia, circa un milione e mezzo per testa e per strato, contro le \(576\) tessere di un ViT su immagini \(384 \times 384\). «Senza convoluzioni» vale per il corpo della rete: nel codice degli autori la proiezione delle tessere sovrapposte è scritta come una convoluzione \(16 \times 16\) con passo \(10\), che è la stessa operazione. Sul benchmark AudioSet completo l’AST raggiunge una mAP di \(0{,}459\) con un singolo modello (\(0{,}485\) nell’ensemble più grande), contro lo \(0{,}444\) del miglior ibrido CNN più attenzione dell’epoca (PSLA) a parità di protocollo e lo \(0{,}439\) delle reti convoluzionali pre-addestrate PANNs [KCI+20]. Sono i numeri del 2021: la graduatoria è stata superata in seguito, anche dalla strada auto-supervisionata della sezione Imparare dal suono senza etichette.
Come già visto nel capitolo sui Transformer, rinunciare alla convoluzione significa rinunciare al suo bias induttivo di località, e quel bias andava «gratis». Senza, servono molti più dati, oppure, come fa l’AST, il transfer dei pesi di un ViT pre-addestrato su ImageNet, adattando gli embedding di patch e di posizione dallo spazio delle immagini a quello degli spettrogrammi. Un Transformer audio addestrato da zero su pochi dati resta dietro a una CNN: l’attenzione paga quando i dati (o il pre-addestramento) abbondano.
Un classificatore a soglie, scritto a mano#
I classificatori visti fin qui si addestrano su milioni di clip, con schede grafiche (le GPU) che fanno migliaia di conti in parallelo. L’idea di fondo, estrarre delle feature e poi decidere, si vede però anche in forma minima: due misure per finestra e due soglie scelte a mano, su un segnale costruito apposta. Non c’è apprendimento, e le soglie valgono per quel segnale. Non si calcola nemmeno uno spettrogramma, per quello c’è la pipeline di Dal suono alle feature: si parte dalla forma d’onda grezza e se ne ricavano due caratteristiche elementari, finestra per finestra.
Il suono non si guarda mai tutto insieme. Lo si taglia a fettine di qualche centesimo di secondo e si misura dentro ciascuna: una fettina si chiama finestra, e le misure si rifanno da capo per ognuna.
Le misure sono due, semplicissime. La prima è l’energia: quanto è «forte» il
suono in quella finestra (grande quando l’onda oscilla ampia, quasi zero nel
silenzio). La seconda è quanto spesso l’onda attraversa lo zero, cioè passa dal
positivo al negativo: si chiama zero-crossing rate, in sigla zcr. Non è un
conteggio ma una frazione, e per questo esce sempre fra 0 e 1: vale \(0{,}5\) se
metà delle coppie di campioni vicini
cambia segno, quasi \(0\) se non cambia quasi mai. Un tono basso e pieno
oscilla lentamente e attraversa lo zero poche volte; un sibilo, fatto di
frequenze alte, lo attraversa tantissime volte: è la differenza tra una «ooo»
profonda e una «sss» sibilante.
Con queste due sole misure distinguiamo già tre situazioni, purché le si guardi in un ordine preciso. Prima l’energia: se è quasi zero c’è silenzio, e non serve chiedere altro. Se invece c’è del suono, allora si guarda quante volte l’onda attraversa lo zero: pochi attraversamenti vuol dire tono, tantissimi rumore. Quest’ultima regola però vale finché il tono è grave e il rumore è un fruscio pieno di frequenze alte. Un fischio molto acuto attraversa lo zero tantissime volte anche lui, e un brontolio cupo, che pure è un rumore, quasi mai: gli attraversamenti dicono dove stanno le frequenze del suono, non se è un tono o un rumore.
Su una finestra di \(L\) campioni \(x[0], \dots, x[L-1]\) definiamo l’energia a breve termine come potenza media e lo zero-crossing rate come frazione di cambi di segno tra campioni adiacenti:
dove \(\mathrm{sgn}(\cdot)\) è il segno del campione. L’energia distingue il sonoro dal silenzio; lo ZCR è un indicatore grezzo del contenuto in frequenza. Per una sinusoide di frequenza \(f\) campionata a \(f_s\) i cambi di segno sono due per periodo, quindi \(\mathrm{ZCR} \approx 2f/f_s\), e per un rumore bianco gaussiano, dove ogni coppia di campioni cambia segno con probabilità \(1/2\), \(\mathrm{ZCR} \approx 1/2\). Lo ZCR misura dove sta lo spettro, non se il segnale è tonale o rumoroso: un tono vicino alla frequenza di Nyquist ha ZCR vicino a \(1\), un rumore con poca energia sopra qualche centinaio di hertz lo ha vicino a \(0\). Separare toni e rumori in generale chiede un’altra misura, che guardi la forma dello spettro invece della sua posizione, come la spectral flatness (il rapporto fra la media geometrica e la media aritmetica dello spettro di potenza, vicina a \(1\) per un rumore bianco e a \(0\) per un tono). Energia e ZCR sono, storicamente, tra le prime feature usate per separare parti sonore e non sonore del parlato: un antenato rudimentale delle feature spettrali di Dal suono alle feature.
Generiamo un segnale finto in tre parti e classifichiamo ogni finestra con la regola a soglie, per vedere come le due misure, prese in quest’ordine, separino le tre situazioni. Il tono è una sinusoide a 200 oscillazioni al secondo; il «silenzio» è un fruscio piccolissimo; il rumore è una fila di valori estratti a caso, il rumore bianco, che contiene un po” di tutte le frequenze. Il generatore di numeri casuali parte da un valore fissato, così chi esegue il codice ottiene esattamente gli stessi numeri:
import numpy as np

rng = np.random.default_rng(0)   # punto di partenza fissato: numeri sempre uguali
fs = 8000                        # frequenza di campionamento (Hz)
dur = 0.15                       # durata di ogni segmento (secondi)
n = int(fs * dur)                # campioni per segmento
t = np.arange(n) / fs

# Tre segmenti: un tono puro, del silenzio, del rumore
tono     = 1.0 * np.sin(2 * np.pi * 200 * t)        # sinusoide a 200 Hz
silenzio = 0.001 * rng.standard_normal(n)           # quasi-zero (fondo)
rumore   = 0.30 * rng.standard_normal(n)            # rumore bianco
segnale  = np.concatenate([tono, silenzio, rumore])

def energia(x):
    "Energia a breve termine: potenza media della finestra."
    return float(np.mean(x**2))

def zcr(x):
    "Zero-crossing rate: frazione di cambi di segno tra campioni adiacenti."
    return float(np.mean(np.abs(np.diff(np.sign(x)))) / 2)

L = 400  # finestra: 400 campioni che qui, a 8 kHz, fanno 50 ms
         # (nella prima sezione 400 campioni erano 25 ms perche' li' si
         #  misurava 16.000 volte al secondo invece di 8.000)
SOGLIA_E, SOGLIA_Z = 0.01, 0.20   # soglie di decisione

def classifica(e, z):
    if e < SOGLIA_E:              # poca energia: nessun suono
        return "silenzio"
    if z > SOGLIA_Z:              # tanti cambi di segno: rumore/sibilo
        return "rumore"
    return "tono"                 # energia alta, pochi cambi: tono/voce

print(f"{'finestra':>8} | {'energia':>9} | {'zcr':>6} | classe")
print("-" * 42)
for i in range(0, len(segnale) - L + 1, L):
    finestra = segnale[i:i+L]
    e, z = energia(finestra), zcr(finestra)
    print(f"{i//L:>8} | {e:>9.4f} | {z:>6.3f} | {classifica(e, z)}")
finestra |   energia |    zcr | classe
------------------------------------------
       0 |    0.5000 |  0.049 | tono
       1 |    0.5000 |  0.048 | tono
       2 |    0.5000 |  0.048 | tono
       3 |    0.0000 |  0.516 | silenzio
       4 |    0.0000 |  0.514 | silenzio
       5 |    0.0000 |  0.486 | silenzio
       6 |    0.0920 |  0.471 | rumore
       7 |    0.1001 |  0.516 | rumore
       8 |    0.0909 |  0.509 | rumore
Il tono ha energia \(0{,}5\), e quel numero si può controllare. L’onda oscilla fra \(-1\) e \(1\), e per una sinusoide osservata per un numero intero di giri (qui dieci, in ogni finestra) la media dei quadrati è esattamente la metà del quadrato del picco: qui \(0{,}5\). Vale per la sinusoide, non per ogni oscillazione regolare: un’onda quadra che salta fra \(-1\) e \(1\) ha media dei quadrati \(1\), perché sta sempre sul picco. (È lo stesso conto per cui si dice che la corrente di casa è a 230 volt: 230 è la radice della media dei quadrati, il valore efficace, di una sinusoide che arriva a 325 volt di picco, e \(325/\sqrt{2} \approx 230\).)
Il suo zcr, invece, è bassissimo: \(0{,}049\). Ecco il conto. Il tono del codice fa 200 oscillazioni al secondo e noi misuriamo 8.000 volte al secondo, quindi ogni oscillazione la campioniamo 40 volte (\(8000\) diviso \(200\)). Ma ogni oscillazione attraversa lo zero due volte, una salendo e una scendendo: quindi un attraversamento ogni 20 campioni, e \(1\) diviso \(20\) fa \(0{,}05\), cioè quello che troviamo nella tabella a meno degli arrotondamenti ai bordi. Più il suono è acuto, più fitti sono quei passaggi: è tutto il legame fra questa misura e le frequenze.
Il silenzio ha energia praticamente nulla, e sullo zcr c’è una cosa da guardare: vale circa \(0{,}5\), cioè quanto quello del rumore. È come l’abbiamo costruito: il nostro «silenzio» è rumore anche lui, solo trecento volte più piccolo. In un fondo così ogni minuscolo sbalzo casuale attraversa lo zero, esattamente come fanno gli sbalzi grossi del rumore vero. Contare gli attraversamenti, da solo, non li distingue affatto.
E allora perché la regola funziona? Perché le due domande si fanno in un ordine preciso: prima l’energia, che manda il silenzio fuori gioco, e solo dopo lo zcr, che a quel punto deve separare soltanto il tono dal rumore, e lì la differenza è enorme (\(0{,}05\) contro \(0{,}5\), dieci volte). Una regola a soglie è una scaletta e non un elenco di condizioni, e cambiare l’ordine la rompe.
La regola funziona su questo segnale, però, perché lo si è costruito così: il tono è grave, e il rumore è bianco, cioè ha frequenze da tutte le parti fino a 4.000 oscillazioni al secondo, metà degli 8.000 campioni. Basta cambiare quelle due cose per romperla. Un tono acuto, a 3.900 oscillazioni al secondo, vicino al limite che a 8.000 misure al secondo si può rappresentare; e un rumore cupo, il rumore browniano, che si ottiene sommando passo dopo passo i valori di un rumore bianco e che per questo sale e scende lentamente, come un brontolio. Al rumore cupo diamo la stessa energia del rumore bianco di prima, e passiamo tutti e due per la stessa regola:
# continua dal blocco precedente: stesse funzioni, stesse soglie
acuto = np.sin(2 * np.pi * 3900 * t[:L])           # tono a 3.900 Hz
cupo = np.cumsum(rng.standard_normal(L))           # rumore browniano
cupo = 0.3 * (cupo - cupo.mean()) / cupo.std()     # energia 0,09, come prima

print(f"{'segnale':>11} | {'energia':>9} | {'zcr':>6} | classe")
print("-" * 45)
for nome, x in [("tono acuto", acuto), ("rumore cupo", cupo)]:
    e, z = energia(x), zcr(x)
    print(f"{nome:>11} | {e:>9.4f} | {z:>6.3f} | {classifica(e, z)}")
    segnale |   energia |    zcr | classe
---------------------------------------------
 tono acuto |    0.5000 |  0.976 | rumore
rumore cupo |    0.0900 |  0.018 | tono
La regola sbaglia tutte e due le volte. Il tono acuto cambia segno quasi a ogni campione, e il conto di prima lo prevede: due attraversamenti per giro, 3.900 giri al secondo, 8.000 campioni, quindi \(2 \times 3900 / 8000 \approx 0{,}975\). Il rumore cupo, che ha la stessa energia del rumore bianco, attraversa lo zero di rado, ben sotto la soglia di \(0{,}20\), e la regola lo chiama tono. Lo zcr dice dove stanno le frequenze di un suono, alte o basse; se il suono sia un tono o un rumore è un’altra domanda, e queste due misure non bastano per capirlo.
Due numeri per finestra e due soglie, nessuna rete, e la logica è già quella dei modelli grandi: estrarre feature che separano le classi, poi decidere. La differenza è che una rete convoluzionale o un AST le feature migliori se le imparano da soli, invece di riceverle scritte a mano.
Da ricordare
Una volta che il suono è diventato una radiografia (lo spettrogramma), riconoscerlo è in gran parte un problema di immagini: la stessa rete che distingue un gatto da un cane in una foto distingue un vetro rotto da un clacson in una lastra sonora, e può perfino partire da quello che ha già imparato sulle foto. Con un’avvertenza: sulla lastra spostare una sagoma a destra è lo stesso suono più tardi, spostarla in alto è un suono diverso, e la rete quella differenza non la conosce, a meno che qualcuno non le scriva accanto l’altezza di ogni riga.
Ci sono due domande diverse, e non vanno confuse. «Quale di questi suoni è?» è a crocetta unica, e le risposte si fanno concorrenza. «Quali suoni ci sono qui dentro?» è una lista della spesa, e possono essere veri tutti insieme. Una terza, più difficile, chiede anche quando ciascuno comincia e finisce.
AudioSet [GEF+17] cambia le regole con la scala: due milioni di frammenti da dieci secondi, etichette «alla buona» (dicono che il cane c’è, non in quale secondo abbaia). Tanti esempi imprecisi battono pochi esempi perfetti, quando la rete è grande.
Le tessere funzionano anche sul suono: si taglia la lastra in quadretti, li si mette in fila e si lascia che ciascuno guardi tutti gli altri, anche quelli lontani. Costa molti più dati che i filtri che scorrono, e per questo di solito si parte da una rete già addestrata sulle immagini.
Due misure semplicissime (quanto è forte il suono, e quante volte l’onda attraversa lo zero) bastano a separare a mano silenzio, tono grave e fruscio, ma soltanto su un segnale costruito apposta: un fischio acuto o un brontolio cupo le ingannano, perché gli attraversamenti dicono dove stanno le frequenze, non se il suono è un tono o un rumore. È la stessa idea dei modelli grandi, che però le misure se le scelgono da soli.
Da ricordare
Trasformato il suono in spettrogramma mel, riconoscerlo diventa in gran parte un problema di visione: una CNN 2D lo tratta come un’immagine a un canale, e il transfer learning da ImageNet si trasporta di peso. Attenzione però al bias: sull’asse delle frequenze la condivisione dei pesi assume un’invarianza per traslazione che i dati non hanno.
Etichetta singola (una sola classe, softmax + cross-entropia) e tagging multi-etichetta (più suoni insieme, sigmoide + BCE) sono problemi diversi; il rilevamento di eventi sonori aggiunge il quando, da etichette deboli di clip, e il pooling che riduce i frame alla clip decide se la localizzazione regge (la linear softmax meglio della media e dell’attenzione).
AudioSet [GEF+17] cambia le regole con la scala: il paper definisce l’ontologia (632 categorie), la raccolta pubblicata arriva a oltre 2 milioni di clip da 10 s su 527 classi di benchmark, con etichette deboli. Contano scala e pre-addestramento più della precisione della singola annotazione (metrica: mAP).
L’Audio Spectrogram Transformer [GCG21] applica un Transformer in stile ViT alle patch dello spettrogramma, senza convoluzioni; in cambio del campo recettivo globale, chiede molti dati o il transfer da ImageNet.
Su un segnale sintetico, energia e zero-crossing rate bastano a separare a mano silenzio, tono grave e rumore bianco; fuori da quelle ipotesi la regola cede, perché \(\mathrm{ZCR} \approx 2f/f_s\) misura la posizione dello spettro e non la sua forma (un tono a 3,9 kHz finisce fra i rumori, un rumore browniano fra i toni). L’idea è quella dei modelli grandi, feature che separano le classi e poi una decisione; la differenza è che le feature le imparano.
Le reti che si costruiscono da sole le feature, però, le imparano da qualcuno che ha etichettato gli esempi: per AudioSet ci sono voluti due milioni di clip ascoltate da persone, e per la maggior parte delle lingue e dei suoni una raccolta etichettata di quella taglia non esiste. Come si impari dal suono senza etichette lo racconta Imparare dal suono senza etichette.