


Overfitting, bias-varianza e validazione#
C’è un modo infallibile per andare male a un esame: imparare a memoria le soluzioni dei compiti degli anni scorsi. Chi lo fa risponde alla perfezione alle domande già viste e va nel panico davanti a un esercizio anche solo leggermente diverso. Ha memorizzato, non capito. Un modello di machine learning può cadere esattamente nella stessa trappola, e distinguere la memoria dalla comprensione è, in fondo, il problema centrale di tutta la disciplina.
La posta in gioco, fin dalle sezioni precedenti, è rispondere bene su input mai visti: si dice generalizzare. Un modello che azzecca ogni risposta sui dati di addestramento e sbaglia su quelli veri non ha imparato nulla di utile. Resta da vedere come accorgersene e come porvi rimedio.
Imparare o memorizzare: overfitting e underfitting#
Ci sono due modi opposti di sbagliare, e si capiscono meglio l’uno accanto all’altro (Fig. 4.8).

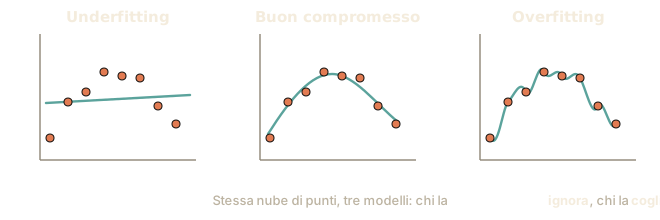
Fig. 4.8 Lo stesso insieme di punti, tre modelli. Il modello troppo semplice non coglie l’andamento; quello troppo flessibile lo ricalca fin dentro il rumore. In mezzo, il buon compromesso.#
Un modello troppo semplice, una retta a cui si chiede di descrivere dati chiaramente curvi, sbaglia già sugli esempi su cui ha studiato. E su un esempio nuovo sbaglia più o meno quanto sui vecchi: il suo limite è la forma che ha, e resta quello anche dandogliene altri mille. Si chiama underfitting, ed è un modello troppo rigido per il problema.
All’estremo opposto c’è il modello troppo flessibile, che si contorce per passare esattamente su ogni singolo punto, rumore compreso. Sul foglio degli esempi già visti prende dieci e lode, ma ha imparato anche gli errori di misura, gli accidenti, il caso, e su un dato nuovo crolla. Si chiama overfitting: ha memorizzato invece di capire.
Accorgersene è un confronto fra due numeri: quanto il modello sbaglia sugli esempi con cui ha studiato, e quanto sbaglia su esempi che non ha mai visto. Sbaglia parecchio in tutti e due i casi, e più o meno allo stesso modo? È underfitting. Quasi niente sugli esempi di studio e parecchio sugli altri? È overfitting, e la distanza fra i due numeri ne dà la misura: quando quella distanza si allarga, il modello sta memorizzando.
Sia \(\mathcal{D}\) l’insieme di addestramento e \(\hat\theta\) i parametri che se ne ricavano. L’errore di generalizzazione del modello \(f_{\hat\theta}\) è il suo rischio,
con \((\mathbf{x},y)\) estratto dalla stessa distribuzione dei dati e indipendente da \(\mathcal{D}\). La sua media sugli insiemi di addestramento possibili, \(\mathbb{E}_{\mathcal{D}}\,R(f_{\hat\theta})\), è l’errore di generalizzazione atteso (in ESL, \(\mathrm{Err}_T\) ed \(\mathrm{Err}\)). L’errore di training, \(\text{err}_{\text{train}} = \mathcal{L}(\hat\theta)\) calcolato sugli stessi \(m\) esempi da cui \(\hat\theta\) è stato ricavato, ne è una stima ottimistica: per una minimizzazione esatta \(\mathbb{E}\,\mathcal{L}(\hat\theta)\le\min_\theta R(f_\theta)\le\mathbb{E}\,R(f_{\hat\theta})\), perché \(\hat\theta\) è scelto proprio per rendere piccolo \(\mathcal{L}\). L’errore di test, \(\text{err}_{\text{test}}\), è la stessa media su esempi indipendenti da \(\mathcal{D}\): stima \(R(f_{\hat\theta})\) senza distorsione, purché non sia servito a scegliere né \(\hat\theta\) né gli iperparametri. Confrontare i due errori rivela il regime in cui ci troviamo:
Underfitting: errore di training alto e vicino a quello di test. Il modello è troppo poco espressivo: non riesce a catturare la struttura dei dati (bias alto).
Overfitting: errore di training molto basso ma errore di test alto. Il modello ha capacità in eccesso e adatta \(f_\theta\) anche alle fluttuazioni casuali del campione (varianza alta).
Il divario tra i due errori, \(\text{err}_{\text{test}} - \text{err}_{\text{train}}\), è la spia dell’overfitting: quando si allarga, il modello sta memorizzando.
Il compromesso bias-varianza#
Underfitting e overfitting sono le due facce di un’unica tensione, che ha un nome classico: il compromesso bias-varianza (bias-variance tradeoff).
Il bias e la varianza si definiscono ripetendo l’esperimento: a ogni ripetizione si estrae un nuovo campione di addestramento, si riaddestra il modello e si guarda la sua previsione in uno stesso punto, e le previsioni formano una nube. Il bias è la distanza fra il centro della nube e il valore vero; la varianza è quanto la nube è larga. Sono due difetti distinti: un modello può essere spostato e compatto, oppure centrato e sparso (Fig. 4.9, con un foro per ogni addestramento e il valore vero al centro del bersaglio).

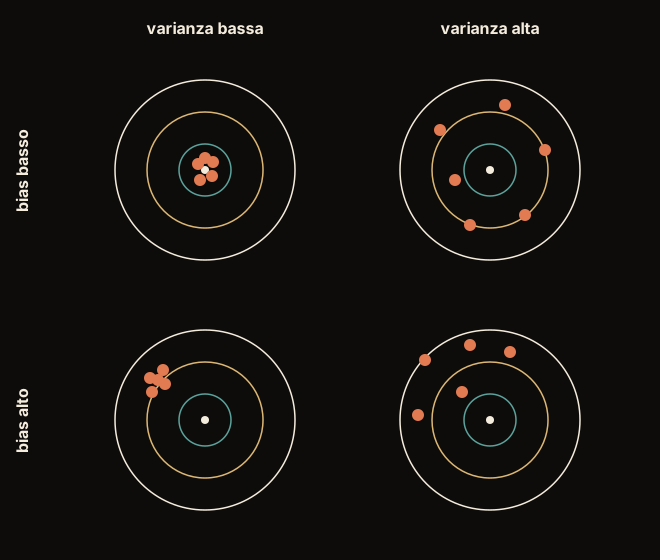
Fig. 4.9 I quattro casi sul bersaglio, con un foro per ogni addestramento. Il bias è di quanto si è spostato il gruppo dei colpi; la varianza è quanto il gruppo è largo. Sono due difetti diversi e si correggono in modi opposti.#
Il bersaglio in basso a sinistra di Fig. 4.9, colpi raccolti ma tutti fuori centro, è il più insidioso: un modello del genere è molto coerente, dà quasi sempre la stessa risposta, e la coerenza si scambia facilmente per affidabilità. Raccogliere altri dati serve a stringere il gruppo dei fori, non a spostarlo: qui il guaio è dove il gruppo è centrato, e altri dati non lo aggiustano.
Al poligono di tiro ci sono due tiratori.
Il primo ha il mirino storto sempre nello stesso modo. I suoi colpi finiscono tutti raccolti, e tutti a dieci centimetri dal centro. È il modello rigido, la retta: campione dopo campione dà quasi la stessa risposta, e quasi sempre la stessa risposta storta, perché la forma giusta non è una retta. L’errore che si ripete uguale è il bias (si pronuncia bàias, e in inglese vuol dire proprio «inclinazione», la tendenza a pendere sempre dalla stessa parte).
Il secondo ha il mirino a posto ma la mano che trema. In media è centrato, preso colpo per colpo va un po’ dappertutto. È il modello flessibile, la curva contorta: a ogni campione nuovo cambia parecchio, perché insegue il rumore di turno. Quell’irrequietezza è la varianza.
Poi c’è il vento, che non dipende da nessuno dei due. Anche con il mirino a posto e la mano ferma i colpi non cadono tutti nello stesso punto, perché l’aria si muove. Nei dati il vento è la misura imprecisa, l’eccezione, tutto ciò che capita e basta: quella parte di errore resta lì comunque, e nessun modello, per quanto bravo, se la prende.
Il conto va fatto come si è fatto sul prezzo delle case: si misura di quanto il colpo si allontana dal centro, si eleva al quadrato, e si fa la media su tutti i colpi. Solo allora i tre pezzi si sommano davvero, e quella media si spacca in tre addendi puliti: quello del mirino, quello della mano, quello del vento. Sulle distanze nude la somma non torna. Il quadrato di una somma si apre nei quadrati dei tre scarti più i loro doppi prodotti. In media su molti colpi, questi prodotti misti fanno zero. Quelli con la mano si annullano perché il tremore si misura a partire dal punto medio dei colpi, e gli scostamenti da una media si compensano per costruzione. Quelli con il vento si annullano perché il vento non sa niente né del mirino né della mano. Resta la somma dei tre quadrati. È la stessa aritmetica che rende il quadrato scomodo da leggere a renderlo scomponibile.
Letto così, il quadro è semplice. Un modello rigido ha molto bias e poca varianza; uno flessibile, poco bias e molta varianza. Il bravo modellista cerca il punto di mezzo.
Il conto vale finché a giudicare è la distanza dal centro. Se quel che conta è soltanto finire dentro il cerchietto o fuori, il tiratore raccolto e storto non fa un centro in tutta la giornata, mentre quello che trema ogni tanto dentro ci finisce. Dove la domanda è secca, sano o malato, un po’ di tremore può perfino convenire, e i tre addendi smettono di sommarsi.
Per un target \(y = f(x) + \varepsilon\), con rumore a media nulla (\(\mathbb{E}[\varepsilon]=0\)), varianza \(\sigma^2\) e indipendente dal campione di addestramento, l’errore quadratico atteso di una previsione \(\hat{f}(x)\), a \(x\) fissato, mediato sui possibili insiemi di addestramento e sul rumore del punto di test, si decompone in tre termini (sono proprio quelle ipotesi a far sparire i doppi prodotti):
Il bias misura quanto la previsione media si scosta dalla verità \(f(x)\); la varianza quanto \(\hat{f}(x)\) oscilla al variare del campione; \(\sigma^2\) è il rumore intrinseco, che nessun modello può eliminare. Aumentando la complessità il bias cala ma la varianza cresce: l’errore di test ha la classica forma a U, e il minimo è il modello ottimale.
Un’avvertenza sull’ambito di validità, perché il vocabolario viaggia più lontano del teorema. La decomposizione è un’identità della loss quadratica. Per la loss 0-1 dei classificatori non esiste una scomposizione additiva con termini non negativi: Domingos [Dom00] ne propone una in cui, per due classi, la varianza entra con segno più dove la previsione più frequente fra i possibili addestramenti coincide con quella ottima, e con segno meno dove non coincide, e in generale una scomposizione additiva analoga non esiste [WMW+23]. Ne segue che più varianza può perfino ridurre l’errore quando il bias sta dalla parte sbagliata della soglia. «Bias» e «varianza» restano quindi utili come vocabolario, anche parlando di alberi e di foreste, ma non come aritmetica.
Al crescere della complessità del modello il bias cala e la varianza cresce. L’errore sui dati di addestramento scende in genere sempre; l’errore sui dati nuovi, somma di bias al quadrato, varianza e rumore, ha di solito un minimo a una complessità intermedia: da sinistra (una retta) scende, perché il modello è troppo rigido per seguire i dati, e a destra (una curva che si contorce) risale, perché il modello segue anche il rumore del campione. Il minimo di questa curva a U è il modello da scegliere. La doppia discesa mostra in quali casi la curva non finisce lì.
Distinguerli in pratica: le curve di apprendimento#
Bias e varianza, finora, sono una spiegazione. C’è un modo di misurarli, e risponde alla domanda che costa di più in un progetto vero: conviene raccogliere altri dati, o cambiare modello?
Si disegnano di nuovo delle curve, ma stavolta sono due e l’asse orizzontale cambia: non più la complessità del modello, come nella U di poco fa, bensì la quantità di dati usata, da pochi esempi a tutti quelli che abbiamo. Le due curve sono l’errore sugli esempi con cui il modello ha studiato (l’addestramento) e l’errore su esempi tenuti da parte per giudicarlo (la validazione: come si mettono da parte, e perché sia essenziale farlo, arriva fra poco). Guardandole scendere si capisce quale dei due mali si ha davanti.
Le due curve si avvicinano e si fermano in alto: il modello sbaglia tanto sui dati che ha visto quanto su quelli che non ha visto, ed è già al suo limite. È bias. Altri dati non servono a niente: serve un modello capace di piegarsi a forme più complicate.
Fra le due resta un divario largo, e quella di validazione sta ancora scendendo: il modello ha imparato bene ciò che ha visto e generalizza meno. È varianza, e qui altri dati aiutano davvero.
Bastano poche righe di scikit-learn, e il verdetto è netto.
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import learning_curve

rng = np.random.default_rng(0)
m = 3000
X = rng.normal(size=(m, 6))
y = np.sin(2 * X[:, 0]) + X[:, 1] ** 2 - X[:, 2] + rng.normal(0, 0.3, m)  # non lineare

# i due estremi del campo di gioco, senza i quali "alto" e "basso" non dicono
# niente: l'errore di chi risponde sempre la media, e il pavimento del rumore
print(f"rispondere sempre la media: {y.var():.3f}")
print(f"pavimento del rumore:       {0.3 ** 2:.3f}")

taglie = np.linspace(0.05, 1.0, 8)
for nome, modello in [("lineare (troppo semplice)", LinearRegression()),
                      ("foresta (abbastanza ricca)",
                       RandomForestRegressor(n_estimators=120, random_state=0))]:
    # shuffle=True mescola le righe prima di ritagliare i sottoinsiemi: senza,
    # il seme non farebbe nulla (learning_curve lo usa solo se si mescola)
    usati, tr, va = learning_curve(modello, X, y, train_sizes=taglie, cv=5,
                                   scoring="neg_mean_squared_error",
                                   shuffle=True, random_state=0)
    tr, va = -tr.mean(1), -va.mean(1)
    print(f"\n{nome}")
    print(f"  con {usati[0]:>4} esempi: train {tr[0]:.3f}  validazione {va[0]:.3f}"
          f"  divario {va[0]-tr[0]:+.3f}")
    print(f"  con {usati[-1]:>4} esempi: train {tr[-1]:.3f}  validazione {va[-1]:.3f}"
          f"  divario {va[-1]-tr[-1]:+.3f}")
rispondere sempre la media: 3.471
pavimento del rumore:       0.090

lineare (troppo semplice)
  con  120 esempi: train 2.294  validazione 2.524  divario +0.230
  con 2400 esempi: train 2.321  validazione 2.335  divario +0.013

foresta (abbastanza ricca)
  con  120 esempi: train 0.142  validazione 0.844  divario +0.702
  con 2400 esempi: train 0.031  validazione 0.215  divario +0.184
Una parola su che cosa sono questi numeri. Qui gli \(y\) sono numeri puri e non
euro né gradi: li fabbrica la riga y = .... E l’errore si misura
come per la retta di best fit, cioè scarto fra vero e previsto, elevato al
quadrato e mediato. Un errore di \(2{,}3\) vuol dire che, in media, il quadrato
dello scarto vale \(2{,}3\): da solo non dice niente, e infatti le prime due
righe del programma servono a costruire il metro.
Il primo estremo del metro è quanto sbaglia chi non ci prova nemmeno, cioè chi risponde sempre la media di tutti gli \(y\): su questi dati \(3{,}471\). (È la varianza di \(y\), e attenzione, non c’entra con la varianza del modello di poco fa: qui è semplicemente quanto i valori di \(y\) sono sparpagliati attorno alla loro media.) Il secondo estremo è quanto sbaglia chi sa tutto. Non è zero: la riga che fabbrica \(y\) ci aggiunge un disturbo casuale di ampiezza \(0{,}3\), che nessun modello può indovinare perché non dipende da niente, e siccome l’errore si misura al quadrato quel disturbo costa \(0{,}3^2 = 0{,}09\). Fra \(3{,}471\) e \(0{,}09\) si gioca tutta la partita: la strada da percorrere è lunga \(3{,}471 - 0{,}09 = 3{,}38\).
Il modello lineare, passando da 120 a 2400 esempi, chiude il divario da \(+0{,}230\) a \(+0{,}013\): le due curve si sono toccate. Ma si sono toccate a \(2{,}335\), che è ancora quasi in cima: dai \(3{,}471\) di partenza sono scesi appena \(1{,}14\) su \(3{,}38\), cioè un terzo della strada. (Metà strada sarebbe stata \(0{,}09 + 3{,}38/2 = 1{,}78\), parecchio più in basso.) L’errore di addestramento, per giunta, non è migliorato di un’unghia (\(2{,}294\) con 120 esempi, \(2{,}321\) con 2400: la differenza è più piccola di quanto il sorteggio dei blocchi sposti da solo). Quello che non fa è scendere, ed è il segno che stiamo cercando: con pochi esempi una retta riesce a passare un po’ più vicino a tutti, con tanti non ce la fa più, perché la forma giusta non è una retta e i punti in più non fanno che ricordarglielo. Quel modello ha dato tutto quello che aveva, e altri diecimila esempi non farebbero scendere l’errore: lo porterebbero, se mai, verso quello della migliore retta possibile, che questo campione, uno dei più facili, sottostima. Se serve di meglio, serve un modello diverso.
La foresta (una foresta casuale, un modello fatto di tanti alberi di decisione che votano: la incontreremo negli alberi decisionali e metodi ensemble, e qui basta sapere che è molto più flessibile di una retta) arriva a \(0{,}031\) sull’addestramento e \(0{,}215\) in validazione, con un divario di \(+0{,}184\) ancora aperto: ha imparato benissimo ciò che ha visto e generalizza un po’ meno. Ma il suo \(0{,}215\), sul metro di prima, è a un passo dal traguardo: della strada da \(3{,}471\) a \(0{,}09\) ne ha percorso il \(96\%\). Diagnosi opposta e ricetta opposta: qui i dati in più pagano.
Il valore di questa diagnostica è che si fa prima di spendere. Raccogliere o etichettare dati è la voce più cara di quasi ogni progetto, e queste due curve dicono in un pomeriggio se quella spesa avrà un effetto.
Due curve diverse con lo stesso nome
Attenzione a non confonderle con le curve che si guardano durante l’addestramento di una rete, dove sull’asse orizzontale ci sono le epoche (un’epoca è una passata completa su tutti gli esempi: si addestra facendone molte di seguito): quelle diagnosticano l’andamento di quella sessione (passi della discesa del gradiente troppo lunghi o troppo corti, overfitting che comincia, quando fermarsi) e sono trattate nel training loop. Qui l’asse orizzontale è la quantità di dati, e la domanda è diversa: non «come sta andando questo addestramento» ma «questo modello, con più dati, andrebbe meglio».
Train, validation e test: perché il test non si tocca#
Per accorgersi dell’overfitting bisogna misurare l’errore su dati che il modello non ha usato per imparare. Per questo gli esempi si dividono in tre parti, ciascuna con un compito distinto:
Training set: i dati su cui il modello impara i parametri \(\theta\). È la parte più grande.
Validation set: i dati tenuti da parte per giudicare, quelli della seconda curva nelle curve di apprendimento, su cui si scelgono gli iperparametri, cioè le grandezze che l’addestramento non ottimizza, come la complessità del modello o l’intensità della regolarizzazione che segue.
Test set: i dati che si usano una sola volta, alla fine, per stimare le prestazioni su dati nuovi.
Le proporzioni tipiche sono \(60/20/20\) o \(80/10/10\), e dipendono dalla quantità di dati e dal rumore.
Il training set è lo studio, il validation set sono le prove in vista dell’esame, il test set è il compito d’esame vero. Se lo sbirci mentre studi e correggi le tue scelte in base a quello, il voto finale non dice più nulla: hai imparato a memoria quell’ esame. Per questo il test si tiene chiuso in un cassetto e si apre soltanto alla fine. Ogni volta che usi il test per decidere qualcosa, lo «consumi», e il numero che ti restituisce diventa troppo ottimista.
E si sbircia anche senza barare. Basta aprire la busta per vedere di che cosa parla, e le settimane di studio si organizzano da sole attorno a quel poco che si è intravisto, anche se su quelle pagine non ci si esercita mai. Per questo la busta si mette da parte come primo gesto, prima ancora di dare un’occhiata ai dati: dopo, è tardi.
Le prove in vista dell’esame sono un’altra faccenda, e si possono rifare quante volte si vuole. È il loro mestiere: assorbono tutte le decisioni prese per strada, su che cosa insistere e per quanto, così che all’esame si arrivi puliti.
Resta da comporre la busta, e il sorteggio da solo non basta. Con moltissime domande in gioco il caso si compensa; con poche, o quando un argomento del programma compare una volta sola, capita di tirare fuori un esame che su quell’argomento non chiede niente. Il voto esce alto e misura un’altra cosa. Si compone allora a proporzioni, da ogni argomento tante domande quanto quello pesa nel programma, e nella busta finisce un po’ di tutto.
Usare il test per selezionare modelli è una forma sottile di data leakage: la stima dell’errore di generalizzazione diventa ottimista. Il validation set assorbe le decisioni intermedie e la selezione avviene su training e validation; il test stima senza distorsione il rischio del modello scelto solo se non ha contribuito a sceglierlo. Con \(m_{\text{te}}\) esempi di test indipendenti dal modello, l’errore di test è la media di \(m_{\text{te}}\) perdite indipendenti e ha deviazione standard \(\sigma_\ell/\sqrt{m_{\text{te}}}\), con \(\sigma_\ell^2\) la varianza della perdita; per la perdita 0-1 e un errore vero \(p\) vale \(\sqrt{p(1-p)/m_{\text{te}}}\), cioè \(0{,}0095\) per \(p=0{,}1\) e \(m_{\text{te}}=1000\): è il margine da scrivere accanto al numero. Se invece si confrontano \(K\) modelli sul test e si tiene il migliore, il punteggio del vincitore è il massimo di \(K\) stime rumorose: per la disuguaglianza dell’unione, con probabilità almeno \(1-\delta\) nessuna si discosta dal vero più di \(\sqrt{\log(2K/\delta)/(2m_{\text{te}})}\), che cresce come \(\sqrt{\log K}\) (lo mostra la sezione sulla concentrazione). Riusare il test poche volte costa poco; riusarlo a ogni tentativo lo trasforma in un secondo validation set, e la stima finale torna ottimista.
import numpy as np

m_te, p = 1000, 0.10      # esempi di test ed errore vero del modello
print(f"errore standard dell'errore di test: {np.sqrt(p * (1 - p) / m_te):.4f}")
errore standard dell'errore di test: 0.0095
Due precisazioni operative che fanno la differenza fra una stima onesta e una
che sembra tale. La prima riguarda come si divide: il taglio puramente
casuale è affidabile solo se il dataset è grande, e su dataset piccoli o con
categorie rare produce insiemi che non si somigliano. Il rimedio è il
campionamento stratificato, che preserva in ciascuna parte le proporzioni
della variabile che conta (la classe da predire, o una covariata importante):
è il stratify= di train_test_split e la StratifiedKFold della sezione
seguente. Nel caso estremo, un test set che non contiene un solo esempio della
classe rara non misura la cosa che interessa.
La seconda è che il test si sporca anche soltanto guardandolo. È il data snooping bias: se si ispeziona il test per decidere quali feature costruire, quale trasformazione applicare o quale famiglia di modelli provare, quelle decisioni sono state prese sui dati d’esame, e il numero finale è ottimista anche se il modello non li ha mai visti in addestramento. La disciplina corretta è mettere da parte il test come primo gesto, prima ancora dell’analisi esplorativa.
Esiste una fuga d’informazione che non passa dal modello ma dai preparativi.

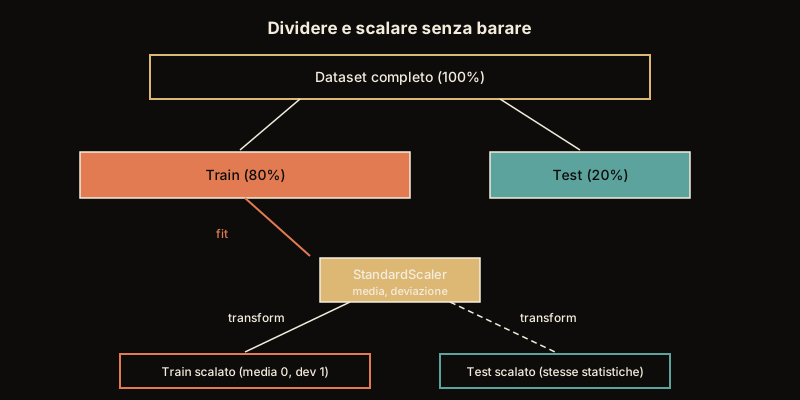
Fig. 4.10 La freccia barrata è l’errore che non si vede. Se il calcolo che riscala i numeri guarda anche il test per farsi la sua media, un pezzo di informazione del test è già entrato nell’addestramento.#
Quasi mai i dati arrivano al modello così come sono: si riportano le colonne su una scala comune (lo scaler calcola, per ogni colonna, media e deviazione standard), si riempiono i valori mancanti con un valore plausibile, come la media della colonna o una stima fatta da un modello a partire dalle altre colonne (è l’imputazione, di cui la sezione su pandas e matplotlib discute, parlando dei valori mancanti, i meccanismi e i rischi), si scartano le colonne inutili. Nella tabella delle case i metri quadri stanno attorno a \(100\) e le stanze attorno a \(3\): senza una scala comune, chi misura distanze fra esempi o penalizza i pesi è dominato dalla colonna con i numeri più grandi.
Tutte queste operazioni imparano qualcosa dai dati, e se lo imparano anche dal test, il test non è più indipendente. È il data leakage (una «fuga» di informazione dal test verso l’addestramento): non produce errori né avvisi, ma un punteggio troppo favorevole, di poco con uno scaler e moltissimo con la selezione delle colonne, di cui la cross-validation mostra un caso estremo. La regola è che qualunque trasformazione che impari dai dati si calcola sul solo training e poi si applica al resto, mai prima della divisione.
La cross-validation#
Mettere da parte un validation set fisso ha un difetto: con pochi dati, la stima dipende troppo da quali esempi sono finiti nel validation. La k-fold cross-validation aggira il problema facendo ruotare il blocco di validazione, così che ogni esempio faccia da giudice una volta sola.
Il test set resta fuori da questo procedimento: a essere diviso in blocchi è solo l’insieme di addestramento, e a ruotare è il blocco di validazione.

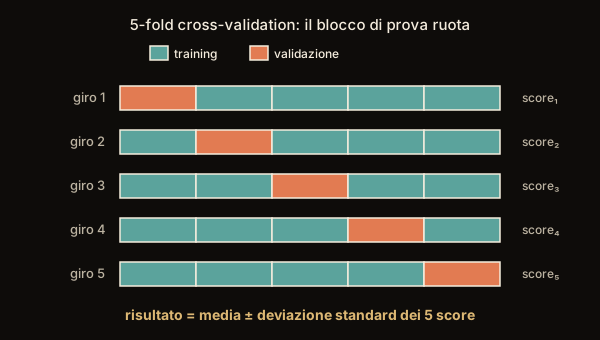
Fig. 4.11 Il blocco di validazione ruota. Alla fine ogni esempio ha fatto da giudice esattamente una volta, e il risultato non è un numero ma un numero con la sua variabilità.#
Dividi i dati di addestramento in \(k\) blocchi uguali (di solito \(k=5\) o \(10\)). A turno, ogni blocco fa da giudice mentre gli altri \(k-1\) addestrano il modello. Ottieni così \(k\) misure di errore, ognuna su un pezzo diverso di dati, e ne fai la media. È come fare cinque compiti in classe su cinque parti diverse del programma invece di giocarsi tutto su una sola interrogazione: il giudizio finale è più affidabile e meno soggetto al caso.
Si può spingere all’estremo: un blocco per ogni singolo esempio, cioè tanti compiti quanti sono i dati. Sembra il giudizio più solido di tutti, e non lo è. Quello che il modello ha studiato prima di un compito e prima del successivo cambia di un esempio soltanto, quindi i giudizi si somigliano tutti, e la media di tanti giudizi che si somigliano è poco più stabile di uno solo. In più il modello va riaddestrato una volta per esempio, e con centomila esempi il conto non sta in piedi. Cinque o dieci blocchi sono il punto in cui la spesa vale il guadagno.
Tutto questo regge su una condizione che salta più spesso di quanto sembri: le domande dei cinque compiti devono essere davvero diverse fra loro. Se nel mucchio ci sono dieci varianti quasi identiche dello stesso esercizio, il sorteggio ne manda qualcuna nel compito e qualcuna nelle pagine da studiare: lo studente ritrova nel compito quello che ha appena letto, e prende dieci senza sapere niente. Con le risposte giuste tirate a monetina, dove non c’è proprio nulla da imparare e chiunque ne azzecca la metà, un giudizio costruito così arriva a dire che il modello non sbaglia mai. Il numero che ne esce non vuol dire niente, e a guardarlo non si vede la differenza.
Succede tutte le volte che più righe raccontano lo stesso soggetto: dieci visite dello stesso paziente, dieci fotogrammi dello stesso video. Il rimedio è tenere insieme la famiglia, tutte le righe di un soggetto nello stesso blocco, così che quando un soggetto fa da giudice non sieda anche fra i banchi.
Partizionato il training in \(k\) fold \(D_1,\dots,D_k\), per ogni \(i\) si addestra su \(D\setminus D_i\) e si valuta su \(D_i\). La stima cross-validata è la media degli errori di validazione:
dove \(f_\theta^{(-i)}\) è il modello addestrato escludendo il fold \(i\)-esimo. Il
caso estremo \(k=m\) (un fold per esempio) è la leave-one-out: quasi non
distorta, perché ogni modello studia su \(m-1\) esempi, ma costosa e con varianza
più alta della \(k\)-fold con \(k<m\) [JWH+23], perché media
\(m\) modelli addestrati su insiemi quasi identici e quindi fortemente correlati
fra loro, e la media di quantità fortemente correlate si stabilizza poco: con
correlazione \(\rho\) fra i termini la sua varianza non scende sotto
\(\rho\,\sigma^2\), qualunque sia il numero dei termini. Valori \(k=5\) o \(k=10\)
sono un buon compromesso fra distorsione, costo computazionale e stabilità
della stima [HTF09]. Resta da dire che cosa stimino.
\(\text{CV}_k\) approssima bene l’errore atteso sui possibili insiemi di
addestramento, e male l’errore del modello addestrato proprio sui nostri dati,
con cui nelle simulazioni di ESL risulta perfino debolmente anticorrelata
[HTF09]; e siccome ogni modello vede \((k-1)m/k\) esempi, la
stima è pessimista per il modello finale, addestrato su tutti gli \(m\). Inoltre,
perché la stima sia valida, ogni passo che guarda i dati deve stare dentro il
ciclo. Il controesempio classico è di ESL: cinquanta esempi, cinquemila colonne
di puro rumore, le cento più correlate con l’etichetta scelte guardando tutti i
dati, e un \(1\)-NN valutato in cross-validation; l’errore stimato è del \(3\%\),
quello vero del \(50\%\). Selezione delle colonne, riscalatura e imputazione
vanno quindi in una Pipeline, che scikit-learn riaddestra da capo in ogni
fold. Per il ricampionamento serve la Pipeline di imbalanced-learn, perché
quella di scikit-learn non ammette passi che cambiano il numero di righe: lo
spiega la sezione sulle metriche.
E quando più configurazioni risultano a pari merito dentro l’incertezza della stima, la convenzione per decidere è la regola dell’errore standard: si tiene la più semplice fra le configurazioni il cui errore sta entro un errore standard dal minimo [JWH+23]. L’errore standard di una stima cross-validata vale la dispersione fra i \(k\) giri divisa per \(\sqrt{k}\), quindi con cinque blocchi meno della metà: usare la dispersione al suo posto allarga la fascia di un fattore \(2{,}2\) e fa scegliere un modello più semplice del dovuto. È il rasoio di Occam applicato a una classifica che si sa incerta.
Un’ipotesi va però dichiarata, perché è quella che regge tutto il ragionamento: \(\text{CV}_k\) stima l’errore a patto che le righe siano scambiabili, cioè che partizionarle a caso produca fold indipendenti fra loro. Se più righe descrivono lo stesso soggetto (più visite dello stesso paziente, più eventi dello stesso utente, più fotogrammi dello stesso video), il rimescolamento mette quasi-duplicati sia in training sia in validation, e il modello ritrova in validation ciò che ha già visto. Il risultato è una stima priva di significato, non solo un po’ ottimista, e non dà nessun segnale d’allarme. Il conto, con duecento soggetti, dieci misure quasi identiche ciascuno e un’etichetta assegnata a caso a ogni soggetto (quindi non c’è niente da imparare, e la verità è \(0{,}50\)), fatto con un classificatore capace di memorizzare come il \(k\)-NN a un vicino:
import numpy as np
from sklearn.model_selection import GroupKFold, KFold, cross_val_score
from sklearn.neighbors import KNeighborsClassifier

rng = np.random.default_rng(0)
soggetto = np.repeat(np.arange(200), 10)              # dieci righe per soggetto
centro = rng.normal(size=(200, 5))
X_g = centro[soggetto] + rng.normal(0, 0.01, (2000, 5))  # quasi identiche
y_g = rng.integers(0, 2, 200)[soggetto]   # a caso: non c'è niente da imparare
uno = KNeighborsClassifier(n_neighbors=1)
mescolata = cross_val_score(uno, X_g, y_g,
                            cv=KFold(5, shuffle=True, random_state=0))
per_soggetto = cross_val_score(uno, X_g, y_g, cv=GroupKFold(5), groups=soggetto)
print(f"5-fold mescolata:    {mescolata.mean():.3f}")
print(f"5-fold per soggetto: {per_soggetto.mean():.3f}")
5-fold mescolata:    1.000
5-fold per soggetto: 0.543
La validazione mescolata dichiara un classificatore perfetto; raggruppata per
soggetto torna a \(0{,}543\), dentro l’oscillazione che duecento soggetti
consentono attorno a \(0{,}5\). In questi casi i fold vanno costruiti per
soggetto (GroupKFold, GroupShuffleSplit); se invece le righe sono ordinate
nel tempo vale il discorso dei dati che cambiano, cioè TimeSeriesSplit e non un
rimescolamento.
La riga finale di Fig. 4.11 è la parte che si tende a buttare via: non la media dei cinque punteggi, ma la loro dispersione, cioè di quanto i cinque giri si discostano dalla media. In statistica la si riassume in un numero, la deviazione standard: quanto, in media, un giro si scosta dal risultato medio.
Serve a non prendere per differenze quelle che sono oscillazioni, con una precisazione. La dispersione dei cinque giri dice quanto l’errore di un modello cambia da una parte dei dati all’altra, in gran parte perché alcuni blocchi sono più difficili di altri; è la misura di quanto fidarsi di quel numero. Il confronto fra due modelli si fa invece giro per giro, sugli stessi blocchi, e la dispersione che conta è quella delle differenze, di solito molto più piccola perché la difficoltà del blocco pesa su tutti e due.
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.linear_model import Ridge

# il test resta da parte fin dall'inizio, non lo tocchiamo più
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42)

modello = Ridge(alpha=1.0)   # alpha: quanto si fa pagare la complessità
scores = cross_val_score(modello, X_train, y_train, cv=5,
                         scoring="neg_mean_squared_error")  # 5-fold CV
print(f"errore medio di validazione: {-scores.mean():.3f}")
print(f"quanto ballano i cinque giri: {scores.std():.3f}")

# un secondo modello sugli stessi cinque blocchi: differenza giro per giro
altro = Ridge(alpha=300.0)
altri = cross_val_score(altro, X_train, y_train, cv=5,
                        scoring="neg_mean_squared_error")
diff = scores - altri
print(f"alpha=300: errore medio {-altri.mean():.3f}, "
      f"ballo dei cinque giri {altri.std():.3f}")
print(f"differenza giro per giro: {diff.round(3)}")
print(f"media {diff.mean():+.3f}, ballo della differenza {diff.std():.3f}")
errore medio di validazione: 2.248
quanto ballano i cinque giri: 0.217
alpha=300: errore medio 2.268, ballo dei cinque giri 0.209
differenza giro per giro: [ 0.024  0.017  0.04   0.024 -0.004]
media +0.020, ballo della differenza 0.014
Il ballo è \(0{,}217\) su una media di \(2{,}248\), poco meno di un decimo: dice
quanto fidarsi del numero di questo modello. Per confrontarlo con
alpha=300.0 si sottraggono gli errori blocco per blocco: la differenza vale
\(+0{,}020\) in media, con un ballo di \(0{,}014\), quindici volte più piccolo di
quello dei singoli modelli, e quattro blocchi su cinque danno lo stesso segno.
Due centesimi, qui, sono un indizio e non una prova: i blocchi condividono i
dati di addestramento e non sono indipendenti, quindi dividere per \(\sqrt{5}\)
darebbe un’incertezza troppo ottimista.
Mettere un freno: la regolarizzazione#
Un modo diretto per contrastare l’overfitting è impedire ai pesi di diventare troppo grandi. Addestrare vuol dire rendere più piccola possibile la loss, il numero che misura quanto il modello sbaglia sui dati di addestramento.
La regolarizzazione aggiunge alla loss un secondo addendo, una penalità che cresce con la grandezza dei pesi (i numeri per cui il modello moltiplica ogni caratteristica). Da quel momento il modello non minimizza più soltanto l’errore ma «errore più spesa in pesi»: alzare un peso continua a convenire se fa scendere l’errore più di quanto fa salire la spesa, e smette di convenire quando serve solo a rincorrere un punto isolato. Il prezzo lo fissa un iperparametro, \(\lambda\) (la lettera greca lambda), che moltiplica la penalità: \(\lambda = 0\) vuol dire nessun freno, \(\lambda\) grande freno tirato.
Resta da decidere come si misura la grandezza dei pesi, e le due scelte classiche si chiamano L1 e L2, dal nome delle norme che usano: la L1 somma i valori assoluti dei pesi, la L2 somma i loro quadrati. La scelta decide quali pesi sopravvivono all’addestramento.
Quello che di solito si impara come una regola da mandare a memoria («la L1 azzera i pesi inutili, la L2 no») è in realtà una questione di forme, e si può disegnare.
Si prenda un modello con due soli pesi, \(w_1\) e \(w_2\), e il piano dei parametri: ogni punto è una scelta possibile della coppia, e la loss \(\mathcal{L}\) assegna a ciascun punto un valore. Penalizzare i pesi e vincolarli sono due formulazioni equivalenti quando loss e penalità sono convesse, come qui: a ogni \(\lambda\) corrisponde un tetto \(t\) che dà la stessa soluzione, e viceversa (chi paga un prezzo per ogni unità di spesa finisce per spendere una certa cifra, e con quella cifra come tetto avrebbe scelto lo stesso). Il tetto conviene perché si disegna: è una regione attorno all’origine, e il modello deve restare dentro. Se la spesa si conta sommando i valori assoluti (la L1), il recinto è un rombo con le punte sugli assi: per star dentro basta che \(|w_1| + |w_2|\) non superi il budget, e i due estremi sono spendere tutto su un peso solo, che sono appunto le punte. Se si conta sommando i quadrati (la L2) il recinto è un cerchio.
Senza vincolo la loss ha un minimo in un punto, e attorno ad esso le curve di livello, cioè i punti con la stessa loss, sono anelli concentrici (ellissi, per una loss quadratica). Se quel minimo cade fuori dal recinto, il modello vorrebbe scendere fin là ma non può uscire: la soluzione vincolata è il punto del recinto dove il primo anello che si allarga dal minimo lo tocca.
Ed è qui che la forma decide.

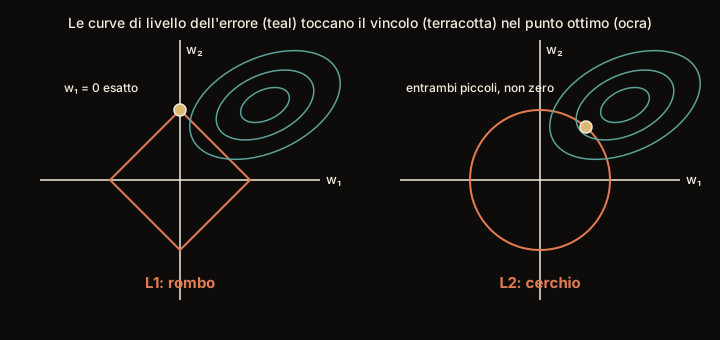
Fig. 4.12 La differenza sta negli spigoli. A sinistra il recinto della L1, un rombo con le punte sugli assi, e gli anelli dell’errore che lo toccano proprio in una punta: lì un peso è esattamente zero. A destra il cerchio della L2, che di punte non ne ha e non privilegia nessuna direzione.#
Un anello che si allarga incontra un rombo in una punta, come mostra Fig. 4.12, e le punte del rombo stanno sugli assi, cioè in punti dove uno dei due pesi vale esattamente zero. Succede tanto più spesso quanto più stretto è il budget, ed è la ragione per cui la L1 azzera di più quando il freno è tirato di più. Un cerchio invece non ha punte, e il primo contatto cade in un posto qualunque del bordo, dove entrambi i pesi sono piccoli ma nessuno è nullo. Ecco perché sommare i valori assoluti seleziona le caratteristiche e sommare i quadrati no: la ragione sta tutta nella forma del recinto.
Il modello compra i suoi pesi, e la regolarizzazione gli dà un budget. Senza, per passare su ogni punto la curva deve piegarsi di scatto, e le pieghe brusche costano pesi enormi di segno opposto, come \(+1000\) e \(-999\), che quasi si annullano a vicenda: così nasce la curva contorta. Con un tetto alla spesa il modello diventa sobrio, e le curve sobrie sono più morbide.
I listini sono due. Nel Ridge (la L2) ogni peso si paga al quadrato, e i pesi calano tutti, dolcemente, senza che nessuno arrivi a zero: portarne uno da \(0{,}1\) a \(0\) fa risparmiare \(0{,}01\), troppo poco per rinunciare a un peso che serve ancora un po’. Nel Lasso (la L1) si paga il valore assoluto, e l’ultimo centesimo costa quanto il primo: azzerare un peso che non serve conviene sempre, e le caratteristiche inutili spariscono dalla tabella. È lo stesso fatto che il rombo con le punte sugli assi racconta con la geometria.
Quanto è stretto il budget è la manopola fra i due modi di sbagliare visti al poligono. Con la spesa quasi vietata tutti i pesi vanno a zero e il modello risponde sempre la stessa cosa: stabile e storto. Con il budget senza fondo torna la curva che si contorce. Il valore giusto sta in mezzo e non si indovina: se ne provano parecchi, e quale tenere lo dicono i cinque compiti in classe della cross-validation.
Il budget ha senso se si paga per le cose giuste, e con la stessa moneta. La quota fissa che il modello somma a ogni previsione non si paga: chi prevede le temperature in gradi Kelvin, che sono i Celsius più 273, ha bisogno di una quota fissa più alta di 273, e se la pagasse il modello cambierebbe per una semplice scelta di unità. E la moneta è la stessa solo se le colonne stanno sulla stessa scala. Un reddito di \(30\,000\) euro porta \(30\) punti con un peso di \(0{,}001\), una percentuale del \(5\) ne vuole uno di \(6\) per portarne altrettanti, e allo stesso prezzo per peso il freno lascerebbe in pace il reddito e strangolerebbe la percentuale. Per questo, prima di fare la spesa, ogni colonna si misura in quanto si scosta dal suo solito.
Il Lasso ha anche un capriccio: davanti a due colonne gemelle, che dicono quasi la stessa cosa, ne compra una e lascia l’altra, e quale delle due è quasi un sorteggio, che cambia con il campione. Al quadrato, invece, dividere un peso a metà fra le gemelle costa meno che darlo tutto a una (\(0{,}5^2 + 0{,}5^2\) fa \(0{,}5\), contro \(1\)), e allora, pagando un po’ con un listino e un po’ con l’altro, le gemelle entrano o escono insieme.
Certe colonne vanno in gruppo per costruzione. Il colore di un’auto, con quattro valori possibili, entra nel modello come quattro colonne sì o no, una per colore (è la codifica one-hot della sezione sull’apprendimento supervisionato), e il Lasso le compra una per una: può tenere «rosso» e lasciare «verde», come se il colore contasse per le auto rosse e non per le verdi. Lo stesso colore si scrive anche con tre colonne, togliendo quella del verde, che fa da zero come in un termometro: un’auto verde ha tutte e tre le colonne a no, e il peso del rosso dice quanto una rossa vale più di una verde. I dati sono gli stessi, eppure scritti così il Lasso può lasciare colori diversi: la conclusione dipendeva dalla scrittura, non dai dati.
Il lasso a gruppi vende ogni gruppo come un pacchetto, al prezzo della sua lunghezza, che è l’ipotenusa di Pitagora con quanti cateti servono: si sommano i quadrati dei pesi e si prende la radice. Due pesi da \(0{,}3\) e \(0{,}4\) fanno \(0{,}09 + 0{,}16 = 0{,}25\), cioè un pacchetto lungo \(0{,}5\). Poi toglie a ogni pacchetto un pezzo fisso di lunghezza, come il Lasso toglie a ogni peso lo stesso tanto: il pacchetto più corto di quel pezzo sparisce tutto, quello più lungo resta, e così entra intero o resta fuori intero. Dentro, i pesi si spartiscono la spesa come nel Ridge, e nessuno viene azzerato da solo. Il pezzo tolto, però, cresce con la radice di quanti pesi il pacchetto contiene, e per quattro pesi è il doppio: anche una colonna inutile riceve dal caso un pesetto, e quattro pesetti fanno un pacchetto più lungo di uno solo, che con lo stesso pezzo per tutti entrerebbe soltanto perché è grosso.
I pacchetti li confeziona chi scrive il modello, e il metodo li prende per buoni. Chi mette nello stesso pacchetto il colore e l’età dell’auto se li vede entrare e uscire insieme, anche se conta soltanto il colore. E se il pacchetto dell’età contiene l’età, il suo quadrato e il suo cubo, e conta solo l’età, chi vuole poter scartare il quadrato e il cubo aggiunge un po’ del listino del Lasso: il pacchetto entra, ma dentro i pesi inutili possono ancora andare a zero.
Si aggiunge alla loss \(\mathcal{L}(\theta)\) un termine di penalità pesato da un iperparametro \(\lambda \ge 0\) che regola l’intensità del freno. Per la regressione Ridge (norma \(\ell_2\)):
per il Lasso (norma \(\ell_1\)):
Con \(\lambda \to 0\) si torna al modello non regolarizzato (varianza alta); con \(\lambda\) grande i pesi sono schiacciati verso zero (bias alto): \(\lambda\) è la manopola del compromesso bias-varianza, e la si sceglie per cross-validation. La geometria spigolosa della norma \(\ell_1\) è ciò che rende sparse le soluzioni del Lasso, annullando interi coefficienti: un selettore automatico di feature. Per la regressione logistica Ng [Ng04] dimostra che con penalità \(\ell_1\) il numero di esempi necessari cresce solo come il logaritmo del numero di feature irrilevanti, mentre per ogni algoritmo invariante per rotazione, come la logistica con penalità \(\ell_2\), nel caso peggiore cresce almeno linearmente.
Con le colonne centrate, così che l’intercetta resti fuori dalla penalità, Ridge ha soluzione in forma chiusa,
dove il fattore \(m\) viene dalla media nella loss. La matrice è invertibile per ogni \(\lambda>0\), anche con colonne collineari o con più colonne che esempi, cioè proprio dove le equazioni normali degeneravano. Con colonne ortogonali, \(\mathbf{X}^\top\mathbf{X} = m\,\mathbf{I}\), le due penalità si leggono coefficiente per coefficiente a partire dalla stima dei minimi quadrati \(\hat{\theta}_j\): Ridge la divide, \(\hat{\theta}_j/(1+\lambda)\), e non la azzera mai; Lasso la accorcia di una quantità fissa, \(\operatorname{sign}(\hat{\theta}_j)\,\big(|\hat{\theta}_j| - \lambda/2\big)_+\) (il soft thresholding), e manda a zero esatto ogni coefficiente sotto \(\lambda/2\) [HTF09]. Le due penalità sono anche stime MAP: con rumore \(\mathcal{N}(0,\sigma^2)\) e prior \(\theta_j \sim \mathcal{N}(0,\tau^2)\) si ottiene Ridge con \(\lambda = \sigma^2/(m\tau^2)\), e con un prior di Laplace si ottiene il Lasso, che non ha forma chiusa e in scikit-learn si risolve per discesa coordinata.
Due cose le formule le dicono in silenzio. La prima è che l’indice \(j\) corre da
\(1\) a \(n\), cioè sulle sole caratteristiche: l’intercetta non è penalizzata. Se
lo fosse, il modello dipenderebbe dall’origine scelta per \(y\), e sommare una
costante a tutte le etichette (per esempio misurarle in gradi Kelvin invece che
in Celsius, cioè aggiungere \(273{,}15\)) cambierebbe la soluzione, il che non ha
senso. La seconda è che la penalità mette sullo stesso piano pesi che vivono su
scale diverse, e quindi presuppone feature standardizzate: il peso che
moltiplica un reddito in euro è piccolo per forza, e la penalità lo lascerebbe
in pace mentre schiaccia quello di una percentuale. Vale qui la stessa
avvertenza del k-NN e delle SVM, con la differenza che qui è meno visibile,
perché un modello mal regolarizzato funziona comunque, solo peggio: Ridge e
Lasso non standardizzano da soli, e vanno messi dietro uno StandardScaler
dentro una Pipeline, la catena di passaggi che scikit-learn tratta come se
fosse un modello solo.
L’Elastic Net [ZH05] somma le due penalità, \(\lambda\big(\alpha\sum_j|\theta_j| + \tfrac{1-\alpha}{2}\sum_j\theta_j^2\big)\), e rimedia a un difetto preciso del Lasso. Fra due feature fortemente correlate il Lasso ne tiene una sola, scelta in modo instabile (basta cambiare il campione perché scelga l’altra), mentre il termine \(\ell_2\) le fa entrare o uscire insieme, il cosiddetto grouping effect. Con feature molte e correlate è un punto di partenza ragionevole, da confrontare in validazione incrociata con le due penalità pure.
Un avvertimento sulla lettera \(\alpha\), che qui fa due mestieri
diversi. Nella formula dell’Elastic Net è il rapporto di miscela fra le due
penalità (\(\alpha = 1\) è Lasso puro, \(\alpha = 0\) è Ridge puro) e non ha niente
a che vedere con la loro intensità, che resta \(\lambda\). Nel codice, invece,
l’argomento alpha di Ridge, Lasso ed ElasticNet fa il mestiere
dell’intensità, cioè del nostro \(\lambda\), mentre la miscela lì si chiama
l1_ratio. Fa il mestiere, però non è lo stesso numero, e la ragione è dove
ciascuna libreria mette la divisione per il numero di esempi: la loss qui
è mediata sugli esempi e la penalità no, mentre Ridge non media affatto e
Lasso divide per \(2m\).
A parità di soluzione, \(\lambda = \texttt{alpha}/m\) per la prima e
\(\lambda = 2\,\texttt{alpha}\) per la seconda. Sono due tradizioni che si sono incrociate su una lettera sola:
conviene guardare che cosa fa il parametro, non come si chiama.
Quando i gruppi sono noti in anticipo (le colonne indicatrici di una variabile categorica, i termini di un polinomio nella stessa variabile) il Lasso li spezza: sulle indicatrici tiene alcuni livelli e ne azzera altri, e quali dipende dalla codifica, per esempio dal livello scelto come riferimento, che è una convenzione e non un fatto dei dati. Il group lasso, proposto da Bakin [Bak99] e studiato da Yuan e Lin [YL06], impone i gruppi, con i coefficienti divisi in blocchi \(\theta_g\) di \(p_g\) elementi e \(\mathbf{X}_g\) le colonne del blocco \(g\):
La norma \(\ell_2\) non elevata al quadrato ha uno spigolo nell’origine di ogni blocco, e lo spigolo annulla il blocco intero; dentro il blocco la norma è rotonda e non azzera nessuna componente da sola. Il fattore \(\sqrt{p_g}\) tiene alla pari i blocchi di taglia diversa. Un blocco resta a zero finché \(\tfrac{2}{m}\lVert\mathbf{X}_g^\top\mathbf{r}_{-g}\rVert_2\) non supera \(\lambda\sqrt{p_g}\), dove \(\mathbf{r}_{-g}\) è il residuo lasciato dagli altri blocchi; se le colonne del blocco non contano, il membro di sinistra cresce per puro caso come \(\sqrt{p_g}\), e senza il fattore un blocco grande entrerebbe più spesso solo perché è grande. Con colonne ortonormali la condizione, elevata al quadrato, confronta con una soglia la somma dei quadrati spiegata dal blocco divisa per \(p_g\), come il test \(F\) dell’analisi della varianza, ed è la ragione per cui Yuan e Lin scelgono questo fattore. E \(p_g\) coefficienti tutti uguali ad \(a\) hanno norma \(a\sqrt{p_g}\), quindi pagano \(p_g a\), quanto il Lasso li farebbe pagare uno per uno.
Se le colonne di ogni blocco sono ortonormali nella scala della media (\(\mathbf{X}_g^\top\mathbf{X}_g = m\,\mathbf{I}\)) e i blocchi sono ortogonali fra loro, la soluzione si scrive blocco per blocco, a partire dalla stima dei minimi quadrati \(\hat{\theta}_g\), come \(\big(1 - \lambda\sqrt{p_g}/(2\lVert\hat{\theta}_g\rVert_2)\big)_+\,\hat{\theta}_g\): è il soft thresholding del Lasso applicato alla lunghezza del blocco invece che al singolo coefficiente. L’ortonormalità dentro i blocchi, che Yuan e Lin assumono in tutto il lavoro, fa più che semplificare i conti. La norma \(\lVert\theta_g\rVert_2\) non cambia se la base del blocco ruota, ma cambia sotto un cambio di base qualsiasi, e solo con blocchi ortonormalizzati la soluzione dipende dallo spazio generato dalle colonne e non dai contrasti con cui si è scritta la variabile; una variabile a quattro livelli ha tre gradi di libertà, e il suo \(p_g\) è \(3\). Su blocchi non ortonormali il metodo prende ancora il blocco intero o niente, ma il \(\lambda\) a cui lo prende torna a dipendere dalla codifica. Con la sola ortonormalità dentro i blocchi, la stessa formula applicata a turno a ogni blocco, sul residuo lasciato dagli altri, è l’algoritmo di Yuan e Lin; nel caso generale la si usa come passo di un metodo del gradiente prossimale, con soglia \(\lambda\sqrt{p_g}\) moltiplicata per il passo.
Il punto di rottura è la partizione, che il metodo prende per vera: un blocco sbagliato entra o esce intero, e se in un blocco conta un solo termine del polinomio entra lo stesso il blocco intero. Lo sparse group lasso [SFHT13] ci rimedia mescolando le due penalità con un rapporto di miscela, come l’Elastic Net,
così che dentro un blocco acceso le singole componenti si possano ancora azzerare. Sulle indicatrici di una variabile categorica il rimedio va letto con cautela, perché lì uno zero dentro il blocco dice che quel livello non si distingue dal livello di base, e quale sia la base dipende di nuovo dalla codifica.
Il blocco costruisce una risposta che dipende da una variabile numerica e dal colore (quattro valori, quindi quattro colonne sì/no), mentre un’altra variabile numerica e la regione di provenienza (altre quattro colonne) non contano. Poi guarda, per trenta intensità del freno, se il Lasso prende qualche gruppo a metà, e quali colori tiene a un’intensità intermedia; e prova a tre intensità il lasso a gruppi, scritto in poche righe come discesa del gradiente seguita dall’accorciamento di ogni blocco.
import numpy as np
from sklearn.linear_model import Lasso

rng = np.random.default_rng(0)
m = 400
def a_colonne(etichette, k):
    """Una variabile a k valori spezzata in k colonne sì/no, centrate (a media zero)."""
    D = np.eye(k)[etichette]
    return D - D.mean(axis=0)
colore = rng.integers(0, 4, m)                    # conta: rosso, verde, blu, giallo
regione = rng.integers(0, 4, m)                   # non conta
x1, x2 = rng.standard_normal(m), rng.standard_normal(m)
X = np.column_stack([x1, x2, a_colonne(colore, 4), a_colonne(regione, 4)])
gruppi = [[0], [1], [2, 3, 4, 5], [6, 7, 8, 9]]  # un gruppo per variabile
nomi = ["x1", "x2", "colore", "regione"]
y = 1.5 * x1 + np.array([0.0, 1.0, -1.0, 0.5])[colore] + rng.normal(0, 1, m)
y = y - y.mean()

def lasso_a_gruppi(X, y, lam, passi=3000):
    """Discesa del gradiente in cui, dopo ogni passo, ogni gruppo si accorcia per
    intero, e sotto una soglia sparisce (il block soft-thresholding): la penalità
    è lam per la radice della taglia del gruppo per la lunghezza dei suoi pesi."""
    theta = np.zeros(X.shape[1])
    # il passo è l'inverso della costante di Lipschitz del gradiente, 2 ||X||^2 / m:
    # con un passo così la discesa non diverge
    passo = len(y) / (2 * np.linalg.norm(X, 2) ** 2)
    for _ in range(passi):
        z = theta - passo * 2 * X.T @ (X @ theta - y) / len(y)
        for g in gruppi:
            norma = np.linalg.norm(z[g])
            soglia = passo * lam * np.sqrt(len(g))       # la penalità, scalata dallo stesso passo
            theta[g] = 0.0 if norma <= soglia else (1 - soglia / norma) * z[g]
    return theta

def a_meta(theta):
    """I gruppi di più colonne presi a metà: qualche colonna dentro, qualcuna fuori."""
    return [nomi[i] for i, g in enumerate(gruppi) if len(g) > 1
            and 0 < np.count_nonzero(theta[g]) < len(g)]

presi_a_meta = set()
for alpha in np.logspace(-3, 0, 30):              # trenta intensità, dal freno lieve al forte
    theta = Lasso(alpha=alpha, fit_intercept=False).fit(X, y).coef_
    presi_a_meta |= set(a_meta(theta))
print("Lasso: gruppi presi a metà per qualche intensità:", sorted(presi_a_meta))
theta = Lasso(alpha=0.1, fit_intercept=False).fit(X, y).coef_
colori = ["rosso", "verde", "blu", "giallo"]
print("Lasso con alpha 0.1, colori tenuti:",
      [c for c, t in zip(colori, theta[2:6]) if t != 0])
for lam in (0.01, 0.1, 1.0):
    theta = lasso_a_gruppi(X, y, lam)
    dentro = ", ".join(f"{nomi[i]} {np.linalg.norm(theta[g]):.2f}"   # la lunghezza del gruppo
                       for i, g in enumerate(gruppi) if np.any(theta[g] != 0))
    print(f"lasso a gruppi, lambda {lam}: dentro {dentro}; a metà {a_meta(theta)}")
Lasso: gruppi presi a metà per qualche intensità: ['colore', 'regione']
Lasso con alpha 0.1, colori tenuti: ['verde', 'blu']
lasso a gruppi, lambda 0.01: dentro x1 1.56, x2 0.02, colore 1.49, regione 0.10; a metà []
lasso a gruppi, lambda 0.1: dentro x1 1.52, colore 1.13; a metà []
lasso a gruppi, lambda 1.0: dentro x1 1.08; a metà []
Il Lasso, per qualche intensità del freno, tiene alcune colonne del colore e
ne butta altre, e fa lo stesso con la regione, che non conta affatto. Con
alpha a \(0{,}1\) tiene il verde e il blu, una selezione che dice «il verde e il
blu contano, il rosso e il giallo no», mentre nei dati ogni colore sposta la
risposta di un tanto suo. Il lasso a gruppi, per costruzione, non prende mai un
gruppo a metà. Con il freno lieve tiene dentro tutto, i due gruppi che non
contano con lunghezze piccole (\(0{,}02\) e \(0{,}10\)); al crescere di \(\lambda\)
escono prima quei due, poi il colore, e ogni gruppo esce intero. La lunghezza di
chi resta cala a ogni stretta del freno: è il restringimento, lo stesso del
Lasso, applicato al blocco. Il blocco non ortonormalizza i gruppi, per restare
vicino alle colonne sì/no, e al colore dà quattro colonne dove ne basterebbero
tre: la regola del tutto o niente non ne risente, le intensità a cui i gruppi
escono sì.
A salti o a poco a poco: scegliere le colonne#
Prima dei freni continui le colonne si sceglievano a salti: si provano dei sottoinsiemi e si tiene il migliore. La selezione del sottoinsieme migliore (best subset selection) li prova tutti, e con \(p\) colonne sono \(2^p\) (ogni colonna dentro o fuori, due scelte per ciascuna), più di un milione già con venti colonne; la selezione in avanti (forward stepwise selection) ne costruisce una catena, aggiungendo a ogni passo la colonna che riduce di più l’errore, e quante tenerne lo decide la cross-validation. Il confronto con il Lasso dice quando il freno continuo conviene, e quando no.
Scegliere a salti è come convocare una squadra: per ogni giocatore si decide dentro o fuori, e chi è dentro gioca tutta la partita. Il freno continuo del Lasso concede invece a ciascuno dei minuti, e li toglie un po” alla volta.
Il difetto dei salti è che una convocazione cambia per poco. Basta qualche esempio diverso perché fra due giocatori simili entri l’altro, e con lui cambia di colpo il modello intero, come una formazione che per un solo cambio ridistribuisce i ruoli di tutti: la scelta a salti è nervosa, e il nervosismo si paga in errore sui dati nuovi. Anche il Lasso, da un campione all’altro, può cambiare quale di due colonne gemelle tiene, ed è il suo capriccio; ma quando i dati si spostano di poco i minuti passano dall’una all’altra poco alla volta, e siccome le gemelle dicono quasi la stessa cosa la previsione si sposta appena. Può ballare l’elenco dei convocati, mentre la previsione resta quasi ferma.
Ma il freno ha un prezzo suo, perché fa due mestieri con una manopola sola: toglie minuti a tutti e decide chi resta in panchina. Tirato quanto serve per lasciare fuori le riserve, toglie troppi minuti ai titolari; allentato per far giocare i titolari, lascia entrare qualche riserva che non servirebbe. C’è poi un costo nascosto nella convocazione, ed è la trappola delle mille persone che lanciano la moneta: chi prova migliaia di squadre sugli stessi dati ne trova sempre una che su quei dati va bene per caso, e il merito che le si attribuisce è gonfiato dalla ricerca stessa, anche se alla fine i convocati sono pochi, perché a pesare non è quanti giocano ma quante squadre si sono provate per sceglierli. Quando i dati sono chiari, con poco rumore, la squadra convocata bene è la più precisa, perché chi gioca gioca a pieno; quando il rumore è tanto conviene il freno, perché una convocazione fatta sul rumore sbaglia di più. Nessuno dei due vince sempre, e la via di mezzo se la cava bene dappertutto: si convoca con il freno, e poi ai convocati lo si allenta.
La selezione del sottoinsieme migliore risolve \(\min_\theta \lVert \mathbf{y} - \mathbf{X}\theta\rVert^2\) con il vincolo \(\lVert\theta\rVert_0 \le k\), il numero di coefficienti non nulli: un problema combinatorio, NP-difficile in generale, che la programmazione intera mista risolve con ottimalità certificata quando le colonne sono centinaia e gli esempi migliaia, in minuti per ogni \(k\) secondo gli autori [BKM16], spesso in un’ora o più per chiudere il certificato secondo chi ha rifatto le prove [HTT20]. La selezione in avanti lo approssima in modo avido, con \(O(p^2)\) adattamenti ai minimi quadrati lungo il cammino, e il Lasso ne è il rilassamento convesso, con \(\lVert\theta\rVert_1\) al posto di \(\lVert\theta\rVert_0\). Breiman ha mostrato, con un argomento euristico e con simulazioni, che la selezione del sottoinsieme è instabile (cambiare pochi esempi può cambiare il sottoinsieme scelto) mentre la regressione ridge è stabile, e che l’instabilità si paga nella scelta della complessità: con la sfera di cristallo, cioè scegliendo \(k\) sull’errore vero, il sottoinsieme batteva spesso la ridge, e perdeva il vantaggio quando \(k\) andava scelto sui dati [Bre96b]. Il Lasso sta dalla parte della ridge: a \(\lambda\) fissato la sua previsione \(\mathbf{X}\hat{\theta}\) è una funzione continua di \(\mathbf{y}\), mentre quella del sottoinsieme migliore e della selezione in avanti, a \(k\) fissato, salta quando \(\mathbf{y}\) attraversa il confine fra due insiemi attivi [HTT20].
Il confronto sistematico di Hastie, Tibshirani e Tibshirani [HTT20], nato per verificare le simulazioni di Bertsimas e colleghi in cui il sottoinsieme migliore vinceva sempre, ha precisato il quadro. A rapporto segnale/rumore alto la selezione del sottoinsieme migliore e quella in avanti, che si comportano in modo simile, battono il Lasso, che per non restringere troppo i coefficienti veri sceglie un \(\lambda\) piccolo e accetta qualche falso positivo; a rapporto basso vince il Lasso. Il sorpasso cade attorno a \(1{,}2\) con cento esempi e dieci colonne, attorno a \(0{,}4\) con cinquecento esempi e cento colonne, e gli autori avvertono che su dati osservazionali già un rapporto di \(1\), cioè un modello che spiega metà della varianza di \(y\), è raro, e uno di \(6\) è inaudito. Il relaxed lasso, che usa il Lasso per scegliere e poi restringe meno, è competitivo dappertutto. C’è anche un costo nascosto nella scelta a salti. I gradi di libertà effettivi di un modello (la somma delle covarianze fra ciascuna previsione e la sua etichetta, divisa per \(\sigma^2\), che per i minimi quadrati su \(k\) colonne fissate vale esattamente \(k\)) superano di molto i \(k\) coefficienti che restano quando le colonne le ha scelte una ricerca, perché la ricerca stessa ha guardato i dati; quelli del Lasso valgono invece il numero atteso di coefficienti non nulli [HTT20].
Il blocco mette alla prova le due strade su cento esempi con venti colonne, di
cui cinque contano, correlate fra loro tanto più quanto sono vicine
(\(0{,}5^{|i-j|}\)), a tre rapporti segnale/rumore (quanto è sparpagliata la
parte di \(y\) che le colonne spiegano, divisa per quanto lo è il rumore: le
varianze dei dati, non quella del modello), trenta campioni per ciascuno. La
selezione in avanti sceglie quante colonne tenere con una cross-validation a
cinque blocchi, come fa LassoCV per l’intensità del freno, e nessuno dei due
stima un’intercetta, che i dati non hanno. L’errore è misurato su dati nuovi e
diviso per la varianza del rumore, quindi \(1\) è il meglio possibile, perché il
rumore nessun modello lo può prevedere; accanto, il blocco stampa lo scarto fra
i due con il suo errore standard, e quante colonne tiene in media ciascuno.
import numpy as np
from sklearn.linear_model import LassoCV
from sklearn.model_selection import KFold

m, p = 100, 20
S = 0.5 ** np.abs(np.subtract.outer(np.arange(p), np.arange(p)))   # correlazioni fra colonne vicine
beta = np.r_[np.ones(5), np.zeros(p - 5)]                          # contano le prime cinque

def dati(snr, rng):
    """m esempi per stimare, 2000 per misurare, rapporto segnale/rumore snr."""
    # Cholesky: trasforma colonne indipendenti in colonne con le correlazioni di S
    X = rng.standard_normal((m + 2000, p)) @ np.linalg.cholesky(S).T
    sigma = np.sqrt(beta @ S @ beta / snr)
    y = X @ beta + sigma * rng.standard_normal(m + 2000)
    return X[:m], y[:m], X[m:], y[m:], sigma

def minimi_quadrati(X, y, colonne):
    return np.linalg.lstsq(X[:, colonne], y, rcond=None)[0]

def in_avanti(X, y):
    """L'ordine in cui le colonne entrano: a ogni passo quella che riduce di più l'errore."""
    dentro, fuori = [], list(range(p))
    for _ in range(p):
        errori = [((y - X[:, dentro + [j]] @ minimi_quadrati(X, y, dentro + [j])) ** 2).sum()
                  for j in fuori]
        dentro.append(fuori.pop(int(np.argmin(errori))))
    return dentro

def in_avanti_cv(X, y):
    """In avanti, con il numero di colonne scelto dalla cross-validation."""
    errore = np.zeros(p)
    for tr, va in KFold(5).split(X):
        ordine = in_avanti(X[tr], y[tr])
        for k in range(1, p + 1):
            b = minimi_quadrati(X[tr], y[tr], ordine[:k])
            errore[k - 1] += ((y[va] - X[va][:, ordine[:k]] @ b) ** 2).sum()
    colonne = in_avanti(X, y)[:int(np.argmin(errore)) + 1]
    return colonne, minimi_quadrati(X, y, colonne)

print("rapporto   in avanti   Lasso   scarto           colonne tenute")
for snr in (0.25, 1.0, 6.0):
    avanti, lasso, n_avanti, n_lasso = [], [], [], []
    for r in range(30):                                  # trenta campioni per ogni rapporto
        X, y, Xt, yt, sigma = dati(snr, np.random.default_rng(r))
        colonne, b = in_avanti_cv(X, y)
        avanti.append(((yt - Xt[:, colonne] @ b) ** 2).mean() / sigma ** 2)
        # senza intercetta, come la selezione in avanti: i dati non ne hanno
        las = LassoCV(cv=5, fit_intercept=False).fit(X, y)
        lasso.append(((yt - las.predict(Xt)) ** 2).mean() / sigma ** 2)
        n_avanti.append(len(colonne))
        n_lasso.append(np.count_nonzero(las.coef_))
    d = np.array(avanti) - np.array(lasso)   # lo scarto, campione per campione
    es = d.std(ddof=1) / np.sqrt(len(d))     # e il suo errore standard
    print(f"{snr:8}{np.mean(avanti):12.2f}{np.mean(lasso):8.2f}",
          f"  {d.mean():+.3f} ± {es:.3f}",
          f"  {np.mean(n_avanti):.1f} contro {np.mean(n_lasso):.1f}")
rapporto   in avanti   Lasso   scarto           colonne tenute
    0.25        1.13    1.09   +0.039 ± 0.010   2.2 contro 6.3
     1.0        1.19    1.12   +0.071 ± 0.011   5.1 contro 8.4
     6.0        1.09    1.12   -0.038 ± 0.011   5.6 contro 8.9
Con molto rumore e con rumore medio il Lasso sbaglia meno (\(1{,}09\) contro \(1{,}13\), \(1{,}12\) contro \(1{,}19\)); con i dati quasi puliti il sorpasso si rovescia, e la selezione in avanti arriva a \(1{,}09\) contro \(1{,}12\). Su questi trenta campioni ogni scarto vale più di tre volte il suo errore standard. L’ultima colonna dice perché il Lasso perde dove i dati sono chiari: tiene in media quasi nove colonne, quando quelle che contano sono cinque, mentre la selezione in avanti ne tiene poco più di cinque. È, in piccolo, quello che Hastie, Tibshirani e Tibshirani trovano su un confronto molto più ampio: il freno continuo conviene quando il rumore rende nervosa ogni convocazione, la scelta a salti quando i dati sono abbastanza chiari da convocare bene.
Il rasoio di Occam#
Sotto tutto questo c’è un principio antico. Nel XIV secolo il frate francescano Guglielmo di Occam enunciò quello che oggi chiamiamo il rasoio, riassunto poi nella formula entia non sunt multiplicanda praeter necessitatem, non moltiplicare le entità oltre il necessario (la frase esatta, per la cronaca, non compare nei suoi scritti: la coniò un commentatore del Seicento). Tradotto per noi: a parità di capacità di spiegare i dati, scegli il modello più semplice.
La regolarizzazione mette il rasoio di Occam in formule: il parametro \(\lambda\) è il prezzo che si fa pagare alla complessità, misurata qui come grandezza dei pesi, così che il modello la compri solo quando serve davvero. La curva morbida del pannello centrale di Fig. 4.8 vince non perché sia la più elaborata, ma perché è la più semplice tra quelle che rendono conto dei dati. A parità di errore sui dati, una regola semplice ha meno probabilità di essere una coincidenza fortunata, ed è per questo che la semplicità aiuta a generalizzare; che cosa conti come semplice, però, non si riduce al numero di parametri, come mostra la sezione che segue.
Quando la U non basta: la doppia discesa#
Il quadro appena disegnato entra in tensione con la pratica delle reti profonde. La curva a U dice che oltre una certa complessità l’errore sui dati nuovi risale. Ma una grande rete neurale per il riconoscimento di immagini (un modello a strati, tema del capitolo sulle reti neurali) ha spesso più parametri che esempi di addestramento, e può portare a zero l’errore di addestramento anche su etichette assegnate a caso [ZBH+17]: interpola i dati, rumore compreso. Secondo la U dovrebbe generalizzare male, e spesso generalizza bene.

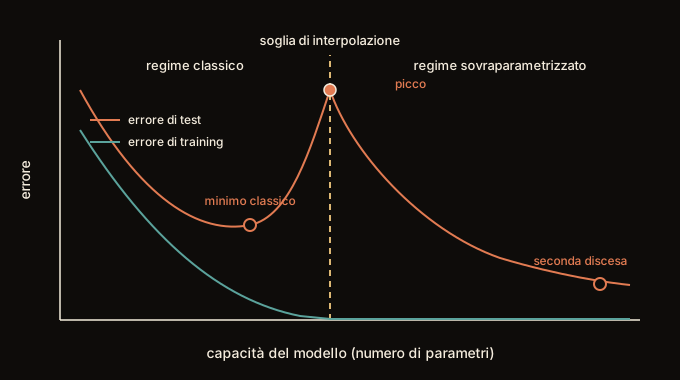
Fig. 4.13 La U descrive solo il primo tratto. Oltre il picco, dove il modello ha appena abbastanza capacità per memorizzare tutto, la curva riscende invece di continuare a salire.#
Il picco di Fig. 4.13 sta alla soglia di interpolazione, dove il numero di parametri uguaglia il numero di esempi: per passare per tutti i punti esiste una sola curva (con dieci punti, un solo polinomio di nono grado, che ha dieci coefficienti), e per obbedire a tutti oscilla fortemente fra un punto e l’altro. Con più parametri le curve che interpolano diventano infinite, e fra di esse ce n’è una regolare; l’addestramento tende a sceglierne una di queste.
Qualcuno ha fatto la cosa che i manuali sconsigliavano: ha continuato a ingrandire il modello oltre il punto in cui impara a memoria ogni esempio. E l’errore sul test, dopo essere risalito come previsto, è tornato a scendere. Non un caso fortunato: un fenomeno riproducibile, chiamato doppia discesa.
La curva, insomma, è una U seguita da una seconda discesa. Il picco sta esattamente nel punto di interpolazione, cioè dove il modello riesce per la prima volta a passare per tutti i punti (in matematica si dice interpolare) e non gli avanza niente.
E l’addestramento sceglie davvero, fra le infinite curve che passano per tutti i punti, quella meno tormentata? Per i modelli lineari è dimostrato: la discesa del gradiente (la procedura a piccoli passi vista con la retta di best fit), partendo da zero e muovendosi a passettini finché non riproduce i dati, arriva a quella con i pesi più piccoli. Per le reti profonde è l’ipotesi più studiata, con buone prove sperimentali ma senza una dimostrazione generale. Avere parametri in eccesso dà soprattutto questo: la libertà di scegliere una soluzione gentile.
La gobba, poi, non compare soltanto ingrandendo il modello. Si vede anche allungando l’addestramento, e perfino aumentando i dati: se il modello sta vicino al punto di interpolazione, raccogliere altri esempi può fargli fare peggio, perché lo spinge proprio là dove non ha margine. Ma non compare sempre: la si vede soprattutto quando fra le risposte giuste ce n’è una quota sbagliata, e il prezzo messo sui pesi grandi l’appiana.
Ne esce un solo consiglio pratico. Quando l’errore sui dati nuovi ha toccato il fondo e ha ricominciato a salire, non è detto che si sia già visto il meglio: ingrandire ancora, qualche volta, ripaga.
Il fenomeno è stato descritto sistematicamente da Belkin e colleghi (2019) [BHMM19] e poi sulle reti profonde da Nakkiran e colleghi (2020) [NKB+20]. Tre precisazioni che evitano di trarne la conclusione sbagliata.
Non è solo la taglia del modello. La doppia discesa si osserva anche rispetto al tempo di addestramento (epoch-wise) e alla quantità di dati, e in quest’ultimo caso produce l’effetto contro-intuitivo per cui, vicino al punto di interpolazione, aggiungere dati può peggiorare il test error.
Il rasoio di Occam regge, se si cambia che cosa si misura. Il numero di parametri è un pessimo proxy della complessità di una rete, e la candidata più studiata al suo posto è una misura di norma della soluzione trovata, la stessa da cui partono i bound di norma della teoria dell’apprendimento. In due casi il legame con l’algoritmo è un teorema: sui minimi quadrati con più parametri che esempi la discesa del gradiente partita da zero converge alla soluzione interpolante di norma \(\ell_2\) minima, un fatto classico dell’algebra lineare, e sulla regressione logistica con dati separabili la direzione dei pesi converge a quella di massimo margine, come hanno dimostrato Soudry e colleghi [SHN+18]. Sulle reti profonde lo stesso bias implicito è un’ipotesi con buone prove sperimentali: che «semplice» non si conti in parametri è assodato, in che cosa si conti no.
Si vede soprattutto con le etichette sporche, e la regolarizzazione appiana il picco. La prima affermazione è degli autori stessi («le osserviamo tutte con più forza dove le etichette hanno del rumore»), che però elencano subito dopo i casi in cui il picco c’è anche con le etichette pulite, e ne mostrano almeno uno in cui sopravvive perfino all’arresto anticipato scelto al meglio. La seconda viene da un lavoro successivo dello stesso gruppo [NVKM21]: una penalità \(\ell_2\) tarata al meglio rende monotona la curva sui modelli lineari con dati isotropi, e attenua il picco anche sulle reti.
Il picco si calcola. Con \(p\) colonne gaussiane isotrope, \(m\) esempi, \(\gamma = p/m\), rumore di varianza \(\sigma^2\) e segnale \(\lVert\boldsymbol\beta\rVert^2 = B^2\), la soluzione ai minimi quadrati di norma minima (l’unica per \(\gamma<1\), l’interpolante di norma \(\ell_2\) minima per \(\gamma>1\)) ha rischio in eccesso \(\sigma^2\,\gamma/(1-\gamma)\) per \(\gamma<1\) e \(B^2(1-1/\gamma)+\sigma^2/(\gamma-1)\) per \(\gamma>1\), per \(m,p\to\infty\) a \(\gamma\) fisso [HMRT22]. Diverge in \(\gamma=1\), dove il sistema \(\mathbf{X}\boldsymbol\beta=\mathbf{y}\) ha una sola soluzione e \(\mathbf{X}\) è quasi singolare, e per \(\gamma\to\infty\) tende a \(B^2\), il rischio del predittore nullo. Con \(\sigma^2=0\) il picco non c’è, in questo modello, ed è per questo che la doppia discesa è più evidente con le etichette rumorose.
Resta parecchio da capire: quali architetture e quali regimi la mostrino, e perché il bias implicito abbia la forma che ha. Il consiglio di fondo non cambia (misurare su dati mai visti, tenere il test chiuso); cambia un dettaglio: il primo minimo della curva di validazione non è detto che sia il migliore, e un modello che sembra troppo grande vale comunque una prova.
Il biglietto vincente: a che serve tutta quella capacità#
La doppia discesa dice che le reti sovradimensionate generalizzano. Resta la domanda su perché, e c’è un risultato che offre una risposta diversa e sorprendentemente concreta.
Una rete neurale è fatta di strati di nodi; fra un nodo e quelli dello strato successivo passa un collegamento con un peso, uno dei parametri che l’addestramento aggiusta (la sezione sul percettrone lo spiega). I pesi iniziali sono sorteggiati a caso: se fossero tutti uguali, tutti i collegamenti di uno strato riceverebbero la stessa correzione e resterebbero uguali per sempre, e la rete non potrebbe specializzarsi. Una rete grande ha milioni di pesi. Potare vuol dire azzerare i pesi più piccoli in valore assoluto, che contano meno nella risposta: tagliarli non cambia quasi la risposta, e quello che resta è una sottorete.

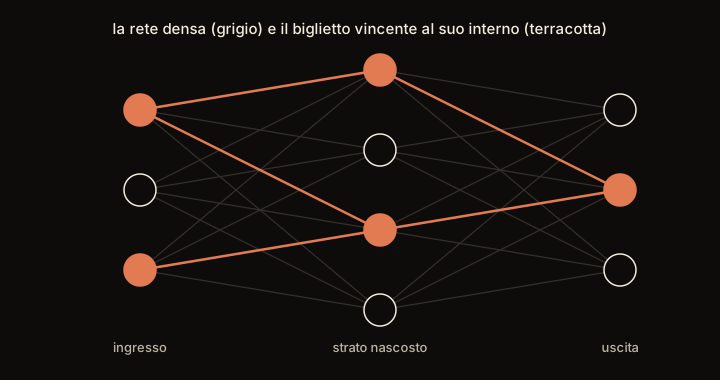
Fig. 4.14 Dentro la rete grande ce n’è una piccola che basta. Il punto sta nell’inizializzazione: quella sottorete funziona solo se riparte dai suoi pesi iniziali, quelli che aveva nella rete grande.#
La condizione in coda a Fig. 4.14 è ciò che rende questa idea, che si chiama ipotesi del biglietto vincente, interessante invece che ovvia. Se si riprende la stessa sottorete e la si inizializza da capo a caso, non impara altrettanto bene: il biglietto sta nella coppia fra la forma della sottorete e i numeri con cui è nata. Sovradimensionare, in questa lettura, serve a comprare molti biglietti.
Il punto di partenza è un paradosso noto da tempo. Prendi una rete addestrata ed elimina i pesi più piccoli: puoi buttarne via il \(90\%\) senza quasi perdere accuratezza. Ma se poi provi a costruire da zero una rete piccola con quella stessa struttura e ad addestrarla, impara peggio. La potatura funziona solo dopo l’addestramento, e nessuno spiegava bene perché.
Frankle e Carbin (2019) hanno provato una cosa diversa. Dopo aver potato, invece di ripartire con pesi casuali nuovi, hanno riavvolto i pesi sopravvissuti ai valori casuali che avevano all’inizio, prima di qualsiasi addestramento. Quella sottorete minuscola, riaddestrata da sola, raggiunge l’accuratezza della rete piena. E il giro si può ripetere: si pota ancora, si riavvolge ancora, e la sottorete si stringe di volta in volta.
La rete grande, allora, non serve tutta. Serve perché, fra le sue milioni di connessioni inizializzate a caso, ne contiene per fortuna un sottoinsieme già disposto bene per il compito; il resto è impalcatura. Da qui il nome, biglietto vincente, e la rete grande come un mazzo di biglietti comprati tutti insieme.
Il seguito ha corretto due cose, e conoscerle evita di prendere l’idea per più di quello che è. Sulle reti grandi e sui dati veri il riavvolgimento fino al primo giorno smette di funzionare: bisogna tornare indietro un po’ meno, a dopo qualche giro di addestramento. Il biglietto, quindi, prende forma nelle prime ore di scuola invece di essere già stampato alla nascita. E per trovarlo la rete intera va addestrata comunque, più di una volta: è un modo di capire a che cosa serva tutta quella taglia, non una scorciatoia per allenare reti piccole.
La procedura [FC19] è l’iterative magnitude pruning: si annota l’inizializzazione \(\theta_0\), si addestra, si elimina una frazione dei pesi più piccoli, si riportano i sopravvissuti ai valori in \(\theta_0\), si riaddestra, si ripete. Le sottoreti trovate pesavano spesso meno del \(10\)–\(20\%\) della rete di partenza, e raggiungevano l’accuratezza piena in un numero comparabile di iterazioni.
Due avvertenze di onestà, perché il risultato è più fragile di come viene spesso citato.
Alla scala grande la ricetta va corretta, e la correzione non è nel lavoro del 2019 ma in uno successivo di Frankle e Carbin con Dziugaite e Roy [FDRC20]: su reti profonde e dataset seri il riavvolgimento a \(\theta_0\) smette di funzionare, e si riavvolge invece a un \(\theta_k\) dopo qualche iterazione di addestramento (rewinding tardivo). Il biglietto, quindi, non è del tutto presente all’inizializzazione: si forma nelle prime fasi.
Non è un metodo di compressione pratico. Per trovare il biglietto bisogna addestrare la rete piena, più volte. Il valore è conoscitivo (dice qualcosa su cosa fa la sovraparametrizzazione) non computazionale. Per comprimere davvero si usano la potatura strutturata e la quantizzazione, che sono il mestiere del capitolo sull’efficienza.
Il filo con la doppia discesa è comunque lo stesso: il numero di parametri misura male la complessità. La doppia discesa lo mostra dall’esterno, guardando la curva d’errore; il biglietto vincente dall’interno, guardando cosa la rete usa davvero.
Attenzione a non trarne la conclusione sbagliata. Doppia discesa e biglietto vincente non smontano nulla di ciò che viene prima: dicono soltanto che «quanto è complesso un modello» non si conta in parametri. Tenere il test chiuso, misurare su dati mai visti e far pagare un prezzo alla complessità restano esattamente ciò che erano, e sono le cose da portarsi via.
Da ricordare
Ci sono due modi opposti di sbagliare: essere troppo rigidi (una retta dove serviva una curva: si sbaglia già sugli esempi di scuola) ed essere troppo flessibili (una curva che passa per ogni punto, rumore compreso: dieci e lode sugli esempi di scuola, disastro sui casi nuovi). Il secondo è l’overfitting, cioè imparare a memoria.
Immagina di riaddestrare il modello molte volte su dati sempre nuovi: se le risposte sono tutte spostate dalla stessa parte è un difetto di mira (il bias); se sono sparpagliate è un difetto di stabilità (la varianza). Si correggono in modi opposti, e mettendo la flessibilità del modello su un asse l’errore sui dati nuovi disegna una U: si sceglie il fondo.
Prima di spendere per raccogliere altri dati, si guardano le curve di apprendimento: si riaddestra con sempre più esempi e si guarda l’errore. Se quello sugli esempi di scuola e quello sui casi nuovi si sono già raggiunti e fermati, altri dati non servono e va cambiato modello; se fra i due resta un divario, i dati in più pagano.
Per accorgersene bisogna misurare su dati che il modello non ha usato: si divide in tre, studio, prove, esame. L’esame (il test) si apre una sola volta, alla fine: ogni sbirciata lo consuma e il voto diventa più generoso del vero. E anche i preparativi (rimettere le colonne in scala, riempire le caselle vuote) vanno fatti guardando solo la parte di studio.
Con pochi dati conviene la cross-validation: si divide in cinque blocchi e a turno uno fa da prova, come cinque compiti in classe su cinque parti diverse del programma invece di una sola interrogazione. Contano la media dei cinque voti e quanto sono discordi. Vale però solo se i cinque compiti chiedono cose davvero diverse: se lo stesso soggetto ricompare in più righe, le sue righe vanno tenute tutte nello stesso blocco.
Per frenare la memorizzazione si mette un prezzo alla complessità: il modello può usare pesi grandi solo se ne conviene. Contando la spesa a valori assoluti alcuni pesi vanno esattamente a zero (le caratteristiche inutili spariscono), contandola a quadrati si rimpiccioliscono tutti. Le colonne che vanno in gruppo si fanno pagare come un pacchetto, che entra o esce intero, e i pacchetti li sceglie chi scrive il modello.
Scegliere le colonne a salti (dentro o fuori) è nervoso: basta poco per cambiare la scelta. Conviene quando i dati sono chiari, mentre con tanto rumore vince il freno continuo, e convocare con il freno per poi allentarlo va bene quasi sempre.
Il principio antico è il rasoio di Occam: a parità di spiegazione dei dati, vince la spiegazione più semplice. Il principio regge anche per la doppia discesa, dove oltre il punto in cui il modello impara tutto a memoria ingrandirlo ancora torna a farlo funzionare meglio: quello che conta è quanto sono grandi i pesi, più che quanti pesi ha il modello.
E una risposta c’è anche alla domanda a che cosa serva tutta quella taglia: dentro una rete grande ce n’è una piccola già disposta bene per il compito, e funziona solo se riparte dai numeri che aveva all’inizio, o poco dopo quando la rete è grande davvero. Trovarla costa più che addestrare la rete intera, quindi è un modo di capire, non di risparmiare.
Da ricordare
Underfitting: modello troppo semplice, sbaglia già sul training (bias alto). Overfitting: modello troppo flessibile, memorizza il rumore ed è ottimo sul training ma pessimo sui dati nuovi (varianza alta).
L’errore di test ha forma a U nella complessità: il minimo è il compromesso bias-varianza. Oltre il punto di interpolazione, però, la curva può riscendere (doppia discesa): il numero di parametri è un pessimo proxy della complessità di una rete.
Il biglietto vincente guarda lo stesso fatto dall’interno: una rete grande contiene una sottorete piccola che, riavviata dai propri pesi iniziali (o da quelli di poche iterazioni dopo, sulle reti grandi), si addestra bene quanto l’intera. Trovarla richiede di addestrare la rete piena più volte: ha valore conoscitivo, non di compressione.
La decomposizione bias-varianza è un’identità della loss quadratica: per la 0-1 i due termini restano vocabolario, non aritmetica.
Si divide in train / validation / test. Il test non si tocca: si apre una sola volta, alla fine, o la stima diventa ottimista. Ogni trasformazione che impara dai dati (scaler, imputazione, selezione) si tara dentro il training: è la forma di leakage che non dà avvisi.
La k-fold cross-validation media \(k\) validazioni su fold diversi: stima più stabile quando i dati sono pochi. Vale se le righe sono scambiabili: con righe raggruppate per soggetto servono
GroupKFold, con righe ordinate nel tempoTimeSeriesSplit.La regolarizzazione (Ridge \(\ell_2\), Lasso \(\ell_1\)) frena la complessità con una penalità \(\lambda\) sui pesi; il Lasso azzera le feature inutili, il group lasso (\(\sum_g\sqrt{p_g}\lVert\theta_g\rVert_2\)) interi blocchi dichiarati in anticipo, indipendentemente dalla codifica solo se i blocchi sono ortonormalizzati.
La selezione discreta (sottoinsieme migliore, selezione in avanti) è instabile, e la sua previsione salta dove quella del Lasso è continua: a rapporto segnale/rumore basso vince il Lasso, a rapporto alto (raro sui dati osservazionali) la selezione; il relaxed lasso è competitivo in tutti e due i regimi.
Il rasoio di Occam regge se la complessità non si conta in parametri: sui modelli lineari la discesa del gradiente ha un bias implicito dimostrato verso soluzioni di norma piccola, sulle reti profonde è l’ipotesi più studiata.